

Resumen
Qwen 3.8 Flash Next es la versión preliminar de pesos abiertos que el equipo de Qwen ha publicado de su arquitectura de nueva generación, Qwen4. Tras una semana usándolo, mi conclusión es esta: es uno de los mejores modelos en inteligencia por dólar que puedes conseguir ahora mismo, y a la vez es una versión de investigación que Qwen entrenó deliberadamente poco. Las dos cosas son ciertas a la vez.
Lo que hace bien es real. Es un modelo de mezcla de expertos de 125B que activa solo 6B parámetros por token, así que corre rápido en hardware que nunca podría alojar un modelo denso de ese tamaño, y la versión alojada cuesta apenas $0.15 de entrada / $0.47 de salida por millón de tokens. Artificial Analysis lo coloca en el puesto 5 de 111 en inteligencia dentro de su clase.
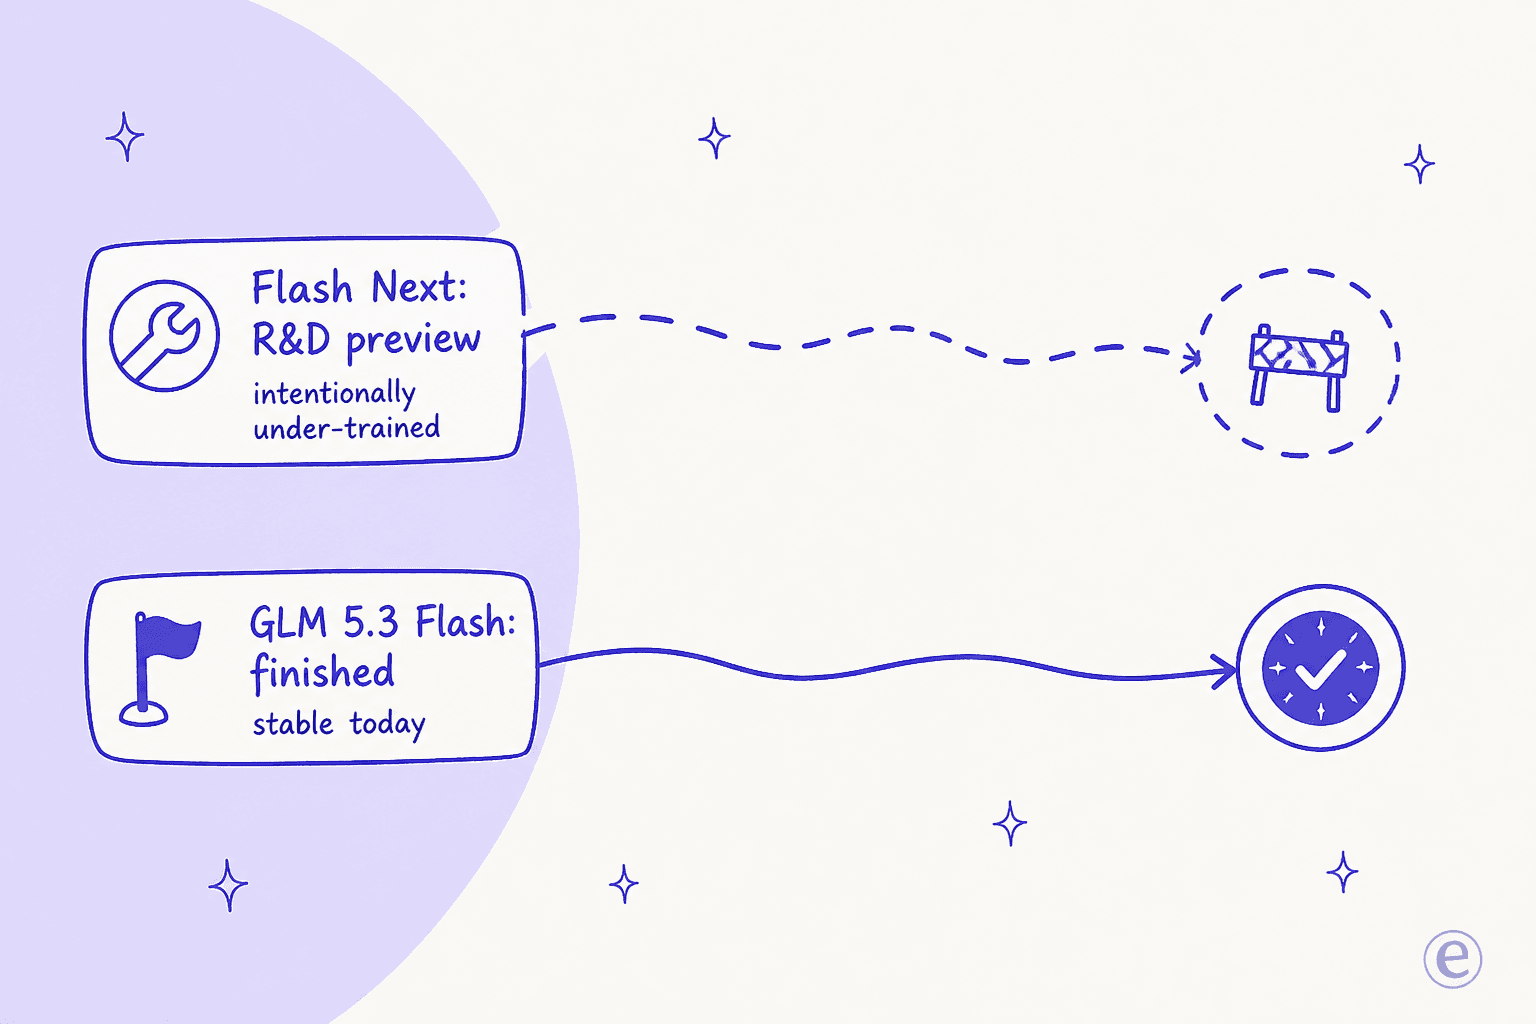
Los inconvenientes son igual de reales. Qwen dice que está deliberadamente poco entrenado, la cuantización de pocos bits necesaria para ejecutarlo en local cuesta calidad de forma visible, y es muy verboso, lo que infla en silencio la factura de tokens de salida. Si quieres hoy un modelo terminado en esta categoría de peso, GLM 5.3 Flash es la opción más segura.
Y si estás leyendo esto porque quieres IA barata para atención al cliente: el modelo es la parte fácil. Un modelo en bruto no lee tus tickets ni redacta respuestas. Eso es trabajo de una plataforma, y es lo que eesel gestiona sobre modelos como este.
Qué estaba analizando exactamente
Construyo agentes de IA en eesel, así que el lanzamiento de un modelo es un problema de trabajo, no un deporte de espectador: la pregunta siempre es si lo pondría delante de una carga de trabajo real. Cuando el equipo de Qwen lanzó Qwen 3.8 Flash Next el 26 de agosto de 2026, la primera hora se fue en desenredar el nombre, porque confunde a la gente.
Esta es la versión clara. Qwen3.8-Flash-Next es la versión preliminar de pesos abiertos que autoalojas; Qwen3.8-Flash es la próxima API alojada con 1M de contexto y herramientas integradas. "Next" no es un Flash más grande. Es la etiqueta que Qwen pone a una vista previa de arquitectura, publicada para que la comunidad pueda probar la nueva fontanería antes de construir sobre ella la familia Qwen4 completa. Todo veredicto de abajo depende de esa palabra.
Ese encuadre importa porque "versión preliminar poco entrenada" no es una crítica que yo me haya inventado. Es la descripción de Qwen, repetida en todos los lugares donde se reunió la comunidad. La explicación más clara vino del hilo de lanzamiento en Hacker News:
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."

Así que la forma justa de analizarlo no es "¿es el mejor modelo?", sino "¿está dando resultado la apuesta por la arquitectura y vale la pena ejecutar este checkpoint concreto?". Preguntas distintas, respuestas distintas.
Qué es realmente bueno
La cifra principal resiste el escrutinio independiente, algo menos común de lo que debería. Artificial Analysis puntúa a Flash Next con 56 en su Intelligence Index, el puesto 5 de 111 de su clase, frente a una mediana de 29. Su veredicto es que está "amongst the leading models in intelligence and reasonably priced". Con unos $0.10 por tarea del Index, la historia de valor no es humo.
En la tabla de benchmarks propia de Qwen, que debes leer como datos reportados por el fabricante, destaca especialmente en programación y trabajo con agentes:
| Benchmark | Qwen3.8-Flash-Next | Qwen3.7-Plus | DeepSeek-V4-Flash | Claude-Opus-4.6 |
|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 55.8 | 56.0 | 53.4 |
| LiveCodeBench v6 | 91.9 | 89.6 | 90.6 | 88.8 |
| GPQA Diamond | 91.7 | 90.3 | 90.8 | 91.3 |
| IFBench (seguimiento de instrucciones) | 81.3 | 79.1 | 79.2 | 62.5 |
| CoWorkBench (tareas largas de oficina) | 73.9 | 65.1 | 45.1 | 68.2 |
| Humanity's Last Exam | 35.9 | 34.7 | 33.8 | 40.0 |
Fuente: tablas de benchmarks de Qwen. Dos lecturas honestas. Supera a modelos mucho más grandes en SWE-bench Pro, un resultado real para este tamaño. Y no es un barrido limpio: Claude Opus 4.6 se lleva Humanity's Last Exam, y DeepSeek V4 Flash lo supera en generación a nivel de repositorio.
La segunda fortaleza real es la eficiencia de hardware, y es la parte que de verdad le importa a la comunidad. Como solo hay 6B parámetros activos por token y la tabla de consulta N-gram de 51B se puede descargar a la RAM normal del sistema, la gente ejecuta un modelo de clase ~180B en equipos modestos. La comunidad de herramientas marcó el tono enseguida:
"Qwen3.8-Flash can now be run locally! The 125B MoE model outperforms Claude-Opus-4.6 (Max). Run on 75GB RAM via Unsloth GGUFs. Qwen3.8-Flash-Next enables CPU RAM / unified mem setups to deliver near VRAM speeds."
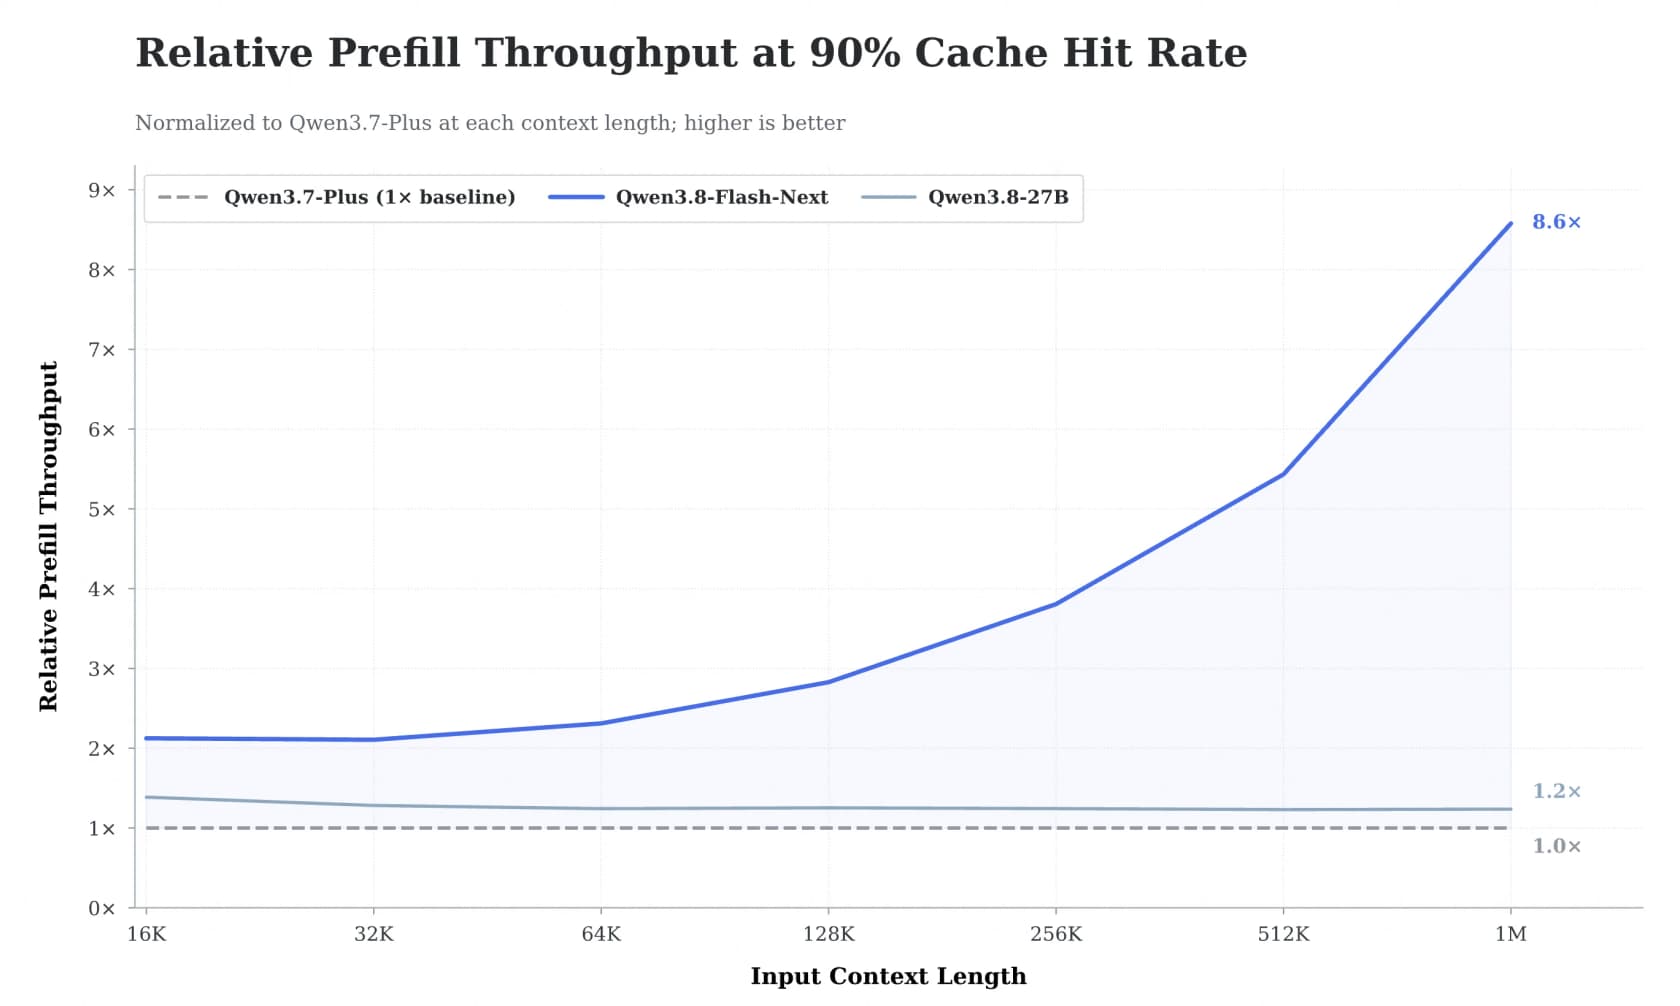
Toma la frase de "supera a Opus 4.6" como entusiasmo, no como dato medido, ya que es suya y no está verificada. Pero lo de las velocidades en hardware barato es real y se repite. Con contexto largo la ganancia es mayor: Qwen informa de que su kernel de atención dispersa alcanza hasta 7.6x de aceleración en prefill y 4.9x en decode con 1M de tokens.
Dónde se nota la versión preliminar
Ahora las partes que lo mantienen fuera de producción.
La cuantización duele, y se nota. Para meter un modelo de clase ~180B en hardware de consumo hay que cuantizar con fuerza, y el coste en calidad no es sutil. Simon Willison lo ejecutó con varios niveles de razonamiento en un DGX Spark y acabó prefiriendo el modelo denso más pequeño:
"I ran some pelicans at the four different reasoning levels... Surprised I didn't get one I liked as much as the Qwen 3.8 27B one, maybe because of quantization."
Ese es el tema recurrente en todos los hilos sobre ejecución local que leí. La arquitectura te permite ejecutarlo barato; no promete que el checkpoint que metes en tu equipo iguale la tabla de benchmarks.
Piensa demasiado. Como la mayoría de los modelos de razonamiento de Qwen, Flash Next es un pensador intenso, y se nota en las trazas.
"It's definitely a heavy thinker, like most Qwens. I see strings like 'write, now.' in the thinking traces then it goes on to think for a lot longer, so it's kind of weird."
Esto conecta con la advertencia práctica más contundente de todo el análisis.
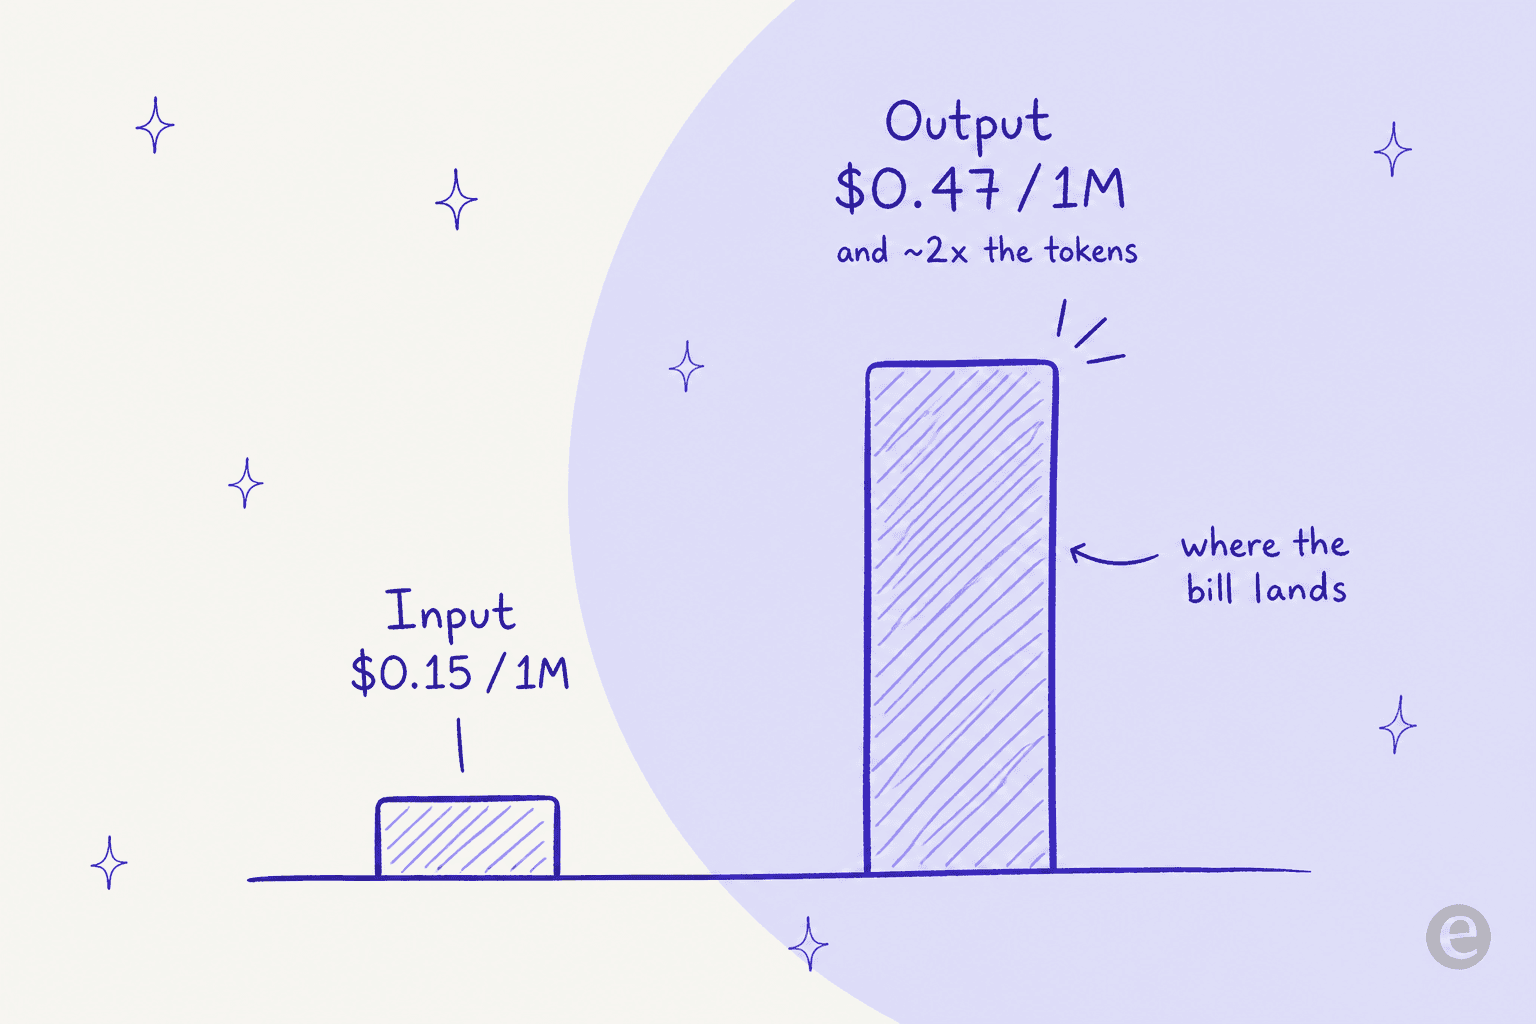
La trampa de costes de la salida verbosa. Artificial Analysis lo marcó como "very verbose": consumió 200M de tokens de salida para completar su Index frente a una mediana de 110M. Es casi el doble. En la API alojada, la salida se factura a $0.47 por millón, así que el titular de entrada barata esconde una factura de salida real en ejecuciones largas con agentes. Para una respuesta de soporte corta es un error de redondeo; para un bucle de agente de varios pasos es la cifra que decide tu coste. Modela los tokens de salida antes de fiarte del precio de lista.
Cuánto cuesta realmente
Los pesos abiertos son gratuitos. Si tienes el hardware, solo pagas computación y nada más, que es todo el atractivo para quienes autoaloja.
Para la API alojada de Qwen3.8-Flash, el precio es plano, sin tramos por longitud de contexto como tenía Qwen 3.7 Flash:
| Concepto | Tarifa (USD / 1M de tokens) |
|---|---|
| Entrada | $0.15 |
| Salida | $0.47 |
| Entrada, lectura en caché | $0.016 |
| Creación explícita de caché | $0.20 |
Esa lectura en caché es un 89% más barata que la entrada nueva, y no es teórico: OpenRouter observó una tasa de aciertos de caché del 91.1% en tráfico real, lo que reduce el precio de entrada efectivo a unos $0.028 por millón. Un asterisco más allá de la verbosidad: por ahora solo hay un proveedor de API, Alibaba Cloud International, así que todavía no hay conmutación por error entre varios proveedores. Sopésalo frente a Kimi K3 o Qwen 3.8 Max si la resiliencia importa más que el último céntimo.
Entonces, ¿deberías usarlo?
Así lo veo tras una semana. Recorre las dos preguntas de abajo y todo se ordena solo.
Quiero ejecutar modelos en mi propio hardware
Un sí rotundo. Un Mac con memoria unificada, un DGX Spark o un equipo con mucha RAM del sistema es exactamente la configuración que este diseño premia. Espera velocidades cercanas a la VRAM y algo de pérdida de calidad por la cuantización. Ajusta los flags del presupuesto de razonamiento para domar el exceso de pensamiento.
Quiero una API alojada barata y centrada en programación
Sí, con los ojos abiertos. Los números de SWE-bench son reales y el precio de entrada en caché es excelente. Modela primero los tokens de salida, porque la verbosidad es donde de verdad cae la factura, y recuerda que hoy hay un único proveedor.
Necesito un modelo estable para producción ahora mismo
Espera. Qwen lo llama una versión preliminar poco entrenada, y se comporta como tal. Recurre a GLM 5.3 Flash, un nivel de Claude Opus 5 o Qwen 3.8 Max hasta que llegue la línea Qwen4 completa.
Úsalo si eres un aficionado a la inferencia local, quieres un adelanto de la arquitectura Qwen4 o tienes una carga de programación favorable a la caché donde el bajo precio y los buenos números de SWE-bench compensan. Espera si necesitas hoy un modelo de calidad de producción, ya que es una versión preliminar poco entrenada según el propio Qwen, la cuantización duele y la API alojada tiene un solo proveedor.
De cualquier modo, lo más útil es entender qué es realmente un modelo: un componente. Algo que tengo que explicar una y otra vez a los equipos que buscan "IA barata".
Dónde encaja un modelo como este en el trabajo real de soporte
Mucha gente lee un lanzamiento así y piensa: "genial, apuntaré mi bandeja de soporte a Qwen 3.8 Flash Next y recortaré mi factura de IA". Es un error de categoría. Un modelo en bruto recibe tokens y devuelve tokens. No conoce tu política de reembolsos, no puede leer el historial de pedidos de un cliente y no sabe si su respuesta segura es realmente correcta. El modelo es infraestructura; lo que hace el trabajo es el empleado.
He visto cómo esa brecha muerde de la peor manera. Al principio con un cliente, el bot decía alegremente a los compradores "sí, soportamos el modelo de tu coche" para marcas que no estaban en su base de datos, porque la base de conocimiento decía "soportamos todos los modelos". La solución no fue un mejor modelo base. Fue mejor recuperación de información, un anclaje más estricto y pruebas con historial real antes de salir en vivo. El propio resumen del equipo sobre esa fase fue "prueba y error al principio", y esa es exactamente la fase a la que te devolvería un modelo nuevo y poco entrenado si confías en él sin más.
Esa capa de empleado es lo que construimos en eesel. La idea es sencilla: eesel es una plataforma de compañeros de IA, y contratas compañeros listos para trabajar en tareas concretas, actualmente un compañero de IA para el helpdesk y un redactor de blog de IA. Cada uno llega con las habilidades, integraciones y contexto de empresa de su rol, de modo que el modelo que corre por debajo pasa a ser un detalle de implementación y no tu problema.

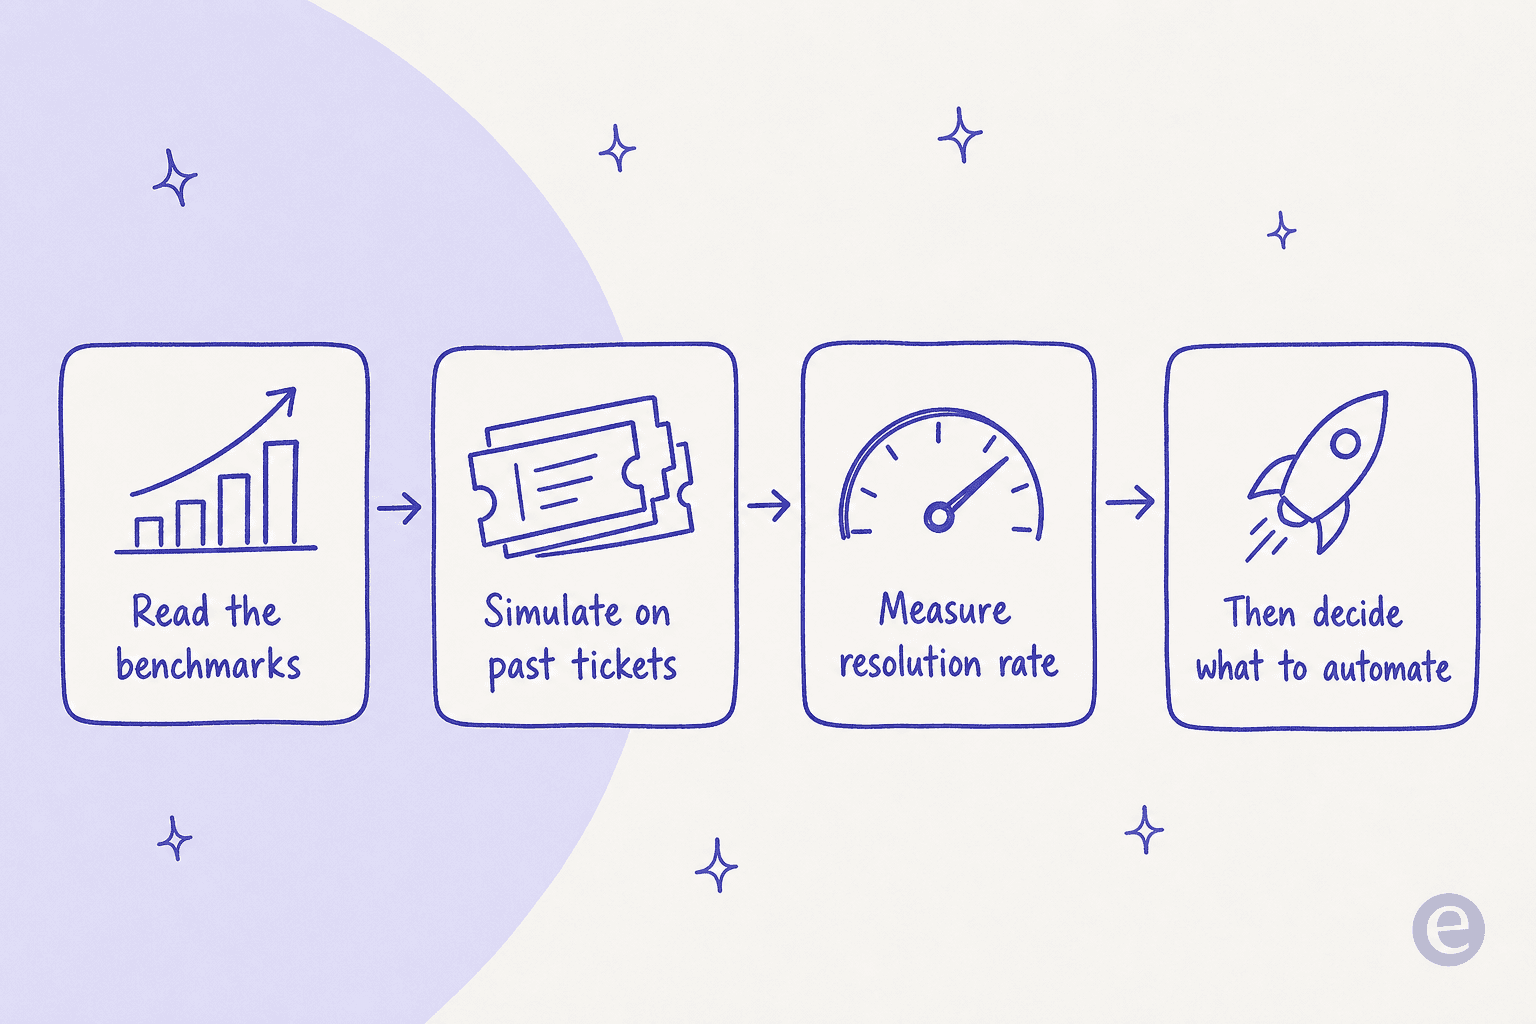
La parte que más subrayaría es la de las pruebas, porque he visto cómo ha salvado a gente. El compañero de helpdesk de eesel simula cada despliegue con tus tickets históricos antes de tocar a un cliente real, así que ves la tasa de resolución y las respuestas exactas que habría enviado en conversaciones pasadas reales, y luego decides qué automatizar. Un modelo preliminar poco entrenado es justo lo que quieres pasar por esa puerta en lugar de fiarte de una tabla de benchmarks. Y como eesel lee de tu base de conocimiento y de tickets pasados, el problema de contexto que un modelo en bruto nunca puede resolver por sí solo queda cubierto.
En resumen: modelos como Qwen 3.8 Flash Next se vuelven baratos y capaces muy rápido, lo cual es una gran noticia, pero elegir uno es el 10% fácil del trabajo. El otro 90% es convertirlo en un compañero que resuelva tickets, y esa es la capa que merece tu tiempo.
Prueba eesel
Si llegaste aquí sopesando Qwen 3.8 Flash Next para una carga de soporte, el consejo honesto es que dejes de buscar un modelo y empieces a probar con tus propios tickets. eesel se conecta a tu helpdesk actual, aprende de tu base de conocimiento y de conversaciones pasadas, y simula cada despliegue con tickets históricos para que veas la tasa de resolución real antes de que nada salga en vivo. Es gratis probarlo, y el modelo de debajo sigue siendo nuestro problema, no el tuyo.