

Qwen 3.8 Flash Next es un gran juguete y una dependencia de producción dudosa. Es la vista previa de pesos abiertos de Alibaba de la arquitectura Qwen4, que la propia Qwen describe como deliberadamente poco entrenada, servida a través de un único proveedor de API y lo bastante verbosa como para inflar las facturas de salida. Así que si te gustaron el precio y la velocidad pero necesitas algo más terminado, aquí tienes dónde mirar:
- El gemelo terminado de pesos abiertos: GLM 5.3 Flash, que la comunidad considera listo para producción y que cuesta $0.075/$0.25 en promoción.
- El suelo de presupuesto: DeepSeek V4 Flash (licencia MIT) o Granite 4.2 8B autoalojado, a $0.06/$0.25 alojado.
- Quedarte en la familia: Qwen 3.8 Max, el hermano mayor estable y alojado.
- Gestionado y multimodal: Gemini 3.7 Flash o GPT-5.6 Luna si quieres la fiabilidad de un gran proveedor.
Y el punto que más importa si buscas "IA barata" para soporte: el modelo es el 10% fácil. Convertir cualquiera de estos en algo que realmente resuelva tickets es el otro 90%, y eso es trabajo de una plataforma, no una elección de modelo.
Por qué la gente deja Qwen 3.8 Flash Next
Construyo agentes de IA en eesel, así que veo cómo la franja de modelos baratos se renueva cada pocas semanas, y Qwen 3.8 Flash Next fue uno de los lanzamientos más sonados del verano. El hilo de Hacker News llegó a 698 puntos y r/LocalLLaMA tuvo un megahilo de más de 650 comentarios. El entusiasmo es real: la activación dispersa y una tabla N-gram de 51B descargable permiten ejecutar un modelo de 125B en un portátil con memoria unificada.
Pero si lees más allá de los gráficos del lanzamiento, surge una lista clara de motivos para cambiar. Esta es la versión honesta de lo que estás aceptando:
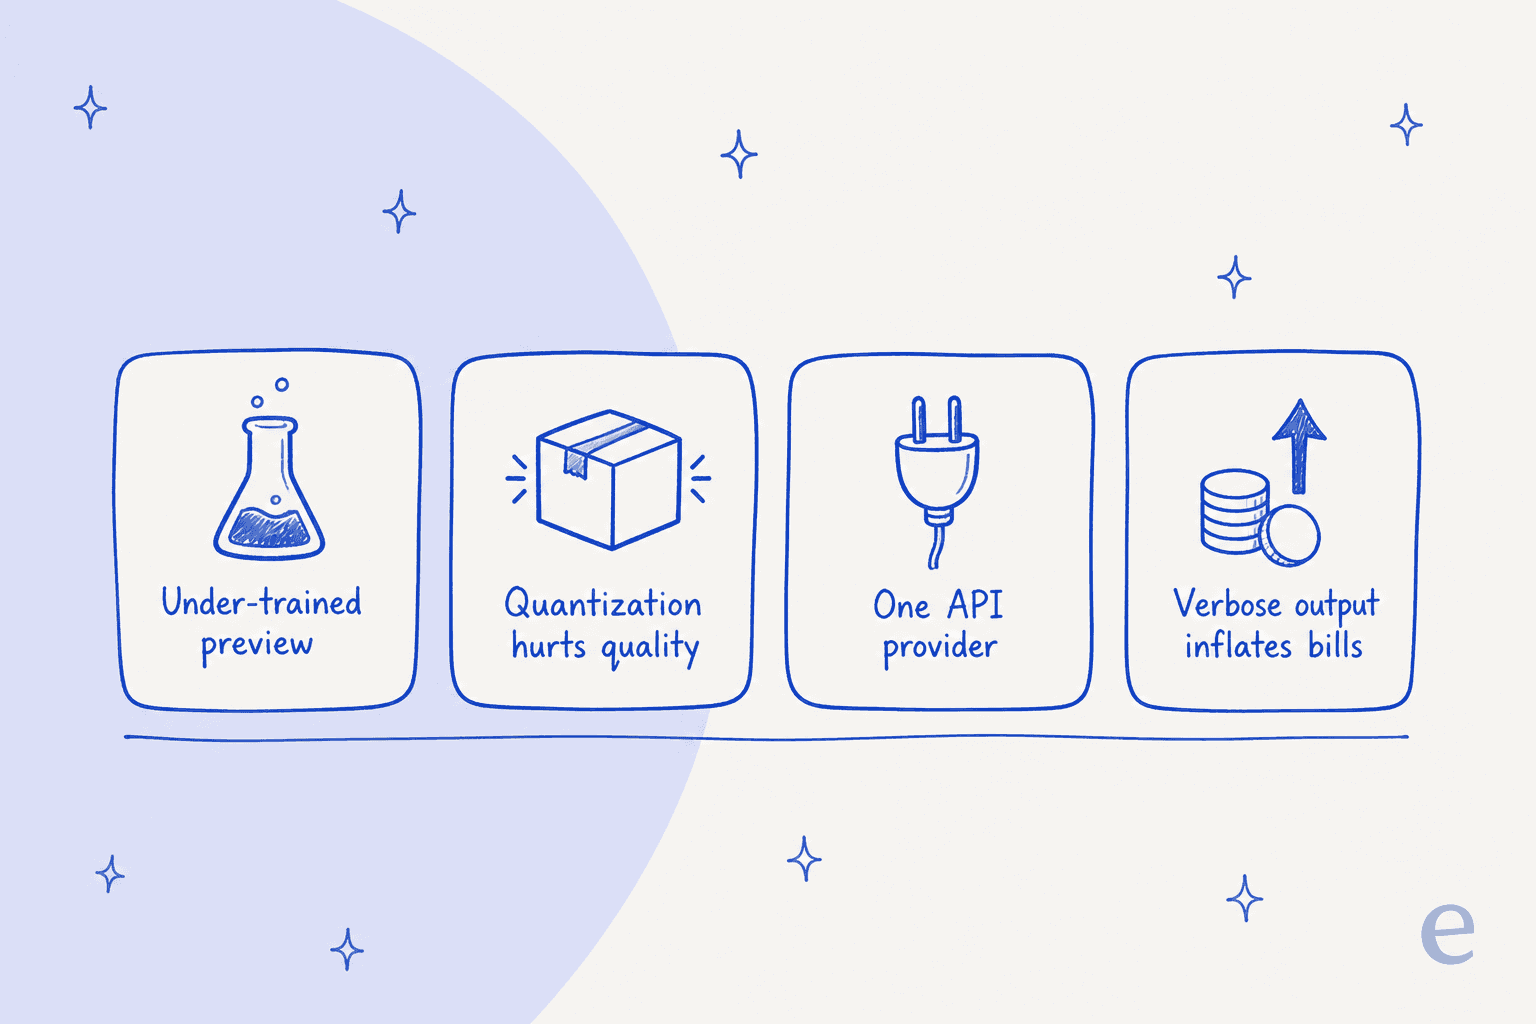
La voz más clara sobre lo que realmente significa "Next" vino del hilo del lanzamiento:
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."

Luego está el impuesto de la cuantización. Simon Willison lo ejecutó con varios niveles de razonamiento en un DGX Spark y acabó prefiriendo el modelo denso más pequeño, culpando a la cuantización de pocos bits necesaria para que cupiera. Además, la API alojada de Qwen3.8-Flash tiene actualmente un solo proveedor, Alibaba Cloud International, así que no hay conmutación por error. Y las pruebas independientes de Artificial Analysis lo marcan como "very verbose": quema 200M de tokens de salida para completar su Index frente a una mediana de 110M, lo que infla discretamente cualquier factura con mucha salida.
Nada de eso lo convierte en un mal modelo. Lo convierte en una vista previa. Si quieres algo en lo que puedas confiar este trimestre, los ocho siguientes son donde está aterrizando esa misma gente.
Cómo elegí estas alternativas
Limité la lista a modelos que resuelven al menos uno de los cuatro problemas de Flash Next descritos arriba, y me apoyé en cifras independientes antes que en tablas de los fabricantes siempre que existen. En concreto, cada elección tenía que cumplir unos requisitos:
- Precios reales y comprobables. Una tarifa publicada por token o pesos abiertos gratuitos, no "contacta con ventas".
- Un lanzamiento que se sienta terminado, o una nota honesta donde no sea así.
- Una puntuación independiente verificable donde exista (sobre todo el Intelligence Index de Artificial Analysis), para no limitarme a citar un blog de lanzamiento.
- Un trabajo distinto. Ninguna pareja de elecciones es "lo mismo pero un poco más barato", cada una gana en un caso de uso diferente.
Lo que no hice fue fingir que un benchmark es un agente de soporte. Más sobre eso al final.
Alternativas a Qwen 3.8 Flash Next de un vistazo
Aquí tienes toda la lista en un solo lugar. Los precios son tarifas de API alojada por 1M de tokens (entrada/salida); todos los modelos de pesos abiertos también se pueden autoalojar gratis si tienes el hardware.
| # | Modelo | Ideal para | Tipo | Contexto | Precio ent./sal. (por 1M) | Licencia |
|---|---|---|---|---|---|---|
| 1 | GLM 5.3 Flash | Gemelo terminado de pesos abiertos | Abierto + alojado | 1M | $0.075 / $0.25 (promo) | Pesos abiertos |
| 2 | DeepSeek V4 Flash | Suelo de presupuesto, MIT | Abierto + alojado | 1M | $0.22 / $0.66 (fuera de pico) | MIT |
| 3 | Qwen 3.8 Max | Quedarse en la familia Qwen | Abierto + alojado | 1M | $2.00 / $6.00 | Licencia Qwen |
| 4 | Kimi K3 | Trabajo agéntico de largo recorrido | Abierto + alojado | 1M | $3.00 / $15.00 | Pesos abiertos |
| 5 | Gemini 3.7 Flash | Multimodal gestionado | Alojado | ~1M | $0.75 / $3.75 (promo) | Cerrado |
| 6 | GPT-5.6 Luna | Fiabilidad de ecosistema cerrado | Alojado | Grande | $0.20 / $1.20 | Cerrado |
| 7 | Granite 4.2 | Empresa / on-prem | Abierto + alojado | 128K | $0.06 / $0.25 (Replicate 8B) | Apache 2.0 |
| 8 | LongCat 2.0 | Gran MoE MIT comodín | Abierto + alojado | 256K | $0.30 / $1.20 (promo) | MIT |
Un ejemplo rápido, porque las tarifas de lista esconden la brecha real. Supongamos que una carga agéntica mensual usa 50M de tokens de entrada y 15M de salida. Con la promoción de GLM 5.3 Flash son unos $7.50; con Granite 4.2 8B en Replicate, aproximadamente $6.75; con el propio Qwen3.8-Flash alojado, unos $14.55; con Gemini 3.7 Flash, cerca de $94; y con Kimi K3, alrededor de $375. El mismo trabajo, una diferencia de 50x. Los tokens de salida, no los de entrada, son donde los modelos de razonamiento entierran el coste sin que se note.
1. GLM 5.3 Flash, el gemelo terminado de pesos abiertos
Ideal para: equipos a quienes les gustó la clase económica de pesos abiertos de Flash Next pero necesitan algo que ya parezca terminado.
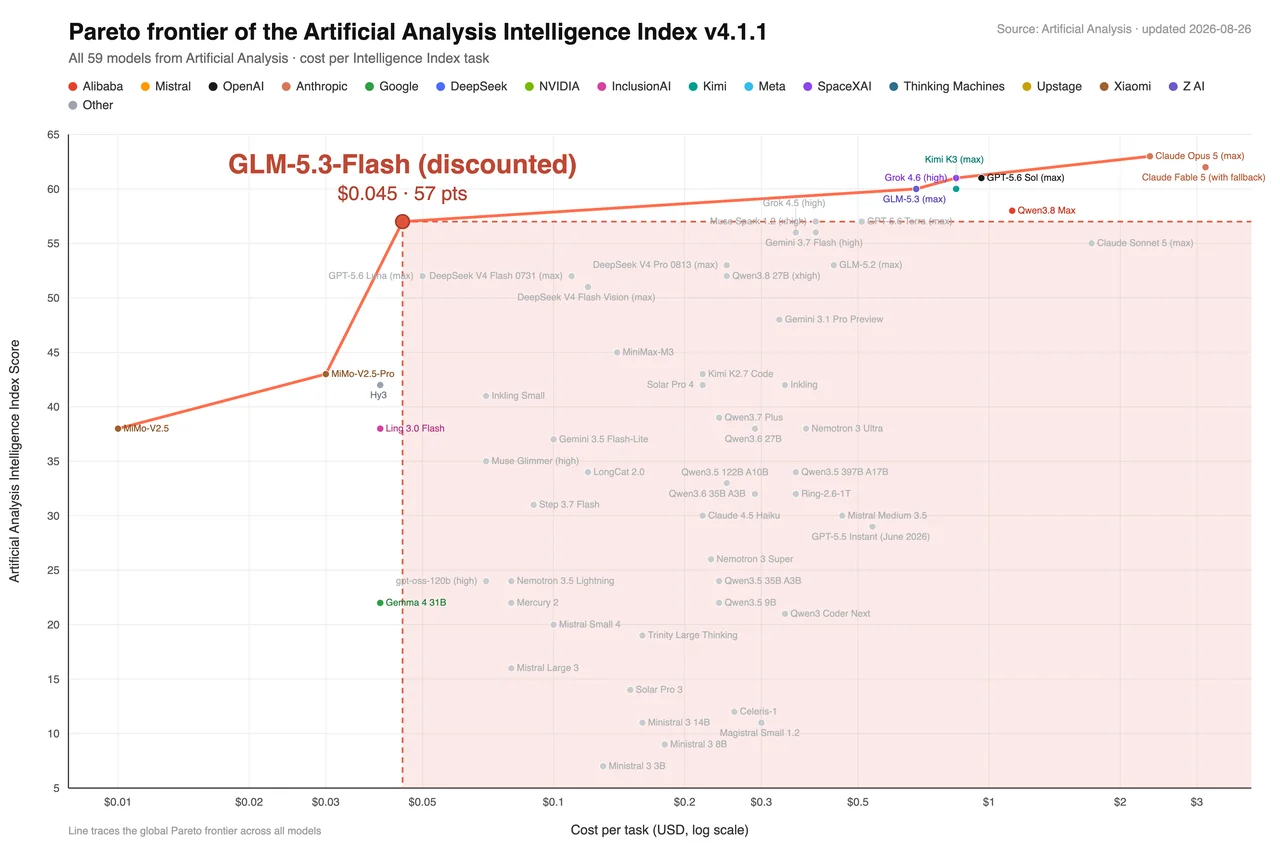
Este es el modelo al que la comunidad dirige una y otra vez a quienes experimentan con Flash Next, y con razón. GLM 5.3 Flash de Z.ai (Zhipu) se lanzó la misma semana, el 26 de agosto de 2026, como el primer modelo GLM-5 nativamente multimodal: 320B en total con 18B activos en un diseño de mezcla de expertos, contexto de 1M de tokens y pesos abiertos en Hugging Face. Bajo el nombre en clave "ox-alpha" estuvo brevemente en el número uno de OpenRouter por volumen de tokens.
Lo crucial: puntúa como un modelo terminado. Artificial Analysis le da un Intelligence Index de 57 por unos $0.045 por tarea, y los primeros probadores fueron claros sobre su valor:
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Ventajas: nivel de producción pese al precio bajo, realmente multimodal, pesos abiertos y un GLM Coding Plan dedicado a $18/$80/$168 al mes si vives en un IDE.
Desventajas: solo piensa, así que no puedes desactivar el razonamiento para ahorrar latencia, y la API propia es lenta (unos 49 tokens/segundo), por lo que los usuarios intensivos pasan por proveedores como Databricks para ganar velocidad.
Precios: promo $0.075 de entrada / $0.25 de salida por 1M (lista $0.15/$0.50), entrada en caché $0.015, con la promoción vigente hasta el 9 de septiembre de 2026.
Veredicto: si quieres la experiencia de Flash Next sin el asterisco de "vista previa", empieza aquí. Es lo más parecido a una mejora directa de esta lista.
2. DeepSeek V4 Flash, el suelo de presupuesto
Ideal para: los obsesionados con el precio que además quieren una licencia permisiva.
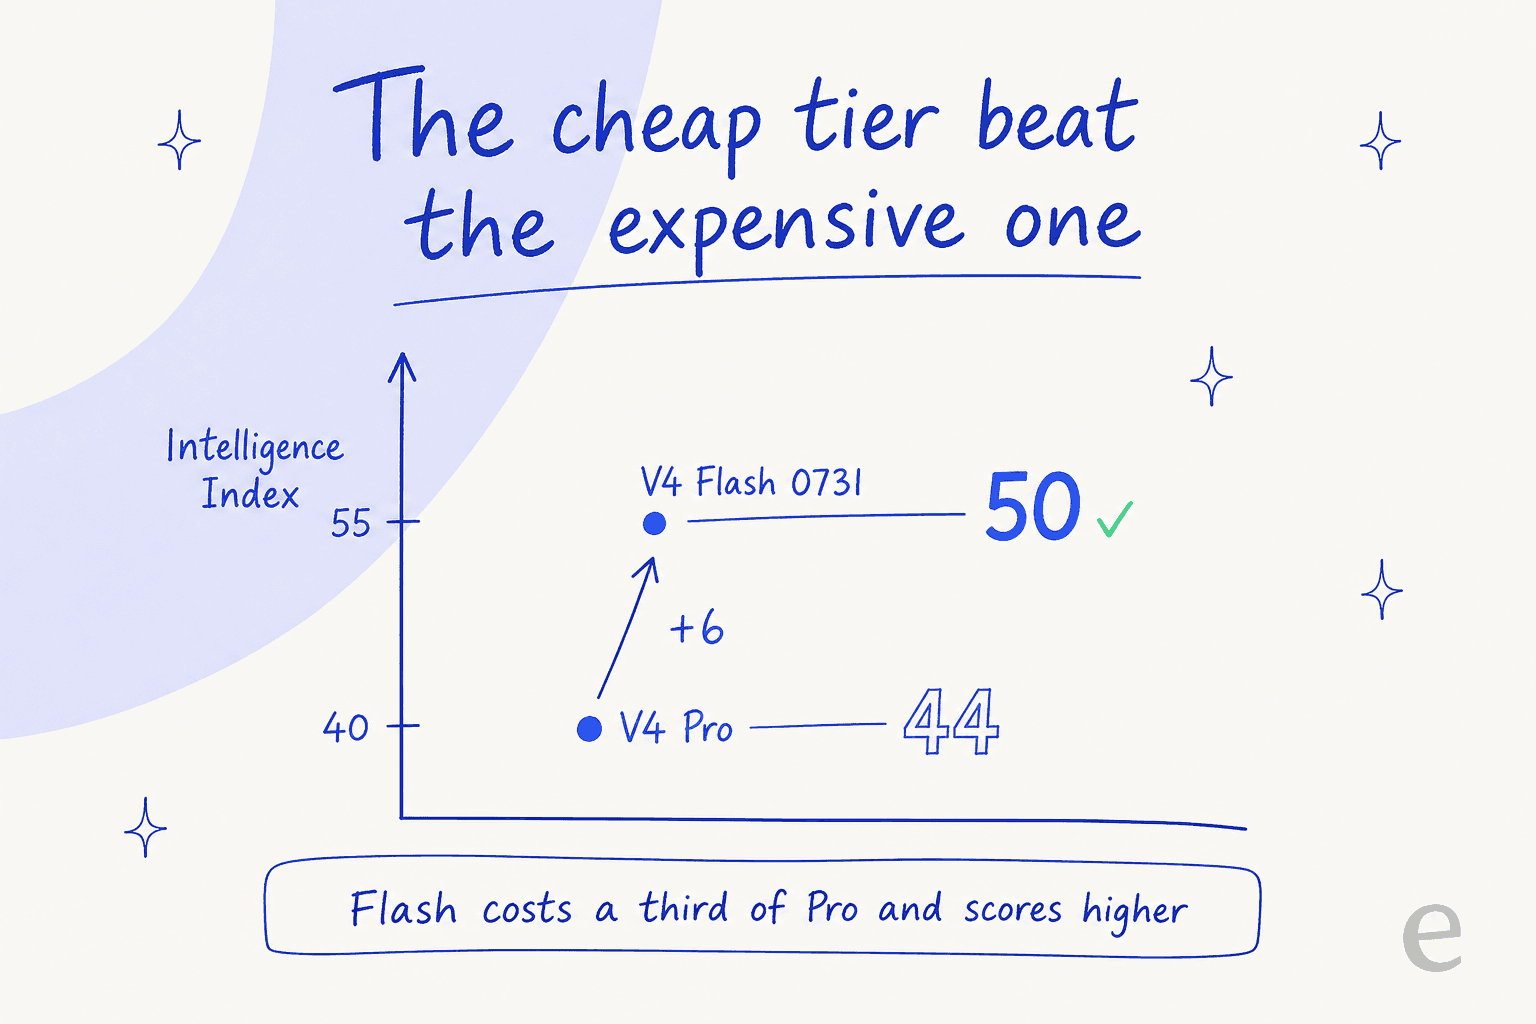
DeepSeek V4 Flash es un MoE de 284B en total y 13B activos con contexto de 1M y, algo inusual en esta clase, pesos abiertos MIT reales (unos 167GB, con decenas de cuantizaciones de la comunidad). El truco que lo hace querido: las pruebas independientes muestran que el nivel Flash, más barato, en realidad supera al más caro V4 Pro en tareas agénticas de largo recorrido, algo que un ingeniero jefe resumió bien:
"DeepSeek V4 Flash is the most cost effective model we've tested... Pro is slower and smarter in one-shot reasoning problems, but less effective with tools and therefore less performant in long horizon agentic tasks."
Hay dos pegas honestas. DeepSeek cambió precios en agosto de 2026 y ahora aplica un recargo de hora punta/valle, con horas punta de 01:00-04:00 y 06:00-10:00 UTC, así que una cola de EE. UU. o la UE factura sobre todo fuera de pico, pero un trabajo por lotes programado en horario comercial chino paga el doble. Y alucina más de lo que te gustaría; un usuario lo dijo sin rodeos:
"DeepSeek V4 hallucinates like crazy and often forgets explicitly mentioned parts of the context."
Ventajas: el menor coste real por token de cualquier modelo alojado aquí, pesos MIT y un buen perfil de uso de herramientas.
Desventajas: verboso (unos 210M de tokens de salida para ejecutar el Index), solo texto (no hay entrada de imagen documentada), y los términos de la API de pago no dicen nada sobre el uso para entrenamiento, así que no es un reemplazo directo para datos de clientes. Para la comparación completa, mira nuestro desglose de DeepSeek vs Kimi K3.
Precios: fuera de pico/pico, entrada sin caché $0.22/$0.44, salida $0.66/$1.32, entrada con acierto de caché desde $0.007.
Veredicto: el rey del valor, siempre que modeles los tokens de salida y mantengas los datos de clientes fuera del endpoint propio.
3. Qwen 3.8 Max, la opción para quedarse en la familia
Ideal para: quienes les gusta el ecosistema Qwen pero necesitan el buque insignia terminado y alojado en lugar de una vista previa.
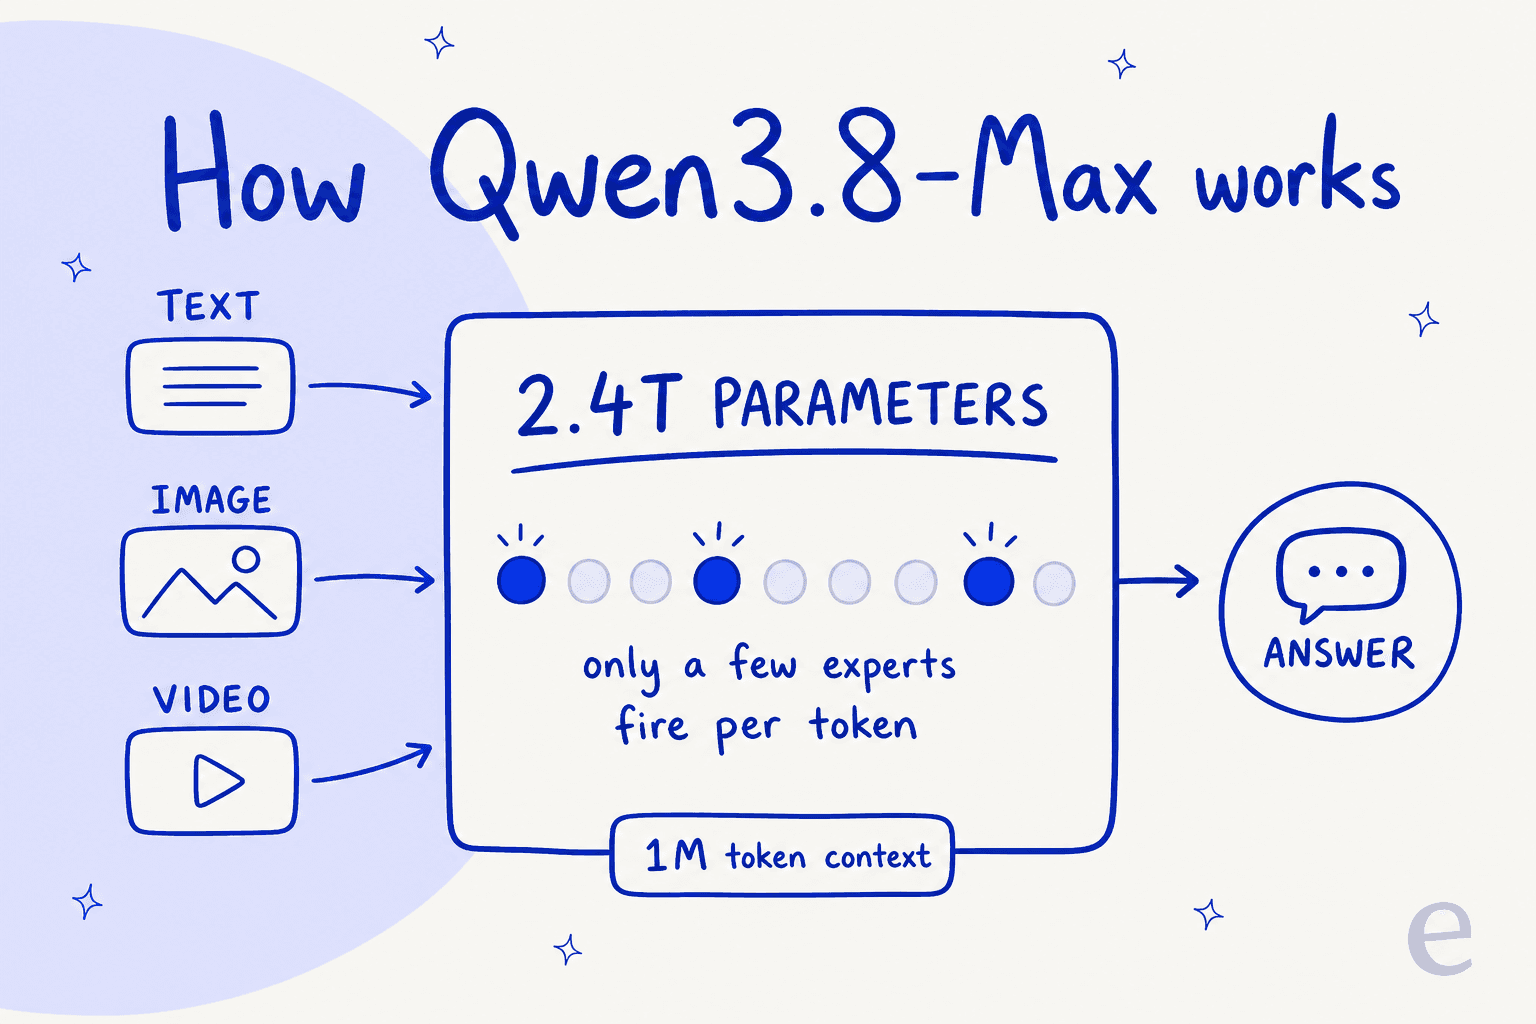
Si Flash Next es la vista previa de investigación, Qwen 3.8 Max es el producto entregado. Salió en disponibilidad general el 2 de agosto de 2026: un MoE de 2.4T en total y 95B activos con contexto de 1M, 131,072 de salida máxima y extras alojados que le faltan a la base abierta (entrada de visión, un modo sin razonamiento y herramientas integradas). Los pesos también se publicaron en agosto, aunque bajo la licencia Qwen y no Apache.
En el ranking independiente se mantiene: Artificial Analysis lo sitúa en el puesto 6 con un Intelligence Index de alrededor de 58 a unos $1.13 por tarea, y en LMArena está entre los cinco primeros en texto y segundo en visión. Si quieres un único número, no lo hagas; el compuesto automatizado y la preferencia humana apuntan en direcciones ligeramente distintas, lo que es un buen recordatorio de no fiarse de un solo benchmark.
Ventajas: estable, alojado, realmente multimodal y te mantiene dentro de herramientas que quizá ya uses con Flash Next.
Desventajas: un orden de magnitud más caro que el nivel Flash, y los pesos abiertos no equivalen en funciones a la versión alojada.
Precios: $2 de entrada / $6 de salida por 1M, con lecturas de caché implícita a $0.25.
Veredicto: la elección sin dramas para los fieles a Qwen que necesitan estabilidad de producción más que el precio mínimo de Flash. Si dudas, nuestra guía de acceso repasa las vías.
4. Kimi K3, la opción agéntica de largo recorrido
Ideal para: ejecuciones de agentes complejas y de varios pasos donde la capacidad importa más que el coste.
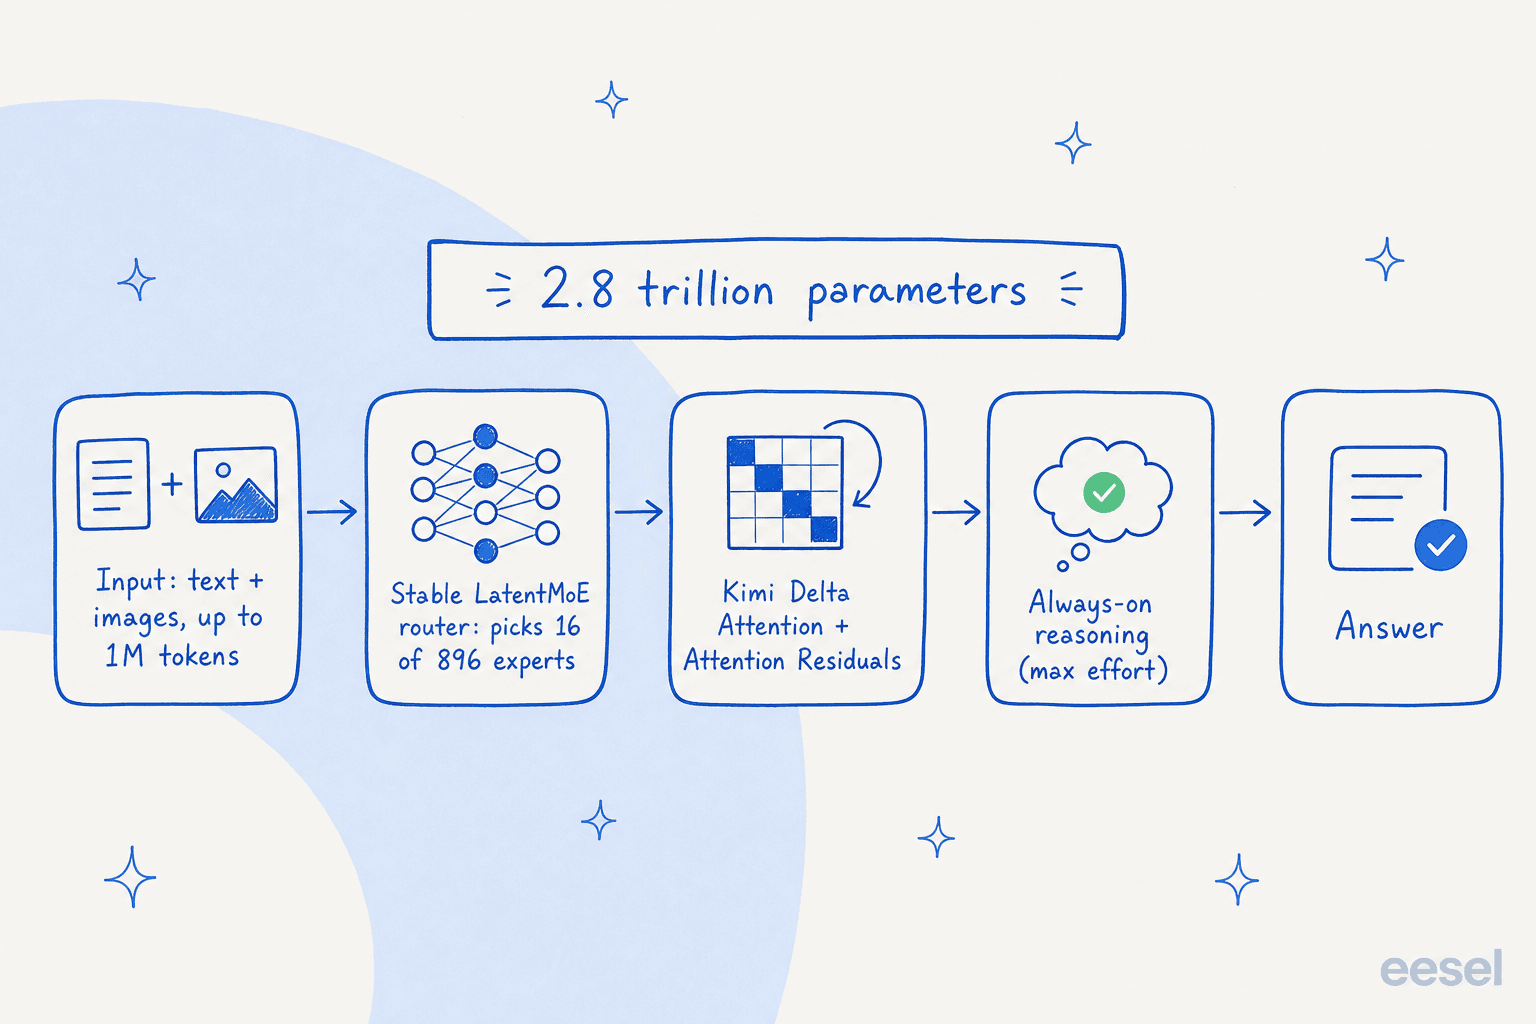
Kimi K3 de Moonshot es el peso pesado de esta lista: 2.8T de parámetros en total con 104B activos, contexto de 1M, visión nativa y pesos abiertos que llegaron a tiempo el 27 de julio de 2026. Su Intelligence Index de Artificial Analysis de 57 lo pone cuarto en general, y es un modelo agéntico y de programación realmente fuerte.
El problema es el precio. K3 cuesta $3 de entrada / $15 de salida por 1M, la misma banda que un modelo cerrado de frontera y aproximadamente 50x la tarifa de salida de DeepSeek V4 Flash. Además, el razonamiento no se puede desactivar, así que incluso una llamada simple paga el impuesto de pensar; el nivel de esfuerzo más bajo puntúa peor y cuesta más por tarea que DeepSeek. No es una alternativa económica a Flash Next; es una alternativa de capacidad.
Ventajas: rendimiento agéntico de primer nivel, un contexto enorme, pesos abiertos y visión nativa.
Desventajas: precios de modelo de frontera, razonamiento siempre activo, y la API de visión rechaza URL públicas de imágenes (solo base64 o un ID de archivo).
Precios: $3 de entrada / $15 de salida por 1M, entrada con acierto de caché $0.30.
Veredicto: recurre a K3 cuando la tarea sea lo bastante difícil para justificar la factura. Para el trabajo cotidiano barato y rápido, es la herramienta equivocada.
5. Gemini 3.7 Flash, la opción multimodal gestionada
Ideal para: equipos que quieren la fiabilidad de un gran proveedor, buena entrada multimodal y nada de autoalojamiento.
Si todo el asunto del autoalojamiento te parece un pasatiempo para el que no tienes tiempo, Gemini 3.7 Flash es la respuesta gestionada. Salió en disponibilidad general el 13 de agosto de 2026 y es el modelo más rápido que Artificial Analysis ha medido, con 340 tokens/segundo (puesto #1 de 188). Lo que conviene saber al comprar: el nivel de esfuerzo de razonamiento que elijas altera mucho coste y calidad. En low puntúa 50.9 en el Index a $0.16 por tarea; en high llega a 56.0 pero salta a $0.40. Dejar el valor por defecto medium suele ser pagar de más.
Dos salvedades lo mantienen honesto. Google eliminó el nivel de pensamiento minimal que hacía de los Flash anteriores el suelo más barato para OCR y clasificación. Y la tasa de alucinación empeoró hasta el 64.5% desde el 55.6% de 3.6 Flash, incluso cuando la precisión mejoró, justo el tipo de cosa que quieres detectar antes de lanzar.
Ventajas: gestionado y fiable, el mayor rendimiento de su clase, buenas puntuaciones de contexto largo y uso del ordenador, y un precio promocional que hoy iguala al de 3.6 Flash.
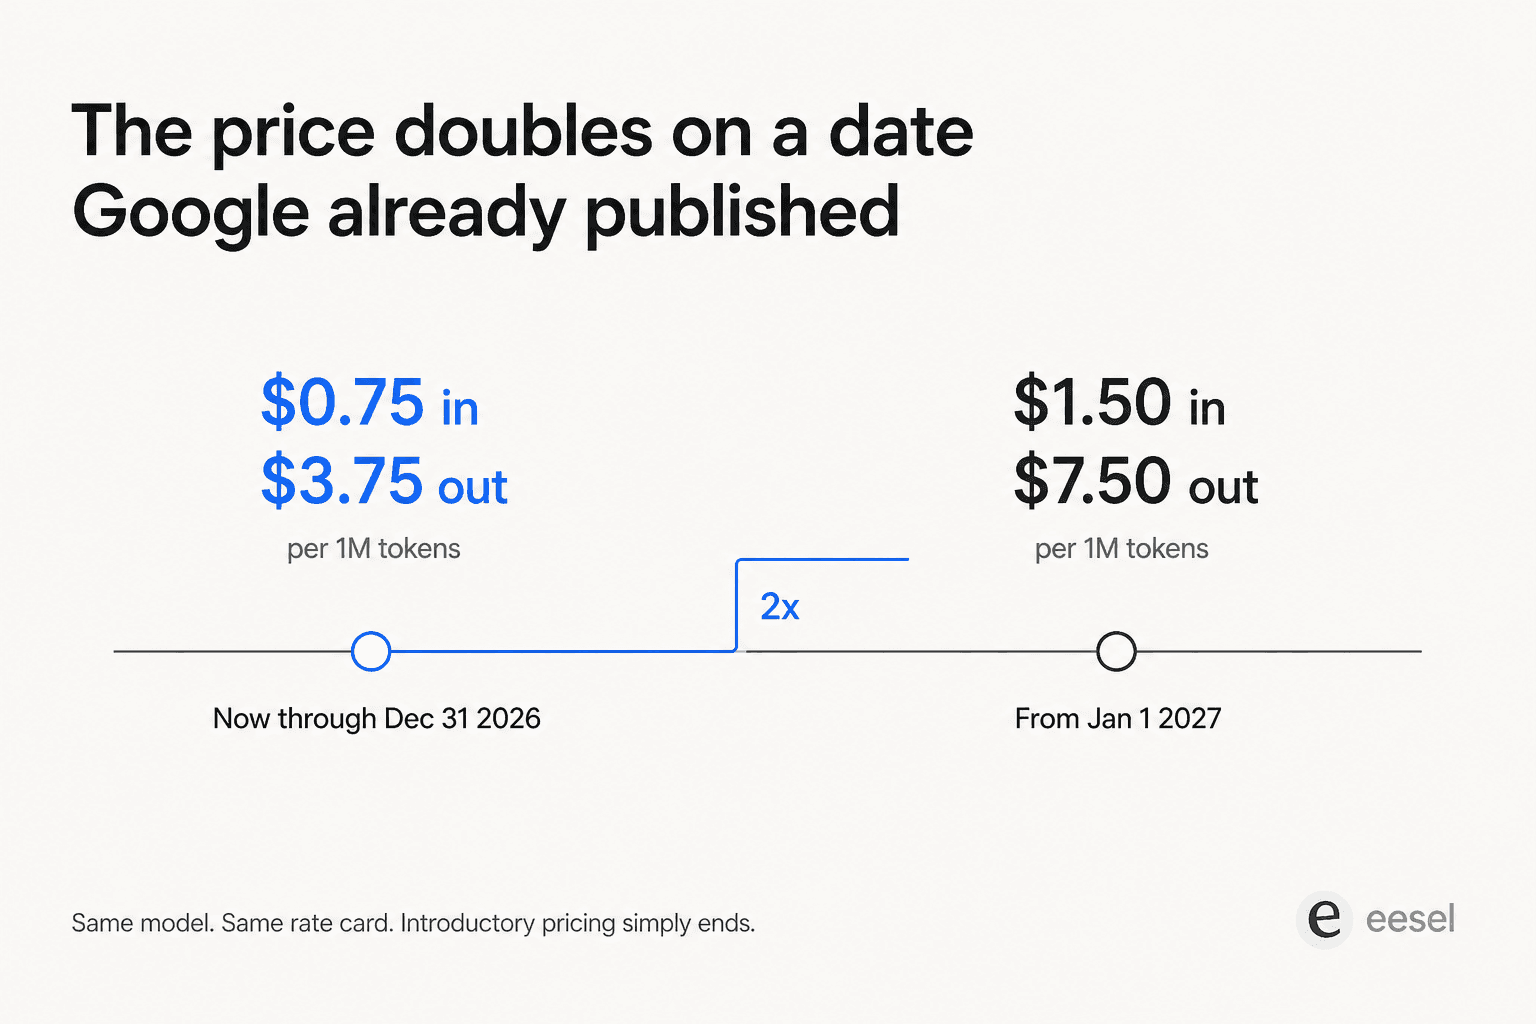
Desventajas: pesos cerrados, una tasa de alucinación mayor que su predecesor y un precio que se duplica en enero de 2027.
Precios: $0.75 de entrada / $3.75 de salida por 1M como precio introductorio hasta el 31 de diciembre de 2026, y después $1.50 / $7.50.
Veredicto: la elección cuando prefieres pagar a una plataforma antes que cuidar una GPU. Solo no dejes el mando de esfuerzo en el valor por defecto.
6. GPT-5.6 Luna, la opción de fiabilidad de ecosistema cerrado
Ideal para: equipos ya estandarizados en OpenAI que quieren un nivel barato sin salir del stack.
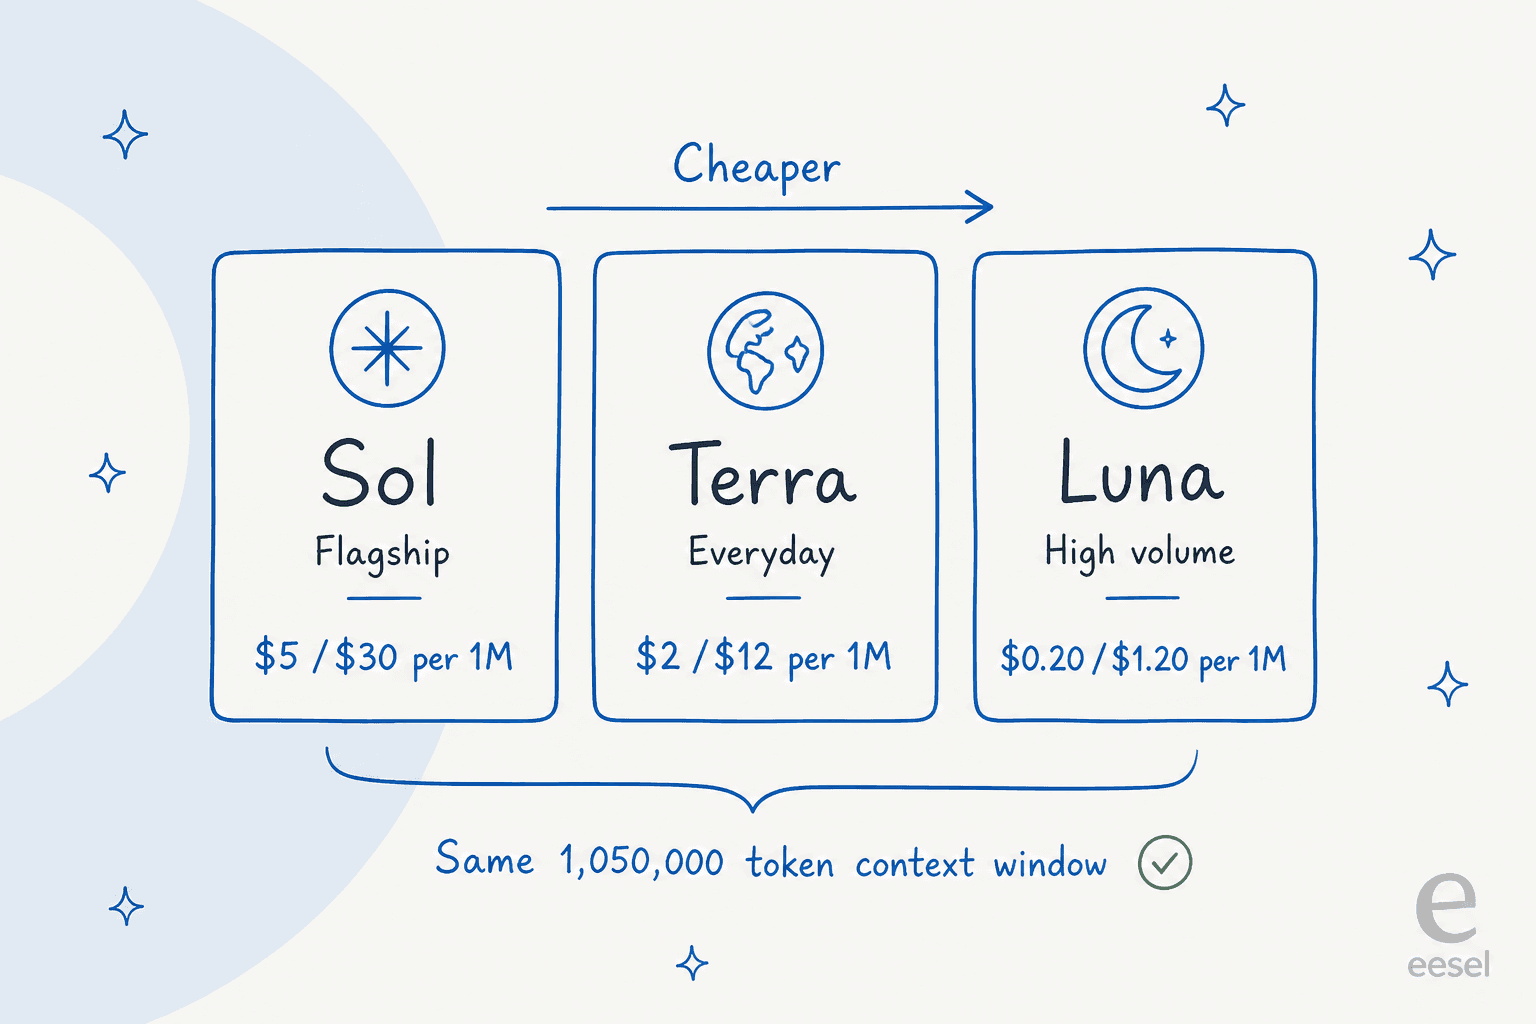
Luna es el peldaño económico de la escalera GPT-5.6 (los otros dos son Terra y el buque insignia Sol). A $0.20 de entrada / $1.20 de salida por 1M es competitivo en precio con los modelos chinos de pesos abiertos, a la vez que te da las herramientas, SDK y fiabilidad de OpenAI. Para un equipo cuya infraestructura ya da por hecha la API de OpenAI, ese coste de cambio ahorrado es real.
La contrapartida es la que lleva cada modelo cerrado aquí: sin pesos, sin autoalojamiento, y OpenAI cobra un nivel de contexto largo que duplica la tarifa pasada la ventana de contexto corto (Luna sube a $0.40/$1.80). Anthropic y Google no cobran ese escalón, así que conviene comprobar si tus longitudes de contexto cruzan la línea.
Ventajas: un proveedor de confianza, un ecosistema maduro y un nivel de entrada realmente barato.
Desventajas: pesos cerrados, un recargo 2x por contexto largo y menos apertura que los modelos con los que compite en precio.
Precios: $0.20 de entrada / $1.20 de salida por 1M en contexto corto; $0.40 / $1.80 en contexto largo; entrada en caché $0.02.
Veredicto: la opción barata sensata si ya eres una empresa OpenAI y valoras el ecosistema por encima de los pesos abiertos.
7. IBM Granite 4.2, la opción empresarial / on-prem
Ideal para: empresas que necesitan licencias permisivas, hardware convencional y llamadas a herramientas fundamentadas.
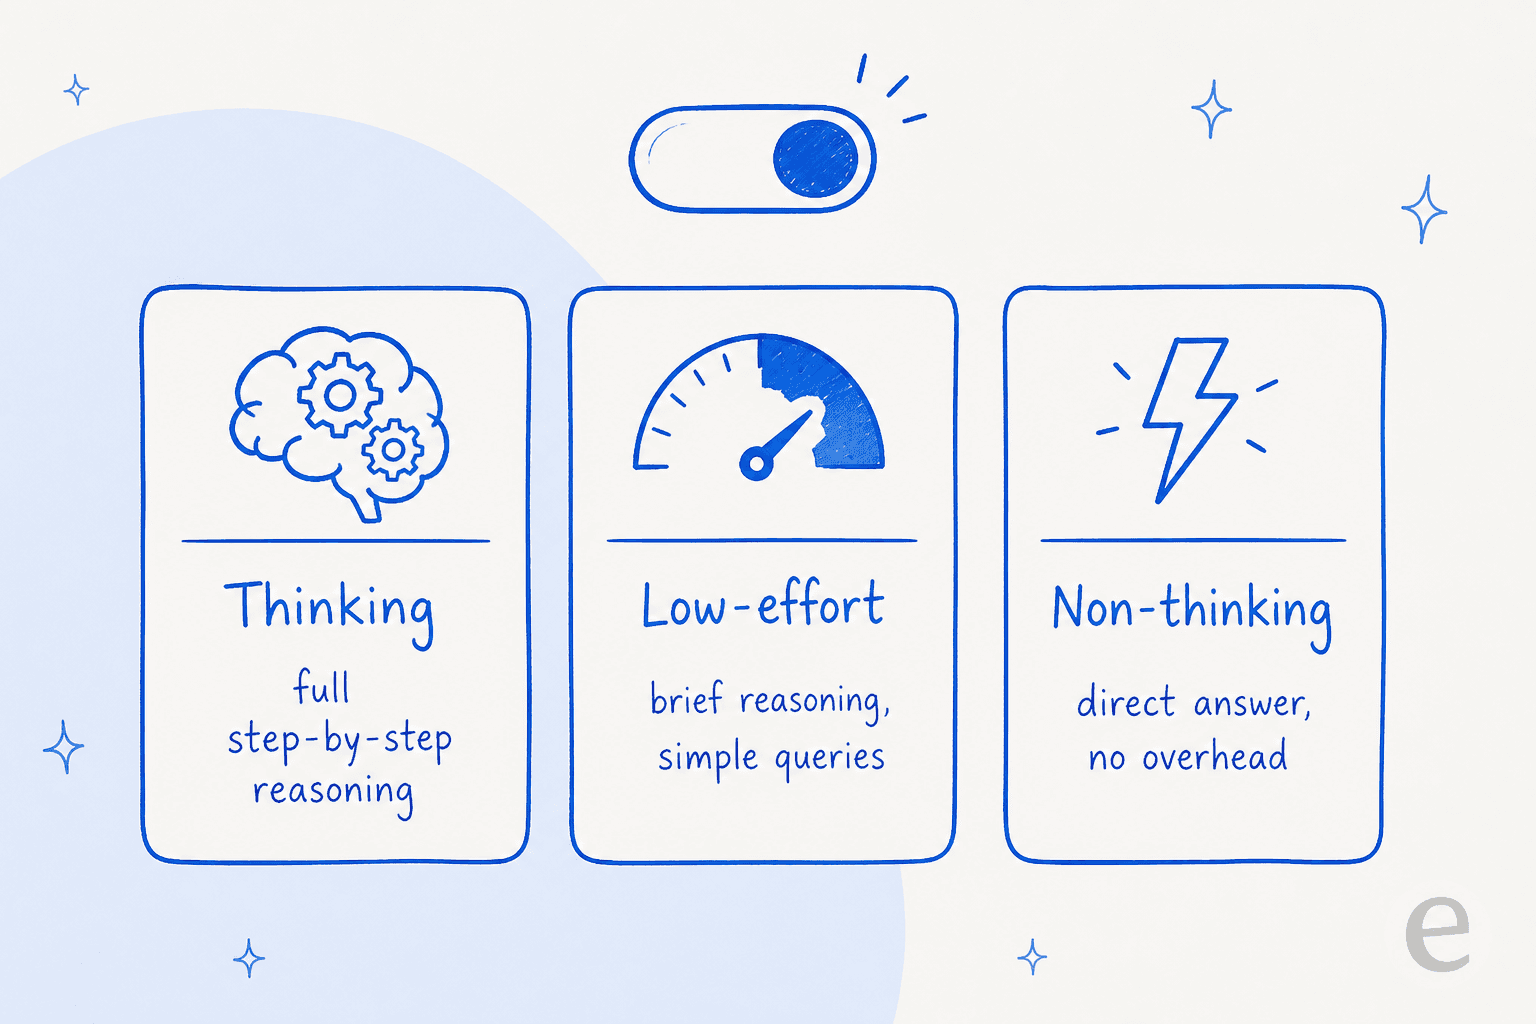
Granite 4.2 es el modelo que tus equipos legales y de seguridad realmente aprobarán. IBM lo lanzó el 25 de agosto de 2026 como tres modelos densos Apache 2.0 (3B, 8B y un buque insignia de 30B) con contexto de 128K y, a diferencia de Flash Next, razonamiento conmutable: pensamiento completo, esfuerzo bajo o desactivado del todo. Está ajustado para extracción fundamentada y llamadas a herramientas más que para ganar benchmarks, y a los probadores les gusta su practicidad:
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly ... Granite has recent training data which is nice."
Sé claro sobre lo que no es. No lidera las tablas de programación en bruto, y la misma comunidad lo dice directamente: "Qwen still wins on raw capability, especially for coding." También hay una rareza de memoria: la descarga de 5.3GB del modelo 8B se infla hasta unos 27GB cuando se carga la caché KV, así que dimensiona tu GPU en consecuencia.
Ventajas: Apache 2.0 de verdad (no solo "pesos disponibles"), razonamiento conmutable, datos de entrenamiento recientes y funciona rápido en hardware modesto.
Desventajas: queda por detrás de Qwen en programación en bruto, los benchmarks de IBM comparan sobre todo con Granite anteriores en lugar de con los líderes chinos, y el aumento de memoria al cargar sorprende a la gente.
Precios: autoalojado gratis (8B es una descarga de 5.3GB); el alojado confirmado más barato es el 8B de Replicate a $0.06 de entrada / $0.25 de salida por 1M.
Veredicto: la opción segura para empresas. Si la licencia y el control on-prem pesan más que los últimos puntos de benchmark, Granite es difícil de superar.
8. LongCat 2.0, el comodín MoE MIT de gran tamaño
Ideal para: los aventureros que quieren un MoE muy grande con licencia MIT y pueden aguantar las herramientas.
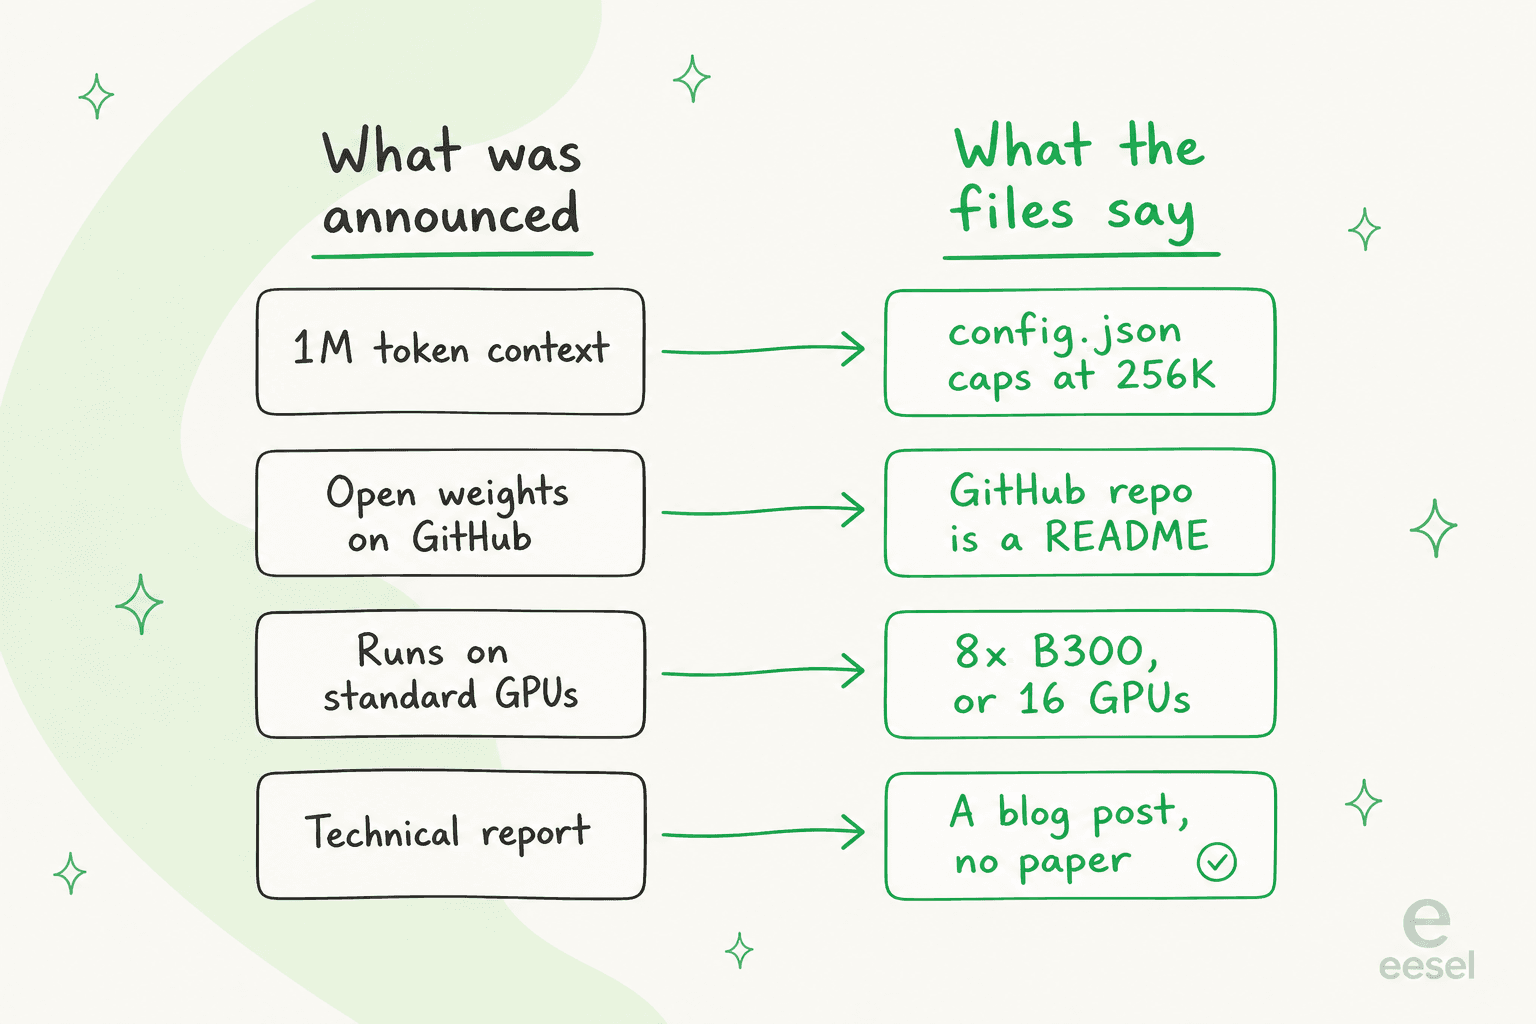
LongCat 2.0 de Meituan es el primo arquitectónico de la familia DeepSeek: un MoE de 1.6T con unos 48B activos por token, pesos MIT sin adornos y precios promocionales que bajan los de la mayoría de esta lista. Es realmente capaz, con un SWE-bench Pro autoevaluado de 59.5 que supera por poco a GPT-5.5.
Pero viene con más asteriscos que cualquier otro aquí, y todos son comprobables. El "contexto de 1M" anunciado es una afirmación de entrenamiento; la configuración publicada limita las posiciones a 256K. El repositorio de GitHub solo tiene README y no hay paper, SGLang es el único motor, y el autoalojamiento requiere realmente 8x GPU B300, ya que no hay GGUF para Ollama ni LM Studio. El pago fuera de China continental se hace con Alipay o WeChat Pay, no con tarjeta. Y para soporte en concreto, las FAQ de la plataforma no dicen nada sobre retención de datos y entrenamiento, que es el verdadero bloqueo, no el precio.
Ventajas: realmente grande y capaz, licencia MIT limpia y precios promocionales agresivos.
Desventajas: herramientas escasas, un contexto real de 256K (no de 1M), una huella de autoalojamiento brutal, pago incómodo y ningún compromiso sobre el tratamiento de datos.
Precios: promo $0.30 de entrada / $1.20 de salida por 1M (lista $0.75/$2.95), sin niveles por longitud de contexto.
Veredicto: un comodín fascinante para investigadores, pero las lagunas de herramientas y de datos lo hacen el más difícil de llevar a producción de esta lista.
¿Qué alternativa deberías elegir?
Si las contrastas con las dos cosas que realmente te alejaron de Flash Next, "¿está terminado?" y "¿quiero ejecutarlo yo mismo?", la lista se ordena sola rápidamente.
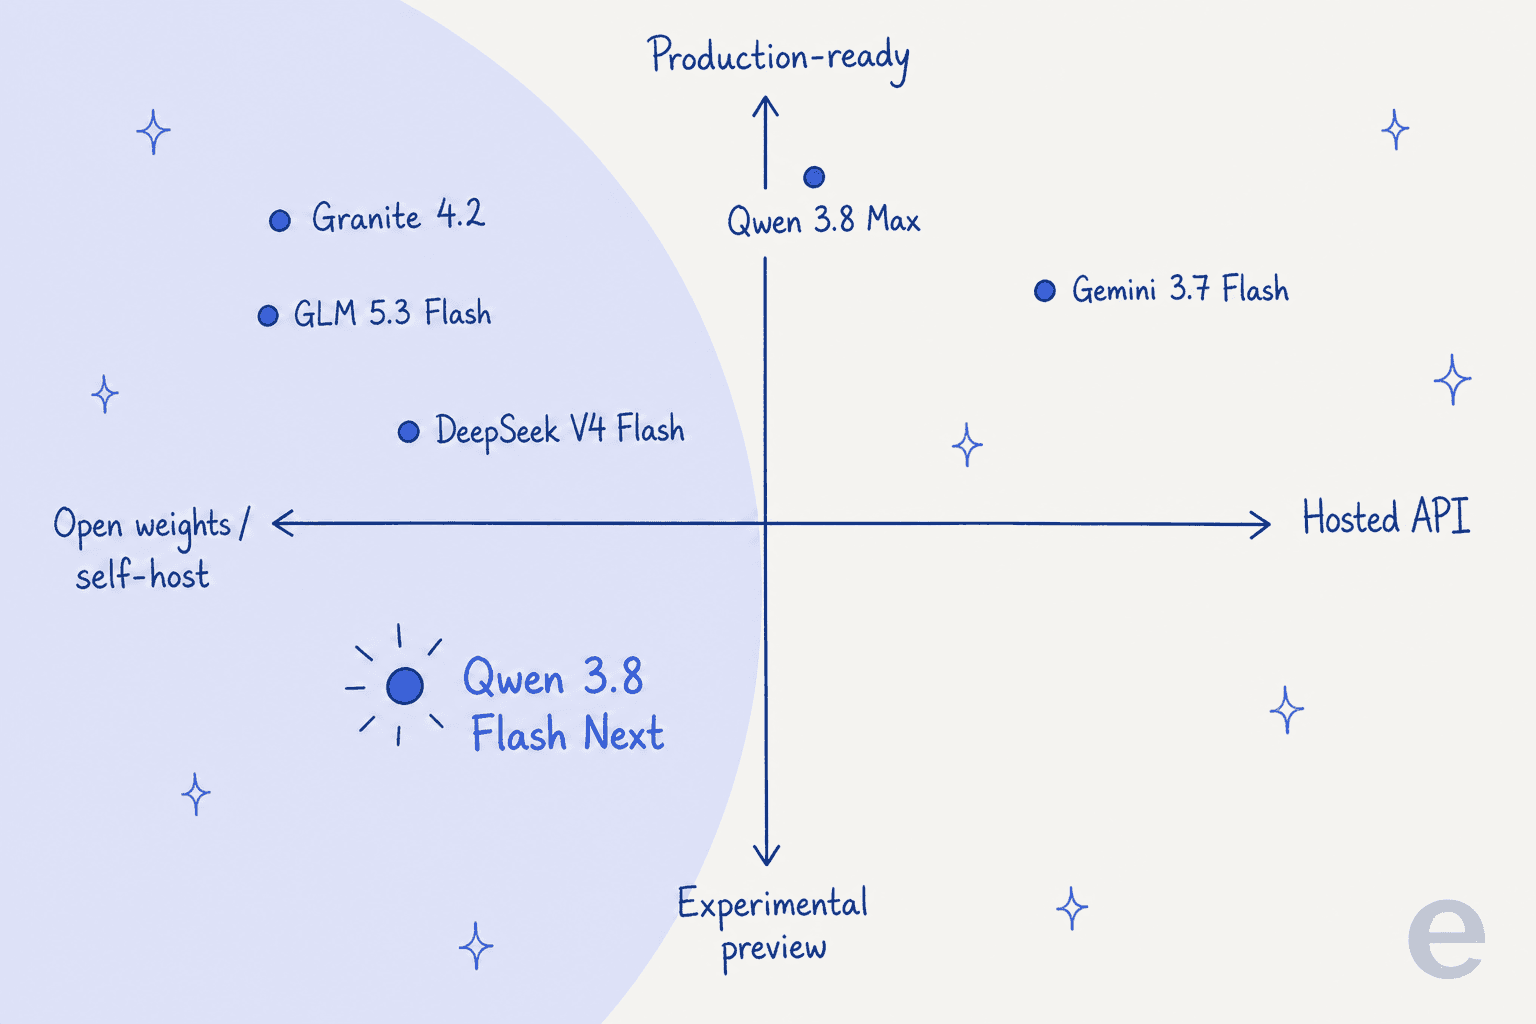
Decisiones rápidas:
- ¿Quieres lo mismo, pero terminado? GLM 5.3 Flash.
- ¿Quieres la factura real más barata? DeepSeek V4 Flash, o Granite 4.2 autoalojado.
- ¿Quieres seguir en el mundo Qwen, pero estable? Qwen 3.8 Max.
- ¿No quieres tocar una GPU? Gemini 3.7 Flash o GPT-5.6 Luna.
- ¿Necesitas licencias empresariales y on-prem? Granite 4.2.
El patrón detrás de todo esto
Esto es lo que sigo teniendo que decir a los equipos que llegan a un artículo como este. Cada modelo de arriba es un componente. Un modelo en bruto recibe tokens y devuelve tokens. No conoce tu política de reembolsos, no puede leer el historial de pedidos de un cliente, no redactará una respuesta dentro de tu helpdesk y no sabe si su respuesta segura es correcta. El modelo es infraestructura; lo que hace el trabajo es el empleado.
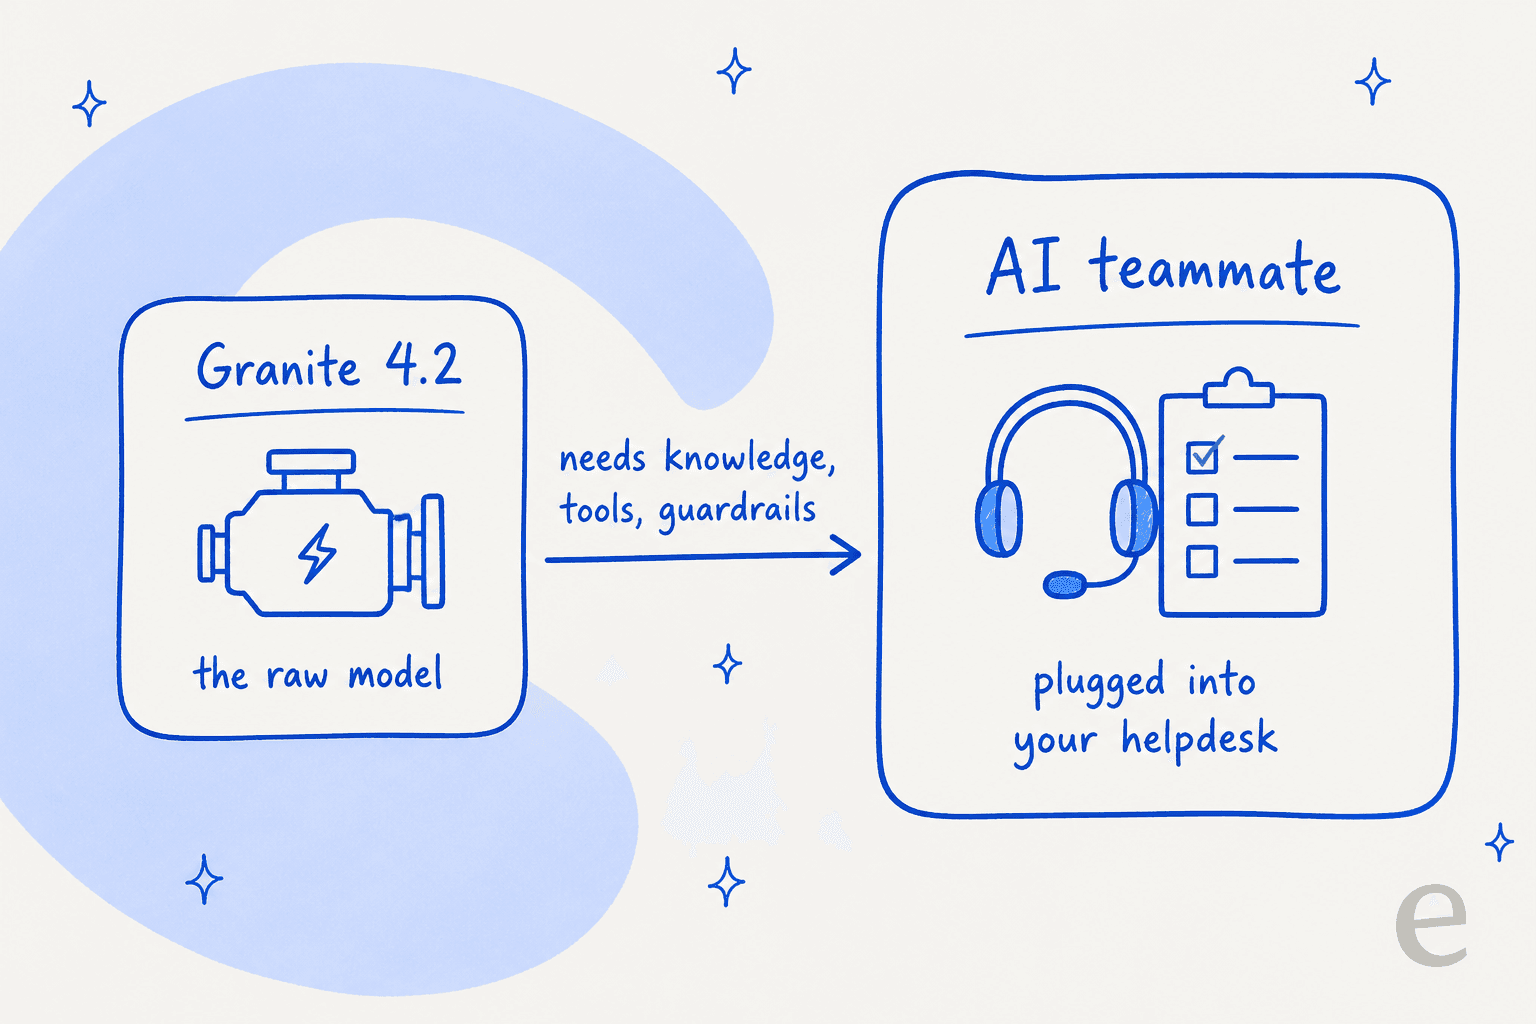
Por eso "¿qué modelo barato debería usar para soporte?" es la primera pregunta equivocada. Elegir el modelo es el 10% fácil. El 90% que decide si los tickets se resuelven de verdad es la capa que lo rodea: recuperación sobre tu base de conocimiento, acciones dentro de tu helpdesk, salvaguardas y pruebas con historial real antes de que nada llegue a un cliente. Eso es cierto ya sea que el modelo subyacente sea Flash Next, GLM 5.3 Flash o un empleado de IA que construyas internamente.
Prueba eesel
Si llegaste aquí sopesando un modelo barato para una carga de soporte, el consejo honesto es dejar de buscar un modelo y empezar a probar con tus propios tickets. Esa capa de empleado es lo que construyo en eesel: una plataforma de compañeros de IA donde contratas compañeros listos para trabajar para tareas concretas, actualmente un compañero de IA para helpdesk y un redactor de blog de IA. Cada uno llega con las habilidades, integraciones y contexto de empresa para su rol, de modo que el modelo que corre por debajo pasa a ser un detalle de implementación y no tu problema.

La parte que señalaría con más fuerza son las pruebas, porque un modelo en vista previa recién salido como Flash Next es justo el tipo de cosa que quieres detrás de una puerta. El compañero de helpdesk de eesel simula cada despliegue con tus tickets históricos antes de tocar a un cliente real, para que veas la tasa de resolución y las respuestas exactas que habría enviado en conversaciones pasadas reales, y luego decidas qué automatizar. Elige el modelo que gane tu benchmark; solo demuéstralo primero con tus propios tickets. Es gratis para probar.