

Qwen 3.8 Flash Next es la vista previa open-weight del equipo Qwen de su arquitectura Qwen4 de nueva generación, lanzada el 26 de agosto de 2026. El nombre confunde a la gente, así que empecemos por aquí: Flash Next es la vista previa de investigación con pesos abiertos que alojas tú mismo; Qwen3.8-Flash es la próxima API alojada con una ventana de contexto de 1M y herramientas integradas. Son dos caras del mismo modelo.
Las especificaciones son la historia. Es un modelo de mezcla de expertos de 125B que activa solo 6B parámetros por token, acoplado a una tabla de búsqueda de N-gramas de 51B que puedes descargar a la RAM normal del sistema. Ese diseño explica por qué corre rápido en hardware que nunca podría alojar un modelo denso de ese tamaño, y por qué la versión alojada cuesta solo $0.15 de entrada / $0.47 de salida por millón de tokens.
Las pruebas independientes respaldan el entusiasmo hasta cierto punto: Artificial Analysis lo sitúa entre los primeros modelos en inteligencia para su precio. La pega, repetida en todos los hilos de la comunidad, es que es una vista previa de I+D deliberadamente infraentrenada, no un modelo de producción terminado. GLM 5.3 Flash es el rival más pulido si necesitas algo estable hoy.
Si estás aquí porque quieres IA barata para atención al cliente, elegir el modelo es la parte fácil. Un modelo en bruto no lee tus tickets, no redacta respuestas ni escala casos. Eso es trabajo de una plataforma, y es exactamente lo que hace eesel sobre modelos como este.
Qué es realmente Qwen 3.8 Flash Next
Construyo agentes de IA en eesel, lo que significa que veo cómo la capa de modelos se agita cada pocas semanas y he aprendido a leer más allá de los gráficos de lanzamiento. Así que cuando el equipo Qwen publicó Qwen 3.8 Flash Next el 26 de agosto de 2026, lo primero que hice fue desenredar el nombre, porque es genuinamente confuso.
Esta es la versión clara. "Flash" es el nivel barato y rápido de Qwen. "Next" no es un Flash más grande ni más nuevo. Es la etiqueta que Qwen pone a una vista previa de arquitectura, el mismo papel que tuvo Qwen3-Next antes de Qwen3.5. Flash Next existe para que la comunidad pueda trastear con la nueva fontanería antes de construir sobre ella toda la familia Qwen4.
La división práctica importa porque cambia lo que puedes hacer con él:
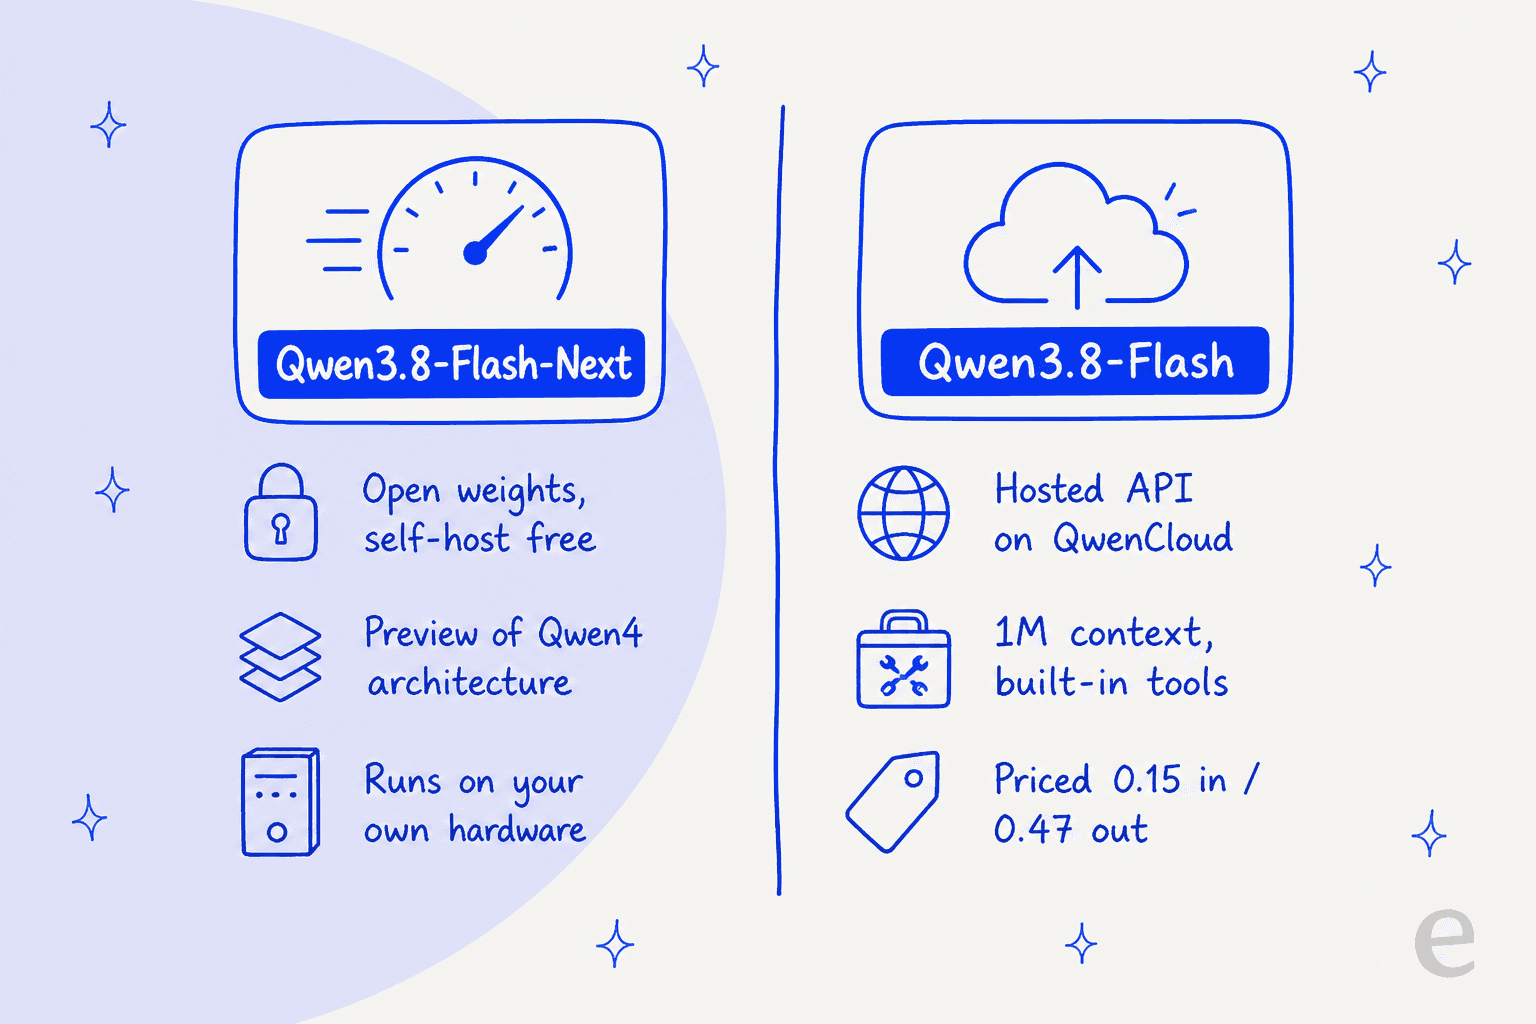
- Qwen3.8-Flash-Next es la versión con pesos abiertos en Hugging Face y ModelScope, bajo la Qwen Community License 1.0. Lo descargas y lo ejecutas tú mismo.
- Qwen3.8-Flash es la versión de producción servida en QwenCloud, con 1M de contexto por defecto y herramientas integradas oficiales. Esa es la que consultas por API.
Esto ya es un cambio real respecto a Qwen 3.7 Flash, que salió cerrado, sin pesos y sin ningún benchmark. Esta vez obtienes pesos abiertos y una tabla detallada de benchmarks desde el primer día. Es un modelo de razonamiento multimodal: recibe texto, imágenes y vídeo, produce texto, y el modo de pensamiento viene activado por defecto.
La arquitectura que se gana el "Next"
Esta es la parte que de verdad me importa, porque la arquitectura es la razón por la que el precio puede ser el que es. Flash Next extiende el diseño híbrido de Qwen3-Next a lo largo de cuatro ejes, y cada uno es una apuesta por cambiar memoria por cómputo.
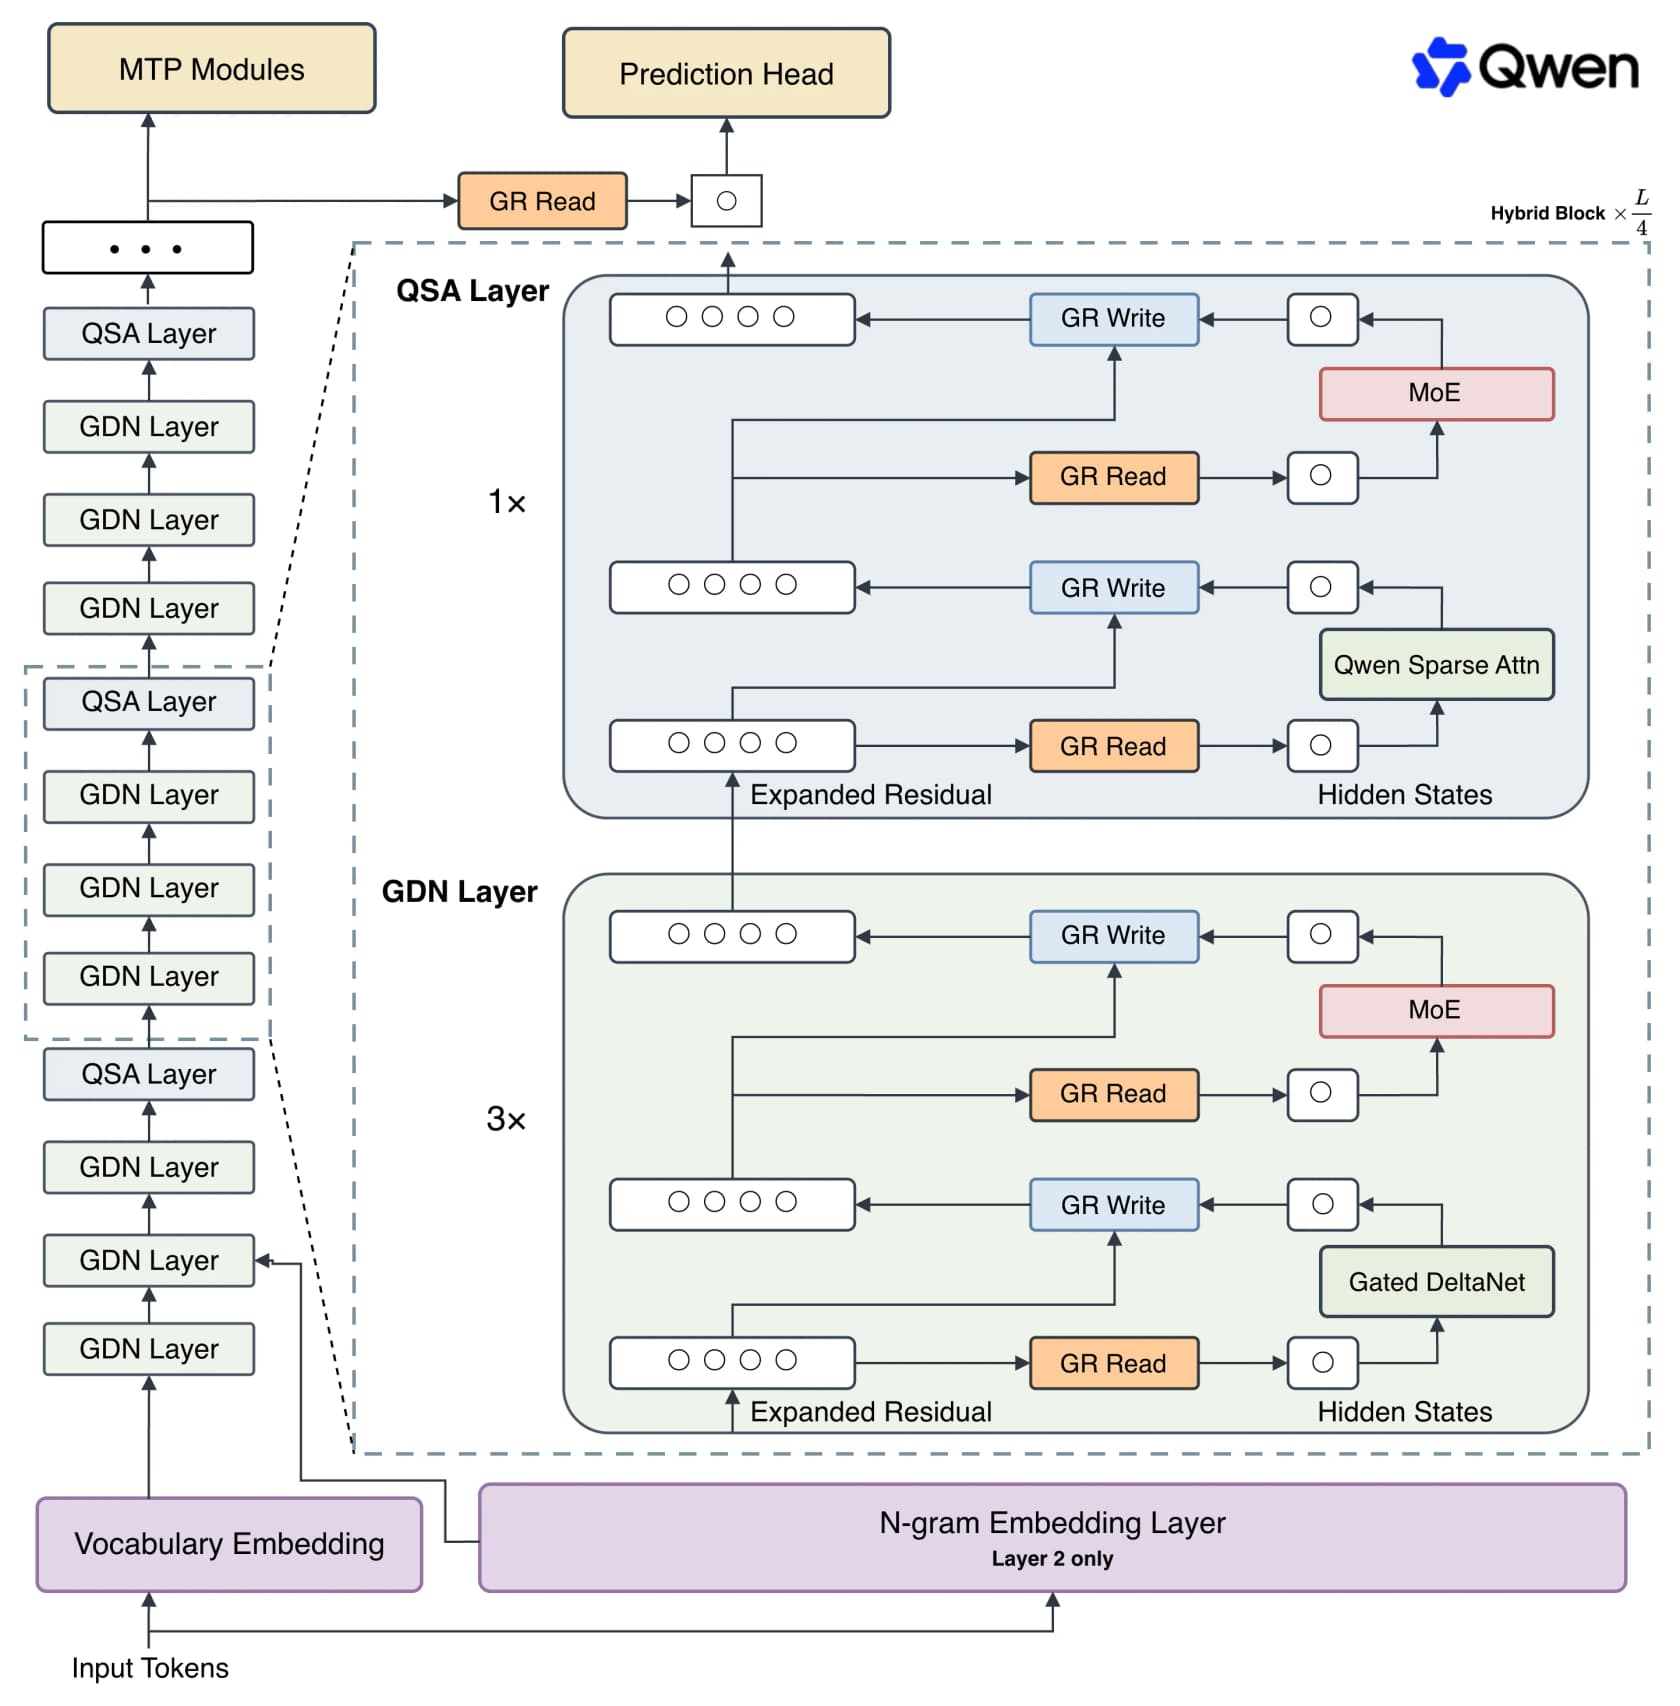
Atención: un híbrido de GDN y QSA. Tres de cada cuatro capas usan Gated DeltaNet para comprimir el historial en un estado de tamaño fijo, algo mucho más barato que almacenar una caché completa de clave-valor. La cuarta capa usa atención global, pero se sustituye por Qwen Sparse Attention, que elige el contexto importante con granularidad de microbloque en lugar de token por token.
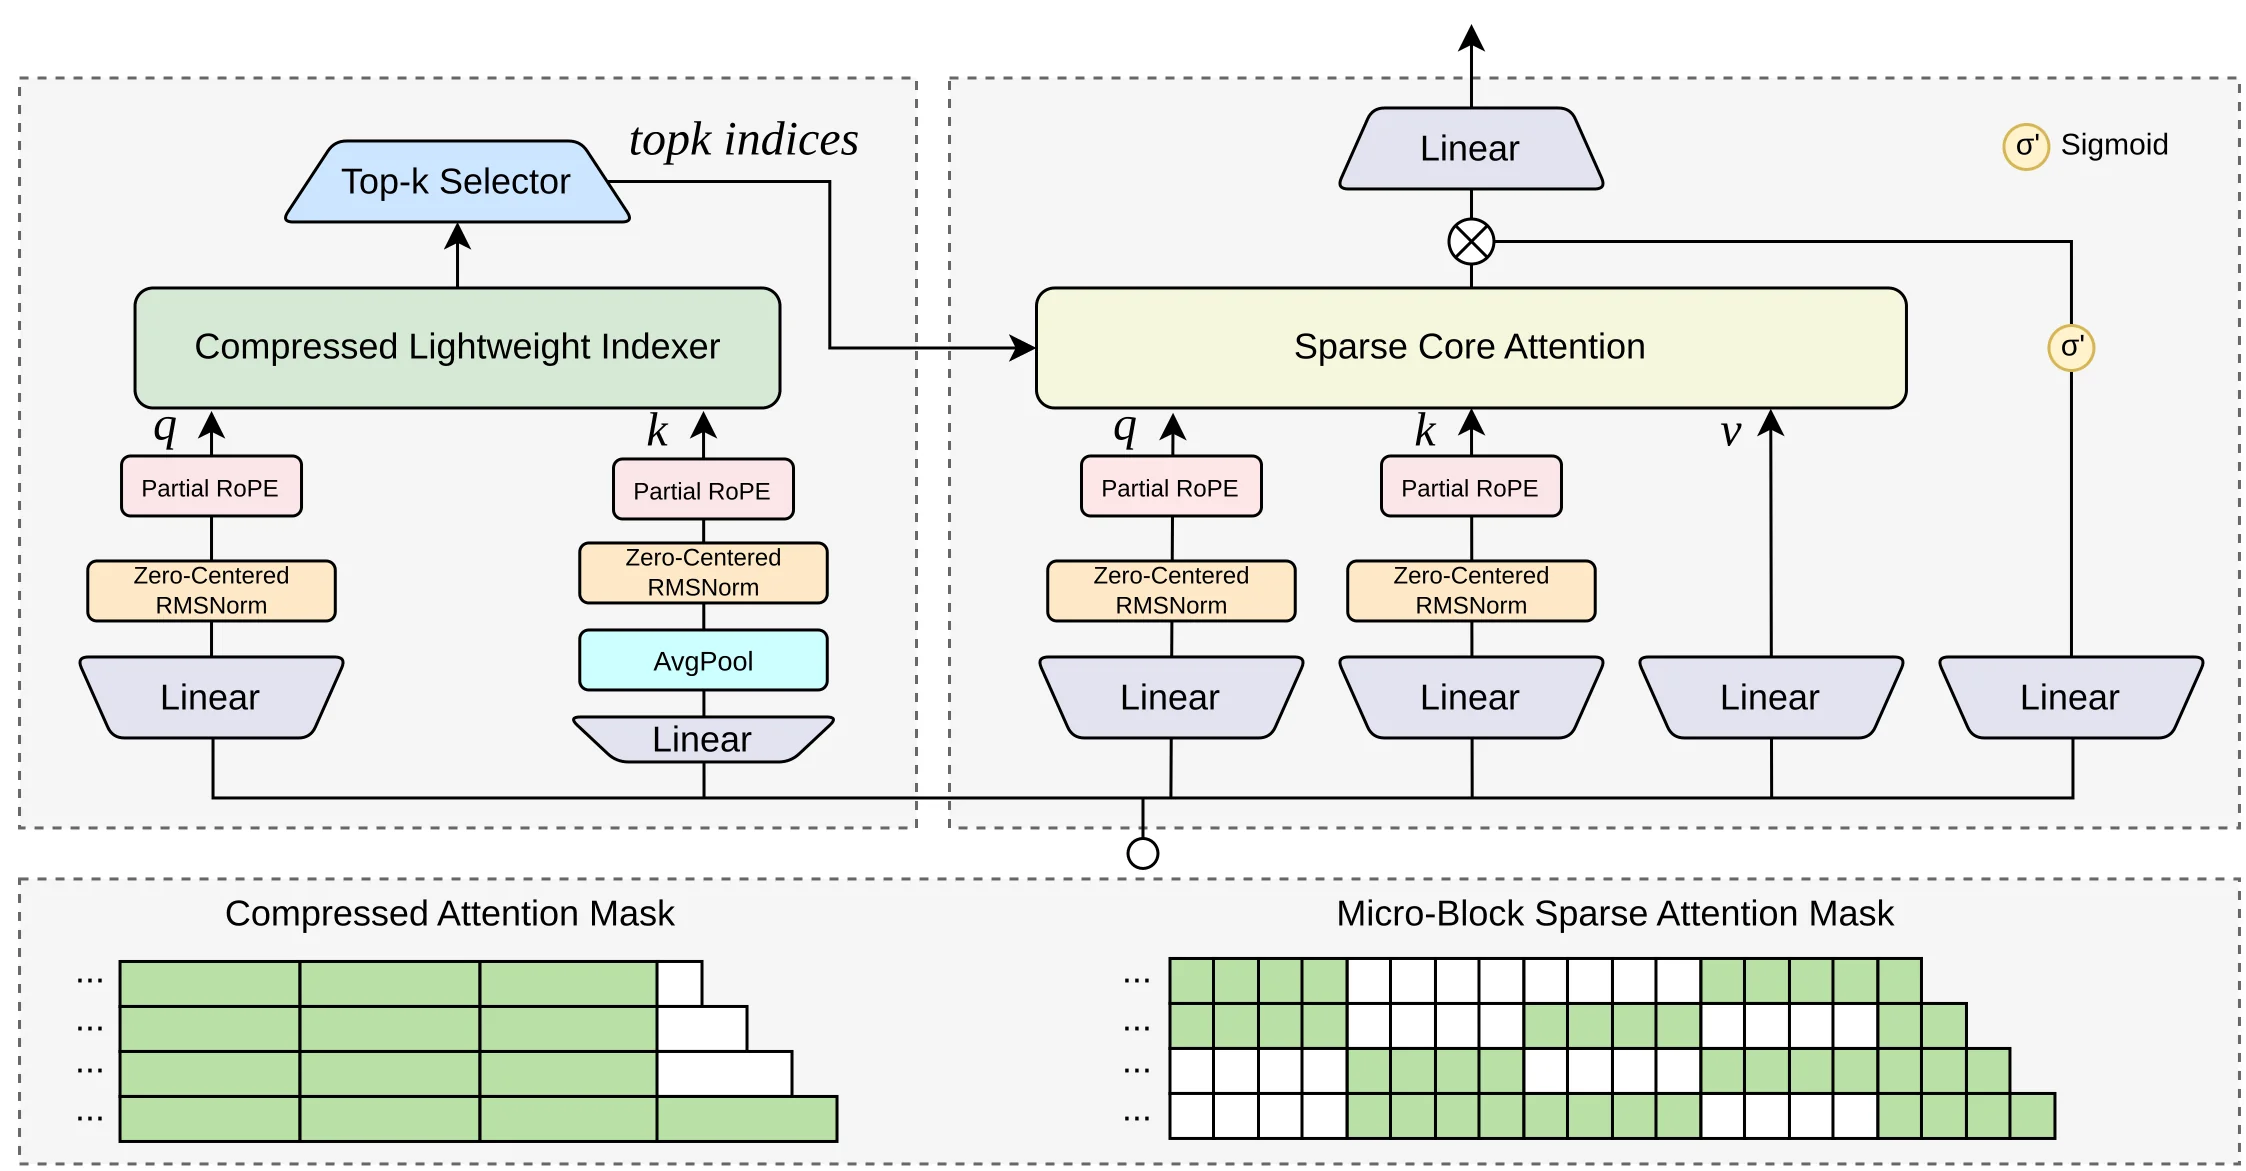
Embedding: una tabla de N-gramas de 51B. Esta es la parte ingeniosa. Qwen añade 51 mil millones de parámetros de búsquedas de bigramas y trigramas basadas en contexto que se pueden descargar a la memoria del host y precargar de forma asíncrona. Obtienes un gran aumento de capacidad con casi ningún cómputo extra por token, por eso hay quien ejecuta un modelo "de unos 180B" en máquinas con GPUs modestas.
Los otros dos ejes son un flujo residual con compuertas, que ensancha el residual en cuatro ramas paralelas con almacenamiento FP8, y el cambio al optimizador Muon para los mapas lineales 2D. Qwen dice que la combinación redujo el coste de entrenamiento a aproximadamente una novena parte del de Qwen3.7-Plus y aun así lo supera en programación y tareas de oficina.
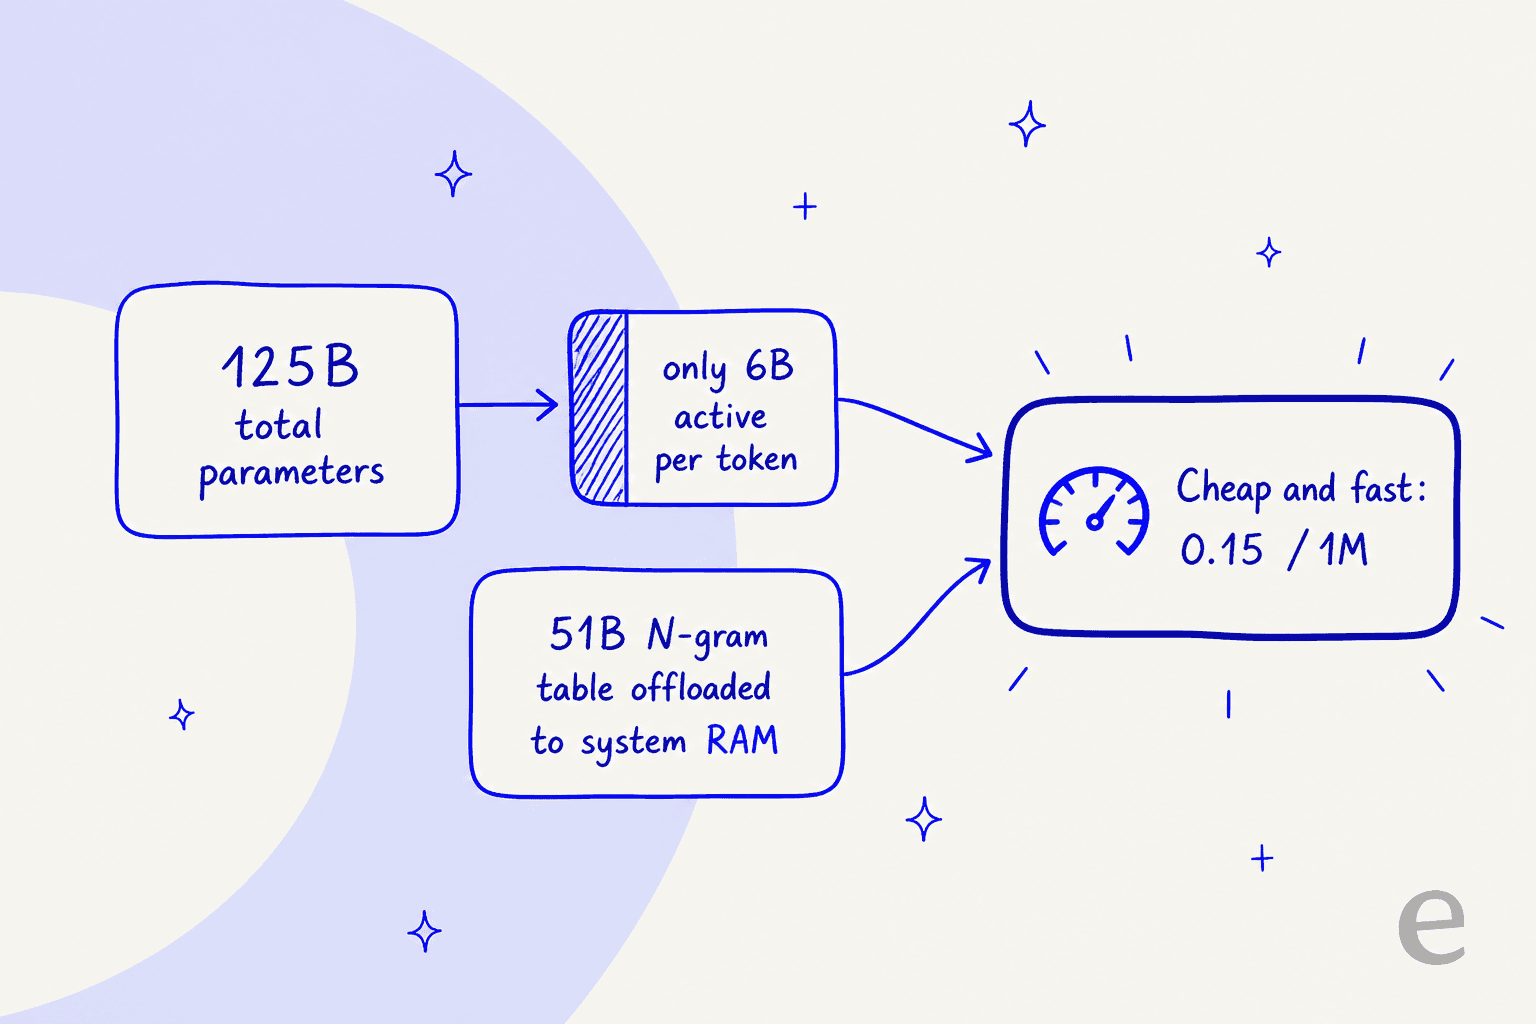
Junta las especificaciones y la forma es clara: 125B de parámetros principales, 6B activados por token, más el embedding de N-gramas de 51B y una cabeza de predicción multitoken de 4B (Artificial Analysis redondea el total a 180B). Usa 512 expertos con 10 enrutados más 1 compartido activos, un contexto nativo de 262.144 tokens ampliable a 1M mediante YaRN. Una advertencia honesta: la cifra de contexto es inconsistente entre fuentes, con la ficha del modelo diciendo 262K nativo, QwenCloud funcionando con 1M por defecto y Artificial Analysis listando 256K. Léelo como "muy largo, el tope exacto depende de dónde lo ejecutes."
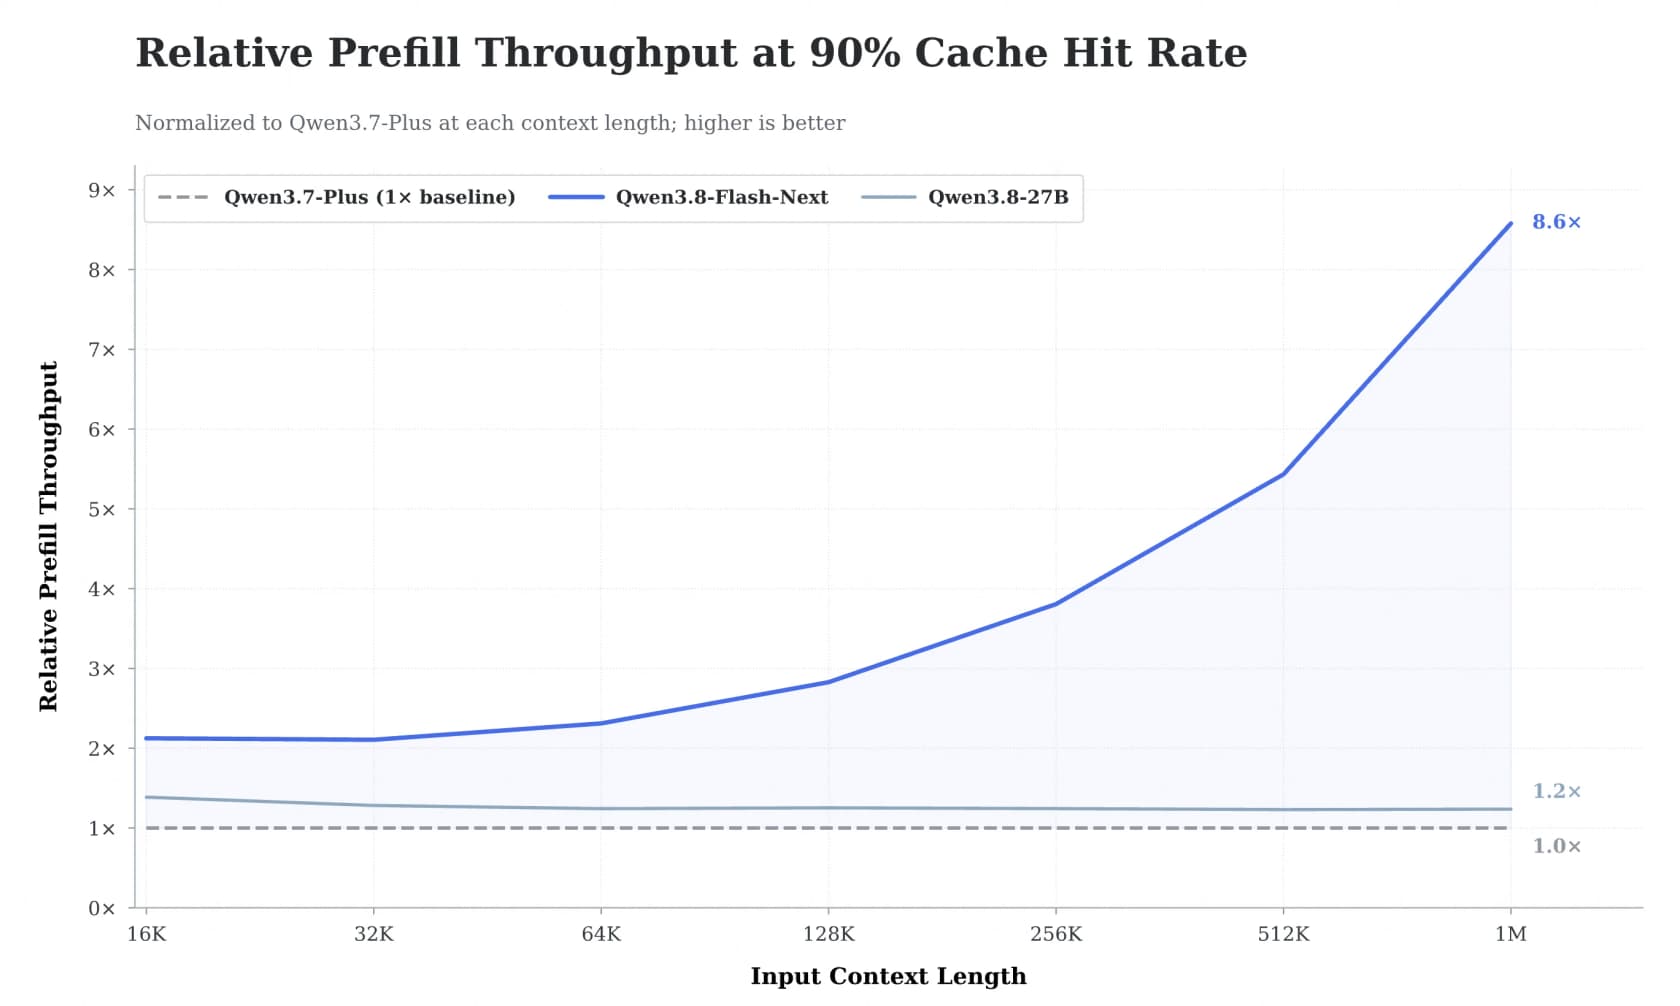
El beneficio de eficiencia se nota más con contexto largo. Qwen reporta que el kernel QSA alcanza hasta 7,6x de aceleración en prefill y 4,9x en decode con 1M de tokens, y 8,6x el rendimiento de prefill de Qwen3.7-Plus con 1M y un 90 % de aciertos de caché.
Qué puede hacer realmente Qwen 3.8 Flash Next
Aquí los benchmarks vienen en dos sabores, y la diferencia importa. Está la tabla propia de Qwen, impresionante pero reportada por el proveedor, y hay un ancla genuinamente independiente.
Empecemos por la independiente. Artificial Analysis puntúa a Flash Next con 56 en su Intelligence Index, lo que lo sitúa en el puesto 5 de 111 de su clase, frente a una mediana de 29. Alcanza 77 tokens de salida por segundo y cuesta unos $0.10 por tarea del Index. Su veredicto en una línea es que está "entre los modelos líderes en inteligencia y con un precio razonable", pero es "muy verboso", quemando 200M de tokens de salida para completar el Index frente a una mediana de 110M. Quédate con lo de la verbosidad, porque infla en silencio las facturas reales.
Los números propios de Qwen, que debes leer como "Qwen reporta" y no como hecho neutral, lo colocan por delante de sus hermanos en la mayoría de las filas:
| Benchmark | Qwen3.8-Flash-Next | Qwen3.8-27B | Qwen3.7-Plus | DeepSeek-V4-Flash | Claude-Opus-4.6 |
|---|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 61.7 | 55.8 | 56.0 | 53.4 |
| SWE-bench Multilingual | 81.0 | 73.8 | 75.8 | - | 77.5 |
| LiveCodeBench v6 | 91.9 | 90.3 | 89.6 | 90.6 | 88.8 |
| GPQA Diamond | 91.7 | 89.2 | 90.3 | 90.8 | 91.3 |
| IFBench (seguimiento de instrucciones) | 81.3 | 79.5 | 79.1 | 79.2 | 62.5 |
| CoWorkBench (tareas largas de oficina) | 73.9 | 70.7 | 65.1 | 45.1 | 68.2 |
| Humanity's Last Exam | 35.9 | 30.8 | 34.7 | 33.8 | 40.0 |
Fuente: las tablas de benchmarks de Qwen. Destacan dos cosas. Es genuinamente fuerte en programación y tareas agénticas, superando por poco a modelos mucho más grandes en SWE-bench Pro. Y no es un barrido limpio: Claude Opus 4.6 sigue ganando Humanity's Last Exam, y DeepSeek V4 Flash lo supera en generación a nivel de repositorio. En visión, Qwen reporta 84,5 en AndroidWorld y 88,5 en RealWorldQA, ambos liderando el conjunto de comparación.
Precios de Qwen 3.8 Flash Next
Los pesos abiertos son gratuitos. Si tienes el hardware, pagas cómputo y nada más, que es todo el atractivo para quienes autoalojan.
Para la API alojada de Qwen3.8-Flash, el precio es plano, sin tramos por longitud de contexto como tenía Qwen 3.7 Flash:
| Concepto | Tarifa (USD / 1M tokens) |
|---|---|
| Entrada | $0.15 |
| Salida | $0.47 |
| Entrada, lectura en caché | $0.016 |
| Creación de caché explícita | $0.20 |
| Lectura de caché explícita | $0.016 |
Esa lectura en caché es un 89 % más barata que la entrada nueva, y no es teórico: OpenRouter observó una tasa de aciertos de caché del 91,1 % en tráfico real, lo que reduce el precio efectivo de entrada a unos $0.028 por millón. Así que lo que realmente pagas en cargas repetitivas y amigables con la caché queda muy por debajo del precio de lista.
Un asterisco sobre el titular de "barato". Como el modelo es muy verboso, las cargas con mucha salida pagan más de lo que sugiere la baja tarifa por token, ya que se te factura por todos esos tokens de pensamiento. Para una respuesta de soporte conversacional es redondeo; para ejecuciones agénticas largas se acumula. Si lo comparas en precio con DeepSeek V4 Flash o Kimi K3, modela los tokens de salida, no solo la tarifa de entrada.
Además, por ahora solo hay un proveedor de API: Alibaba Cloud International. OpenRouter reenvía directamente allí, así que todavía no hay enrutamiento multiproveedor ni conmutación por error.
Qué dice la gente realmente
La reacción de la comunidad ha sido ruidosa, y es casi por completo una historia de inferencia local más que de API o empresa. El hilo de lanzamiento en Hacker News llegó a 698 puntos, y r/LocalLLaMA tuvo un megahilo de lanzamiento con más de 650 comentarios. La gente está obsesionada con ejecutarlo en sus propias máquinas.
La gente de herramientas marcó el tono. Unsloth lo puso a funcionar rápido e hizo una afirmación grande:
"Qwen3.8-Flash can now be run locally! The 125B MoE model outperforms Claude-Opus-4.6 (Max). Run on 75GB RAM via Unsloth GGUFs. Qwen3.8-Flash-Next enables CPU RAM / unified mem setups to deliver near VRAM speeds."
Esa frase de "supera a Opus 4.6" es suya y no está evaluada de forma independiente, así que tómala como entusiasmo, no como un hecho. Las voces más fundamentadas añadieron la salvedad que no deja de aparecer. Aquí está la explicación más clara de lo que realmente significa "Next", del hilo de HN:
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."

Y el inconveniente práctico, de Simon Willison, que lo ejecutó con varios niveles de razonamiento en un DGX Spark y acabó prefiriendo el modelo denso más pequeño, culpando a la cuantización de pocos bits necesaria para que cupiera. Ese es el tema recurrente: la arquitectura es emocionante, pero este checkpoint concreto es una vista previa, y exprimirlo en hardware de consumo cuesta calidad. Si quieres hoy la opción que se siente terminada en esta clase de peso, muchos hilos apuntan en su lugar a GLM 5.3 Flash.
Entonces, ¿deberías usarlo?
Aquí es donde aterrizo tras una semana observándolo.
Úsalo si eres un aficionado a la inferencia local con una máquina de memoria unificada o una GPU de sobra, quieres un adelanto de la arquitectura Qwen4, o tienes una carga amigable con la caché y centrada en programación donde el bajo precio alojado y los fuertes números de SWE-bench compensan. El diseño de activación dispersa realmente le deja rendir por encima de su tamaño de hardware.
Espera si necesitas un modelo estable y listo para producción ahora mismo. Es una vista previa infraentrenada por admisión del propio Qwen, la cuantización perjudica, y la API alojada de Qwen3.8-Flash solo tiene un proveedor. Para trabajo crítico, un modelo más terminado, ya sea GLM 5.3 Flash, un nivel de Claude Opus 5 o Qwen 3.8 Max, es la opción más segura hasta que llegue la línea Qwen4 completa.
En cualquier caso, el punto más importante es lo que realmente es un modelo: un componente. Lo que me lleva a lo que tengo que explicar una y otra vez a los equipos que buscan "IA barata".
Dónde encaja un modelo así en el trabajo real de soporte
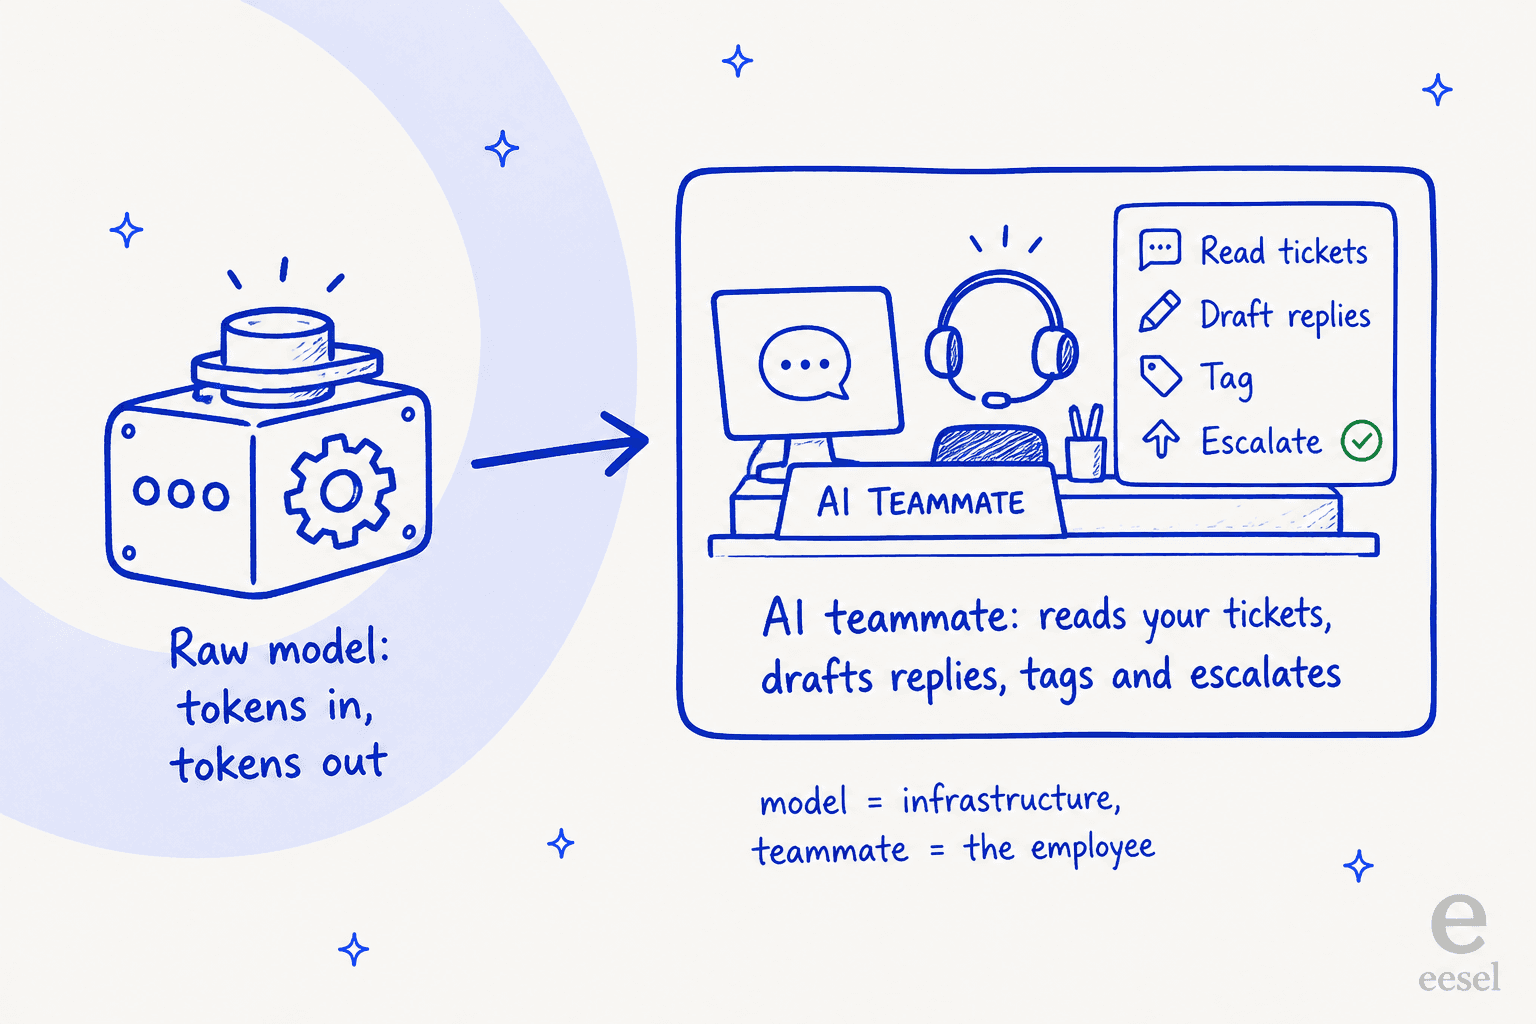
Mucha gente lee un lanzamiento así y piensa "genial, apuntaré mi bandeja de soporte a Qwen 3.8 Flash Next y recortaré mi factura de IA". Eso es un error de categoría. Un modelo en bruto recibe tokens y devuelve tokens. No conoce tu política de reembolsos, no puede leer el historial de pedidos de un cliente, no redactará una respuesta en tu helpdesk y no sabe si su respuesta segura es realmente correcta. El modelo es infraestructura; lo que hace el trabajo es el empleado.
Esa capa de empleado es lo que construimos en eesel. El enfoque que usamos es simple: eesel es una plataforma de compañeros de IA, y contratas compañeros listos para trabajar en tareas concretas, actualmente un compañero de IA para helpdesk y un redactor de blog con IA. Cada uno llega con las habilidades, integraciones y contexto de empresa para su puesto, así que la pregunta de qué modelo corre por debajo pasa a ser un detalle de implementación y no tu problema.

La parte que más destacaría, porque he visto cómo ha perjudicado a la gente, son las pruebas. Todos hemos visto a un bot de apariencia segura dar en silencio una respuesta equivocada, por eso el compañero de helpdesk de eesel simula cada despliegue con tus tickets históricos antes de tocar a un cliente real. Ves la tasa de resolución y las respuestas exactas que habría enviado en conversaciones pasadas reales, y luego decides qué automatizar. Un modelo nuevo e infraentrenado es justo lo que quieres pasar por esa puerta en lugar de fiarte de una tabla de benchmarks. Y como eesel se integra con tu helpdesk actual y lee de tu base de conocimiento y tickets pasados, el problema del contexto, el que un modelo en bruto nunca puede resolver por sí solo, queda cubierto.
La versión corta: modelos como Qwen 3.8 Flash Next se vuelven baratos y capaces rápidamente, lo cual es una gran noticia, pero elegir uno es el 10 % fácil del trabajo. El otro 90 % es convertirlo en un compañero que de verdad resuelva tickets, y esa es la capa en la que vale la pena invertir tu tiempo.