

IBM lanzó Granite 4.2 el 25 de agosto de 2026: una familia de modelos de razonamiento con pesos abiertos en tres tamaños, 3B, 8B y 30B, todos con licencia Apache 2.0. El cambio principal es el "pensamiento" nativo: el razonamiento paso a paso ahora viene integrado en el modelo y se puede alternar entre completo, de bajo esfuerzo y desactivado.
Los modelos son pequeños, baratos y honestos sobre para qué sirven: trabajo agéntico empresarial, llamadas a herramientas y tareas estructuradas que puedes ejecutar en tu propio hardware. El mínimo es gratis porque los pesos son abiertos, y la tarifa alojada más barata que pude confirmar es la del 8B en Replicate, a 0,06 $/0,25 $ por millón de tokens. En benchmarks, el de 30B es realmente sólido (57,0 en SWE-Bench Verified), aunque la gente de los LLM locales sigue recurriendo a Qwen cuando lo único que importa es la capacidad bruta de programación.
Algo que conviene decir desde el principio, porque me dedico a construir IA de soporte: un modelo no es un producto. Granite 4.2 es un motor excelente. Si lo que realmente quieres es un agente de IA que resuelva tickets, el modelo es el 10 % fácil; el conocimiento, las integraciones y las barreras de seguridad son el otro 90 %. Más sobre eso al final.
¿Qué es IBM Granite 4.2?
Granite es la familia de modelos abiertos de IBM para empresas, y 4.2 es la versión centrada en el razonamiento. Llegó como tres checkpoints, granite-4.2-3b, granite-4.2-8b y granite-4.2-30b, cada uno posentrenado a partir del modelo base de Granite 4.1 correspondiente. Junto a ellos, IBM también lanzó dos diminutos modelos de transcripción Granite Speech 5.0, pero el nombre "4.2" se refiere realmente a estos tres modelos de lenguaje.
He pasado los últimos años poniendo IA en colas de soporte reales, y lo primero que miro en cualquier modelo abierto nuevo no es el benchmark principal, sino la licencia y cómo se despliega. Granite puntúa bien aquí: los pesos son Apache 2.0, los modelos están firmados criptográficamente y certificados ISO, y la familia obtuvo una calificación máxima en el Foundation Model Transparency Index de Stanford. Para un equipo regulado que necesita ejecutar el modelo dentro de sus propias paredes, esa combinación importa más que un par de puntos de benchmark.
El argumento de IBM es "competitivo con modelos de pensamiento más grandes, a una fracción del coste". Es una apuesta interesante y conviene comprobarla en lugar de repetirla, así que veamos la gama real.
La gama de modelos: 3B, 8B y 30B
Así se comparan los tres tamaños en las especificaciones que deciden dónde puede ejecutarse cada uno. Los tres son transformers densos solo decodificador, así que el número de parámetros que ves es el modelo completo; no hay ningún truco de mezcla de expertos que esconda un tamaño activo menor.
| Modelo | Parámetros | Capas | Contexto | Modelo base | Ideal para |
|---|---|---|---|---|---|
| granite-4.2-3b | 3B (denso) | 40 | 128K | granite-4.1-3b-base | Portátiles y edge, tareas simples y rápidas |
| granite-4.2-8b | 8B (denso) | 40 | 128K | granite-4.1-8b-base | Trabajo empresarial de propósito general |
| granite-4.2-30b | 30B (denso) | 64 | 128K (512K ampliado) | granite-4.1-30b-base | Razonamiento complejo y agentes |
Cada tamaño maneja de forma nativa una ventana de contexto de 128K tokens, y el de 30B puede ampliarse a 512K. IBM también publica versiones cuantizadas oficiales de cada tamaño (fp8, mxfp4, nvfp4) que reducen el uso de memoria, además de conversiones GGUF de la comunidad para llama.cpp y LM Studio. Si quieres una capa de seguridad, las fichas de los modelos remiten al Granite Guardian 4.1 8B, separado, para detección de riesgos.
Lo más difícil para la mayoría es simplemente elegir un tamaño. Aquí tienes una guía rápida según lo que estés optimizando.
Lo realmente nuevo: razonamiento nativo que puedes alternar
La verdadera historia de 4.2 es que el razonamiento ya viene integrado. Los modelos Granite anteriores respondían directamente; 4.2 puede primero trabajar un problema dentro de etiquetas <think>...</think> antes de comprometerse con una respuesta, lo que ayuda con matemáticas, programación y cualquier lógica de varios pasos. Lo que lo hace práctico es que IBM hizo el razonamiento conmutable dentro de un solo modelo, así que no tienes que mantener checkpoints separados de "razonamiento" y de "chat".
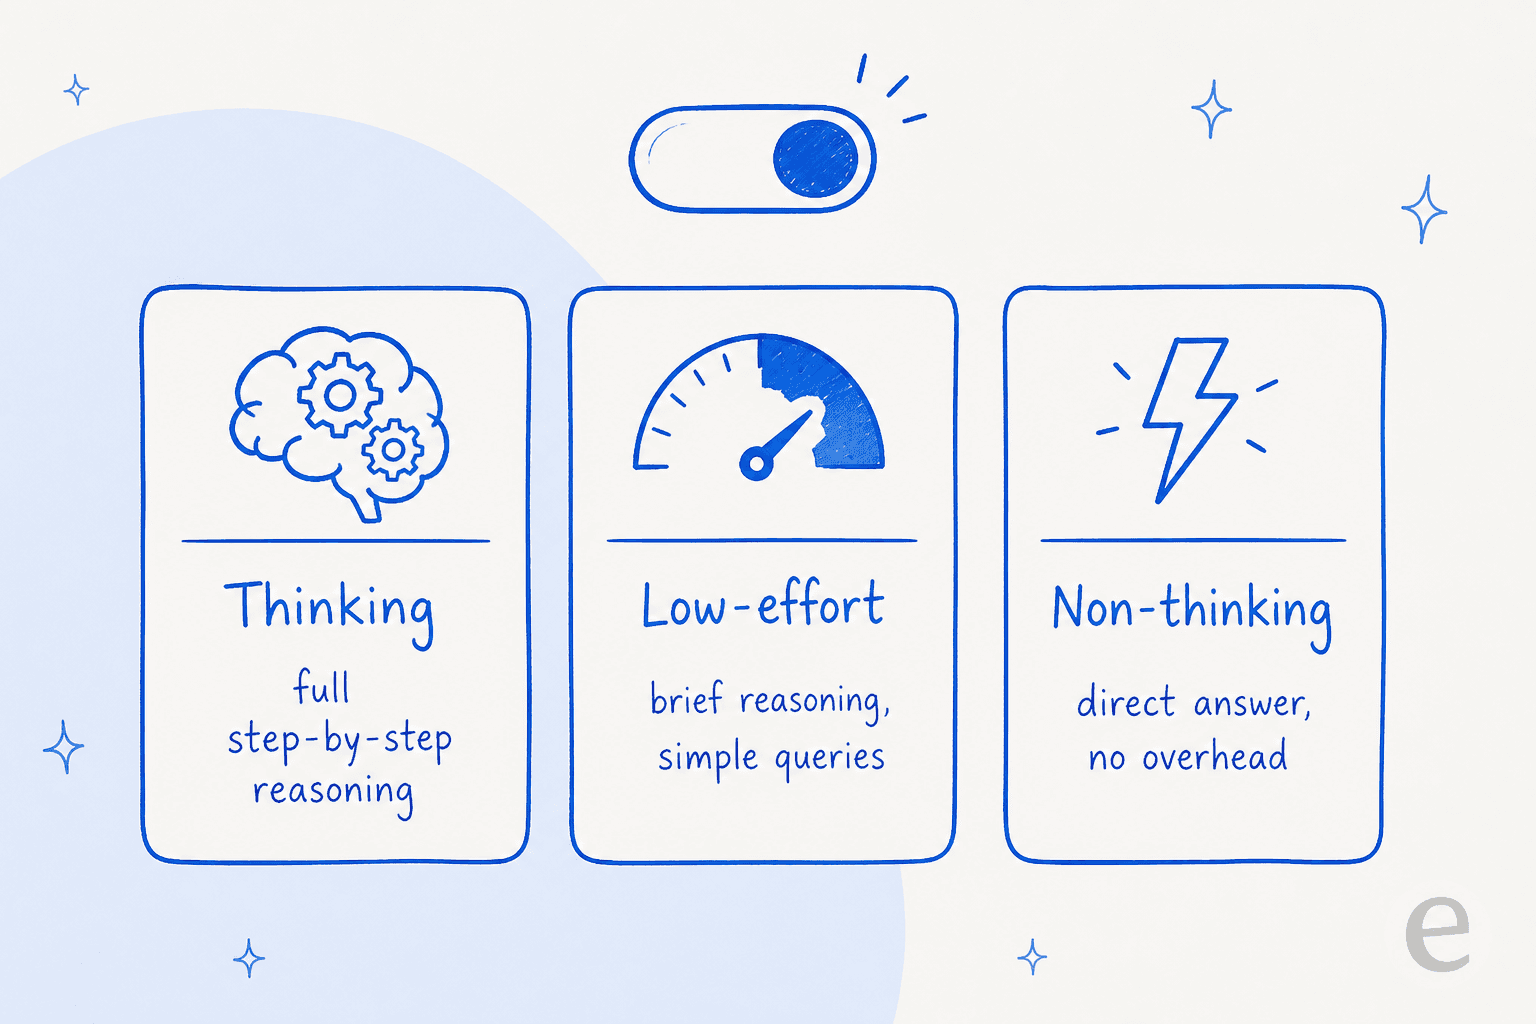
Hay tres modos, y elegir el correcto es sobre todo una decisión de coste:
- Thinking (el predeterminado): cadena de pensamiento completa. Lo mejor para razonamiento difícil, lo peor en latencia y gasto de tokens.
- Low-effort: una pasada breve de razonamiento para consultas más simples, un punto medio que conserva parte de la precisión sin toda la sobrecarga.
- Non-thinking: una respuesta directa sin ningún token de razonamiento, para cuando solo necesitas velocidad.
En Ollama alternas entre ellos con /set think y /set nothink. Esto es realmente útil en producción, porque "razonar siempre" es caro y "no razonar nunca" es tonto, y la mayoría de las cargas reales quieren mezclar ambos según la consulta. Si alguna vez has ajustado un bot de soporte, es el mismo equilibrio que decidir cuándo escalar frente a responder automáticamente.
Llamadas a herramientas con razonamiento
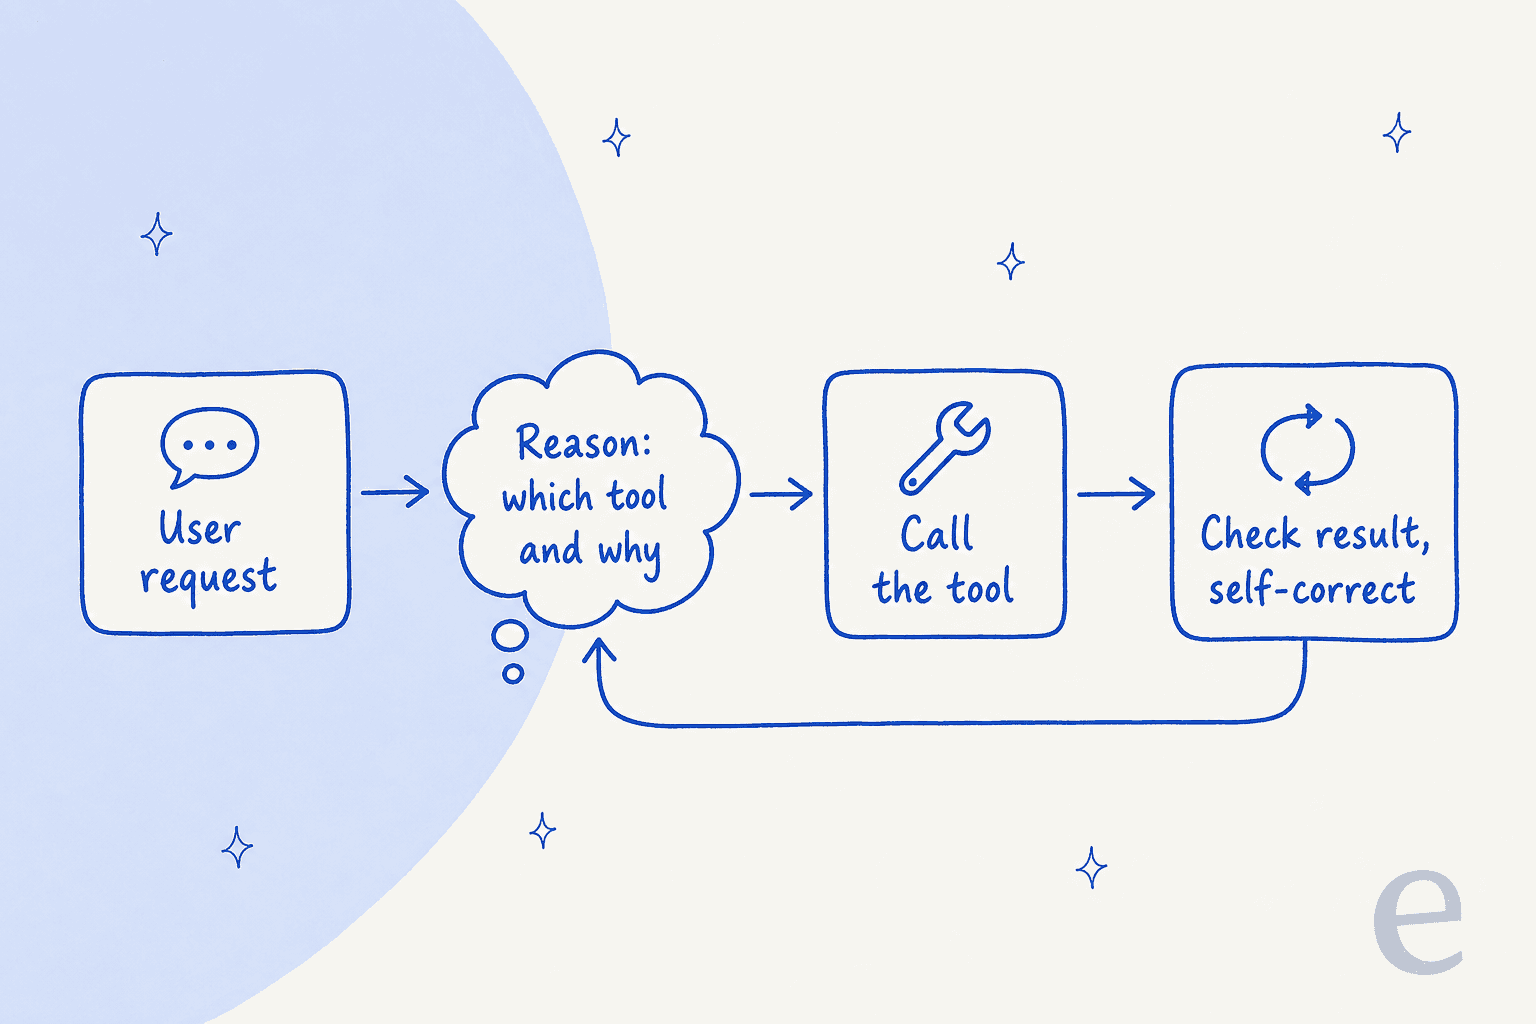
La otra mejora, y la que a IBM claramente más le importa, son las llamadas a herramientas. Granite 4.2 fue entrenado para razonar qué herramienta llamar y por qué antes de hacer la llamada, en lugar de reconocer patrones para dar con el nombre de una función. En la práctica, el modelo planifica, llama a una herramienta, revisa el resultado y puede autocorregirse.
Expone una API compatible con OpenAI y funciona de inmediato con arneses agénticos de programación como OpenCode, Pi y OpenHands, y está optimizado para vLLM (v0.20+) y SGLang para el despliegue. Esta es la parte que hace que 4.2 parezca dirigido directamente al público de agentes de IA y no al de los chatbots. También conviene ser realista: las llamadas a herramientas fiables en una demo no son lo mismo que las llamadas a herramientas fiables contra tus desordenados sistemas de producción, y por eso mismo simulamos cada despliegue con datos históricos reales antes de que toque a un cliente real.
Denso, no híbrido: el cambio respecto a Granite 4.0
Este es un matiz que confunde a la gente, así que merece un párrafo. Granite 4.0 usaba una arquitectura híbrida Mamba-2/transformer con una capa de mezcla de expertos (MoE), que IBM promocionaba por su menor uso de memoria y su inferencia más rápida. Granite 4.2 va en sentido contrario: es un transformer denso, solo decodificador, sencillo, posentrenado a partir de la base densa de Granite 4.1.
¿Por qué te importa? Con un modelo denso no hay división entre parámetros "activos y totales", así que un modelo denso de 30B usa aproximadamente el cómputo de 30B parámetros en cada token. Es más pesado por token que un MoE comparable, pero es más simple de razonar, ampliamente compatible con las herramientas estándar y predecible de desplegar. La propia formulación de IBM es que "its dense architecture supports broad compatibility", una forma justa de decir que cambia algo de eficiencia por mucha menos fricción de despliegue.
Cómo rinde Granite 4.2 en los benchmarks
Estas son las cifras que IBM publicó en las fichas de los modelos, usando los valores en los que coinciden las dos tablas oficiales de IBM. Me he limitado a los benchmarks que realmente le importan a un comprador.
| Benchmark | 3B | 8B | 30B |
|---|---|---|---|
| SWE-Bench Verified (programación) | NA | 47.67 | 57.00 |
| Terminal-Bench 2.1 | NA | 20.56 | 29.24 |
| AIME25 (razonamiento matemático) | 78.33 | 86.67 | 89.17 |
| GPQA | 54.80 | 64.14 | 66.41 |
| MMLU-Pro | 67.84 | 74.04 | 77.60 |
| Arena-Hard-V2 | 34.96 | 65.19 | 67.93 |
| RULER 128K (contexto largo) | 55.30 | 71.41 | 81.38 |
Son resultados sólidos para estos tamaños, sobre todo el de 30B en programación y matemáticas. Pero aquí quiero ser claro contigo, porque es lo más útil de esta sección: IBM compara Granite sobre todo con versiones anteriores de Granite, y sitúa los nuevos modelos frente a Nemotron 3 Super y Gemma 4 en lugar de frente a los modelos que la mayoría ejecuta localmente. Eso limita de verdad cuánto te dicen estas tablas.
La lectura de la comunidad es más escéptica, y con razón. Como lo expresó un comentarista de Hacker News tras el lanzamiento de 4.1:
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models."

Así que toma los benchmarks como "Granite mejoró mucho respecto al Granite anterior", que es cierto y útil, y no como "Granite supera a todo lo de su tamaño", algo que las tablas no muestran en realidad.
Qué dice la gente
Las reseñas independientes y prácticas de 4.2 en concreto aún son escasas, ya que tiene solo unos días, pero la opinión sobre Granite 4.x está bien asentada y es coherente. El elogio es real: los modelos pequeños corren rápido en hardware común y son discretamente excelentes en trabajo estructurado y fundamentado.
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly ... Granite has recent training data which is nice."
La crítica es igual de coherente y viene en dos versiones. Primero, en capacidad bruta, la comunidad de LLM locales sigue valorando más a Qwen para programación y razonamiento agéntico:
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."
Segundo, hay un problema práctico que conviene conocer antes de descargar el 8B: varias personas han visto cómo su uso de memoria se dispara muy por encima del tamaño de descarga una vez cargado, por la caché KV de la larga ventana de contexto.
"I downloaded the 5.3 GB Granite 4 8b model from Ollama library, but when I run the model, it bloats up to 27 GB, and won't fit onto the GPU VRAM"

La solución suele ser limitar la longitud de contexto al cargar, pero es una trampa real si asumes que el tamaño de descarga es el tamaño en memoria.
Qué cuesta y cómo ejecutarlo
Como los pesos son abiertos, la forma más barata de ejecutar Granite 4.2 es gratis: descárgalo con Ollama o Hugging Face y paga solo tu propio cómputo. Esto es lo que cuesta realmente cada vía.
| Vía | Lo que pagas | Notas |
|---|---|---|
| Autoalojado (Ollama / Hugging Face / vLLM) | 0 $ de licencia | Apache 2.0; tú cubres el hardware. El 3B es una descarga de 2,2 GB apta para portátil |
| Replicate (granite-4.2-8b) | 0,06 $ / 1M de entrada, 0,25 $ / 1M de salida | Tarifa alojada por token confirmada más barata; ~0,0014 $ por ejecución típica |
| IBM watsonx.ai | Pago por uso por 1M de tokens + alojamiento por hora | Plan Standard ~1.050 $/mes; facturado en Resource Units (1 RU = 1.000 tokens) |
Una nota sobre watsonx: la tabla de precios en vivo de la línea de Granite 4.2 devolvía un error cuando la consulté, así que no pude confirmar directamente una cifra exacta por token para 4.2. La tarifa confirmada más cercana de la familia Granite-4 en la documentación de IBM es de unos 0,06 $ por 1M de entrada y 0,27 $ por 1M de salida, y el modelo de precios (pago por uso por millón de tokens más alojamiento por hora) está confirmado. En el momento de escribir, OpenRouter seguía listando solo Granite 4.0 y 4.1, no 4.2.
Para una comparación de costes real, autoalojar el 3B en hardware que ya tienes es lo más cercano a inferencia gratuita que vas a conseguir, y es una gran razón por la que a los equipos que se preocupan por la privacidad de los datos les gusta la familia Granite. Si lo estás comparando con un producto alojado, nuestro desglose de la tasa de resolución de la IA es una mejor vara de medir que el precio bruto por token.
¿Quién debería usar realmente Granite 4.2?
Después de revisarlo todo, esta es mi lectura honesta.
Elige Granite 4.2 si necesitas un modelo abierto y licenciable que puedas ejecutar on-prem, te importan las tareas estructuradas y fundamentadas (llamadas a herramientas, resumen, extracción, etiquetado) y quieres razonamiento conmutable sin hacer malabares con dos checkpoints. El 8B es una opción por defecto fantástica para la automatización empresarial, y el 3B es un modelo legítimamente bueno para "funcionar en un portátil". También se combina de forma natural con una capa de recuperación, ya que estos modelos brillan cuando se apoyan en tus propios documentos en lugar de responder de memoria.
Busca otra opción si tu única prioridad es la mejor programación o el mejor razonamiento agéntico a cualquier precio, donde el consenso de la comunidad sigue apuntando a Qwen, o si quieres un producto gestionado y completo en lugar de un modelo sobre el que construir. Granite es un excelente modelo, no una aplicación terminada, y la brecha entre ambas cosas es donde la mayoría de los proyectos de IA de soporte aciertan o fracasan.
Del modelo al compañero de equipo: dónde encaja eesel
Esta es la parte que más me importa, porque es el error que veo cometer a los equipos una y otra vez. Un modelo en bruto como Granite 4.2 es un motor. Un motor muy bueno. Pero un motor no es una contratación.
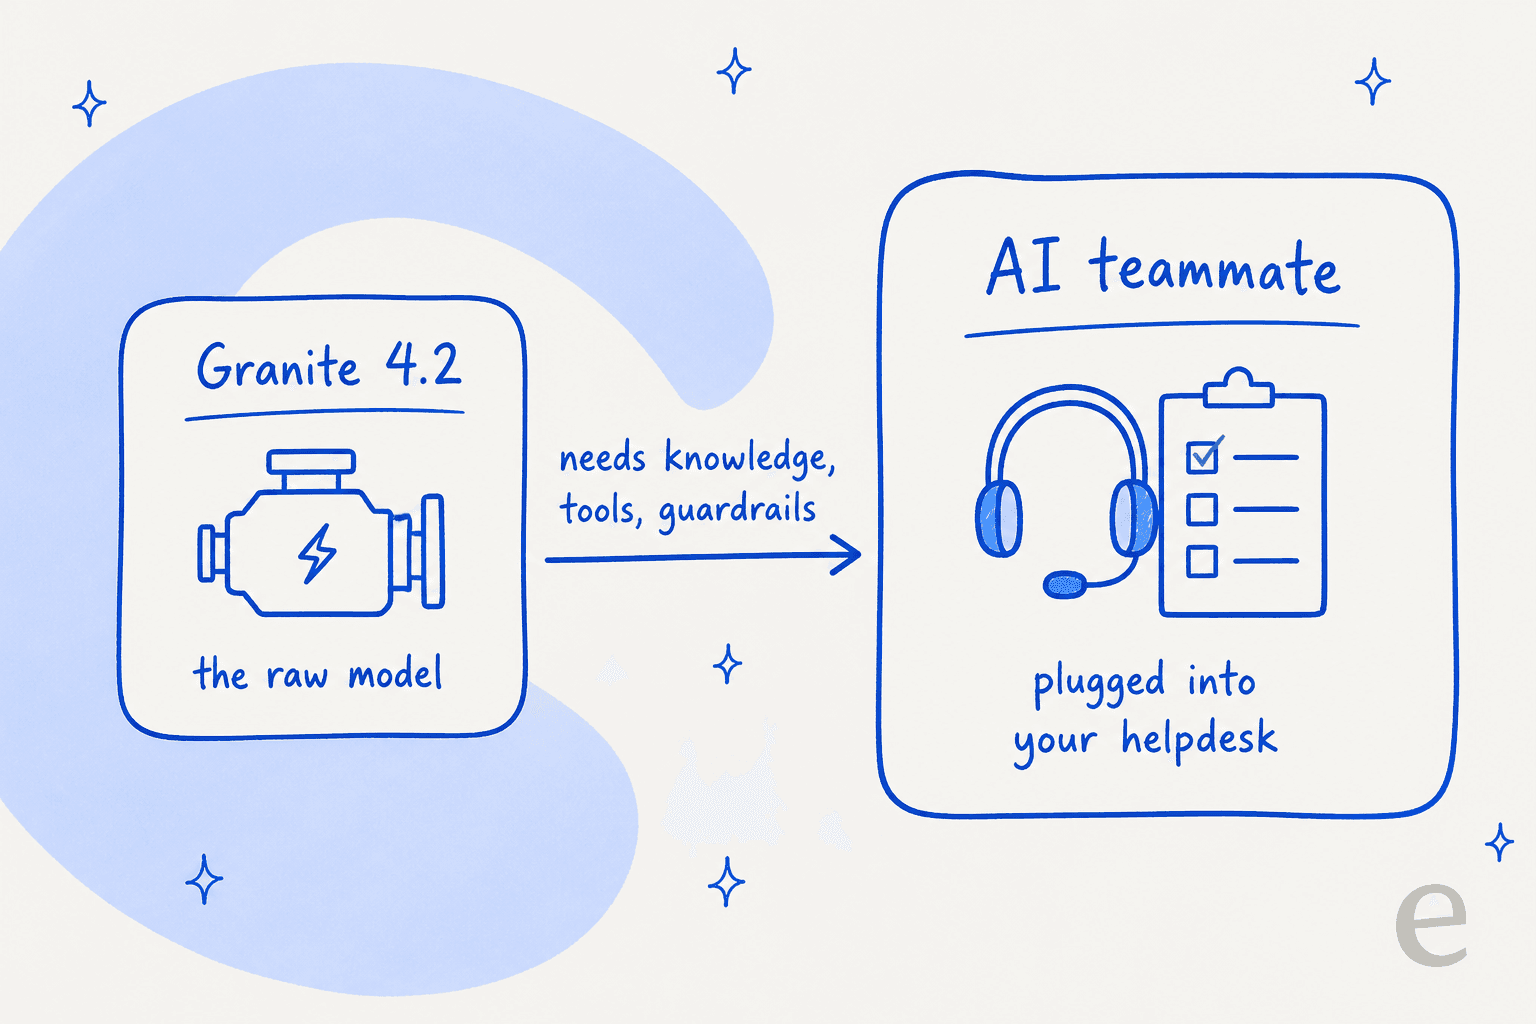
eesel vende el compañero de equipo terminado, no el motor. El compañero de equipo de IA para helpdesk se conecta al helpdesk que ya usas, ya sea Zendesk, Freshdesk, Gorgias o una bandeja compartida, aprende de tus tickets pasados y de tu base de conocimiento, y redacta o envía respuestas dentro de tus herramientas existentes. Lo que Granite 4.2 te da, razonamiento nativo y llamadas a herramientas, aquí es lo mínimo exigible; el 90 % difícil es el contexto de la empresa, las integraciones y la red de seguridad a su alrededor.

Y lo que yo no lanzaría sin tener en un bot de soporte: eesel te permite simular al compañero de equipo con miles de tus tickets históricos reales antes de que hable con un cliente, de modo que ves la tasa de resolución y las respuestas exactas antes de salir en vivo, en lugar de accionar un interruptor y esperar. Lo construimos porque hemos visto bots que suenan seguros dar respuestas equivocadas en silencio, y probar con tus propios tickets es lo único que lo detecta.
Si estás evaluando Granite 4.2 porque quieres automatizar el soporte, ese es el atajo que vale la pena conocer: puedes probar eesel gratis, conectar tu helpdesk en pocos minutos y ver cómo un compañero de equipo listo para trabajar gestiona tus tickets reales, sin tener que montar y vigilar un modelo tú mismo. Y si lo tuyo es escribir, la misma idea impulsa también al compañero de equipo redactor de blogs con IA.
Preguntas frecuentes
¿Qué es IBM Granite 4.2?
IBM Granite 4.2 es una familia de modelos de lenguaje de razonamiento con pesos abiertos, lanzada el 25 de agosto de 2026 en tres tamaños: 3B, 8B y 30B parámetros. Los tres se publican con licencia Apache 2.0, admiten una ventana de contexto de 128K y añaden razonamiento nativo de cadena de pensamiento que puedes activar o desactivar. Están pensados para IA en atención al cliente, programación y uso agéntico de herramientas.
¿Cuánto cuesta ejecutar Granite 4.2?
El mínimo es gratis: los pesos son Apache 2.0, así que puedes autoalojarlo con Ollama o Hugging Face y pagar solo tu propio hardware. La tarifa alojada confirmada más barata es granite-4.2-8b en Replicate, a 0,06 $ por 1M de tokens de entrada y 0,25 $ por 1M de salida. watsonx.ai, de IBM, factura por millón de tokens más alojamiento por hora, con un plan Standard de unos 1.050 $/mes.
¿Es Granite 4.2 bueno para programar y para agentes?
El modelo de 30B obtiene 57,0 en SWE-Bench Verified y añade llamadas a herramientas con razonamiento, así que es creíble para trabajo agéntico y de programación. En capacidad pura de programación, la comunidad de LLM locales sigue valorando más a Qwen. Si tu objetivo es un agente de IA que resuelva tickets de soporte, el modelo es solo el motor: aún necesitas conocimiento, herramientas y barreras de seguridad a su alrededor.
¿En qué se diferencia Granite 4.2 de Granite 4.0?
Granite 4.0 usaba un diseño híbrido Mamba-2/transformer con una capa de mezcla de expertos. Granite 4.2 es un transformer denso, solo decodificador, posentrenado a partir de la base de Granite 4.1, y su principal novedad es el razonamiento nativo conmutable. Denso significa que no hay división entre parámetros activos y totales: el tamaño que descargas es el tamaño que se ejecuta.
¿Puedo usar Granite 4.2 de forma comercial y gratuita?
Sí. La licencia Apache 2.0 permite el uso comercial y de investigación sin restricciones, el ajuste fino y el autoalojamiento sin cuota de licencia por token. Eres responsable del cómputo en el que lo ejecutes. Para un despliegue de soporte, combinarlo con una capa de agente de IA para helpdesk como eesel es lo que convierte el modelo en bruto en algo que de verdad atiende tu cola.