

¿Qué es Mistral Large 4?
Construyo agentes de IA para ganarme la vida en eesel, así que cada lanzamiento de frontera llega a mi mesa con la misma pregunta: si los agentes de eesel deberían funcionar con él. Con Mistral Large 4 la respuesta honesta es "todavía no, pero hay que vigilarlo", y los motivos son más interesantes que lo que sugiere el gráfico de benchmarks.
Mistral lo llama su "largest and most capable model to date". Según el artículo de lanzamiento, se entrenó con 3,800 GPU NVIDIA Grace Blackwell en centros de datos europeos propios de Mistral, y es también el primer hito de la hoja de ruta que financia la Serie D de €3 mil millones de Mistral. Si necesitas un repaso de la empresa, mi resumen de Mistral AI cubre la historia, y la recopilación de opiniones sobre Mistral AI recoge lo que opinan los usuarios de los modelos anteriores.
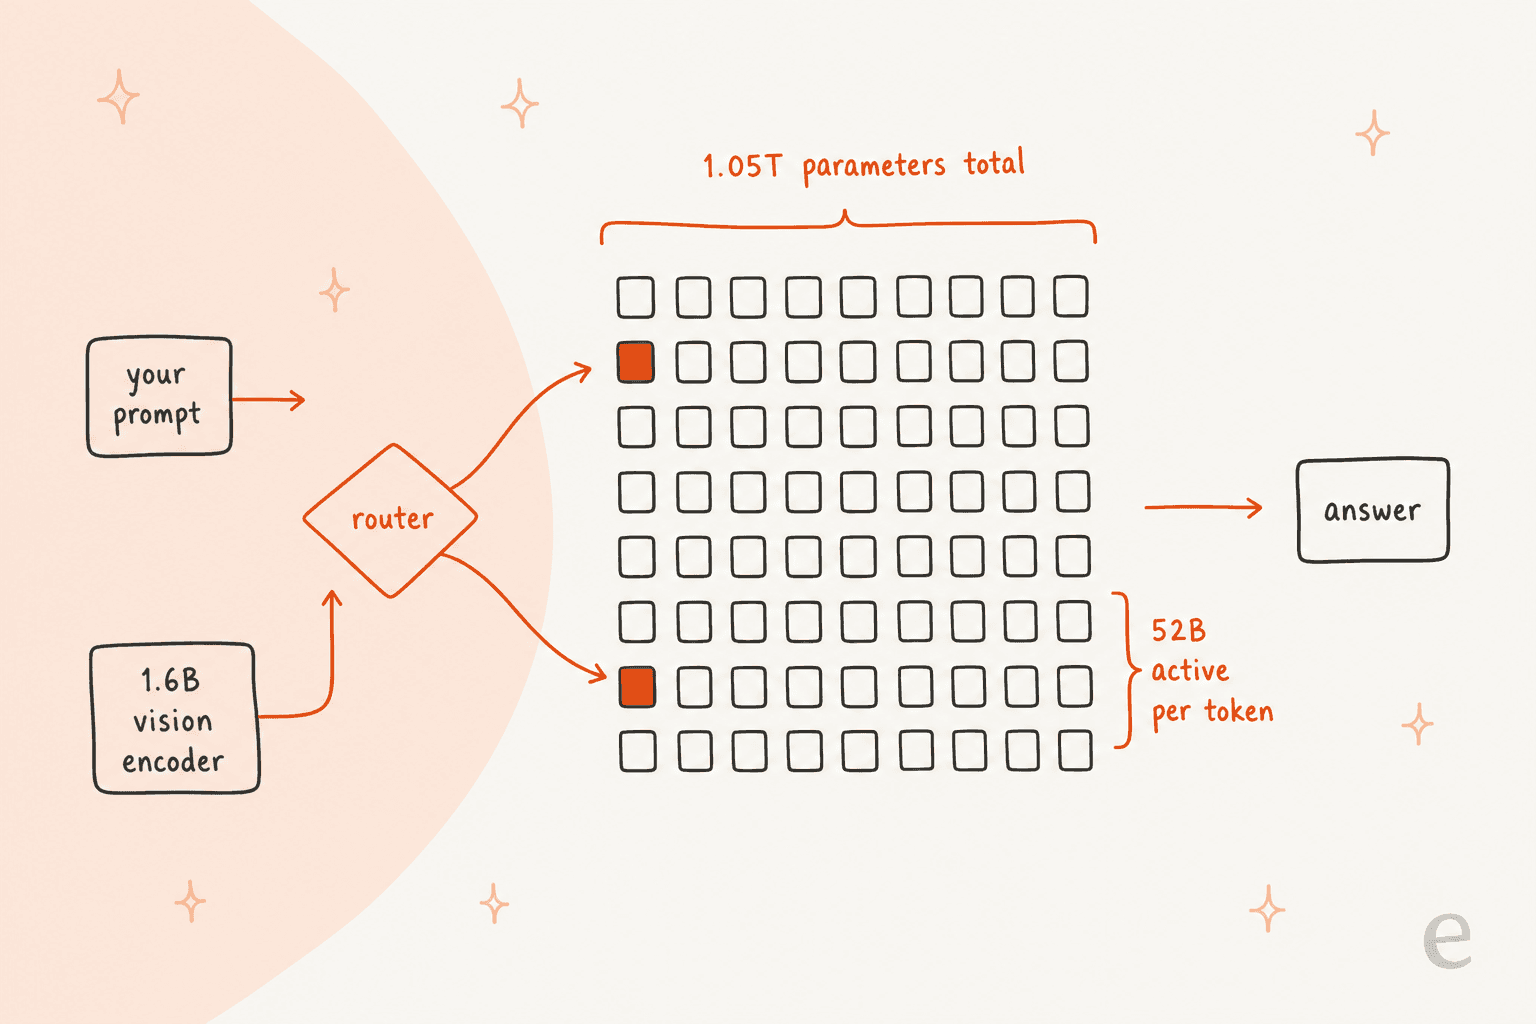
Estas son las especificaciones que importan, directamente de la ficha del modelo en la documentación:
| Especificación | Mistral Large 4 |
|---|---|
| Lanzamiento | 6 de octubre de 2026, preview pública (v26.10) |
| Arquitectura | Mezcla de expertos granular, híbrido de instrucciones y razonamiento |
| Parámetros | 1.05T totales, 52B activos, más un codificador de visión de 1.6B |
| Ventana de contexto | 1M de tokens |
| Entrada | Texto e imágenes |
| ID del modelo en la API | mistral-large-4 |
| Funciones | Function calling, salidas estructuradas, document QnA, batching, Agents API, herramientas integradas |
| Pesos | Prometidos para finales de octubre de 2026, licencia aún sin nombrar |
| Idiomas de entrenamiento | Más de 160, incluidos todos los idiomas oficiales de la UE |
Hay una pequeña pega con las cifras: la ficha de la documentación dice 52B de parámetros activos, mientras que el propio artículo de lanzamiento en X de Mistral dice 49B. Artificial Analysis también indica la ventana de contexto en 524,288 tokens, la mitad del 1M de la ficha, así que yo planificaría con la cifra menor hasta que Mistral lo aclare.
Cómo funciona Mistral Large 4 por dentro
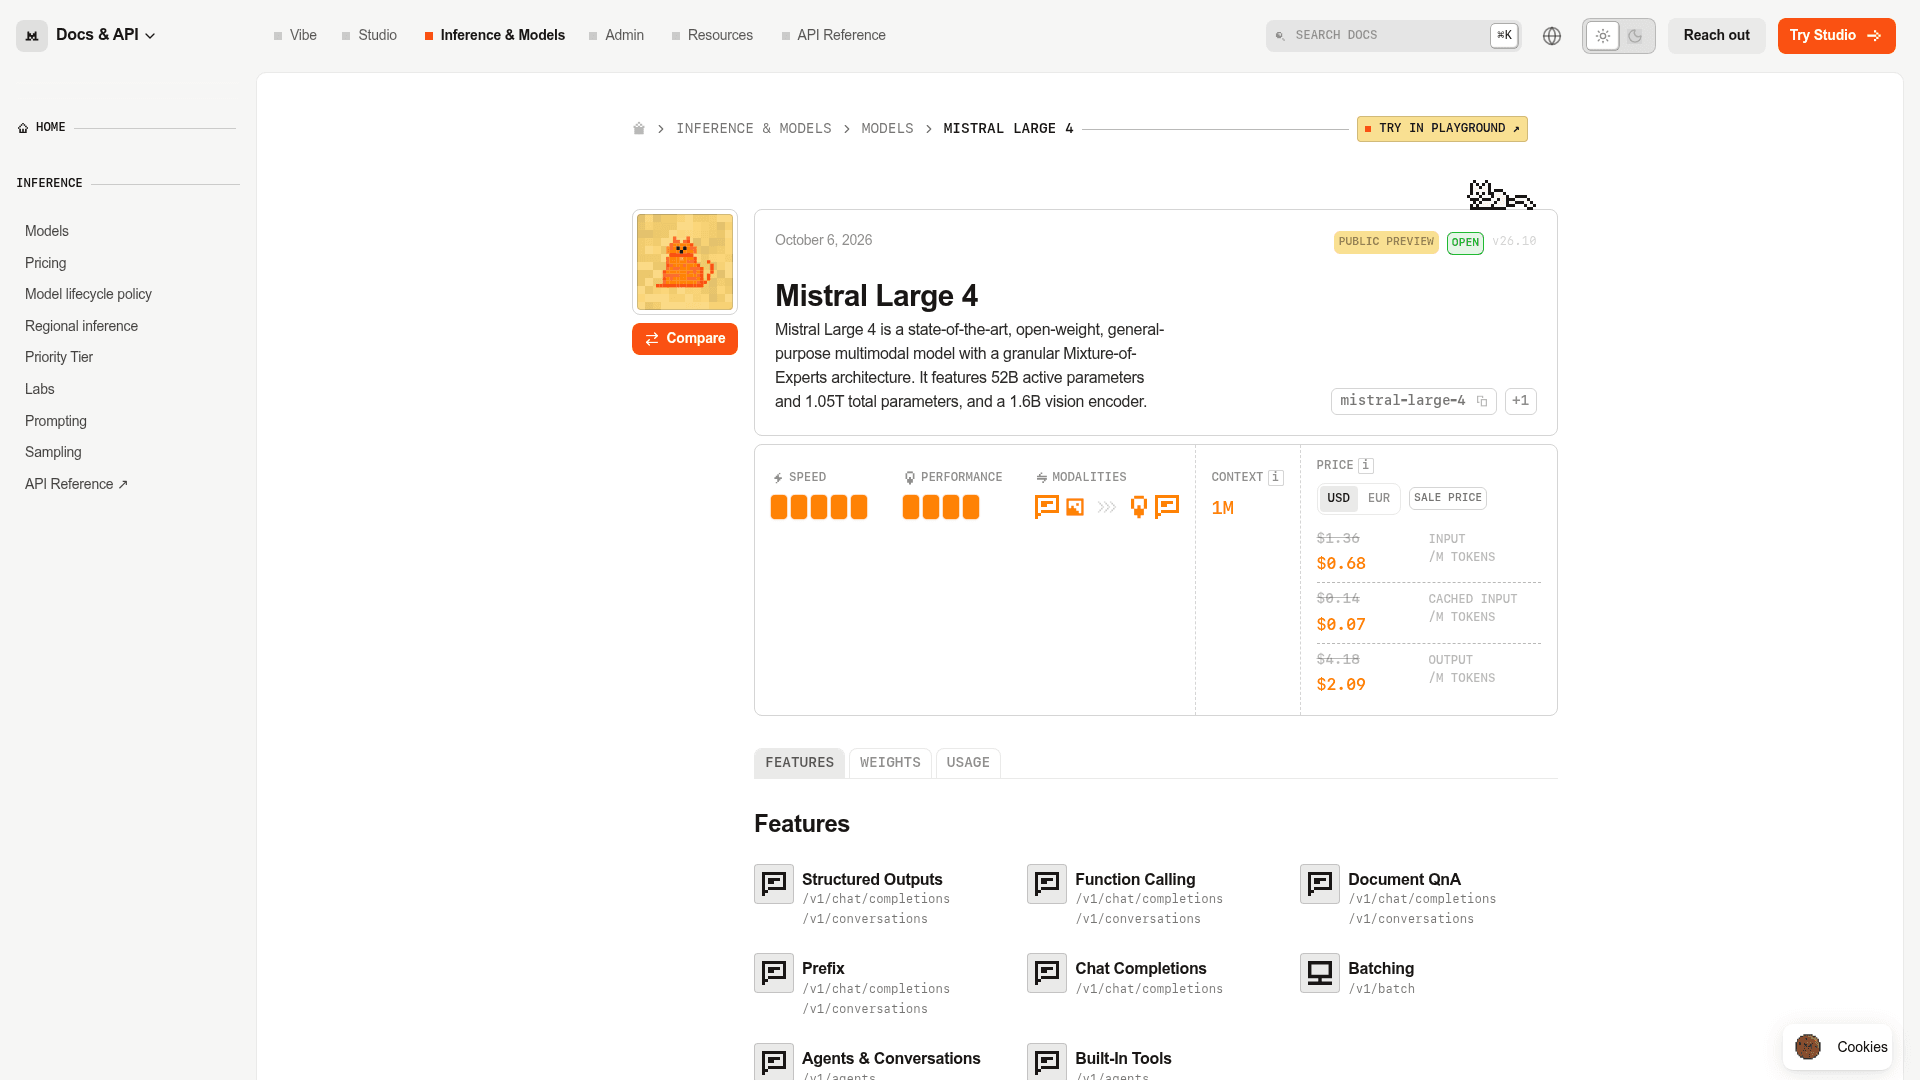
La cifra del titular, 1.05T de parámetros, es algo engañosa si la miras sola. Mistral Large 4 es un modelo de mezcla de expertos: un enrutador elige una pequeña parte de la red para cada token, de modo que solo un 5% aproximado de los pesos (52B) trabaja en un token dado. Por eso el modelo puede ser enorme y a la vez razonablemente rápido. Artificial Analysis midió 116.1 tokens de salida por segundo en la API de Mistral, muy por encima de la mediana de 77.0 de los modelos de razonamiento a un precio similar.
También es un modelo híbrido, así que puedes usarlo como modelo de instrucciones normal o activar el razonamiento con el parámetro reasoning_effort que muestra el ejemplo de la documentación. El razonamiento es donde se esconden el coste y la latencia (cada paso de pensamiento se factura como tokens de salida), y volveré a ello más adelante, porque es lo más importante que hay que entender antes de ponerlo delante de clientes.
La otra decisión de diseño que creo que vale la pena conocer es que Mistral lo entrenó en su propia infraestructura y sirve la preview desde el mismo sitio, incluyendo "a European deployment that Mistral operates end-to-end". Para los equipos que trabajan bajo la normativa de datos de la UE, eso importa más que cualquier benchmark. También cuenta en las revisiones de SOC 2 y GDPR, donde una de las primeras preguntas suele ser exactamente dónde se ejecuta el modelo.
Precios de Mistral Large 4
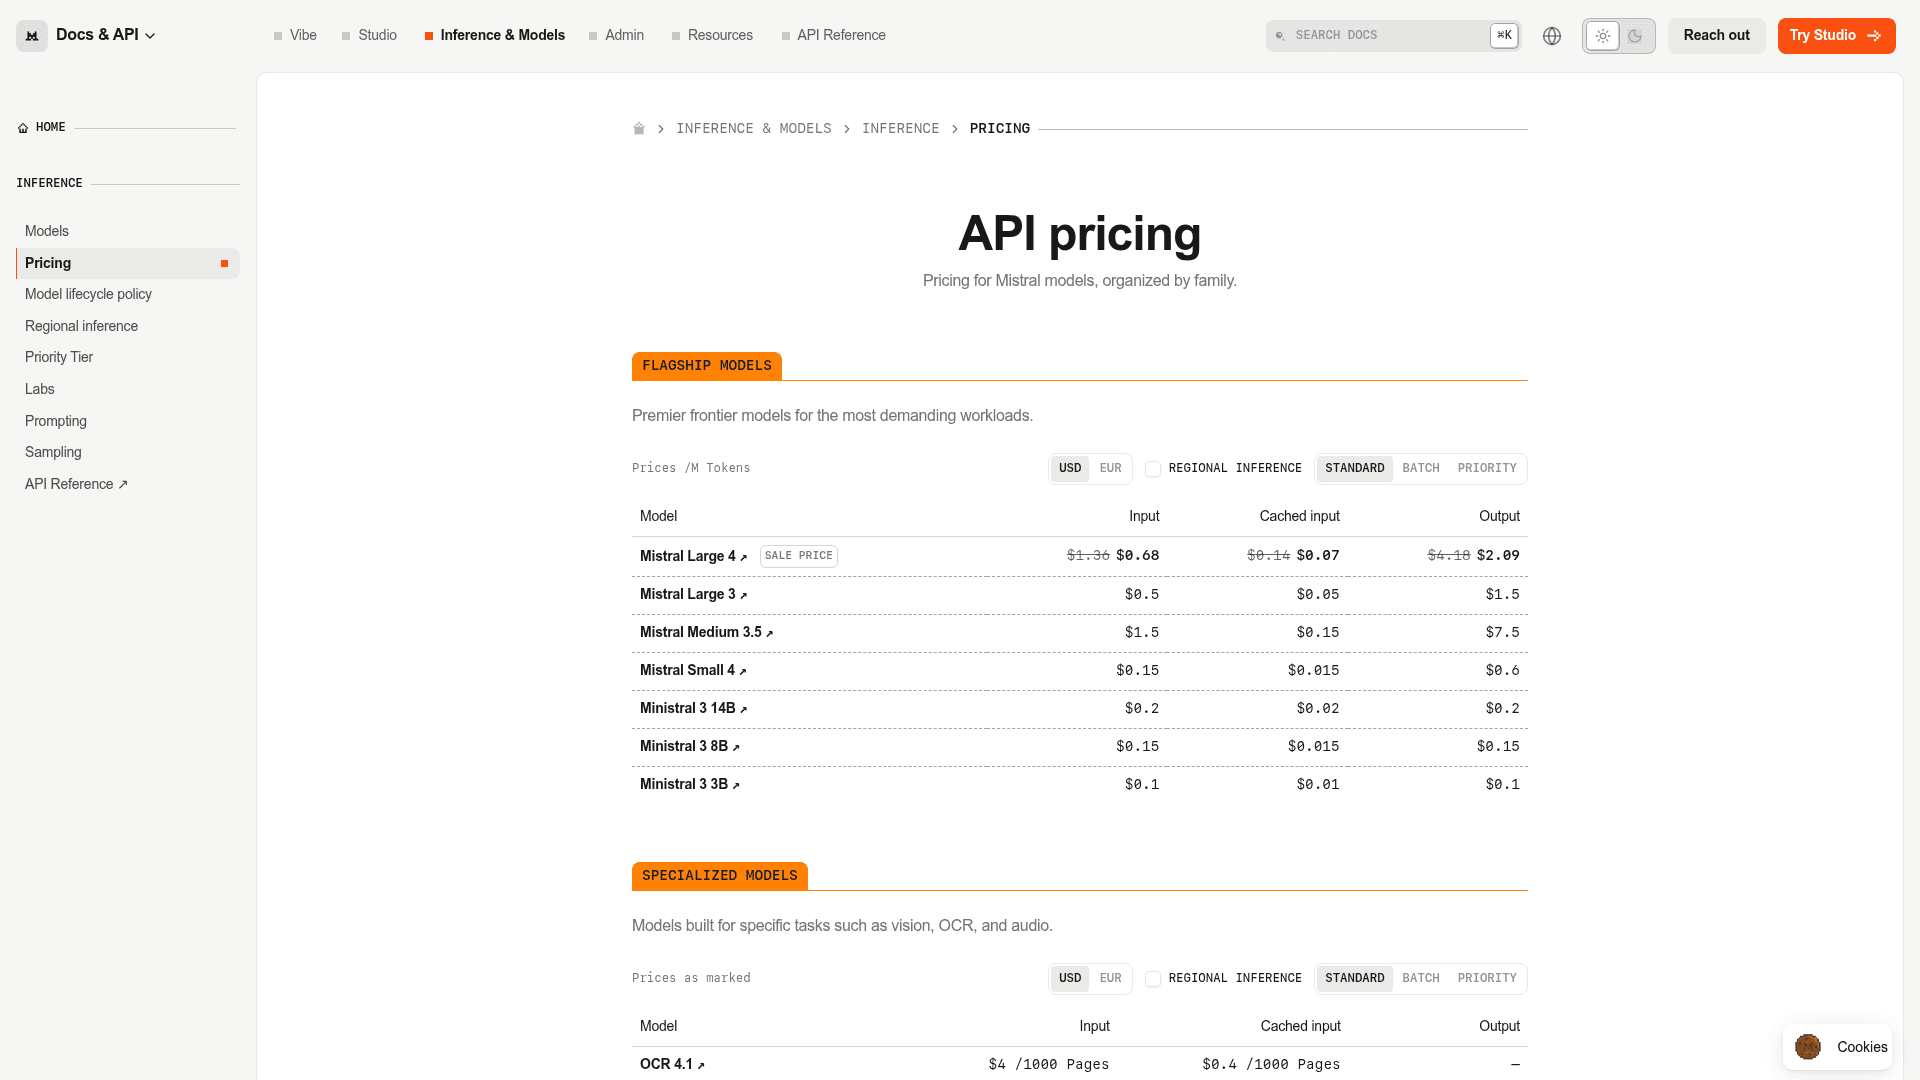
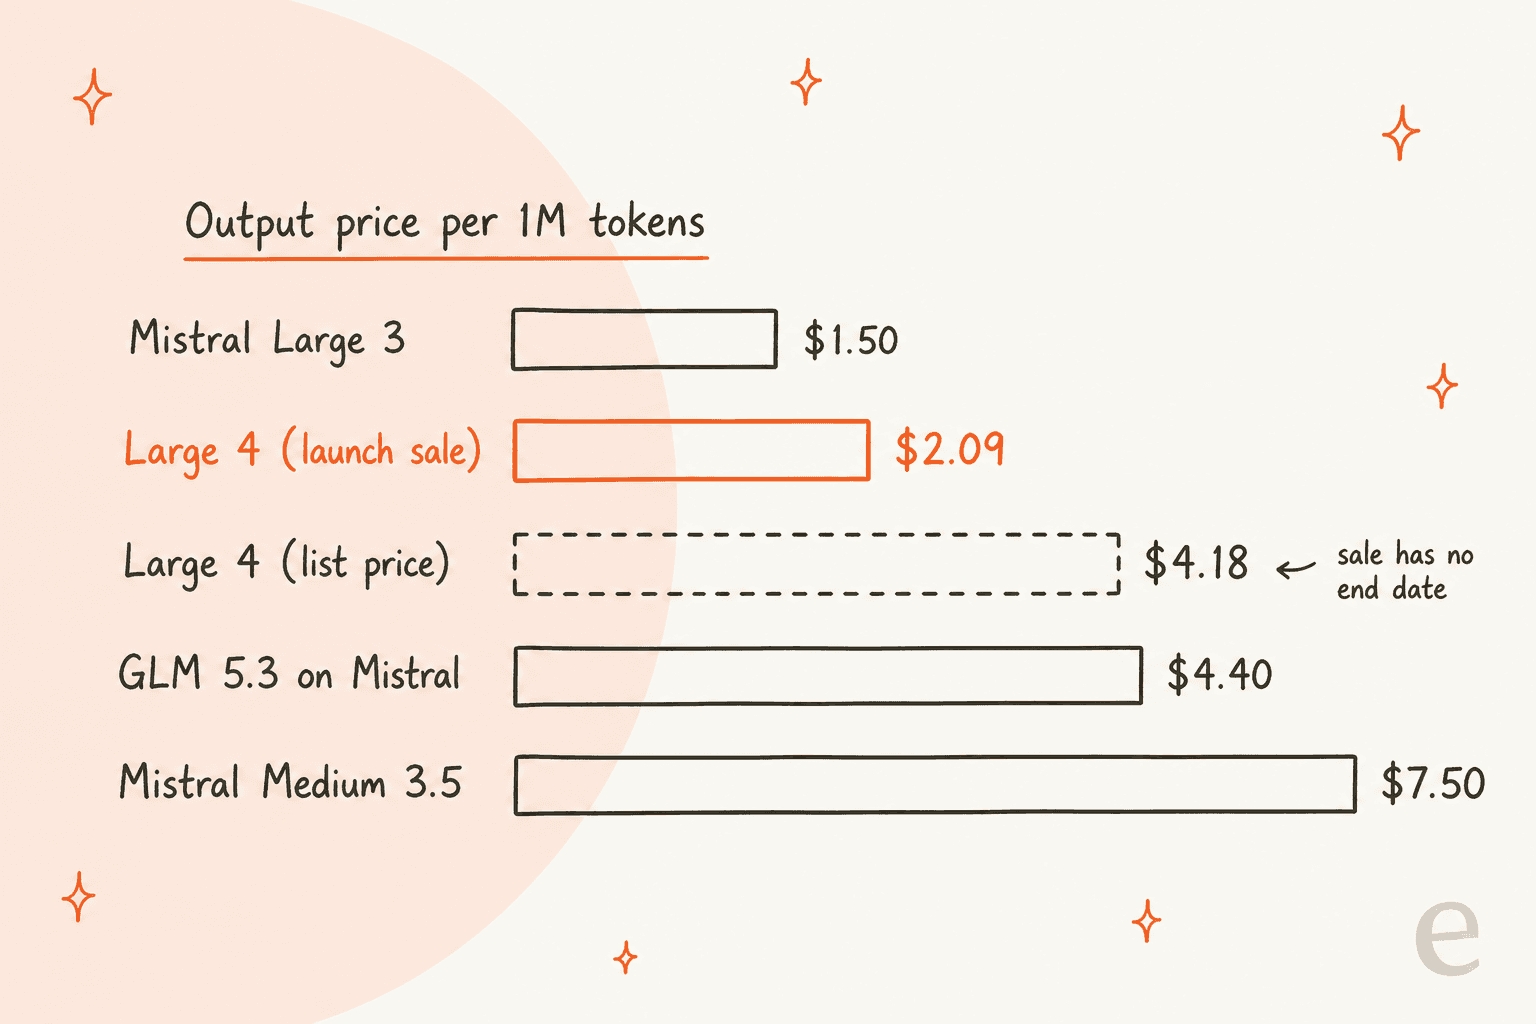
Mistral Large 4 se factura por token a través de la API, y ahora mismo hay una oferta de lanzamiento, exactamente a la mitad del precio de lista. La página de precios de la API muestra ambos:
| Modelo (por 1M de tokens) | Entrada | Entrada en caché | Salida |
|---|---|---|---|
| Mistral Large 4 (oferta de lanzamiento) | $0.68 | $0.07 | $2.09 |
| Mistral Large 4 (precio de lista) | $1.36 | $0.14 | $4.18 |
| Mistral Large 3 | $0.50 | $0.05 | $1.50 |
| Mistral Medium 3.5 | $1.50 | $0.15 | $7.50 |
| Mistral Small 4 | $0.15 | $0.015 | $0.60 |
| GLM 5.3 (alojado por Mistral) | $1.40 | $0.14 | $4.40 |
Hay tres cosas que me llaman la atención:
- La oferta no tiene fecha de fin. A precio de lista, la salida cuesta 2.8 veces lo que costaba Large 3. Presupuesta con $1.36 / $4.18 y trata la oferta como un extra.
- Deja por debajo a Medium 3.5, de la propia Mistral. En oferta, la salida de Large 4 cuesta $2.09 frente a $7.50 de Medium 3.5, así que hay pocos motivos para quedarse en Medium en cualquier trabajo nuevo.
- Batch es aún más barato. Las preguntas frecuentes de precios de Mistral dicen que las solicitudes batch cuestan un 50% menos y la entrada en caché hasta un 90% menos.
Si prefieres usarlo como aplicación de chat en vez de a través de una API, está dentro del producto para consumidores de Mistral, que ahora se llama Vibe (antes Le Chat): Free por $0, Pro por $14.99/mes, Team por $24.99/usuario/mes y Enterprise bajo petición. La página de precios no dice qué planes de Vibe incluyen Large 4, así que conviene comprobarlo antes de pagar una licencia por él. Mi guía completa de precios de Mistral AI desglosa los planes.
Cuánto cuesta una respuesta de soporte con Large 4
Los precios por token son más fáciles de valorar cuando tienen una carga de trabajo real asociada. Supongamos que una respuesta de soporte lee 8,000 tokens de entrada (el hilo del ticket más algunos artículos del centro de ayuda obtenidos con RAG) y escribe 3,000 tokens de salida, razonamiento incluido. Al precio de oferta son unos $0.012 por respuesta, y al precio de lista unos $0.023.
Es barato, y por eso diría a la mayoría de equipos de soporte que el precio por token rara vez es la partida que decide un despliegue de soporte con IA. Las respuestas erróneas y las horas dedicadas a vigilar al bot cuestan mucho más, que es también el tema de mi desglose del coste de un agente de soporte con IA.
Benchmarks de Mistral Large 4: los gráficos de Mistral frente a pruebas independientes
Mistral publicó muchos gráficos para este lanzamiento, y vale la pena leerlos con atención, porque son honestos de una forma algo inusual. Los propios gráficos de Mistral muestran que sus rivales superan a Large 4 en cuatro de los seis benchmarks que pude leer.
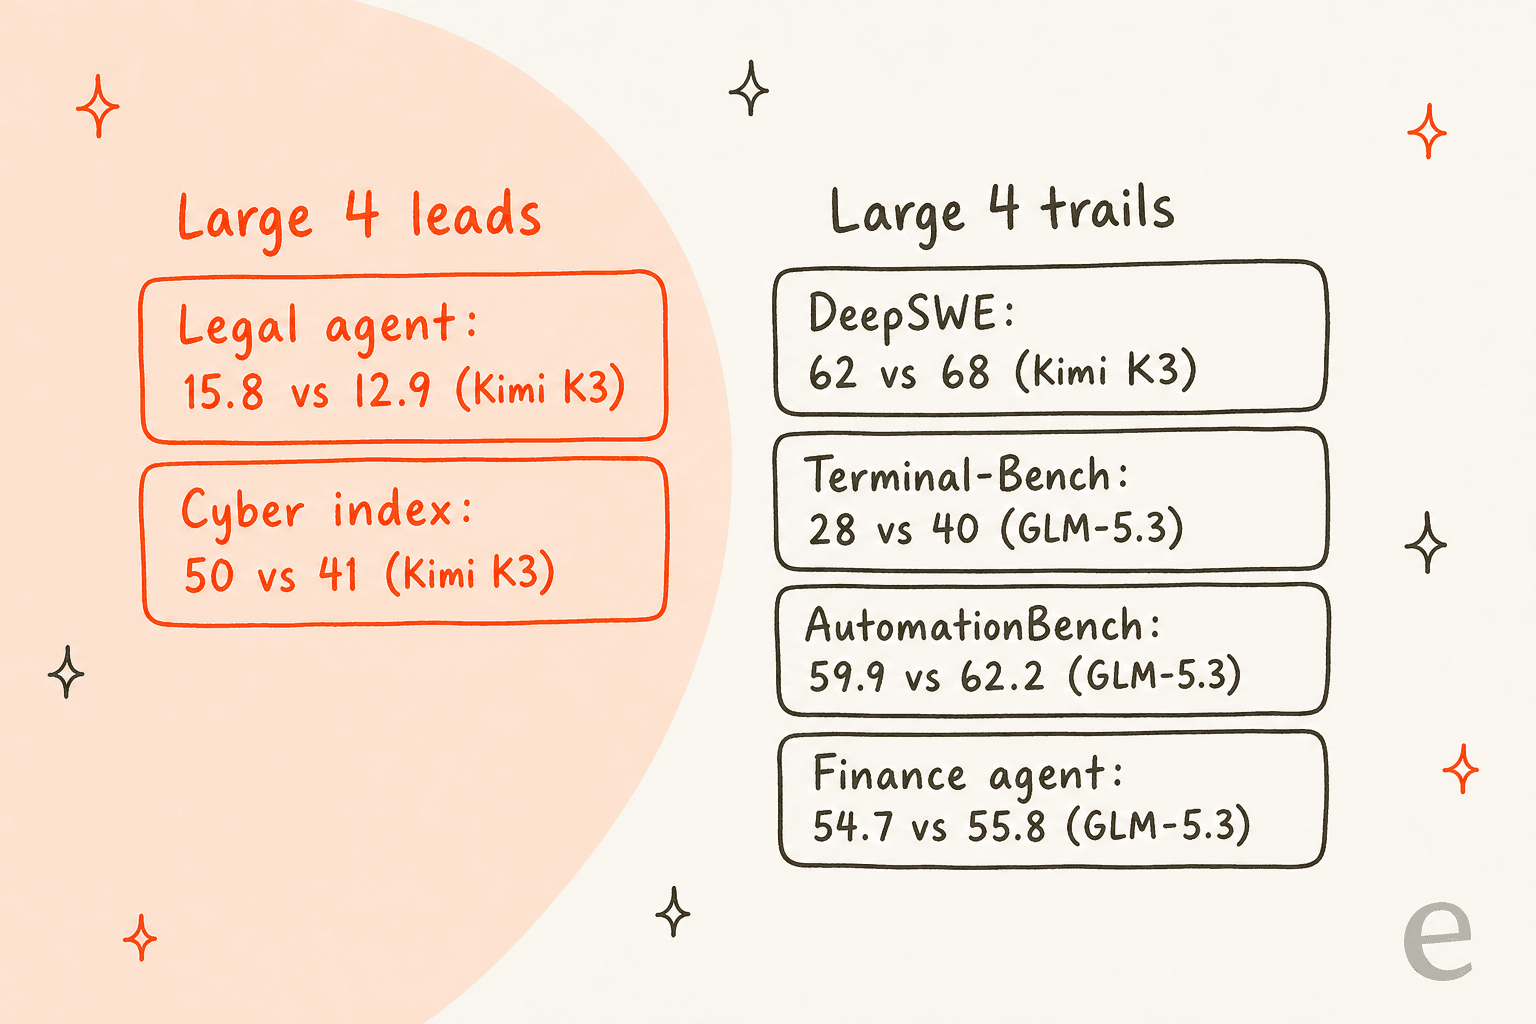
En programación, obtiene un 61.7% en DeepSWE v1.1 y un 28.3% en Terminal-Bench 4. Kimi K3 es superior en DeepSWE (68) y GLM-5.3 lo es en Terminal-Bench (40), ambos datos de los propios gráficos de Mistral.
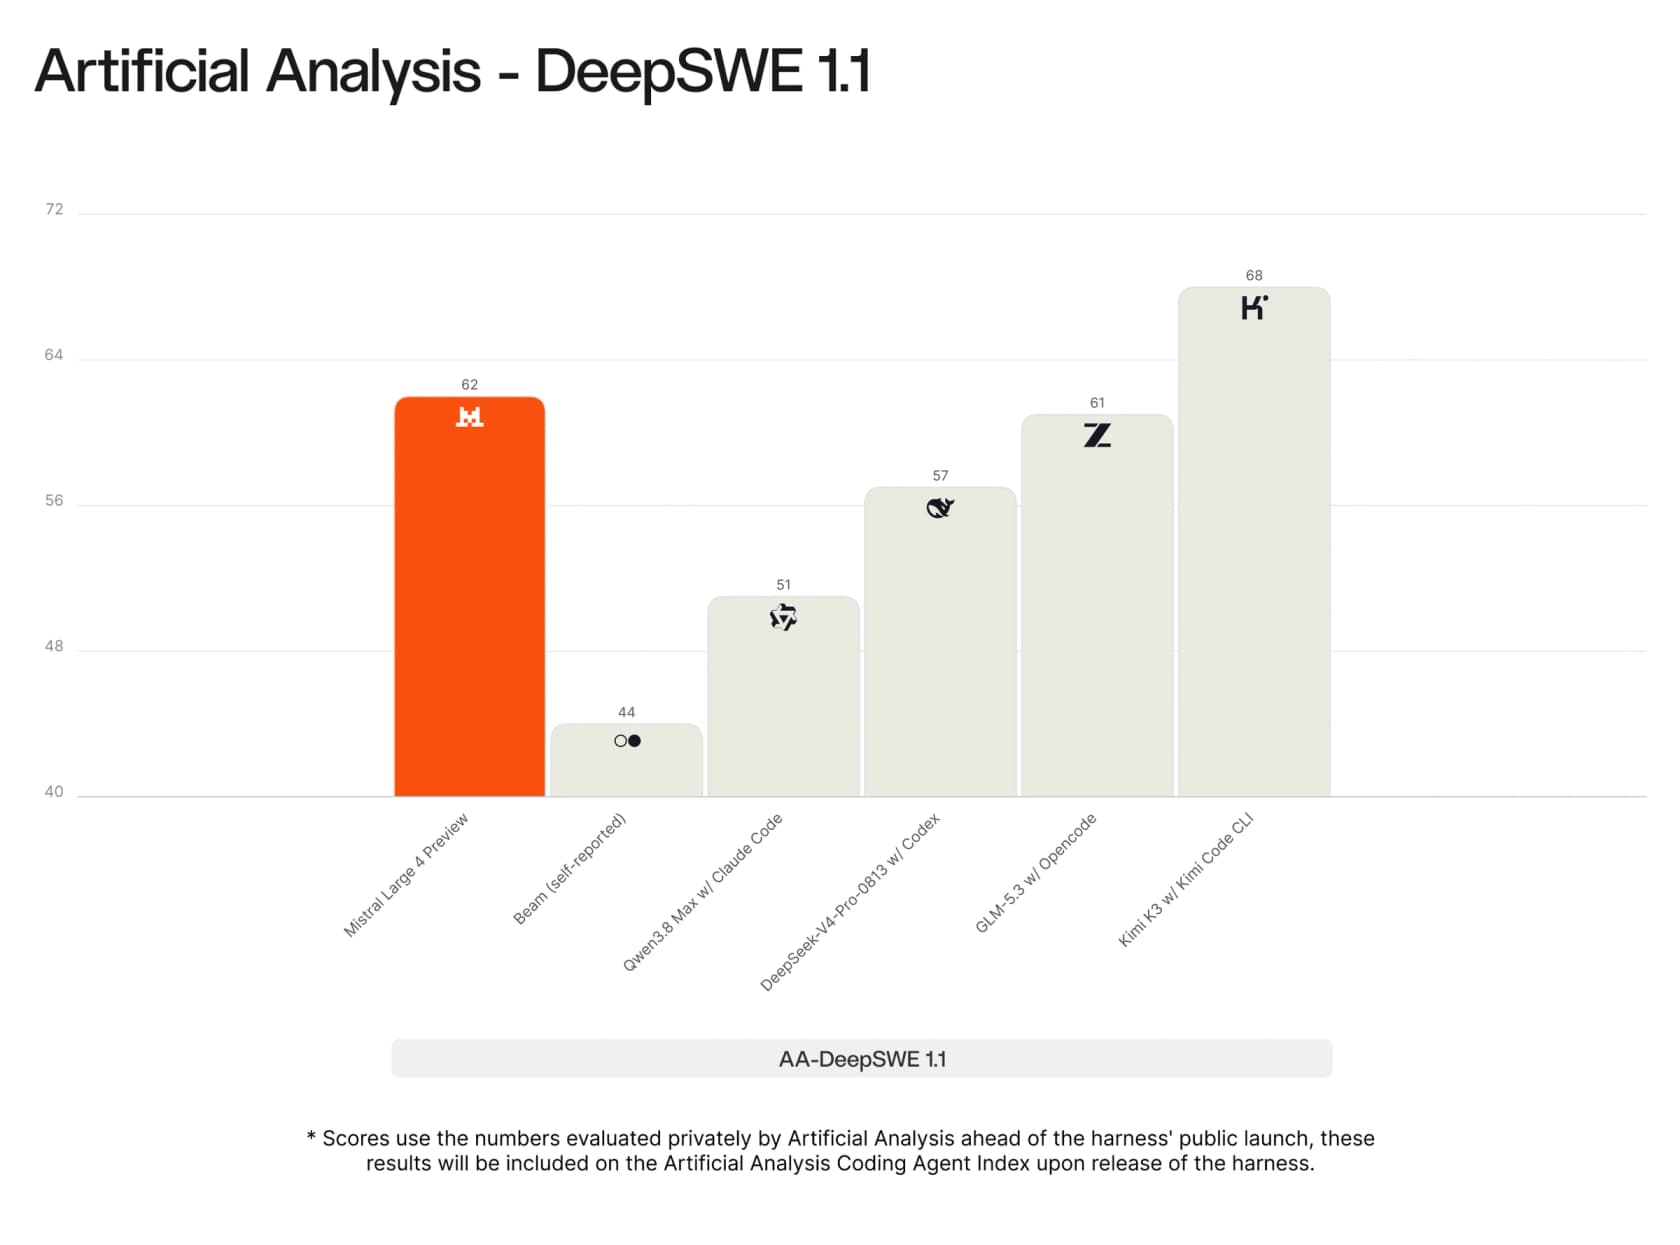
El panorama independiente de Artificial Analysis coincide con eso. Aquí está la posición de Large 4 en su Intelligence Index, con el coste de completar una tarea del benchmark:
| Modelo | AA Intelligence Index | Precio entrada / salida por 1M | Coste por tarea |
|---|---|---|---|
| Claude Sonnet 5.5 (Max) | 56.0 | $2 / $10 | $5.46 |
| Qwen 3.8 Max | 45.4 | $2 / $6 | $5.41 |
| Kimi K3 (Max) | 43.6 | $3 / $15 | $2.00 |
| Claude Haiku 5.5 (Max) | 43.4 | $0.10 / $0.50 | $0.21 |
| Gemini 3.8 Flash (High) | 40.9 | $0.75 / $3.75 | $1.24 |
| DeepSeek V4.1 Flash (Max) | 39.5 | $0.30 / $1.20 | $0.27 |
| Mistral Large 4 Preview | 38.4 | $1.36 / $4.18 | $1.13 |
| GPT-5.6 Luna (Max) | 37.3 | $0.20 / $1.20 | $0.18 |
| DeepSeek V4 Pro (Max) | 36.0 | $1.32 / $3.96 | $0.67 |
| Mistral Large 3 | 9.3 | $0.50 / $1.50 | $0.03 |
Hay dos lecturas de la misma tabla, y ambas son ciertas. Frente al pasado de Mistral, Large 4 es un salto generacional: 4.1 veces la puntuación de Large 3. Frente al panorama actual, queda por detrás de Kimi K3 y Qwen 3.8 Max, y aterriza justo por debajo de DeepSeek V4.1 Flash y justo por encima de GPT-5.6 Luna, que cuestan una fracción por tarea.
La razón es el apetito de tokens. Artificial Analysis contó 69,330 tokens de salida por tarea para Large 4, de los cuales 52,011 fueron de razonamiento. Large 3 usó 5,566. Un modelo de razonamiento que piensa tanto convierte un precio por token moderado en un precio por tarea alto.
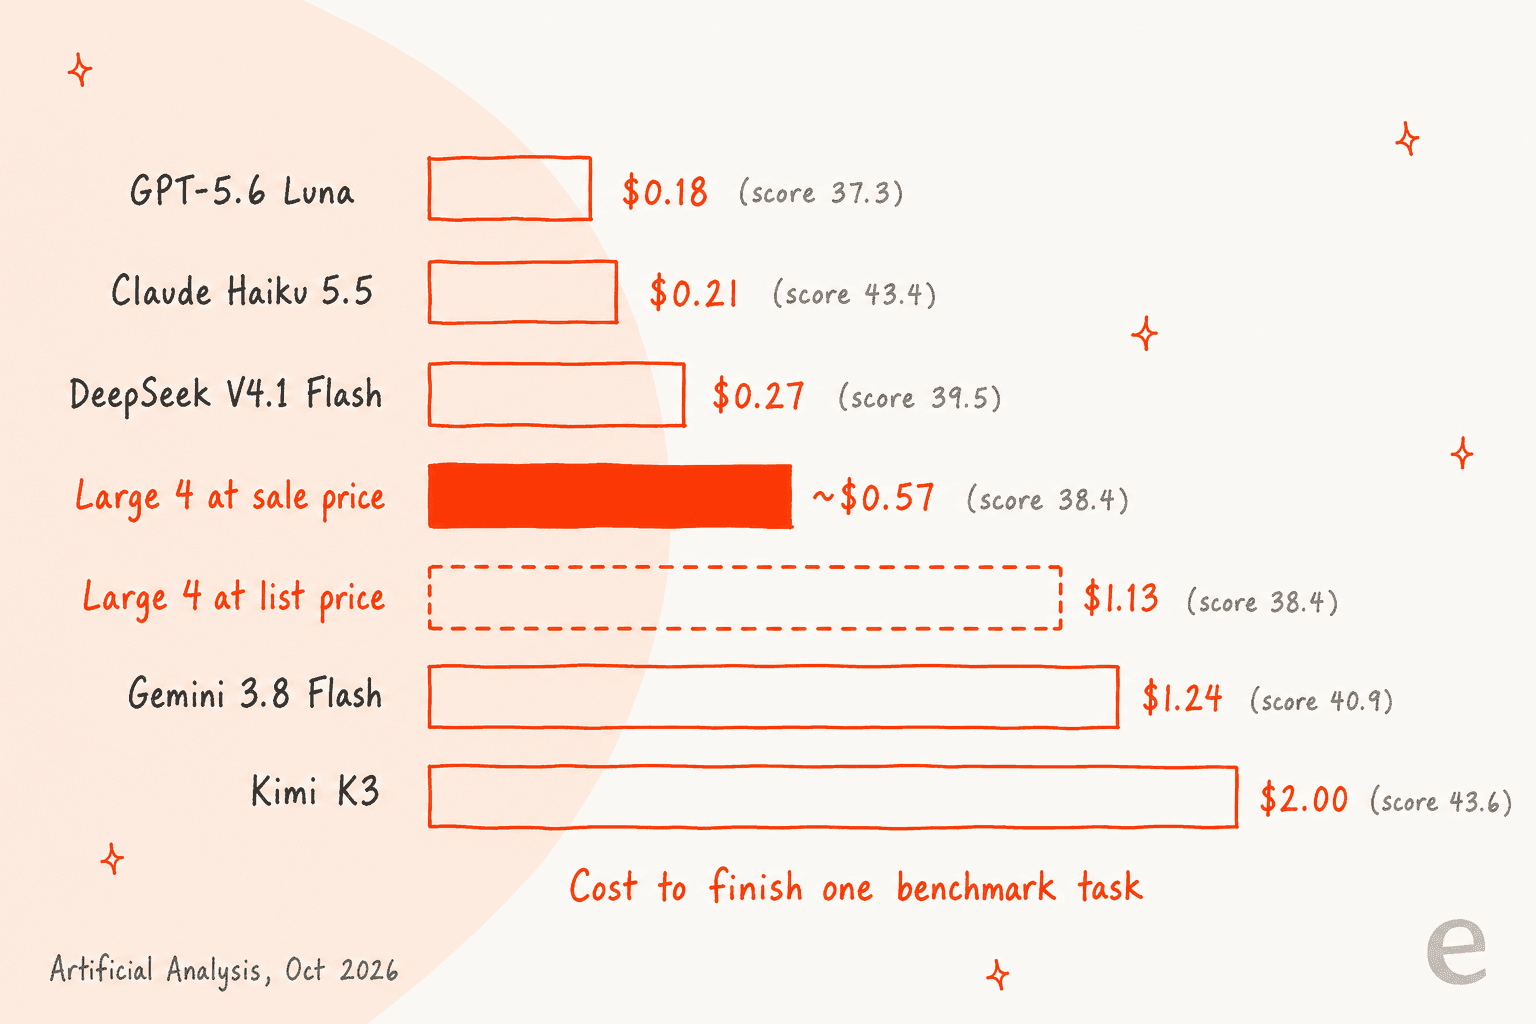
Artificial Analysis fija el precio de sus ejecuciones a tarifas de lista, y como la oferta reduce a la mitad todas las tarifas, incluida la entrada en caché, el precio de oferta resulta en unos $0.57 por tarea. Sigue siendo aproximadamente el doble que DeepSeek V4.1 Flash para una puntuación algo menor. Si comparas modelos abiertos por coste, mis artículos sobre los precios de DeepSeek V4 Flash y los precios de Kimi K3 tienen las tarifas completas.
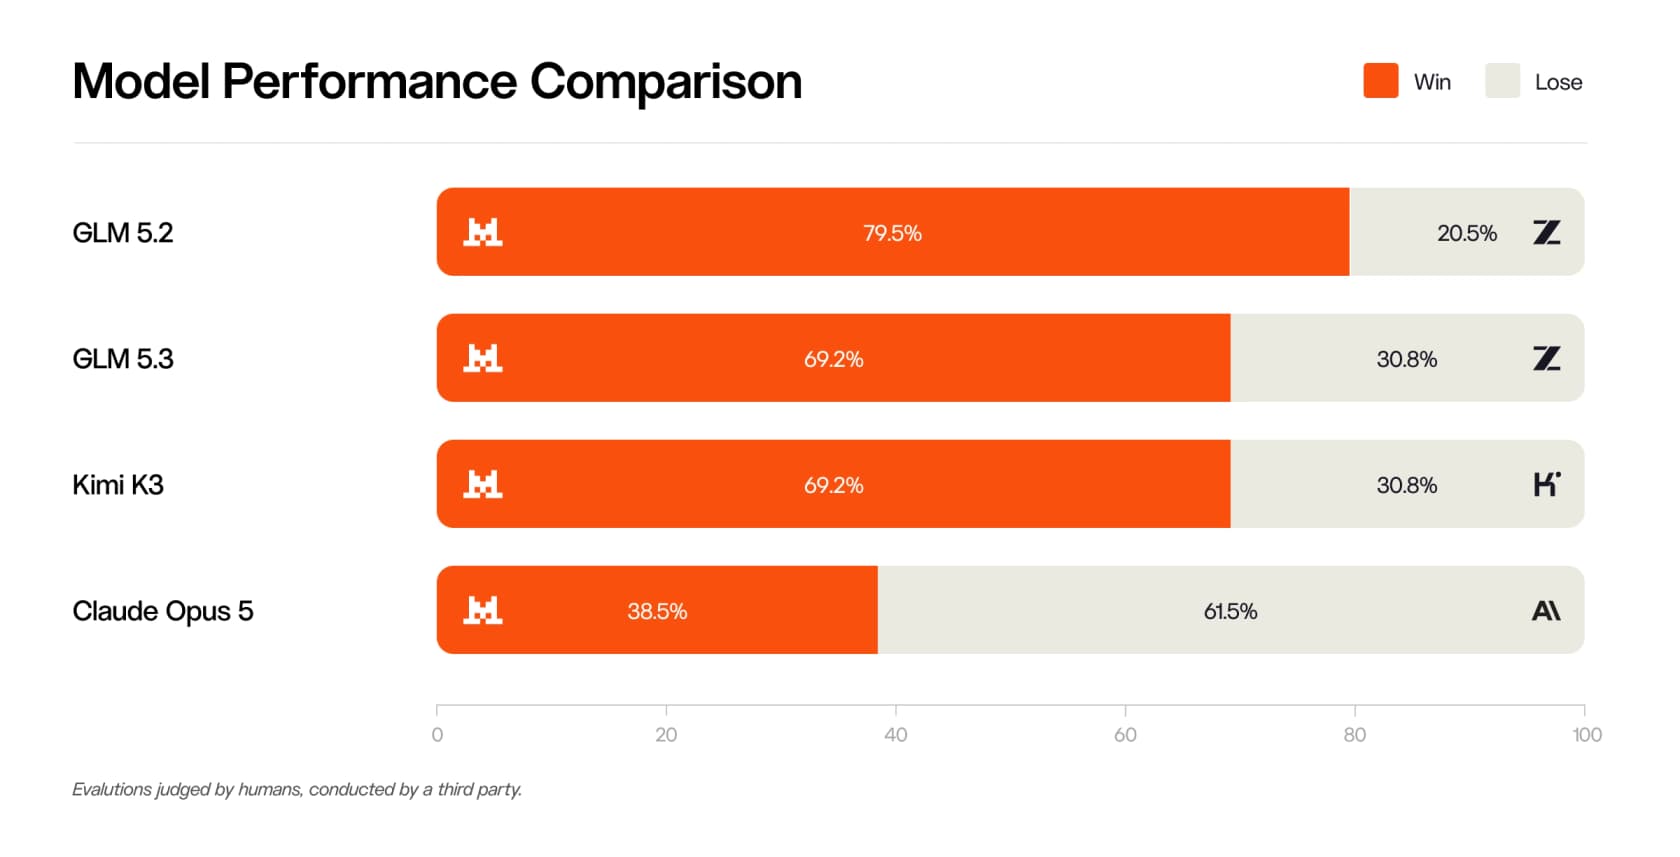
Los evaluadores humanos cuentan una historia más amable que el índice. En las evaluaciones humanas de Mistral, realizadas por un tercero, Large 4 ganó el 69.2% de los enfrentamientos directos tanto contra GLM-5.3 como contra Kimi K3, y el 38.5% contra Claude Opus 5.
Dónde destaca más Mistral Large 4
Si quitas el índice general, aparece una forma clara: Large 4 no es el mejor generalista, pero sí lidera en unos pocos puntos concretos.
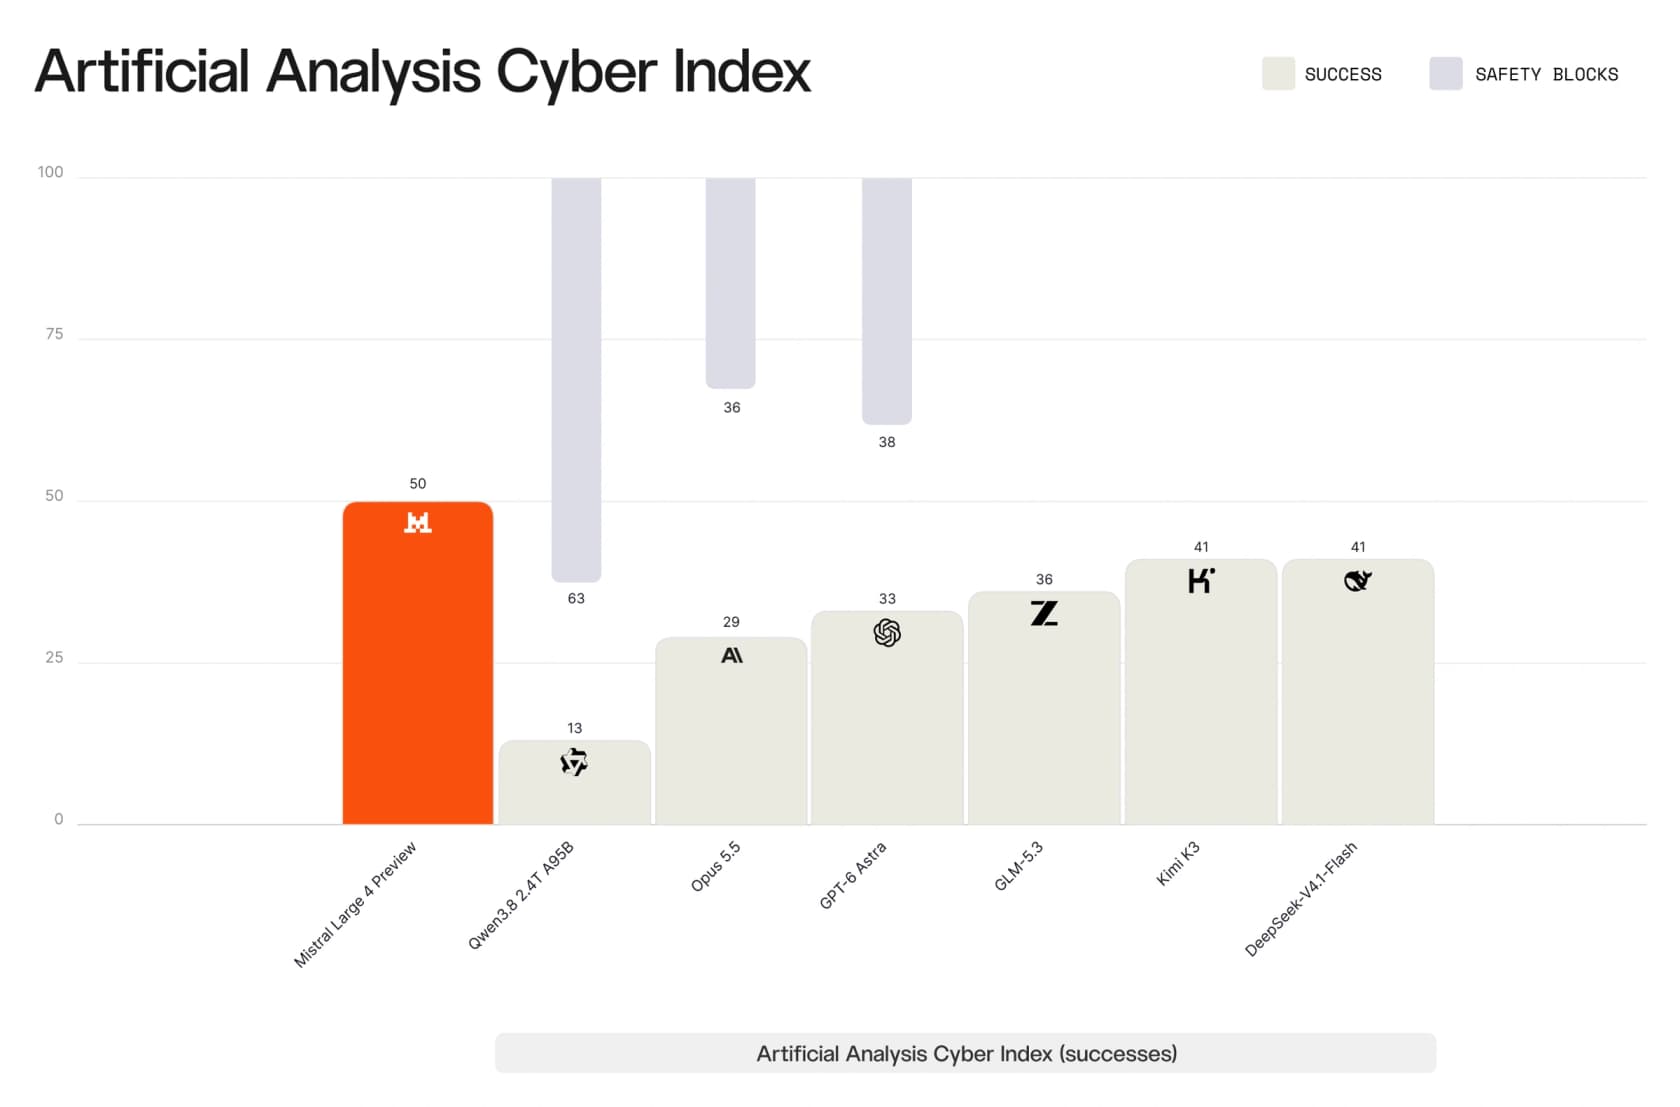
Defensa en ciberseguridad. Es la afirmación estrella, y las cifras la respaldan. Large 4 obtuvo 50 en el Artificial Analysis Cyber Index, por delante de Kimi K3 con 41, GPT-6 Astra con 33 y Claude Opus 5.5 con 29, según el artículo de lanzamiento de Mistral. Alcanzó un 82% en una prueba de reproducir y luego parchear y un 93% en Cybench. En esa prueba de parcheo, Mistral señala que los modelos cerrados de frontera "score near zero on the same test because they refuse", así que parte de la ventaja ahí tiene que ver con la disposición, no con la habilidad.
El cofundador de Mistral Guillaume Lample defendió la idea directamente:
"Open models are the best defense for enterprises today: capable, auditable, self-hosted and governed under enterprise policies -- and more importantly, they do not refuse to help."
Trabajo de agentes legales. En el benchmark Harvey Legal Agent de Vals.ai obtuvo 15.8, por delante de Kimi K3 con 12.9 y GPT-6 Astra con 5.4. Las cifras absolutas son bajas, pero la ventaja es clara.
Documentos largos y gráficos. Obtuvo un 81.3% en la prueba de razonamiento de contexto largo de Artificial Analysis (AA-LCR) y un 42% en Dense 200 visual grounding, superando por poco el 41% de GPT-6 Astra. El equipo de datos de Plotly vio lo mismo en la práctica (más abajo).
Seguridad ante ataques. Resistió el 93.3% de los ataques en el benchmark de seguridad de agentes Lakera B3, la puntuación más alta que Mistral reportó entre los competidores.
Qué dice la comunidad sobre Mistral Large 4
El hilo de lanzamiento en Hacker News llegó a 1,990 puntos y 1,144 comentarios, y el ambiente está dividido más o menos como sugiere la tabla de benchmarks: la gente se impresiona con el salto, pero no está convencida de que supere al resto.
La prueba práctica más útil vino de alguien en Plotly que lo ejecutó en su benchmark de analítica de datos:
"It's 10x cheaper than Mistral Medium 3.5 from April and goes from 58% to 74% correct. Definitely a generational shift. It's not on the Pareto curve yet, but it's good enough for data analytics"

El precio salió mucho en las respuestas. Un comentarista lo puso junto a los modelos "flash" más baratos:
"So, I think it would have to be significantly better than GLM 5.3-flash to be worth it. GLM 5.3-flash is already very good."
Para el cara a cara con modelos cerrados, mis comparativas Claude vs Mistral y ChatGPT vs Mistral son una buena lectura siguiente.
Reddit fue más duro. En r/LocalLLaMA, un usuario que ejecuta su propio benchmark de ajedrez escribió:
"Played around with it a bit, for code analysis, image classifications, and chess capability. Feels quite dated and far behind what I usually utilize."

Y aun así el argumento de la soberanía vuelve una y otra vez, que es el que yo tomaría más en serio para los compradores de empresa:
"In most corporate workflows, it is probably good enough. And you don't have to sell your soul to Xi or Trump. As a european, I had feared much worse."
La respuesta con más me gusta al artículo de lanzamiento de Mistral en X fue un chiste que dice mucho sobre el enfoque "open weights": "me with 12 GB of VRAM reading 'open weights, 1.05T parameters'" (An Xuan en X). Lo cual me lleva a la parte que, por ahora, sigue siendo solo una promesa.
Open weights: qué significa "abierto" hoy
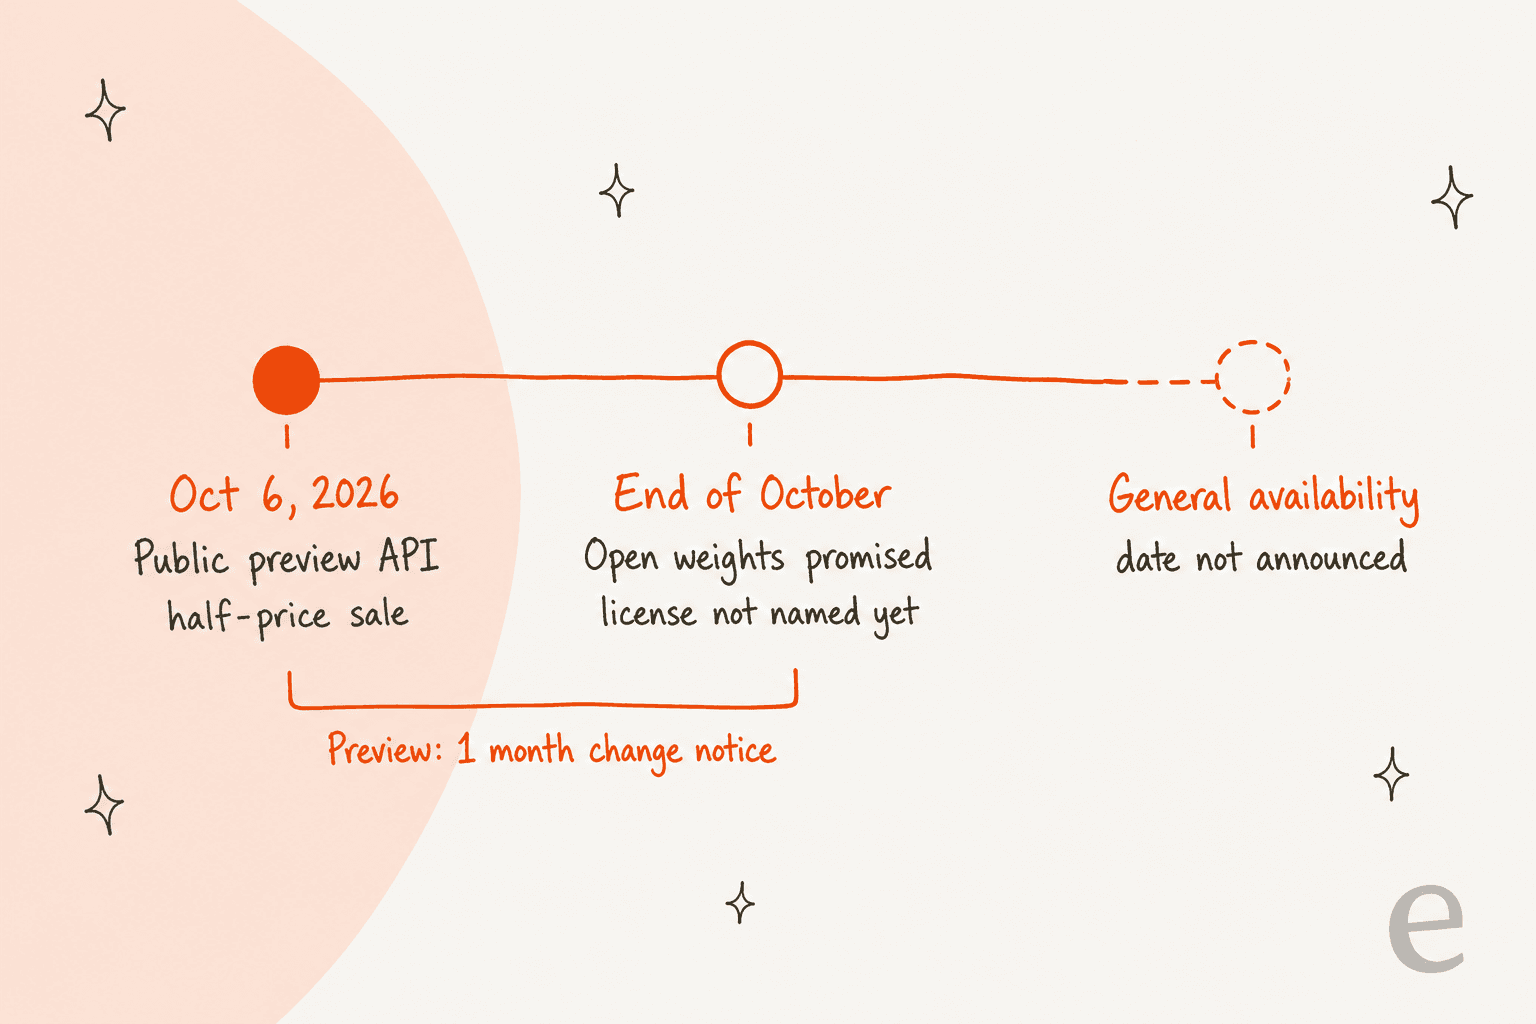
Mistral etiqueta Large 4 como open-weight, pero a fecha de 8 de octubre de 2026 no puedes descargarlo. No hay ningún repositorio de Mistral Large 4 en la página de Mistral en Hugging Face y no se ha nombrado ninguna licencia. Lample dice que la ejecución de RL "is still in flight" y que una versión final llegará con los pesos antes de fin de mes.
Eso tiene dos consecuencias prácticas para ti:
- Los benchmarks pueden cambiar. El modelo que pruebas hoy es una preview, y la política de ciclo de vida de Mistral da a los modelos en Public Preview solo un mes de aviso antes de los cambios, frente a seis meses en disponibilidad general. Vuelve a ejecutar tus evaluaciones cuando llegue la versión final.
- La licencia lo decide todo. Large 3 se publicó bajo Apache 2.0, mientras que Medium 3.5 usa una licencia MIT modificada. Hasta que Mistral nombre una para Large 4, "abierto" es una dirección, no un contrato.
Incluso con los pesos, la mayoría de los equipos no lo ejecutarán por su cuenta, ya que con 1.05T de parámetros estás en territorio de servidores multi-GPU, así que los caminos realistas son la API de Mistral, un despliegue europeo a través de Mistral o un proveedor de alojamiento cuando aparezcan. Si quieres algo que puedas ejecutar hoy en tu propio hardware, mi lista de alternativas a Mistral incluye modelos abiertos más pequeños.
¿Deberías usar Mistral Large 4 para atención al cliente?
Es la pregunta que más me hacen, así que esta es mi respuesta directa: Large 4 puede escribir una buena respuesta de soporte, pero nunca debería responder de memoria.
En la prueba de conocimiento de Artificial Analysis (AA-Omniscience), respondió correctamente el 25.8% de las preguntas y tuvo una tasa de alucinación del 41.9%, lo que significa que cuando no sabía la respuesta, a menudo simplemente adivinaba. En un helpdesk, una conjetura segura sobre tu política de reembolsos o sobre la compatibilidad de tu producto es la peor respuesta posible.
He visto este modo de fallo de cerca. En una llamada de ventas de eesel, un equipo danés B2B de telemática de vehículos que usa Zendesk con unos 200 tickets al mes temía que su bot confirmara modelos de coche no compatibles, porque su base de conocimiento decía "we support all models". Un modelo mejor no lo habría arreglado, porque el modelo leía bien los documentos y los documentos estaban mal. Por eso cada despliegue en el que trabajo se prueba con tickets históricos antes de salir en vivo, y por eso las guías para evitar las alucinaciones empiezan por la base de conocimiento, no por el modelo.
Una responsable de CX de una marca de suplementos DTC, que gestiona unos 7,000 tickets, expresó el requisito real mejor que cualquier benchmark:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
La latencia es lo segundo que hay que comprobar. Con el razonamiento activado, Artificial Analysis midió unos 18.7 segundos hasta el primer token de respuesta con un prompt largo. Está bien para correos y respuestas a tickets, pero es lento para el chat en vivo, donde querrías un reasoning_effort más bajo o un modelo más rápido. Mi comparativa del mejor modelo de IA para tickets profundiza en este equilibrio.
Así lo resumiría para un equipo de soporte:
| Caso de uso | Encaje de Large 4 | Por qué |
|---|---|---|
| Redactar respuestas para que las revisen los agentes | Bueno | Buena redacción, barato por respuesta, una persona en el circuito revisa el resultado |
| Respuestas autónomas por correo o ticket | Solo con barreras de seguridad | Necesita basarse en tus documentos, una puntuación de confianza y un respaldo humano |
| Chat en vivo | Débil con el razonamiento activado | ~18.7 s hasta el primer token de respuesta |
| Requisitos de residencia de datos en la UE | Fuerte | Creado y servido en Europa por Mistral |
| Leer capturas de pantalla y PDF que adjuntan los clientes | Fuerte | Entrada de imágenes nativa, buenas puntuaciones en documentos y gráficos |
Si estás eligiendo entre modelos para un stack de soporte, mi guía del mejor LLM para soporte compara las opciones principales, y RAG vs fine-tuning explica por qué basar las respuestas en tus documentos supera al entrenamiento en los centros de ayuda.
El modelo es infraestructura, eesel es el empleado
Este es el cambio que te pediría que hicieras. Un modelo como Mistral Large 4 es infraestructura: un motor que predice texto. Lo que un equipo de soporte necesita de verdad es un compañero que conozca el producto, trabaje dentro del helpdesk, sepa cuándo derivar y pueda comprobarse antes de hablar con los clientes. Elegir el motor es la mitad fácil del trabajo.
Karel, de GENERAL BYTES, lo dijo claro al explicar por qué su equipo no construyó el suyo:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Ese es el trabajo de eesel, una plataforma de compañeros de equipo con IA donde contratas compañeros listos para trabajar en tareas concretas.
Para soporte, es el compañero de equipo de helpdesk con IA: se conecta a Zendesk, Freshdesk o Gorgias, aprende de tus tickets anteriores y tu centro de ayuda, y ejecuta una simulación sobre cientos de tus tickets pasados para que veas cómo habría respondido antes de activarlo. Para equipos de contenido, el redactor de blogs con IA hace lo mismo con artículos largos.
Si lo estás comparando con la IA integrada de tu helpdesk, comparé por separado eesel vs Zendesk AI.
Para ser claros con los límites: eesel funciona con modelos de OpenAI, Anthropic y Google, según su página de seguridad, así que Mistral Large 4 no es hoy una opción que puedas elegir dentro de eesel. Si tu requisito es específicamente "un modelo de Mistral, alojado en Europa", llamar directamente a la API de Mistral es la ruta más directa.
Si llegaste a Large 4 porque quieres control a nivel de API, la CLI de eesel te lo da sobre el propio compañero de equipo. npx @eesel/cli init chat-bubble --site <your-site> crea una burbuja de chat entrenada con tu sitio sin cuenta, cada comando devuelve JSON para que Claude Code, Cursor o Codex puedan dirigir la configuración, y eesel mcp token convierte tu espacio de trabajo en un servidor MCP. Es el mismo agente que el del panel, así que todo lo que configures desde el terminal aparece también allí. Mi artículo sobre las CLI de agentes de IA explica por qué importa.
Prueba eesel
Si estás evaluando Mistral Large 4 porque quieres una IA que responda tickets de soporte, yo empezaría un paso más arriba. El compañero de equipo de helpdesk de eesel se une a tu cola de Zendesk, Freshdesk o Gorgias en minutos, aprende de los tickets que tu equipo ya respondió y te muestra una simulación puntuada sobre esos tickets pasados antes de responder a nadie. Ves las respuestas erróneas en un informe, no en la bandeja de entrada de un cliente.

El plan gratuito incluye 100 créditos sin tarjeta, y los planes de pago empiezan en $299/mes por 500 tickets o chats, según los precios de eesel. Prueba eesel con una parte de los tickets del mes pasado y mira cómo le va.
Preguntas frecuentes
¿Qué es Mistral Large 4?
¿Cuánto cuesta Mistral Large 4?
¿Mistral Large 4 es de código abierto?
¿Es Mistral Large 4 mejor que Kimi K3 o Qwen 3.8 Max?
¿Es bueno Mistral Large 4 para atención al cliente?
¿Cuál es el nombre del modelo Mistral Large 4 en la API?
mistral-large-4 y acepta un parámetro reasoning_effort. Admite function calling, salidas estructuradas, batching y la Agents API. Los modelos en preview tienen un mes de aviso antes de los cambios, así que fija tus pruebas a él antes de construir un agente de IA encima.