

En resumen
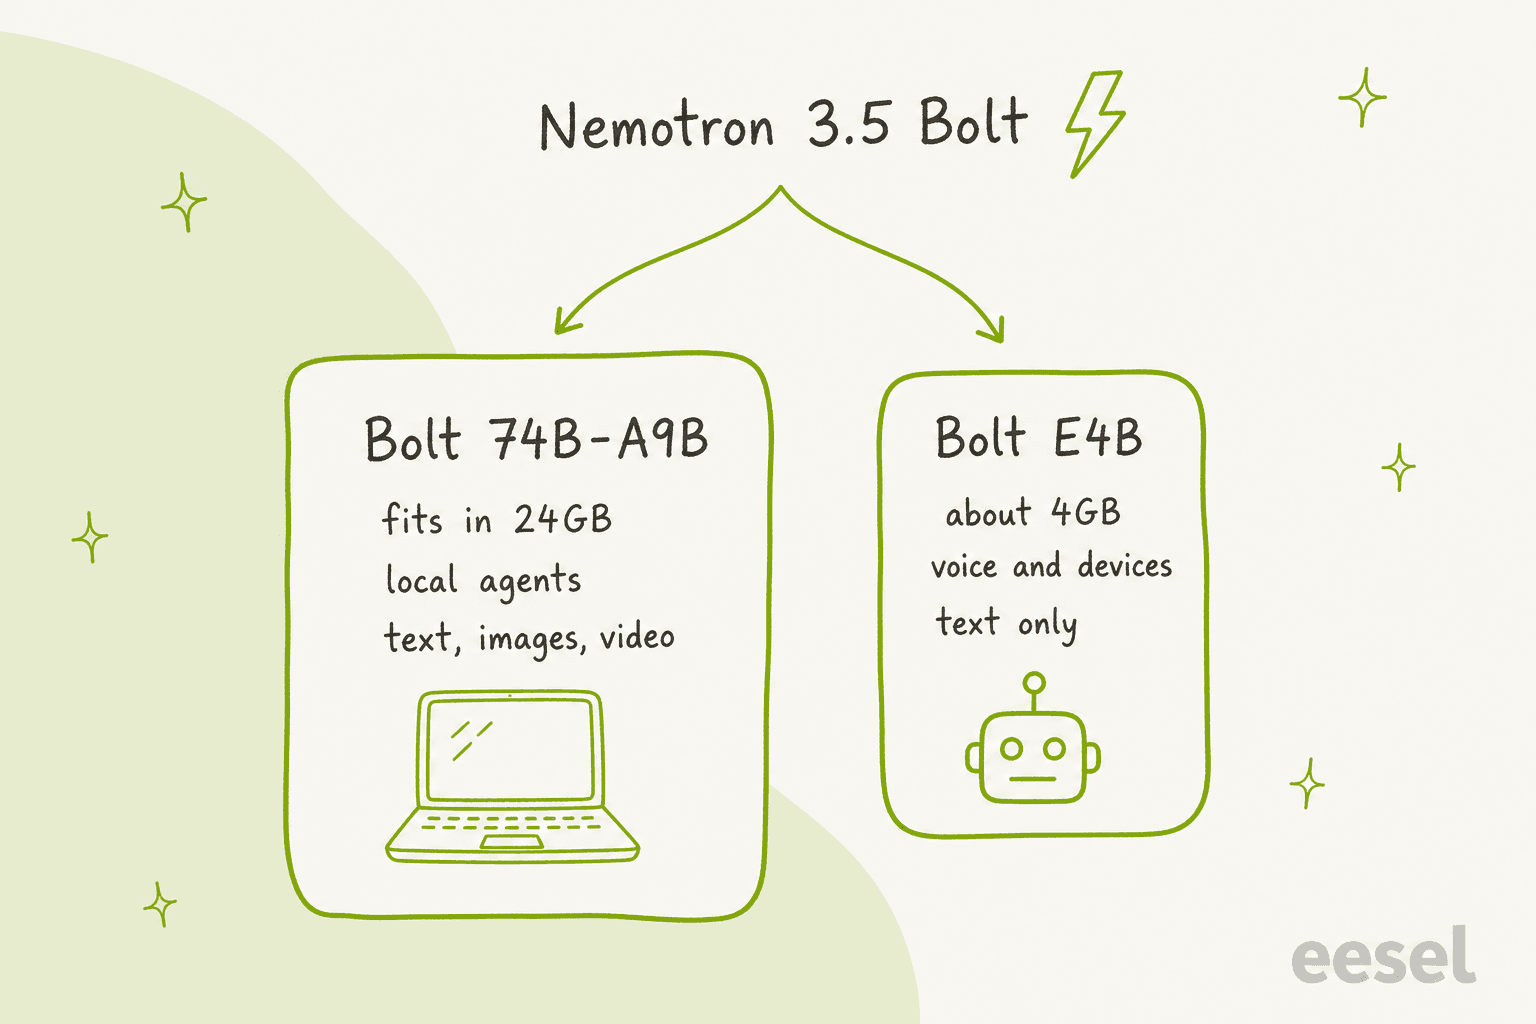
Nemotron 3.5 Bolt es la nueva familia de modelos abiertos de NVIDIA diseñada para ejecutarse en tu propio equipo, y son dos modelos, no uno. Bolt 74B-A9B comprime un modelo de 74B parámetros en 24GB con pesos de 2 bits para que los agentes locales puedan ejecutarse en una sola GPU de consumo. Bolt E4B es un modelo de 4GB para asistentes de voz, personajes de videojuegos y dispositivos.
El modelo de 74B obtiene 21 en el Artificial Analysis Intelligence Index, ocupa el cuarto puesto entre los modelos de menos de 100B parámetros y queda a menos de 2 puntos de Nemotron 3 Ultra de NVIDIA, de 550B. Los pesos son gratuitos bajo OpenMDW-1.1, y todavía no hay una API de pago para ninguno de los dos Bolt, así que tu factura es tu hardware.
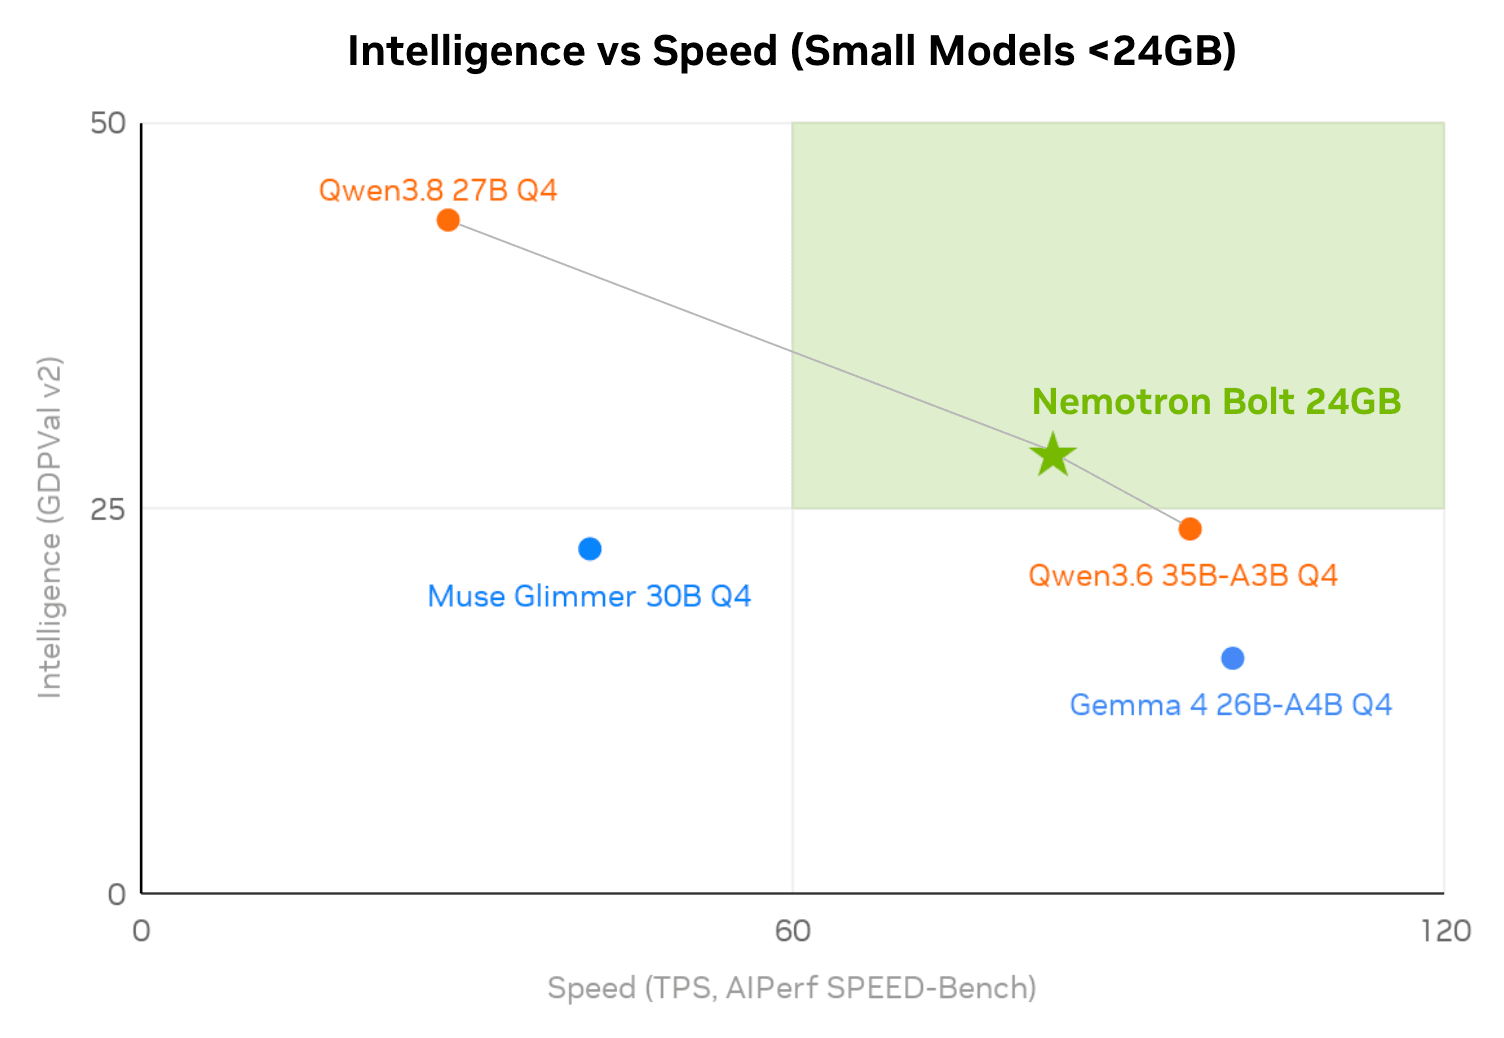
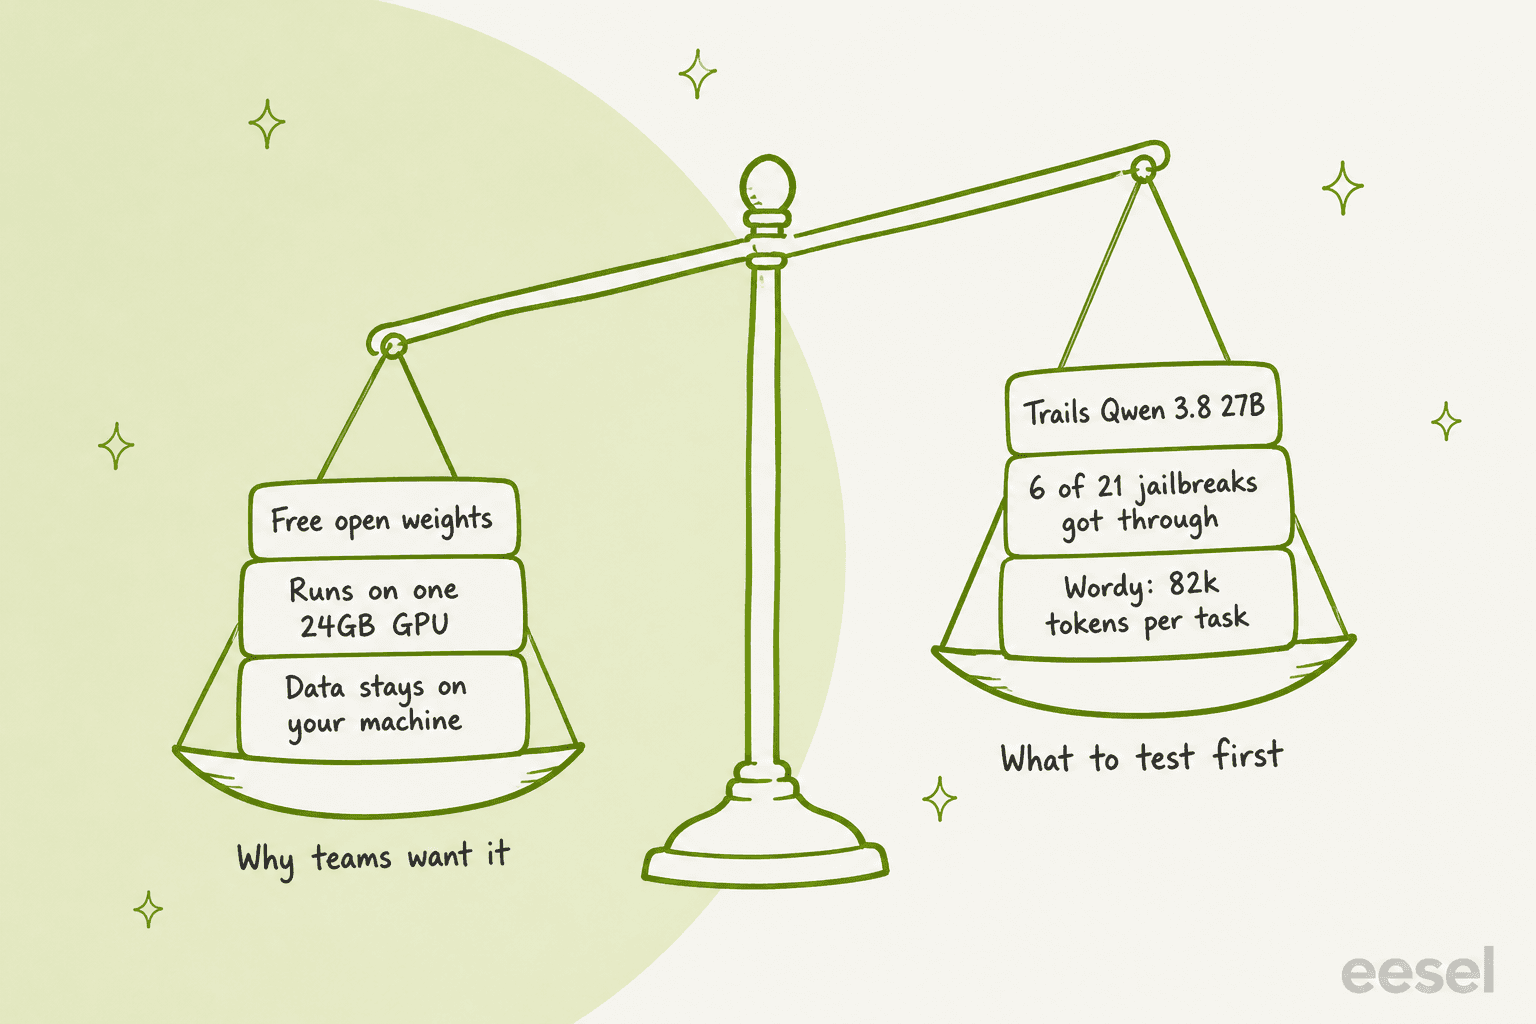
La pega: el modelo denso Qwen3.8 27B sigue siendo más inteligente (44.5 frente a 28.5 en el propio gráfico GDPVal v2 de NVIDIA), Bolt se extiende demasiado y una persona que lo probó vio que fallaba en 6 de 21 pruebas de jailbreak. Para los equipos de soporte es un motor prometedor para trabajar de forma privada en el dispositivo, no un sistema que activas y empieza a responder tickets. Si eso es lo que quieres hoy, el compañero de soporte con IA de eesel responde solo a partir de tus propios documentos y se prueba con tus tickets anteriores antes de responder a nadie.
Por qué leí el informe técnico de Bolt
Desarrollo funciones y agentes de IA en eesel, así que paso la mayor parte de la semana en la parte intermedia y aburrida de un agente: qué entra en el contexto, qué herramienta llama y qué pasa cuando el modelo se equivoca. La pregunta que más escucho de compradores técnicos no es «¿qué tan inteligente es?», sino «¿adónde van nuestros datos?». En una llamada de ventas este año, un evaluador de una empresa de hardware preguntó si la IA recurriría a "some kind of other ChatGPT" cuando no supiera una respuesta, y si su conocimiento se mantendría dentro de su organización.
Un modelo que puedes ejecutar en un equipo debajo de tu propio escritorio es una respuesta honesta a esa pregunta. Así que, cuando NVIDIA lanzó un modelo cuyo principal argumento es "fit a big model in 24GB," leí la ficha del modelo, el informe técnico y todas las pruebas de usuarios que pude encontrar. Esto es lo que se sostiene y lo que necesita una nota al pie.
¿Qué es Nemotron 3.5 Bolt?
Nemotron 3.5 Bolt es la línea "edge" de NVIDIA dentro de la familia Nemotron 3.5. NVIDIA lo anunció el 15 de octubre de 2026 junto con Nemotron 3.5 Super VL, y describe la familia así: Lightning se encarga de las cargas de trabajo de alto rendimiento, Ultra se ocupa del razonamiento más difícil y "Bolt brings intelligence to the edge."
El nombre engloba dos modelos muy distintos, algo que ha causado confusión en buena parte de la cobertura inicial:
- Bolt 74B-A9B 24GB es el modelo principal. Está "designed to run everyday agentic tasks locally on NVIDIA RTX/DGX Spark, using a native 2-bit quantization to fit in 24GB of memory," según NVIDIA.
- Bolt E4B 4GB llegó el 23 de octubre. Es un modelo de 8B con 4B parámetros efectivos, basado en Gemma 4 E4B de Google con posentrenamiento de Nemotron, para "fast local voice assistants, interactive characters and embedded interfaces."
Aquí tienes las especificaciones en paralelo:
| Especificación | Bolt 74B-A9B 24GB | Bolt E4B 4GB |
|---|---|---|
| Lanzamiento | 15 de octubre de 2026 | 23 de octubre de 2026 |
| Parámetros | 74B en total, 9B activos por token | 8B en total, 4B efectivos |
| Basado en | Nemotron 3.5 Super VL (120B), comprimido | Gemma 4 E4B, con posentrenamiento |
| Arquitectura | Mezcla de expertos híbrida de Mamba-2 y Transformer | Gemma 4 E4B |
| Formato de los pesos | Expertos de 2 bits (IQ2_XXS), 22.1GB | 4 bits (Q4_K_M) |
| Entradas | Texto, imágenes, video (MP4 de hasta 2 minutos) | Texto |
| Ventana de contexto | Hasta 256K tokens | 64K tokens |
| Hardware objetivo | RTX Spark, DGX Spark, GeForce RTX, RTX PRO | GeForce RTX, Jetson, RTX/DGX Spark |
| Licencia | OpenMDW-1.1 | OpenMDW-1.1, más Apache 2.0 para la base Gemma |
Ambos tienen un razonamiento que puedes activar o desactivar, y el modelo de 74B admite llamadas a herramientas y salida JSON. Si has seguido lanzamientos abiertos como Meta Muse Spark Open o Kimi K3, la diferencia aquí es el objetivo: Bolt está diseñado para un solo equipo, no para un centro de datos.
¿Cómo consigue NVIDIA que un modelo de 74B quepa en 24GB?
La versión corta: empieza con algo grande, recórtalo y luego reduce cada número. La página de investigación de NVIDIA expone el objetivo con claridad: "fit into 24GB of memory and achieve a decoding speed of at least 80 TPS, while maximizing intelligence." Lo consigue en cuatro pasos.
- Comprimir un modelo más grande. Bolt parte de Super VL, que tiene 120B parámetros y selecciona 22 expertos por token. El método Star Elastic de NVIDIA lo poda hasta 74B y fija el número de expertos en 9. Por sí solo, eso cuesta 2.85 puntos de precisión media, un 4,94 % respecto al modelo original, según el informe técnico.
- Recuperarlo con entrenamiento. Después, Bolt recibe 120B tokens de entrenamiento de recuperación, se le reincorpora la visión y pasa por ajuste fino supervisado y aprendizaje por refuerzo. La parte de visión es la que más lo necesita: la compresión redujo la puntuación de WebArena de 57.4 a 1.35, y el entrenamiento la devolvió a alrededor de 50.
- Cuantizar los expertos a 2 bits. Los pesos de los expertos se almacenan a 2.0625 bits cada uno, usando destilación consciente de la cuantización para que el modelo pequeño aprenda a igualar al grande con esa precisión. Las capas Mamba usan NVFP4 de 4 bits, y la atención y los embeddings se mantienen en 8 bits. Eso reduce el modelo de 148GB a 22.1GB, "an 85.1% reduction in size. This quantization is lossy by design," dice NVIDIA.
- Añadir un modelo de borrador para ganar velocidad. Un modelo independiente de 1.13B parámetros llamado LiLiCorr predice varios tokens por adelantado y el modelo principal los comprueba, que es como NVIDIA consigue 84 tokens por segundo en RTX Spark.
La apuesta de NVIDIA es que un modelo grande reducido a 2 bits supera a un modelo pequeño entrenado a 4 bits. Es lo contrario de cómo se construye la mayoría de los modelos locales, y es la idea nueva de este lanzamiento.
Una nota al pie sobre los "24GB" del nombre. La tabla de memoria del informe técnico suma 23.83GB solo para texto. El codificador de visión necesita otros 1.68GB.
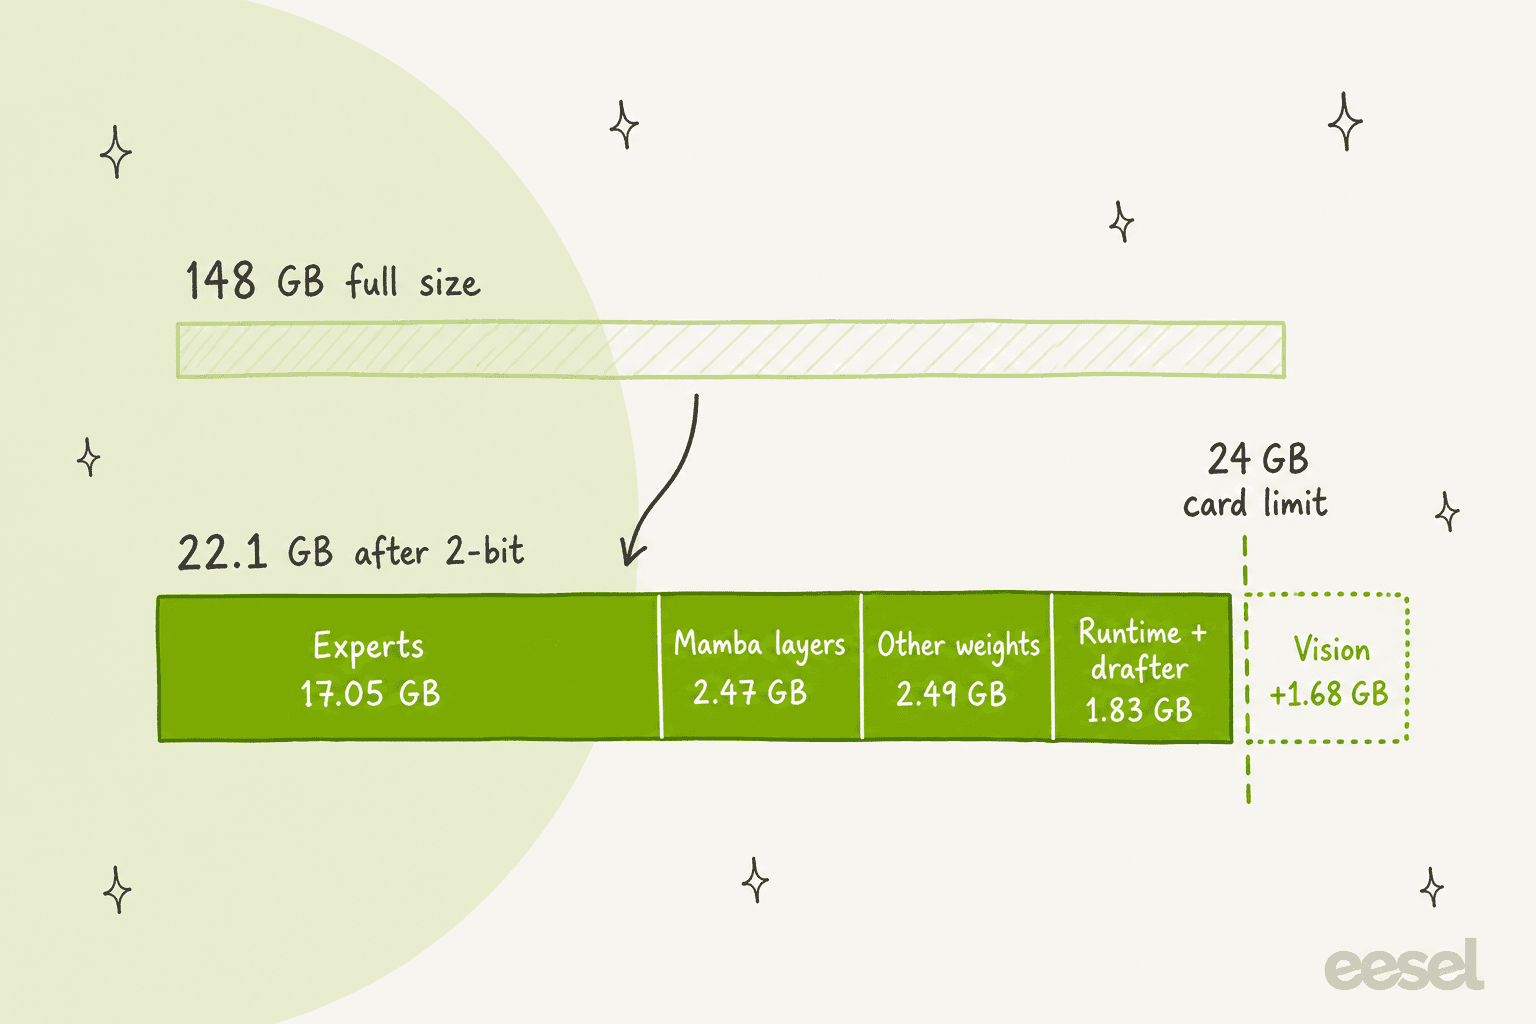
Así que en una tarjeta de 24GB ejecutarás agentes de texto. Si también quieres las capacidades de imagen y video, calcula algo más de margen; de todos modos, la guía local de Unsloth sugiere entre 24 y 32GB de memoria.
¿Qué tan bueno es Nemotron 3.5 Bolt, en realidad?
Mira dos tablas de puntuaciones: la independiente y la propia de NVIDIA.
La puntuación independiente. Artificial Analysis sitúa a Bolt 74B en 21.4 en su Intelligence Index, "placing 4th among models under 100B parameters and first among US models in that class." Eso lo deja a menos de 2 puntos de Nemotron 3 Ultra (23), un modelo con unas siete veces más parámetros. Bolt incluso supera a Ultra en AutomationBench-AA (15,5 % frente a 3,0 %).
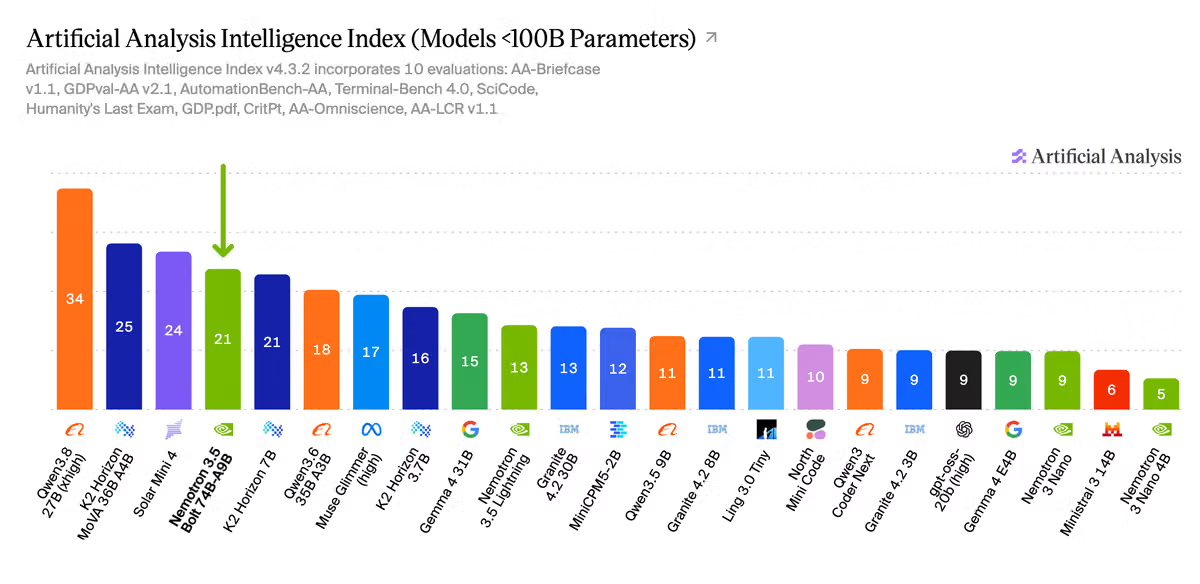
Pero mira la parte izquierda de ese gráfico. Qwen3.8 27B obtiene 34. Bolt es el mejor modelo estadounidense de su categoría, no el mejor modelo de su categoría.
La propia tabla de NVIDIA. La ficha del modelo enfrenta a Bolt de 2 bits con tres modelos similares de mezcla de expertos a precisión completa:
| Prueba de referencia | Bolt 74B 24GB (2 bits) | Qwen3.6 35B-A3B | Gemma 4 26B-A4B | Nemotron 3.5 Lightning |
|---|---|---|---|---|
| GDPVal-AA-V2 (tareas de trabajo reales) | 28.47 | 25.75 | 15.33 | 18.26 |
| Terminal-Bench 2.1 | 50.98 | 44.38 | 37.22 | 23.46 |
| Tau3 Banking (atención al cliente) | 17.01 | 10.52 | 14.02 | 9.48 |
| GPQA Diamond | 86.43 | 83.40 | 79.61 | 75.57 |
| BrowseComp | 66.75 | 48.74 | 26.30 | 36.81 |
| PinchBench | 87.82 | 88.07 | 74.70 | 83.43 |
| Precisión de AA-Omniscience | 16.90 | 19.47 | 22.17 | 16.63 |
| IFBench (seguimiento de instrucciones) | 66.17 | 63.71 | 77.25 | 72.88 |
Frente a esos tres, Bolt gana en la mayoría de las filas, y hacerlo a 2 bits es impresionante. Pero la tabla deja fuera al modelo denso Qwen3.8 27B. El propio informe técnico de NVIDIA lo sitúa en 44.5 en GDPVal v2 frente a los 28.5 de Bolt, a aproximadamente un tercio de la velocidad. Es un equilibrio razonable que ofrecer, pero tienes que leer el PDF para verlo.
Otros dos costes que conviene conocer:
- Los 2 bits tienen un coste. Frente a los propios pesos de Bolt a precisión completa, GDPVal baja de 31.13 a 28.47 y la precisión de Omniscience de 21.80 a 16.90, según el informe técnico.
- Habla mucho. Artificial Analysis contó 82k tokens de salida por tarea del Index, 1.8x los de Super VL y 2.9x los de Ultra. En local eso cuesta tiempo en lugar de dinero, pero sigue siendo tiempo.
¿Qué tan rápido es en hardware real?
La propia tabla de velocidad de NVIDIA es más modesta que las publicaciones del lanzamiento. En RTX Spark con llama.cpp, Bolt funciona a 83.99 tokens por segundo, frente a 96.63 de Qwen3.6 35B-A3B, 100.56 de Gemma 4 26B-A4B y 28.26 de Qwen3.8 27B, según la página de investigación. Así que es más lento que los modelos pequeños de mezcla de expertos a los que supera en precisión, y unas 3x más rápido que el modelo denso que lo supera.
Los usuarios con tarjetas más potentes ven cifras mucho mayores:
"343 tok/s median with the LiLiCorr drafter (DFlash, n_max 6, about 55% of drafted tokens accepted), 166 tok/s without it. 25.0 GiB at 32K with the drafter and the projector, 22.7 GiB without the drafter."

Eso es en una RTX 5090, y fíjate en la cifra de 25GB una vez cargados la visión y el modelo de borrador. En una tarjeta de 16GB, un usuario informó de unos 45 tokens por segundo al descargar parte del modelo en la memoria del sistema. Los usuarios de Mac lo tienen peor por ahora:
"Nemotron Bolt appears to be really quite good but unfortunately it is quite slow on macOS/Metal in llama.cpp at the moment because of lack of support for a tensor type (or something… not sure I understand)."

¿Cuánto cuesta Nemotron 3.5 Bolt?
Los pesos son gratuitos, y esa es toda la lista de precios. A fecha del 27 de octubre de 2026, ninguno de los dos modelos Bolt tiene una API alojada de pago. No aparece en OpenRouter ni en DeepInfra, la página de build.nvidia.com de NVIDIA para el modelo de 74B devuelve un 404, y Artificial Analysis indica "No publicly available API."
| Opción | Bolt 74B-A9B 24GB | Bolt E4B 4GB |
|---|---|---|
| Pesos abiertos | Gratis, OpenMDW-1.1 | Gratis, OpenMDW-1.1 |
| Alojado por NVIDIA | No disponible | Endpoint de prueba gratuita bajo las condiciones de prueba de la API de NVIDIA |
| OpenRouter, DeepInfra | No aparece | No aparece |
| Descarga local | 22GB (GGUF de 2 bits) | 6.18GB (GGUF de 4 bits, Unsloth) |
| Memoria para ejecutarlo | De 24 a 32GB | Unos 4GB de memoria de video |
Si prefieres pagar por token, los otros modelos de la familia sí están alojados. En OpenRouter, Super VL figura a 0,15 $ por millón de tokens de entrada y 0,50 $ de salida, y Lightning a 0,07 $ y 0,20 $. Si tu plan es usar un servicio alojado, mi guía del mejor modelo de IA para tickets de soporte también compara las opciones cerradas, como Claude Haiku 5.5 y Gemini 3.8 Flash.
La licencia es la otra mitad de la cuestión del coste, y es una buena licencia. OpenMDW-1.1 permite el uso "without restriction," no impone límites a las salidas y no tiene un límite de usuarios ni una política de uso aceptable. Conservas los avisos cuando redistribuyes, y tus derechos terminan si demandas alegando que el modelo infringe una patente o derechos de autor. Un comentarista de Reddit la llamó "an Apache styled license," una descripción bastante acertada.
¿Cómo lo ejecutas?
Tienes más opciones que con la mayoría de los lanzamientos desde el primer día. NVIDIA y sus socios lanzaron:
- Ollama:
ollama run nemotron-3.5-boltdescarga la compilación de 25GB con contexto de 256K y entrada de imágenes. Ollama también ofrece comandos de inicio de una sola línea para Claude Code, OpenCode, Hermes Agent y OpenClaw. - llama.cpp: el propio GGUF de NVIDIA más un archivo independiente del modelo de borrador. NVIDIA dice que la compilación está "optimized for use on RTX Spark with llama.cpp and DGX Spark with vLLM."
- vLLM: necesita una compilación nightly y, por ahora, solo admite GPU de la generación Blackwell.
- LM Studio, Unsloth y un paquete snap de Canonical completan las opciones.
El entorno de ejecución de agentes locales es el verdadero caso de uso. NVIDIA propone encargarle a Bolt proyectos "from researching the web to writing to debugging code," sin enviar el trabajo a la nube. Los usuarios a los que más les gusta le dan una tarea acotada con una meta clara:
"I really don't hate this model. I was expecting to, it's a 2 bit quant for fucks sakes, but it seems to do really well when it's got some tools, a defined goal and a success condition such as 'compile works and tests pass'."
¿Qué dicen quienes lo han probado primero?
La reacción en r/LocalLLaMA es positiva, con un límite claro. Cuatro temas aparecieron una y otra vez.
El truco de los 2 bits funciona mejor de lo esperado. Un comentarista calificó "74GB QAT coming in at 24GB on disk" de "pretty incredible" y dijo que "has a decent chance of retiring Qwen3.6-35B for some people." Otro lo usa para una tarea de ingesta de faxes en el trabajo, donde superó a su modelo de visión anterior en una comparación directa.
Está por debajo del modelo denso Qwen 3.8 27B en trabajo real. La prueba más cuidadosa que encontré ejecutó 33 tareas de infraestructura en una RTX 5090:
"26 of 33 passed, with the LiLiCorr drafter on. On the same tasks the same day qwen3.8:27b passed 32, qwen3.6:27b 31, gemma4:31b and glm-4.7-flash 29, qwen3.6:35b and gemma4:12b 27."
Una segunda persona ejecutó 36 tareas a ciegas frente a Gemma 31B y encontró que Bolt era "about 3.5 times faster, but it made up more problems that weren't there."
Explora mucho. La misma persona que realizó la prueba de 33 tareas encontró que el 54 % de sus llamadas a herramientas eran comprobaciones y diagnósticos, y lo resumió como "Careful, and expensive in turns." Otro usuario vio que ignoraba la instrucción de Docker en su archivo AGENTS.md.
La seguridad es una verdadera incógnita. Esto es lo más importante para cualquier aplicación de cara al cliente:
"It is not safe for an agent; it failed 6/21 jailbreak tests. Qwen3.8 Flash and 27 B failed none."
Es la prueba de una sola persona, y una respuesta en el mismo hilo planteó un contrapunto válido: "If you're relying on model weights to protect you from hostile content, you're doing it wrong." Ambas cosas son ciertas.
¿Y qué hay de Bolt E4B?
Bolt E4B es el que conviene seguir de cerca si desarrollas productos de voz o dispositivos. La página de E4B de NVIDIA afirma "~40 % higher average quality" respecto a su anterior modelo de 4B y "up to ~80% fewer tokens vs peers," e incluye "customer service" entre sus usos como asistente de voz. Tiene un modo conversacional que mantiene las respuestas lo bastante cortas para decirlas en voz alta y admite 35 idiomas.
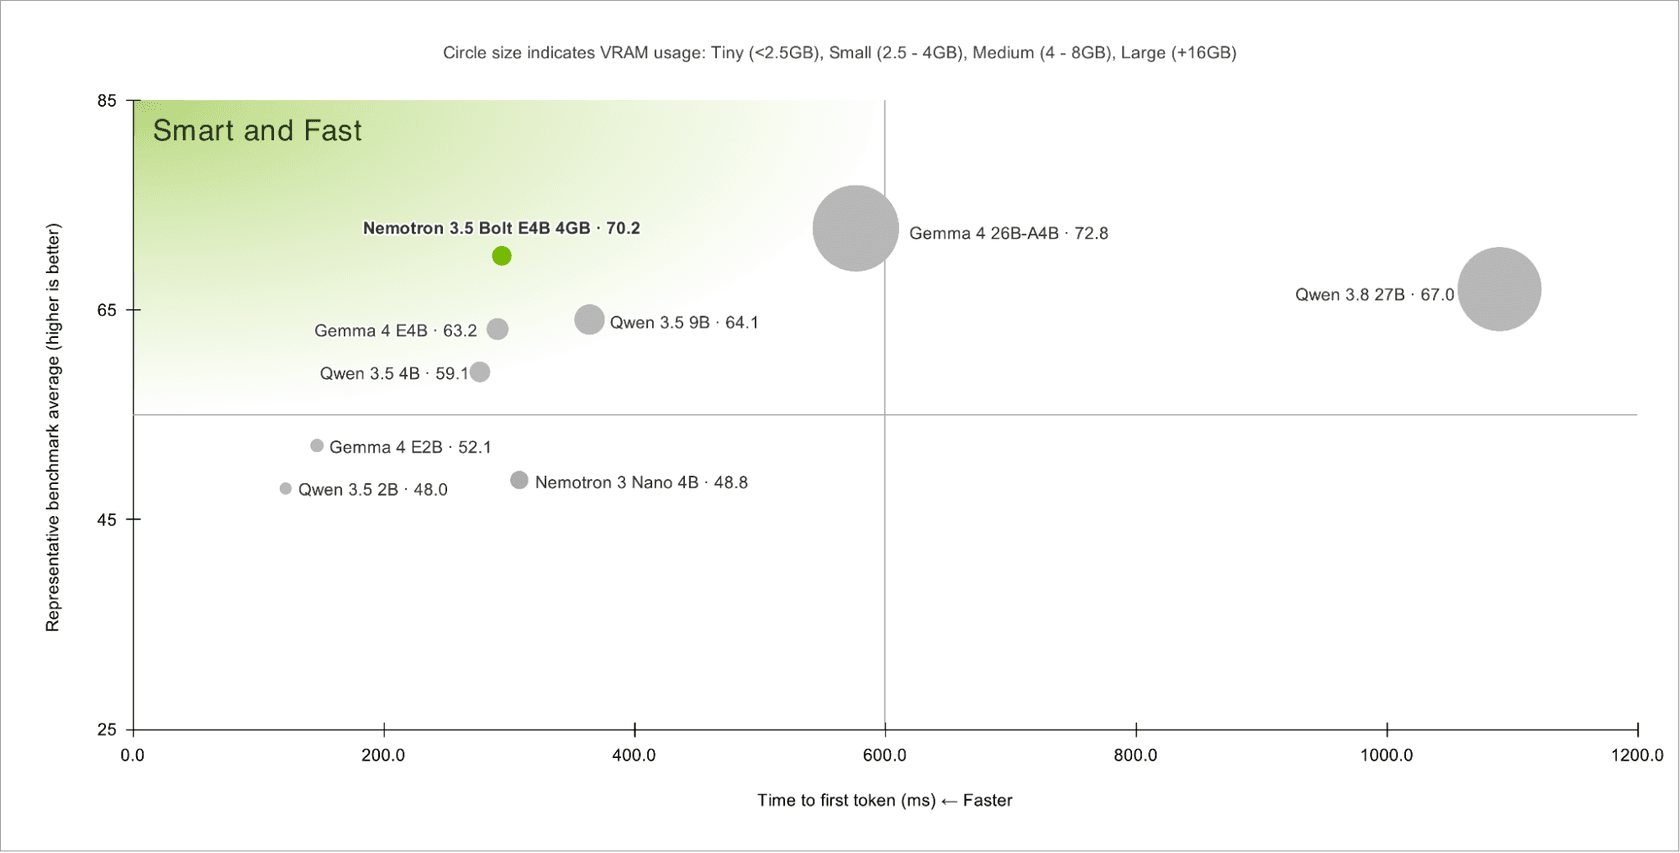
Es rápido. En una RTX 5070 devuelve su primer token en 548 milisegundos y funciona a 133.4 tokens por segundo, usando 3.5GB de memoria de video. Incluso una Jetson Orin Nano consigue 15.5 tokens por segundo.
La tabla de pruebas de referencia muestra mayormente victorias, con una fila a la que los equipos de soporte deberían prestar atención:
| Prueba de referencia | Bolt E4B | Qwen 3.5 4B | Gemma 4 E4B |
|---|---|---|---|
| IHEval (jerarquía de instrucciones) | 84.8 | 60.6 | 67.0 |
| RoleMRC | 80.6 | 65.8 | 74.6 |
| RAGTruth F1 | 77.6 | 75.6 | 77.0 |
| BFCL-v3 (llamadas a herramientas) | 68.5 | 70.9 | 66.4 |
| Tau2-Bench (tareas de clientes) | 55.1 | 75.1 | 38.5 |
Qwen 3.5 4B lo supera por 20 puntos en Tau2-Bench, la prueba de referencia que simula a un agente atendiendo solicitudes de clientes bajo una política de empresa. Si estás desarrollando un agente de voz para atención al cliente, prueba ambos.
¿Encaja Nemotron 3.5 Bolt en la atención al cliente?
Encaja bien en una parte del soporte, y es una opción arriesgada para la parte a la que suele referirse la gente.
La parte buena: mantener los datos dentro de la empresa. Un modelo que se ejecuta en un solo equipo con una licencia permisiva responde claramente a la pregunta «¿adónde van nuestros datos?». Para trabajo interno, como resumir tickets, clasificarlos o redactar respuestas que revisa un agente, un Bolt local es un motor razonable, y su puntuación en Tau3 Banking (17.01) supera a la de todos sus pares en la tabla de NVIDIA.
La parte arriesgada: responder directamente a los clientes. Un 17 % en una prueba de referencia de atención al cliente bancaria sigue siendo bajo en términos absolutos. Añade una tasa de fallo reportada de 6 de cada 21 pruebas de jailbreak y la costumbre de explorar con llamadas adicionales a herramientas, y tienes un modelo que necesita mucha estructura de apoyo antes de hablar con un cliente. Cada mensaje de un cliente es una entrada no confiable.
Lo que tiene que hacer esa estructura de apoyo es la parte a la que dedico mis días. eesel aprendió pronto que un detalle incorrecto es peor que no dar una respuesta, por eso cada despliegue se simula con tickets históricos antes de que una IA responda a un cliente real. Uno de nuestros clientes con un caso publicado, una empresa de automatización industrial, tiene un chat que responde a sus ingenieros solo a partir de sus documentos técnicos e indica de dónde procede cada respuesta. No encontrar una respuesta es un resultado aceptable en ese caso. Esa es una propiedad del sistema que rodea al modelo, no de los pesos. Nuestra guía para prevenir las alucinaciones de IA en soporte trata las medidas de protección con más profundidad.
Así que mi veredicto es este: si tienes ingenieros, una GPU NVIDIA de 24GB+ y un motivo para mantener los datos en local, Bolt merece un fin de semana. No es algo que conectes el lunes a tu cola de Zendesk AI. Si, en cambio, estás comparando herramientas listas para usar, empieza por mi selección de software de soporte con IA.
¿Quién debería usar Nemotron 3.5 Bolt?
Así lo decidiría yo:
- Ejecutas agentes locales de programación o investigación en una sola GPU. Esto es exactamente para lo que se diseñó Bolt 74B. Dale herramientas y una condición de éxito clara.
- Necesitas mantener los datos fuera de la nube. Datos regulados, un contrato que prohíbe los procesadores externos de IA o una computadora portátil en un avión. La licencia y el espacio de 24GB que ocupa hacen que sea fácil justificarlo.
- Desarrollas productos de voz, videojuegos o dispositivos. Bolt E4B es rápido, pequeño y de pocas palabras por diseño.
- Quieres el modelo más inteligente que quepa en 24GB. Mira primero Qwen3.8 27B y acepta que es unas 3x más lento. O elige una opción alojada con Qwen3.8 Flash-Next o DeepSeek V4 Flash.
- Necesitas una API alojada esta semana. Bolt no tiene una. Usa en su lugar Nemotron 3.5 Super VL, que está en OpenRouter.
Prueba eesel
Nemotron 3.5 Bolt es infraestructura: pesos gratuitos, una GPU y un fin de semana de configuración. Todavía tendrías que desarrollar la recuperación de información, las reglas de escalamiento, las pruebas y el registro de auditoría. eesel es el empleado. Nuestro compañero de soporte con IA se conecta a Zendesk, Freshdesk, Gorgias y el resto, aprende de tus tickets anteriores y tu centro de ayuda, y responde solo a partir de tu propio conocimiento. Antes de que responda a un solo cliente, puedes probarlo con cientos de tus tickets históricos y ver qué habría dicho.
Así es como Dokument 24 lo usa en Zendesk: en un mes, el compañero preparó 680 tickets para el equipo y dejó 670 borradores de respuesta en danés como notas internas, listos para enviar o editar.

Si te gusta manejar agentes desde una terminal como lo harías con un modelo local, la eesel CLI permite operar al mismo compañero. Puedes leer y editar sus instrucciones permanentes, listar las acciones pendientes de aprobación humana y consultar el registro de actividad de cada ejecución, con salida JSON y simulaciones de las operaciones de escritura, para que un agente de programación como Claude Code pueda gestionar a tu compañero de soporte junto con tu repositorio. Si escribes contenido en lugar de responder tickets, el mismo equipo tiene un redactor de blogs con IA.
Empezar es gratis. Prueba eesel con los tickets del mes pasado antes de comprar una tarjeta de 24GB para ello, y consulta los planes en la página de precios.