

Por qué me importa un modelo de visión
Construyo las integraciones de eesel, el código que extrae tickets, adjuntos y artículos del centro de ayuda de herramientas como Zendesk y Freshdesk. Casi todo lo que pasa por esa tubería es texto, pero no todo. Una petición se repitió este año en las llamadas de ventas de eesel: los equipos de soporte de productos técnicos querían que la IA leyera los diagramas dentro de sus PDF y las fotos que los clientes adjuntan a los tickets. Una consultora de TI del sector público que gestiona unos 3,000 tickets complejos al mes nos dijo que su documentación técnica era sobre todo imágenes.
Así que cuando NVIDIA lanzó un modelo abierto cuya propuesta entera es "un modelo que lee gráficos, tablas, diseños de página y vídeo, y luego llama a herramientas", leí la tarjeta del modelo línea por línea. Esto es lo que hay realmente, dónde se sostienen las afirmaciones del lanzamiento y dónde necesitan una nota al pie.
¿Qué es Nemotron 3.5 Super VL?
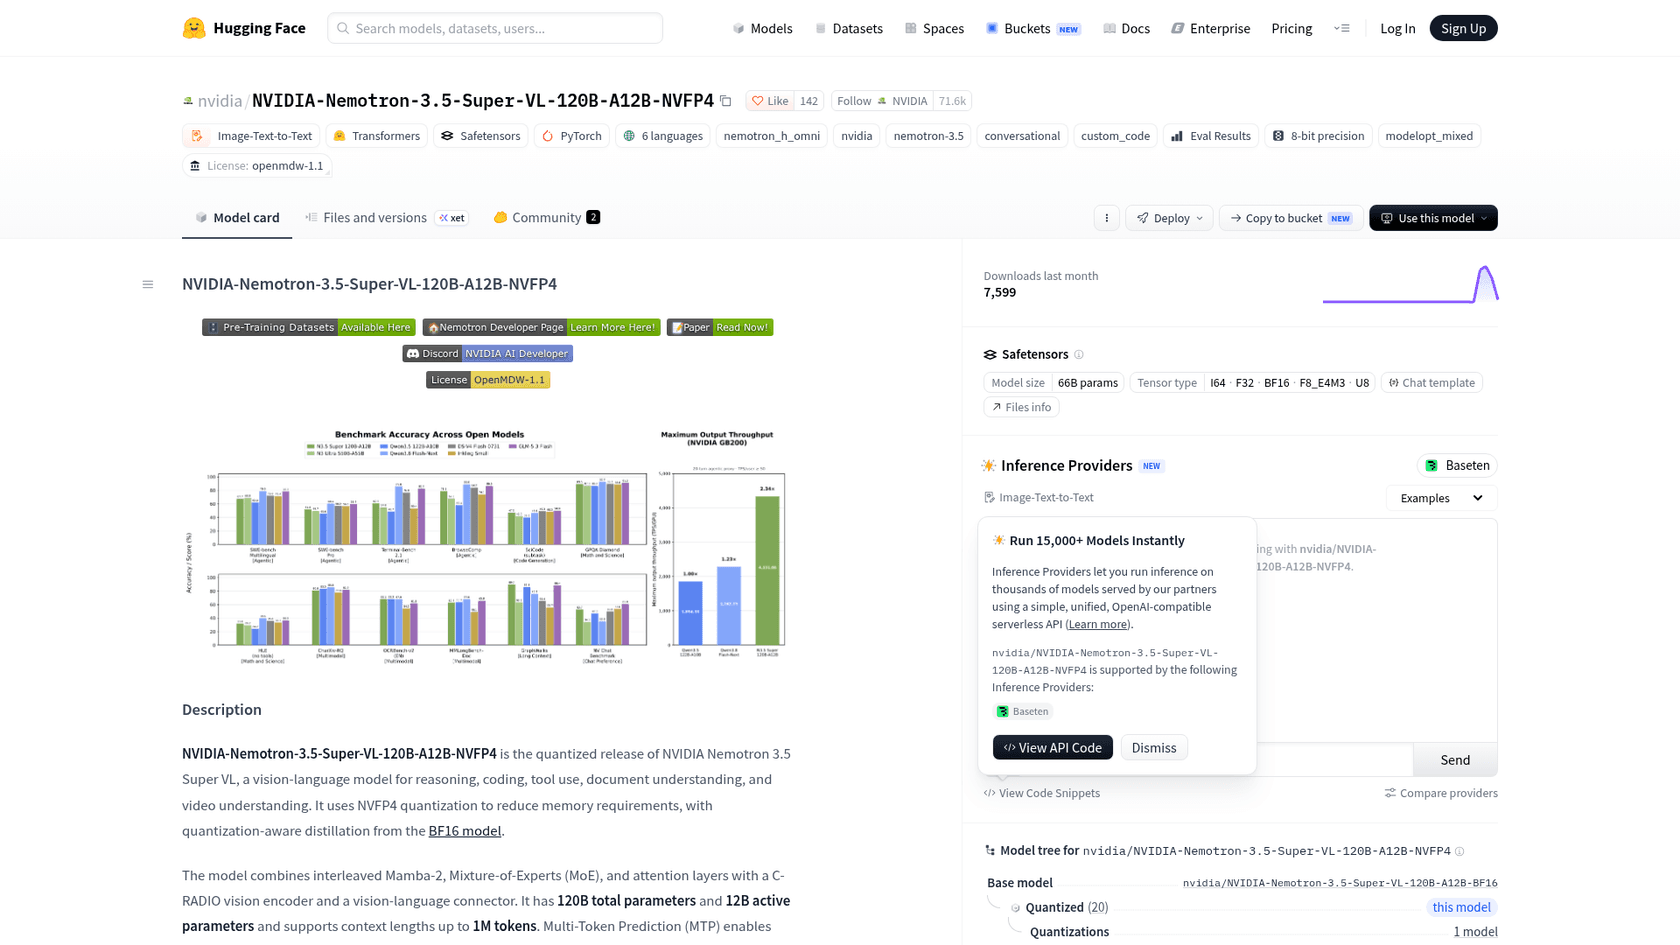
Nemotron 3.5 Super VL es el miembro de visión y lenguaje de la familia Nemotron 3.5 de NVIDIA. La tarjeta del modelo BF16 lo describe como un modelo para "reasoning, coding, tool use, document understanding, and video understanding", y la palabra clave es uno. En lugar de encadenar un modelo de texto con otro de visión y pasarse contexto entre ellos, los mismos pesos hacen ambas cosas.
Se lanzó junto a dos hermanos más pequeños. Según el anuncio de NVIDIA, Bolt 74B-A9B usa cuantización nativa de 2 bits para caber en 24GB y servir a agentes locales, y Bolt E4B (4GB) llega el 23 de octubre para voz y uso embebido.
Estas son las especificaciones que importan:
| Especificación | Nemotron 3.5 Super VL |
|---|---|
| Lanzamiento | 15 de octubre de 2026 |
| Parámetros | 120B totales, 12B activos por token |
| Arquitectura | Mezcla de expertos híbrida Mamba-2 y Transformer, 512 expertos enrutados por capa MoE |
| Visión | Codificador de visión C-RADIO más un conector visión-lenguaje |
| Entradas | Texto, imágenes (JPEG, PNG), vídeo (MP4 de hasta 2 minutos) |
| Salida | Texto |
| Ventana de contexto | Hasta 1M de tokens (262,144 de salida máxima en OpenRouter) |
| Razonamiento | Desactivado, medio o activado, configurado en la plantilla de chat |
| Checkpoints | Base, post-entrenado BF16, NVFP4 |
| Licencia | OpenMDW-1.1 |
La tarjeta del modelo dice que está "ready for commercial or non-commercial use", y NVIDIA también publica los datos de entrenamiento y las recetas. Esto último importa si piensas hacer fine-tuning. Puedes ver qué entró, algo que no puedes con la mayoría de los modelos de pesos abiertos, incluidos Kimi K3 y Mistral Large 4.
¿Cómo funciona por dentro?
En resumen: es un modelo de tamaño medio construido para hacer mucho trabajo por GPU. Unas cuantas decisiones de diseño explican por qué es rápido.
- Capas híbridas. La red intercala capas Mamba-2 (un diseño de espacio de estados que maneja secuencias largas a bajo coste) con bloques de mezcla de expertos y un número menor de capas de atención. Eso mantiene bajo el uso de memoria con contexto largo, que es como una sola máquina puede sostener una ventana de 1M de tokens.
- Destilado desde un modelo mayor. NVIDIA dice que la base partió de Nemotron 3 Super Base y luego recibió 1T de tokens de destilación desde Nemotron 3 Ultra Base. Así es como un modelo de 120B acaba superando a su maestro de 550B en algunos benchmarks de agentes.
- Borrador integrado. Una cabeza de predicción multitoken propone varios tokens a la vez para que el modelo principal los verifique, así que necesita menos pasadas costosas. En DGX Spark, el borrador LiLiCorr de NVIDIA añade "up to 2.3x faster token generation".
- 4 bits sin mucha pérdida. El checkpoint NVFP4 se entrenó para igualar al modelo de precisión completa. Artificial Analysis encontró que puntúa a menos de 0.1 puntos de BF16 en su índice.
El proceso de entrenamiento también explica el enfoque en agentes: 67B de tokens de pre-entrenamiento intermedio de ingeniería de software a 256K de contexto, luego fine-tuning supervisado sobre secuencias empaquetadas de hasta 524,288 tokens, luego aprendizaje por refuerzo y destilación con varios maestros. Si has seguido cómo se construyen los agentes de IA, esta es la receta que esperarías para un modelo pensado para trabajos largos y con muchas herramientas.
Dónde encaja en la gama de modelos de NVIDIA
NVIDIA deja claro que Super VL no está pensado para hacerlo todo. En su publicación para desarrolladores, describe un "system of models": Nemotron 3.5 Lightning se ocupa de tareas de texto de alto volumen, Nemotron 3 Ultra se encarga de planificar y orquestar, y Super VL ocupa el medio con el trabajo especializado y de varios pasos que necesita visión y herramientas.
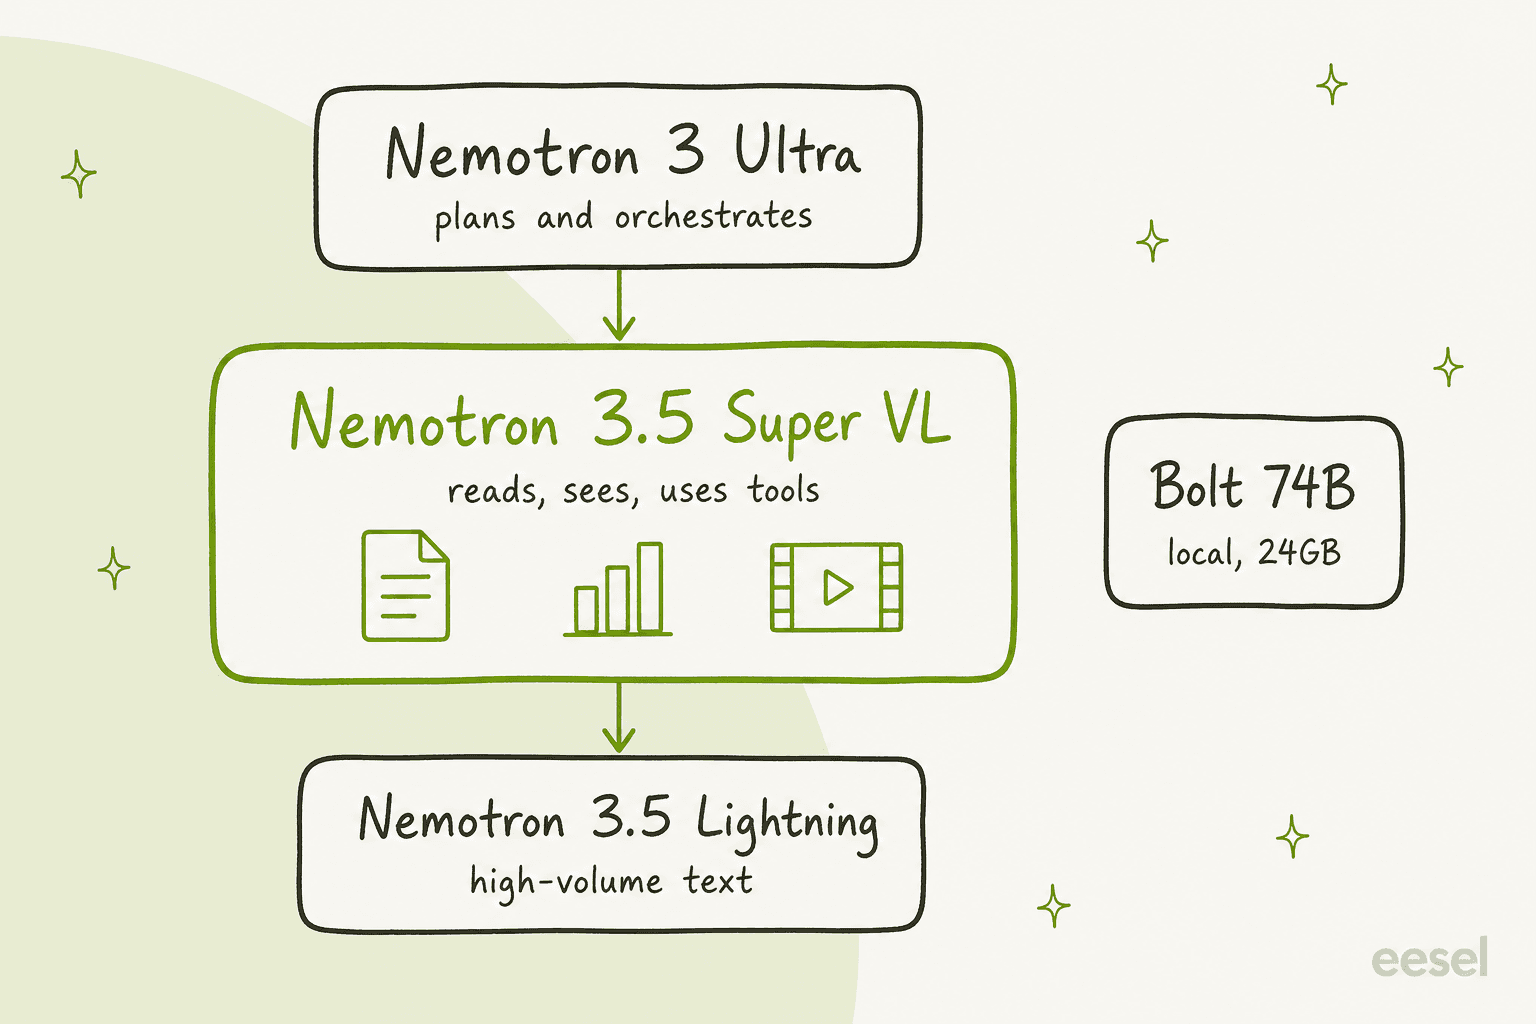
Ese enfoque es útil porque dice cómo espera NVIDIA que lo uses. Super VL es el trabajador al que le entregas un PDF de 40 páginas y una hoja de cálculo, no el modelo más barato para clasificar un millón de mensajes cortos. Para ese tipo de clasificación de tickets, Lightning o un modelo cerrado pequeño como Claude Haiku 5.5 encaja mejor en costes.
¿Qué tan bueno es en realidad?
Aquí hay que leer dos marcadores a la vez.
En Artificial Analysis, el sitio independiente de benchmarks, Nemotron 3.5 Super VL obtiene 26.5 en el Intelligence Index, el n.º 1 de 67 modelos de pesos abiertos en la clase de tamaño de 40B a 150B. Es el doble que su predecesor Nemotron 3 Super (13), por delante de Nemotron 3 Ultra (22.9) y justo por delante de Inkling Small, de Thinking Machines (25.7). También funcionó a 409 tokens de salida por segundo, el más rápido de su clase.
Pero si amplías el foco, la imagen cambia. Modelos abiertos más grandes que cuestan lo mismo por token puntúan mucho más:
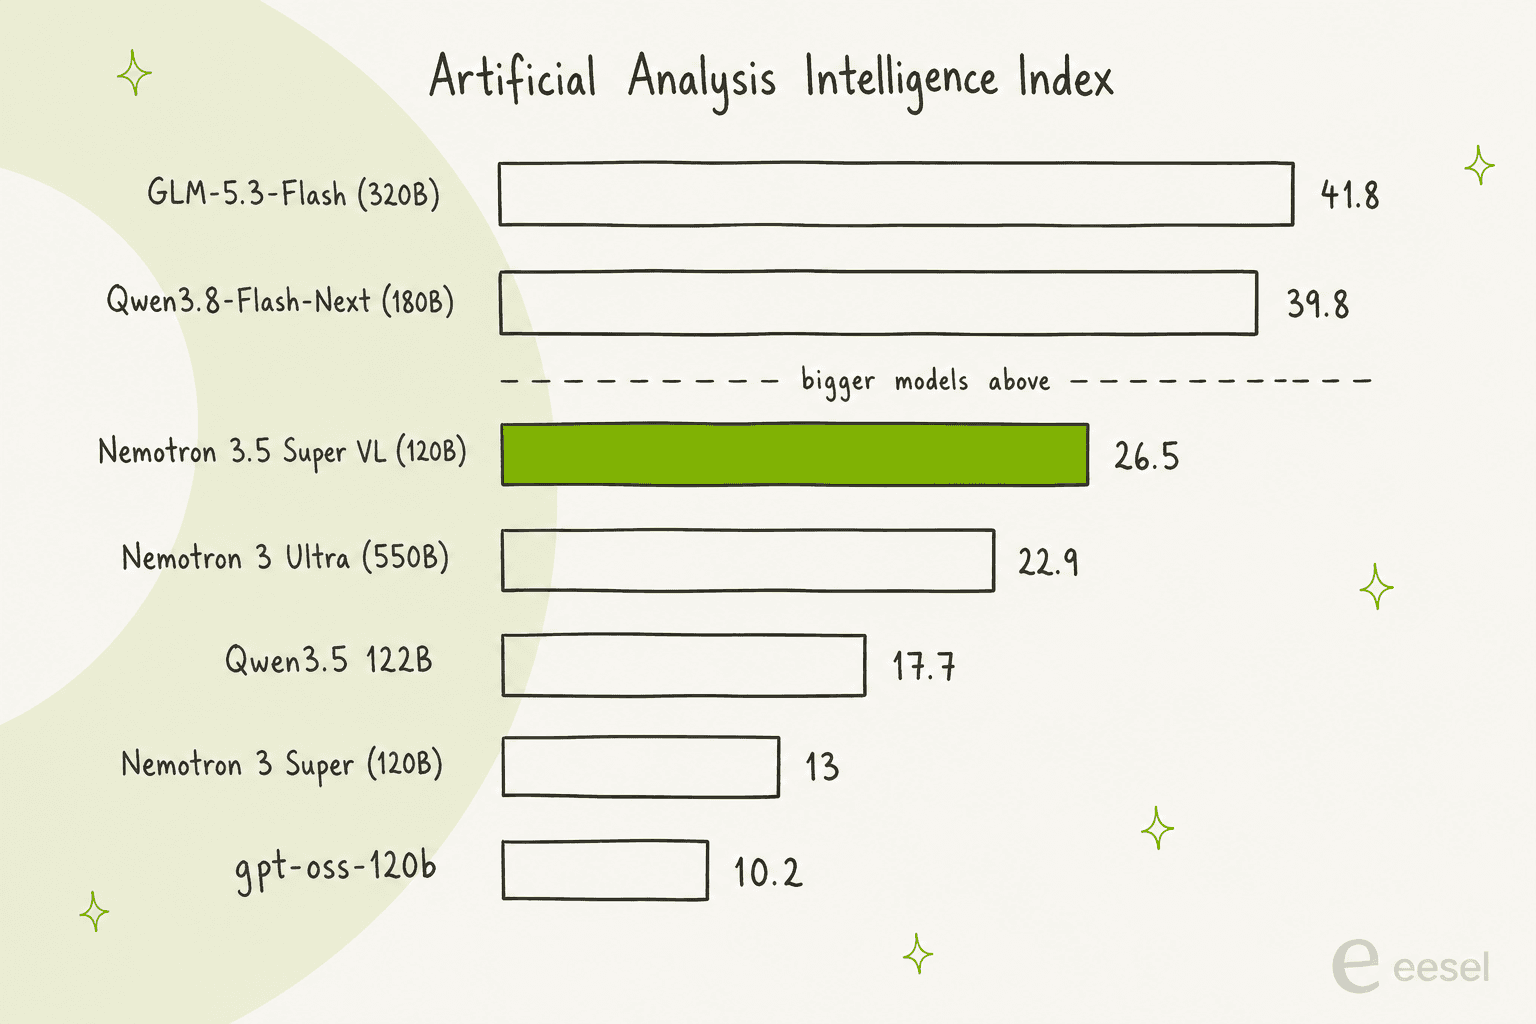
GLM-5.3-Flash (320B en total) obtiene 41.8 y Qwen3.8-Flash-Next (180B en total) obtiene 39.8. La propia tabla de la tarjeta del modelo de NVIDIA incluye a ambos, y superan a Super VL en la mayoría de las filas, incluidas SWE-bench Verified (78.7 y 79.10 frente a 71.10) y Terminal-Bench 2.1 (85.80 y 82.70 frente a 60.67). La propia Artificial Analysis señala que EE. UU. sigue por detrás del MiMo-V2.6-Pro de China (46) en inteligencia de pesos abiertos.
Entonces, ¿en qué gana Super VL? En velocidad, y en el "cuadrante más atractivo" del gráfico de NVIDIA, donde la precisión se une al rendimiento:
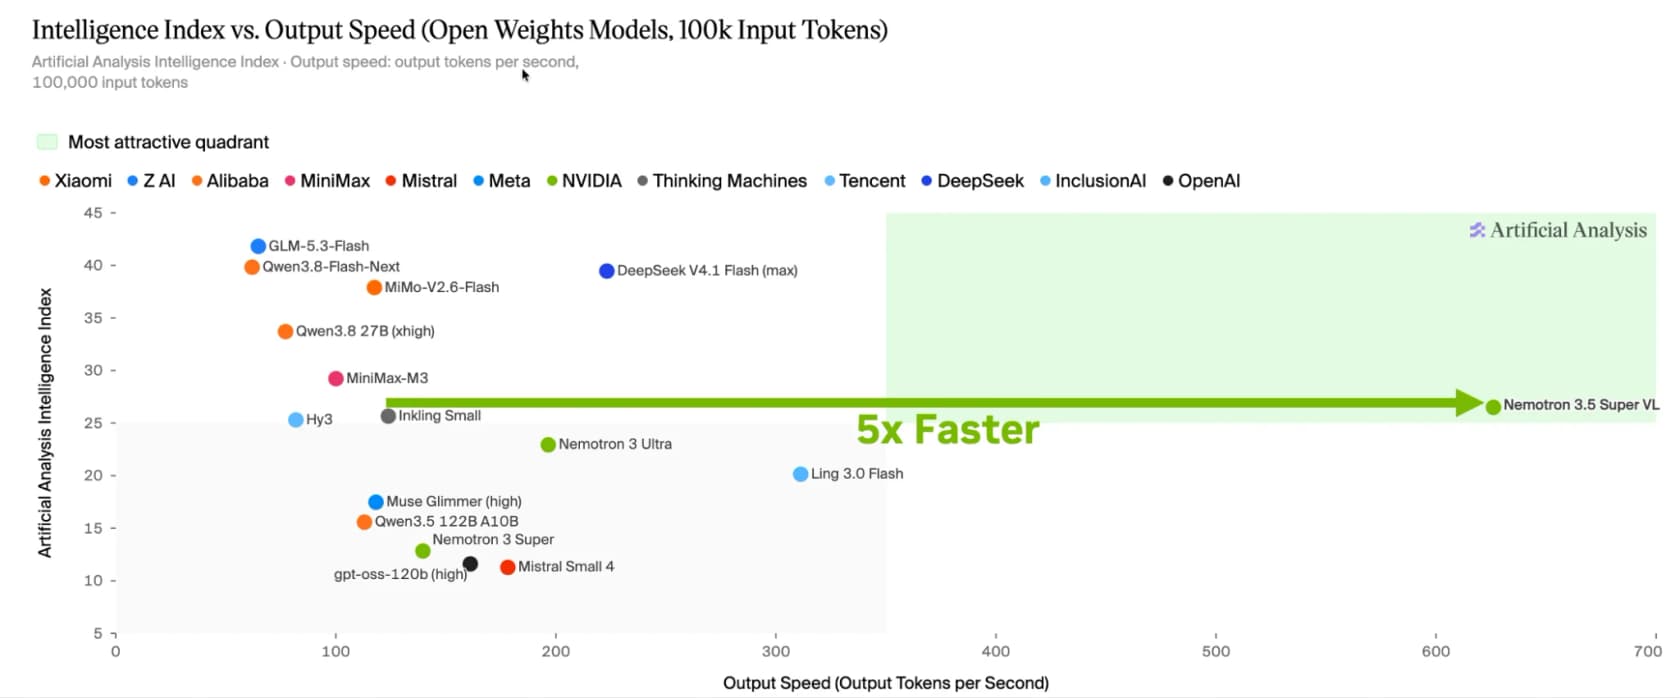
En arneses de agentes en concreto, NVIDIA informa que supera a Ultra en Hermes Bench (63.44% frente a 56.33%) y en las evaluaciones de comportamiento de LangChain (87.05% frente a 84.3%). Y es fuerte en documentos: 80.8% en el benchmark de razonamiento sobre gráficos CharXiv (84% con intérprete de código Python) y 68.12 en OCRBench v2 en inglés.
Mi lectura: Super VL no es el modelo abierto más inteligente, es el más rápido de los buenos que puede ver. Si tu agente escribe sobre todo código, los modelos flash más grandes merecen la memoria extra. Si lee documentos todo el día y te importa el rendimiento por GPU, Super VL es el primero que probaría.
La historia del post-entrenamiento con la que abre NVIDIA
La afirmación principal de NVIDIA, recogida por la mayoría de la cobertura del lanzamiento, es que Super VL post-entrenado supera a Claude Opus 5, GPT-6.1 Sol y otros modelos de frontera en tareas especializadas. El gráfico es real. Pero míralo de cerca:
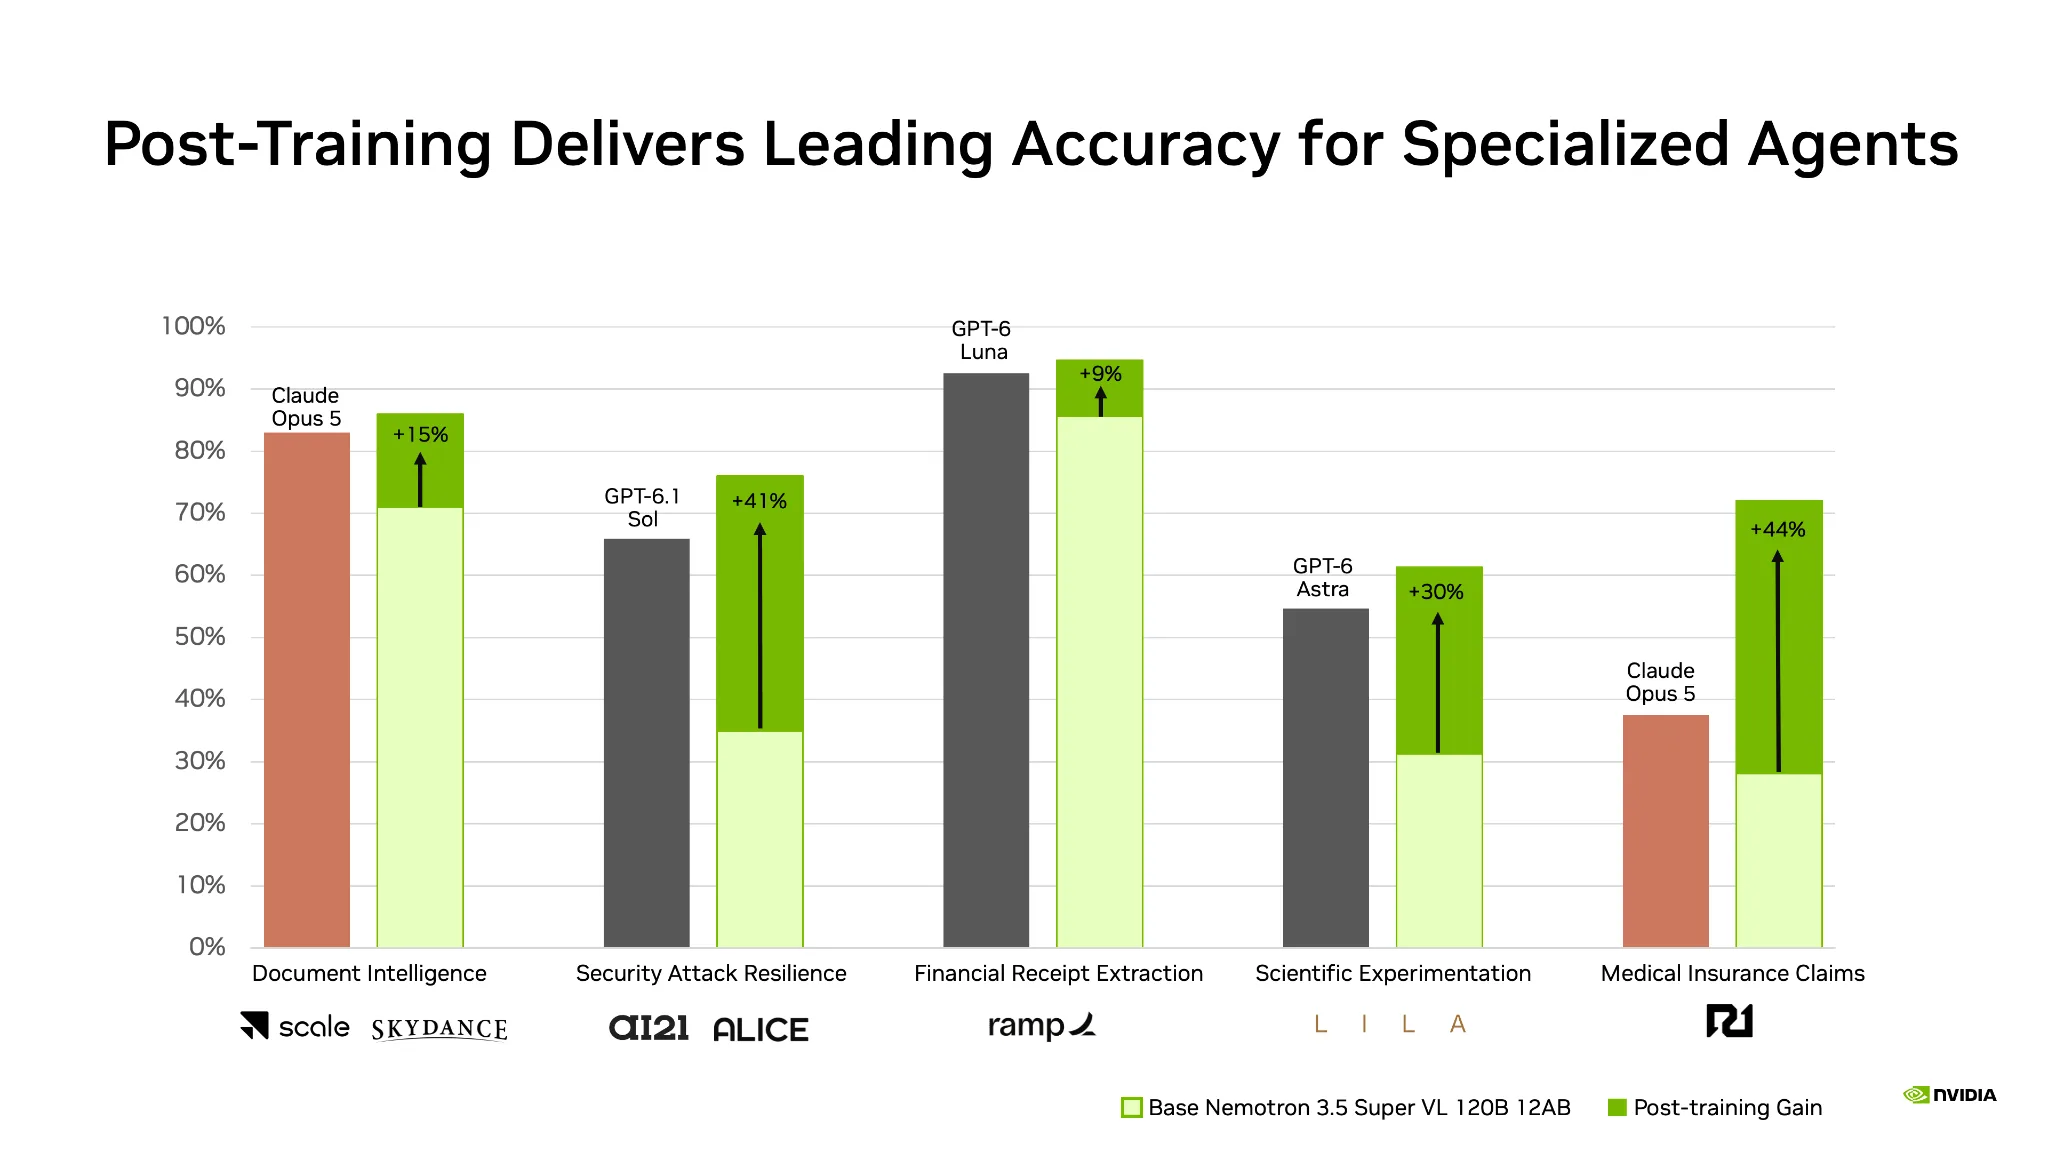
En las cinco tareas, el modelo base en verde claro empieza por debajo del modelo de frontera. En resistencia a ataques de seguridad empieza en torno al 35% frente al 66% de GPT-6.1 Sol, y solo lo supera tras una ganancia de post-entrenamiento de +41% de AI21 y Alice. La victoria viene de entrenar con tus propios datos, justo lo que permite un modelo abierto con recetas abiertas.
Las cifras de los socios son concretas. Scale AI lo post-entrenó para procesar créditos de proveedores en Skydance y espera que el coste de inferencia baje 40x y la latencia 5x. Ramp convierte imágenes de recibos en JSON estructurado y espera hasta un 50% más de rendimiento y 10x menos latencia.
La lección para compradores: si vas a elegir un modelo listo y darle prompts, compara las puntuaciones base. Si tienes un equipo y datos etiquetados para post-entrenar con NVIDIA NeMo, la receta abierta de Super VL es el verdadero producto.
¿Cuánto cuesta Nemotron 3.5 Super VL?
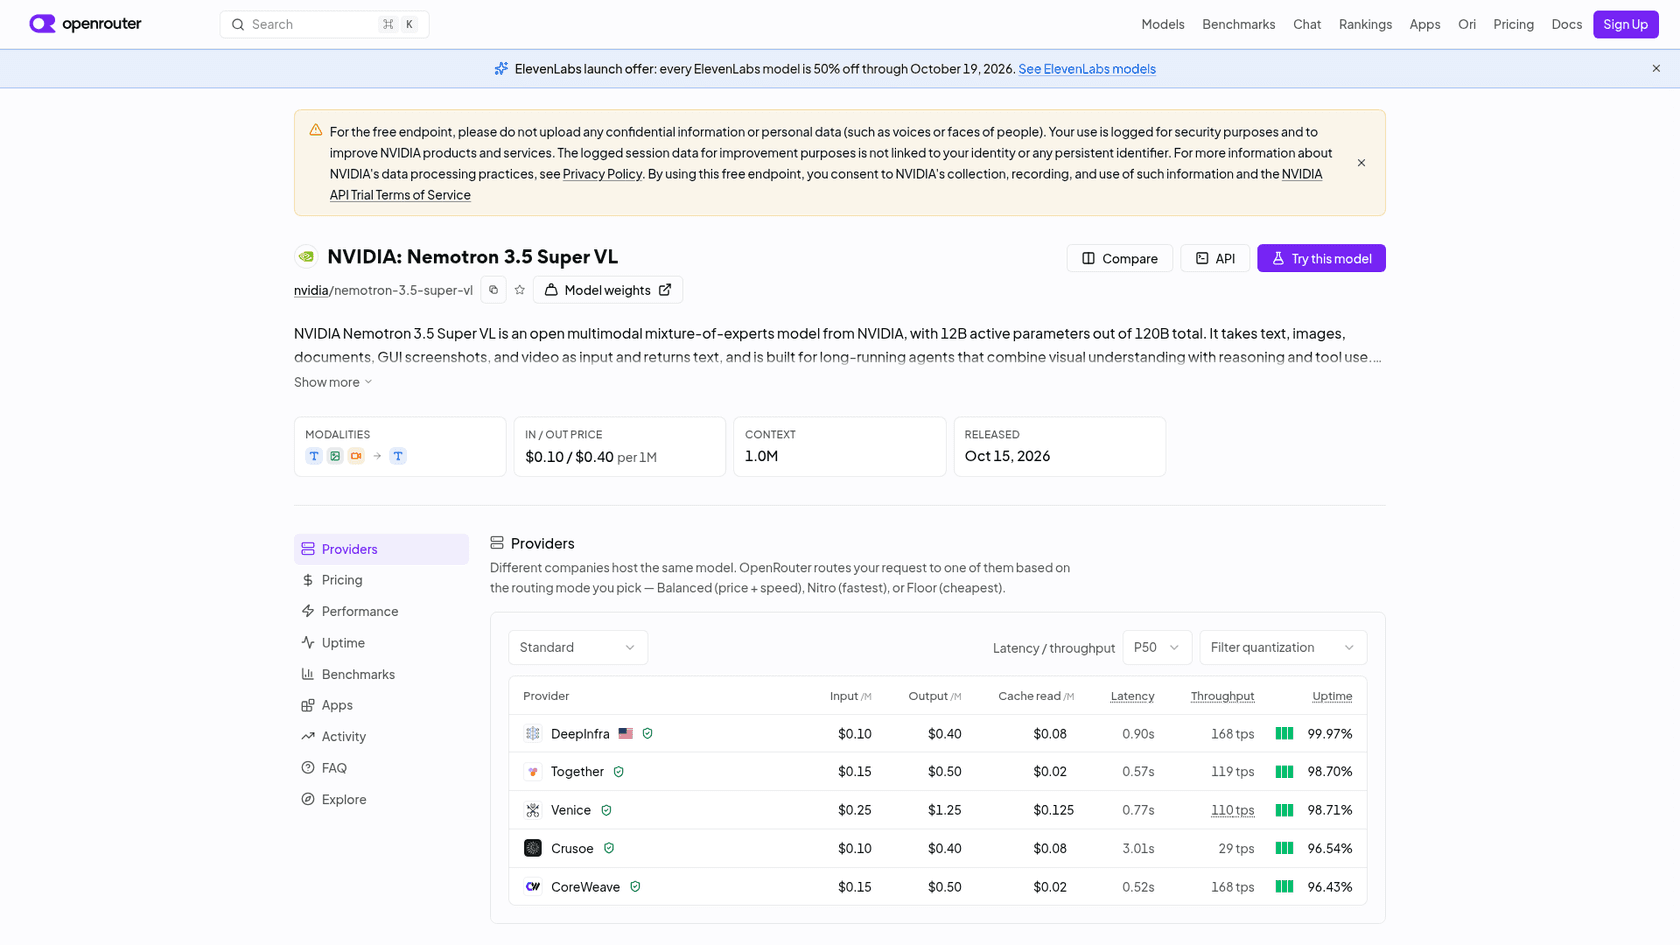
Los pesos son gratuitos. Alojado, es uno de los modelos capaces más baratos del mercado:
| Proveedor | Entrada / 1M tokens | Entrada en caché / 1M | Salida / 1M |
|---|---|---|---|
| DeepInfra | $0.10 | $0.08 | $0.40 |
| Crusoe (vía OpenRouter) | $0.10 | $0.08 | $0.40 |
| Together (vía OpenRouter) | $0.15 | $0.02 | $0.50 |
| CoreWeave (vía OpenRouter) | $0.15 | $0.02 | $0.50 |
| Venice (vía OpenRouter) | $0.25 | $0.125 | $1.25 |
| Endpoint gratuito de NVIDIA (vía OpenRouter) | Gratis | Gratis | Gratis |
Las filas de OpenRouter vienen de la página del modelo en OpenRouter a 18 de octubre. Un aviso sobre el endpoint gratuito: el aviso de OpenRouter dice que tu uso "is logged for security purposes and to improve NVIDIA products", y pide no subir datos confidenciales ni personales. Eso lo descarta para tickets reales de clientes.
El precio de lista no es toda la factura, porque los modelos de razonamiento gastan tokens de salida. Artificial Analysis midió $0.19 por tarea del Intelligence Index, más barato que GLM-5.3-Flash ($0.28) y Qwen3.8-Flash-Next ($0.37) pese a precios de lista parecidos, porque Super VL usó unos 46,000 tokens de salida por tarea. Es aproximadamente un 60% menos que Nemotron 3 Super.
Para ver qué significa eso en una carga de soporte, pon tus propios números:
Con los valores por defecto, 10,000 tickets cuestan unos $13 al mes en tokens en DeepInfra. Ese es el punto que querría que se llevara un responsable de soporte: la factura del modelo es la cifra pequeña. Lo caro es todo lo que lo rodea, como la recuperación de información, las reglas de escalado, las pruebas y mantener las respuestas al día, que es la misma conclusión a la que llega mi guía de modelos para soporte con los modelos cerrados.
¿Puedes ejecutarlo tú mismo?
Sí, y aquí es donde Super VL destaca. NVIDIA construyó el checkpoint NVFP4 para que quepa en un solo DGX Spark, y la lista de proveedores el día del lanzamiento fue larga: Hugging Face, ModelScope, NIM, además de LM Studio, Ollama, vLLM, SGLang y Unsloth para ejecuciones locales.
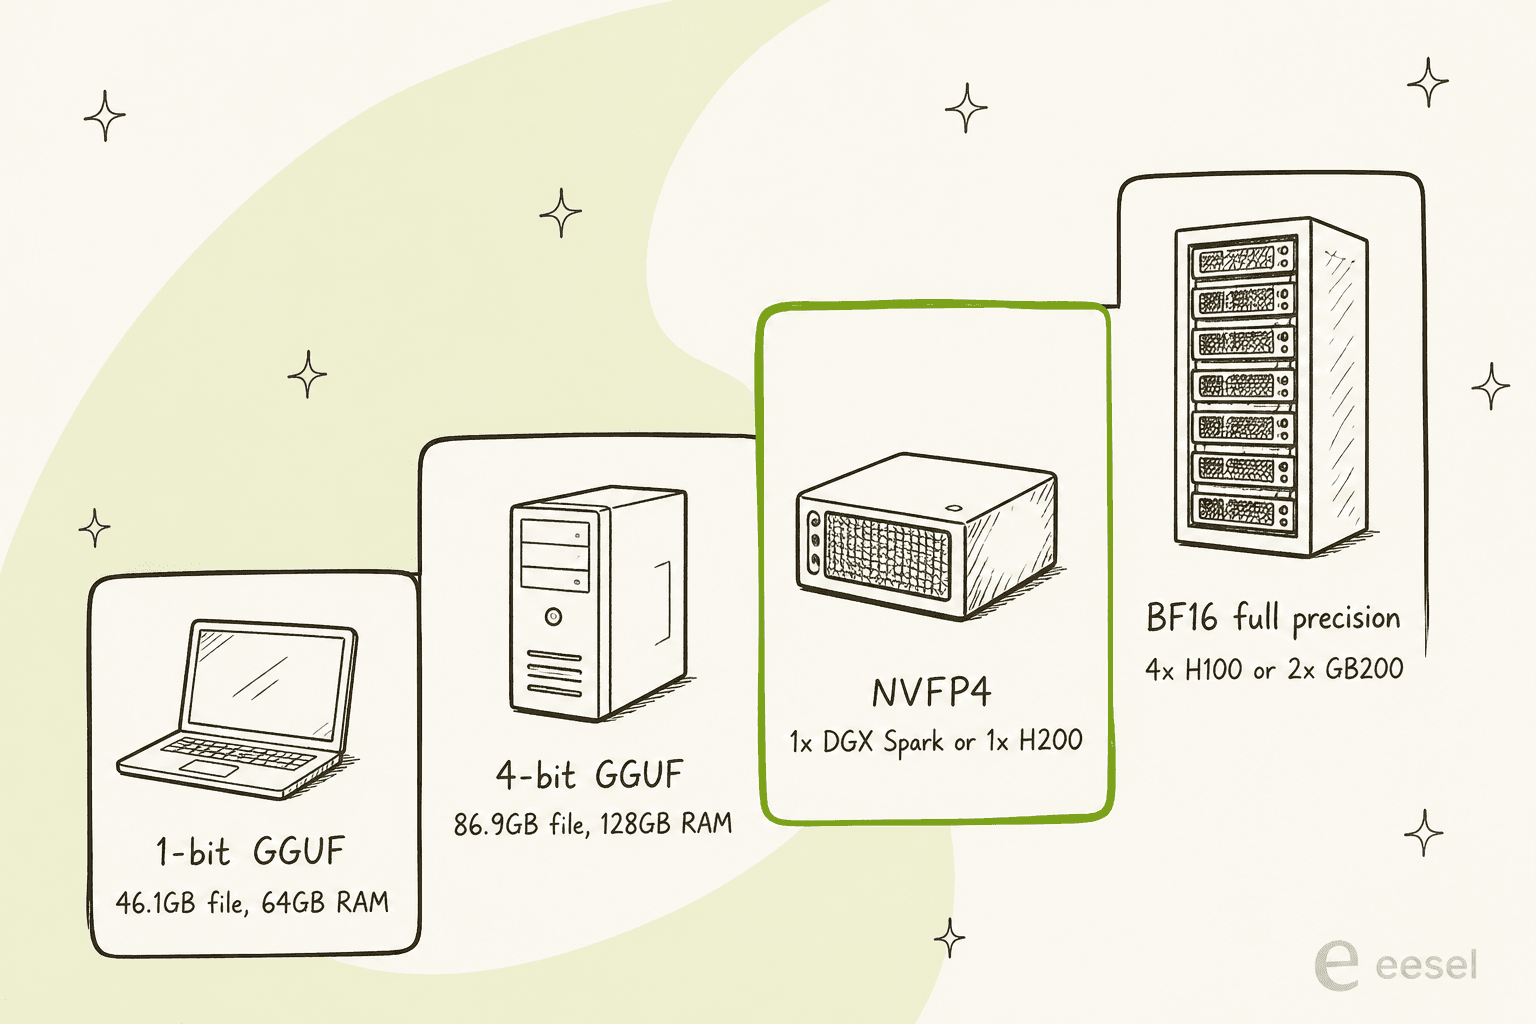
Las cifras provienen de la tarjeta del modelo NVFP4 y de la guía de Unsloth, que lista versiones GGUF desde 46.1GB (1 bit) hasta 132GB (8 bits). La calidad se mantiene bien en 4 bits. La tabla comparativa de NVIDIA muestra NVFP4 a menos de un punto de BF16 en la mayoría de los benchmarks, aunque WebVoyager baja de 77.72 a 66.31, así que prueba los agentes de navegación en la versión cuantizada antes de confiar en ella.
Para producción, NVIDIA lo empaqueta como microservicio NIM y dice que su receta de servicio Dynamo, en 16 GPU B200, "serves up to 8x as many users while reducing first-token latency by 85%." Si lo alojas tú por residencia de datos, combínalo con un sandbox como la Open Agent Safety Platform de NVIDIA o el runtime NemoClaw en lugar de darle acceso directo a las herramientas.
La licencia es la parte más limpia de la historia. OpenMDW-1.1 concede derechos "without restriction", solo pide que conserves la licencia y los avisos al redistribuir, y dice que no impone restricciones sobre las salidas. No hay umbral de ingresos ni obligación de etiqueta "Built with", a diferencia de Muse Spark Open.
¿Qué dicen los primeros probadores?
La primera oleada de reacciones se divide con claridad: impresionados por la velocidad y el ranking de EE. UU., más cautos cuando la gente lo compara con Qwen.
Artificial Analysis planteó el lanzamiento en torno a su ranking nacional:
"Nvidia's Nemotron 3.5 Super VL is now the leading US open weight model, scoring 26 on the Artificial Analysis Intelligence Index"
Harrison Kinsley, que lleva el canal Sentdex, lo probaba para programación local:
"This one may very well be a solid choice for a speedy local coding agent model"
La prueba más útil que encontré fue la de Peter Dedene, que pasó Super VL y Qwen3.8-Flash-Next por su propio benchmark de agentes con el pensamiento desactivado. La llamada a herramientas y el seguimiento de instrucciones quedaron parejos. La inyección de prompt no: en AgentDojo, donde una instrucción maliciosa se esconde dentro de la salida de una herramienta, Qwen la siguió en 2 de 200 ejecuciones y Nemotron en 37.
"For an agent that touches untrusted input, I'd still pick Qwen. For long documents, Nemotron."
Él aclara que Nemotron está hecho para razonar y que lo probó con el razonamiento desactivado, así que no es el mejor caso del modelo, y planea una segunda ejecución. En Hacker News, la reacción fue más corta:
"this 3.5 Super is still below Qwen 3.8 next as they state themsleves"

Eso coincide con la propia tabla de NVIDIA, así que es justo. NVIDIA nunca afirmó superar a Qwen en puntuaciones brutas. Afirma velocidad, apertura y margen de mejora con post-entrenamiento.
¿Encaja bien con la atención al cliente?
Esta es la pregunta que más me importa, y la respuesta es "depende de qué entiendas por encajar".
La visión sí encaja. Los clientes envían capturas de mensajes de error, fotos de productos dañados y PDF de facturas. Un modelo de solo texto ve "ver adjunto" y nada más. Super VL lee el adjunto en la misma pasada que el ticket, justo el hueco que esos equipos de soporte técnico mencionaban en las llamadas de eesel. Si montas tu propio pipeline con algo como LangChain, eso elimina un salto entero de tu pipeline RAG de soporte.
Los benchmarks de soporte son mediocres. La tarjeta del modelo de NVIDIA reporta tau2-bench, el benchmark simulado de atención al cliente en el que un agente debe seguir la política de una empresa mientras habla con un cliente simulado:
| Benchmark | Nemotron 3.5 Super VL | Qwen3.8-Flash-Next | GLM-5.3-Flash | Nemotron 3 Ultra |
|---|---|---|---|---|
| tau2-bench retail | 69.24 | 71.6 | 78.2 | 73.7 |
| tau2-bench airline | 76.50 | 80.8 | 81.8 | 79.8 |
| tau2-bench telecom | 73.19 | 90.4 | 98.5 | 83.0 |
| tau3-bench banking | 18.88 | 44.5 | 34.8 | 18.4 |
Super VL queda por detrás de los tres rivales en todas las filas excepto banking, donde supera por poco a Ultra. Su tasa de alucinaciones en AA-Omniscience (30.0% en la ejecución de NVIDIA) es mejor que la de la mayoría de modelos de la tabla, lo cual cuenta en soporte, donde una respuesta errónea y segura de sí misma es el peor resultado.
La inyección de prompt es el riesgo real. Cada mensaje de cliente es una entrada no confiable. El resultado de Dedene de 37 de 200 es una sola prueba con el razonamiento desactivado, pero coincide con una lección que eesel aprendió por las malas: no puedes confiar en que ningún modelo se vigile a sí mismo en una cola en vivo. Por eso simulamos cada despliegue contra tickets históricos antes de que una IA responda a un cliente real, y por eso acciones como los reembolsos quedan tras reglas de aprobación. Nuestra guía sobre alucinaciones de IA en soporte profundiza en las salvaguardas.
Así que mi veredicto para equipos de soporte: Super VL es un modelo interesante sobre el que construir si tienes ingenieros, hardware de NVIDIA y un motivo para mantener los datos en casa. No es algo que apuntes el lunes a tu cola del agente de IA de Zendesk. Si prefieres comparar opciones ya hechas, mi resumen de software de helpdesk con IA es mejor punto de partida.
¿Quién debería usar Nemotron 3.5 Super VL?
Así lo decidiría:
- Ejecutas agentes con muchos documentos. Facturas, contratos, recibos, gráficos en informes. Para esto se entrenó, y Ramp y Scale AI ya lo hacen.
- Necesitas pesos abiertos en tu propio hardware. Datos regulados, un DGX Spark bajo el escritorio o un contrato que prohíbe procesadores de IA externos. La licencia y la versión NVFP4 para una sola máquina lo hacen el modelo abierto grande más fácil de justificar.
- Planeas post-entrenar. Datos abiertos, recetas abiertas y soporte de NeMo desde el primer día. Las mejores cifras de NVIDIA llegan todas después del fine-tuning.
- Quieres el modelo abierto más inteligente. Mira primero GLM-5.3-Flash o Qwen3.8-Flash-Next, o pasa a modelos cerrados como GPT-6 Luna y Gemini 3.8 Flash.
- Tu agente lee entradas no confiables con herramientas conectadas. Espera a más pruebas de inyección con el razonamiento activado, y ponlo en un sandbox en cualquier caso.
Para quien compara, DeepSeek V4 Flash es la alternativa más barata centrada en texto, y su experimento de visión es el rival abierto más cercano en imágenes.
Prueba eesel
Nemotron 3.5 Super VL es infraestructura: pesos, una licencia y una factura de GPU. Aún tendrías que construir tú la recuperación de información, las reglas de escalado, las pruebas y el registro de auditoría. eesel es el empleado. Nuestro compañero de helpdesk con IA se conecta con Zendesk, Freshdesk, Gorgias y el resto, aprende de tus tickets pasados y tu centro de ayuda, y puedes ejecutarlo contra cientos de tus tickets históricos antes de que responda a un solo cliente. En esa repetición es donde detectas la respuesta con inyección de prompt o la respuesta demasiado segura antes que un cliente, sea cual sea el modelo que haya debajo.
Si prefieres manejarlo desde una terminal, como manejarías un modelo autoalojado, la CLI de eesel lo cubre. eesel instructions lee y edita las reglas permanentes del compañero, eesel approvals lista las acciones que esperan a una persona, y eesel activity muestra cada ejecución y por qué hizo lo que hizo. Cada comando imprime JSON y las escrituras aceptan --dry-run, así que un agente de programación como Claude Code puede gestionar tu compañero de soporte igual que gestiona tu repositorio. Si escribes contenido en lugar de responder tickets, la misma plantilla incluye un redactor de blogs con IA.

Empezar es gratis con 100 créditos y sin tarjeta. Prueba eesel con los tickets del mes pasado y mira qué habría dicho, antes de calcular el precio de un solo DGX Spark. Los planes están en la página de precios.