

Nemotron 3.5 Transcribe es el modelo de voz gratuito y de pesos abiertos de NVIDIA, lanzado el 28 de octubre de 2026, y un solo checkpoint hace cuatro trabajos: transcripciones en 40 idiomas, etiquetas de "quién dijo qué" para hasta ocho hablantes, traducción en 31 idiomas y respuestas sobre el audio. Le indicas qué trabajo quieres con un prompt sencillo en lenguaje normal.
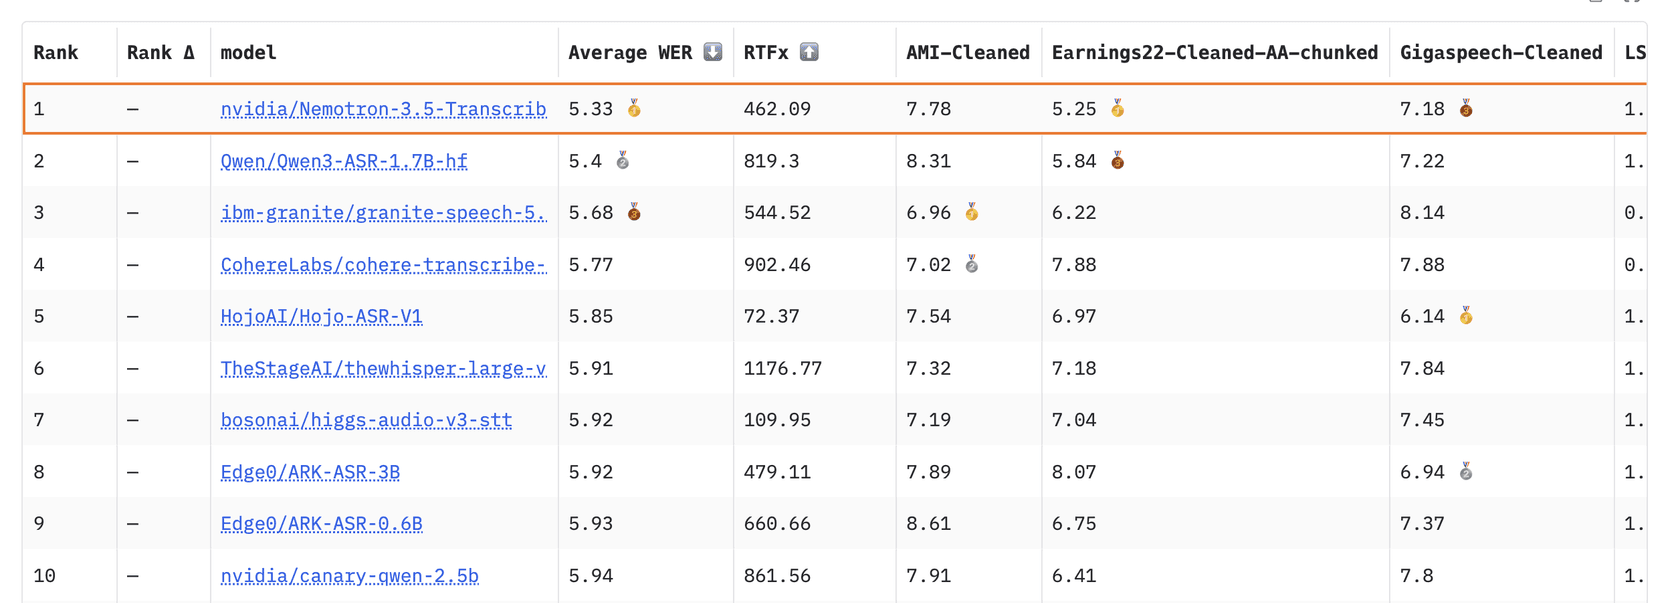
Es preciso para ser un modelo abierto: 2,81 % de tasa de error de palabras en Artificial Analysis, segundo entre los modelos abiertos, y primero en el leaderboard abierto en inglés de Hugging Face con un 5,33 %. El inconveniente es el tamaño y el momento. Hoy necesita una GPU de centro de datos de 80 GB y solo funciona con grabaciones, no con llamadas en vivo. Si no quieres el hardware, DeepInfra lo aloja a 0,002 $ el minuto, cerca de la mitad de lo que cobran la mayoría de las API de transcripción.
Para un equipo de soporte, una transcripción es el primer paso, no el último. Trabajo en eesel, y el compañero de IA para el helpdesk que ayudo a construir es el que recoge el ticket en que se convierte una llamada o un mensaje de voz y lo responde en el idioma del cliente, como hace para Koffer.ch en alemán, francés, inglés e italiano.
¿Qué es Nemotron 3.5 Transcribe?
Nemotron 3.5 Transcribe es un modelo de voz de pesos abiertos de NVIDIA. Toma un archivo grabado y lo convierte en texto, y después en el tipo de texto que le pidas. NVIDIA lo llama un modelo de lenguaje aumentado con voz: un codificador de audio alimenta a un modelo de lenguaje, así que controlas la salida con instrucciones en lugar de ajustes (ficha del modelo).
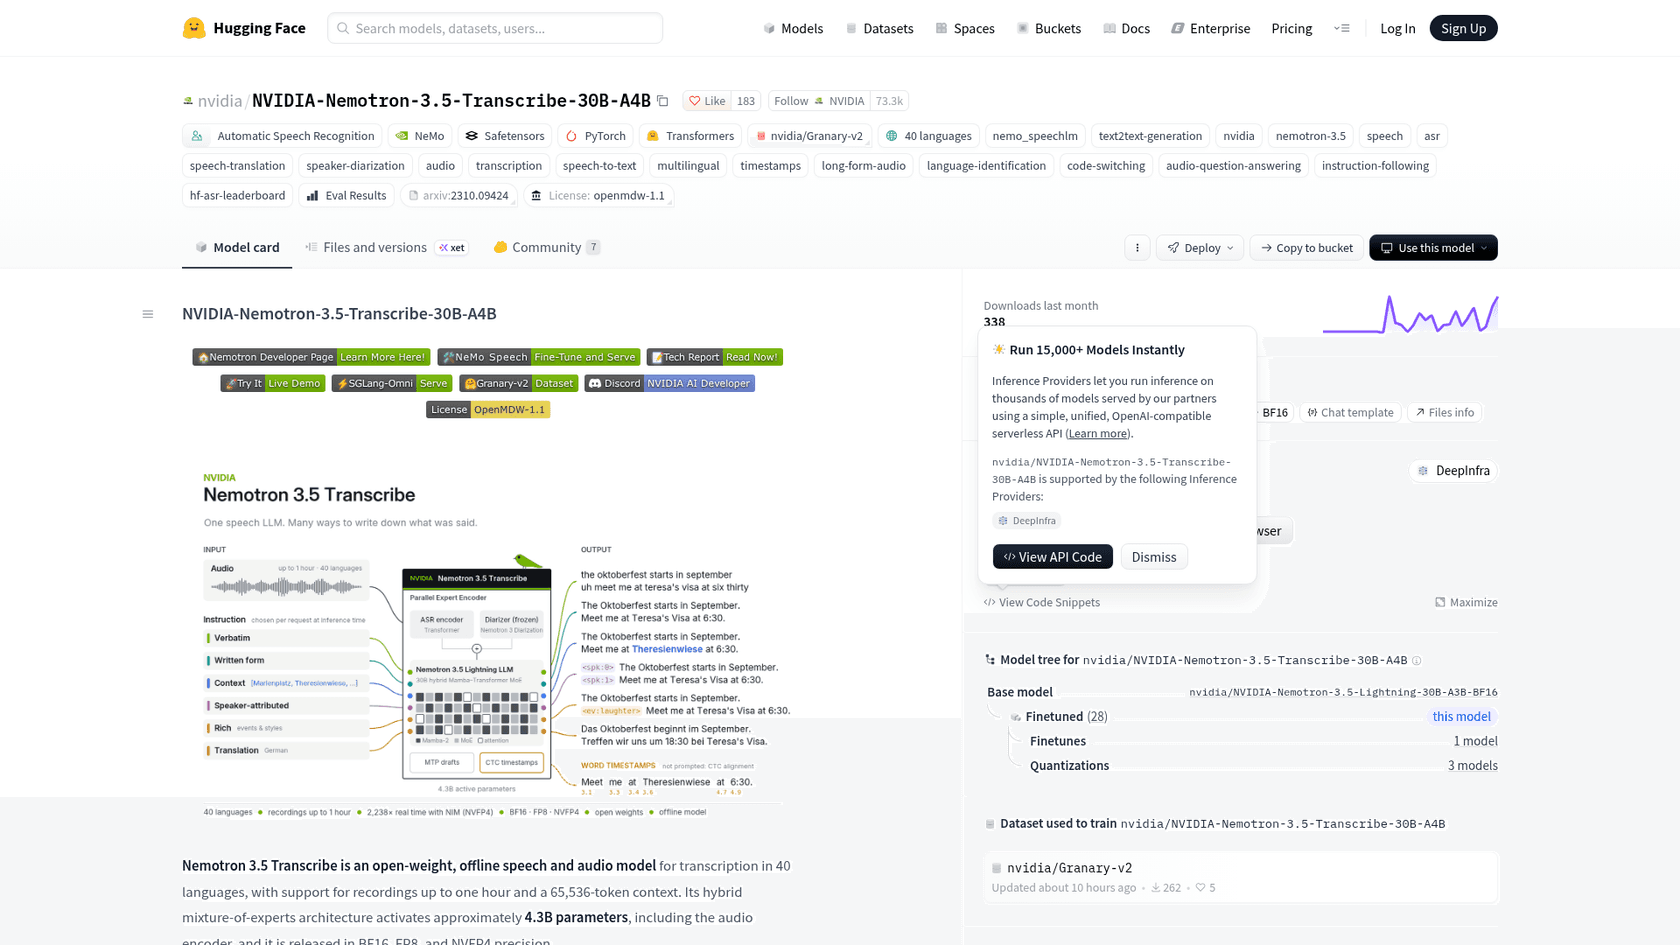
Las cifras principales, todas del blog de lanzamiento de NVIDIA y de la ficha del modelo:
| Especificación | Nemotron 3.5 Transcribe |
|---|---|
| Lanzamiento | 28 de octubre de 2026 |
| Tamaño | Mezcla de expertos de clase 30B, unos 4B activos por token (la ficha cuenta 34B en total, 4,3B activos, con el codificador de audio) |
| Transcripción | 40 idiomas |
| Traducción | 31 idiomas, desde o hacia el inglés |
| Etiquetas de hablante | 13 idiomas, hasta 8 hablantes |
| Grabación más larga | 1 hora (contexto de 65.536 tokens) |
| Streaming en vivo | No, solo audio grabado |
| Licencia | OpenMDW-1.1, uso comercial permitido |
| Precisiones | BF16 ahora; FP8 y NVFP4 anunciadas como próximas |
La parte de "unos 4B activos" es en realidad la razón por la que un modelo de este tamaño es utilizable. Es una mezcla de expertos híbrida Mamba-Transformer, construida sobre el modelo de lenguaje Nemotron 3.5 Lightning de NVIDIA, así que solo una pequeña porción de los pesos trabaja en cada token. Es el mismo truco que usa el resto de la familia, como Nemotron 3.5 Super VL.
Hay una trampa de nombres que conviene señalar. "Nemotron 3.5 ASR" es un modelo de streaming distinto y diminuto, así que cuando veas un precio o una cifra de velocidad en línea, comprueba de cuál de los dos habla.
¿Qué le puedes pedir que haga?
Puedes pedir una transcripción literal, una limpia, una con etiquetas de hablante, una traducción o una respuesta, todo desde el mismo archivo. Lo único que cambia entre ellas es una línea de prompt. Los propios ejemplos de NVIDIA son tan simples como "Transcribe this recording and label each speaker" o "What decisions were made in this meeting?" (blog de lanzamiento).
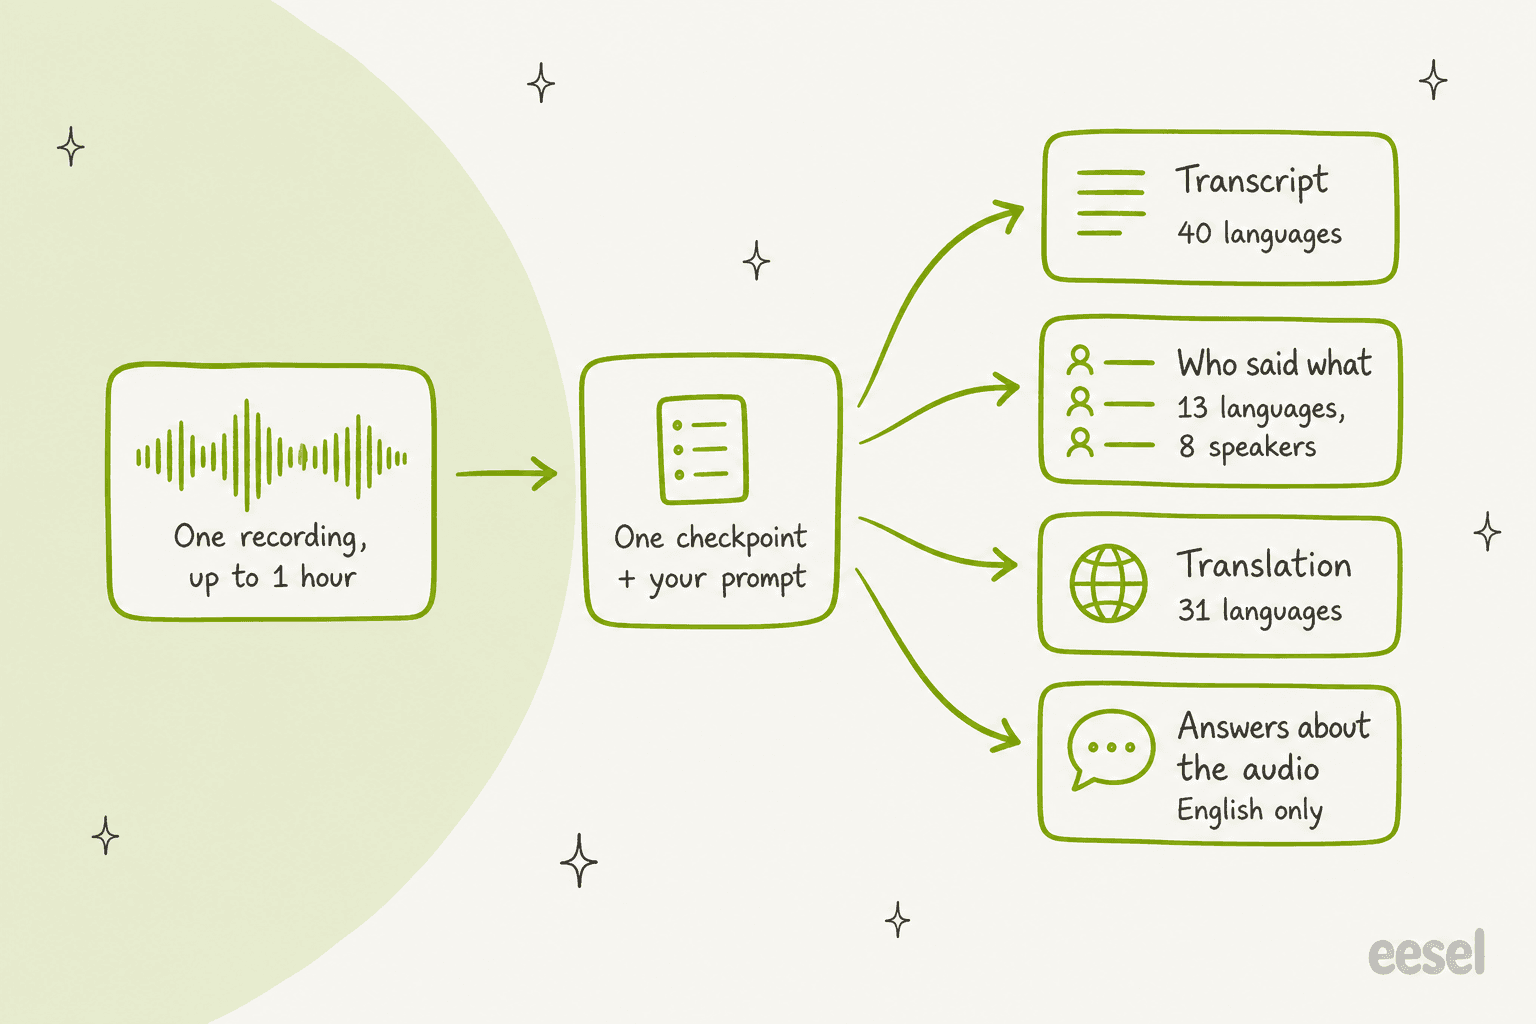
Los prompts que más importan en el trabajo real, según la ficha del modelo:
- Literal o limpio. Conservar cada "eh" y repetición, o quitarlos y dejar el resto igual.
- Términos de contexto. Lista de antemano nombres de producto, personas o jerga. En la prueba contextual de llamadas de resultados de NVIDIA, la recuperación de palabras clave pasó del 58,16 % al 96,05 % al darle los términos.
- Hablantes y marcas de tiempo. Pide etiquetas de hablante y tiempos de palabra en una sola pasada, en lugar de ejecutar después una herramienta de diarización aparte.
- Valores exactos. Un preajuste mantiene correos, URL, rutas de archivo y números de pedido escritos como se dijeron, que es lo que una transcripción de soporte no puede equivocar.
- Marcado de datos personales. El modelo fue entrenado para marcar o censurar datos personales, útil si censuras las transcripciones de soporte antes de que alguien las lea.
La ficha incluso nombra las "support recordings" como un caso adecuado para el prompt de términos de contexto y lista el servicio al cliente como campo de aplicación. Así que los centros de llamadas están bastante claramente en la mente de NVIDIA con este modelo.
¿Qué tan bueno es en realidad?
En las pruebas públicas es el mejor o el segundo mejor modelo de voz abierto, y queda un paso por detrás de los mejores cerrados. A continuación, lo que dicen las cifras y también dónde no coinciden entre sí.
Leaderboard Open ASR de Hugging Face (inglés). Primero entre los modelos de pesos abiertos con una tasa media de error de palabras del 5,33 %, justo por delante de Qwen3-ASR-1.7B con un 5,4 % (leaderboard). La tasa de error de palabras es la proporción de palabras que un modelo falla, así que cuanto menor, mejor.
Artificial Analysis. 2,81 % en su índice de error, segundo entre los modelos abiertos, a un pelo de Voxtral Small con 2,77 %, que usa unas seis veces más parámetros activos (Artificial Analysis). El propio blog de NVIDIA lo llama un empate por el primer puesto. Los modelos cerrados siguen liderando en conjunto: MAI-Transcribe-2 está en 2,04 % y Gemini 3.5 Transcribe en 2,60 %. En el conjunto de agentes de voz, AgentTalk, obtiene 1,78 %, cerca de lo más alto de toda la tabla.
Pondría dos asteriscos a esa cifra, eso sí. El endpoint público de DeepInfra mide 3,4 % en el mismo índice, así que el 2,81 % salió de una configuración a la que la mayoría aún no puede acceder. Y en llamadas de resultados obtiene 5,69 %, por detrás de ElevenLabs Scribe v2 con 3,95 %.
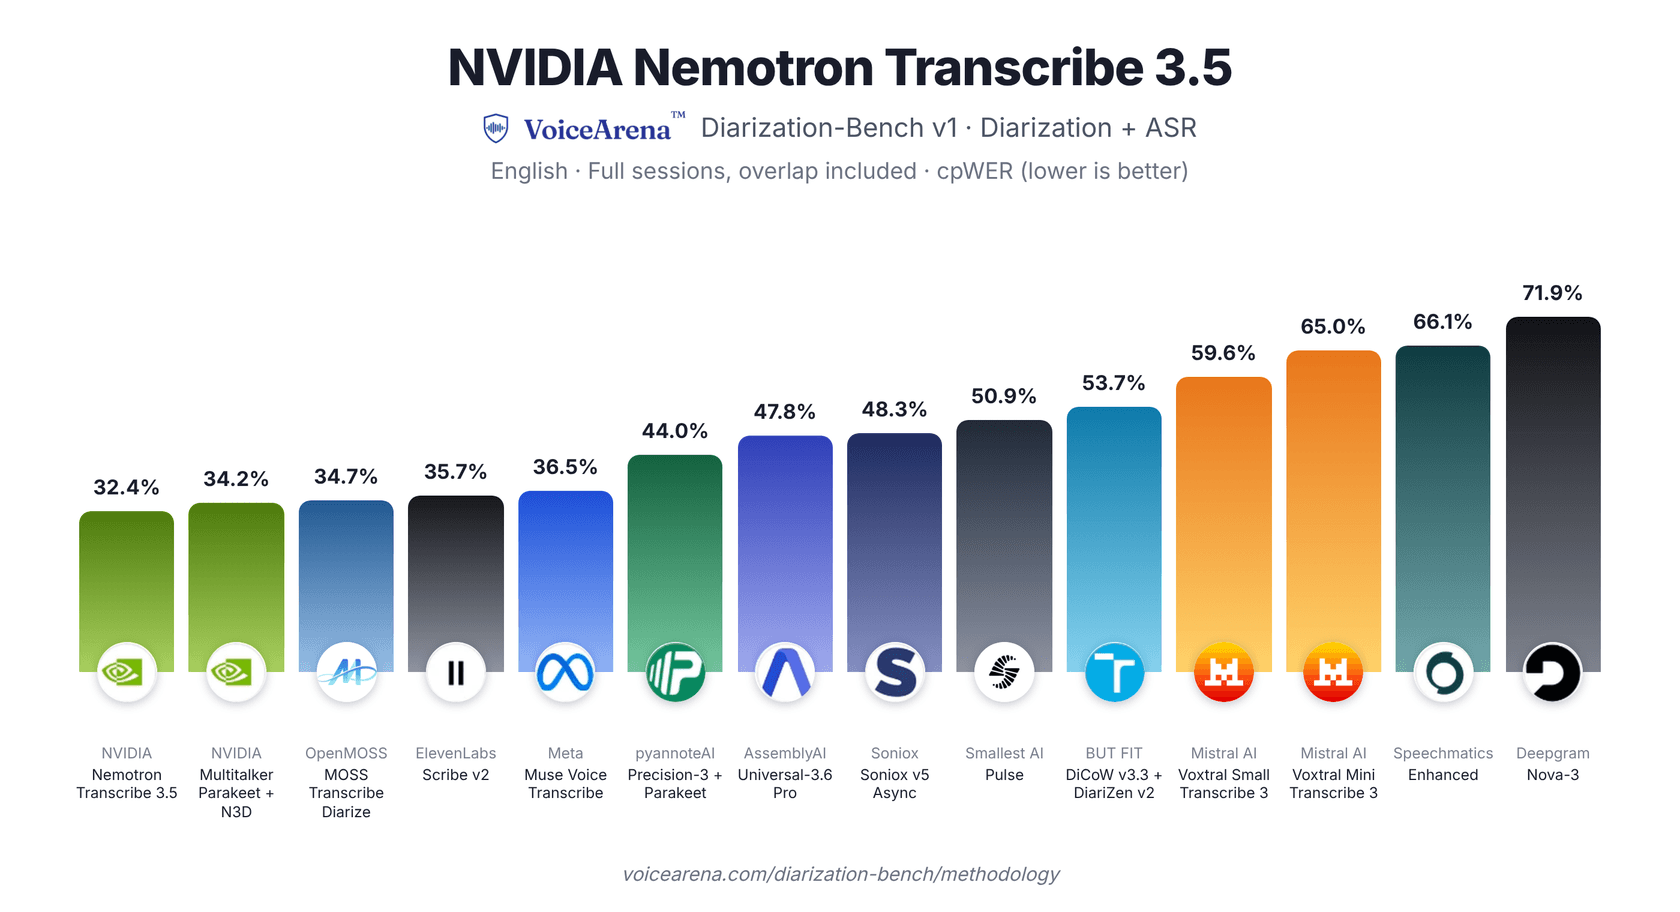
Quién dijo qué. Aquí es donde más destaca. En el benchmark de diarización de VoiceArena, con sesiones completas en inglés y habla superpuesta, quedó primero de 14 sistemas con un 32,4 % de error tras emparejar hablantes, y omitió muchas menos palabras que el resto: 8,32 % frente a una mediana de alrededor del 31 % (blog de lanzamiento).
Los idiomas no son iguales. NVIDIA clasifica 13 idiomas como "leading", entre ellos inglés, español, alemán, francés, hindi y coreano, y otros 15 como listos para producción. Algunos van muy rezagados: el error en FLEURS es del 26,93 % para el griego y del 20,97 % para el hebreo, y el noruego, con 63,76 %, no tiene soporte de transcripción en absoluto (ficha del modelo). Así que si tus clientes llaman en noruego, este modelo todavía no es para ti.
¿Qué dice la gente tras el primer día?
La reacción inicial es entusiasta con la lista de funciones, pero mixta cuando la gente lo prueba de verdad. El hilo de r/LocalLLaMA superó los 193 votos en un día, y su comentario más votado marcó el tono:
"Holy! This might be the holy grail of OS ASR models I have been looking for - something to dethrone venerable Qwen ASR."

La única prueba real hasta ahora, en Hacker News, vino de alguien que ejecutó una cuantización comunitaria de 4 bits con audio en japonés, y que advirtió que podría no tener la precisión completa:
"testing it against parakeet right now for ASR, it's slower, heavier, and has a higher error rate. but i'm doing a pass with the embedded translation to see if that's any good, it might be worth it."

Su seguimiento sobre la traducción no fue más amable ("disappointing model"), así que trata las victorias en benchmarks como cifras de NVIDIA hasta que lleguen pruebas independientes con pesos de precisión completa. Lo otro que sale una y otra vez es el tamaño. Como dijo un comentarista de Reddit, "30b for ASR is such a luxury", cuando el Parakeet de 0,6B de NVIDIA funciona en casi cualquier cosa (Reddit).
El caso de uso que más pareció gustar es uno que los equipos de soporte y operaciones conocen bien: reuniones y llamadas desordenadas donde la gente habla encima de los demás.
"finally a model that can follow a standup where everyone unmutes at once"
¿Cómo se ejecuta Nemotron 3.5 Transcribe?
Ahora mismo hay tres formas de entrar. Puedes probar una demo gratuita o llamar a una API alojada, y si tienes el hardware, ejecutarlo en tu propia GPU.
- Probar la demo. El Hugging Face Space de NVIDIA acepta una subida y un prompt. Es buena forma de comprobar tu propio audio antes de comprometerte con nada.
- Llamar a una API alojada. DeepInfra lo lista a 0,002 $ por minuto con cero retención de datos. Baseten y Simplismart también lo alojan, pero venden tiempo de GPU o presupuestos a medida en lugar de un precio por minuto.
- Alojarlo tú mismo. La ficha del modelo da una receta de vLLM 0.32.0 en una H100 de 80 GB, además de opciones con Transformers y SGLang-Omni. El servidor vLLM habla el formato de chat de OpenAI, así que el código escrito para la API de audio de OpenAI se porta con cambios pequeños.
La ficha también tiene algunas trampas fáciles de pasar por alto:
- La versión rápida aún no es abierta. El titular de NVIDIA de 100 horas de audio en menos de tres minutos usa los pesos NVFP4 sin publicar y su propio servidor optimizado. La configuración abierta de vLLM "expected to be roughly two times slower".
- SGLang-Omni solo transcribe. Esa vía omite marcas de tiempo, etiquetas de hablante y traducción, que son la mitad de la razón para elegir este modelo.
- Las GPU más pequeñas esperan. El soporte de la RTX 5090 es solo NVFP4 y el de la L40S solo FP8, y ninguno de los repositorios era público el 29 de octubre.
- Puede entrar en bucle. NVIDIA incluye una expresión regular de limpieza para el raro caso en que la salida no se detiene, y avisa de habla alucinada. Revisa por muestreo nombres y cambios de hablante.
Si ejecutar modelos abiertos en tu propio hardware es nuevo para ti, la guía de Hugging Face cubre lo básico del hub por el que NVIDIA lo distribuye.
¿Cuánto cuesta?
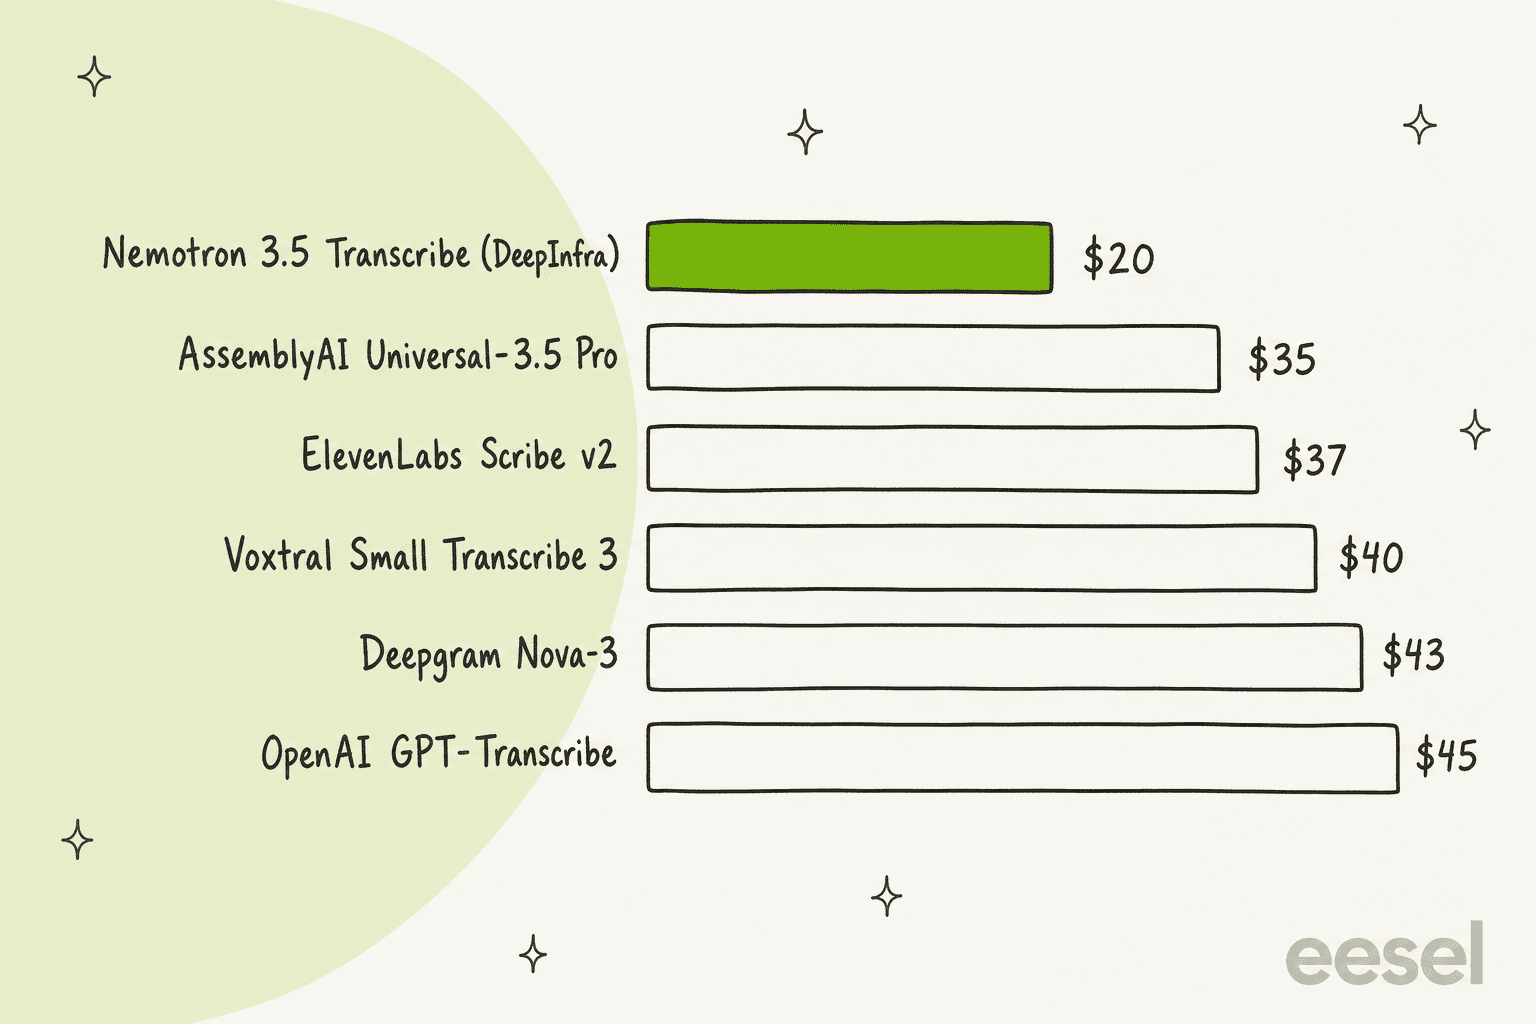
Los pesos no cuestan nada, así que el precio real es lo que pagues por la GPU o la API. A tarifas alojadas, resultó ser la opción precisa más barata que encontré. Aquí van 10.000 minutos de llamadas grabadas al mes, unas 167 horas, con precios de la página de cada proveedor:
| Modelo | Precio por lotes | 10.000 minutos | Fuente |
|---|---|---|---|
| Nemotron 3.5 Transcribe (DeepInfra) | 0,002 $/min | 20 $ | DeepInfra |
| AssemblyAI Universal-3.5 Pro | 0,21 $/h | 35 $ | AssemblyAI |
| ElevenLabs Scribe v2 | 0,22 $/h | unos 37 $ | ElevenLabs |
| Mistral Voxtral Small Transcribe 3 | 0,004 $/min | 40 $ | Mistral |
| Deepgram Nova-3, pregrabado | 0,0043 $/min | 43 $ | Deepgram |
| OpenAI GPT-Transcribe | 0,0045 $/min | 45 $ | OpenAI |
| Gemini 3.5 Transcribe | unos 0,005 $/min | unos 50 $ |
La brecha se amplía al comparar funciones por igual. Nemotron incluye prompting, términos de contexto y etiquetas de hablante en la llamada base. En AssemblyAI, añadir prompting (0,05 $/h) y diarización (0,02 $/h) a Universal-3.5 Pro lo sube a 0,28 $ la hora, más del doble de los 0,12 $ de Nemotron. Para un análisis más profundo de los rivales, mira los desgloses de Gemini 3.5 Transcribe y Voxtral 3.
Alojarlo tú mismo solo sale más barato por hora de audio si la GPU se mantiene ocupada. Baseten alquila una H100 a 0,10833 $ el minuto (Baseten), unos 6,50 $ la hora. NVIDIA mide de 260 a 410 veces el tiempo real en esa tarjeta para inglés por lotes, así que una hora de GPU cubre de 260 a 410 horas de audio. Según mis cuentas, son aproximadamente 2 a 3 centavos por hora de audio, frente a 12 centavos en DeepInfra, pero solo cuando le das un lote constante. Un equipo con 167 horas al mes pagaría por una GPU casi siempre inactiva, así que la API gana hasta que el volumen sea serio.
¿Dónde encaja para un equipo de soporte?
Encaja en cualquier sitio donde ya tengas grabaciones y quieras texto que puedas buscar, puntuar o accionar. Las conversaciones en vivo son donde no encaja.
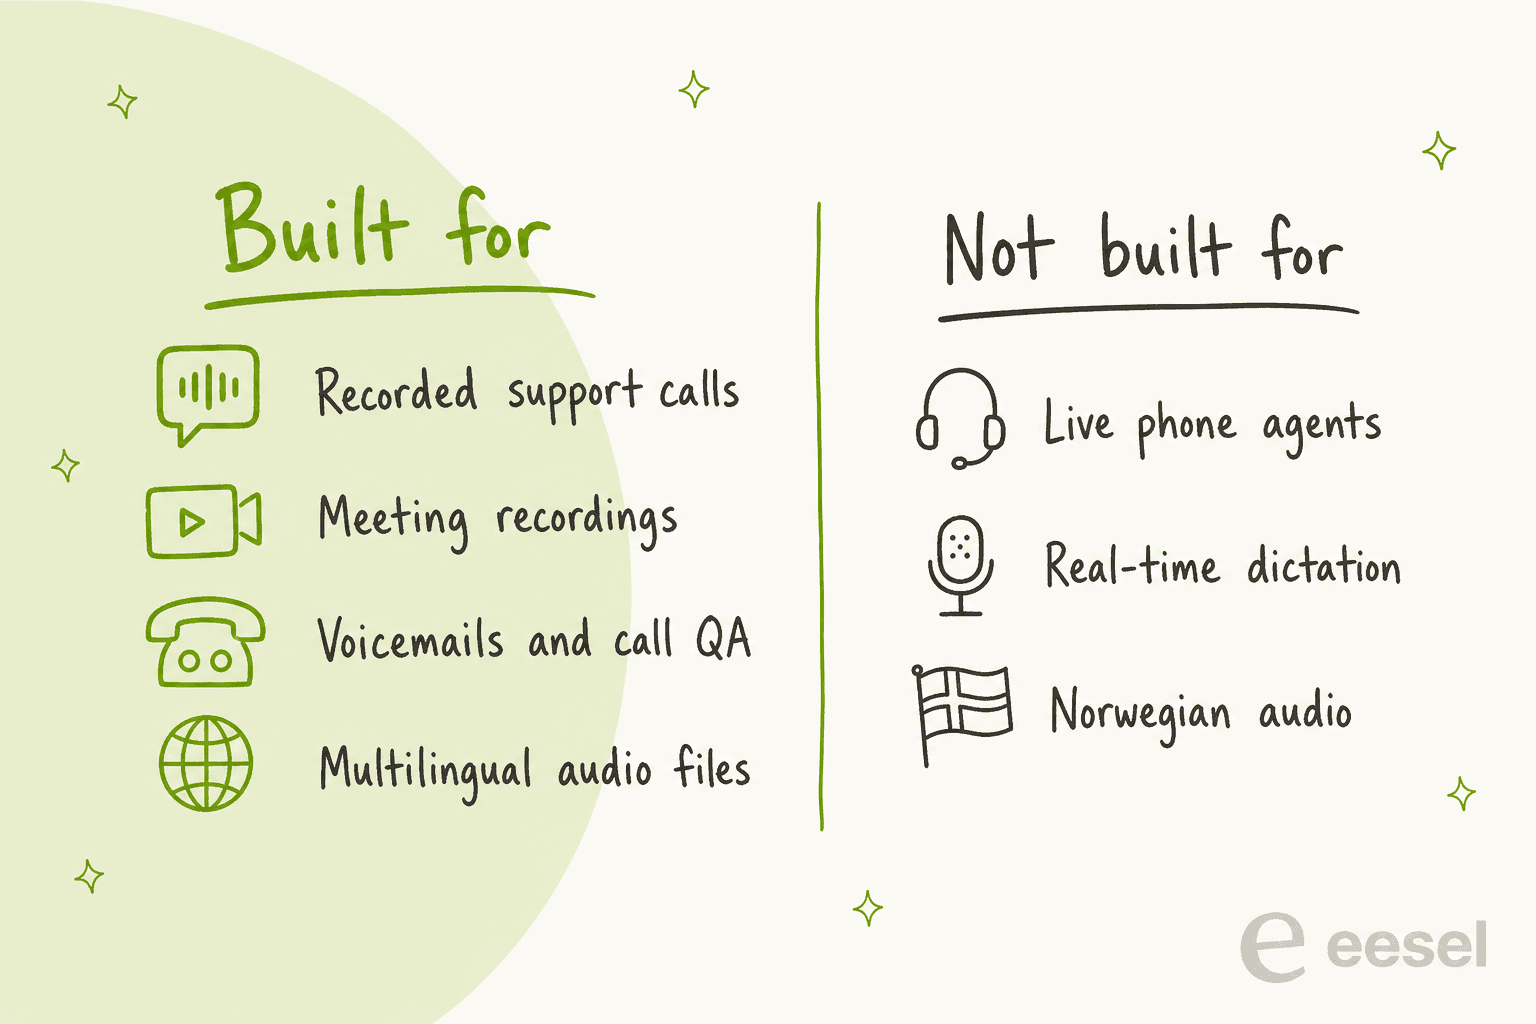
- Control de calidad de llamadas. Las transcripciones con etiquetas de hablante facilitan puntuar cómo gestionan los agentes las llamadas, la parte aburrida del control de calidad en centros de llamadas. Combínalo con el QA de soporte con IA para calificar el texto.
- Mensajes de voz y devoluciones de llamada. Transcribe y deja que el ticket lleve el texto, para que quien lo recoja no tenga que escuchar primero.
- Resúmenes y sentimiento. La transcripción alimenta el resumen de tickets y el análisis de sentimiento, igual que las transcripciones de chat.
- Colas multilingües. Un modelo que cubre 40 idiomas es mejor que unir una herramienta distinta por mercado, que es media batalla en el soporte al cliente multilingüe.
Lo que no hará es hablar con quien llama. Para eso necesitas un modelo de streaming dentro de un agente de voz con IA, o una de las herramientas de mi lista de mejores agentes de voz con IA. Tampoco decidirá qué responder. Una transcripción perfecta de una solicitud de reembolso sigue necesitando a alguien, o algo, que conozca tu política de reembolsos.
Esa segunda parte es donde paso la mayor parte de mis días. En los años que eesel lleva ejecutando IA en colas de soporte reales, lo difícil nunca fue convertir palabras en texto. Fue responder correctamente a partir de las políticas propias de una empresa y saber cuándo traspasar, y por eso cada despliegue se prueba con los tickets pasados de un equipo antes de responder a nadie.
Por qué importa Nemotron 3.5 Transcribe
Importa porque hace opcional "enviar el audio a la nube de otro". Hasta ahora, los modelos de voz precisos con etiquetas de hablante y traducción integradas eran API cerradas, y los abiertos eran modelos pequeños de un solo trabajo que había que encadenar. Nemotron 3.5 Transcribe lo pone todo en un checkpoint abierto que puedes ejecutar en tu propio centro de datos, con una licencia comercial y los datos de entrenamiento Granary v2 de NVIDIA (463.062 horas en 48 idiomas) publicados junto a él.
El otro cambio es que adaptarlo ahora es barato. El caso de estudio médico de NVIDIA lo ajustó con habla clínica con acento indio y redujo los errores del 30,8 % de fábrica al 11,8 %, en unas 14 horas de GPU en una sola GB300 (caso de estudio).
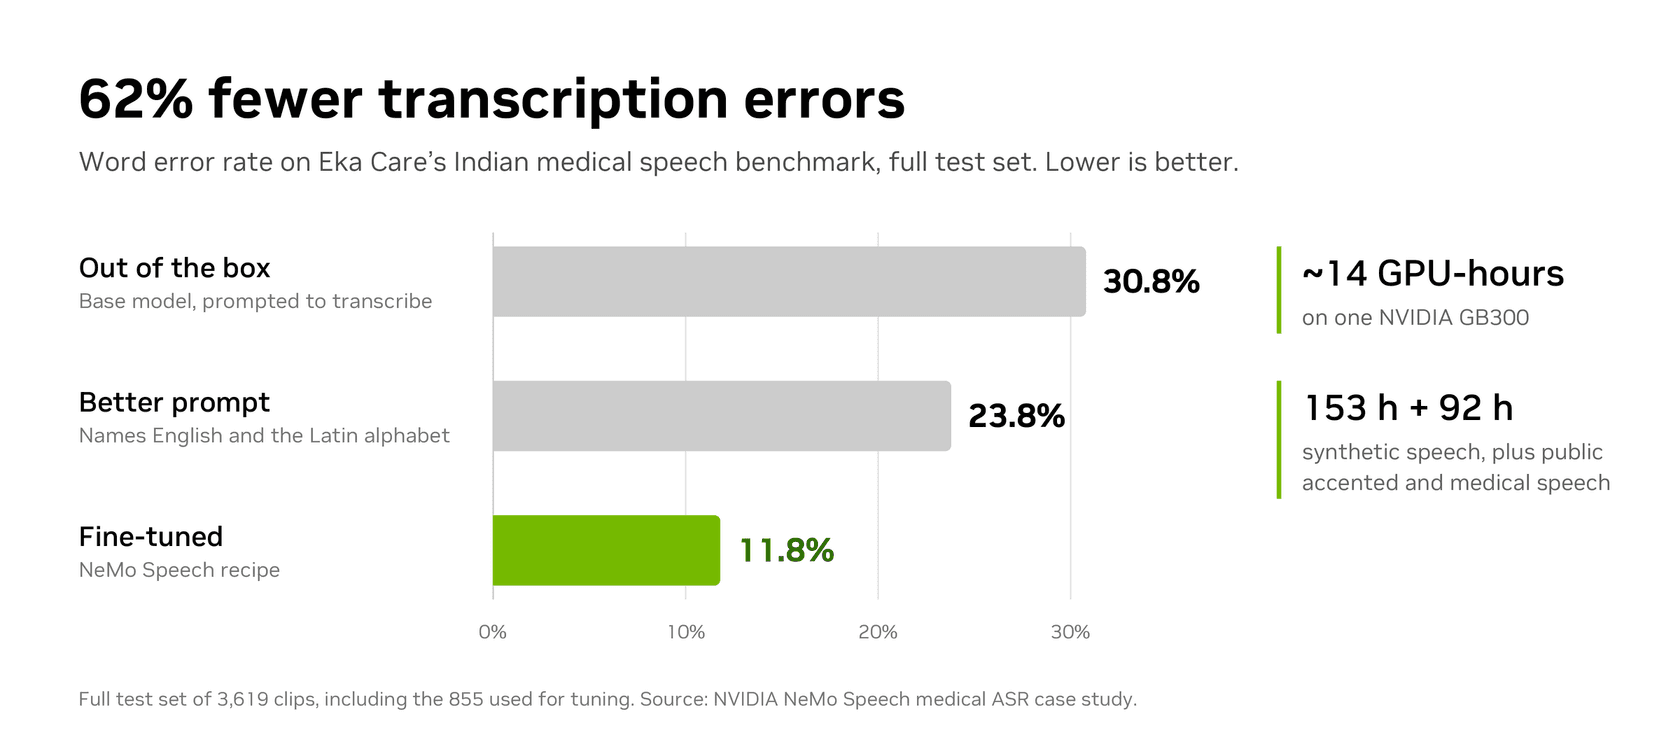
La barra del medio es la que hay que mirar. Un mejor prompt por sí solo lo llevó de 30,8 % a 23,8 % antes de cualquier entrenamiento. Mi opinión: prueba el prompt antes de probar el ajuste fino. Decirle al modelo el idioma y el alfabeto, además de los nombres de tus productos, no cuesta nada y, para la mayoría de los equipos de soporte, es casi toda la mejora.
Si lo estás comparando con otros modelos abiertos para una pila más amplia, la plataforma abierta de seguridad de agentes de NVIDIA y mi lista de agentes de IA de código abierto cubren las piezas alrededor.
Prueba eesel
Nemotron 3.5 Transcribe es infraestructura: oídos excelentes, sin descripción de puesto. Convierte una llamada en texto. Lo que pasa después, leer el ticket, comprobar el pedido, responder en el idioma del cliente, escalar al enfadado, es un trabajo, y eso es lo que hace el compañero de IA para el helpdesk de eesel. Se une a Zendesk, Freshdesk o Gorgias, aprende de tus tickets pasados y tu centro de ayuda, y puedes probarlo con cientos de esos tickets antes de que responda a nadie.

El idioma es donde más rinde. En smava, gestionó 27.000 tickets de Zendesk en un mes, etiquetando el idioma y la categoría de cada uno y redactando respuestas en alemán. En Koffer.ch, redacta respuestas de Freshdesk en cualquiera de los cuatro idiomas en que escribió el cliente, con ortografía suiza en el alemán.
Si te gusta ejecutar modelos desde una terminal, la CLI de eesel opera el mismo compañero: leer y editar sus instrucciones, aprobar acciones que esperan a una persona y revisar el registro de actividad de cada ejecución, con salida JSON y simulaciones en las escrituras. Un agente de programación como Claude Code puede gestionar tu compañero de soporte junto a tu pipeline de transcripción. Prueba eesel gratis, o reserva una demo para verlo con tus propios tickets.