

¿Qué es EmbeddingGemma 2?
EmbeddingGemma 2 es un modelo de embeddings abierto de Google DeepMind, anunciado el 6 de octubre de 2026.
Un modelo de embeddings hace una sola cosa: convierte una entrada en una lista de números (un vector) para que las cosas parecidas queden cerca. Es el motor de la búsqueda semántica, del clustering y de la mitad de recuperación de RAG.
El primer EmbeddingGemma, un modelo de 308M solo de texto, salió en 2025 y superó los 20 millones de descargas, según Google. La versión 2 mantiene la idea de un modelo pequeño que funciona en cualquier sitio y lo vuelve multimodal con cuatro tipos de entrada más. Según la model card, asigna texto (incluido código), imágenes, vídeo y audio, o cualquier mezcla de ellos, a un único espacio de 768 dimensiones.
Una nota rápida sobre mi punto de partida. Soy ingeniero de software en eesel y construyo los agentes de IA que buscan en el centro de ayuda de un cliente antes de responder un ticket. Así que, cuando leo el lanzamiento de un modelo de embeddings, me interesa menos el ranking y más tres preguntas: qué encuentra que el anterior no encontraba, cuánto cuesta ejecutarlo y qué se rompe. No he puesto este modelo en producción. Mi lectura se basa en la model card y la documentación de Google, la guía para desarrolladores y los primeros tres días de informes prácticos en Hacker News.
EmbeddingGemma 2 de un vistazo
| Spec | EmbeddingGemma 2 | Fuente |
|---|---|---|
| Lanzamiento | 6 de octubre de 2026 | Google blog |
| Parámetros | 740M en total: 270M texto, 170M visión, 300M audio | Model card |
| Entradas | Texto, código, imágenes, vídeo, audio y mezclas intercaladas | Model card |
| Salida | 768 dimensiones, truncable a 512, 256, 128 | Developer guide |
| Ventana de contexto | 8,192 tokens (v1: 2,048) | Model card |
| Idiomas | Más de 100 | Gemma docs |
| RAM, cuantizado, Pixel 11 Pro | ~191MB solo texto, ~567MB completo | Google AI Edge |
| Licencia | Apache 2.0 | Gemma docs |
| Precio | Pesos gratuitos; pagas el cómputo | n/a |
| Base | Arquitectura de decodificador de Gemma 4 | Gemma docs |
¿Cómo funciona EmbeddingGemma 2?
Por dentro, es un modelo de texto pequeño con dos complementos opcionales acoplados al frente. El núcleo es un modelo de 270M de parámetros (un transformer de 130M más un embedder de 140M) adaptado del decodificador de Gemma 4. Un codificador de visión de 170M se encarga de imágenes, fotogramas de vídeo y documentos visuales como PDF y diapositivas. Un codificador de audio de 300M toma voz y sonido en bruto. Todo pasa por la misma base y sale como un único vector de 768 números.
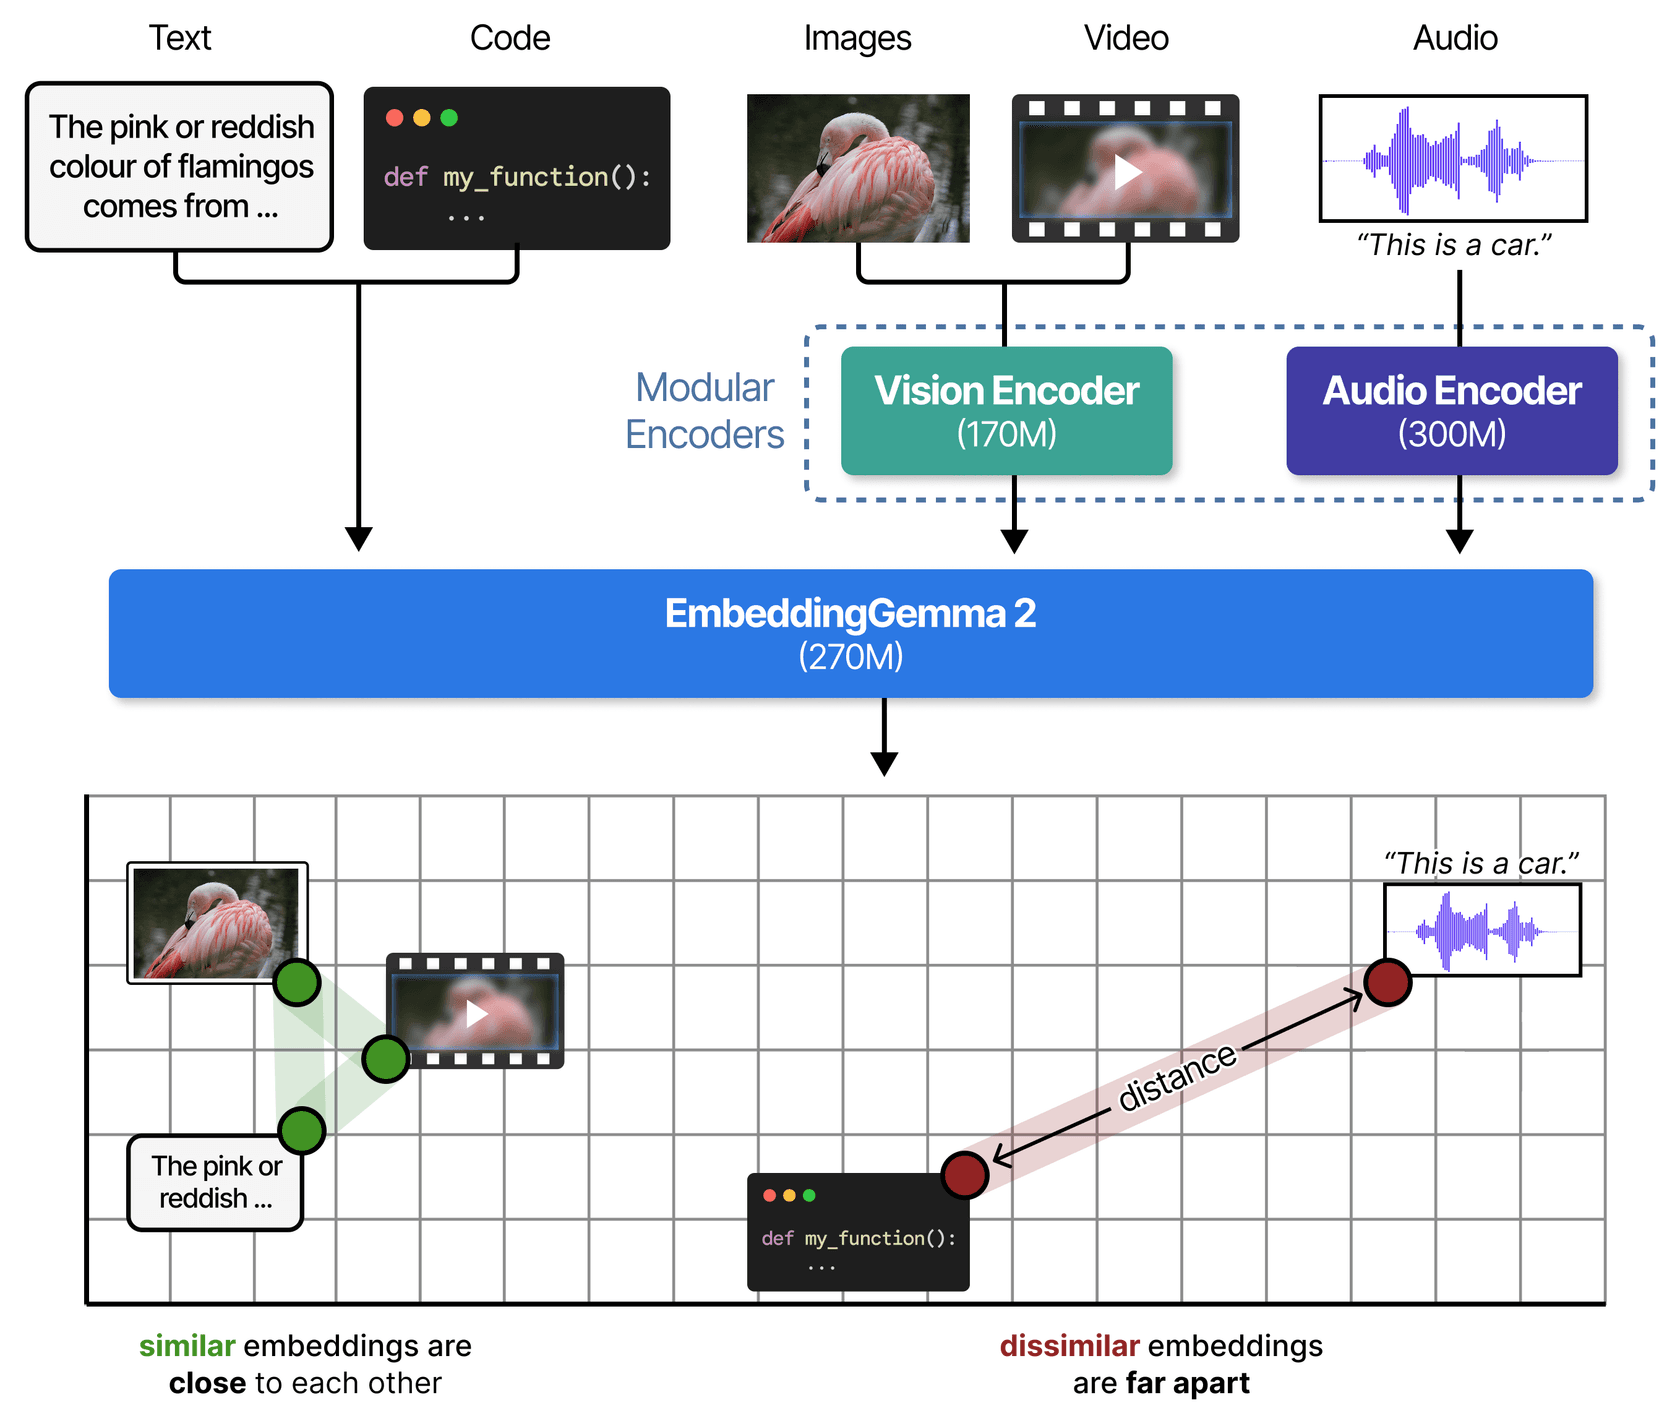
Lo ingenioso es que los complementos son opcionales al cargar. Pones vision_config o audio_config en None y ese codificador nunca se carga, lo que ahorra disco y memoria. Según la guía para desarrolladores de Google, las cuatro configuraciones cargan desde el mismo checkpoint y comparten un espacio vectorial. Una consulta generada con la configuración de solo texto de 270M puede coincidir con documentos generados con el modelo completo.
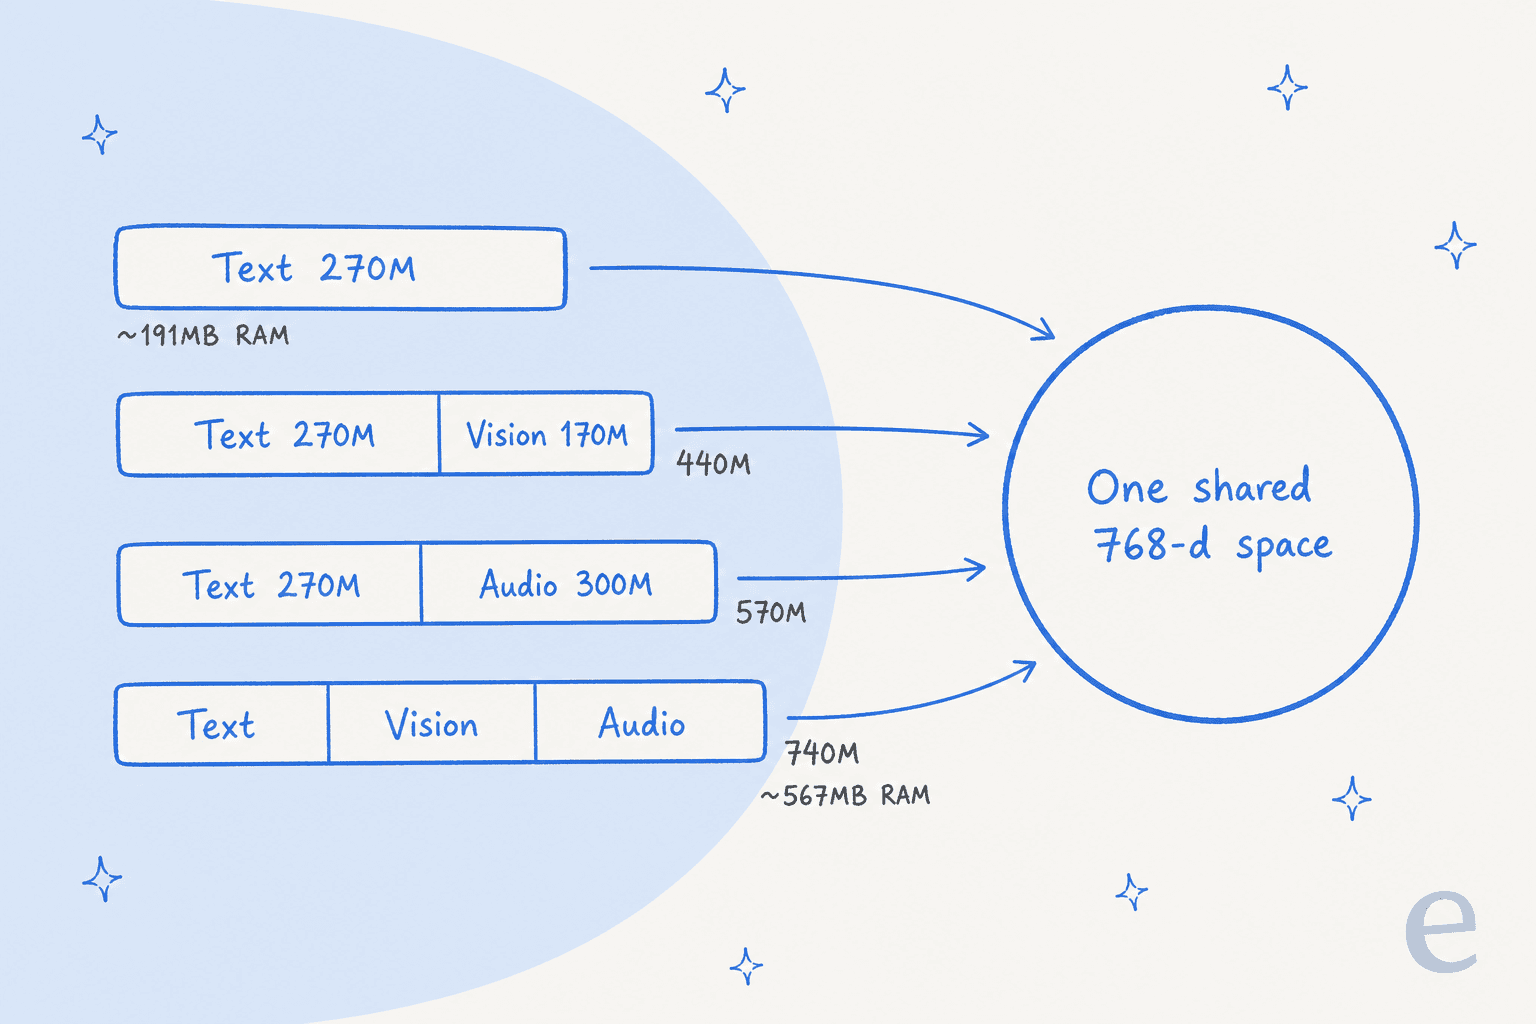
Eso tiene una ventaja práctica que me gusta mucho. Puedes empezar solo con texto y añadir imágenes después sin recalcular un solo vector que ya tengas, dice la guía. Si alguna vez has vuelto a generar los embeddings de un millón de documentos por cambiar de modelo, sabes cuánto vale eso.
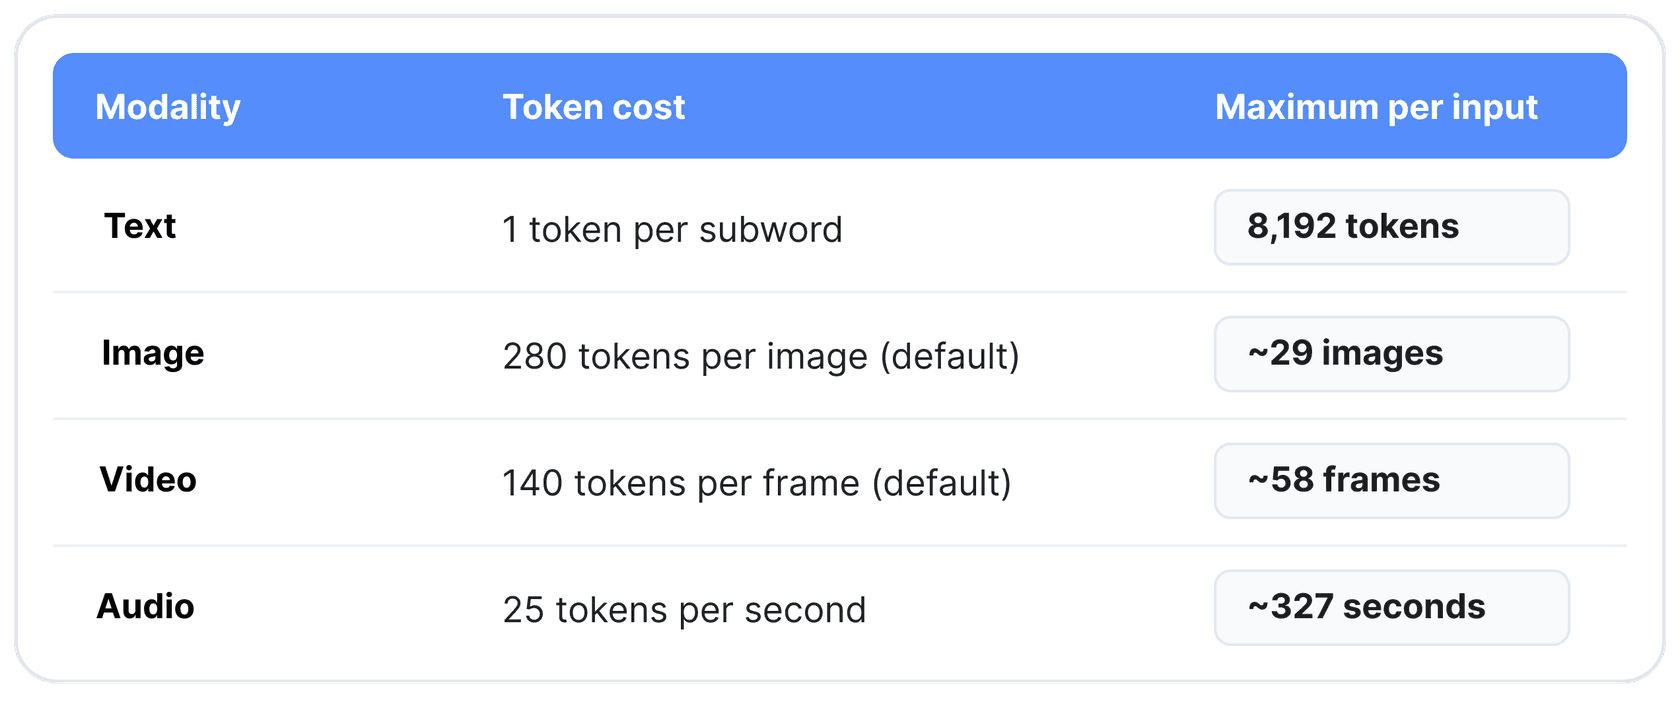
Las entradas comparten la ventana de contexto de 8,192 tokens a tarifas fijas, contadas en tokens. Una imagen cuesta 280 tokens por defecto, un fotograma de vídeo 140 y un segundo de audio 25. Así que una sola llamada puede contener unas 29 imágenes, 58 fotogramas de vídeo o 327 segundos de audio, según la model card.
Algunos detalles mecánicos que conviene conocer antes de escribir código:
- El vídeo se muestrea a 1 fotograma por segundo por defecto, y el audio tiene que ser mono a 16 kHz.
- El detalle de la imagen es un dial. La documentación multimodal enumera cinco presupuestos por imagen: 70, 140, 280, 560 o 1,120 tokens. Más tokens significan más detalle y ejecuciones más lentas.
- Puedes intercalar. Una entrada puede mezclar texto con marcadores
<|image|>,<|video|>y<|audio|>, como una página de producto con una foto y un clip de demostración, y sigue saliendo como un único vector. - El texto lleva un prefijo de tarea, los medios no. Las consultas se ven como
task: search result | query: ...y los documentos comotitle: ... | text: .... Omitir el prefijo funciona, pero pierde precisión.
¿Qué cambió respecto a EmbeddingGemma 1?
Aquí iría más despacio, porque el planteamiento del lanzamiento y las cifras cuentan historias ligeramente distintas. El anuncio de Google dice que v2 iguala el rendimiento de texto multilingüe de v1 y da un salto en código. Es cierto. Pero la model card también incluye MTEB inglés, y ahí v2 queda un poco por detrás.
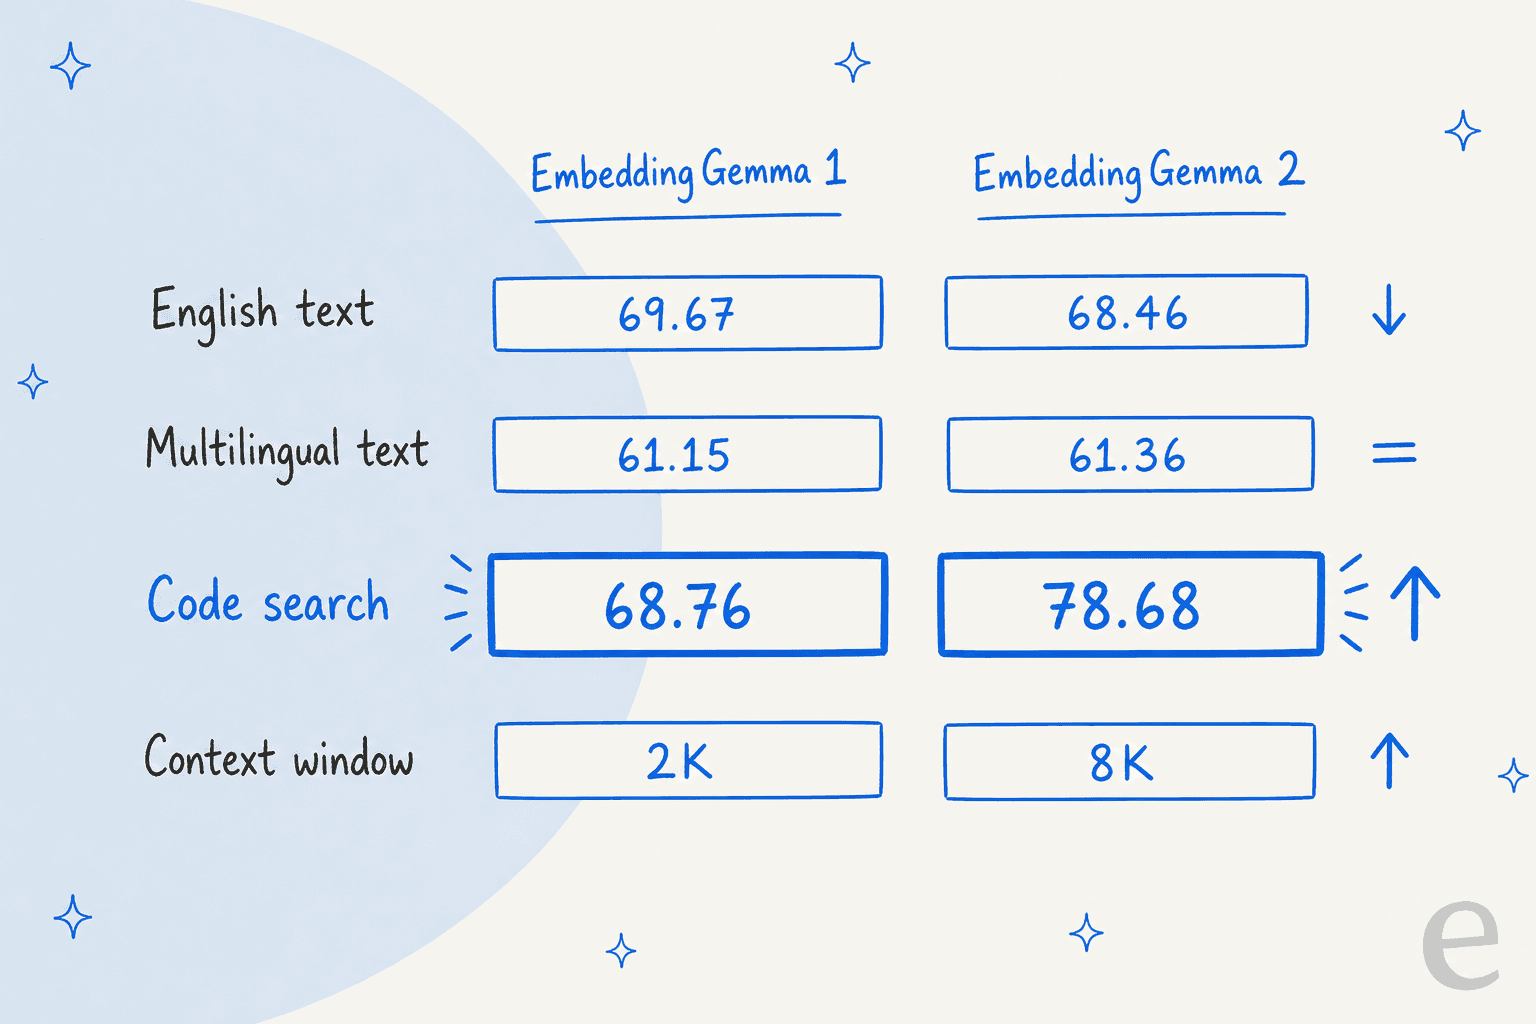
| Benchmark (768 dim.) | EmbeddingGemma 1 | EmbeddingGemma 2 | Cambio |
|---|---|---|---|
| MTEB English v2 | 69.67 | 68.46 | -1.21 |
| MTEB Multilingual v2 | 61.15 | 61.36 | +0.21 |
| MTEB Code v1 | 68.76 | 78.68 | +9.92 |
| Ventana de contexto | 2,048 tokens | 8,192 tokens | 4x |
| Entradas | Texto | Texto, código, imagen, vídeo, audio | +4 |
| Licencia | Términos de Gemma, descarga restringida | Apache 2.0 | Abierta |
Las cifras de v1 vienen de la card de EmbeddingGemma 300M y las de v2 de la card de v2. Los primeros probadores llegaron a la misma conclusión:
"for text, benchmarks are identical to the first EmbeddingGemma. but you can use this new one and enable/disable what you don't need. can keep only text for ex."

Mi lectura es simple. Si solo buscas texto en inglés, v2 es un movimiento lateral, y la actualización solo merece la pena si te ayuda el contexto 4 veces más largo (menos fragmentos, pero más grandes) o si la licencia Apache desbloquea un producto. Si buscas código, o cualquier cosa que no sea texto, es un gran paso. Para un centro de ayuda que son sobre todo artículos, mi opinión sobre RAG vs. ajuste fino importa más que esta actualización.
Qué dicen los nuevos benchmarks
Para los nuevos tipos de entrada no hay v1 con el que comparar, así que las puntuaciones de la model card hablan por sí solas. Google lo califica de "best-in-class" entre los modelos de embeddings multimodales de menos de 1B en MTEB Code y MAEB, el benchmark de audio. Es una afirmación del fabricante sin una tabla comparativa directa en la card, así que tómala como punto de partida.
| Entrada | Benchmark | Puntuación |
|---|---|---|
| Imagen | MIEB lite | 64.64 |
| Imagen | MMEB v2 Image (Hit@1) | 57.28 |
| Documentos visuales | MMEB v2 VisDoc (NDCG@5) | 67.84 |
| Vídeo | MMEB v2 Video (Hit@1) | 50.67 |
| Audio | MSEB Retrieval (MRR@10) | 69.54 |
| Audio | MAEB | 49.39 |
Dos cosas que destacaría del hilo de HN. Un comentarista preguntó por qué no se compara con SigLIP 2, el modelo de imagen y texto de Google. Otro lo ejecutó en local y encontró que el ejemplo de clasificación zero-shot de la propia demo de Google fallaba:
"I got this running locally, and funnily enough the exact example they have for classifying "Cancel my flight and refund my credit card immediately." failed. It said the request does not involve a payment, charge, or refund, with a p(true) of 0.22 (where true means it is financial)."
Eso duele un poco si lo estás considerando para el enrutamiento de tickets, ya que "reembolso o no" es justo la etiqueta que querría un equipo de soporte. Un dato no es un veredicto, pero es una buena razón para probar con tus propios tickets antes de conectarlo a nada.
También hay un detalle más discreto en la documentación multimodal: las puntuaciones de similitud no están calibradas entre modalidades. Un cuadro sin relación obtuvo 0,585 frente a una foto del Golden Gate, más que los prompts de texto sin relación. Compara el ranking dentro de una búsqueda, no las puntuaciones en bruto entre imágenes y texto.
¿Qué tan rápido y pequeño es realmente?
Aquí es donde EmbeddingGemma 2 se gana la etiqueta "on-device". El equipo de AI Edge de Google publicó cifras por dispositivo para generar el embedding de una imagen con un presupuesto de 70 tokens:
| Dispositivo | Chip | Latencia por imagen | Imágenes/s |
|---|---|---|---|
| iPhone 18 Pro | CPU | 191 ms | 5.2 |
| iPhone 18 Pro | GPU | 69.8 ms | 14.3 |
| Pixel 11 Pro XL | NPU | 48.9 ms | 20.6 |
| MacBook M5 Pro | GPU | 37.3 ms | 26.9 |
| Dell XPS 16 | NPU | 49.8 ms | 20.1 |
| Raspberry Pi 5 | CPU | 1,761 ms | 0.6 |
Las cifras reales en un portátil son parecidas. Un comentarista de HN compartió el rendimiento en un M3 Pro:
"Text: 78 embeddings/second on small texts - Image: 4 embeddings/second - Audio: 6 embeddings/second for 30 second chunks (which is how the encoder works) - Video: 0.2 embeddings/second per minute of video"
Fíjate en la diferencia. Vídeo a 0,2 por minuto de metraje significa que una hora de vídeo tarda unos cinco minutos en indexarse en ese portátil. Bien para una biblioteca de demos de producto. Demasiado lento para vídeo en directo y de gran volumen.
El almacenamiento es la otra palanca. El modelo usa entrenamiento Matryoshka, así que puedes recortar los vectores de 768 números a 512, 256 o 128 y conservar la mayor parte de la calidad. Según la guía para desarrolladores, un millón de vectores de 768 dimensiones ocupan unos 1,5GB en bfloat16, y unos 250MB a 128 dimensiones.
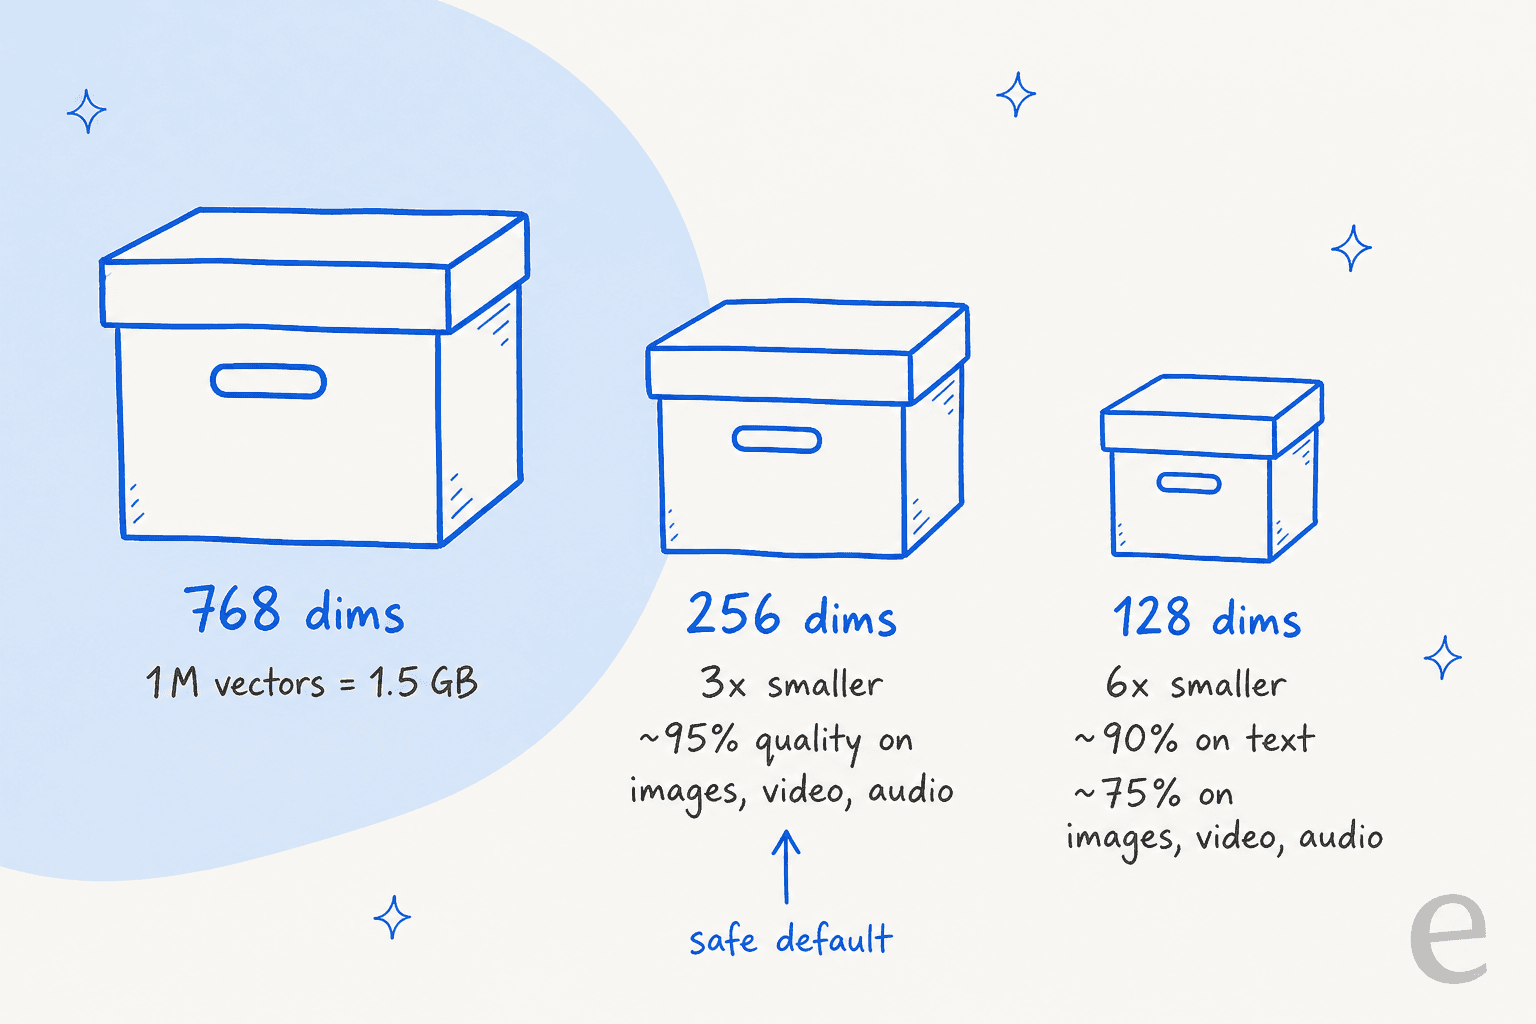
La pega es que los medios se degradan más rápido que el texto al comprimir. En la model card, MMEB v2 baja de 59,01 con 768 dimensiones a 45,65 con 128. Para un índice mixto, me detendría en 256 dimensiones y solo bajaría a 128 para preselecciones solo de texto que luego reordenas. Dos reglas de la card que te morderán si las ignoras: vuelve a normalizar los vectores después de truncar y nunca lo ejecutes en float16. Las activaciones se desbordan y obtienes NaN o vectores peores en silencio, sin ningún error.
¿Qué configuración de EmbeddingGemma 2 deberías cargar?
Como solo pagas memoria por los codificadores que cargas, la primera decisión es qué contiene realmente tu índice. Elige la opción más cercana:
¿Qué entra en tu índice de búsqueda?
Toca una opción para ver la configuración con la que empezaría.
vision_config=None, audio_config=None. Nota honesta: para búsqueda solo en inglés, v1 puntuó algo más (69,67 frente a 68,46). Cambia si necesitas el contexto de 8K o Apache 2.0, no por precisión. 256 dimensiones es un recorte de almacenamiento seguro.CodeRetrieval para las consultas y pon el nombre del archivo en el título del documento. Quédate en 512 o 768 dimensiones; el código pierde calidad más rápido al truncar.audio_config=None. La visión cubre imágenes, PDF, diapositivas y gráficos (MMEB v2 VisDoc 67,84). Sube el presupuesto de imagen a 560 o 1,120 tokens si tus capturas tienen texto pequeño. Mantén 256 dimensiones o más.vision_config=None. Remuestrea el audio a mono de 16 kHz y divídelo en fragmentos; una llamada admite unos 327 segundos. Coincide con el contenido del habla, no solo con "esto es habla", pero prueba primero con tus propias llamadas.¿Cómo se ejecuta EmbeddingGemma 2?
Los pesos están en Hugging Face y Kaggle (¿eres nuevo en la plataforma? empieza con mi explicación de Hugging Face), y el soporte desde el primer día es amplio: sentence-transformers (v6.1.0 o posterior), Transformers, vLLM, SGLang, MLX, llama.cpp GGUF, Ollama, LM Studio y LiteRT, de Google, para móviles. El camino más corto, directo de la model card:
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2")

query_emb = model.encode("What causes the northern lights?", prompt_name="SearchQuery")
doc_emb = model.encode("The northern lights are caused by charged particles from the sun.", prompt_name="Document")
print(model.similarity(query_emb, doc_emb))
Si prefieres no tocar Python, la versión de Ollama encaja en la mayoría de pilas de RAG locales, y frameworks como LangChain y LlamaIndex lo tratarán como cualquier otro generador de embeddings.
Para un ejemplo de soporte completo, consulta mi guía de la canalización de RAG para soporte o esta guía de búsqueda semántica en Zendesk. Todavía necesitas un lugar donde guardar los vectores; Qdrant publicó una guía el día del lanzamiento, y mi artículo sobre RAG vs. bases de datos vectoriales explica cómo elegir.
En móviles, Google lo llevará a Android como un servicio gestionado de ML Kit "en las próximas semanas", con aceleración por NPU. Hasta entonces, la app AI Edge Gallery es la forma más fácil de probarlo. Su demo Instant Media Search busca en tu carrete mientras escribes, sin conexión, y Video Moments Finder salta a marcas de tiempo para consultas como "perro atrapando un frisbee" sin transcripción.
¿Alojarlo tú mismo o usar Gemini Embedding 2?
Este es el segundo replanteamiento que ofrecería. EmbeddingGemma 2 se descarga gratis, y la gente suele suponer que eso lo convierte en la opción barata. Para la mayoría de los equipos no lo es por mucho, porque su hermano alojado de Google ya es muy barato.
Gemini Embedding 2 es la API de pago de embeddings multimodales de Google, y es el único modelo de embeddings en la lista de precios actual de la API de Gemini. (Si estás comparando la API de Google en general, mira API de OpenAI vs. API de Gemini.) Mi artículo sobre los precios de Gemini cubre el resto; aquí están las tarifas de embeddings:
| Entrada | Estándar (por 1M de tokens) | Lote | Por unidad (estándar) |
|---|---|---|---|
| Texto | $0.20 | $0.10 | n/a |
| Imagen | $0.45 | $0.225 | $0.00012 por imagen |
| Audio | $6.50 | $3.25 | $0.00016 por segundo |
| Vídeo | $12.00 | $6.00 | $0.00079 por fotograma |
Ahora un ejemplo práctico para un equipo de soporte mediano. Supongamos 2,000 artículos de ayuda de unos 800 tokens cada uno (1,6M de tokens), 10,000 capturas de producto y 100 horas de llamadas grabadas:
- Artículos: 1,6M de tokens x $0.20 = $0.32
- Capturas: 10,000 x $0.00012 = $1.20
- Llamadas: 360,000 segundos x $0.00016 = $57.60
Eso es menos de $60 para generar los embeddings de toda la biblioteca una vez a tarifas estándar, y la mitad en lote. Una GPU alquilada a los $1 a $2 por hora que citó un comentarista de HN estaría en marcha más tiempo que eso solo para arrancar. Así que plantearía la elección de esta manera:
- Usa Gemini Embedding 2 si tus datos pueden ir a la API de Google y quieres cero configuración. Ten en cuenta solo que los datos del nivel gratuito pueden usarse para mejorar los productos de Google; los del nivel de pago no.
- Usa EmbeddingGemma 2 si los datos no pueden salir del dispositivo o de tus propios servidores (salud, legal, soporte interno), si lo necesitas sin conexión o si generas embeddings de consultas en un móvil y no quieres viaje de ida y vuelta. Esas son razones reales. El coste por sí solo normalmente no lo es.
Simon Willison expuso bien el argumento a favor de los modelos abiertos:
"I really appreciate that EmbeddingGemma 2 is under the Apache 2.0 license. For embedding models in particular, I don't think it makes sense to use a closed, proprietary, hosted-only model."
Su punto trata más de dependencia de proveedor que de precio. Cada vector de tu índice está atado al modelo que lo generó. Si se retira un modelo alojado, tienes que volver a generar todo. Con pesos abiertos, el modelo con el que indexaste sigue disponible mientras conserves una copia.
Por qué a los equipos de soporte les debería importar la parte multimodal
Este es el enfoque que no he visto en la cobertura del lanzamiento. La mayoría de lo que se escribe sobre RAG para atención al cliente asume que el conocimiento es texto. En la práctica, mucho no lo es, y sale constantemente en las llamadas de ventas de eesel.
Una marca DTC de suplementos con unos 7,000 tickets al mes dijo que sus respuestas vivían en SOP de ClickUp, vídeos de Loom sin transcribir y macros antiguas. Una empresa de TI del sector público que gestiona unos 3,000 tickets complejos al mes funciona con Freshdesk y documentación técnica cargada de imágenes. Los equipos de productos técnicos piden una y otra vez una IA que pueda leer los diagramas dentro de sus PDF y las fotos que los clientes adjuntan a los tickets. Los modelos de embeddings solo de texto no ven nada de eso a menos que alguien lo transcriba o lo describa primero, por eso tantas herramientas de base de conocimiento para soporte siguen tratando los medios como un adjunto, no como una respuesta.
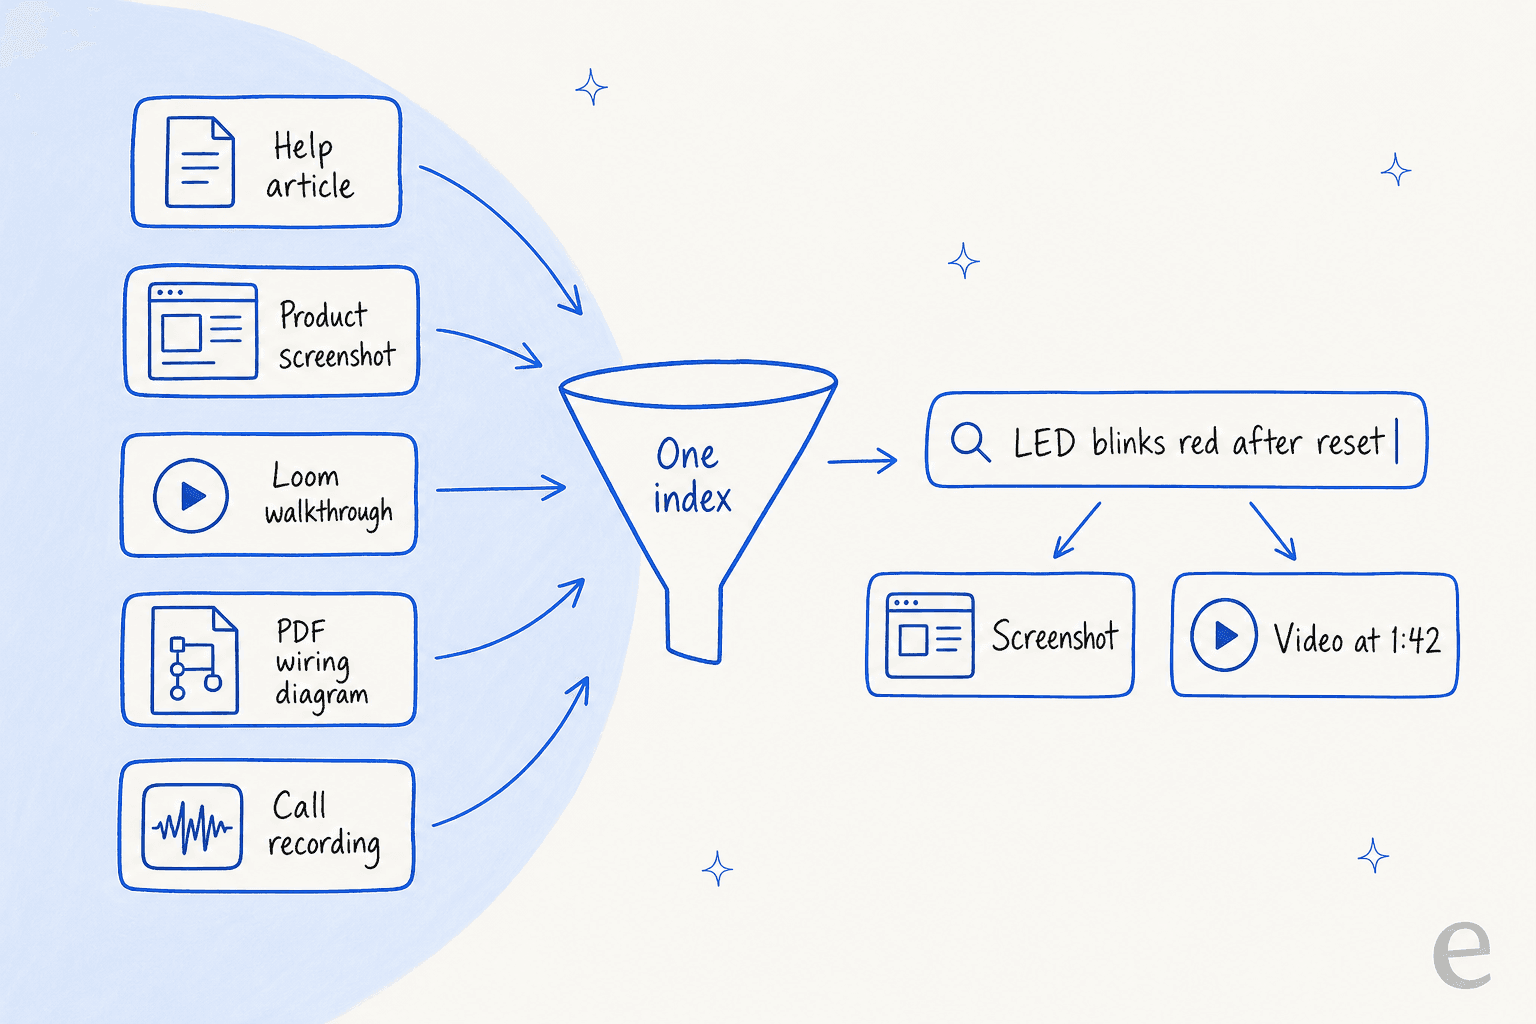
Un espacio compartido es la solución. Indexa la captura, el tutorial y el artículo juntos, y una consulta de texto como "el LED parpadea en rojo tras el reinicio" puede devolver el fotograma correcto del vídeo correcto. Un lector de HN, abogado, describió la misma idea para expedientes de casos:
"I could imagine using it to search a case file for "undamaged roof before Hurricane Katrina" and "damaged roof after Hurricane Katrina" and being able to locate both deposition testimony and pertinent photographs in the body of evidence."
Pero la recuperación es solo la mitad de un bot de soporte, y en mi experiencia no es la mitad que duele. A principios de este año, algunos clientes de pago de eesel, entre ellos un proveedor danés de energía solar, vieron cómo su bot inventaba respuestas cuando la búsqueda en la base de conocimiento volvía vacía. Rellenó el hueco con los datos de entrenamiento del modelo, un caso de manual de alucinación de IA, y envió datos de suscripción inventados a clientes reales.
Un mejor generador de embeddings no lo habría arreglado. Lo arregló una regla estricta de "sin coincidencia, pasa el caso a una persona", además de simular el bot con tickets anteriores antes de salir en vivo. Si construyes sobre EmbeddingGemma 2, planifica esa capa desde el primer día; mi guía para evitar las alucinaciones de la IA cubre los patrones.
¿Quién debería usar EmbeddingGemma 2?
| Tú eres | Mi opinión |
|---|---|
| Construyes búsqueda sobre una base de código o memoria para agentes de programación | Úsalo. +9,92 puntos en MTEB Code es la mejora más clara de este lanzamiento. |
| Buscas en fotos, capturas, PDF, audio o vídeo | Úsalo, con 256 dimensiones o más, y prueba con tus propios archivos. |
| Lanzas búsqueda en el dispositivo o sin conexión en una app | Úsalo. 191MB para texto es lo bastante pequeño para un móvil, y el soporte de ML Kit para Android está en camino. |
| Ya usas EmbeddingGemma 1 solo para texto en inglés | Quédate donde estás, salvo que necesites contexto de 8K o la licencia Apache. |
| Ejecutas búsqueda de soporte en la nube sin límites de datos | Gemini Embedding 2 es menos trabajo por casi el mismo dinero. |
| Quieres un bot de soporte que funcione, no una canalización | Sáltate la construcción. El modelo es una pieza de cinco. |
Para comparar con otras opciones, mis artículos sobre Cohere Embed 5 y la API de embeddings de OpenAI cubren las principales alternativas alojadas, y modelos de lenguaje pequeños profundiza en la tendencia on-device a la que pertenece este modelo.
Para el panorama más amplio, mi resumen de herramientas de recuperación de conocimiento compara los productos terminados.
El veredicto
EmbeddingGemma 2 es un lanzamiento bueno y honesto. El diseño modular es inteligente, la licencia Apache elimina un bloqueo real, y la búsqueda de código y la multimodal dan un paso claro hacia delante en un paquete lo bastante pequeño para un móvil. Si tus datos no son solo texto, es el primer modelo abierto que probaría.
Solo lee más allá del titular. Para texto en inglés está a la par con el modelo al que reemplaza, las afirmaciones de "best-in-class" son de Google, y para la mayoría de los equipos en la nube la API alojada cuesta más o menos lo mismo que ejecutarlo tú mismo. Elígelo por privacidad, uso sin conexión, código o medios, y quedarás contento. Elígelo esperando un gran salto en búsqueda de texto plano, y no lo verás.
Prueba eesel
Si llegaste aquí porque estás pensando en construir un bot de soporte sobre un modelo de embeddings nuevo, este es el atajo: el generador de embeddings encuentra pasajes, pero alguien tiene que leerlos, redactar la respuesta y saber cuándo callar. El compañero de helpdesk con IA de eesel hace ese trabajo dentro de Zendesk, Freshdesk o Gorgias. Aprende de tu centro de ayuda, de tu documentación en lugares como Confluence y Google Docs, y de tus tickets anteriores, y luego ejecuta una simulación sobre cientos de tus tickets reales para que veas sus respuestas antes que un cliente. Cuando la búsqueda vuelve vacía, pasa el ticket a una persona en lugar de adivinar.

Hay un plan gratuito con 100 créditos y sin tarjeta, y los planes de pago están en la página de precios. Prueba eesel y repite los tickets del mes pasado antes de construir nada.