

Gemini 4 Carbon es el nuevo modelo de frontera de Google, y es el modelo más fuerte del Artificial Analysis Intelligence Index con 59, nueve puntos por encima de Gemini 4 Argon, que salió solo dos semanas antes. Supera a Argon en los 17 benchmarks que publicó Google, lidera el campo en pruebas de ciberseguridad como SEC-bench Pro (88,2 %) y cuesta exactamente lo mismo: $2/$10 por millón de tokens al lanzamiento, $4/$20 después.
El problema es el acceso. Hoy solo un subconjunto de defensores de ciberseguridad puede usar Carbon, a través del Fairwind Program de Google. Desarrolladores, empresas y consumidores lo recibirán "lo antes posible", sin fecha. Argon pasó del anuncio a la API en unas dos semanas, así que esa es la mejor estimación también para Carbon.
Mi lectura: Carbon no es un nivel superior a Argon, es su reemplazo. Si ya usas Argon, prepárate para cambiar el nombre del modelo cuando llegue. Si lo estás considerando para tickets de soporte, el titular que importa es la afirmación de Google de que Carbon hace aproximadamente la mitad de afirmaciones sin respaldo. Es el mismo problema que eesel resuelve a nivel de agente de helpdesk: borradores fundamentados en tu centro de ayuda y tickets anteriores, y un traspaso cuando no hay nada en qué fundamentarlos.
¿Qué es Gemini 4 Carbon?
Gemini 4 Carbon es un modelo de lenguaje grande de Google DeepMind, anunciado el 28 de octubre de 2026 por Koray Kavukcuoglu, Chief AI Architect de Google. Google lo llama "our strongest model with state-of-the-art cybersecurity and long horizon capabilities", y está construido "building on" Argon, no como una clase de tamaño independiente.
La versión corta de lo que afirma Google:
| Qué | Gemini 4 Carbon |
|---|---|
| Anunciado | 28 de octubre de 2026 |
| Basado en | Gemini 4 Argon (lanzado dos semanas antes) |
| Artificial Analysis Intelligence Index v5.0 | 59,4, n.º 1 al lanzamiento |
| Diseñado para | Programación agéntica de larga duración, defensa en ciberseguridad |
| Ventana de contexto | 1M de tokens, según Artificial Analysis |
| Precio de lanzamiento | $2 entrada / $10 salida por 1M de tokens, entrada en caché con 95 % de descuento |
| Precio tras la promoción | $4 entrada / $20 salida |
| Quién puede usarlo hoy | Un subconjunto de defensores de ciberseguridad mediante el Fairwind Program |
Google dice que sus propios equipos han visto a Carbon "run for days to persist through dead ends" en trabajos de ingeniería como encontrar la causa raíz de errores sutiles en grandes bases de código. Ese es el trabajo para el que está diseñado, y por eso la mayor parte de la publicación de lanzamiento habla de programación y seguridad y no tanto de chat.
¿En qué se diferencia Carbon de Argon?
Carbon es un Argon mejor por el mismo precio. Google no dice si es un nuevo entrenamiento o un checkpoint posterior, pero todo en el lanzamiento (misma tarifa, misma vía de despliegue, "building on Gemini 4 Argon") apunta a un sucesor y no a un hermano. Así se comparan los dos en las cifras que más cambiaron:
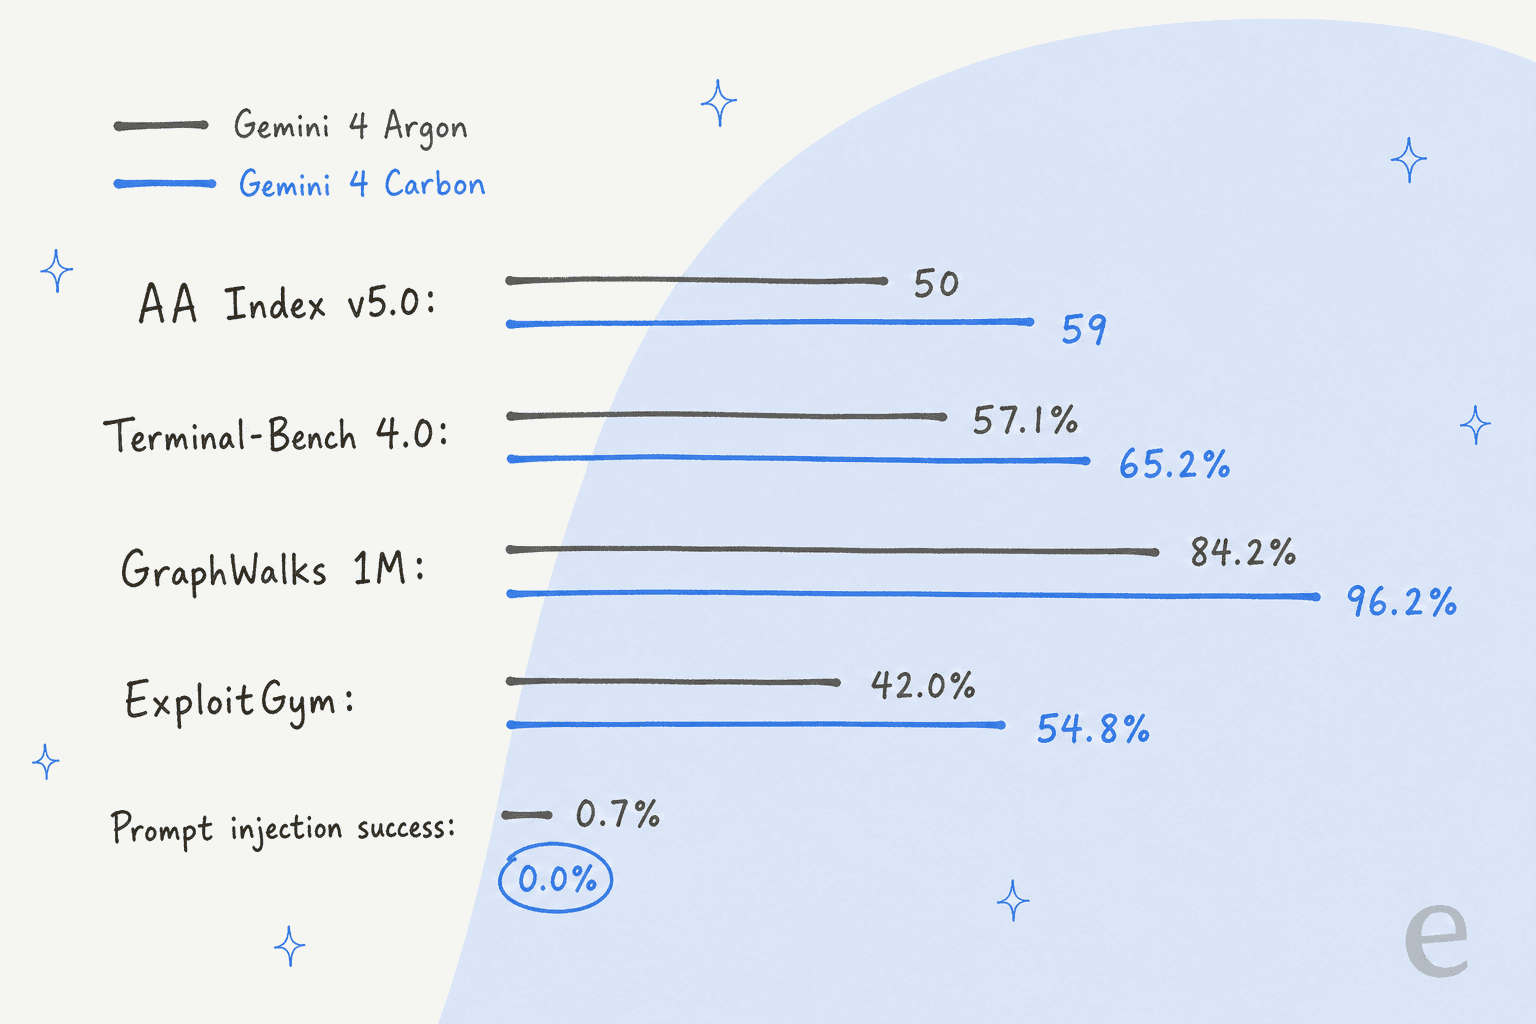
Los mayores saltos están en contexto largo y en seguridad. GraphWalks, que prueba el razonamiento entre 256K y 1M de tokens, pasa de 84,2 % a 96,2 %, y el benchmark de explotación ExploitGym sube casi 13 puntos. Las mejoras en programación general son menores pero reales: Terminal-Bench 4.0 gana ocho puntos y en WebDev Arena Carbon sube 89 Elo hasta el n.º 4.
Los nombres confundieron a casi todo el mundo. Laboratorios como OpenAI y Anthropic usan nombres que indican el orden de tamaño (Astra, Sol, Terra; Opus, Sonnet, Haiku). Los nombres de elementos de Google no lo hacen, y el hilo de Hacker News dedicó cientos de comentarios solo a esto:
"Confusingly, Carbon is another model in the same size class as Argon. Every other lab would have just called it Gemini 4.1 Argon."

Creo que ese es el modelo mental correcto. Si tratas a Carbon como "Argon, siguiente versión", el resto del lanzamiento también cobra sentido.
¿Cómo puntúa Gemini 4 Carbon en los benchmarks?
Carbon lidera 15 de las 17 filas de la tabla de Google, frente a Argon, GPT-6 Astra, Claude Opus 5.5 y Claude Fable 5.1. Aquí está la tabla completa tal como la publicó Google:
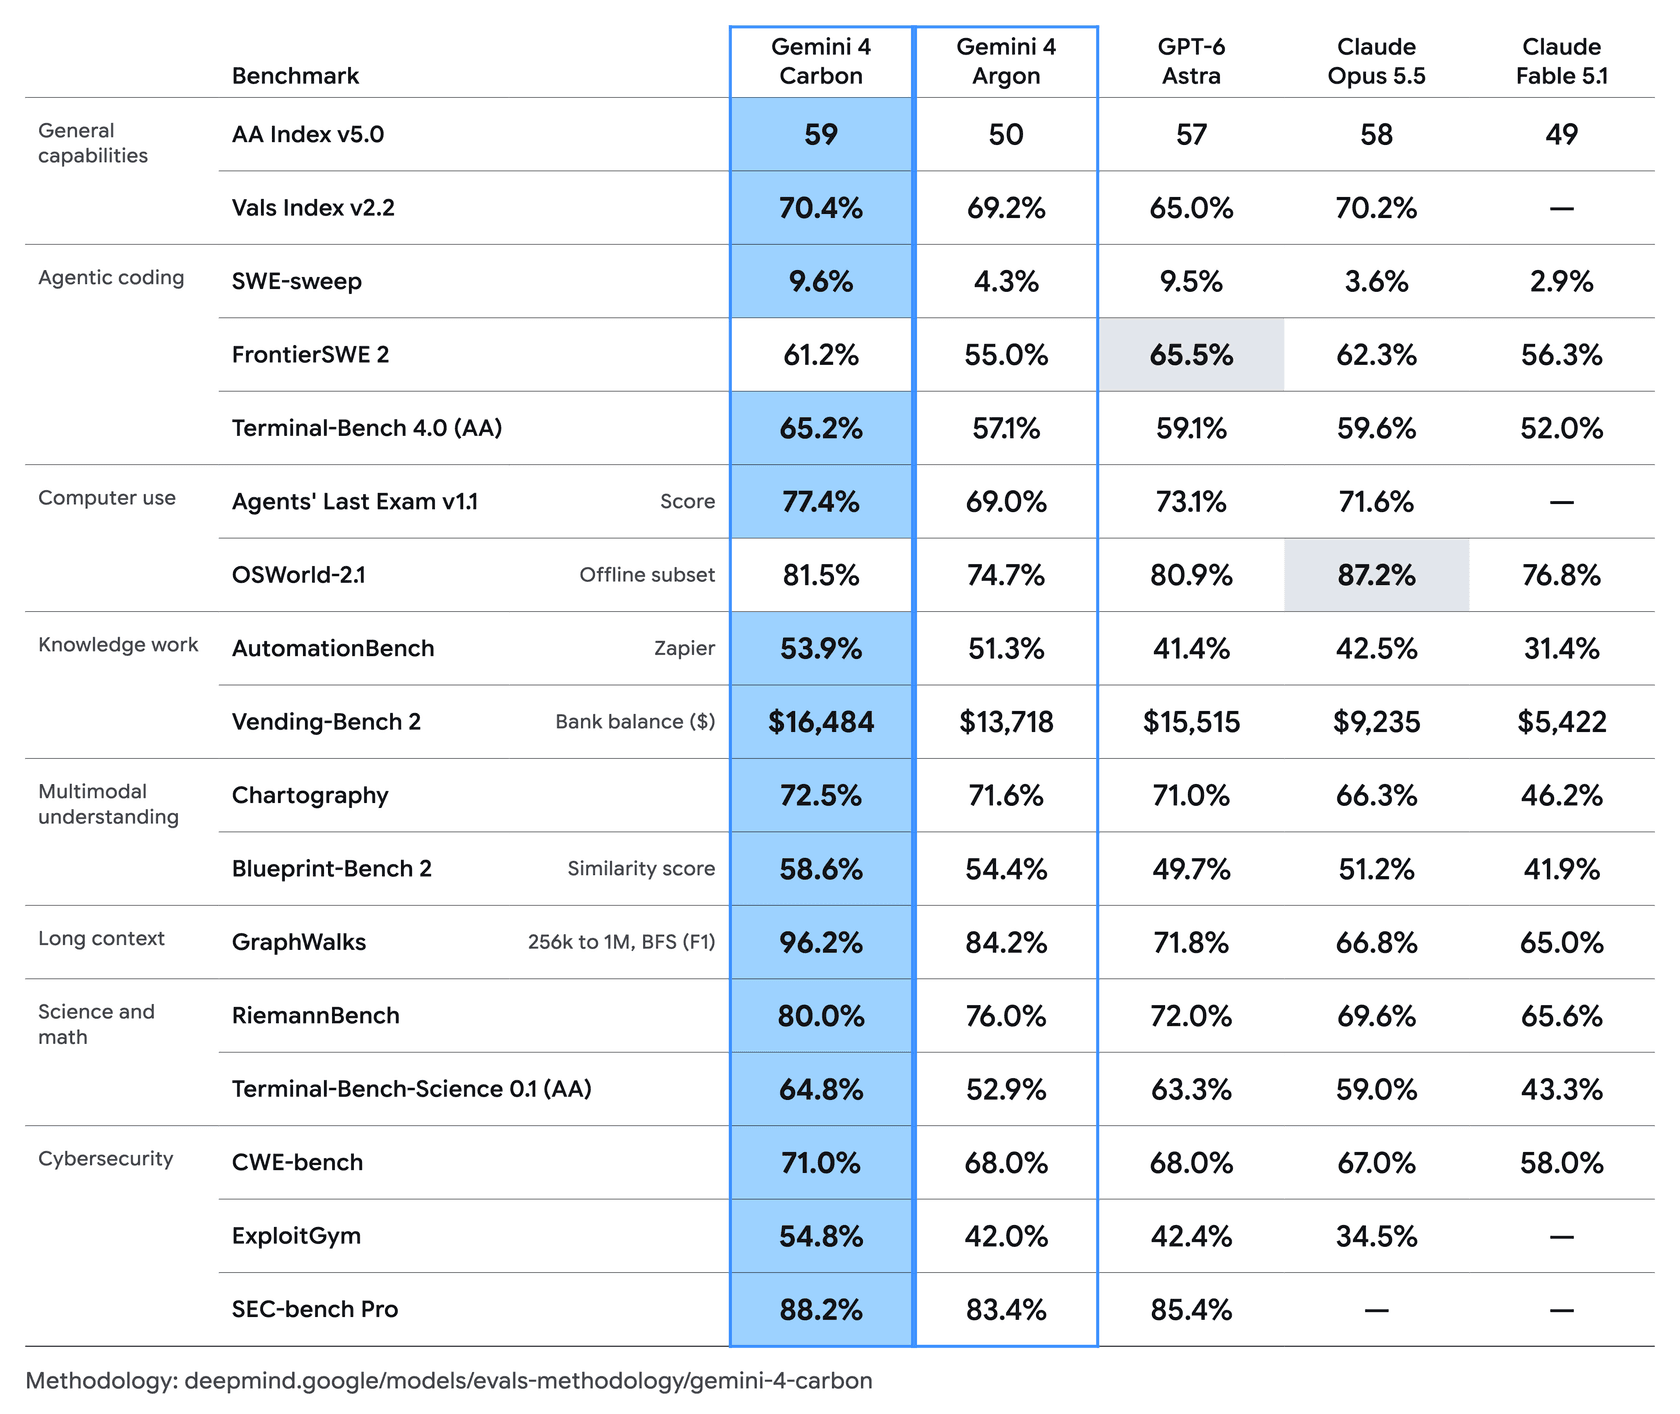
Las dos filas donde Carbon no gana merecen atención, porque son las que un comprador de programación o de uso del ordenador miraría primero:
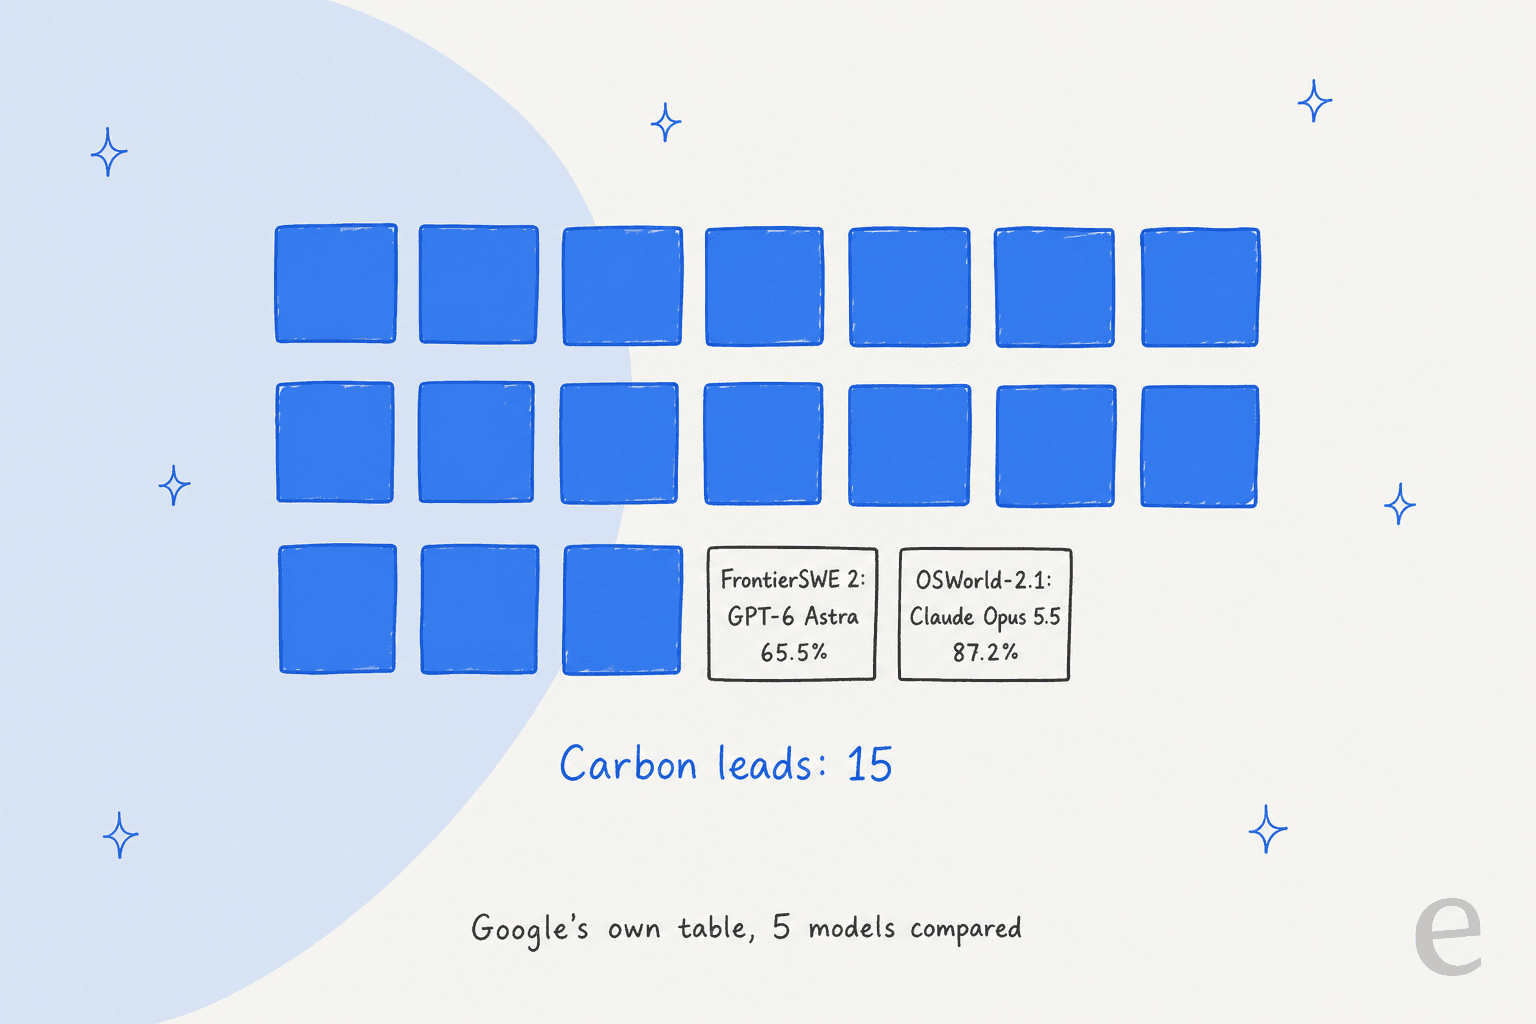
Estas son las filas a las que prestaría más atención, tomadas de la página del modelo en DeepMind:
| Benchmark | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| AA Intelligence Index v5.0 | 59 | 50 | 57 | 58 |
| Terminal-Bench 4.0 (programación agéntica) | 65.2% | 57.1% | 59.1% | 59.6% |
| FrontierSWE 2 (ingeniería de software) | 61.2% | 55.0% | 65.5% | 62.3% |
| OSWorld-2.1 (uso del ordenador) | 81.5% | 74.7% | 80.9% | 87.2% |
| AutomationBench (tareas de Zapier) | 53.9% | 51.3% | 41.4% | 42.5% |
| GraphWalks (256K a 1M de tokens) | 96.2% | 84.2% | 71.8% | 66.8% |
| SEC-bench Pro (encontrar vulnerabilidades) | 88.2% | 83.4% | 85.4% | n/a |
Hay dos cosas que me llaman la atención. Primero, la ventaja en contexto largo es grande, no marginal: 96,2 % en GraphWalks frente a 66,8 % de Opus 5.5. Si tu trabajo es leer bases de código enteras o contratos largos, esa es la fila que importa. Segundo, la cifra de AutomationBench (la prueba de Zapier de flujos de trabajo empresariales reales) deja a Carbon más de 11 puntos por delante de Astra y Opus, y para el trabajo con agentes es una señal más fuerte que cualquier puntuación de programación aislada.
Una salvedad justa: son cifras del proveedor. La comprobación independiente hasta ahora es Artificial Analysis, que sitúa a Carbon en 59,4, primero en general, a $7,76 por tarea a precio de lista. Y el historial de Argon es un motivo para esperar al uso real antes de fiarse de la tabla. Argon también parecía fuerte sobre el papel, y buena parte del hilo de Hacker News sobre Carbon son desarrolladores diciendo que se sentía más débil en el uso diario, algo que trato en mi reseña de Gemini 4 Argon.
¿Por qué Google llama a Carbon un modelo de ciberseguridad?
Porque es donde su ventaja es más clara, y también donde está el riesgo. Google informa de resultados de vanguardia en los pasos que ejecuta realmente un equipo de seguridad: encontrar un fallo, demostrar que es explotable y luego parchearlo.
- Encontrar: 88,2 % en SEC-bench Pro, descubriendo de forma autónoma fallos en software real.
- Validar: 54,8 % en ExploitGym, el benchmark de explotación, frente al 42,0 % de Argon.
- Parchear: 71,0 % en CWE-bench, convirtiendo hallazgos en correcciones que funcionan.
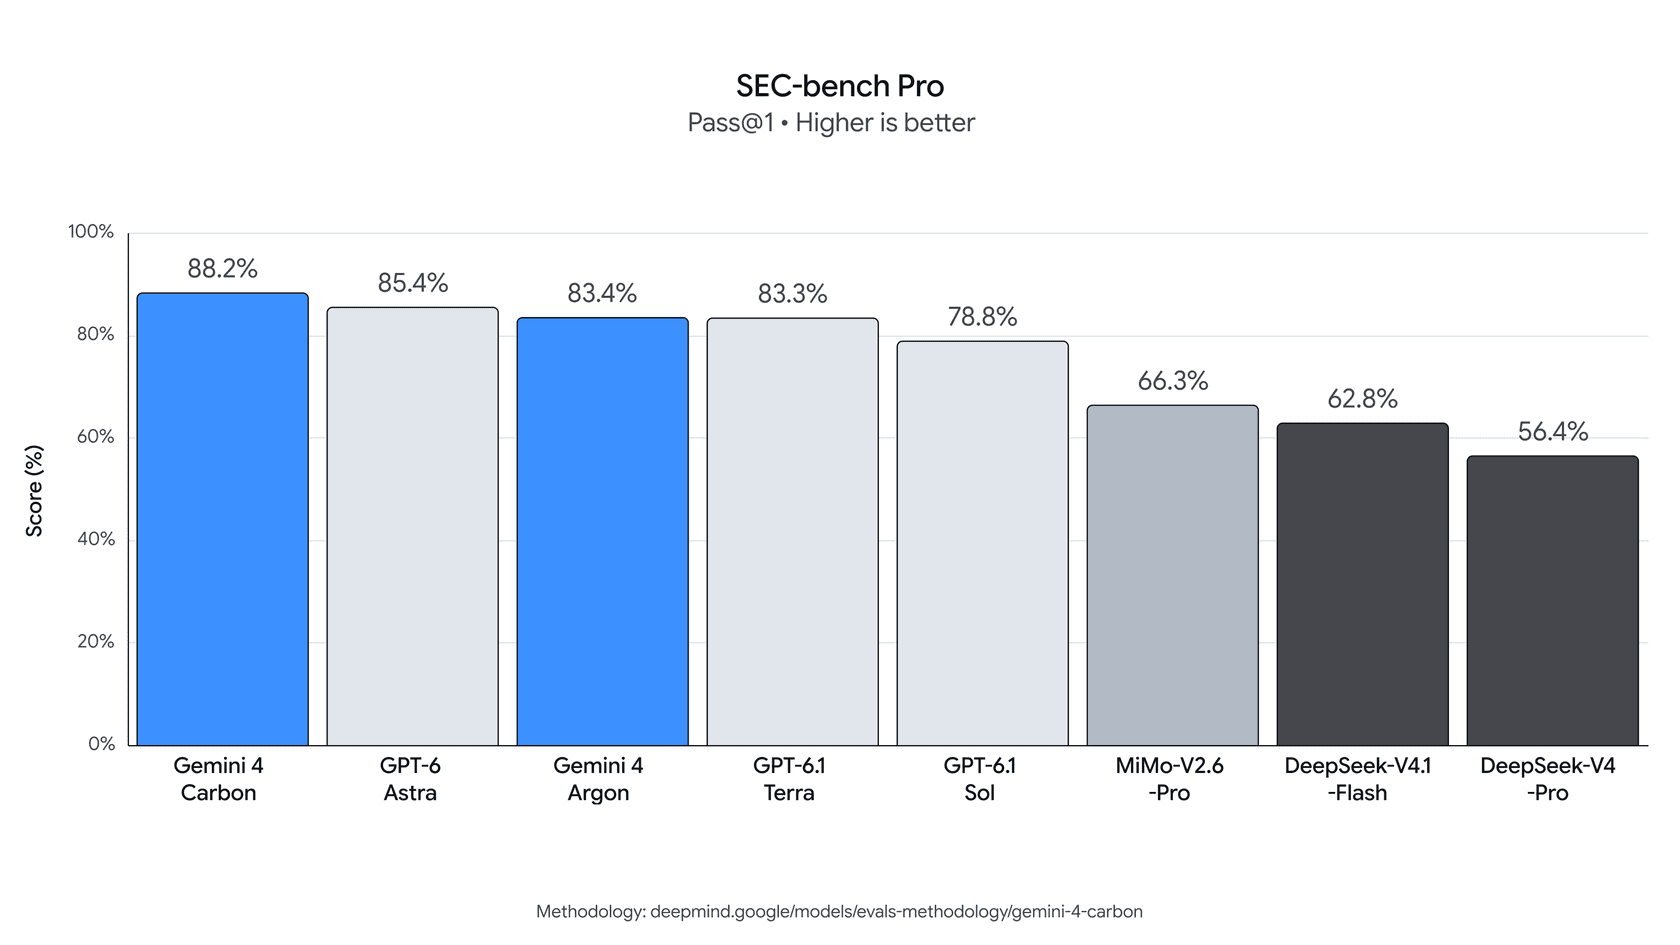
Google añade también algunas afirmaciones desde dentro de sus propios muros. En pruebas internas, Carbon tiene "more than 2x uplift in success rate for generating secure code over Argon". El equipo de Chrome dice que rindió "more than 10X better than another lab's large frontier model" escribiendo parches de alta calidad. Y Wiz lo ve liderando en pruebas de penetración web. Nada de esto se puede comprobar todavía de forma independiente, así que lo leería como una dirección y no como cifras para planificar.
Un modelo así de bueno encontrando y explotando errores también es útil para los atacantes, por eso el despliegue empieza por los defensores. El Fairwind Program da acceso anticipado a "high-priority defenders (like governments, healthcare providers, and telecommunications services)", y Google dice que trabaja con más de 650 socios. Es el mismo patrón que GPT-5.6-Cyber y Claude Mythos 5.1 de Anthropic: los modelos de ciberseguridad más capaces ahora llegan primero a equipos de seguridad verificados. No todo el mundo piensa que sea justo para los proyectos más pequeños:
"Too bad you won't be able to use it to secure your open-source projects. If you try it'll throw up a prompt telling you to use some initiative you can't use or afford while the provider collects the findings."
Si necesitas un modelo de Google afinado para ciberseguridad que puedas llamar hoy, Gemini 3.8 Flash Cyber es la opción disponible.
¿Qué cambió Google en seguridad y honestidad?
Esta es la parte del lanzamiento que me parece más útil fuera de la seguridad. Carbon funciona sobre la pila de seguridad de Argon (entrenamiento, defensas contra el mal uso en tiempo real, resistencia a la inyección de prompts, monitorización de la cadena de pensamiento), y Google dice que han ido más allá en cómo se comporta el modelo bajo presión:
- Menos trampas. Las trampas exitosas en Terminal-Bench 4.0 bajaron a 0,0 %, con intentos en 0,4 %. En programación en vivo con los equipos de Google, las alertas de desalineación de alta gravedad cayeron casi un 80 %.
- Menos afirmaciones inventadas. Carbon "cuts unsupported claims by approximately 2x over Argon". Incluye salvedades en el entregable o enumera lo que aún falta, "rather than fabricating or hedging around missing evidence".
- Pregunta antes de adivinar. Cuando una tarea es ambigua, recupera fuentes y señala discrepancias al usuario antes de actuar.
- Se mantiene en su alcance. Extralimitación un 26 % menos, servicio insuficiente un 29 % menos.
- Resistencia a la inyección de prompts. 0,0 % de éxito de ataque en el benchmark de inyección indirecta de prompts de Gray Swan, frente al 0,7 % de Argon.
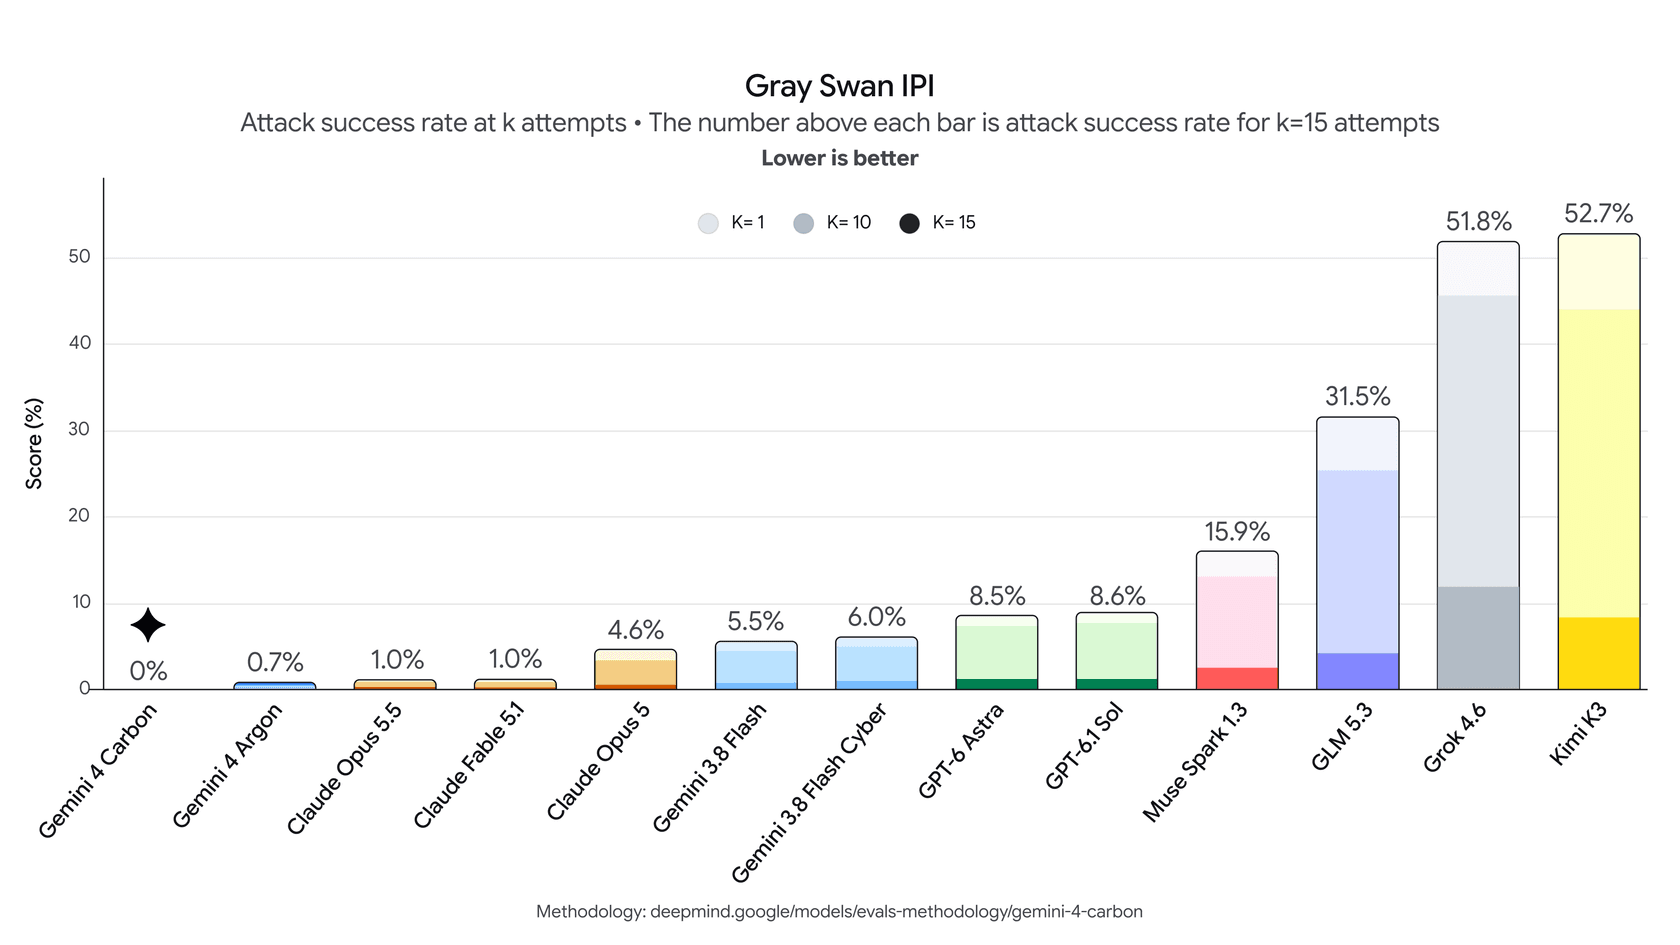
La inyección de prompts es lo que subrayaría para cualquiera que construya agentes que lean contenido externo. Un agente que lee correos, páginas web o tickets de clientes está leyendo texto escrito por extraños, y parte de ese texto intentará darle órdenes. Una tasa de éxito de ataque del 0 % en todos los intentos de Gray Swan es un avance real, aunque "todos los intentos evaluados" no es lo mismo que todos los intentos.
¿Quién puede usar Gemini 4 Carbon y cuándo?
Ahora mismo, casi nadie. El despliegue de Google tiene tres pasos y solo ha empezado el primero:
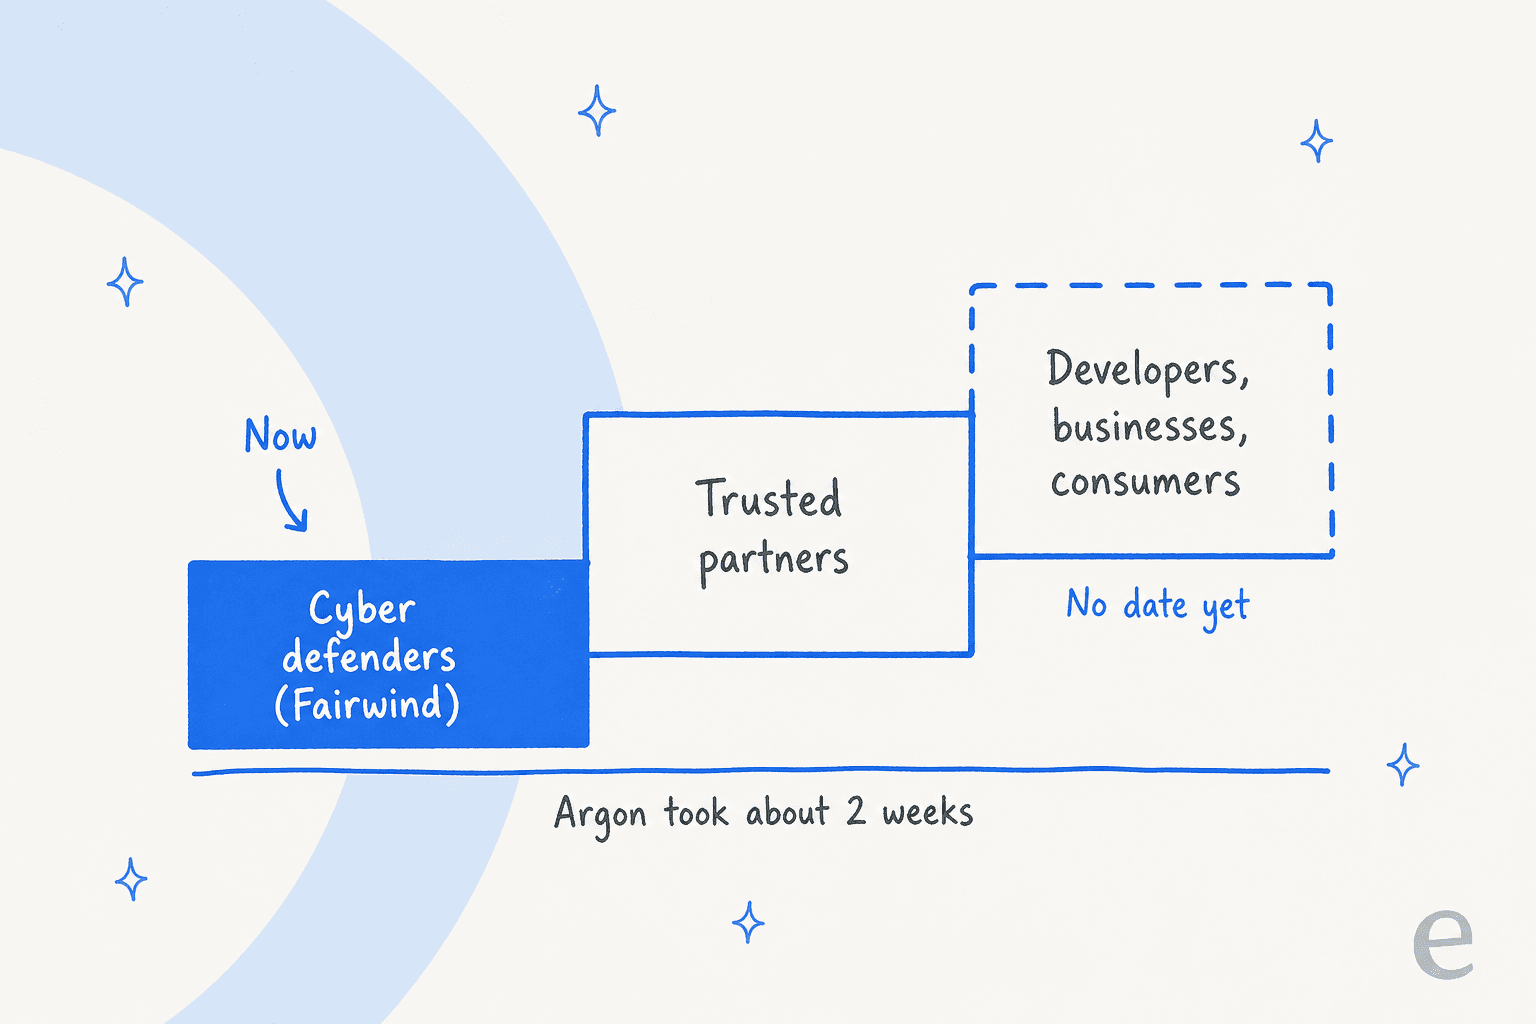
Google también dice que está "actively engaged in the U.S. government's voluntary process for pre-release model testing", así que parte de la espera no depende de Google. La única promesa sobre plazos es "as soon as possible".
Argon es la mejor guía de lo que eso significa en la práctica. Un comentarista expuso las fechas:
"The previous model, Argon, was announced on 30 Sep and released on 13 Oct."
Si Carbon sigue el mismo camino, llegará a la Gemini API y a los planes Google AI Pro y Ultra a mediados de noviembre. Espero que aterrice en los mismos sitios que Argon: la API, la app Gemini para suscriptores de pago y las herramientas de programación de Google.
Hasta entonces, las opciones prácticas son:
- Usar Argon ahora y cambiar cuando llegue Carbon. Misma API, misma tarifa.
- Usar Gemini 3.8 Flash para trabajo cotidiano de alto volumen. Es mucho más barato y para la mayoría de las tareas diarias es suficiente.
- Usar GPT-6.1 Sol o Claude Opus 5.5 si necesitas un modelo de frontera esta semana y Argon no te ha funcionado.
¿Cuánto cuesta Gemini 4 Carbon?
Carbon se lanza al mismo precio que Argon: $2 por millón de tokens de entrada y $10 por millón de tokens de salida, con la entrada en caché con 95 % de descuento ($0,10). Tras un periodo introductorio, según la nota al pie de Google, se aplica $4/$20. No hay fecha de fin, y Carbon aún no aparece en la página de precios de la Gemini API.
| Gemini 4 Carbon | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra | |
|---|---|---|---|---|
| Entrada / 1M (lanzamiento) | $2.00 | $2.00 hasta el 30 de nov. | $4.00 | $10.00 |
| Salida / 1M (lanzamiento) | $10.00 | $10.00 hasta el 30 de nov. | $20.00 | $50.00 |
| Entrada / salida tras la promoción | $4 / $20 | $4 / $20 desde el 1 de dic. | Sin promoción | Sin promoción |
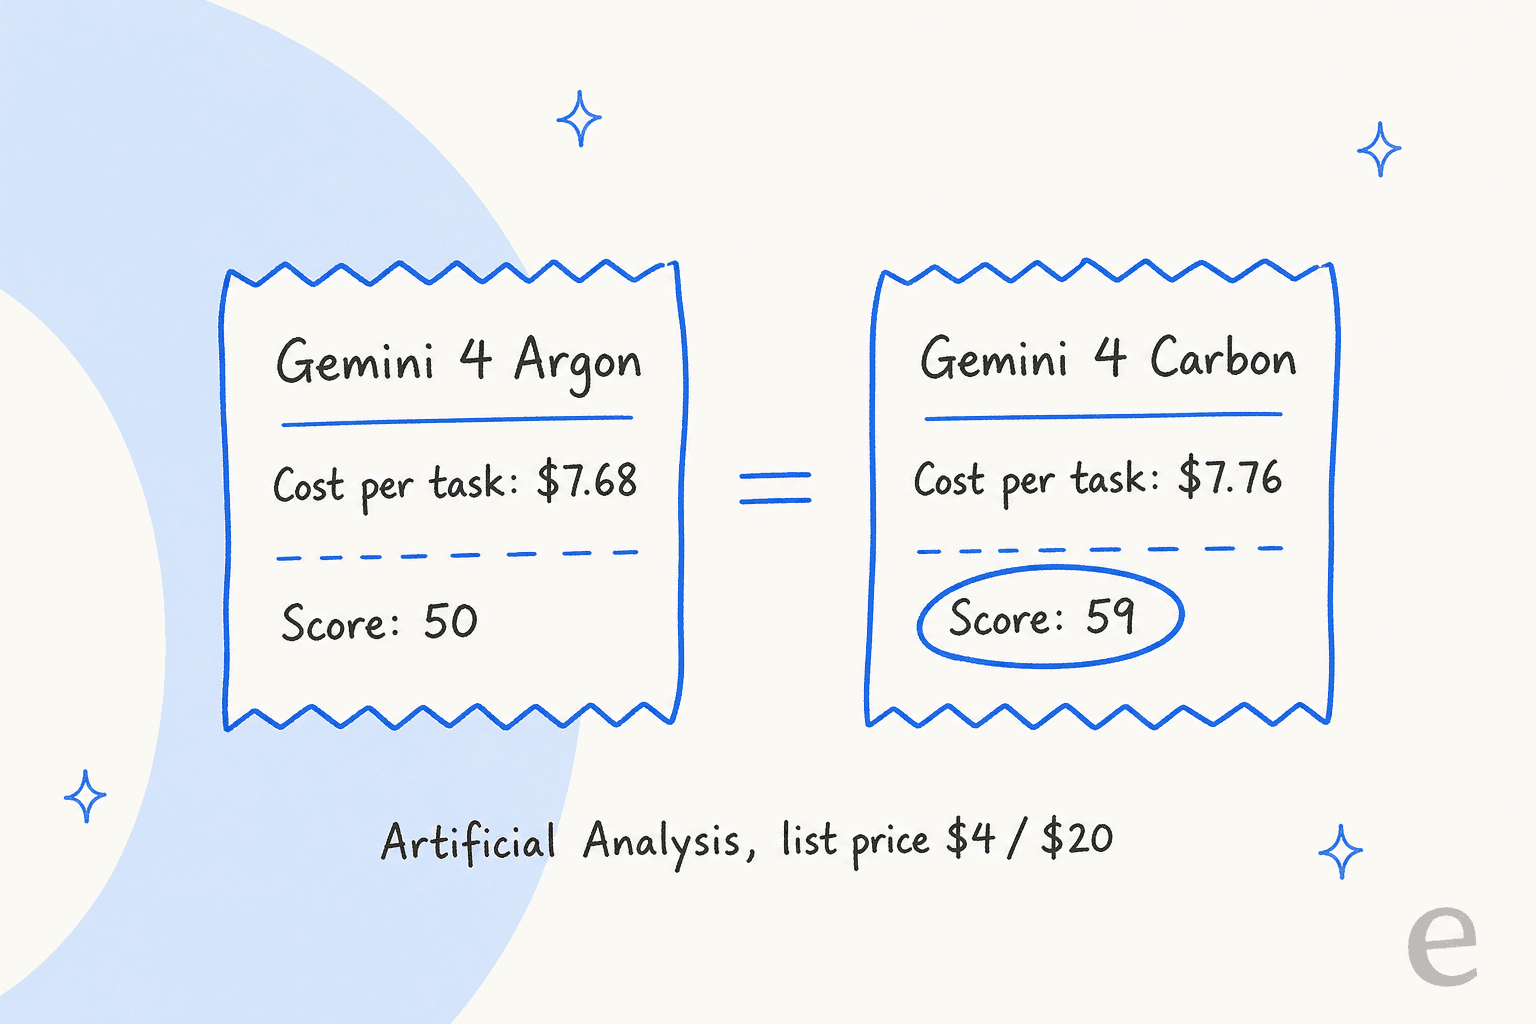
| Coste AA por tarea (lista) | $7.76 | $7.68 | $10.03 (Max) | $6.24 (Max) |
La cifra por tarea de Artificial Analysis es la que importa. Carbon escribe algunos tokens más que Argon, así que una tarea cuesta más o menos lo mismo con una puntuación nueve puntos mejor:
Para las cuentas de la promoción, una calculadora de costes y adónde va realmente el dinero en una tarea (spoiler: sobre todo a la entrada en caché), consulta mi desglose completo de los precios de Gemini 4 Carbon. La guía más amplia de precios de Gemini cubre el resto de la gama de Google.
¿Deberías esperar a Gemini 4 Carbon?
Depende de lo que vayas a hacer con él, así que así decidiría yo.
¿Ya usas Argon? Sí, espera y luego cambia. Mismo precio, misma API y mejor en todos los benchmarks que probó Google. Una vez que Carbon esté disponible para ti, no hay motivo para quedarte en Argon.
¿Eliges un modelo de frontera para programación agéntica larga o trabajo con documentos largos? Carbon es el primero que probar cuando llegue. Las ventajas en contexto largo y en Terminal-Bench son grandes, y a $2/$10 durante la promoción reduce a la mitad el precio por token de Opus 5.5. Si no puedes esperar, mi recopilación de alternativas a Gemini 4 Argon valora cada opción para un comprador.
¿Haces uso del ordenador o ingeniería de software pura? Opus 5.5 sigue liderando OSWorld-2.1 y Astra sigue liderando FrontierSWE 2. Carbon queda cerca en ambos, pero "cerca" no es motivo para cambiar.
¿Tareas cotidianas de alto volumen? Probablemente no necesites un modelo de frontera. Un comentarista describió un reparto que coincide con lo que haría yo:
"I personally use 3.8 Flash most of the time and Argon/Carbon when I need to do deep analysis or research an ambiguous problem."
Las opciones de pesos abiertos como Kimi K3.1 Pro y DeepSeek V4.1 Flash también merece la pena valorarlas para ese tipo de volumen. Para una visión más amplia de la competencia de Google, consulta alternativas a Gemini.
¿Qué significa Gemini 4 Carbon para la IA en atención al cliente?
Menos de lo que sugiere la tabla de benchmarks, con una excepción. La mayoría de los tickets de soporte no necesitan un modelo capaz de encontrar la causa raíz de un error del kernel en tres días. Una respuesta a un ticket necesita la respuesta correcta de tu centro de ayuda con tu tono, y luego un traspaso cuando no está seguro. Los modelos más pequeños y baratos lo manejan bien cuando el sistema a su alrededor es bueno.
La excepción es la honestidad. La afirmación de Google de que Carbon reduce a la mitad las afirmaciones sin respaldo y "surfaces discrepancies to the user before acting" es el comportamiento que quiere todo equipo de soporte, porque una respuesta equivocada y segura a un cliente cuesta más que no dar respuesta. Aun así, las alucinaciones de la IA en soporte rara vez dependen solo del modelo. Vienen de conocimiento ausente, reglas poco claras y un agente al que se le permite adivinar. Un modelo mejor hace el problema más pequeño, no lo elimina.
He construido las partes de eesel que rodean al modelo, y el patrón en el que confío es hacia el que se está entrenando a Carbon: buscar primero, responder con lo que encontraste y decirlo cuando no encontraste nada. Qontro, una empresa de ERP de Nueva Zelanda, usa eesel así en Freshdesk. Cada ticket nuevo recibe un borrador de respuesta como nota interna, fundamentado en unos 9.800 tickets anteriores y artículos de ayuda, con los artículos enlazados. Las caídas, la pérdida de datos y la facturación pasan directamente a una persona, y si un ticket no tiene suficiente información para responder con confianza, eesel lo dice en lugar de adivinar. El equipo compara cada borrador con lo que realmente envió y usa las diferencias para mejorar el centro de ayuda.
Ese último ciclo es lo que ningún lanzamiento de modelo te da. También es como medirías si un modelo nuevo ayuda: lo ejecutas con tus propios tickets anteriores y comparas. El coste del servicio de atención al cliente con IA de una respuesta equivocada es la cifra a vigilar, no el coste por token.
Prueba eesel
Si lo que te llamó la atención es la promesa de Gemini 4 Carbon de "menos respuestas inventadas", puedes tener ese comportamiento en tu cola de soporte ya, sin esperar al despliegue de Google. Carbon es infraestructura; eesel es el empleado. El compañero de IA para helpdesk de eesel aprende de tus tickets anteriores y tu centro de ayuda, se integra con Freshdesk, Zendesk y los demás helpdesks que ya usas, y traspasa un ticket a una persona cuando no puede fundamentar la respuesta.
Puedes ejecutar una simulación con tus tickets anteriores reales antes de que responda a nadie, para ver qué habría dicho. Los planes son un plan de créditos mensual fijo, desde $299 por 500 créditos, y puedes empezar gratis con 100 créditos. Prueba eesel con una parte de tu cola y comprueba sus borradores frente a tus propias respuestas.