

Gemini 3.7 Flash es un modelo muy bueno que dejó de ser barato sin hacer ruido. Rápido, sí. Artificial Analysis lo mide en 340.1 tokens por segundo, el más veloz que miden actualmente. Salió en disponibilidad general el 13 de agosto de 2026. El precio de lanzamiento fue de $0.75 por 1M de tokens de entrada y $3.75 por 1M de salida.
Luego viene la trampa, y está en la lista de precios, no en ningún gráfico de benchmarks. Ese precio es introductorio. El 1 de enero de 2027 se duplica, a $1.50 y $7.50. Además, el nivel de razonamiento minimal ha desaparecido, el que hacía viables los modelos Flash anteriores para clasificación de alto volumen, así que ahora low es tu suelo más barato. Y los tokens de razonamiento se facturan a la tarifa de salida, aunque lo que te llega a ti es solo un resumen de ellos.
Construyo integraciones y la infraestructura de modelos en eesel. Nuestros agentes funcionan en helpdesks reales con volumen real, y un cliente procesa más de 100,000 tickets al mes en alemán a través de Zendesk. Ese trabajo me ha vuelto alérgico a elegir modelos mirando una tabla de benchmarks. Así que: para programación, trabajo con agentes y trabajo con documentos, 3.7 es una mejora real. Pero si elegiste Flash originalmente porque era el nivel barato, 3.7 no es tu camino de actualización, y la propia tabla de precios de Google lo confirma sin decirlo.
Qué es realmente Gemini 3.7 Flash
Gemini 3.7 Flash es el modelo de batalla más reciente de la línea de Gemini AI. Se publica como gemini-3.7-flash y está marcado como GA y no como preview. El planteamiento de Google es directo: "our most intelligent workhorse model yet for coding and agents."
Tiene una ventana de contexto de 1M de tokens con un techo de salida de 64k. La entrada puede ser texto, imagen, video, audio y PDF, pero la salida sigue siendo solo texto. Seis superficies lo tienen activo, entre ellas AI Studio y la Gemini API, y también Google Antigravity, donde ahora es el modelo por defecto detrás del agente de Antigravity.
Hay un dato de contexto importante para leer todo lo que sigue. Actualmente no hay un Gemini 3 Pro estable. gemini-3-pro-preview figura como apagado, y el único Pro que queda en la lista es 3.1 Pro en preview, lo cual es un cambio real respecto a la forma del lanzamiento de Gemini 3. Así que Flash carga con más peso en la gama del que normalmente tendría un modelo con "Flash" en el nombre, y eso explica mucho de cómo se ha posicionado y fijado su precio.
La API cambió más que el modelo
Esta es la parte que de verdad te costará una tarde, y casi nadie la pone al frente.
Si migras desde Gemini 3.5 Flash, Gemini 3 Flash Preview o Gemini 3.1 Pro, la lista de migración de Google te indica que elimines temperature, top_p, top_k y candidate_count, reemplaces el thinking_budget numérico por una cadena thinking_level, quites los turnos del modelo prellenados y muevas el historial multi-turno a un previous_interaction_id del lado del servidor. Gemini 3.6 Flash ya había eliminado los parámetros de muestreo, así que pasar de 3.6 a 3.7 sale casi gratis. Para todos los demás, limpieza completa.
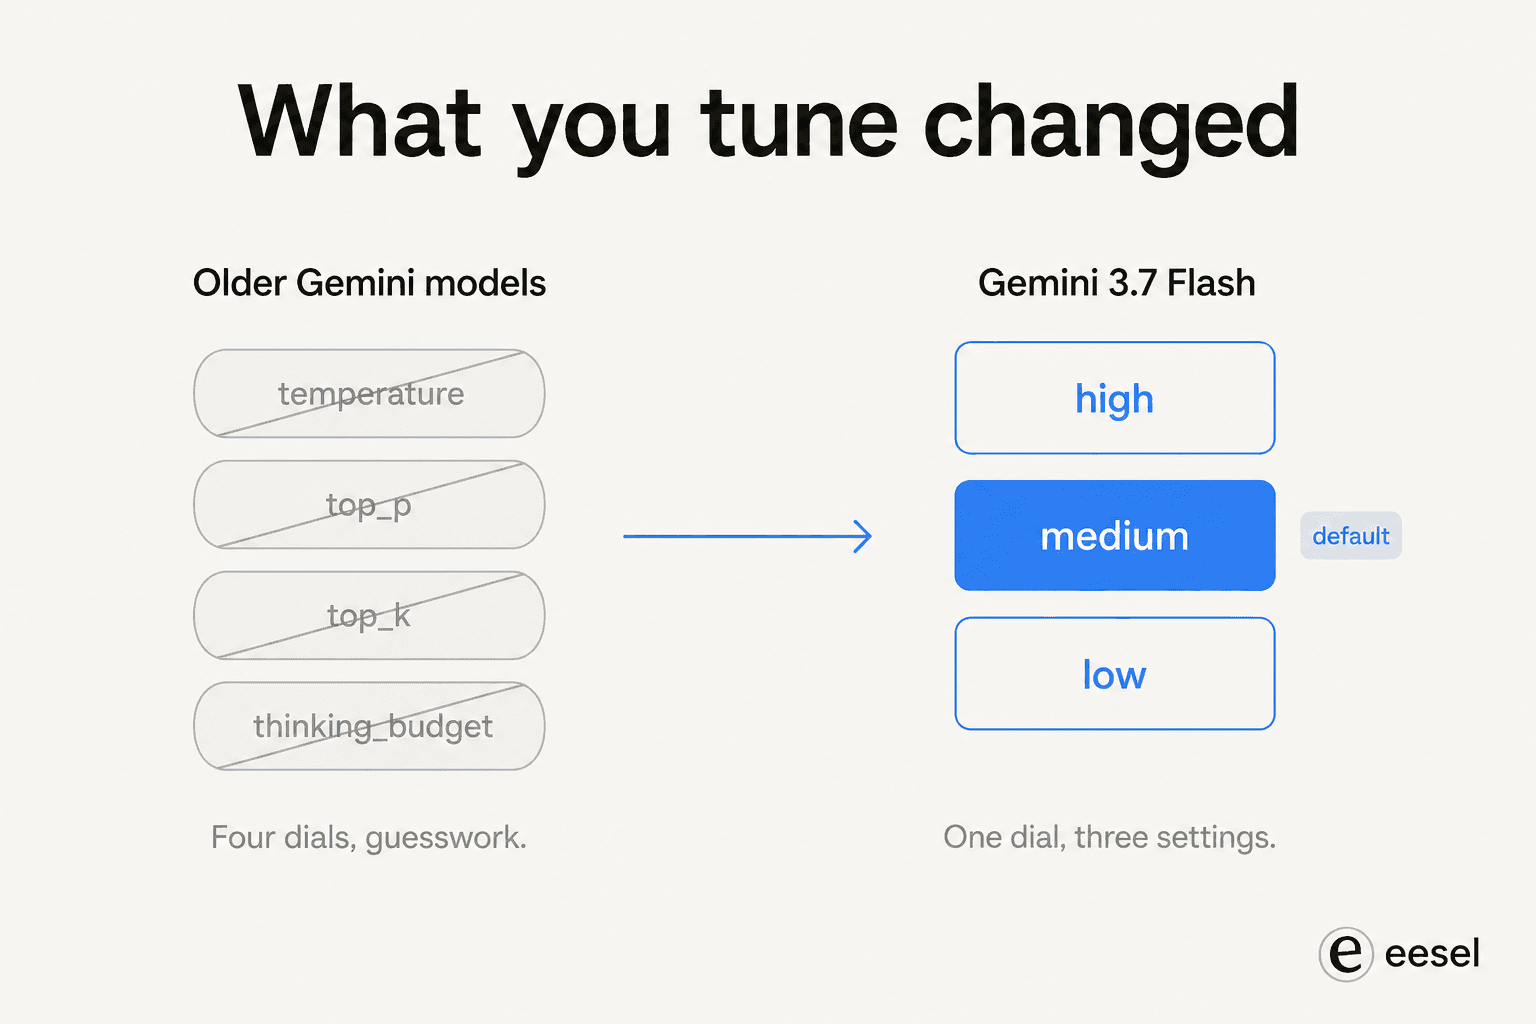
En lugar de cuatro mandos ahora tienes uno, con tres ajustes, y se configura dentro de generation_config:
| Nivel | Para qué lo recomienda Google | Perfil de costo |
|---|---|---|
low | Trabajo crítico en latencia: respuesta a incidentes, chat en tiempo real, borradores, análisis rápido de datos | Suelo más barato disponible |
medium (por defecto) | Código complejo y uso agéntico, con mayor precisión a la primera | Por defecto si no configuras nada |
high | Matemáticas difíciles, las tareas de programación y agentes más exigentes, uso extendido de herramientas | "Higher token consumption and cost" |
Esta es la regresión que nadie puso en un comunicado de prensa. Gemini 3.6 Flash, 3.5 Flash, 3.5 Flash-Lite y 3 Flash Preview aceptan todos un cuarto nivel, minimal. Gemini 3.7 Flash no. En un hilo de lanzamiento de 347 comentarios, Simon Willison fue la única persona que lo señaló:
"The 'introductory pricing' for this 3.7 Flash model is really weird.
It's scheduled to double in price on December 31, 2026, but who would anticipate still using this model five months from now? Especially since 3.6 Flash came out just three weeks ago!"

Perder minimal importa más de lo que suena. Si usabas Flash para OCR y etiquetado, o para la clasificación de tickets, minimal era el ajuste que hacía que los números cuadraran. low es un suelo real. Pero no es el mismo suelo.
El otro cambio silencioso: todos los ejemplos de código de la página usan ahora la Interactions API, que pasó a GA junto con el modelo, en lugar de generateContent. Conviene saberlo antes de copiar un fragmento en una base de código construida sobre la forma anterior.
Qué tan rápido es y cómo se reparte esa velocidad
La velocidad es donde 3.7 Flash sigue sin rival. Artificial Analysis lo mide en 340.1 tokens de salida por segundo, primero de los 188 modelos que siguen, frente a una mediana de clase de 68.6. El Intelligence Index llega a 56, decimoséptimo de 188, muy por encima de la mediana de clase de 34.
Los números del mundo real son menos halagadores, y más útiles. OpenRouter muestra un P50 de 93 tokens por segundo con 1.85 segundos de latencia. La división por proveedor es marcada: Google AI Studio sirve 124 tokens por segundo a 1.74 segundos, mientras Vertex alcanza 84 a 2.02 segundos.
El tiempo hasta el primer token es el punto débil, y depende por completo del nivel de razonamiento que elijas. Artificial Analysis mide una mediana de 9.83 segundos hasta el primer token en esfuerzo high, con un p95 de 49.5 segundos, frente a una mediana de clase de 2.88. En low baja a 0.74 segundos. Esa es la diferencia entre una latencia interactiva usable y otra de la que se quejarán tus usuarios.
Lo cual deja a la vista el hallazgo más práctico de todo el conjunto de datos:
| Nivel de razonamiento | Intelligence Index | Tiempo hasta el primer token | Costo por tarea de benchmark |
|---|---|---|---|
high | 56.0 | 9.83s | $0.40 |
medium | 53.5 | 4.22s | $0.26 |
low | 50.9 | 0.74s | $0.16 |
En esfuerzo low todavía puntúa 50.9, a menos de un punto de Gemini 3.6 Flash con esfuerzo high completo, con el 40% del costo por tarea y aproximadamente una treceava parte de la espera. Así que si migras desde 3.6 Flash y dejas el valor por defecto en medium, probablemente estés pagando por un razonamiento que no necesitabas.
Lo curioso es que el 93.1% del tráfico de OpenRouter va a Vertex, el endpoint más lento, porque lleva un descuento de plataforma del 50%. La gente cambia latencia por precio, lo que te dice para qué compran realmente este modelo.
También hay un fuerte contraargumento a toda la historia de la velocidad, y llega con números. Artificial Analysis midió que con razonamiento alto, 3.7 Flash aumenta el uso de tokens en alrededor de un 40% sobre 3.6 Flash, con un promedio de 37k tokens de salida por tarea. Tokens por segundo y tiempo hasta la respuesta no son lo mismo:
"Sol high is almost the same speed if you take into account drastically lower token use. Look at the artificial analysis speed vs token use. Gemini is 7x faster but 5x more tokens. And that's with Sol high being a substantially better model."
Ese aumento del 40% en tokens es una subida de precio disfrazada de insignia de velocidad. La tarifa no se movió. Lo que se movió es la cantidad de tokens de salida facturables por tarea, y los tokens de razonamiento también se cobran ahí a la tarifa de salida. Ten esto presente para la calculadora de más abajo.
Los benchmarks, incluidos los que Google no puso al frente
Google publicó una comparación de 21 filas frente a Gemini 3.6 Flash, Claude Sonnet 5, GPT-5.6 Terra y Muse Spark 1.2. A su favor, también publicaron las derrotas. Estas son las filas que más importan:
| Benchmark | Gemini 3.7 Flash | Gemini 3.6 Flash | Claude Sonnet 5 | GPT-5.6 Terra | Muse Spark 1.2 |
|---|---|---|---|---|---|
| Precio de entrada, $/1M | $0.75 | $0.75 | $2.00 | $2.00 | $1.25 |
| Precio de salida, $/1M | $3.75 | $3.75 | $10.00 | $12.00 | $4.25 |
| AA Intelligence Index | 56 | 52 | 55 | 57 | 57 |
| FrontierCode 1.1 Main | 43.6% | 34.4% | 42.7% | 41.3% | - |
| DeepSWE v1.1 | 65.3% | 48.6% | 53.8% | 69.6% | 54.9% |
| Code Arena (Elo) | 1588 | 1538 | 1541 | 1523 | 1535 |
| Terminal-bench 2.1 | 85.8% | 78.0% | 80.4% | 87.4% | 82.9% |
| Terminal-bench 3.0 | 14.9% | 5.4% | 14.6% | 20.8% | - |
| AutomationBench (privado) | 30.4% | 17.0% | 10.7% | 23.6% | - |
| GDPVal-AA v2 (Elo) | 1525 | 1422 | 1598 | 1578 | 1628 |
| Harvey LAB-AA (legal) | 90.7% | 85.1% | 90.1% | 85.2% | - |
| GDP.pdf (comprensión de PDF) | 34.0% | 22.0% | 28.0% | 24.7% | 16.0% |
| CharXiv Reasoning (sin herramientas) | 84.5% | 85.2% | 77.0% | 85.9% | - |
| CharXiv Reasoning (con herramientas) | 88.7% | 89.4% | 88.3% | - | - |
| LVBench (video largo) | 85.4% | 84.2% | 68.5% | 78.9% | - |
| GDM-MRCR v2 @128k | 97.0% | 91.8% | 81.5% | 93.5% | - |
| OSWorld-2.0 (uso del ordenador) | 47.9% | 33.8% | - | 50.2% | - |
| HLE-Verified | 53.6% | 51.2% | 31.0% | 51.1% | - |
Algunas lecturas honestas de esa tabla.
Los saltos frente a su propio predecesor son grandes y reales. DeepSWE pasando de 48.6% a 65.3%, y AutomationBench de 17.0% a 30.4%, no son redondeos. La propia prosa de Google cita DeepSWE en 49.0% en lugar de 48.6% para 3.6 Flash, una pequeña discrepancia entre el texto y el gráfico, aunque la dirección no está en duda.
GPT-5.6 Terra sigue dominando el trabajo agéntico de terminal. Terminal-bench 2.1, Terminal-bench 3.0, DeepSWE y OSWorld-2.0 son todos de Terra. Si tu carga de trabajo es un agente de programación de largo recorrido masticando un repositorio real, esos son cuatro de los cuatro benchmarks que importan, y es la razón por la que varias personas en Hacker News leyeron este modelo como un competidor de Terra y no como una opción económica.
Perdió dos filas frente a Gemini 3.6 Flash. Ambas son razonamiento sobre gráficos de CharXiv, 84.5 contra 85.2 sin herramientas y 88.7 contra 89.4 con ellas. Pequeño. Pero significa que "3.7 supera a 3.6 en todo" no es una afirmación verdadera, y si los gráficos son tu carga de trabajo, deberías comprobarlo antes de migrar.
Hay un número más que solo aparece en las pruebas independientes. Artificial Analysis mide una tasa de alucinación de 64.5% para 3.7 Flash frente a 55.6% para 3.6 Flash. La precisión subió, y la alucinación subió junto con ella.
Para ser justos con Google, ese número se ve muy distinto según la base de comparación que tomes. Un lector que revisaba los mismos datos en Reddit lo puso en un contexto más amplio:
"Flash 3 had 93 % hallucination but also very good world knowledge. 3.7 Flash has 65 %. This is a considerable improvement but it still lacks behind 3.1 Pro. […] Both Gemini Flash and GPT Sol are very good at getting the right answer, better than all other models except Claude Fable and Opus. It's just that when they don't get it right hallucination is likely or almost guaranteed."

Entonces: mucho mejor que Flash 3. Ligeramente peor que el modelo al que reemplaza directamente, y todavía por detrás de 3.1 Pro. Esto último es lo que importa, y más adelante vuelvo a por qué me quita el sueño.
Dos salvedades sobre las fuentes. Artificial Analysis no tiene puntuación de 3.7 Flash para SWE-Bench Verified, AIME, LiveCodeBench ni MMLU-Pro, así que cualquier cifra que circule para esos es el gráfico de Google y no una ejecución independiente. Además, la ventana de contexto difiere entre fuentes: Artificial Analysis dice 1,000,000 mientras la ficha de Vertex de Google dice 1,048,576.
Cuánto cuesta y la fecha en que termina ese precio
El titular dice $0.75 por 1M de tokens de entrada y $3.75 por 1M de salida. El asterisco es toda la historia.
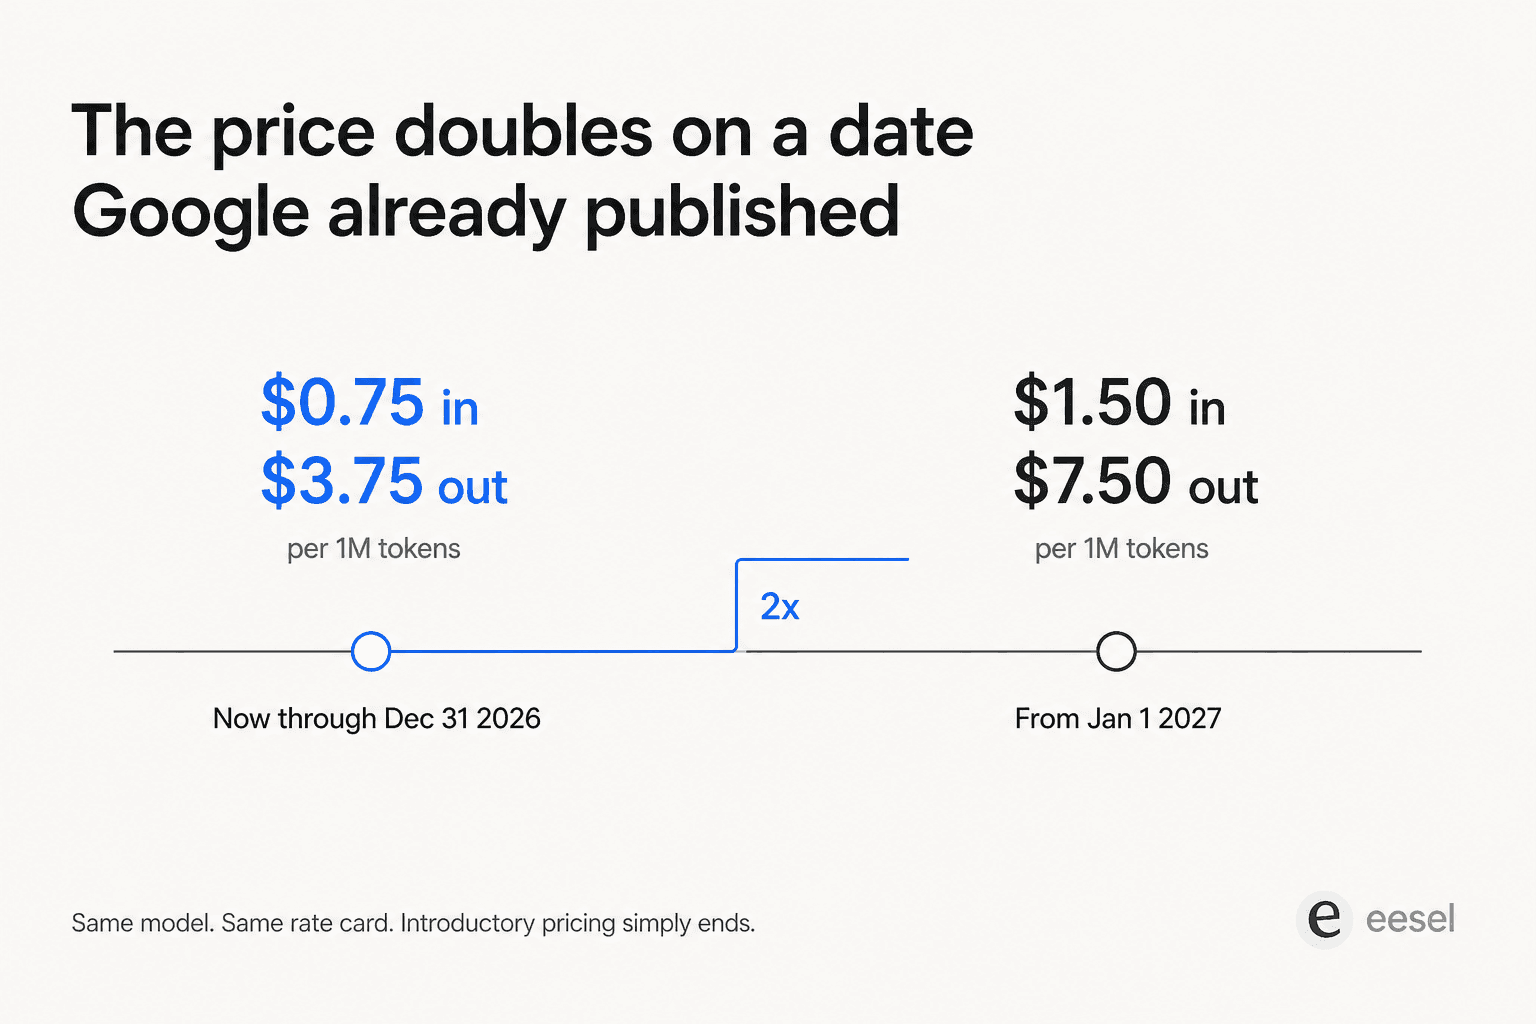
Esta es la lista de precios completa, tomada de la página de precios de Google:
| Concepto | Hasta el 31 dic. 2026 | Desde el 1 ene. 2027 |
|---|---|---|
| Entrada, por 1M de tokens | $0.75 | $1.50 |
| Salida (incluido el razonamiento), por 1M | $3.75 | $7.50 |
| Modo batch entrada / salida | $0.375 / $1.875 | $0.75 / $3.75 |
| Modo Flex | Igual que batch | Igual que batch |
| Modo Priority | $1.35 / $6.75 | $2.70 / $13.50 |
| Lectura de caché de contexto, por 1M | $0.075 | $0.15 |
| Almacenamiento de caché de contexto, por 1M por hora | $0.50 | $1.00 |
| Google Search grounding | 5,000 solicitudes gratis al mes entre todos los modelos 3.x, luego $14 por 1,000 | Igual |
Varias cosas merecen destacarse. No hay escalón de precio por longitud de contexto, así que un prompt de 900k tokens cuesta lo mismo por token que uno de 900, a diferencia de 3.1 Pro Preview. Tampoco hay recargo por modalidad: la entrada de audio y video se factura a la misma tarifa que el texto, mientras que 3 Flash Preview cobra el doble por el audio. Y el grounding se abarató mucho a lo largo de la generación 3.x, bajando de $35 por 1,000 solicitudes a $14.
Lo que resulta extraño es que Gemini 3.6 Flash tiene ahora el mismo precio que 3.7 Flash, la misma tarifa introductoria y la misma fecha de vencimiento, y también el mismo precio estándar después. La prosa de Google describe 3.7 Flash como aproximadamente la mitad del costo del 3.6 Flash original, cierto frente al precio de lista, no cierto frente a lo que 3.6 Flash te cuesta hoy. No hay sobreprecio en el modelo nuevo, lo que básicamente significa que no hay razón para quedarse en 3.6 salvo que CharXiv o minimal sean imprescindibles para ti. Nuestro desglose de precios de 3.6 Flash sigue valiendo, porque ahora es la misma tarifa.
Introduce aquí tu propio volumen:
Pagas por un razonamiento que nunca ves
Esta es la partida que sorprende a la gente, y está dicha con claridad en la documentación de thinking de Google: "When thinking is turned on, response pricing is the sum of output tokens and thinking tokens."
Luego la frase más afilada, unos párrafos más abajo: "Pricing is based on the full thought tokens the model needs to generate, despite only the summary being output from the API."
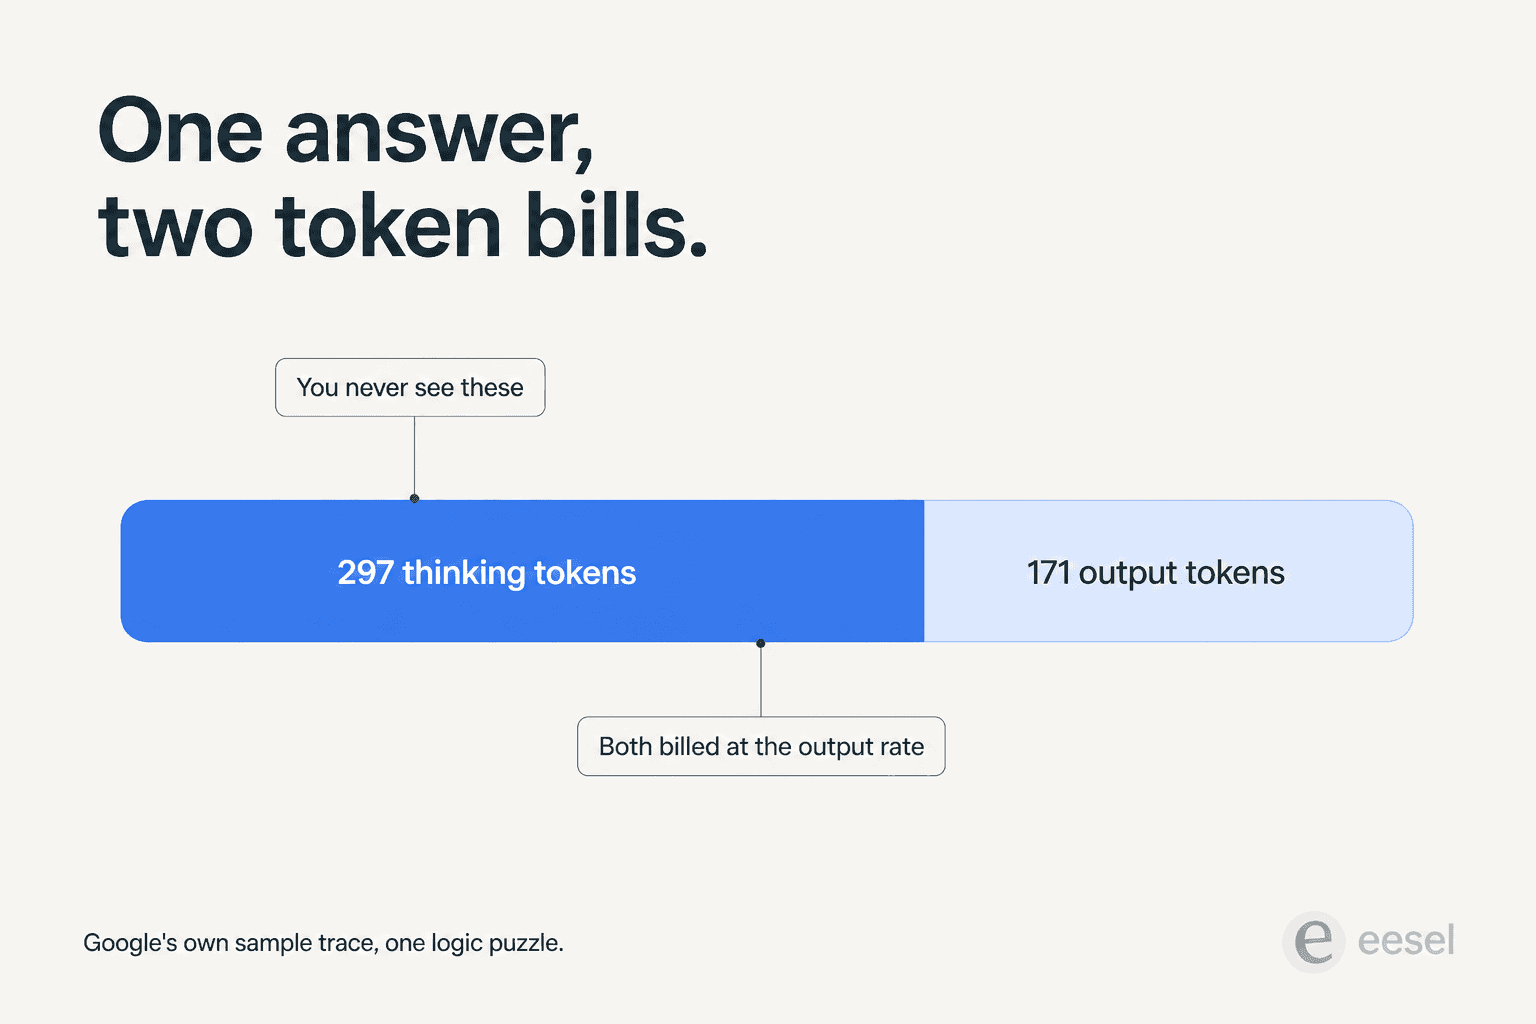
La traza de ejemplo de Google sobre un acertijo lógico de tres pistas gasta 297 tokens de razonamiento frente a 171 tokens de salida. Es decir, casi dos tercios de la factura de salida de esa respuesta fueron un razonamiento que quien llama nunca recibe, solo un resumen. El conteo se expone como usage.total_thought_tokens, así que se puede medir, pero hay que ir a buscarlo. Si ejecutas varios modelos en paralelo, esto es justo lo que las herramientas de seguimiento de LLM existen para detectar.
Multiplica eso por una carga de producción y que medium sea el valor por defecto se convierte en una decisión real y no en un encogimiento de hombros. También es la razón por la que el control de sobrecarga de razonamiento de la calculadora de arriba está en 75% y no en cero.
Algunos desarrolladores encuentran el enfoque resumido peor que inútil. Del hilo de lanzamiento:
"I really, really like DSv4 Flash because you see the full, real thinking text. That's been so useful for helping steer the model; as well as seeing its thoughts and correcting any errors, or expanding on it. It's so difficult for me to use closed models with no or summarised thinking now."
Qué dicen realmente los desarrolladores
El hilo de lanzamiento alcanzó 621 puntos y 347 comentarios en unas ocho horas, y su forma es más interesante que la puntuación.
El número más citado de todo el hilo resulta ser el precio de un competidor:
"Ever since the insane discount with GPT-5.6 Luna, not much excites me anymore. I mean just look at the benchmarks, even though Gemini 3.7 Flash performs well on the DeepSWE 1.1, Luna (Max) still performs way better.
> Starting January 1, 2027, $1.50/1M input tokens and $7.50/1M output tokens will apply.
Compare this to Luna which is at $0.2/1M input ($0.02 cached) and $1.2/1M output."
La corrección de posicionamiento llegó unos comentarios después, y es lo más útil de todo el hilo:
"They need to release benchmarks against Luna/Terra. Luna is much cheaper which feels like it undercuts the need for Flash.
I've always considered the Flash series of models to be for low-cost, high-volume, mostly text-based use cases (e.g. summarization, parsing, formatting), emphasis on low-cost."
Ese es el replanteamiento. Flash ya no compite en el extremo bajo del mercado; ahí compite Flash-Lite. Si te encantaba Flash por ser barato, el modelo que realmente quieres a continuación está un nivel más abajo, o fuera por completo de la familia de Google.
Los lugares obvios donde mirar son Qwen y Kimi. Si necesitas un proveedor occidental con un presupuesto similar, Mistral es la comparación más cercana.
El veredicto práctico más certero salió de una prueba de imagen a HTML ejecutada con opencode, que enfrentó a 3.7 Flash con Claude Opus 5 y Grok:
"It's not a bad model by any means, but I just don't know what situation I'd reach for 3.7 Flash first for. Google really needs a differentiator, especially given how hard it is to get an API key from them. They can't be high friction and non-pareto."
Esa última cláusula abrió el subhilo más grande del día, y el modelo no era su tema en absoluto. El tema era si se le puede comprar a Google. Un comentarista reportó el mensaje de error "Failed to create project, The request is suspicious. Please try again" en una clave nueva; otro reportó lo mismo en una cuenta de Cloud de diez años que solo empezó a funcionar dos días después. El más doloroso a nivel operativo:
"There are places where you CAN set a limit. This seems great until you are at the center of a huge traffic spike because of good pr and so you try to change it to a larger number only to be told you need to wait 24 hours for the setting to change.
Biggest traffic day of the decade and our site was down because of google."
Para ser justos, esto se discute más abajo en el hilo. Un comentarista creó una clave en una cuenta nueva en dos clics y sin salir de la página, y además Google ya ofrece límites de gasto en la Gemini API. Así que la fricción es real para algunos y no es un problema para otros, lo cual es un problema en sí mismo. Como contraste, los límites de tasa de OpenAI y los precios de la API de GPT-5 Pro están documentados de modo que la mayoría los supera sin un solo ticket de soporte.
Dónde Flash sigue ganando sin discusión
En visión y en documentos. Es el único eje en el que incluso los críticos del hilo concedieron el punto.
Mira otra vez la tabla de benchmarks: GDP.pdf con 34.0% frente al 24.7% de Terra, LVBench con 85.4% frente a 68.5% de Sonnet 5, y luego la prueba de aguja de 128k con 97.0%. Eso forma un cuadro coherente y no tres filas con suerte. Un comentarista expuso la versión práctica mejor que cualquier benchmark, al describir cómo Gemini diagnosticó correctamente un problema de una planta a partir de una foto, después de que un modelo centrado en texto se equivocara.
"That's been my association as well. I see Flash get brought up a lot in relation to things like OCR and PDF processing frequently, and a lot of other routine multimodal workloads."
También hay un argumento de escala, y me sorprendió:
"did you try to ingest 1M documents per hour with any provider except GCP with Flash? None work at scale. Deepseek, Luna, Mistral all fail. 1 in 3 requests is a fail. I stopped trying. The only thing that works at scale is gemini flash."
Barato por token y fiable a volumen son dos cosas distintas, y es una distinción que los hilos de comparación de precios suelen saltarse.
Los clientes que Google nombra llegan al mismo punto. El cofundador de Browser Use, Gregor Zunic, informa que el agente fue "35% cheaper than 3.6 Flash, with a +8% observed prompt-cache hit rate and fewer tool errors." Conviene leerlo como gasto total y no como tarifa de lista, porque hoy ambos modelos se facturan igual; el ahorro sale de los aciertos de caché y de menos llamadas a herramientas repetidas. Niko Grupen, de Harvey, reporta +2.6 puntos all-pass en su Legal Agent Bench. Kyrill Hux, de Nunu.ai, lo califica a la par de GPT-5.6 Terra "at around half the cost." Son citas aportadas por el proveedor en una página de lanzamiento, así que pésalas en consecuencia.
La lectura de terceros más útil vino de Cognition, que lo puso dentro de Devin y luego fue específica sobre dónde encaja:
"On FrontierCode 1.1, it reaches Claude Sonnet 5-level performance at less than half the cost, with the low latency the Flash series is known for. […] Within Devin, Gemini 3.7 Flash performs particularly well on tightly scoped refactors, where it delivers minimal diffs that match repo conventions."
"Tightly scoped refactors" es un límite preciso y honesto, y coincide con lo que dicen los benchmarks de agentes de terminal sobre el extremo de largo recorrido.
Quién debería usar Gemini 3.7 Flash y quién no
Úsalo si haces extracción de documentos, trabajo con PDF y gráficos, recuperación en contexto largo, comprensión de video o generación de código web y de UI a partir de maquetas. Los 1588 Elo de Code Arena son la mejor puntuación en la tabla de Google, y los benchmarks de documentos no están reñidos. También es la elección correcta si ya estás en Antigravity, ya que allí ahora es el valor por defecto.
Evítalo si tu carga de trabajo es un agente de programación de terminal de largo recorrido, donde GPT-5.6 Terra gana esos cuatro benchmarks que miden exactamente eso. Evítalo también si llegaste a Flash por el precio mínimo. Entre perder minimal, que los tokens de razonamiento se facturen como salida y una tarifa que se duplica en enero, el argumento del nivel barato se ha trasladado en silencio a Flash-Lite y a competidores un orden de magnitud por debajo en salida.
Espera si estás en 3.6 Flash y el razonamiento sobre gráficos al estilo CharXiv es imprescindible para ti. Pagarías el mismo dinero por dos filas de benchmark que empeoran ligeramente.
Si todavía estás sopesando el panorama, los resúmenes que valen tu tiempo son alternativas a Gemini, alternativas a Gemini 3 y alternativas a Claude.
En cuanto a herramientas, el modelo importa menos que el entorno en el que lo ejecutas. La mayoría de quienes lean esto se encontrarán con 3.7 Flash a través de un editor y no de una llamada cruda a la API, y nuestras notas sobre los mejores asistentes de programación con IA, las CLI de programación agéntica y los precios de Cursor cubren esa capa.
Qué significa esto si vas a poner un modelo en una cola de soporte
Volvamos al número de alucinación, porque aquí empieza mi trabajo diario.
Artificial Analysis mide que Gemini 3.7 Flash alucina un 64.5%, frente a 55.6% de 3.6 Flash. La precisión mejoró, y la alucinación empeoró, al mismo tiempo. Esa combinación no es una contradicción; es la forma normal de un modelo afinado para comprometerse con respuestas en lugar de cubrirse. Estupendo para un agente de programación que un compilador puede corregir. Un riesgo cuando la salida va directamente a un cliente.
Alguien que ejecuta exactamente esta carga en producción trazó el límite mejor de lo que yo podría:
"Yeah we use it for auto-triage of incidents, attempts to auto-remediate, and escalation to human. But for actual development, it's not a viable option for us."
Triaje, luego intento, luego escalado. Esa es la forma correcta, y fíjate en que ahí el humano es el último paso y no una ocurrencia tardía.
Llevamos años ejecutando agentes de IA en helpdesks reales con volumen real, incluido un prestamista que procesa más de 100,000 tickets al mes en alemán a través de Zendesk y un equipo de e-commerce que gestiona más de 50,000 al mes en Freshdesk. Lo que enseña esa experiencia es que una puntuación de benchmark casi no dice nada sobre cómo se comporta un modelo con tus tickets. Dos equipos con el mismo modelo, el mismo helpdesk y el mismo sector obtienen respuestas distintas, porque sus bases de conocimiento tienen formas diferentes.
Así que la elección del modelo importa menos que lo que lo rodea. Una recuperación que realmente encuentre el documento correcto, y eso es un problema de RAG y no un problema del modelo. Enrutamiento por confianza, para que una respuesta de baja confianza se convierta en borrador en lugar de un envío. Y luego una prueba en seco con tu propio historial de tickets, antes de que ningún cliente vea una sola palabra, que es el paso que se saltan la mayoría de los despliegues de automatización de soporte.
Fíjate en que ninguno de esos es el modelo en sí. La mayoría de las razones por las que un chatbot de IA responde mal son fallos de contenido y de recuperación, y no que el modelo no sea lo bastante listo, y arreglar la base de conocimiento suele mover el número más que cambiar a lo que se lanzó esta semana.
Ese último punto es todo el argumento. No puedes leer una tasa de alucinación de 64.5% en una tabla de clasificación y predecir lo que recibirán tus clientes. Lo que sí puedes hacer es ejecutar el agente sobre 500 de tus tickets cerrados y leer tú mismo las respuestas. También es la única forma honesta de comparar herramientas de automatización de tickets o de elegir entre plataformas de helpdesk con IA, porque la demo de cada proveedor está construida con sus datos y no con los tuyos.

Si la razón por la que valoras tokens es un presupuesto de soporte, la comparación más barata para hacer primero es costo de agente de IA vs humano, que suele empequeñecer la diferencia entre $3.75 y $7.50 por millón. Pusimos números a eso en ahorro con IA en soporte.
Prueba eesel
Si llegaste aquí porque estás evaluando Gemini 3.7 Flash para dar soporte, el consejo honesto es que dejes de comparar fichas de modelos y empieces a probar con tus propios tickets. Para eso está hecho eesel: se conecta en pocos minutos a Zendesk, Freshdesk, Gorgias, HubSpot, Front o Slack, aprende de los tickets que ya resolviste y no solo de tu centro de ayuda, y luego ejecuta una simulación sobre tu historial de tickets, para que veas las respuestas exactas que habría enviado, por tema, antes de que nada salga en vivo.
Es un precio mensual fijo, desde $299/mes por 500 créditos (1 crédito por ticket o chat) sin cargo por asiento, así que las cuentas se comparan con una factura de tokens más fácilmente de lo que la mayoría de los proveedores permite. Un cliente resolvió el 73% de las solicitudes de nivel 1 en el primer mes, y los resultados fueron visibles dentro de una prueba de siete días.
Prueba eesel gratis, ejecútalo sobre tus últimos cientos de tickets y deja que la simulación te diga si el modelo es lo bastante bueno o no. Esa respuesta vale más que cualquier tabla de benchmarks de esta página, la mía incluida.