Qué es realmente Xiaomi MiMo V2.6
Me dedico a construir integraciones y APIs, así que mi primer instinto ante cualquier lanzamiento de este tipo es saltarme la página de marketing y leer la ficha del modelo. La ficha de MiMo V2.6 se sostiene.
MiMo V2.6 es una familia de modelos de lenguaje de pesos abiertos y nativamente omnimodales del equipo MiMo de Xiaomi, lanzada el 22 de septiembre de 2026. "Nativamente omnimodal" hace un trabajo real en esa frase: el mismo modelo procesa texto, imágenes, vídeo y audio, en lugar de acoplar un adaptador de visión a un modelo de texto a posteriori. Cada checkpoint de la familia incluye una ventana de contexto de 1 millón de tokens.
El lema del lanzamiento es "Scaling Reinforcement Learning Toward Self-Improvement", y Xiaomi enmarca toda la serie como un paso en una vía de auto-mejora recursiva: escalar el cómputo de RL en tareas verificables y complejas y dejar que el modelo siga empujando su propia frontera de capacidad. Es el tipo de frase que normalmente me hace poner los ojos en blanco, pero el informe técnico tiene suficiente metodología concreta detrás como para leerse como ingeniería, no como una nota de prensa.
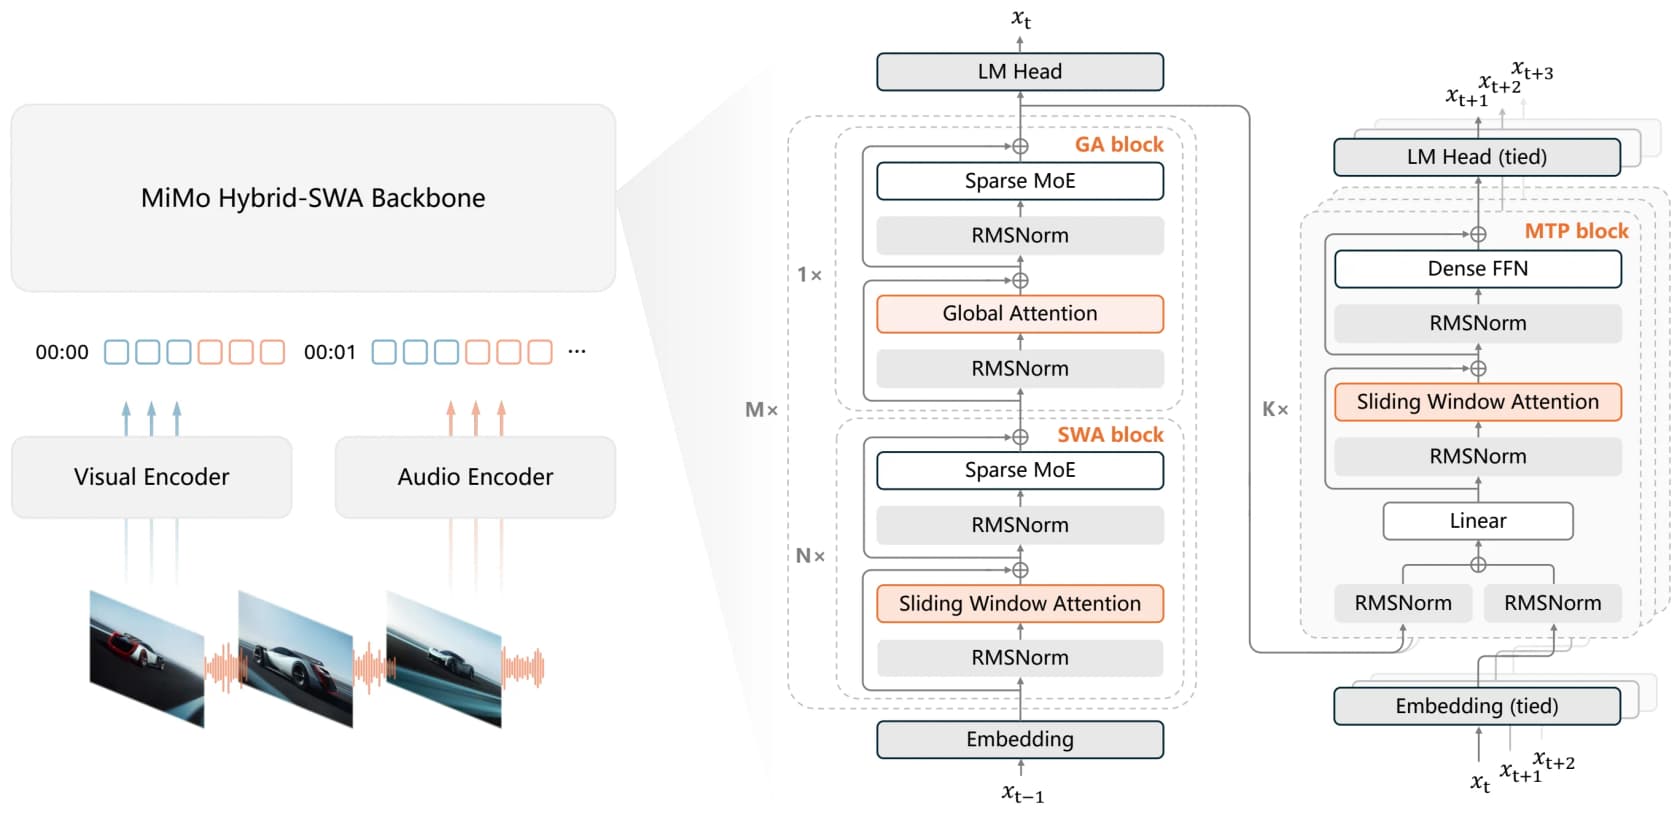
Si quieres la versión de un párrafo de la arquitectura: Pro es un modelo disperso de mezcla de expertos con una columna vertebral de atención híbrida: 70 capas que intercalan atención local de ventana deslizante (ventana de 128) con atención global, 384 expertos enrutados de los que 8 se activan por token, un codificador visual de 681 millones de parámetros, codificadores de audio dedicados, y un decodificador de predicción multi-token de 5 capas que predice varios tokens por pasada hacia adelante para acelerar la decodificación. No necesitas preocuparte por nada de esto para usarlo, pero explica cómo un modelo de "un billón de parámetros" sigue siendo barato de ejecutar: solo 42.000 millones de esos parámetros están activos en un token dado.
La familia de modelos, de Flash a un Pro de un billón de parámetros
MiMo V2.6 no es un solo modelo, son cuatro checkpoints pensados para cuatro trabajos distintos. Aquí es donde surge gran parte de la confusión online, así que merece la pena exponerlo con claridad.
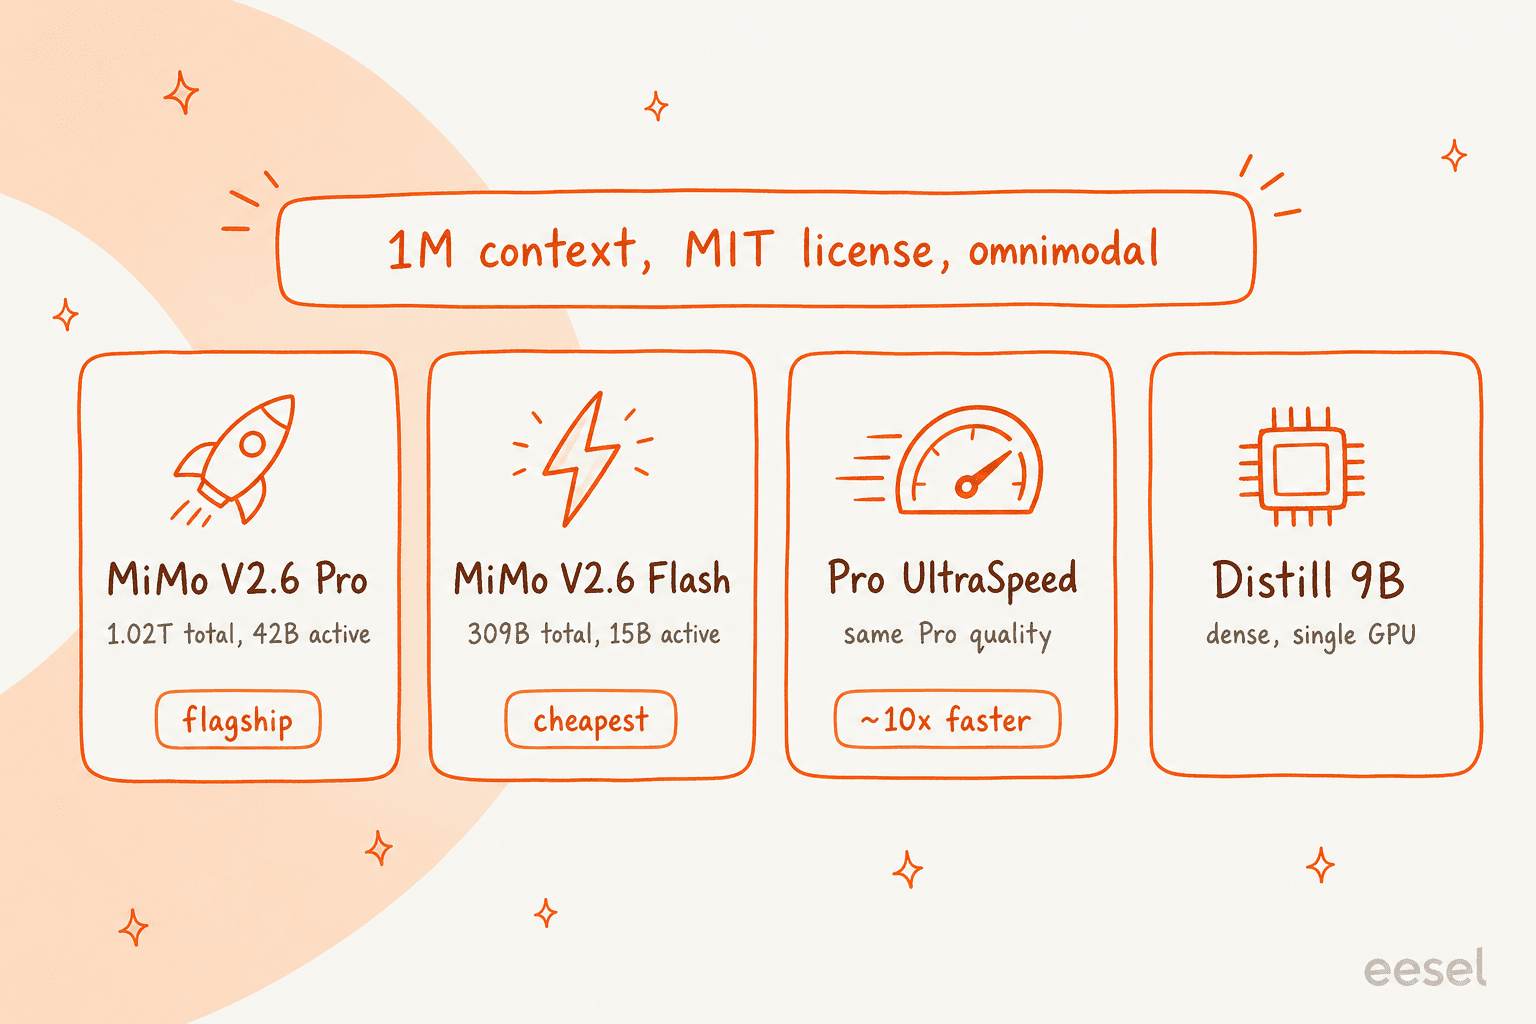
| Modelo | Arquitectura | Parámetros totales | Parámetros activos | Contexto | Mejor para |
|---|---|---|---|---|---|
| MiMo V2.6 Pro | MoE disperso | 1,02T | 42B | 1M | El trabajo agéntico más exigente y de largo horizonte |
| MiMo V2.6 Flash | MoE disperso | 309B | 15B | 1M | El mejor equilibrio entre inteligencia, velocidad y coste |
| MiMo V2.6 Pro UltraSpeed | Mismo checkpoint de Pro, versión rápida | ~1T | 42B | 1M | Calidad de nivel Pro cuando necesitas la salida rápido |
| MiMo V2.6 Distill-Qwen-9B | Denso (SFT de Qwen3.5-9B) | 9B | 9B | n/a | Investigación de RL agéntica abierta y de una sola GPU |
Hay varias cosas que destacar. Pro se presenta como el modelo más capaz de Xiaomi hasta la fecha. Flash es el que la mayoría de la gente realmente elegirá, ya que ofrece el equilibrio que la mayoría de las cargas de trabajo buscan. UltraSpeed es el mismo checkpoint de Pro servido a una velocidad de salida unas 10 veces mayor (el blog de Xiaomi afirma que hasta 20 veces), lo cual importa mucho si estás transmitiendo respuestas a un usuario que espera al otro lado. Y el destilado de 9B es un ajuste fino supervisado de Qwen3.5-9B sobre datos generados por MiMo, publicado como punto de partida para la investigación abierta en lugar de como modelo de producción.
El salto generacional es la verdadera noticia aquí. El buque insignia anterior, MiMo V2.5 Pro, obtuvo 19,0 en el benchmark de codificación DeepSWE v1.1. V2.6 Pro obtiene 71,9 en la misma tabla. En Terminal Bench 4.0 pasó de 1,5 a 34,9. No son mejoras incrementales, son el tipo de salto que solo se ve cuando un laboratorio cambia su enfoque de entrenamiento, que es exactamente lo que Xiaomi dice que ocurrió.
Los benchmarks con los que Xiaomi presume, y los que no
Todo lanzamiento de modelo elige a dedo sus gráficos, así que fui directo a la tabla de evaluación de la ficha del modelo, que compara MiMo V2.6 con Claude Opus 5, GPT-5.6 Sol y Claude Fable 5. Aquí está el desglose honesto.
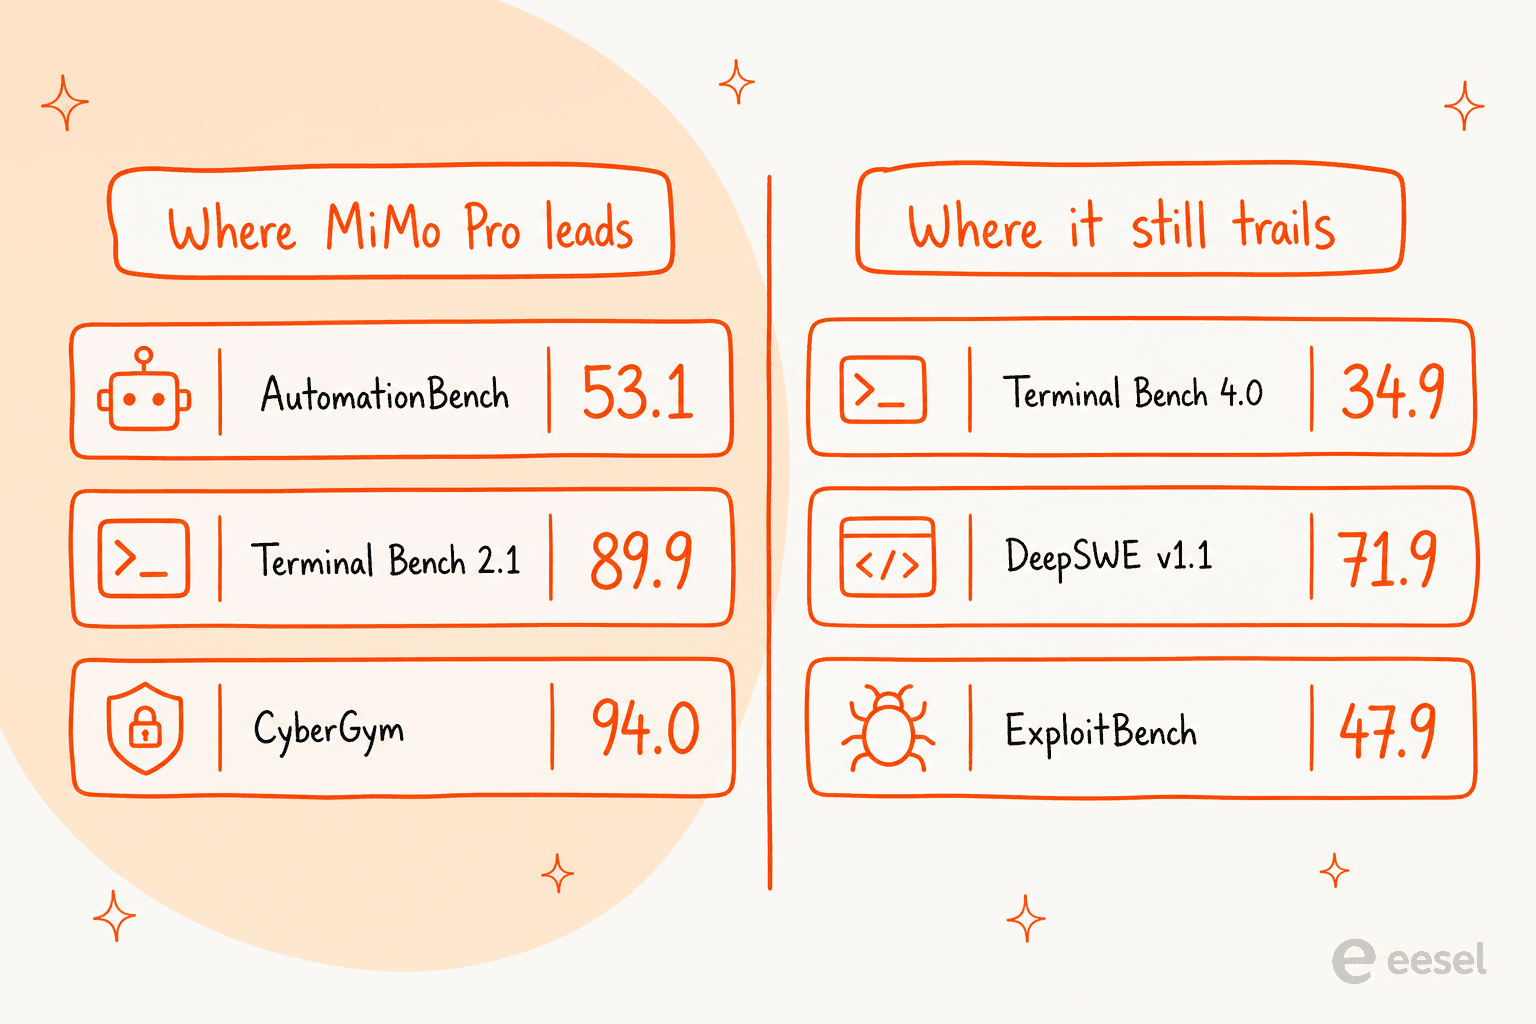
Dónde Pro supera claramente a la vanguardia cerrada según las cifras de Xiaomi:
| Benchmark | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| AutomationBench v1.0.6 | 53,1 | 50,3 | 45,8 |
| Terminal Bench 2.1 | 89,9 | 89,1 | 88,8 |
| Agents' Last Exam | 31,6 | 31,6 | 30,8 |
| MiMo Visual Coding | 72,3 | 70,0 | 73,4 |
Y dónde se queda atrás, algo que Xiaomi, para su mérito, publica justo al lado de las victorias:
| Benchmark | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| DeepSWE v1.1 | 71,9 | 74,0 | 73,0 |
| ProgramBench | 26,5 | 37,0 | 25,0 |
| Terminal Bench 4.0 | 34,9 | 49,0 | 39,9 |
| ExploitBench | 47,9 | 70,0 | 78,5 |
El patrón es consistente y, creo, creíble: MiMo V2.6 Pro está a la altura de la vanguardia en tareas agénticas generales y de uso de herramientas, y se queda atrás en los benchmarks más duros de codificación de largo horizonte y de explotación. Cuando Xiaomi amplió la comparación en su blog de lanzamiento para incluir GPT-6 Astra, DeepSeek V4.1 Flash y GLM 5.3, se mantuvo la misma forma: Pro se sitúa cerca de la cabeza del grupo en AutomationBench y Terminal Bench 2.1, y por detrás de GPT-6 Astra en Terminal Bench 4.0 (59,6) y ExploitGym.
Una cifra sí merece un aviso. Pro registra un llamativo 94,0 en CyberGym (Flash es incluso más alto, con 95,1), donde el anterior V2.5 Pro obtenía 40,0. La ciberseguridad es claramente un área en la que Xiaomi ha entrenado con fuerza, aunque el más adversarial ExploitBench cuenta una historia más humilde, así que trataría el resultado de CyberGym como impresionante en lugar de definitivo.
La cifra independiente que importa más que cualquier tabla individual
Los benchmarks individuales tienen ruido. El índice agregado de Artificial Analysis es el que realmente sigo, porque combina muchas evaluaciones en una única puntuación comparable y, de forma crucial, la representa frente al coste.
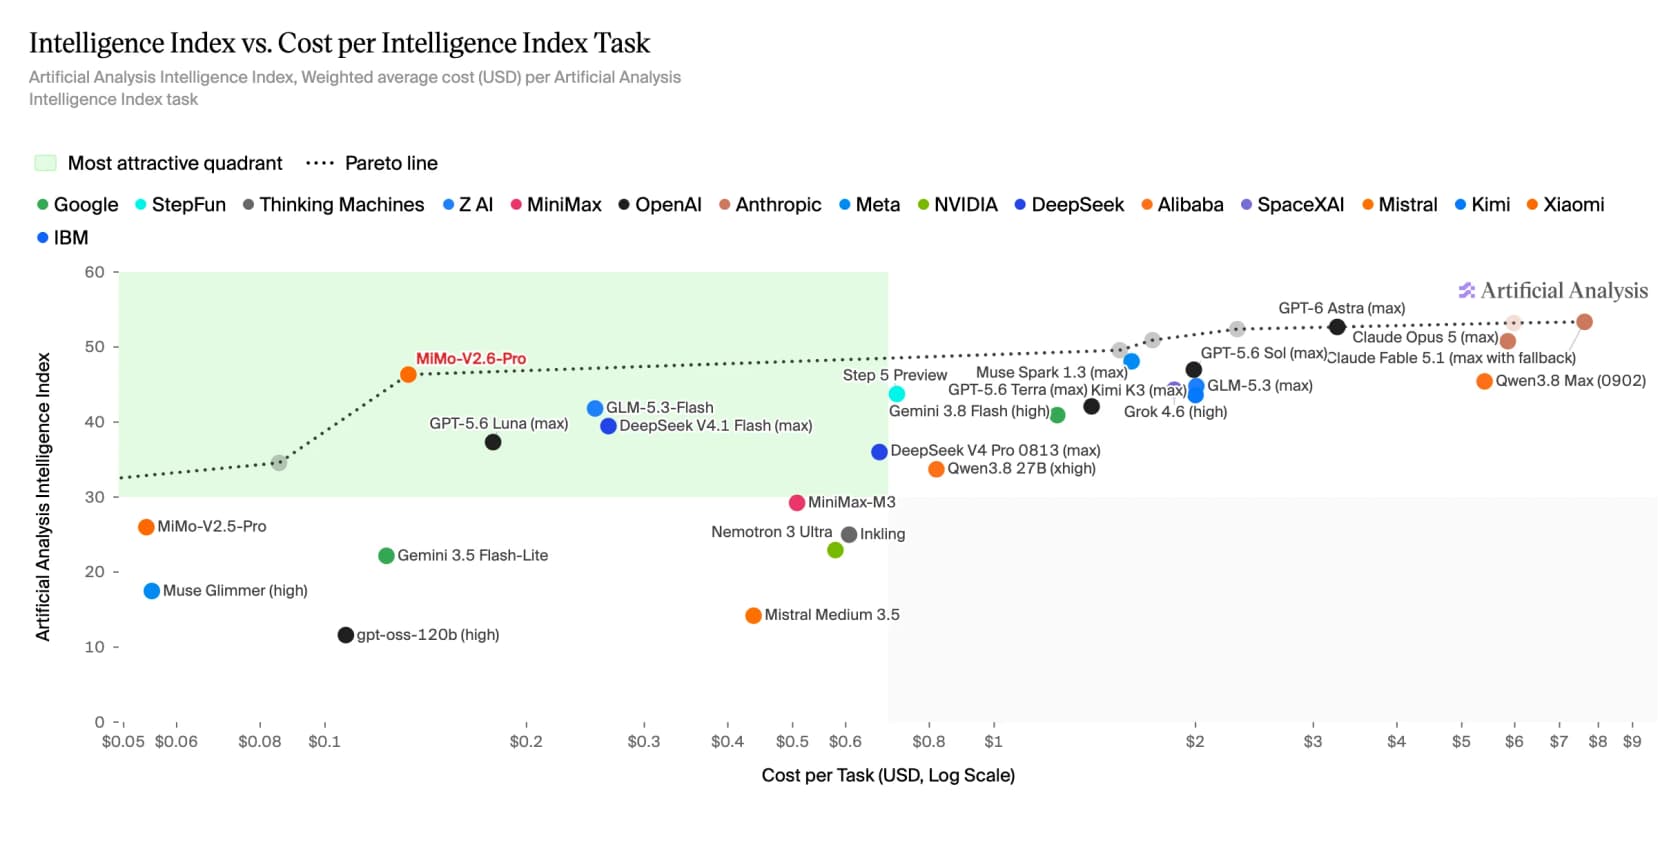
MiMo V2.6 Pro alcanza un Intelligence Index de 46, el modelo de pesos abiertos líder en la tabla, situándose en lo que Artificial Analysis literalmente etiqueta como el "cuadrante más atractivo". La vanguardia cerrada puntúa más alto en inteligencia bruta (GPT-6 Astra, Opus 5 y Fable 5.1 se sitúan todos entre el rango bajo y medio de los 50), pero lo hacen a entre 3 y 8 $ por tarea. MiMo consigue su 46 por unos 0,13 $.
Esa relación precio-inteligencia es todo el argumento de venta, y por eso este lanzamiento ha sacudido tantos ánimos. Como dijo un comentarista en el hilo de lanzamiento, el modelo "aterrizó en el cuadrante más verde de inteligencia frente a velocidad de AA" mientras mantenía el precio idéntico a la generación anterior. Cuando puedes obtener entre el 85 y el 90% de la inteligencia de vanguardia por una cuarentava parte del coste, las cuentas cambian para muchos casos de uso.
Cómo ejecutarlo de verdad: pesos, API y precio
Esta es la parte que más me importa, porque una puntuación de benchmark es inútil si no puedes meter el modelo en tu pila. MiMo V2.6 es refrescantemente fácil de acceder, ya sea que quieras alojarlo tú mismo o simplemente llamar a un endpoint.
Los pesos están abiertos bajo licencia MIT, que es tan permisiva como puede serlo (uso comercial permitido, casi sin condiciones). Puedes descargar Pro, Flash y el destilado de 9B desde Hugging Face y ModelScope, y Xiaomi distribuye un checkpoint en FP8 para que no te veas obligado a usar precisión completa.
En cuanto al hardware, hay que ser realista sobre lo que necesita Pro. El propio comando de lanzamiento de la ficha del modelo ejecuta Pro en dos nodos con paralelismo tensorial de 16 vías, así que se trata de un clúster de GPU multinodo, no algo que montes en una estación de trabajo de repuesto. Flash es mucho más accesible, con un único nodo de 8 GPU, y el destilado de 9B funciona en una sola GPU, con cuantizaciones GGUF de la comunidad ya disponibles para llama.cpp, LM Studio y Ollama. Si has seguido nuestros artículos sobre modelos de IA personalizados, nada de esto te sorprenderá: los pesos abiertos son gratis, pero la factura de servirlos es real.
Si prefieres saltarte la infraestructura por completo, MiMo V2.6 está alojado en la plataforma API propia de Xiaomi, en MiMo Studio y Desktop, y en OpenRouter. Aquí están los precios de OpenRouter, por millón de tokens, verificados en la semana del lanzamiento:
| Modelo | Entrada / 1M | Salida / 1M | Contexto |
|---|---|---|---|
| MiMo V2.6 Flash | 0,14 $ | 0,28 $ | 1M |
| MiMo V2.6 Pro | 0,435 $ | 0,87 $ | 1M |
| MiMo V2.6 Pro UltraSpeed | 4,35 $ | 8,70 $ | 1M |
Dos cosas destacan. Flash, a 0,14 $ de entrada / 0,28 $ de salida, es barato para un modelo omnimodal con contexto de 1M. Y UltraSpeed es exactamente 10 veces más caro y más rápido que Pro, así que es una prima deliberada para el trabajo sensible a la latencia, no un modelo mejor. Para la mayoría de los equipos, Flash es la opción por defecto sensata y Pro es a lo que se escala cuando una tarea realmente lo necesita.
Lo que dijo la gente tras probarlo
Los benchmarks son la historia de Xiaomi. Yo quería la historia de los usuarios, así que leí la discusión del lanzamiento, y la reacción dominante no trataba en absoluto sobre las puntuaciones. Trataba sobre lo abiertamente que Xiaomi entrenó el modelo.
"I really like how transparent they've been about the training of this model. The realtime dashboard they shared during training was an incredible learning and teaching tool for me, and they've been unusually comprehensive in sharing details about their methodology... and benchmark scores (even the stuff they didn't do well on)."

"The best thing they did is being open about all the setbacks they had to deal with. They logged every restart with a reason, talked about dropping a cyber dataset after it degraded coding benchmarks. Also published real time training loss, benchmark scores after every checkpoint and running cost estimates."
Ese detalle sobre descartar un conjunto de datos de ciberseguridad porque perjudicaba las puntuaciones de codificación es el tipo de cosa que los laboratorios casi nunca admiten públicamente, y es una gran parte de por qué el lanzamiento ganó buena voluntad incluso entre los escépticos. La lectura técnica más aguda del hilo vino de un usuario veterano de MiMo que hizo el recuento él mismo:
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! Good to see they also kept the price the same, and landed in the greenest quadrant of the intelligence vs speed of AA."
No fue todo elogios. La preocupación recurrente, la que sigue a cada modelo abierto potente que sale de China, es el "benchmaxxing": puntuaciones geniales, trabajo real decepcionante. Un comentarista fue tajante sobre la generación anterior:
"No chinese lab has caught up yet. They've tried to fake it by distilling and overfitting on benchmarks to make their models look better than they are, the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them."
El contrapeso vino de gente que ya usaba la línea en producción. La opinión de un ingeniero de software sobre las cuentas de valor es la que sigo teniendo en mente:
"I been using MiMo-V2.5 to do most of my work as software engineer... I been VERY happy with ROI. The model is very powerful!... The cost is unbelievably low, and the quality of intelligence I get is equivalent to when I was working mostly with Anthropic models (late last year/early this year)... but when I add cost of M-token in the ROI math, Jeez! MiMo is an order of magnitude better."
Vale la pena señalar que esa última cita es sobre V2.5, al que varias personas también llamaron "rápido pero tonto" para tareas más difíciles, así que la verdadera prueba de V2.6 es si cierra esa brecha en el uso diario, no solo en las gráficas. En X, el lanzamiento se leyó sobre todo como un golpe contra Grok 4.7, que salió el mismo día, con reacciones que iban desde "Mejor que Grok 4.7" hasta un más moderado "esperemos primero a ver el rendimiento en pruebas reales."
Dónde encaja MiMo V2.6 en la carrera de los modelos abiertos
Si damos un paso atrás, MiMo V2.6 es un dato más en una tendencia cada vez más difícil de ignorar: los modelos de pesos abiertos de laboratorios chinos siguen aterrizando cerca de la vanguardia mientras funcionan en hardware mucho más barato. DeepSeek V4.1 Flash, GLM 5.3, Qwen 3.8 Max y ahora MiMo V2.6 se están disputando golpes en la misma franja de inteligencia que antes pertenecía solo a los modelos cerrados.
Hay un empuje estratégico real detrás de los benchmarks, y un comentarista lo expresó bien:
"Chinese models are increasingly closer to the frontier, while being able to run on much cheaper hardware than what US frontier models run on... the rest of the world is going to see the risks and the availability of good enough open weight models for their purposes and be more likely to lean in favor of self-hosted Chinese models or local inference clouds."
Esa es la verdadera historia competitiva: no "si MiMo supera a Opus en una tabla", sino "si puedes conseguir inteligencia suficientemente buena, en tu propio hardware, a un precio que hace que la vanguardia cerrada parezca un lujo". Para muchos equipos la respuesta ahora es sí. Si quieres un repaso más amplio de lo que hay disponible, nuestro resumen de los mejores agentes de IA de código abierto es una buena siguiente lectura, y nuestra reseña de DeepSeek y nuestra reseña de Kimi K3 cubren a sus rivales abiertos más cercanos.
Qué significa esto si estás poniendo IA en una cola de soporte
Aquí es donde tengo que ser honesto sobre mi propio sesgo, porque he pasado los últimos años ayudando a poner IA en colas de soporte reales, y el lanzamiento de MiMo V2.6 confirma algo que aprendimos por las malas: el modelo ya no es el cuello de botella.
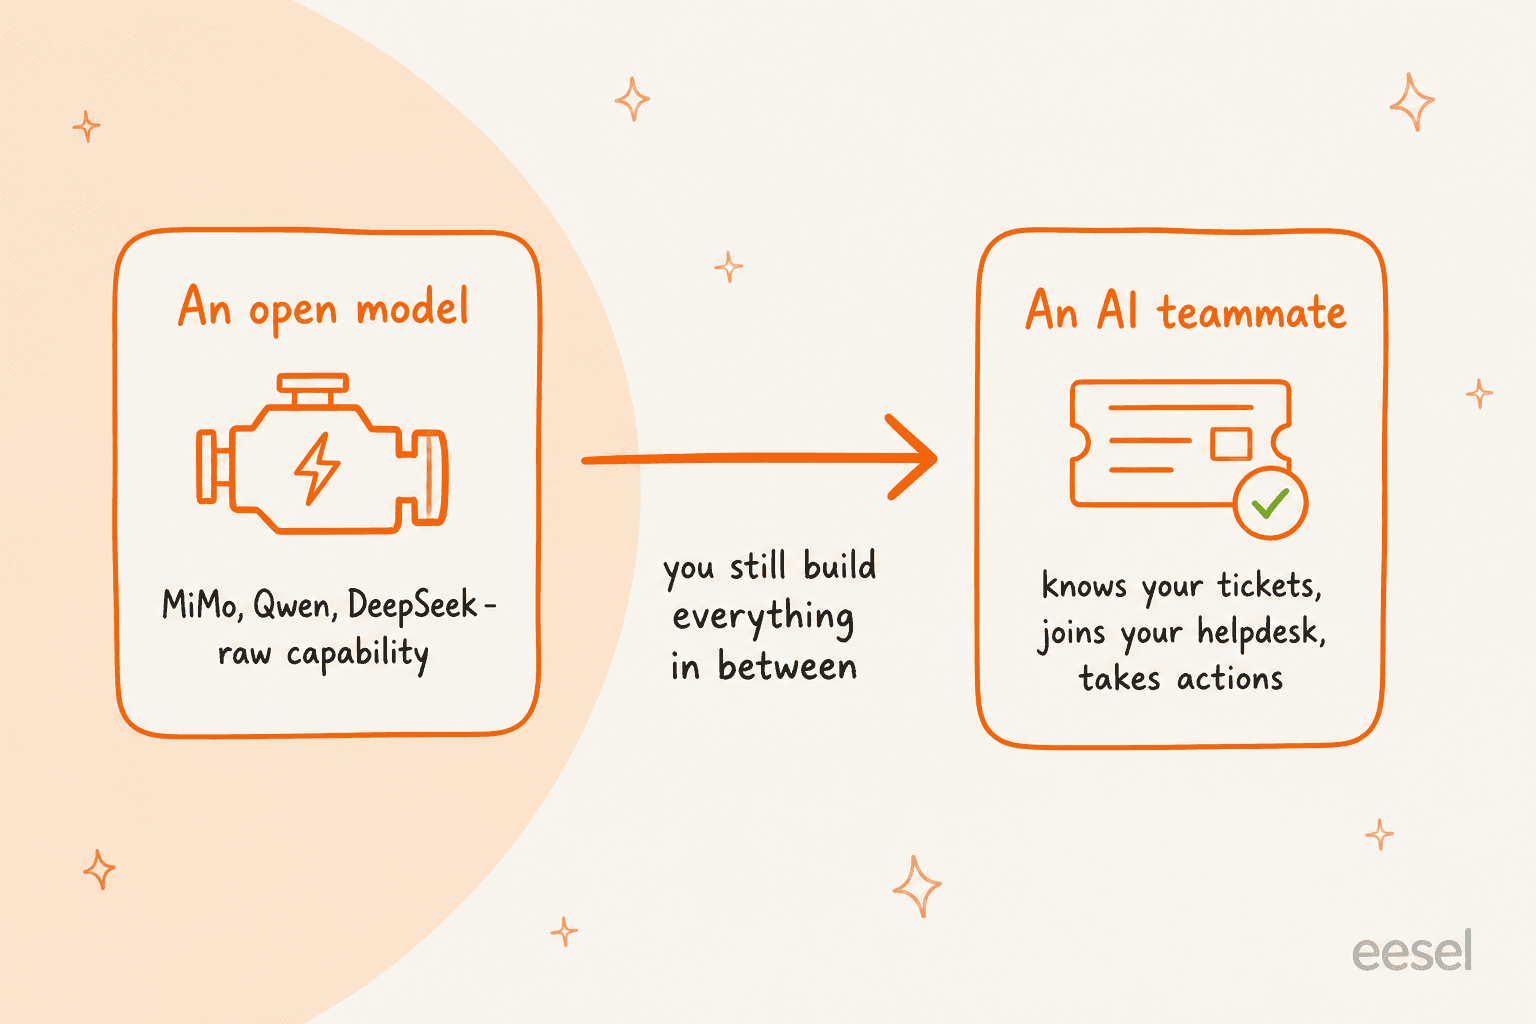
MiMo V2.6, DeepSeek, Qwen, Claude, GPT: cualquiera de ellos puede escribir una respuesta fluida y de sonido correcto a una pregunta de un cliente. Eso era lo aterrador hace un par de años. Ahora está resuelto. Lo que ninguno de ellos hace de fábrica es el trabajo real: leer tu centro de ayuda concreto y tus tickets pasados, seguir tu política de reembolsos en lugar de una inventada que suene plausible, consultar un pedido, etiquetar y enrutar el ticket, saber cuándo escalar a un humano y, lo más importante, ser probado antes de responder a un cliente real.
Ese último punto es en el que no cedería. Hemos visto modelos que suenan seguros de sí mismos dar respuestas equivocadas en colas reales, que es exactamente por lo que cada despliegue que hacemos se simula primero contra tickets históricos, para que veas cómo habría manejado miles de tus propias conversaciones pasadas antes de que toque una en vivo. Una puntuación de benchmark de 46 en el índice AA no te dice nada sobre cómo un modelo manejará tu extraña política de devoluciones para casos límite. Una simulación sobre tus últimos 5.000 tickets, sí.
Así que si te entusiasma MiMo V2.6 (y deberías, es un motor estupendo), la pregunta correcta no es "qué modelo" sino "qué envuelve al modelo". El modelo ya es una mercancía. El sistema que lo rodea es el producto.
Prueba eesel
Todo el sentido de este artículo es que un modelo abierto como MiMo V2.6 es infraestructura, capacidad en bruto que todavía tienes que convertir en algo que haga un trabajo. eesel es la capa que convierte un modelo en un compañero de equipo funcional. Contratas un agente de IA para el helpdesk listo para trabajar que se conecta al helpdesk que ya usas (Zendesk, Freshdesk, Gorgias, Help Scout, y más de 1000 integraciones), entrena con tus tickets pasados y tu centro de ayuda, y empieza a redactar o enviar respuestas, sin necesidad de gestionar el modelo.

El diferenciador es lo que los propios benchmarks de MiMo no pueden darte: antes de que un agente de eesel responda a un solo cliente real, lo simulas sobre tu historial real de tickets y ves la tasa de resolución exacta y las respuestas que habrías obtenido. Y como eesel es una plataforma de compañeros de equipo, la misma cuenta también ejecuta un redactor de blog con IA, así que si te ha gustado lo que MiMo hace por la ingeniería, el lado de la escritura también tiene compañero de equipo. Para desarrolladores, eesel expone al mismo compañero de equipo a través de una CLI, API y MCP públicas, de modo que una persona, un script o un agente de codificación pueden manejarlo desde la terminal.
Puedes empezar gratis, sin tarjeta de crédito y sin llamada de ventas, y tener un compañero de equipo en marcha en minutos. El modelo se volvió barato. Conseguir que de verdad haga el trabajo sigue siendo la parte interesante.
Preguntas frecuentes
¿Qué es Xiaomi MiMo V2.6?
¿Cuánto cuesta Xiaomi MiMo V2.6?
¿Es Xiaomi MiMo V2.6 mejor que DeepSeek o Kimi K3?
¿Puedo alojar Xiaomi MiMo V2.6 yo mismo?
¿Debería usar Xiaomi MiMo V2.6 para atención al cliente?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.