Las 8 mejores alternativas a Xiaomi MiMo V2.6 en 2026

Rama Adi Nugraha

Katelin Teen
Última edición September 23, 2026
Por qué buscar una alternativa a MiMo V2.6
Déjame ser justo con MiMo primero, porque se ha ganado la atención. El modelo Pro de 1T de parámetros supera al modelo de 2,8T de parámetros Kimi K3 en 14 de los 15 benchmarks que un comentarista contó a mano, con una fracción del tamaño, y Xiaomi mantuvo el precio igual que en V2.5. Tiene licencia MIT, es nativamente omnimodal y viene con un contexto de 1M de tokens. La reacción de la comunidad fue inusualmente cálida, y sobre todo por la transparencia más que por las puntuaciones.
Entonces, ¿por qué comparar? Algunas razones honestas:
- La ventaja en benchmarks es más estrecha justo donde más importa. En Terminal Bench 4.0, MiMo-V2.6-Pro puntúa 34,9, muy por debajo del 59,6 de GPT-6 Astra y el 49,0 de Claude Opus 5. En las tablas de código real más difíciles, MiMo lidera el campo abierto de forma barata pero se queda por detrás de los modelos halo. Si tu trabajo vive en esas tareas, el gasto extra en un modelo de frontera puede valer la pena.
- La residencia de datos es una restricción real. La API hospedada de MiMo funciona bajo la ley de la RPC, y autoalojar el checkpoint Pro necesita una caja de 2 nodos y 16 GPU. Para datos regulados o de clientes, eso es un bloqueo genuino, no un detalle menor.
- Escepticismo sobre el "benchmaxxing". Una preocupación recurrente en la comunidad es que las ventajas en los índices no sobreviven al contacto con código de producción. Como dijo un comentarista de Hacker News, sin rodeos:
"No chinese lab has caught up yet... the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them."

Esa es una opinión, y lo contrario también está bien argumentado (muchos ingenieros reportan que los modelos chinos baratos más un modelo de frontera supervisor superan a los modelos caros de EE.UU. en ROI). Pero el desacuerdo en sí mismo es la razón para conocer tus alternativas.
Cómo elegí estas alternativas
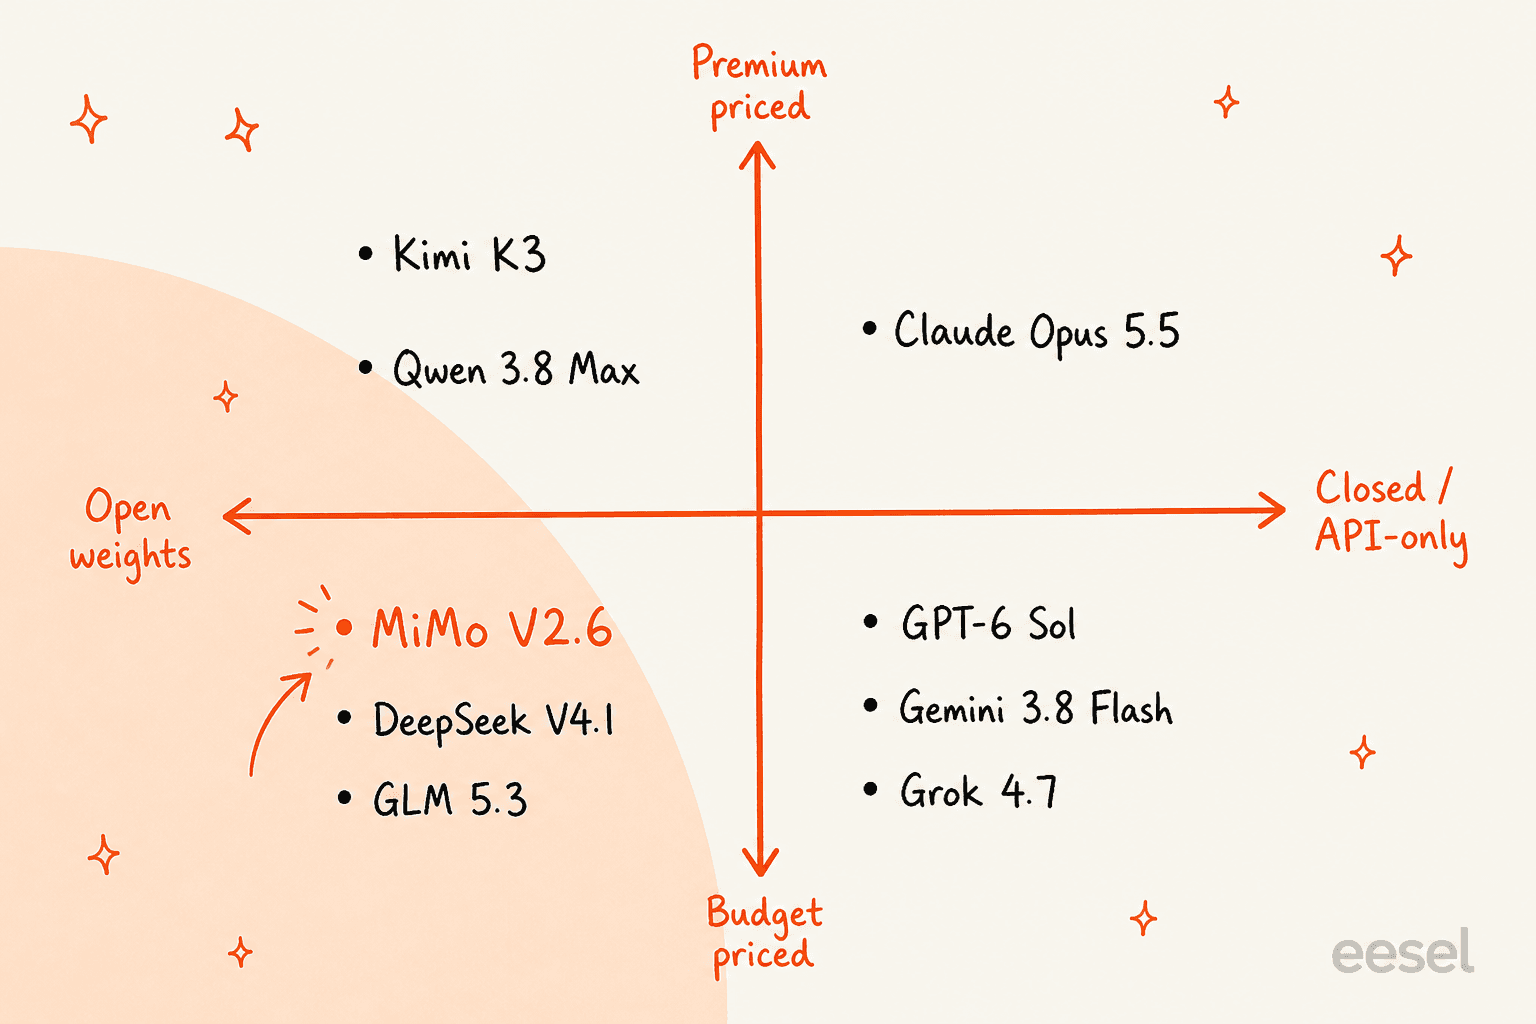
Mantuve la lista corta a modelos que realmente están disponibles y que un equipo real consideraría junto a MiMo V2.6. Eso significó tres filtros: actuales (todos lanzados o repreciados en los últimos meses de 2026), comparables (aparecen en las mismas tablas de benchmarks contra las que se mide MiMo) y distintos (cada uno gana en un eje diferente, para que la lista no sean ocho versiones de la misma compensación).
Me apoyé en fuentes primarias para cada cifra: las propias fichas de modelo y páginas de precios de los proveedores, los listados de OpenRouter, y el índice de Artificial Analysis para una lectura neutral de inteligencia frente a costo. Cuando la comunidad tenía un punto agudo y verificable, lo cité con un enlace permanente. Los precios de abajo son por 1M de tokens salvo que se indique lo contrario.
Alternativas a MiMo V2.6 de un vistazo
| Modelo | Tipo | Parámetros | Contexto | Precio /1M (entrada / salida) | AA Intelligence | Mejor para |
|---|---|---|---|---|---|---|
| MiMo V2.6 Pro | Abierto (MIT) | 1.02T / 42B activos | 1M | $0.435 / $0.87 | 46 | El mejor modelo abierto más barato |
| DeepSeek V4.1 | Abierto (MIT) | 552B MoE | 1M | $0.15 / $0.60 (fuera de hora punta) | nivel workhorse | Caballo de batalla barato que usa herramientas |
| Kimi K3 | Abierto | 2.8T / 104B activos | 1M | $3 / $15 | 57 | El modelo abierto más grande |
| Qwen 3.8 Max | Abierto (hospedado) | 2.4T / 95B activos | 1M | $2 / $6 | 58 | Variantes pequeñas aptas para local |
| GLM 5.3 Flash | Abierto | 320B / 18B activos | 1M | $0.15 / $0.50 | 57 | Modelo abierto barato para código real |
| Claude Opus 5.5 | Cerrado | No revelado | 1M | $5 / $25 | 58 | El techo de razonamiento más alto |
| GPT-6 Sol | Cerrado | No revelado | 1.05M | $2 / $10 | 48 | El más barato por tarea completada |
| Gemini 3.8 Flash | Cerrado | No revelado | 1M | $0.75 / $3.75 | 59 | Contexto multimodal enorme |
| Grok 4.7 | Cerrado | Modelo base más grande | 500K | $2 / $6 | 46 | Bucles de agentes con volumen, datos en vivo de X |
1. DeepSeek V4.1
Mejor para: equipos que quieren el modelo abierto capaz más barato con un historial real.
DeepSeek V4.1 Flash pasó a disponibilidad general el 10-09-2026, y DeepSeek retiró el V4 Pro más antiguo fusionándolo en él, enrutando esas solicitudes a V4.1 Flash a las tarifas de Flash. Es el modelo abierto chino de referencia, y MiMo se enmarca repetidamente como el respaldo más barato de él, en lugar de al revés. La arquitectura es genuinamente novedosa: un codificador-decodificador causal de 552B de parámetros que usa 8B de parámetros activos para la entrada y 16B para la salida, con una caché KV unas 4x más pequeña que la generación anterior. Los pesos tienen licencia MIT con visión nativa incorporada.
En la propia tabla de DeepSeek, V4.1 lidera en Terminal-Bench 2.1 (90,6), DeepSWE (74,2) y HLE-con-herramientas (63,9, justo por encima de Opus 5). Los benchmarks de la comunidad lo miden entre 250-400 tokens por segundo, desbancando a Gemini Flash como la opción más rápida que muchos habían probado.
Pros:
- El modelo abierto serio más barato: la entrada fuera de hora punta con fallo de caché cuesta 0,15 $, la salida 0,60 $ por 1M, y el horario fuera de pico cubre la mayor parte del horario laboral de EE.UU. y la UE.
- Pesos MIT, visión multimodal nativa, contexto de 1M.
- Un caballo de batalla probado y ampliamente desplegado, no un lanzamiento de la primera semana.
Contras:
- El razonamiento en bruto es el punto débil: un HLE de 36,8 queda por debajo de GPT-6 Sol y Opus 5. Es un usuario de herramientas, no un campeón del razonamiento.
- Las tarifas de hora punta (01:00-04:00 y 06:00-10:00 UTC) duplican el precio, así que el costo es un objetivo móvil.
- Los términos de la API de pago guardan silencio, no permiso explícito, sobre el uso para entrenamiento, y los datos se procesan en la RPC, así que piénsalo dos veces antes de enviar datos de clientes a través de ella.
Veredicto: si el precio de MiMo fue lo que te atrajo, DeepSeek V4.1 es el cambio más directo, y posiblemente la apuesta más segura en madurez. Elígelo cuando quieras un motor barato para trabajo intensivo en herramientas y puedas vivir con la salvedad de la residencia de datos.
2. Kimi K3
Mejor para: equipos que quieren el modelo abierto más grande del mercado y están dispuestos a pagar por el techo.
Kimi K3 de Moonshot se lanzó el 16-07-2026 como un modelo de 2,8T de parámetros con 104B activos, y Moonshot publicó los pesos abiertos a tiempo, algo que no todos los laboratorios hacen. Puntúa 57 en el índice de Artificial Analysis, un buen cuarto puesto en general, y es el modelo con el que más se compara a MiMo para ilustrar el argumento tamaño-versus-rendimiento.
El problema es que K3 es donde muerde la lección de "más grande no es más barato". Su API cuesta 3 $ de entrada y 15 $ de salida por 1M, la misma banda que un modelo cerrado de gama media, y el razonamiento no se puede desactivar a ningún nivel. Ese recuento de GodelNumbering vale la pena citarlo porque captura exactamente esa tensión:
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!!"
Pros:
- Pesos abiertos, contexto de 1M, visión nativa, inteligencia general fuerte (índice AA 57).
- Genuinamente capaz en razonamiento difícil, donde MiMo es más flojo.
Contras:
- Aproximadamente 50 veces el precio de salida de MiMo, a 15 $ por 1M, y más o menos igual que el precio de nivel Claude Sonnet.
- El razonamiento siempre está activo, así que es un costo de latencia que no puedes bajar.
- 1.561 GB de pesos convierten el autoalojamiento en un proyecto de hardware serio.
Veredicto: K3 es el modelo abierto al que recurres cuando quieres la máxima capacidad y el tamaño no te asusta, pero en precio puro por inteligencia, tanto MiMo como DeepSeek lo superan. Elige K3 cuando el techo importe más que la factura.
3. Qwen 3.8 Max
Mejor para: equipos que quieren una familia abierta con variantes pequeñas genuinamente aptas para uso local.
Qwen 3.8 Max de Alibaba pasó a disponibilidad general el 02-08-2026, un MoE de 2,4T / 95B activos con un contexto de 1M. En el tablero de Artificial Analysis ocupa el puesto 6 con un índice de 58, y también es fuerte en LMArena (Texto #5, Visión #2). El precio de la API es de 2 $ de entrada y 6 $ de salida por 1M a través de Qwen Cloud.
La razón por la que Qwen sigue apareciendo como alternativa a MiMo es la familia, no solo el buque insignia. El favorito de la comunidad para inferencia local son los modelos Qwen más pequeños, que un comentarista calificó de "crazy good for how small it is" y que se pueden ejecutar indefinidamente en una máquina de clase workstation. Los pesos Max hospedados se lanzaron, pero bajo una licencia no Apache; la opción permisiva y verdaderamente local es el Qwen3.8-27B más pequeño (Apache 2.0).
Pros:
- Inteligencia general fuerte (AA 58) y excelentes puntuaciones de preferencia humana.
- Una escala real de tamaños, incluyendo un modelo pequeño con licencia permisiva para ejecuciones locales.
- Precios hospedados razonables de 2 $ / 6 $.
Contras:
- El Max hospedado y la base abierta no son equivalentes en funciones (la visión, el modo sin pensamiento y el contexto de 1M por defecto son solo hospedados).
- Su propio entorno de codificación limita la salida a 65K tokens, así que nunca pide el techo completo de 131K de fábrica.
- Las puntuaciones compuestas automatizadas y la preferencia humana apuntan en direcciones diferentes, así que no confíes en un solo número como veredicto.
Veredicto: Qwen 3.8 Max es la elección cuando quieres una familia abierta en la que crecer, desde un modelo pequeño apto para portátil hasta un buque insignia casi de frontera. Si "local" es un requisito estricto, Qwen te da el camino más limpio de todos los modelos aquí.
4. GLM 5.3 Flash
Mejor para: equipos que quieren el modelo abierto más barato que aguanta bien en código real.
GLM 5.3 Flash de Z.ai se lanzó el 26-08-2026 como el primer modelo GLM-5 nativamente multimodal, un MoE de 320B / 18B activos con contexto de 1M y pesos abiertos. Puntúa un índice de Artificial Analysis de 57 a aproximadamente 0,045 $ por tarea, lo que lo coloca justo en el nivel de presupuesto de MiMo. El precio de la API es de 0,15 $ de entrada y 0,50 $ de salida por 1M (la promoción de lanzamiento de 0,075 $ / 0,25 $ ya terminó).
GLM es el modelo abierto que la gente nombra específicamente cuando la conversación gira hacia el código real en lugar de los benchmarks. En ese mismo hilo escéptico de Hacker News, el contraargumento fue que GLM más un modelo de frontera supervisor ya supera a los modelos caros de EE.UU. en la práctica:
"I mean DSv4.1 Flash and GLM 5.3 kept in check by a supervising frontier like Astra or Fable already in my experience clowns massively on ever using Opus or Sonnet."
Pros:
- Muy barato (0,15 $ / 0,50 $) con un índice AA fuerte (57), pesos abiertos, contexto de 1M.
- Una reputación real de aguantar bien en tareas de codificación de producción.
- Un buque insignia separado solo de texto (GLM-5.3 a 1,40 $ / 4,40 $) para codificación más pesada y trabajo de ciberseguridad.
Contras:
- La API propia es lenta (~49 tokens por segundo); necesitas un host de terceros como Databricks para un rendimiento real.
- El pensamiento no se puede desactivar.
- Como con los demás modelos abiertos chinos, aplican las mismas preguntas sobre residencia de datos y uso para entrenamiento.
Veredicto: GLM 5.3 Flash es la elección de valor-más-código. Si DeepSeek es el generalista barato y Kimi es el grande, GLM es el que hay que probar cuando tu carga de trabajo es sobre todo código y la factura aún tiene que ser diminuta.
5. Claude Opus 5.5
Mejor para: equipos que necesitan el techo de razonamiento más alto en el trabajo agéntico más difícil.
Si el punto débil de MiMo es la parte alta de la curva de dificultad, Claude Opus 5.5 es el modelo que la domina. El buque insignia de Anthropic ocupa el puesto #1 del Intelligence Index de Artificial Analysis (58) y supera cómodamente a MiMo en Terminal Bench 4.0 y en las tablas de agentes de codificación más difíciles. Cuesta 5 $ de entrada y 25 $ de salida por 1M con un contexto plano de 1M (sin recargo por contexto largo), y las lecturas de caché cuestan una décima parte de eso.
El contrapeso honesto es el costo por tarea. Opus gasta muchos tokens de salida: en el índice de Artificial Analysis ronda los 5,98 $ por tarea a esfuerzo máximo, frente a los 0,13 $ de MiMo. Pagas precios de frontera por un techo de frontera.
Pros:
- Puntuaciones de razonamiento y agénticas máximas; el techo que MiMo no alcanza en las tablas más difíciles.
- Precios de contexto plano de 1M, herramientas maduras y una postura clara de manejo de datos para trabajo regulado.
Contras:
- Caro por token, y aún más por tarea completada porque es verboso a esfuerzo alto.
- Tiempo lento hasta el primer token a esfuerzo máximo, lo que perjudica a cualquier cosa que una persona espere.
- Pesos cerrados, así que el autoalojamiento y la inferencia local real quedan fuera de la mesa.
Veredicto: Opus 5.5 es el anti-MiMo: no la apuesta de valor, sino la apuesta de capacidad. Recurre a él cuando la tarea realmente necesite el mejor razonamiento disponible y el presupuesto pueda absorberlo, y combínalo con un modelo más barato para el 80 % rutinario.
6. GPT-6 Sol
Mejor para: equipos que quieren un modelo de frontera hospedado al menor costo por tarea completada.
GPT-6 Sol de OpenAI se lanzó el 22-09-2026, el mismo día que MiMo, y toda su historia gira en torno al valor. Se fijó en 2 $ de entrada y 10 $ de salida por 1M, un recorte plano del 50 % frente a GPT-5.6 Sol, con un contexto de 1,05M. Su Intelligence Index de Artificial Analysis (48) está a la par de la generación anterior, así que esto es un recorte de precio disfrazado de salto de versión, no un salto de capacidad, pero eso es exactamente lo que lo convierte en una fuerte alternativa a MiMo para trabajo hospedado.
El número que importa es el costo por tarea, donde Sol es inusualmente eficiente porque usa muchos menos tokens de salida que Opus. En el índice de Artificial Analysis ronda 1,06 $ por tarea a esfuerzo máximo frente a los 5,98 $ de Opus 5.5, aproximadamente 5,6 veces más barato para un modelo apenas un escalón por debajo en inteligencia. La factualidad también mejoró, con la alucinación a esfuerzo máximo cayendo del 92 % al 60 %.
Pros:
- Barato para un modelo de frontera hospedado: 2 $ / 10 $, y dramáticamente más barato por tarea completada que Opus.
- Contexto enorme de 1,05M, conjunto completo de herramientas Responses, y una gran mejora de factualidad frente a 5.6.
- La fiabilidad y postura de datos de un laboratorio de frontera de EE.UU.
Contras:
- La inteligencia se mantiene plana frente a la generación anterior, así que si necesitabas un salto real, no lo encontrarás aquí.
- Pesos cerrados y sin nivel gratuito específico para Sol.
- Las solicitudes de contexto largo se facturan a un nivel más alto (4 $ / 15 $), el mismo precipicio de estilo 200K que cobran tanto OpenAI como xAI.
Veredicto: GPT-6 Sol es lo más cercano a "la economía de MiMo con la fiabilidad de un laboratorio de frontera". Si quieres un modelo hospedado, te importa la factura total y no necesitas el razonamiento de nivel Opus, Sol es la opción de valor por defecto.
7. Gemini 3.8 Flash
Mejor para: equipos que quieren un contexto multimodal masivo de un laboratorio de frontera, de forma barata.
Gemini 3.8 Flash de Google salió el 02-09-2026, su tercer lanzamiento Flash en seis semanas. No es un modelo base nuevo (la ficha dice cuatro veces que se basa en 3.7 Flash), por eso el precio no se movió: 0,75 $ de entrada y 3,75 $ de salida por 1M hasta finales de 2026, luego 1,50 $ / 7,50 $ desde enero. Tiene un Intelligence Index de Artificial Analysis de primer nivel de 59 y acepta texto, imagen, audio, video y PDF.
El problema poco reportado es la capacidad de respuesta. Artificial Analysis mide un tiempo hasta el primer token de 13,30 segundos frente a una mediana de clase de 2,99 segundos, aunque se clasifica #3 de 196 en velocidad de salida bruta. El rendimiento no es lo mismo que la latencia, lo que lo descalifica para cualquier cosa que una persona espere en vivo, pero está bien para un agente por lotes durante la noche. Curiosamente, el propio Google recomienda a los desarrolladores centrados en la eficiencia que se queden con 3.7 Flash.
Pros:
- Índice de inteligencia máximo (59) a un precio genuinamente barato para un modelo de frontera.
- El input multimodal nativo más amplio de cualquier modelo aquí, con contexto de 1M.
- Un nivel gratuito y generosos descuentos por lotes y flex.
Contras:
- Lento hasta el primer token, así que es una mala opción para chat en vivo o respuestas de soporte.
- Verboso (unos 120M de tokens de salida para ejecutar el índice frente a una mediana de 71M), lo que infla la factura real.
- El propio consejo de Google es que 3.7 Flash es la opción de eficiencia, lo que enturbia el argumento de actualizar.
Veredicto: Gemini 3.8 Flash es el caballo de batalla multimodal por lotes. Si tu caso de uso de MiMo es intensivo en documentos, imágenes o video y funciona de forma asíncrona, esta es la alternativa de frontera a batir. Si una persona está esperando la salida, busca en otro lado.
8. Grok 4.7
Mejor para: equipos que ejecutan bucles de agentes de alto volumen y quieren datos en vivo de X y calidad casi de frontera.
Grok 4.7 de xAI se lanzó el 21-09-2026, construido sobre un modelo base más grande y entrenado para tareas agénticas de varias horas. Es el espejo interesante de MiMo en el índice de Artificial Analysis: ambos aterrizan en 46, y la coincidencia de fecha de lanzamiento es la razón por la que "MiMo mogged Grok" se hizo viral. El precio es de 2 $ de entrada y 6 $ de salida por 1M por debajo de 200K tokens de prompt, y 4 $ / 12 $ por encima, donde las tarifas largas aplican a toda la solicitud.
La verdadera ventaja de Grok sobre los modelos abiertos aquí es su herramientas nativas: búsqueda en vivo en la web y en X, ejecución de código, y un diseño ajustado para ejecuciones largas de agentes, además de la pila de seguridad más fuerte que xAI ha lanzado. Es casi de frontera en lugar de líder de frontera (Fable sigue liderando en codificación punta y trabajo de terminal), pero tiene un precio pensado para funcionar de verdad a volumen.
Pros:
- La misma inteligencia AA que MiMo (46) pero con las herramientas hospedadas de un laboratorio de frontera y búsqueda en vivo en X y web.
- Con precio pensado para volumen en bucles de agentes a 2 $ / 6 $, con una pila de seguridad y rechazo nueva y fuerte.
- Grandes mejoras en terminal y codificación frente a Grok 4.6.
Contras:
- El contexto de 500K es el más pequeño del grupo, y el precipicio de precio por encima de 200K aplica a todos los tokens de una solicitud.
- Pierde ante GPT-6 Sol y Fable en algunos benchmarks profesionales como HealthBench.
- Pesos cerrados, y sin prueba con historial de tickets para pruebas de estilo soporte.
Veredicto: Grok 4.7 es la elección "casi de frontera a volumen", especialmente si los datos en vivo de X o web forman parte del trabajo. Si te atrajo el precio de MiMo pero quieres herramientas hospedadas y puedes vivir con el contexto más pequeño, es un intercambio justo.
Lo que todos estos benchmarks se pierden
Esto es lo que tres años poniendo IA en colas de soporte en vivo nos enseñaron: el modelo es lo de menos. Cada opción de arriba es un motor, y un buen motor no es un coche terminado. Por sí solo, un modelo en bruto no conoce tu producto, no puede ver tu helpdesk, no puede realizar una acción y no se puede probar de forma segura contra tu historial real antes de hablar con un cliente.
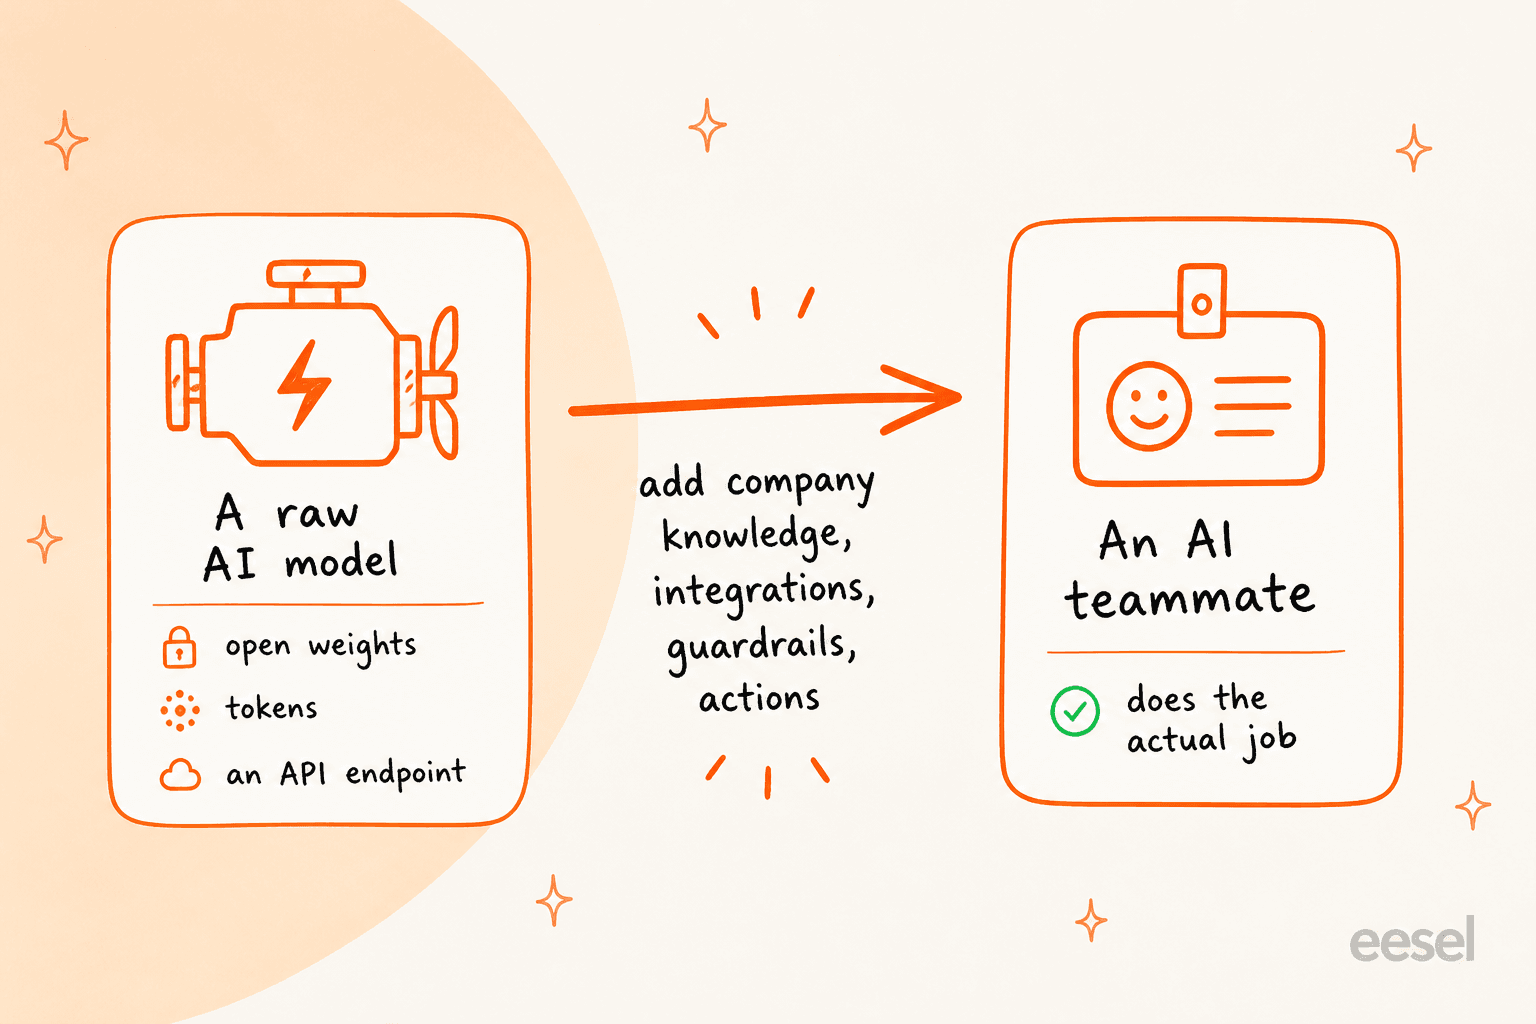
Lo aprendimos por las malas, viendo a un bot que sonaba convincente dar respuestas incorrectas en silencio, por lo que ahora simulamos cada despliegue contra tickets históricos antes de ponerlo en producción. Esa brecha entre "un modelo inteligente" y "un compañero que hace el trabajo" es exactamente lo que los benchmarks no miden, y es donde vive la mayor parte del trabajo real: conectar el conocimiento, cablear las integraciones, establecer las barreras de seguridad y demostrar que funciona con tus propios datos primero.
Así que la pregunta más útil a menudo no es "¿qué modelo?" sino "¿quién va a hacer el trabajo?". Si la respuesta es tu equipo de ingeniería, envolviendo un modelo en todo eso, entonces elige entre los ocho de arriba según precio, techo y licencia. Si la respuesta es "solo quiero el resultado", el modelo se convierte en un detalle de implementación.
Prueba eesel
eesel trabaja en el otro extremo de esta decisión. En lugar de darte un motor y un proyecto de construcción, te da un compañero de IA listo para trabajar en tu helpdesk que ya conoce tus integraciones y el contexto de tu empresa, y deja que el modelo de debajo se mantenga intercambiable. Ese es todo el sentido de la visión de "el modelo es infraestructura": contratas al compañero, no al motor.
En concreto, el compañero de IA del helpdesk se une a tu cola existente en minutos, aprende de tus tickets pasados y de tu centro de ayuda, y, de forma crucial, simula contra tu historial real de tickets antes de responder a un cliente en vivo por primera vez, así que ves la resolución y calidad proyectadas de antemano en lugar de pulsar un interruptor y esperar. Y como eesel está construido para manejarse de forma programática, también hay un eesel CLI completo: puedes operar al mismo compañero y espacio de trabajo desde una terminal, automatizarlo en scripts, o dejar que un agente de codificación como Claude Code o Cursor lo maneje, lo cual encaja de forma natural si ya estabas buscando un modelo en bruto para hacer scripts en primer lugar.
Si estás sopesando MiMo V2.6 o alguna de sus alternativas para potenciar la automatización de soporte, vale la pena echar un vistazo antes de comprometerte con una construcción. Prueba eesel gratis, y deja que el modelo sea la parte fácil.
Preguntas frecuentes
¿Cuál es la mejor alternativa a Xiaomi MiMo V2.6?
¿Hay alternativas más baratas a Xiaomi MiMo V2.6?
¿Qué alternativas a MiMo V2.6 tienen pesos abiertos?
¿Es Xiaomi MiMo V2.6 suficientemente bueno como para saltarse las alternativas?
¿Necesito elegir un modelo para automatizar el soporte?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.