La respuesta corta: lo que realmente cuesta Xiaomi MiMo V2.6
Llevo dos años observando páginas de precios de IA, y la mayoría de los lanzamientos de modelos entierran el número por el que en realidad viniste. Xiaomi hizo lo contrario: abrió el código de toda la familia MiMo V2.6 el 22 de septiembre de 2026, bajo MIT, y mantuvo los precios de la API sin cambios respecto a la generación anterior.
Así que en realidad hay dos precios en los que pensar. Está el cero, si descargas los pesos y los ejecutas en tu propio hardware. Y está el precio por token de la API, si prefieres que otro aloje las GPUs. Aquí está la lista completa de precios alojados, de OpenRouter, comprobada el día del lanzamiento:
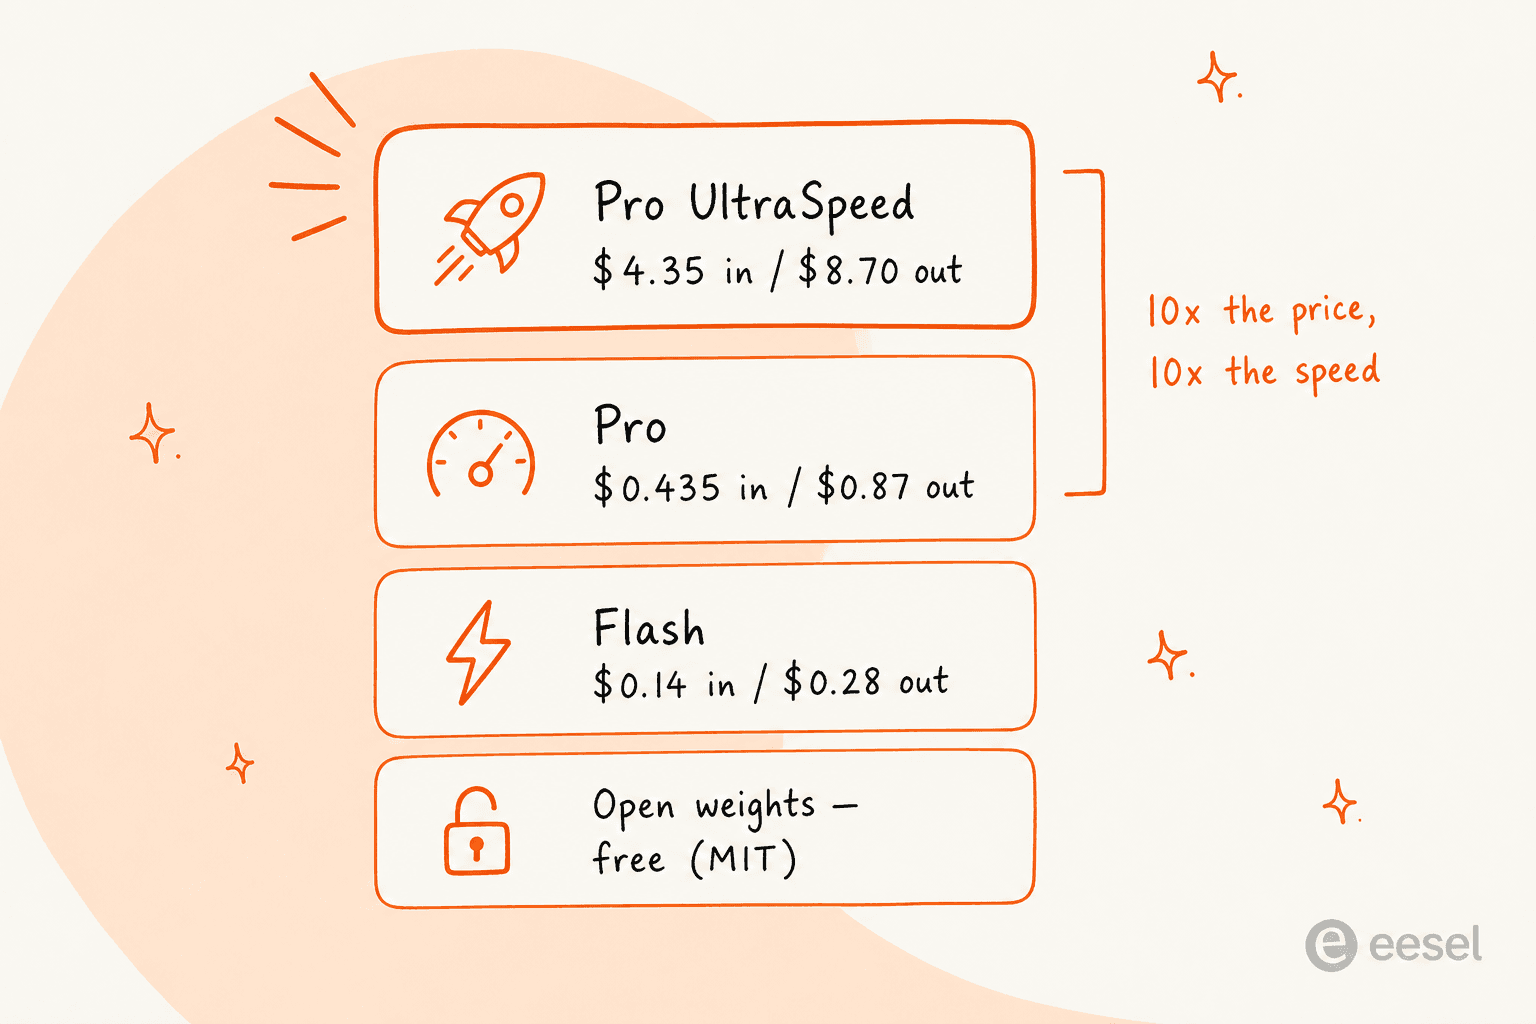
Cada variante tiene la misma ventana de contexto de 1M de tokens y es nativamente omnimodal (texto, imagen, vídeo, audio), así que no pagas un extra por el contexto largo ni por las modalidades adicionales. Eso es inusual, y es gran parte de por qué los precios se leen como agresivos.
Las cuatro variantes y para qué sirve cada una
MiMo V2.6 no es un modelo con un solo precio. Es una familia de cuatro checkpoints, y elegir el equivocado es la forma más rápida de pagar de más. Así es como se ordenan.
MiMo V2.6 Pro ($0,435 entrada / $0,87 salida)
Pro es el buque insignia: un modelo de mezcla de expertos dispersa con 1,02 billones de parámetros totales y 42B activos. Es el que lidera los benchmarks de pesos abiertos, y el que quieres para trabajo agéntico genuino, programación de largo alcance, uso de herramientas en varios pasos. A $0,435 de entrada / $0,87 de salida es más barato que la mayoría de los modelos cerrados de vanguardia con los que se mide, que es toda la historia de este lanzamiento.
MiMo V2.6 Flash ($0,14 entrada / $0,28 salida)
Flash es el checkpoint de eficiencia: 309B en total, 15B activos, descrito por Xiaomi como el mejor equilibrio entre inteligencia, eficiencia y coste. A $0,14 de entrada / $0,28 de salida cuesta un tercio de Pro y, según las propias cifras de Xiaomi, cede sorprendentemente poco. En AutomationBench obtiene 52,3 frente al 53,1 de Pro. Para la mayoría de trabajos de alto volumen y bien delimitados, Flash es la opción de mejor relación calidad-precio.
MiMo V2.6 Pro UltraSpeed ($4,35 entrada / $8,70 salida)
UltraSpeed resulta confuso hasta que te das cuenta de que no estás comprando más inteligencia. Es exactamente el mismo checkpoint de Pro, servido a aproximadamente 10 veces la velocidad de salida (unos 116 tokens por segundo). Xiaomi cobra 10 veces la tarifa de Pro por ello. Así que es un impuesto de latencia puro: págalo solo cuando la velocidad sea el verdadero cuello de botella, como un agente de chat en directo al que un cliente ve escribir. Para un trabajo por lotes que se ejecuta de noche, es 10 veces dinero desperdiciado.
MiMo V2.6 Distill-Qwen-9B (solo pesos gratuitos)
El distill de 9B es un ajuste fino supervisado denso de Qwen3.5-9B sobre datos generados por MiMo. No está en la API de pago; existe como un punto de partida pequeño, de una sola GPU, para inferencia local e investigación abierta. Ya existen cuantizaciones GGUF de la comunidad para llama.cpp, LM Studio y Ollama, así que es el que puedes ejecutar en una estación de trabajo.
El descuento por caché que casi todos pasan por alto
Los precios de lista anteriores no son lo que realmente pagan los usuarios intensivos. MiMo V2.6 Pro lista los tokens de lectura de caché a unos $0,0036 por millón, un descuento del 99% sobre la tarifa de entrada de $0,435. El socio de benchmarking de Xiaomi lo explicó así:
"Despite the improvement, it retains the same attractive pricing at $0.435 per 1M input tokens (with a 99% cache-hit discount) and $0.87 per 1M output tokens."
¿Por qué importa esto para el precio? Porque cualquier carga de trabajo real envía el mismo contexto una y otra vez. Un agente de programación vuelve a leer el mismo repositorio. Un agente de soporte vuelve a leer las mismas políticas y macros en cada ticket. Una vez que ese contexto está en caché, pagas céntimos por los tokens de entrada. Si tu caso de uso reutiliza prompts, tu precio de entrada efectivo queda muy por debajo del de lista, y esa brecha es donde el coste total de MiMo realmente se distancia de la vanguardia.
Cómo se comparan los precios de MiMo V2.6 con la vanguardia
Esta es la comparación para la que se construyó el lanzamiento. En el Índice de Inteligencia de Artificial Analysis, MiMo V2.6 Pro obtuvo 46 puntos, el mejor modelo de pesos abiertos, empatado con el lanzamiento del mismo día de Grok 4.7 y justo por detrás de los líderes cerrados.
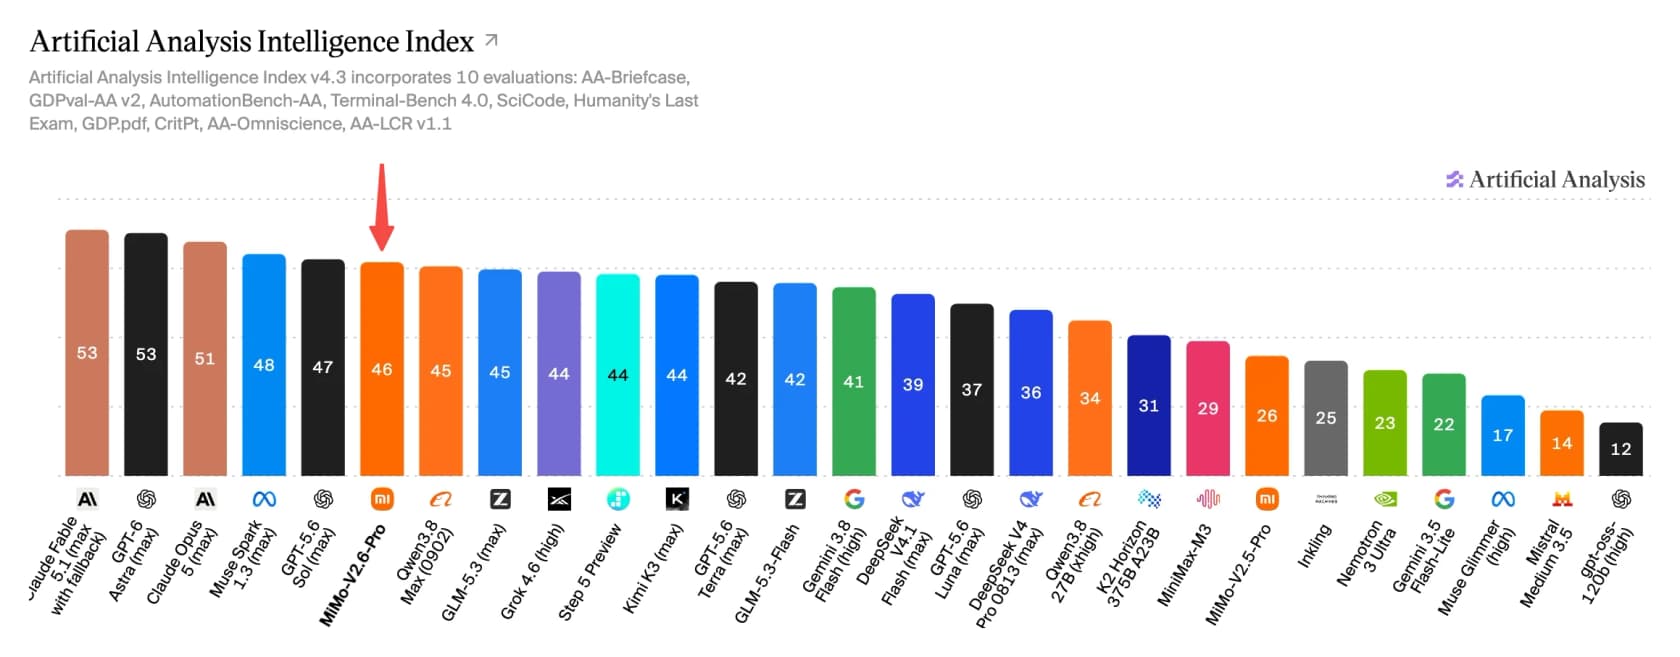
Pero el puntaje por sí solo no cuenta toda la historia del precio. El gráfico que importa para el coste es el de inteligencia frente a coste por tarea, donde MiMo V2.6 Pro cae en el "cuadrante más atractivo", en verde, a unos $0,13 por tarea, mientras que Claude Opus 5 y GPT-6 Astra se sitúan en el extremo de $3 a $8 de ese mismo eje.
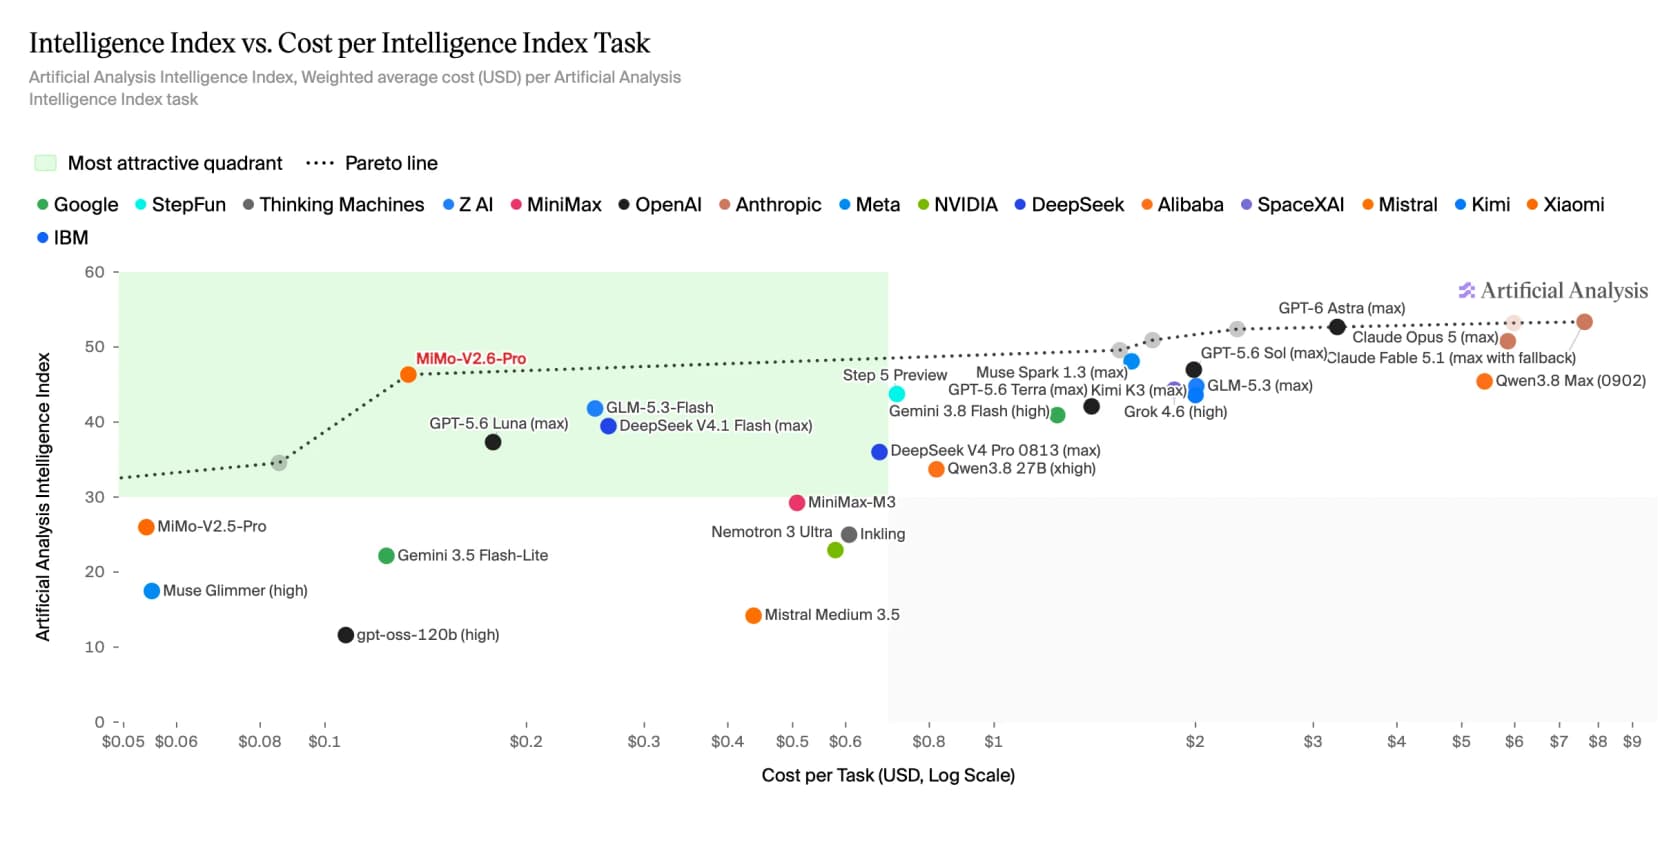
Frente al campo abierto es igual de contundente. Flash iguala a los niveles más baratos como DeepSeek V4.1 Flash, y el Pro de 1,02T supera al mucho más grande Kimi K3, de 2,8T, mientras lo lidera en la mayoría de las tablas. Un comentarista de Hacker News, que había usado el modelo intensivamente, resumió la cuenta de valor así:
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! Good to see they also kept the price the same, and landed in the greenest quadrant of the intelligence vs speed of AA."

Aviso justo, porque un artículo sobre precios debe ser honesto sobre el techo: MiMo queda por detrás de los mejores modelos cerrados en las tablas más difíciles. En Terminal Bench 4.0 obtiene 34,9 frente al 59,6 de GPT-6 Astra, y en ExploitBench se queda en 47,9 frente a más de 70 de GPT-5.6 Sol y Claude. Si tu trabajo vive en esas fronteras, el precio barato del token no es toda la decisión. Para todo lo demás, la relación precio-rendimiento es difícil de rebatir.
Ejemplos prácticos: lo que pagarías en realidad
Los precios por millón de tokens son abstractos. Aquí tienes lo que costarían tres cargas de trabajo realistas en MiMo V2.6, para que las cifras signifiquen algo.
- Un desarrollador independiente en Flash. Digamos que consumes 20M de tokens de entrada y 5M de salida al mes programando con Flash. Eso es 20 × $0,14 + 5 × $0,28 = $4,20 al mes. Un error de redondeo.
- Un equipo pequeño ejecutando un agente de programación en Pro. 300M de entrada, 80M de salida al mes en Pro: 300 × $0,435 + 80 × $0,87 = $200,10 al mes, antes de cualquier descuento por caché. Con una fuerte reutilización de prompts, la factura real queda muy por debajo.
- Una carga de trabajo de soporte de alto volumen en Flash. 10.000 tickets al mes, unos 8K de entrada y 1K de salida cada uno, así que 80M de entrada y 10M de salida: 80 × $0,14 + 10 × $0,28 = $14 al mes en tokens brutos.
Ese último número es en el que vale la pena detenerse. Diez mil conversaciones de soporte por $14 de tokens de modelo. Si ese fuera el coste real del soporte con IA, todo el mundo lo habría lanzado hace años. No lo es, y la brecha entre "$14 de tokens" y "un agente de soporte que funciona" es exactamente el tema de la siguiente sección.
Los pesos gratuitos no son gratis de ejecutar
MiMo V2.6 es realmente abierto bajo MIT, así que "simplemente aloja tú mismo" es un consejo real, no marketing. Pero que los pesos sean gratuitos no hace que ejecutarlos lo sea. La factura de hardware es la partida oculta.
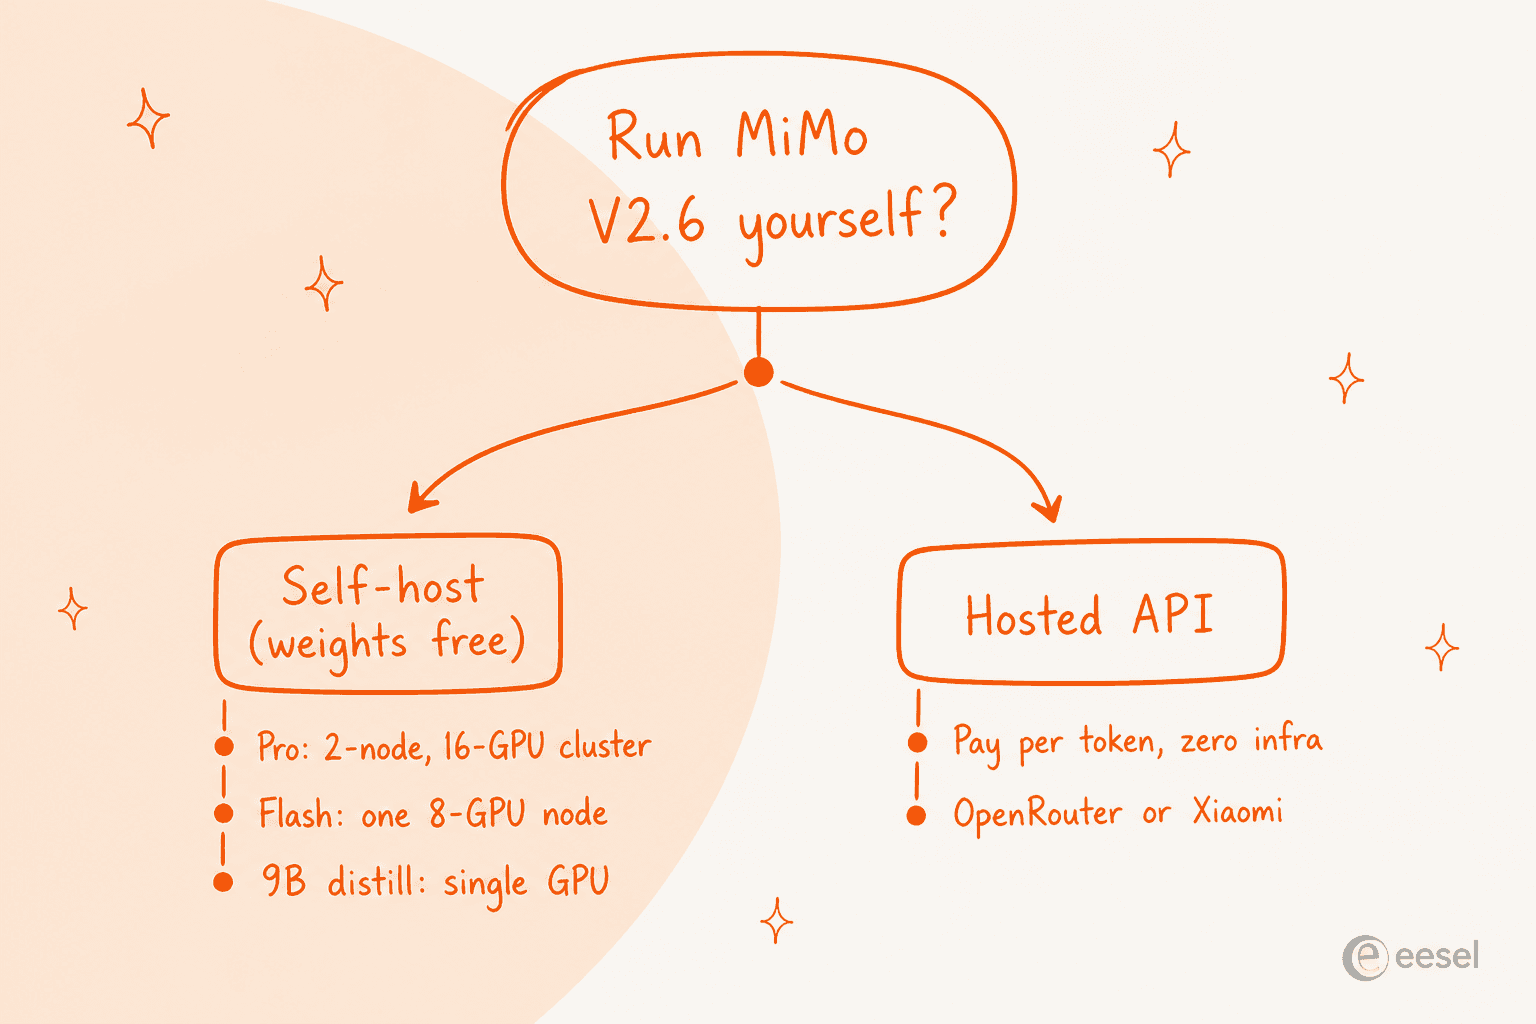
Esto es lo que necesita cada variante, según las fichas del modelo:
- Pro (1,02T / 42B activos): el lanzamiento de referencia con SGLang usa un clúster de 2 nodos y 16 GPUs (tensor-paralelo 16). Es un compromiso de hardware serio.
- Flash (309B / 15B activos): funciona en un único nodo de 8 GPUs.
- Distill-Qwen-9B: lo bastante pequeño para una sola GPU, y ya hay cuantizaciones GGUF para herramientas locales.
Todos los checkpoints se distribuyen en FP8, lo que mantiene razonable la huella de memoria, pero la lectura honesta es esta: el autoalojamiento solo supera a la API cuando tienes volumen alto y constante y GPUs inactivas que llenar. Para volumen intermitente o bajo, la API alojada, de $0,14 a $0,87 por millón de tokens, es casi siempre más barata que mantener un clúster caliente. Haz tus propios cálculos de utilización antes de asumir que "pesos gratuitos" significa "gratis".
La parte que la etiqueta de precio nunca muestra
Aquí tengo que dar un paso atrás, porque me dedico a construir y operar IA para el helpdesk, y la conversación sobre precios casi siempre pasa por alto la factura real.
El coste en tokens de MiMo V2.6, o de DeepSeek, o de Qwen, o de cualquiera de ellos, es la partida más pequeña del presupuesto de un sistema en producción. La parte cara es todo lo que rodea al modelo.
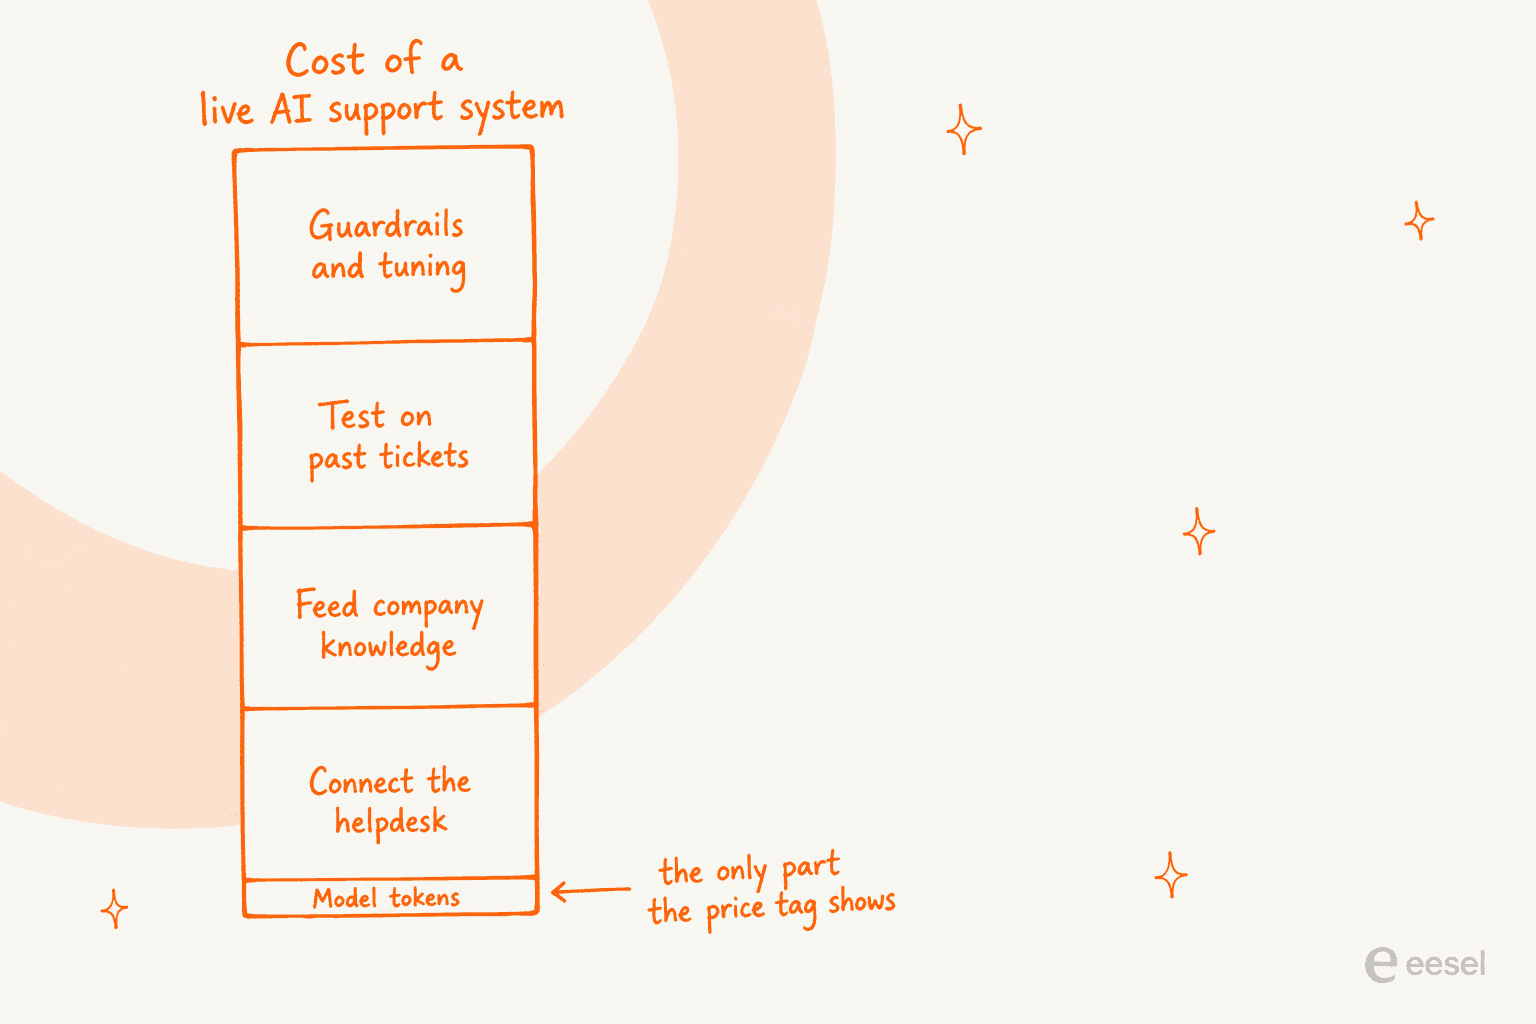
Llevamos varios años poniendo agentes de IA en colas de soporte en vivo, y la lección recurrente es que un modelo en bruto, por barato e inteligente que sea, no es un agente de soporte. Para pasar de "$14 de tokens" a "un agente en el que confío con un cliente", hay que conectarlo a tu helpdesk, alimentarlo con tu base de conocimiento y tickets pasados, enseñarle tus políticas, darle acciones que pueda tomar de forma segura y, sobre todo, probarlo antes de que salga en vivo. Hemos visto bots que suenan seguros dar respuestas silenciosamente incorrectas, que es exactamente por qué todo despliegue debería simularse contra tickets históricos primero.
Nada de eso aparece en una página de precios de OpenRouter. Es la diferencia entre un modelo y un compañero de equipo que funciona, y ahí es donde vive el verdadero coste del soporte con IA.
Prueba eesel
Un modelo como MiMo V2.6 es un motor. eesel es el compañero de equipo que contratas para conducirlo. eesel es una plataforma de compañeros de equipo con IA, y el agente de helpdesk con IA es un compañero de soporte listo para trabajar: se conecta a tu helpdesk en minutos, ya lee tus tickets pasados y tu base de conocimiento, y puedes simularlo con miles de tus conversaciones históricas reales antes de que responda a un solo cliente en vivo. En lugar de pagar una tarifa plana por asiento, eesel factura por uso, de modo que el coste sigue el trabajo realmente realizado.

Y si vives en una terminal, eesel tiene una CLI pública más un servidor MCP, así que el mismo compañero de equipo y espacio de trabajo que gestionas en el panel se puede manejar desde scripts o desde agentes de programación como Claude Code, Codex y Cursor. Es la forma amigable con agentes de operar eesel: una persona lo maneja a mano, un script lo automatiza, o un agente de IA lo invoca, todo contra el mismo compañero de helpdesk. Esa es la capa que convierte un modelo barato y capaz en algo que realmente resuelve tickets. Pruébalo gratis.
Preguntas frecuentes
¿Cuánto cuesta Xiaomi MiMo V2.6?
¿Cuál es la forma más barata de ejecutar Xiaomi MiMo V2.6?
¿Es gratis Xiaomi MiMo V2.6?
¿Cómo se comparan los precios de Xiaomi MiMo V2.6 con DeepSeek y Kimi K3?
¿Qué es MiMo V2.6 Pro UltraSpeed y por qué cuesta 10 veces más?
¿Xiaomi MiMo V2.6 ofrece descuento por caché?
¿Debería usar Xiaomi MiMo V2.6 para atención al cliente?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.