Cómo lo he analizado
Paso mis días pensando en intención de búsqueda y en la mirada de constructor de producto que hay debajo del marketing, así que mi proceso para un lanzamiento como este es deliberadamente aburrido. Me salté la página de prensa de Xiaomi y fui directo a las fichas del modelo en Hugging Face, contrasté las puntuaciones con el índice independiente de Artificial Analysis, y luego leí unos 670 comentarios en los hilos de lanzamiento, panel de entrenamiento y análisis de precios en Hacker News para ver qué reportaba de verdad la gente que usa el modelo en condiciones reales.
No he pasado un año viviendo dentro de MiMo como sí lo he hecho con las herramientas que construyo a diario, así que dejaré claro dónde estoy leyendo la investigación frente a dónde reporto uso real. Esa distinción importa para un modelo de apenas unos días, y la mayoría de las "reseñas" que aparecen horas después de un lanzamiento la omiten en silencio.
Qué es realmente MiMo V2.6
MiMo V2.6 es una familia de modelos de lenguaje de pesos abiertos, nativamente omnimodales, del equipo MiMo de Xiaomi, lanzada el 22 de septiembre de 2026. "Nativamente omnimodal" tiene sentido aquí: el mismo modelo procesa texto, imágenes, vídeo y audio en lugar de acoplar un adaptador de visión a un modelo de texto. Cada checkpoint incluye una ventana de contexto de 1M de tokens bajo licencia MIT.
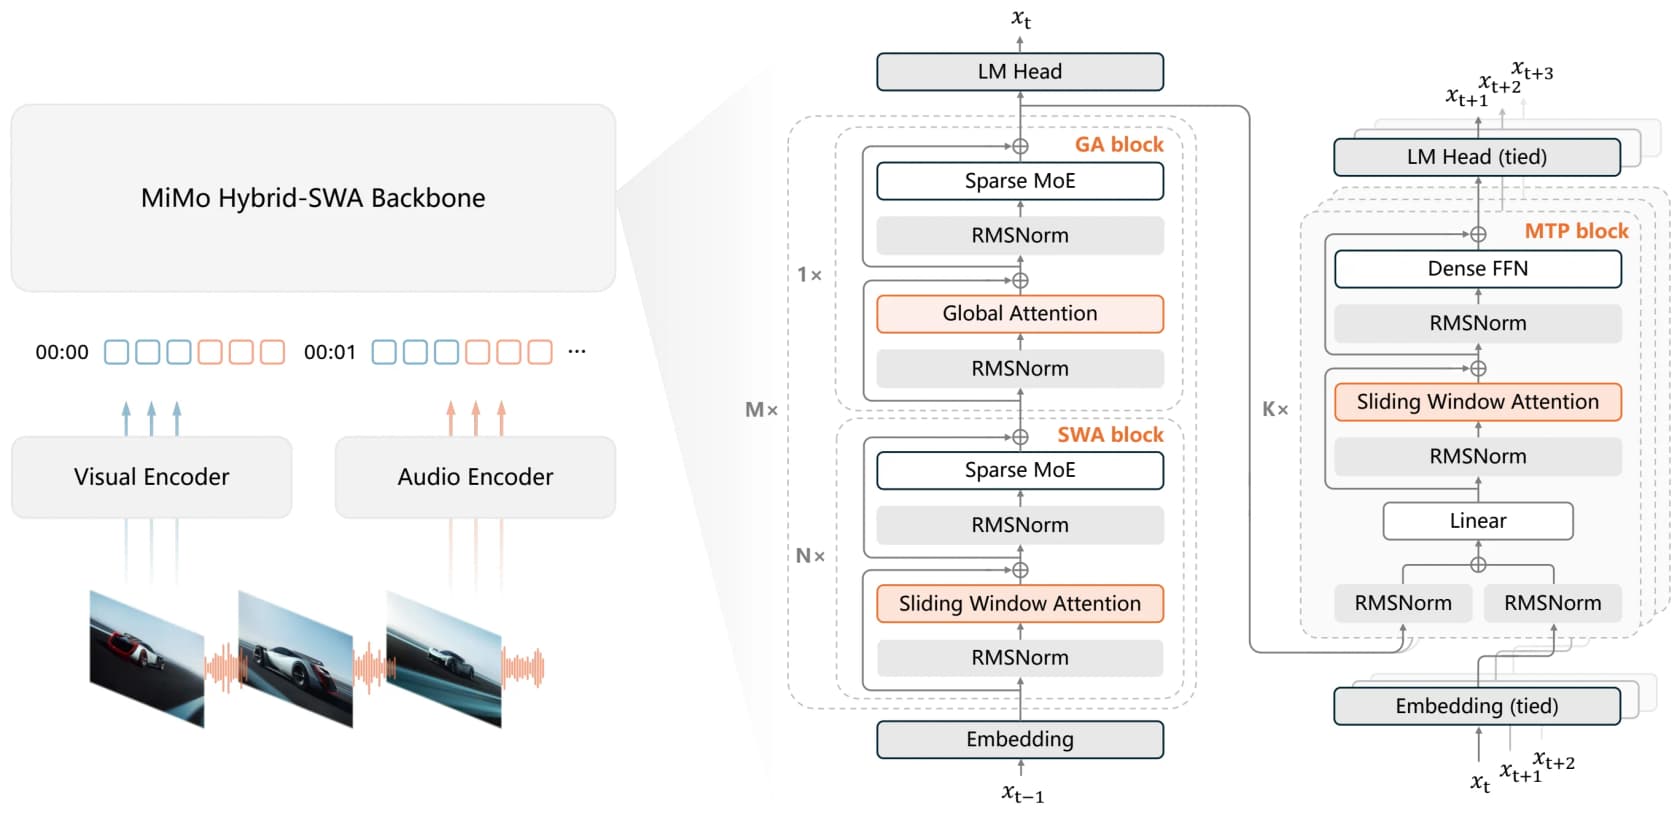
La mirada de constructor en un párrafo: Pro es una mezcla de expertos dispersa, con 1,02T de parámetros totales pero solo 42B activos por token, con una columna de atención híbrida (70 capas que alternan sliding-window local y atención global), 384 expertos enrutados de los que 8 se activan por token, un codificador de visión de 681M, codificadores de audio y un decodificador de predicción multi-token de 5 capas. No necesitas saber nada de esto para usarlo, pero explica cómo un modelo "de un billón de parámetros" se mantiene barato: lo que pagas es el número de parámetros activos, no el total.
Se lanza en cuatro checkpoints, y de ahí viene buena parte de la confusión online:
| Modelo | Parámetros totales | Parámetros activos | Contexto | Mejor para |
|---|---|---|---|---|
| MiMo V2.6 Pro | 1,02T | 42B | 1M | El trabajo agéntico más exigente a largo plazo |
| MiMo V2.6 Flash | 309B | 15B | 1M | El mejor equilibrio entre inteligencia, velocidad y coste |
| MiMo V2.6 Pro UltraSpeed | ~1T | 42B | 1M | Calidad Pro cuando necesitas salida rápida |
| MiMo V2.6 Distill-Qwen-9B | 9B | 9B | n/a | Investigación de RL agéntico abierto y uso en una sola GPU |
Flash es al que recurrirá la mayoría. UltraSpeed es el mismo checkpoint Pro servido a una salida unas 10x más rápida al 10x del precio, así que es un sobreprecio por latencia, no un modelo más inteligente. La destilación de 9B es un ajuste fino supervisado de Qwen3.5-9B sobre datos generados por MiMo, un punto de partida para investigación más que para producción.
Los benchmarks, leídos con honestidad
Todo lanzamiento elige a dedo sus gráficos, así que fui a la tabla de evaluación de la ficha del modelo y la dividí en victorias y derrotas. Hay que reconocerle a Xiaomi que publica ambas.
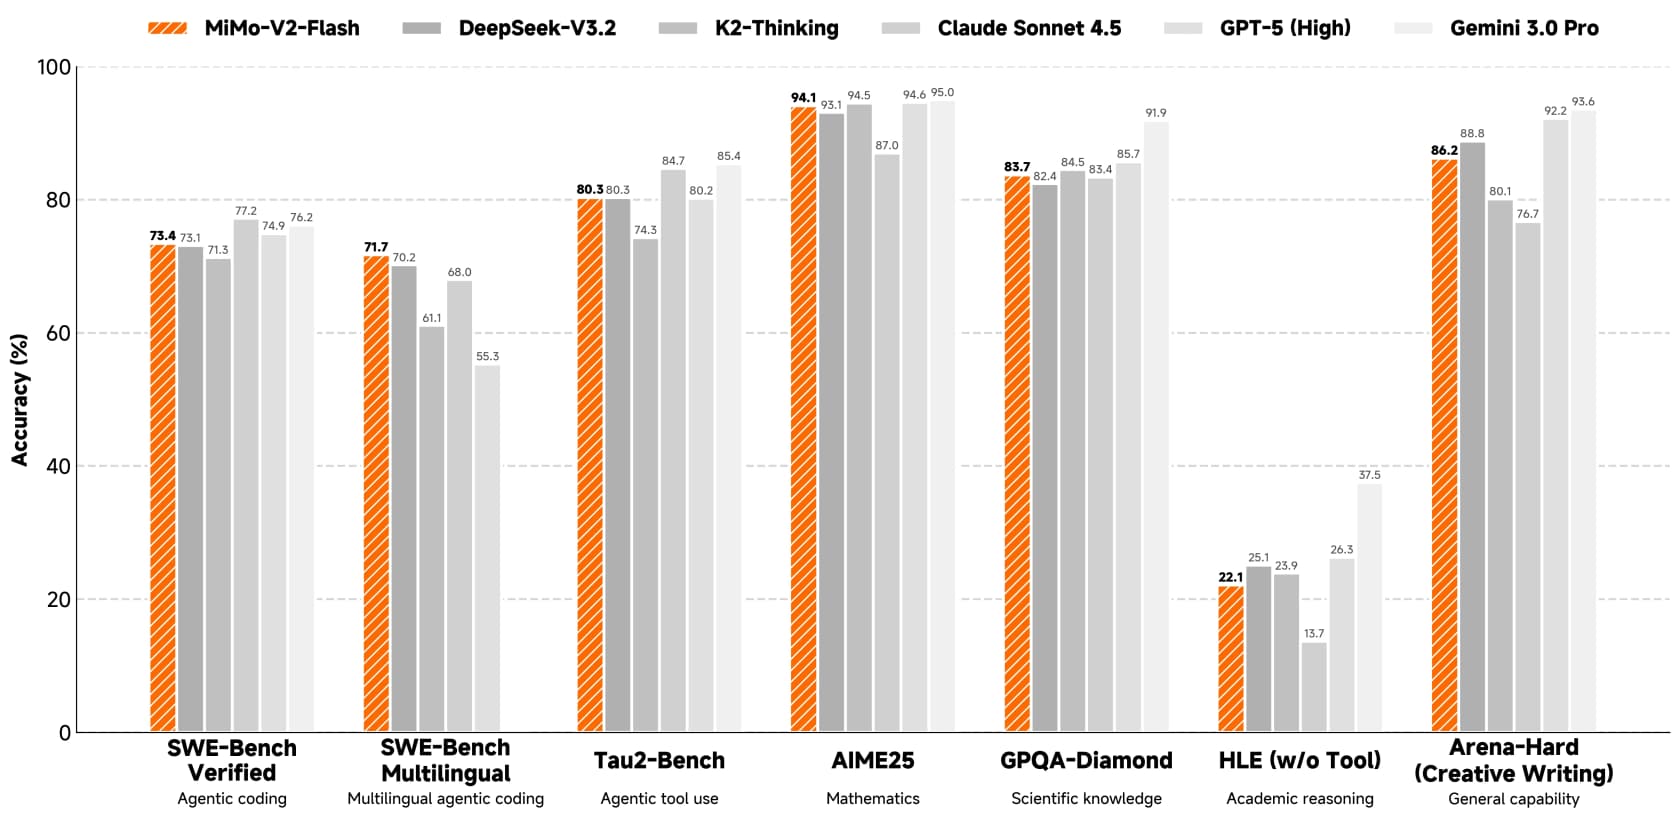
Dónde Pro supera a la frontera cerrada según los datos de Xiaomi:
| Benchmark | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| AutomationBench v1.0.6 | 53,1 | 50,3 | 45,8 |
| Terminal Bench 2.1 | 89,9 | 89,1 | 88,8 |
| Agents' Last Exam | 31,6 | 31,6 | 30,8 |
| CyberGym | 94,0 | - | - |
Y dónde se queda atrás, algo que el tablero de Terminal Bench 4.0 deja claro:
| Benchmark | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| DeepSWE v1.1 | 71,9 | 74,0 | 73,0 |
| ProgramBench | 26,5 | 37,0 | 25,0 |
| Terminal Bench 4.0 | 34,9 | 49,0 | 39,9 |
| ExploitBench | 47,9 | 70,0 | 78,5 |
El patrón es consistente y, creo, creíble: Pro está a la altura de la frontera en tareas generales de agentes y uso de herramientas, y se queda atrás en los benchmarks de codificación y explotación más difíciles a largo plazo. Cuando Xiaomi amplió la comparación para incluir a GPT-6 Astra, se mantuvo la misma forma: Pro se sitúa cerca de la cima en AutomationBench y Terminal Bench 2.1, y por detrás de Astra en Terminal Bench 4.0 (59,6).
El salto generacional es lo que de verdad me impresionó. El anterior MiMo V2.5 Pro obtuvo 19,0 en DeepSWE v1.1; V2.6 Pro obtiene 71,9. En Terminal Bench 4.0 pasó de 1,5 a 34,9. Eso no es incremental, es el tipo de salto que solo se ve cuando un laboratorio cambia su enfoque de entrenamiento.
Una cifra merece una señal de alerta más que un aplauso. Pro marca 94,0 en CyberGym, donde V2.5 apenas llegaba a 40,0, pero el más adversarial ExploitBench cuenta una historia más modesta con 47,9. Yo leería el resultado de CyberGym como impresionante, no como algo ya asentado.
La cuenta de valor es la verdadera historia
Los tableros individuales son ruidosos. La cifra que realmente vigilo es el índice agregado de Artificial Analysis, porque combina muchas evaluaciones en una puntuación comparable y la representa frente al coste.
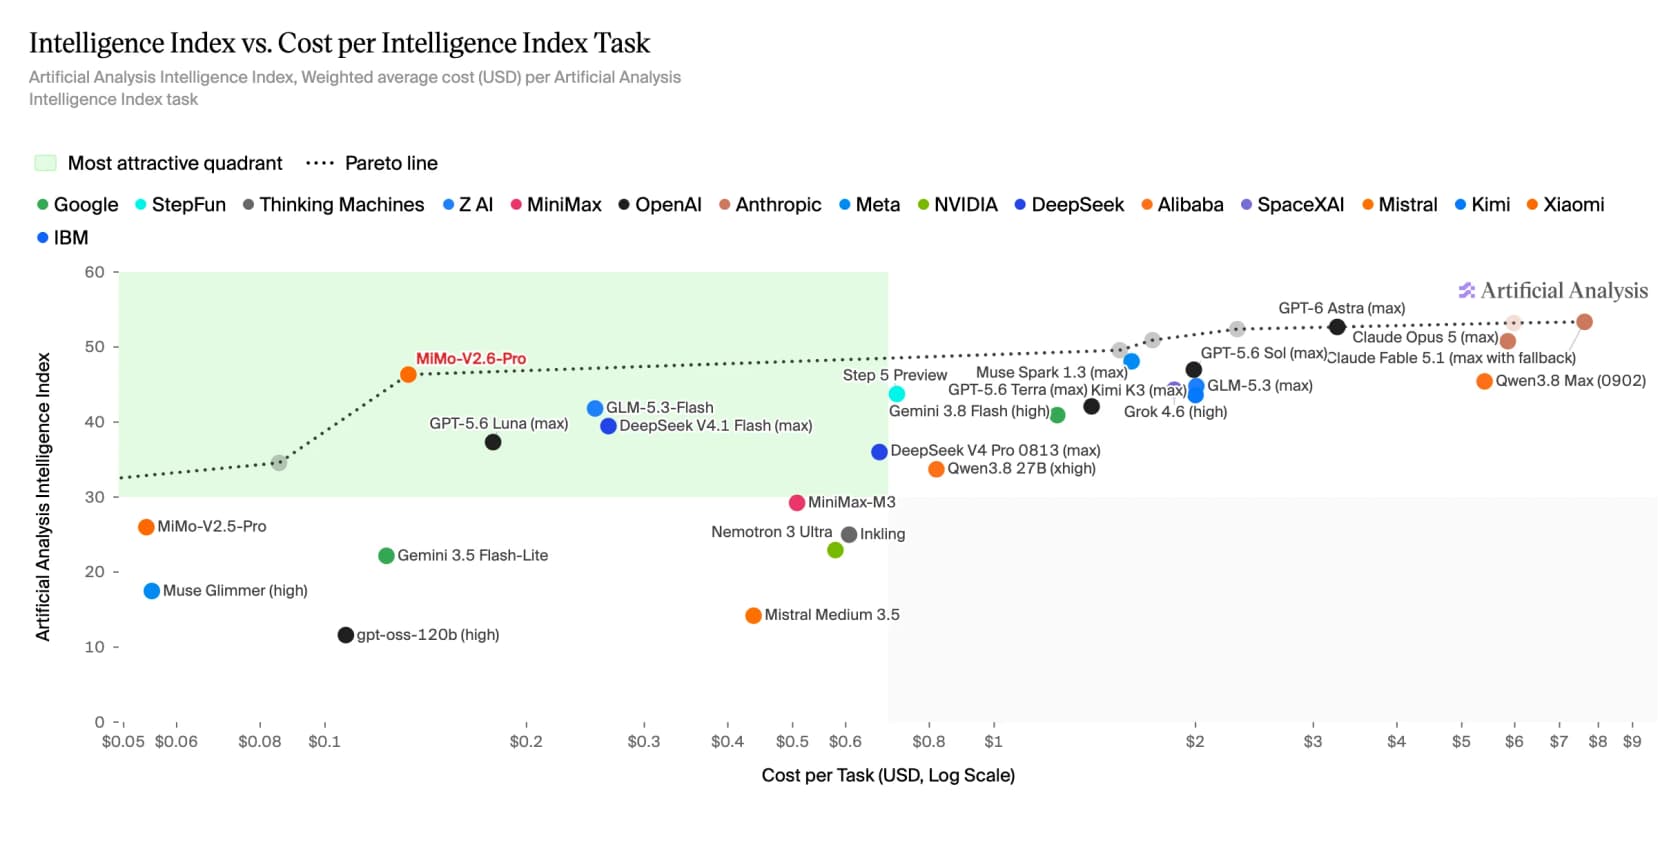
MiMo V2.6 Pro alcanza un Intelligence Index de 46, el mejor modelo de pesos abiertos del panorama, justo en lo que Artificial Analysis llama literalmente el "cuadrante más atractivo". La frontera cerrada puntúa más alto en inteligencia pura (Astra, Opus 5 y Fable 5.1 se sitúan entre 50 y mediados de los 50), pero a $3-$8 por tarea. MiMo logra su 46 por unos $0,13.
Esa relación precio-inteligencia es todo el argumento de venta. Aquí están los precios alojados de OpenRouter, por millón de tokens, comprobados en la semana de lanzamiento:
| Modelo | Entrada / 1M | Salida / 1M | Contexto |
|---|---|---|---|
| MiMo V2.6 Flash | $0,14 | $0,28 | 1M |
| MiMo V2.6 Pro | $0,435 | $0,87 | 1M |
| MiMo V2.6 Pro UltraSpeed | $4,35 | $8,70 | 1M |
Flash, con $0,14 de entrada / $0,28 de salida, es extraordinariamente barato para un modelo omnimodal con contexto de 1M. Para la mayoría de los equipos, Flash es la opción por defecto y Pro es a lo que se escala.
Qué checkpoint de MiMo V2.6 te conviene
La alineación de cuatro checkpoints es, con diferencia, lo más confuso de este lanzamiento, así que aquí tienes una herramienta rápida de decisión. Responde las tres preguntas y te indicará el checkpoint adecuado (o te alejará de MiMo por completo).
Lo que dijo la gente que lo probó de verdad
Los benchmarks son la historia de Xiaomi; yo quería la historia de los usuarios. La reacción dominante en el hilo de lanzamiento no fue en absoluto sobre las puntuaciones. Fue sobre lo abiertamente que Xiaomi entrenó el modelo.
"I really like how transparent they've been about the training of this model. The realtime dashboard they shared during training was an incredible learning and teaching tool for me, and they've been unusually comprehensive in sharing details about their methodology... and benchmark scores (even the stuff they didn't do well on)."

"The best thing they did is being open about all the setbacks they had to deal with. They logged every restart with a reason, talked about dropping a cyber dataset after it degraded coding benchmarks. Also published real time training loss, benchmark scores after every checkpoint and running cost estimates."
Ese detalle de haber descartado un conjunto de datos de ciberseguridad porque perjudicaba las puntuaciones de codificación es del tipo de cosas que los laboratorios casi nunca admiten, y es una gran parte de por qué el lanzamiento se ganó la simpatía incluso de los escépticos. La lectura técnica más aguda vino de un usuario veterano de MiMo que contó los tableros a mano:
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! Good to see they also kept the price the same, and landed in the greenest quadrant of the intelligence vs speed of AA."
No todo fue elogios. La preocupación que acompaña a todo modelo abierto potente salido de China es el benchmaxxing, buenas puntuaciones y un trabajo real decepcionante:
"No chinese lab has caught up yet. They've tried to fake it by distilling and overfitting on benchmarks to make their models look better than they are, the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them."
El contrapeso vino de gente que ya lo tiene corriendo en producción. La reflexión sobre la relación de valor es la que más me ronda la cabeza, aunque hay que notar que habla del anterior V2.5, al que varias personas también calificaron de rápido pero tonto en tareas difíciles:
"I been using MiMo-V2.5 to do most of my work as software engineer... I been VERY happy with ROI. The model is very powerful!... The cost is unbelievably low, and the quality of intelligence I get is equivalent to when I was working mostly with Anthropic models... but when I add cost of M-token in the ROI math, Jeez! MiMo is an order of magnitude better."
En X, el lanzamiento se interpretó sobre todo como un golpe contra Grok 4.7, que salió el mismo día, con reacciones que van desde "Better than Grok 4.7" hasta un mesurado "let's wait for real-world test performance first." Esa advertencia sobre el mundo real es la correcta, y es exactamente por lo que la reputación de V2.5 de "rápido pero tonto en tareas difíciles" es el listón que V2.6 tiene que superar en el uso diario, no solo en los gráficos.
Mi veredicto: el mejor valor de pesos abiertos, no el modelo más inteligente
Aquí es donde aterrizo tras una semana con la investigación.
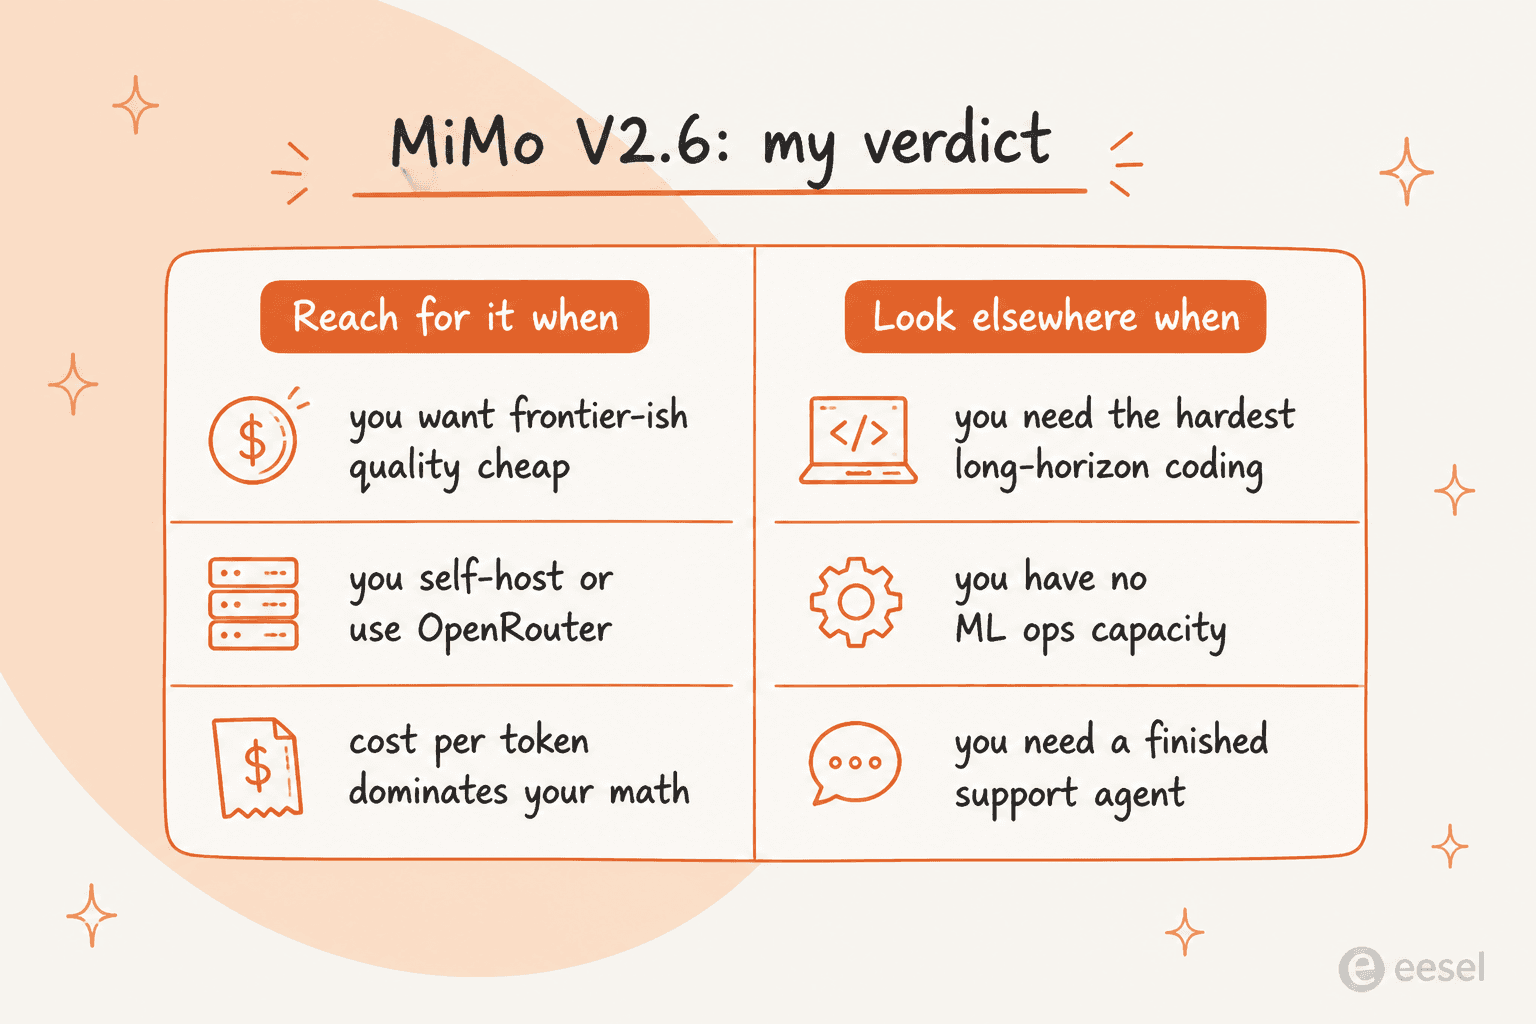
Recurre a MiMo V2.6 cuando el coste por token domine tus cuentas, te sientas cómodo auto-alojándolo o usando OpenRouter, y quieras una calidad casi de frontera en trabajo general de agentes y uso de herramientas. Flash en particular es una opción por defecto sólida para tareas cotidianas de alto volumen donde el precio por token de la frontera cerrada dolería.
Busca otra opción cuando tu carga de trabajo sea la codificación o el trabajo de explotación más difícil a largo plazo, donde Pro se queda mensurablemente atrás de Astra y Opus 5; cuando no tengas capacidad para operar infraestructura de modelos ni un plan para la factura de servicio; o cuando en realidad necesites un agente terminado que haga un trabajo, no un modelo en bruto. En este último punto, MiMo no es la herramienta, y tampoco lo es ningún otro modelo por sí solo.
En cuanto a valoración, como apuesta de valor entre pesos abiertos lo colocaría cerca de la cima del panorama actual, junto a DeepSeek V4.1 Flash y Qwen 3.8 Max. Como afirmación de "superar a la frontera cerrada", la respuesta honesta es: en precio, sí; en los benchmarks más difíciles, todavía no. Para un panorama más amplio, nuestro resumen de los mejores agentes de IA de código abierto es una buena siguiente lectura.
La parte que una reseña de modelos suele omitir: un motor no es un empleado
He pasado los últimos años ayudando a poner IA en colas de soporte reales, y el lanzamiento de MiMo V2.6 confirma lo que aprendimos por las malas: el modelo ya no es el cuello de botella.
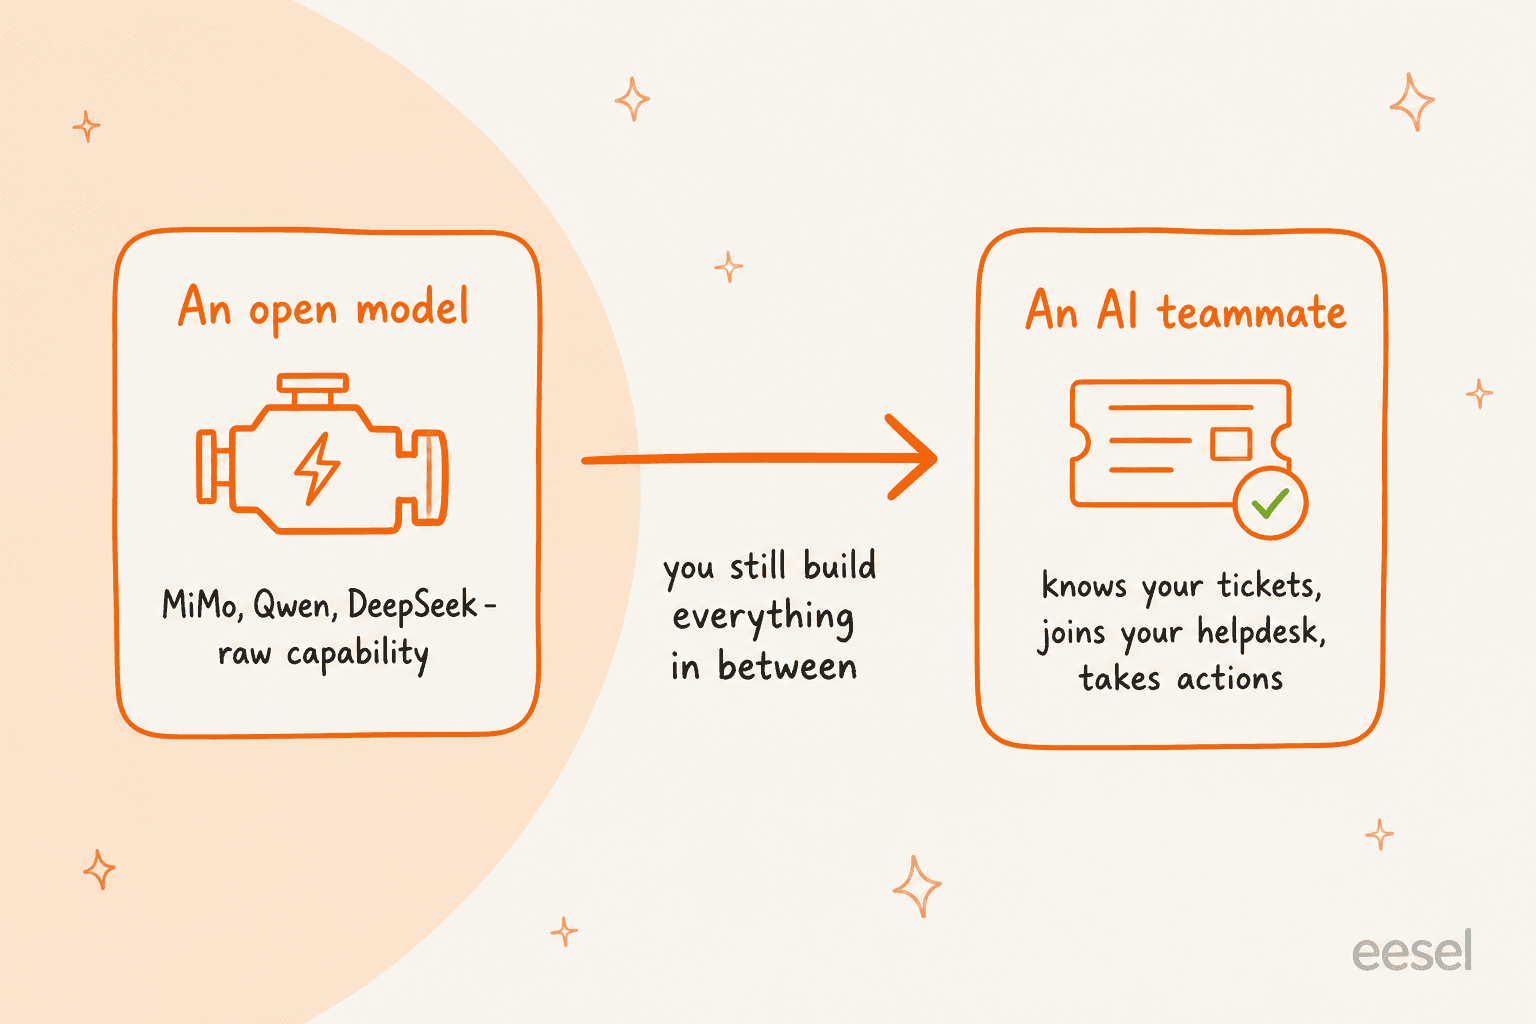
MiMo V2.6, DeepSeek, Qwen, Claude, GPT: cualquiera de ellos puede escribir una respuesta fluida y con apariencia correcta a una pregunta de un cliente. Eso daba miedo hace dos años. Ya está resuelto. Lo que ninguno hace de fábrica es el trabajo real: leer tu centro de ayuda específico y los tickets pasados, seguir tu política de reembolsos en lugar de una inventada pero plausible, consultar un pedido, etiquetar y enrutar el ticket, saber cuándo escalar, y ser probado antes de responder a un cliente real.
Ese último punto es en el que no transigiría. Hemos visto modelos que suenan seguros de sí mismos dar respuestas equivocadas en colas reales, por eso cada implementación se simula primero contra tickets históricos. Un 46 en el índice AA no te dice nada sobre cómo maneja un modelo tu rara excepción de política de devoluciones. Una simulación sobre tus últimos 5.000 tickets sí. Si estás eligiendo un modelo específicamente para soporte, nuestra guía sobre el mejor modelo de IA para tickets de soporte y el desglose de coste de agente de IA frente a agente humano son las dos siguientes lecturas que recomendaría.
Prueba eesel
Todo el sentido de esta reseña es que un modelo abierto como MiMo V2.6 es infraestructura, capacidad en bruto que todavía tienes que convertir en algo que haga un trabajo. eesel es la capa que convierte un modelo en un compañero funcional. Contratas a un agente de IA para helpdesk listo para trabajar que se conecta al helpdesk que ya usas (Zendesk, Freshdesk, Gorgias, Help Scout, y más de 1000 integraciones), se entrena con tus tickets pasados y tu base de conocimiento, y empieza a redactar o enviar respuestas sin necesidad de gestionar modelos.

El factor diferencial es el que los propios benchmarks de MiMo no pueden darte: antes de que un agente de eesel responda a un solo cliente en vivo, lo simulas sobre tu historial real de tickets y ves la tasa de resolución exacta y las respuestas que habrías obtenido. Y como eesel es una plataforma de compañeros, la misma cuenta también hace funcionar un redactor de blog con IA. Para los desarrolladores a quienes les gustó la afinidad de MiMo con la terminal, eesel expone al mismo compañero mediante una CLI, API y MCP públicas, de modo que una persona, un script o un agente de codificación pueden manejarlo todos desde la terminal.
Puedes empezar gratis, sin tarjeta de crédito y sin llamada de ventas, y tener un compañero activo en minutos. El modelo se ha vuelto barato. Conseguir que de verdad haga el trabajo sigue siendo la parte interesante.
Preguntas frecuentes
¿Es bueno Xiaomi MiMo V2.6?
¿Cuánto cuesta ejecutar Xiaomi MiMo V2.6?
¿Es Xiaomi MiMo V2.6 mejor que Kimi K3 o DeepSeek?
¿Puedo auto-alojar Xiaomi MiMo V2.6?
¿Qué modelo de MiMo V2.6 debería usar?
¿Debería usar Xiaomi MiMo V2.6 para atención al cliente?
¿Es real la transparencia de benchmarks de Xiaomi MiMo V2.6?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.