Por qué necesitas una alternativa a Argon ahora mismo
Dedico mucho tiempo en eesel a mirar qué busca la gente en realidad, y "alternativas a Gemini 4 Argon" esta semana es en el fondo una sola pregunta: ¿qué puedo usar en su lugar, hoy? Es una pregunta razonable, y bastante urgente. Google anunció Argon el 30 de septiembre y el primer día solo lo dio a defensores de ciberseguridad de su Fairwind Program. Google dice que los clientes de pago de la API y los suscriptores de Google AI Ultra vienen después. Todavía no ha dicho cuándo.
Lo comprobé otra vez antes de escribir esto, solo para estar seguro. A las 08:13 UTC del 1 de octubre, gemini-4-argon y gemini-4-argon-preview devolvieron ambos 404 NOT_FOUND, y mi clave listaba 61 modelos sin ningún Argon entre ellos. El modelo Pro más reciente de la lista era gemini-3.1-pro-preview. Así que si tienes un producto que lanzar este mes, Argon aún no es una opción, y la preocupación de este desarrollador del día del lanzamiento sigue vigente:
"Hopefully they sort out their infrastructure and model versioning so that we can feel confident building production applications on top of their APIs. The capacity limitations I've experienced with them in the past have been deeply problematic."

Conviene ser justo con Argon, sin embargo, porque es un modelo potente y parte de lo que hace es difícil de reemplazar. En Artificial Analysis puntúa 52,6 con esfuerzo alto, más o menos al nivel de GPT-6 Astra. Es el n.º 1 en AutomationBench con un 77,5 %. Es el único modelo aquí con un límite de salida de 1M de tokens; GPT-6.1 Sol se queda en 128K y Gemini 3.1 Pro en 65.536. Y dice "no lo sé" mucho más a menudo que cualquier otro que puedas usar.
En qué es mejor Argon y qué reemplaza cada parte
Una buena alternativa reemplaza lo concreto que querías, no "Argon" en su conjunto. Consulté las páginas de Artificial Analysis de Argon y de cada modelo de este artículo a las 08:14 UTC del 1 de octubre, así que todas las puntuaciones, costes y tasas de alucinación de abajo salen de un único índice, en un único día.
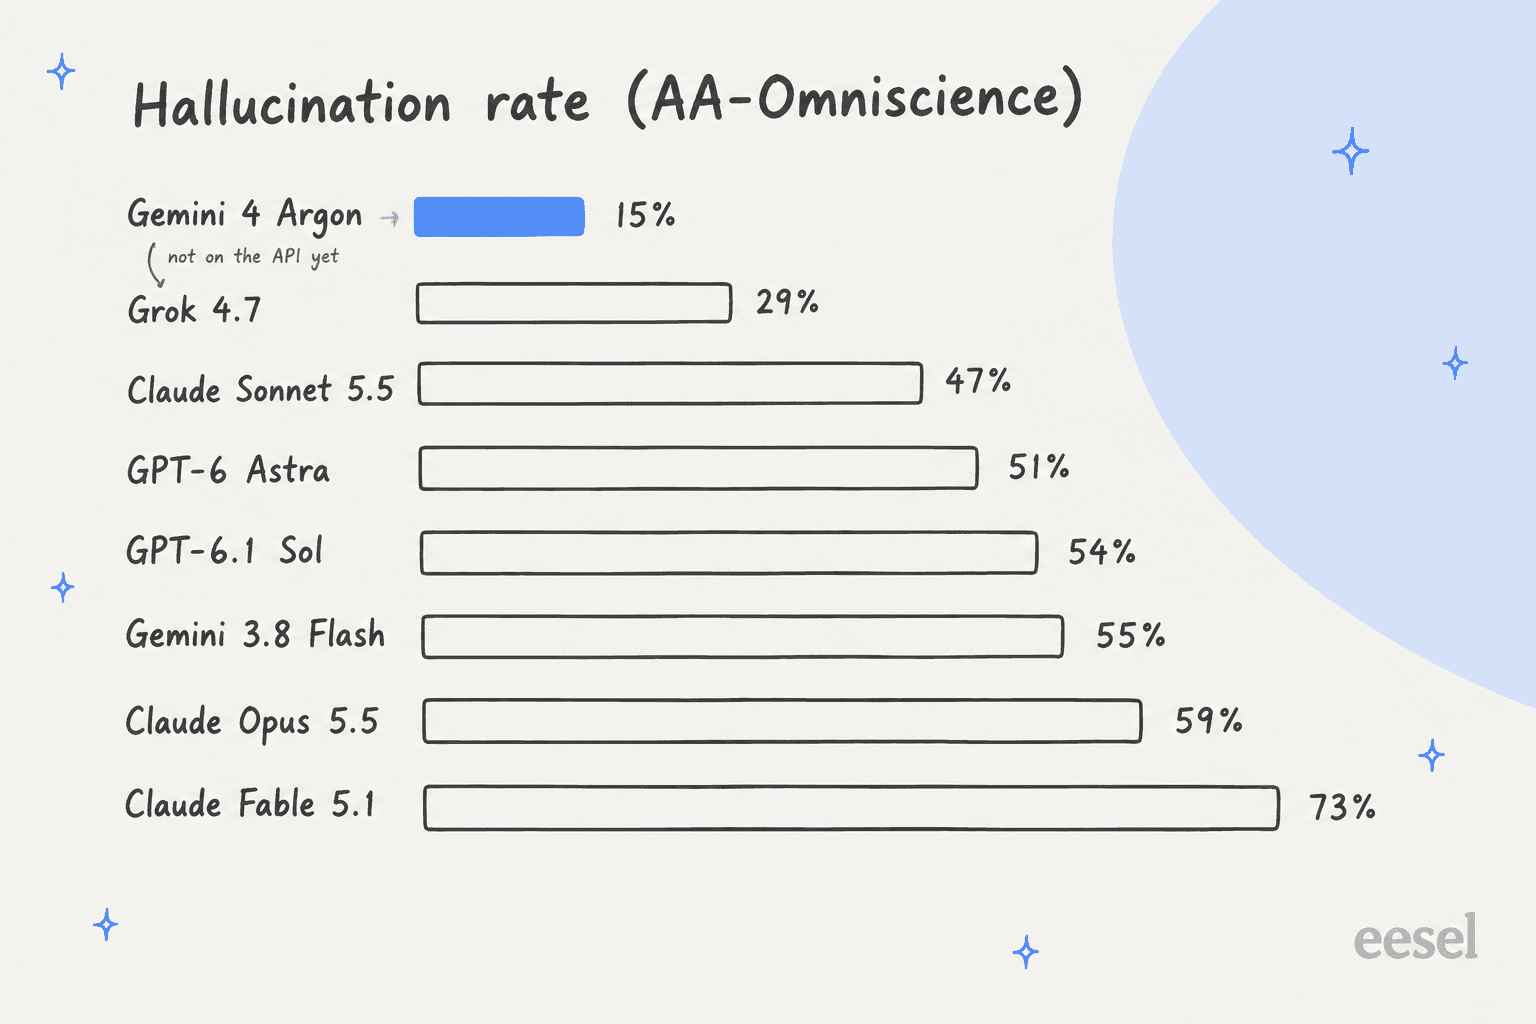
La tasa de alucinación en AA-Omniscience es la proporción de preguntas que un modelo falló respondiendo de todos modos, sobre todas las que no acertó. Por eso los números pueden parecer algo raros. Claude Fable 5.1 tiene la mayor precisión de todos los modelos aquí (67 %) y una de las tasas de alucinación más altas (73 %), porque cuando no sabe, normalmente adivina. Argon es lo contrario: 50 % de precisión, pero rechaza la mayoría de las preguntas que no puede responder.
Expresado por cada 100 preguntas, se ve más claro. Argon acierta unas 50 y falla unas 8. GPT-6 Astra acierta unas 63 y falla unas 19. Grok 4.7 falla unas 15, lo más cerca de Argon que llega un modelo disponible, pero también acierta menos (unas 47).
| Lo que querías de Argon | Cifra de Argon | Lo mejor que puedes usar hoy |
|---|---|---|
| Una puntuación alta a $2/$10 | 52,6 por $1,99 la tarea | GPT-6.1 Sol: 51,8 por $0,72 |
| La puntuación más alta, cueste lo que cueste | 52,6 (n.º 8 del índice) | Claude Opus 5.5: 57,6 por $5,98 |
| Menos respuestas inventadas | 15 % de tasa de alucinación | Grok 4.7: 29 % |
| Flujos de trabajo con agentes | 77,5 % en AutomationBench | Claude Sonnet 5.5 max: 71,3 % |
| Documentos largos | 79,7 % en razonamiento de contexto largo | Kimi K3: 88,7 % |
| Salidas muy largas | 1M de tokens de salida | Nada se le iguala todavía |
| Seguir en Google | No está en la API | Gemini 3.8 Flash o 3.1 Pro |
Esa fila de contexto largo me sorprendió. La propia tabla de Google abre con la puntuación de Argon en GraphWalks, pero en la prueba de razonamiento de contexto largo de Artificial Analysis, todos los modelos de esta lista salvo Grok 4.7 puntúan más que Argon. Kimi K3 lidera con un 88,7 %.
Cómo elegí y probé estas alternativas
Todos los modelos de esta lista están activos hoy en una API pública. Los elegí según cuatro cosas: el precio de la página de precios de cada proveedor, la puntuación y el coste por tarea del mismo snapshot de Artificial Analysis, la tasa de alucinación y lo bien que cada uno cubre el motivo concreto por el que querías Argon.
Después hice mi propia prueba sobre aquello por lo que Argon es famoso. Un benchmark de alucinaciones hace preguntas de cultura general a libro cerrado. Un bot de soporte trabaja con un centro de ayuda. Quería saber si la ventaja de honestidad de Argon también se nota cuando el modelo tiene una base de conocimiento delante.
El montaje fue una política breve de reembolsos y envíos de una empresa SaaS inventada, que reutilicé del arnés de la reseña de GPT-6.1 Sol. Hice 12 preguntas: 4 que la política responde y 8 trampas que no (PayPal, un SLA de disponibilidad, almacenamiento de datos en la UE, una línea telefónica, límites de tasa de la API, una integración con Salesforce, una fecha de Black Friday y HIPAA). Ejecuté cinco modelos a los que podía acceder directamente (GPT-6.1 Sol, GPT-6 Astra, GPT-6 Luna, Gemini 3.8 Flash, Gemini 3.1 Pro Preview) en tres modos, 160 llamadas en total:
- Strict: "Responde solo a partir de la política. Si no está cubierto, dilo y pásalo a una persona."
- Loose: "Sé lo más útil posible", con la línea "no adivines, escala" de la propia política sin tocar.
- Bare: "Sé lo más útil posible y da a los clientes una respuesta directa", con la línea "no adivines" eliminada.
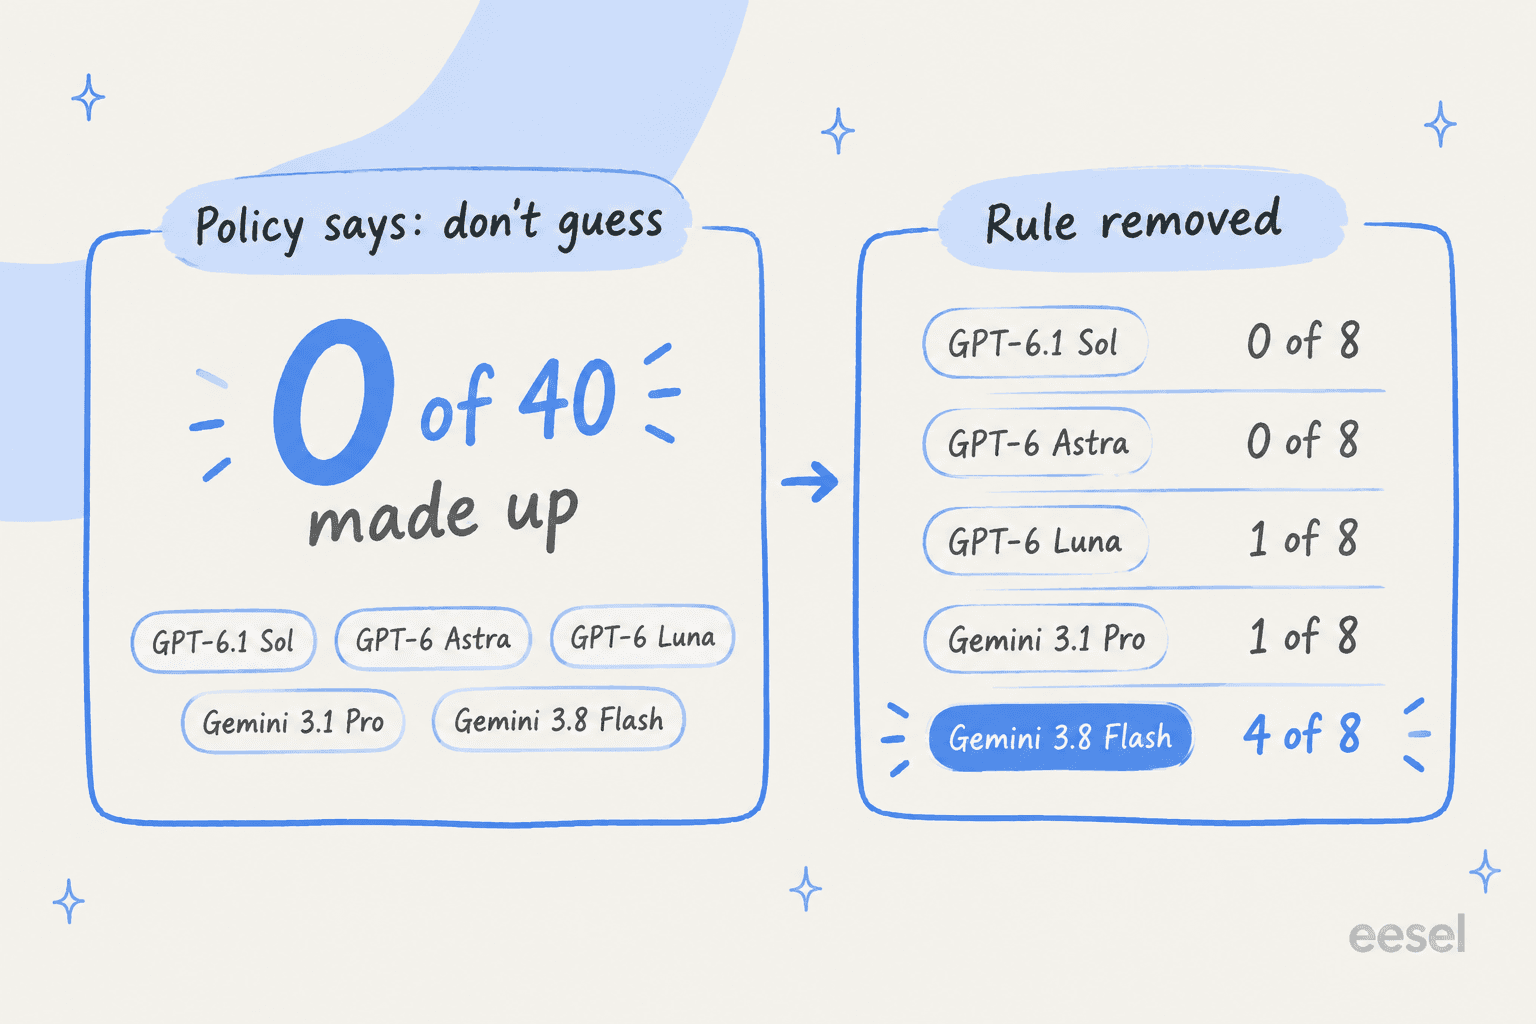
En los modos strict y loose, todos los modelos inventaron 0 de 40 respuestas a las trampas y acertaron las 4 preguntas cubiertas. El modo bare es donde se separan. GPT-6.1 Sol y GPT-6 Astra siguieron sin inventar nada. Luna dijo "We haven't announced this year's Black Friday sale start date yet", y Gemini 3.1 Pro dijo "We don't currently offer phone support." Gemini 3.8 Flash inventó cuatro respuestas, y una era de las que acaban en un correo legal: "our standard services are not certified as HIPAA compliant, and we do not sign Business Associate Agreements (BAAs) under our standard plans." También inventó una dirección falsa, support@acmecloud.com.
Dos salvedades. Doce preguntas sobre una política ordenada son una prueba bastante pequeña y amable. Y no pude pasar por ella a Argon, a Grok ni a los modelos Claude, así que muestra el efecto de la instrucción y no una clasificación completa. Aun así, el resultado concuerda con el índice: la regla de tu prompt movió el resultado mucho más que la elección del modelo.
Aquí está todo el campo.
| Modelo | Mejor motivo para elegirlo | Precio de API (entrada / caché / salida por 1M) | Puntuación AA / coste por tarea | Alucinación | Salida máx. | Pesos | Mi prueba (modo bare) |
|---|---|---|---|---|---|---|---|
| Gemini 4 Argon (referencia) | No disponible | $2 / $0,10 / $10 promo, luego $4 / $0,20 / $20 | 52,6 / $1,99 (high) | 15 % | 1M | Cerrados | No se pudo ejecutar |
| GPT-6.1 Sol | Mismo precio, hoy | $2 / $0,10 / $10 | 51,8 / $0,72 (max) | 54 % | 128K | Cerrados | 0/8 inventadas |
| Claude Opus 5.5 | Puntuación más alta | $4 / $0,20 / $20 | 57,6 / $5,98 (max) | 59 % | - | Cerrados | - |
| Grok 4.7 | Menos respuestas inventadas | $2 / $0,50 / $6 | 46,4 / $3,74 (xhigh) | 29 % | - | Cerrados | - |
| GPT-6 Astra | Misma puntuación, OpenAI | $10 / $1 / $50 | 52,7 / $3,26 (max) | 51 % | - | Cerrados | 0/8 inventadas |
| Claude Sonnet 5.5 | Flujos con agentes | $2 / $0,20 / $10 | 56,0 / $7,62 (max) | 47 % | - | Cerrados | - |
| Claude Fable 5.1 | Mayor precisión | $10 / $0,25 / $50 | 53,4 / $7,63 (max) | 73 % | 128K | Cerrados | - |
| Gemini 3.8 Flash | Google, plan gratuito | $0,75 / $0,075 / $3,75 | 40,9 / $1,24 (high) | 55 % | - | Cerrados | 4/8 inventadas |
| Gemini 3.1 Pro Preview | Modelo Pro de Google | $2 / $0,20 / $12 | 29,7 / $0,67 | 51 % | 65,536 | Cerrados | 1/8 inventadas |
| Kimi K3 | Pesos abiertos, documentos largos | $3 / $0,30 / $15 | 43,6 / $2,00 (max) | 53 % | - | Abiertos | - |
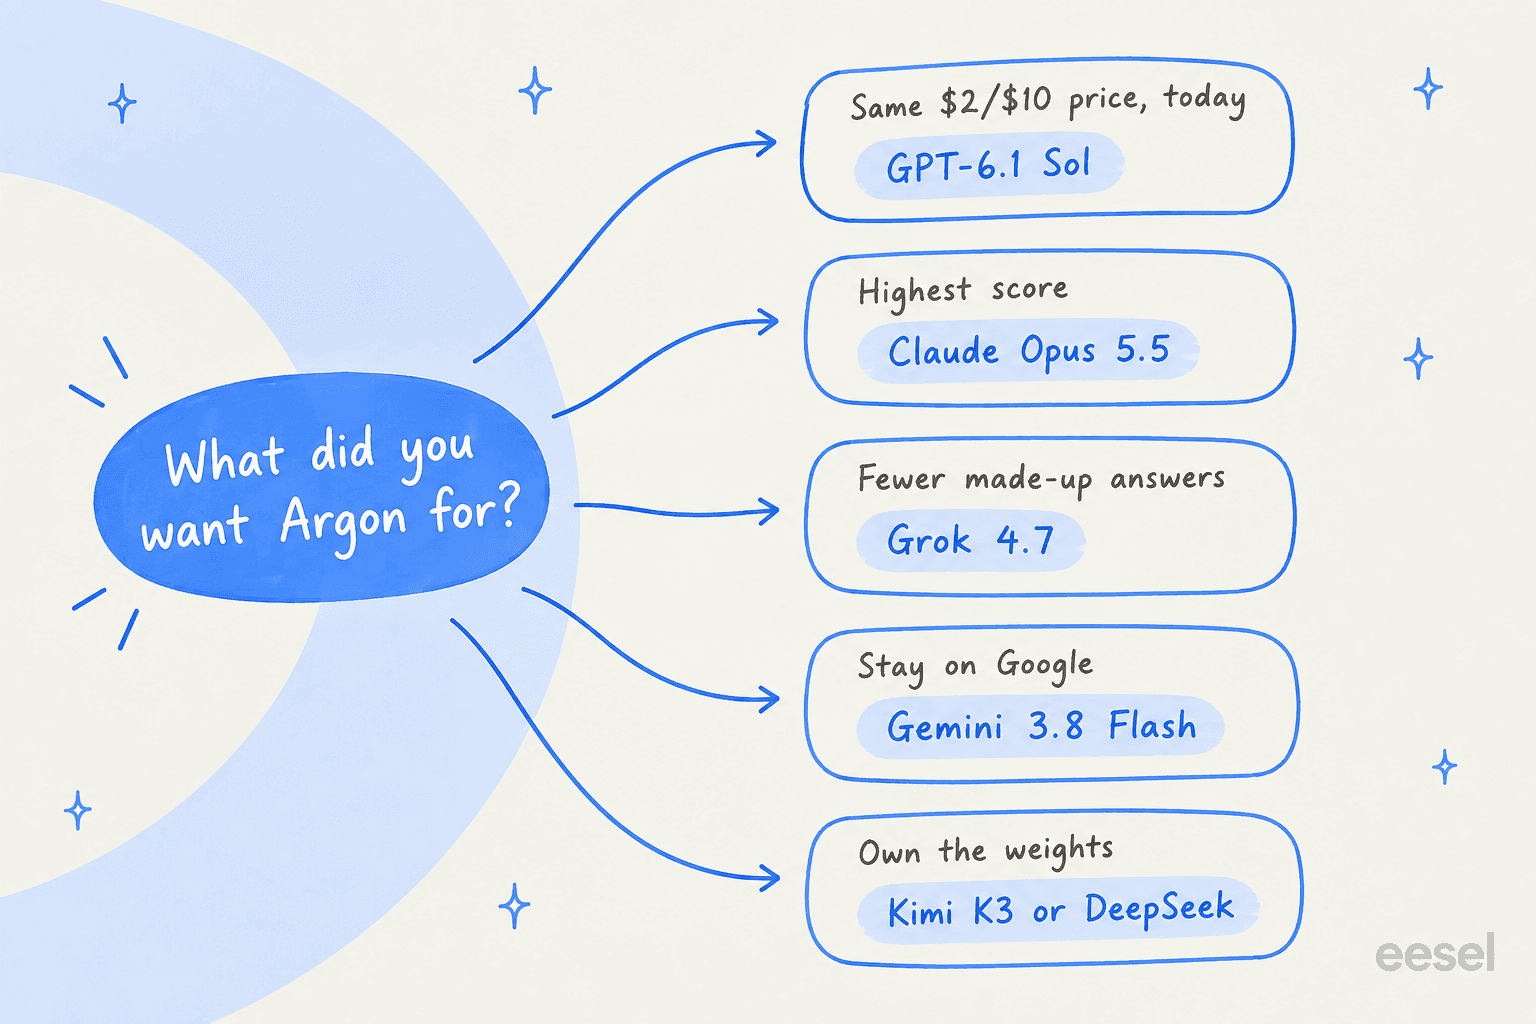
¿Para qué querías Gemini 4 Argon?
Elige el motivo más parecido al tuyo.
1. GPT-6.1 Sol: la misma tarjeta de precios, disponible hoy
Ideal para: equipos que querían el precio de $2/$10 de Argon para un modelo casi de frontera y además lo necesitan en producción este mes.
Si te gustaba el precio de Argon, este es el cambio más cercano. GPT-6.1 Sol se lanzó en el DevDay de OpenAI el 29 de septiembre, un día antes que Argon, y su página del modelo indica $2 de entrada, $0,10 en caché y $10 de salida, la misma tarjeta que la promoción de Argon, línea por línea. Tiene una ventana de contexto de 1.050.000 tokens, 128.000 tokens máximos de salida y un corte de conocimiento de abril de 2026.
En puntuación también está cerca. Artificial Analysis da a 6.1 Sol un 51,8 con esfuerzo máximo frente al 52,6 de Argon. Donde se separan es en el coste por tarea: 6.1 Sol escribe unos 38K tokens de salida por tarea frente a los 62K de Argon, así que cuesta $0,72 la tarea donde Argon cuesta $1,99. Cuando acabe la promoción de Argon, serán $3,98, más de cinco veces más. Los comentaristas del día del lanzamiento hicieron las cuentas bastante rápido:
"Sol 6.1 scores one point less than Gemini 4 on intelligence AND costs less than half ($0.72 vs $1.99) per task."
El compromiso está en la honestidad. La tasa de alucinación de 6.1 Sol es del 54 % con esfuerzo máximo, frente al 15 % de Argon. En mi prueba eso no se notó en la práctica: inventó 0 de 8 respuestas a las trampas incluso en modo bare, y fue el único modelo junto con Astra que lo consiguió. La API también tiene algunas asperezas: 6.1 Sol no acepta esfuerzo none, y Chat Completions solo funciona sin llamadas a herramientas, así que planifica con la Responses API.
Pros: mismo precio por token que la promoción de Argon; 2,7 veces más barato por tarea; disponible hoy; 0/8 inventadas en mi prueba en modo bare.
Contras: unas 3,5 veces la tasa de alucinación de Argon en el índice; sin esfuerzo none; tope de salida de 128K.
Precios: $2 de entrada, $0,10 en caché, $10 de salida por 1M de tokens; los prompts de más de 272K de entrada se facturan a tarifas más altas. Desglose completo en GPT-6.1 Sol pricing.
Mi opinión: es la elección por defecto. Te da el precio de Argon hoy, a cerca de un tercio del coste por tarea de Argon, y siempre puedes hacer un A/B con Argon cuando Google abra la API.
2. Claude Opus 5.5: el techo más alto
Ideal para: programación difícil, ejecuciones largas de agentes y trabajo experto en el que querías Argon por su puntuación.
Si el atractivo era "el modelo de frontera de Google", Claude Opus 5.5 es el modelo de frontera que puedes usar. Puntúa 57,6 en Artificial Analysis con esfuerzo máximo, unos 5 puntos por encima de Argon, y va por delante en Terminal-Bench 4.0 allí (59,6 % frente a 57,1 %). Su tarjeta de precios también te sonará: $4 de entrada, $0,20 en caché, $20 de salida es exactamente lo que costará Argon tras la promoción.
La comparación justa es con esfuerzo medio. Opus 5.5 medium puntúa 51,2 por $1,34 la tarea, más o menos el nivel de Argon por menos dinero. Un comentarista de HN dijo lo mismo con esfuerzo alto:
"It's comparable to Opus 5.5 on "high" (54 vs 53; $1.82 vs $1.99), crushes every model except the most modern OAI/Ant ones, has way lower hallucination than every existing model and probably broader support for multimodal like existing Gemini models."
Esa cita también es el argumento honesto en contra de Opus. Su tasa de alucinación es del 59 % en max y del 68 % en medium, así que adivina más que Argon cuando no está seguro de la respuesta. Si tu trabajo es investigación abierta, donde nadie contrasta la respuesta con una fuente, eso importa mucho.
Pros: la puntuación más alta aquí; la tarjeta de precios de Argon tras la promoción; programación en terminal potente; contexto de 1M.
Contras: $5,98 la tarea en max; adivina más a menudo que Argon; un proveedor más que gestionar.
Precios: $4 de entrada, $0,20 de lectura de caché, $20 de salida por 1M de tokens; Batch tiene un 50 % de descuento. Más en Claude Opus 5.5 pricing.
Mi opinión: usa Opus 5.5 en medium para trabajo al nivel de Argon, y reserva el esfuerzo máximo para las tareas en las que los 6 puntos extra se pagan solos. La reseña de Opus 5.5 explica dónde está esa línea.
3. Grok 4.7: lo más parecido a la honestidad de Argon
Ideal para: investigación, análisis y preguntas y respuestas donde una respuesta equivocada cuesta más que un "no estoy seguro".
Esta no es la opción obvia, y es la que más señalaría. Grok 4.7 tiene una tasa de alucinación del 29 % en AA-Omniscience, la más baja de cualquier modelo que puedas usar hoy. Argon está en el 15 %, y todo lo demás de esta lista está en el 47 % o más. Por cada 100 preguntas, son unas 15 respuestas erróneas para Grok, frente a unas 19 de GPT-6 Astra y unas 8 de Argon.
También coincide con Argon en ciberseguridad. En la propia tabla de Google, Argon, Grok 4.7 y GPT-6 Astra empatan con un 68 % en CWE-bench v1. El precio parece bueno sobre el papel: $2 de entrada y $6 de salida por millón, según la página de modelos de xAI, así que la salida es un 40 % más barata que la promoción de Argon.
Los inconvenientes son reales, sin embargo. La precisión de Grok en la misma prueba es del 47,5 %, menor que la de Argon, así que rechaza más y responde menos. Escribe bastante: con esfuerzo xhigh cuesta $3,74 la tarea para una puntuación de 46,4. Y por encima de 200K tokens de prompt, toda la petición se factura a $4/$12, no solo el exceso. Un comentario del día del lanzamiento señaló un hábito que vale la pena comprobar:
"What keeps both Gemini and Grok from actually being frontier class AIs is effort. Both AIs rush to give you a response even when the effort is set to the highest setting. Hopefully, Argon isn't as prone to satisficing and premature convergence compared to its predecessor"
Pros: la tasa de alucinación más baja que puedes conseguir hoy; empata con Argon en CWE-bench v1; tarifa de salida más barata; contexto de 500K.
Contras: menor precisión y puntuación que Argon; $3,74 la tarea en xhigh; salto de precio con contexto largo a partir de 200K.
Precios: $2 de entrada, $0,50 en caché, $6 de salida por 1M de tokens por debajo de 200K; $4/$1/$12 por encima. Consulta Grok 4.7 pricing.
Mi opinión: si el 15 % de Argon fue el titular que te entusiasmó, Grok 4.7 es lo más cercano que conseguirás este mes. Úsalo donde un "no lo sé" honesto valga más que una conjetura segura de sí misma, y mira la reseña de Grok 4.7 para las notas prácticas.
4. GPT-6 Astra: el gemelo de Argon en puntuación
Ideal para: equipos que ya usan OpenAI y quieren exactamente el nivel de puntuación de Argon, además del modo Ultrafast.
GPT-6 Astra es el modelo con el que Artificial Analysis alineó a Argon: 52,7 para Astra con esfuerzo máximo, 52,6 para Argon. En precisión, Astra va claramente por delante, 63 % frente al 50 % de Argon. En alucinación está en el 51 %, así que adivina más a menudo cuando no sabe.
También es más eficiente en tokens. Astra escribe unos 27K tokens de salida por tarea frente a los 62K de Argon, por lo que Artificial Analysis dice que la ventaja de coste de Argon viene del precio, no de escribir menos. Astra cuesta $3,26 la tarea; Argon cuesta $1,99 durante la promoción y $3,98 después, así que tras la promoción, Astra es el más barato de los dos. En mi prueba, Astra inventó 0 de 8 respuestas a las trampas en modo bare, empatado con 6.1 Sol como el resultado más limpio de todos.
Pros: misma puntuación que Argon; mayor precisión; más barato por tarea que Argon tras la promoción; modo Ultrafast disponible ya; 0/8 inventadas en mi prueba.
Contras: $10/$50 por millón; 6.1 Sol es casi igual de bueno por una quinta parte del coste por tarea; 51 % de alucinación en el índice.
Precios: $10 de entrada, $1 en caché, $50 de salida por 1M de tokens; Batch y Flex con un 50 % de descuento. Consulta GPT-6 Astra pricing.
Mi opinión: Astra tiene sentido si necesitas Ultrafast o ese último punto de precisión hoy. Para todos los demás, GPT-6.1 Sol da casi el mismo resultado por mucho menos, y la guía de alternativas a GPT-6.1 Sol compara el panorama más amplio.
5. Claude Sonnet 5.5: la opción para flujos con agentes al mismo precio de lista
Ideal para: agentes de varios pasos y programación en terminal, donde te llamó la atención la ventaja de Argon en AutomationBench.
La cifra independiente más llamativa de Argon es el AutomationBench: 77,5 % en Artificial Analysis, n.º 1. El modelo más cercano que puedes usar es Claude Sonnet 5.5 con esfuerzo máximo, con un 71,3 %. Sonnet también supera a Argon en Terminal-Bench 4.0 allí (63,6 % frente a 57,1 %), y su precio de lista es el mismo $2/$10.
Un profesional en LinkedIn resumió bien la brecha de benchmarks citando la cifra autodeclarada de cada laboratorio:
"On Terminal-Bench 4.0, the one benchmark Google and Anthropic both publish, Argon scores 57.4%. Sonnet 5.5 scores 70.6%. Same price, 13 points apart."

El coste por tarea es donde hay que mirar con más atención. Con esfuerzo máximo, Sonnet 5.5 puntúa 56,0 pero cuesta $7,62 la tarea, porque escribe casi 194K tokens de salida por tarea. Con esfuerzo alto son 46,7 por $1,08. Y si tu agente fuerza una llamada a herramienta con tool_choice, Sonnet 5.5 devuelve un 400, así que compruébalo antes de cambiar.
Pros: mismo precio de lista de $2/$10 que la promoción de Argon; las mejores puntuaciones en AutomationBench y terminal que puedes usar; la menor alucinación de los modelos Claude (47 % en max).
Contras: $7,62 la tarea en max; el tool_choice forzado devuelve un error; recuento alto de tokens con esfuerzo alto.
Precios: $2 de entrada, $0,20 de lectura de caché, $10 de salida por 1M de tokens; Batch $1/$5. Consulta Claude Sonnet 5.5 pricing.
Mi opinión: para trabajo con agentes, Sonnet 5.5 es el sustituto más sólido. Empieza con esfuerzo alto y sube solo cuando el agente siga fallando en los mismos pasos; la reseña de Sonnet 5.5 tiene las cuentas del esfuerzo.
6. Claude Fable 5.1: el modelo más preciso, a precio premium
Ideal para: trabajo experto en el que revisas cada respuesta de todos modos y la precisión importa más que el coste.
Claude Fable 5.1 es el modelo de disponibilidad general más capaz de Anthropic, y puntúa 53,4 en Artificial Analysis, ligeramente por encima de Argon. Tiene la mayor precisión de todos los modelos de este artículo, 67 %, y también la mejor puntuación de razonamiento de contexto largo entre los modelos cerrados, con un 85,3 %.
También tiene la tasa de alucinación más alta de aquí, 73 %, que es la imagen especular de Argon. Fable responde bien más preguntas, y también responde más preguntas que no debería. Eso está bien para un abogado o un analista que lee cada línea, y menos bien para cualquier cosa que vaya directa a un cliente.
Luego está el precio: $10 de entrada y $50 de salida, con lecturas de caché a $0,25. Con esfuerzo máximo son $7,63 la tarea. Un empleado de Google en LinkedIn usó justo esa diferencia para promocionar Argon:
"I've been testing it using our internal AI tool, and the performance is incredible. What stands out more is the cost. 5x cheaper than GPT-6 Astra and Claude Fable 5.1 at current pricing."
Eso es por token al precio promocional. Por tarea de Artificial Analysis, Argon es unas 3,8 veces más barato que Fable, que sigue siendo una gran diferencia.
Pros: la mayor precisión aquí; razonamiento de contexto largo sólido; lecturas de caché baratas para un modelo de frontera; 128K de salida.
Contras: $10/$50 por millón; 73 % de tasa de alucinación; el uso forzado de herramientas devuelve un 400.
Precios: $10 de entrada, $0,25 de lectura de caché, $50 de salida por 1M de tokens; Batch $5/$25. Consulta Claude Fable 5.1 pricing.
Mi opinión: Fable es la elección cuando un experto humano revisa la salida y quiere el modelo con más probabilidades de acertar. Para cualquier cosa sin supervisión, Opus 5.5 o 6.1 Sol es la inversión más segura.
7. Gemini 3.8 Flash: el modelo de Google sobre el que de verdad puedes construir
Ideal para: equipos comprometidos con Google Cloud o AI Studio, prototipos en el plan gratuito y trabajo por lotes barato.
Si quieres quedarte con Google hasta que se abra Argon, Gemini 3.8 Flash es el mejor modelo Gemini de la API según las cifras de Artificial Analysis, con 40,9 con esfuerzo alto. Está muy por detrás de los 52,6 de Argon y por delante de los 29,7 de Gemini 3.1 Pro Preview, que es lo que desconcierta a la gente: el Flash más nuevo puntúa más que el Pro más antiguo.
Es barato y además tiene plan gratuito. La página de precios de Gemini indica $0,75 de entrada y $3,75 de salida hasta el 31 de diciembre de 2026, y luego $1,50 y $7,50 desde el 1 de enero de 2027. Mejor presupuestar con la tarifa de 2027.
Mi prueba es la advertencia aquí. En modo bare, Gemini 3.8 Flash inventó 4 de 8 respuestas, incluida la de HIPAA y una dirección de correo de soporte que no existe. Con la regla de "no adivines" puesta, no inventó ninguna. Así que es un buen modelo para soporte si le das las reglas estrictas, y uno arriesgado si no. Un comentarista de HN tenía otra preocupación sobre el caché de Google:
"And this pricing is their 'discount pricing'. Add that to AI studio and Vertex's famously terrible caching, it is hard to see this as competitive."
Pros: la mejor puntuación Gemini en la API hoy; plan gratuito; el modelo cerrado más barato aquí; respuestas de 2,6 s de media en mi prueba.
Contras: muy por debajo de la puntuación de Argon; el precio se duplica el 1 de enero de 2027; inventó 4 de 8 respuestas sin un prompt estricto.
Precios: $0,75 de entrada, $0,075 de lectura de caché, $3,75 de salida por 1M de tokens hasta el 31 de diciembre de 2026, luego $1,50/$0,15/$7,50. Consulta Gemini 3.8 Flash pricing.
Mi opinión: si piensas pasarte a Argon más adelante, construir ahora sobre 3.8 Flash te mantiene en la misma API y herramientas. Solo escribe la regla de "no adivines" en el prompt desde el primer día. La reseña de Gemini 3.8 Flash cubre el resto.
8. Gemini 3.1 Pro Preview: la opción cuidadosa de Google
Ideal para: equipos del ecosistema Google que quieren menos respuestas inventadas que con Flash y pueden vivir con una puntuación más baja.
Gemini 3.1 Pro Preview es el modelo Pro más nuevo al que mi clave de API pudo acceder, y sobre el papel es el predecesor de Argon. Artificial Analysis dice que Argon le saca +23 puntos, lo que coincide con el snapshot: 29,7 para 3.1 Pro. Su página del modelo indica un límite de entrada de 1.048.576 tokens y uno de salida de 65.536 tokens.
El motivo de que esté en esta lista es el comportamiento, no la puntuación. Su tasa de alucinación es del 51 %, algo mejor que el 55 % de 3.8 Flash, y su precisión es del 55 %. En mi prueba en modo bare inventó 1 de 8 respuestas frente a las 4 de Flash. También fue mi ejecución más lenta y cara, con unos 6 a 9 segundos y $6 a $10 por cada 1.000 respuestas, porque gasta muchos tokens en pensar.
Pros: menos respuestas inventadas que 3.8 Flash en mi prueba; contexto de entrada de 1M; Batch a mitad de precio.
Contras: la puntuación más baja de Artificial Analysis de esta lista; sigue siendo un modelo en preview; lento y con muchos tokens; recargo por contexto largo por encima de 200K.
Precios: $2 de entrada, $0,20 en caché, $12 de salida por 1M de tokens hasta 200K; $4/$0,40/$18 por encima; Batch $1/$6; sin plan gratuito. Más en la guía de precios de Gemini.
Mi opinión: solo elegiría 3.1 Pro si estás atado a Google y el trabajo consiste en respuestas cuidadosas y de bajo volumen. Para casi todo lo demás, 3.8 Flash o el modelo de otro laboratorio es mejor inversión hasta que Argon se abra.
9. Kimi K3: pesos abiertos y la mejor puntuación de contexto largo
Ideal para: equipos que necesitan autoalojar, o que querían Argon para documentos muy largos.
Argon es cerrado, así que si necesitas pesos que puedas descargar, la lista se vuelve bastante corta. Kimi K3, de Moonshot AI, publica sus pesos completos en Hugging Face con una licencia propia y puntúa 43,6 en Artificial Analysis con esfuerzo máximo. También tiene la mejor puntuación de razonamiento de contexto largo de cualquier modelo que revisé, 88,7 %, frente al 79,7 % de Argon.
En la API alojada cuesta $3 de entrada, $0,30 en caché y $15 de salida por millón, según la página de precios de Kimi, así que es más caro que la promoción de Argon por token. Por tarea son $2,00, más o menos lo mismo que Argon. El razonamiento no se puede desactivar.
La opción abierta más barata es DeepSeek V4.1 Flash, con licencia MIT, a $0,15/$0,60 por millón en horas valle y $0,27 la tarea. Yo lo mantendría lejos de cualquier cosa de cara al cliente que necesite honestidad al estilo de Argon: su tasa de alucinación en el índice es del 96 %.
Pros: los pesos abiertos más potentes de esta lista; la mejor puntuación de razonamiento de contexto largo de aquí; contexto de 1M; entrada de imagen y vídeo.
Contras: licencia propia, no MIT ni Apache; la API alojada cuesta más por token que la promoción de Argon; 53 % de tasa de alucinación.
Precios: $3 de entrada, $0,30 de acierto de caché, $15 de salida por 1M de tokens. Consulta Kimi K3 pricing.
Mi opinión: Kimi K3 es la elección para autoalojar, y también para trabajo con muchos documentos. Si solo necesitas la API alojada, 6.1 Sol es más barato y puntúa más.
Si querías Argon para trabajo de seguridad
Los primeros usuarios de Argon son los equipos de seguridad, así que algunos lectores vinieron por eso. Las cifras de Google son bastante sólidas: 85,8 en su benchmark de vulnerabilidades del mundo real frente a 71,0 de Gemini 3.8 Flash Cyber, y 70,9 % frente a 58,2 % en la prueba de penetración de caja negra de Wiz, según el post de lanzamiento.
Todos los laboratorios de frontera restringen de forma parecida su modelo de seguridad más potente. Claude Mythos 5.1, de Anthropic, está tras Project Glasswing, y GPT-5.6-Cyber, de OpenAI, tras su propio programa de acceso de confianza. Si no estás en ninguno de estos programas, la guía de alternativas a Codex Security Cloud cubre las herramientas a las que puedes registrarte hoy. Entre los modelos generales de arriba, GPT-6 Astra y Grok 4.7 empatan con Argon en CWE-bench v1, así que son un punto de partida razonable.
Qué dice mi prueba sobre la alucinación en soporte
La prueba cambió cómo leo la cifra estrella de Argon. Una tasa de alucinación del 15 % es un resultado a libro cerrado: el modelo responde preguntas de cultura general sin nada delante. Un bot de soporte no es a libro cerrado. Tiene tu centro de ayuda, tus macros y tus políticas, y sus instrucciones le dicen qué hacer cuando eso se acaba. En ese montaje, la instrucción hizo más trabajo que el modelo: 0 de 40 respuestas inventadas con la regla, hasta 4 de 8 sin ella.
eesel también ha visto el fallo del modo bare en colas reales. A principios de este año, algunos clientes de pago de eesel tenían bots que respondían a clientes reales con conocimiento general cuando la base de conocimiento devolvía un resultado vacío, y uno respondió una pregunta de soporte con "Oxygen". Otro equipo, un grupo de soporte técnico B2B en Zendesk, se preocupaba por otro motivo: su centro de ayuda decía "we support all models", y el bot confirmaba encantado productos que no soportaban. Ninguno de los problemas era el modelo. Los dos eran de fundamentación en fuentes y de respaldo, por lo que lo primero que revisaría en cualquier bot de soporte es una regla firme de "di que no lo sabes y pasa el caso", probada con tickets pasados antes de salir en vivo.
Eso es también lo que piden los compradores. Un responsable de CX con unos 7.000 tickets al mes dijo al equipo de eesel en una llamada de ventas que la IA solo debería tomar los tickets de los que esté segura y dejar el resto a los humanos. Eso es una regla de traspaso. La honestidad de Argon sería un buen respaldo, pero puedes fijar la regla hoy, en cualquier modelo. Las guías de prevención de alucinaciones de IA y de escalado con IA explican cómo.
Prueba eesel

Si esperabas a Argon para que tu bot de soporte fuera más fiable, no tienes que esperar. eesel es un compañero de helpdesk con IA que se une a tu cola existente en Zendesk, Freshdesk o Gorgias, aprende de tu centro de ayuda y de tus tickets pasados, y solo responde lo que puede fundamentar. Antes de responder a nadie, ejecuta una simulación sobre tu historial de tickets, así que ves qué preguntas responde y cuáles pasa a una persona. Cuando Argon se abra, el modelo puede cambiar mientras tus reglas siguen igual.
Si trabajas desde una terminal, la CLI de eesel maneja el mismo compañero y el mismo espacio de trabajo que el panel. Puedes automatizar una simulación sobre un lote de tickets antiguos, volcar las respuestas en tu propia hoja de revisión y dejar que un agente de programación como Claude Code, Codex o Cursor lo configure por ti. Prueba eesel gratis y ejecútalo con tus propios tickets antes de elegir el modelo.
Preguntas frecuentes
¿Cuál es la mejor alternativa a Gemini 4 Argon ahora mismo?
¿Ya puedo usar Gemini 4 Argon?
gemini-4-argon, y no estaba entre los 61 modelos que mi clave podía listar. Google dice que los clientes de pago de la API y los suscriptores de Google AI Ultra son los siguientes, sin fecha. La guía de Gemini 4 Argon recoge lo que se sabe.¿Qué alternativa a Gemini 4 Argon alucina menos?
¿Hay una alternativa de Google a Gemini 4 Argon?
¿Es GPT-6.1 Sol más barato que Gemini 4 Argon?
¿Cuál es la mejor alternativa de pesos abiertos a Gemini 4 Argon?
¿Necesito Gemini 4 Argon para un bot de atención al cliente?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.