Qué es realmente Cohere Embed 5
Cohere es la empresa de IA empresarial detrás de los modelos Command, Rerank y el analizador de documentos Parse 5. Un modelo de embeddings es la parte silenciosa de cualquier sistema de búsqueda o RAG: la pieza que convierte un fragmento de texto (o una imagen) en una lista de números, y los fragmentos con significado parecido acaban cerca unos de otros. Cuando un usuario pregunta algo, esa pregunta también se convierte en números, y el sistema recupera los fragmentos más cercanos.
Cuando el modelo de embeddings es débil, la respuesta correcta simplemente nunca se recupera, y un prompt ingenioso no lo va a arreglar. Es la misma capa que impulsa la búsqueda empresarial con IA.
Embed 5 toma el relevo de Embed 4 como modelo estrella de Cohere y viene en dos niveles: Pro, "optimized for maximum quality across multimodal, multilingual, financial, code, and parsed-document retrieval", y Fast, que "brings highly competitive performance to latency- and cost-sensitive workloads".
Construyo agentes de IA para vivir en eesel, y la recuperación es la capa donde se va la mayor parte de mi tiempo de depuración, así que estas especificaciones fueron lo primero que busqué. Aquí están lado a lado, sacadas de la documentación del modelo de Cohere y de su publicación de lanzamiento:
| Embed 5 Pro | Embed 5 Fast | Embed 4 (anterior) | |
|---|---|---|---|
| ID del modelo en la API | embed-v5.0-pro | embed-v5.0-fast | embed-v4.0 |
| Precio del texto (por 1M de tokens) | 0,12 $ | 0,08 $ | 0,12 $ |
| Precio de la imagen (por 1M de tokens) | 0,40 $ | 0,40 $ | 0,47 $ |
| Longitud de contexto | 128K tokens | 128K tokens | 128K tokens |
| Entradas | Texto, imágenes, texto + imagen fusionados | Texto, imágenes, texto + imagen fusionados | Texto, imágenes, mixtas |
| Dimensiones de salida | 256 a 2048 (por defecto 2048) | 256 a 2048 (por defecto 2048) | 256 a 1536 (por defecto 1536) |
| Formatos | float, int8, binary | float, int8, binary | float, int8, binary |
| Idiomas | 100+ | 100+ | Multilingüe |
| Ideal para | Indexación sin conexión, búsqueda donde la calidad es crítica | Consultas en vivo, bucles de agentes, alto volumen |
Las tarifas de Embed 4 vienen de los precios de Cohere en Microsoft Foundry, ya que la página de precios de Cohere ya no lista Embed 4. Si vienes de la serie 3 de OpenAI, ten en cuenta que sus precios de API siguen llegando como máximo a 0,13 $ para text-embedding-3-large. En la tabla de Cohere hay dos detalles pequeños que la gente suele pasar por alto. La salida por defecto subió de 1536 a 2048 dimensiones, algo que importa para el almacenamiento (más sobre esto abajo), y además la entrada de imágenes se abarató, de 0,47 $ a 0,40 $ por 1M de tokens.
Cómo funciona Embed 5: indexar con Pro, consultar con Fast
Esta es la función alrededor de la que yo construiría, y es la que menos bombo lleva. La mayoría de las familias de embeddings, incluida la API de embeddings de OpenAI, te obligan a elegir un modelo y quedarte con él, porque los vectores de dos modelos distintos no son comparables. Cohere entrenó Pro y Fast en un único espacio compartido, de modo que una consulta convertida en embedding con Fast se puede comparar directamente con documentos convertidos con Pro.
Esto importa porque indexar y consultar piden cosas opuestas. La indexación ocurre una vez (o en cada actualización de un documento) y nadie espera por ella, así que aquí quieres la mejor calidad que el dinero pueda comprar. La consulta es otra historia: ocurre en cada petición del usuario y dentro de tu presupuesto de latencia, lo que significa que lo que cuenta es la velocidad. Tener un espacio compartido te permite elegir cada lado por separado.
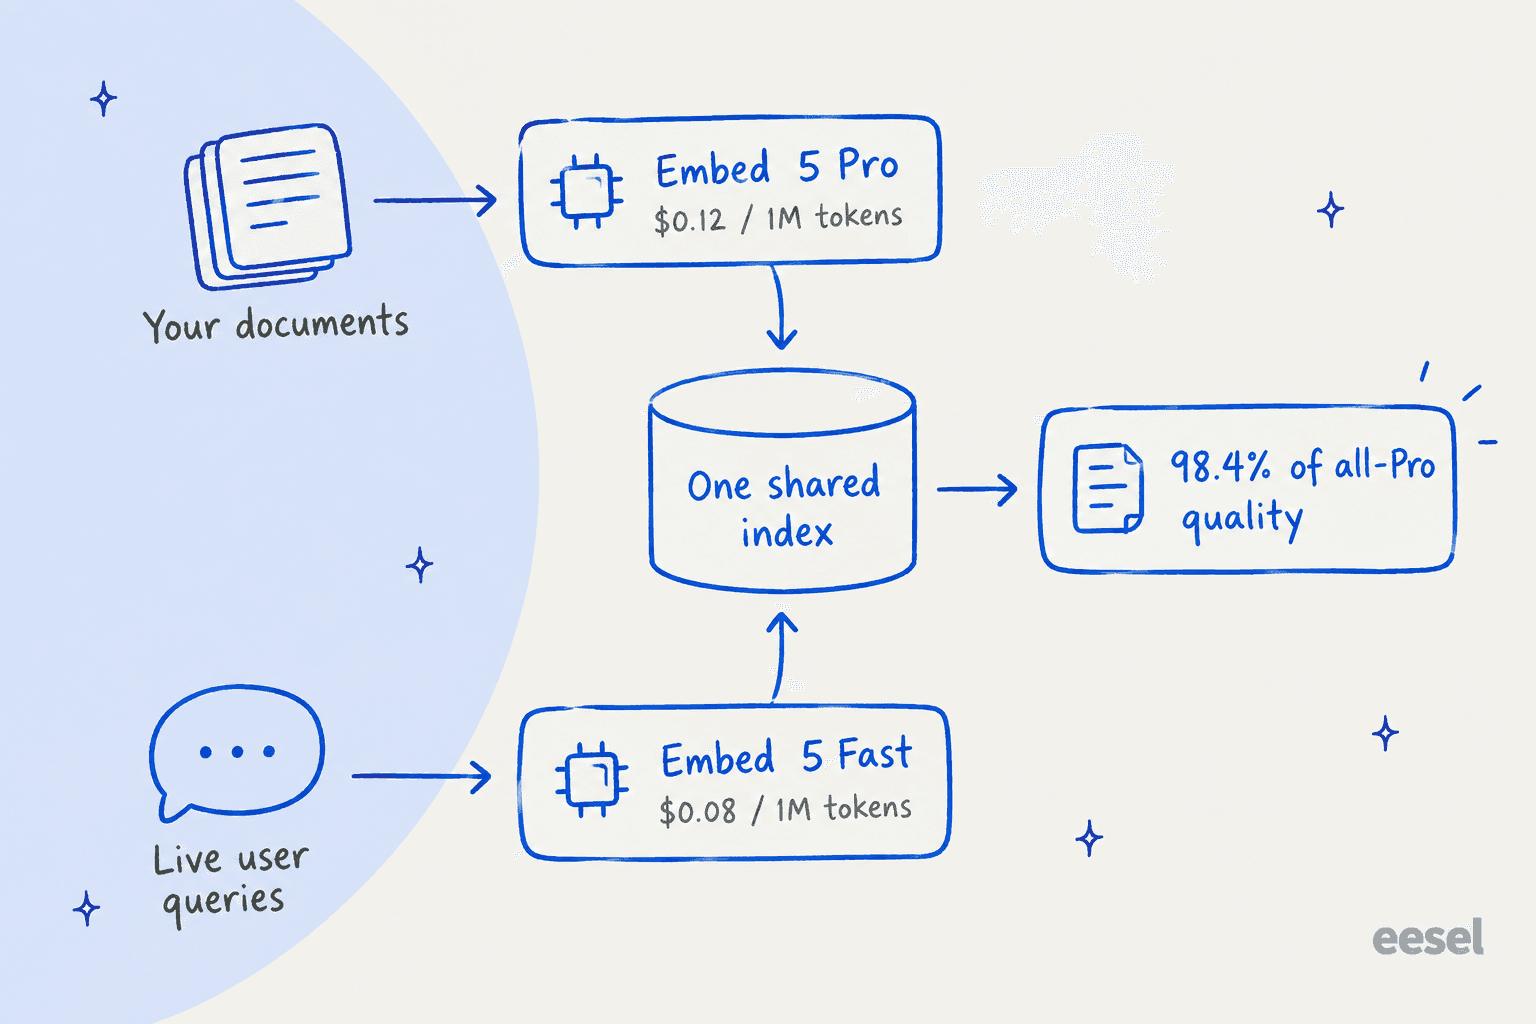
Cohere probó todas las combinaciones en 40 conjuntos de datos de desarrollo y luego normalizó las puntuaciones de modo que documentos de Pro más consultas de Pro sea igual a 100:
| Calidad media de recuperación | Documentos indexados con Fast | Documentos indexados con Pro |
|---|---|---|
| Consultas con Fast | 96.6 | 98.4 |
| Consultas con Pro | 97.3 | 100 |
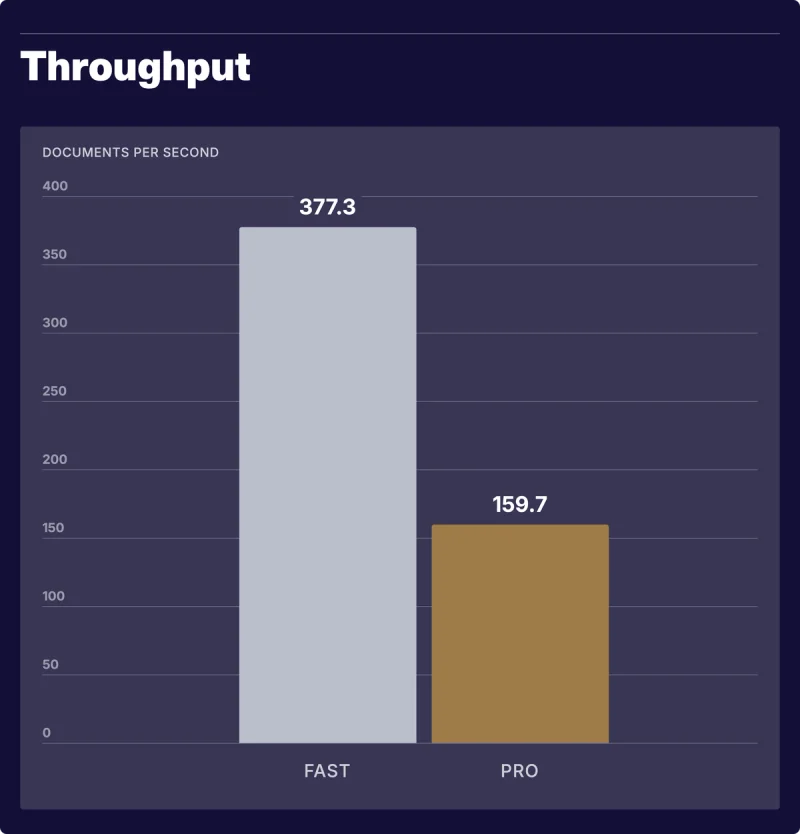
Así que índice de Pro más consultas de Fast llega a 98,4, una pérdida del 1,6%, mientras Fast hace el trabajo de tiempo de consulta con aproximadamente 2,4 veces el rendimiento de Pro (377,3 frente a 159,7 documentos por segundo en la prueba de Cohere). El propio Cohere recomienda exactamente este patrón, y en la nota al pie está la condición que conviene conocer: ambos lados deben usar la misma dimensión de salida. El emparejamiento sigue funcionando al añadir truncamiento Matryoshka y cuantización int8, así que también sirve con un índice comprimido.
Algunos detalles de la API, de la referencia de Embed, que condicionan cómo la llamas:
input_typees obligatorio. Usasearch_documental indexar ysearch_queryal consultar. También hay modosclassificationyclustering.- 96 entradas por llamada. Cada entrada puede mezclar partes de texto e imagen, con un tope de 20 MB de carga total.
- El truncamiento por defecto es
END. Con un contexto de 128K es raro llegar a él, pero si prefieres recibir un error antes que perder en silencio el final de un documento largo, pontruncateenNONE. - Los límites de uso son por entrada, no por solicitud: 2.000 entradas de texto por minuto tanto con claves de prueba como de producción, y 5 frente a 400 entradas de imagen por minuto, según la página de límites de uso. Las claves de prueba son gratuitas pero limitadas a 1.000 llamadas al mes y no se permiten en producción.
Los benchmarks: sólidos, pero lee la letra pequeña
Los números que publicó Cohere son buenos. Abajo está la tabla principal de ViDoRe V3, que cubre documentos empresariales de ocho dominios:
| Modelo | Promedio ViDoRe V3 | Precio del texto por 1M de tokens |
|---|---|---|
| Cohere Embed 5 Pro | 85.8 | 0,12 $ |
| Cohere Embed 5 Fast | 84.5 | 0,08 $ |
| Voyage 4 Large | 83.7 | 0,12 $ |
| Gemini Embedding 2 | 83.2 | 0,20 $ |
| Cohere Embed 4 | 77.0 | 0,12 $ |
| OpenAI text-embedding-3-large | 75.5 | 0,13 $ |
| Jina Embeddings v5 Text Small | 74.5 | 0,05 $ |
En la misma prueba, Pro gana 8,8 puntos sobre Embed 4, y los mayores saltos están en RR. HH. (+11,4) y en documentos industriales (+10,3). También lidera la suite de PDF analizados de Cohere con 84,8. En recuperación financiera queda primero en FinanceBench (80,1) y FinQA (90,0), además de ViDoRe V3 Finance (85,0), con Fast en segundo lugar en todos.
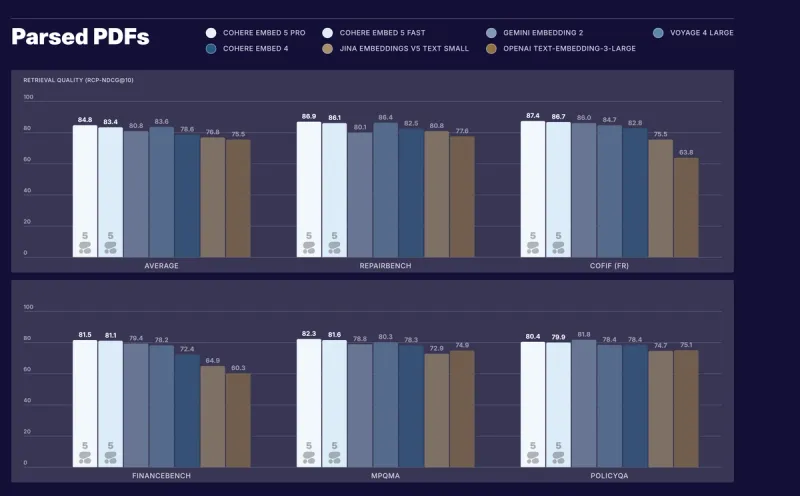
Para mí el resultado más impresionante es en realidad Fast. Frente a otros modelos compactos en ViDoRe V3 puntúa 84,5, donde Voyage 4 Nano saca 77,6 y Qwen3-VL-Embedding saca 64,2. La leyenda del propio gráfico de Cohere (abajo) lista Fast con unos 1B de parámetros, 500M de texto más 500M de visión, y la publicación de lanzamiento dice que supera a Qwen3-VL-Embedding-2B por unos 20 puntos pese a tener aproximadamente la mitad de tamaño.
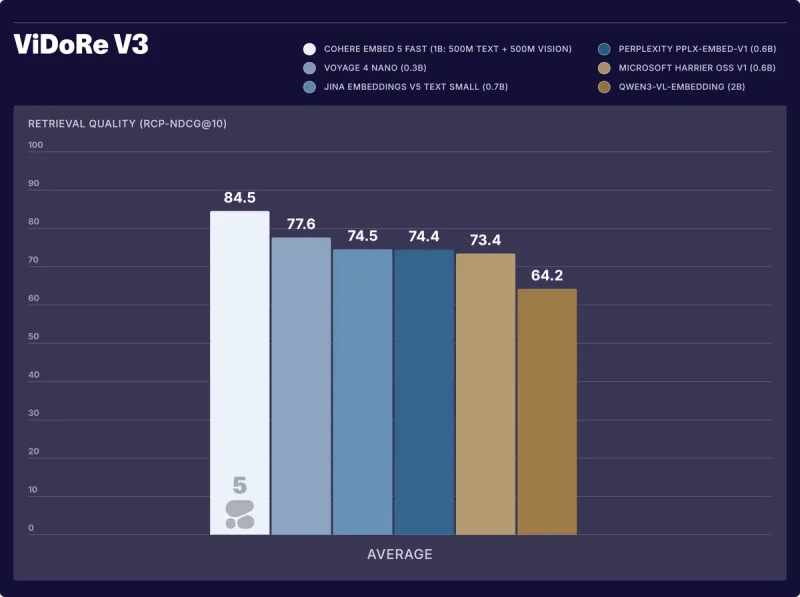
Ahora la letra pequeña, porque una lectura justa la necesita.
Es una métrica nueva, ejecutada por el proveedor. Embed 5 es la primera familia de modelos puntuada con RCP-nDCG@10, un método que Cohere publicó el mismo día. La propia nota al pie de Cohere dice que evalúa los modelos reordenando un conjunto fijo de candidatos, así que "scores therefore reflect reranking quality rather than first-stage retrieval performance." Es una forma razonable de medir, y el código es público, pero no es el mismo número que obtendrías ejecutando una búsqueda top-10 simple sobre todo tu índice. Además, algunos de los conjuntos de datos son internos, como el de "High Finance", que Cohere anotó por sí misma.
Gemini Embedding 2 gana en la mayoría de los idiomas no europeos. Pro lidera el conjunto europeo (77 de promedio entre alemán, francés, español, italiano y ruso). Pero en la tabla de diez idiomas del propio Cohere, Gemini Embedding 2 supera a Pro en 9 de 10: japonés, coreano, árabe, farsi, hindi, bengalí, telugu, indonesio y tailandés. Pro solo lo supera por poco en chino (82 frente a 81). El telugu es la mayor brecha, 91 frente a 80.
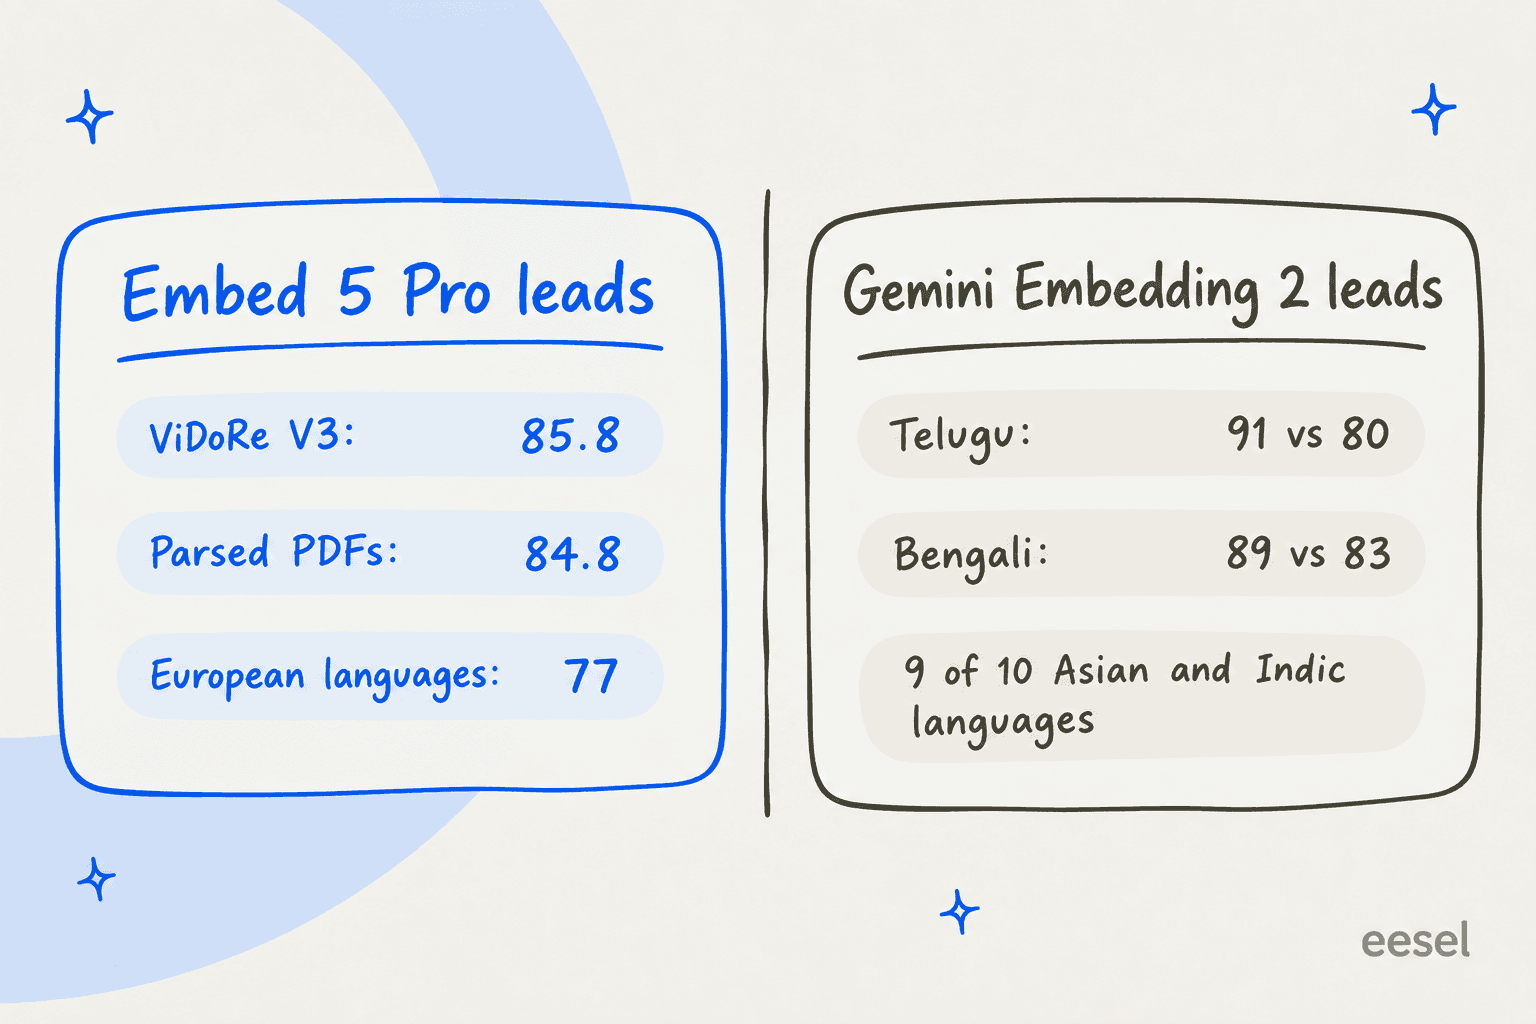
Si tu cola de soporte o tu base de documentos depende mucho del hindi, el tailandés o el bengalí, esa tabla es lo más útil de todo el lanzamiento, y hay que reconocerle a Cohere que la haya publicado. Para un equipo que sirve una base de conocimiento multilingüe en Europa y en inglés, Pro es la opción más fuerte según estos números.
La reacción de la comunidad aún es temprana y escasa, lo esperable un día después de un lanzamiento. La voz más útil de un profesional que encontré es más antigua y trata de los embeddings de Cohere en general, no de Embed 5 en sí:
"My experience with Cohere and interacting with their sales engineers has been boring, I say that is the most flattering way possible. Embeddings are a core service at this point like VMs and DBs. They just need to work and work well and thats what they're selling."

Eso encaja bastante bien con la propuesta. Embed 5 no intenta ser emocionante, intenta ser la capa aburrida y fiable que va debajo de tu búsqueda.
Precios de Cohere Embed 5
La facturación de Embed 5 es por token de entrada, y no hay cargo por la salida. Esto es todo lo que Cohere publica, de la página de precios y de la publicación de lanzamiento:
| Opción | Embed 5 Pro | Embed 5 Fast | Unidad de facturación |
|---|---|---|---|
| API de Cohere, texto | 0,12 $ por 1M de tokens | 0,08 $ por 1M de tokens | Tokens de entrada |
| API de Cohere, imágenes | 0,40 $ por 1M de tokens | 0,40 $ por 1M de tokens | Tokens de imagen |
| Clave de prueba | Gratis, 1.000 llamadas al mes | Gratis, 1.000 llamadas al mes | No apta para producción |
| Model Vault Small | 3,00 $/hora o 2.000 $/mes | 3,00 $/hora o 2.000 $/mes | Por instancia dedicada |
| Model Vault Medium | 5,00 $/hora o 3.250 $/mes | 5,00 $/hora o 3.250 $/mes | Por instancia dedicada |
| Amazon SageMaker | 2,39 $ a 8,48 $ por hora de host | 2,39 $ a 3,36 $ por hora de host | Tarifa de software más coste de la instancia AWS |
| Microsoft Foundry | Aún sin publicar (vista previa) | Aún sin publicar (vista previa) |
Las tarifas de SageMaker vienen de los listados de AWS Marketplace para Embed 5 Pro, con un listado equivalente para Fast. Cohere factura al final de cada mes, o antes si llegas a 250 $ pendientes. Para el resto del catálogo (Rerank, Parse, Command), consulta mi guía completa de precios de Cohere. Si además analizas PDF, el desglose de precios de Parse 5 cubre ese medidor.
Tres notas de facturación que me gustaría haber sabido antes de fijar un presupuesto:
- El conteo de tokens de imagen no está documentado. El precio es por 1M de tokens de imagen, pero Cohere no publica una fórmula de tokens por imagen. La respuesta de la API reporta las imágenes como un conteo (
"images": 1), así que haz una prueba con un lote pequeño y lee la factura antes de generar embeddings de un millón de imágenes de página. - Model Vault solo compensa con un volumen muy alto. Una instancia Small a 2.000 $ al mes equivale a unos 16.700 millones de tokens de Pro, o 25.000 millones de Fast, a tarifas de API. Por debajo de eso, la API sale más barata. Si eliges Vault, las razones reales son el aislamiento y la capacidad garantizada, no el precio.
- Aún no está en Bedrock. Amazon Bedrock sigue listando Embed 4 a 0,12 $ por 1M de tokens, sin SKU de Embed 5. OpenRouter no incluye ningún modelo de embeddings de Cohere.
Por qué el precio por token es el número menos importante aquí
Hagamos las cuentas de una configuración de soporte realista, ya que es el mundo en el que paso mis días de trabajo. Supón que tienes 2.000 artículos del centro de ayuda (unos 1.500 tokens cada uno) y 200.000 tickets pasados (unos 600 tokens cada uno), aproximadamente 123 millones de tokens en total. Generar embeddings de todo una vez con Pro cuesta unos 14,76 $. Con Fast, unos 9,84 $. Cincuenta mil preguntas de clientes al mes con 30 tokens cada una son 1,5 millones de tokens, unos 12 centavos con Fast. Es decir, la factura de embeddings es básicamente un error de redondeo.
Lo que no se redondea es el almacenamiento, que escala con dimensiones y precisión. El ejemplo del propio Cohere: un vector float32 de 2048 dimensiones pesa 8 KB, un vector int8 de 1024 dimensiones pesa 1 KB y un vector binario de 256 dimensiones pesa 32 bytes.
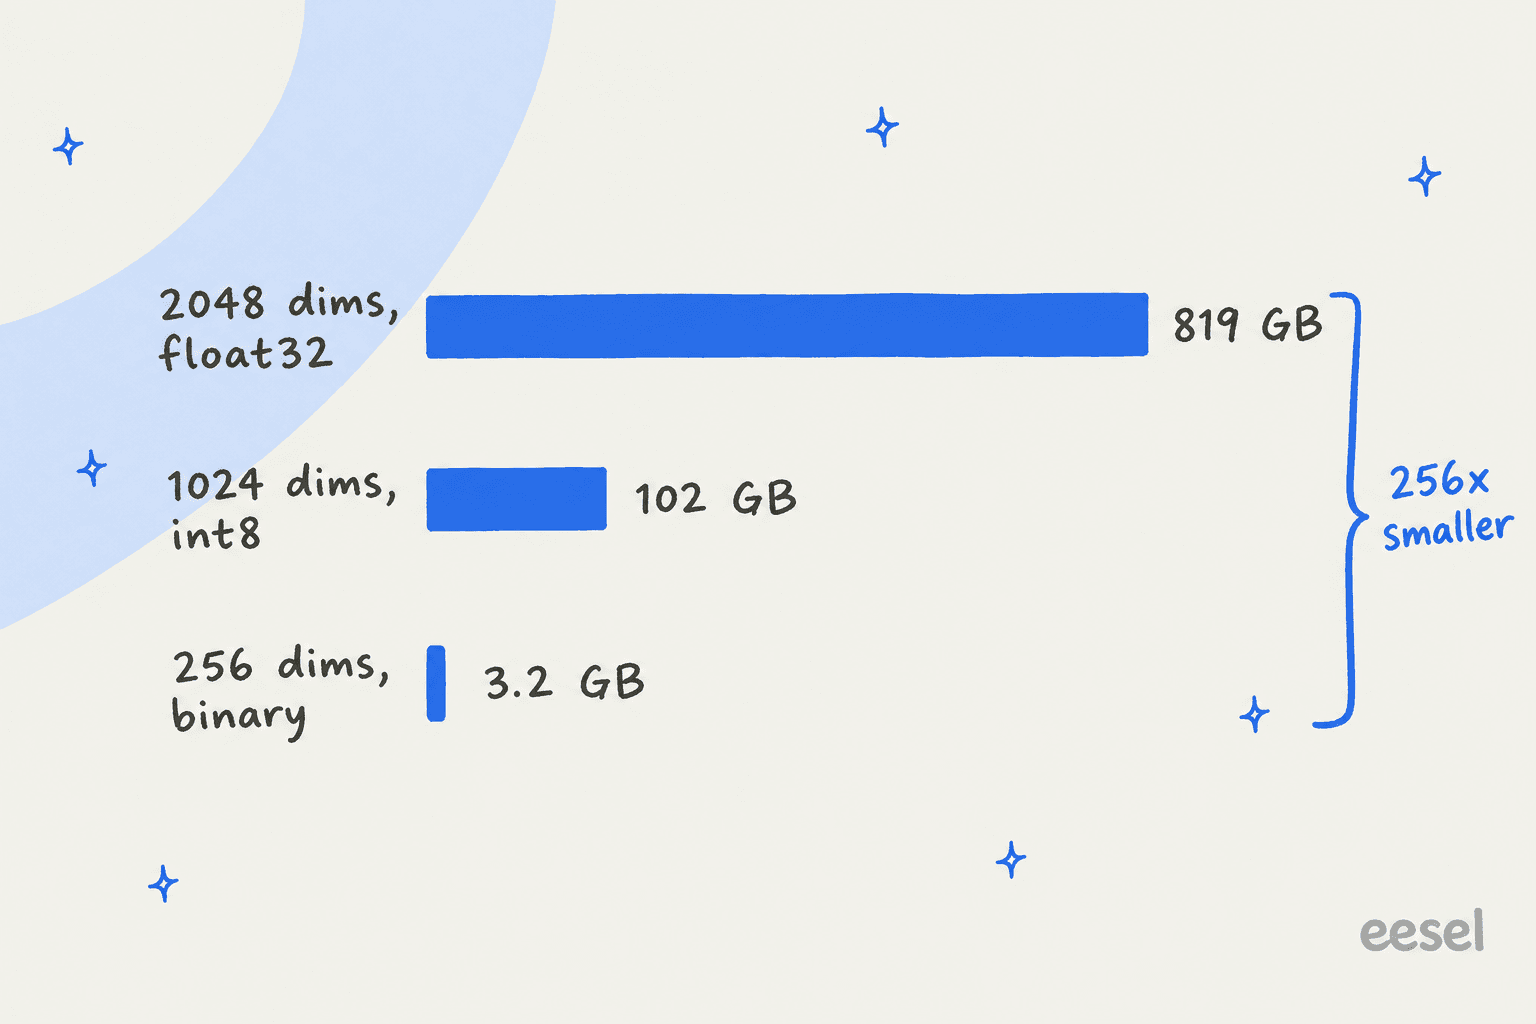
Con 100 millones de fragmentos, la salida float32 por defecto son unos 819 GB de vectores en bruto. En el plan Standard de Pinecone (o un almacén de vectores alojado) a 0,33 $ por GB al mes, eso son unos 270 $ al mes antes de la sobrecarga del índice, cada mes. Los mismos fragmentos en int8 de 1024 dimensiones son unos 102 GB, unos 34 $ al mes. Generar embeddings de esos 100 millones de fragmentos una sola vez (a unos 500 tokens cada uno) cuesta unos 6.000 $ con Pro, un cargo único. Elige tus dimensiones y precisión antes de indexar, porque cambiarlas después implica volver a generar todos los embeddings desde cero.
La recomendación de Cohere coincide: "For most deployments, we recommend 1,024-dimensional int8 vectors as the ideal performance-efficiency point," y int8 "retains near-full-precision retrieval quality." El binario es el más pequeño, pierde algo de precisión y funciona bien como primera pasada rápida antes de un reranker.
Migrar desde Embed 4: qué planificar
Si hoy usas Embed 4, la migración es más que cambiar el nombre del modelo. Cosas que planificar:
- Reindexa todo. Cohere dice que Pro y Fast comparten espacio entre sí. No dice nada sobre que los vectores de Embed 4 sean comparables con los de Embed 5, así que asume que no lo son y presupuesta una regeneración completa. Con los precios de arriba suele ser barato en dólares, aunque caro en tiempo de ingeniería.
- Cuidado con la dimensión por defecto. Embed 4 usaba 1536 por defecto, Embed 5 usa 2048. Si el índice de tu base de datos vectorial está fijado en 1536, pasa
output_dimension=1536(Embed 5 lo admite) o reconstruye el índice. - Revisa tu nube. Si llamas a Cohere a través de Bedrock u Oracle OCI, Embed 5 aún no está allí. Los canales de lanzamiento son la API de Cohere, Model Vault, Microsoft Foundry y SageMaker.
- Trabajos por lotes. Cohere dice que el embedding por lotes está disponible para ingestas a gran escala, pero la tabla de la documentación solo lista el endpoint estándar de Embed para los modelos v5, así que confirma que Embed Jobs sea compatible con tu modelo antes de diseñar un pipeline masivo alrededor de ello.
Antes de culpar (o elogiar) al modelo, revisa primero el resto del pipeline. Esta respuesta en un hilo de r/Rag sobre ajustar embeddings es el consejo más práctico sobre cambios de modelo que he encontrado:
"more than I expected. but only after chunking was already clean. dirty chunks make every embedding model look bad."

Eso coincide con mi propia experiencia. Si quieres un ejemplo práctico, la guía de búsqueda semántica sobre Zendesk Guide recorre la parte de la fragmentación. Un mejor modelo de embeddings ayuda más cuando la fragmentación ya es sólida y tienes búsqueda híbrida y un reranker en su sitio.
Dónde encaja Embed 5 y dónde no
Embed 5 es una gran elección si eres un equipo de plataforma que construye su propio stack de búsqueda o RAG, sobre todo con documentos largos, visualmente ricos o financieros. El contexto de 128K significa menos cortes incómodos de fragmentos, y la entrada fusionada de texto más imagen se encarga de presentaciones y páginas escaneadas. Además, la división Pro/Fast te da un mando limpio entre velocidad y calidad. Combínalo con Parse 5 para convertir PDF en Markdown y con Rerank para ordenar las coincidencias, y tendrás todo el stack de recuperación de Cohere. Cohere también anunció que su plataforma de búsqueda gestionada, Compass Cloud, está ahora en beta privada.
"Cohere seems to be doing a lot on the search side this year with their parsing model, Compass Cloud announcement, and now Embed 5... exciting stuff"
Es el nivel equivocado del stack si tu objetivo real es una herramienta de uso diario, como una base de conocimiento con IA para tu equipo o una IA que responda a las preguntas de clientes desde tu centro de ayuda y tickets pasados. Un modelo de embeddings te da vectores. Aún necesitas fragmentación, una base de datos vectorial, un reranker, un modelo de generación como GPT-6.1 Sol, salvaguardas y una forma de conectar las respuestas a tu helpdesk.
Si quieres los compromisos con más detalle, empieza por RAG frente a LLM puros. Para centros de ayuda en concreto, hay una guía aparte sobre RAG frente a ajuste fino.
La lección más dura que me llevé de ejecutar IA en colas de soporte en vivo no tiene nada que ver con la calidad de la recuperación, sino con lo que pasa cuando la recuperación vuelve vacía. He visto bots de clientes de pago responder a clientes reales con afirmaciones seguras e inventadas porque la base de conocimiento no tenía nada relevante y el modelo llenó el hueco con sus datos de entrenamiento. Un mejor modelo de embeddings lo hace menos frecuente, pero no imposible. La solución está en la capa superior: una respuesta alternativa firme cuando no se encuentra nada relevante, y pruebas con tickets reales antes del lanzamiento.
Prueba eesel si quieres las respuestas, no el pipeline
Si estás leyendo sobre modelos de embeddings por un problema de soporte, eesel es el atajo. eesel es una plataforma de compañeros de IA, y su compañero de IA para el helpdesk es todo el stack de recuperación, ya montado: se conecta a tu centro de ayuda, tu documentación y tus tickets pasados, y redacta o envía respuestas dentro de tu helpdesk, Slack o un enlace compartible. Sin vectores que dimensionar, sin índice que reconstruir cuando sale un modelo nuevo.
Se integra con los helpdesks que ya usan la mayoría de los equipos de soporte. En Zendesk responde a partir de macros y tickets resueltos; en Freshdesk y Gorgias trabaja la misma cola que tus agentes.

Antes de tocar a un cliente en vivo, eesel simula el despliegue sobre tus tickets históricos, de modo que ves de antemano las respuestas que habría enviado y la tasa de resolución. Así es como querría que cualquier resolución automatizada de tickets se ganara su lugar en una cola en vivo.
Y si has llegado aquí porque te gusta trabajar desde una terminal, la CLI de eesel te permite ejecutar el mismo compañero desde la línea de comandos: conectar una integración con eesel integrations connect, editar sus instrucciones permanentes, aprobar o denegar acciones pendientes y leer cada ejecución con eesel activity. Cada comando devuelve JSON y admite --dry-run, así que scripts y agentes de programación como Claude Code también pueden manejarlo. Hay una guía completa sobre gestionar agentes desde una terminal y una más breve sobre la CLI para atención al cliente.
Prueba eesel gratis con tus propios tickets.
Preguntas frecuentes
¿Qué es Cohere Embed 5?
embed-v5.0-pro) y Embed 5 Fast (embed-v5.0-fast), ambos con una ventana de contexto de 128K tokens y más de 100 idiomas.¿Cuánto cuesta Cohere Embed 5?
0,12 $ por 1M de tokens de texto y Embed 5 Fast cuesta 0,08 $. La entrada de imágenes cuesta 0,40 $ por 1M de tokens de imagen en ambos. Las instancias dedicadas de Model Vault empiezan en 3,00 $ la hora (2.000 $ al mes). Para la lista de precios completa de Cohere, consulta este desglose de precios de Cohere.¿Cuál es la diferencia entre Embed 5 Pro y Embed 5 Fast?
¿Es Cohere Embed 5 mejor que los embeddings de OpenAI?
¿Necesito volver a generar los embeddings de mis datos para pasar de Embed 4 a Embed 5?
output_dimension de forma explícita si el esquema de tu índice es fijo.¿Está Cohere Embed 5 disponible en Amazon Bedrock?
¿Puedo usar Cohere Embed 5 para la búsqueda en atención al cliente?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.