Precios de Cohere Embed 5 de un vistazo
Cohere lanzó la familia Embed 5 el 30 de septiembre de 2026 en dos niveles, y ambos comparten 128K de contexto y más de 100 idiomas, además de entradas que pueden ser texto, imagen o la combinación fusionada de texto e imagen. Repasé todos los precios publicados y los reuní en una tabla, tomados directamente de la página de precios de Cohere, la publicación del lanzamiento y los listados de los marketplaces en la nube:
| Opción | Precio | Facturación por | Ideal para |
|---|---|---|---|
| Clave de prueba | Gratis, 1.000 llamadas/mes | n/d (sin uso en producción) | Pruebas |
| Embed 5 Pro, texto | $0,12 / 1M de tokens | Tokens de entrada | Indexar documentos |
| Embed 5 Fast, texto | $0,08 / 1M de tokens | Tokens de entrada | Consultas, bucles de agentes |
| Embed 5 Pro o Fast, imágenes | $0,40 / 1M de tokens | Tokens de imagen | Imágenes de páginas, diapositivas |
| Model Vault Small (Pro o Fast) | $3,00/h o $2.000/mes | Instancia dedicada | Volumen alto y constante |
| Model Vault Medium (Pro o Fast) | $5,00/h o $3.250/mes | Instancia dedicada | Volumen muy alto |
| Amazon SageMaker | $2,39 a $8,48/host/h de tarifa de software + instancia | Hora | Equipos que ya usan AWS |
| Microsoft Foundry | Listado en vista previa, aún sin precio | n/d | Equipos en Azure |
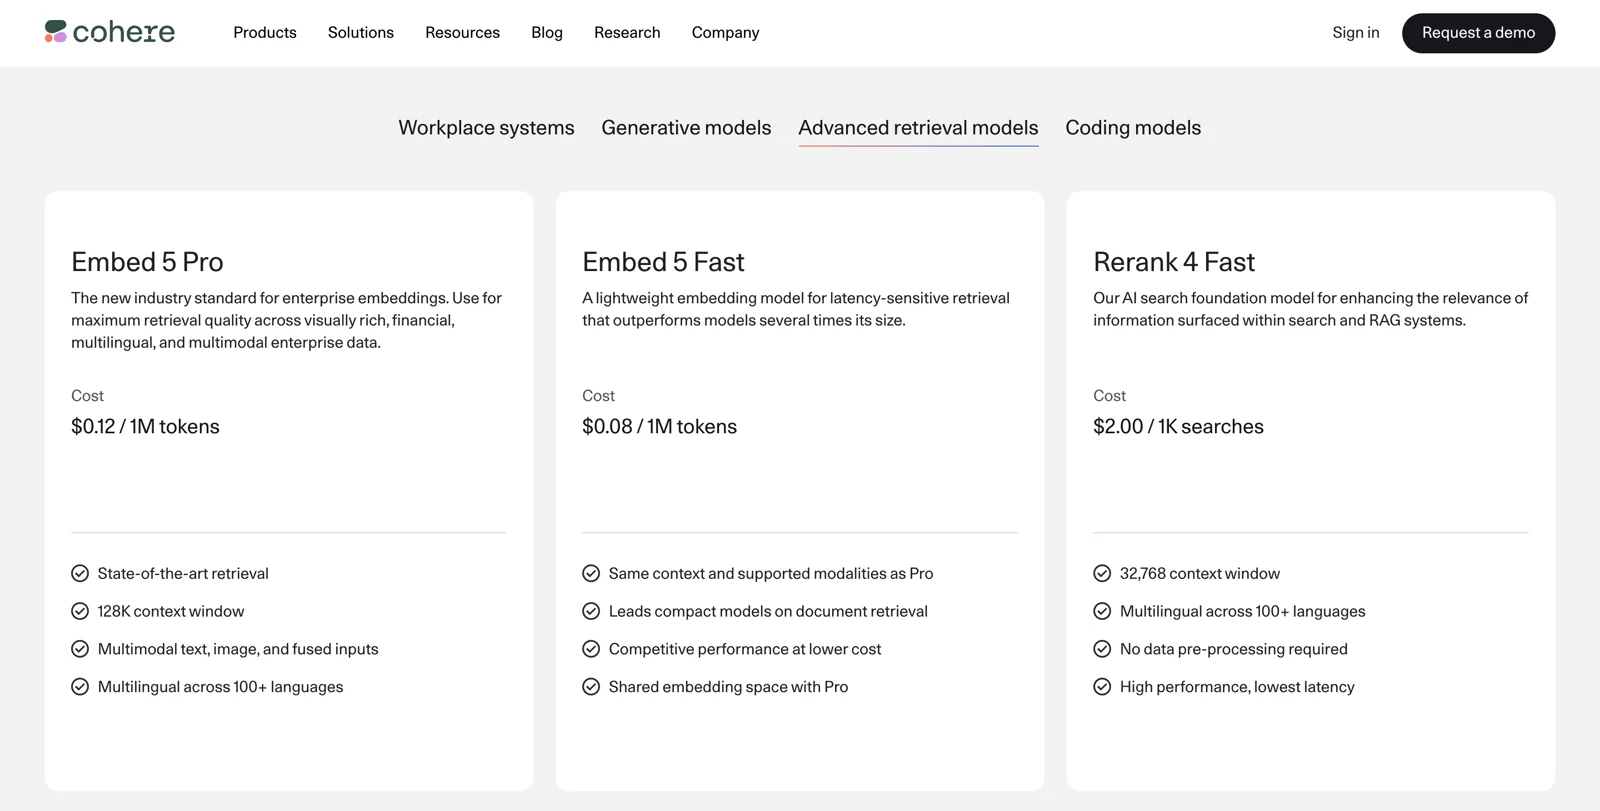
La misma pestaña lista también Parse 5 a $1,50 por 1.000 páginas y Rerank 4 desde $2,00 por 1.000 búsquedas, y junto con Embed 5 forman todo el stack de recuperación que vende Cohere. Al leer las tarjetas, dos cosas me llamaron la atención. La primera: Model Vault cobra la misma tarifa por Pro y Fast, así que en una instancia dedicada desaparece toda la lógica de "Fast es más barato", y la única razón para elegir Fast ahí es la velocidad. La segunda: Embed 4 ha desaparecido por completo de la página de precios, aunque la documentación de modelos todavía lo lista sin aviso de obsolescencia. Si hoy usas Embed 4 no se rompe nada, pero la señal sobre dónde quiere Cohere que estés es bastante clara. (Mi reseña de Cohere AI cubre el resto de la gama.)
En eesel me dedico a construir integraciones, y la parte de eesel que convierte un centro de ayuda y unos años de tickets en algo que una IA puede buscar es exactamente esta capa. Así que cuando leo tarjetas de precios de embeddings, las leo como un fontanero lee un presupuesto de tuberías. El precio por unidad importa, claro, pero lo que de verdad estás valorando es todo aquello a lo que se conectan las tuberías.
Qué cambió respecto a Embed 4
La versión corta: Cohere mantuvo el precio y movió casi todo lo demás. Aquí va la comparación lado a lado, con las tarifas de Embed 4 de los precios de Cohere en Azure y la instantánea de precios de Cohere de agosto:
| Embed 4 | Embed 5 Pro | Embed 5 Fast | |
|---|---|---|---|
| Texto, por 1M de tokens | $0,12 | $0,12 | $0,08 |
| Imágenes, por 1M de tokens | $0,47 | $0,40 | $0,40 |
| Model Vault Small | $4,00/h, $2.500/mes | $3,00/h, $2.000/mes | $3,00/h, $2.000/mes |
| Dimensiones por defecto | 1536 | 2048 | 2048 |
| Puntuación ViDoRe V3 (Cohere) | 77,0 | 85,8 | 84,5 |
Es decir, un salto de calidad de 8,8 puntos al mismo precio de texto, imágenes un 15 % más baratas y una instancia dedicada $500 al mes más barata. Fast, en cambio, no existía antes.
La fila que yo rodearía es la de dimensiones por defecto. El precio por token es el mismo, pero cada vector sale un tercio más grande por defecto. Si cambias de modelo y mantienes la configuración por defecto, tu factura de embeddings se queda igual y la de tu base de datos vectorial sube. Llegaré a la solución más abajo, ya que es sencilla y ahorra dinero de verdad.
Qué cuenta como token facturable
La documentación de facturación de Cohere dice que embed se factura según el número de tokens embebidos, y los tokens que Cohere añade internamente no se cobran. Solo pagas por la entrada. No hay ningún cargo por tokens de salida, ya que lo que devuelve una llamada de embedding es una lista de números y no texto.
Hay algunos detalles que conviene conocer porque moldean la factura real:
- El batching no cambia el precio. Cada llamada de embed admite hasta 96 textos o entradas, lo que es bueno para el rendimiento, pero el coste por token sigue igual.
- Las imágenes se facturan por token, pero la conversión no está publicada. La documentación explica el redimensionado (las imágenes de más de 2.458.624 píxeles se reducen), pero no da una fórmula de tokens por imagen. Conviene ejecutar primero una muestra pequeña antes de fijar un presupuesto para un archivo grande de PDF.
- No hay un descuento por lotes indicado. La publicación del lanzamiento dice que el embedding por lotes está disponible, pero la guía de Embed Jobs aún dice que solo funciona con modelos v3.0. No planifiques con una tarifa de lotes del 50 % como la de Google.
- Las claves de prueba son estrechas. El embedding de texto va a 2.000 entradas por minuto tanto en prueba como en producción, pero el de imágenes es de 5 entradas por minuto en prueba frente a 400 en producción.
Todo lo demás es aritmética simple: tokens de entrada por la tarifa. Es el mismo modelo de facturación que la API de OpenAI y la mayoría de los demás servicios de embeddings alojados.
El truco de indexar con Pro y consultar con Fast
Para mí es lo más útil de todo el lanzamiento, y en realidad es una característica de precio disfrazada de técnica. Pro y Fast comparten un espacio de embeddings, así que una consulta que Fast ha embebido puede buscar en un índice construido por Pro, sin reconstruir nada.
"For many customers, we recommend the following deployment pattern: index with Pro, query with Fast."
Cohere probó todas las combinaciones en 40 conjuntos de datos de desarrollo. Con una configuración totalmente Pro puntuada como 100, un índice Pro consultado con Fast obtuvo 98,4, un índice Fast consultado con Pro 97,3 y todo Fast 96,6. Hay una trampa escondida en las notas al pie: ambos lados deben usar la misma dimensión de salida.
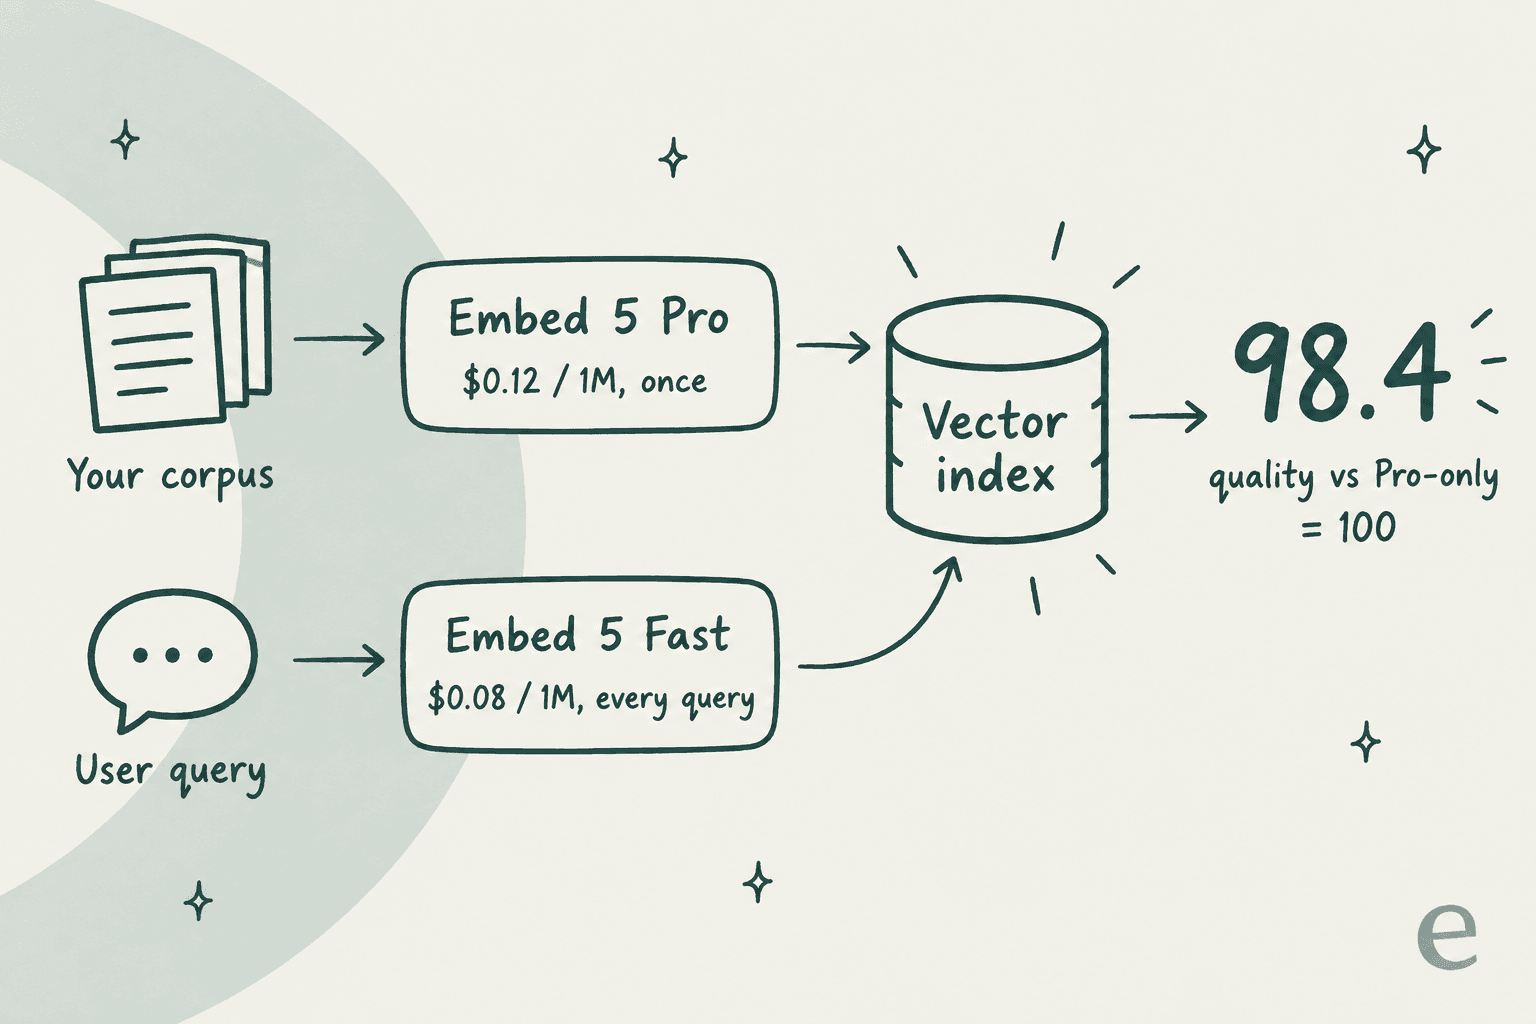
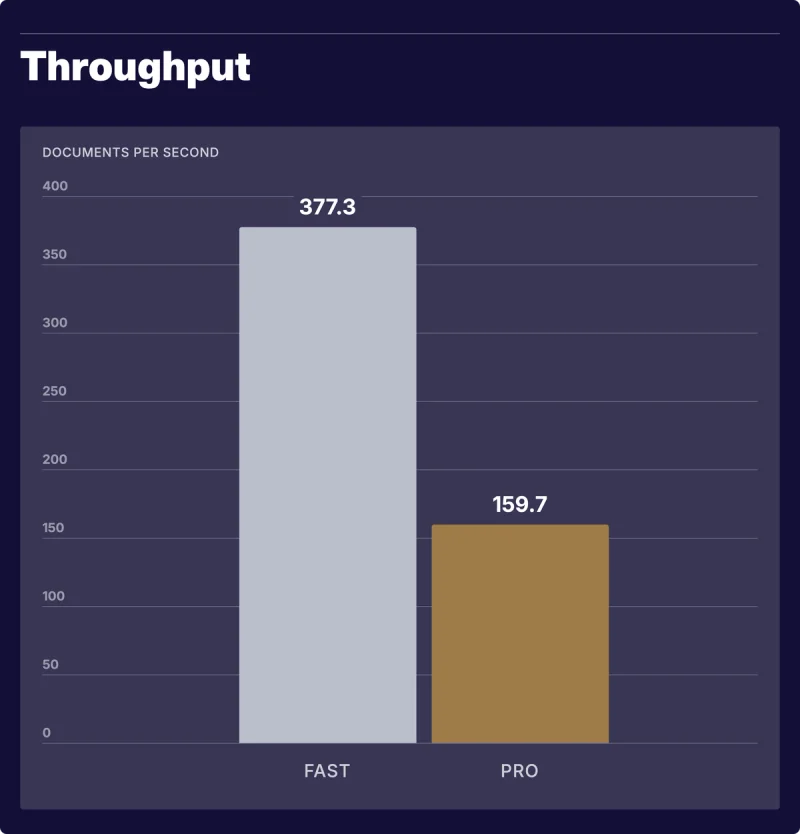
¿Por qué importa para el coste? Porque en la mayoría de los sistemas de búsqueda y RAG (aquí tienes un pipeline RAG de soporte si quieres ver la forma completa), la indexación ocurre una vez (más las actualizaciones), mientras que las consultas ocurren para siempre. Así pagas la tarifa Pro en la parte que haces rara vez, y la tarifa Fast en la parte que haces cada segundo. Fast además procesó 377,3 documentos por segundo frente a 159,7 de Pro en la prueba de rendimiento de Cohere, de modo que las consultas son más rápidas además de más baratas.
Aquí es donde yo matizaría la lectura habitual, porque para la mayoría de los equipos el lado de las consultas es minúsculo. Un bot de soporte que atiende 30.000 preguntas al mes con unos 100 tokens cada una envía 3 millones de tokens de consulta: son $0,36 en Pro o $0,24 en Fast. El titular de que "Fast ahorra dinero" es real a escala de bucles de agentes, donde un modelo lanza decenas de búsquedas por tarea. Para un centro de ayuda normal, elige Fast por la latencia y deja de preocuparte por su coste.
El coste que la página de precios no muestra: almacenamiento vectorial
Cada vector que creas tiene que vivir en algún sitio, normalmente una base de datos vectorial, y ese sitio te factura cada mes. De todo un presupuesto de embeddings, esta es la parte que más veo subestimada, porque la API de embeddings es un coste único por documento mientras que la base de datos es un alquiler.
Embed 5 te permite elegir el tamaño de salida (256, 512, 768, 1024, 1536 o 2048 dimensiones) y el formato (float, int8, binary y algunas variantes). El ejemplo de Cohere: 100 millones de chunks con las 2048 dimensiones float por defecto ocupan 819 GB, mientras que 256 dimensiones binary ocupan 3,2 GB, es decir, 256 veces menos.
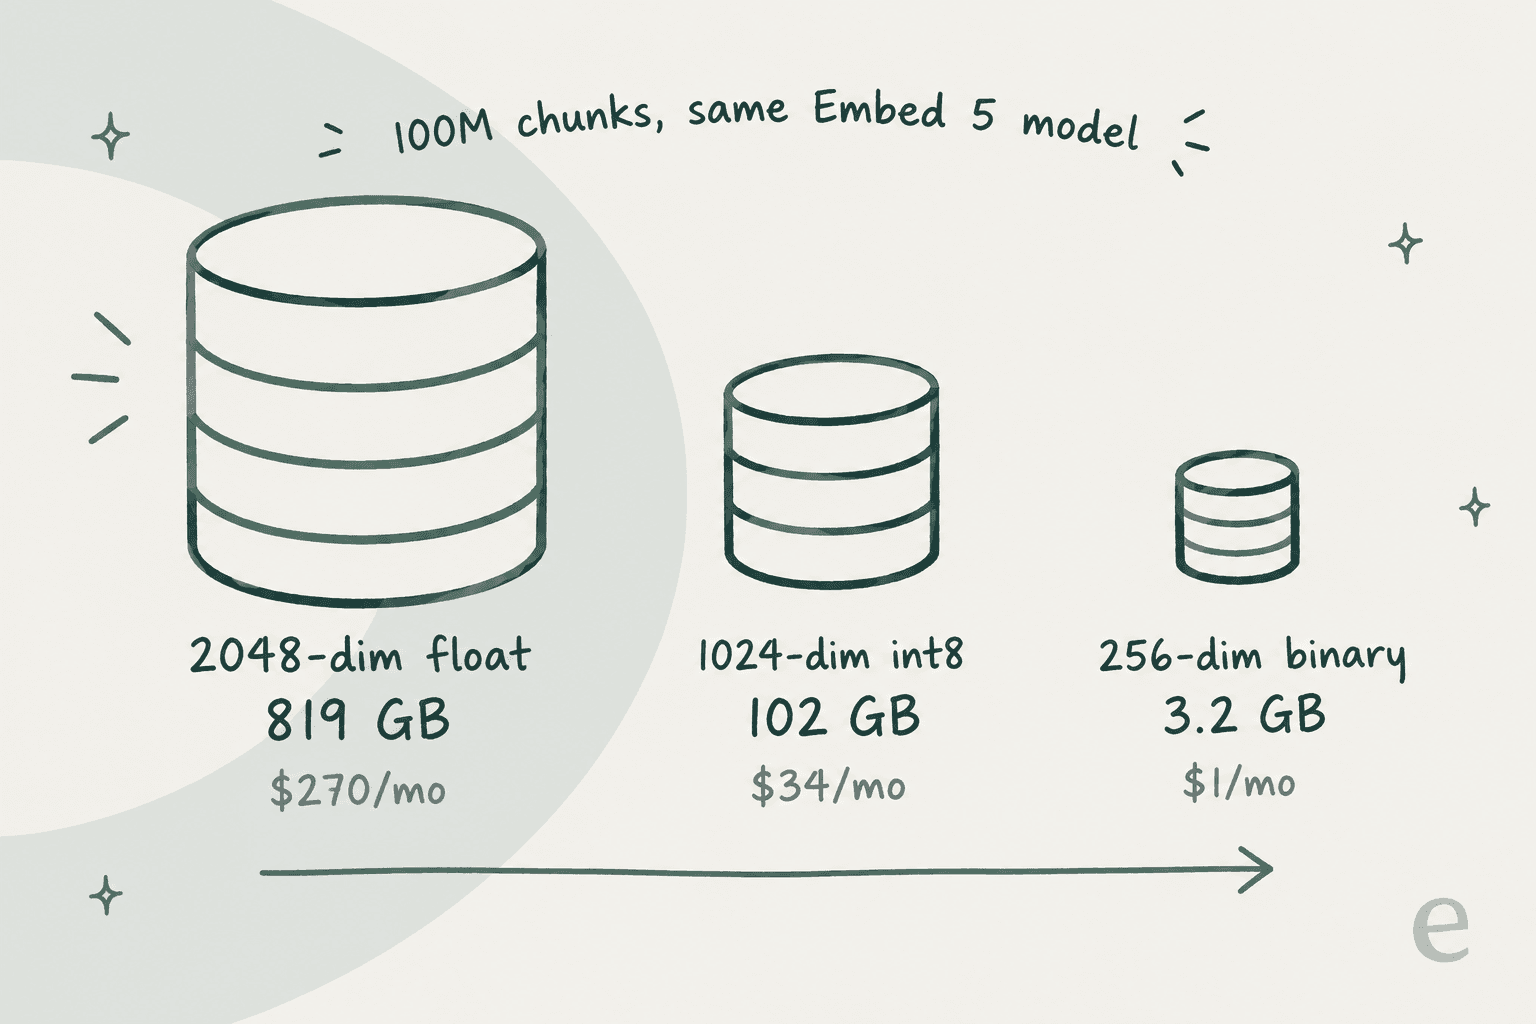
Puse precio a esos tres tamaños en el plan serverless de Pinecone a $0,33 por GB al mes (solo bytes de vector en bruto, antes de la sobrecarga del índice y los metadatos). Eso deja la diferencia en $270 al mes frente a $34 frente a aproximadamente $1. En dos años, la configuración float por defecto cuesta unos $6.500 solo en almacenamiento, más que los $6.000 que cuesta embeber 50.000 millones de tokens con Pro en primer lugar.
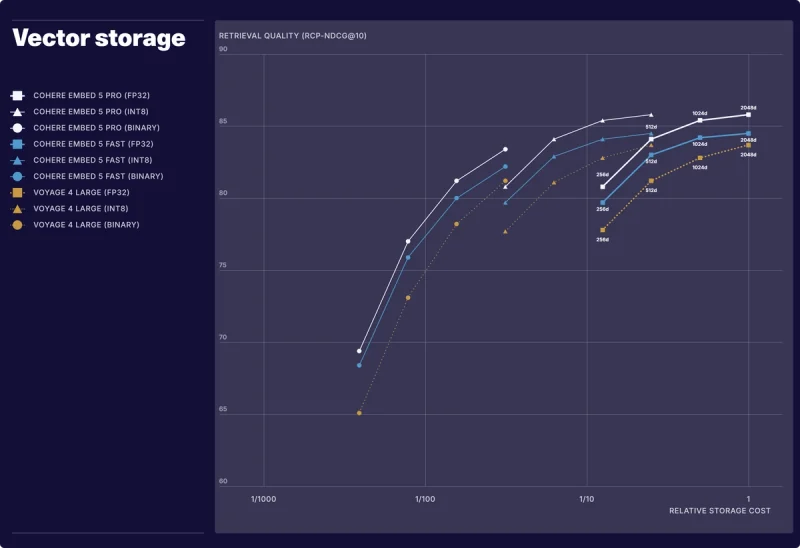
Lo que pierdes en calidad al reducir es menos de lo que imaginas. El gráfico de Cohere traza la calidad de recuperación frente al coste relativo de almacenamiento, y las líneas int8 quedan casi encima de las float. La propia recomendación de Cohere es int8 de 1024 dimensiones, y es también la configuración con la que yo empezaría.
Otras bases de datos fijan precios de otra manera, y con ellas cambia la forma de la factura. Weaviate Cloud cobra por millón de dimensiones vectoriales almacenadas (desde $0,00465 en Flex), así que 2048 dimensiones cuestan literalmente el doble que 1024. Pinecone además cobra de $16 a $18 por millón de unidades de lectura en Standard, con un mínimo mensual de $50, y para índices pequeños eso importa más que el almacenamiento. Comparé las opciones de bases de datos con más detalle en mi desglose de precios de Weaviate y en el repaso de alternativas a Weaviate.
Si prefieres no gestionar una base de datos en absoluto, la opción alojada de OpenAI se cubre en mi guía de vector stores, aunque te ata a los propios modelos de embeddings de OpenAI.
Estima tu factura de Embed 5
Introduce aquí tu propio corpus y tu propio tráfico. La calculadora usa las tarifas publicadas de la API y la tarifa de almacenamiento de Pinecone de $0,33/GB, así que la línea de almacenamiento conviene tomarla como un mínimo.
Prueba a pasar de int8 de 1024 dimensiones a float de 2048 dimensiones, que son los valores por defecto de Embed 5. Con un millón de chunks la factura de indexación no se mueve en absoluto, mientras que la línea de almacenamiento se multiplica por 8.
API vs Model Vault vs marketplaces en la nube
Model Vault cambia el contador por token por un alquiler fijo de una instancia dedicada de un solo inquilino. La cuenta del punto de equilibrio es bastante sencilla:
| Instancia | Mensual | Equilibrio en Pro | Equilibrio en Fast |
|---|---|---|---|
| Small | $2.000 | ~16.700M tokens/mes | ~25.000M tokens/mes |
| Medium | $3.250 | ~27.100M tokens/mes | ~40.600M tokens/mes |
Dieciséis mil millones de tokens al mes son unos 550 millones al día. Muy pocos equipos embeben tanto, así que para casi todos la API sigue siendo la opción más barata. Cohere tampoco publica cuántos tokens puede mover al mes una instancia Small, así que consulta el rendimiento con ventas antes de asumir que una instancia cubrirá tu pico.
Aun así la gente compra Model Vault, y el motivo es más el control que el precio. No hay multitenencia compartida y el rendimiento está garantizado, lo que también da un argumento más limpio para las revisiones de seguridad. Encaja con todo el planteamiento de Cohere en torno al despliegue empresarial. Si necesitas que funcione por completo dentro de tu propia red, ambos modelos pueden alojarse por tu cuenta en vLLM mediante un despliegue privado, con el precio fijado por ventas.
Los marketplaces son una tercera vía. En Amazon SageMaker, Embed 5 se factura como una tarifa de software por hora y host ($2,39 en una ml.g5.xlarge, hasta $8,48 en la instancia Pro más grande) más la propia instancia de SageMaker. Microsoft Foundry lista ambos modelos en vista previa, aún sin precio. Amazon Bedrock y Oracle OCI solo tienen Embed 4 a fecha del 1 de octubre, a $0,12 por 1M de tokens en Bedrock. Si tu empresa tiene gasto en la nube comprometido, la vía del marketplace puede seguir teniendo sentido aunque la tarifa en bruto sea peor.
Ejemplos prácticos: lo que paga un equipo real
A continuación, tres escenarios con las tarifas publicadas y almacenamiento int8 de 1024 dimensiones salvo que indique otra cosa.
El centro de ayuda y el historial de tickets de un equipo de soporte. 2.000 artículos de ayuda de unos 800 tokens y 50.000 tickets anteriores de unos 400 tokens suman 21,6 millones de tokens. Indexar con Pro cuesta $2,59, una sola vez. Las consultas, a 30.000 al mes en Fast, cuestan $0,24 al mes. Los vectores caben en el nivel gratuito de 2 GB de Pinecone. La factura de embeddings en este caso es un error de redondeo. El coste real está en la ingeniería para construir el chunking y la sincronización, más los permisos y la capa de LLM encima, el mismo compromiso que recorro en búsqueda semántica sobre Zendesk Guide.
Un archivo de documentos para una herramienta de búsqueda interna. 20 millones de chunks de 500 tokens son 10.000 millones de tokens. Indexar con Pro cuesta $1.200; con Fast serían $800. El almacenamiento en float de 2048 dimensiones es de unos 164 GB, o $54 al mes en Pinecone. Con int8 de 1024 son unos 20 GB, o $6,76 al mes. Cuando salga el próximo modelo, un reindexado cuesta otra vez los $1.200 completos, y si los PDF necesitan análisis previo, Parse 5 añade su propia factura por página.
Un agente de alto volumen que busca en cada paso. 500 millones de tokens de consulta al día son 15.000 millones al mes. En Fast son $1.200 al mes; en Pro, $1.800. Ninguno cruza la línea de $2.000 de Model Vault, así que la API sigue ganando a menos que necesites capacidad dedicada.
La lección de los tres: la API de embeddings casi nunca es la parte cara. Lo son el almacenamiento y el reindexado, y también las personas que mantienen el pipeline.
Cómo se comparan los precios de Embed 5
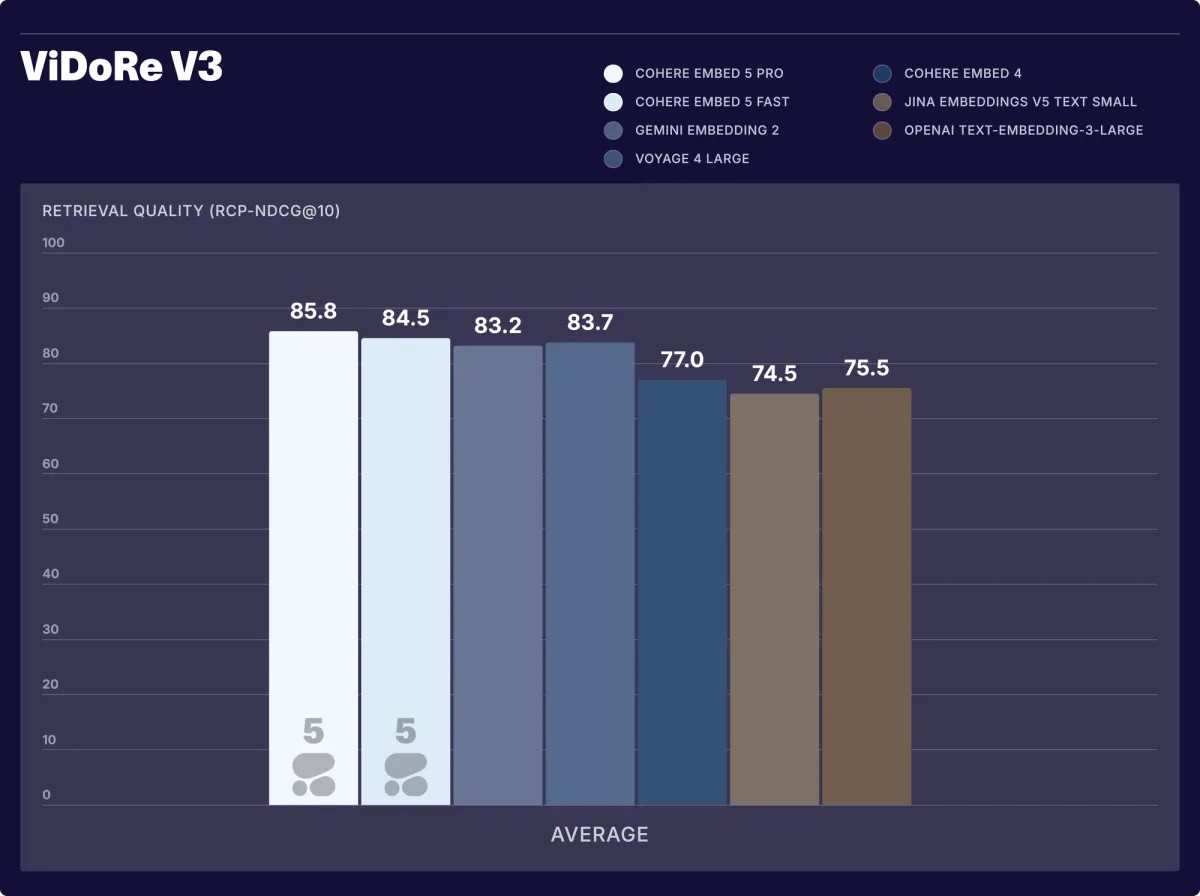
Alineé Embed 5 con los demás modelos de embeddings insignia, cada precio tomado de la página de precios del proveedor. Las puntuaciones son las cifras ViDoRe V3 de Cohere de su publicación del lanzamiento, así que léelas como la prueba de la propia Cohere y no como una independiente.
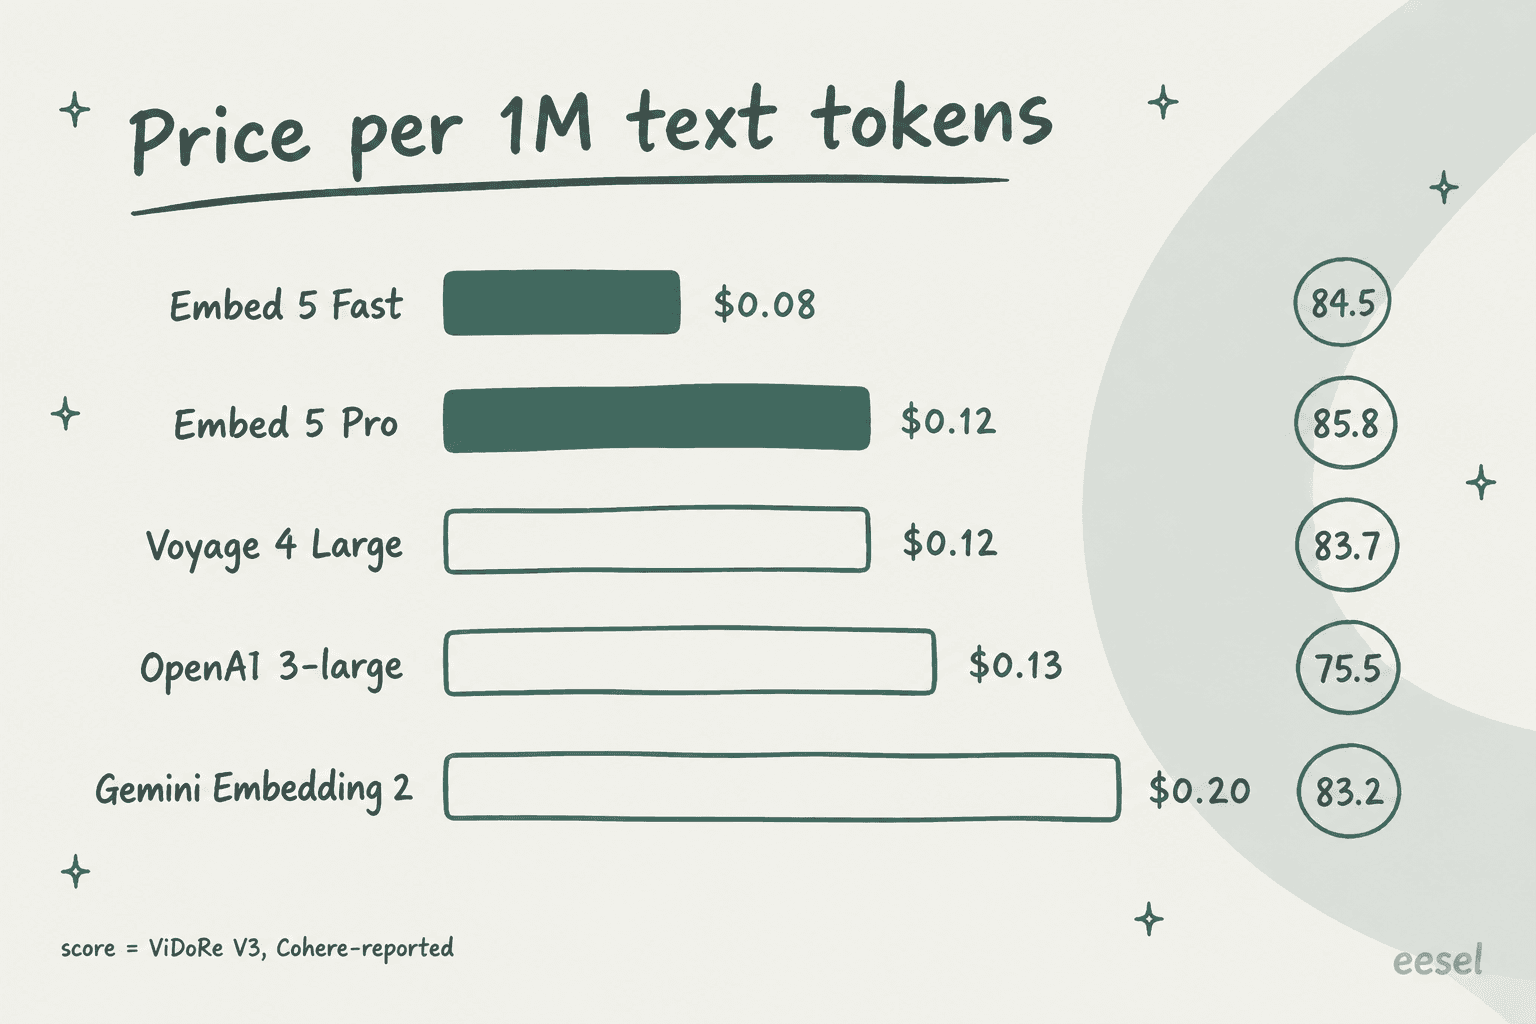
| Modelo | Texto / 1M de tokens | Lotes | Plan gratuito | ViDoRe V3 (Cohere) |
|---|---|---|---|---|
| Cohere Embed 5 Pro | $0,12 | No indicado | Prueba de 1.000 llamadas/mes | 85,8 |
| Cohere Embed 5 Fast | $0,08 | No indicado | Prueba de 1.000 llamadas/mes | 84,5 |
| Voyage 4 Large | $0,12 | 33 % de descuento | 200M de tokens | 83,7 |
| Gemini Embedding 2 | $0,20 | $0,10 | Sí | 83,2 |
| OpenAI text-embedding-3-large | $0,13 | n/d | Ninguno | 75,5 |
| OpenAI text-embedding-3-small | $0,02 | n/d | Ninguno | n/d |
| Jina Embeddings v5 | $0,045 a $0,05 | n/d | 10M de tokens, no comercial | 74,5 (v5 Small) |
| Mistral embed | $0,10 | n/d | n/d | n/d |
Embed 5 Fast es el modelo más barato del grupo de mayor puntuación, y Pro iguala a Voyage 4 Large en precio mientras lo supera ligeramente en la prueba de Cohere. Gemini Embedding 2 cuesta 2,5 veces lo que Fast a tarifa completa, aunque su precio por lotes de $0,10 lo reduce mucho para la indexación offline (las tarifas completas, en mi guía de precios de Gemini). La API de embeddings de OpenAI cuesta un centavo más que Pro por una puntuación mucho más baja en este benchmark.
Hay dos salvedades honestas que señalar. Si el precio puro por token es tu único objetivo, 3-small de OpenAI y Voyage 4 Lite están ambos a $0,02, una cuarta parte de Fast. Y la propia tabla multilingüe de Cohere muestra a Gemini Embedding 2 por delante de Pro en 9 de los 10 idiomas asiáticos y de Oriente Medio que probó, con el telugu como mayor diferencia (91 vs 80). Si tu corpus está sobre todo en hindi, japonés o árabe, vale la pena probar Gemini antes de comprometerte. El modelo embed de Mistral a $0,10 es otra opción para datos europeos; consulta mis notas sobre los precios de Mistral AI. Para una lista más amplia, mi artículo de alternativas a Cohere AI compara a los proveedores más allá de los embeddings.
Qué dicen los desarrolladores
Embed 5 tiene un día mientras escribo esto, así que todavía no hay reseñas reales de usuarios. Lo que sí existe es un historial constante de los embeddings de Cohere en general, y el tema que sigue apareciendo es la fiabilidad:
"It has the most crisp, steady P50 of any external service I've used in a long time."

Las críticas suelen ser sobre el coste a gran volumen y sobre depender de una API cerrada, algo que es cierto en cualquier modelo de embeddings alojado:
"The API can also become expensive when you start using it more frequently."

"Voyage for embeddings + rerank is totally defensible - Cohere is popular partly because it's been the default in a lot of examples, not because it's always better."

Creo que lo último es justo, y los números de Embed 5 respaldan ambos lados: Pro gana el propio benchmark de Cohere, pero por 2,1 puntos sobre Voyage 4 Large al mismo precio. Si ya usas bien Voyage, no hay una razón urgente para migrar. Si estás en Embed 4, pasar a Embed 5 no cuesta nada extra por token y es casi una victoria pura. La integración de Cohere en LangChain convierte el cambio en una modificación de una línea del modelo, aunque tendrás que volver a embeber el corpus.
Qué camino de precios de Embed 5 te conviene
Estas son mis recomendaciones, según la situación:
- Estás prototipando. Usa la clave de prueba y luego una clave de producción de pago por uso. No pienses todavía en Model Vault.
- Estás construyendo búsqueda o RAG sobre un corpus fijo. Indexa con Pro, consulta con Fast, almacena en int8 de 1024 dimensiones. Es la configuración de alta calidad más barata que ofrece Cohere.
- Ejecutas agentes que buscan constantemente. Fast en ambos lados si necesitas el rendimiento 2,4 veces mayor; índice Pro más consultas Fast si importa más la calidad.
- Embebes decenas de miles de millones de tokens al mes o necesitas aislamiento. Valora Model Vault y pide a ventas el rendimiento por instancia antes de firmar. En AWS, compáralo con SageMaker y con los precios de agentes de Bedrock que quizá ya pagas.
- Embebes sobre todo contenido en idiomas asiáticos. Haz primero un benchmark de Gemini Embedding 2 frente a Pro con tus propios datos.
- Solo quieres un bot de soporte que responda a partir de tus documentos. Sáltate por completo la decisión de embeddings y mira una base de conocimiento con IA o un compañero de helpdesk que gestione la recuperación por ti.
Prueba eesel cuando el objetivo sean respuestas de soporte
La mayoría de quienes valoran modelos de embeddings no están construyendo un buscador por el simple hecho de hacerlo. A menudo están eligiendo entre RAG y fine-tuning para un centro de ayuda. Lo que quieren al final es un bot que responda a los clientes a partir de un centro de ayuda y de tickets anteriores. Ahí es donde yo pararía y preguntaría si realmente necesitas ser dueño del stack.
En eesel he visto a equipos tomar esta decisión desde ambos lados. Una empresa neerlandesa de alojamiento web en Zendesk, que gastaba unos $1.700 al mes, dejó eesel para construir su propia IA internamente. La lectura del equipo después no tuvo nada que ver con el coste de los modelos:
"A lot of their friction came from setup complexity (handovers, Zendesk integration, business hours logic) and a lack of clear guidance on how to configure things correctly."
Esa es la parte que las páginas de precios de embeddings nunca muestran. Los vectores son baratos. Lo que da trabajo de verdad son los traspasos y las integraciones, además de las reglas que los rodean.

eesel es un compañero de helpdesk con IA que se une a tu cola actual en Zendesk, Freshdesk y otros helpdesks, aprende de tu base de conocimiento y de tus tickets anteriores, y te permite reproducir tickets reales a través de él antes de que hable con un cliente. No hay modelo de embeddings que elegir ni número de dimensiones que ajustar, y tampoco recibes una factura de base de datos vectorial.
El precio son planes fijos de créditos desde $299 por 500 créditos al mes, donde un ticket o chat gestionado es un crédito.
Si eres desarrollador, ir por este camino no significa perder el control, algo que cubro con más profundidad en mi guía de la API de agente de atención al cliente. La CLI de eesel te permite conectar integraciones, editar las instrucciones del compañero, aprobar o denegar acciones pendientes y leer su registro de actividad desde un terminal, con salida JSON y un indicador --dry-run para scripts. Agentes de programación como Claude Code también pueden manejarla por MCP.
He escrito más sobre ese flujo de trabajo en gestionar agentes desde el terminal y en el recorrido por la CLI para soporte.
Prueba eesel gratis y mira cómo se ve tu centro de ayuda como un compañero de soporte en funcionamiento, sin escribir una sola llamada de embedding.
Preguntas frecuentes
¿Cuánto cuesta Cohere Embed 5?
¿Cuál es la diferencia de precio entre Embed 5 Pro y Embed 5 Fast?
¿Es Cohere Embed 5 más caro que Embed 4?
¿Hay un plan gratuito para Cohere Embed 5?
¿Cuándo sale más barato Cohere Model Vault que la API de Embed 5?
¿Cómo se comparan los precios de Cohere Embed 5 con los embeddings de OpenAI?
¿Necesito Cohere Embed 5 para crear un agente de soporte con IA?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.