Qué es realmente TypeSafe Jev
TypeSafe AI es un laboratorio de San Francisco que pasó dos años en modo sigiloso antes de lanzar Jev el 15 de septiembre de 2026. El planteamiento de la página de inicio es deliberadamente provocador: los LLM «producen palabras para personas», mientras que «Jev produce decisiones tipadas y se parece más al código». El post de lanzamiento tiene una frase más limpia, y llama a Jev «una llamada a función con inteligencia de frontera: entra estado no estructurado, salen decisiones probabilísticas tipadas».
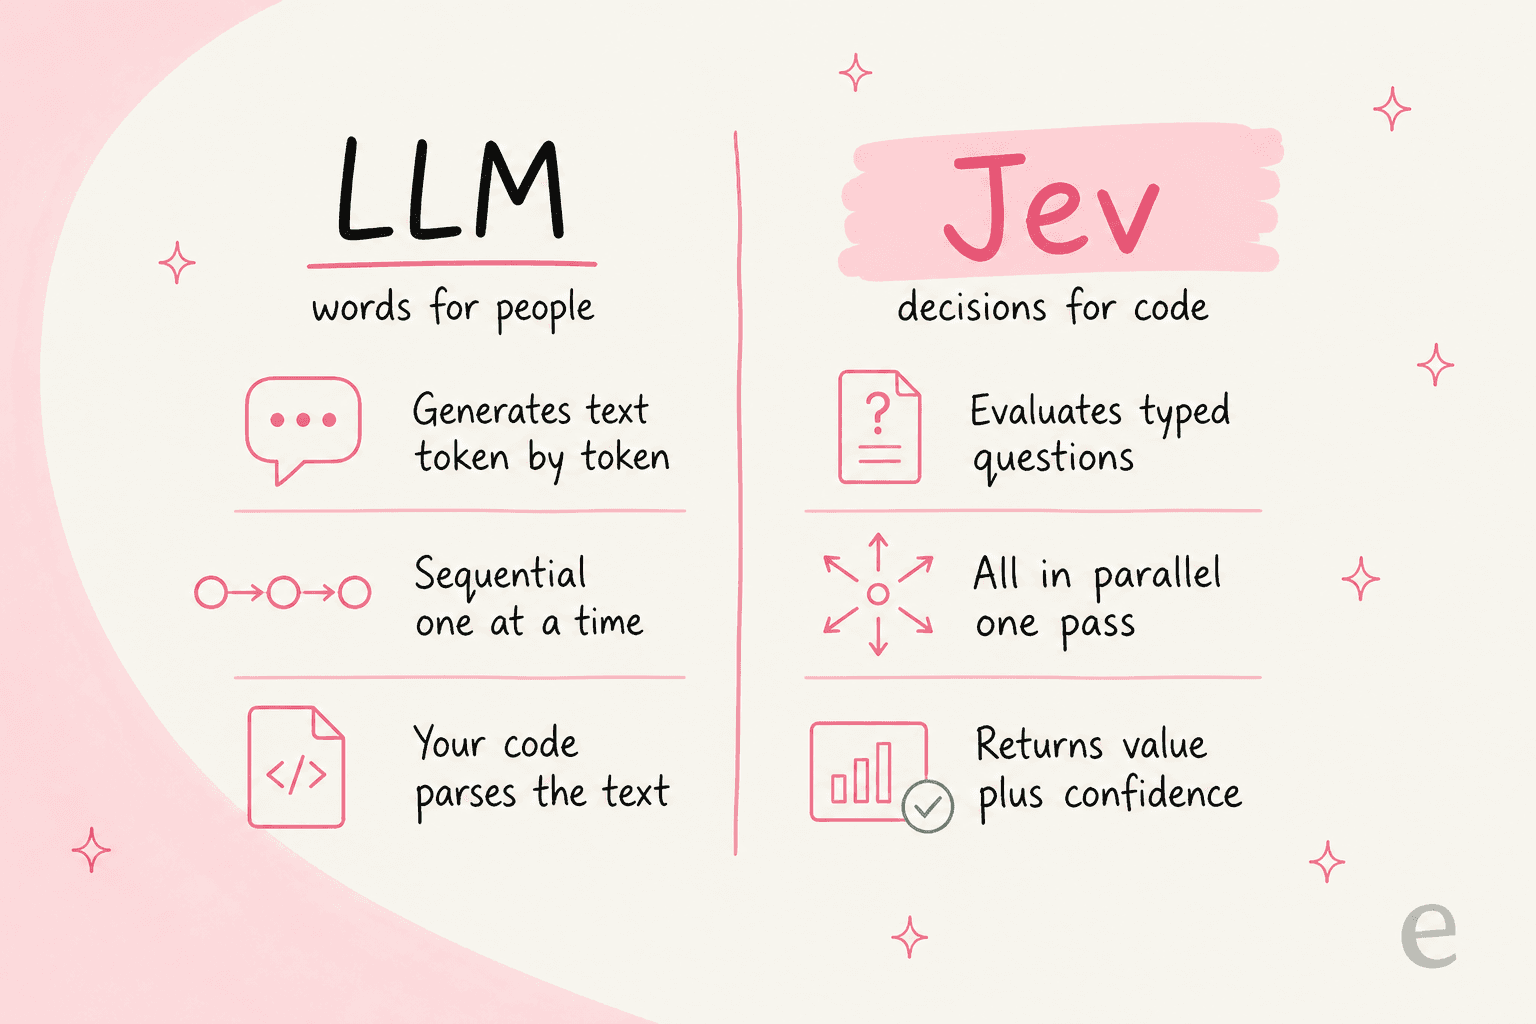
El nombre delata toda la filosofía. «System One» hace un guiño al pensamiento rápido e intuitivo del Sistema 1 de Daniel Kahneman, y «Jev» viene del economista William Stanley Jevons, cuya paradoja dice que cada caída en el coste de un recurso desbloquea un uso mucho mayor de él. TypeSafe apuesta a que las decisiones tipadas, baratas y rápidas se usarán en todos los sitios donde hoy una llamada generativa lenta resulta demasiado cara.
La compañía también dice que tomó «la dirección de investigación opuesta» al chat. En lugar de más RLHF, entrenó con un nuevo objetivo que llama Reinforcement Learning for Calibrated Decisions (RLCD), con una nueva arquitectura y un nuevo muestreador. El argumento se resume en tres ideas: decisiones, no cadenas de texto; confianza calibrada; más parecido al código. Su lema, «Build Prod, Not God», te dice a quién se dirigen.
Cómo funciona: estado más preguntas, evaluadas en paralelo
Esta es la parte que me hizo clic, y merece la pena entenderla antes de entrar en las afirmaciones. La documentación describe el desajuste que Jev está construido para eliminar:
"you are coercing a text-generation system into outputting structured decisions, then parsing the results back into something your code can depend on."
Cualquiera que haya lanzado una función con LLM ha sentido exactamente ese dolor. El modelo de Jev es distinto: envías un estado (una cadena de texto o un objeto estructurado) más un conjunto de preguntas tipadas, y evalúa cada pregunta contra ese estado, en paralelo, en un único paso. Tu código luego se ramifica, ordena y enruta según las respuestas tipadas que recibe.
Solo hay tres primitivas, y se corresponden con las formas que realmente necesitas:
| Tipo de pregunta | Qué pregunta | Qué devuelve |
|---|---|---|
| Noul | ¿Es verdadera esta afirmación? | una única probabilidad, de 0 a 1 |
| Choice | Elegir una opción de una lista | la elección, probabilidades por opción y una confianza |
| Score | Puntuar el estado según una rúbrica | una puntuación numérica, probabilidades por nivel y una confianza |
La decisión de diseño que más me gusta: como cada pregunta se evalúa de forma independiente contra el mismo estado, añadir más preguntas apenas mueve la latencia y nunca genera «context-rot». La guía de composición de TypeSafe recomienda mantener cada pregunta atómica, «el tipo de juicio que una persona con conocimiento podría hacer en unos segundos», y componer lo difícil en el código en lugar de en un único prompt gigante. En vez de «puntúa este pitch de startup», preguntas por separado sobre el tamaño del mercado, la viabilidad y la diferenciación, y luego combinas las puntuaciones con tu propia fórmula.
La página del modelo en Cloudflare lo concreta con un ejemplo de soporte que, honestamente, se lee como nuestra propia especificación de producto. Envías el estado "Help! My payouts have been failing for 3 days." con tres preguntas, y obtienes de vuelta:
is_urgent(Noul):0.95department(Choice):"billing", confianza0.8, probabilidades {billing 0.87, technical 0.13}frustration(Score):1.04en una escala Calm/Frustrated/Very angry, confianza0.94
Eso es triaje de tickets en una sola llamada. También es la imagen más clara de qué es Jev: un clasificador muy rápido con probabilidades calibradas, no algo que habla.
Las afirmaciones, comprobadas una a una
El marketing de TypeSafe es audaz, así que voy a repasar las afirmaciones principales en orden y separar lo que se sostiene de lo que se exagera.
Velocidad: rápido, para las tareas para las que está pensado
TypeSafe afirma 70-500 ms de extremo a extremo frente a 3-329 segundos en LLM de frontera, planteado como 40x a 200x más rápido. El único paso paralelo es una razón arquitectónica real para ser rápido, y las pruebas externas son alentadoras. El CEO de Vercel lo reportó en producción:
"Jev is up to 18x faster (p95) and more accurate. It's coming to @vercel AI Gateway and likely new default."
La objeción razonable, planteada repetidamente en Hacker News, es que la comparación no es equivalente. Un modelo generativo que produce todos los nombres de tipo, el esquema y la prosa está haciendo más trabajo que un modelo que solo emite una decisión restringida. La velocidad es real; el multiplicador depende de con qué se compare.
Precio: barato, con un asterisco honesto
A 0,042 $ por millón de tokens de entrada con salida gratuita, Jev tiene un precio de infraestructura, no de modelo de frontera. TypeSafe afirma que eso es 238 veces menos que el precio de entrada de Claude Fable 5.1. Hay que reconocerlo: abordan de frente la pregunta sobre el subsidio en lugar de esquivarla.
"We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
Vale la pena saber, antes de planificar en base a esto: no hay página de precios (hoy cualquier URL /pricing da un 404), no hay niveles de plan publicados ni límites de tasa, y el acceso está bloqueado tras una lista de espera. Es un precio de lanzamiento en un producto de acceso anticipado, así que trátalo como orientativo. Si estás modelando costes, nuestra guía sobre los precios de Qwen muestra lo rápido que se mueven las cifras de lanzamiento. La misma lección recorre nuestro desglose de los precios de Gemini 3, y si la lista de espera es un obstáculo, nuestra lista de alternativas a Qwen tiene opciones abiertas hoy.
«No puede alucinar»: mitad verdad, y sobrevendido
Esta es la frase que recibió más rechazo, y creo que con razón. Jev no puede cometer un error de tipo porque la salida está matemáticamente restringida a tu esquema. Esa parte es real y útil. Pero el marketing desliza de «sin errores de tipo» a «no puede alucinar», y lo más votado del hilo de Hacker News no se lo tragó:
"if it puts a high confidence value on a wrong answer, thats still hallucinating, no?"

Los defensores tenían una respuesta razonable: una puntuación de confianza calibrada significa que puedes ver un 0.1 y descartarlo, que es distinto de un modelo que se equivoca con total seguridad. Otro comentarista fijó el listón con el que debería medirse la afirmación:
"What we would want to see is a confidence value that is in line with the actual correctness. If the value is 0.9 for 1000 different answers, then approximately 900 of those answers should be correct."
Esa es la prueba correcta, y es exactamente lo que se supone que RLCD debe optimizar. Mi lectura: la confianza calibrada es una característica de seguridad genuina que me gustaría ver expuesta en más modelos. «No puede alucinar» es una promesa más fuerte de lo que el modelo realmente cumple, y TypeSafe estaría en terreno más firme diciendo «type-safe con confianza calibrada».
El benchmark: un gráfico que merece una lectura atenta
Las propias evaluaciones de flujos de trabajo de TypeSafe destacan un llamativo «193,6x más rápido, 444,6x más barato», que el propio blog admite está «en el extremo alto de las ganancias del mundo real». El gráfico que hay debajo es más honesto que el titular, y es lo más útil que han publicado.
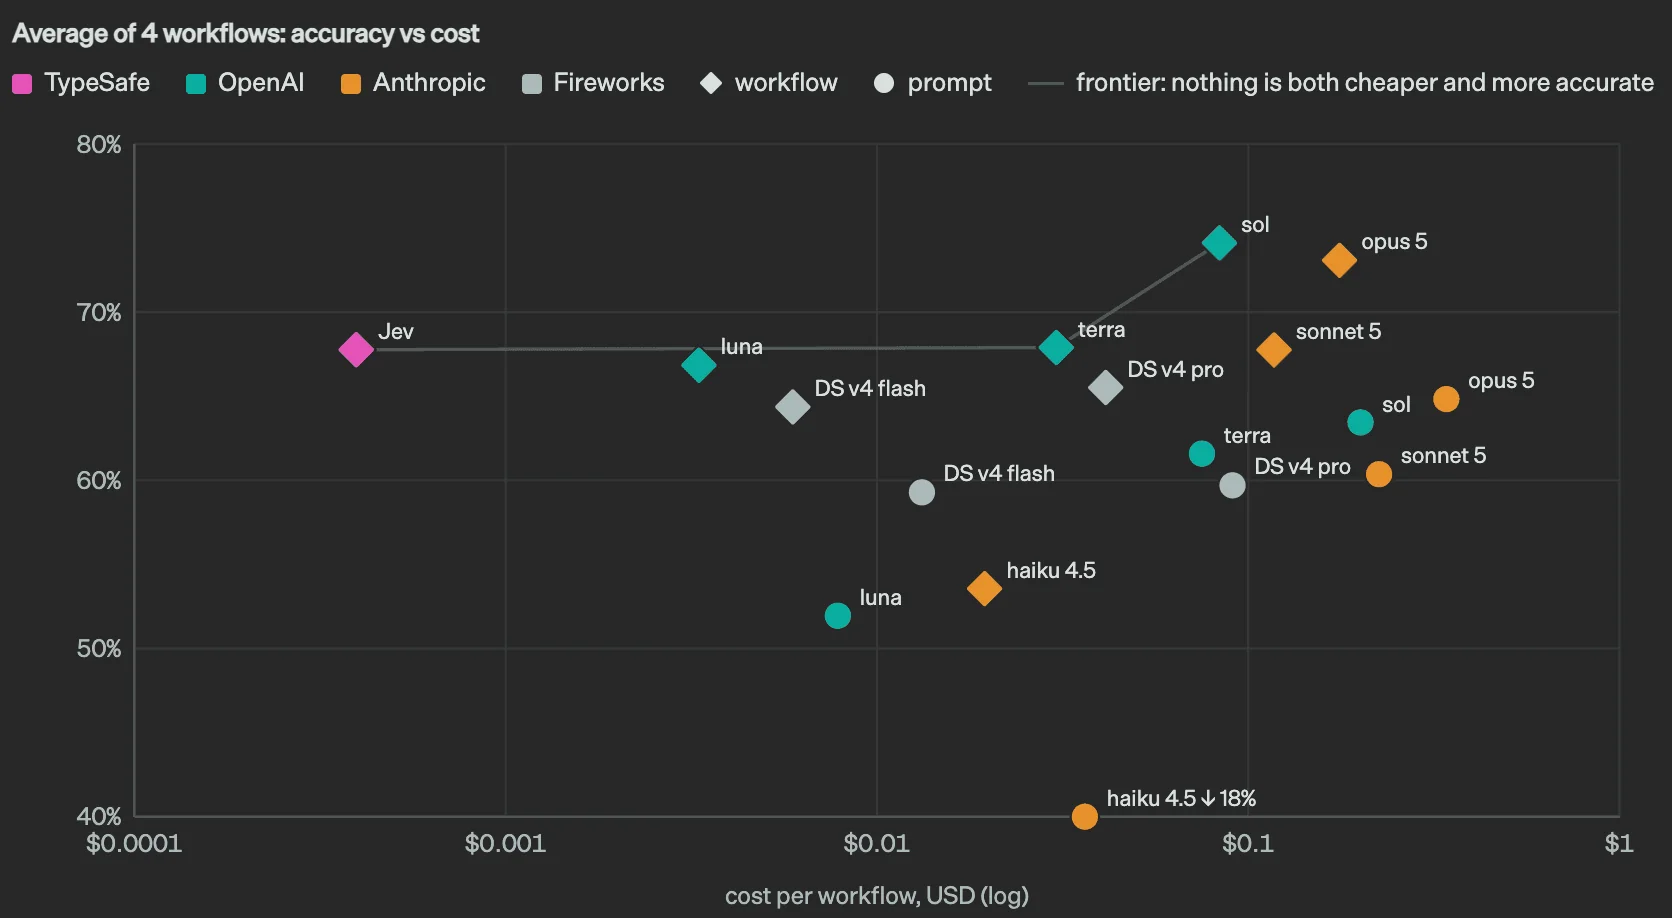
Leyéndolo bien, la afirmación real se aclara: Jev se sitúa en la frontera con aproximadamente la precisión de un modelo de razonamiento de gama media, a una fracción del coste por flujo de trabajo. No es el punto más preciso del gráfico. Es el punto más barato que sigue siendo competitivo, que para el trabajo de decisiones de alto volumen suele ser lo que importa. La opinión mesurada de un comentarista destacado lo resume bien:
"Seems like a more accurate title would be "Jev: Trading general purpose generation for fast typed inference"."
Lo que los desarrolladores están haciendo realmente con él
La reacción en X fue lo que más me convenció de que aquí hay algo real, porque eran demos, no opiniones. Los dos posts más grandes trataban ambos sobre exprimir el contexto de los agentes. Un desarrollador usó Jev para una compactación instantánea:
"in 2026, why is compaction still a summarization prompt? Jev can make it instant by scoring every tool call and dropping what's irrelevant"
Otro lo conectó a Claude como revisor de llamadas a herramientas y reportó haber llevado una sesión «de casi 1M a 86K tokens» en aproximadamente un segundo. Ese es exactamente el tipo de tarea para la que Jev es bueno: un juicio rápido, barato y de alto volumen que un modelo grande estaba masivamente sobrecualificado para hacer. Es el mismo instinto detrás de las buenas herramientas de agent-assist, pequeñas comprobaciones que no necesitan un cerebro de frontera.
No es amor universal, y las críticas merecen escucharse. La respuesta directa del desarrollador Theo Browne, «Please don't do this», capturó una preocupación real: que la gente recurra a un clasificador System One en sitios donde el razonamiento de un modelo general realmente importaba. Ambas cosas son ciertas a la vez. Jev es excelente para la decisión concreta, ya sea triaje de reportes de errores o una decisión de escalado, y equivocado para la pregunta abierta. La disciplina está en saber distinguir cuál es cuál.
Dónde encaja un modelo de decisiones tipadas, y dónde no
Aquí está el límite honesto, porque un análisis que dice «úsalo para todo» no sirve de nada.
Jev encaja cuando la tarea es una decisión que tu código consume: enrutamiento y triaje, puntuación de urgencia y sentimiento, marcas de spam y abuso, etiquetado de tickets, o una revisión de una llamada a herramienta antes de que se ejecute. En cualquier sitio donde de otro modo forzarías a un LLM a producir JSON, un modelo de decisiones tipadas es una primitiva más limpia, y la confianza calibrada te da una palanca real para decidir cuándo actuar automáticamente frente a escalar.
No encaja cuando la salida es el objetivo en sí. Jev no redacta la respuesta, no explica su razonamiento, no mantiene una conversación ni maneja la larga cola de una pregunta verdaderamente novedosa. Además, tiene una ventana de contexto de 32.000 tokens y, como producto en su semana de lanzamiento, una lista de espera de acceso anticipado en lugar de disponibilidad abierta. Para la respuesta en sí, sigues necesitando un modelo general, del tipo que comparamos en nuestro resumen de el mejor constructor de chatbots con IA, y si eres un equipo pequeño, nuestra guía de agentes de IA para pequeñas empresas.
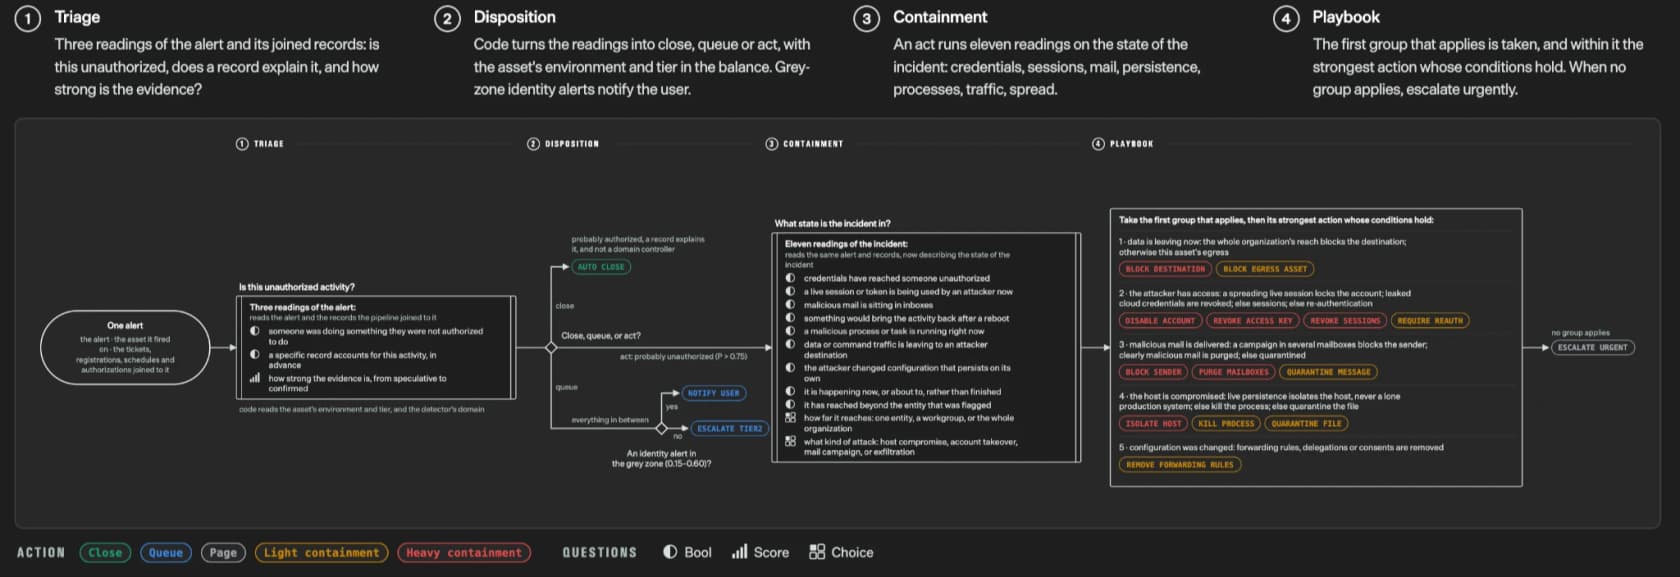
El modelo mental más útil al que llegué: Jev es el reflejo rápido, no la deliberación. El propio diagrama de flujo de seguridad de TypeSafe muestra bien el patrón: una tubería de pequeñas preguntas Bool, Score y Choice, con tu código eligiendo la acción entre ellas.
Para tomar la decisión más rápido, aquí está el razonamiento que yo seguiría en realidad:
Jev de un vistazo
| Modelo | Jev (jev-1.13.0), el primer modelo System One público |
| Qué devuelve | decisiones tipadas (Noul / Choice / Score) con confianza calibrada |
| Latencia | 70-500 ms de extremo a extremo, un solo paso paralelo |
| Precio | 0,042 $ / MTok de entrada, salida gratuita (precio de lanzamiento, sin niveles) |
| Ventana de contexto | 32.000 tokens |
| Acceso | lista de espera de acceso anticipado, además de typesafe/jev en Cloudflare Workers AI |
| Mejor para | decisiones estructuradas de alto volumen, revisión de llamadas a herramientas, compactación |
| No es para | redactar respuestas, razonar en prosa, conversación abierta |
Qué significa esto si diriges un equipo de soporte
La propia demo insignia de Jev es un ticket de soporte, y no es casualidad: el triaje es la tarea de manual para System One. He pasado suficiente tiempo en colas en vivo como para conocer la trampa: una gran decisión de triaje es solo la primera pulgada de la automatización de atención al cliente. Esta es una distinción de desarrollador a la que sigo volviendo. La clasificación es donde la IA ya es fiable; la respuesta generada, y la cuenta de costes agente humano vs. IA, es donde todavía falla.
Vimos exactamente esa división en una prueba que ayudé a llevar a cabo para una marca de bienes de consumo, en 284 chats y una validación cruzada de 100 tickets. Las decisiones tipadas fueron excelentes: 93 % de precisión en el triaje y 100 % de detección de spam sin falsos positivos. Las respuestas redactadas seguían teniendo una tasa de error factual del 7 %, y solo el 12 % estaban lo bastante limpias como para enviarse tal cual.
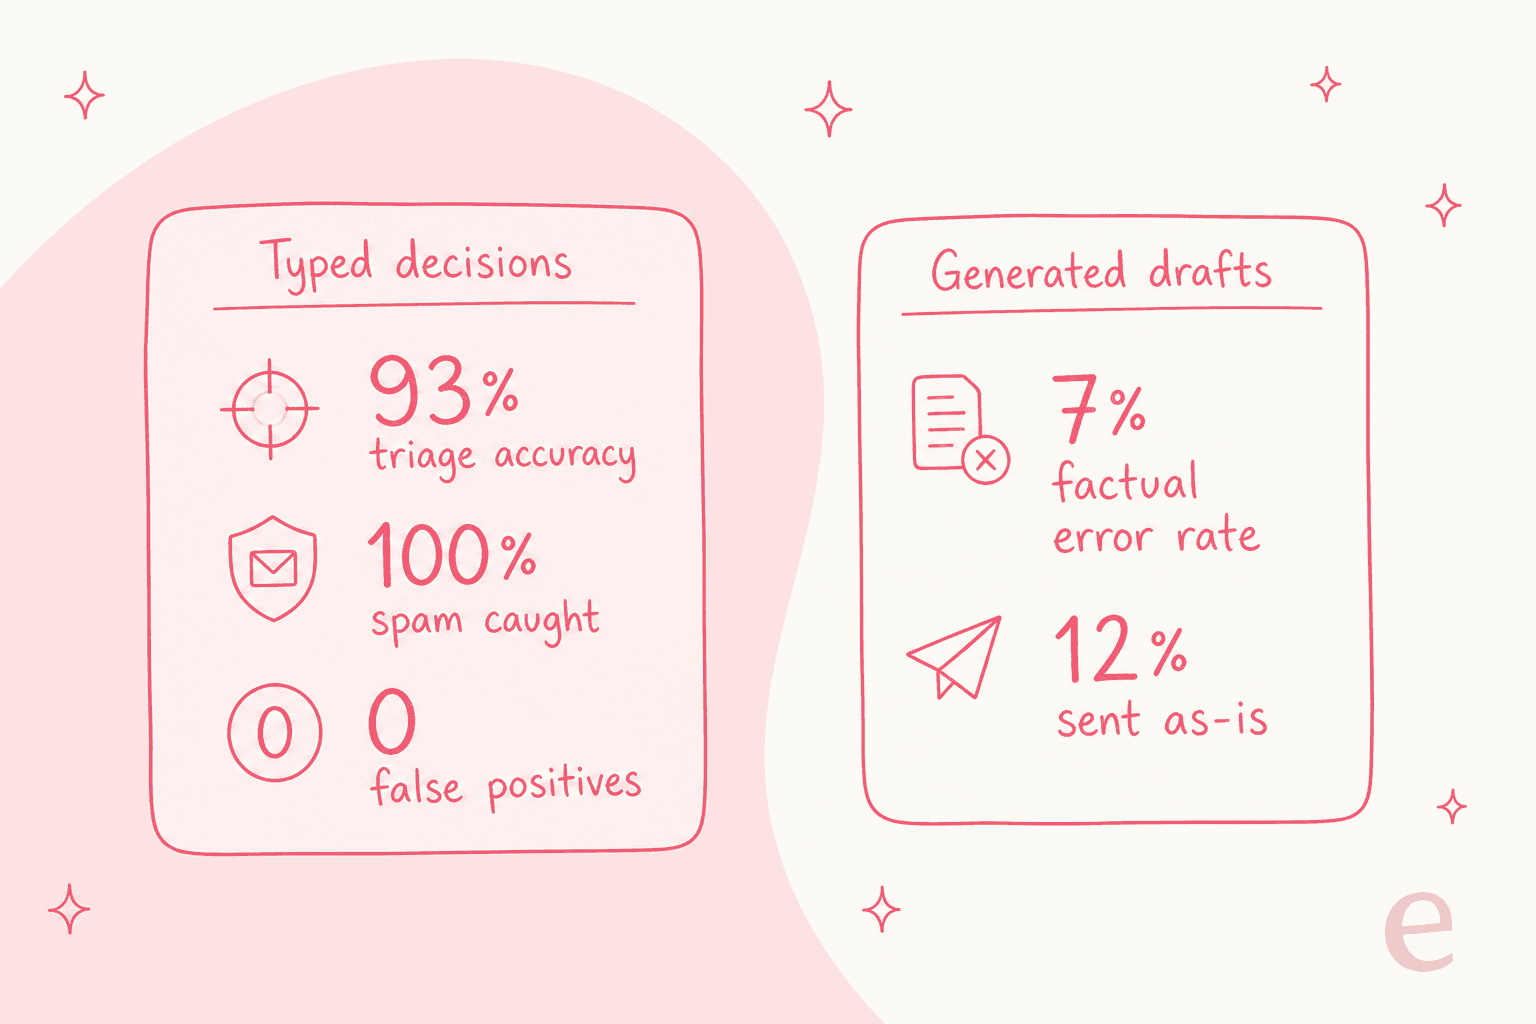
Esa es toda la razón por la que un modelo como Jev es emocionante, y también la razón por la que no es la meta. Un modelo de decisiones tipadas es infraestructura. El trabajo de soporte que se construye encima, conectar con el helpdesk, leer tu base de conocimiento, redactar la respuesta, ejecutar la acción, saber cuándo escalar y demostrar que funciona antes de salir en vivo, es el trabajo de un empleado.
Esa es la línea en la que se sitúa eesel. Donde Jev es una pieza rápida, el compañero de equipo de IA para helpdesk de eesel es la contratación lista para trabajar: se conecta a las principales integraciones de helpdesk (Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot), y luego triaja, redacta y resuelve en tu cola en vivo.
Fundamentalmente, simula sobre tickets pasados antes de responder a un solo cliente, así que ves la precisión sobre tus propios datos en lugar de en un gráfico de lanzamiento. Factura por ticket gestionado, no por asiento, así que la economía sigue el trabajo real.
Y para los desarrolladores a los que va dirigido realmente este post, eesel no es solo un panel. El mismo compañero de equipo se puede manejar desde la CLI de eesel (npx @eesel/cli): una persona puede ejecutarlo desde una terminal, los scripts pueden automatizarlo en CI con un token de API, y agentes de programación como Claude Code, Codex y Cursor pueden operarlo directamente. Puedes conectar una integración, editar las instrucciones permanentes, listar y aprobar acciones con humano en el bucle, y leer el registro de actividad ejecución por ejecución, todo como JSON, con --dry-run para previsualizar una escritura antes de que se dispare. Cada workspace es también un servidor MCP, así que el mismo agente que apuntarías a Jev puede apuntar a tu compañero de equipo de soporte. La plantilla tampoco se limita al soporte; hay un compañero de equipo redactor de blog con IA para contenido. Si te gusta Jev porque trata la inteligencia como código, esa es la misma razón para que te guste operar un compañero de equipo desde la terminal.
Mi veredicto
Jev es uno de los lanzamientos de modelos más interesantes del año precisamente porque no persigue un chatbot mejor. Es una primitiva real y útil: decisiones rápidas, baratas y type-safe con confianza calibrada, y un modelo mental limpio para componerlas en código. La velocidad y el precio se sostienen para lo que están pensados, la afirmación de «no puede alucinar» está sobrevendida, y el titular del benchmark suena más fuerte que la realidad (todavía buena) que hay debajo.
Si eres desarrollador y estás montando sistemas agénticos, apúntate a la lista de espera y úsalo exactamente donde es fuerte: las decisiones de alto volumen que estabas forzando a hacer a un modelo grande. Para el panorama más amplio de cómo se ven estos sistemas en producción, nuestros resúmenes de ejemplos de agentes de IA y los mejores compañeros de equipo con IA son una buena siguiente lectura.
Solo no confundas el reflejo con todo el sistema nervioso. La decisión es la pulgada fácil; el trabajo de principio a fin sigue siendo la milla.
Preguntas frecuentes
¿Qué es TypeSafe Jev?
Jev es el primer modelo System One de TypeSafe AI, lanzado el 15 de septiembre de 2026. En lugar de generar texto como un chatbot, evalúa preguntas tipadas frente a un estado y devuelve decisiones estructuradas con puntuaciones de confianza. Está más cerca de un clasificador rápido que de un LLM general, que es justo el punto central de este análisis de TypeSafe Jev.
¿Jev es un LLM?
No, y TypeSafe se cuida de dejarlo claro. Jev no razona en prosa ni escribe explicaciones. Devuelve un valor tipado más una probabilidad, y cualquier cosa más compleja se divide en preguntas separadas y se recombina en tu propio código. Si necesitas respuestas conversacionales, un modelo general o un agente de IA de soporte son la herramienta adecuada.
¿De verdad Jev no puede alucinar?
No puede cometer un error de tipo, porque la salida está restringida a tu esquema. Sí puede equivocarse con total seguridad en un juicio, que es el punto que más presionaron los comentaristas de Hacker News. La lectura honesta: una puntuación de confianza calibrada es una característica de seguridad real, pero «no puede alucinar» es más fuerte que lo que el modelo realmente garantiza.
¿Cuánto cuesta Jev?
TypeSafe fija el precio de entrada en 0,042 $ por millón de tokens y los tokens de salida son gratuitos. Todavía no hay una página de precios propia ni niveles de plan, y el acceso funciona mediante una lista de espera de acceso anticipado. En Cloudflare Workers AI, la facturación se gestiona desde el panel de Cloudflare.
¿Qué se puede construir con un modelo System One?
Decisiones estructuradas que tu código consume directamente: clasificación de tickets, enrutamiento, puntuación de urgencia y sentimiento, revisión de llamadas a herramientas y compactación de contexto. Encaja bien en cualquier sitio donde estuvieras forzando a un LLM a producir JSON y luego lo analizabas de vuelta. Para el trabajo de soporte de principio a fin sobre esas decisiones, consulta los mejores agentes de IA para atención al cliente.
¿Jev es mejor que GPT o Claude para soporte?
Son trabajos distintos. Jev es más rápido y más barato para la decisión concreta (¿es urgente? ¿qué cola?), mientras que un modelo como el mejor LLM para casos de uso de soporte sigue siendo el que redacta la respuesta. La mayoría de los sistemas en producción usarán ambos, o delegarán todo el flujo de trabajo a un compañero de equipo que ya conecta las piezas entre sí.
¿Cómo accedo a TypeSafe Jev?
Apúntate al acceso anticipado en console.typesafe.ai, úsalo mediante el id de modelo typesafe/jev de Cloudflare Workers AI, o envuelve un LLM existente con el adaptador System One de código abierto de TypeSafe. Todos los detalles están en la documentación.


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.