

Qué es realmente TypeSafe Jev
TypeSafe es un laboratorio de IA de San Francisco que pasó dos años en modo sigiloso antes de lanzar Jev. Su planteamiento es deliberadamente provocador: en la página de inicio de TypeSafe, los LLM "producen palabras para las personas", mientras que "Jev produce decisiones tipadas y se parece más al código: confiable, rápido, autoconsistente y type-safe". El post de lanzamiento llama a Jev "una llamada a función con inteligencia de frontera: estado no estructurado entra, decisiones probabilísticas tipadas salen".
El nombre es un juego de palabras con dos partes. "System One" toma prestado de Pensar rápido, pensar despacio de Daniel Kahneman: la distinción que planteó entre el pensamiento rápido e intuitivo del Sistema 1 y el razonamiento lento y deliberado del Sistema 2. Los modelos de chat persiguen el Sistema 2. Jev está construido para el Sistema 1: el juicio instantáneo que una persona con conocimiento hace en un par de segundos. "Jev" en sí lleva el nombre del economista William Stanley Jevons, cuya paradoja TypeSafe cita como su tesis: cada caída de un orden de magnitud en el costo de la inteligencia desbloquea órdenes de magnitud más casos de uso.
La premisa detrás de todo esto es que RLHF, la técnica que hizo que los chatbots fueran agradables para conversar, también los volvió poco fiables para el consumo por máquinas. La propuesta de TypeSafe es que "tomó la dirección de investigación opuesta" y entrenó una nueva clase de modelo con un nuevo algoritmo que llama Reinforcement Learning for Calibrated Decisions (RLCD).
Cómo funciona Jev: estado entra, decisiones tipadas salen
El bucle central es una solicitud a una respuesta. Envías un estado (ya sea un string simple o un objeto estructurado) más un conjunto de preguntas tipadas. Jev evalúa cada pregunta en paralelo contra ese mismo estado, y devuelve respuestas tipadas con probabilidades y confianza. Tu código entonces ramifica, ordena y enruta según esas respuestas.
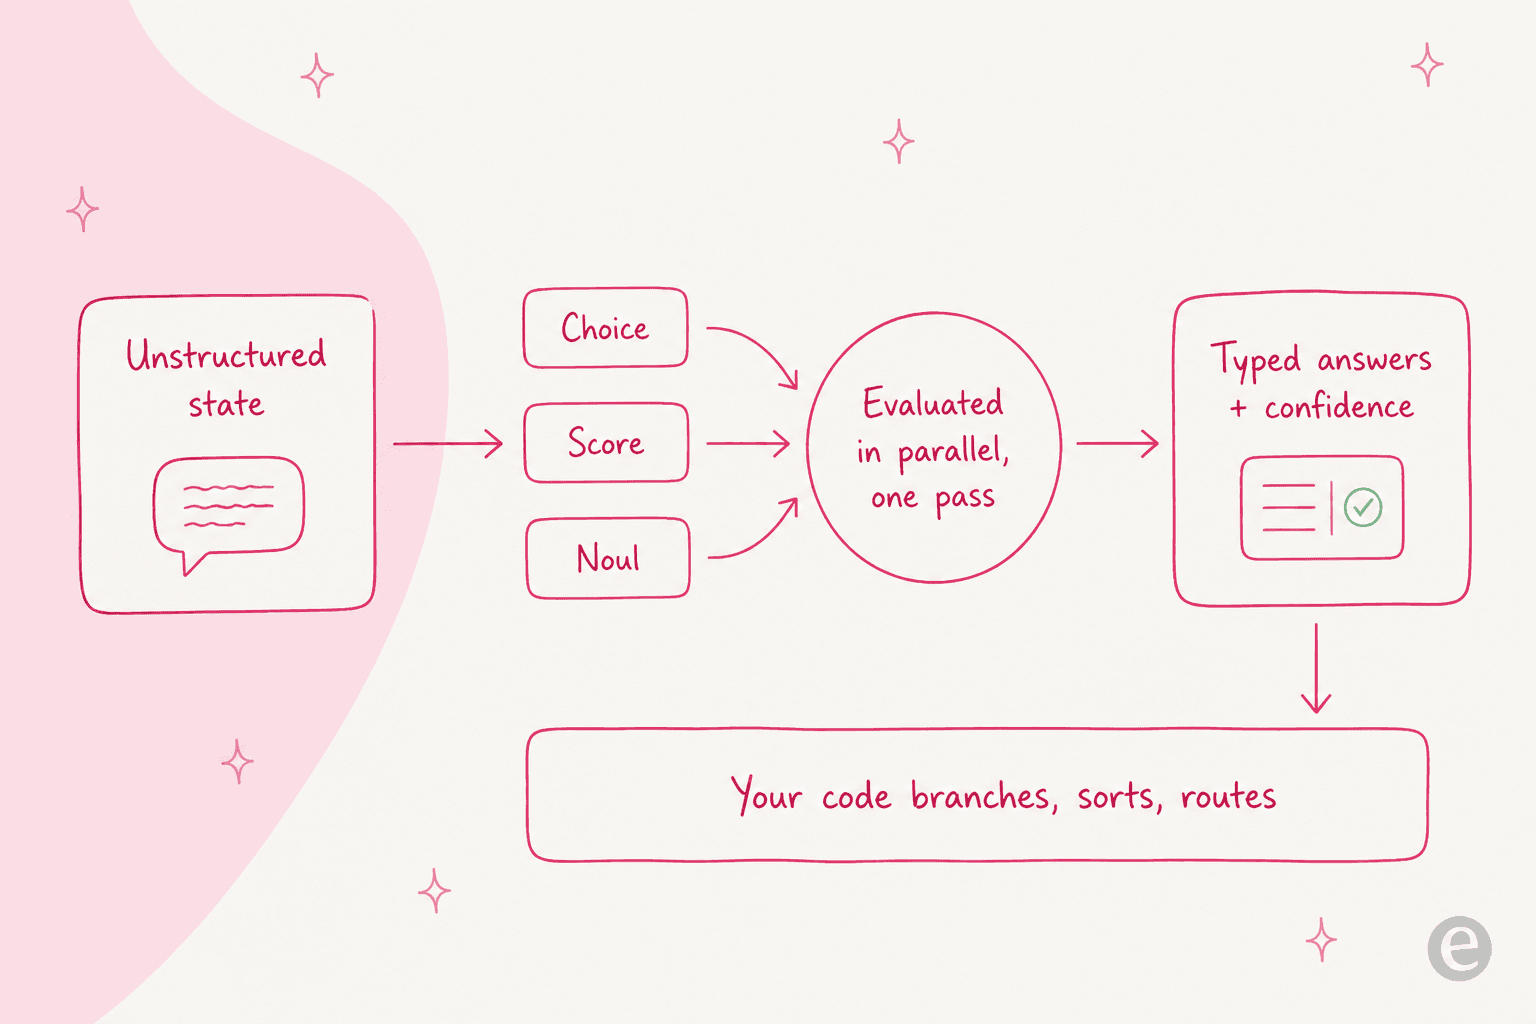
La decisión de diseño que más importa: cada pregunta se evalúa de forma independiente y aislada contra el mismo estado. TypeSafe dice que agregar preguntas apenas cambia el tiempo de respuesta, y como cada una se puntúa por separado, no obtienes el "context-rot" que se cuela cuando metes una docena de instrucciones en un solo prompt.
El consejo de TypeSafe es mantener cada pregunta atómica. En lugar de preguntar "califica este pitch de startup", preguntas cada dimensión por separado (tamaño de mercado, viabilidad técnica, diferenciación) y combinas las puntuaciones con tu propia fórmula. Cuando las prioridades cambian, cambias un coeficiente en el código en lugar de reescribir un prompt. Si alguna vez has peleado con un mega-prompt para que se comporte, ese instinto de descomposición te resultará familiar, y es la misma lógica detrás de una buena automatización de flujos de trabajo con IA.
Los tres primitivos: Noul, Choice y Score
Jev expone exactamente tres tipos de preguntas, y puedes mezclar los tres en una sola llamada a la API.
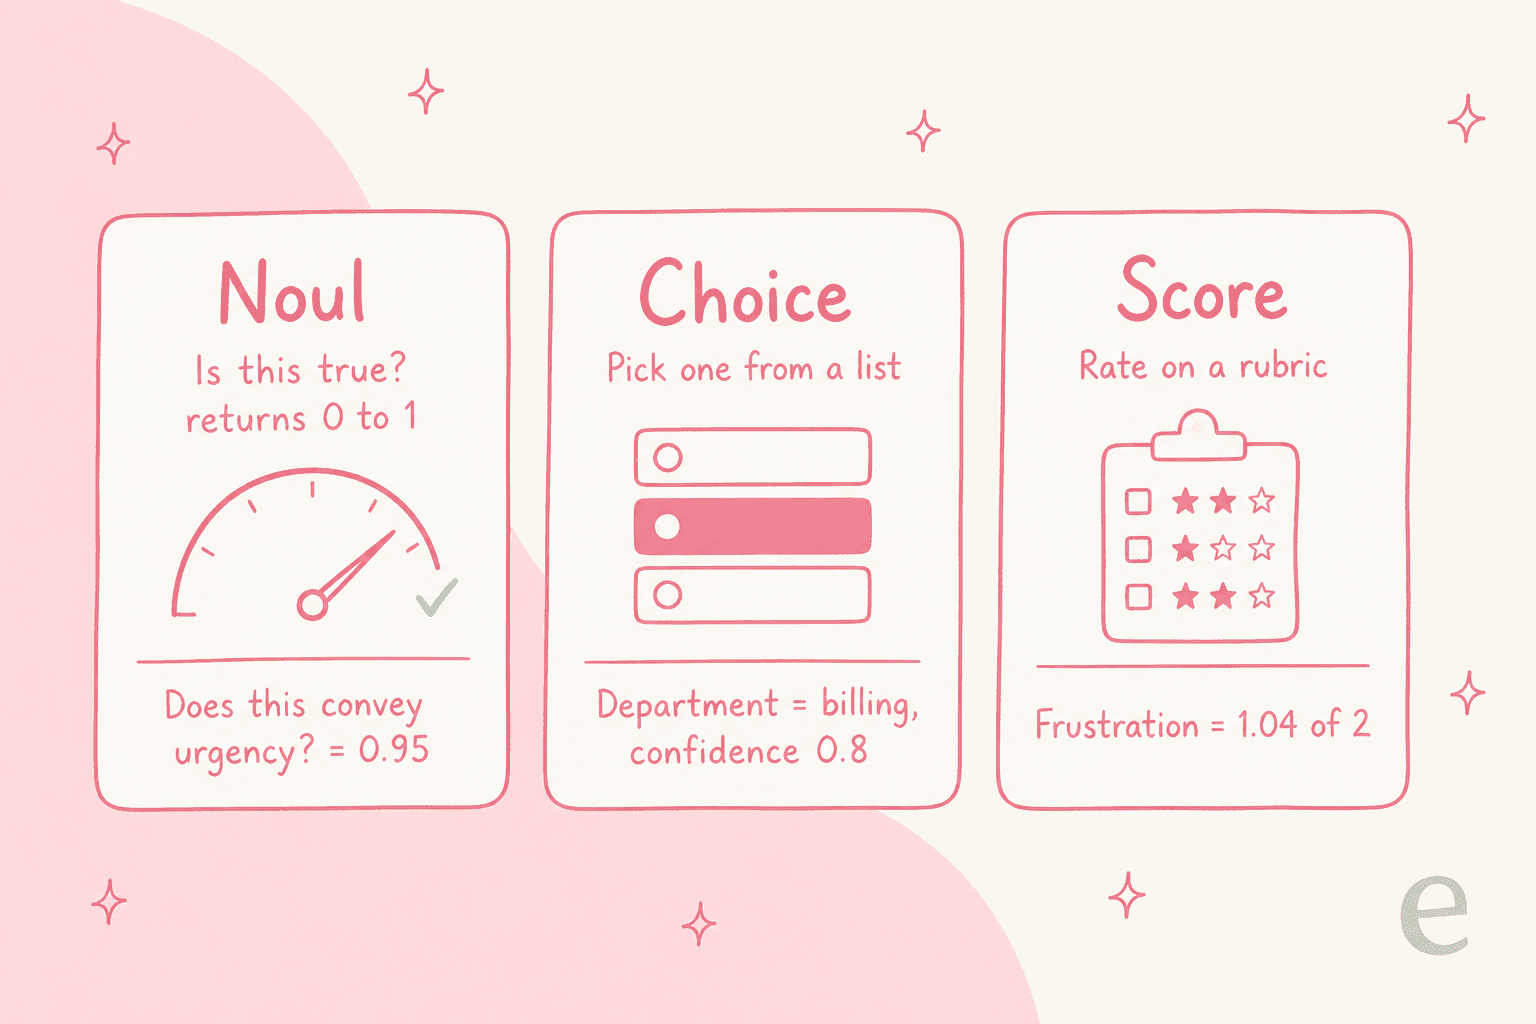
- Noul responde "¿es verdadera esta afirmación?" y devuelve una única probabilidad de 0 a 1.
- Choice elige una opción de una lista que defines, y devuelve la elección, probabilidades por opción y un valor de confianza.
- Score puntúa el estado según una rúbrica que defines, y devuelve un valor numérico (puede caer entre niveles, como 1,04 sobre 2), probabilidades por nivel y confianza.
El ejemplo trabajado que publica Cloudflare es, reveladoramente, un ticket de soporte. Dale a Jev el mensaje "Help! My payouts have been failing for 3 days" y tres preguntas mixtas, y responde con is_urgent (Noul) en 0,95, department (Choice) como billing con 0,8 de confianza, y frustration (Score) en 1,04 en una escala de calma a muy enojado, todo en una sola llamada. Eso es triaje, enrutamiento y sentimiento en una sola solicitud, exactamente el tipo de decisión que necesita un paso de triaje de tickets con IA.
Dónde Jev rompe con un LLM normal
Si solo te llevas un modelo mental, que sea este: un LLM escribe, Jev decide.
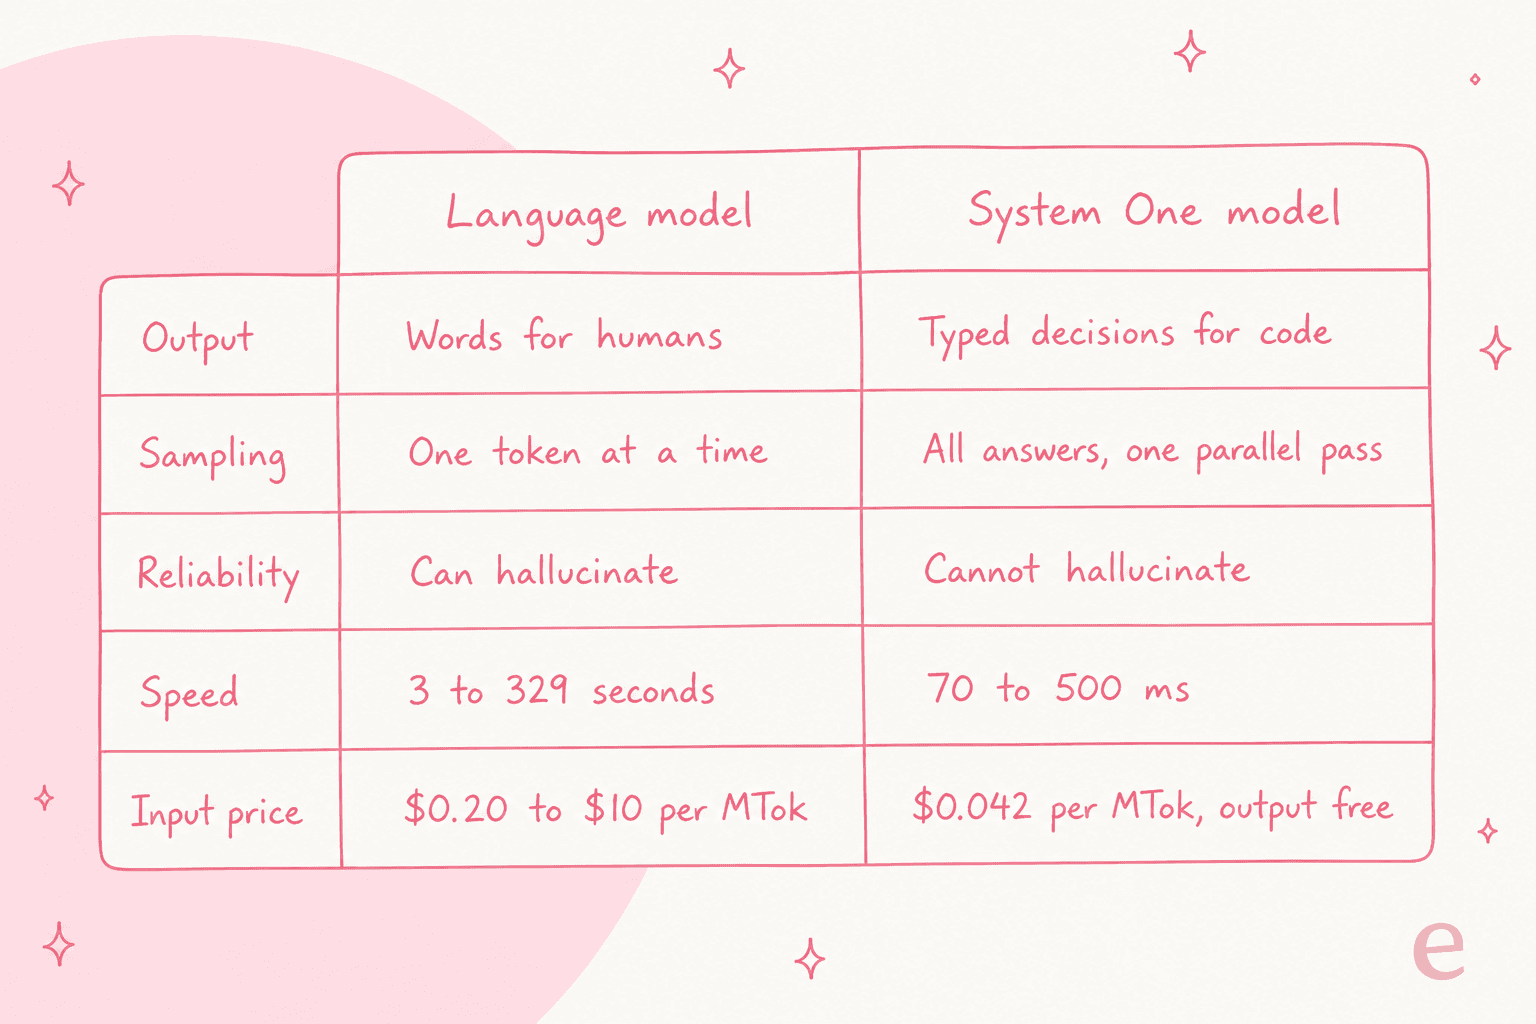
Un modelo de lenguaje muestrea un token a la vez, en secuencia, hasta producir un string que un humano lee. Jev genera todas sus salidas en un único paso paralelo y nunca produce texto libre en absoluto. Por eso es rápido, y también por eso la comparación no es del todo justa, un punto al que volveré. La conclusión práctica para quienes construyen es que Jev encaja en cualquier lugar donde actualmente estés forzando a un LLM a emitir un blob JSON que luego parseas y esperas que sea válido. Es la misma pregunta de "qué capa estoy eligiendo en realidad" que aparece en AgentKit frente a la API de Anthropic.
Las cifras que afirma TypeSafe
TypeSafe no se guarda las cifras, así que aquí están con sus salvedades.
| Afirmación | Jev | Referencia declarada por TypeSafe |
|---|---|---|
| Latencia de extremo a extremo | 70 ms a 500 ms | de 3 a 329 segundos para LLM de frontera |
| Múltiplo de velocidad | 40x a 200x más rápido | en consultas con forma System One |
| Titular de flujo de trabajo | 193,6x más rápido, 444,6x más barato | "en el extremo alto de las ganancias del mundo real" |
| Precio de entrada | 0,042 $ / MTok, salida gratuita | 238x menor que Claude Fable 5.1 |
| Ventana de contexto | 32.000 tokens | versión del modelo jev-1.13.0 |
Jev ya está en vivo en Cloudflare Workers AI como typesafe/jev, y TypeSafe está abriendo el acceso anticipado desde una lista de espera. Todavía no hay una página de precios independiente; la cifra de 0,042 $ proviene de la página de inicio y del post de lanzamiento. Sobre la sostenibilidad, TypeSafe es refrescantemente franco en su post de lanzamiento: "We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
El dato externo más creíble vino del CEO de Vercel, que puso a Jev en un producto real:
"We're seeing extraordinary results from @typesafeai. Default mode in 𝚏𝚡 is auto, with a safety reviewer analyzing every command. That reviewer runs on GPT Luna today. Jev is up to 18x faster (p95) and more accurate."
Una aceleración de 18x en un paso real de revisión de seguridad es una afirmación mucho más fundamentada que la cifra de marketing de 200x, y señala dónde brilla realmente Jev: el verificador rápido que se sitúa delante de un sistema más lento.
Qué significa realmente "no puede alucinar"
Esta es la afirmación que encendió el hilo de lanzamiento en Hacker News (1.929 puntos, 508 comentarios), y vale la pena detenerse en ella porque es lo que la mayoría de la gente entenderá mal.
Jev no puede cometer un error de tipo y no puede devolver una opción que no estaba en tu lista. En ese sentido mecánico, "no puede alucinar". Pero una respuesta tipada aún puede estar equivocada con alta confianza, y varios comentaristas lo señalaron con claridad:
"if it puts a high confidence value on a wrong answer, thats still hallucinating, no?"

La defensa es que Jev siempre te entrega un valor de confianza, así que puedes actuar sobre las respuestas seguras y enrutar las dudosas a un humano:
"they mean they produce a confidence value for every result, so you could see for example it has 0.1 confidence, and you can disregard the result."
La verdadera prueba es la calibración, no el eslogan de "no puede alucinar". Como dijo un comentarista, si el modelo dice 0,9 en mil respuestas, alrededor de 900 deberían ser correctas. Se supone que RLCD está optimizado exactamente para eso. Hasta que existan cifras de calibración independientes, trata "no puede alucinar" como "no devolverá una salida mal formada", no como "siempre tiene razón". Para cualquiera que despliegue IA en preguntas reales de clientes, esa distinción lo es todo, y por eso nos apoyamos tanto en el grounding y las pruebas para prevenir las alucinaciones de IA en soporte.
Quién está detrás de Jev
TypeSafe tiene una trayectoria difícil de ignorar. El fundador y CEO Diogo Almeida coinventó RLHF e InstructGPT en OpenAI, la línea de investigación que llevó a ChatGPT, y antes trabajó en Google Brain. Lo acompañan la COO Sasha Sheng (ex-Meta/FAIR) y el CTO Erik Gafni, con un equipo procedente de OpenAI, Google Brain, Meta, Stripe, Airbnb y Docker.
La empresa dice que está "respaldada por inversores de primer nivel" pero no ha publicado una cifra de financiación en sus propias páginas, así que no le pondré un número. El eslogan, "Build Prod, Not God", revela la postura: es un equipo que optimiza para lanzar piezas de producción confiables, no para perseguir la AGI.
¿Deberías usar Jev realmente?
Esta es mi lectura después de revisar la documentación, las demos y las críticas.
Recurre a Jev cuando el trabajo es una decisión estrecha y bien acotada que consume tu código: enrutamiento, moderación, detección de intención, puntuación, filtros de extracción, o una verificación de seguridad rápida delante de un modelo más grande. La opinión de desarrollador más convincente en Hacker News vino de alguien que ya hacía esto a mano:
"this is exactly how I am using LLMs in production, to narrowly make choices and return structured data... Jev's focus on structured I/O and confidence scores are game changing. If this does at all what it claims, I think this is going to quickly become the new standard approach for agentic systems."
No recurras a Jev cuando necesites generación, explicación o razonamiento en varios pasos. El comentario más votado de todo el hilo dio en el clavo con el planteamiento honesto:
"Seems like a more accurate title would be 'Jev: Trading general purpose generation for fast typed inference.'"
Y los escépticos más ruidosos, incluido el desarrollador Theo Browne, argumentaron que las demos virales lo empujan hacia trabajos que debería tener un clasificador simple o una regla. Es una advertencia justa: una herramienta tan rápida invita al sobreuso. La línea a mantener es que Jev es una pieza primitiva. Te da una gran decisión; tú sigues siendo responsable del pipeline, la lógica de escalamiento, la estrategia de deflection y cada acción que ocurre después de la decisión.
Prueba eesel
Si diriges soporte, la traducción honesta de todo esto es: Jev es un motor brillante, no un auto. Te dirá que un ticket es urgente, de facturación y viene de un cliente frustrado en 114 milisegundos. No abrirá el ticket, no redactará la respuesta fundamentada en tu centro de ayuda, no aplicará el reembolso ni lo transferirá a un humano cuando no esté seguro. Alguien todavía tiene que construir eso.
eesel es ese compañero de equipo terminado. Es un compañero de equipo de IA para soporte que conectas a tu helpdesk, y ya toma las decisiones de triaje, enrutamiento y escalamiento que Jev expone como primitivos, y luego actúa sobre ellas de principio a fin. Se une a tu cola de servicio al cliente existente, aprende de tus tickets pasados y tu centro de ayuda, y puedes simularlo contra tickets históricos antes de que toque a un cliente real.

Y si te gustó la ergonomía para desarrolladores de Jev, esto te va a gustar: eesel no es solo un panel. La CLI de eesel (npx @eesel/cli) opera al mismo compañero de equipo y espacio de trabajo desde una terminal. Una persona puede ejecutar eesel chat, eesel activity o eesel approvals a mano; los scripts pueden automatizarlo en CI; y agentes de programación como Claude Code, Codex y Cursor pueden manejarlo, ya que cada comando imprime JSON y --dry-run muestra la llamada exacta antes de ejecutarla. Cada espacio de trabajo es además un servidor MCP. Jev te da la decisión; eesel te da al compañero de equipo que actúa sobre ella, y permite que tus agentes lo operen. Puedes probar eesel gratis.
Preguntas frecuentes
¿Qué es TypeSafe Jev?
TypeSafe Jev es el primer modelo System One público: en lugar de generar texto, evalúa preguntas tipadas frente a un estado y devuelve decisiones tipadas con probabilidades y una puntuación de confianza. Está diseñado para los juicios estrechos y estructurados que el software consume directamente, como la triaje de nivel 1 y el enrutamiento.
¿Cuánto cuesta TypeSafe Jev?
TypeSafe fija el precio de Jev en 0,042 $ por millón de tokens de entrada, con la salida gratuita, lo que la empresa presenta como un precio de entrada 238 veces menor que Claude Fable 5.1. Todavía no hay una tabla de niveles de precios publicada, y el acceso es mediante una lista de espera de acceso anticipado.
¿De verdad Jev no puede alucinar?
No puede producir un error de tipo ni inventar una opción fuera de la lista que le diste, pero una respuesta tipada con alta confianza aún puede ser incorrecta, un punto debatido en Hacker News. La verdadera prueba es la calibración. Si quieres respuestas fundamentadas en una cola de soporte, aplica la misma disciplina que describimos en nuestra guía para prevenir alucinaciones de IA.
¿Es Jev un reemplazo para un LLM?
No. Jev toma decisiones tipadas rápidas, no escribe texto, no razona paso a paso ni mantiene una conversación. Muchos equipos lo combinan con un LLM, usando Jev para el paso de clasificar y enrutar, de forma similar a como funciona en la práctica una división entre un sistema basado en reglas y un agente de IA.
¿En qué se diferencia Jev de un agente de servicio al cliente de IA normal?
Jev es infraestructura: una pieza de decisión que conectas a tu propio código. Un producto de servicio al cliente con IA como eesel es el compañero de equipo terminado que toma esas decisiones y ejecuta la acción dentro de tu helpdesk. Incluso puedes manejarlo desde una terminal con la CLI de eesel.