Resumen
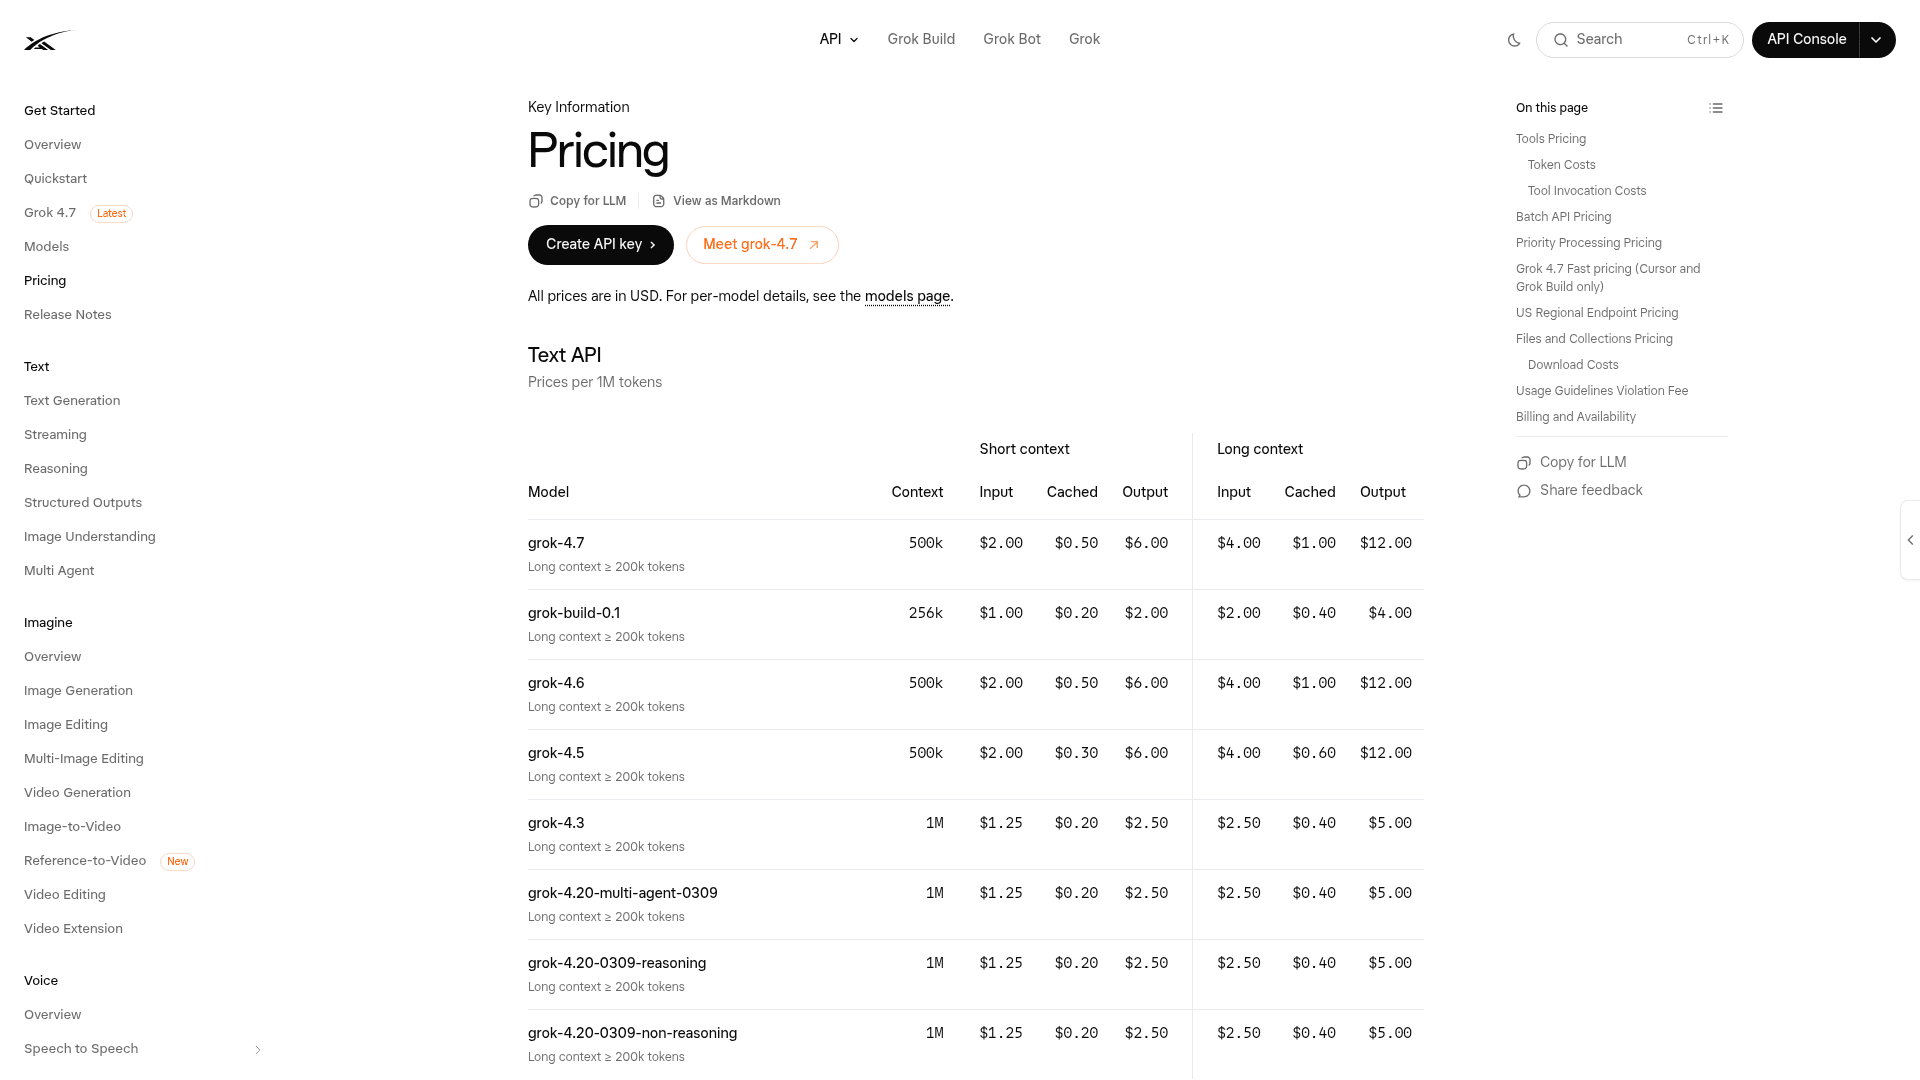
Grok 4.7 tiene un precio pensado para ejecutarse a volumen. En la API de xAI cuesta $2 por millón de tokens de entrada y $6 por millón de tokens de salida en solicitudes estándar, y salta a $4 / $12 en cuanto un prompt supera los 200k tokens. Es exactamente la misma tabla de precios que Grok 4.6, así que la mejora añade capacidad sin subir el medidor.
Frente a la competencia, ese precio de salida es la noticia. Grok 4.7 iguala a GPT-6 Sol en entrada ($2) pero es un 40% más barato en salida ($6 frente a $10), y es una quinta parte de la tarifa de Fable 5.1. La trampa está en lo que no aparece en la etiqueta: el precipicio de contexto largo en 200k que repriza toda tu solicitud, la variante Fast que duplica el precio por token, y los medidores de llamadas a herramientas por uso que se acumulan en silencio cuando un agente busca y ejecuta en un bucle.
Llevo los últimos tres años y medio poniendo agentes de IA en colas de soporte reales, y la cifra que realmente decide qué modelo se despliega nunca es el benchmark más alto, es la factura por token una vez que un agente lleva miles de tickets al día en bucle. Así que este artículo trata sobre la factura: la tabla de precios completa, los medidores que la mayoría de modelos de coste pasan por alto, y cómo se compara Grok 4.7 con los precios de GPT-6 Sol y los precios de Fable 5.1 cuando los tokens se acumulan.
Introduce tu propio volumen mensual de tokens para ver dónde queda Grok 4.7 frente a GPT-6 Sol y Fable 5.1. El interruptor de contexto largo cambia Grok a sus tarifas de 200k en adelante.
Precios de Grok 4.7 de un vistazo
Aquí está la tabla de precios, directamente de la fuente en vez de una cifra "desde".
| Nivel | Entrada / 1M | Entrada en caché / 1M | Salida / 1M |
|---|---|---|---|
grok-4.7, prompt por debajo de 200k | $2.00 | $0.50 | $6.00 |
grok-4.7, prompt de 200k en adelante | $4.00 | $1.00 | $12.00 |
| Grok 4.7 Fast (solo Cursor y Grok Build) | 2x las tarifas anteriores | 2x | 2x |
La ventana de contexto de 500k y las tarifas por token no han cambiado respecto a Grok 4.6, que es el titular de este lanzamiento para un comprador: obtienes un modelo más potente en el mismo medidor. Las mejoras se dieron en el trabajo agéntico de largo alcance, y el precio no se movió para pagarlas.
Un detalle interesante para la API: el esfuerzo de razonamiento es configurable entre bajo, medio, alto y xhigh, así que puedes ajustar cuánto piensa el modelo por solicitud. Como los tokens de salida cuestan 3 veces más que los de entrada, y el razonamiento consume tokens de salida, el esfuerzo es una palanca de coste real, no solo de calidad. Bajar el esfuerzo en las llamadas fáciles es la optimización más barata que no estás haciendo.
El precipicio de contexto largo en 200k
Esto es lo más caro que se puede pasar por alto en los precios de Grok 4.7. En cuanto el prompt de una solicitud supera los 200k tokens, las tarifas de contexto largo se aplican a cada token de la solicitud, no solo al excedente por encima de 200k.
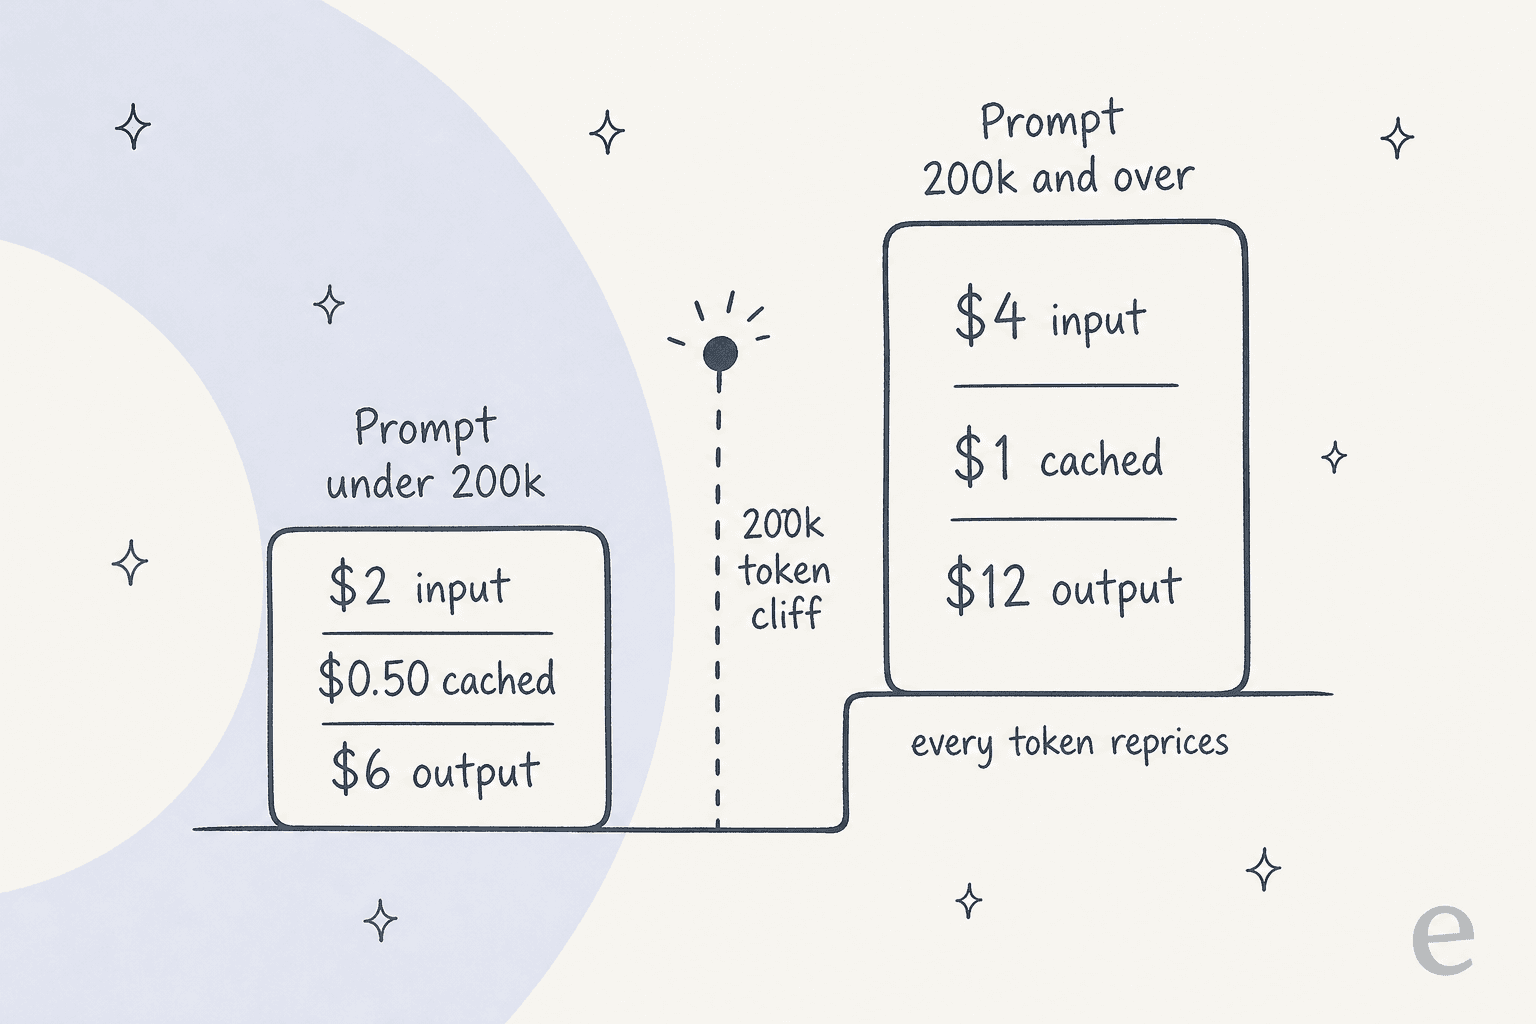
Así que un prompt de 210k tokens se factura íntegramente a $4 / $12, no en su mayoría a $2 / $6. Eso es una duplicación provocada por los últimos 10k tokens. Para un bucle de agente largo que va acumulando contexto lentamente, mensaje a mensaje, el precipicio es una trampa real: la ejecución se vuelve silenciosamente el doble de cara en el momento en que se cae, y nada en las cabeceras de la respuesta lo avisa antes.
xAI sabe esto claramente, porque lanzó una Context Compaction API específicamente para reducir las conversaciones antes de que crucen la línea. Si ejecutas algo largo, presupuesta tiempo de ingeniería para mantener los prompts en el lado barato de los 200k, o acepta que algunas de tus solicitudes se facturarán silenciosamente al doble. Este es el tipo de detalle que hace que el precio por token parezca predecible en una hoja de cálculo e impredecible en la factura.
Los medidores que la mayoría de modelos de coste pasan por alto
Las tarifas por token son el titular, pero no son toda la factura. En la API, la página de precios de xAI lista una serie de medidores por llamada que se suman a los tokens, y importan mucho para agentes que hacen algo más que chatear:
- Búsqueda web, búsqueda en X y ejecución de código: $5 por 1.000 llamadas cada uno.
- Búsqueda en archivos adjuntos: $10 por 1.000 llamadas.
- Búsqueda de colecciones (la de recuperación estilo RAG): $2.50 por 1.000 llamadas.
- Priority Processing: duplica todas las tarifas de tokens, y solo se factura cuando la respuesta confirma que se ejecutó en el nivel prioritario.
- Tarifa por infracción de las directrices de uso: $0.05 por una solicitud bloqueada antes de generarse.
Ninguno de estos rompe el banco por sí solo. Pero un agente que busca en la web, recupera de una base de conocimiento y ejecuta código en cada ticket dispara tres o cuatro llamadas facturables por turno, y esa es una partida que tus cálculos de tokens no mostrarán. Si estás modelando el coste de un agente de IA, es en estos medidores donde suele esconderse la sorpresa.
También hay una nota sobre lotes que conviene conocer: el descuento del 20% por lote de xAI no aplica a Grok 4.7. Solo cubre las variantes más antiguas grok-4.3 y grok-4.20, así que si tienes un trabajo voluminoso y tolerante a la latencia, ejecutarlo en Grok 4.3 en lote puede salir más barato por token que Grok 4.7 a tarifas estándar. Es una bifurcación real para las cargas de trabajo sin conexión.
Grok 4.7 Fast, y el recargo del 2x
Grok 4.7 Fast es el mismo modelo, servido a aproximadamente el doble de velocidad de salida por el doble de precio por token. Solo está disponible dentro de Cursor y Grok Build, no en la API pública.
El intercambio es latencia pura por dinero. Pagas $4 / $12 (u $8 / $24 tras el precipicio) para recortar segundos de la respuesta. Vale la pena en una sesión de codificación interactiva en la que estás viendo el código transmitirse y cada segundo de espera rompe el flujo. Es un desperdicio en trabajos por lotes, ejecuciones nocturnas o cualquier tarea en segundo plano donde nadie está mirando el cursor. Mi regla general: Fast para el primer plano, estándar para todo lo demás.
Dónde puedes (y no puedes) comprar Grok 4.7
La vía de compra cambia el precio efectivo más de lo que la mayoría espera, así que vale la pena mapearla antes de decidirte.
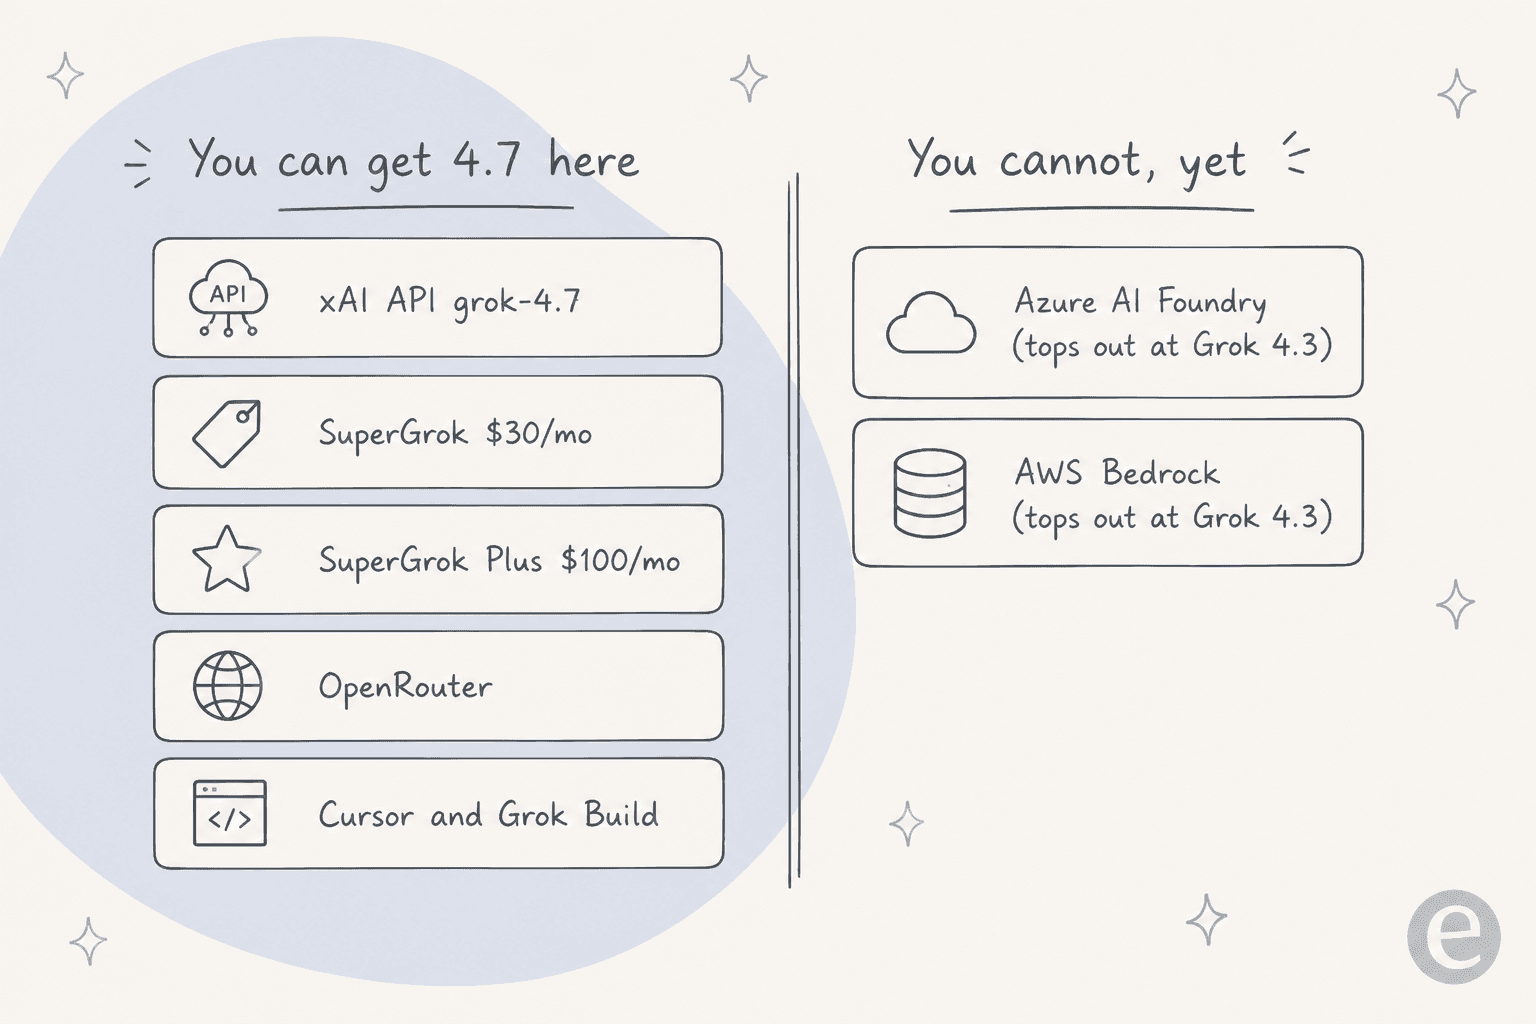
- API de xAI (
grok-4.7): el precio de referencia, $2 / $6, y el lugar donde deberías modelar tu factura. - SuperGrok y SuperGrok Plus: las suscripciones para consumidores, $30/mes y $100/mes. Buenas para una persona que usa Grok en la app, no para volumen programático.
- OpenRouter: traslada los precios del proveedor sin margen de inferencia, pero cobra un 5.5% en las compras de crédito (mínimo $0.80), y los créditos caducan al año. Su valor está en el precio efectivo real y medido: en Grok 4.6, el caché intensivo llevó el precio de entrada promedio ponderado muy por debajo del precio de lista, un adelanto de cómo se facturará 4.7 en tráfico favorable al caché.
- Cursor y Grok Build: donde vive la variante Fast, y un buen lugar para probar el modelo antes de conectar la API.
La brecha que conviene señalar: Azure AI Foundry y AWS Bedrock llegan como máximo a Grok 4.3, con precios en torno a $1.25 / $2.50. Si tu empresa exige la compra a través de un marketplace en la nube, no puedes comprar Grok 4.7 ahí en absoluto, al menos no todavía. Es una limitación real, no una crítica, y es el tipo de detalle que decide la elección de modelo para compradores empresariales, al margen de la tabla de precios.
Grok 4.7 frente a GPT-6 Sol y Fable 5.1 en precio
Aquí está la comparación actual, usando las tarifas publicadas por cada proveedor. Nótese que el propio material de lanzamiento de xAI comparaba con el GPT-5.6 Sol más antiguo a $4 / $20, pero OpenAI ha lanzado desde entonces GPT-6 Sol a la mitad de ese precio, así que este es el panorama real al que se enfrenta un comprador hoy.
| Modelo | Entrada / 1M | En caché / 1M | Salida / 1M |
|---|---|---|---|
| Grok 4.7 | $2.00 | $0.50 | $6.00 |
| GPT-6 Sol | $2.00 | $0.20 | $10.00 |
| Fable 5.1 | $10.00 | n/d | $50.00 |
El patrón es claro. Grok 4.7 iguala a GPT-6 Sol en entrada y lo supera en un 40% en salida, que es donde un agente hablador gasta la mayor parte de su dinero. Frente a Fable 5.1, Grok cuesta más o menos una quinta parte por token. Fable sigue liderando en codificación de máximo nivel y trabajo de terminal de largo alcance, así que la pregunta real nunca es "cuál es más inteligente" (a menudo Fable), sino "cuánto estoy dispuesto a pagar por cada punto adicional".
Llevado a términos por tarea: un solo turno de agente de 50k de entrada más 10k de salida cuesta alrededor de $0.16 en Grok 4.7, $0.40 en GPT-6 Sol y $1.00 en Fable 5.1. Repite eso diez mil veces al día y la diferencia es toda la razón por la que las cargas de trabajo de alto volumen optan por defecto por el modelo de salida barata. Una advertencia que he aprendido por las malas: más barato por token no siempre es más barato por tarea, porque un modelo que emite más tokens de razonamiento para terminar el mismo trabajo puede anular su ventaja de tarifa. Modélalo con tu propio tráfico usando la calculadora de arriba antes de cambiar. Si estás sopesando esto frente a un modelo premium, nuestro desglose de precios de Claude Opus 5.5 hace el mismo punto por tarea con más detalle.
¿Merece la pena el precio de Grok 4.7?
Para cualquiera que escriba código, construya agentes de IA o despliegue en la API donde el coste por token se acumula, sí, con comodidad. La combinación de puntuaciones cercanas a la vanguardia y los precios de Grok 4.6 es todo el argumento, y las mejoras de largo alcance significan que aguanta bien en trabajos que se prolongan, no solo en prompts de una sola vez. Si quieres la lectura más profunda de capacidades, nuestra visión general de Grok 4.7 cubre los benchmarks.
Los usuarios intensivos confirman el ángulo de "dejarlo correr constantemente". Un suscriptor veterano de Grok describió cómo lo integró en tareas cotidianas y nunca llegó a acercarse al límite:
"Tengo un bot de Grok que vigila mi correo cada 15 minutos y archiva cosas por mí. Tengo otro bot que vigila los resultados de análisis de sangre... y nunca me acerco siquiera a agotar mi cuota."

Esa es la forma de un modelo con precio pensado para el volumen: invita a dejarlo funcionando. Donde ajustaría las expectativas es en los medidores y el precipicio. El precio de etiqueta es bajo, pero un agente que busca, recupera y ejecuta código en cada turno, sobre prompts que se acercan a los 200k tokens, facturará muy por encima de los "$2 / $6" que presupuestaste. Grok 4.7 es barato para empezar y fácil de subestimar, la misma trampa que tiende todo modelo con precio por token.
El precio por token es un medidor, no una factura predecible
Aquí está el replanteamiento, porque es lo que se le escapa a una simple comparación de precios. Cada cifra de este artículo es una lectura del medidor, no una factura. Grok 4.7 es infraestructura: un motor brillante que alquilas por token, que llega sin saber nada de tu empresa, tus tickets, tu tono ni tus herramientas. Para convertirlo en algo que haga un trabajo real, alguien tiene que construir el arnés, conectar el conocimiento, cablear las integraciones, escribir las barreras de seguridad, gestionar la escalación, y luego seguir vigilando un medidor que se repriza a sí mismo a los 200k tokens y añade $5 cada mil búsquedas.
Esa brecha es toda la idea detrás de eesel. En lugar de un modelo y un arnés en blanco, eesel es una plataforma de compañeros de equipo de IA donde contratas compañeros listos para trabajar para un trabajo concreto. La plantilla actual incluye un compañero de equipo de IA para helpdesk que se une a tu cola de soporte y un redactor de blog de IA que investiga y redacta artículos largos. Cada uno llega ya con las habilidades, integraciones y contexto de empresa que su rol necesita, funcionando por debajo sobre modelos punteros como este, así que obtienes la capacidad sin ser dueño de la tontería, ni del medidor.

La diferencia de precio es el punto clave: eesel factura por ticket resuelto, no por token, así que el coste refleja el trabajo realizado en vez de lo verboso que estuvo el modelo ese día. No estás pronosticando tokens de salida ni esquivando un precipicio de contexto largo, estás pagando por resultados.
Y si Grok 4.7 te gustó porque vives en una terminal, eesel te encuentra ahí mismo. La CLI de eesel opera el mismo compañero de equipo y el mismo espacio de trabajo que el panel, pero desde la línea de comandos: una persona puede ejecutarla, los scripts pueden automatizarla, y agentes de codificación como Claude Code, Codex y Cursor pueden manejarla. Puedes revisar las instrucciones de un compañero de equipo, enviar un mensaje de prueba, leer de vuelta el resultado en JSON y la actividad, y proponer un cambio acotado para que lo apruebe un responsable, todo sin salir de tu terminal. Es el mismo atractivo de "operar el agente de forma programática" que hace atractiva a una API de modelo en bruto, pero dirigido a un empleado que ya conoce el trabajo. Puedes probar eesel gratis.
Preguntas frecuentes
¿Cuánto cuesta Grok 4.7?
El precio de Grok 4.7 es de $2 por millón de tokens de entrada, $0.50 por millón de tokens de entrada en caché y $6 por millón de tokens de salida para cualquier solicitud cuyo prompt esté por debajo de 200k tokens, según la página de precios de xAI. Al superar los 200k tokens de prompt, las tarifas se duplican a $4 / $1 / $12 en cada token de esa solicitud. Es exactamente la misma tabla de precios que Grok 4.6.
¿Cuál es el precio de la API de Grok 4.7 por millón de tokens?
En la API de xAI, grok-4.7 cuesta $2 de entrada y $6 de salida por millón de tokens en el nivel estándar de contexto corto. Esa es la cifra sobre la que modelar tu factura. La página de precios de Grok 4.7 también lista medidores de llamadas a herramientas (búsqueda web y en X, ejecución de código a $5 por 1.000 llamadas) que se suman a los tokens en cargas de trabajo agénticas.
¿Qué es el precipicio de precios de contexto largo de Grok 4.7?
En cuanto el prompt de una solicitud llega a 200k tokens o más, xAI factura toda la solicitud a la tarifa de contexto largo de $4 / $1 / $12 por millón, no solo los tokens que superan los 200k. Un prompt de 210k tokens se factura íntegramente a la tarifa más alta. xAI ofrece una Context Compaction API para reducir las conversaciones antes de que caigan por el precipicio.
¿Qué es Grok 4.7 Fast y cuánto más cuesta?
Grok 4.7 Fast es el mismo modelo servido a aproximadamente el doble de velocidad de salida por el doble de precio por token. Solo está disponible dentro de Cursor y Grok Build, no en la API pública. Vale la pena la prima cuando la latencia importa, como al ver el código transmitirse en directo, y es un desperdicio en trabajos por lotes o en segundo plano.
¿Es Grok 4.7 más barato que GPT-6 Sol o Fable 5.1?
En tokens de salida, sí. Grok 4.7 cuesta $2 / $6, GPT-6 Sol cuesta $2 / $10, y Fable 5.1 cuesta $10 / $50. Grok iguala a GPT-6 Sol en entrada y lo supera en un 40% en salida, y es una fracción de la tarifa de Fable. Para trabajo de agentes de alto volumen, Grok 4.7 suele ser la opción de clase puntera más barata.
¿Cuánto cuesta Grok 4.7 para consumidores?
En x.ai/pricing, el nivel de pago más barato que incluye el Grok más reciente es SuperGrok a $30/mes, con SuperGrok Plus a $100/mes. Hay un nivel gratuito con límites. Si prefieres llamar a Grok 4.7 de forma programática, ese es el precio de la API de $2 / $6, no la suscripción.
¿Puedo usar Grok 4.7 en Azure o AWS Bedrock?
Todavía no. Azure AI Foundry y AWS Bedrock llegan como máximo a Grok 4.3 en el momento de escribir esto, así que un comprador con mandato de nube no puede adquirir Grok 4.7 a través de ellos. Puedes acceder a él en la API de xAI, a través de OpenRouter, o dentro de Cursor y Grok Build.
¿Merece la pena el precio de Grok 4.7 frente a pagar por resultado?
El precio por token te recompensa por optimizar los prompts y te penaliza por el contexto largo, así que tu factura es tan predecible como tu tráfico. Si prefieres pagar por ticket resuelto en vez de por token, un compañero de equipo de IA como eesel corre por debajo sobre modelos punteros pero factura por resultado, de modo que el coste refleja el trabajo hecho.


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.