Qué es Grok 4.7
Grok 4.7 es el modelo insignia de xAI para código, agentes y trabajo de conocimiento, publicado como grok-4.7 en la API de xAI. Mantiene la ventana de contexto de 500k tokens de Grok 4.6, acepta texto e imagen y devuelve texto, y expone un esfuerzo de razonamiento configurable en bajo, medio, alto y xAlto. Su fecha de corte de conocimiento es mayo de 2026, y como todo modelo Grok, no tiene conciencia de eventos en vivo salvo que actives las herramientas de búsqueda web y de X en el servidor.
Lo interesante está en cómo se construyó. xAI entrenó 4.7 sobre un modelo base nuevo y más grande que 4.6, y luego ejecutó una pasada de aprendizaje por refuerzo más larga sobre una mezcla de tareas más difícil, orientada a problemas que llevan muchas horas. También se entrenó para entender de forma nativa el entorno de Grok Bot, lo que explica por qué se siente más fluido en trabajo de múltiples pasos con llamadas a herramientas de lo que suele ser un modelo de chat en bruto. Junto a él llega una función de API totalmente nueva: una API de compactación de contexto para mantener historiales largos por debajo del umbral de precios.
Grok 4.7 es el cerebro de texto y código de una gama más amplia, y esta reseña trata únicamente de ese modelo. Si buscabas las otras piezas, xAI las separa: Grok Imagine se encarga de imagen y video, la API de Grok Voice se encarga del habla, y el lado del creador de agentes vive en Grok Bot. Todo lo que sigue trata únicamente de grok-4.7.
Qué cambió realmente respecto a Grok 4.6
La mejora de Grok 4.5 a 4.6 fue incremental, como señaló la reseña de Grok 4.5. El salto a 4.7 no lo es, al menos en un aspecto. La forma más clara de verlo son las diferencias de benchmarks que publicó xAI.
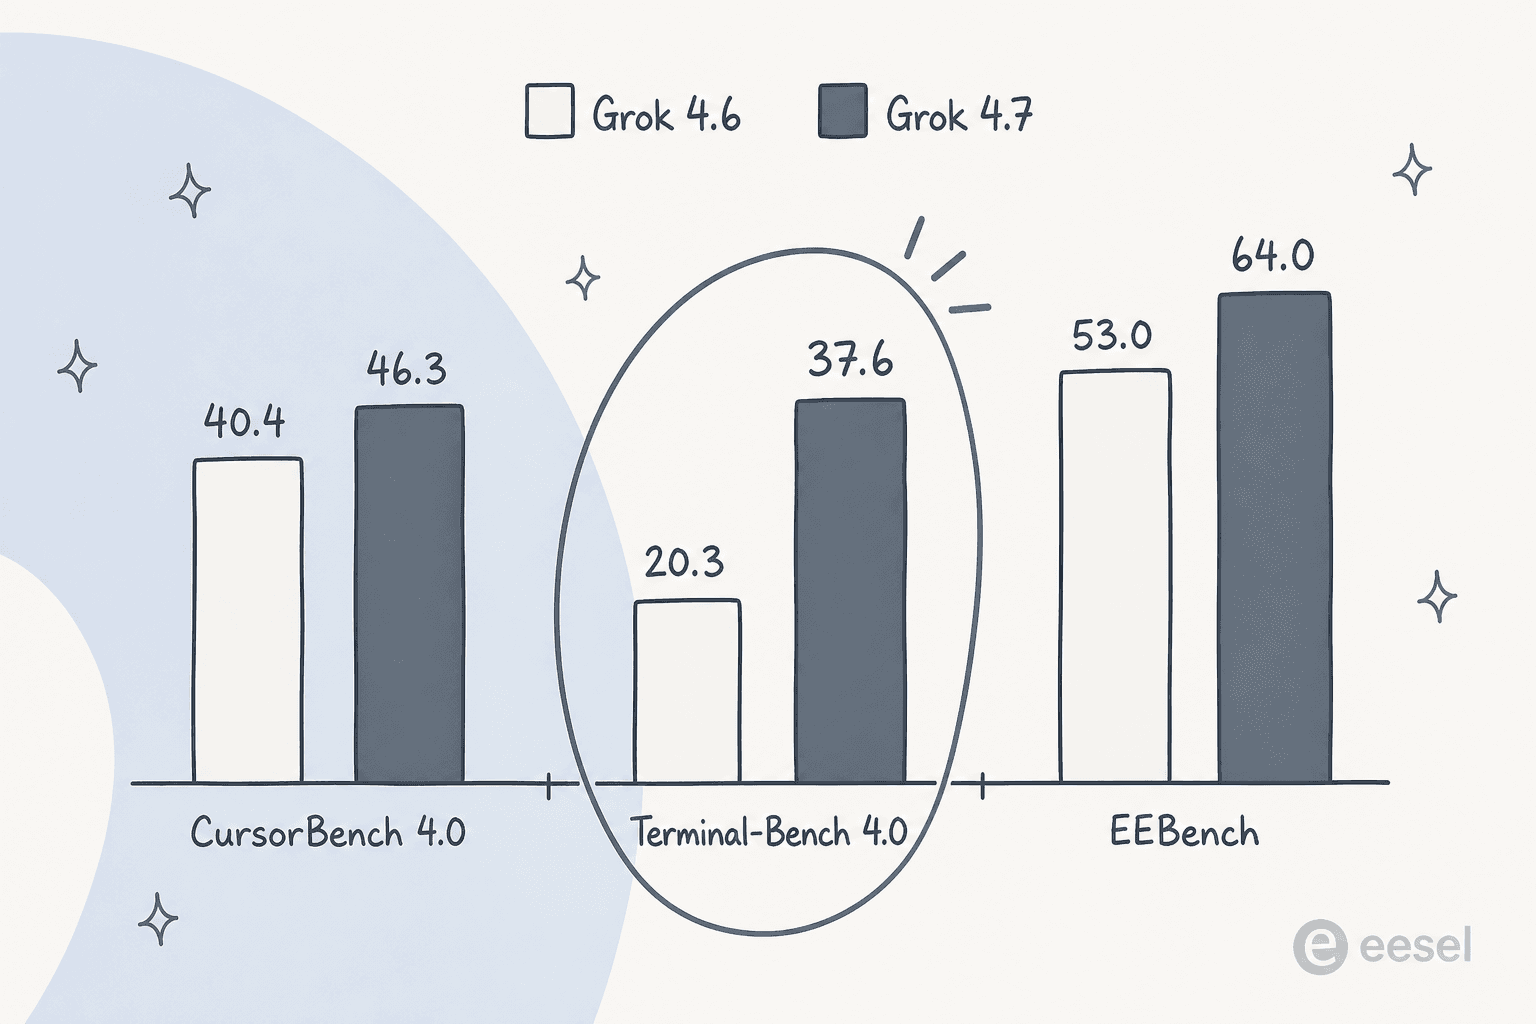
CursorBench 4.0 pasó de 40,4 a 46,3, y EEBench (ingeniería eléctrica) de 53,0 a 64,0. Son avances sólidos. El más destacado es Terminal-Bench 4.0, que casi se duplicó de 20,3 a 37,6, la mayor ganancia individual entre 4.6 y 4.7, y una lectura directa de lo bien que el modelo sostiene un trabajo de terminal largo y de varios pasos sin perder el hilo. Si tu caso de uso es un agente que avanza por una lista de tareas real en lugar de responder a un solo prompt, este es el número que importa, y es el que la reseña de Grok 4.6 no podía mostrarte todavía.
El resto de las mejoras son más discretas: mejor autoverificación, un manejo más estable del contexto largo y una salida más sólida en documentos y presentaciones, lo que se traduce en ganancias en los benchmarks de trabajo profesional GDPval y AA Briefcase. Nada de eso es gratis en otros sitios, y aquí llega al mismo precio.
Los benchmarks, leídos con honestidad
xAI comparó Grok 4.7 xHigh con Grok 4.6 High, GPT-5.6 Sol Max y Fable 5.1 Max. Aquí está la tabla principal, directa de la página de lanzamiento, para que veas tanto dónde gana 4.7 como dónde no.
| Benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| Entrada $/1M | $2 | $2 | $4 | $10 |
| Salida $/1M | $6 | $6 | $20 | $50 |
| CursorBench 4.0 | 46.3 | 40.4 | 41.7 | 51.8 |
| DeepSWE v1.1 | 71.0* | 65.2 | 72.7 | 70.0 |
| Terminal-Bench 4.0 | 37.6 | 20.3 | 37.3 | 57.9 |
| EEBench | 64.0 | 53.0 | 39.4 | 56.4 |
| AA Briefcase v1.1 (Elo) | 1657 | 1546 | 1487 | 1678 |
| Harvey Legal Agent | 19.6 | 15.8 | 2.5 | 6.7 |
| HealthBench Professional | 56.7 | 48.5 | 60.5 | 62.1 |
*puntuación con esfuerzo alto. Fuente: xAI, lanzamiento de Grok 4.7.
Leído con justicia, el panorama es claro. Grok 4.7 gana claramente en EEBench y en el benchmark Harvey Legal Agent, donde más que duplica la puntuación de Fable, y es competitivo en todo lo demás. Pero Fable 5.1 lidera en CursorBench, Terminal-Bench y AA Briefcase, GPT-5.6 Sol le gana por poco en DeepSWE, y en HealthBench Professional Grok 4.7 pierde frente a ambos. Así que si tu trabajo exige máxima precisión de programación o razonamiento clínico y el presupuesto no es un problema, Grok 4.7 no es la elección. Si tu trabajo consiste en ejecutar esa capacidad a gran volumen, el próximo gráfico es el que decide.
El precio es todo el argumento
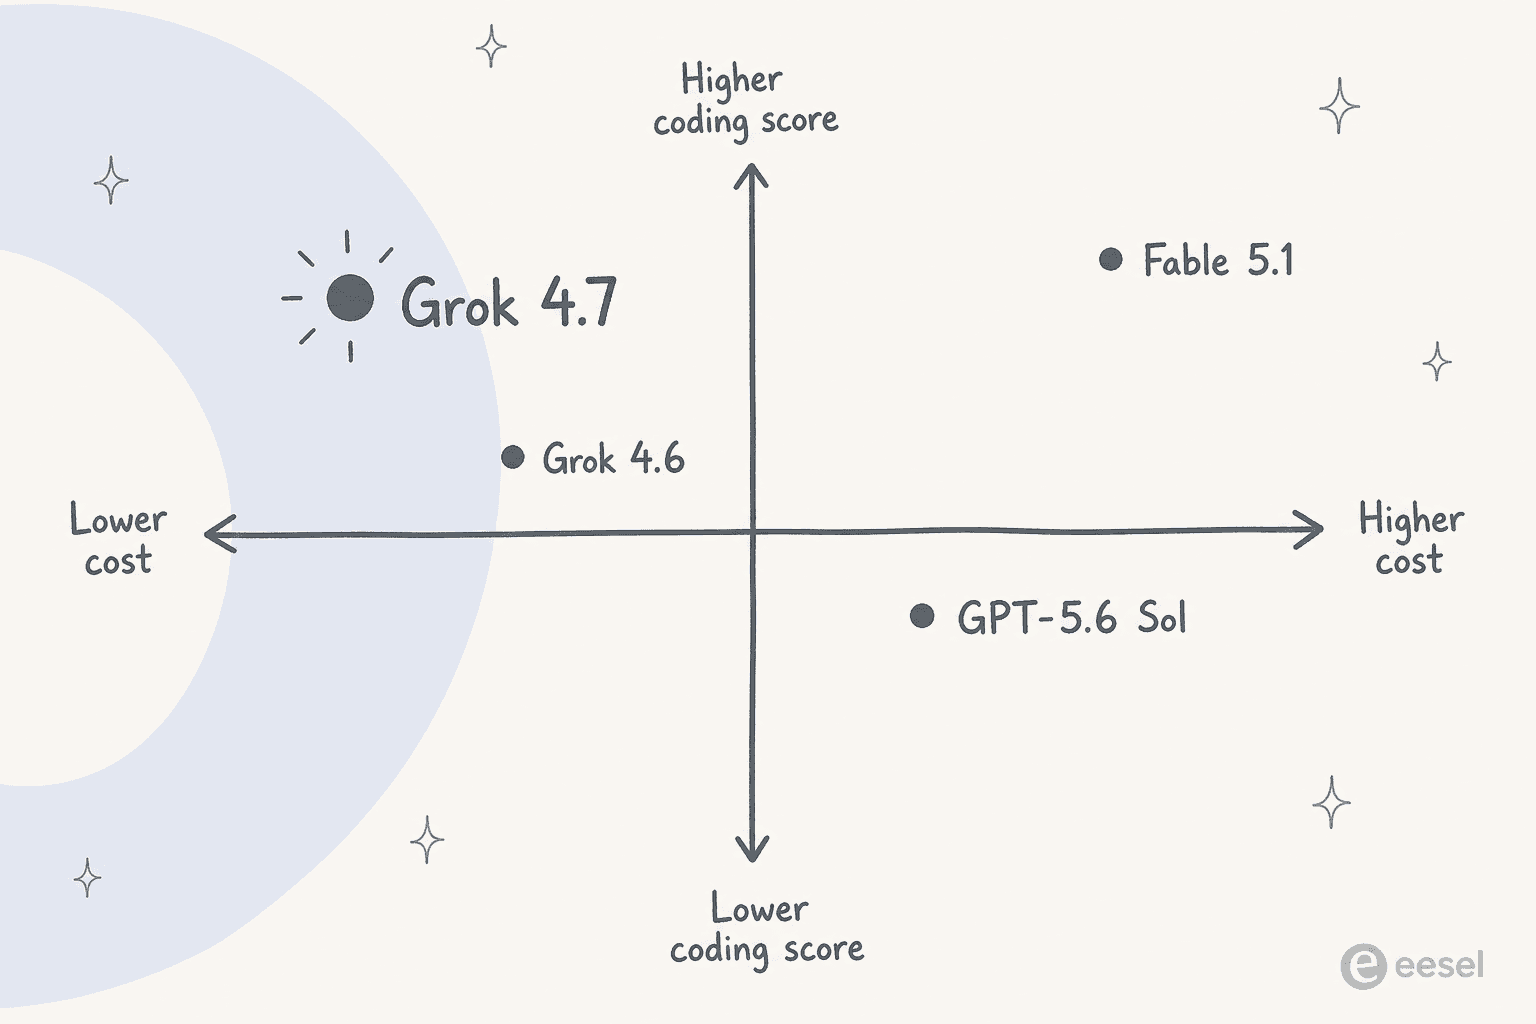
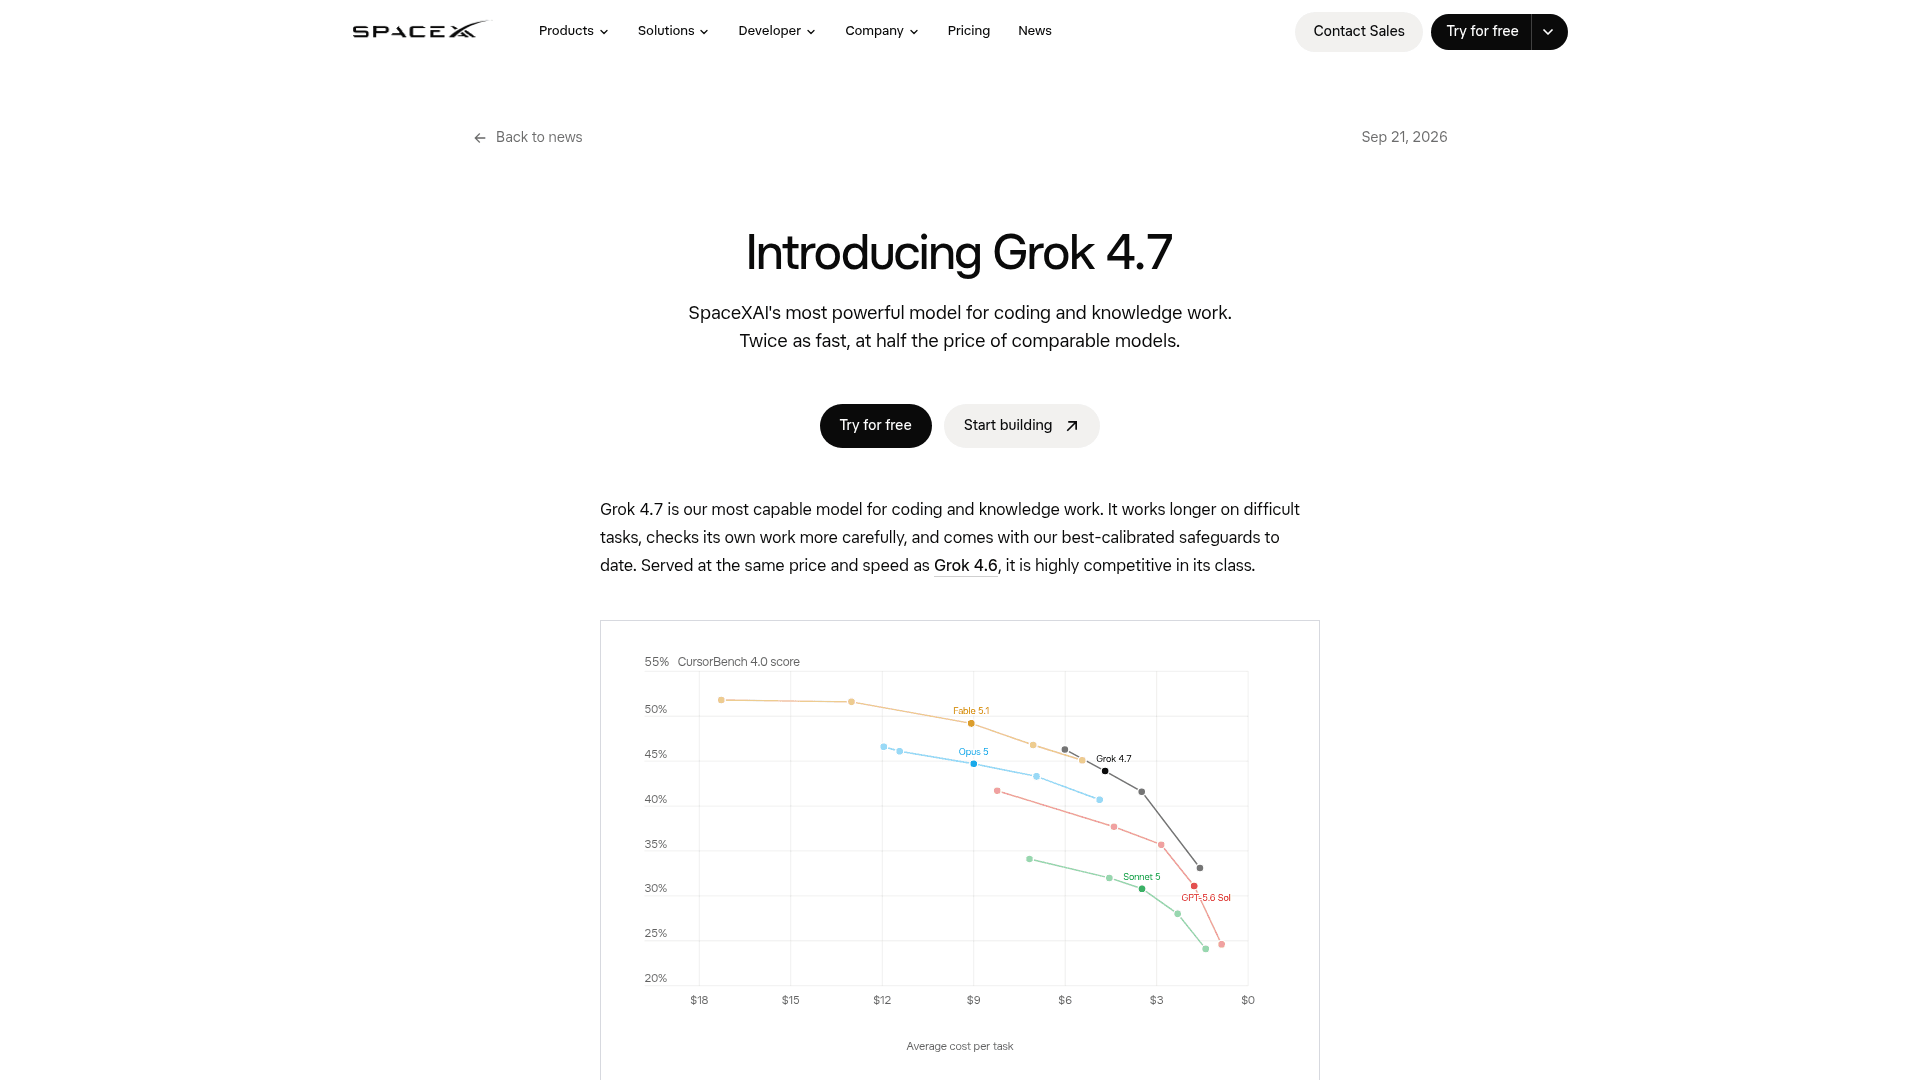
Grok 4.7 ofrece una capacidad cercana a la de Fable al precio de Grok 4.6. En concreto, una tarea que lee 50k tokens y escribe 10k cuesta alrededor de 0,16 $ en Grok 4.7 frente a 0,40 $ en GPT-5.6 Sol y 1,00 $ en Fable 5.1. Multiplica eso por un agente que hace miles de ejecuciones al día, y la elección de modelo deja de ser una cuestión de decimales de un benchmark para convertirse en una cuestión de tu factura.
Dos salvedades para mantener esto honesto. Primero, el umbral de 200k: superar los 200k tokens de prompt duplica la tarifa a 4 $ / 1 $ / 12 $, aplicada a todos los tokens de la solicitud, no solo al exceso, que es exactamente lo que la API de compactación de contexto existe para evitar. Segundo, el gráfico de lanzamiento comparaba con el antiguo GPT-5.6 Sol a 4 $ / 20 $, pero OpenAI lanzó GPT-6 Sol a 2 $ / 10 $ al día siguiente, así que la brecha real de precio de salida es del 40%, no del 70% que sugiere el gráfico. Los precios de xAI siguen siendo los más fuertes de su categoría, solo que no con un margen tan amplio como el que muestra la diapositiva. El desglose completo, medidor por medidor, está en la guía de precios de Grok 4.7.
También está el recargo de la variante Fast que conviene conocer. Grok 4.7 Fast es el mismo modelo al doble de velocidad de salida por el doble de precio por token, y solo existe dentro de Cursor y Grok Build, no en la API pública. Vale la pena pagarlo cuando estás viendo el código generarse en tiempo real y la latencia molesta; es dinero desperdiciado en trabajos por lotes o nocturnos donde nadie está esperando.
Ejecuto agentes a gran volumen (llamadas a herramientas, trabajo de terminal)
Sí, cámbiate. Este es el punto óptimo. El salto en Terminal-Bench junto con el precio de 2 $ / 6 $ es exactamente lo que necesita un bucle de agentes. Vigila el umbral de 200k y usa Context Compaction.
Necesito la máxima precisión de programación, sin importar el coste
Quédate con Fable 5.1 para las tareas más difíciles. Muchos equipos dirigen la mayor parte del trabajo a Grok 4.7 y solo escalan los casos más exigentes a un modelo más caro.
Hago razonamiento clínico o sensible a la salud
No es la elección. Grok 4.7 va por detrás de GPT-5.6 Sol y Fable 5.1 en HealthBench Professional. Decide según ese benchmark, no por el precio.
Quiero que la IA responda tickets de soporte o escriba mi blog
Un modelo en bruto es la capa equivocada. Quieres un compañero de equipo que ya conozca tu producto y se conecte a tus herramientas. Salta a la última sección.
Seguridad, algo que xAI se tomó en serio esta vez
Merece un párrafo porque es un cambio real. Grok 4.7 se lanzó con una pila de seguridad completamente nueva y es, según las propias pruebas de xAI, su modelo más fuerte en negativas y resistencia a jailbreaks. En HackerBench v0.3 deja pasar solo el 3,3% de los prompts de doble uso arriesgados mientras rara vez bloquea trabajo legítimo de seguridad, y lidera el benchmark de bioseguridad de LatchBio con un 62,4%. xAI también ha empezado a dar a socios de ciberseguridad seleccionados acceso por invitación a las capacidades de red-team del modelo. Para una empresa cuyos modelos anteriores recibieron críticas justo en este eje, es una mejora significativa y verificable, no solo una línea de nota de prensa.
Lo que dice quien realmente construye con él
Los benchmarks son la historia que cuenta xAI. Esto es lo que informan desarrolladores independientes. La señal más útil que encontré fue sobre alcance: el modelo resuelve cosas pequeñas de una sola vez de forma excelente, y el entusiasmo se enfría en bases de código grandes ya existentes.
"I agree, the models keep getting better at one shotting. That's useful in a lot of situations, like for small one-off scripts that filter/transform some tool call, or make a clever bash call. For the code itself, it doesn't help me much though."

Eso coincide con la forma de los benchmarks: fuerte en tareas acotadas y bien especificadas, menos mágico cuando el trabajo es "entiende este repositorio de 200k líneas". El otro tema recurrente es que quienes lo usan intensamente a diario rara vez llegan al límite de uso, algo que importa si te has quemado antes con topes de crédito en otras herramientas.
"I use the crap out of Grok in my daily life, including to build a couple self-hosted apps as an amateur. I have a Grok bot monitor my email every 15 minutes and file things away for me... and I never even get close to using my quota."
Ambos coinciden con el hilo conductor de esta reseña: como motor barato y de alto rendimiento en el que apoyarte todo el día, Grok 4.7 cumple. Lo que ninguno de los dos comentaristas describe es un sistema que ya conozca su empresa, que es exactamente la brecha que quiero cerrar en la última sección.
Quién debería usar Grok 4.7
Recurre a él si escribes código, ejecutas agentes o construyes sobre la API y te importa el coste por tarea, que es la mayoría de la gente que construye productos de IA en 2026. Es la opción por defecto natural para bucles de agentes de alto volumen, y una base inteligente incluso si escalas el 5% de los trabajos más difíciles a Claude Opus 5 o Fable. Comparado con el resto del campo económico de frontera, es un todoterreno más sólido en trabajo agéntico que Kimi K3 o DeepSeek V4 Flash.
También supera a Qwen en tareas de terminal y es más barato que GPT-5.6 Sol mientras iguala la mayor parte de su capacidad de programación. Dentro de un editor viene integrado en Cursor, así que en el día a día compite con las mismas herramientas sobre las que ya discute esa comunidad.
Sáltalo, o al menos no lo pongas primero, si necesitas la máxima precisión de programación sin importar el presupuesto, si tu trabajo es clínico, o si lo que realmente quieres no es un modelo, sino un trabajo terminado. Ese último caso es más habitual de lo que admite el planteamiento de reseña de modelos, y ahí quiero ser directo.
La parte que una reseña de modelo suele omitir: un motor no es un empleado
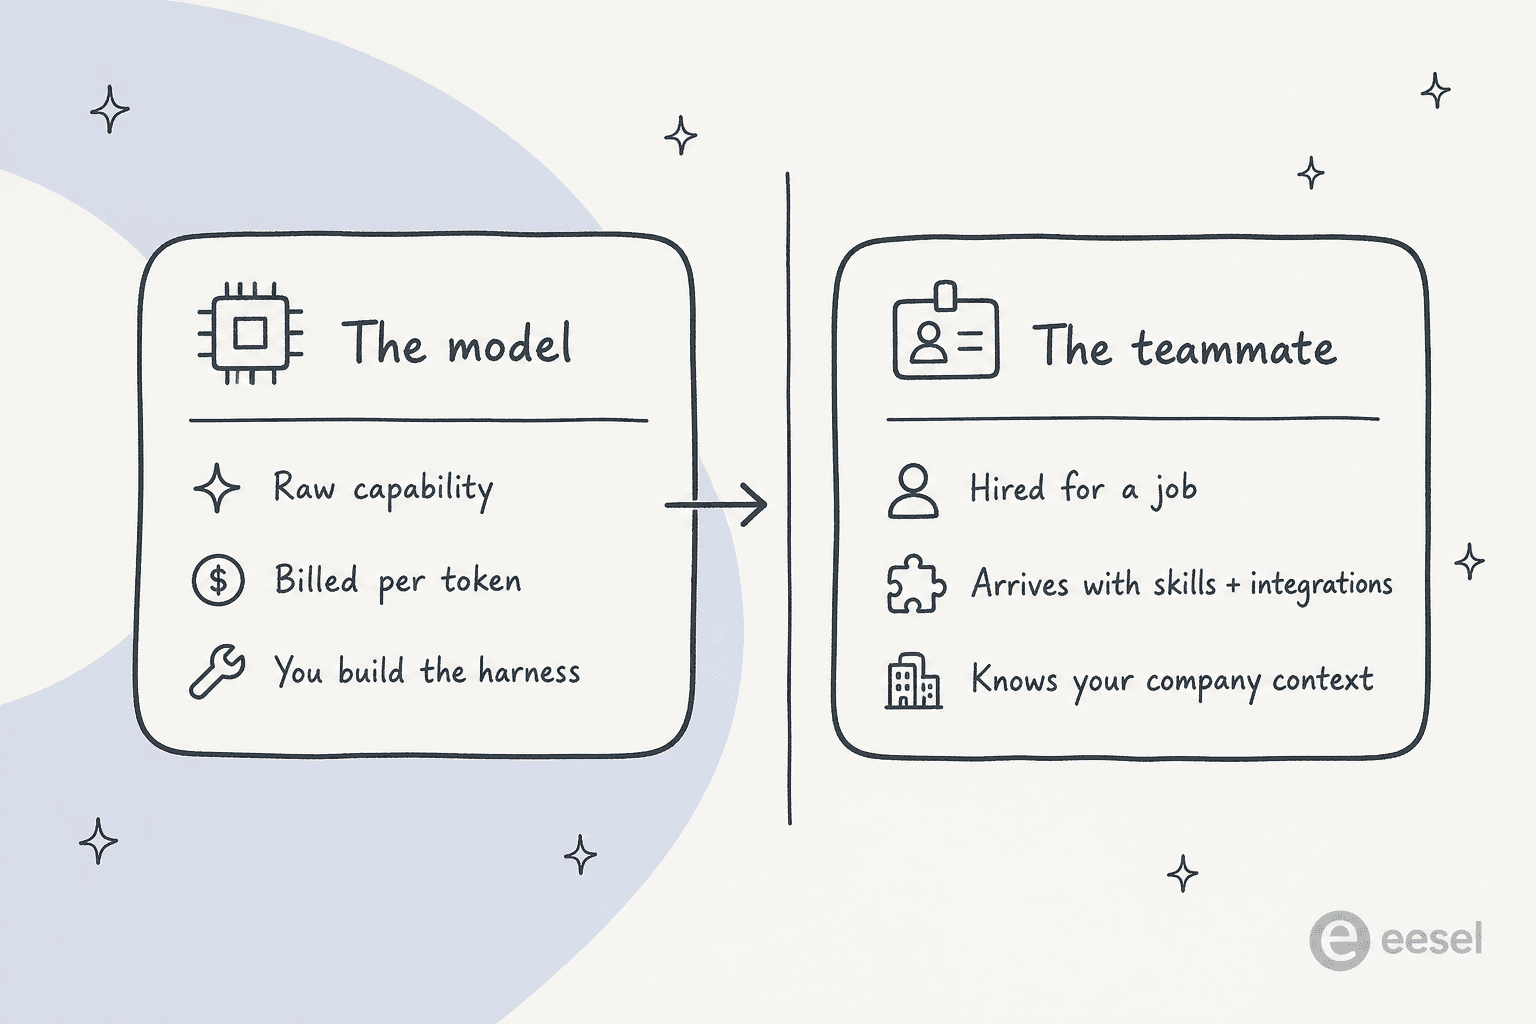
Esto es lo que me han enseñado tres años poniendo IA en colas de soporte reales. Un modelo de frontera es un motor increíblemente capaz, y un motor no es lo mismo que un empleado. Grok 4.7 te da inteligencia bruta por token. No conoce tu política de reembolsos, no está conectado a tu helpdesk, nunca ha visto tus tickets pasados, y no va a decidir por sí mismo qué preguntas puede responder con suficiente confianza y cuáles dejar para una persona. Conectar todo eso es un proyecto real, y es la parte sobre la que la puntuación de benchmark no dice nada.
Es una decisión de construir versus comprar que todo equipo termina enfrentando. Un cliente, una empresa de infraestructura, lo resumió así:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Esa es la brecha que eesel está construido para cerrar. eesel es una plataforma de compañeros de equipo de IA, y contratas compañeros listos para trabajar en trabajos específicos en lugar de alquilar tokens en bruto. La oferta actual incluye un compañero de equipo de IA para helpdesk que se suma a tu cola de soporte existente, y un redactor de blog con IA que se sitúa junto a las mejores herramientas de escritura con IA para contenido con investigación de calidad. Cada uno llega ya construido sobre modelos de frontera, y ya con las habilidades, integraciones y contexto de empresa para su rol.
El compañero de soporte se entrena con tus tickets históricos, redacta o responde completamente en tu tono, y solo se encarga de aquello sobre lo que tiene confianza, exactamente el control que el enfoque de modelo por token te obliga a construir tú mismo. Esa diferencia es todo el argumento en agente de IA frente a chatbot basado en reglas, y por eso la IA para atención al cliente es una categoría de producto, no solo un prompt.
La prueba está en la cola, no en el benchmark. Un cliente, una plataforma de movilidad, vio a eesel resolver el 73% de las solicitudes de nivel 1 en el primer mes, y otro reportó hasta un 80% de ahorro de tiempo en soporte. Esas son cifras que obtienes de un compañero que conoce el trabajo, no de un modelo que sacó buena puntuación en Terminal-Bench. Si todavía estás sopesando el lado del coste, el desglose de agente de IA frente a coste de agente humano y el panorama más amplio de software de atención al cliente con IA son las piezas que leería a continuación.
Si realmente quieres manejar el modelo tú mismo
Para los desarrolladores a los que apunta Grok 4.7, hay un camino intermedio que vale la pena conocer. eesel ofrece una interfaz de línea de comandos y un servidor MCP que exponen el mismo compañero de equipo y espacio de trabajo de forma amigable para agentes. Una persona puede manejarlo desde una terminal, los scripts pueden automatizarlo, y agentes de programación como Claude Code, Codex y Cursor pueden operarlo directamente. Así obtienes el control programable y sin interfaz que te hizo interesarte en una API en bruto en primer lugar, pero dirigido a un compañero que ya conoce tu empresa en lugar de un modelo en blanco al que tienes que volver a enseñar en cada ejecución. Es la misma lógica detrás de automatizar la clasificación de tickets desde el código en lugar de hacer clic en un panel.
¿Quieres verlo con tus propios tickets? eesel se conecta a tu helpdesk en minutos, se entrena con tu historial y te permite simular con miles de tickets pasados antes de responder uno solo en vivo. Gratis para probar.

Mi veredicto
Grok 4.7 es un modelo fácil de recomendar por lo que es: la mejor relación calidad-precio en la frontera, especialmente para agentes y programación de alto volumen. No es el modelo más inteligente en todos los aspectos, y el gráfico de lanzamiento exagera ahora la brecha de precio ya que existe GPT-6 Sol, pero para trabajo sensible al coste es el primero al que recurriría. Solo recuerda qué estás comprando. Un modelo te da capacidad por token. Si lo que necesitas es un trabajo hecho de forma fiable, eso requiere un compañero de equipo, y esa es una compra completamente distinta.
Preguntas frecuentes
¿Es bueno Grok 4.7?
Para programación y trabajo agéntico a bajo coste, sí. En mi reseña de Grok 4.7, logra el mayor salto de cualquier lanzamiento reciente de xAI en tareas de terminal de larga duración y mantiene una posición de frontera en relación precio-rendimiento. No es el modelo más inteligente en todas las tablas, ya que Fable 5.1 de Claude sigue liderando la programación de máximo nivel y el trabajo de terminal, pero es la mejor relación calidad-precio de su categoría.
¿Cuánto cuesta Grok 4.7?
Grok 4.7 cuesta 2 $ por millón de tokens de entrada, 0,50 $ en caché y 6 $ de salida por debajo de 200k tokens de prompt, y luego 4 $ / 1 $ / 12 $ una vez que una solicitud supera los 200k, según la página de precios de xAI. Es idéntico a Grok 4.6. El desglose completo, incluyendo los medidores de búsqueda y ejecución de código, está en la guía de precios de Grok 4.7.
¿Es Grok 4.7 mejor que GPT-5.6 Sol?
Según el propio conjunto de benchmarks de xAI, Grok 4.7 supera a GPT-5.6 Sol en la mayoría de las tareas de programación y agénticas por una fracción del precio, aunque Sol se adelanta en razonamiento clínico. Cabe señalar que OpenAI ya ha lanzado GPT-6 Sol a 2 $ / 10 $, por lo que la brecha de precios real es más estrecha de lo que sugiere la tabla de lanzamiento.
¿Cuál es la diferencia entre Grok 4.7 y Grok 4.6?
Grok 4.7 funciona sobre un modelo base más grande y una ejecución de aprendizaje por refuerzo más larga orientada a tareas de muchas horas. Logra las mayores ganancias en Terminal-Bench 4.0, casi duplicando la puntuación de 4.6. Ambos mantienen la ventana de contexto de 500k y el mismo precio, así que se trata de una mejora de capacidad gratuita. La reseña de Grok 4.6 cubre la versión anterior.
¿Es bueno Grok 4.7 para programar?
Programar es su punto fuerte principal. Obtiene un 46,3% en CursorBench 4.0 y supera a Grok 4.6 en todos los benchmarks de software publicados por xAI. Viene integrado en Cursor y Grok Build, y programadores de la comunidad informan que es fuerte generando scripts de una sola vez, aunque menos transformador en bases de código grandes ya existentes.
¿Qué es Grok 4.7 Fast?
Grok 4.7 Fast es el mismo modelo al doble de velocidad de salida por el doble de precio por token, disponible solo en Cursor y Grok Build, no en la API pública. Vale la pena pagarlo cuando la latencia importa, como al ver el código generarse en tiempo real, y se puede omitir en trabajos por lotes o nocturnos. Consulta la visión general de precios de xAI.
¿Cómo accedo a Grok 4.7?
Puedes llamarlo en la API de xAI como grok-4.7, usarlo gratis en Grok Build, o acceder a él dentro de Cursor. Si quieres que esa inteligencia haga un trabajo definido en lugar de tokens en bruto, un compañero de equipo de IA empaqueta un modelo de frontera con las habilidades, integraciones y contexto de empresa para un rol real como la automatización de soporte.


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.