Qué es realmente Grok 4.7
Grok 4.7 es el modelo puntero de xAI para programación, tareas agénticas y trabajo de conocimiento. En la API se ofrece como grok-4.7, con una ventana de contexto de 500k, entradas de texto e imagen, y salida de solo texto sin límite de salida, según las notas de lanzamiento de xAI. El esfuerzo de razonamiento se puede configurar entre bajo, medio, alto (el predeterminado) y xhigh, para que puedas ajustar cuánto piensa el modelo en cada solicitud.
Por debajo, xAI dice que Grok 4.7 usa un modelo base nuevo y más grande que Grok 4.6. Quiero ser preciso aquí, porque buena parte de la cobertura le puso una cifra exacta de parámetros: el propio material de xAI lo describe como un modelo base más grande sin publicar una cifra, así que el número concreto que circula no es algo que la empresa haya declarado. Lo que xAI sí afirma es la forma del cambio, y esa forma es la parte interesante.
El entrenamiento estuvo orientado a problemas difíciles que tardan muchas horas en completarse, y luego se reforzó a lo largo de una ejecución más larga. xAI también entrenó al modelo para entender de forma nativa su arnés Grok Bot, que es el andamiaje que permite al modelo chatear, llamar herramientas y avanzar en una tarea. En términos simples, optimizaron menos para responder bien una sola pregunta y más para atravesar un trabajo largo y de varios pasos sin perder el hilo.
Qué cambió respecto a Grok 4.6
La forma clara de ver el salto es poner ambos modelos uno al lado del otro en los benchmarks publicados por xAI. Las mejoras no son uniformes, y dónde se concentran te dice de qué trata realmente este lanzamiento.
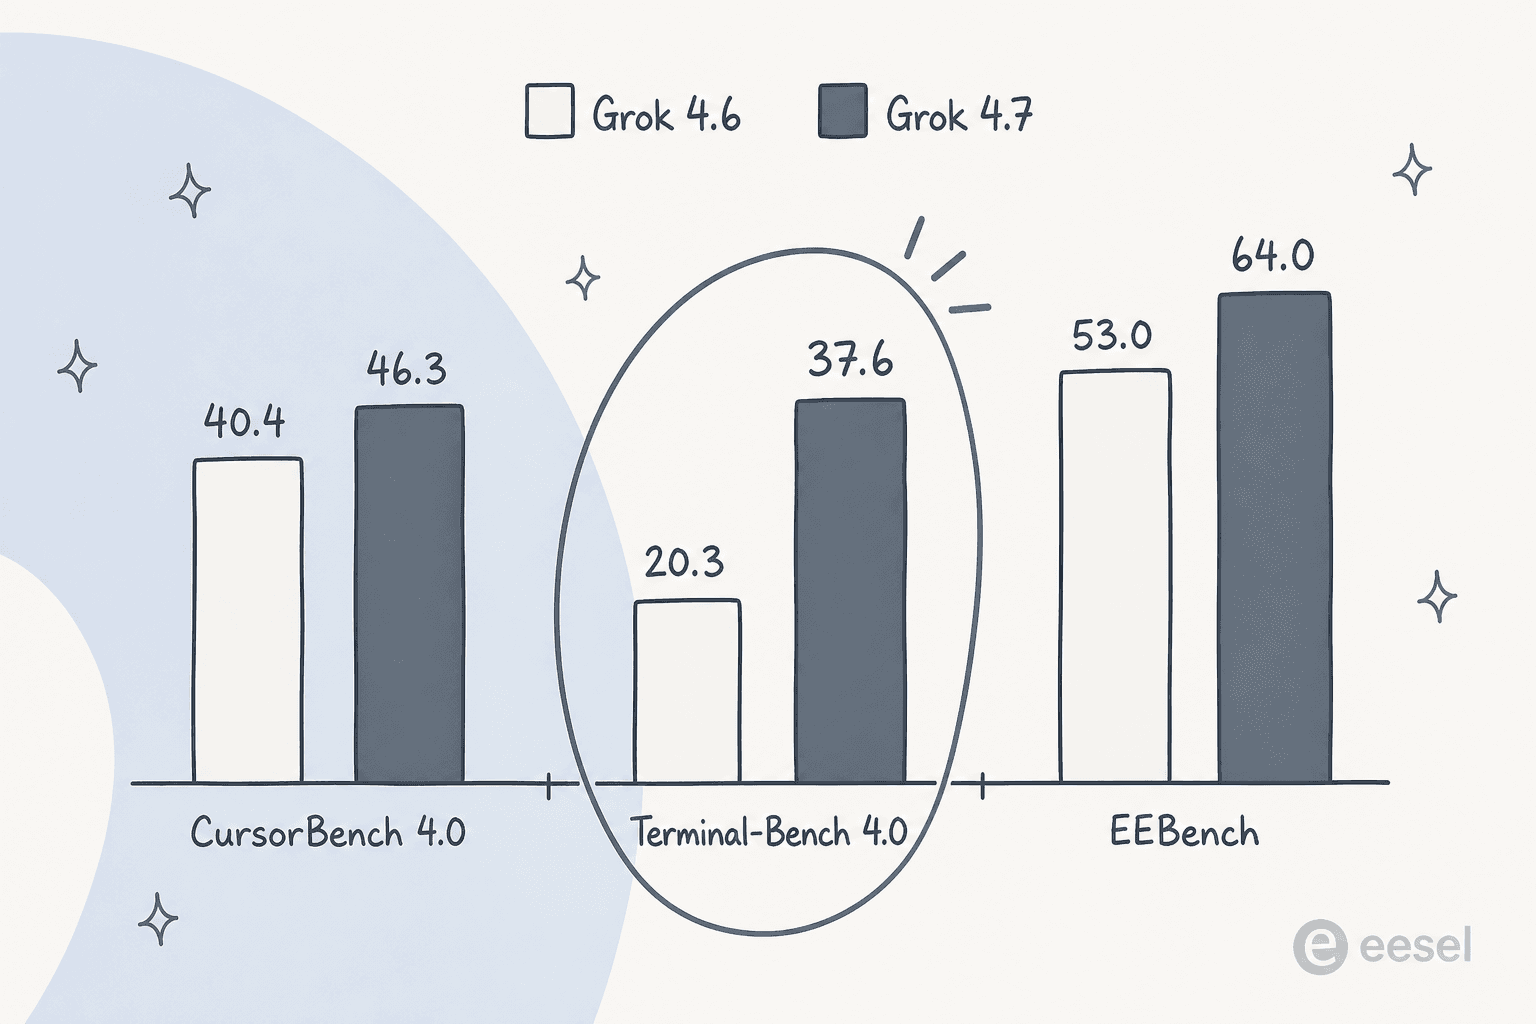
El movimiento individual más grande está en Terminal-Bench 4.0, que mide trabajo de varias horas en una terminal real: Grok 4.6 obtuvo 20,3 % y Grok 4.7 casi lo duplica hasta 37,6 %. Ese es exactamente el tipo de tarea de largo horizonte para la que se construyó la ejecución de RL más larga, y es donde el lanzamiento se gana su lugar. La programación y la ingeniería siguen la misma historia: CursorBench 4.0 sube de 40,4 % a 46,3 %, y EEBench (ingeniería eléctrica) salta de 53,0 % a 64,0 %.
Aquí está la tabla más completa, con GPT-5.6 Sol y Fable 5.1 al lado para que las cifras tengan contexto. Todas las cifras de Grok 4.7 están en esfuerzo xHigh, Grok 4.6 en High.
| Benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| Precio de entrada / 1M | $2 | $2 | $4 | $10 |
| Precio de salida / 1M | $6 | $6 | $20 | $50 |
| CursorBench 4.0 (programación) | 46,3 % | 40,4 % | 41,7 % | 51,8 % |
| DeepSWE v1.1 | 71,0 %* | 65,2 % | 72,7 % | 70,0 % |
| Terminal-Bench 4.0 | 37,6 % | 20,3 % | 37,3 % | 57,9 % |
| EEBench (ingeniería eléctrica) | 64,0 % | 53,0 % | 39,4 % | 56,4 % |
| AA Briefcase v1.1 (Elo) | 1.657 | 1.546 | 1.487 | 1.678 |
| Harvey Legal Agent | 19,6 % | 15,8 % | 2,5 % | 6,7 % |
| HealthBench Professional | 56,7 % | 48,5 % | 60,5 % | 62,1 % |
*La puntuación de DeepSWE de Grok 4.7 se mide con esfuerzo alto. Cifras del anuncio de Grok 4.7 de xAI.
Dos advertencias honestas antes de que alguien lea esto como una victoria total. Fable 5.1 sigue encabezando la tabla en CursorBench, Terminal-Bench y razonamiento clínico, así que si solo te importa la puntuación máxima y el costo no es problema, va por delante. Y en HealthBench Professional, tanto GPT-5.6 Sol (60,5 %) como Fable 5.1 (62,1 %) superan el 56,7 % de Grok 4.7. La historia de Grok 4.7 no es "el mejor en todo". Es "muy cerca del mejor, por una fracción del precio".
Precios de Grok 4.7 y el recargo Fast
El precio es donde este modelo se pone interesante, así que vale la pena detallarlo en lugar de limitarse a agitar una cifra "desde".
| Nivel | Entrada / 1M | Entrada en caché / 1M | Salida / 1M |
|---|---|---|---|
grok-4.7, prompt bajo 200k tokens | $2,00 | $0,50 | $6,00 |
grok-4.7, prompt de 200k o más | $4,00 | $1,00 | $12,00 |
| Grok 4.7 Fast (solo Cursor y Grok Build) | 2x las tarifas anteriores | 2x | 2x |
El primer detalle a tener en cuenta es el nivel de contexto largo. Una vez que una solicitud supera los 200k tokens de prompt, las tarifas más altas se aplican a cada token de la solicitud completa, no solo al excedente por encima de 200k. Así que un prompt de 210k tokens se factura por completo a 4 $ / 12 $, no en su mayoría a 2 $ / 6 $. Para bucles de agentes largos que acumulan contexto poco a poco, ese salto es real, y es la razón por la que xAI lanzó una API de compactación de contexto para reducir las conversaciones antes de que se desborden.
El segundo es la variante Fast. Grok 4.7 Fast es el mismo modelo servido al doble de velocidad de salida por el doble de precio por token, y solo está disponible dentro de Cursor y Grok Build, no en la API pública. Es un intercambio de latencia por dinero, útil cuando ves el código transmitirse en tiempo real y cada segundo cuenta, y prescindible para trabajo por lotes o en segundo plano donde la velocidad no importa.
Luego están los medidores que la mayoría de los artículos pasan por alto. En la API, la página de precios de xAI enumera las llamadas a herramientas por separado: la búsqueda web, la búsqueda en X y la ejecución de código cuestan 5 $ por cada 1.000 llamadas, la búsqueda en archivos adjuntos cuesta 10 $ por cada 1.000, y la búsqueda de colecciones estilo RAG cuesta 2,50 $ por cada 1.000. Priority Processing duplica todas las tarifas por token. Ninguno de estos rubros arruina el presupuesto, pero si estás modelando el costo de un agente que busca y ejecuta constantemente, el precio por token no es toda la factura.
La conclusión: Grok 4.7 está fijado en precio para funcionar a gran volumen. Esa es una posición deliberada, y es la razón más clara para elegirlo sobre un modelo puntero más caro para cualquier cosa que funcione en bucle.
Dónde se ubica Grok 4.7 frente a GPT-5.6 Sol y Fable 5.1
Si trazas la capacidad frente al costo, Grok 4.7 cae en un rincón que se está llenando de competencia pero que sigue siendo valioso: puntuaciones sólidas, precio bajo.
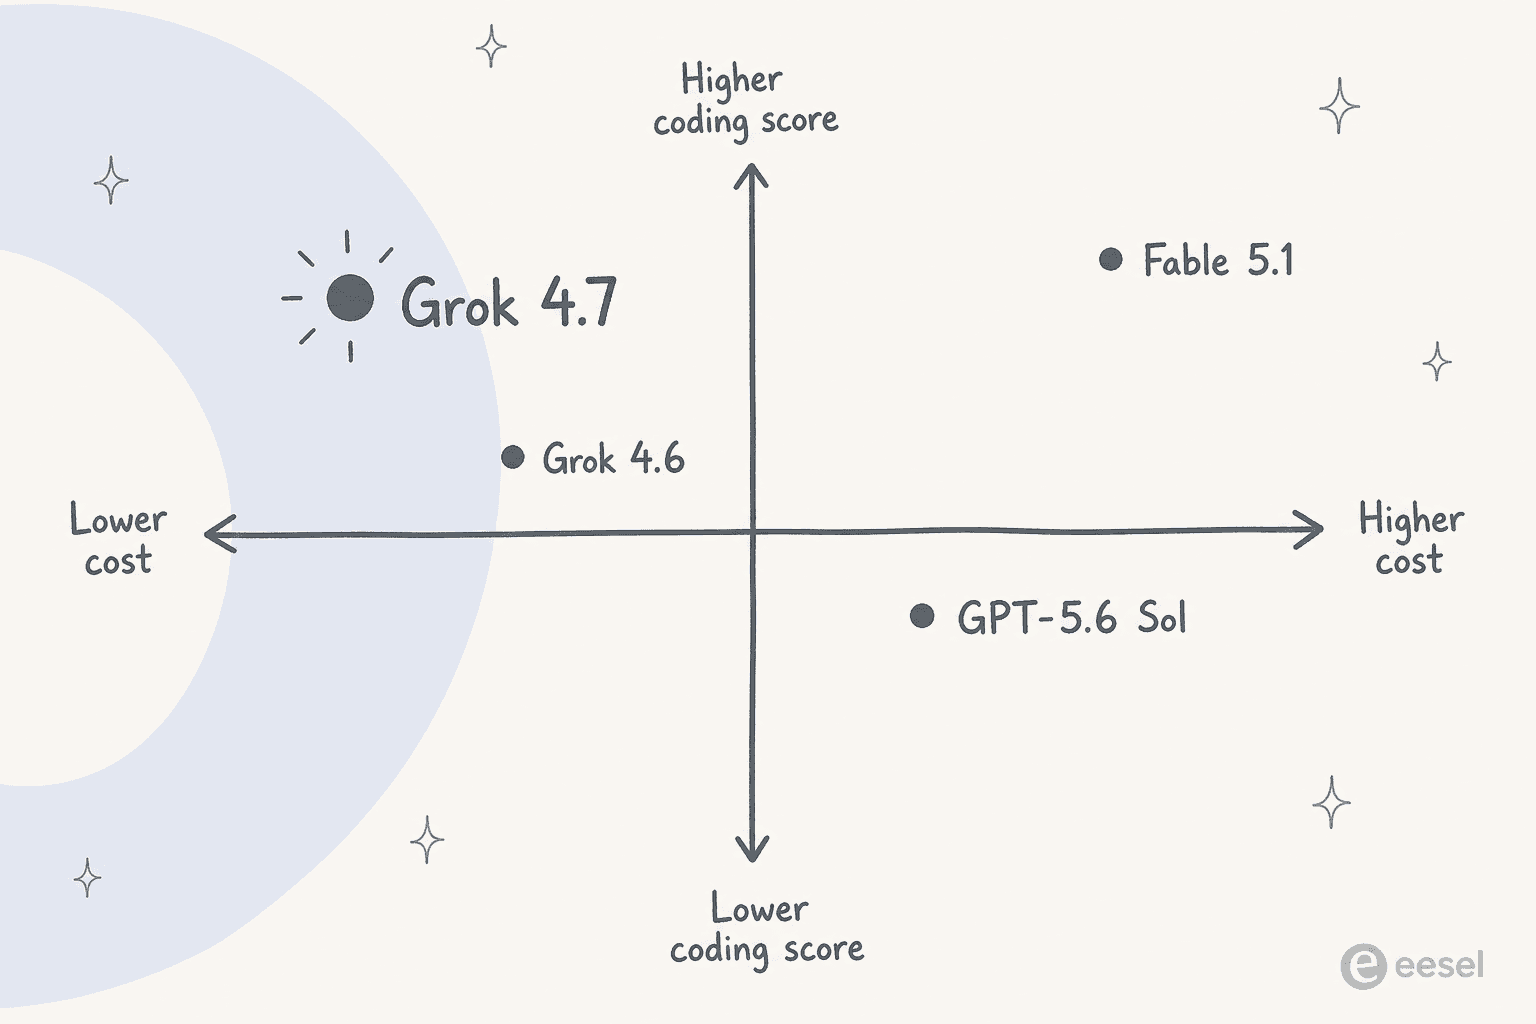
Frente a GPT-5.6 Sol, Grok 4.7 es la mejor opción en la mayoría del trabajo agéntico y de ingeniería: supera a Sol en CursorBench, EEBench, Terminal-Bench, el benchmark legal de Harvey y AA Briefcase, a la mitad del precio de entrada y menos de un tercio del precio de salida. Sol mantiene una ventaja real en razonamiento clínico y una estrecha en DeepSWE, así que no es un barrido total, pero la diferencia de precio hace de Grok 4.7 la opción por defecto para trabajo agéntico sensible al costo.
Frente a Fable 5.1, la lectura honesta es que Fable sigue siendo el modelo más fuerte en programación pura y trabajo de terminal de largo horizonte, y su Elo de conocimiento profesional GDPval de 1.735 supera el 1.695 de Grok 4.7. Pero Fable cobra 10 $ / 50 $ por millón de tokens, de cinco a ocho veces las tarifas de Grok. Así que la pregunta no es "cuál es más inteligente" (a menudo Fable), sino "cuánto estás dispuesto a pagar por cada punto adicional". Para muchas cargas de trabajo en producción, Grok 4.7 es la respuesta que mantiene la factura razonable.
Seguridad y ciberseguridad
xAI le dio un peso real a la seguridad en este ciclo, y es una de las partes más concretas del lanzamiento. Grok 4.7 se construyó con una pila de salvaguardas completamente nueva, y xAI lo llama el modelo más sólido que ha probado en rechazos y resistencia a jailbreaks.
Los detalles son lo que hace verificable esa afirmación. En HackerBench v0.3, el benchmark de xAI para tareas cibernéticas de riesgo, Grok 4.7 deja pasar solo el 3,3 % de los prompts de doble uso riesgosos mientras que, según xAI, rara vez bloquea trabajo legítimo de seguridad. También encabeza el benchmark de bioseguridad de LatchBio con un 62,4 %. La propuesta es un modelo que se mantiene útil para trabajo real de seguridad e investigación sin ser una herramienta fácil para la versión peligrosa de la misma tarea, y xAI ha comenzado a dar a socios de ciberseguridad seleccionados acceso solo por invitación a las capacidades de red-team del modelo para investigación de defensa. Los benchmarks son del propio proveedor, así que hay que tratarlos como punto de partida, pero la dirección es clara.
Para quién es realmente Grok 4.7
Después de analizar las cifras, aquí es donde llego. Grok 4.7 es una opción sólida si escribes código, construyes agentes, o lanzas cualquier cosa en la API donde el costo de los tokens se acumula. La combinación de puntuaciones cercanas a la frontera y los precios de Grok 4.6 es la razón principal para prestarle atención, y las mejoras de largo horizonte significan que aguanta mejor que 4.6 en trabajos que duran un tiempo.
Usuarios reales confirman el ángulo de "ejecutarlo constantemente". Un suscriptor intensivo de Grok describió cómo lo integró en tareas cotidianas y aun así nunca alcanzó los límites:
"Tengo un bot de Grok que supervisa mi correo cada 15 minutos y archiva cosas por mí. Tengo otro bot que supervisa resultados de análisis de sangre... y nunca me acerco siquiera a agotar mi cuota."

Donde ajustaría las expectativas es en código profundo y complicado. Los modelos punteros están todos mejorando en resolver un script de una sola vez, y eso es real, pero no es lo mismo que sostener una base de código grande. Como lo puso un desarrollador en el mismo hilo:
"Los modelos cada vez son mejores resolviendo todo de una vez. Eso es útil en muchas situaciones, como scripts pequeños y puntuales... Pero para el trabajo de código en sí, no me ayuda mucho."
Esa es una lectura justa de cualquier modelo de esta categoría, Grok 4.7 incluido. Úsalo para el volumen de trabajo de dificultad media donde su precio gana, y recurre al modelo más caro solo para las tareas que realmente necesitan esos últimos puntos.
Un modelo puntero es el motor, no el empleado
Aquí está el replanteamiento que prometí en el TL;DR, porque es lo que la mayoría de los artículos de "qué modelo debería usar" se saltan.
Grok 4.7 es infraestructura. Es un motor brillante que alquilas por token, y llega sin saber nada sobre tu empresa, tus tickets, tu tono o tus herramientas. Para convertirlo en algo que haga un trabajo real, alguien tiene que construir el arnés: conectar el conocimiento, cablear las integraciones, escribir las barreras de seguridad, manejar la escalación y mantener todo funcionando. Eso es un proyecto real, no un simple interruptor de configuración.
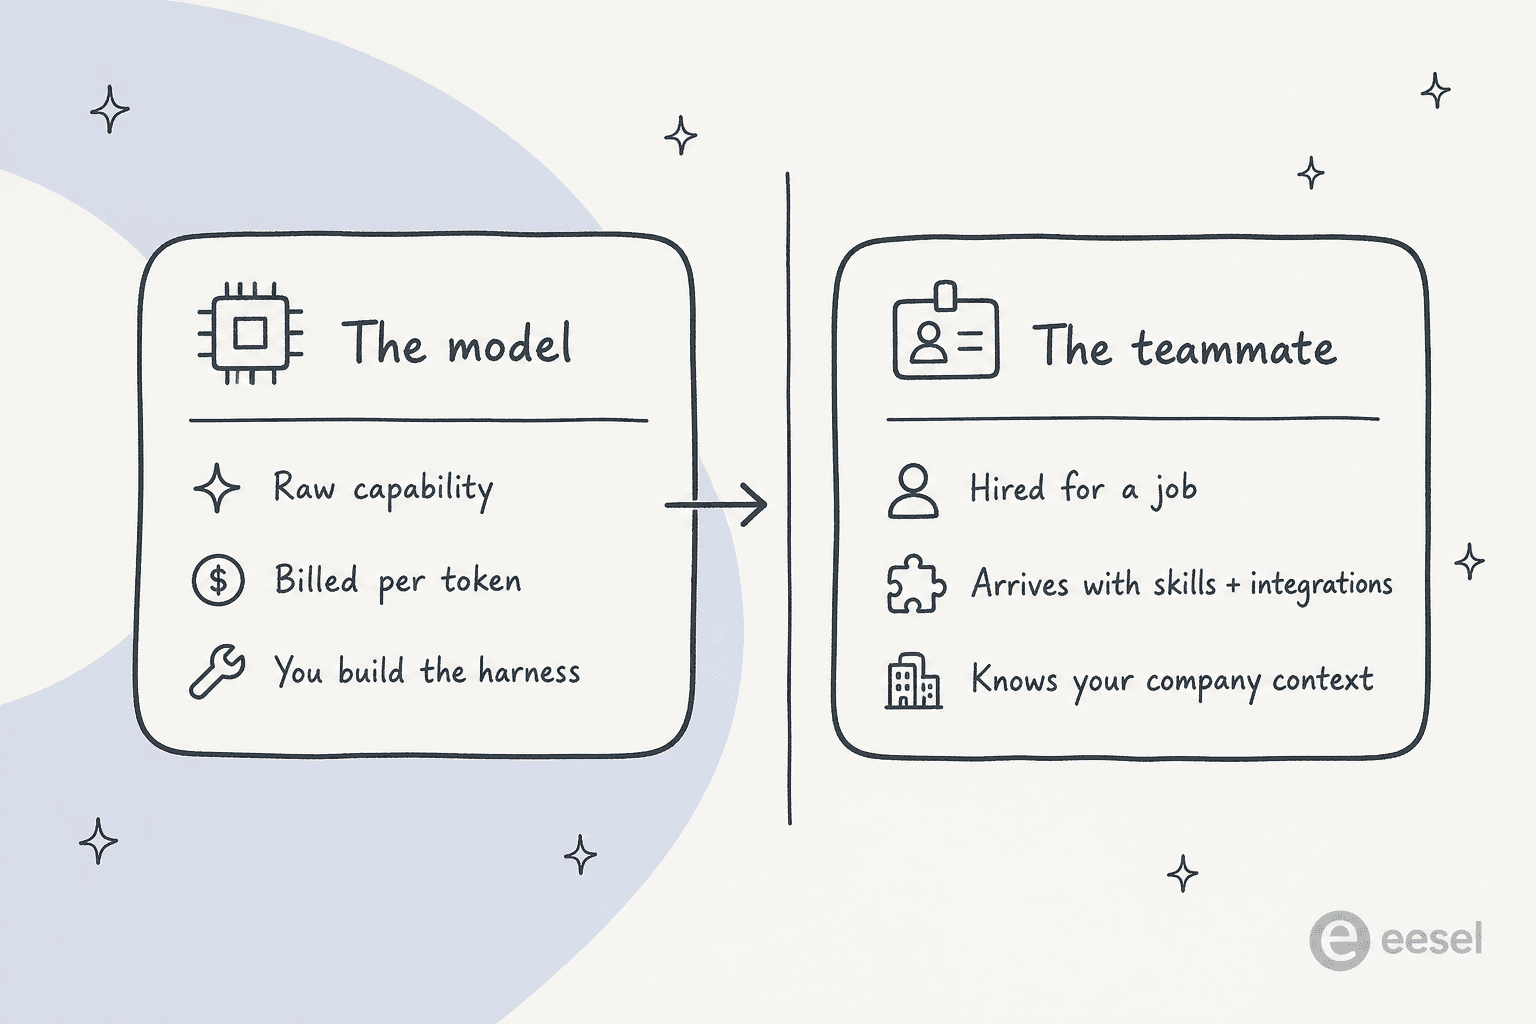
Esa brecha es toda la idea detrás de eesel. En lugar de entregarte un modelo y un arnés vacío, eesel es una plataforma de compañeros de equipo de IA donde contratas compañeros listos para trabajar para un puesto específico. La plantilla actual es un compañero de equipo de IA para helpdesk que se une a tu cola de soporte y un redactor de blog con IA que investiga y redacta publicaciones extensas. Cada uno llega ya con las habilidades, integraciones y contexto de empresa que su rol necesita, funcionando por debajo sobre modelos punteros para que obtengas la capacidad sin tener que ser dueño de la infraestructura.
Y si te gustó Grok 4.7 porque vives en una terminal, eesel también te alcanza ahí. La CLI de eesel opera el mismo compañero de equipo y espacio de trabajo que el panel, pero desde la línea de comandos: una persona puede ejecutarla, los scripts pueden automatizarla, y agentes de código como Claude Code, Codex y Cursor pueden manejarla. Puedes inspeccionar las instrucciones de un compañero de equipo, enviar un mensaje de prueba, leer de vuelta el resultado JSON y la actividad, y proponer un cambio acotado para que un responsable lo apruebe, todo sin salir de tu shell. Es el mismo patrón de "operar el agente de forma programática" que hace atractiva a una API de modelo en bruto, pero dirigido a un empleado que ya conoce el trabajo. Puedes probar eesel gratis.
Preguntas frecuentes
¿Qué es Grok 4.7?
Grok 4.7 es el modelo puntero de xAI para programación, tareas agénticas y trabajo de conocimiento, lanzado el 21 de septiembre de 2026. Funciona sobre un modelo base nuevo y más grande que Grok 4.6, mantiene la ventana de contexto de 500k y se ofrece en la API de xAI como grok-4.7. Es el mismo tipo de motor de modelo en bruto sobre el que se construye un producto como un compañero de equipo de IA.
¿Cuánto cuesta Grok 4.7?
El precio de Grok 4.7 es de 2 $ por millón de tokens de entrada, 0,50 $ de entrada en caché y 6 $ de salida por debajo de 200k tokens de prompt, duplicándose a 4 $ / 1 $ / 12 $ cuando una solicitud supera los 200k, según la página de precios de xAI. Eso coincide exactamente con Grok 4.6, así que la actualización añade capacidad sin subir el precio.
¿Cuál es la diferencia entre Grok 4.7 y Grok 4.6?
Grok 4.7 usa un modelo base más grande y una ejecución de aprendizaje por refuerzo más larga, orientada a tareas de varias horas, y logra las mayores mejoras en benchmarks agénticos de larga duración como Terminal-Bench 4.0. Ambos comparten la ventana de contexto de 500k y los mismos precios por token.
¿Es bueno Grok 4.7 para programar?
Sí, la programación es su principal fortaleza. Obtiene un 46,3 % en CursorBench 4.0 y supera a Grok 4.6 en todos los benchmarks de software publicados por xAI, y se ofrece dentro de Cursor y Grok Build. Para trabajo de código más profundo, los equipos a menudo lo siguen combinando con un modelo más caro para las tareas más difíciles.
¿Cómo accedo a Grok 4.7?
Puedes llamar a Grok 4.7 a través de la API de xAI como grok-4.7, usarlo gratis en Grok Build, o acceder a él dentro de Cursor. Si lo que quieres es que esa inteligencia haga un trabajo definido en lugar de tokens en bruto, una plataforma de compañeros de equipo de IA como eesel empaqueta un modelo puntero con las habilidades, integraciones y contexto de la empresa para un rol real.
¿Es Grok 4.7 mejor que GPT-5.6 Sol o Fable 5.1?
Depende de qué valores más. Grok 4.7 supera a GPT-5.6 Sol en la mayoría de los benchmarks de programación y agénticos por una fracción del precio, mientras que Fable 5.1 sigue liderando en programación punta y trabajo de terminal, pero cuesta de cinco a ocho veces más por token. Para trabajo sensible al costo y de alto volumen, Grok 4.7 suele ser la mejor opción.
¿Qué es Grok 4.7 Fast?
Grok 4.7 Fast es el mismo modelo servido al doble de velocidad de salida por el doble de precio por token, disponible solo dentro de Cursor y Grok Build, no en la API pública. Vale la pena cuando la baja latencia importa, como ver el código transmitirse en tiempo real, y es prescindible para trabajos por lotes o en segundo plano.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.