Alternativas a TypeSafe Jev: 8 formas de obtener decisiones de IA rápidas y tipadas

Alicia Kirana Utomo

Katelin Teen
Última edición September 21, 2026
¿Qué cuenta realmente como una alternativa a TypeSafe Jev?
La propuesta de Jev es estrecha y específica: envíale estado no estructurado más preguntas tipadas, recibe de vuelta decisiones tipadas con probabilidades calibradas, rápido. En Hacker News el lanzamiento consiguió 1.929 puntos, y el comentario más agudo reformuló todo el asunto con claridad:
"Seems like a more accurate title would be 'Jev: Trading general purpose generation for fast typed inference'... Jev can only generate structured output, right?"

Esa reformulación es el enfoque correcto para comparar alternativas. Cualquier cosa que convierta la salida de un modelo en una forma garantizada compite con Jev en la parte tipada. Lo que realmente es difícil de copiar es la parte calibrada y sin generación, por eso la lista se divide según lo cerca que llega cada opción a eso.
He agrupado las ocho opciones en las tres familias de arriba. Aquí está el conjunto completo de un vistazo antes de repasar herramienta por herramienta.
| Herramienta | Tipo | Qué devuelve | Garantía de esquema | Puntuación de confianza | Alojamiento | Precio | Mejor para |
|---|---|---|---|---|---|---|---|
| eesel | Compañero de soporte | Un ticket resuelto, no solo una decisión | Acciones en tu helpdesk | Simulado sobre tickets pasados | SaaS (SOC 2, RGPD) | Basado en uso, ~$0,40/ticket | Gestionar el soporte de principio a fin |
| TypeSafe Jev | Modelo System One | Decisión tipada + probabilidad | Sí, nativo | Sí, calibrado con RLCD | API + Cloudflare | ~$0,042/MTok entrada, salida gratis | Decisiones rápidas y estrechas a escala |
| OpenAI Structured Outputs | Función de API gestionada | JSON que coincide con tu esquema | Sí, JSON Schema | Vía logits (aproximada) | API de OpenAI | Tarifa normal de tokens del modelo | Equipos ya en OpenAI |
| Gemini structured output | Función de API gestionada | JSON que coincide con tu esquema | Sí, JSON Schema | Vía logits (aproximada) | API de Google | Tarifa normal de tokens del modelo | Clasificación barata en Flash-Lite |
| Cloudflare Workers AI | Puerta de enlace de modelos | Modo JSON / llamadas a funciones | Sí, según el modelo | Depende del modelo | Edge + serverless | Basado en uso (Neurons), nivel gratuito | Apps en el edge, y ejecutar el propio Jev |
| BAML | DSL de esquema + biblioteca | Objetos tipados de cualquier LLM | Sí, al analizar | Depende del modelo | Autoalojado / OSS | Gratis (código abierto) | Mejor DX para prompt-a-tipo |
| Instructor | Biblioteca (Pydantic) | Objetos tipados validados | Sí, con reintentos | Vía logits (aproximada) | Autoalojado / OSS | Gratis (código abierto) | Extracción en Python, inicio rápido |
| Outlines | Biblioteca de generación | Estructura forzada durante la decodificación | Sí, en tiempo de decodificación | Depende del modelo | Autoalojado / OSS | Gratis (OSS) + API alojada | Modelos locales, gramáticas estrictas |
| Hugging Face AutoTrain | Clasificador entrenado | Etiqueta de clase + probabilidad | Conjunto de etiquetas fijo | Sí, softmax | HF Hub / autoalojado | Coste de cómputo | Clasificación estrecha y de alto volumen |
Una nota sobre el tono antes de la lista: ninguna de estas herramientas es mala, y algunas son excelentes. Cuando señalo un límite, es un dato sobre el alcance, no una crítica. Vamos a repasarlas.
1. eesel: la capa de compañero de equipo, no un primitivo de decisión
Seré directo: esta es un tipo de respuesta diferente. Mucha gente que busca un modelo de decisión tipada en realidad está tratando de resolver un problema de soporte u operaciones, y recurrió a un primitivo porque era lo nuevo y brillante. Si ese eres tú, la recomendación honesta es saltarte el primitivo.

Qué es. eesel es una plataforma de compañeros de equipo con IA. Los clientes contratan compañeros de equipo listos para trabajar en un puesto específico, y la plantilla actual incluye un compañero de IA para helpdesk y un redactor de blog con IA. El compañero de helpdesk se une a tu cola existente, lee tu centro de ayuda y tickets pasados, y toma las mismas decisiones de triaje, enrutamiento y escalado que tomaría un modelo de decisión, y luego redacta y resuelve.
Dónde encaja. Cuando la decisión es un medio para un fin y ese fin es un ticket resuelto. Jev te da "urgente, facturación, 0,94". eesel toma ese juicio y realmente responde, etiqueta, enruta y cierra, conectado a tu flujo de trabajo de atención al cliente con IA. Se comporta menos como un truco de decodificación y más como un agente de IA con tu contexto cargado, y vive dentro de tu software de atención al cliente en lugar de al lado.
A tener en cuenta. eesel no es una API de decisión de propósito general. Si quieres un primitivo puro para incrustar en un producto no relacionado, necesitas una de las herramientas de abajo, no un compañero de equipo.
Si vives en una terminal: eesel también ofrece una CLI pública más un servidor MCP, así que el mismo compañero de equipo y espacio de trabajo se pueden manejar desde scripts y desde agentes de código como Claude Code, Codex y Cursor. Es el mismo agente que el del panel, no un juguete aparte, algo que importa si tu instinto con Jev era escribir scripts para todo. Mira cómo se compara con una integración MCP de Claude Code.
Precio. Basado en uso, alrededor de $0,40 por ticket resuelto, sin recargo de IA por puesto. Puedes simular sobre tus tickets históricos antes de salir en vivo, el paso de calibración que todas las demás herramientas de esta página se saltan.
2. OpenAI Structured Outputs
Si tu stack ya está en OpenAI, esta es la alternativa a Jev con menos fricción, porque es una función, no un proveedor nuevo.
Qué es. Structured Outputs hace que un modelo siempre devuelva respuestas que cumplen un JSON Schema que tú defines, así que no omitirá una clave obligatoria ni inventará un valor de enum inválido. También hace que los rechazos de seguridad sean detectables de forma programática, y acepta esquemas definidos con pydantic.BaseModel o z.object.
Dónde encaja. Extracción de datos, clasificación de tickets y enrutamiento cuando quieres todo el razonamiento del modelo detrás de la decisión, y puedes vivir con la latencia de generación. Es un buen soporte para una pipeline de automatización de tickets hecha en casa.
A tener en cuenta. Esto es una restricción sobre un modelo generativo, así que sigues pagando por la generación de tokens y esperando por ella. Te da una forma válida, no una puntuación de confianza calibrada, así que si específicamente quieres la calibración para la que Jev está entrenado, tienes que derivarla tú mismo a partir de logits.
Precio. Función gratuita; pagas la tarifa normal de tokens del modelo que llames.
3. Gemini structured output
La versión de Google, y a la que recurro cuando la tarea es clasificación barata y de alto volumen.
Qué es. Gemini structured output configura los modelos Gemini para generar respuestas que cumplen un JSON Schema, y la documentación nombra tres usos ideales: extracción de datos, clasificación estructurada y generación de entradas estructuradas para flujos de trabajo agénticos. Admite esquemas de Pydantic y Zod.
Dónde encaja. Clasificación y extracción a gran volumen, incluido el tipo de automatización de tickets de soporte que antes necesitaba un motor de reglas ajustado a mano. En el nivel más barato (Flash-Lite) el coste por llamada se acerca al territorio de Jev, que es el verdadero ángulo competitivo aquí.
A tener en cuenta. Misma advertencia central que OpenAI: es generación con una restricción de esquema, no un motor de decisión construido a propósito, así que la latencia y la confianza se comportan como las de un LLM, no como las de Jev.
Precio. Función gratuita; pagas las tarifas de tokens de Gemini, y elegir el nivel de modelo adecuado es donde está el coste real.
4. Cloudflare Workers AI
El giro interesante: esto es a la vez una alternativa a Jev y el lugar donde Jev realmente corre.
Qué es. Workers AI es la puerta de enlace de modelos serverless de Cloudflare, con un catálogo de más de 65 modelos, muchos etiquetados para llamadas a funciones y salidas estructuradas, corriendo en el edge. Jev también está listado aquí, bajo el id de modelo typesafe/jev.
Dónde encaja. Apps en el edge que quieren un modelo pequeño y rápido cerca del usuario, y equipos que quieren una sola superficie de facturación tanto para un modelo general como para decisiones al estilo Jev.
A tener en cuenta. La garantía de salida estructurada depende del modelo concreto que elijas, no de Workers AI en sí. Trátalo como una capa de distribución y elige el modelo por sus méritos.
Precio. Basado en uso (facturado en "Neurons") con una asignación diaria gratuita, y la facturación de Jev en Cloudflare depende del panel de Cloudflare.
5. BAML
La mejor experiencia de desarrollador entre las opciones de biblioteca, y la que le daría a un equipo que odia pelearse con prompts.
Qué es. BAML es un lenguaje específico de dominio para generar salidas estructuradas desde LLMs. Ofrece salidas totalmente type-safe (incluso durante el streaming), un playground interactivo de VSCode, y funciona con cualquier LLM, cualquier lenguaje y cualquier esquema. Tiene alrededor de 9.200 estrellas en GitHub.
Dónde encaja. Equipos que quieren prompt-a-objeto-tipado con autocompletado real y un ciclo de edición ajustado, sea cual sea el modelo que elijan. Si estás construyendo tu propio agente de IA para helpdesk, BAML es la capa que mantiene la salida del modelo fiel a tus tipos.
A tener en cuenta. BAML te da seguridad de tipos al analizar, pero el comportamiento de confianza se hereda del modelo subyacente, así que no es un motor de decisión calibrado como Jev afirma ser.
Precio. Gratis y de código abierto.
6. Instructor
La biblioteca más adoptada en este espacio, y la forma más rápida de tener extracción tipada funcionando en Python.
Qué es. Instructor extrae datos estructurados de cualquier LLM con seguridad de tipos, validación y reintentos automáticos. Está construida sobre Pydantic, en la v1.17.0, con cerca de 14 mil estrellas, 3 millones de descargas mensuales, más de 100 colaboradores, y más de 15 proveedores compatibles incluyendo Ollama y DeepSeek. Funciona en Python, TypeScript, Go, Ruby, Elixir y Rust.
Dónde encaja. Extracción rápida y centrada en esquemas donde quieres validación y reintentos sin arrastrar un framework de agentes.
A tener en cuenta. La propia documentación de Instructor es refrescantemente honesta al decir que es para extracción; para runtimes de agentes más pesados te dirige a PydanticAI. Y como toda biblioteca aquí, estandariza la forma de la salida, no la veracidad de la respuesta.
Precio. Gratis, con licencia MIT.
7. Outlines
La opción a la que recurrir cuando ejecutas tus propios modelos y quieres la estructura forzada a nivel de token.
Qué es. Outlines garantiza salidas estructuradas durante la generación, directamente desde cualquier LLM, en lugar de analizar o corregir con regex una salida defectuosa después. Funciona con OpenAI, Ollama y vLLM, admite JSON Schema, expresiones regulares y gramáticas libres de contexto, está en la v1.3.0 con alrededor de 15.900 estrellas, y se combina con una API alojada de Dottxt para generación 100% conforme al esquema sin ejecutar tus propios modelos.
Dónde encaja. Modelos locales y autoalojados, y casos en los que necesitas una gramática estricta, no solo JSON.
A tener en cuenta. Forzar la estructura en tiempo de decodificación es poderoso pero de más bajo nivel; estás más cerca del metal que con una función gestionada, lo cual es exactamente el punto o una carga según tu equipo.
Precio. Código abierto y gratis; la API alojada de Dottxt es la opción de pago.
8. Hugging Face AutoTrain
Si tu decisión es realmente estrecha y de alto volumen, la respuesta más barata a largo plazo podría ser un modelo que entrenas y posees tú.
Qué es. AutoTrain es la forma sin código de Hugging Face para entrenar, evaluar y desplegar modelos subiendo datos. Su lista de tareas incluye Text Classification y Token Classification, y los modelos resultantes viven en el Hugging Face Hub, listos para servir.
Dónde encaja. Un conjunto de etiquetas fijo y bien definido para el que tienes datos de entrenamiento, como etiquetar tickets por código de motivo o enrutar por cola. Esta es la opción a la que los comentaristas de HN seguían apuntando, argumentando que Jev está cerca de un pequeño clasificador que podrías reproducir:
"It's a heavily constrained, tiny model that can only produce a probability score or a yes/no answer over pre-defined selections... I suspect someone will be able to recreate this within a week."
A tener en cuenta. Eres dueño de todo el ciclo de vida: etiquetado, entrenamiento, deriva, reimplementaciones. Un clasificador entrenado te da una probabilidad softmax limpia, pero solo conoce las clases que le enseñaste, y el reentrenamiento depende de ti.
Precio. Pagas por tiempo de cómputo; no hay licencia por decisión.
¿Cuál deberías elegir realmente?
Así es como guiaría a un compañero de equipo por esta decisión.
Lo que cada una de estas todavía te debe
Sea cual sea la herramienta que elijas, fíjate en la brecha entre una respuesta válida y una correcta. Este fue el punto más debatido en el hilo de lanzamiento de Jev, y se aplica a las ocho alternativas:
"if it puts a high confidence value on a wrong answer, thats still hallucinating, no?"
La reformulación útil del mismo hilo es que una puntuación de confianza solo vale algo si está calibrada:
"What we would want to see is a confidence value that is in line with the actual correctness. If the value is 0.9 for 1000 different answers, then approximately 900 of those answers should be correct."
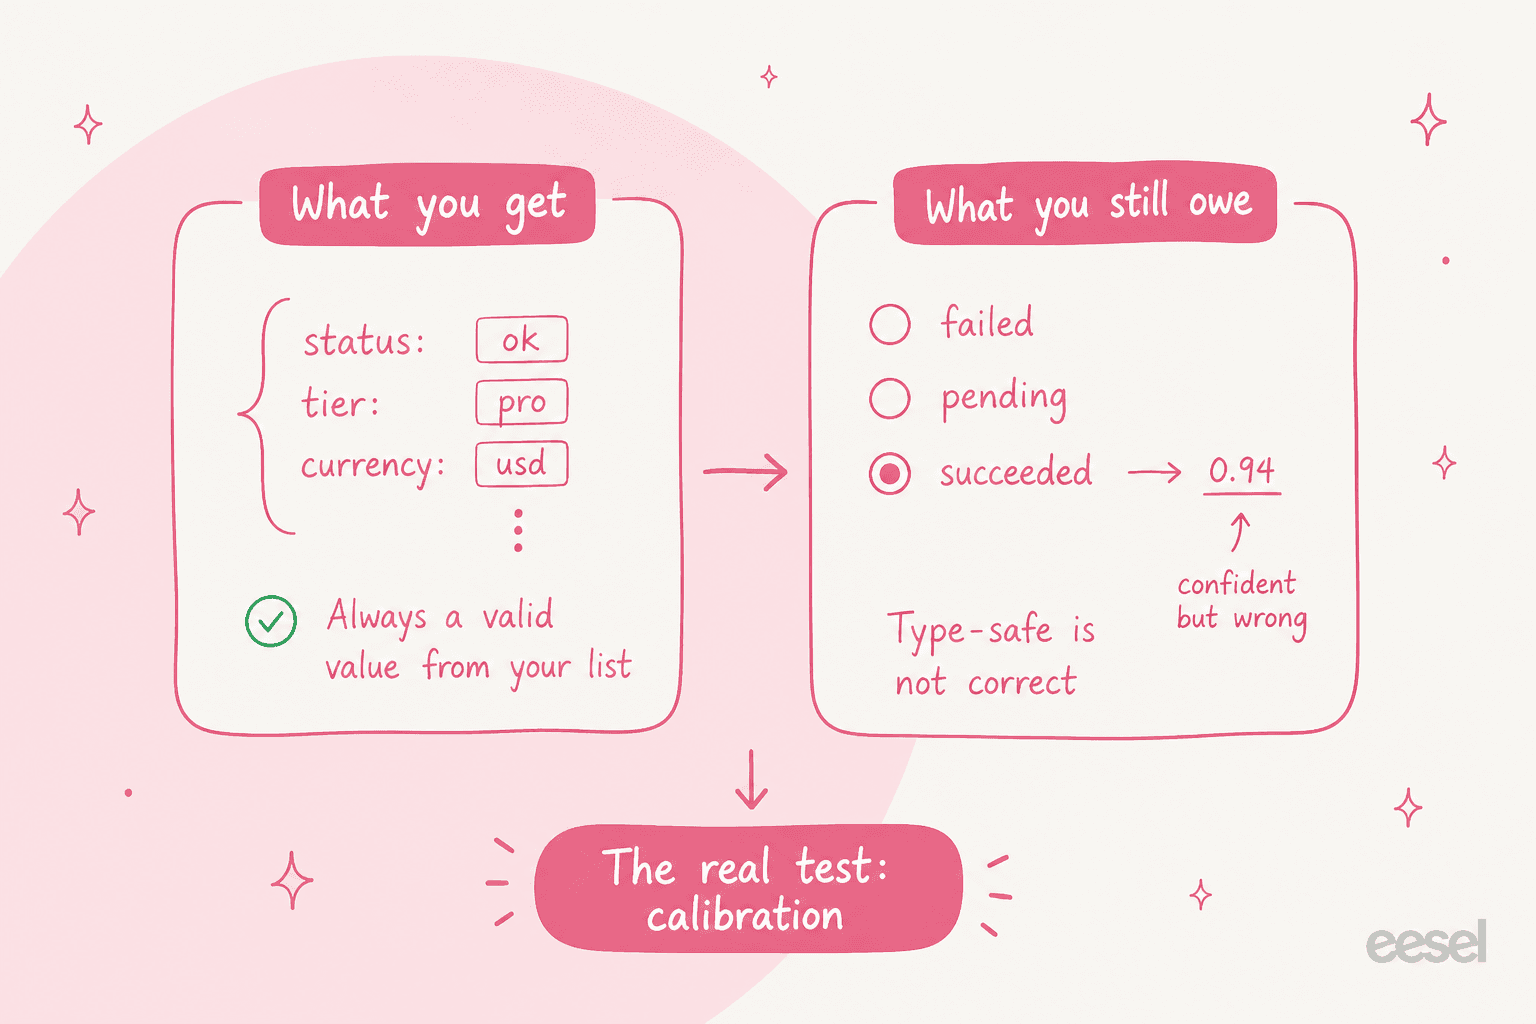
Por eso, en el lado del soporte, no confío en ninguna capa de decisión hasta que se ha ejecutado contra los tickets pasados propios de un equipo, la misma disciplina que aplicaría al elegir un LLM para soporte o al preseleccionar los mejores agentes de soporte con IA. Un modelo que puntúa 0,94 en una llamada de enrutamiento no significa nada hasta que hayas comprobado que las llamadas con 0,94 de confianza son realmente correctas el 94% de las veces con tus datos. Aun así, el entusiasmo es real, y donde aterriza la gente lo dice con franqueza:
"After much fumbling around with prompts and evals, this is exactly how I am using LLMs in production, to narrowly make choices and return structured data... I think this is going to quickly become the new standard approach for agentic systems."
Y en producción, la velocidad no es solo hype. El CEO de Vercel reportó cifras reales:
"Jev is up to 18x faster (p95) and more accurate. It's coming to Vercel AI Gateway and likely new default."
Dónde encaja eesel en todo esto
Toda herramienta de esta página es infraestructura. Le entregan a tu código una decisión tipada, y luego tu código tiene que hacer algo con ella. Esa es la forma correcta si estás construyendo un producto. Es la forma incorrecta si tu trabajo es gestionar una cola de soporte y esperabas que un modelo de decisión lo hiciera.
eesel es el empleado, no el primitivo. El compañero de IA para helpdesk lee tu centro de ayuda y tickets pasados, toma las mismas decisiones de triaje y enrutamiento que tomaría Jev, y luego redacta, etiqueta, enruta y resuelve dentro de tu helpdesk con IA existente. Puedes apuntarlo a tu historial y simular el despliegue antes de que responda a un solo cliente en vivo, así que la calibración es un paso que tomas, no una afirmación en la que confías. Y si tu instinto es escribir scripts para todo, el mismo compañero de equipo se puede manejar desde la CLI de eesel y MCP.
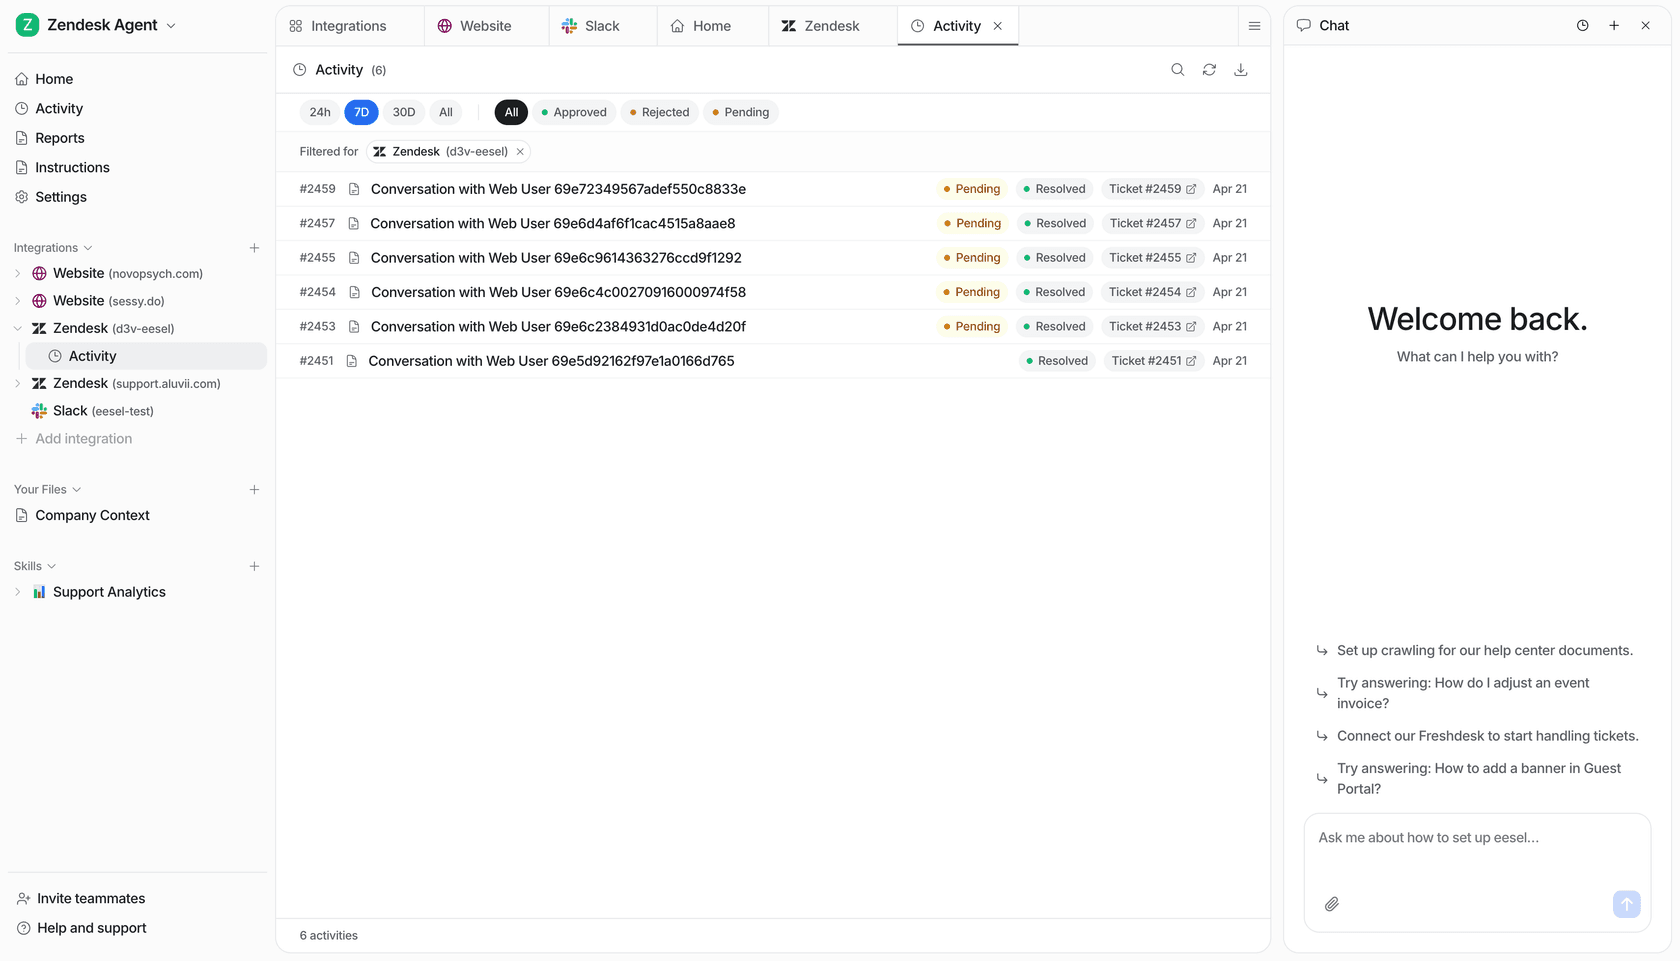
Si estás sopesando Jev o una de sus alternativas porque quieres decisiones de soporte más rápidas y fiables, el camino más corto es probar la capa que ya convierte esas decisiones en tickets resueltos, del mismo modo que un copiloto de IA redacta junto a tus agentes. Prueba eesel gratis, o reserva una demo y míralo funcionar con tus propios tickets.
Preguntas frecuentes
Preguntas frecuentes
¿Cuáles son las mejores alternativas a TypeSafe Jev?
Las alternativas más cercanas a TypeSafe Jev son funciones de salida estructurada gestionadas como OpenAI Structured Outputs y Gemini structured output, bibliotecas de código abierto como BAML, Instructor y Outlines, y un clasificador entrenado mediante Hugging Face AutoTrain. Si quieres la decisión y la acción en un helpdesk, un agente de IA para atención al cliente es la capa por encima de todos ellos.
¿Existe una alternativa gratuita a TypeSafe Jev?
Sí. Instructor (MIT) y Outlines (Apache-2.0) son bibliotecas gratuitas de código abierto, y las salidas estructuradas en OpenAI y Gemini son una función gratuita sobre el precio normal por token. De todas formas pagas por el modelo que corre debajo, así que "gratis" se refiere a la capa de esquema, no a la inferencia.
¿Cuál es la diferencia entre Jev y OpenAI Structured Outputs?
Jev es un modelo System One construido específicamente que se salta la generación de texto y devuelve una decisión tipada más una puntuación de confianza calibrada en un solo paso en paralelo. OpenAI Structured Outputs es una restricción añadida sobre un modelo generativo normal, así que sigues pagando la latencia y el coste de generación, pero obtienes todo el razonamiento de un LLM de frontera. Jev cambia ese razonamiento por velocidad.
¿Cuánto cuestan las alternativas a TypeSafe Jev?
Varía según el tipo. Las bibliotecas de código abierto son gratuitas y solo pagas la tarifa por token del modelo subyacente. Las funciones gestionadas como Gemini structured output cuestan la tarifa normal de tokens de Gemini (Flash-Lite es el nivel más barato). Un clasificador entrenado en Hugging Face cuesta tiempo de cómputo. Como referencia, el propio Jev indica un precio de entrada de $0,042 por millón de tokens con salida gratuita.
¿Pueden estas alternativas gestionar el soporte al cliente como Jev?
Ninguna de ellas gestiona el soporte por sí sola, y Jev tampoco. Todas devuelven una decisión sobre la que tu propio código tiene que actuar. Para convertir "este ticket es urgente, enrutar a facturación" en un ticket resuelto, necesitas una capa que también lea tu clasificación de tickets, redacte la respuesta y ejecute la acción. Ese es el trabajo de un agente de IA para helpdesk, no de un primitivo de decisión.
¿Todas las alternativas a TypeSafe Jev dan puntuaciones de confianza?
No de la misma manera. Jev se entrena con RLCD (Reinforcement Learning for Calibrated Decisions) para que sus probabilidades reflejen la precisión real. Las opciones basadas en LLM exponen logits de token que puedes leer como una confianza aproximada, y un clasificador entrenado te da una probabilidad softmax. La prueba honesta para cualquiera de ellas es la calibración con tus propios datos, no el número en sí.
¿Qué alternativa a TypeSafe Jev es mejor para clasificación?
Para clasificación estrecha y de alto volumen, un clasificador de Hugging Face ajustado es el más barato por llamada, mientras que Gemini structured output en Flash-Lite es el más rápido de poner en marcha. Para trabajo específico de soporte como triaje y enrutamiento, un flujo de trabajo de atención al cliente con IA que ya conecta la clasificación con acciones te ahorra el código de pegamento.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.