Las 8 mejores alternativas a Gemini 3.8 Flash en 2026

Rama Adi Nugraha

Katelin Teen
Última edición September 8, 2026
¿Por qué mirar más allá de Gemini 3.8 Flash?
Gemini 3.8 Flash es un buen modelo. Se ubica #3 de 196 en velocidad de salida con 302 tokens/segundo y obtiene 59 puntos en el Intelligence Index de Artificial Analysis, muy por encima de la mediana. Para un trabajo por lotes nocturno que procesa un gran acumulado, es difícil de superar en precio.
El truco está en lo que cuesta ese "trabajo más duro". La propia nota de lanzamiento de Google es inusualmente franca al respecto:
"Estas mejoras de rendimiento provienen de una decisión de diseño fundamental: 3.8 Flash trabaja más duro. En tareas complejas, muestra mayor diligencia, ejecuta pasos de razonamiento adicionales y llama a herramientas de forma iterativa. A veces, el modelo puede usar más tokens para maximizar el rendimiento, especialmente en niveles de esfuerzo más altos."
Luego la frase que debería decidir tu actualización: Google recomienda a los desarrolladores preocupados por la eficiencia de cómputo "seguir confiando en Gemini 3.7 Flash, que permanece totalmente soportado para cargas de trabajo enfocadas en eficiencia." Que un proveedor te diga que su modelo anterior sigue siendo la elección correcta es lo bastante raro como para tomárselo en serio.
Dos números convierten esto en una razón real para buscar alternativas. Primero, Artificial Analysis mide 13.3 segundos hasta el primer token frente a una mediana de clase de unos 3 segundos. El rendimiento no es lo mismo que la capacidad de respuesta, y 13 segundos de silencio muerto son un factor decisivo para un widget de chat o una respuesta de soporte. Segundo, consume 120M de tokens de salida para completar el AA Index frente a una mediana de 71M, algo que la propia AA marca como "muy verboso". Una salida más locuaz significa una factura más grande en exactamente la tarifa de salida que se duplica en enero de 2027.
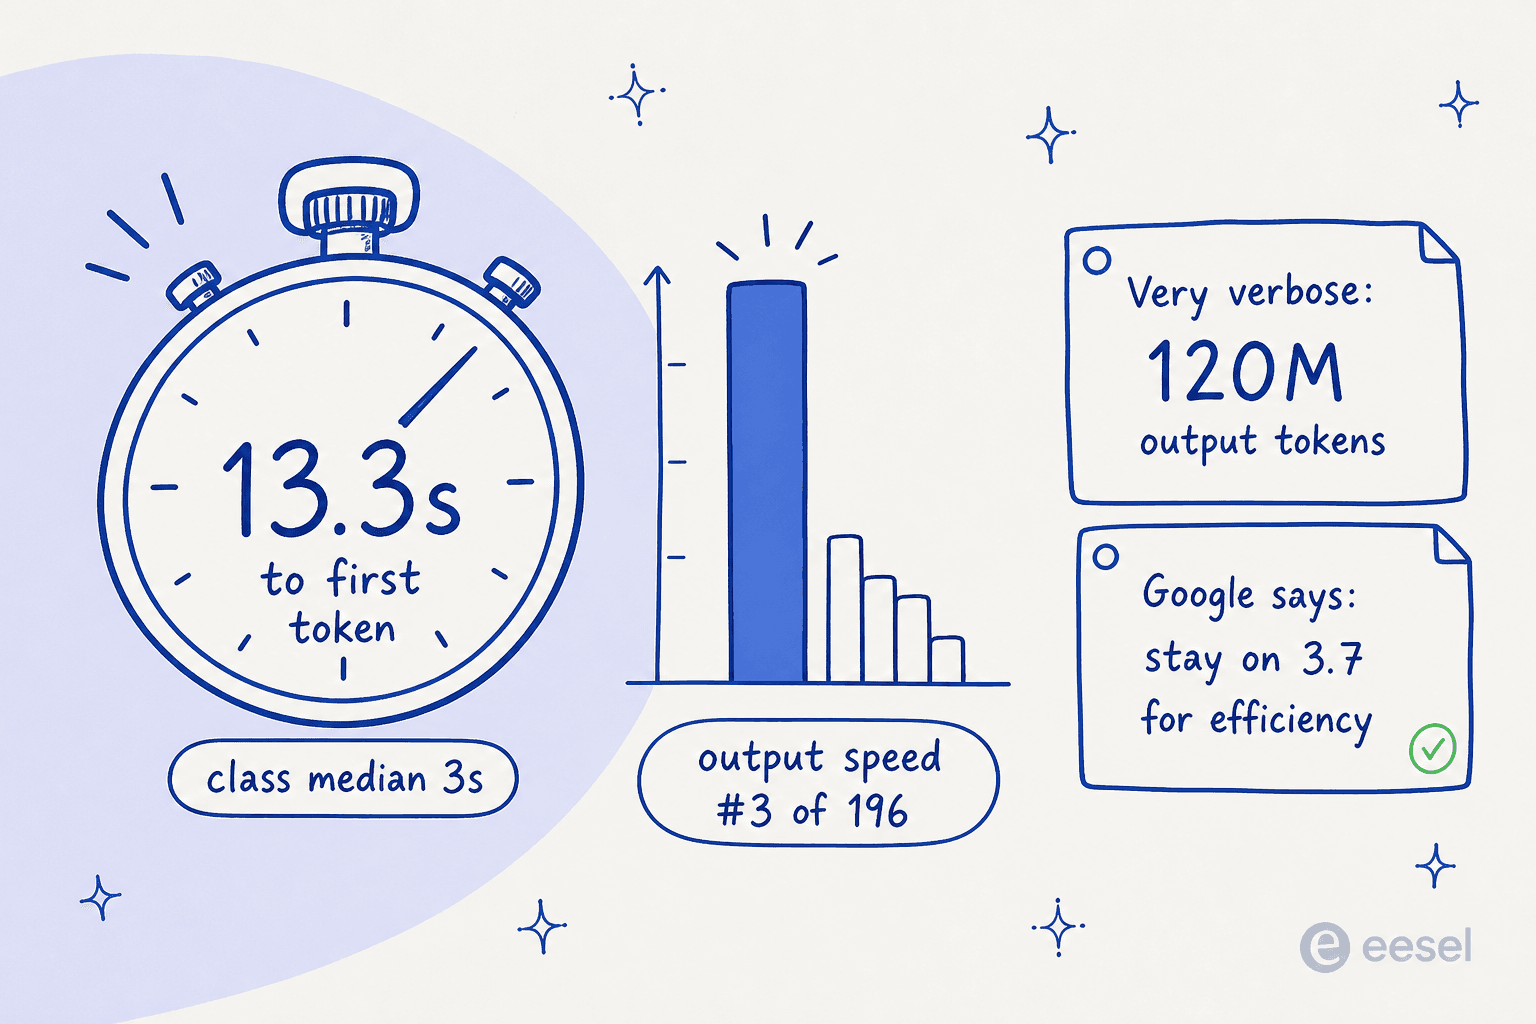
Así que no es que "3.8 Flash sea malo". Es que "rápido y económico" esconde un muro de latencia y un impuesto de hinchazón de tokens, y para muchas cargas de trabajo, otro modelo, a veces el propio modelo anterior de Google, es el mejor cambio.
Cómo elegí estas alternativas
Limité la lista a modelos que están realmente en el mismo trabajo que Flash: caballos de batalla rápidos, económicos y de alto volumen a los que recurrirías para impulsar un agente, un clasificador o un asistente de código, no buques insignia de $30 por millón. Para cada uno sopesé cuatro cosas:
- Costo real por tarea, no solo la tarifa nominal. Un modelo que cuesta la mitad por token pero es el doble de locuaz no es más económico. La verborrea es donde muchos modelos "económicos" recuperan silenciosamente el dinero.
- Latencia con la que puedas vivir. El tiempo hasta el primer token importa más que el throughput máximo en el momento en que hay un humano del otro lado.
- Abierto vs. cerrado. Varios de estos entregan pesos abiertos que puedes alojar tú mismo, lo que cambia por completo la ecuación de residencia de datos y costos.
- Lo que reportan usuarios reales, de hilos de Hacker News y Reddit, no de las publicaciones de benchmark del día de lanzamiento.
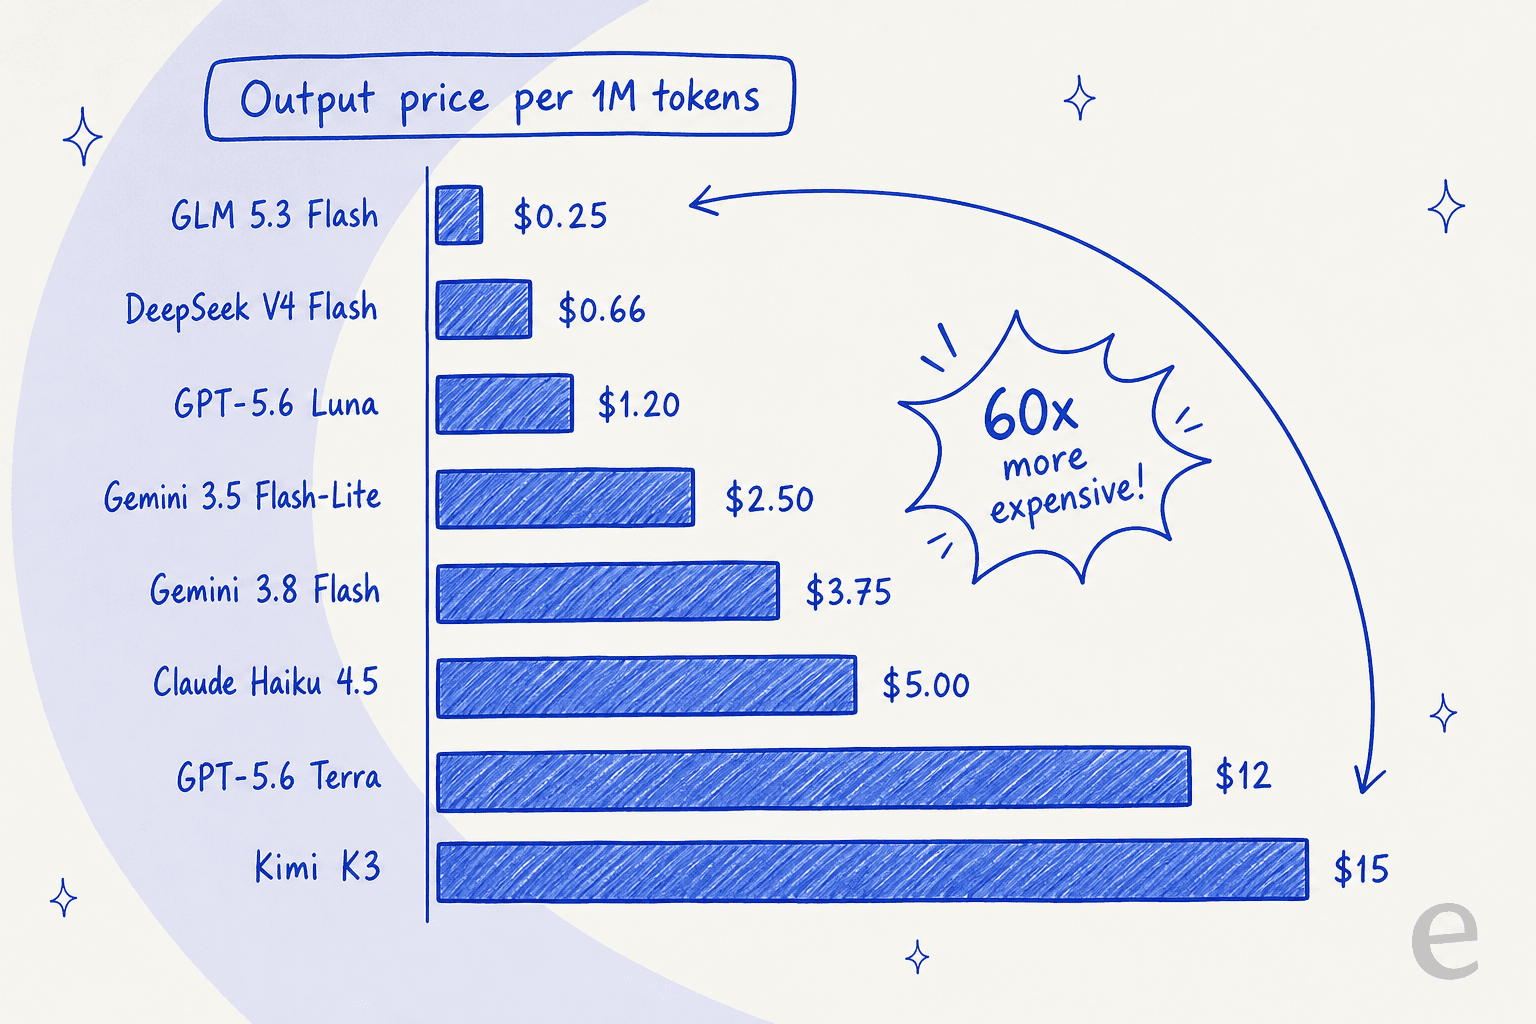
Los precios abajo son por 1M de tokens, nivel estándar, según figuran en la página de precios de cada proveedor. Los tokens de razonamiento y pensamiento se facturan a la tarifa de salida en todos los modelos aquí, así que la columna de salida suele ser la que decide tu factura.
Alternativas a Gemini 3.8 Flash de un vistazo
| Modelo | Mejor para | Entrada / Salida ($/1M) | Pesos abiertos | Contexto | El truco principal |
|---|---|---|---|---|---|
| Gemini 3.7 Flash | Enfocado en eficiencia, mismo precio | $0.75 / $3.75 | No | 1M | Se duplica en enero de 2027; eliminó minimal |
| OpenAI GPT-5.6 (Terra) | Cambio de frontera más ligero | $2.00 / $12.00 | No | 400K | El nivel de contexto largo cuesta 2x |
| DeepSeek V4 Flash | El menor costo real | $0.22 / $0.66 (fuera de pico) | Sí (MIT) | 1M | Recargo en hora pico; alucina; solo texto |
| Kimi K3 | Razonamiento de pesos abiertos | $3.00 / $15.00 | Sí | 1M | Caro por token; no puede dejar de pensar |
| Qwen 3.8 Flash-Next | Contexto largo, vista previa abierta | ~$0.03-$0.20 in / $0.13-$0.80 out | Sí | 1M | Vista previa sub-entrenada; un solo proveedor |
| Claude Haiku 4.5 | Confiabilidad + seguridad | $1.00 / $5.00 | No | 200K | Más costoso que el paquete económico |
| GLM 5.3 Flash | Multimodal más económico | $0.075 / $0.25 (promo) | Sí | 200K | La promo termina; ecosistema más pequeño |
| Gemini 3.5 Flash-Lite | OCR / clasificación de alto volumen | $0.30 / $2.50 | No | 1M | Más débil en razonamiento difícil |
La dispersión en la columna de salida es toda la historia: de $0.25 a $15 por millón, una brecha de 60x para modelos que todos se ubican más o menos en la misma categoría de "rápido y económico".
1. Gemini 3.7 Flash
Mejor para: equipos que quieren todo lo que Flash hace bien, menos el gasto extra de tokens, al mismo precio.
La alternativa más honesta a Gemini 3.8 Flash es el modelo sobre el que fue construido, y es Google quien te lo dice. Como 3.8 es 3.7 Flash entrenado más, se facturan de forma idéntica, y la única diferencia real es que 3.8 hace más trabajo (y gasta más tokens) por tarea. Si no persigues los últimos puntos en un benchmark de razonamiento difícil, 3.7 Flash te da la misma velocidad y una factura más pequeña.
Los desarrolladores que lo usan como auditor económico e incansable lo califican muy bien:
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green... it is blazing fast in Antigravity CLI. Easily 10x faster than Opus."

Ventajas: precio idéntico a 3.8 Flash, menos hinchazón de tokens, una ventana de contexto completa de 1M de tokens, y la misma entrada multimodal amplia (texto, imagen, audio, video, PDF).
Desventajas: la tarifa introductoria se duplica a $1.50/$7.50 el 1 de enero de 2027, igual que 3.8. Y 3.7 eliminó el nivel de pensamiento minimal, así que el piso más económico para OCR y clasificación de tickets desapareció; low es ahora el nuevo mínimo.
Precios: $0.75 de entrada / $3.75 de salida por 1M hasta finales de 2026.
Veredicto: si ya estás recurriendo a 3.8 Flash, prueba primero 3.7 Flash con tus propios prompts. Nueve de cada diez veces hace el trabajo por menos, que es exactamente por qué Google sigue recomendándolo.
2. OpenAI GPT-5.6
Mejor para: equipos que quieren un modelo de frontera que no sea de Google y que llegue a la respuesta con menos tokens.
GPT-5.6 viene en tres variantes, y el nivel que realmente compite con Flash es Terra, no el más económico Luna. La razón para considerarlo frente a Gemini es la eficiencia: los modelos GPT tienden a llegar a la misma respuesta con mucho menos texto de salida, lo que compensa una tarifa nominal más alta en cualquier trabajo intensivo en salida. Un desarrollador lo planteó claramente:
"Sol high is almost the same speed if you take into account drastically lower token use. Look at the artificial analysis speed vs token use. Gemini is 7x faster but 5x more tokens."
Esa es toda la decisión GPT vs. Gemini Flash en una línea. Los tokens/segundo puros favorecen a Gemini; los tokens por tarea terminada a menudo favorecen a OpenAI. Si tu factura está dominada por la salida, haz los números con ambos. Para el desglose completo de niveles, nuestra lista de modelos de OpenAI los detalla.
Ventajas: razonamiento de frontera real, un ecosistema de herramientas enorme, y menos verborrea que Gemini Flash en tareas comparables. Luna ($0.20/$1.20) es un piso económico real si quieres bajar de nivel.
Desventajas: OpenAI cobra un nivel de contexto largo que duplica la tarifa más allá de la ventana de contexto corto, el mismo precipicio tipo 200K que usa xAI. Gemini y Anthropic no lo hacen. Vigila también tus límites de tasa si operas alto volumen.
Precios: Terra $2.00 de entrada / $12.00 de salida; Luna $0.20 / $1.20; Sol $5.00 / $30.00 por 1M (contexto corto).
Veredicto: la alternativa integral más sólida si no estás atado a Google, especialmente cuando tu carga de trabajo es intensiva en salida y el conteo de tokens, no el precio por token, es lo que te está matando.
3. DeepSeek V4 Flash
Mejor para: el menor costo real por token de cualquier modelo alojado aquí, y para quien quiera pesos abiertos.
DeepSeek V4 Flash es el disruptor de precios. Un modelo de mezcla de expertos con 284B en total / 13B activos y pesos con licencia MIT (~167GB, funciona en casa por menos de $10k), figura en $0.22 de entrada / $0.66 de salida fuera de pico, una fracción de Gemini Flash. Y aguanta en trabajo real, no solo en costo:
"I benched DS4 flash and Pro vs opus 4.8 xhigh on 16 work-related tasks a month ago across 4 days. Opus 4.8 came out as a winner by 1 task only [...] But flash performed as well or better (as in being more thorough) in 13 out if 16."
Hay dos trampas honestas. DeepSeek cambió sus precios en agosto de 2026 y ahora aplica un recargo de hora pico/fuera de pico, con horas pico de 01:00-04:00 y 06:00-10:00 UTC, así que una cola de EE.UU. o la UE en su mayoría factura fuera de pico, pero un trabajo por lotes programado en horario laboral chino paga el doble. Y alucina más de lo que te gustaría:
"DeepSeek V4 hallucinates like crazy and often forgets explicitly mentioned parts of the context."
Otra cosa a saber: Flash es solo texto, sin entrada de imagen documentada, así que si tu carga de trabajo involucra capturas de pantalla, esto lo decide. Y en cuanto a datos, los términos de la API de pago de DeepSeek callan sobre el uso para entrenamiento en lugar de proteger, y los datos residen en la RPC bajo ley de la RPC, así que no es un reemplazo directo para datos de clientes regulados.
Ventajas: el menor costo real por token aquí, pesos abiertos MIT, un perfil sólido de uso de herramientas, y texto de razonamiento totalmente visible que puedes dirigir.
Desventajas: el recargo en hora pico, una tasa real de alucinaciones, sin entrada de imagen, y residencia de datos en la RPC.
Precios: $0.22 de entrada / $0.66 de salida por 1M fuera de pico (el doble en hora pico). El nivel Pro cuesta más.
Veredicto: la mejor jugada de costo puro en esta lista, y más sólido de lo que "económico significa débil" sugeriría. Combínalo con recuperación (retrieval) y pruebas intensivas para mantener a raya las alucinaciones, igual que harías con cualquier configuración basada en RAG.
4. Kimi K3
Mejor para: razonamiento de pesos abiertos que compite con los buques insignia, si puedes absorber el costo por token.
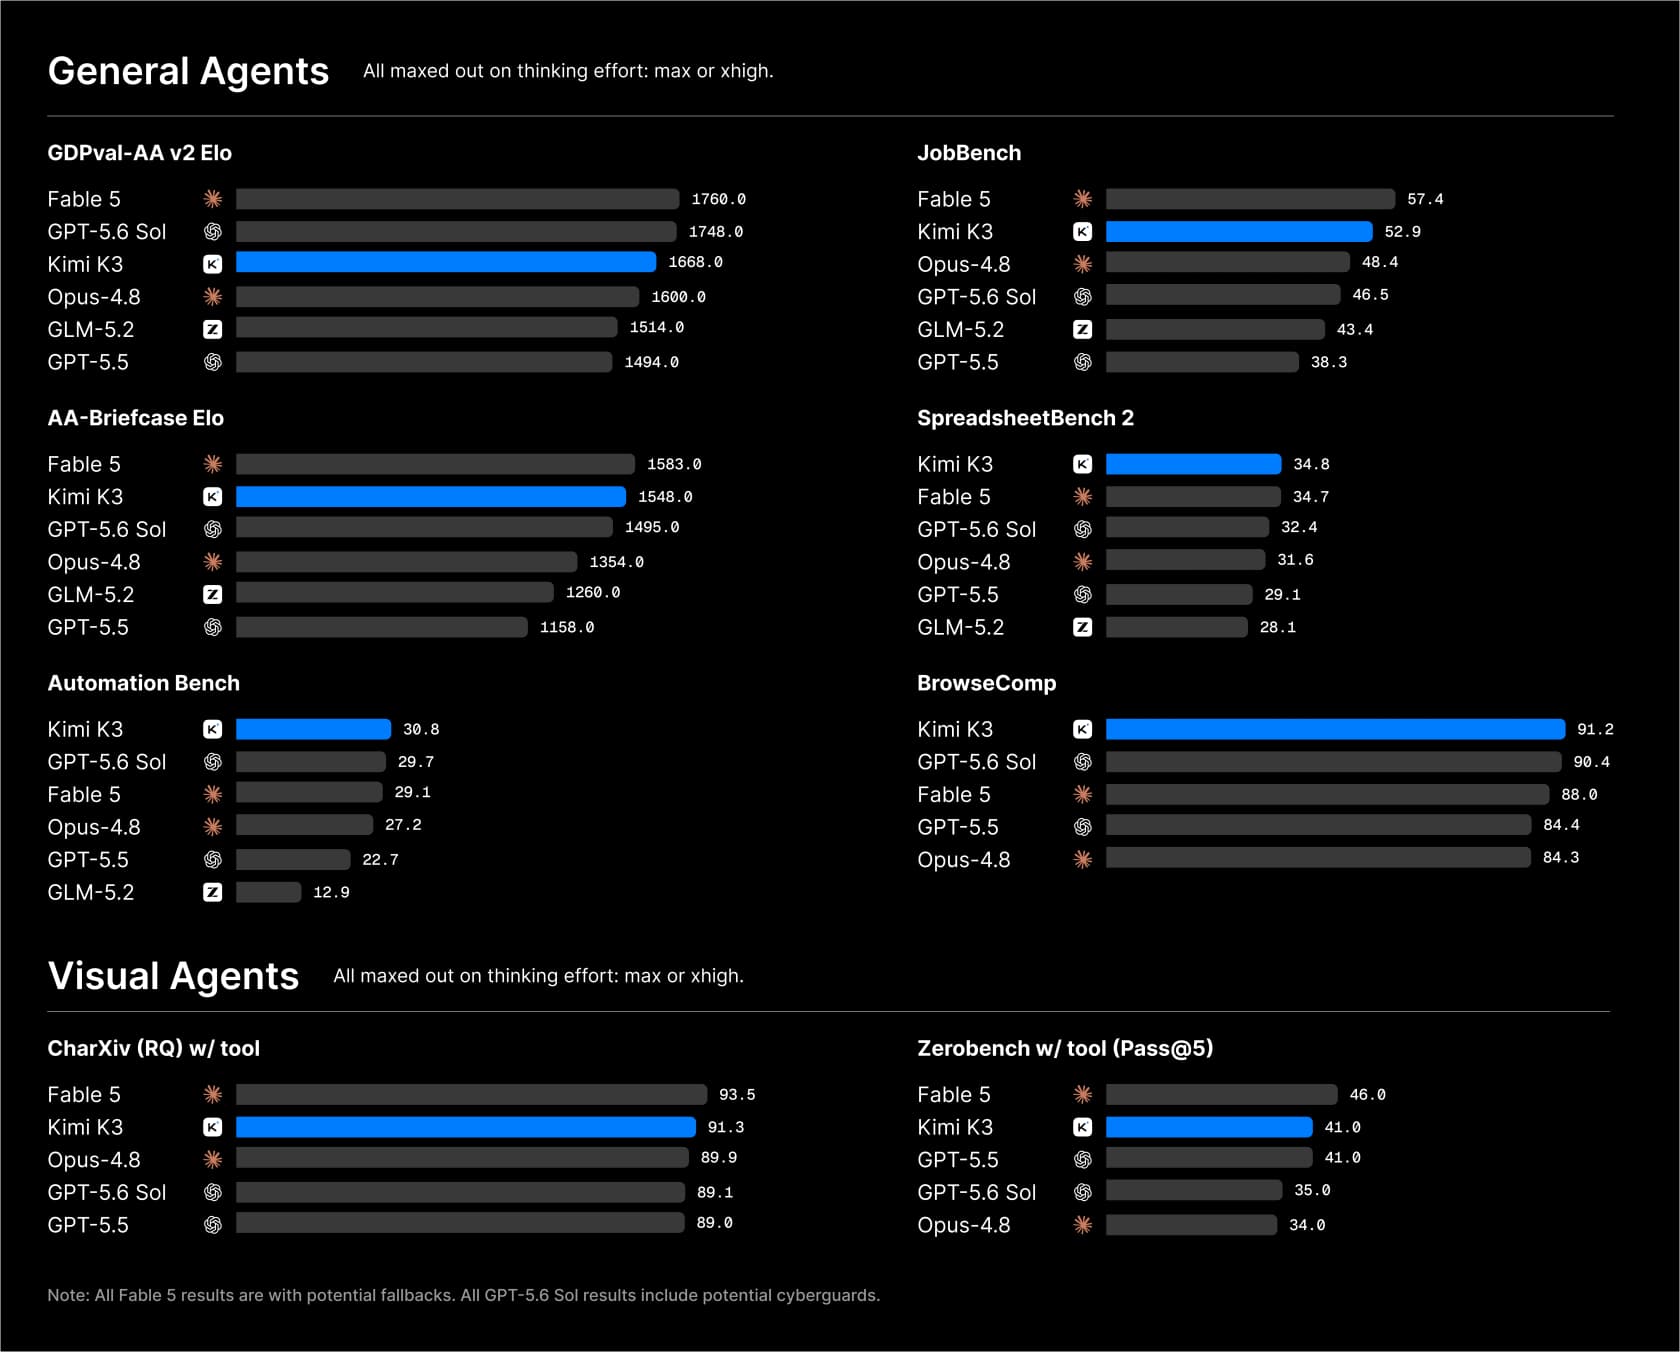
Kimi K3 de Moonshot AI es el peso pesado del razonamiento en el mundo de pesos abiertos: 2.8T en total / 104B parámetros activos, un contexto de 1M de tokens, visión nativa, y pesos abiertos que salieron a tiempo. En Artificial Analysis obtiene un Intelligence Index de 57, territorio top cinco, y lidera claramente varios benchmarks de agentes como BrowseComp.
El problema es el precio y el pensamiento. A $3 de entrada / $15 de salida, se ubica en la banda de Claude Sonnet, aproximadamente 50x la tarifa de salida de DeepSeek Flash, y no puede dejar de razonar. Hay un ajuste low, pero es un control de latencia, no un nivel de costo, y puntúa peor que DeepSeek Flash mientras cuesta 8x más. Los usuarios sienten la lentitud:
"Faster iterations are way better for me, I hate waiting for 5-10 minutes on small changes. I tried to use recent versions of Kimi and GLM, but they use too much thinking for no reason and are pretty slow because of it."
Ventajas: razonamiento de nivel buque insignia, entrada nativa de imagen y video, una ventana de 1M de tokens, y pesos abiertos con quants de la comunidad ya disponibles.
Desventajas: caro por token, sin forma de desactivar el razonamiento, y más lento de lo que esperarías de un competidor de "Flash" (no lo es; es un modelo de frontera). Tampoco se aceptan URLs de imágenes públicas, solo base64 o un id de archivo subido.
Precios: $3.00 de entrada / $15.00 de salida por 1M ($0.30 entrada con cache-hit).
Veredicto: la elección cuando necesitas razonamiento real y quieres la opción de auto-alojarlo, no cuando necesitas económico y rápido. Si tu barra es "tan bueno como un buque insignia pero soy dueño de los pesos", K3 la supera; si tu barra es "reemplazar Flash en costo", no lo hace. Desglose completo en nuestra reseña de Kimi K3.
5. Qwen 3.8 Flash-Next
Mejor para: cargas de trabajo de contexto largo y alto cache donde el throughput a escala importa, en pesos abiertos.
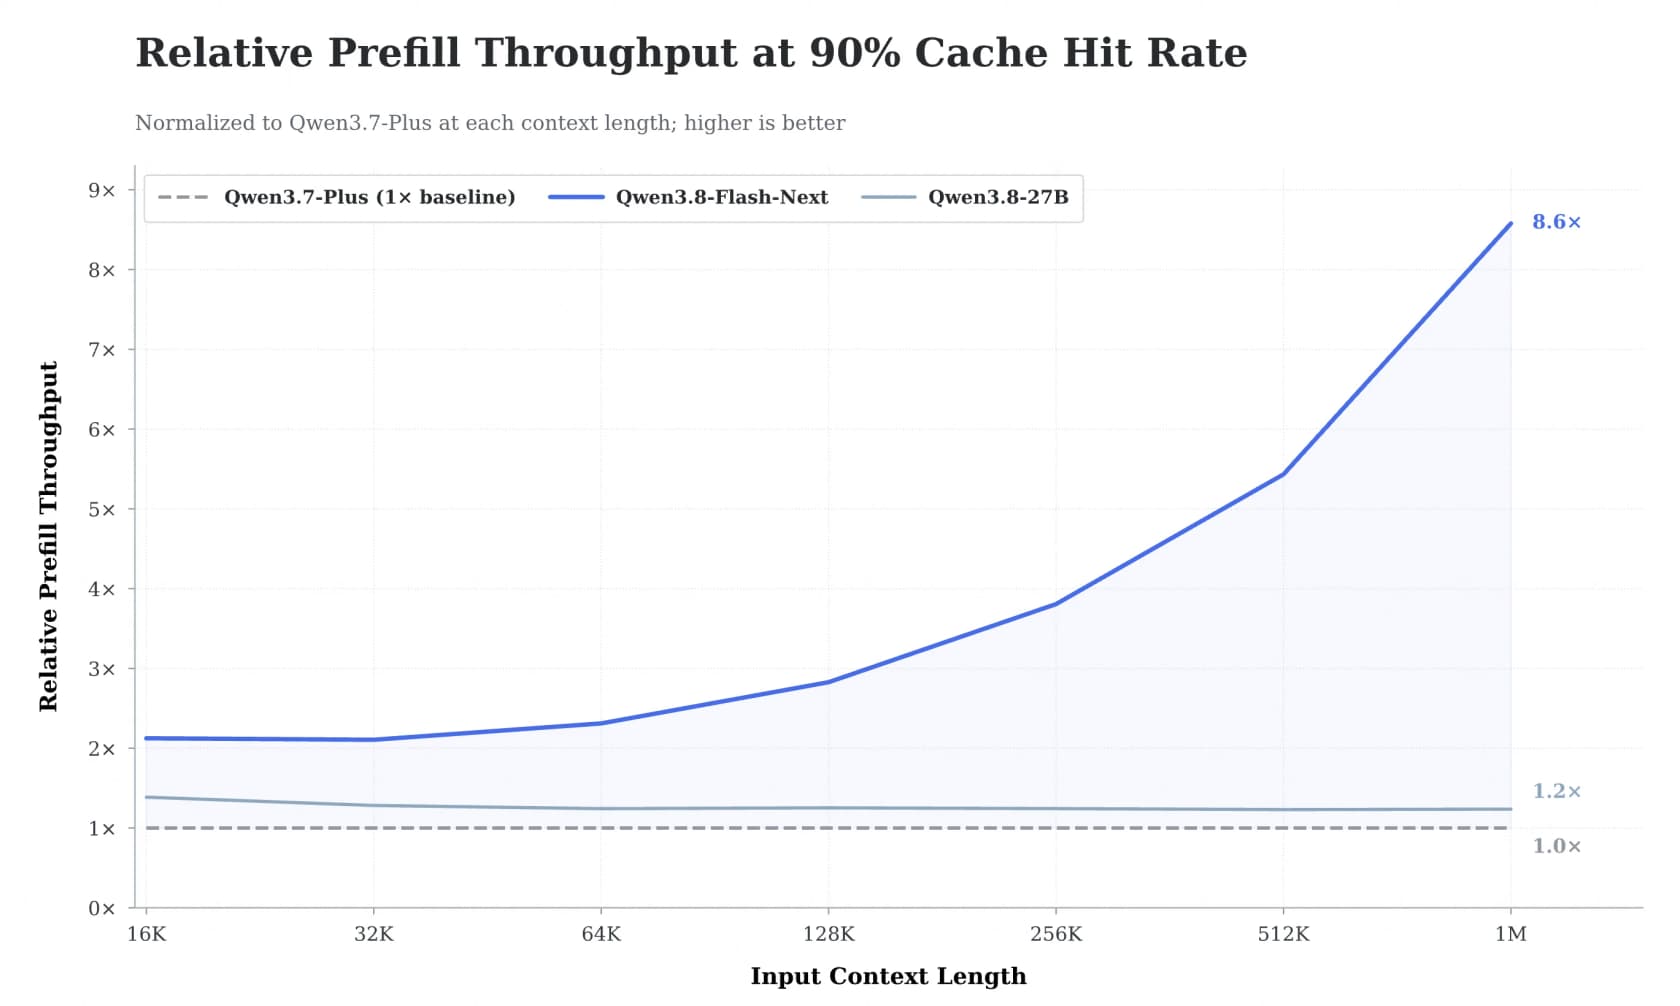
Qwen 3.8 Flash-Next de Alibaba es la rareza más interesante aquí. Es una vista previa de la próxima arquitectura de Qwen, y su truco de fiesta es el throughput de prefill: con Qwen Sparse Attention alcanza 8.6x el throughput de Qwen3.7-Plus en un contexto de 1M de tokens. Para una carga de trabajo pesada de contexto largo y alto acierto de cache, esa escala es real y difícil de igualar. Entrega pesos abiertos y cobra por tramos, desde alrededor de $0.03/$0.13 por 1M en prompts cortos hasta $0.20/$0.80 en los más grandes.
El truco es lo que significa "vista previa". Está deliberadamente inacabado:
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."
Además, Simon Willison lo probó y terminó preferir un modelo denso más pequeño, culpando a la cuantización de bajo bit necesaria para que encaje, y la API alojada actualmente tiene un único proveedor, así que no hay respaldo. Artificial Analysis también lo marca como "muy verboso", 200M de tokens de salida para completar su Index frente a una mediana de 110M.
Ventajas: throughput excepcional en contexto largo, pesos abiertos, muy económico en prompts cortos, y una vista previa de hacia dónde se dirige Qwen. Nuestra guía de precios de Qwen tiene la tabla completa de tramos.
Desventajas: deliberadamente sub-entrenado, un golpe de calidad por cuantización, alojamiento de un solo proveedor, y salida verbosa que infla la factura.
Precios: por tramos, aproximadamente $0.03-$0.20 de entrada / $0.13-$0.80 de salida por 1M según el tamaño del prompt.
Veredicto: una vista previa de nivel de investigación, no un valor predeterminado de producción. Recurre a él si el throughput de contexto largo es tu cuello de botella y puedes auto-alojarlo; de lo contrario, espera la línea Qwen4 terminada. Más opciones en nuestro resumen de alternativas a Qwen.
6. Claude Haiku 4.5
Mejor para: equipos que cambiarán un precio algo más alto por confiabilidad y un historial de seguridad más limpio.
Claude Haiku 4.5 es el modelo rápido y pequeño de Anthropic, y es al que recurro cuando la prioridad es un modelo que se comporte de forma predecible en lugar del token absolutamente más económico. A $1 de entrada / $5 de salida cuesta más que el paquete económico, pero viene con el precio plano de Anthropic (sin recargo de contexto largo), un perfil sólido de seguimiento de instrucciones, y la madurez de herramientas del ecosistema más amplio de Claude.
Importa aquí porque dos métricas de seguridad realmente retrocedieron en Gemini 3.8 Flash: la seguridad multilingüe y los rechazos injustificados se movieron ambos en la dirección equivocada frente a 3.7, y Google señaló que la seguridad en idiomas distintos al inglés "retrocedió levemente". Si atiendes a una audiencia multilingüe o regulada, un modelo con un historial de seguridad más estable vale la prima.
Ventajas: precio plano sin precipicio de contexto, seguimiento de instrucciones confiable, un ecosistema maduro, y una postura de seguridad sólida. Buen ajuste para quien ya esté construyendo sobre Claude.
Desventajas: más caro que DeepSeek Flash, GLM, o la línea Gemini Flash, pesos cerrados, y una ventana de contexto más pequeña de 200K frente a los modelos de 1M de tokens aquí.
Precios: $1.00 de entrada / $5.00 de salida por 1M.
Veredicto: la elección de "el impuesto de confiabilidad vale la pena". Si te has quemado con un modelo económico que alucina frente a clientes, Haiku 4.5 recompra mucha tranquilidad. Mira cómo se compara en nuestra guía de alternativas a Claude.
7. GLM 5.3 Flash
Mejor para: el modelo multimodal verdadero más económico aquí.
GLM 5.3 Flash de Z.ai es el primer modelo multimodal nativo de la serie GLM-5, y en su promoción de lanzamiento es el modelo de pago más económico aquí: $0.075 de entrada / $0.25 de salida por 1M (lista $0.15/$0.50). Entrega pesos abiertos y, a diferencia de DeepSeek Flash, realmente acepta imágenes. Los primeros probadores califican muy bien la relación precio-calidad:
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

También hay un GLM Coding Plan ($18/$80/$168 al mes) que funciona dentro de Claude Code, Cursor, Cline y más de 20 herramientas de agentes, lo que lo convierte en un backend de código muy económico si vives en un IDE.
Ventajas: calidad de nivel producción a un precio muy bajo, entrada multimodal nativa, pesos abiertos, y una suscripción dedicada de código. Los niveles gratuitos GLM-4.7-Flash y 4.5-Flash son una buena rampa de entrada.
Desventajas: el descuento de lanzamiento del 50% termina, después la tarifa se duplica a $0.15/$0.50 (todavía económico). El ecosistema es más pequeño que el de OpenAI o Google, y el modelo de razonamiento insignia GLM-5.3 es un SKU separado y más caro.
Precios: $0.075 de entrada / $0.25 de salida por 1M en promoción; $0.15/$0.50 en lista.
Veredicto: el campeón de valor para trabajo multimodal. Si el límite de solo-texto de DeepSeek Flash lo descarta para ti, GLM 5.3 Flash es la forma más económica de mantener la entrada de imagen sin pagar las tarifas de Gemini Flash.
8. Gemini 3.5 Flash-Lite
Mejor para: clasificación de alto volumen, etiquetado y OCR donde Flash completo es excesivo.
A veces la alternativa correcta a Gemini 3.8 Flash es un Gemini más pequeño. Gemini 3.5 Flash-Lite es el modelo económico y de alto throughput de Google: $0.30 de entrada / $2.50 de salida, un contexto de 1M de tokens, y entrada multimodal. Es la respuesta cuando haces mucho trabajo económico y bien acotado, extrayendo campos, etiquetando tickets, corriendo OCR, donde no necesitas un razonador pesado que gaste 120M de tokens en pensarlo.
También es el modelo que mantuvo el piso económico que 3.7 y 3.8 Flash abandonaron. Flash-Lite todavía admite los ajustes de pensamiento ultra bajos que hacen funcionar la economía de la clasificación, exactamente la carga de trabajo que se volvió más cara cuando los modelos Flash más nuevos eliminaron minimal.
Ventajas: más económico que Flash completo, un enorme contexto de 1M de tokens, throughput fuerte (~490 tokens/segundo), entrada multimodal, y se mantiene dentro del ecosistema Google/Vertex que quizá ya uses.
Desventajas: más débil en razonamiento difícil y tareas agénticas que los modelos Flash completos, sin uso de computadora, y el mismo patrón de precio introductorio-luego-más-alto en toda la línea Gemini 3.x.
Precios: $0.30 de entrada / $2.50 de salida por 1M (estándar).
Veredicto: el downgrade correcto, no un compromiso. Para trabajos de alto volumen y baja complejidad, Flash-Lite hace el trabajo por un tercio del precio y te mantiene en infraestructura de Google.
La capa en la que realmente estás comprando
Aquí está lo que sigo repitiéndome, porque construyo esto para vivir. Si estás elegiendo un modelo rápido y económico para impulsar un agente de atención al cliente, comparar Flash contra DeepSeek contra GLM es la pregunta equivocada. El modelo es el motor. No es el auto.
Una API de modelo puro te da un endpoint de texto-entra, texto-sale. Para convertir eso en algo que resuelva tickets, todavía tienes que conectar tu base de conocimiento, construir recuperación (retrieval) para que deje de alucinar, escribir reglas de escalación, probarlo contra casos reales antes de que toque a un cliente, y monitorearlo y reentrenarlo para siempre. Eso son semanas de ingeniería, y eres dueño de todo, incluido cambiar el modelo cada seis semanas cuando sale el siguiente Flash.
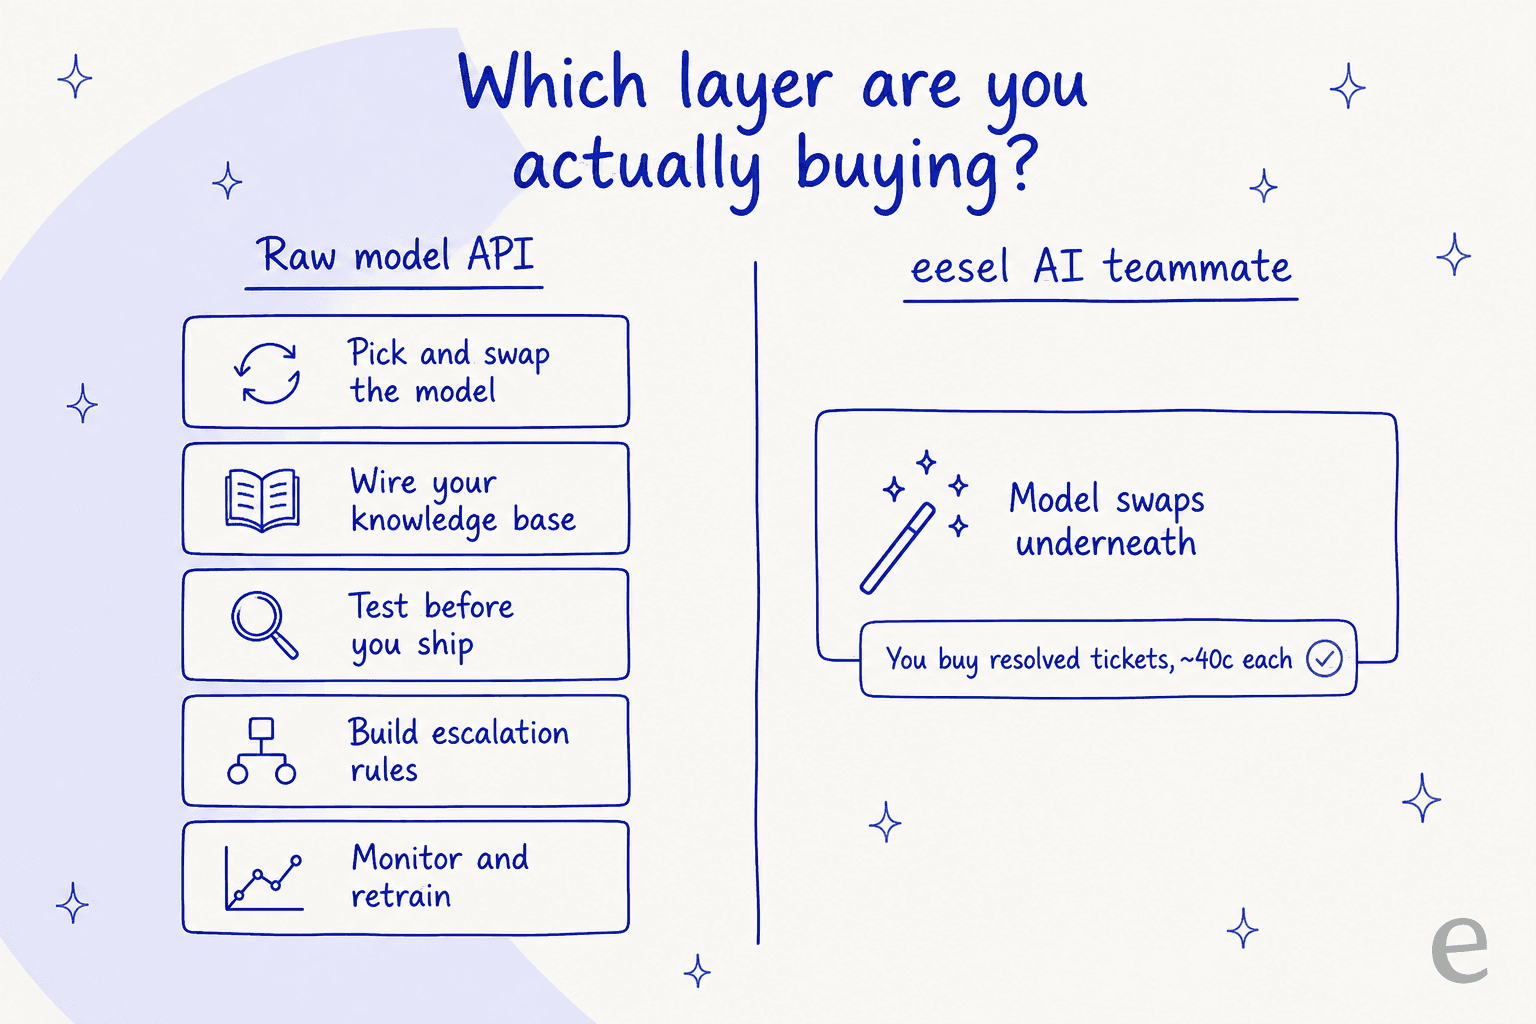
Esta es la distinción que vale la pena recordar: un modelo es infraestructura; un compañero de equipo es el empleado. Si tu meta es un asistente de código con IA que funcione o un pipeline de investigación, entonces sí, elige el mejor modelo y construye. Pero si tu meta es "responder bien los tickets de soporte", el camino más rápido y económico es comprar el compañero terminado y dejar que otra persona se obsesione con qué Flash está ganando este mes.
Prueba eesel para atención al cliente
Si llegaste aquí porque quieres un modelo rápido y económico para manejar el soporte, eesel es la capa sobre el modelo que realmente hace el trabajo. Es una plataforma de compañeros de IA, y el compañero listo para trabajar para esto es el agente de mesa de ayuda con IA: se une a tu cola existente, entrena con tus tickets pasados y tu base de conocimiento, y comienza a resolver conversaciones, sin necesidad de manipular modelos.
Dos cosas lo hacen adecuado para este problema exacto. Primero, es agnóstico de modelo por diseño, así que la pregunta "¿es mejor Gemini 3.8 Flash o DeepSeek Flash?" se convierte en el problema de eesel, no en el tuyo; nosotros elegimos y cambiamos el modelo subyacente a medida que mejoran. Segundo, y esta es la cicatriz que te enseña cada uno de estos modelos rápidos, eesel simula cada lanzamiento contra tus tickets históricos antes de que salga en vivo, así que ves la tasa de resolución real y detectas las respuestas seguras-pero-equivocadas antes de que lo haga un cliente. ¿Prefieres operarlo desde una terminal o un script? Hay un CLI de eesel completo para que los agentes de código y los pipelines de CI puedan operar el mismo compañero. La facturación es basada en uso, aproximadamente 40 centavos por ticket resuelto, así que pagas por resultados, no por tokens. Es gratis probarlo.
Preguntas frecuentes
¿Cuál es la mejor alternativa a Gemini 3.8 Flash de bajo costo?
¿Es Gemini 3.7 Flash una buena alternativa a Gemini 3.8 Flash?
¿Cuánto cuesta Gemini 3.8 Flash comparado con las alternativas?
¿Qué alternativa a Gemini 3.8 Flash es mejor para atención al cliente?
¿Existen alternativas de pesos abiertos a Gemini 3.8 Flash?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.