8 mejores alternativas a Claude Opus 5.5 en 2026 (más baratas, más rápidas, abiertas)

Kurnia Kharisma Agung Samiadjie

Katelin Teen
Última edición September 23, 2026
Por qué la gente mira más allá de Claude Opus 5.5
Primero, la parte justa. Opus 5.5 se gana su reputación. Está construido para programación agéntica de larga duración y trabajo de conocimiento, maneja la ambigüedad sin mucha ayuda, y ocupa el número uno del Artificial Analysis Intelligence Index con una puntuación de 58. Anthropic incluso bajó el precio de los $5/$25 de Opus 5 a $4/$20, una concesión genuina y no forzada a los compradores. Si ya estás metido de lleno en Claude Code y el trabajo es realmente difícil, quedarte donde estás es una decisión defendible.
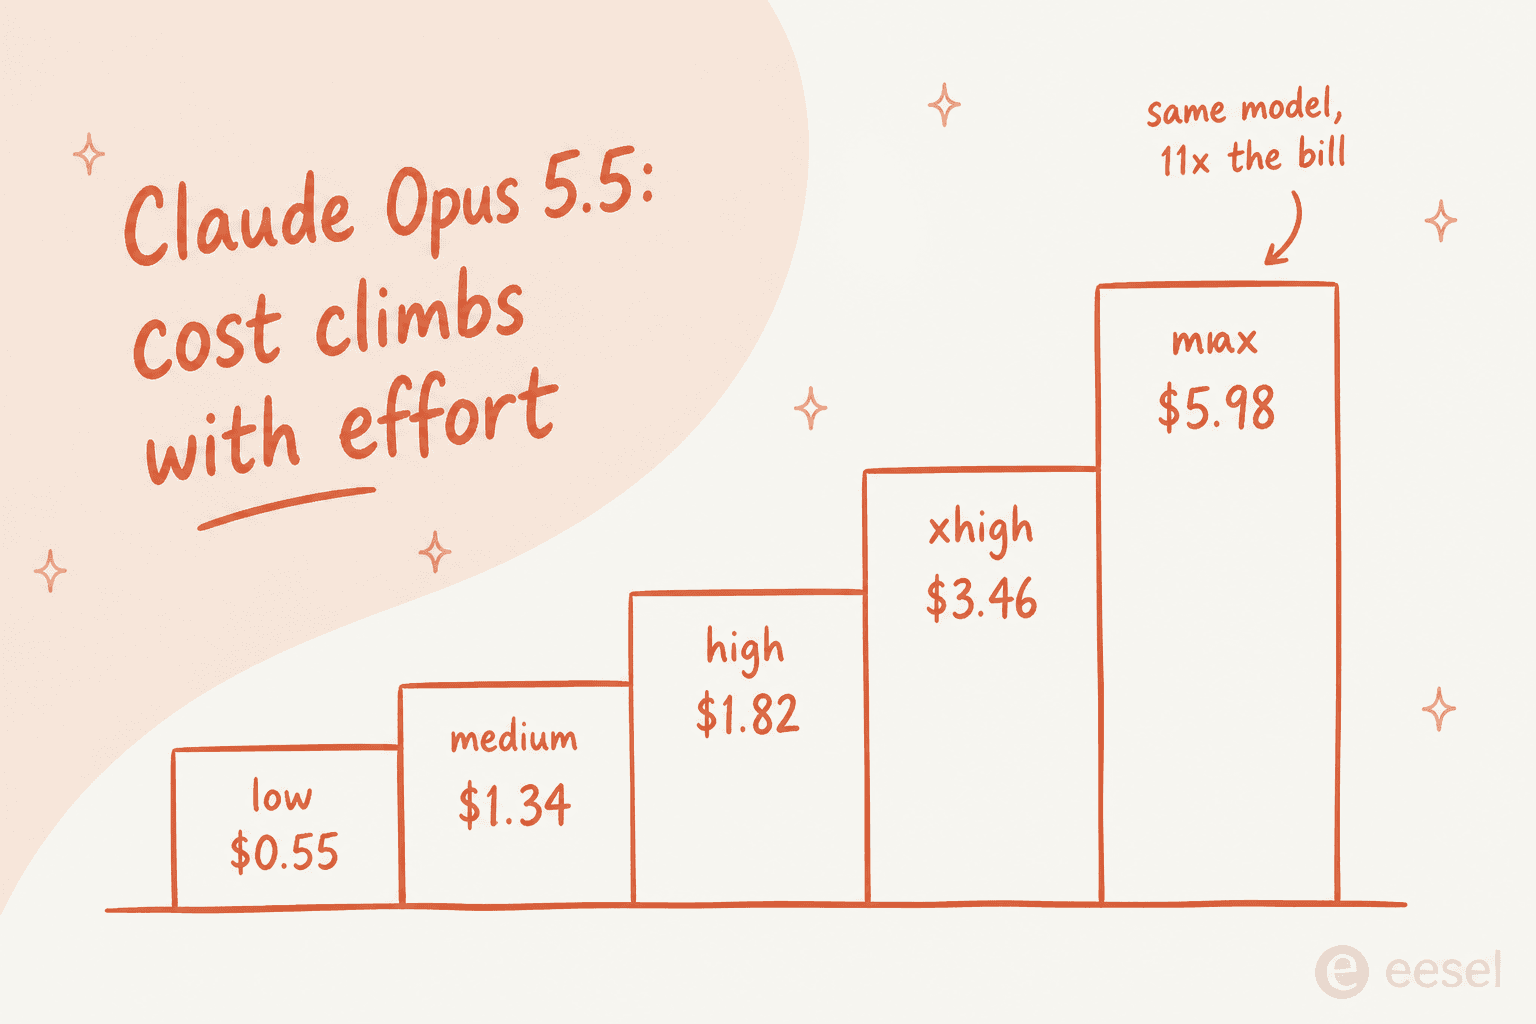
Llevo los últimos años poniendo IA en colas de soporte al cliente en vivo, y lo que más me sorprendió de los modelos de frontera no fue la calidad, fue que la factura sigue mucho más el dial del esfuerzo que el precio de lista. Opus 5.5 es un ejemplo perfecto. La tarifa por token está en la media, pero el coste por tarea oscila entre unos $0.55 con esfuerzo bajo y $5.98 con el máximo, porque con esfuerzo alto razona más tiempo y emite más tokens.
Así que las razones por las que la gente se pone a mirar suelen ser una de cuatro:
- Coste por tarea terminada. Un modelo que puntúa unos pocos puntos menos pero cuesta una quinta parte por tarea es la mejor compra para la mayoría de las cargas de trabajo.
- Velocidad. Opus es pausado. Para cualquier cosa que un humano espera, como una respuesta de chat, la latencia importa más que un benchmark.
- Pesos abiertos. Algunos equipos necesitan autoalojarse por privacidad, soberanía o control de costes.
- Amplitud multimodal o contexto. Audio, vídeo, o una ventana de contexto realmente enorme puede ser la característica decisiva.
Así se comparan las ocho alternativas que realmente consideraría antes de entrar en cada una de ellas.
Las alternativas a Claude Opus 5.5 de un vistazo
| Modelo | Mejor para | Precio /1M (entrada / salida) | Contexto | Pesos abiertos | Visión nativa |
|---|---|---|---|---|---|
| Claude Opus 5.5 (actual) | Programación agéntica más difícil | $4 / $20 | ~1M | No | Sí |
| GPT-6 Sol | Calidad de frontera, más barato por tarea | $2 / $10 | 1,05M | No | Sí |
| Gemini 3.8 Flash | Multimodal barato a escala | $0.75 / $3.75 | 1M | No | Sí (+ audio/vídeo/PDF) |
| Grok 4.7 | Bucles de agentes de alto volumen | $2 / $6 | 500K | No | Sí |
| Qwen 3.8 Max | Valor multimodal, base abierta | $2 / $6 | 1M | Solo base | Sí |
| Kimi K3 | Pesos abiertos con visión | $3 / $15 | 1M | Sí | Sí |
| DeepSeek V4 Flash | El suelo de coste | ~$0.22 / $0.66 | 1M | Sí (MIT) | No |
| GPT-6 Luna | El más barato a escala | $0.10 / $0.50 | 1,05M | No | Sí |
| Claude Sonnet 5 | Quedarse en la familia Claude | $2 / $10 | ~1M | No | Sí |
Los precios son las tarifas estándar de lista para contexto corto por millón de tokens, comprobadas en septiembre de 2026. La cifra de DeepSeek es la tarifa fuera de pico para entrada con fallo de caché y la tarifa de salida estándar. La tarifa de Gemini 3.8 Flash es promocional hasta el 31 de diciembre de 2026, y luego se duplica.
Una nota rápida sobre cómo elegí. Esto es una lista corta, no un catálogo, así que ponderé tres cosas: un precio real y comprobable (por token y, donde Artificial Analysis lo ha medido, por tarea), cómo se comporta el modelo realmente frente a su marketing, y si cubre un hueco que Opus 5.5 deja abierto. Cualquier cosa que fuera solo "Opus pero ligeramente peor al mismo precio" no entró.
1. GPT-6 Sol: el rival de frontera más cercano, a una quinta parte del coste
Mejor para: equipos que quieren calidad casi de frontera pero no pueden asumir la factura por tarea de Opus 5.5.
GPT-6 Sol se lanzó el 23 de septiembre de 2026, un día después de Opus 5.5, y es la comparación más directa de esta lista. Tiene una ventana de contexto de 1.050.000 tokens, entrada de imagen nativa, y el conjunto completo de herramientas OpenAI Responses, incluyendo búsqueda web, intérprete de código, shell alojada, uso del ordenador y MCP.
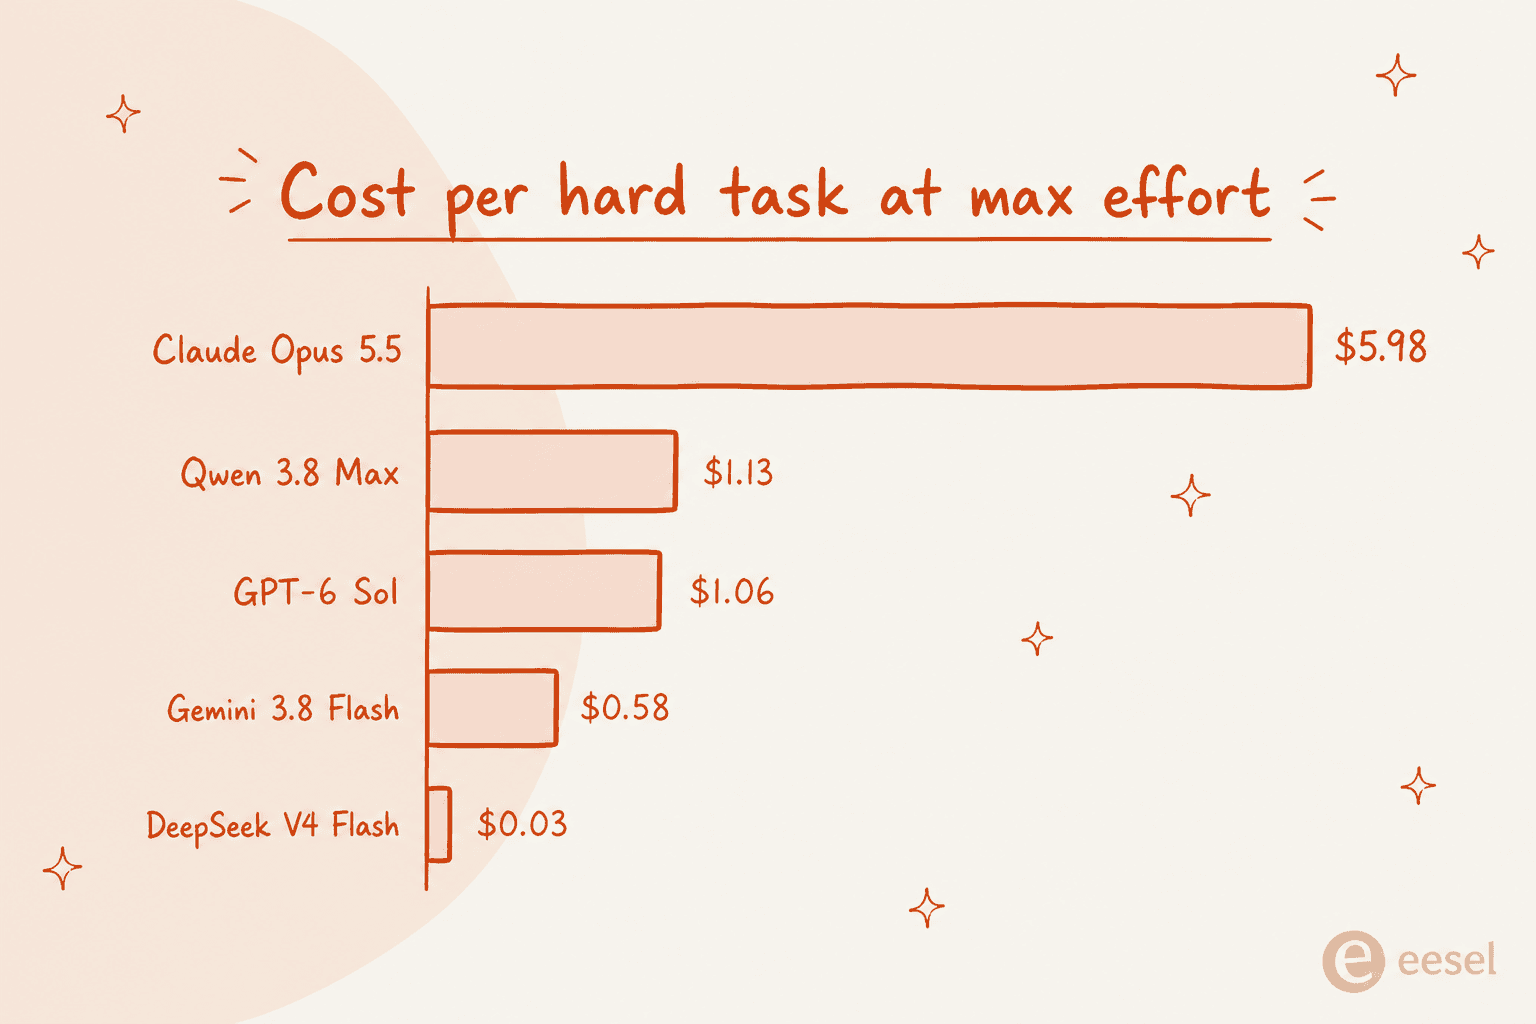
En inteligencia bruta, gana Opus: Artificial Analysis puntúa a Sol con 48 en su Intelligence Index frente al 58 de Opus 5.5. Pero mira lo que cuesta cada punto. Sol cuesta $2/$10 por millón de tokens, la mitad que Opus, y con el máximo esfuerzo termina una tarea difícil por unos $1.06 frente a los $5.98 de Opus, en parte porque emite muchos menos tokens de salida. Ese es el número más contundente de todo este artículo.
Hay un debate real sobre si esa diferencia merece la pena, y la comunidad está dividida. Aquí tienes a un tester experimentado en el hilo de lanzamiento:
My initial takeaway is that GPT-6 is mostly a lower cost win, for Luna. GPT-6 Max is an upgrade on intelligence too, but its mostly a cost play (which is great, not complaining). I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability.

Pros: aproximadamente 5 veces más barato por tarea con esfuerzo máximo, prosa por defecto más limpia, una ventana de contexto enorme, y una mejora genuina en factualidad (OpenAI reporta cerca de la mitad de los errores del Sol anterior; la tasa de alucinación con esfuerzo máximo bajó del 92 % al 60 % según Artificial Analysis).
Contras: un techo de razonamiento más bajo que Opus 5.5, y no está en el plan gratuito de ChatGPT, así que el acceso casual implica un plan de pago.
Veredicto: para la mayoría de las cargas de trabajo de construir un agente, Sol es la compra más inteligente. Renuncias a una porción del razonamiento máximo y recuperas la mayor parte en velocidad y presupuesto. Si estás ejecutando muchas tareas y vigilando la factura, empieza por aquí.
2. Gemini 3.8 Flash: la opción barata y genuinamente multimodal
Mejor para: trabajos de alto rendimiento que necesitan entrada de audio, vídeo o PDF con presupuesto ajustado.
Gemini 3.8 Flash es el tercer lanzamiento Flash de Google en seis semanas, y hace algo curioso: supera a Opus 5.5 en el Artificial Analysis Intelligence Index (59 frente a 58) costando una fracción, a $0.75/$3.75 por millón de tokens hasta finales de 2026. Es también el único modelo aquí que ingiere de forma nativa imagen, audio, vídeo y PDF, con una ventana de entrada de 1M de tokens.
Sin embargo, las salvedades honestas importan. El tiempo hasta el primer token es de 13,30s frente a una mediana de la clase cercana a 3s, así que queda descalificado para cualquier cosa que un humano espere en directo y es perfecto para un lote nocturno. También es verboso, y el propio Google dice en el post de lanzamiento que las cargas de trabajo centradas en eficiencia deberían quedarse en 3.7 Flash. En precio y alcance multimodal es excelente; en capacidad de respuesta, no lo es.
Pros: puntuación de Intelligence Index de nivel frontera, los tipos de entrada más amplios de la lista, muy barato, y un plan gratuito para probar.
Contras: primer token lento, salida verbosa que reduce la ventaja de precio, y una duplicación de precio a $1.50/$7.50 ya programada para el 1 de enero de 2027.
Veredicto: si tu carga de trabajo es asíncrona y multimodal, esta es posiblemente la mejor relación calidad-precio de la página. Solo no lo pongas detrás de un widget de chat en vivo donde se notará el retraso de 13s en el primer token. Para la diferencia entre un agente asíncrono y uno en tiempo real, nuestro artículo sobre agentes de IA frente a chatbots basados en reglas es un marco útil.
3. Grok 4.7: tarificado para vivir dentro de bucles de agente
Mejor para: programación agéntica de alto volumen y muchas horas donde el coste por token se acumula.
Grok 4.7 se lanzó el 21 de septiembre de 2026, construido sobre un modelo base mayor que el 4.6 con una ejecución de aprendizaje por refuerzo más larga orientada a tareas de varias horas. Cuesta $2/$6 por millón de tokens por debajo de un prompt de 200K, la tarifa de salida más barata de cualquier modelo de nivel frontera aquí, y tiene una ventana de contexto de 500K más una nueva API de Context Compaction para sesiones largas.
La historia de los benchmarks es "adyacente a la frontera a precios del año pasado". En la propia tabla de xAI, Grok 4.7 obtiene un Terminal-Bench 4.0 de 37.6 (casi el doble del 20.3 del 4.6), EEBench 64.0, y una puntuación de Harvey Legal Agent de 19.6 que de hecho supera tanto a Sol como a modelos de clase Opus. Sin embargo, no gana en todo. En HealthBench Professional puntúa 56.7, por detrás tanto de GPT-6 Sol como del nivel superior de Anthropic.
Pros: la tarifa de salida baja lo hace muy adecuado para bucles que consumen tokens, un salto real en benchmarks de programación y terminal, y el stack de seguridad más fuerte de xAI hasta la fecha.
Contras: una ventana de contexto de 500K que es la mitad que la de los rivales de 1M de tokens, el recargo por contexto largo ($4/$12) se aplica a cada token de la solicitud una vez superados los 200K, y pierde frente a la frontera en salud y algunas evaluaciones de razonamiento.
Veredicto: si estás montando un agente de programación que funciona durante horas y te importa más el medidor por token que los últimos puntos de razonamiento, Grok 4.7 es una elección sólida y honesta. También hay una CLI de xAI si quieres manejarlo desde la terminal.
4. Qwen 3.8 Max: Intelligence Index de nivel frontera, mitad de precio
Mejor para: equipos que quieren una puntuación de Intelligence de clase Opus con una base descargable como respaldo.
Qwen 3.8 Max llegó a disponibilidad general el 2 de agosto de 2026, y en silencio es uno de los modelos de frontera con mejor relación calidad-precio. Es un modelo de mezcla de expertos de 2,4T total / 95B activos con contexto de 1M de tokens, tarificado a $2/$6 por millón de tokens en la nube de Alibaba. En el tablero de Artificial Analysis ahora ocupa el sexto puesto con un Intelligence Index de 58.08, prácticamente al nivel de la cifra de cabecera de Opus 5.5, por una fracción del coste.
El matiz es que aquí los índices automatizados y la preferencia humana no coinciden. En LMArena, Qwen 3.8 Max es fuerte en preferencia ciega: Texto #5, WebDev #4 y Vision #2. Pero el índice compuesto y los votos humanos apuntan en direcciones ligeramente distintas, así que nunca daría un veredicto de una sola cifra sobre él. Ten en cuenta también que los pesos base abiertos existen pero no son equivalentes en funciones al Max alojado, que añade visión, modo sin razonamiento y herramientas integradas.
Pros: Intelligence Index de nivel frontera a $2/$6, excelentes clasificaciones multimodales en LMArena, y una base abierta para equipos que quieren una opción de autoalojamiento.
Contras: los pesos abiertos llevan una licencia que no es Apache y les faltan las funciones del modelo alojado, y la brecha entre puntuación automatizada y humana significa que deberías probar en tus propias tareas.
Veredicto: una elección infravalorada. Si quieres algo que puntúe cerca de Opus 5.5 por menos, y te sientes cómodo haciendo tus propias evaluaciones en lugar de confiar en una sola cifra, Qwen 3.8 Max merece un lugar en tu lista corta.
5. Kimi K3: pesos abiertos que realmente ven
Mejor para: equipos que quieren un modelo de frontera genuinamente abierto y capaz de visión.
Kimi K3 es el buque insignia de Moonshot AI, un modelo de mezcla de expertos de 2,8T total / 104B activos con contexto de 1M de tokens y visión nativa (imagen y vídeo). Crucialmente, los pesos abiertos se lanzaron a tiempo, el 27 de julio de 2026, y el índice de safetensors confirma el recuento de 2,8T de parámetros de forma independiente al comunicado de prensa. En el Artificial Analysis Intelligence Index se sitúa en 57, en el mismo vecindario que Opus 5.5.
La tarificación es de $3/$15 por millón de tokens, que corresponde a la franja de Claude Sonnet en lugar del nivel de saldo. Una peculiaridad que conviene saber: el razonamiento no se puede desactivar. El control reasoning_effort ahora tiene niveles low y high, pero son un control de latencia, no un nivel de coste, ya que cada nivel se factura igual. Tampoco se acepta una URL de imagen pública; se pasa base64 o un ID de archivo.
Pros: pesos verdaderamente abiertos con visión, una puntuación de Intelligence cercana a la frontera, y sólidos resultados agénticos y de BrowseComp.
Contras: tarificado como Sonnet en lugar de como los modelos abiertos baratos, razonamiento que no se puede desactivar, y manejo de imágenes que necesita base64 en lugar de URLs.
Veredicto: la elección cuando "pesos abiertos" y "maneja imágenes" tienen que ser ciertos a la vez. Si solo necesitas uno de esos dos, DeepSeek es más barato y Qwen puntúa más alto, así que Kimi K3 es una elección específica en lugar de una opción por defecto.
6. DeepSeek V4: el suelo de coste, con un asterisco
Mejor para: el coste por token más bajo absoluto, y equipos que quieren pesos con licencia MIT.
DeepSeek V4 Flash es la forma más barata de ejecutar un modelo capaz en esta lista, sin más. Es un modelo de mezcla de expertos de 284B total / 13B activos con contexto de 1M de tokens y pesos abiertos MIT, y en Artificial Analysis puntúa un Intelligence Index de 50 por aproximadamente $0.03 por tarea con esfuerzo máximo, y eso no es un error tipográfico.
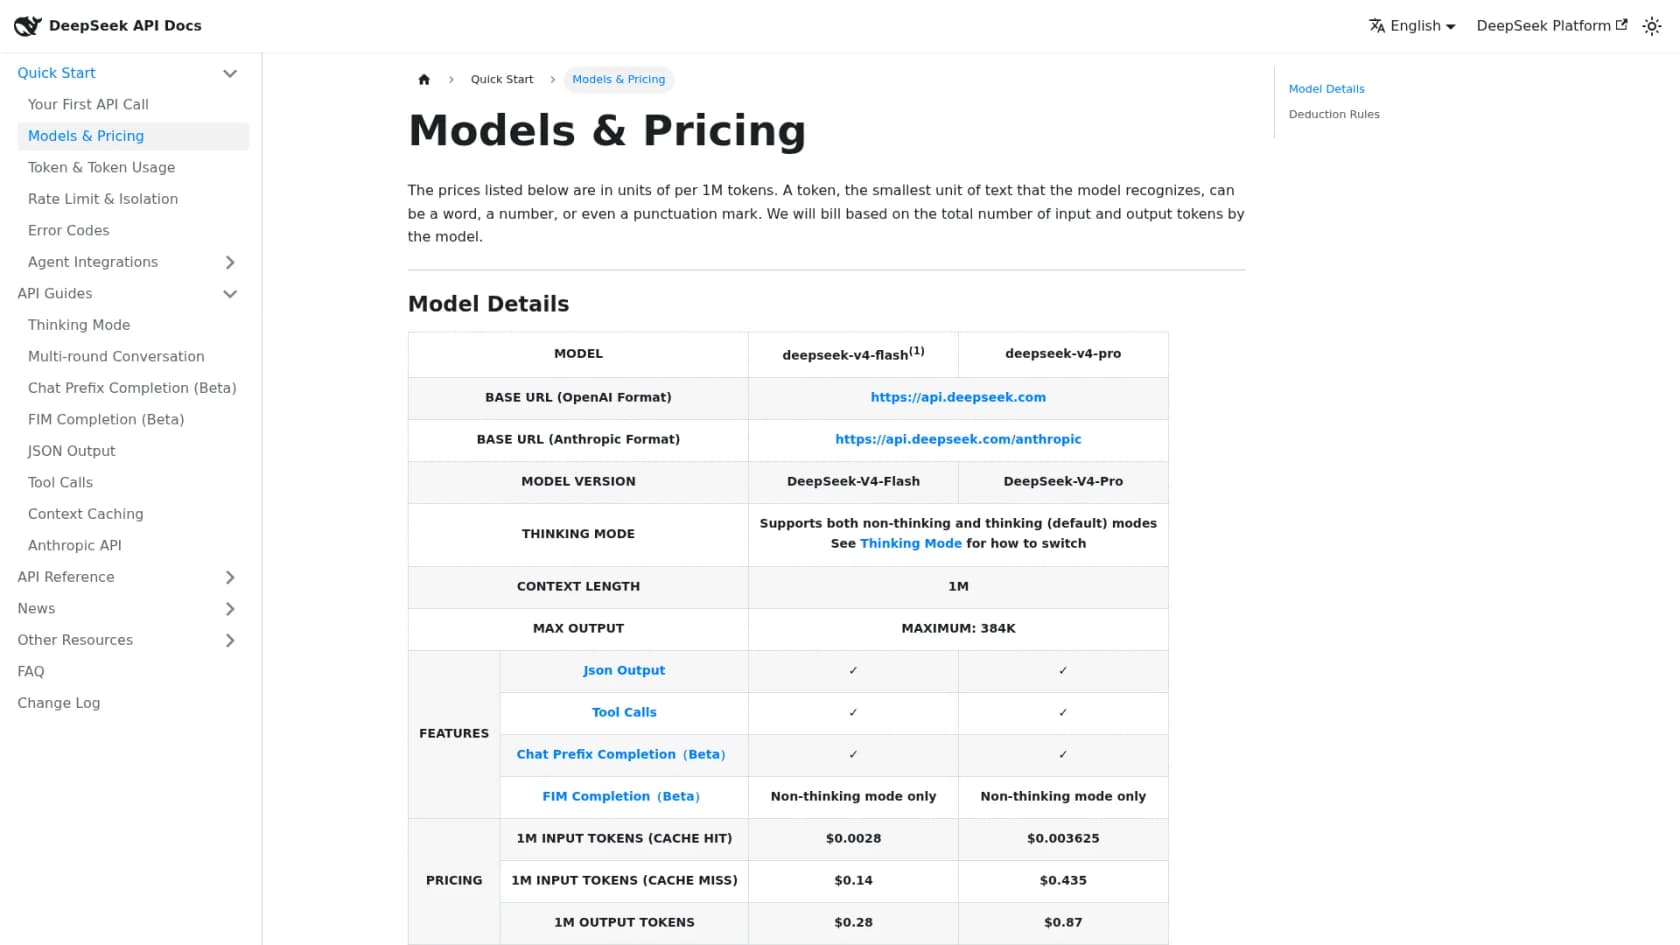
Los asteriscos son reales y merece la pena decirlos con claridad. La tarificación lleva un recargo pico/fuera de pico: la entrada con fallo de caché es $0.22/$0.44 y la salida $0.66/$1.32 por millón (fuera de pico / pico), donde el pico corresponde al horario laboral chino, así que una cola de EE. UU. o la UE se factura mayoritariamente fuera de pico. El modelo es solo texto, sin entrada de imagen documentada. Y sus datos residen en la RPC bajo ley de la RPC, mientras que los términos de la API de pago guardan silencio, no dan permiso explícito, sobre el uso para entrenamiento. Esa combinación lo convierte en una mala opción de sustitución directa para datos de clientes regulados, aunque sea un motor fantástico para código y herramientas internas. Un desarrollador planteó el caso práctico sin rodeos:
I have been using DeepSeek since forever and it's so good I was able to write a compiler and native desktop applications with it. I use it as a coding assistant in my IDE so the results end up at the same quality I would write by hand.
Pros: el coste por tarea más bajo de cualquier sitio, pesos abiertos con licencia MIT, y un contexto de 1M de tokens.
Contras: solo texto, verboso con una alta tasa de alucinación, una peculiaridad frágil de precios pico, y residencia de datos en la RPC que lo descarta para datos sensibles de clientes.
Veredicto: el campeón en relación calidad-precio para código y trabajo interno donde los datos no son sensibles. Combínalo con nuestra guía sobre alucinaciones de IA antes de apuntarlo a algo de cara al cliente.
7. GPT-6 Luna: la forma más barata de escalar
Mejor para: trabajo de alto volumen y bajo riesgo donde unos pocos puntos de inteligencia no cambian el resultado.
GPT-6 Luna es el nivel económico de OpenAI, y es agresivamente barato a $0.10/$0.50 por millón de tokens, un recorte plano del 50 % respecto a GPT-5.6 Luna. Comparte el contexto de 1.050.000 tokens de Sol y la entrada de imagen nativa, y es el único modelo GPT-6 disponible en los planes gratuito y Go ($8) de ChatGPT. El propio planteamiento de OpenAI es "construye con Sol, escala con Luna", y el mercado parece estar de acuerdo; el Luna anterior ya era el modelo más usado en OpenRouter.
6-luna is at the pareto for most of the tasks! I dont know how they make money here but its insane value from a closed source model.
El contrapunto honesto es que "más barato por token" y "más barato por tarea" no son lo mismo. En flujos de programación muy cacheados, algunos desarrolladores encuentran que modelos abiertos como DeepSeek acaban saliendo más baratos por el diferencial de lectura de caché, así que haz tus propios números si el caching domina tu uso.
Pros: la opción más barata de la familia frontera cerrada, una ventana de contexto grande, y acceso gratuito para probar.
Contras: el techo de razonamiento más bajo de la línea GPT-6, y unas cuentas por tarea que pueden perder frente a modelos abiertos en trabajos intensivos en caché.
Veredicto: la herramienta adecuada para volumen, clasificación, traducción y pasos de agente sencillos. No es el modelo al que le encargas tu tarea de razonamiento más difícil, pero es un caballo de batalla excelente y un gran valor por defecto para el aburrido 80 %.
8. Claude Sonnet 5: quédate en la familia, paga la mitad
Mejor para: equipos a los que les gusta el tooling y el ecosistema de Claude pero no necesitan Opus en cada llamada.
Si la razón por la que estás en Opus 5.5 es el ecosistema Claude, Claude Sonnet 5 es la alternativa interna obvia. Cuesta $2/$10 por millón de tokens, exactamente la mitad que Opus, y Anthropic lo posiciona como el mejor equilibrio entre velocidad e inteligencia. Mantienes la misma API, la misma integración de Claude Code y el mismo ecosistema de herramientas; solo dejas de pagar tarifas de Opus por tareas que no necesitan el razonamiento de Opus.
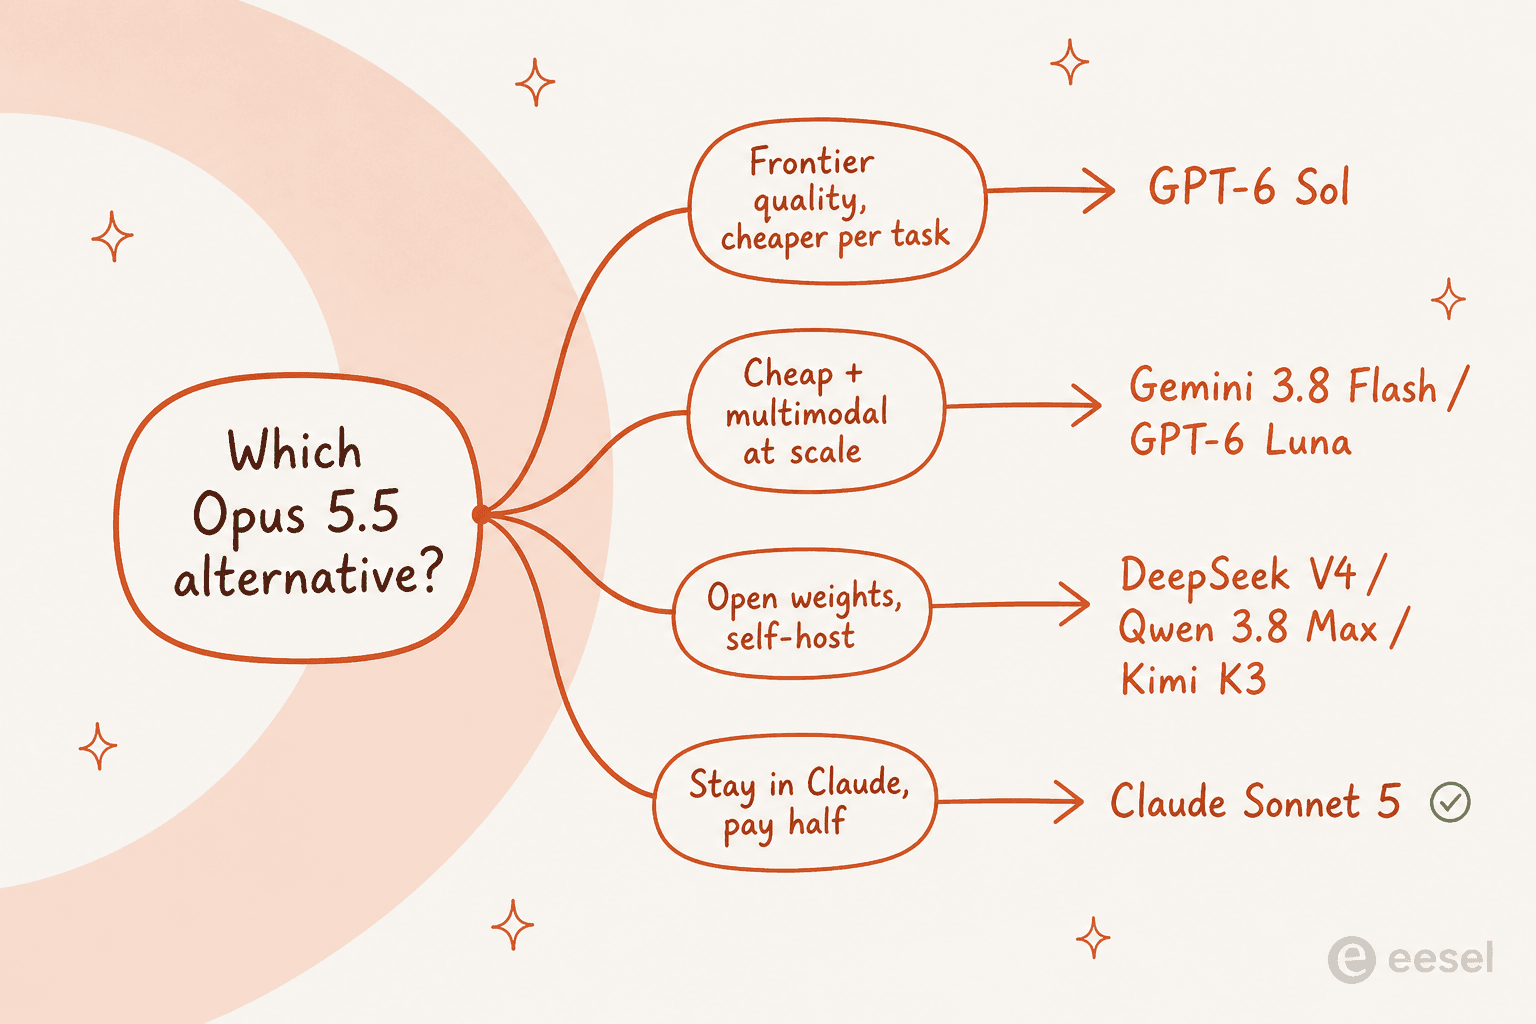
El patrón más sensato que he visto es una configuración de dos modelos: enviar las tareas difíciles y ambiguas a Opus 5.5 y todo lo demás a Sonnet 5. Captura la mayor parte del techo de Opus en las tareas que lo necesitan mientras recorta la factura en las que no.
Pros: la mitad del precio de Opus, sin cambio de ecosistema, y el nivel de Anthropic ajustado a la velocidad.
Contras: un techo de razonamiento más bajo que Opus 5.5, y sigues dentro de los precios de un solo proveedor.
Veredicto: la alternativa con menos fricción de esta lista. Si estás contento con Claude y solo quieres gastar menos, este es el cambio a hacer antes de buscar en cualquier otro sitio.
Cómo elegiría yo en la práctica
Quita la tabla de clasificación y la decisión se reduce a unas pocas preguntas honestas. No hay un único ganador, porque "el mejor" depende de la forma de tu carga de trabajo.
- ¿Quieres lo más parecido a Opus por mucho menos? GPT-6 Sol. Calidad casi de frontera, aproximadamente una quinta parte del coste por tarea.
- ¿Ejecutas trabajos asíncronos y multimodales a escala? Gemini 3.8 Flash por alcance y precio, o GPT-6 Luna por la tarifa más barata por token.
- ¿Necesitas pesos abiertos? DeepSeek V4 para el suelo de coste, Qwen 3.8 Max para el benchmark más alto, Kimi K3 si también necesitas visión.
- ¿Contento con Claude? Sonnet 5 a mitad de precio, idealmente enrutado junto a Opus para las tareas difíciles.
Y hay un punto más silencioso debajo de todo esto, en el que los desarrolladores experimentados coinciden una y otra vez. Los benchmarks son un pistoletazo de salida, no un veredicto:
Only hands-on experience matters in the end, and these days it's very easy to switch models.
Esa última frase, "very easy to switch models", es la verdadera historia de 2026. Lo que lleva a la pregunta que la mayoría de estas comparativas se saltan.
Prueba eesel: el compañero de equipo que funciona con cualquiera de estos modelos
Esto es lo que cada publicación de modelo contra modelo asume en silencio: que tu trabajo es elegir un modelo, conectar su API, gestionar la ingeniería de prompts, conectarlo con tus herramientas, y evitar que todo alucine con clientes reales. Para la mayoría de los equipos, ese no es el trabajo. El trabajo es una tasa de resolución más alta, o publicaciones publicadas. El modelo es solo el motor.
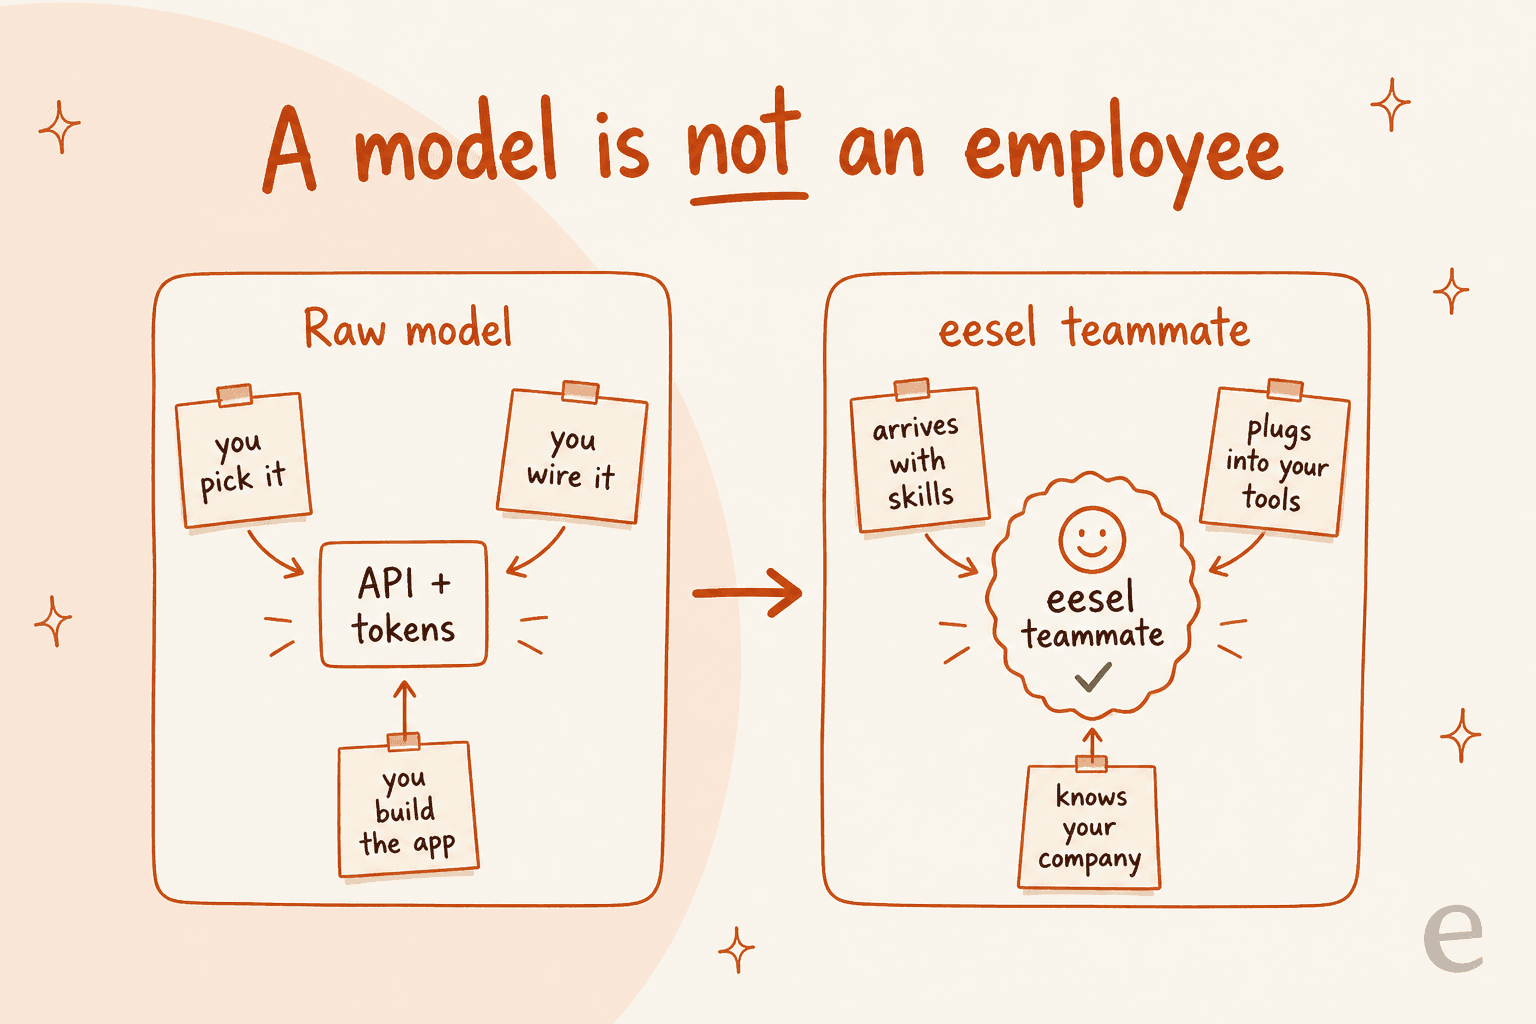
Así es como enmarcaría eesel. Es una plataforma de compañeros de equipo de IA, y contratas compañeros listos para trabajar en tareas específicas. La plantilla actual es un compañero de equipo de IA para helpdesk que se une a tu cola de soporte existente y un escritor de blog con IA que redacta publicaciones investigadas. Cada uno llega ya sabiendo cómo hacer su trabajo, conectado a tus herramientas, y anclado en el contexto de tu empresa, así que no eres tú quien elige entre Opus 5.5 y Sol y cuida un prompt. Como el modelo está debajo del compañero de equipo, un modelo más barato o mejor que salga el mes que viene es una mejora gratuita, no una reconstrucción.

Si eres de los que leen una publicación de alternativas de modelos, te gustará esta parte: todo se puede manejar desde la terminal. La CLI de eesel (npx @eesel/cli) te permite conectar integraciones, editar las instrucciones permanentes del agente, simular un despliegue contra tus tickets históricos, aprobar acciones, y leer el registro de actividad de cada ejecución, todo como JSON, con un flag --dry-run que imprime la llamada exacta que haría una escritura antes de enviarla. Cada workspace es también un servidor MCP, así que agentes de programación como Claude Code, Codex y Cursor pueden operar el mismo compañero de equipo. Es el mismo producto que el panel de control, expuesto para personas y agentes que viven en una terminal. Puedes probar eesel gratis.
Preguntas frecuentes
¿Cuál es la mejor alternativa a Claude Opus 5.5?
¿Cuánto cuesta Claude Opus 5.5 y son las alternativas más baratas?
¿Hay alternativas de código abierto a Claude Opus 5.5?
¿Qué alternativa a Claude Opus 5.5 es mejor para agentes de programación?
¿Tengo que elegir un solo modelo para construir un agente de soporte de IA?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.