Por qué la gente está mirando más allá de GPT-6 Astra
Déjame ser justo primero con GPT-6 Astra, porque es un modelo genuinamente impresionante. Trae una ventana de contexto de 1.050.000 tokens, una shell alojada, apply-patch, uso de computadora y soporte MCP de fábrica, según la página del modelo de OpenAI. En los benchmarks agénticos el salto es real: OpenAI reporta que Terminal-Bench 4.0 sube a 57,9% desde el 37,3% de Sol, y es el primer modelo que OpenAI ha calificado como "Crítico" en ciberseguridad bajo su Preparedness Framework. Si estás construyendo agentes autónomos de programación o pipelines de uso de herramientas de larga duración, esto es importante.
Aquí está el problema, y es la razón por la que estás leyendo esto. OpenAI fijó el precio de Astra en $10 por millón de tokens de entrada y $50 por millón de salida, 2,5 veces los $4/$20 que costaba GPT-5.6 Sol. Por ese dinero esperarías un salto equivalente en inteligencia. No lo obtienes. El índice independiente de Inteligencia de Artificial Analysis pone a Astra en 61,2 contra el 60,9 de Sol, lo cual está dentro del margen de ruido. La opinión más aguda en Hacker News fue que esto se siente "más como un 5.7 que como un 6", y el número lo respalda (profundizamos en esto en nuestra reseña de GPT-6 Astra).

Hay algunas razones más por las que los equipos están buscando alternativas:
- No está en el nivel gratuito. Astra es solo para Plus/Pro/Business/Enterprise y API, y en Enterprise viene desactivado por defecto por espacio de trabajo. (Si estás mapeando la lista más amplia de modelos de OpenAI, Astra está en la cima.)
- La monitoreabilidad bajó. OpenAI señala con franqueza en la ficha del sistema que el modelo puede influir en su propia cadena de pensamiento, así que agregaron un monitoreo de desalineación que puede pausar el uso legítimo de herramientas.
- Los prompts largos cuestan más. Las solicitudes de más de 272K tokens se facturan al doble de entrada y 1,5 veces la salida, así que la ventana de contexto estrella de Astra no tiene un precio plano como sí lo tienen algunos rivales.
Nada de esto hace que Astra sea malo. Lo convierte en un especialista por el que estás pagando precios de buque insignia. Así que veamos qué más hay disponible.
Alternativas a GPT-6 Astra de un vistazo
Aquí está todo el campo lado a lado. Los precios son por millón de tokens en la API estándar de cada proveedor, y los puntajes de inteligencia vienen del índice de Artificial Analysis (se mueven semana a semana, así que trátalos como una referencia aproximada, no como verdad absoluta).
| Modelo | Entrada / salida ($/M) | Contexto | Índice de inteligencia (aprox.) | ¿Pesos abiertos? | Mejor para |
|---|---|---|---|---|---|
| GPT-6 Astra | $10 / $50 | 1,05M | ~61 | No | Agentes autónomos, programación, ciber |
| Claude Fable 5.1 | $10 / $50 | 1M | ~66 | No | Máxima capacidad medida |
| Claude Opus 5 | $5 / $25 | 1M | ~61 | No | Reemplazo más cercano, mitad de precio en salida |
| Claude Sonnet 5 | $2 / $10 | 1M | ~53 | No | Valor en producción de alto volumen |
| Gemini 3.8 Flash | $0.75 / $3.75 | 1M | ~59 | No | Más barato alojado, trabajos por lotes |
| Kimi K3 | $3 / $15 | 1M | ~57 | Sí | Capacidad con pesos abiertos |
| Qwen 3.8 Max | $2 / $6 | 1M | ~58 | Parcial | Base abierta + fuerte preferencia humana |
| DeepSeek V4 Flash | ~$0.22-0.44 / $0.66-1.32 | 1M | ~50 | Sí (MIT) | Más barato por tarea, autoalojable |
| Grok 4.6 | $2 / $6 | 500K | ~54 | No | Rápido, flujos nativos de xAI |
Una palabra rápida sobre cómo leería esta tabla. El precio de lista y el costo por tarea no son lo mismo. Un modelo que quema el doble de tokens de salida para terminar un trabajo puede costar más que un modelo "más caro" que llega en una sola pasada. Así que usa la tabla para hacer una preselección y luego pasa tus prompts reales por dos o tres finalistas para medir la factura real. El mejor modelo de IA para tickets de soporte rara vez es el que tiene el número de benchmark más grande, y qué LLM gana suele depender de tus datos.

1. Claude Opus 5
Mejor para: equipos que quieren capacidad de nivel Astra sin la factura de Astra.
Claude Opus 5 es el intercambio uno a uno más natural en esta lista. Iguala la ventana de contexto de 1M de Astra, y Anthropic factura toda la ventana a tarifas estándar sin penalización de contexto largo, así que una solicitud de 900K tokens cuesta lo mismo por token que una de 9K. En el índice de Artificial Analysis está justo al lado de Astra (ambos alrededor de 61), y durante un tiempo ocupó el primer puesto en solitario.
La peculiaridad interesante es el dial de esfuerzo. Opus 5 activa el pensamiento por defecto y te deja subir el esfuerzo de razonamiento hasta max, que es donde vive gran parte de su calidad, pero también donde se va el costo. El consenso de la comunidad es que Opus 5 gasta aproximadamente el doble de tokens de salida que Opus 4.8 con el mismo esfuerzo, así que el costo por tarea subió aunque el precio de lista no cambió.

Aquí una opinión real de un desarrollador tras cambiar:
"Opus 5 matched Fable 5 on my agent tasks, and it was faster and cheaper to run."

- Ventajas: mitad del precio de salida de Astra, precios planos de 1M de contexto, razonamiento de primer nivel, su propio cupo de límite de tasa.
- Desventajas: el pensamiento está activado por defecto y no se puede desactivar por encima de esfuerzo
high, y el uso de tokens por tarea puede subir rápido. - Precios: $5 de entrada / $25 de salida por millón; modo rápido $10/$50; lote 50% de descuento; lecturas de caché $0.50.
Veredicto: si estás dejando Astra porque la relación precio-calidad te molestó, empieza aquí. Obtienes esencialmente el mismo nivel de inteligencia a la mitad del costo de salida. Vigila el dial de esfuerzo, porque un hábito de esfuerzo max puede borrar silenciosamente el ahorro.
2. Claude Fable 5.1
Mejor para: el modelo más capaz que puedes comprar al precio de Astra.
Si el problema de Astra es que cobra precio de buque insignia por un puntaje plano, Claude Fable 5.1 es la respuesta directa: cuesta exactamente los mismos $10/$50 y encabeza el índice de inteligencia con aproximadamente 65,7, varios puntos por delante de Astra. Se sitúa por encima de Opus 5 en la propia gama de Anthropic y lidera todos los evals que Anthropic publicó en el lanzamiento, incluyendo Terminal-Bench-Science, donde más que duplicó el puntaje anterior.
Dos detalles lo convierten en una compra genuinamente distinta a Astra. Primero, las lecturas de caché bajaron un 75% a $0.25 por millón, más barato por token que los $0.50 de Opus 5, lo que suma rápido en cargas de trabajo agénticas que releen un system prompt grande. Segundo, Fable 5.1 ahora estampa una marca de agua estadística en su salida para cumplir con la Ley de IA de la UE, algo que a algunos equipos les encanta por la trazabilidad y a otros les parece raro. Vale la pena saberlo antes de comprometerte.
- Ventajas: la inteligencia medida más alta de la lista al precio de Astra, lecturas de caché muy baratas, precios planos de 1M de contexto, prosa y programación sólidas.
- Desventajas: el mismo $50/M de salida que Astra (esta no es la opción barata), algunos rechazos falsos positivos reportados en código propio relacionado con seguridad, y la marca de agua en la salida no le gustará a todos.
- Precios: $10 de entrada / $50 de salida; lectura de caché $0.25; lote $5/$25; no está en un nivel gratuito.
Veredicto: si de todos modos ibas a pagar precios de Astra, Fable 5.1 te da más capacidad medida por la tarifa idéntica. Es la alternativa de "mismo dinero, más modelo".
3. Claude Sonnet 5
Mejor para: trabajo de producción de alto volumen donde el valor por tarea gana a la capacidad máxima.
No todo trabajo necesita un buque insignia. Claude Sonnet 5 es el caballo de batalla de la familia Claude 5 a $2/$10 por millón, una quinta parte del precio de salida de Astra, y Anthropic confirmó en agosto de 2026 que esta es la tarifa estándar permanente, no una promoción que va a caducar. Puntúa alrededor de 53 en el índice de inteligencia, más bajo que los buques insignia, pero suficiente para clasificación, enrutamiento, resumen y la larga cola de generación rutinaria.
La trampa a vigilar son los turnos por tarea. Más barato por token no siempre significa más barato por trabajo, porque un modelo más pequeño a veces necesita más idas y vueltas para llegar al mismo resultado. Aun así, en una tarea bien delimitada, Sonnet 5 es uno de los mejores modelos en valor por token que puedes apuntar al tráfico de producción.
- Ventajas: una fracción del precio de Astra, 1M de contexto a precio plano, rápido, genuinamente bueno en tareas cotidianas.
- Desventajas: no es un razonador de frontera, y puede quemar turnos extra en trabajo ambiguo.
- Precios: $2 de entrada / $10 de salida por millón; lectura de caché $0.20; lote 50% de descuento.
Veredicto: el modelo al que recurriría para el 80% del tráfico que no necesita un buque insignia. Combínalo con Opus 5 o Fable 5.1 para el difícil 20% restante y tendrás una estructura de costos que Astra no puede igualar.
4. Google Gemini 3.8 Flash
Mejor para: trabajos por lotes baratos y de alto rendimiento donde nadie espera la respuesta.
Gemini 3.8 Flash es el modelo alojado más barato aquí que todavía entra en la conversación de frontera, a $0.75 de entrada / $3.75 de salida hasta finales de 2026 (se duplica a $1.50/$7.50 el 1 de enero de 2027, así que presupuéstalo). Puntúa alrededor de 59 en el índice de inteligencia y tiene un nivel gratuito, algo que Astra no tiene.
Una advertencia honesta que la mayoría de las coberturas omiten: Artificial Analysis mide su tiempo hasta el primer token en 13,30 segundos frente a una mediana de clase de unos 3 segundos, aunque su rendimiento bruto se ubica entre los primeros modelos probados. Rendimiento no es responsividad. Eso lo hace excelente para pipelines de lotes nocturnos y lo descalifica para cualquier cosa que un humano esté esperando activamente, como una respuesta de chat en vivo. Google mismo incluso sugiere quedarse en el 3.7 Flash más antiguo para cargas de trabajo centradas en eficiencia, ya que 3.8 "trabaja más" y puede usar más tokens.
- Ventajas: la opción alojada más barata, nivel gratuito, entrada multimodal enorme (texto, imagen, audio, video, PDF), rendimiento muy alto.
- Desventajas: tiempo lento hasta el primer token, el precio se duplica en enero de 2027, y dos métricas de seguridad retrocedieron ligeramente respecto a 3.7.
- Precios: $0.75 / $3.75 por millón hasta el 31 de dic. de 2026, luego $1.50 / $7.50; lote y Flex 50% de descuento.
Veredicto: un modelo excelente para lotes y procesamiento offline a un precio que los buques insignia no pueden igualar. Solo no lo pongas frente a un cliente que está mirando un indicador de "escribiendo".
5. Kimi K3
Mejor para: equipos que quieren capacidad sólida con pesos abiertos que puedan autoalojar.
Kimi K3 es el buque insignia de Moonshot AI, un modelo de mezcla de expertos con 2,8 billones de parámetros y 104B activos, y sus pesos abiertos salieron a tiempo en la fecha prometida, algo que no todos los laboratorios logran. Puntúa alrededor de 57 en el índice de inteligencia, superando a buques insignia más antiguos como Opus 4.8, y tiene visión nativa (aunque solo acepta base64 o IDs de archivo, no URLs públicas de imágenes).
El precio es la sorpresa: a $3/$15 por millón está en la misma banda que Claude Sonnet, no la jugada de precio mínimo que la era K2 acostumbró a la gente a esperar. El razonamiento siempre está activado y no se puede apagar en ningún nivel de esfuerzo, así que es un control de latencia, no un nivel de costo. Si tu razón para querer K3 es autoalojarlo, los pesos abiertos son todo el punto; si vas a limitarte a usar la API alojada, la cuenta de valor es menos obvia frente a Sonnet 5.
- Ventajas: pesos genuinamente abiertos, benchmarks sólidos, visión nativa, 1M de contexto.
- Desventajas: el precio alojado es de nivel medio, no de presupuesto, el razonamiento no se puede desactivar, no acepta URLs públicas de imágenes.
- Precios: $3 de entrada / $0.30 de acierto de caché / $15 de salida por millón.
Veredicto: la mejor opción de esta lista si los pesos abiertos son un requisito indispensable y de verdad vas a ejecutarlos. Solo como API alojada, Sonnet 5 suele ganar en valor.
6. Qwen 3.8 Max
Mejor para: un todoterreno sólido con una base abierta permisiva y puntajes de preferencia humana entre los cinco primeros.
El Qwen 3.8 Max de Alibaba se lanzó de forma general en agosto de 2026, un MoE de 2,4T de parámetros con 95B activos, con precio de $2 de entrada / $6 de salida por millón. Puntúa alrededor de 58 en el índice de inteligencia, y en las clasificaciones de preferencia humana de LMArena es genuinamente fuerte, entre los cinco primeros en texto y los dos primeros en visión, así que el índice automatizado y los votos humanos a ciegas apuntan en direcciones ligeramente distintas. Cuando no coinciden, yo no confiaría solo en ninguno de los dos números y probaría.

En la cuestión de los pesos abiertos, es un "sí" parcial. El checkpoint pesado Qwen3.8-2.4T-A95B salió bajo una licencia Qwen restringida, mientras que un modelo permisivo Apache-2.0 de 27B es el que realmente puedes reutilizar libremente. El Max alojado tampoco es equivalente en funciones a la base abierta, ya que añade entrada de visión, un modo sin pensamiento y herramientas integradas.
- Ventajas: precio alojado bajo, rankings de primer nivel en preferencia humana, 1M de contexto, un modelo abierto más pequeño y permisivo.
- Desventajas: los pesos grandes están bajo licencia restringida, las versiones alojada y abierta difieren, y la residencia de datos está en China en la API de primera parte.
- Precios: $2 de entrada / $6 de salida por millón; lectura de caché implícita $0.25.
Veredicto: un todoterreno legítimamente fuerte y barato, especialmente si valoras la calidad de preferencia humana por encima de los puntajes de benchmark. Lee la licencia con cuidado antes de planear autoalojar el modelo grande.
7. DeepSeek V4 Flash
Mejor para: cargas de trabajo de alto volumen donde el costo por tarea lo es todo.
Si tu prioridad es gastar lo menos posible por token, nada aquí se acerca a DeepSeek V4 Flash. En la tarjeta de precios en vivo ronda los $0.22-$0.44 por millón de entrada y $0.66-$1.32 de salida, dependiendo de si es hora pico o valle. Como la ventana pico de DeepSeek (01:00-04:00 y 06:00-10:00 UTC) coincide con el horario laboral chino, una cola de EE. UU. o de la UE se factura mayormente a la tarifa más barata de valle, una peculiaridad real (aunque frágil) que vale la pena conocer.

Dos cosas para mantener la honestidad. Primero, "barato" y "bueno" son ejecuciones distintas de los mismos pesos: los propios números de DeepSeek muestran una gran brecha entre la calidad sin pensamiento y la de máximo esfuerzo, y los tokens de razonamiento se facturan a la tarifa de salida, así que la configuración económica no es la que encabeza las tablas. Segundo, en cuanto a datos de clientes, los términos de la API de pago guardan silencio sobre el uso para entrenamiento en lugar de excluirlo explícitamente, no hay una opción de retención cero publicada, y los datos residen en la RPC bajo ley china. Así que es un motor de costos fantástico para trabajo de alto volumen no sensible, y no un reemplazo directo para datos regulados de clientes.
- Ventajas: con diferencia el más barato, pesos abiertos con licencia MIT (~167GB), 1M de contexto, 384K de salida máxima.
- Desventajas: la configuración económica se queda atrás en calidad, uso de tokens verboso, solo texto (sin entrada de imagen documentada), y términos de manejo de datos no aptos para datos sensibles.
- Precios: valle / pico, por millón: entrada ~$0.22 / $0.44, salida ~$0.66 / $1.32; entrada por acierto de caché una fracción de centavo.
Veredicto: el campeón de valor por amplio margen. Úsalo para clasificación, extracción y resumen masivos con datos no sensibles. Mantén el PII de clientes fuera de la API de primera parte hasta que los términos y la residencia se alineen con tus requisitos.
8. Grok 4.6
Mejor para: equipos ya en el ecosistema xAI que quieren respuestas rápidas y una ventana de contexto grande.
Grok 4.6 cierra la lista a $2 de entrada / $6 de salida por millón para prompts menores a 200K tokens, con una ventana de contexto de 500K. Es rápido, y si ya estás construyendo sobre xAI o quieres búsqueda en vivo de X/web integrada, es una elección sensata. Una cosa que la tarjeta de precios deja clara: las solicitudes de contexto largo (prompts en o por encima de 200K) recalculan el precio de toda la solicitud a $4/$12, no solo el excedente, así que un prompt grande cuesta más de lo que sugiere la tarifa titular.
Grok también mide cosas más allá de los tokens: la búsqueda web, la búsqueda en X y la ejecución de código cuestan $5 por 1.000 llamadas, y la búsqueda de archivos adjuntos cuesta $10 por 1.000. Los precios efectivos medidos por OpenRouter son la lectura más aguda del mundo real aquí, mostrando un promedio de entrada bien por debajo del $2 de lista gracias a una tasa de acierto de caché de ~90%, con la salida ligeramente por encima de la lista porque parte del tráfico cae en el nivel de contexto largo. Si el área de compras te obliga a un marketplace en la nube, ten en cuenta que Azure y Bedrock solo llegan a generaciones más antiguas de Grok, así que no puedes conseguir 4.6 ahí.
- Ventajas: rápido, 500K de contexto, búsqueda en vivo nativa, precio efectivo a menudo por debajo de la lista gracias a buen caché.
- Desventajas: las solicitudes de contexto largo recalculan todo el prompt, contadores extra por llamada para búsqueda y herramientas, sin descuento por lote en 4.6.
- Precios: $2 / $6 por millón (≤200K); $4 / $12 para prompts ≥200K; los contadores de herramientas/búsqueda son adicionales.
Veredicto: un modelo sólido y rápido con una ventaja real si quieres búsqueda integrada o ya estás en el mundo de xAI. El recálculo de precios en contexto largo y los contadores por llamada significan que deberías modelar tu uso real antes de asumir que es la opción barata.
La parte que todo comparativo de modelos pasa por alto: un modelo no es un compañero de equipo
Esto es lo que me hubiera gustado que alguien me dijera antes de pasar una semana haciendo benchmarking. Si estás eligiendo un modelo para responder tickets de soporte, escribir publicaciones de blog o ejecutar cualquier flujo de trabajo real de negocio, el modelo es solo el motor. Es inteligencia bruta sin idea de cuál es tu política de reembolsos, qué vista de Zendesk debe mirar, o cuándo debe detenerse y preguntarle a un humano.
Todos los modelos de esta lista, Astra incluido, tienen la misma brecha. Los puntajes de conocimiento de Artificial Analysis no superan el 50 sobre 100, que es una forma elegante de decir que ningún modelo aquí conoce tu negocio. Para convertir un modelo en algo que realmente haga un trabajo, tienes que envolverlo con tu centro de ayuda y tickets pasados, conectarlo a tus herramientas, y ponerle barreras de seguridad, pruebas y aprobaciones alrededor. Ese es el trabajo detrás de cualquier IA para atención al cliente real, y es el mismo trabajo sin importar qué modelo gane tu benchmark.

Aquí es también donde la conversación de precios da un giro. Pagar $50 por millón de tokens de salida duele más cuando lo gastas en el 80% rutinario de tickets que cualquier modelo de nivel medio podría manejar. La estructura más inteligente es dejar que otra cosa decida cuándo una pregunta difícil realmente necesita un buque insignia, y pagar por el resultado en lugar de por los tokens. Esa es la diferencia entre alquilar un motor y contratar a un compañero de equipo de IA, y también cambia el costo frente a un agente humano.
Prueba eesel
La razón por la que sigo volviendo al planteamiento de "motor vs. compañero de equipo" es que es lo que construimos. eesel es una plataforma de compañeros de equipo de IA: en lugar de darte un modelo en bruto y una clave de API, contratas a un compañero de equipo listo para trabajar en un puesto específico, como el compañero de helpdesk de IA que se une a tu cola de soporte o el redactor de blog de IA. Cada uno llega ya sabiendo cómo usar el modelo, tus integraciones y el contexto de tu empresa, así que no eres tú quien está pegando GPT-6 Astra a Zendesk a las 2 de la mañana.

Dos cosas importan para cualquiera que compare costos de modelos. Primero, eesel factura por ticket a $0.40, no por token, así que estás aislado de exactamente la guerra de precios de la que trata esta publicación; sea que el mejor modelo sea Astra, Opus 5 o algo más barato el próximo mes, tu costo por conversación resuelta no da tumbos. Segundo, como Astra es fundamentalmente una historia de agentes y API, vale la pena saber que eesel expone al mismo compañero de equipo a través de una verdadera interfaz de línea de comandos y servidor MCP: puedes manejarlo desde una terminal, programarlo en CI, o conectarlo por MCP a un agente de programación como Claude Code y operarlo sin interfaz. La documentación literalmente dice que todo lo que puedes hacer en el panel, puedes hacerlo desde la terminal.
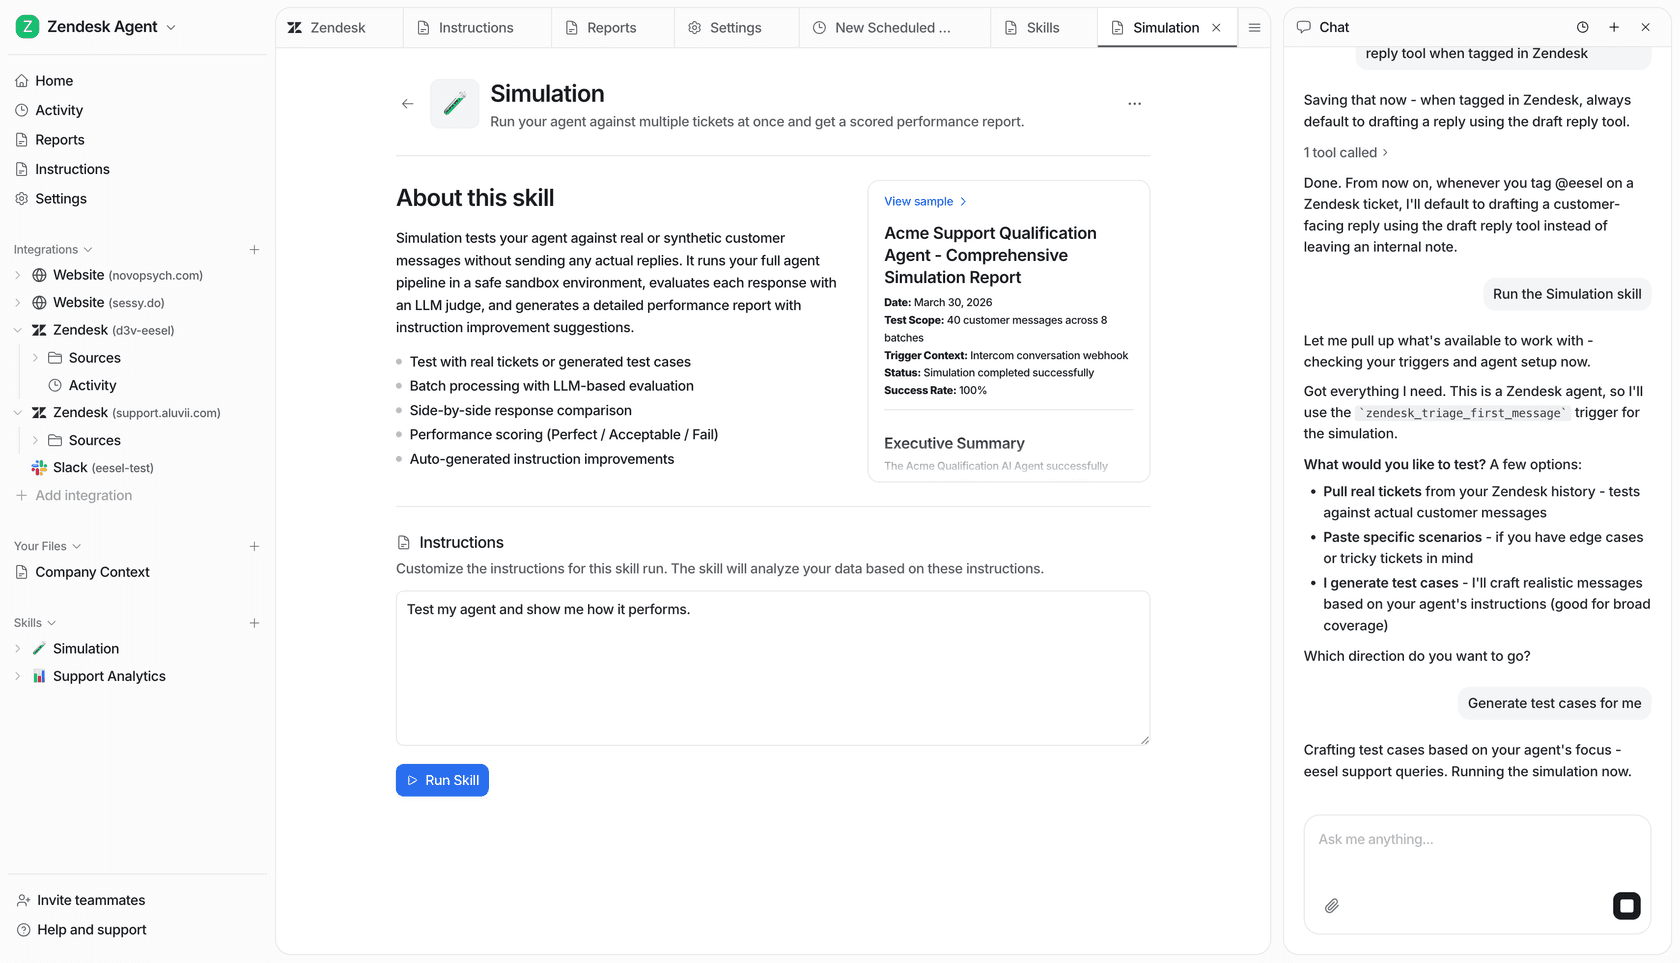
Antes de salir a producción, eesel puede simular al compañero de equipo contra tus tickets pasados y calificar sus respuestas frente a lo que tu equipo realmente envió, así encuentras los huecos en una prueba segura en vez de frente a un cliente. Puedes empezar con $50 de uso gratis y sin tarjeta de crédito. Si estás decidiendo sobre qué modelo construir tu soporte, esa es la capa que hace que la elección del modelo importe mucho menos. Prueba eesel gratis.
Preguntas frecuentes
¿Cuál es la mejor alternativa a GPT-6 Astra?
¿Cuánto cuesta GPT-6 Astra comparado con las alternativas?
¿Hay una alternativa más barata a GPT-6 Astra para atención al cliente?
¿Qué alternativas a GPT-6 Astra tienen pesos abiertos?
¿Qué pasa si simplemente espero a que baje el precio en vez de cambiar?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.