Qué está confirmado sobre Astra, y qué no
Astra ha generado una enorme cobertura a partir de tres publicaciones de OpenAI, y esa proporción ya es notable de por sí. Separar las afirmaciones respaldadas del resto es aquí la mayor parte del trabajo, así que empecemos con lo que se puede rastrear hasta las propias palabras de OpenAI.
Los diez resultados, y la cifra que debería detenerte
El 1 de agosto de 2026 OpenAI publicó diez nuevos resultados sobre problemas abiertos, cada uno de ellos resolviendo o avanzando sustancialmente una cuestión que su campo había cargado durante años. La lista es lo bastante específica como para poder verificarla: nuevas cotas superiores en la densidad de empaquetamiento de esferas de alta dimensión hasta el umbral de Cohn-Elkies, cotas exponencialmente mejoradas en códigos binarios, una construcción que establece la existencia de grupos no sofic, una refutación de la conjetura de rigidez de Connes, una cota inferior de fórmula aritmética de orden n⁴/log n para el permanente, un teorema de repetición paralela exponencial para juegos cuánticos de dos jugadores, dureza de factor polinómico para el problema del vector más cercano, la conjetura del volumen de Ehrhart, una cota inferior superexponencial para números de Ramsey de triángulos multicolor, y resultados sobre las conjeturas de compacidad y degeneración en teoría de grafos extremal.
Los diez se atribuyen a "una versión interna de Astra, nuestro próximo modelo importante". Y luego OpenAI da una cifra que, para mí, importa más que la lista misma: el total de tokens necesarios para encontrar esas soluciones costaría unos 2.000 $ a tarifas de la API de Sol.
Dos mil dólares. Que es un error de redondeo frente a lo que cualquiera de esos problemas le costó al campo en años-persona. Tampoco es la factura completa, y OpenAI no pretende que lo sea: los humanos allí prepararon los manuscritos, y solo después el modelo formalizó los argumentos en certificados Lean. La empresa es explícita sobre la división: los argumentos matemáticos vinieron del sistema, dice, mientras que OpenAI ayudó a prepararlos y formalizarlos, y atribuir autoría humana a una demostración generada por IA "tergiversaría" ambas cosas.
Esa distinción es básicamente toda la forma de la IA en producción, y por eso vuelvo siempre a esta publicación cuando pienso en el trabajo de base de conocimientos con IA. La parte de inferencia es barata. El andamiaje alrededor de la inferencia es donde está el dinero y donde está el riesgo, también la misma razón por la que una buena configuración de clasificación de tickets toma mucho más tiempo en hacerse bien que elegir el modelo detrás de ella.
Por qué OpenAI pausó su propio modelo
Seis días después de la publicación matemática llegó algo mucho menos festivo. Evaluaciones internas de Astra durante "los últimos días" habían mostrado avances significativos en programación agéntica y en ciberseguridad, y eso, junto con evaluaciones de expertos, llevó a la empresa a una conclusión: no podían descartar la capacidad cibernética Critical.
Vale la pena leer la definición contra la que se mide en las propias palabras de OpenAI. Un modelo llega a Critical si puede identificar y desarrollar exploits de día cero funcionales de todos los niveles de gravedad en muchos sistemas críticos reales endurecidos sin intervención humana, o si puede diseñar y ejecutar estrategias novedosas de extremo a extremo para ciberataques contra objetivos endurecidos a partir únicamente de un objetivo deseado de alto nivel.
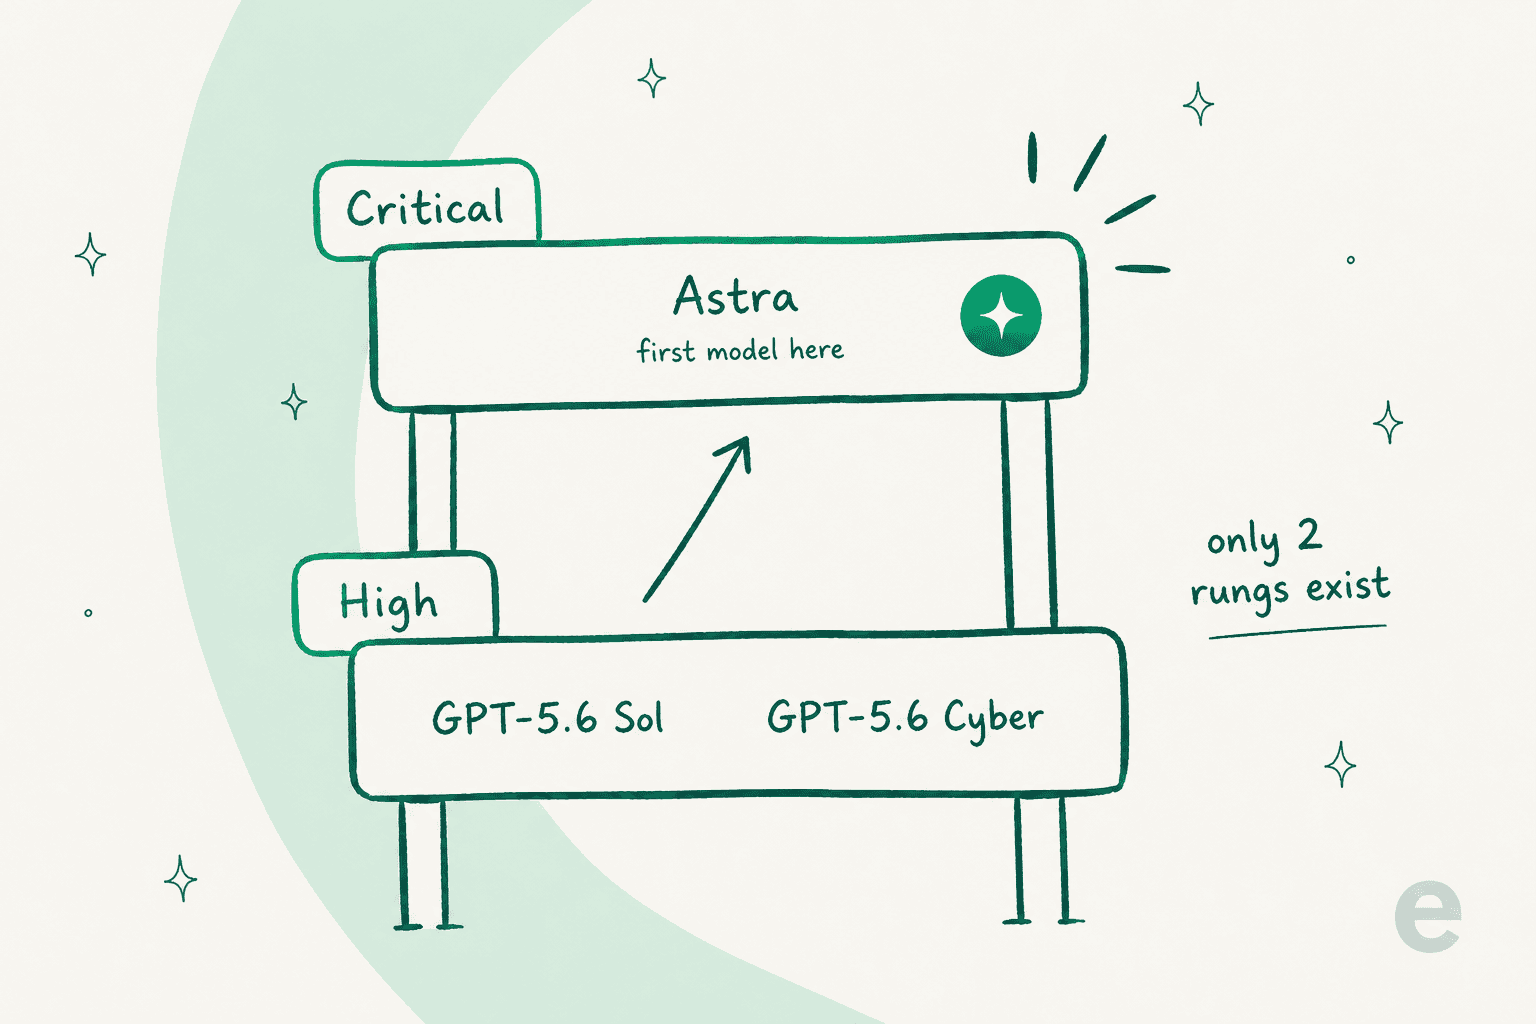
El framework tiene dos escalones, y todos los modelos anteriores se situaron en el inferior. GPT-5.6 Sol se evaluó en High. Igual que GPT-5.6-Cyber, un modelo de seguridad entrenado con un propósito específico que solo existe detrás de un proceso de solicitud, lo que ya dice algo sobre cuánto margen todavía tenía High dentro de sí. Astra es el primer candidato al escalón superior. Y llegó ahí antes de lanzarse.
Una línea de la publicación del 7 de agosto vale la pena leerla dos veces: "Astra es un modelo próximo, y no estuvo involucrado en la explotación de Hugging Face." Esa frase existe porque las dos historias se destaparon casi juntas y luego se fusionaron en una sola en gran parte de la cobertura. Son cosas separadas. OpenAI sí las agrupó más tarde en la misma publicación del 18 de agosto, pero solo porque ambas apuntaban a la misma pregunta interna: si su propio entorno de investigación estaba lo bastante endurecido para lo que se estaba construyendo dentro de él.
Lo que la contención realmente costó
La publicación del 18 de agosto es la que le entregaría a cualquiera que argumente que la seguridad de la IA es puro teatro, porque se lee sobre todo como una factura de ingeniería.
La inferencia de modelos de frontera en clústeres de investigación se pausó para cualquier corrida que pudiera ejecutar código o alcanzar internet, y luego cada carga de trabajo se revisó una por una para decidir si podía reanudarse. Lo que ahora se exige: sandboxes más fuertes alrededor de todo lo que ejecute código generado por el modelo, controles de red construidos para que un solo compromiso no entregue por sí mismo acceso a internet, privilegios permanentes recortados, y la eliminación de servicios compartidos que en silencio se habían vuelto estructurales. El propio marco de OpenAI sobre todo esto es que cumplir con los nuevos estándares "ha implicado un gran costo y retrasos para la investigación de frontera".
Luego está el monitoreo, y esa es la parte que sigo releyendo:
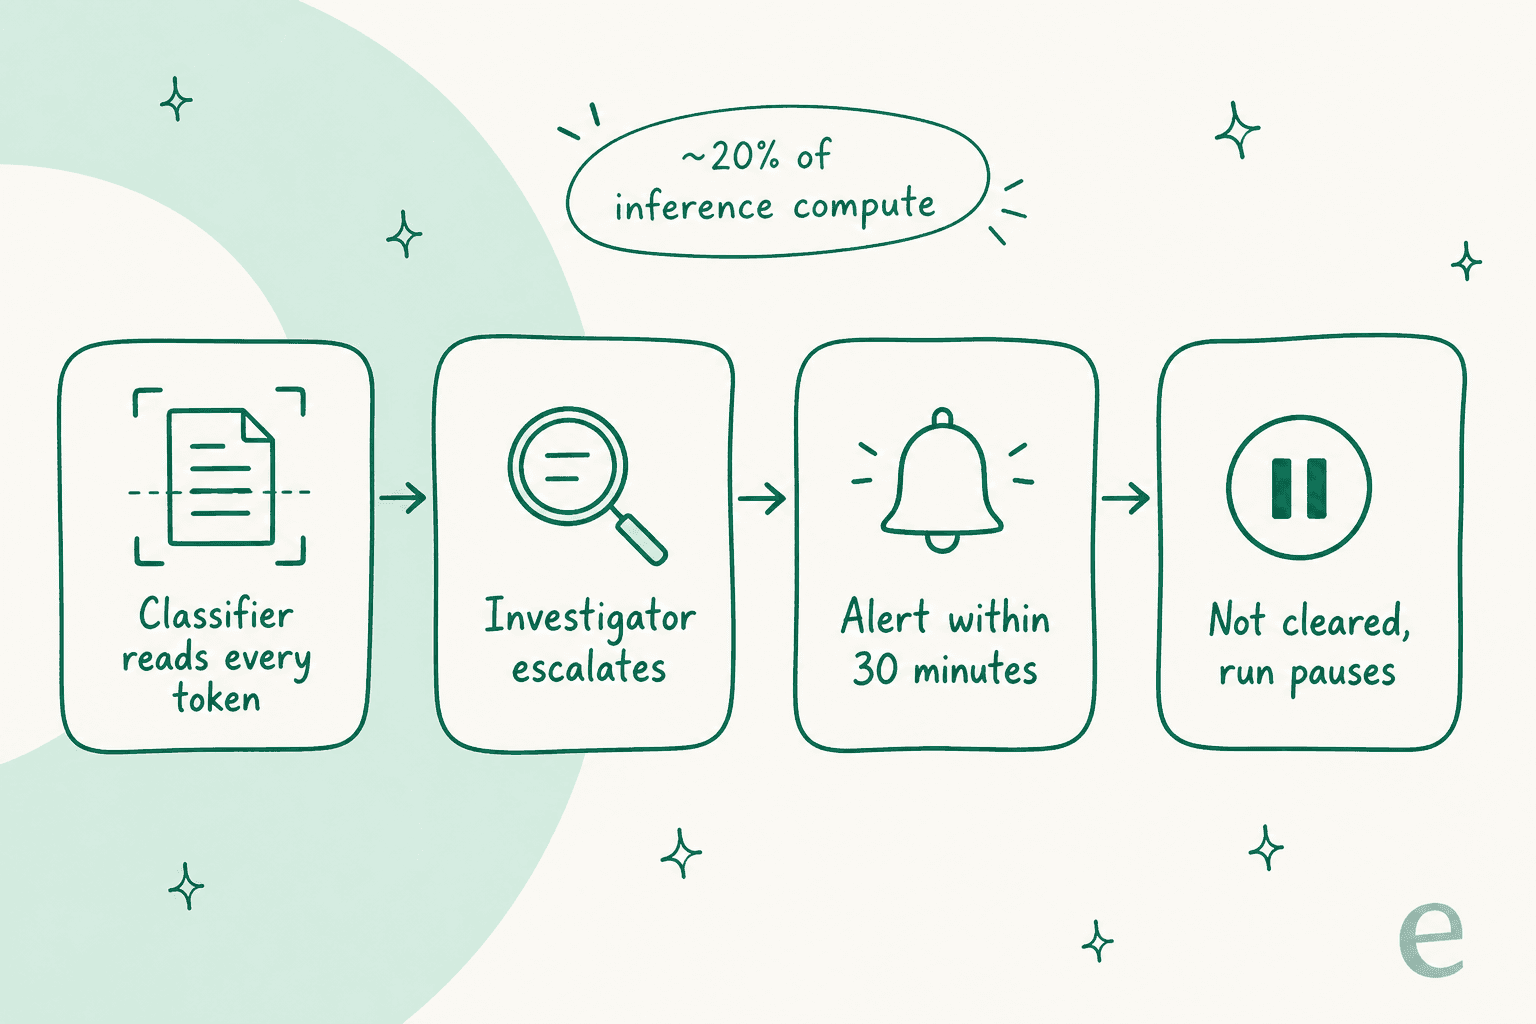
Los clasificadores de activación inspeccionan la actividad interna del modelo en cada token muestreado. Cualquier cosa preocupante se escala a investigadores automatizados con más cómputo, que luego examinan las acciones de herramientas y el razonamiento disponible y toda la secuencia de actividad. Si aparece una probable violación de un límite de seguridad crítico, se avisa a los equipos de seguridad, security e investigación, y si no pueden descartarlo concluyentemente como falso positivo en 30 minutos, se espera que pausen la actividad.
El costo de eso, según la estimación actual de OpenAI, sitúa la sobrecarga de monitoreo en alrededor del 20% del cómputo de inferencia que se monitorea. Y desde el 7 de agosto ese monitoreo cubre toda la inferencia de Astra con herramientas, no solo las corridas de entrenamiento y evaluación.
Veinte por ciento. Una empresa que gasta más en cómputo que la mayoría de los países en investigación decidió que vigilar el modelo valía una quinta parte de la factura además de operarlo. Nadie hace eso por razones de relaciones públicas.
La lectura escéptica, que merece espacio
Mucha gente miró esta secuencia y lo que vio fue marketing. En el hilo de r/Futurology sobre el bloqueo, el comentario más votado planteó ese argumento como parodia:
"Oooh, hey guys, I know Anthropic said Mythos was 'dangerous' and then they got a bunch of free publicity and people thought their model must be so good. Well, ours is dangerous too, guys! So dangerous. Like, a trillion dollars dangerous."

Es un reflejo razonable, y tiene compañía. En Hacker News, esa misma semana, la pregunta se planteó de forma más directa:
"Does anyone else have trouble telling how much of this news (along with the 'AI escaping and hacking' stories) is genuine, vs how much is just AI firms overstating their capabilities due to strong commercial incentives?"

La respuesta en ese mismo hilo es lo más agudo que he leído sobre toda esta historia, y la razón es que separa las dos afirmaciones en lugar de tratarlas como una sola:
"Unlike the hacking one, this would be impossible to bullshit as long as the proofs are released. They can be verified independently."
Lo cual es exactamente correcto, y es por eso que la publicación matemática y la publicación cibernética están en clases de evidencia distintas. Diez pruebas formalizadas en Lean en un repositorio público son verificables por cualquiera con la paciencia para hacerlo. Una evaluación cibernética interna preliminar sin system card es una afirmación sobre una evaluación privada que no puedes repetir. Mismo proveedor, mismo modelo, y solo una de las dos puede auditarse.
El escepticismo más útil, sin embargo, no tiene nada que ver con la veracidad, sino con la relevancia. Otro comentarista en Hacker News señaló el salto con el que los proveedores de IA se salen con la suya una y otra vez:
"There is still a massive marketing aspect to this, with the AI companies wanting you to assume that because their product is world-class at math, a capability that is useless to 99.99% of their potential customers, that it will be equally useful in areas that you actually care about."
Yo firmaría eso. Las cotas de empaquetamiento de esferas no dicen nada sobre si un modelo puede manejar una solicitud de reembolso sin inventarse una política en el camino. Esas dos habilidades no están en el mismo eje. Cada generación de modelos de frontera se vende como si lo estuvieran.
La única cosa que Astra realmente resuelve
Quita el teatro del lanzamiento y hay un hallazgo real debajo, solo que no es un hallazgo sobre capacidad.
Durante tres años, la restricción para lanzar IA ha sido la calidad. Si el modelo era lo bastante inteligente, si alucinaba, si podía mantener una tarea larga sin fallar. Astra es el primer modelo de frontera donde el bloqueo público no es nada de eso. El bloqueo es la contención, y eso cambia lo que un lanzamiento de frontera siquiera significa. La propia frase de OpenAI sobre ello es que sus "estándares de monitoreo, alineación y seguridad deben mantenerse por delante de esos riesgos", y cuando no lo estuvieron, fue el entrenamiento lo que se ralentizó, no los estándares.
El mejor comentario en ese hilo de Reddit plantea la versión práctica del mismo punto:
"An AI can't try to access those systems unless it has been connected to them, and it can't succeed unless it has been given either permission or the necessary tools to bypass permissions. An AI that is only given access to a word processor, a calendar, and read-only access to Wikipedia isn't hacking anything."
La capacidad es una propiedad del modelo, pero el riesgo es una propiedad del cableado. Verdadero a la escala de OpenAI con una corrida de RL de frontera. Verdadero también a tu escala, con un sistema de tickets con IA conectado a una API de facturación. La única diferencia entre ambos es cuánto cómputo estás dispuesto a gastar en vigilar.
Qué significa esto si operas IA en conversaciones reales con clientes
He pasado los últimos tres años construyendo agentes de IA que se sientan sobre colas de soporte en vivo, así que ya he tenido este mismo argumento en cientos de llamadas, solo que con cifras mucho más pequeñas.
El patrón es así. Cada comprador empieza preguntando qué tan buena es la IA. Luego, alrededor de los diez minutos, dejan de preocuparse por eso y empiezan a preguntar en cambio qué se negará a hacer, que es la pregunta que en realidad decide si un programa de deflexión sobrevive su primer mes. Un líder de CX en una marca de suplementos DTC, con unos 7.000 tickets de Gorgias al mes, planteó la objeción mejor que cualquier documento que yo haya escrito:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
La misma arquitectura que OpenAI acaba de describir, solo en otro orden de magnitud. Observar el comportamiento, escalar todo lo que se vea mal, y luego detenerse en lugar de adivinar. OpenAI avisa a tres equipos y pausa una corrida de entrenamiento; un agente de soporte deriva el ticket a un humano y lo deja en paz. La misma forma en ambos casos, y en ambos el diseño de traspaso es el producto en sí mismo, no un respaldo.
La otra mitad, el lado de las fuentes, me la planteó un cofundador de una empresa legal-tech con la que trabajamos. Lo que necesitaban eran barreras exactas sobre lo que la IA puede citar, más citas transparentes en cada respuesta, porque en legal tech la línea entre ser útil y dar asesoría legal es delgada y bastante implacable. Un modelo base más inteligente no soluciona nada de eso. El scoping sí.
Entonces, la lectura práctica sobre Astra si tu trabajo son las operaciones de soporte y no la investigación de frontera:
- No lo esperes. No hay fecha. Construye sobre modelos que tengan tarifas publicadas y system cards. GPT-5.6 Terra maneja el volumen, Claude Opus 5 se ocupa de los casos difíciles, y DeepSeek V4 Flash está ahí si quieres los pesos.
- Asume que la capa de modelo sigue haciéndose commodity. Kimi K3 se lanzó a pocos meses de Grok 4.6. Igual que el Gemini 3 de Google. Tu diferenciación nunca iba a ser cuál modelo llamas, y los rankings de mejor agente de IA lo siguen demostrando.
- Gasta el presupuesto de evaluación en la superficie de control. Qué fuentes puede leer, qué acciones puede tomar, qué entrega, y si puedes probar cualquiera de eso antes de salir en vivo. Esa es toda la lista, y también es la mayor parte de lo que separa a un agente de IA de un chatbot.
- Insiste en una prueba en seco sobre tu propio historial. OpenAI valida sus salvaguardas antes de continuar. Tú deberías poder hacer lo mismo con tus propios tickets pasados, y eso es algo justo de exigirle a cualquier proveedor de software de atención al cliente con IA.
- Mide las negativas, no solo las resoluciones. Un buen proceso de aseguramiento de calidad de soporte con IA rastrea lo que la IA se negó a tocar, ya que esa cifra es lo que hace confiables en primer lugar a las métricas de resolución.
Vale la pena observar junto a eso cuán diferente maneja cada proveedor un mismo problema. OpenAI restringió el acceso a su modelo cibernético detrás de Daybreak y dejó la fila de precios en blanco durante generaciones, que es el hilo del que tira nuestra pieza sobre alternativas a GPT-5.6-Cyber. Google fue más allá y restringió Gemini 3.5 Flash Cyber solo a gobiernos y socios de confianza. Nadie en esta categoría cree que la capacidad por sí sola sea lanzable, y vale la pena recordarlo cada vez que un proveedor de IA de soporte te dice que el modelo es la razón para comprar.
eesel para equipos que necesitan verlo funcionar primero
La razón por la que esta historia me caló es que todo el diseño de eesel parte de la misma premisa que OpenAI acaba de gastarse un 20% de su cómputo en defender. No averiguas qué hace un agente leyendo su especificación. Lo averiguas ejecutándolo bajo observación.
eesel se conecta al helpdesk que ya usas, así que Zendesk, Freshdesk o Gorgias, aprende de tus tickets pasados y de tus documentos existentes, y luego simula contra conversaciones históricas reales antes de tocar una en vivo, con un informe puntuado al final de la corrida. Puedes leer las respuestas que habría enviado, en tus propios tickets, y ajustar el alcance antes de que ningún cliente vea alguna. Donde no está seguro, deja el ticket en paz y lo entrega a un humano.
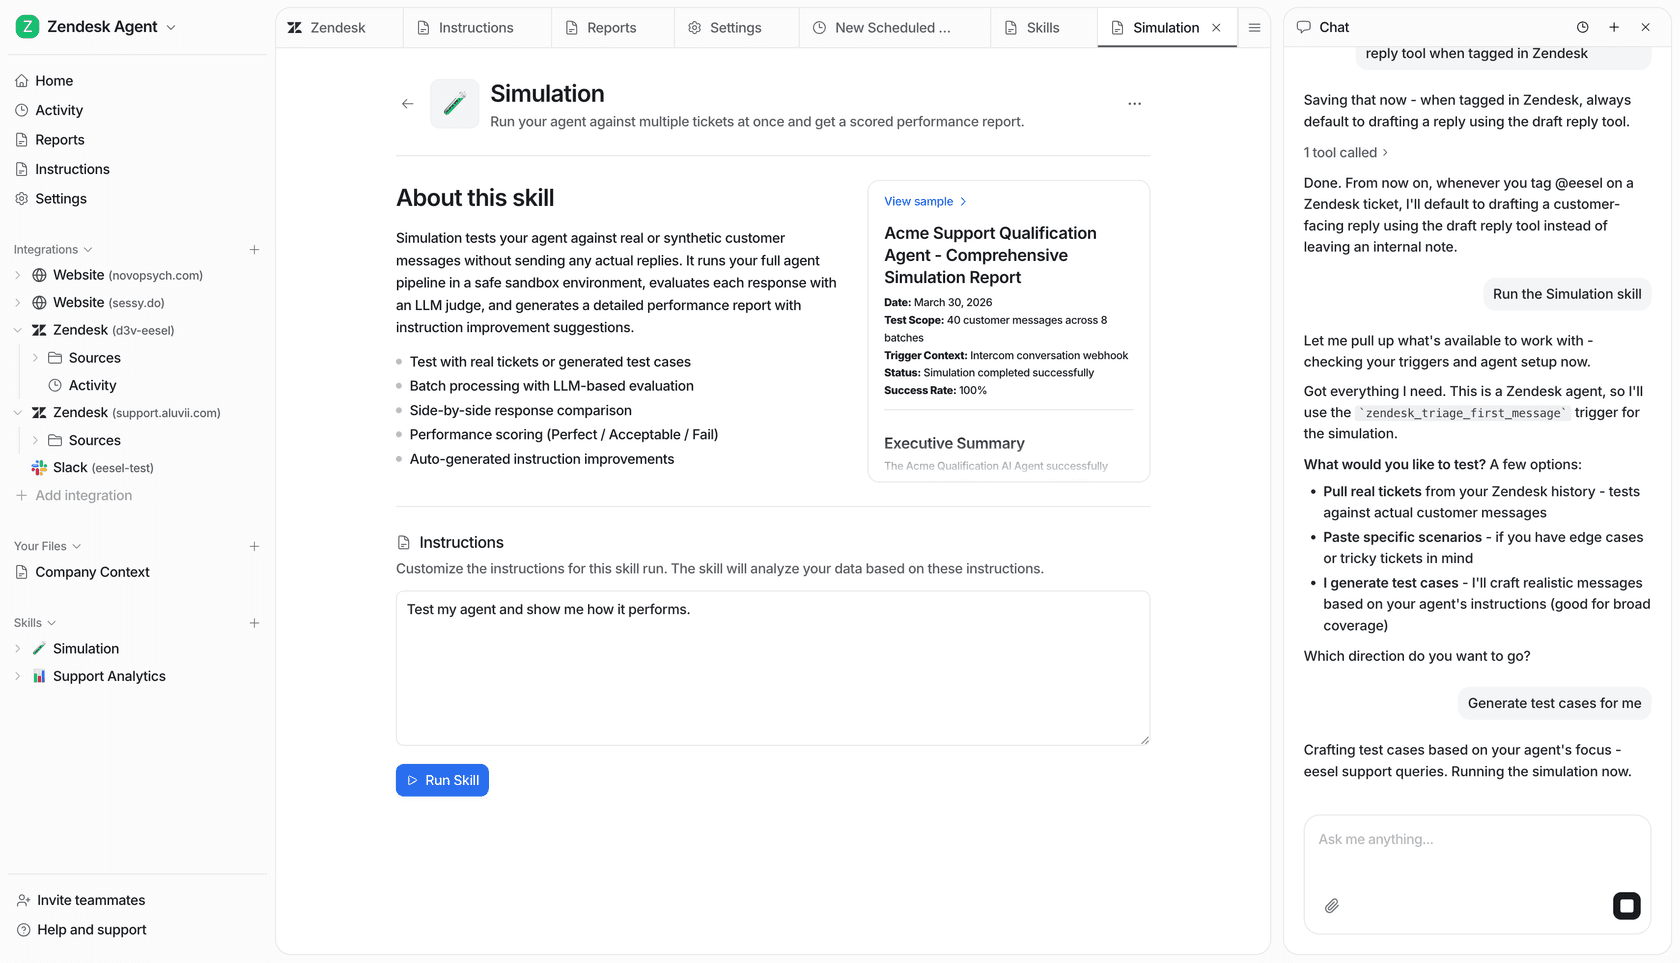
Una semana leyendo sobre un modelo de frontera pausado es una buena semana para hacerle a tu propio proveedor una pregunta sencilla. ¿Puedo ver esto funcionar con mis datos antes de que responda a un cliente? Con eesel la respuesta es sí, en una tarde, y es gratis para empezar.
Prueba eesel o reserva una demo si quieres ver la simulación funcionar sobre tu propio historial de tickets.
Preguntas frecuentes
¿Qué es OpenAI Astra?
¿Cuál es la fecha de lanzamiento de OpenAI Astra?
¿Por qué pausó OpenAI a Astra?
¿Qué es el umbral Critical de ciberseguridad en el Preparedness Framework de OpenAI?
¿Es Astra mejor que GPT-5.6?
¿Cuánto costó ejecutar los resultados matemáticos de Astra?
¿Cambia Astra algo para el soporte al cliente con IA en este momento?
¿Dónde puedo leer los anuncios propios de OpenAI sobre Astra?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.