Resumen rápido
Gemini 3.8 Flash TTS cuesta 0,50 $ por millón de tokens de entrada de texto y 9,00 $ por millón de tokens de salida de audio en el nivel estándar de pago, hasta el 31 de diciembre de 2026. El audio se factura a 25 tokens por segundo, así que una hora completa de voz generada sale por unos 0,81 $. También hay un nivel realmente gratuito en Google AI Studio.
Dos cosas para tener presentes. Primero, ambas tarifas se duplican el 1 de enero de 2027, así que cualquier presupuesto que construyas con las cifras de hoy hay que duplicarlo para el año que viene. Segundo, a unos 0,81 $ la hora, este es uno de los modelos de voz expresiva más baratos que se pueden comprar, muy por debajo de ElevenLabs y de los niveles generativos premium de Amazon y Deepgram.
La trampa es la que aplica a cualquier modelo en bruto: audio barato no es lo mismo que un producto funcional. Un endpoint de TTS habla; no conoce tu base de conocimiento, no llama a tus herramientas ni se prueba antes contra conversaciones reales. Si vas a poner un modelo de voz de cara a la atención al cliente, esa brecha lo es todo, y es justo lo que existe para cerrar un agente de helpdesk con IA.
Qué es realmente Gemini 3.8 Flash TTS
Gemini 3.8 Flash TTS (gemini-3.8-flash-tts) es el actual modelo de texto a voz de Google, y a diferencia de muchos de los modelos de audio que circulan por ahí, es estable y no una vista previa. El id no lleva sufijo -preview, y Google lo señala como el reemplazo recomendado del antiguo gemini-3.1-flash-tts-preview. Recibe texto y produce audio, nada más, que es exactamente lo que se espera de un modelo de voz dedicado.
La ficha técnica es generosa. Tienes 30 voces de estudio predefinidas (Zephyr, Puck, Kore, Fenrir y compañía), cada una con un descriptor como Bright o Firm, más una Extended Voice Library con cientos más que puedes obtener con client.voices.list(). Habla 130 idiomas con detección automática de entrada, y puedes dirigir estilo, acento, ritmo y tono con prompts en lenguaje natural, o insertar etiquetas en línea como <laugh> y <sigh> para eventos vocales puntuales. También incluye diseño de voz (construir una persona a partir de una descripción de texto) y clonado de voz a partir de un clip de referencia.
El detalle técnico que muerde en producción: el multi-hablante está limitado a dos hablantes por solicitud. Un podcast de tres personas o una escena grupal significa sintetizar cada turno por separado y unir el audio tú mismo. La salida por defecto es WAV mono a 24 kHz, con mulaw y alaw disponibles para telefonía. Esto convive con el modelo solo de texto Gemini 3.8 Flash, y ambos se facturan de forma completamente distinta, que es donde empieza la mayor parte de la confusión.
Precios de Gemini 3.8 Flash TTS: la tabla completa
Aquí está cada nivel, en USD por millón de tokens, a las tarifas promocionales de 2026. La tarifa de 2027 va entre paréntesis porque, como veremos, todo se duplica.
| Nivel | Entrada de texto / 1M | Salida de audio / 1M | Notas |
|---|---|---|---|
| Estándar | 0,50 $ (1,00 $) | 9,00 $ (18,00 $) | La tarifa por defecto |
| Batch | 0,25 $ (0,50 $) | 4,50 $ (9,00 $) | ~50 % de descuento, trabajos asíncronos |
| Flex | 0,25 $ (0,50 $) | 4,50 $ (9,00 $) | Misma tarifa, caché más barato |
| Priority | 0,90 $ (1,80 $) | 16,20 $ (32,40 $) | ~1,8x, sensible a la latencia |
| Free | Gratis | Gratis | Estándar/priority vía AI Studio |
Todo esto sale directamente de la página de precios de la API de Gemini de Google. El caché de contexto es compatible y parte de 0,125 $ por millón de tokens de caché de entrada en el nivel estándar, más una tarifa de almacenamiento de 0,50 $ por millón por hora. La cifra de salida de audio es la que importa, porque es la que escala con cuánta voz generas. La entrada de texto es casi un redondeo en comparación.
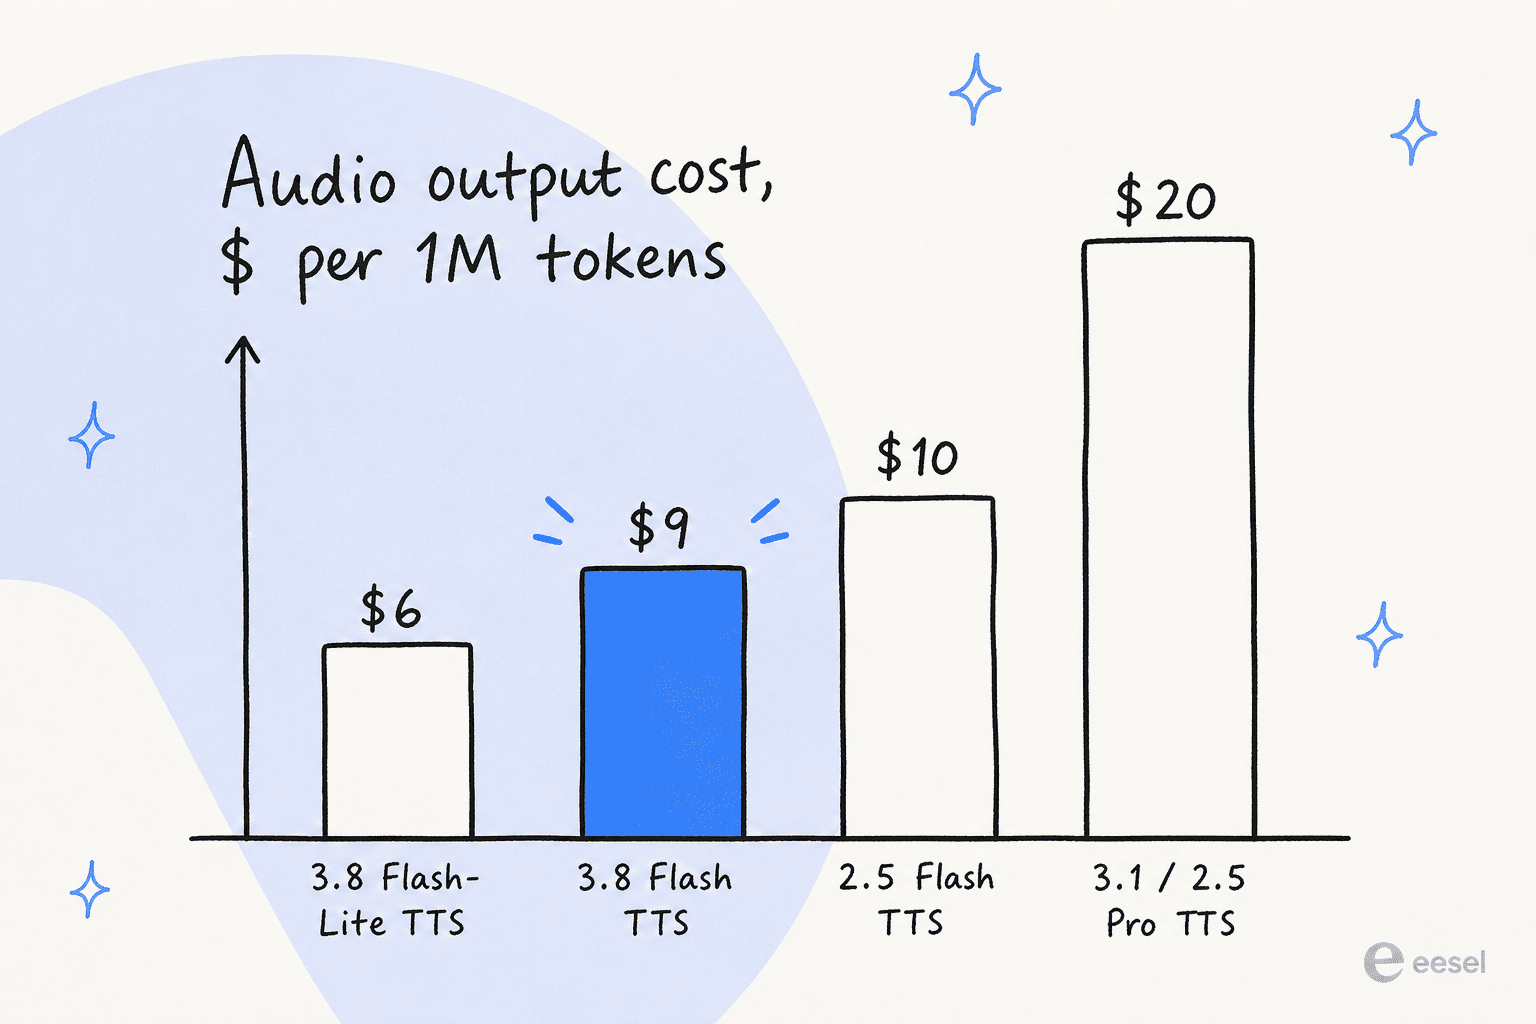
Lo interesante es dónde se sitúan esos 9,00 $ dentro de la propia gama de Google. Es más barato que el Gemini 2.5 Flash TTS al que sucede (10 $ de salida de audio), y menos de la mitad de precio que los modelos preview 2.5 Pro y 3.1 Flash TTS (20 $ de salida de audio). También hay un hermano más barato, Flash-Lite TTS, a 6 $ de salida de audio si puedes vivir con 101 idiomas en lugar de 130.
Lo que eso te cuesta en realidad
El precio por token es difícil de sentir, así que convirtámoslo en dinero real. El audio se factura a 25 tokens por segundo, lo que da 1.500 tokens por minuto y 90.000 tokens por hora. A la tarifa estándar de 2026 de 9,00 $ por millón, una hora de voz generada cuesta unos 0,81 $. Si sumas el texto que introdujiste (una hora completa de narración son solo unos 12.000 tokens de entrada), añade bien poco más de un centavo.
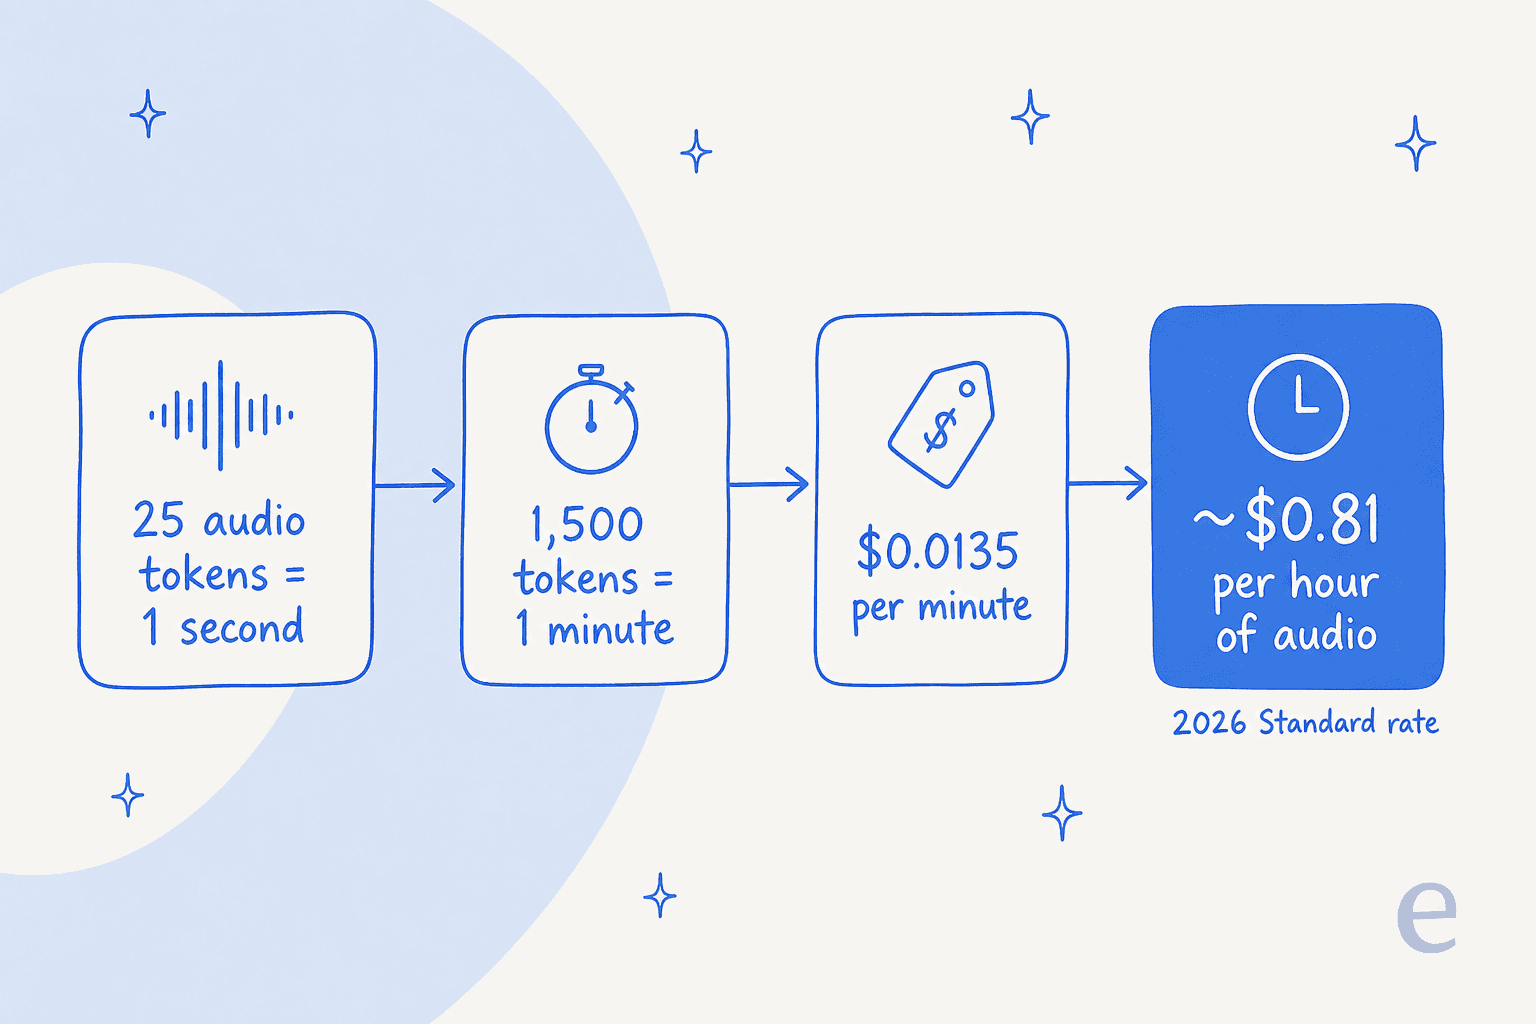
Algunos ejemplos prácticos a la tarifa estándar:
- Un episodio de podcast de 30 minutos: unos 0,41 $ en audio.
- Un audiolibro de 8 horas: aproximadamente 6,48 $.
- 10.000 mensajes de IVR de soporte de 15 segundos cada uno: 3,75 millones de tokens de audio, así que unos 33,75 $.
Si ejecutas cualquiera de esos como un trabajo batch nocturno, lo reduces a la mitad, lo que acerca el audiolibro a 3,24 $. Para generación de alto volumen y no interactiva, batch es la jugada obvia. El único sitio donde el precio de etiqueta no cuenta toda la historia es cualquier cosa que un humano espera en tiempo real, donde pagas la tarifa priority y asumes una latencia que no puedes controlar del todo.
La trampa: los precios se duplican el 1 de enero de 2027
Esta es la parte para anotar en una nota adhesiva. Las cifras de 0,50 $ y 9,00 $ son tarifas promocionales de lanzamiento. El 1 de enero de 2027, la entrada de texto estándar sube a 1,00 $ por millón y la salida de audio a 18,00 $ por millón. Todos los demás niveles se duplican al mismo tiempo: la salida de audio de batch y flex a 9,00 $, la de priority a 32,40 $.
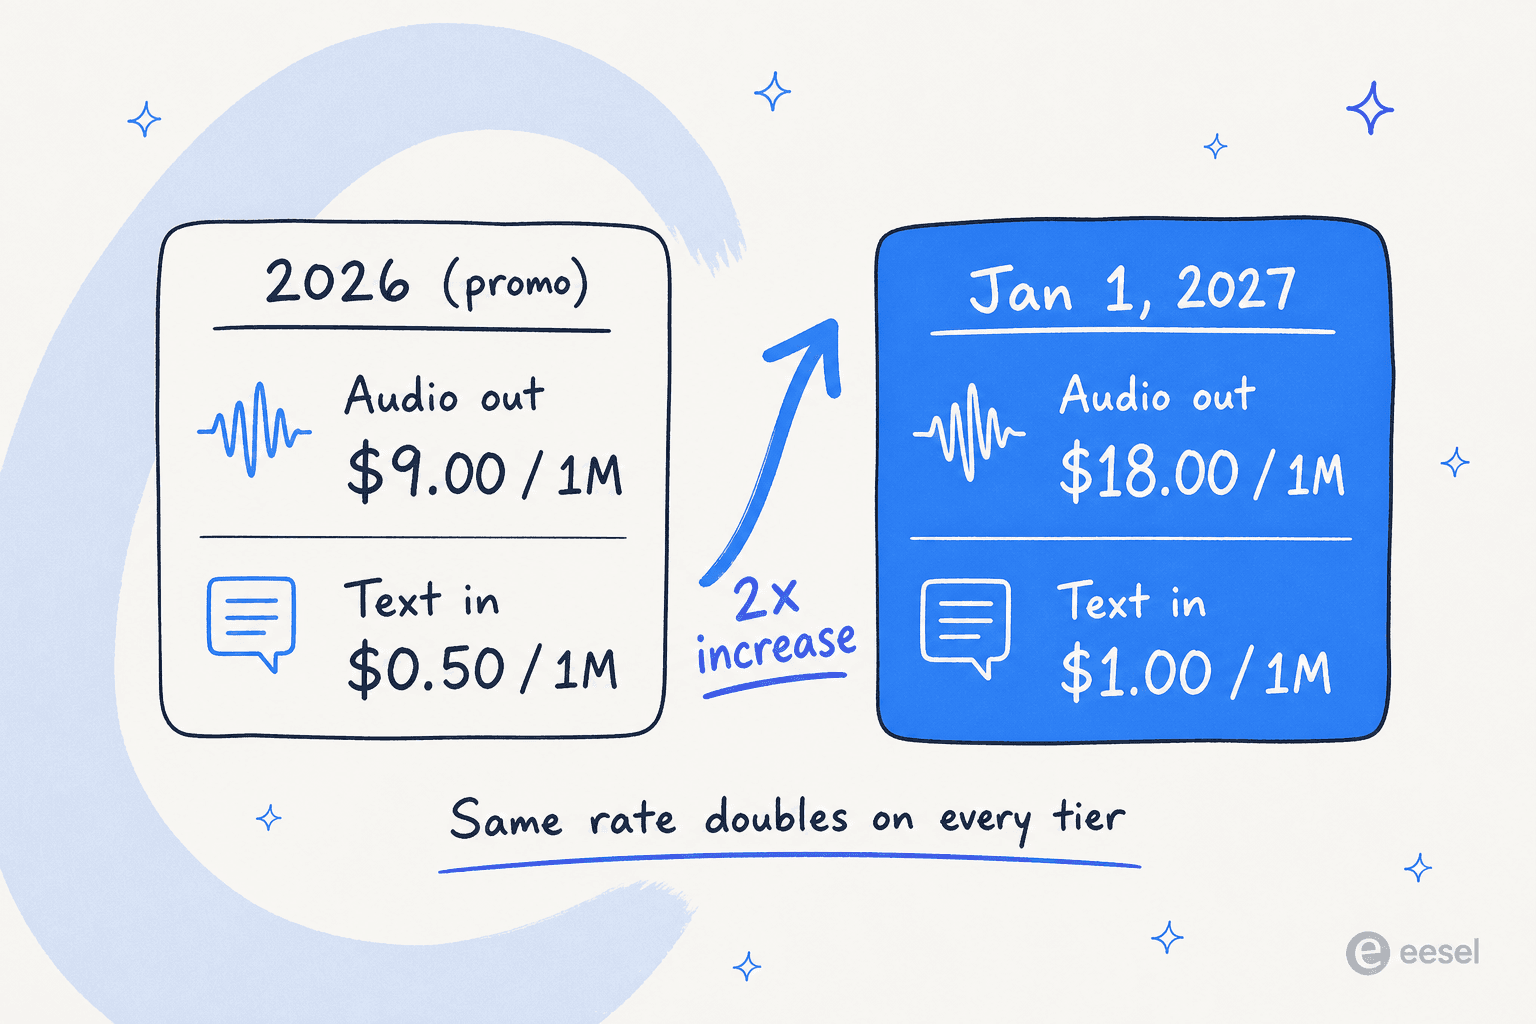
Así que esa hora de audio a 0,81 $ pasa a costar unos 1,62 $ en 2027, y el audiolibro de 8 horas sube de 6,48 $ a 12,96 $. Es el mismo movimiento que hizo Google con los modelos de texto, y es justo mientras lo veas venir. Si estás presupuestando algo más allá de este año, duplica las cifras de este artículo y planifica a partir de ahí. También es un empujón para asegurar ahora todo el ahorro de caché y batch que puedas.
Cómo se compara con ElevenLabs, OpenAI y el resto
Comparar modelos de voz es realmente complicado, porque los proveedores no cobran de la misma forma. Amazon, Azure y Deepgram cobran por carácter de texto de entrada. OpenAI y Google cobran por token de salida de audio, que escala con la duración de la voz generada, no con el guion. ElevenLabs vende créditos de suscripción. Para ponerlos todos en un mismo eje, convertí todo a un coste estimado por hora de voz, usando la propia referencia de Amazon de que 1 millón de caracteres son aproximadamente 23 horas de audio. Trata las cifras por hora como estimaciones, no como condiciones contractuales, porque varían con el ritmo de habla.
| Proveedor | Modelo insignia | Precio nativo | ~ $/hora de audio | Nivel gratuito |
|---|---|---|---|---|
| Gemini 3.8 Flash TTS | gemini-3.8-flash-tts | 9 $ / 1M tokens de audio | ~0,81 $ | Gratis en AI Studio |
| Amazon Polly (Neural) | Neural | 16 $ / 1M caracteres | ~0,70 $ | 1M caracteres/mes (12 meses) |
| Azure AI Speech | Neural / HD Flash | 15 $ / 1M caracteres | ~0,65 $ | 0,5M caracteres/mes |
| OpenAI | gpt-4o-mini-tts | 12 $ / 1M tokens de audio | ~0,90 $ | Ninguno |
| Amazon Polly (Generative) | Generative | 30 $ / 1M caracteres | ~1,30 $ | 100k caracteres/mes |
| Deepgram | Aura-2 | 30 $ / 1M caracteres | ~1,30 $ | 200 $ de crédito |
| ElevenLabs | Eleven v3 / Flash | ~5c/min (Business) | ~3,00 $ | 10k créditos/mes |
Lo que más me sorprendió: Gemini 3.8 Flash TTS tiene el precio de una voz neuronal genérica siendo, en realidad, uno de los modelos generativos más expresivos. Las filas más baratas de Amazon y Azure son sus voces neuronales antiguas; su nivel de calidad generativa (Polly Generative) está en 1,30 $ la hora, y el modelo insignia de Deepgram cae en el mismo lugar. ElevenLabs, que sigue siendo la referencia en calidad de voz, cuesta aproximadamente cuatro veces más por hora. Si el coste por hora es tu factor decisivo y quieres salida expresiva, ahora mismo Gemini es difícil de superar, al menos hasta que el reajuste de 2027 lo suba a unos 1,62 $.
Para la parte de OpenAI de esta comparación, mis artículos sobre la API Realtime de OpenAI y los precios de gpt-realtime-mini profundizan más en dónde tiene sentido la voz facturada por token.
¿La voz es realmente buena?
El precio solo importa si el resultado es utilizable, y aquí las primeras reacciones son más mixtas. El lanzamiento provocó algo de descontento con la calidad. Un desarrollador en Hacker News lo dijo sin rodeos:
"I don't know, I guess their roll out is a bit sloppy. It's a bit of a shame, though, since the voices which are available all sound like generic Gemini voices to me. Nothing stands out."

Es el oído de una sola persona, y la preferencia de voz es subjetiva, pero coincide con un patrón: el TTS de Google es barato y amplio, mientras que ElevenLabs sigue ganando la prueba de "esta voz en concreto suena excepcional" para mucha gente. Algunos usuarios se quedan por ahora con lo que ya conocen:
"For on the go, I've been using ElevenReader. Technically not free but their free tier has been plenty for me."
Así que la lectura honesta es esta. Si necesitas narración barata, multilingüe y suficientemente buena a gran escala, Gemini 3.8 Flash TTS tiene una relación calidad-precio excelente. Si una voz única, distintiva y que define la marca es el producto, pruébala con cuidado frente a ElevenLabs, y no des por hecho que la diferencia de precio significa una diferencia de calidad a tu favor.
Dónde encaja un modelo de voz barato, y dónde no
Esta es la reformulación con la que me gustaría que un comprador se quedara. Un modelo de TTS es infraestructura. Es una forma fantástica y barata de darle voz a una aplicación: una pipeline de audiolibros, un narrador dentro del producto, una capa de accesibilidad, mensajes de IVR. Para eso, 0,81 $ la hora es un muy buen trato.
Pero en el momento en que el caso de uso es atención al cliente, el modelo es el 10 % fácil del problema. Lo difícil es todo lo que lo rodea: extraer la respuesta correcta de tu base de conocimiento, llamar a las herramientas que realmente resuelven un ticket, y pasar pruebas contra tu historial real antes de hablarle a un cliente. Esa es la diferencia entre infraestructura y un empleado. Gemini TTS es lo primero. No conocerá tu política de reembolsos ni hará triaje de un ticket, y montar todo eso tú mismo es un proyecto, no una llamada a una API.
Este es el marco en el que trabajamos todos los días. Llevamos años poniendo IA en colas de soporte reales, y lo que separa una demo de un despliegue nunca es el modelo, es siempre la fontanería y las pruebas. Por eso un agente de helpdesk con IA es una compra muy distinta a un endpoint de voz, incluso cuando ambos digan "IA" en la etiqueta. Si estás sopesando en general la cuenta entre humano y automatización, nuestro análisis de coste de agente de IA frente a agente humano es mejor punto de partida que una tarifa por token.
Prueba eesel
eesel es una plataforma de compañeros de IA, y su catálogo actual incluye un agente de helpdesk con IA listo para trabajar que se une a tu cola de soporte existente. Mientras que Gemini TTS es un modelo alrededor del cual tienes que construir, eesel llega ya sabiendo conectarse a tu helpdesk, aprender de tus tickets pasados y simularse contra conversaciones históricas reales para que conozcas su tasa de resolución antes de salir en producción.

Si prefieres trabajar en una terminal, la CLI de eesel controla ese mismo compañero y espacio de trabajo de forma programática. Puedes manejarla a mano, integrarla en scripts o dejar que un agente de codificación como Claude Code o Cursor la ejecute sin interfaz, de modo que la IA que compras esté disponible tanto en el panel como a través de la API, igual que recurrirías a un modelo como Gemini TTS. Puedes probar eesel gratis y simularlo primero contra tus propios tickets.
Preguntas frecuentes
¿Cuánto cuesta Gemini 3.8 Flash TTS?
¿Existe un nivel gratuito para Gemini 3.8 Flash TTS?
¿Cómo se comparan los precios de Gemini 3.8 Flash TTS con ElevenLabs?
¿Por qué se duplica el precio de Gemini 3.8 Flash TTS en enero de 2027?
¿Es Gemini 3.8 Flash TTS suficientemente bueno para voz de atención al cliente?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.