Qué es en realidad Gemini 3.8 Flash TTS
Primero los datos aburridos pero importantes, porque buena parte de la confusión online viene de mezclar los ID de los modelos.
Gemini 3.8 Flash TTS es un modelo de texto a voz: entra texto, sale audio, nada más. Se lanzó como estable, no en preview, con el ID gemini-3.8-flash-tts, y Google lo indica como el reemplazo recomendado del antiguo gemini-3.1-flash-tts-preview. Hay una versión hermana más barata, gemini-3.8-flash-lite-tts, a la que volveré más adelante.
Algunas especificaciones que conviene fijar, todas de la propia documentación de generación de voz de Google:
- 130 idiomas en Flash TTS, con detección automática del idioma de entrada.
- 8.192 tokens de entrada y 16.384 tokens de salida por solicitud, así que está pensado para frases y párrafos, no para novelas enteras en una sola llamada.
- La salida por defecto es WAV mono a 24 kHz, con opciones mulaw y alaw para telefonía.
- El audio se factura a 25 tokens por segundo, que es el detalle que hace que la cuenta del precio cuadre.
No hace llamadas a funciones, salida estructurada, razonamiento, grounding con búsqueda ni Live API. Es un motor de renderizado, no un agente. Conviene tener esto claro, porque importa más adelante.
¿Cómo suena en realidad?
Es la única pregunta que importa para un modelo de voz, y también es donde el marketing y la realidad divergen un poco.
El argumento de Google es sólido. La entrada de lanzamiento afirma #1 en el Voice Design Benchmark de Hume AI (71,4) y #1 y #2 en el Overall Quality Index de Hume para Flash y Flash-Lite. Son cifras reales. Un matiz que me gustaría tener presente antes de confiar del todo: el fundador de Hume figura como autor en el propio anuncio de Google, así que el proveedor y el autor del benchmark no son del todo independientes aquí. Eso no invalida las puntuaciones, pero hace que las sopese algo menos.
La lectura independiente es más útil. Según Artificial Analysis, Gemini 3.8 Flash TTS logró #1 en Pronunciation Robustness con 89,5 % (subiendo del 88,2 % de 3.1 Flash TTS), pero solo #2 en la Provider Voice Arena a ciegas, con un Elo de alrededor de 1.263, detrás de Sonic 3. Así que el resumen justo es: el mejor de su clase pronunciando las palabras correctamente, segundo en sonar como la voz que realmente elegirías.
"Google ha lanzado Gemini 3.8 Flash TTS y Gemini 3.8 Flash-Lite TTS. Gemini 3.8 Flash TTS debuta en el #1 de nuestro Pronunciation Robustness Benchmark y en el #2 de nuestro ranking Provider Voice Arena"
Los desarrolladores que de verdad lo probaron fueron más directos. El comentario más contundente del hilo del día de lanzamiento en Hacker News:
"Las voces disponibles me suenan todas a voces genéricas de Gemini. Nada destaca como particularmente interesante o impresionante en esto."

Eso encaja con la brecha del benchmark. La pronunciación está resuelta; la personalidad no. Si tu trabajo es un narrador claro, correcto y neutro, estarás muy contento. Si necesitas una voz que el oyente recuerde, baja las expectativas.
Qué puedes controlar realmente
El motivo para recurrir a Gemini en vez de a una voz neuronal simple es el control, y esta es la parte que más me gustó. No solo eliges una voz de un catálogo, la diriges.
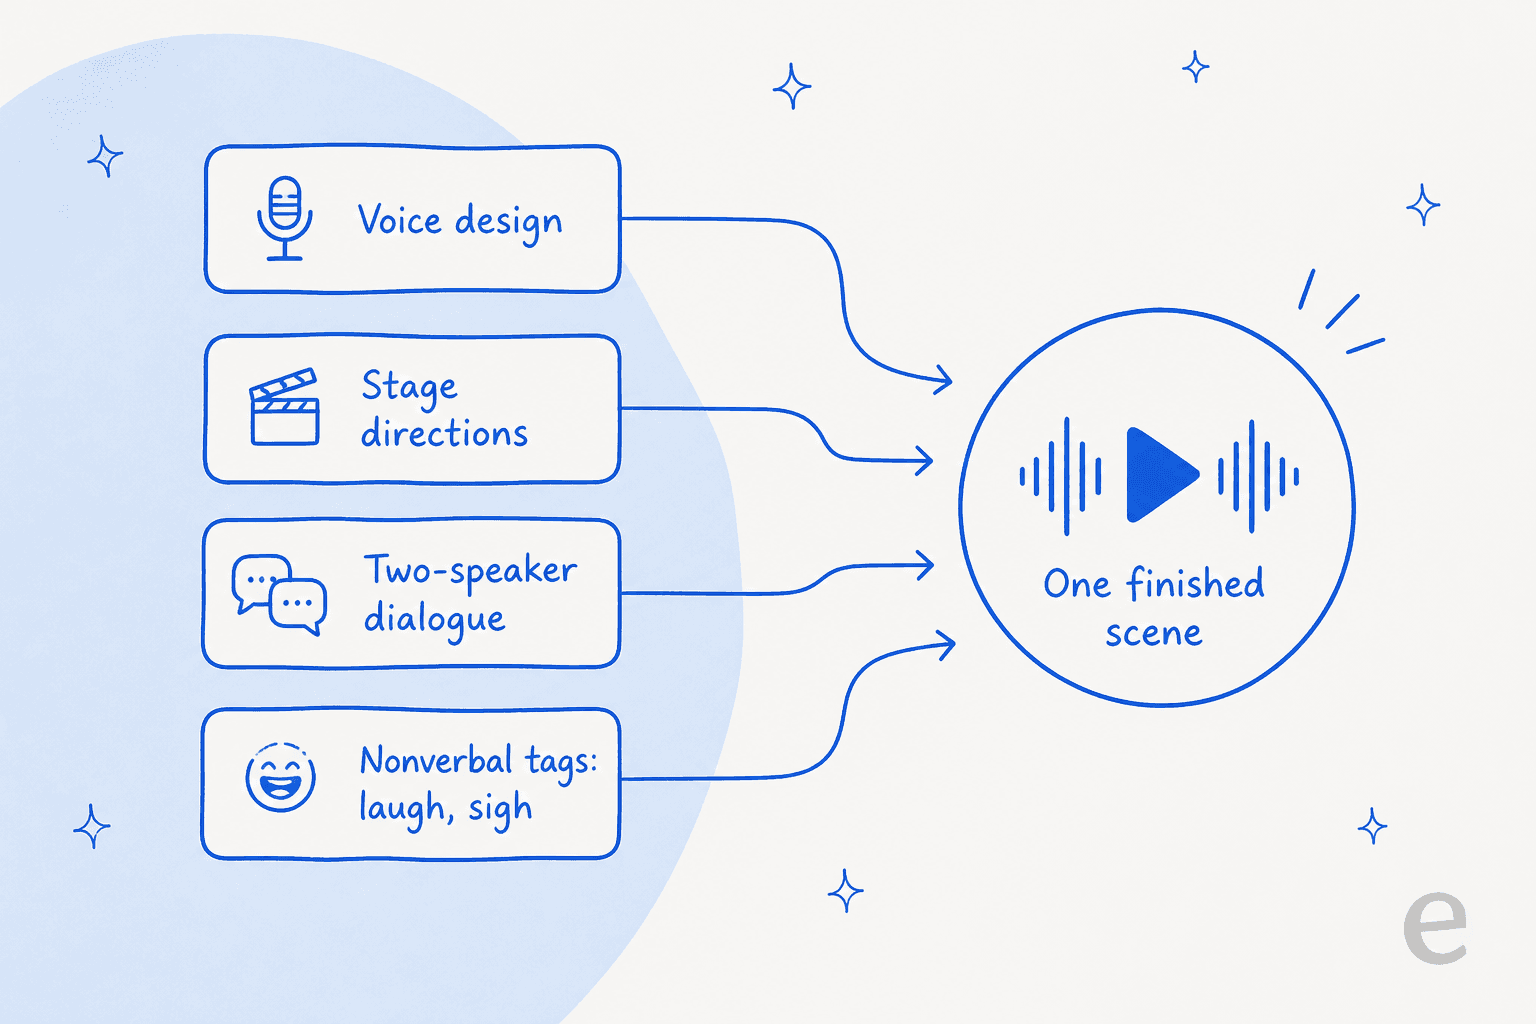
Se combinan cuatro capas:
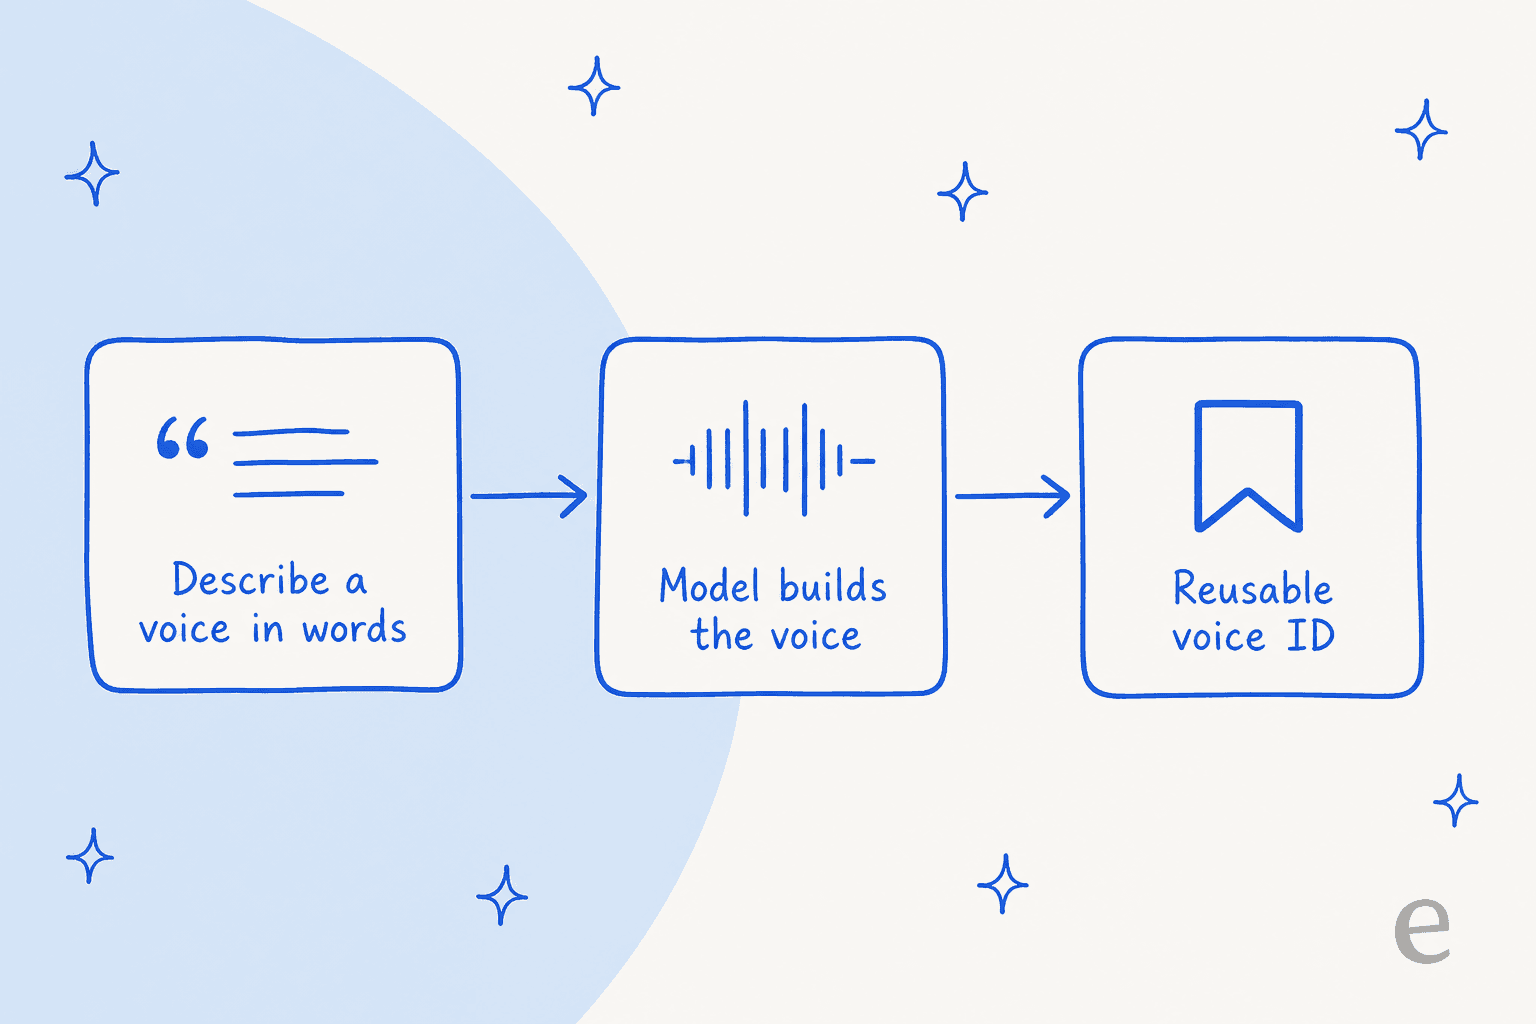
- Diseño de voz. Describe una persona en lenguaje natural y el modelo construye una voz a partir de esa descripción, que luego puedes guardar como un ID reutilizable.
- Indicaciones de dirección. Un campo estilo
speech_metadatate permite dirigir el tono, el acento y el ritmo por turno ("lee esto con calidez, algo apresurado"). - Diálogo de dos hablantes. Un modo conversacional maneja hasta dos voces predefinidas en una sola solicitud, lo que hace posibles clips rápidos estilo pódcast.
- Etiquetas no verbales. Marcadores en línea como
<laugh>,<sigh>,<breath>y<short pause>colocan eventos vocales exactamente donde quieras.
El flujo de diseño de voz es la característica estrella y es realmente ingenioso: pasas de una frase de descripción a una voz persistente y reutilizable sin grabar nada nunca.
El límite honesto: la controlabilidad es real, pero no del todo fiable. En un lanzamiento anterior de Gemini TTS, un desarrollador informó que la dirección a veces se ignoraba por completo:
"Sin importar lo que escribiera en el perfil de audio, AI Studio nunca lo seguía, sin importar la escena o el contexto. Por ejemplo, intenté conseguir una voz masculina y seguía obteniendo voces femeninas."
Google dice que 3.8 mejora la dirección creativa, y en mi lectura así es, pero conviene contar con algunas regeneraciones cuando una indicación no acierta a la primera. Es un prompt, no una garantía.
La replicación de voz (clonado) también se lanzó, algo que durante un tiempo Google parecía reacio a hacer. Como dijo Simon Willison:
"Supongo que la clonación de voz ya está lo bastante extendida en otros proveedores como para que Google ya no tenga reparos en lanzarla."
Flash vs Flash-Lite: cuál usar
La división en dos modelos es sencilla una vez que la ves, y elegir mal solo te cuesta dinero o calidad.
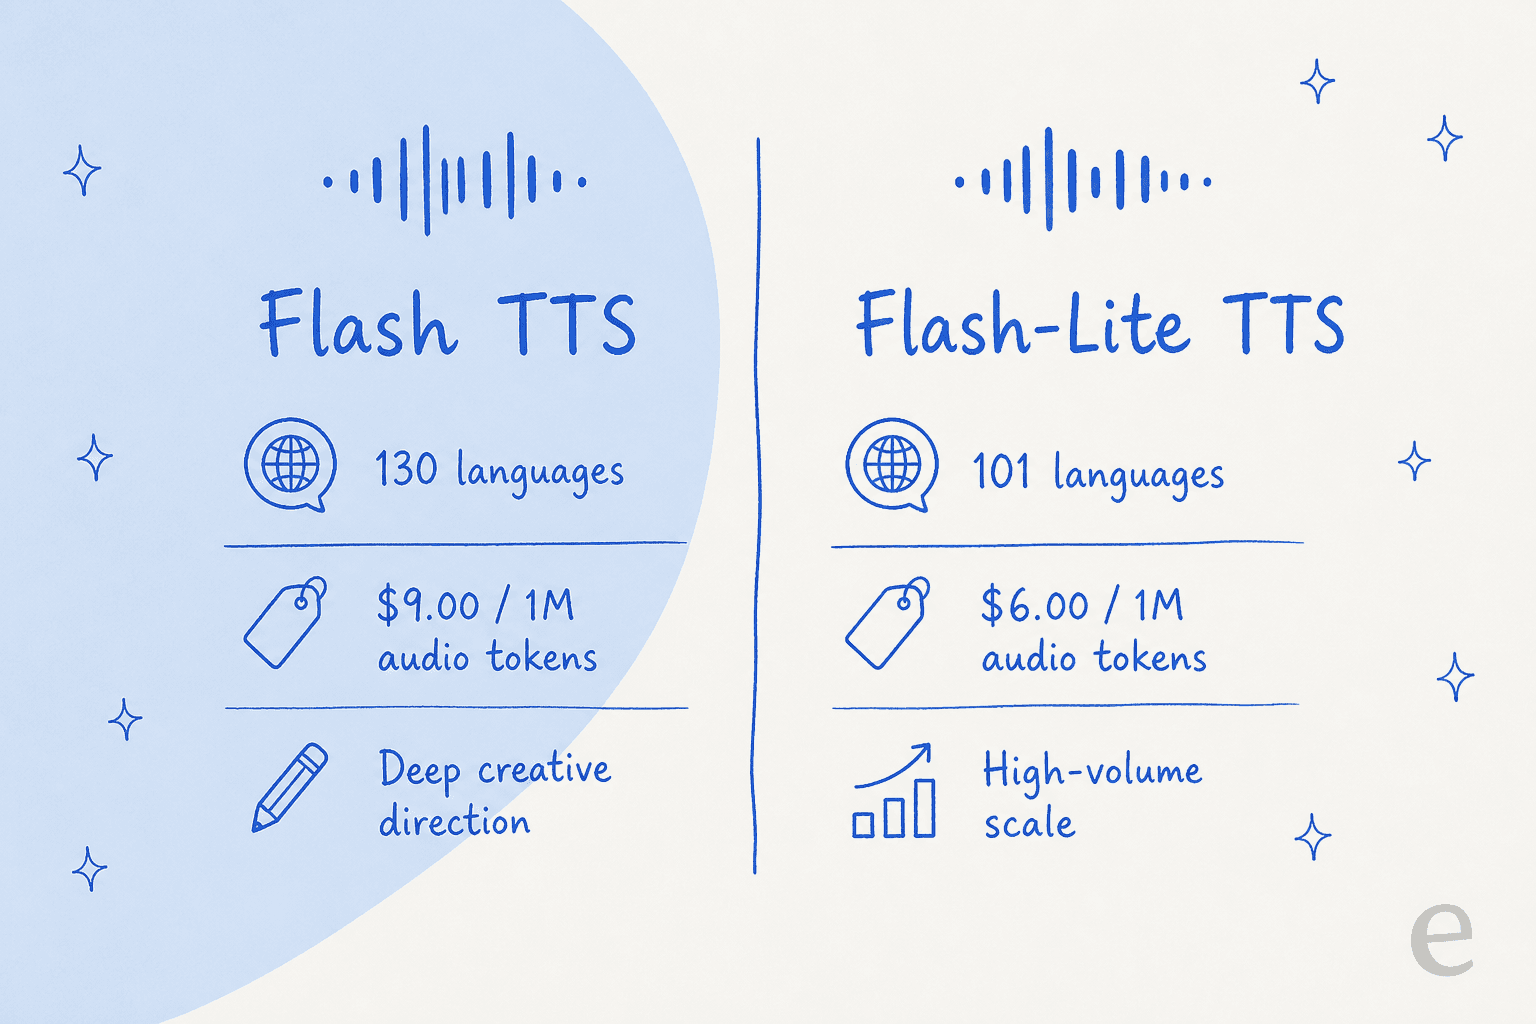
Flash TTS es el expresivo: 130 idiomas, 9,00 $ por 1M de tokens de audio, y el kit completo de dirección creativa. Recurre a él cuando el audio es el producto, como un audiolibro, un anuncio de marca o un personaje.
Flash-Lite TTS es el caballo de batalla: 101 idiomas, 6,00 $ por 1M de tokens de audio, ajustado para renderizado de gran volumen donde "bueno y barato" gana a "expresivo". Recurre a él cuando generas miles de clips y nadie va a notar una lectura algo más plana.
Mi regla general: prototipa con Flash para escuchar el techo de calidad, y luego baja a Flash-Lite para todo lo que renderices en volumen. Si ninguno encaja, las alternativas a Gemini que merece la pena probar son Sonic 3 de Cartesia y ElevenLabs.
La realidad del precio (y la trampa de 2027)
Mantengo las cifras completas en el artículo de precios de Gemini 3.8 Flash TTS, pero la versión relevante para este análisis es corta.
En el nivel estándar, Flash TTS cuesta 9,00 $ por 1M de tokens de salida de audio. Como el audio se factura a 25 tokens por segundo, una hora de voz son unos 90.000 tokens, así que unos 0,81 $ por hora de audio generado. Batch y Flex tienen un 50 % de descuento sobre eso. Hay un nivel gratuito real a través de Google AI Studio.
La trampa que hay que prever: esas son tarifas promocionales hasta el 31 de diciembre de 2026, y se duplican aproximadamente el 1 de enero de 2027 (Flash sube a 18,00 $ por 1M de tokens de audio). Si estás presupuestando una carga de trabajo para 2027, presupuesta la cifra duplicada, no la de lanzamiento. Es el mismo patrón en toda la línea de precios de Gemini, así que no debería sorprender si sigues de cerca Gemini.
En cuanto al coste, el veredicto de la comunidad fue claro incluso entre los escépticos. Simon Willison, probando el modo conversación:
"El modo conversación es genial, y la mayoría de mis experimentos han costado menos de un centavo."
Cómo se compara con la competencia
Los precios de TTS entre proveedores son un lío porque las unidades de facturación difieren: Amazon, Azure y Deepgram cobran por carácter, mientras que OpenAI y Google cobran por token de audio. Para comparar de forma justa lo normalicé todo a dólares por hora de audio (usando el propio ancla de Amazon de unas 23 horas de voz por 1M de caracteres). Trata estos números como estimaciones, ya que la velocidad de habla cambia el cálculo.
| Modelo | Precio de referencia | ~ $/hora de audio | Nivel gratuito |
|---|---|---|---|
| Gemini 3.8 Flash TTS | 9,00 $ / 1M tokens de audio | ~0,81 $ | Sí (AI Studio) |
| Gemini 3.8 Flash-Lite TTS | 6,00 $ / 1M tokens de audio | ~0,54 $ | Sí (AI Studio) |
| Amazon Polly Neural | 16 $ / 1M caracteres | ~0,70 $ | 1M caracteres/mes (12 meses) |
| Azure Neural / HD Flash | 15 $ / 1M caracteres | ~0,65 $ | 0,5M caracteres/mes |
| OpenAI gpt-4o-mini-tts | 12 $ / 1M tokens de audio | ~0,90 $ | Ninguno (TTS) |
| Deepgram Aura-2 | 30 $ / 1M caracteres | ~1,30 $ | 200 $ de crédito al registrarse |
| ElevenLabs Business | "desde 5 c/min" | ~3,00 $ | 10.000 créditos/mes |
La conclusión: Gemini 3.8 Flash TTS tiene un precio de voz neuronal genérica pero se comporta como una voz expresiva y generativa. Se sitúa justo al lado de Amazon Polly Neural y Azure en coste, supera en precio a OpenAI y Deepgram, y es una fracción de ElevenLabs por hora. Si te importa la relación entre precio y expresividad, ese es el titular de todo el lanzamiento.
Un matiz que hay que reconocer: los precios de ElevenLabs te compran una biblioteca de voces y un nivel de carácter que la tabla de costes no recoge, que es exactamente por lo que los equipos siguen pagando por él, como muestran las reseñas de ElevenLabs.
¿Deberías usarlo? Una decisión rápida
En vez de otro párrafo de "depende", aquí está la decisión que yo tomaría según el caso de uso.
Dónde se queda corto
Para ser justos, estos son los límites reales que señalaría antes de decidirte:
- A las voces les falta carácter. La crítica de desarrolladores más votada fue que todo suena "genéricamente Gemini". Genial para lo utilitario, más débil para la marca.
- La dirección puede ignorarse. El control creativo es un prompt, no un contrato, así que espera fallos ocasionales y regeneraciones.
- No es lo mejor de la arena. #1 en pronunciación, pero #2 en preferencia humana a ciegas, detrás de Sonic 3. Si tu requisito es "la mejor voz", esto no está zanjado.
- El coste se duplica en 2027. El precio de lanzamiento es promocional. Una carga de trabajo que dimensiones en 2026 costará el doble en enero.
- Los modelos locales están alcanzando. Varios desarrolladores señalaron opciones abiertas como Fish Audio, Higgs y Qwen3 TTS como suficientemente buenas para un render final, sobre todo cuando el coste o la privacidad descartan una API en la nube.
Ninguna de estas cosas es descalificante. Son la diferencia entre "increíble" y "muy bueno y muy barato", que es donde queda esto.
La parte por la que de verdad viniste: voz para soporte
Mucha gente que busca un modelo de voz en realidad se está haciendo otra pregunta: ¿puedo poner esto delante de mis clientes? Esta es la sección que no me saltaría.
Un modelo TTS es infraestructura. Convierte texto en audio, y ese es todo su trabajo. No conoce tu política de reembolsos, no puede leer tu software de atención al cliente, y no tiene idea de si la frase que acaba de decir en voz alta es cierta. Si pones un modelo de voz sin más delante de una línea de soporte, leerá con total confianza una respuesta equivocada con una voz preciosa, lo cual es peor que un simple mensaje de error. Es lo contrario del ahorro de costes que persigue la mayoría de los equipos.
Trabajo en esto en eesel, y la forma en que lo veo es simple: el modelo es la voz, el compañero de equipo es el empleado. eesel es una plataforma de compañeros de equipo con IA, y el compañero relevante aquí es el agente de helpdesk con IA. Se conecta a tu helpdesk existente, aprende de tus tickets anteriores y tu centro de ayuda, sigue las reglas que definas, y se simula contra tu historial real de tickets antes de responder nunca a un cliente en vivo. Esa última parte importa: hemos visto bots que suenan seguros de sí mismos dar respuestas equivocadas sin que nadie se dé cuenta, que es justo por lo que cada implementación se prueba primero en seco con tickets históricos. Un modelo de voz no tiene una red de seguridad equivalente.
Si trabajas desde una terminal o quieres automatizar esto, la CLI de eesel controla el mismo compañero de equipo y el mismo espacio de trabajo que el panel. Una persona puede inspeccionar las instrucciones de un compañero de equipo desde la línea de comandos, un script puede automatizar un flujo de trabajo, y un agente de código como Claude Code, Codex o Cursor puede operar eesel de forma programática, imprimir resultados en JSON y proponer cambios acotados para que un responsable los apruebe. Es la interfaz amigable para agentes del mismo producto, no algo aparte. Es una diferencia real frente a conectar tú mismo Gemini TTS, donde tienes que asumir en solitario toda la orquestación, las métricas de soporte, la lógica de escalado y la gestión de SLA.
Así que: usa Gemini 3.8 Flash TTS para lo que se le da genial, que es voz barata, clara y controlable. Para una voz que de verdad resuelva problemas de clientes, necesitas un compañero de equipo probado encima, no el modelo en crudo. Si ese es tu objetivo real, empieza con un chatbot de helpdesk con IA de verdad y las herramientas más amplias de automatización del soporte, y compara las opciones del mejor agente de IA para atención al cliente antes de construir nada desde cero.
Mi veredicto
Gemini 3.8 Flash TTS es un modelo de voz muy bueno a un precio genuinamente disruptivo. Domina la pronunciación, ofrece control creativo real, incluye diseño de voz y clonación, y cuesta una fracción de ElevenLabs por hora. Los matices honestos son que a las voces les falta carácter destacado, queda #2 en vez de #1 en preferencia a ciegas, y el precio se duplica en 2027.
Para la mayoría de los desarrolladores que renderizan audio a escala, es el nuevo estándar sensato. Para una voz de marca distintiva, ElevenLabs y Sonic 3 siguen en la contienda. Y si viniste queriendo una IA que hable con tus clientes y resuelva de verdad sus problemas, recuerda que la voz es la parte fácil: las empresas de atención al cliente con IA que merecen tu tiempo son las que resuelven la parte difícil, y el software de helpdesk con IA que resuelve un ticket importa mucho más que la voz que lee la respuesta.

¿Quieres un compañero de equipo de IA para tu cola de soporte, no solo una voz bonita? eesel se conecta a tu helpdesk en minutos, aprende de tus propios tickets, y puedes simularlo con tu historial real antes de ponerlo en marcha. Prueba eesel gratis, o reserva una demo para verlo con tus propios datos.
Preguntas frecuentes
¿Es bueno Gemini 3.8 Flash TTS?
Sí, con matices. Tiene calidad de estudio en claridad y pronunciación, y debutó en el puesto #1 del benchmark Pronunciation Robustness de Artificial Analysis. Pero en preferencia humana a ciegas quedó #2, detrás de Sonic 3 de Cartesia, y varios desarrolladores dijeron que las voces predefinidas suenan genéricas. Es una opción por defecto excelente, no un barrido total.
¿Cuánto cuesta Gemini 3.8 Flash TTS?
Cuesta 0,50 $ por 1M de tokens de entrada de texto y 9,00 $ por 1M de tokens de salida de audio en el nivel estándar hasta el 31 de diciembre de 2026, lo que equivale a unos 0,81 $ por una hora de voz. Ambas tarifas se duplican el 1 de enero de 2027. Los niveles completos están en mi desglose de precios de Gemini 3.8 Flash TTS, y la familia completa está en la guía de precios de Gemini 3.
Gemini 3.8 Flash TTS vs ElevenLabs: ¿cuál es mejor?
Gemini gana en precio por un margen amplio, entre 4 y 5 veces más barato por hora de audio. ElevenLabs sigue ganando en voces destacadas y con carácter, y en su biblioteca de voces. Si el coste y la escala importan más, Gemini; si lo que importa más es una voz distintiva, mira también las alternativas a ElevenLabs.
¿Cuál es la diferencia entre Gemini 3.8 Flash TTS y Flash-Lite TTS?
Flash TTS cubre 130 idiomas a 9,00 $ por 1M de tokens de audio y está pensado para audio expresivo y dirigido. Flash-Lite TTS cubre 101 idiomas a 6,00 $ por 1M de tokens de audio y está pensado para trabajos de gran volumen y sensibles al coste. Elige Flash cuando importe la dirección creativa, y Flash-Lite cuando renderices a gran escala.
¿Puede Gemini 3.8 Flash TTS clonar una voz?
Sí. Admite diseño de voz (describir una persona con palabras) y replicación de voz (clonar a partir de un clip de referencia corto más audio de consentimiento). Las voces clonadas pueden guardarse como un ID de voz reutilizable, con un límite de 200 por proyecto y un TTL de un año, o como una clave sin estado de 7 días.
¿Gemini 3.8 Flash TTS admite varios hablantes?
Hasta dos hablantes por solicitud usando voces predefinidas, con un modo conversacional para diálogos. Para más de dos voces se sintetiza cada turno por separado y se unen los audios.
¿Es suficiente un modelo de voz como Gemini TTS para atención al cliente?
No. Un modelo TTS convierte texto en voz; no lee tu centro de ayuda, no sigue tus políticas ni resuelve un ticket. Para soporte necesitas un compañero de equipo de IA sobre esa base, como un agente de helpdesk con IA que se conecte a tu software de atención al cliente y se pruebe primero con tu historial real de tickets.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.