

La mejor alternativa a Gemini 4 Carbon para la mayoría de los equipos es Gemini 4 Argon, el modelo sobre el que se construye Carbon: está en la API hoy al mismo precio introductorio de $2/$10, e inventó respuestas el 4% de las veces frente al 11% de Carbon en Artificial Analysis. El propio Carbon está limitado a defensores de ciberseguridad a través del Fairwind Program de Google, sin fecha para el resto.
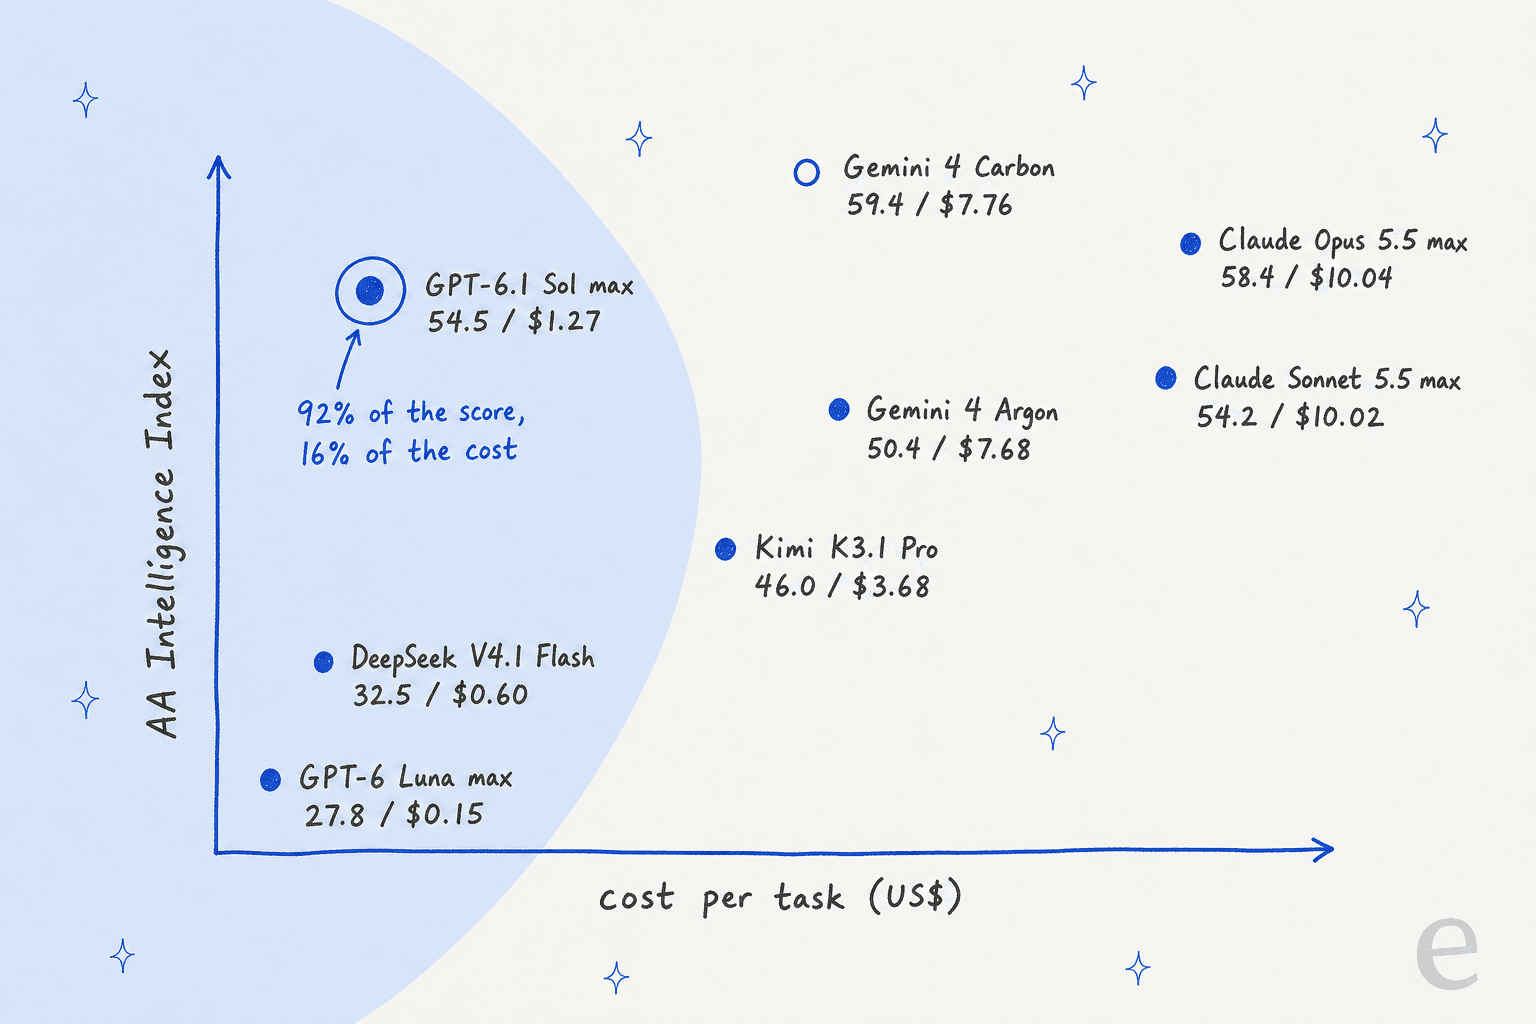
Si querías Carbon por su puntuación, GPT-6.1 Sol con esfuerzo máximo obtiene el 92% de la puntuación de índice de Carbon por el 16% del coste por tarea ($1,27 frente a $7,76). Claude Opus 5.5 es el más cercano en puntuación bruta (58,4) pero el más caro por tarea. Kimi K3.1 Pro, DeepSeek V4.1 Flash y GPT-6 Luna cubren contexto largo, pesos abiertos y triaje barato.
Si tenías a Carbon en el punto de mira para un agente de soporte, el modelo importa menos que lo que lee. Yo construyo las integraciones detrás de eesel, donde un compañero de helpdesk con IA responde desde tu centro de ayuda y tus tickets anteriores con cualquiera de estos modelos; SamCart ejecuta un agente en los tickets de Freshdesk y otro en el chat de su web, respondiendo desde 280 artículos de ayuda.
¿Por qué la gente busca alternativas a Gemini 4 Carbon?
Porque casi nadie puede usarlo. Google anunció Gemini 4 Carbon el 28 de octubre de 2026 y dijo que "starting this week" llega a un subconjunto de defensores de ciberseguridad, luego gradualmente a más socios de confianza, con desarrolladores, empresas y consumidores listados bajo "coming soon". No hay fecha para ese último grupo.
La puerta de acceso es el Fairwind Program, que Google describe como acceso anticipado para defensores de alta prioridad "like governments, healthcare providers, and telecommunications services". Trabaja con más de 650 socios y hace verificaciones de antecedentes a las organizaciones que solicitan. Si diriges un equipo de soporte o un producto SaaS, ese no eres tú, al menos por ahora.
Es una pena, porque Carbon es potente. Lidera el Artificial Analysis Intelligence Index con 59,4, supera a Argon en las 17 filas de la propia tabla de benchmarks de Google y se lanza al precio de Argon: $2 por millón de tokens de entrada y $10 por millón de salida, y luego $4/$20 tras el periodo introductorio. Lo repasé todo en mi explicación de Gemini 4 Carbon.
El hilo de Hacker News sobre el lanzamiento (735 puntos) captó bien el ambiente:
"I can't tell if they're withholding access to manufacture some sense of scarcity but the delays are really prolonged."

El precedente de Argon ayuda un poco. Argon se anunció el 30 de septiembre y se lanzó el 13 de octubre, unas dos semanas después, como señaló un comentarista de Hacker News. Pero Argon nunca estuvo limitado a un programa de seguridad, así que no planificaría el lanzamiento de un producto contando con que Carbon siga el mismo calendario.
Cómo elegí estas alternativas
Empecé por donde empezaría un comprador. Le pregunté a ChatGPT, en un chat nuevo, por las mejores alternativas para un agente de soporte con IA ahora que Carbon es solo para ciberseguridad. Preseleccionó GPT-6.1 Sol, Gemini 4 Argon, Claude Sonnet 5.5 y GPT-6 Luna, y sugirió una configuración de dos modelos en la que uno barato hace el triaje y uno más potente se encarga de los casos difíciles. Los cuatro entraron en esta lista, y esa idea de enrutamiento da forma a la última sección.
Después añadí los modelos que compiten con Carbon en sus propios benchmarks y comprobé cada precio en la página de precios del proveedor el 29 de octubre de 2026. Los datos de puntuación vienen de Artificial Analysis, que pasó a Carbon, Argon y el resto por el mismo índice a precio de lista. Saqué tres números por modelo:
- Intelligence Index v5.0, la puntuación principal que Carbon encabeza.
- Coste por tarea, lo que costó realmente una tarea del índice a precio de lista, incluyendo todos los tokens de razonamiento. Este es el número que te dice si una tarifa barata es barata en la práctica.
- Tasa de alucinación en AA-Omniscience: con qué frecuencia el modelo da una respuesta incorrecta cuando debería haber dicho que no sabía. Para cualquier cosa que dé la cara ante clientes, este es el que más me importa.
eesel lleva años poniendo agentes de IA en colas de soporte reales, y hemos visto a bots de apariencia segura dar respuestas erróneas en silencio. Por eso cada despliegue de eesel se ejecuta ahora contra los tickets históricos de un equipo antes de responder a un cliente real, y por eso la columna de alucinación pesa aquí tanto como la puntuación principal.
Alternativas a Gemini 4 Carbon de un vistazo
Aquí tienes toda la lista en una tabla. Los precios son tarifas estándar de la API por millón de tokens a 29 de octubre de 2026. Los números de AA corresponden al nivel de esfuerzo más alto de cada modelo salvo que se indique, a precio de lista.
| Modelo | ¿Se puede usar hoy? | Entrada / salida (por 1M) | Entrada en caché | AA Index v5.0 | Coste AA por tarea | Tasa de respuestas inventadas | Ventana de contexto | Pesos abiertos | Mejor para |
|---|---|---|---|---|---|---|---|---|---|
| Gemini 4 Carbon (referencia) | Solo defensores de ciberseguridad | $2 / $10 intro, luego $4 / $20 | 95% de descuento en entrada | 59.4 | $7.76 | 11% | 1M | No | Seguridad y programación, si consigues acceso |
| Gemini 4 Argon | Sí, Gemini API | $2 / $10 hasta 30 nov., luego $4 / $20 | $0.10, luego $0.20 | 50.4 | $7.68 | 4% | 1,048,576 | No | Menos respuestas inventadas |
| GPT-6.1 Sol | Sí, OpenAI API | $2 / $10 | $0.10 | 54.5 | $1.27 | 52% | 1,050,000 | No | Mejor puntuación por dólar |
| Claude Opus 5.5 | Sí, Claude API | $4 / $20 | $0.20 | 58.4 | $10.04 | 50% | 1M | No | Puntuación bruta más cercana |
| Claude Sonnet 5.5 | Sí, Claude API | $2 / $10 | $0.10 | 54.2 | $10.02 | 43% | 1M | No | Calidad de escritura, uso de herramientas |
| Kimi K3.1 Pro | Sí, Kimi API | $2 / $10 | $0.20 | 46.0 | $3.68 | 37% | 1,048,576 | Todavía no | Contexto largo, trabajo de agentes |
| DeepSeek V4.1 Flash | Sí, DeepSeek API | $0.15 / $0.60 horas valle, $0.30 / $1.20 horas punta | $0.003 horas valle | 32.5 | $0.60 | 64% | 1M | Sí | Autoalojamiento, factura más baja |
| GPT-6 Luna | Sí, OpenAI API | $0.10 / $0.50 | $0.01 | 27.8 | $0.15 | 79% | 1,050,000 | No | Triaje y enrutamiento baratos |
Hay dos cosas que llaman la atención. Primero, cinco de estos modelos comparten la tarifa de $2/$10 de Carbon, así que el precio por token no los distingue. El coste por tarea sí, porque refleja cuántos tokens gasta cada modelo pensando. Segundo, la columna de respuestas inventadas va del 4% al 79%, una dispersión mucho mayor que la de las puntuaciones del índice.
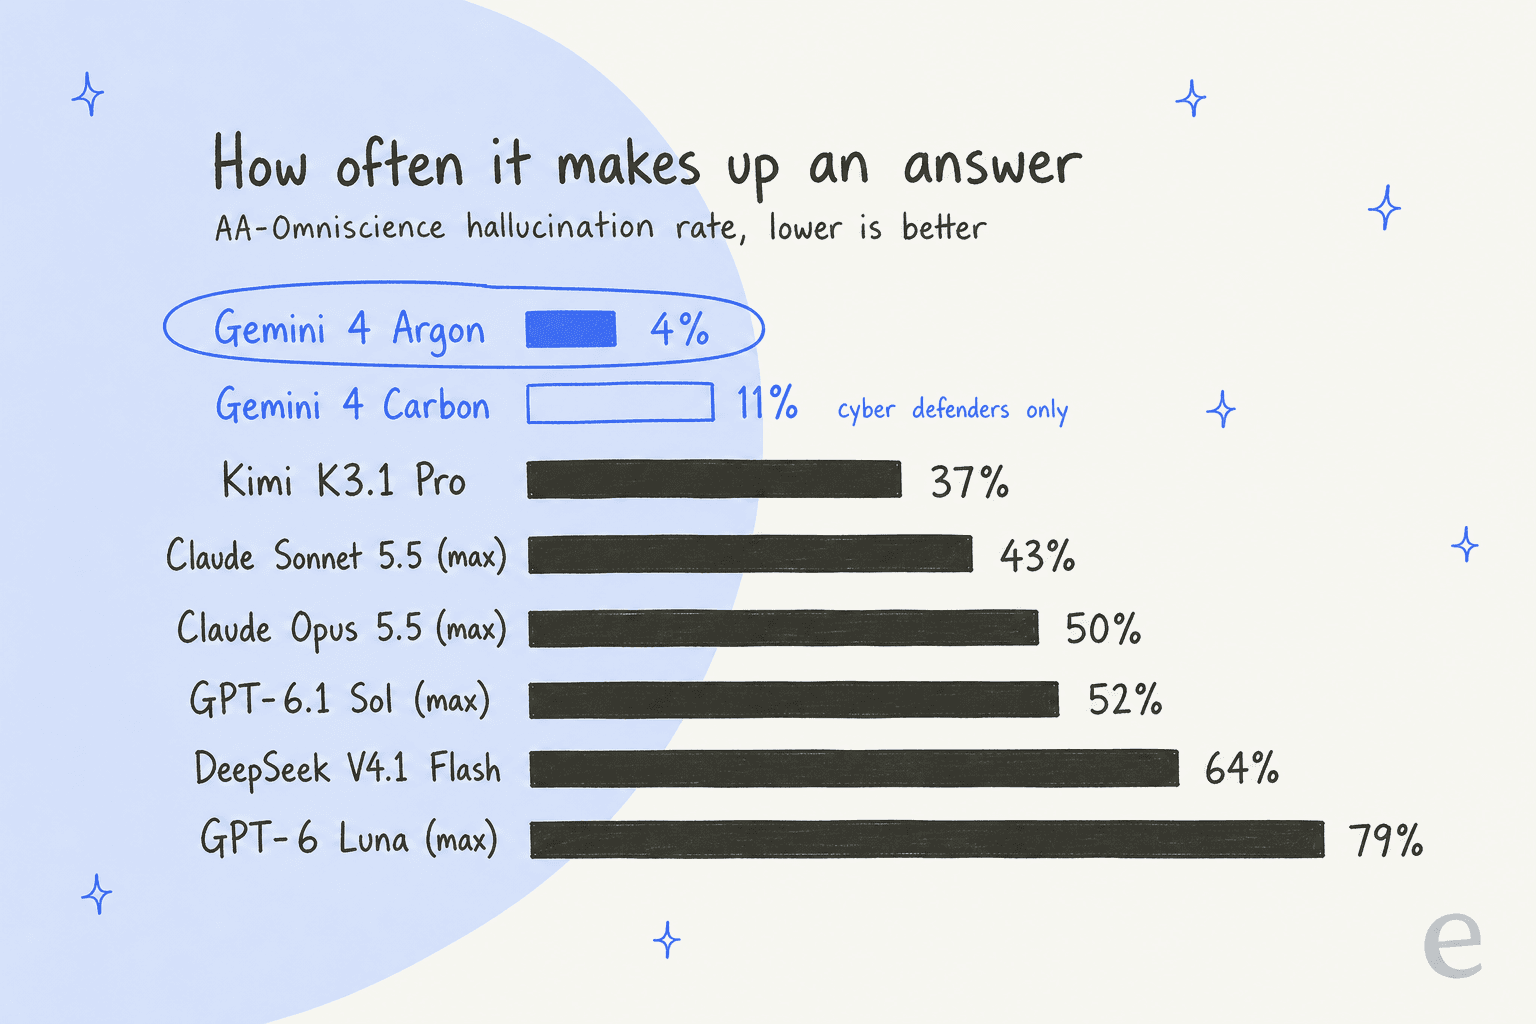
Ese gráfico es la razón por la que mi primera elección no es el modelo con la puntuación más cercana. Si te atraía Carbon porque Google dice que es más honesto sobre lo que no sabe, Argon ya lo supera en esa misma prueba.
1. Gemini 4 Argon
Mejor para: equipos que querían Carbon para un agente de cara al cliente y necesitan menos respuestas inventadas más que una puntuación más alta.
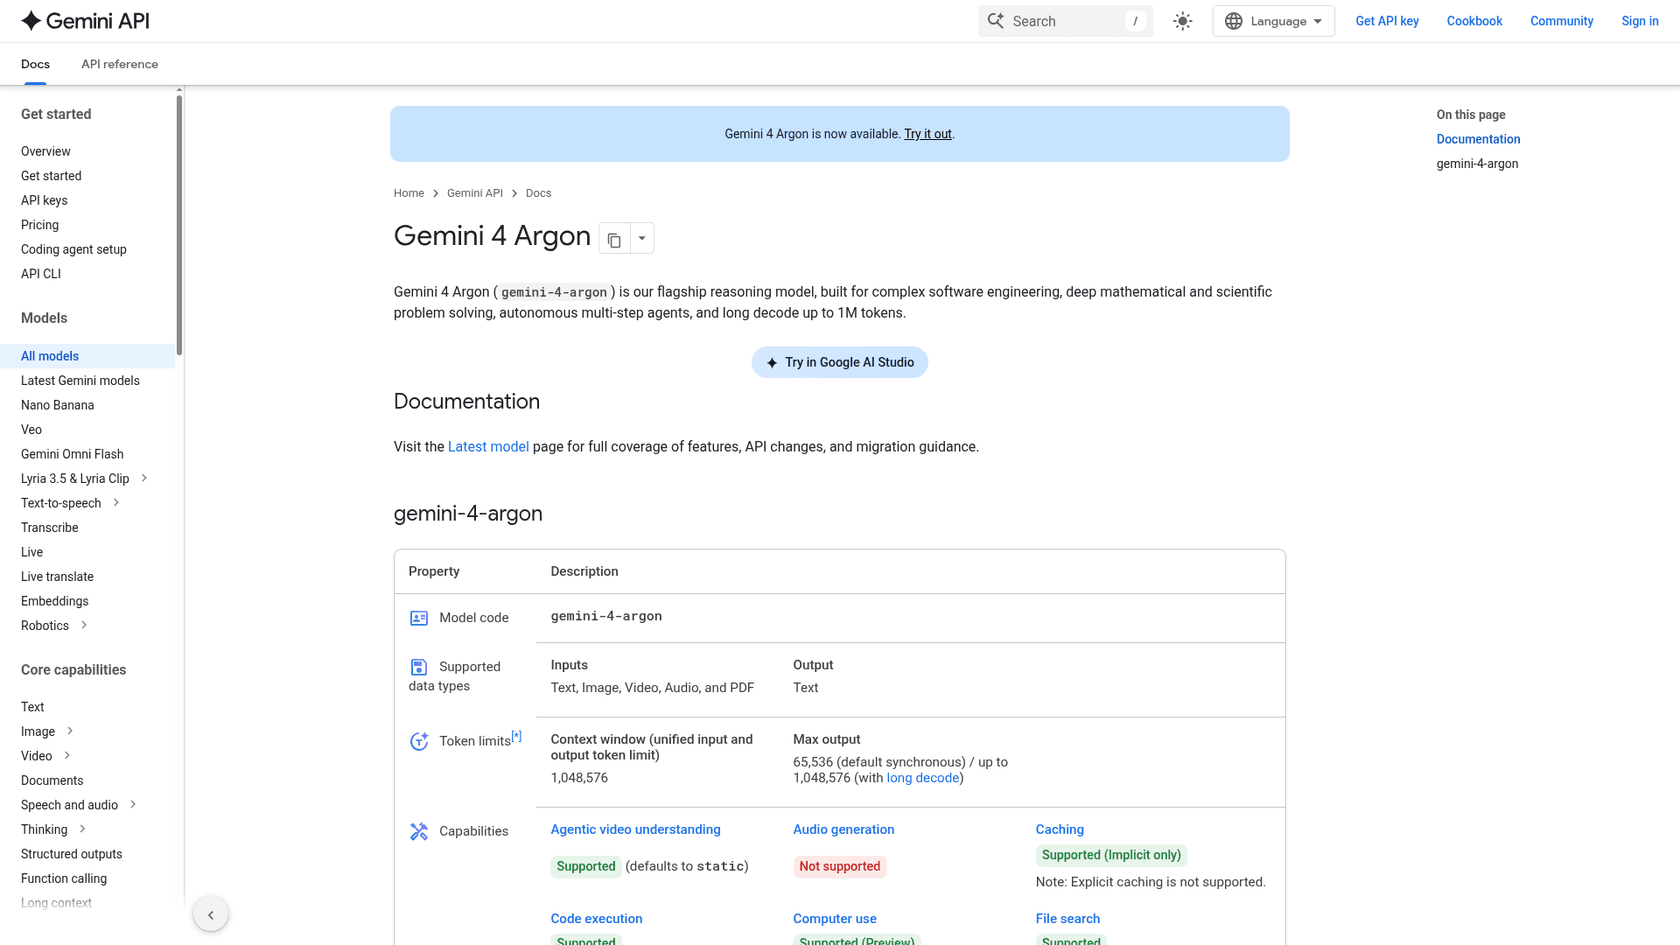
Argon es el modelo sobre el que se construye Carbon, así que es la primera parada obvia. Está disponible con carácter general a través de la API de Gemini y Google AI Studio, con una ventana de contexto de 1.048.576 tokens y hasta 1M de tokens de salida con long decode. Si tu código ya llama a Gemini, pasar a Carbon más adelante es un cambio de nombre de modelo.
En Artificial Analysis, Argon puntúa 50,4 frente a los 59,4 de Carbon, así que Carbon es el modelo más listo. Pero la tasa de alucinación de Argon es del 4% frente al 11% de Carbon, la más baja de todos los modelos que revisé, y en AutomationBench (flujos de trabajo empresariales de varios pasos) obtuvo 77,5% frente al 77,8% de Carbon. Argon incluso costó algo menos por tarea del índice ($7,68 frente a $7,76). Para un agente de soporte, la brecha que realmente importa es bastante pequeña.
"For what it's worth: Argon is a pretty good model, and this is coming from someone who just sticks with Opus 5.5 mostly across the board. For the current introductory price, it provides an exceptional value."
Pros
- La misma tarifa que Carbon, así que tu modelo de costes no cambiará cuando Carbon se abra.
- La tasa de respuestas inventadas más baja de esta lista, por un amplio margen.
- Google Search grounding incluye 5.000 solicitudes gratuitas al mes.
Contras
- Piensa mucho: 116K tokens de salida por tarea de AA, así que la factura por tarea es alta para su puntuación.
- Solo caché implícita. No puedes fijar una caché de forma explícita como en Claude.
- No todos lo valoran. Un usuario de Hacker News lo llamó "a clear tier below" los modelos actuales de Claude y Sol.
Precios
| Nivel (por 1M de tokens) | Entrada | Salida | Entrada en caché |
|---|---|---|---|
| Estándar, hasta 30 nov. 2026 | $2.00 | $10.00 | $0.10 |
| Estándar, desde 1 dic. 2026 | $4.00 | $20.00 | $0.20 |
| Batch o Flex, hasta 30 nov. | $1.00 | $5.00 | $0.05 |
| Priority, hasta 30 nov. | $3.60 | $18.00 | $0.18 |
El grounding de búsqueda son 5.000 solicitudes gratuitas al mes, luego $14 por 1.000, según la página de precios de Google. No hay nivel gratuito para Argon. Mi artículo sobre los precios de Gemini 4 Argon repasa el salto de precio de diciembre.
Mi opinión: empieza aquí si construyes algo que responde a clientes. Presupuesta la duplicación de precio del 1 de diciembre, y si lo que más necesitas es velocidad y coste, mira Sol en su lugar. Cubrí más opciones en mi resumen de alternativas a Gemini 4 Argon.
2. GPT-6.1 Sol
Mejor para: equipos que querían la inteligencia de Carbon pero cuidan la factura.
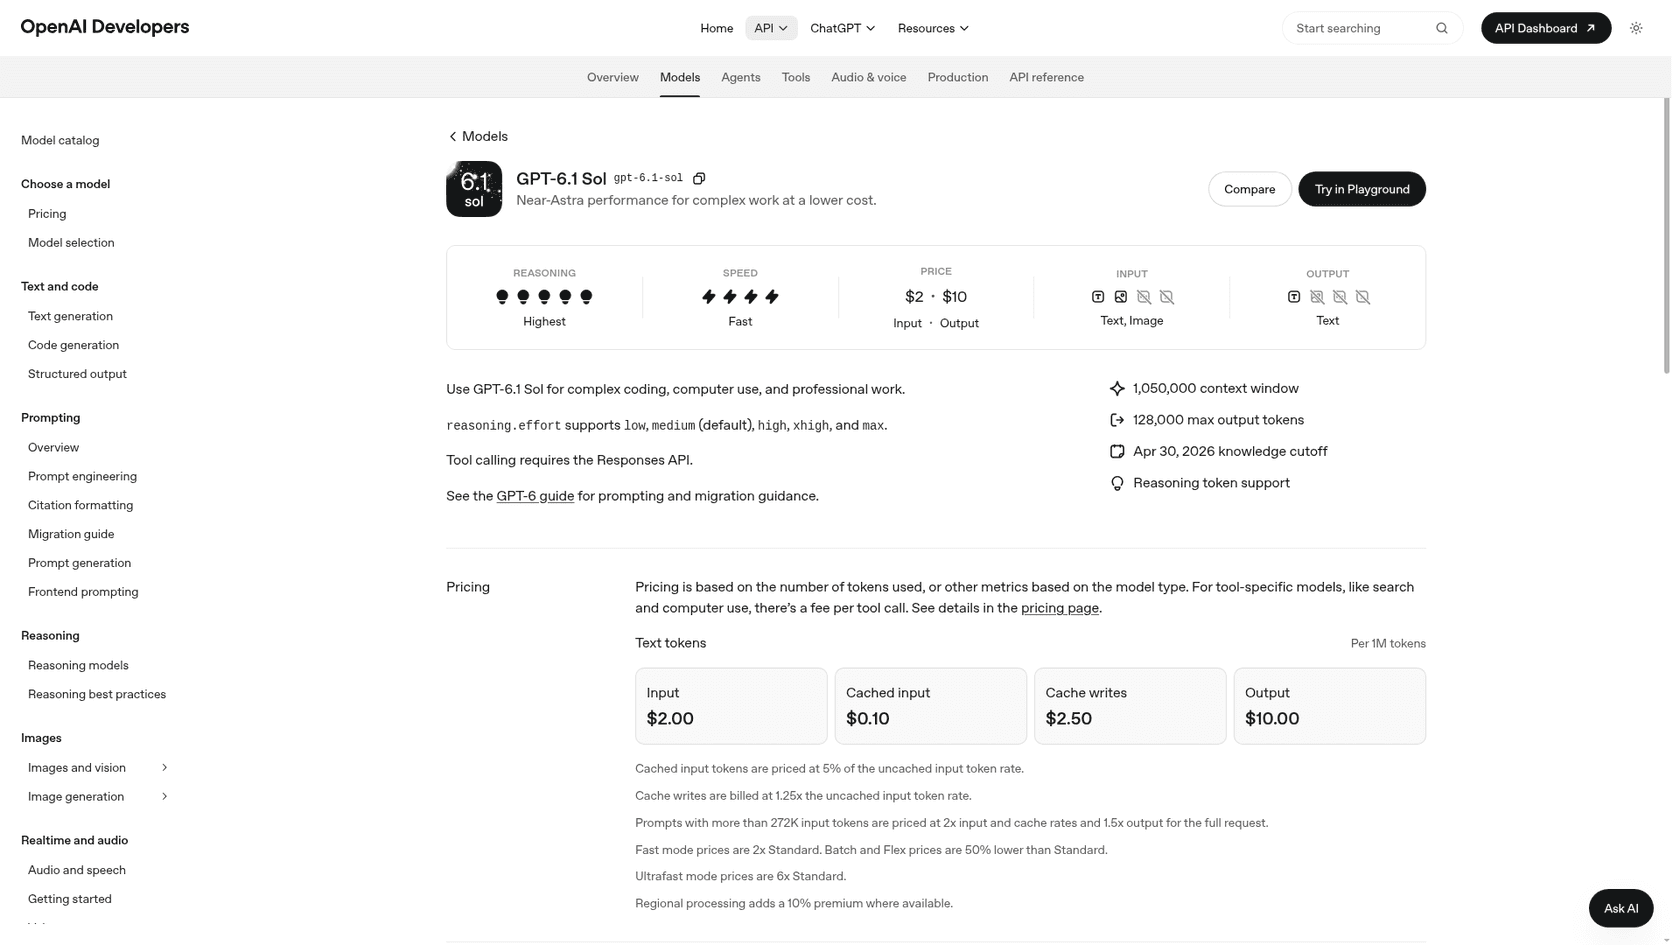
Sol fue la primera sugerencia de ChatGPT para un agente de soporte, y los números lo respaldan. La página del modelo de OpenAI lo describe como "Near-Astra performance for complex work at a lower cost", con una ventana de contexto de 1.050.000 tokens y esfuerzo de razonamiento de low a max.
Con esfuerzo máximo, Sol puntúa 54,5 en el índice de Artificial Analysis por $1,27 por tarea, frente a los $7,76 de Carbon. Eso es el 92% de la puntuación de Carbon al 16% del coste. En xhigh son 52,3 por $0,76, y en medium 46,1 por $0,36, que es el ajuste con el que yo empezaría un agente de soporte.
Pros
- La mejor puntuación por dólar de todo lo de esta lista.
- Cinco niveles de esfuerzo, así que un modelo puede cubrir tickets baratos y difíciles.
- Los precios batch reducen la factura a la mitad, a $1/$5, para todo lo que pueda esperar.
Contras
- Inventó respuestas el 52% de las veces en AA-Omniscience con esfuerzo máximo. Necesita basarse en tu propio contenido.
- El tool calling requiere la Responses API, así que el código antiguo de Chat Completions necesita migración.
- Los prompts de más de 272K tokens de entrada se facturan a 2x de entrada y 1,5x de salida.
Precios
| Modo (por 1M de tokens) | Entrada | Salida | Entrada en caché |
|---|---|---|---|
| Estándar | $2.00 | $10.00 | $0.10 |
| Batch / Flex | $1.00 | $5.00 | $0.05 |
| Fast | $4.00 | $20.00 | $0.20 |
| Ultrafast | $12.00 | $60.00 | $0.60 |
Los precios son de la página de precios de OpenAI. Mi guía de precios de GPT-6.1 Sol tiene ejemplos resueltos.
Mi opinión: la elección por defecto si no tienes motivo para quedarte con Google. Solo no dejes que responda a clientes de memoria. Mi reseña de GPT-6.1 Sol cubre dónde falla.
3. Claude Opus 5.5
Mejor para: equipos que quieren lo más parecido a la puntuación de Carbon y están dispuestos a pagarlo.
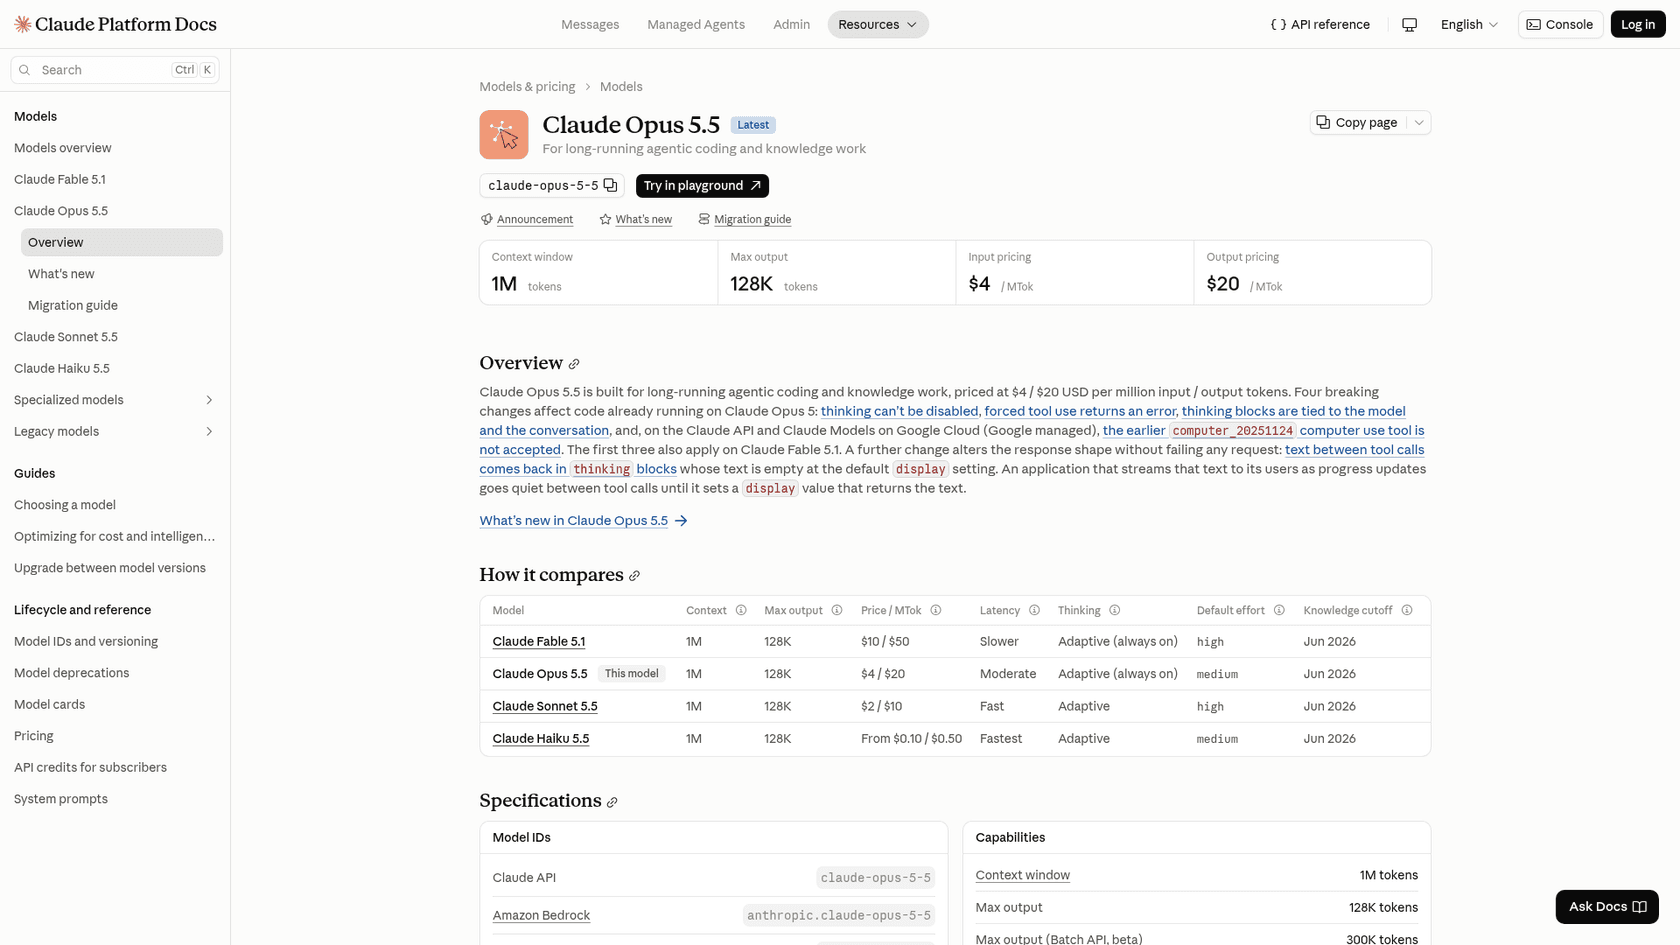
Opus 5.5 es el modelo que Carbon apenas superó. En Artificial Analysis puntúa 58,4 con esfuerzo máximo, un punto por detrás de los 59,4 de Carbon, y en la propia tabla de Google sigue liderando el uso de ordenador OSWorld-2.1 con 87,2% frente al 81,5% de Carbon. Anthropic lo posiciona para "long-running agentic coding and knowledge work".
El problema, en términos de dinero, es la factura. Con esfuerzo máximo una tarea de AA costó $10,04, lo más alto de esta lista. Xhigh es mejor compromiso: 57,0 por $6,05, que aún supera a Carbon en coste por tarea. Anthropic también indica que Opus 5.5 cambió parte del comportamiento de la API respecto a Opus 5 (no se puede desactivar el thinking, el uso forzado de herramientas devuelve un error), así que conviene revisar la guía de migración antes de cambiarlo.
"I've found its worse in most tasks, especially when ranked on a cost-per-task metric."
Esa respuesta era sobre Claude Fable 5.1 frente a Opus 5.5, y resume bien por qué aquí la elección de Anthropic es Opus y no Fable.
Pros
- La puntuación bruta más cercana a Carbon que realmente puedes comprar.
- Los aciertos de caché de prompt cuestan el 5% de la entrada ($0,20 por millón), más barato que el 10% habitual.
- También apto para el Cyber Verification Program de Anthropic si la seguridad forma parte del trabajo.
Contras
- Mayor coste por tarea con esfuerzo máximo ($10,04).
- Inventó respuestas el 50% de las veces con esfuerzo máximo en AA-Omniscience.
- El modo Fast cuesta $8/$40, el doble del estándar.
Precios
| Modo (por 1M de tokens) | Entrada | Salida | Lectura de caché |
|---|---|---|---|
| Estándar | $4.00 | $20.00 | $0.20 |
| Batch | $2.00 | $10.00 | n/a |
| Modo Fast | $8.00 | $40.00 | n/a |
De la documentación de precios de Anthropic. Más detalle en mi artículo sobre los precios de Claude Opus 5.5.
Mi opinión: elige Opus 5.5 en xhigh si el trabajo es difícil y largo, como programación con agentes o investigación profunda. Para una cola de soporte es más modelo del que necesitan la mayoría de los tickets. Mi reseña de Claude Opus 5.5 tiene los detalles.
4. Claude Sonnet 5.5
Mejor para: redacción de cara al cliente y uso de herramientas donde importa el tono.
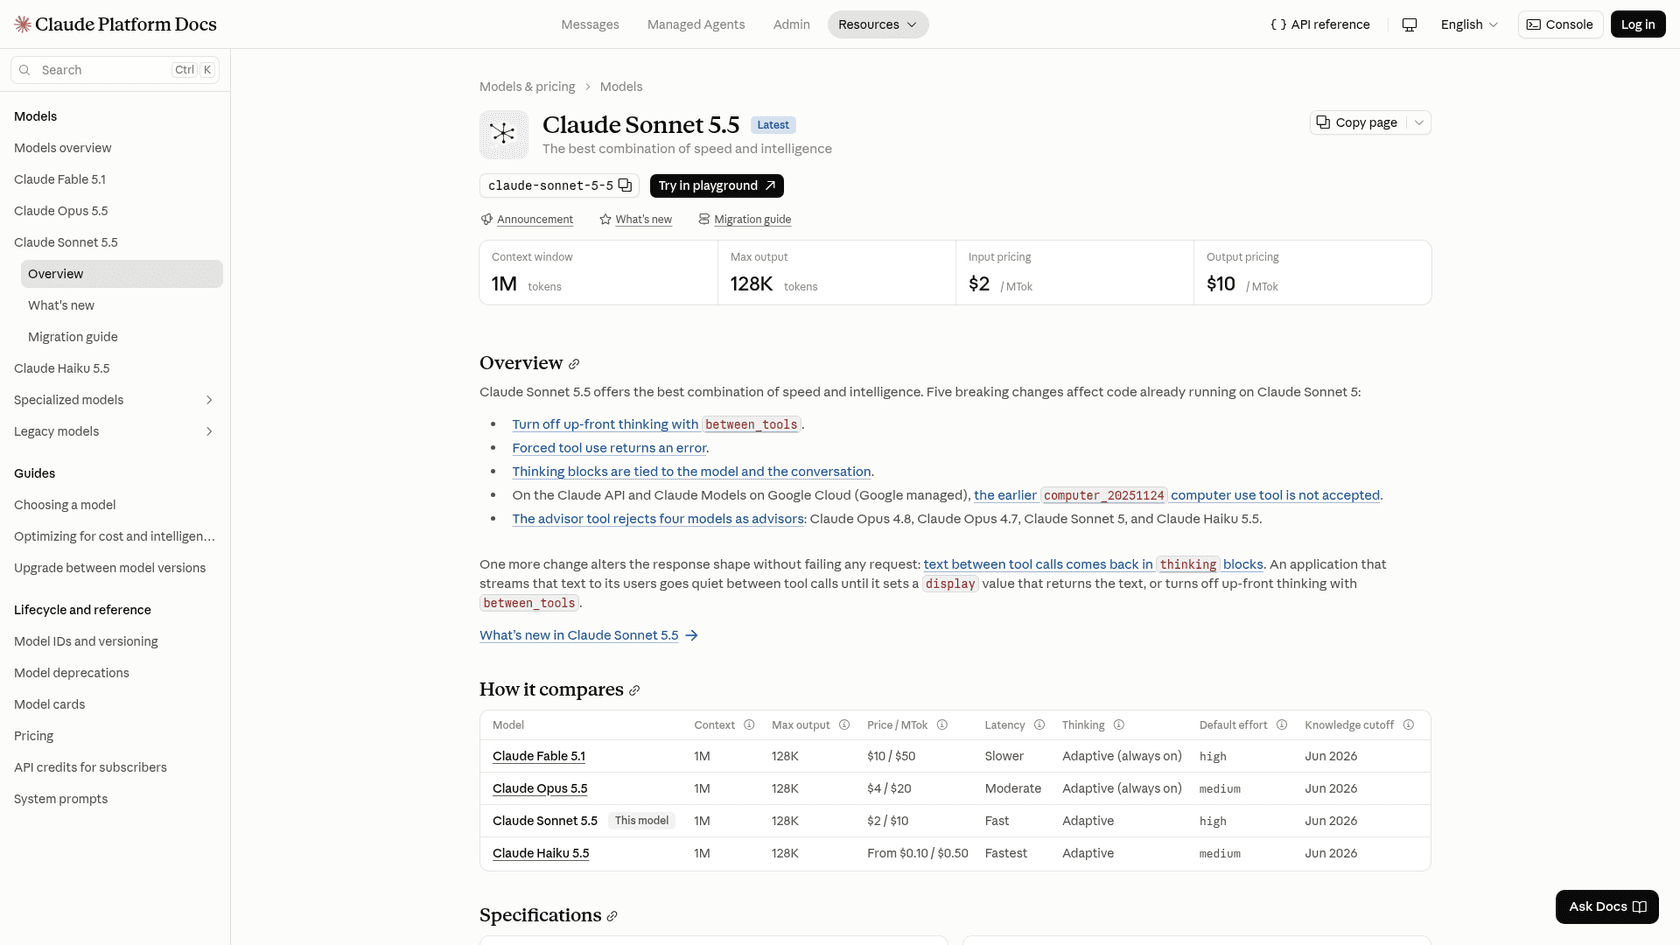
Sonnet 5.5 es el tercer modelo que sugirió ChatGPT, para "nuanced, high-quality customer conversations". Anthropic lo llama "the best combination of speed and intelligence" de su gama, al mismo $2/$10 que el precio de lanzamiento de Carbon.
Las puntuaciones dependen mucho del esfuerzo. En max, Sonnet alcanza 54,2 en Artificial Analysis, cerca de Sol, pero esa ejecución costó $10,02 por tarea. Con esfuerzo high baja a 41,1 por $1,64. Su tasa de alucinación es la mejor de los modelos de frontera de Anthropic y OpenAI aquí con esfuerzo máximo (43%), y su resultado en AutomationBench en max (71,8%) solo queda por detrás de los dos modelos Gemini 4 y Kimi.
Pros
- El modelo intermedio de Anthropic: más rápido que Opus 5.5 a la mitad del precio por token.
- Aciertos de caché a $0,10 por millón, el 5% de la entrada.
- La misma API y herramientas que Opus, así que puedes enrutar entre ambos.
Contras
- El esfuerzo max cuesta lo mismo por tarea que Opus 5.5.
- La caída de puntuación de max a high es pronunciada (54,2 a 41,1).
- Sin pesos abiertos, sin autoalojamiento.
Precios
| Modo (por 1M de tokens) | Entrada | Salida | Lectura de caché |
|---|---|---|---|
| Estándar | $2.00 | $10.00 | $0.10 |
| Batch | $1.00 | $5.00 | n/a |
De la documentación de precios de Anthropic. Mi guía de precios de Claude Sonnet 5.5 desglosa los costes por esfuerzo.
Mi opinión: una opción por defecto sólida para respuestas de soporte, con esfuerzo medium o high y grounding. Evita el esfuerzo max salvo que la tarea sea difícil. Mira mi reseña de Claude Sonnet 5.5 para más.
5. Kimi K3.1 Pro
Mejor para: tickets largos, documentos largos y trabajo de herramientas de varios pasos a una tarifa de modelo de frontera.
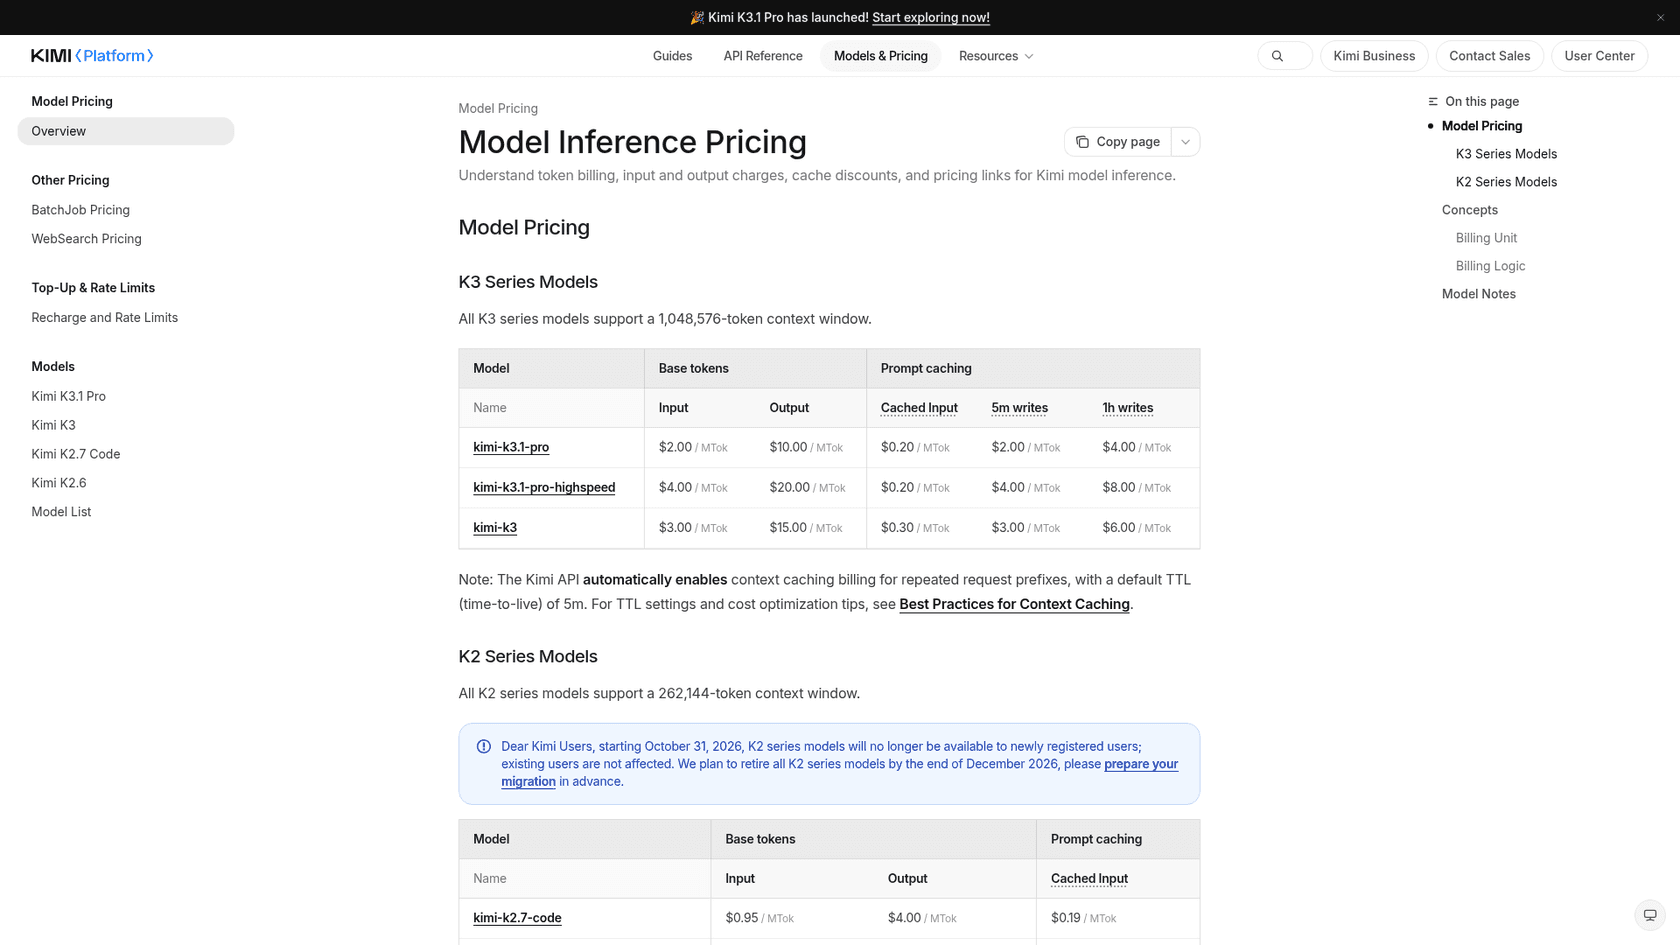
Kimi K3.1 Pro, de Moonshot, es un poco el discreto de esta lista. Puntúa 46,0 en el índice de Artificial Analysis, por debajo de los demás, pero logra el mejor resultado de razonamiento de contexto largo de mi comparación (86,3% en la prueba de contexto largo de AA, frente al 79,3% de Carbon) y 73,3% en AutomationBench. Su tasa de alucinación del 37% es la más baja fuera de la familia Gemini 4.
Cuesta $3,68 por tarea de AA, la mitad que Carbon, y es el modelo más lento de aquí, con unos 36 tokens de salida por segundo. Para un agente de soporte que redacta respuestas en segundo plano esa velocidad está bien, para chat en vivo no.
Pros
- La mejor puntuación de contexto largo del grupo.
- Segunda tasa más baja de respuestas inventadas entre los modelos que puedes comprar.
- La misma tarifa de $2/$10 que el precio de lanzamiento de Carbon.
Contras
- Salida lenta, así que no es una opción para chat en vivo.
- Puntuación principal más baja que los modelos de frontera de EE. UU.
- Los pesos abiertos aún no están disponibles, así que por ahora es solo por API.
Precios
| Modelo (por 1M de tokens) | Entrada | Salida | Entrada en caché |
|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 |
De la página de precios de Kimi Platform. Mi artículo sobre los precios de Kimi K3.1 Pro tiene las cuentas por tarea.
Mi opinión: merece una prueba si tus tickets son largos y desordenados, o si tu agente lee documentos grandes. Usa el nivel highspeed si la latencia importa. Más en mi reseña de Kimi K3.1 Pro.
6. DeepSeek V4.1 Flash
Mejor para: equipos que necesitan pesos abiertos, autoalojamiento o la factura más baja por token.
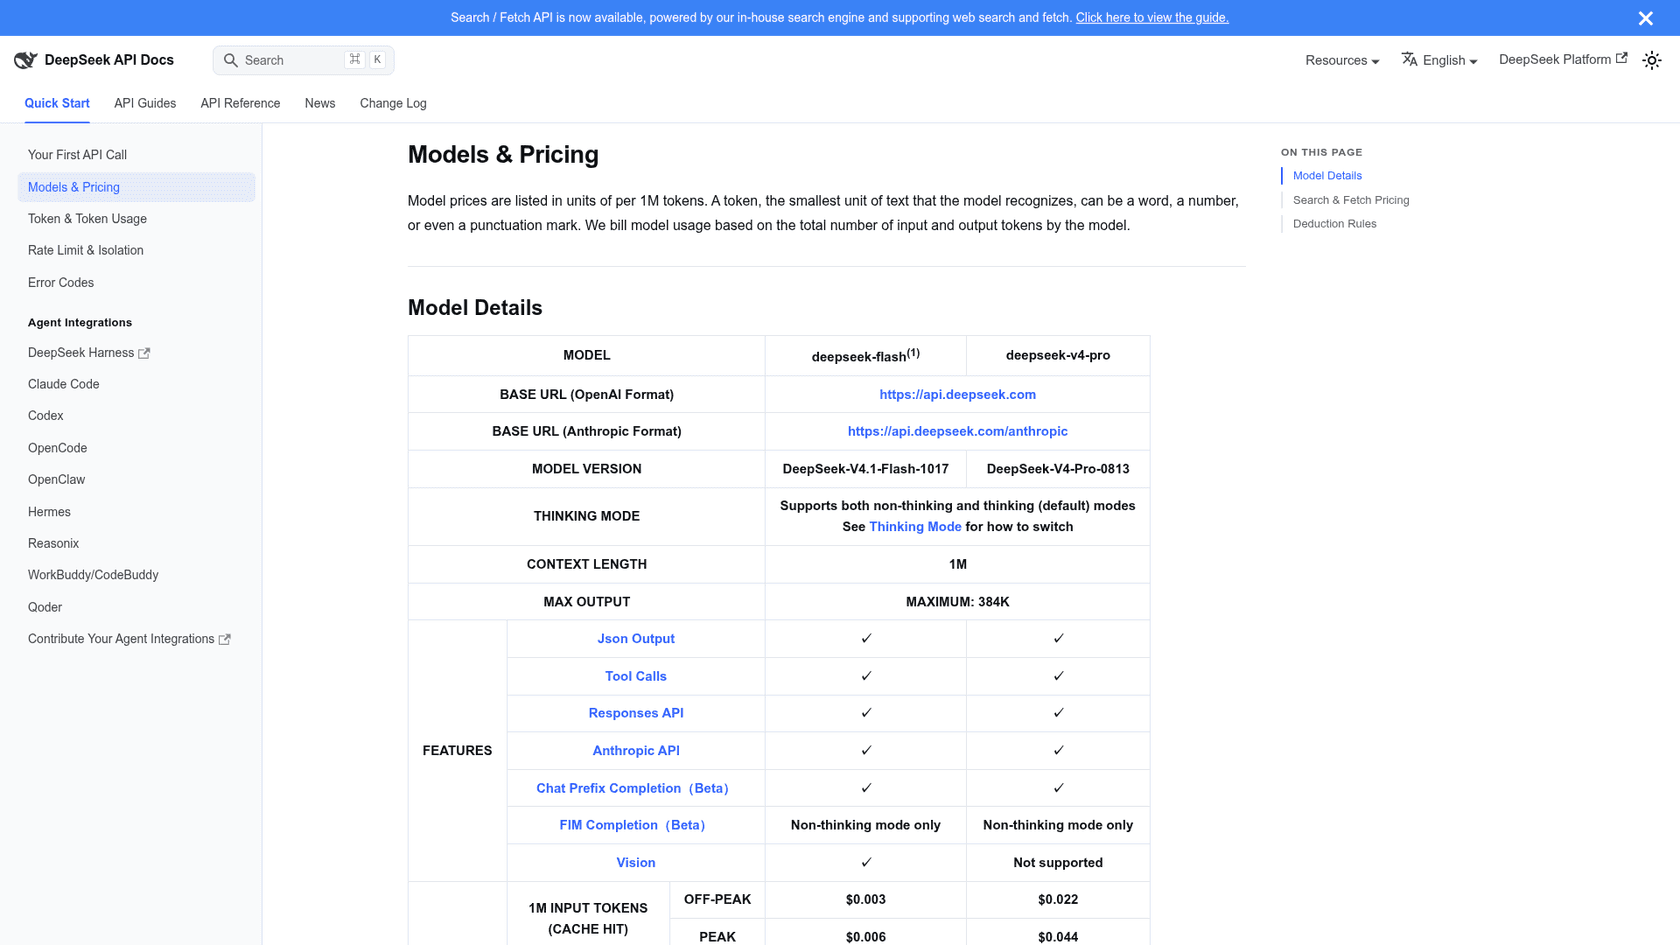
DeepSeek V4.1 Flash es el único modelo de esta lista con pesos abiertos, lo que importa si tus datos no pueden salir de tus propios servidores. En la API funciona a $0,15 de entrada y $0,60 de salida en horas valle, con las horas punta (01:00 a 04:00 y 06:00 a 10:00 UTC entre semana) al doble, según la página de precios de DeepSeek.
Puntúa 32,5 en el índice de Artificial Analysis con esfuerzo máximo por $0,60 por tarea, y su tasa de alucinación es del 64%. Es un caballo de batalla capaz y barato, no un modelo de la clase de Carbon, y necesita una guía firme.
"I use DeepSeek too but it's more of a workhorse model, requires a lot more guiding and sometimes struggles to get where I want it."
Pros
- Pesos abiertos, así que puedes autoalojarlo.
- La factura de API más barata de esta lista cercana a la frontera, con aciertos de caché a $0,003 por millón en horas valle.
- 1M de contexto, 384K de salida máxima, tool calls y visión.
Contras
- Puntuación mucho más baja que Carbon (32,5 frente a 59,4).
- 64% de respuestas inventadas, así que debe basarse en tus contenidos.
- El precio en horas punta duplica el coste en las mañanas laborables de Asia y Europa.
Precios
| Por 1M de tokens | Horas valle | Horas punta |
|---|---|---|
| Entrada, acierto de caché | $0.003 | $0.006 |
| Entrada, fallo de caché | $0.15 | $0.30 |
| Salida | $0.60 | $1.20 |
Las APIs Search y Fetch de DeepSeek cuestan $0,75 por 1.000 solicitudes, con la facturación de llamadas a herramientas del lado del servidor a partir del 1 de noviembre de 2026. Mi artículo sobre los precios de DeepSeek V4.1 Flash cubre el calendario de horas punta.
Mi opinión: elígelo cuando el autoalojamiento o el coste por token sea la restricción. No lo elijas como sustituto de Carbon en calidad. Mira mi reseña de DeepSeek V4.1 Flash.
7. GPT-6 Luna
Mejor para: un modelo barato de primera pasada que clasifica y responde los tickets fáciles antes de que un modelo más potente vea el resto.
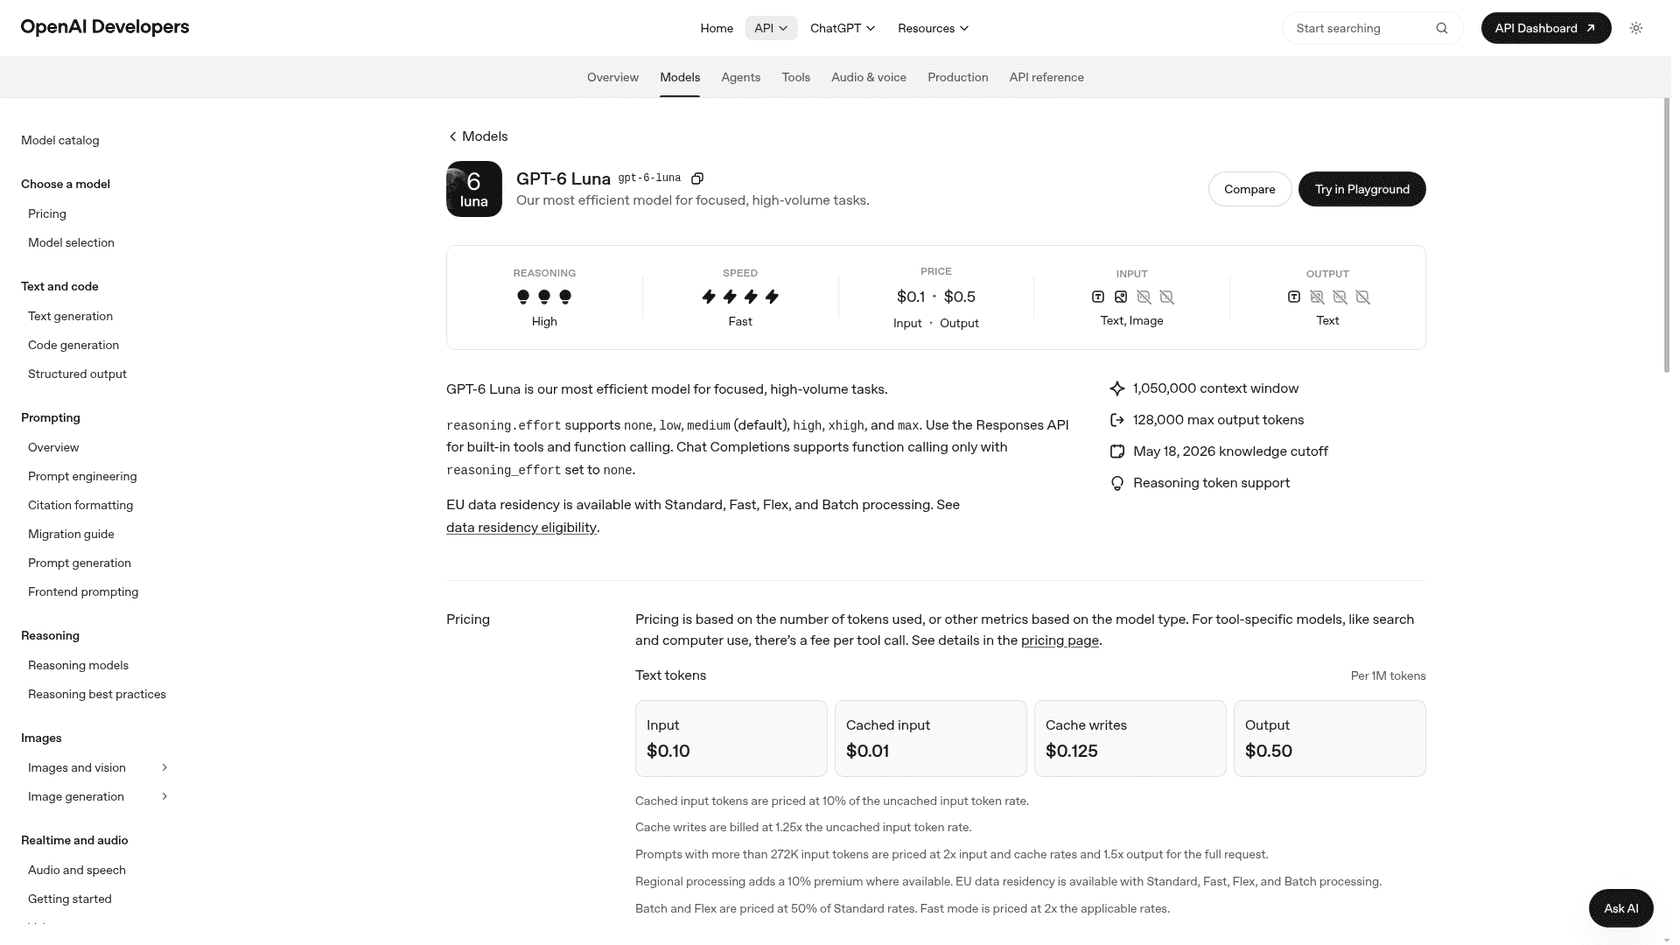
Luna es la cuarta elección de ChatGPT, para "high-volume, repetitive requests". OpenAI lo llama su "most efficient model for focused, high-volume tasks", y a $0,10 de entrada y $0,50 de salida por millón de tokens es 20 veces más barato que el precio de lanzamiento de Carbon.
Por sí solo no es un sustituto de Carbon. Luna puntúa 27,8 en el índice de Artificial Analysis con esfuerzo máximo por $0,15 por tarea, e inventó respuestas el 79% de las veces en AA-Omniscience. Su trabajo es el triaje: etiquetar el ticket, responder la pregunta sobre el estado de un pedido con tus datos y pasar todo lo demás a un nivel superior.
Pros
- El más barato por tarea de esta lista.
- Rápido, con una ventana de 1.050.000 tokens.
- La misma API que Sol, así que enrutar entre ambos es sencillo.
Contras
- La tasa más alta de respuestas inventadas aquí (79% con esfuerzo máximo).
- No apto para nada que requiera criterio.
- Solo salida de texto.
Precios
| Modo (por 1M de tokens) | Entrada | Salida | Entrada en caché |
|---|---|---|---|
| Estándar | $0.10 | $0.50 | $0.01 |
| Batch / Flex | $0.05 | $0.25 | $0.005 |
| Fast | $0.20 | $1.00 | $0.02 |
De la página de precios de OpenAI. Si quieres un modelo de triaje barato con menos respuestas inventadas, Claude Haiku 5.5 cuesta lo mismo, $0,10/$0,50, para prompts de hasta 100K tokens y obtuvo una tasa de alucinación del 34% con esfuerzo máximo.
Mi opinión: usa Luna (o Haiku 5.5) como primera capa barata, nunca como único modelo. Más en mi desglose de precios de GPT-6 Luna.
¿Y si necesitabas Carbon para trabajo real de seguridad?
Entonces no te conformes con un modelo general, solicita un programa restringido, porque los modelos generales bloquean parte del trabajo cibernético a propósito. Hay tres vías:
| Vía | Modelo que obtienes | Cómo entrar | Coste |
|---|---|---|---|
| Google Fairwind | Gemini 4 Carbon | Formulario de interés, verificación de antecedentes, más de 650 socios hasta ahora | $2/$10 de intro de Carbon, luego $4/$20 |
| OpenAI Daybreak | GPT-5.6-Cyber y niveles de acceso de Daybreak | Solicitud; OpenAI ofrece $1.000 millones en créditos de Daybreak para defensores | $12.50 / $75 por 1M para gpt-5.6-cyber en la tarifa de OpenAI |
| Anthropic Cyber Verification Program | Claude Opus 5.5, Sonnet 5.5 y Mythos 5.1 con menos bloqueos cibernéticos | Una solicitud por organización; decisión en siete días hábiles | Precios estándar de la API de Claude |
El programa de Anthropic es el más fácil de conseguir de los tres. Su actualización de octubre de 2026 añadió tres niveles de acceso y llama a Opus 5.5 su "most capable cyber model yet". Investigadores independientes, mantenedores y cazadores de recompensas por bugs pueden solicitarlo como individuos, aunque por ahora los individuos solo obtienen el nivel Defense. Mi artículo sobre las alternativas a GPT-5.6-Cyber compara estos programas con más profundidad.
No a todos les gusta la restricción:
"Too bad you won't be able to use it to secure your open-source projects. If you try it'll throw up a prompt telling you to use some initiative you can't use or afford while the provider collects the findings."
Para las tareas rutinarias de seguridad puede que no necesites ningún programa. Anthropic dice que sus modelos de disponibilidad general siguen pudiendo usarse para revisión segura de código, modelado de amenazas, parcheo de problemas conocidos y triaje de alertas de seguridad.
¿Qué alternativa a Gemini 4 Carbon deberías elegir?
Parte de para qué querías Carbon. El mapa de abajo es cómo enrutaría yo la decisión.
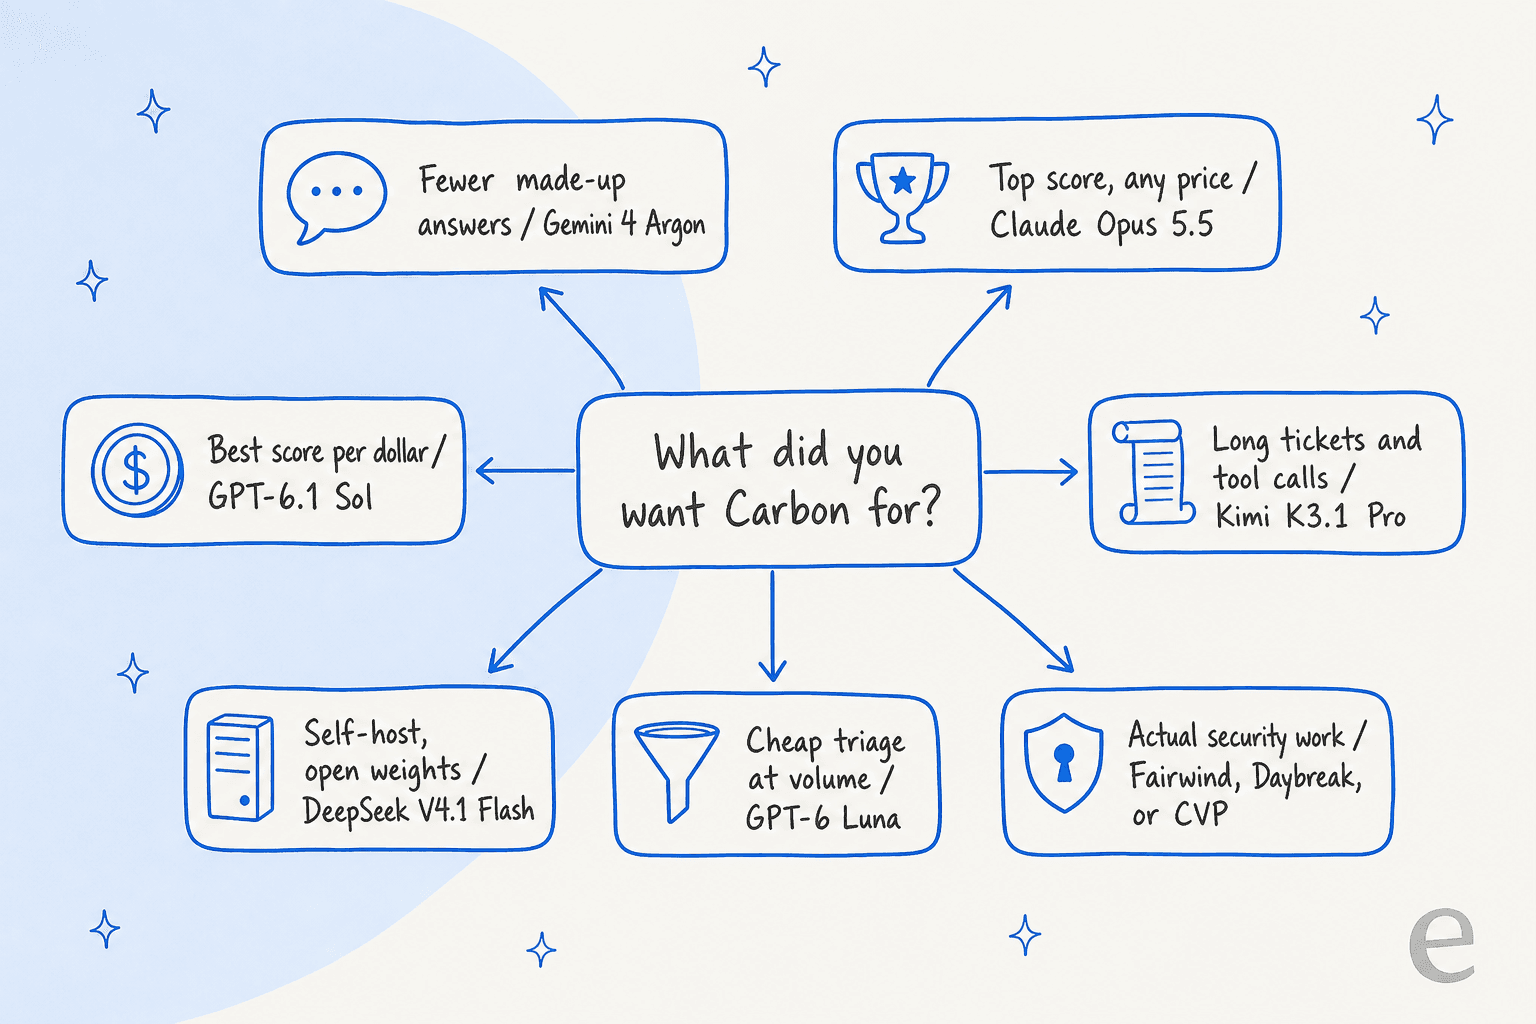
Para la mayoría de los lectores la respuesta honesta es un par de modelos, no uno. La sugerencia de dos modelos de ChatGPT es acertada: un modelo barato como Luna o Haiku 5.5 se encarga del trabajo fácil y de alto volumen, y uno más potente (Argon, Sol o Sonnet 5.5) de los casos difíciles. Como cinco de estos modelos cuestan lo mismo por token, la elección del modelo más potente se reduce al coste por tarea y a la tasa de respuestas inventadas, no a la tarifa.
Y una cosa para decir con claridad: la brecha entre Carbon y Argon en una cola de soporte es menor que la brecha entre un agente con grounding y uno sin él. Todos estos modelos inventan respuestas cuando les preguntas algo que tu documentación no cubre. La solución es la capa que rodea al modelo, que es la parte en la que yo trabajo.
¿Cómo se traduce esta elección en un agente de soporte real?
En eesel, el modelo es solo un ajuste. El trabajo que decide si los clientes reciben respuestas correctas es lo que lee el compañero de IA y lo que se le permite hacer. Cuando un equipo conecta su helpdesk, el agente aprende de sus tickets anteriores, su centro de ayuda y sus documentos internos, sigue reglas escritas sobre qué pasar a una persona, y se simula con tickets históricos antes de responder a nadie en vivo.
Dos clientes en Freshdesk muestran cómo se ve. Qontro, una empresa de software ERP, recibe un borrador de respuesta con artículos de ayuda ya enlazados en cada ticket de Freshdesk, redactó 190 tickets en un mes y responde a partir de 9.800 tickets anteriores y artículos de ayuda. SamCart ejecuta un agente por canal, uno en los tickets de Freshdesk y otro en el chat de su web, con un plan dimensionado para 8.000 interacciones al mes.
Ninguno necesitó un modelo de seguridad de frontera. Necesitaron un agente que diga "voy a buscar a una persona" en lugar de adivinar. Si estás comparando modelos para una cola de soporte, mi guía del mejor modelo para tickets de soporte profundiza en ese equilibrio, y también el artículo sobre LLMs para atención al cliente.
Prueba eesel
Si has llegado aquí porque querías Carbon dentro de un agente de soporte, eesel es el camino más corto. Es un compañero de helpdesk con IA que se conecta a Freshdesk, Zendesk y otros helpdesks, aprende de tus tickets anteriores y tu centro de ayuda, y se prueba con tu propio historial de tickets antes de responder a un cliente. Tienes resuelta la elección del modelo y el grounding que evita que cualquiera de estos modelos se invente cosas.
Puedes ver los planes en la página de precios de eesel, o prueba eesel gratis con tus propios tickets.