

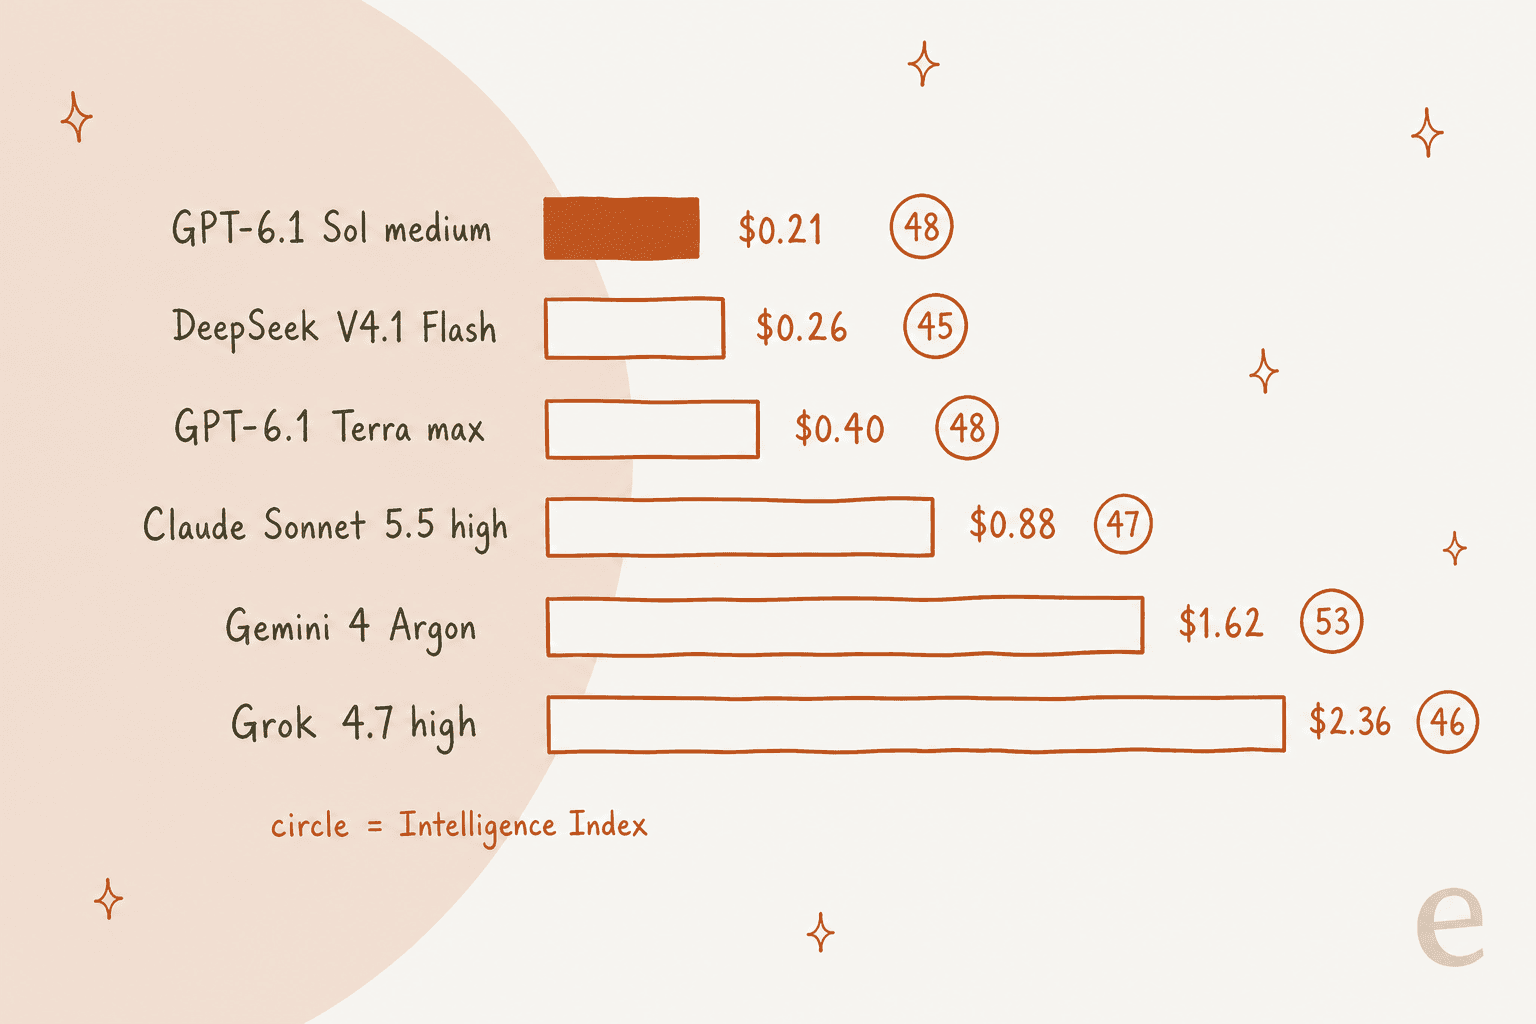
La mejor alternativa a GPT-6.1 Terra para la mayoría de los equipos es GPT-6.1 Sol con esfuerzo medio, lo cual suena al revés porque Sol cuesta el doble por token. Por tarea, se invierte: Artificial Analysis puntúa a Sol medium con 47.8 por $0.21 la tarea, mientras que Terra en max puntúa 48.1 por $0.40. Si ibas a subir Terra a esfuerzo máximo, cambia de modelo en su lugar.
Si quieres salir de OpenAI: Claude Sonnet 5.5 para programación y agentes ($2/$10), DeepSeek V4.1 Flash para la factura más baja ($0.15/$0.60 en valle, pesos abiertos) y Gemini 4 Argon para el razonamiento más difícil, con un precio promocional que se duplica el 1 de diciembre. En un mes de 1 millón de solicitudes, la factura a precio de lista va de $480 con DeepSeek a $7,000 con Sol o Sonnet, frente a $3,500 con Terra.
Si el modelo es para una cola de soporte, el modelo importa menos de lo que crees. En mi reseña de GPT-6.1 Terra, Terra acertó 15 de 16 tickets frente a los 16 de Sol, y el único fallo fue una regla de escalado, no de inteligencia. Esa regla vive en la capa que gestiona eesel, como la ejecuta Koffer.ch en Freshdesk con cada respuesta como borrador.
¿Por qué mirar más allá de GPT-6.1 Terra?
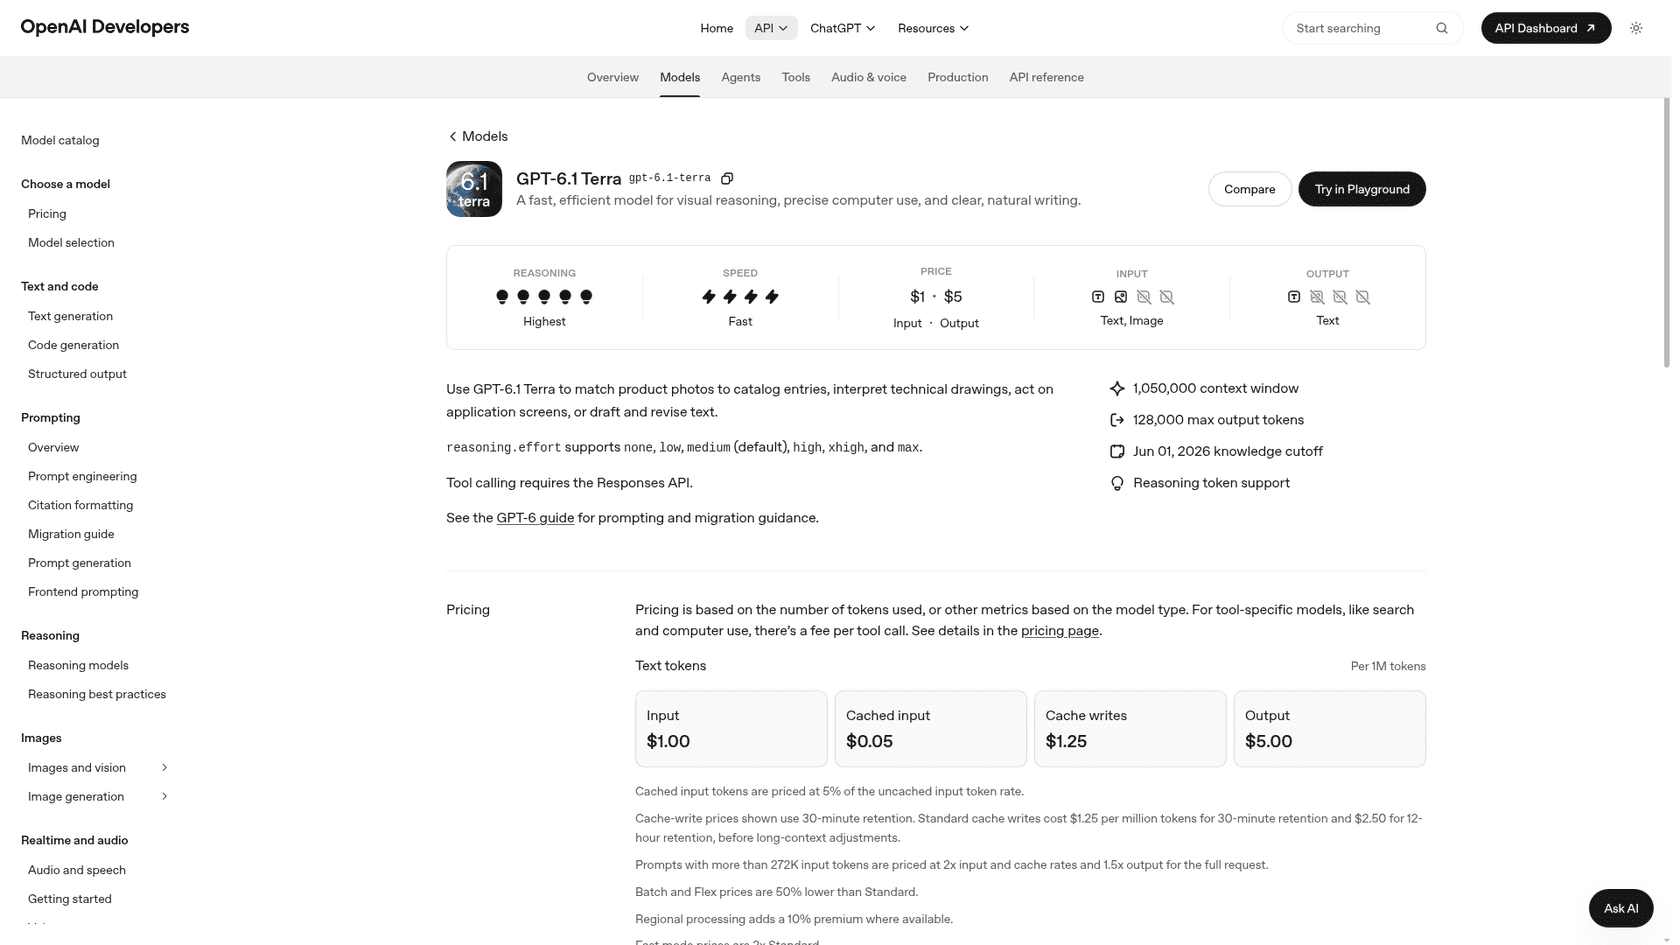
Lo digo primero: Terra es un buen modelo. GPT-6.1 Terra salió el 26 de octubre de 2026 a $1 por millón de tokens de entrada y $5 por millón de salida. Tiene una ventana de contexto de 1,050,000 tokens, además de un nivel de razonamiento none que Sol y Astra no tienen. Con mis propios tickets de soporte fue el modelo más rápido que probé, con 2.5s a 3.1s cada uno.
Aun así, la gente busca otra cosa, y suele reducirse a esto:
- Se encarece cuando lo subes. El Intelligence Index de Terra pasa de
36.2con esfuerzo bajo a48.1en max. Pero el coste por tarea sube de$0.05a$0.40, y el tiempo por tarea de29sa384s, según Artificial Analysis. Si lo llevas al máximo, pagas precio de Sol por algo que no es Sol. - La programación y el trabajo en terminal quedan por detrás de los modelos más grandes. Terminal-Bench 4.0 salió una y otra vez en el hilo de lanzamiento de Hacker News. Un comentarista situó a Terra en max en el 50 %, y a Claude Opus 5.5 en el 70 %.
- Riesgo de depender de un solo proveedor. Cuando todo tu producto descansa en un único modelo de OpenAI, su cambio de precio o su caída pasan a ser también tuyos.
Un comentario escéptico resume bastante bien el punto 1:
"Terra XHigh more expensive than Sol Low and still does worse."

Y esta es la frase que conviene tener presente al leer cada tabla de abajo:
"Per token, yes. But per task it's not even necessarily the case depending on how much thinking is needed."
Cómo elegí y puse precio a estas opciones
Construyo los agentes de IA que trabajan en los helpdesks de los clientes de eesel, y fui yo quien ejecutó la evaluación de Terra con 80 tickets para mi reseña. Años con colas en vivo me enseñaron que el precio por token es lo que no hay que medir. La mitad de precio con el doble de reintentos no te ahorra nada en producción. Así que juzgué cada opción de abajo con estos criterios:
- Precio de lista por 1M de tokens, obtenido el 28 de octubre de 2026 de la página de precios de cada proveedor.
- Coste por tarea e Intelligence Index de Artificial Analysis. Ejecuta una misma batería de pruebas en todos los modelos y registra lo que cada uno gastó realmente.
- Una factura mensual para un comprador: imagina un producto que envía 1 millón de solicitudes al mes, cada una con 2.000 tokens de entrada y 300 de salida. Eso suma 2.000 millones de tokens de entrada y 300 millones de salida, sin contar caché ni tokens de razonamiento.
También le hice esta pregunta a ChatGPT como la haría un comprador. Su lista corta fue Sonnet 5.5, Gemini 3.6 Flash, DeepSeek V4.1 Flash, Gemini 4 Argon y Grok 4.7. La mayoría se quedó. Cambié Gemini 3.6 Flash por 3.8 Flash (mismo precio, modelo más nuevo) y añadí Sol y Haiku 5.5, que ChatGPT omitió.
Alternativas a GPT-6.1 Terra comparadas
| Modelo | Entrada / salida por 1M | Entrada en caché | Contexto | AA Intelligence Index | AA coste por tarea | Tiempo al primer token | Pesos abiertos | Factura mensual (comprador de ejemplo) |
|---|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra (base) | $1 / $5 | $0.05 | 1.05M | 48.1 (max) | $0.40 | 1.3s (low) | No | $3,500 |
| GPT-6.1 Sol | $2 / $10 | $0.10 | 1.05M | 47.8 (medium) | $0.21 | 4.4s | No | $7,000 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | 1M | 46.8 (high) | $0.88 | 3.1s (medium) | No | $7,000 |
| DeepSeek V4.1 Flash | $0.15 / $0.60 en valle | $0.003 | 1M | 45.1 (max) | $0.26 | 1.2s | Sí | $480 (valle) |
| Gemini 3.8 Flash | $0.75 / $3.75 hasta el 31 dic. | $0.075 | 1M | 40.9 (high) | $3.49 | 28.3s (high) | No | $2,625 |
| Gemini 4 Argon | $2 / $10 hasta el 30 nov. | $0.10 | 1M | 52.6 (high) | $1.62 | 48.2s | No | $7,000 |
| Grok 4.7 | $2 / $6 | n/d | 500K | 46.3 (high) | $2.36 | 5.4s (low) | No | $5,800 |
| Claude Haiku 5.5 | $0.10 / $0.50 hasta 100K de prompt | $0.01 | 1M | 37.8 (high) | $0.08 | 26.7s (high) | No | $350 |
Destacan dos cosas. DeepSeek V4.1 Flash cuesta unas 7 veces menos que Terra en factura y queda a menos de 3 puntos en el índice. Luego está Gemini 3.8 Flash: barato por token, pero de los más caros por tarea, porque piensa mucho antes de responder. El índice, el coste por tarea y los tiempos al primer token proceden de las páginas de modelos de Artificial Analysis, con el esfuerzo indicado entre paréntesis.
1. GPT-6.1 Sol
Ideal para: equipos que ya usan la API de OpenAI y necesitan mejor criterio sin cambiar una línea de código de integración.
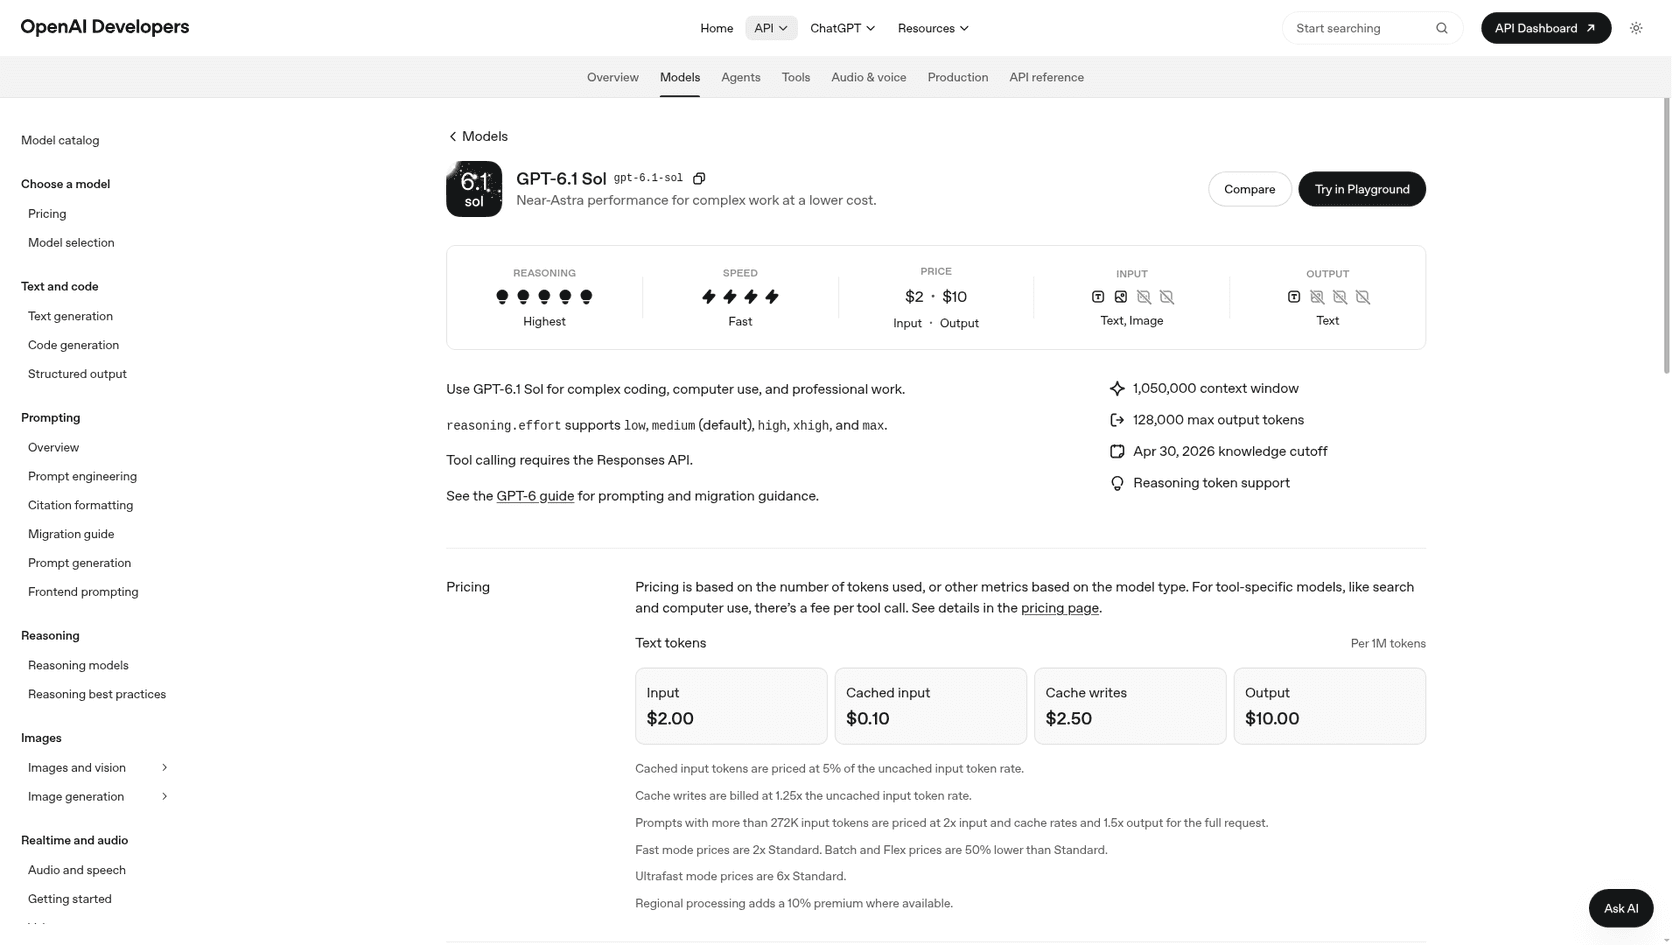
Piensa en Sol como el hermano mayor de Terra. Está un peldaño más arriba en la escalera de OpenAI, entre Terra y GPT-6 Astra. La API, las herramientas y la generación gpt-6.1 son las mismas, así que cambiar solo significa cambiar el nombre del modelo.
Ventajas
- Sol con esfuerzo medio iguala a Terra en max en el índice de Artificial Analysis, por aproximadamente la mitad del coste por tarea (
$0.21frente a$0.40). - En mi prueba de soporte su criterio fue el mejor: 16 de 16. También fue la única configuración que escaló un cambio de dirección en español que no podía hacer.
- AA sitúa su tasa de alucinación con esfuerzo alto en
49%, frente a38%de Terra en max. Así que no es el modelo más cuidadoso con los hechos. Donde gana es en las decisiones de casos límite.
Inconvenientes
- Es más lento. AA mide unos
54tokens de salida por segundo en medium frente a los91de Terra, y un primer token de4.4sfrente a1.3sde Terra en low. - Las solicitudes cortas y fáciles cuestan más en Sol. Mi prueba salió a
$1.62por 1.000 tickets, frente a$0.75de Terra en low. - No hay esfuerzo
none, lo que significa que no hay vía rápida sin razonamiento.
Precio: $2 de entrada, $0.10 en caché, $10 de salida por 1M de tokens en la página de precios de OpenAI. El modo por lotes lo reduce a la mitad, $1/$5.
Mi opinión: deja el 80 % fácil en Terra con low y enruta a Sol con medium todo lo que necesitaría esfuerzo alto. El camino de mejora desde Terra no es Terra en max, es Sol. Encontrarás los números completos en la reseña de GPT-6.1 Sol.
2. Claude Sonnet 5.5
Ideal para: herramientas de programación, agentes de terminal y uso de herramientas en varios pasos.
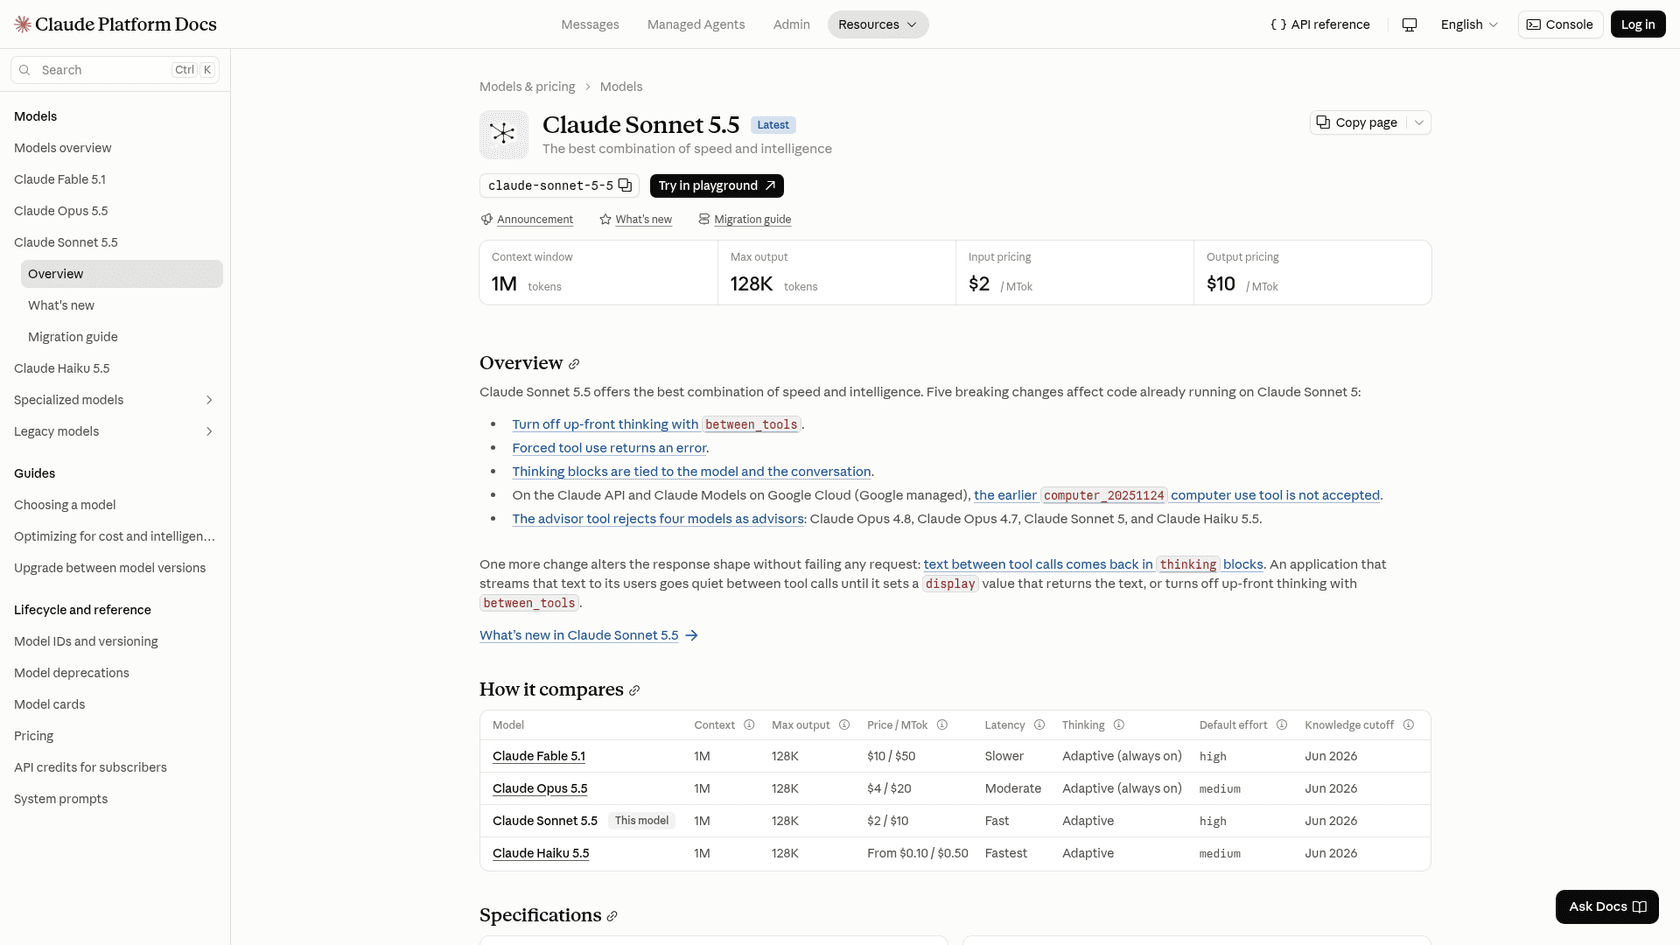
Este es el modelo de gama media de Anthropic, disponible desde el 28 de septiembre de 2026. ChatGPT lo llamó la "best first alternative to test", y para trabajo con agentes diría que acierta.
Ventajas
- Los mejores números de programación de su rango de precio. Anthropic informa de
70.6%en Terminal-Bench 4.0, por delante del66.4%de Opus 5.5, y de80.1%en OSWorld 2.1 para uso del ordenador. - Tiene el mismo precio que Sol,
$2/$10, y viene con una ventana de contexto de 1M y 128K de salida. - Primer token rápido con esfuerzo medio (
3.1sen AA) y unos107tokens de salida por segundo.
Inconvenientes
- Con esfuerzo alto cuesta
$0.88por tarea en AA. Es más de 4 veces Sol medium, con una puntuación de índice menor. - En AA su tasa de alucinación con esfuerzo alto es del
65%, la más alta entre los modelos cerrados de aquí. - Migrar no es indoloro:
thinking: disabledy untool_choiceforzado devuelven ambos un error 400 en Sonnet 5.5, así que el código creado para modelos Claude anteriores necesitará cambios.
Precio: $2 de entrada, $10 de salida, $0.10 por aciertos de caché, según la página de precios de Claude. El modo por lotes es $1/$5.
Mi opinión: si tu producto escribe o ejecuta código, o maneja un navegador durante largos periodos, elige Sonnet 5.5. Las tareas de texto corto como redacción y extracción rinden más por dólar en Terra o Sol. La reseña de Claude Sonnet 5.5 y la comparativa Sol vs Opus 5.5 profundizan más.
3. DeepSeek V4.1 Flash
Ideal para: chat de alto volumen, extracción y RAG donde la factura de tokens es la principal restricción, o donde quieres pesos que puedas alojar tú.
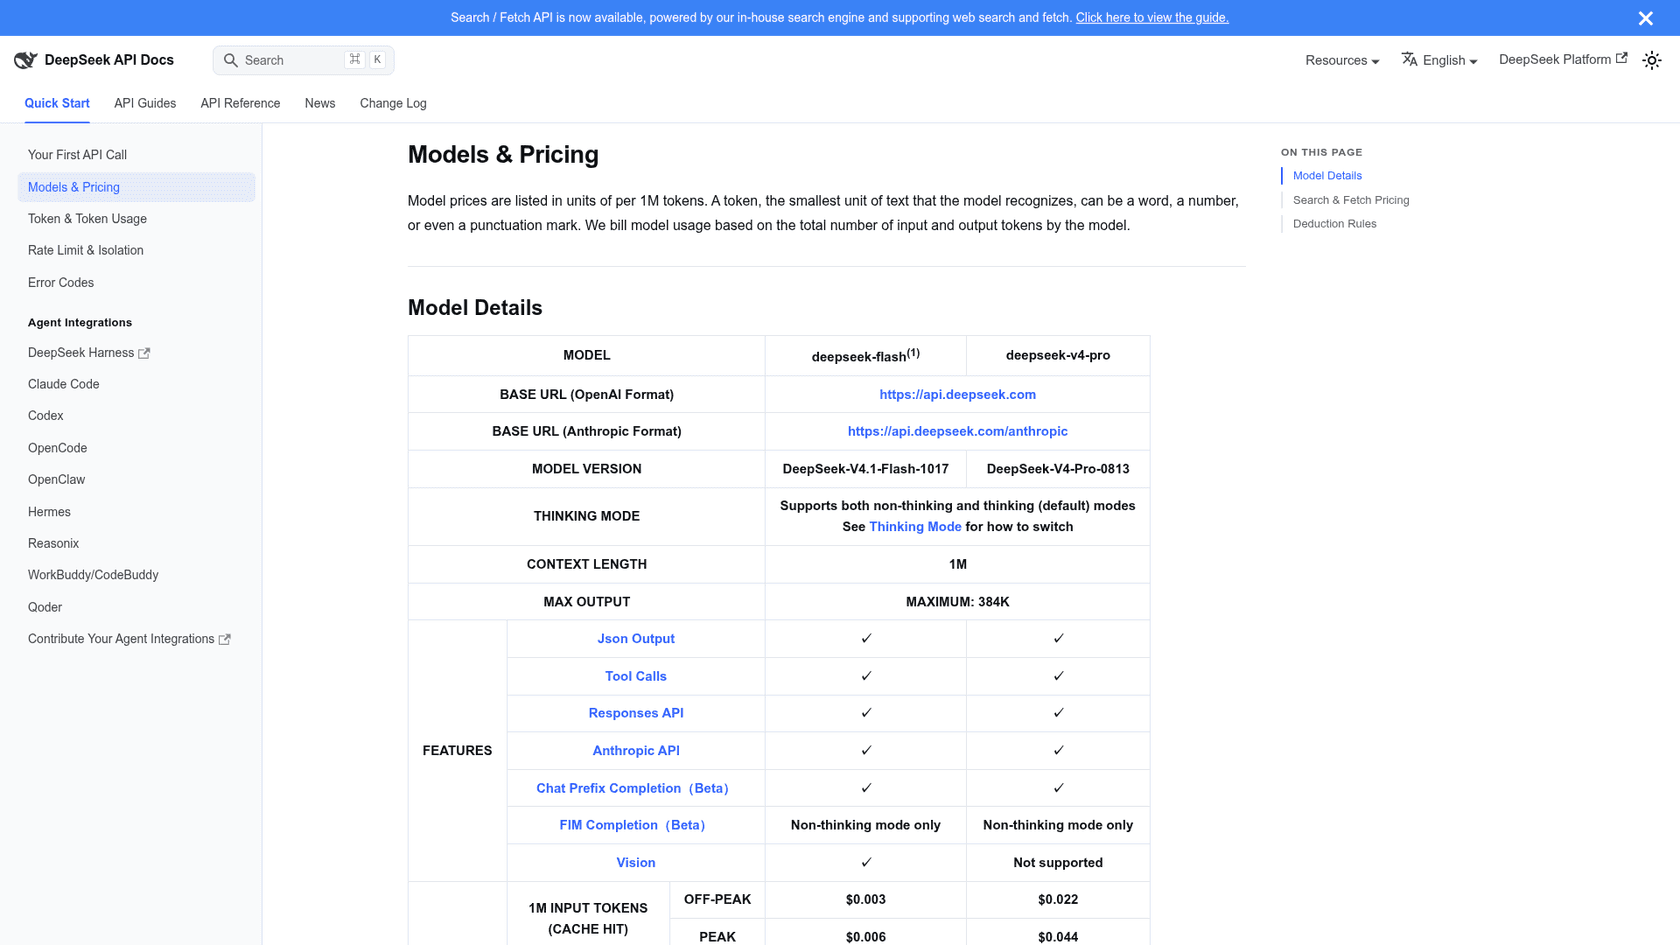
En la API, el nombre ahora es simplemente deepseek-flash, y lo sirve el checkpoint DeepSeek-V4.1-Flash-1017. Los nombres antiguos como deepseek-v4-flash siguen funcionando y se facturan al precio de Flash, según la documentación de precios de DeepSeek.
Ventajas
- De los modelos de aquí que puntúan por encima de 45, este tiene la factura más baja. El comprador de ejemplo paga
$480al mes en valle, frente a$3,500con Terra. - Los aciertos de caché cuestan
$0.003por 1M de tokens en valle, así que los prompts de sistema repetidos cuestan casi nada. - Los pesos son abiertos, así que puedes alojarlo tú cuando importe la residencia de datos. También lee imágenes, admite llamadas a herramientas y habla los formatos de API de OpenAI y de Anthropic.
- Tiene el primer token más rápido de aquí,
1.2sen Artificial Analysis.
Inconvenientes
- El precio en hora punta lo duplica todo a
$0.30/$1.20. Las horas punta van de 01:00 a 04:00 y de 06:00 a 10:00 UTC en días laborables, justo en la mañana laboral europea. - La tasa de alucinación de AA para el checkpoint 1017 en max es del
67%, así que mantenlo anclado a tus propios documentos. - Las llamadas de Search y Fetch del lado del servidor empiezan a facturarse a
$0.75por 1.000 solicitudes el 1 de noviembre de 2026.
Precio: $0.15 de entrada (fallo de caché), $0.003 por acierto de caché, $0.60 de salida en valle; $0.30, $0.006 y $1.20 en hora punta.
Mi opinión: para tráfico mayormente sencillo, y si te vale otro proveedor, DeepSeek es el cambio más barato que merece tomarse en serio. Un comentarista de HN resumió la división con claridad:
"If all I want is coding at a cheaper price, then deepseek is a good model for that."
La reseña de DeepSeek V4.1 Flash 1017 y la guía de la API de DeepSeek explican la configuración.
4. Gemini 3.8 Flash
Ideal para: trabajos multimodales por lotes (PDF, vídeo, audio) donde nadie espera la respuesta.
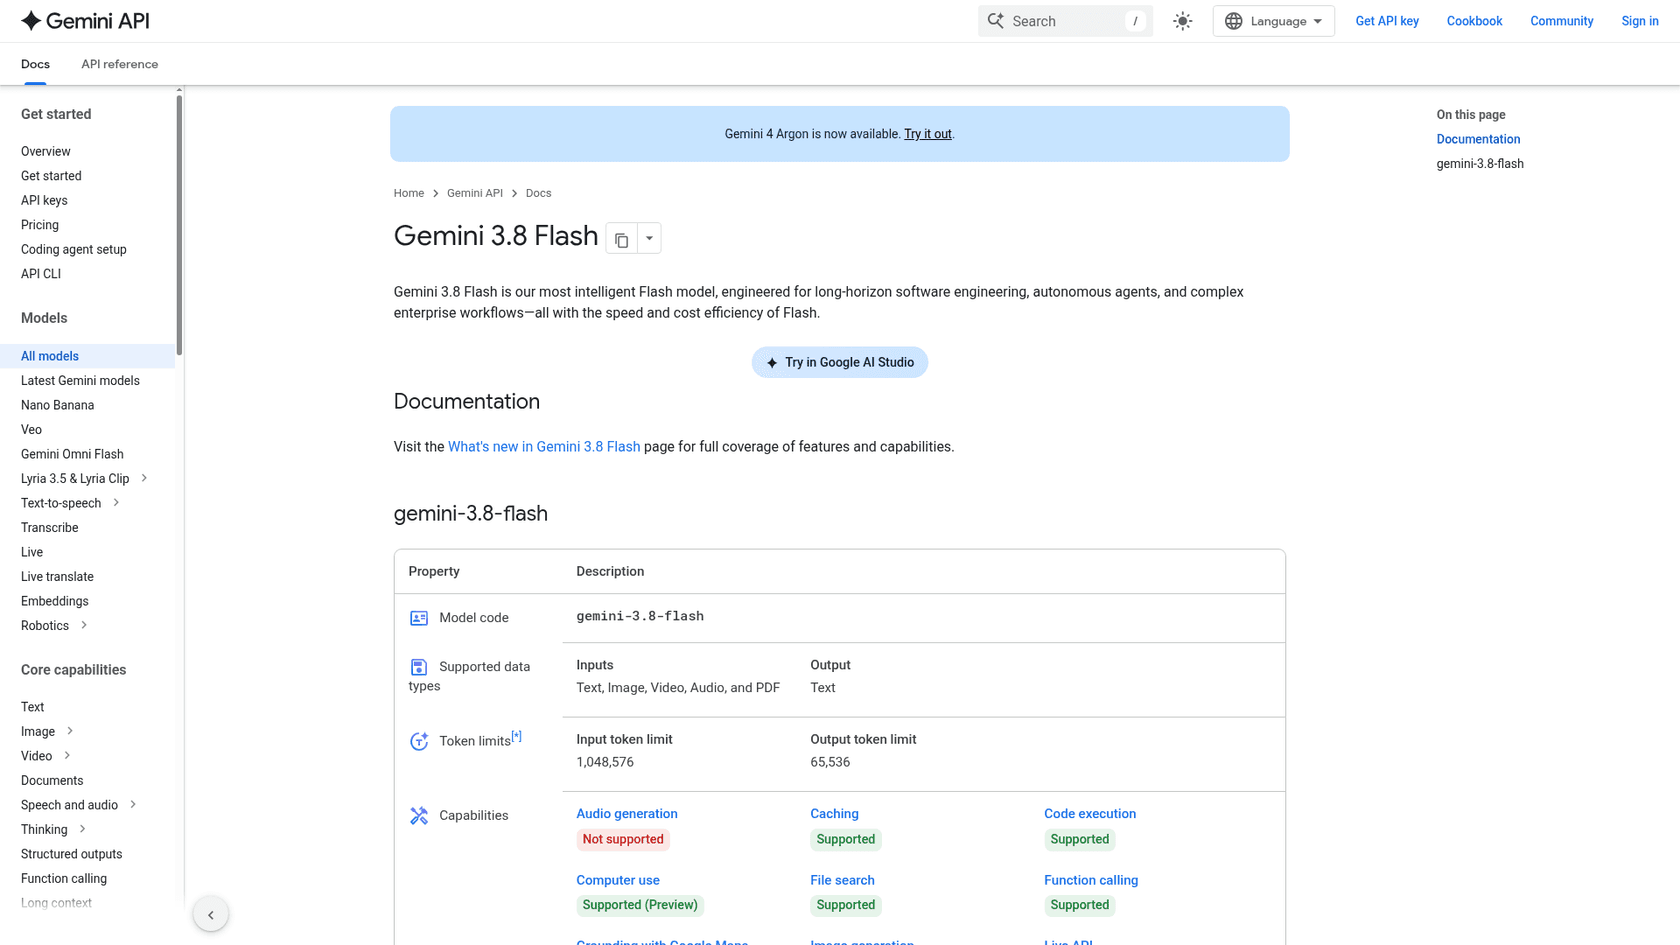
La elección de ChatGPT para este hueco fue Gemini 3.6 Flash. Pero en la página de precios de Gemini, 3.6 Flash y 3.8 Flash cuestan exactamente lo mismo, y Google ahora llama a 3.6 su "previous generation Flash model". Si vas a probar el nivel Flash de Google, prueba 3.8.
Ventajas
- Más barato por token que Terra hasta finales de 2026:
$0.75de entrada y$3.75de salida, lo que deja al comprador de ejemplo en$2,625. - Acepta entrada de texto, imagen, vídeo, audio y PDF, más amplia que cualquier otro modelo de aquí.
- Hay un nivel gratuito para probar, algo que Terra no ofrece.
Inconvenientes
- El 1 de enero de 2027 el precio se duplica a
$1.50/$7.50, quedando por encima de Terra por token. - Piensa mucho. AA lo sitúa en
$3.49por tarea y un primer token de28.3scon esfuerzo alto, lo que lo hace poco adecuado para una ventana de chat que alguien está mirando. - Las propias notas de lanzamiento de Google dicen que 3.8 Flash puede usar más tokens para maximizar el rendimiento. La reseña de Gemini 3.8 Flash tiene el detalle.
Precio: $0.75/$3.75 hasta el 31 de diciembre de 2026, después $1.50/$7.50. Batch y Flex cuestan la mitad.
Mi opinión: funciona bien para procesar documentos por la noche con precio por tokens. Para cualquier cosa interactiva, o que siga funcionando en enero, calcula primero el coste por tarea.
5. Gemini 4 Argon
Ideal para: el razonamiento más difícil, la investigación y los agentes autónomos largos, donde acertar la respuesta merece el precio.
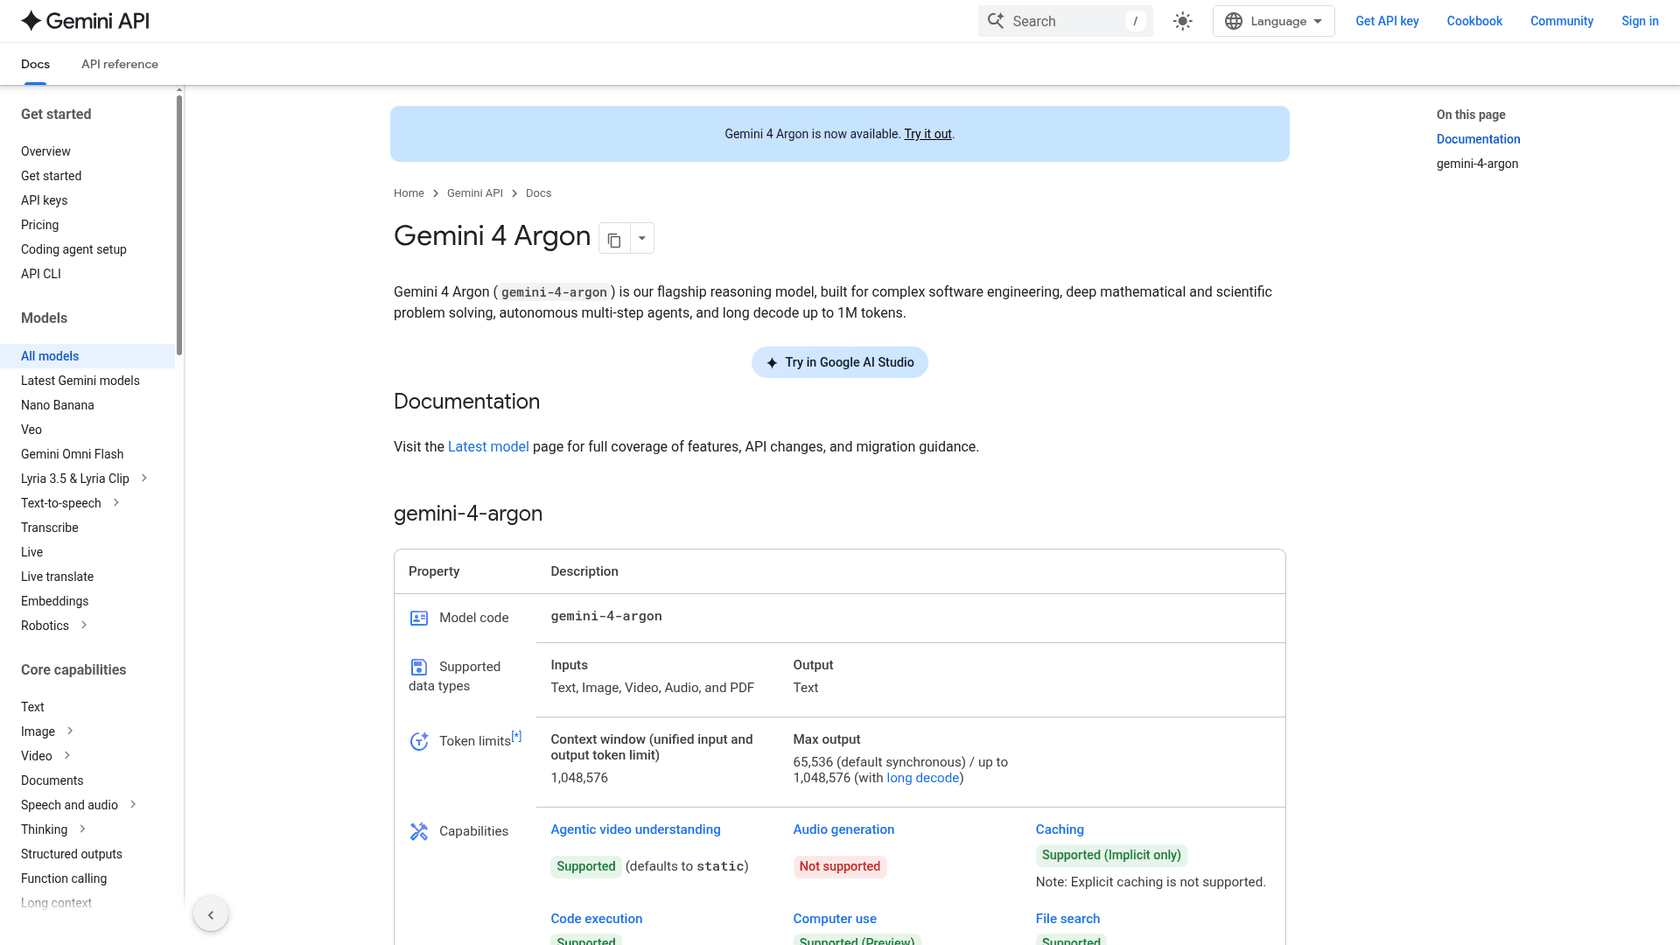
Este es el buque insignia de Google, lanzado el 30 de septiembre de 2026, y nada de esta lista puntúa más alto.
Ventajas
- El Intelligence Index más alto de aquí con
52.6, más de 4 puntos por encima de Terra en max, en Artificial Analysis. - Su tasa de alucinación en AA,
15%, es la más baja de esta lista, frente al38%de Terra en max. Si los datos erróneos son tu mayor riesgo, Argon es el modelo más seguro de aquí. - 1M de contexto y salidas largas.
Inconvenientes
- Ese precio de
$2/$10es solo una tarifa introductoria, que termina el 30 de noviembre. Desde el 1 de diciembre pasa a$4/$20, lo que duplica la factura del comprador de ejemplo de$7,000a$14,000. - Es lento, con un primer token de
48.2sy unos80tokens por segundo en AA. - No hay nivel gratuito, y el caché es solo implícito.
Precio: $2/$10 hasta el 30 de noviembre de 2026, luego $4/$20, según la página de precios de Gemini. La guía de precios de Gemini 4 Argon desglosa la promoción.
Mi opinión: trata a Argon como el especialista caro al que escala tu enrutador, no como un reemplazo de Terra para el tráfico diario. Y presupuesta con el precio de diciembre, no con el promocional. La reseña de Gemini 4 Argon tiene más.
6. Grok 4.7
Ideal para: añadir un cuarto proveedor independiente a tu comparativa, sobre todo para respuestas largas con mucha salida.
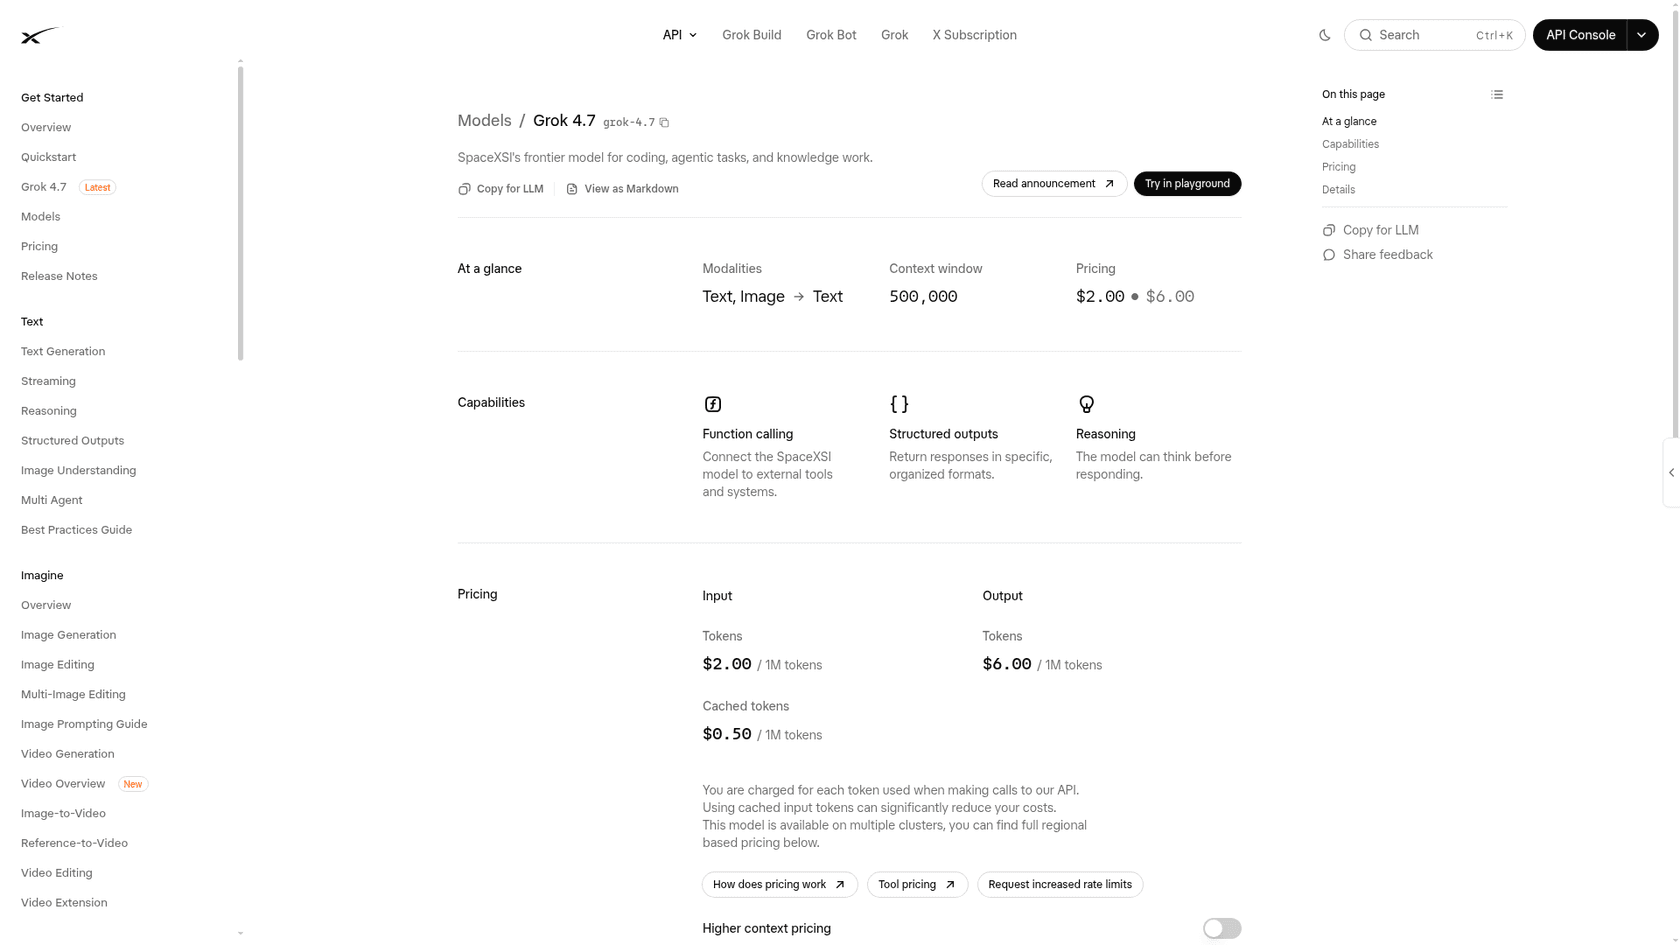
Este es el buque insignia de xAI, descrito en su página de modelos como "our flagship model for code and everything else".
Ventajas
- La salida es barata para un modelo de frontera:
$6por 1M frente a$10de Sol y Sonnet, lo que lleva al comprador de ejemplo a$5,800. - La tasa de alucinación de AA con esfuerzo alto es del
32%, menor que la de Terra en max. - El razonamiento es configurable, y hay herramientas de búsqueda web y de X del lado del servidor.
Inconvenientes
- Con 500K de tokens, tiene la mitad del contexto que todo lo demás de aquí.
- Es caro por tarea. AA lo sitúa en
$2.36con esfuerzo alto para un índice de46.3, la peor relación de esta lista. - El primer token tarda
45.7scon esfuerzo alto, aunque con esfuerzo bajo baja a5.4s.
Precio: $2 de entrada, $6 de salida por 1M en la documentación de xAI.
Mi opinión: se gana un hueco en una comparativa para no depender solo de los tres grandes. Con estos números, sin embargo, no lo elegiría antes que Sol o Sonnet. La reseña de Grok 4.7 entra en el resto.
7. Claude Haiku 5.5
Ideal para: etiquetado, enrutamiento y clasificación a gran volumen, donde nada va directo a un cliente.
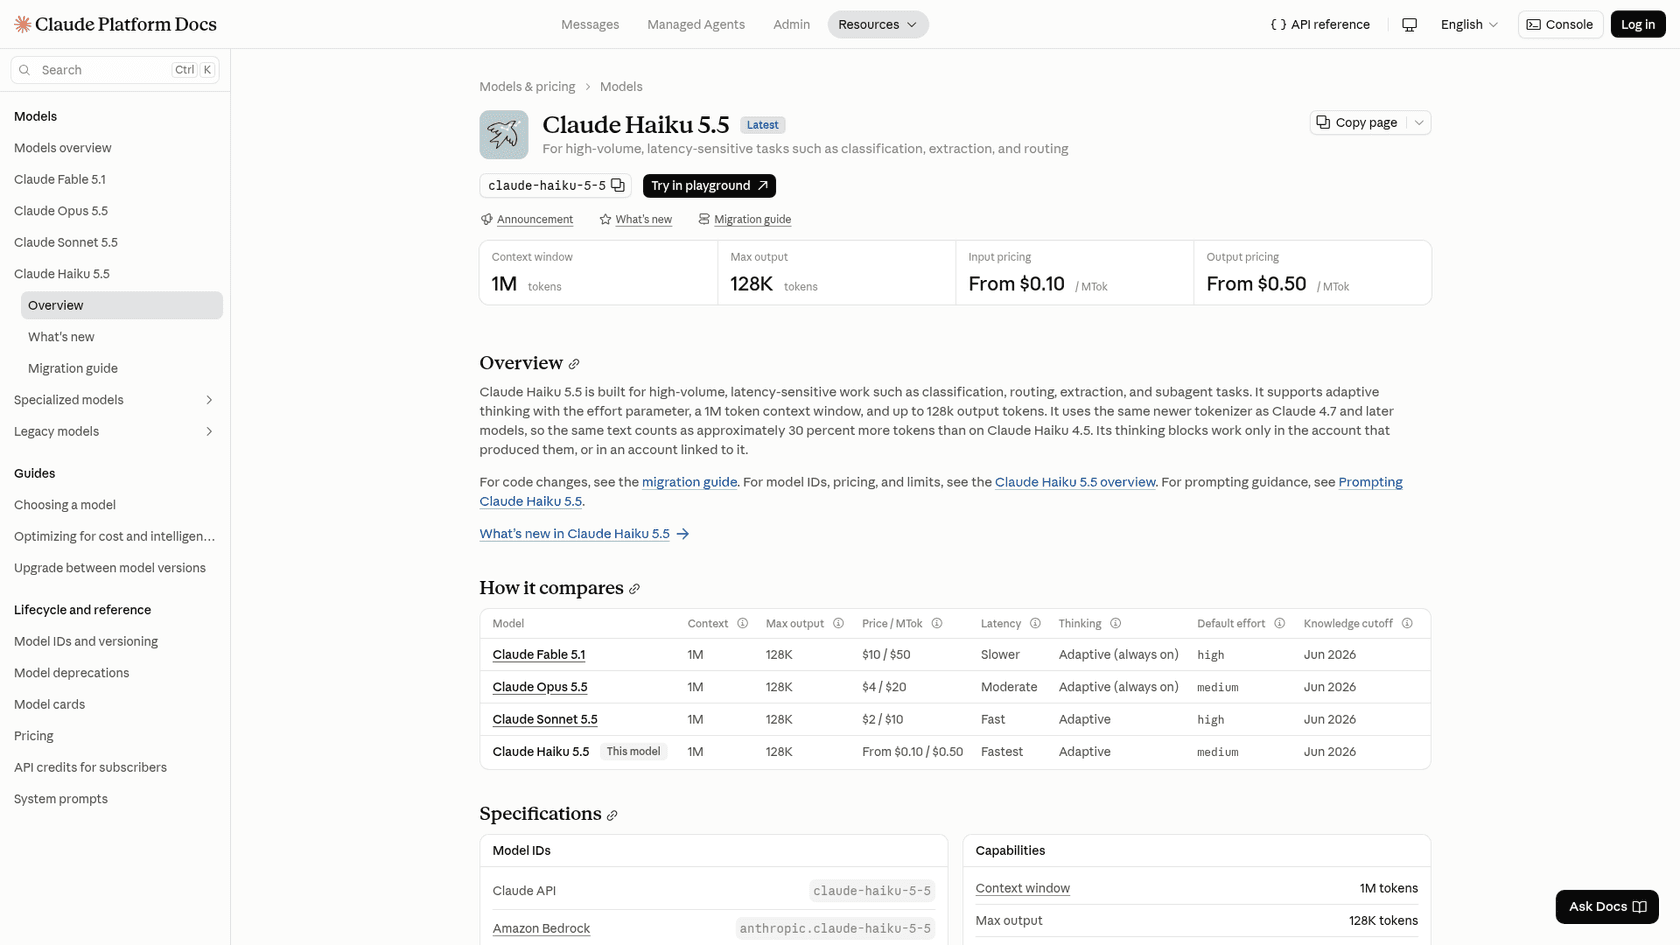
Cuando Terra es más modelo del que necesita el trabajo, baja un nivel en vez de moverte de lado. Claude Haiku 5.5 es el modelo pequeño de Anthropic, disponible desde el 7 de octubre de 2026, y está en el mismo precio de $0.10/$0.50 que GPT-6 Luna.
Ventajas
- El comprador de ejemplo paga
$350al mes, una décima parte de la factura de Terra. - AA le da
37.8con esfuerzo alto por$0.08la tarea, por delante de los32.9de Luna. - Corre a unos
185tokens de salida por segundo en AA.
Inconvenientes
- Cuando un prompt pasa de 100.000 tokens, pagas 5 veces más:
$0.50de entrada y$2.50de salida. Un usuario de HN lo llamó un modelo "destroyed by Anthropics crazy decision to price it x5 after 100k context" (rockdoe). - Queda
10puntos por debajo de Terra en el índice, así que trátalo como un nivel inferior y no como un reemplazo.
Precio: $0.10/$0.50 hasta prompts de 100K tokens, $0.50/$2.50 por encima, según la página de precios de Claude.
Mi opinión: Haiku 5.5 o Luna son una buena primera pasada barata en un enrutador. Solo mantén los prompts por debajo de 100K. La reseña de Claude Haiku 5.5 tiene sus benchmarks.
¿Qué alternativa a GPT-6.1 Terra encaja con tu producto?
Parte del trabajo, no de la clasificación. Un modelo puede leer bien una captura de pantalla y aun así hacer clic en el botón equivocado. Otro puede ser brillante en matemáticas y aun así sentirse lento en una ventana de chat.
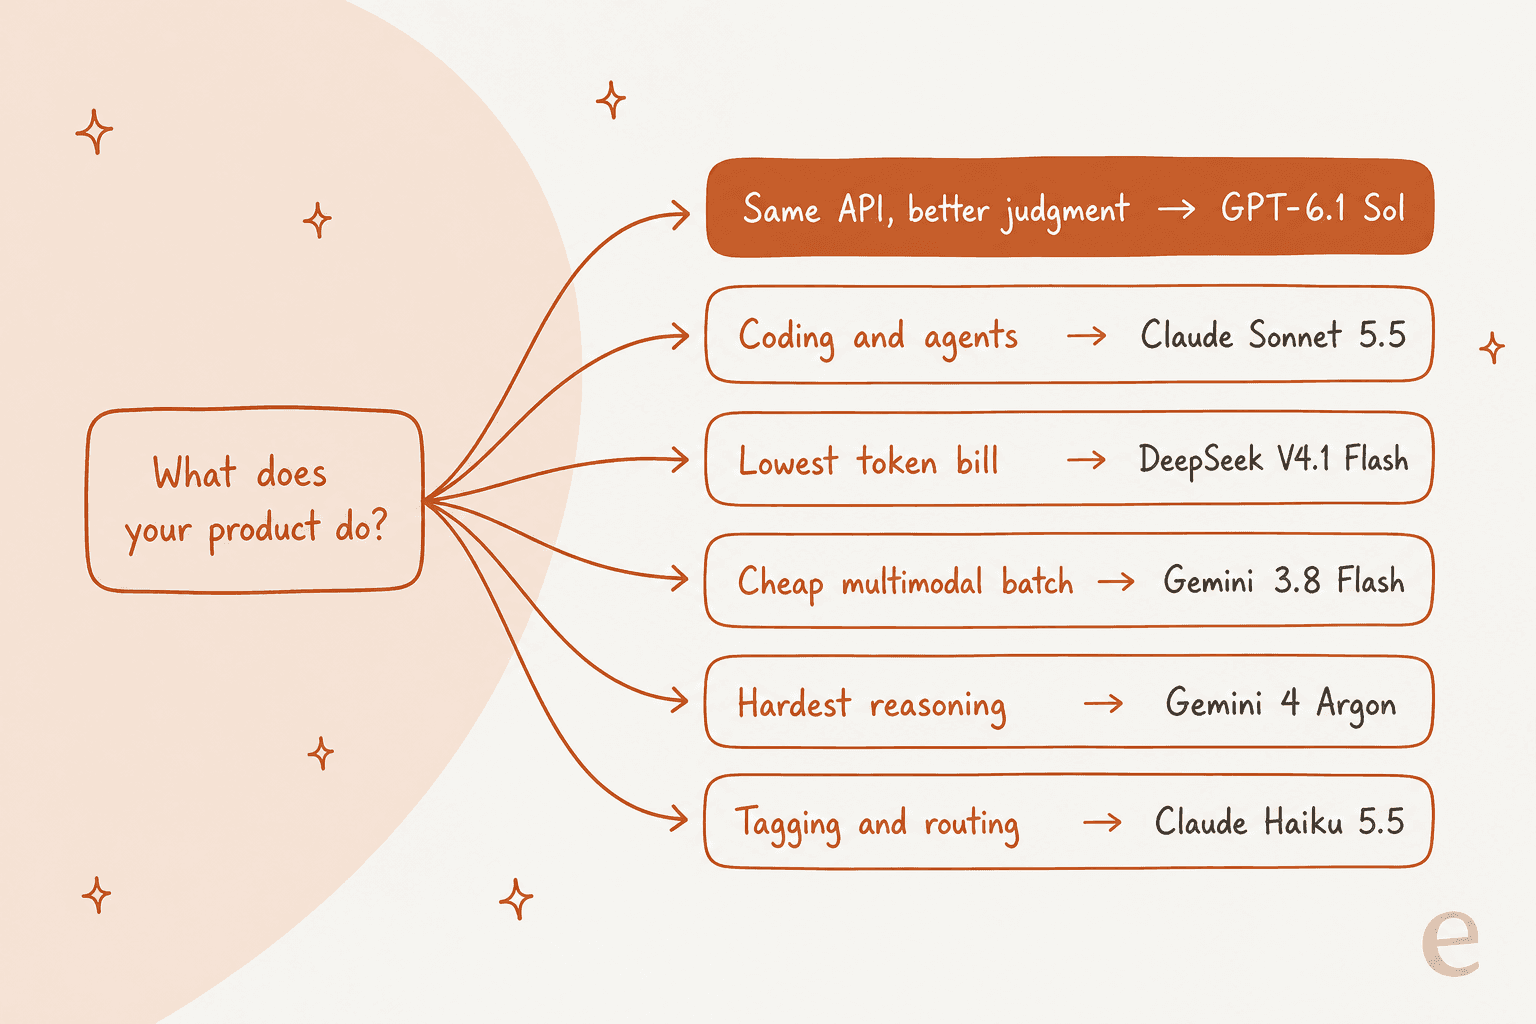
| Si tu producto sobre todo hace... | Prueba primero | Por qué |
|---|---|---|
| Borradores y chat de cara al cliente | Terra en low, Sol en medium | Primer token rápido, buena redacción y Sol para casos límite |
| Programación o agentes de terminal | Claude Sonnet 5.5 | 70.6% en Terminal-Bench 4.0 según Anthropic |
| Extracción o RAG de alto volumen | DeepSeek V4.1 Flash | $0.15/$0.60 en valle y pesos abiertos |
| Procesamiento de PDF, vídeo o audio por la noche | Gemini 3.8 Flash | Tipos de entrada más amplios, barato hasta 2027 |
| Investigación y el razonamiento más difícil | Gemini 4 Argon | Mejor índice de AA, menor tasa de alucinación |
| Etiquetado y enrutamiento | Claude Haiku 5.5 o GPT-6 Luna | $0.10/$0.50 |
| Alojamiento propio o sujeto a residencia de datos | DeepSeek V4.1 Flash, o Qwen 3.8 | Pesos que puedes ejecutar tú mismo |
Si nada de esto encaja, conviene conocer otros dos. Kimi K3.1 Pro puntuó 55.1 en AA pero es lento, con unos 46 tokens por segundo. Mistral Large 4 sigue en vista previa.
Cómo hacer una comparativa de modelos antes de cambiar
Un ranking muestra cómo rinde un modelo en la prueba de otro. Lo que necesitas es cómo rinde en la tuya. Este es el proceso que seguiría, con la misma forma que la evaluación de mi reseña de Terra:
- Saca de 100 a 500 solicitudes reales. Anonimízalas y deja las feas: erratas, dos preguntas en una, tiempos de espera de herramientas, una inyección de prompt.
- Elige tres retadores. Usa Terra como base y añade las dos o tres filas de la tabla de arriba que encajen con tu trabajo.
- Mide lo que sienten los usuarios. Tasa de éxito de la tarea, datos inventados, latencia
p50yp95, precisión de las llamadas a herramientas, reintentos y coste por tarea exitosa. - Califica a mano al principio. En la primera ejecución, lee tú mismo cada salida. Cuando confíes en la rúbrica, automatiza; las herramientas de evaluaciones de agentes de OpenAI ayudan con eso.
- Prueba un enrutador, no solo modelos sueltos. Envía todo a un modelo barato por defecto y escala los casos difíciles o inciertos.
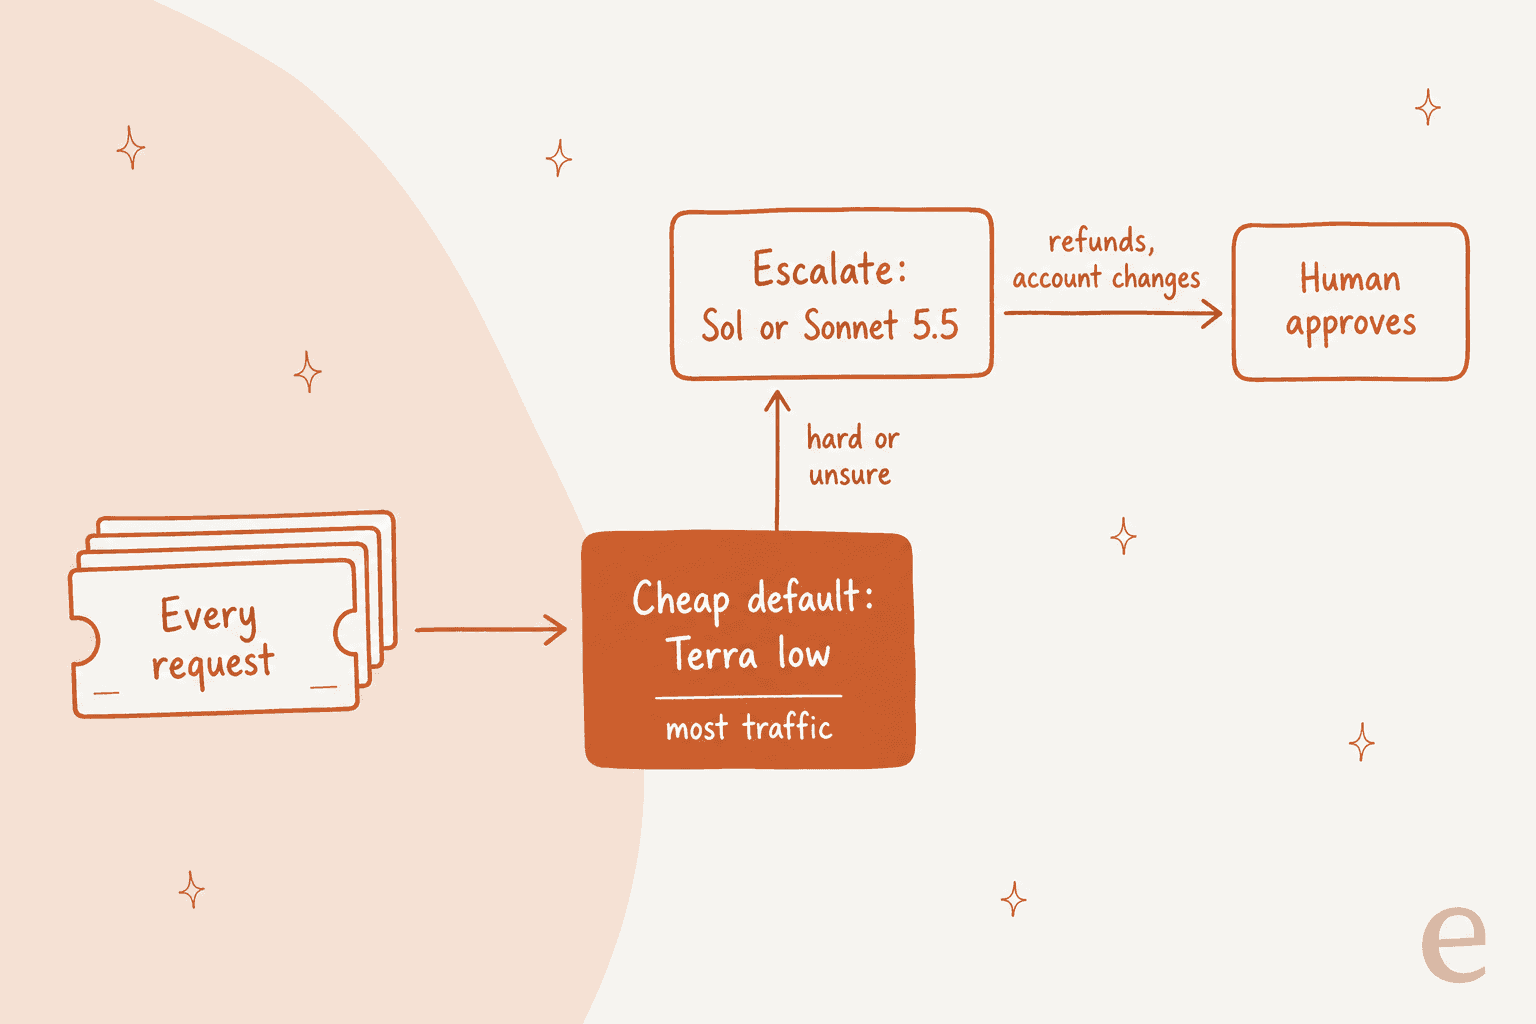
La mayor parte del ahorro viene del enrutamiento. OpenAI creó los esfuerzos none y low de Terra para esta misma vía rápida, y los usuarios de HN volvían una y otra vez a una pregunta sobre ello:
"Is a high effort terra above a low effort Sol? Are larger models mostly always better regardless of effort?"
Según los datos de AA, la respuesta suele ser no, y medir es la única forma de saberlo para tu propia carga. El caché también ayuda con todas las opciones. La entrada en caché de Terra cuesta $0.05, un descuento del 95 %, y la guía de precios de la API de OpenAI cubre Batch y los límites de tasa antes de escalar.
Si el modelo es para una cola de soporte
Muchos de los equipos que comparan alternativas a Terra están, en realidad, construyendo un bot de soporte. Llevo años poniendo agentes de IA en colas de helpdesk en vivo, y veo siempre lo mismo: el modelo rara vez es el punto débil; lo son las reglas que lo rodean. En mi prueba de Terra con 80 ejecuciones, ningún modelo acertó menos de 15 de 16 tickets. El único fallo real fue Terra en none diciéndole a un cliente hispanohablante "we've noted the new address" cuando no tenía forma de cambiarla.
Eso es un problema de escalado. Se arregla en la capa que decide cuándo pasar el caso, no pagando por un modelo más grande. Lo que previene las alucinaciones de la IA es basar las respuestas en tu centro de ayuda y tus tickets pasados, sin importar qué modelo escriba las palabras. Y al lado de una promesa equivocada a un cliente que paga, la factura de tokens es una porción pequeña del coste de la IA en atención al cliente.
SamCart muestra cómo es esa capa en la práctica. Un agente de eesel trabaja sus tickets de Freshdesk y otro su chat web, ambos respondiendo a partir de unos 280 artículos del centro de ayuda, en un plan dimensionado para 8.000 interacciones al mes. Koffer.ch, una tienda suiza de maletas, mantiene cada respuesta como borrador en alemán, francés, inglés o italiano en Freshdesk. Es justo el tipo de configuración en la que un modelo más barato hace bien el trabajo.
¿Prefieres manejarlo desde código? La CLI de eesel ejecuta el mismo compañero que configurarías en el panel. Prueba una respuesta con eesel chat y mira qué hizo el agente con eesel activity; cualquier cambio se puede previsualizar con --dry-run. Cada comando devuelve JSON. Cada espacio de trabajo es además un servidor MCP, así que un agente de programación que funcione con Terra o Sonnet puede llamar a tu compañero de soporte como una herramienta.
Prueba eesel
Terra, Sol y Sonnet son motores. Cuando lo que construyes es automatización de soporte, eesel es el compañero de IA para helpdesk que ya hace ese trabajo sobre ellos. Se une al helpdesk que ya usas, sea Zendesk, Freshdesk, Gorgias u otro. Aprende de tus tickets y macros pasados además de tu centro de ayuda, y sigue las reglas de escalado que defines. Antes de responder a nadie en vivo, ejecuta una simulación sobre tus tickets pasados reales, para que puedas comparar sus respuestas con lo que tu equipo envió de verdad.

El precio es un plan de créditos mensual fijo, donde un ticket o chat cuenta como un crédito. Empieza en $299 al mes por 500 créditos, con todas las funciones y usuarios ilimitados incluidos. Como no hay cargo por token, tu factura se mantiene cuando sale un modelo más barato como Terra. Empieza con el plan gratuito y prueba eesel en una parte de tu cola.