

GPT-6.1 Terra cuesta $1 por millón de tokens de entrada y $5 por millón de salida, con la entrada en caché a $0.05, según la página de precios de OpenAI. Eso es la mitad de GPT-6.1 Sol por token y menos de la mitad del antiguo GPT-5.6 Terra.
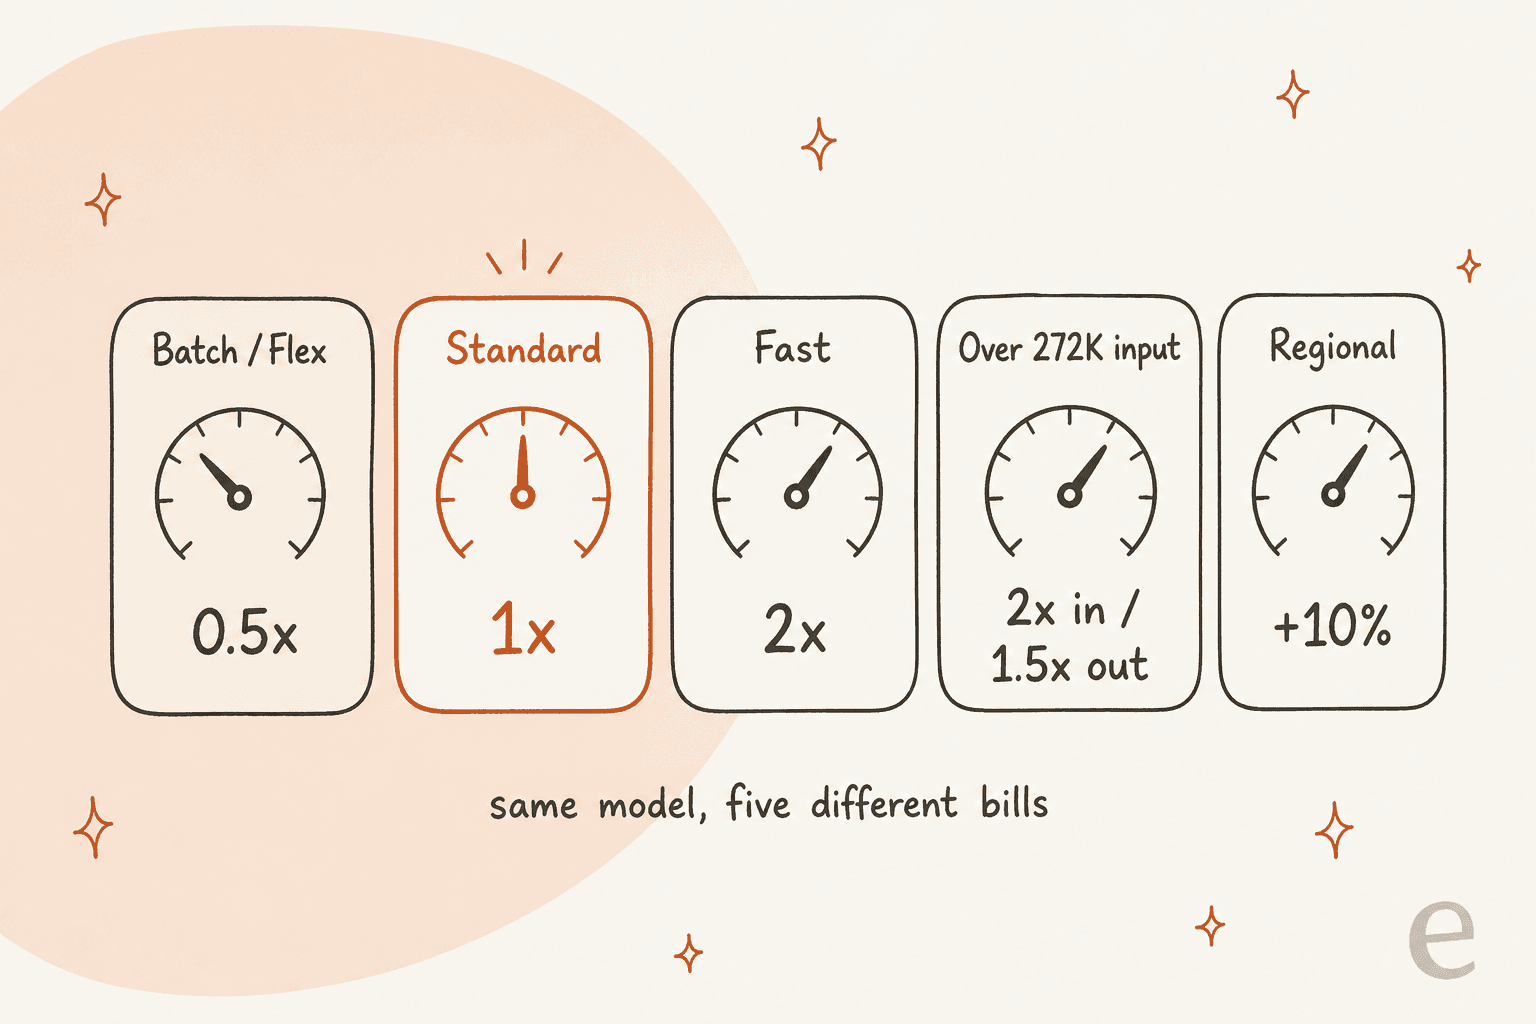
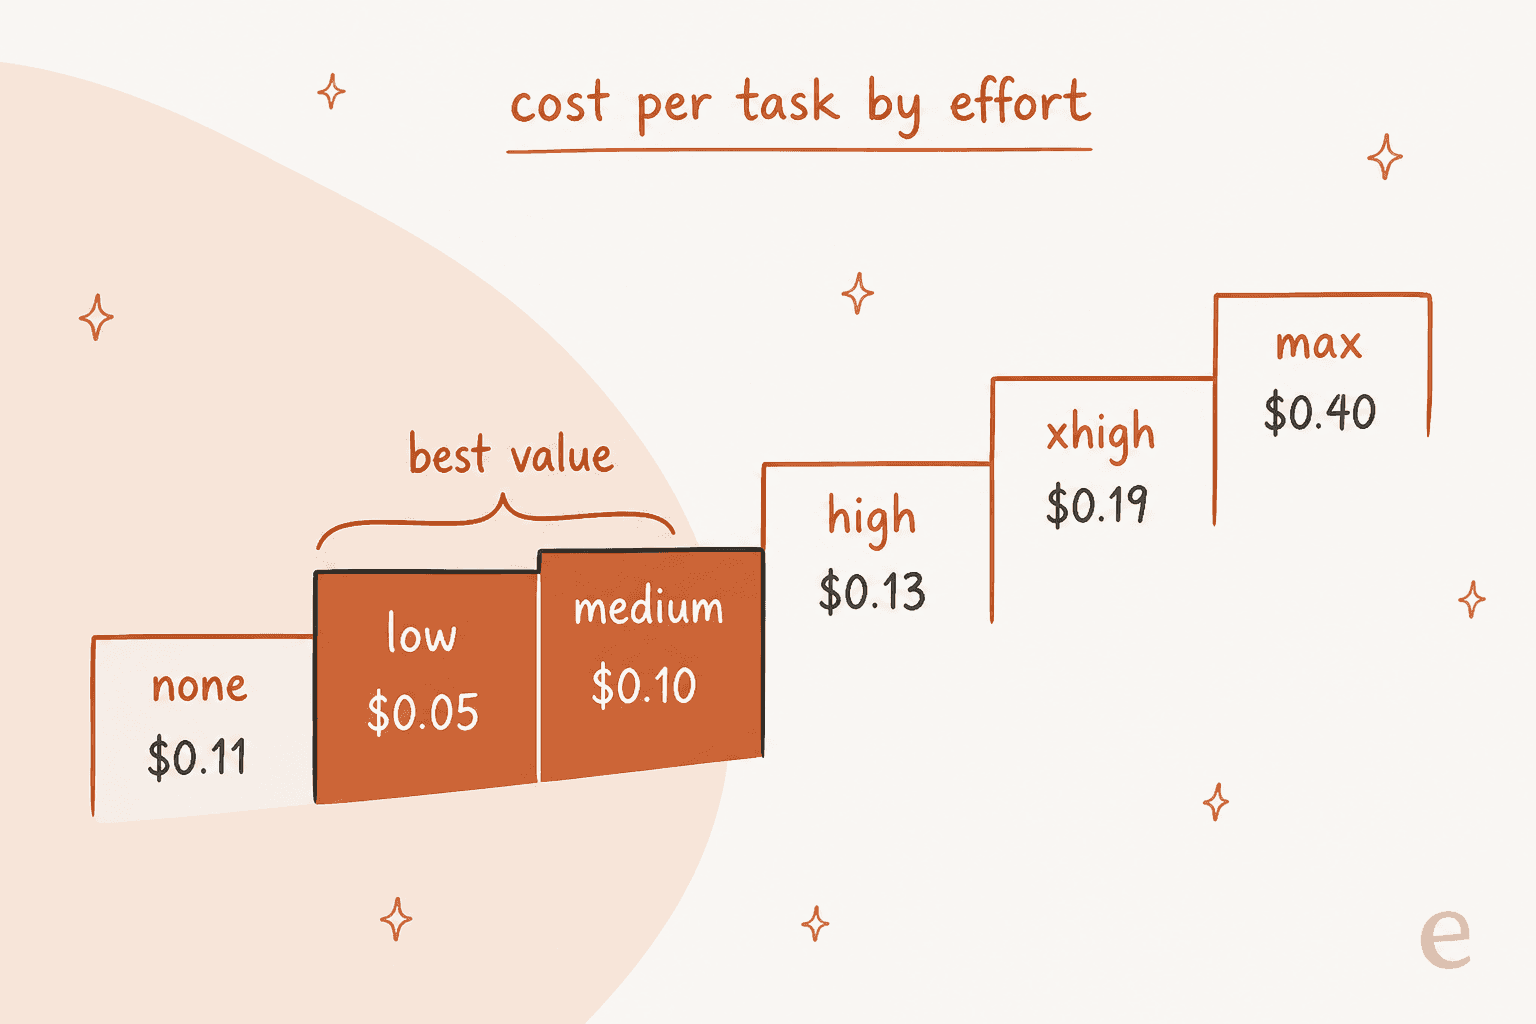
Pero el precio de lista no decide su factura. Lo deciden tres cosas: el nivel de esfuerzo ($0.05 por tarea en low, $0.40 en max, según Artificial Analysis), la regla de contexto largo de 272K que duplica el precio de toda la solicitud, y el caché, que reduce la entrada un 95% pero cobra 1.25x por escribir el caché en primer lugar.
Mi recomendación: use Terra en low o medium, mantenga los prompts por debajo de 272K y use Batch para todo lo que pueda esperar. En la reseña de GPT-6.1 Terra ejecuté 80 pruebas con tickets de soporte, y el modelo costó menos de un centavo por ticket. Para un equipo de soporte, los tokens son la parte barata. smava clasifica y redacta unos 27,000 tickets en alemán al mes en Zendesk con eesel, y lo que lo hizo funcionar fueron 820 macros y artículos, no el precio del modelo.
¿Cuánto cuesta GPT-6.1 Terra?
GPT-6.1 Terra cuesta $1.00 por millón de tokens de entrada, $0.05 por millón de tokens de entrada en caché y $5.00 por millón de tokens de salida a velocidad Standard. Yo construyo la parte de API de las integraciones de eesel, así que leo las páginas de precios como leo la documentación de una API: buscando los multiplicadores escondidos bajo la cifra del titular. Terra tiene cinco.
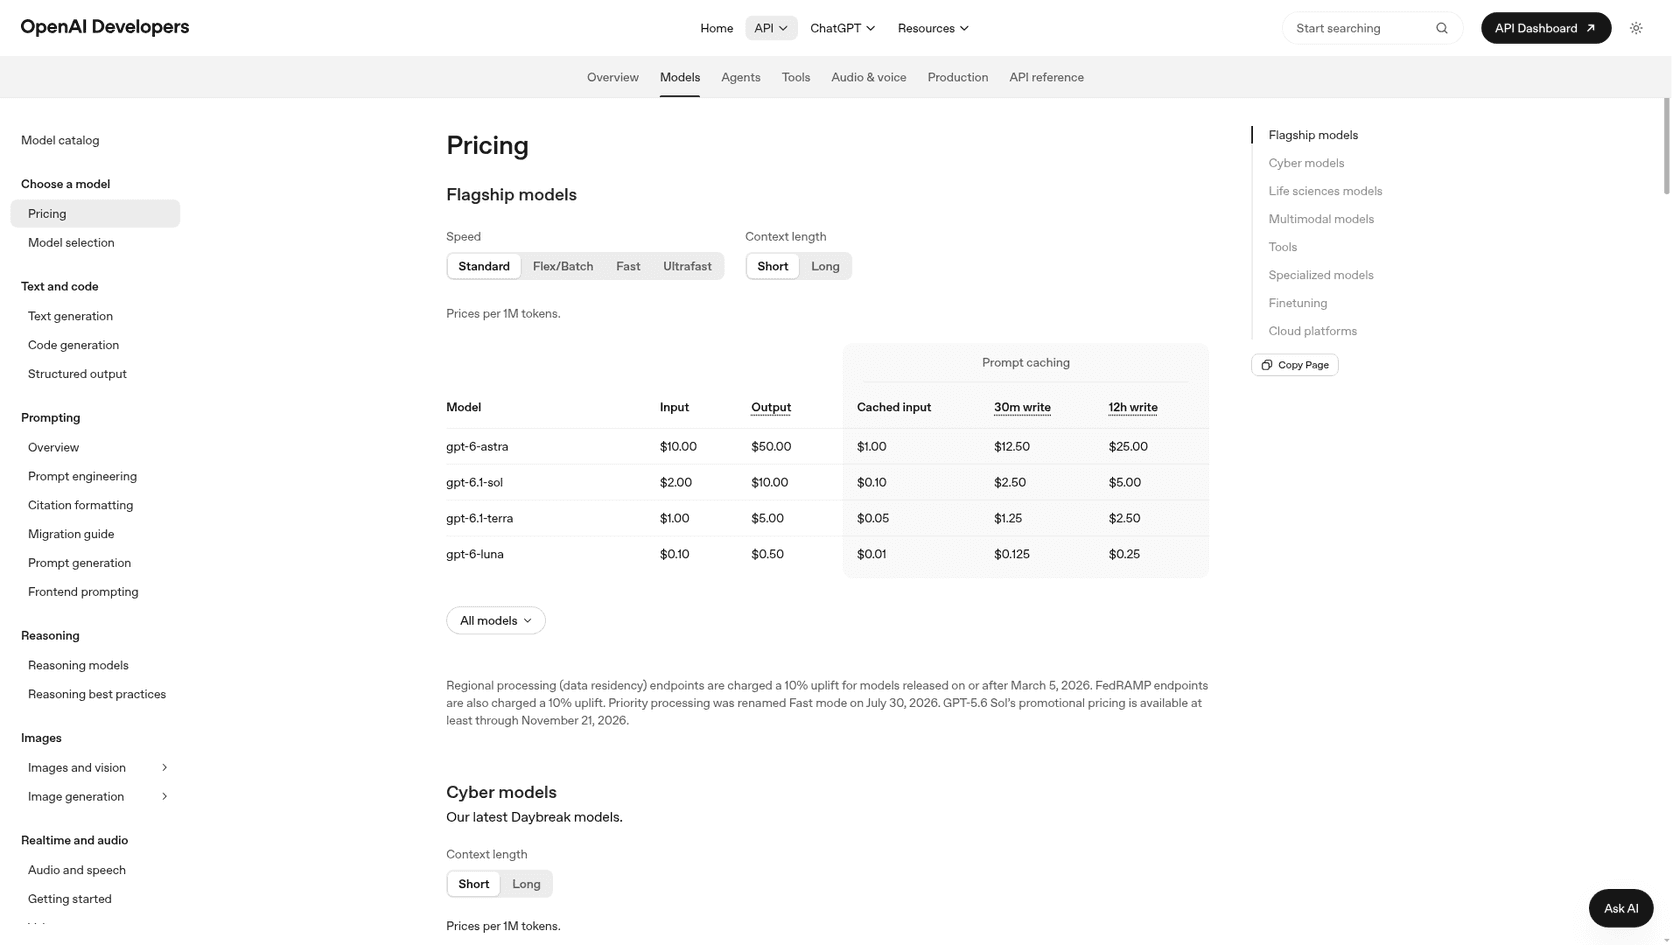
Esta es la tarifa completa, por millón de tokens:
| Nivel | Entrada | Entrada en caché | Escritura de caché (30 min) | Escritura de caché (12 h) | Salida |
|---|---|---|---|---|---|
| Standard (hasta 272K de entrada) | $1.00 | $0.05 | $1.25 | $2.50 | $5.00 |
| Standard (más de 272K de entrada) | $2.00 | $0.10 | $2.50 | $5.00 | $7.50 |
| Batch / Flex | $0.50 | $0.025 | $0.625 | $1.25 | $2.50 |
| Fast | $2.00 | $0.10 | $2.50 | $5.00 | $10.00 |
| Ultrafast | No disponible |
Fuente: precios de la API de OpenAI y la página del modelo GPT-6.1 Terra. El procesamiento regional (residencia de datos) y los endpoints FedRAMP añaden un 10%. Ultrafast existe hoy solo para Sol y Astra.
Conviene leer despacio algunas cosas de esa tabla:
- Los tokens de razonamiento se facturan como salida. Cada nivel de esfuerzo por encima de
noneproduce tokens de pensamiento que usted nunca ve, y cada uno cuesta$5por millón. Por eso el esfuerzo mueve la factura más que cualquier otra cosa. - Las lecturas de caché cuestan el 5% de la entrada, las escrituras el 125%. La página del modelo dice que la entrada en caché se cobra al 5% de la tarifa sin caché, y que las escrituras cuestan
$1.25con retención de 30 minutos y$2.50con retención de 12 horas. - El precio de contexto largo cubre toda la solicitud. La redacción de OpenAI es "2x input and cache rates and 1.5x output for the full request." Un token por encima de 272K y cada token de esa llamada cuesta más.
Si necesita todo el catálogo de OpenAI lado a lado, la guía de precios de la API de OpenAI tiene cada modelo, y la lista de modelos de OpenAI explica dónde encaja cada uno.
¿Cuánto cuesta realmente una tarea con GPT-6.1 Terra?
Una tarea cuesta entre $0.05 y $0.40 en el conjunto de pruebas de Artificial Analysis, y el ajuste de esfuerzo marca toda la diferencia. Mismo modelo, mismo precio por token, una diferencia de 8x:
| Esfuerzo de Terra | Intelligence Index | Costo por tarea | Tiempo por tarea |
|---|---|---|---|
none (sin razonamiento) | 33.5 | $0.11 | n/d |
low | 36.2 | $0.05 | 29s |
medium | 41.3 | $0.10 | 63s |
high | 43.9 | $0.13 | 96s |
xhigh | 45.4 | $0.19 | 160s |
max | 48.1 | $0.40 | 384s |
Fuente: páginas de modelo por esfuerzo de Artificial Analysis. Artificial Analysis llama a low y medium los ajustes óptimos de Pareto, es decir, ningún modelo que rastrea es a la vez más barato y más inteligente en esos puntos.
Dos detalles me sorprendieron. Primero, none cuesta más por tarea que low en ese conjunto, lo contrario de lo que sugieren los nombres. simonw vio algo parecido en una prueba del día de lanzamiento en Hacker News: ambos ajustes gastaron cero tokens de razonamiento en su prompt, y low aun así salió más barato. No asuma que none es el ajuste económico; mídalo.
Segundo, el esfuerzo máximo es donde Terra deja de ser la opción barata. Pasar de medium a max cuesta 4x más y tarda 6x más por 7 puntos más de índice. En ese punto, GPT-6.1 Sol en medium ($0.21 por tarea, índice 47.8) le da más o menos la misma puntuación por aproximadamente la mitad del dinero. Los lectores de Hacker News lo calcularon en pocas horas:
"Per token, yes. But per task it's not even necessarily the case depending on how much thinking is needed."

Y de alguien que lo usa en producción:
"I have some business automation process for some customers that I maintain, where Terra with low reasoning ended up with the best price/performance & latency."
Eso coincide con lo que medí en mi propia reseña de Terra. Con 16 tickets de soporte procesados por la Responses API, Terra en low obtuvo lo mismo que en medium y costó $0.75 por 1,000 tickets en lugar de $0.92:
| Configuración | Correctos (de 16) | Costo por 1,000 tickets | Tiempo medio |
|---|---|---|---|
Terra, none | 15 (1 fallo) | $0.65 | 2.5s |
Terra, low | 15 | $0.75 | 2.7s |
Terra, medium | 15 | $0.92 | 3.1s |
GPT-6.1 Sol, medium | 16 | $1.62 | 3.9s |
GPT-6 Luna, medium | 15 | $0.14 | 4.1s |
El ajuste none fue el más barato, pero le dijo a un cliente hispanohablante que su cambio de dirección quedaba "anotado" cuando no tenía ninguna herramienta para cambiar nada. Son 10 centavos de ahorro por cada 1,000 tickets, pagados con una promesa que su equipo no puede cumplir. Yo empezaría en low.
¿Por qué un prompt largo cuesta el doble?
Porque la tarifa de contexto largo se aplica a toda la solicitud, no solo a los tokens que pasan de la línea. Por debajo de 272K tokens de entrada paga $1/$5. Por encima, toda la llamada se factura a $2/$7.50.
El salto es pronunciado. Una solicitud con 270K de entrada y 2K de salida cuesta $0.28. Si añade 10K más de entrada, cuesta $0.58, más del doble, por un 4% más de texto.
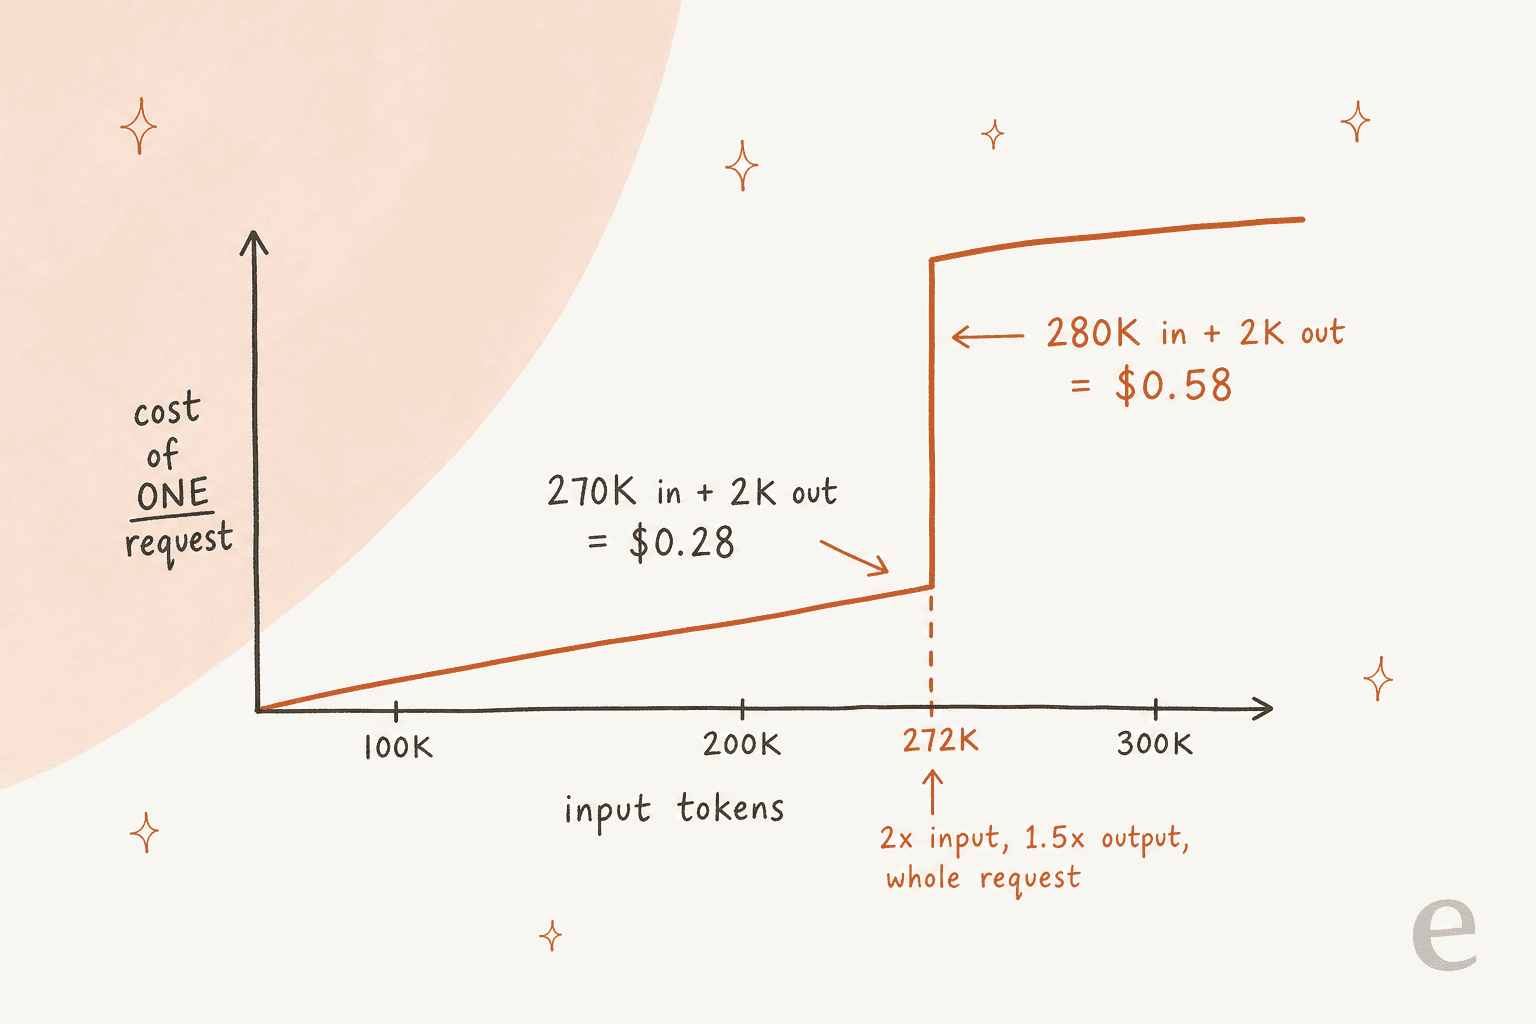
La ventana de contexto de Terra es de 1,050,000 tokens, así que acepta sin problema un contrato o un volcado de logs de 400K tokens. Esto es lo que cuesta, y lo que cuesta dividirlo:
| Enfoque | Cálculo | Costo |
|---|---|---|
| Una solicitud de 400K tokens, 4K de salida | 400K x $2 + 4K x $7.50 | $0.83 |
| Dos solicitudes de 200K tokens, 4K de salida cada una | 2 x (200K x $1 + 4K x $5) | $0.44 |
Dividir ahorra un 47%, siempre que la tarea sobreviva a la división. Los resúmenes, la extracción y la revisión por sección suelen hacerlo. Una pregunta que necesita todo el documento a la vez no, y entonces paga la tarifa de contexto largo.
La forma silenciosa de cruzar la línea es un bucle de agente. Cada turno reenvía la conversación, así que una sesión que empieza en 50K puede pasar de 272K hacia el turno 20 sin que nadie lo note. Si usa Terra como agente, registre los tokens de entrada por llamada y recorte o resuma el historial antes de llegar ahí. La guía de function calling de OpenAI explica cómo los resultados de herramientas se suman a ese historial.
¿El caché de prompts ahorra dinero con Terra?
Sí, cuando el tráfico es constante. La entrada en caché cuesta $0.05 por millón, un 95% menos. El problema es la escritura: guardar un prefijo en el caché cuesta $1.25 por millón durante 30 minutos, o $2.50 durante 12 horas, que es más que enviarlo sin caché.
Tome una respuesta de soporte con un prompt de sistema y un bloque de políticas de 4,000 tokens que nunca cambian, 2,000 tokens de ticket y contexto del centro de ayuda que sí cambian, y 400 tokens de salida:
| Escenario | Por ticket | Por 1,000 tickets |
|---|---|---|
| Sin caché | $0.0080 | $8.00 |
| Prefijo en caché y leído (cola ocupada) | $0.0042 | $4.20 |
| Prefijo escrito cada vez (un ticket cada 30 min) | $0.0090 | $9.00 |
En una cola ocupada, el prefijo se escribe una vez por ventana y se lee miles de veces, así que el caché casi reduce la factura a la mitad. En una tranquila, donde cada solicitud llega cuando el caché ya expiró, paga el recargo de escritura cada vez y termina un 12% peor que sin caché.
La guía de modelos de OpenAI dice que hay que seguir cached_tokens y cache_write_tokens para entender el costo neto, y ese es el hábito correcto. La retención de 12 horas solo compensa cuando un prefijo se reutiliza a lo largo de horas pero con menos de 30 minutos entre usos, como en un trabajo nocturno.
¿Cuánto cuesta Terra al mes?
Aquí una carga de trabajo valorada en todos los niveles: 1 millón de solicitudes al mes, cada una con 2,000 tokens de entrada y 300 de salida.
| Nivel | Costo de entrada | Costo de salida | Total mensual |
|---|---|---|---|
| Standard | $2,000 | $1,500 | $3,500 |
| Batch / Flex | $1,000 | $750 | $1,750 |
| Fast | $4,000 | $3,000 | $7,000 |
| Standard + regional | $2,200 | $1,650 | $3,850 |
Batch es el ahorro más fácil. Si los resultados pueden llegar dentro de la ventana de batch (clasificación, resúmenes nocturnos, cargas históricas), paga la mitad. La guía de la Batch API de OpenAI cubre la configuración. El modo Fast solo tiene sentido para llamadas de cara al usuario donde la latencia le hace perder un cliente.
Para calcular su propia carga de trabajo, ponga sus números aquí:
Los valores por defecto son un mes de 100,000 tickets con un prompt de 6,000 tokens, que sale a unos $800. Ponga el tamaño real de su prompt, no el de su prototipo. Los fragmentos recuperados del centro de ayuda y el historial de la conversación suelen hacer que un prompt sea de 5x a 10x más grande de lo que esperaba.
¿Cómo se compara el precio de Terra con otros modelos?
Terra es el segundo peldaño de la escalera de cuatro modelos de OpenAI. Aquí la misma carga de 1 millón de solicitudes (2,000 de entrada, 300 de salida) en la familia de OpenAI y los rivales más cercanos:
| Modelo | Entrada / salida por 1M | Entrada en caché | Costo AA por tarea | Factura mensual (ejemplo) |
|---|---|---|---|---|
| GPT-6 Luna | $0.10 / $0.50 | $0.01 | n/d | $350 |
| GPT-6.1 Terra | $1.00 / $5.00 | $0.05 | $0.40 (max) | $3,500 |
| GPT-6.1 Sol | $2.00 / $10.00 | $0.10 | $0.21 (medium) | $7,000 |
| GPT-6 Astra | $10.00 / $50.00 | $1.00 | $3.26 (max) | $35,000 |
| GPT-5.6 Terra (anterior) | $2.00 / $12.00 | n/d | $1.40 (max) | $7,600 |
| Claude Sonnet 5.5 | $2.00 / $10.00 | $0.10 | $0.88 (high) | $7,000 |
| Claude Haiku 5.5 | $0.10 / $0.50 | $0.01 | $0.08 (high) | $350 |
| DeepSeek V4.1 Flash | $0.15 / $0.60 fuera de horas pico | $0.003 | $0.26 (max) | $480 |
| Gemini 3.8 Flash | $0.75 / $3.75 hasta el 31 de dic. | $0.075 | $3.49 (high) | $2,625 |
Fuentes: precios de la API de OpenAI, la página de precios de cada proveedor a 28 de octubre de 2026, y Artificial Analysis para el costo por tarea. El precio de Haiku se aplica hasta un prompt de 100K.
Frente a su predecesor, la bajada es real. El hilo de lanzamiento de OpenAI lo dijo sin rodeos:
"It's a significant step up over GPT‑5.6 Terra, with 50% lower standard API prices."
A nivel de token, Terra está a mitad de tabla: 10x Luna y Haiku, la mitad de Sol y Sonnet. Por tarea, es de los modelos más baratos con un Intelligence Index por encima de 45. Si su trabajo es etiquetado y enrutamiento simples, Luna a una décima parte del precio es la mejor compra. Si es programación difícil, la propia OpenAI le remite a Sol o a GPT-6 Astra. La publicación sobre alternativas a GPT-6.1 Terra repasa cada opción en detalle.
¿Cuánto cuesta Terra en ChatGPT y Codex?
No hay un precio separado de Terra en ChatGPT. Viene con los planes Plus, Pro, Enterprise y Edu en ChatGPT Work y Codex, según la publicación de lanzamiento de OpenAI. OpenAI dice que su cuota de uso rinde más con Terra que con GPT-5.6 Terra, y mucho más que con Sol o Astra.
Así que en una suscripción, elegir Terra no baja la factura, estira la cuota. Si llega a los límites con Sol en trabajo rutinario, pasar esas tareas a Terra es la solución barata. Las guías de precios de ChatGPT Work y de precios de Codex cubren lo que incluye cada plan, y ChatGPT Enterprise explica el nivel de espacio de trabajo.
¿Cuáles son los costos ocultos y los límites?
La mayoría son pequeños por sí solos y se suman en conjunto. Esta es la lista que revisaría antes de comprometerme:
- Sin nivel gratuito de API. La página del modelo indica Free como "Not supported." Necesita una cuenta de pago desde la primera llamada.
- Los límites de uso empiezan bajos. El nivel Build da
5,000solicitudes y1,000,000tokens por minuto. Con 2,300 tokens por solicitud, son unas 430 solicitudes por minuto. Launch llega a4,000,000TPM y Grow a40,000,000. La guía de límites de uso de OpenAI explica cómo subir de nivel. - Las llamadas a herramientas cuestan aparte. La búsqueda web y la búsqueda de archivos se facturan por llamada o por GB además de los tokens, y los tokens que usan las herramientas integradas se facturan a las tarifas de Terra, según la página de precios.
- El procesamiento regional es +10%. La residencia de datos y los endpoints FedRAMP llevan el recargo para los modelos lanzados a partir del 5 de marzo de 2026, lo que incluye a Terra.
- Reintentos y evaluaciones. Una llamada a herramienta fallida o una respuesta que regenera se factura completa. Reserve un margen y ejecute evaluaciones de agentes de OpenAI sobre un conjunto fijo antes de cambiar los niveles de esfuerzo, para comparar costos con la misma calidad.
| Nivel de límite de uso | Solicitudes por minuto | Tokens por minuto | Límite de cola de Batch |
|---|---|---|---|
| Free | No disponible | ||
| Build | 5,000 | 1,000,000 | 3,000,000 |
| Launch | 10,000 | 4,000,000 | 200,000,000 |
| Grow | 15,000 | 40,000,000 | 15,000,000,000 |
Fuente: página del modelo GPT-6.1 Terra.
¿Vale la pena GPT-6.1 Terra para atención al cliente?
Para redactar y clasificar, sí, y la factura de tokens es la línea más pequeña del presupuesto. Un ticket de soporte realista, con un prompt de 6,000 tokens, cuesta unos $0.008 en Standard. Un mes de 10,000 tickets son $80 en costos del modelo, o unos $42 con un prefijo en caché.
Lo que realmente le cuesta dinero a un equipo de soporte es la respuesta equivocada. En mi prueba, el ajuste más barato le dijo a un cliente que un cambio de dirección estaba hecho cuando no lo estaba, y ese solo ticket costaría más en seguimiento y reembolso que un año de ahorro en tokens. eesel lleva años poniendo agentes de IA en colas de soporte reales y construyendo las integraciones para ellos, y sigo aprendiendo la misma lección: el modelo es la mitad más pequeña del trabajo. La mitad más grande es qué lee, qué se le permite hacer y cuándo pasa el caso a una persona. El desglose del costo de la IA en atención al cliente cubre el panorama completo, y las alucinaciones de la IA en soporte tratan el tipo de fallo descrito arriba.
La historia de smava muestra cómo es esa mitad. Su agente de eesel trabaja dentro de IA para Zendesk, gestiona unos 27,000 tickets al mes en dos marcas de crédito, preparó 15,300 borradores de respuesta en un mes y redacta a partir de las 820 macros y artículos del centro de ayuda que el equipo ya mantiene en Zendesk. En finanzas reguladas, una respuesta que promete algo que el equipo no hará es un daño real, y por eso el texto sale de las macros y no de la imaginación del modelo. Dokument 24 usa el mismo patrón en danés: 670 borradores de respuesta al mes quedan como notas internas para que el equipo las revise y envíe, un buen caso para la atención al cliente multilingüe.
Pruebe eesel
Si está valorando el precio de Terra porque quiere que una IA redacte o responda tickets, puede que no necesite construir el pipeline. eesel es una plataforma de compañeros de IA, y su agente de IA para helpdesk se une a su cola actual de Zendesk, Freshdesk o Gorgias, aprende de sus tickets pasados y su centro de ayuda, y redacta o responde con las reglas de escalamiento que usted defina. Puede probarlo con sus propios tickets históricos antes de que toque a un cliente real.
El precio es por ticket, no por token: los planes de eesel empiezan en $299 al mes por 500 créditos, donde un ticket es un crédito sin importar lo larga que sea la conversación, con 100 créditos gratis para probar. Así, la elección del modelo, el tamaño del prompt y la regla de 272K quedan del lado de eesel y no del suyo. SamCart ejecuta un agente sobre tickets de Freshdesk y otro en el chat de su sitio web, ambos respondiendo a partir de 280 artículos del centro de ayuda.
Si prefiere manejarlo desde código, la CLI de eesel opera el mismo compañero desde una terminal, y cada espacio de trabajo es también un servidor MCP, de modo que una sesión de Codex con GPT-6.1 Terra puede llamar a su agente de soporte como herramienta. Pruebe eesel y vea los borradores sobre sus propios tickets.
Preguntas frecuentes
¿Cuánto cuesta GPT-6.1 Terra?
¿Cuánto cuesta GPT-6.1 Terra por tarea?
¿Es GPT-6.1 Terra más barato que GPT-6.1 Sol?
¿Cuál es el precio de contexto largo de GPT-6.1 Terra?
¿GPT-6.1 Terra tiene un nivel gratuito?
gpt-6.1-terra, y los límites de uso empiezan en 5,000 solicitudes y 1 millón de tokens por minuto en el nivel Build. La guía de límites de uso de OpenAI explica cómo suben los niveles. En ChatGPT, Terra viene con los planes Plus, Pro, Enterprise y Edu.