

Mercury 3 cuesta $0.10 por millón de tokens de entrada y $0.35 por millón de salida en el lanzamiento, con la entrada en caché a $0.01. Es un 50% de descuento sobre el precio de lista real de $0.20 / $0.70 / $0.02, y Inception no ha dicho cuándo termina. Las cuentas nuevas reciben 100 millones de tokens gratis.
Al precio de lanzamiento es el modelo más barato de su clase en todos los trabajos que calculé. Al precio de lista cuesta entre 1,6 y 1,8 veces lo que GPT-6 Luna y Claude Haiku 5.5 con prompts cortos, porque la salida es de $0.70 frente a sus $0.50. A precio de lista solo gana con prompts largos: supera a Haiku 5.5 pasados los 100K tokens y empata más o menos con Luna pasados los 272K, porque Mercury 3 cobra la misma tarifa hasta 1M. Presupuesta con el precio de lista y trata el descuento como un extra.
Si estás calculando Mercury 3 para un bot de soporte, recuerda que los tokens son la partida pequeña. Un mes de 10.000 tickets en Mercury 3 cuesta bastante menos de $100 en tokens y semanas de ingeniería en todo lo que los rodea. Ese es el hueco que cubre el teammate de helpdesk con IA de eesel, a un precio mensual fijo por ticket, con la integración y las pruebas ya construidas.
Por qué lo calculé por tarea y no por token
Me dedico a construir integraciones y APIs, y lo primero que hago con cualquier modelo nuevo es leer el objeto usage que devuelve. Una tarifa por millón de tokens es solo la etiqueta. Lo que pagas de verdad depende de cuántos tokens consume un trabajo, cuántos están en caché y cuántos son tokens de razonamiento que nunca ves. Así que para este artículo calculé Mercury 3 como lo haría antes de integrarlo en nada: por tarea, en lanzamiento y en lista, frente a los modelos a los que persigue.
Hay un segundo motivo para mirarlo así. eesel lleva años ejecutando modelos de IA en colas de soporte reales, y la factura por token nunca ha sido la parte cara de esos despliegues. Lo caro es todo lo que rodea al modelo. Volveré a eso al final, con cifras reales de uno de nuestros clientes.
Si quieres primero la historia de velocidad y benchmarks, mi resumen de Mercury 3 explica qué es el modelo y lo rápido que va. Este artículo trata solo del dinero.
¿Cuánto cuesta Mercury 3?
Esta es la tabla de precios de la propia Inception, tomada de la página de modelos y de la documentación de modelos, comprobada el 20 de octubre de 2026.
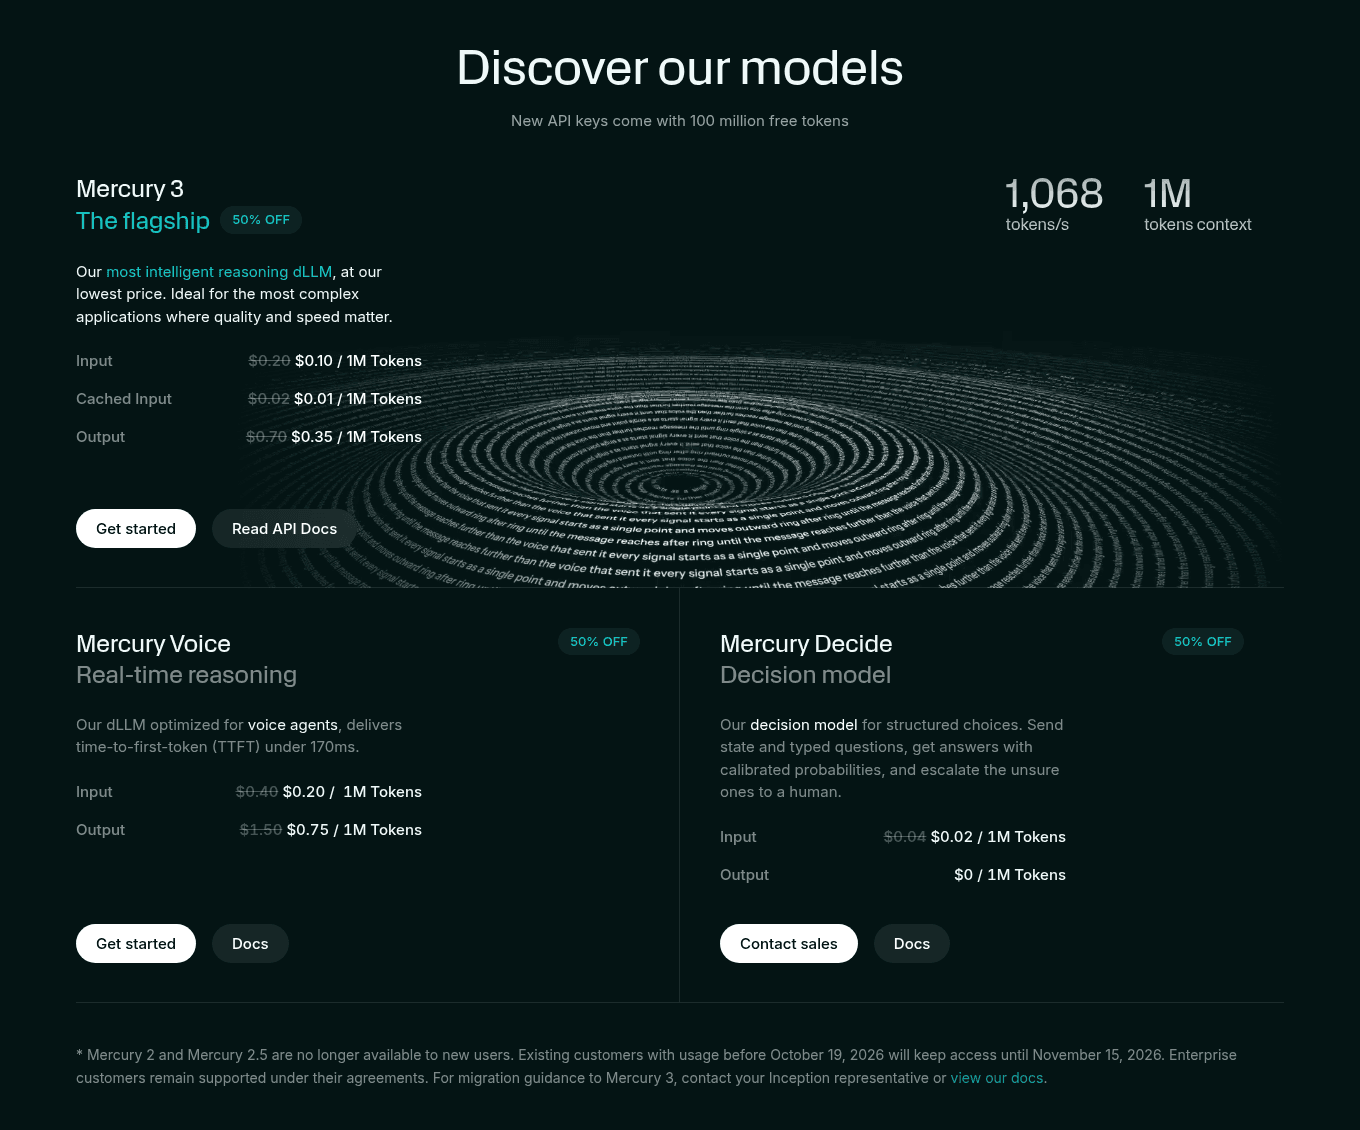
| Modelo | Entrada (lista → lanzamiento) | Entrada en caché | Salida (lista → lanzamiento) | Contexto | Salida máx. |
|---|---|---|---|---|---|
| Mercury 3 | $0.20 → $0.10 | $0.02 → $0.01 | $0.70 → $0.35 | 1M | 131,072 |
| Mercury Voice | $0.40 → $0.20 | $0.04 → $0.02 | $1.50 → $0.75 | 128K | 50,000 |
| Mercury Decide | $0.04 → $0.02 | $0 | $0 (no se factura) | n/d | n/d |
| Mercury Edit 2 | $0.25 | $0.025 | $0.75 | 32K | 8,192 |
| Mercury 2.5 (se retira) | $0.20 | $0.02 | $0.75 | 260K | 65,536 |
| Mercury 2 (se retira) | $0.25 | $0.025 | $0.75 | 128K | 50,000 |
Todos los precios son por millón de tokens. Algunas cosas que la tabla no dice por sí sola:
- La unidad facturable son los tokens simples. La FAQ de Inception dice que los tokens de razonamiento se cuentan dentro de los tokens de completion y se facturan a la tarifa de salida, y que los tokens en caché son un subconjunto de los tokens del prompt facturados a la tarifa de caché. No hay cargo por petición.
- El esfuerzo de razonamiento se fija por petición. Mercury 3 acepta
instant,low,mediumohigh, y según la documentación de razonamiento por defecto usalowsi no lo configuras. Los benchmarks de Inception se ejecutaron todos en medium, así que si copias sus ajustes, espera más tokens de salida que con el valor por defecto. - Mercury Voice es solo para enterprise a través de la API, según la documentación, y Mercury Decide es un endpoint aparte para clasificación que factura solo la entrada.
Los tres planes de acceso
Además de los precios por token, Inception vende el acceso en tres planes. Cambian tus límites de uso y el soporte, no el precio del token.
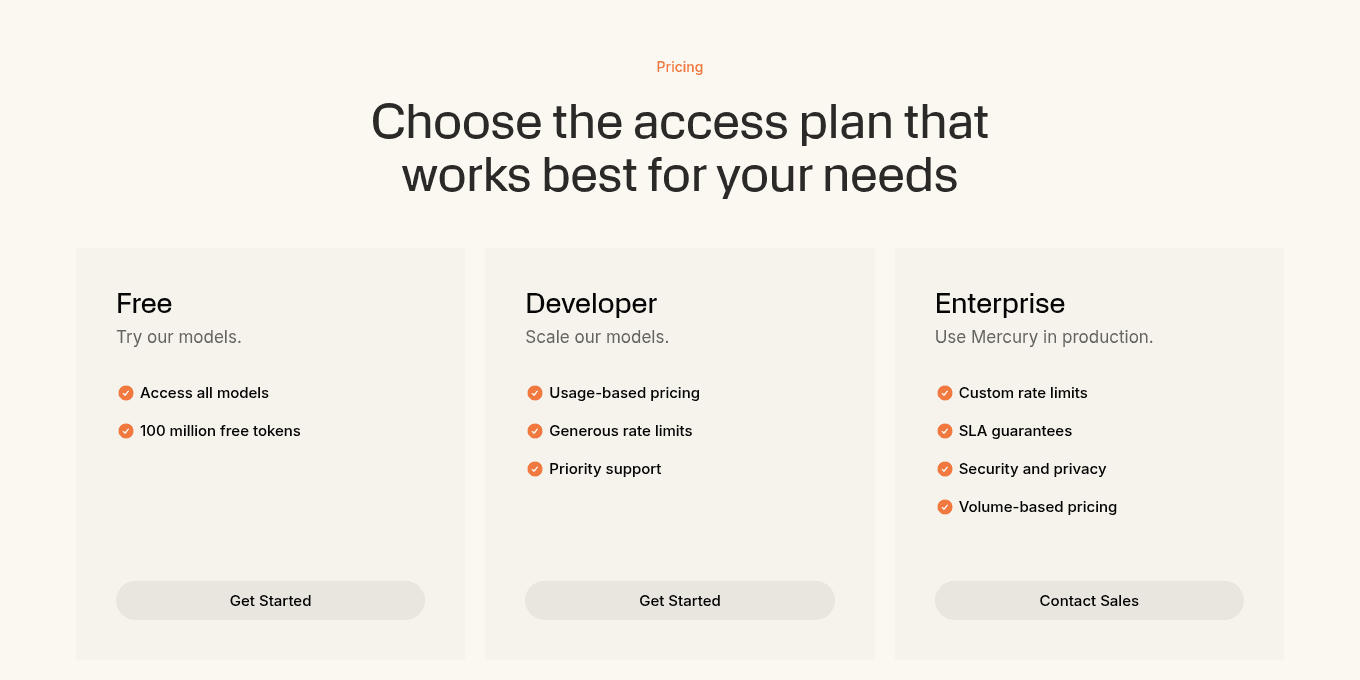
| Plan | Lo que pagas | Peticiones por minuto | Tokens de entrada por minuto | Tokens de salida por minuto |
|---|---|---|---|---|
| Free | 100M de tokens gratis, una sola vez | 1,000 | 1,000,000 | 100,000 |
| Developer (pago por uso) | Por uso, tabla de precios de arriba | 3,000 | 3,000,000 | 300,000 |
| Enterprise | Precios por volumen | Personalizado | Personalizado | Personalizado |
Los límites provienen de la página de límites de uso de Inception. El crédito gratuito es una concesión única compartida entre todos los modelos, no una asignación mensual, según la FAQ. Cuando se agota, añades una tarjeta en facturación y sigues con las tarifas por uso.
Qué significa realmente el descuento de lanzamiento del 50%
El descuento es el dato de precios más importante de Mercury 3 y el menos especificado. Tanto la página de modelos como la documentación dicen que Mercury 3 tiene "50% off at launch". Ninguna da una fecha de fin, un tope de tokens ni un plazo de aviso.
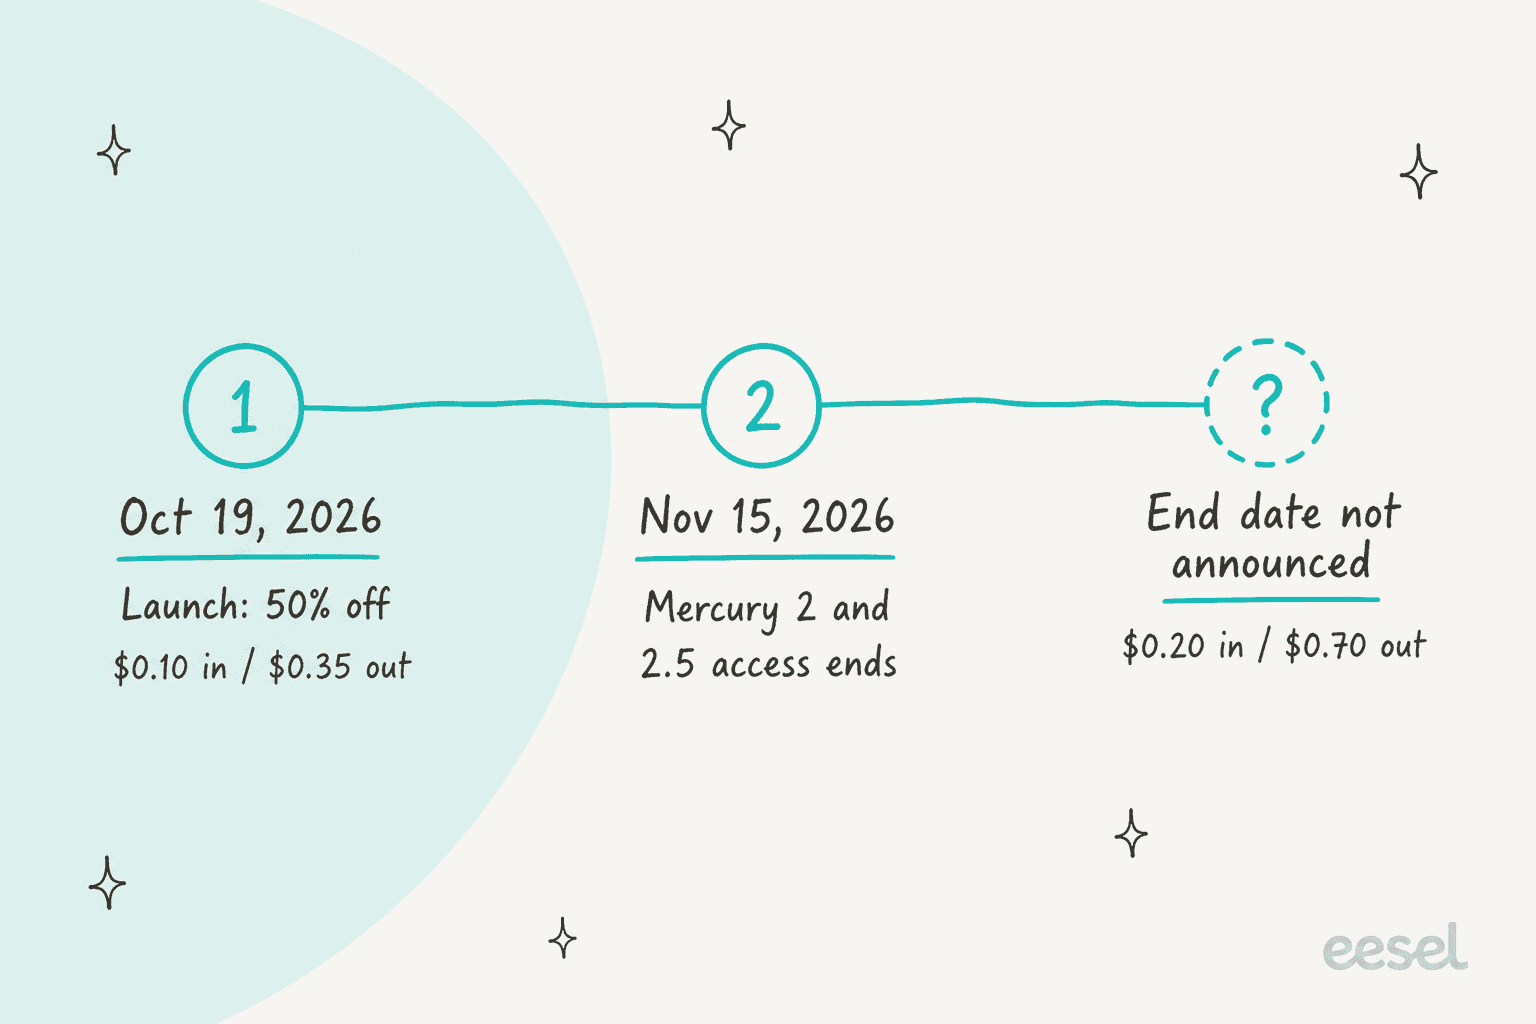
Es algo inusual para este segmento. La página de precios de Gemini de Google también tiene una promoción en Gemini 3.8 Flash, pero fecha ambos extremos: $0.75 de entrada y $3.75 de salida hasta el 31 de diciembre de 2026, y luego $1.50 y $7.50 desde el 1 de enero de 2027. Con Mercury 3 conoces el precio posterior pero no la fecha, así que cualquier presupuesto construido sobre $0.35 de salida tiene un agujero. Los primeros usuarios lo notaron:
"I'm going to start using this instead of Haiku/GPT-Luna for tasks that require speed. I'm wondering if it'll still be useful once the discount is lifted?"

Junto a eso hay dos buenas noticias. Primero, el cofundador de Inception dijo en ese mismo hilo que el modelo "runs in our API at reasonable costs", que es su explicación de los precios de lanzamiento. Otro comentarista replicó que el precio "can always be set at a loss", y no hay datos públicos que lo confirmen ni lo desmientan.
Segundo, si ya eres cliente de Mercury, el precio de lista sigue suponiendo un pequeño ahorro. Mercury 2.5 cuesta hoy $0.20 de entrada y $0.75 de salida, así que Mercury 3 a su tarifa completa de salida de $0.70 es más barato que el modelo al que sustituye, con casi cuatro veces más contexto. Los usuarios de Mercury 2 ahorran también en la entrada. Los clientes actuales mantienen el acceso a Mercury 2 y 2.5 hasta el 15 de noviembre de 2026, así que esa migración tiene una fecha límite aunque el descuento no la tenga.
Mercury 3 vs. GPT-6 Luna, Haiku 5.5, DeepSeek y Gemini Flash
Inception posiciona Mercury 3 frente a GPT-6 Luna y Claude Haiku 5.5. Añadí DeepSeek V4.1 Flash, con el que lo compararon los probadores de Hacker News, y Gemini 3.8 Flash como opción de Google. Cada precio de abajo procede de la propia página del proveedor.
| Modelo | Entrada | Entrada en caché | Salida | Regla para prompts largos | Fuente |
|---|---|---|---|---|---|
| Mercury 3 (lanzamiento) | $0.10 | $0.01 | $0.35 | Plano hasta 1M | Inception |
| Mercury 3 (lista) | $0.20 | $0.02 | $0.70 | Plano hasta 1M | Inception |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | Más de 272K: 2x entrada, 1,5x salida | OpenAI |
| Claude Haiku 5.5 | $0.10 | $0.01 | $0.50 | Más de 100K: $0.50 / $2.50 | Anthropic |
| DeepSeek V4.1 Flash | $0.15 | $0.003 | $0.60 | Plano hasta 1M; horas punta 2x | DeepSeek |
| Gemini 3.8 Flash | $0.75 | $0.075 | $3.75 | Promoción hasta 31 dic. 2026, luego 2x |
Por millón de tokens, nivel estándar. Las cifras de DeepSeek son de horas valle; en horas punta (de 01:00 a 04:00 y de 06:00 a 10:00 UTC en días laborables) cuesta el doble.
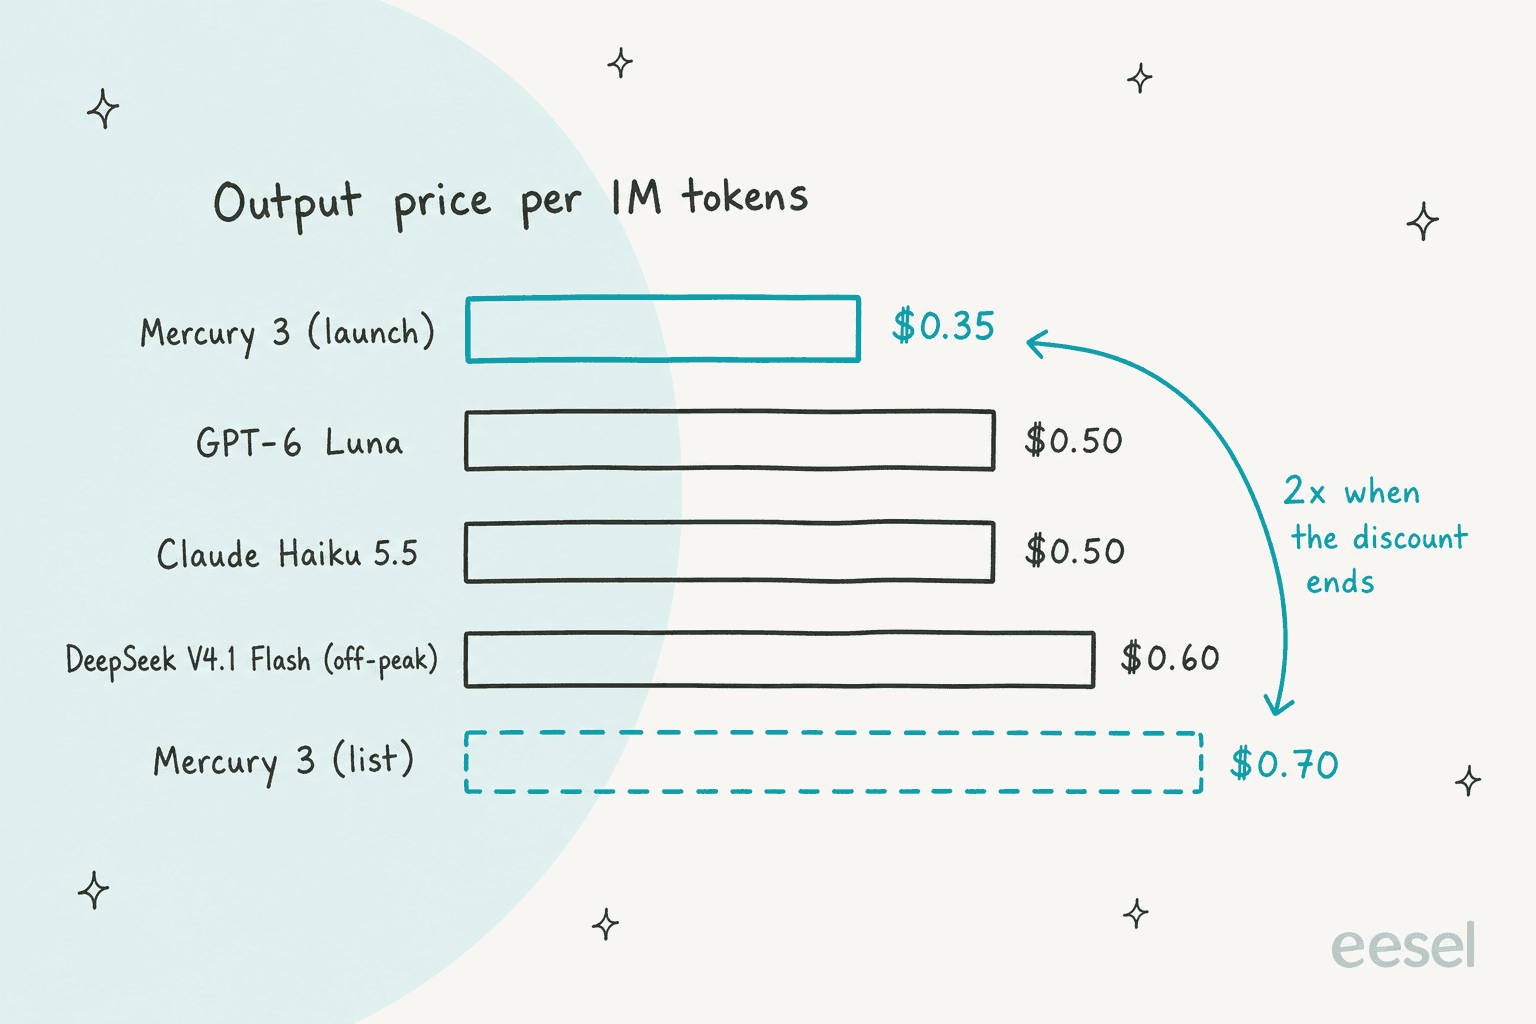
Lee la columna de salida y la historia es simple. En el lanzamiento, Mercury 3 tiene el token de salida más barato de este grupo. A precio de lista, tiene la salida más cara de los cuatro modelos económicos, y Gemini 3.8 Flash está en una categoría de precio superior.
En entrada hay empate con Luna y Haiku a $0.10 durante el lanzamiento, y luego el doble que ellos en lista. En entrada en caché, DeepSeek juega en otra liga con $0.003, más de tres veces más barato que la tarifa en caché de cualquier otro.
La columna que la mayoría de las comparativas se salta es la regla para prompts largos. Haiku 5.5 factura toda la petición a $0.50 de entrada y $2.50 de salida cuando el prompt pasa de 100,000 tokens, incluidas las lecturas de caché. Luna pasa a 2x en entrada y 1,5x en salida pasados los 272K. Mercury 3 cobra la misma tarifa en toda su ventana de 1M, algo que un probador temprano detectó enseguida:
"If these benchmarks hold up it is a no-brainer against Haiku 5.5 and GPT-6 Luna, especially considering that Haiku 5.5 becomes 5x more expensive past 100k context, and this model goes up to 1M for the same price. (Note: the price increases 2x after a period post launch but is still way lower than Haiku is priced for >100k requests)"
Mis desgloses de precios de GPT-6 Luna y precios de Haiku 5.5 cubren esos umbrales en detalle, y el artículo sobre los precios de V4.1 Flash explica las reglas de horas punta de DeepSeek.
Calculadora de costes de Mercury 3
Las tarifas por millón de tokens cuesta imaginarlas. Elige un trabajo abajo, o escribe tus propios recuentos de tokens, y la calculadora calcula un mes en cada modelo a la tarifa estándar de su proveedor. Alterna DeepSeek entre horas valle y horas punta para ver cuánto influye el reloj ahí.
Elige un trabajo o introduce tus propios recuentos de tokens para comparar un mes de Mercury 3 a precio de lanzamiento y de lista con GPT-6 Luna, Claude Haiku 5.5, DeepSeek V4.1 Flash y Gemini 3.8 Flash.
Lo que cuesta una tarea real en Mercury 3
Aquí tienes los cuatro ajustes predefinidos de la calculadora en forma de tabla, para que veas el patrón sin hacer clic. Cada uno asume tarifas estándar, DeepSeek en horas valle y sin créditos gratuitos.
| Trabajo (por mes) | Forma de una tarea | Mercury 3 lanzamiento | Mercury 3 lista | GPT-6 Luna | Haiku 5.5 | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|---|
| 20,000 respuestas de soporte | 1 llamada, 6,000 de entrada (70% en caché), 400 de salida | $7.24 | $14.48 | $8.44 | $8.44 | $10.45 | $63.30 |
| 10,000 tareas de agente | 12 llamadas, 8,000 de entrada (85% en caché), 600 de salida | $47.76 | $95.52 | $58.56 | $58.56 | $67.25 | $439.20 |
| 1,000 documentos largos | 1 llamada, 200,000 de entrada, 2,000 de salida | $20.70 | $41.40 | $21.00 | $105.00 | $31.20 | $157.50 |
| 500,000 clasificaciones | 1 llamada, 1,500 de entrada, 150 de salida | $101.25 | $202.50 | $112.50 | $112.50 | $157.50 | $843.75 |
Destacan tres cosas.
Primero, todas las cifras son pequeñas. Diez mil tareas de agente de 12 pasos cuestan menos de $100 al mes en Mercury 3 incluso a precio de lista. Para la mayoría de los equipos que leen esto, la factura del modelo no es la decisión. Lo son la velocidad, la calidad y el trabajo alrededor del modelo.
Segundo, el precio de lista cambia la clasificación. En el lanzamiento Mercury 3 gana todas las filas. En lista pierde frente a Luna y Haiku 5.5 en respuestas de soporte, tareas de agente y clasificación, por aproximadamente 1,6 a 1,8 veces. En documentos largos supera a Haiku 5.5, cuya tarifa por encima de 100K entra en juego ($41.40 frente a $105), pero sigue costando cerca del doble que los $21 de Luna. Si el prompt pasa de 272K, la tarifa de contexto largo de Luna cierra esa brecha hasta el empate.
Tercero, la salida es la mayor parte de la factura cuando el caché funciona. En la fila de tareas de agente a precio de lista, así se reparte el dinero:
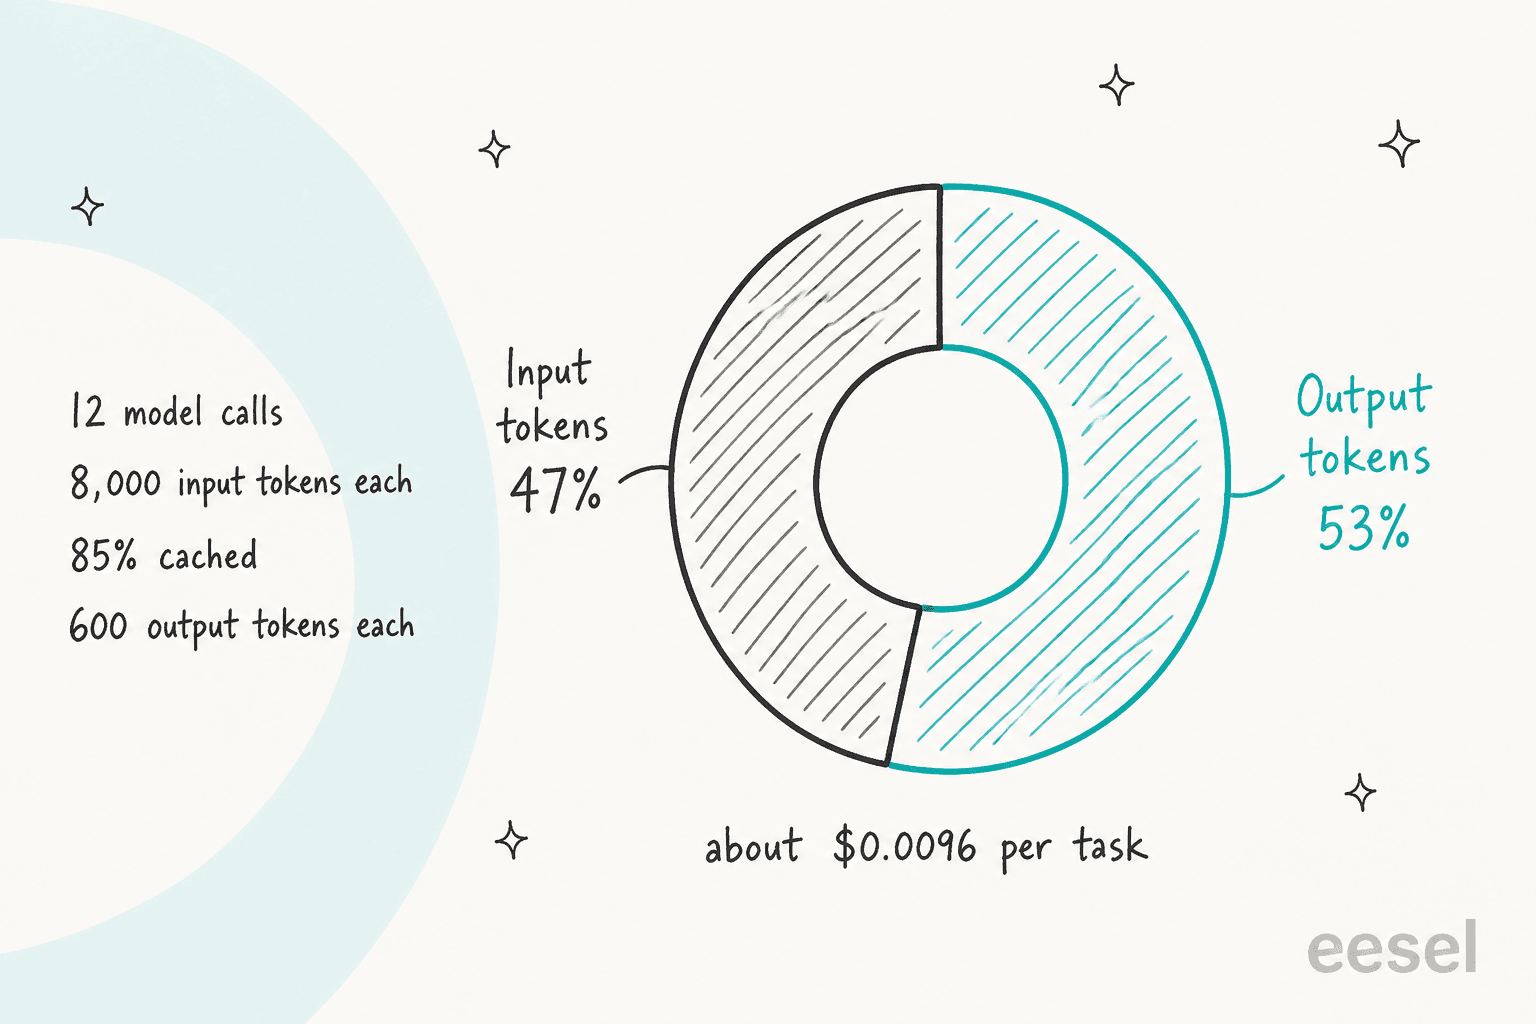
Con el 85% de la entrada en caché a una décima parte del precio, los 600 tokens de salida por llamada pesan más que 8,000 tokens de entrada. Como los tokens de razonamiento se facturan como salida, el esfuerzo de razonamiento que elijas es el principal mando de costes. Pasar del low por defecto a medium o high añade tokens de razonamiento a cada llamada. Prueba si instant o low mantienen la calidad en tu trabajo antes de pagar más.
Otra línea de esa tabla merece su propia nota. Si tu trabajo es clasificación, Mercury 3 es el modelo de Inception equivocado para calcular. Mercury Decide factura solo la entrada, a $0.02 por millón en el lanzamiento y $0.04 en lista, y no cobra la salida. Las mismas 500.000 clasificaciones costarían unos $15 en el lanzamiento, frente a $101.25 en Mercury 3. Mi guía sobre clasificación de tickets con IA explica cuándo un clasificador supera a un modelo de chat para ese trabajo.
Los detalles de facturación que mueven tu factura
Más allá de la tabla de precios, cinco detalles cambian lo que realmente pagas. Ninguno está oculto, pero están repartidos en cuatro páginas distintas.
El caché es automático, sin tarifa de escritura
Inception guarda en caché los prefijos de prompt repetidos por su cuenta, sin parámetro en la petición. Los tokens en caché se facturan a una décima parte del precio de entrada, y la tabla de precios no tiene recargo por escritura en caché. Es más simple que las tablas de OpenAI y Anthropic, que listan una tarifa de escritura en caché aparte ($0.125 por millón para Luna y para las escrituras de 5 minutos de Haiku 5.5). La contrapartida es el control: la FAQ dice que Inception no documenta cuánto tiempo permanece un prefijo en caché, y no puedes fijar ni inspeccionar las entradas.
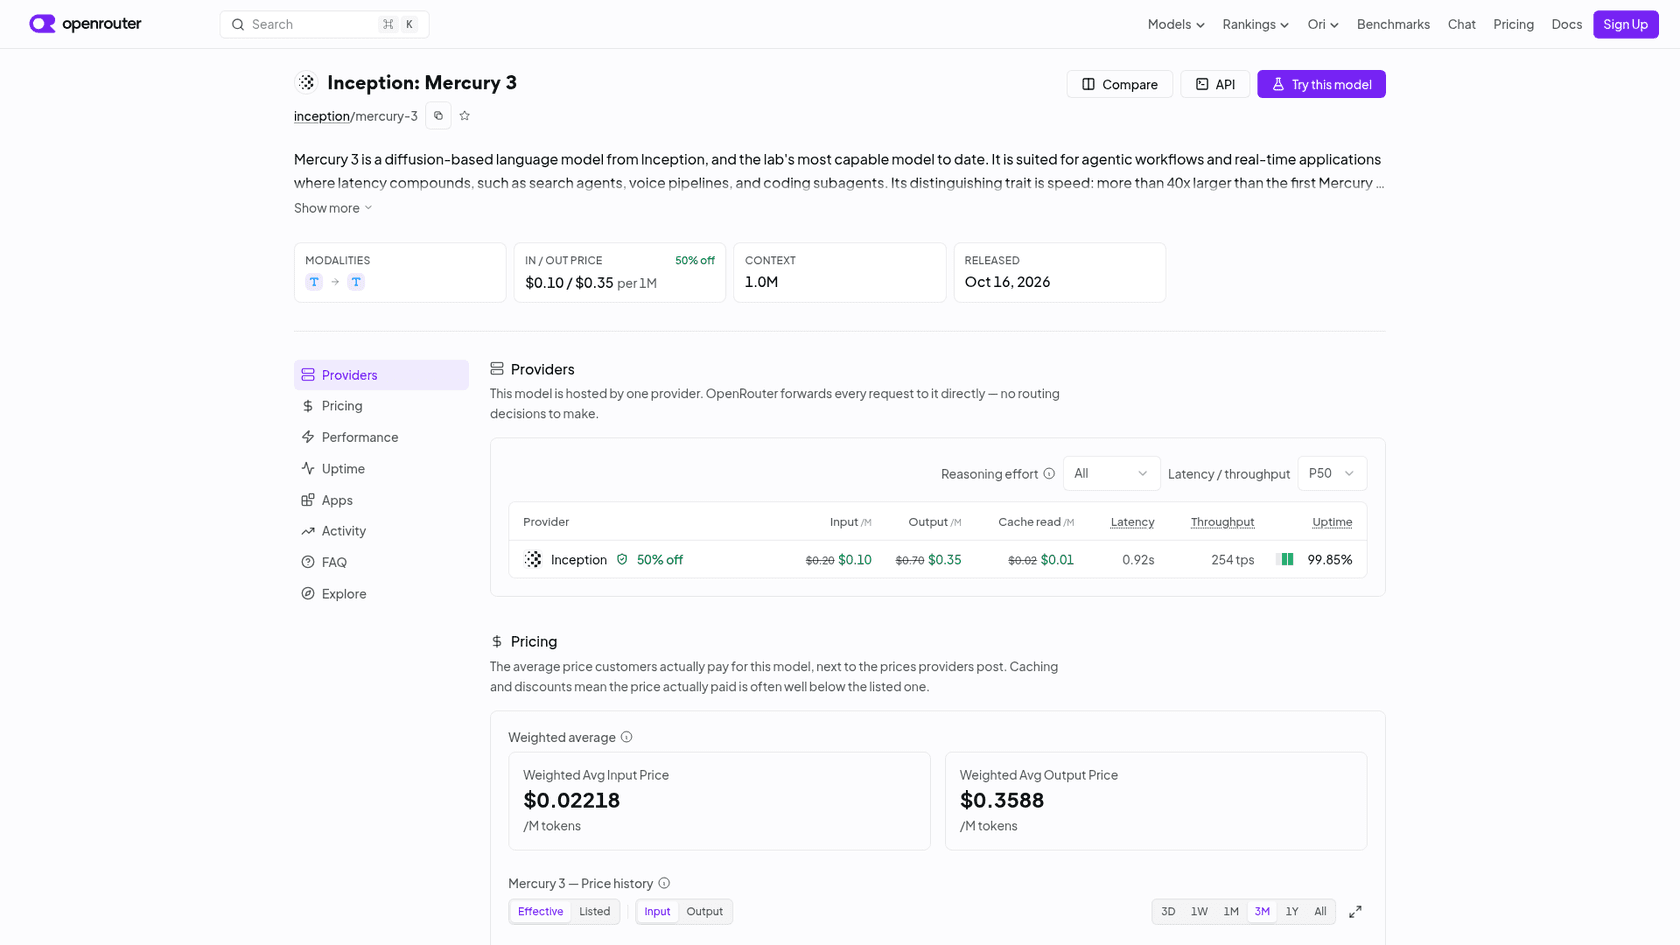
El efecto en la práctica es grande. OpenRouter publica lo que pagan realmente los usuarios de Mercury 3, y el 20 de octubre de 2026 su precio medio ponderado de entrada fue de $0.0222 por millón, frente a $0.10 listados, con un 86,6% de aciertos de caché en todo su tráfico. Si tu aplicación reutiliza un prompt de sistema largo, presupuesta la entrada más cerca de la tarifa en caché que de la tarifa de cabecera.
OpenRouter cuesta lo mismo
La página de Mercury 3 en OpenRouter lista un proveedor, Inception, con los mismos precios de lanzamiento de $0.10 / $0.35 / $0.01. Así que pasar por OpenRouter no te ahorra ni te cuesta nada en la tarifa por token. Inception también cita a Baseten y Vercel como socios de lanzamiento, pero ninguno publica un precio de Mercury 3; Baseten pide que los contactes. Si ya compras modelos abiertos a través de Together AI o Fireworks, ten en cuenta que Mercury 3 no tiene pesos públicos, así que solo lo venden Inception y los socios que nombra.
Los tokens gratis rinden más de lo que parece
100 millones de tokens son muchos a este tamaño. Con la forma de respuesta de soporte de arriba, unos 6.400 tokens por respuesta, son aproximadamente 15.600 respuestas si cada token cuenta contra la concesión. Con la forma de tarea de agente de 12 llamadas, unos 103.000 tokens por tarea, son menos de 1.000 tareas. Es suficiente para hacer una evaluación real con tu propio tráfico, que es exactamente como lo gastaría yo.
Los límites de uso pueden afectarte antes que el precio
El nivel gratuito permite 100,000 tokens de salida por minuto. Una sola petición en streaming a los 1.068 tokens por segundo que cita Inception produce unos 64.000 tokens por minuto, así que dos streams a plena velocidad pueden alcanzar el tope de salida del nivel gratuito. El pago por uso lo triplica a 300,000. En la práctica OpenRouter midió un promedio de una semana de 203 tokens por segundo, así que tienes más margen, pero si planeas una flota de agentes en paralelo, revisa la tabla de límites antes que la de precios.
No hay descuento por lotes
OpenAI y Anthropic ofrecen ambos procesamiento por lotes a mitad de precio en Luna y Haiku 5.5, y Google tiene niveles Batch y Flex. La tabla de precios de Inception no tiene nivel por lotes. Para trabajos nocturnos donde la latencia no importa, Luna por lotes a $0.05 de entrada y $0.25 de salida supera incluso el precio de lanzamiento de Mercury 3, así que las cargas aptas para lotes son el único caso en el que me saltaría Mercury 3 solo por coste. Mi guía de precios de la API de OpenAI explica cómo funciona el nivel por lotes.
¿Compensa la velocidad el precio de lista?
Esta es la pregunta real detrás del descuento. Si Mercury 3 fuera solo barato, el fin de la promoción acabaría con el argumento a su favor. El argumento que sobrevive al precio de lista es la velocidad.
Inception cita 1.068 tokens por segundo; el promedio medido por OpenRouter en una semana fue de 203, frente a los aproximadamente 130 que Inception indica para Luna. La diferencia importa más en bucles de agentes, donde las llamadas se encadenan y cada segundo de generación se acumula. Mi resumen de Mercury 3 incluye una calculadora para ese tiempo de espera. Para los precios, el enfoque útil es este: en lista pagas aproximadamente 1,6 a 1,8 veces la factura de tokens de Luna para recortar el tiempo de generación en cadenas largas. Para subagentes de Claude Code, agentes de navegador y pipelines de voz, suele merecer la pena. Para un trabajo en segundo plano que nadie espera, no.
Si la velocidad es lo que te trae aquí, también conviene comparar la vía del hardware. Groq vende inferencia rápida sobre modelos abiertos, cubierta en mi artículo sobre Groq 3 LPX. Y si quieres entender por qué los modelos de difusión son rápidos en primer lugar, mi explicación sobre los modelos de IA basados en difusión lo detalla.
Cuándo Mercury 3 es la opción barata y cuándo no
Así decidiría yo, con el precio de lista en mente.
- Prompts largos, de 100K tokens en adelante. Mercury 3 a precio de lista supera aquí claramente a Haiku 5.5. Frente a Luna cuesta aproximadamente el doble entre 100K y 272K, y luego empata más o menos pasados los 272K. Si tus llamadas llevan varios cientos de miles de tokens de documentos o historial, es una opción sólida con cualquiera de los dos precios.
- Bucles de agentes donde la velocidad importa. Paga la prima en lista. Vuelve a ejecutar antes la calculadora con tus recuentos reales de tokens.
- Llamadas cortas, de alto volumen y tolerantes a la latencia. En lista, Luna y Haiku 5.5 son más baratos, y DeepSeek V4.1 Flash en horas valle se acerca. Disfruta del precio de lanzamiento mientras dure, pero construye tu presupuesto sobre las alternativas.
- Trabajos por lotes o nocturnos. Usa un proveedor con nivel por lotes. Luna por lotes cuesta la mitad de la tarifa estándar de Luna.
- Clasificación y enrutamiento. Calcula Mercury Decide, no Mercury 3, o un modelo pequeño. Mi recopilación de modelos de lenguaje pequeños cubre opciones que puedes alojar tú mismo.
- Todo lo que necesite visión o pesos abiertos. Mercury 3 es solo texto con pesos cerrados. DeepSeek V4.1 Flash admite visión y Gemini 3.8 Flash también acepta imágenes. Si quieres un modelo de difusión abierto, mira DiffusionGemma.
Si estás comparando más modelos de la gama económica, mis desgloses de precios de Gemini 3.8 Flash, precios de Gemini 3.5 Flash-Lite y precios de Kimi K3 usan el mismo método por tarea.
La factura de tokens vs. el coste total de un agente de IA
La mayor parte del coste de poner un modelo a trabajar en un caso real está fuera de la tabla de precios, y el soporte es donde lo veo con más claridad. Un mes de 10.000 tickets son menos de $100 de tokens de Mercury 3 incluso a precio de lista. Pero para que esos tokens respondan tickets, tienes que construir la conexión con el helpdesk, la recuperación sobre tu centro de ayuda y tus tickets pasados, reglas para saber cuándo derivar, una forma de probar con conversaciones reales y la monitorización para detectar una mala respuesta. Son semanas de ingeniería, más mantenimiento cada vez que cambian tu helpdesk o tus políticas.
Ese compromiso nos resulta familiar por nuestras propias llamadas de ventas. Un responsable de ingeniería de una empresa de hardware cripto con una base de conocimiento en Confluence de más de 300 artículos lo expresó con sencillez al decidir comprar en lugar de construir:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Mira lo que ejecuta uno de nuestros clientes para ver la escala. smava, una plataforma berlinesa de comparación de préstamos, gestiona unos 27.000 tickets de Zendesk al mes en dos marcas con tres agentes de eesel: uno categoriza cada ticket, otro redacta la respuesta a partir de unas 820 macros y artículos del centro de ayuda, y uno por marca prepara respuestas listas para el cliente en los tickets sin asesor asignado. Los agentes aprueban cada borrador, y un ticket con adjuntos pasa a una persona con una nota. Cada una de esas reglas es trabajo que una factura por token no incluye.
SE Ranking es otra forma del mismo argumento: unas 4.650 conversaciones al mes en tres productos, con un agente de eesel por producto, respondiendo a partir de unas 16.800 páginas de conocimiento. Ninguno de los dos equipos tuvo que pensar en tokens, caché ni esfuerzo de razonamiento. Mis guías sobre el coste de agentes de IA vs. humanos y el coste de un chatbot hacen las cuentas completas de ambos caminos.
Prueba eesel
Mercury 3 es infraestructura, y en el lanzamiento es infraestructura de muy buena relación calidad-precio. eesel es el empleado. Si estás calculando un modelo porque quieres que una IA responda tickets de soporte, su teammate de helpdesk con IA se incorpora a la cola que ya gestionas, en Zendesk y los demás helpdesks principales, aprende de tus tickets y documentos pasados y se reproduce a sí mismo contra tus conversaciones históricas antes de responder a un solo cliente.

El precio funciona como piensa un responsable de soporte: los planes empiezan en $299 al mes por 500 créditos, un ticket o un chat es un crédito sin importar lo que dure, y la prueba gratuita te da 100 créditos sin tarjeta. Compáralo con una solución propia por token en la página de precios.
Si prefieres manejarlo como manejarías una API de modelos, la CLI de eesel opera el mismo teammate desde una terminal, y cada comando devuelve JSON que puede leer un script o un agente de código como Claude Code. Mi guía de la CLI de agentes de IA muestra cómo se ve eso. Prueba eesel con los tickets del mes pasado y comprueba tú mismo el coste por ticket respondido. Y si estás aquí porque escribes contenido y no tickets, el equipo también tiene un redactor de blog con IA.