

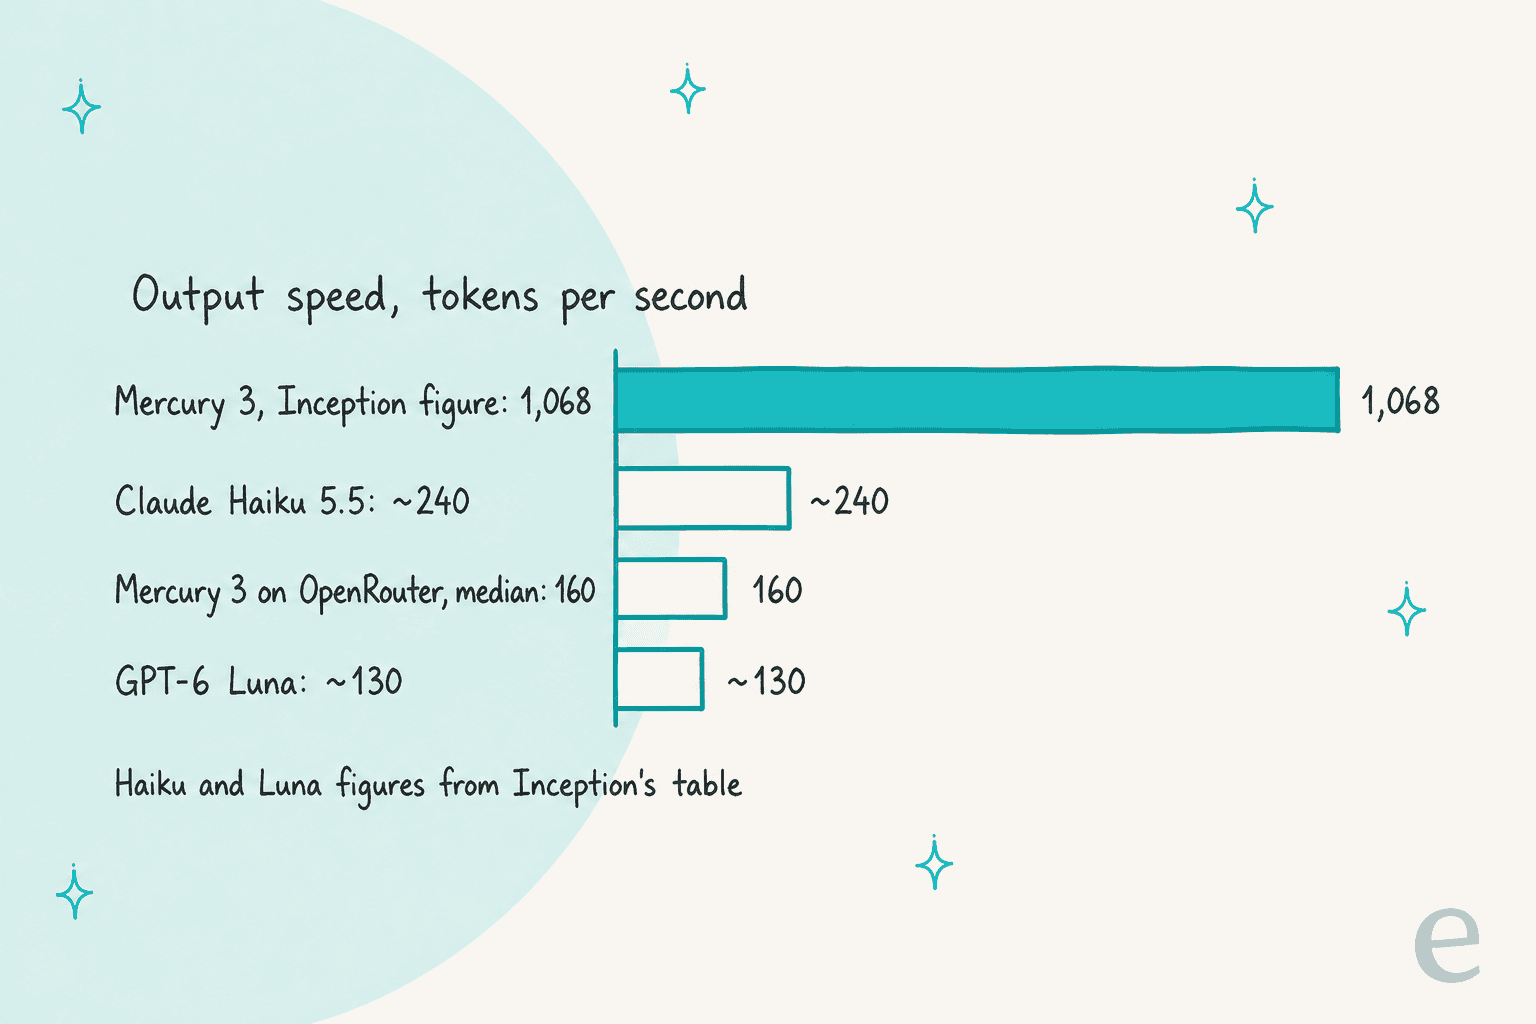
Mercury 3 es el modelo más reciente de Inception, lanzado el 19 de octubre de 2026. Es un modelo de lenguaje de difusión: en lugar de teclear un token a la vez, redacta la respuesta entera y la pule en unas pocas pasadas. Inception lo mide en 1,068 tokens por segundo, con una ventana de contexto de 1M de tokens, llamadas a herramientas y salidas estructuradas.
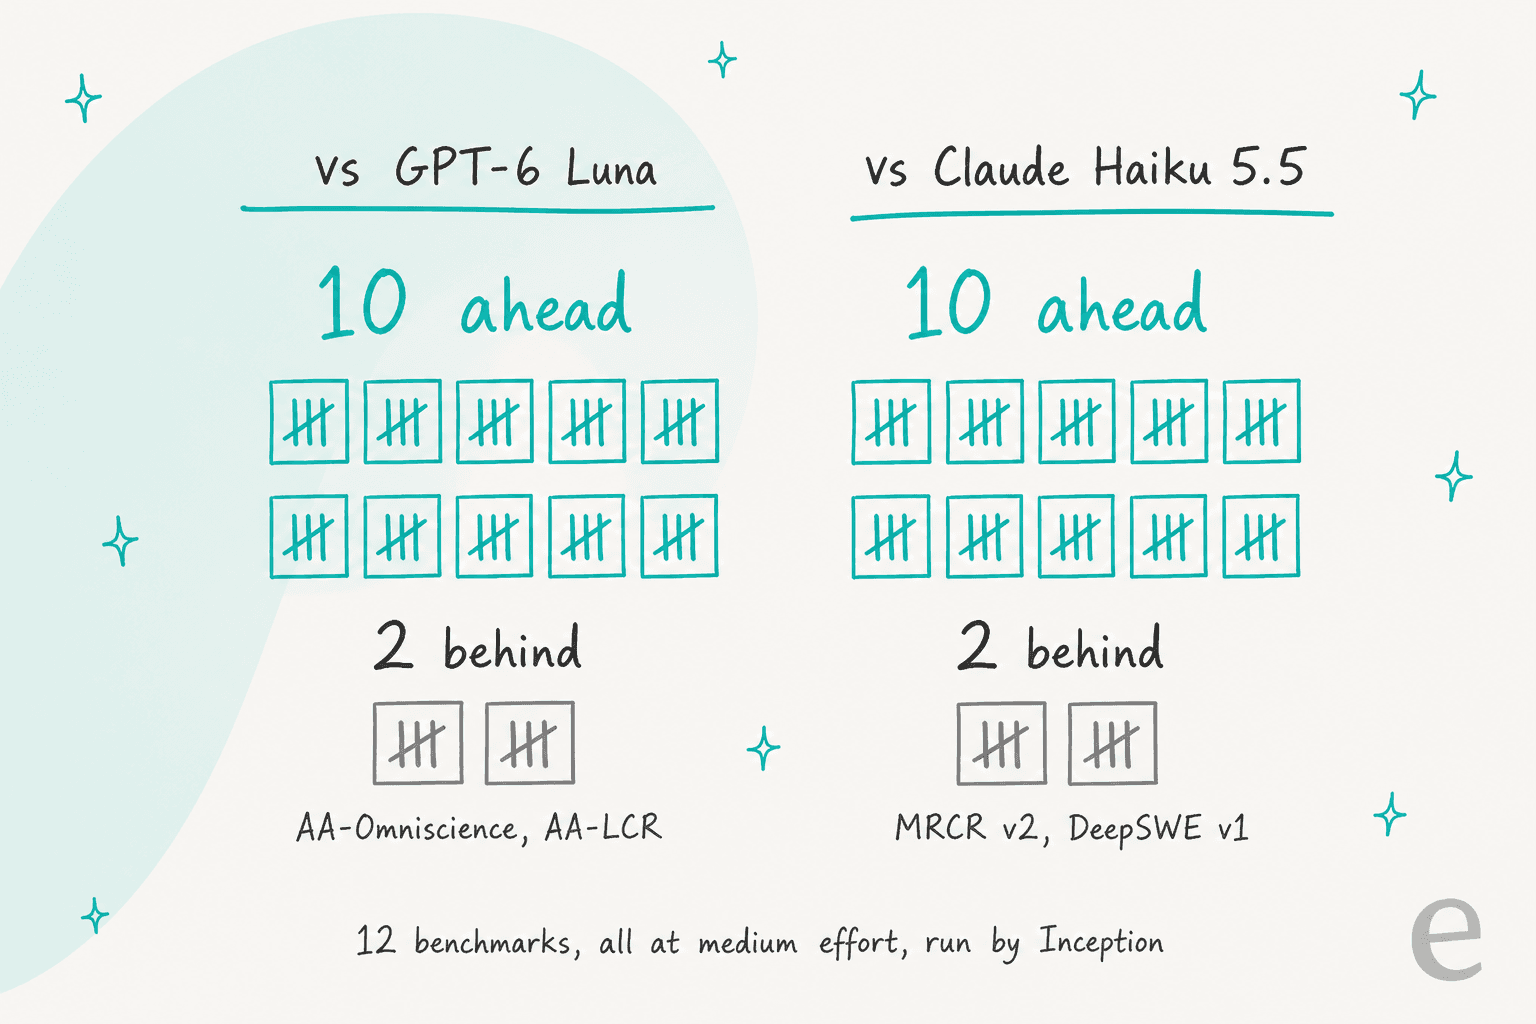
En la tabla de benchmarks propia de Inception, supera a GPT-6 Luna y Claude Haiku 5.5 en 10 de 12 pruebas, todas con esfuerzo medio. Cuesta $0.20 de entrada y $0.70 de salida por millón de tokens, la mitad en el lanzamiento ($0.10 / $0.35), y las claves nuevas reciben 100 millones de tokens gratis.
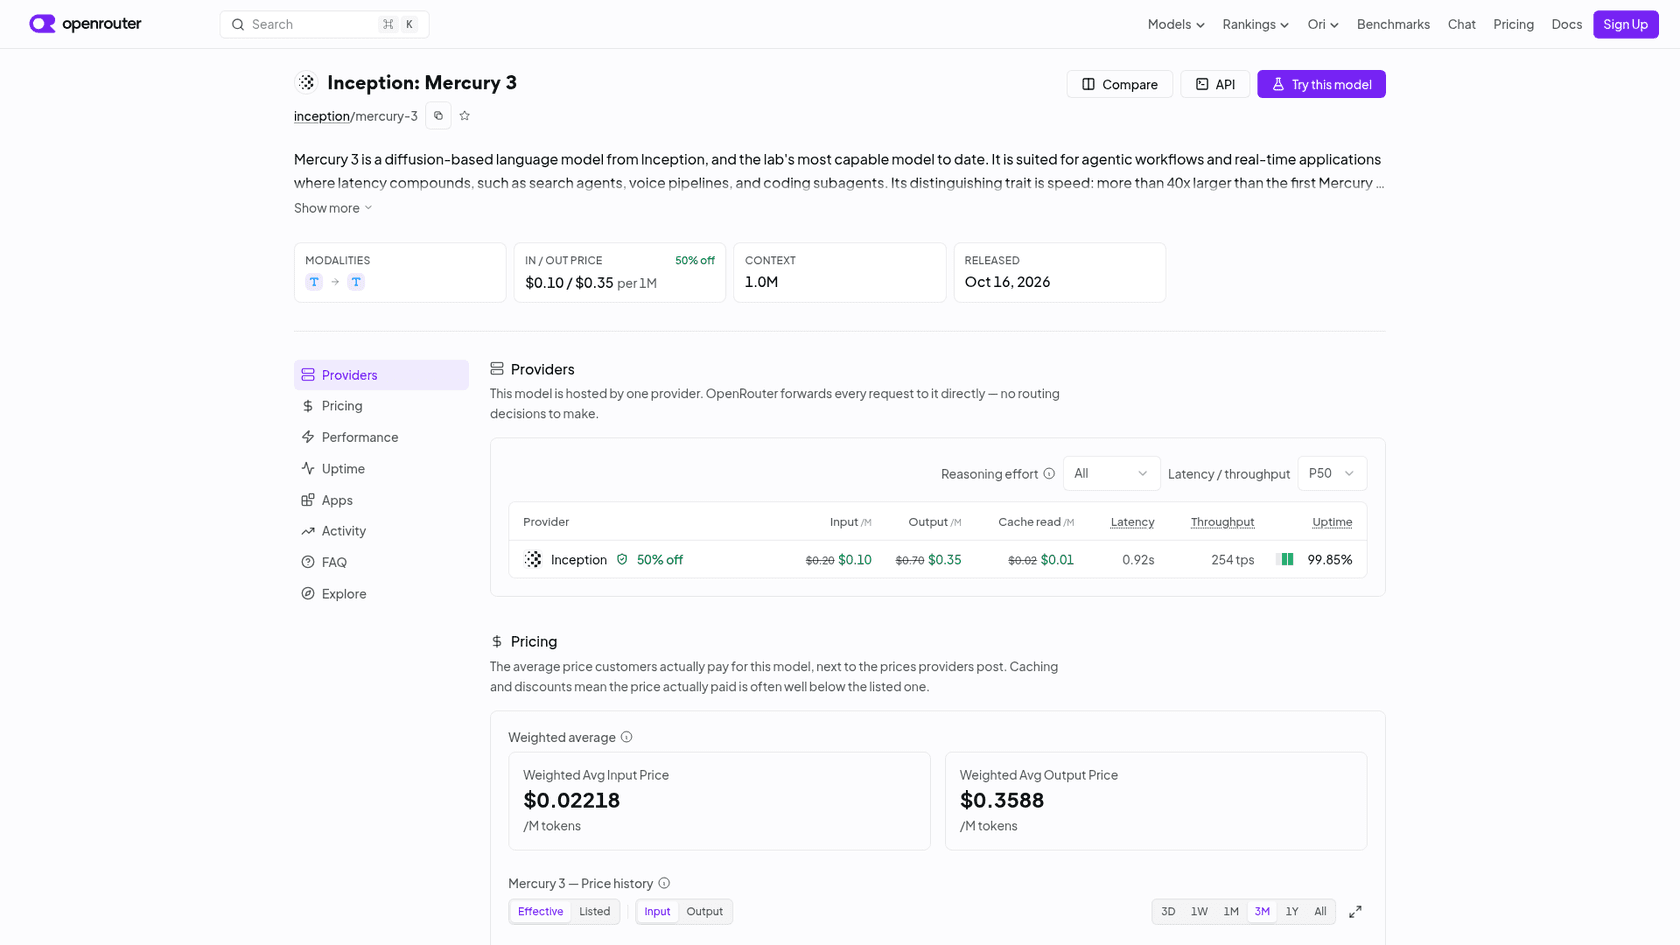
El problema es la velocidad que verás en la práctica. OpenRouter, que envía cada petición de Mercury 3 a Inception, midió una mediana de 160 a 254 tokens por segundo en la semana de lanzamiento, rápido pero muy lejos de 1,068, y los probadores de Hacker News señalaron un primer token lento. Úsalo en bucles de agentes y subagentes, donde la espera se acumula. Para equipos de soporte es un motor potente, pero es infraestructura: eesel es el empleado, y su compañero de IA para el helpdesk es lo que convierte un modelo como este en tickets respondidos.
Por qué miré este lanzamiento con lupa
Paso gran parte de la semana leyendo qué busca la gente y qué quiere decir en realidad. "Mercury 3" es una búsqueda de velocidad: la gente quiere saber si la cifra de 1.000 tokens por segundo sobrevive al contacto con una API real. Así que leí el lanzamiento de esa manera, con las páginas de Inception abiertas junto a las cifras en vivo de OpenRouter y el hilo de lanzamiento de Hacker News.
Hay una segunda razón. eesel lleva años poniendo modelos de IA en colas de soporte reales, y la lección que se repite es que las cifras de laboratorio de un modelo nunca deciden si funcionará con tus tickets. Por eso eesel simula cada despliegue con los tickets históricos del cliente antes de que la IA responda a nadie. Apliqué el mismo hábito aquí: contrasta la afirmación con una medición externa antes de planificar en torno a ella.
¿Qué es Inception Mercury 3?
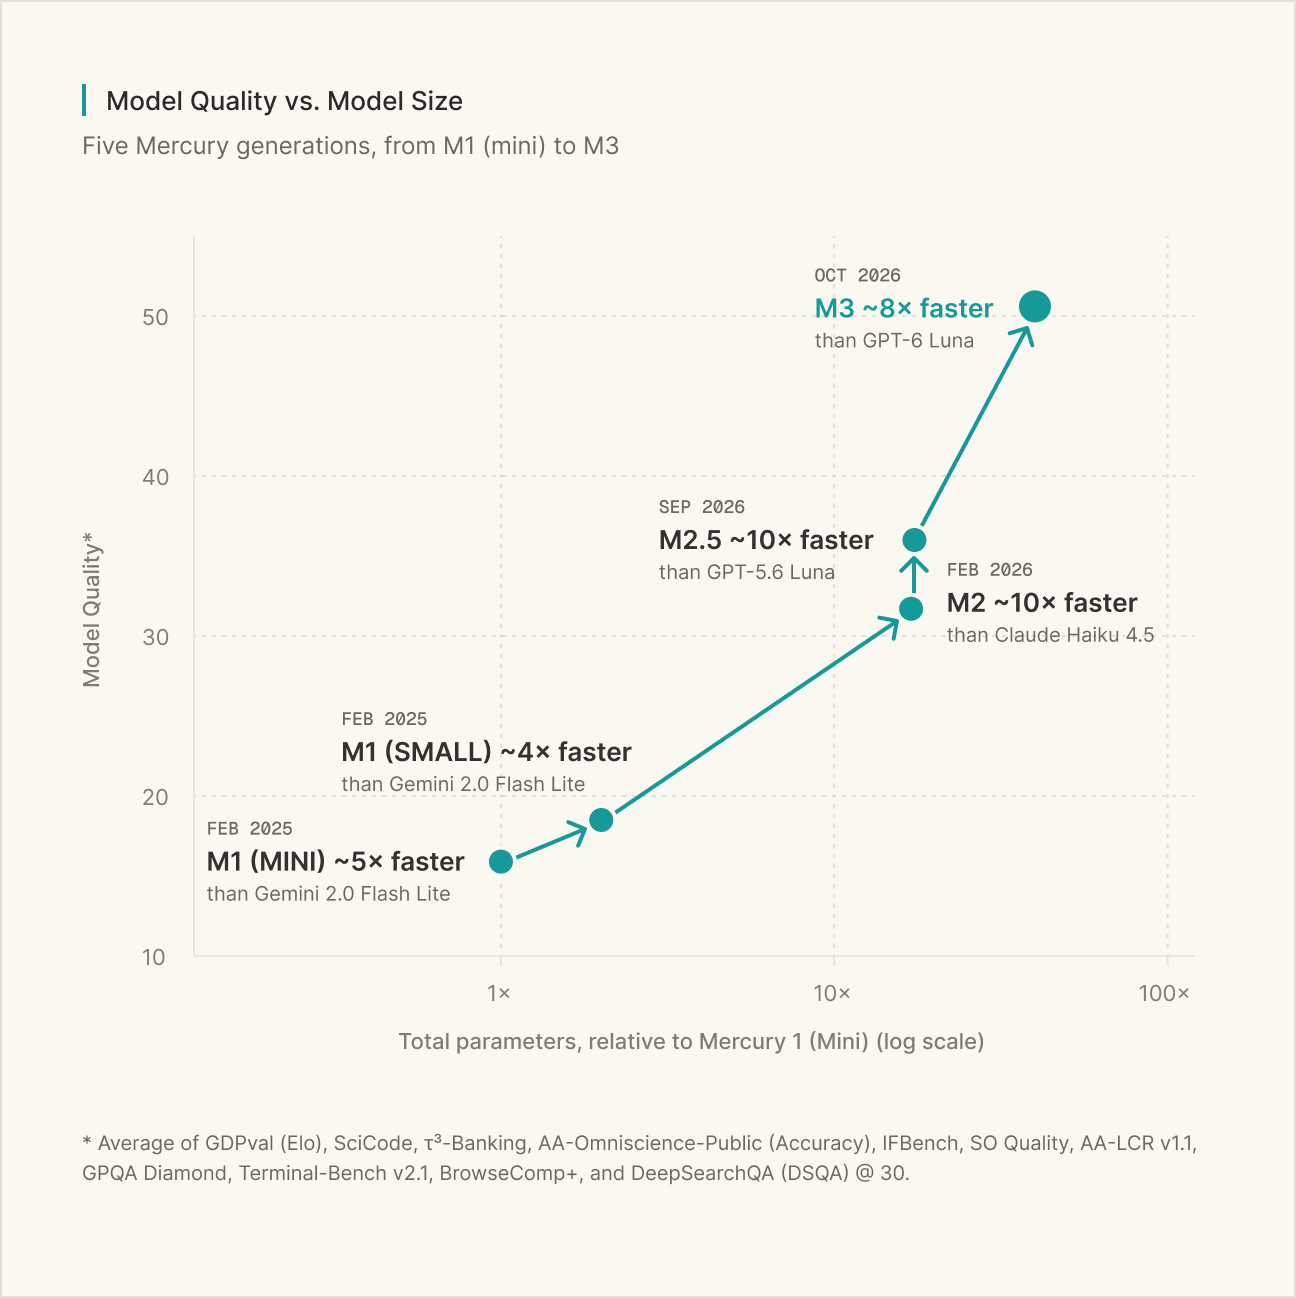
Mercury 3 es el modelo insignia de Inception, un laboratorio que construye lo que llama LLM de difusión (dLLM). La publicación de lanzamiento de Inception lo llama "the most capable diffusion-based LLM released to date" y dice que es más de 40 veces más grande que Mercury 1 y corre a la misma velocidad. Sustituye a Mercury 2.5, que salió apenas el mes pasado.
Esto es lo que obtienes, directamente de la documentación de modelos de Inception:
| Característica | Mercury 3 |
|---|---|
| Fecha de lanzamiento | 19 de octubre de 2026 |
| Tipo | LLM de difusión, pesos cerrados |
| Velocidad de salida (cifra de Inception) | 1,068 tokens por segundo en GPU de NVIDIA |
| Ventana de contexto | 1M de tokens (frente a 260K en Mercury 2.5) |
| Salida máxima | 131,072 tokens |
| Esfuerzo de razonamiento | instant, low, medium, high |
| Funciones | Llamadas a herramientas, salidas estructuradas |
| Entrada y salida | Solo texto |
| API | Compatible con OpenAI, ID de modelo mercury-3 |
| Precio (lista) | $0.20 entrada / $0.70 salida por 1M de tokens |
| Precio (lanzamiento, 50 % de descuento) | $0.10 entrada / $0.35 salida por 1M de tokens |
| Cuota gratuita | 100 millones de tokens en claves de API nuevas |
Dos cosas que la tabla no dice. Inception no ha publicado el número de parámetros; su cofundador escribió en Hacker News que "not publicly announcing the model size right now." Y no hay pesos que descargar. Si eso te importa, DiffusionGemma de Google es el modelo de difusión abierto con el que comparar.
¿En qué se diferencia un LLM de difusión?
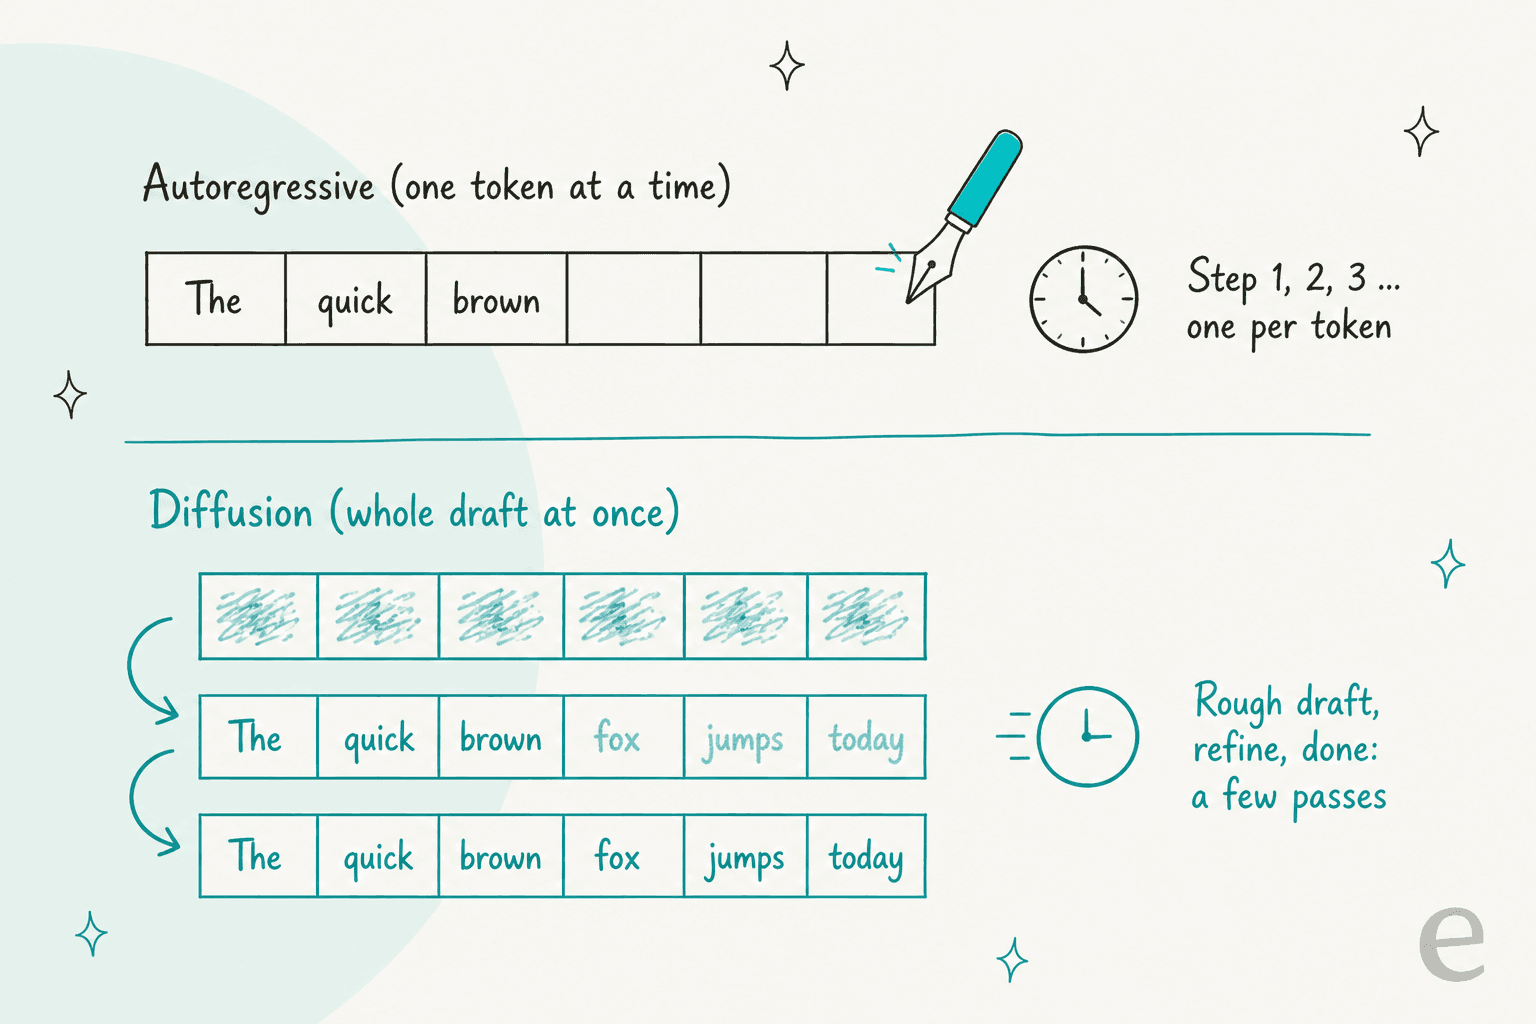
Casi todos los modelos que usas hoy, desde GPT-6.1 Sol hasta DeepSeek V4.1 Flash, son autorregresivos. Predicen el siguiente token, lo añaden y repiten, de izquierda a derecha. Por eso las respuestas largas tardan: una respuesta de 2,000 tokens son 2,000 pasos seguidos, sin importar lo rápido que sea cada paso.
Un modelo de difusión funciona al revés. Parte de un borrador tosco y ruidoso de toda la respuesta y lo refina todo en paralelo en un número reducido de pasadas. La publicación de lanzamiento de Mercury 2 de Inception lo dijo bien: "Less typewriter, more editor revising a full draft at once." Si has visto a un generador de imágenes sacar una imagen nítida de la estática, es la misma idea aplicada al texto. Mi explicación sobre los modelos de IA basados en difusión profundiza en el lado de las imágenes.
Por qué importa más ahora: los modelos de razonamiento piensan antes de responder, y pensar son tokens de salida. El cofundador y científico jefe de Inception, Volodymyr Kuleshov, señaló en el hilo de lanzamiento que, como la difusión escribe tokens en paralelo, la brecha de velocidad crece cuanto más piensan los modelos.
"Diffusion generates tokens in parallel through iterative denoising rather than one at a time, so as reasoning models think longer per answer, the speed advantage over autoregressive models of the same size grows."

Durante años, la pregunta abierta fue si los LLM de difusión podían volverse inteligentes, no solo rápidos. La respuesta de Inception es un gráfico de escalado: cinco generaciones de Mercury desde principios de 2025 hasta hoy, con la calidad subiendo a medida que crece el modelo.
Benchmarks de Mercury 3: lo que muestra la tabla de Inception
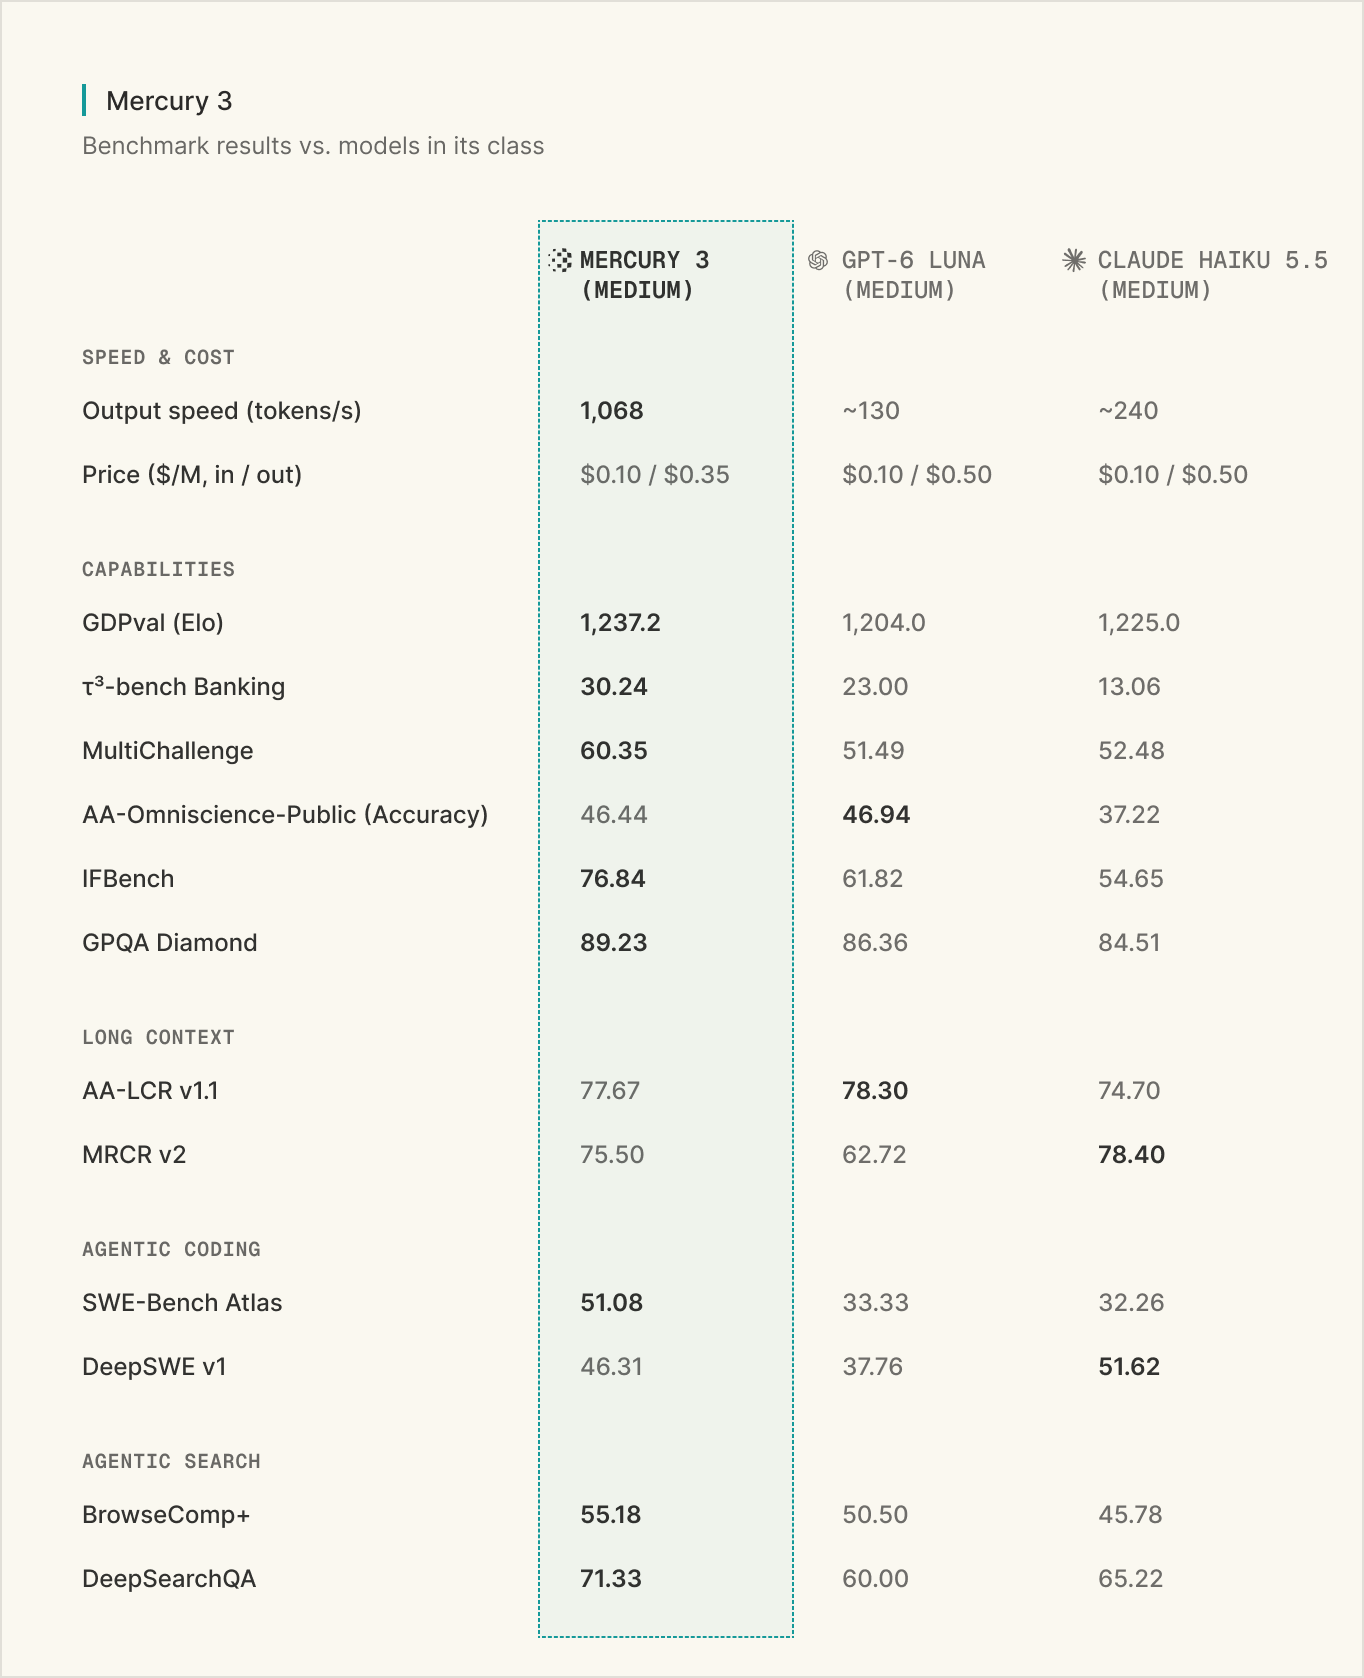
Inception compara Mercury 3 con los dos modelos a los que está pensado para reemplazar: GPT-6 Luna de OpenAI y Claude Haiku 5.5 de Anthropic, ambos con esfuerzo medio. Esta es la tabla completa de la publicación de lanzamiento:
| Benchmark | Qué mide | Mercury 3 | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|---|
| GDPval (Elo) | Tareas de trabajo reales | 1,237.2 | 1,204.0 | 1,225.0 |
| τ³-bench Banking | Agente de atención al cliente | 30.24 | 23.00 | 13.06 |
| MultiChallenge | Chat de varios turnos | 60.35 | 51.49 | 52.48 |
| AA-Omniscience (Accuracy) | Recuerdo de hechos | 46.44 | 46.94 | 37.22 |
| IFBench | Seguimiento de instrucciones | 76.84 | 61.82 | 54.65 |
| GPQA Diamond | Ciencia de nivel de posgrado | 89.23 | 86.36 | 84.51 |
| AA-LCR v1.1 | Razonamiento de contexto largo | 77.67 | 78.30 | 74.70 |
| MRCR v2 | Recuerdo de contexto largo | 75.50 | 62.72 | 78.40 |
| SWE-Bench Atlas | Programación agéntica | 51.08 | 33.33 | 32.26 |
| DeepSWE v1 | Programación agéntica | 46.31 | 37.76 | 51.62 |
| BrowseComp+ | Búsqueda agéntica | 55.18 | 50.50 | 45.78 |
| DeepSearchQA | Búsqueda agéntica | 71.33 | 60.00 | 65.22 |
Leyendo toda la tabla, Mercury 3 tiene la mejor puntuación en 8 de 12 filas. Cara a cara, supera a cada rival en 10 de 12.
Tres cosas que tendría en cuenta antes de citarlo:
- Cada cifra sale de la ejecución de Inception. Todavía no hay una página de Artificial Analysis para Mercury 3, y Kuleshov dijo en Hacker News que las pruebas de terceros siguen en curso.
- Todo es con esfuerzo medio. Un comentarista preguntó por qué, ya que mucha gente ejecuta los modelos baratos con esfuerzo alto o máximo. No hay una curva de bajo a alto, así que no se sabe cuánto acortan distancias Luna o Haiku con más razonamiento.
- Las mayores victorias están en las pruebas de agentes. SWE-Bench Atlas (51 frente a 33) y τ³-bench Banking (30 frente a 23 y 13) son brechas amplias. Las derrotas están en el recuerdo de contexto largo y en una prueba de programación, donde Haiku 5.5 va por delante.
El resumen honesto viene de la propia Inception. Al preguntarle por qué Haiku ganó DeepSWE, Kuleshov no exageró:
"overall we have found the model to be Haiku- or Luna-level in our own daily usage. That means that it won't yet replace Opus or Fable as the primary driver of a harness, but we have used it successfully for subagents"
Ese es el marco que usaría: inteligencia de clase Luna, salida mucho más rápida. Los resultados de socios en la publicación de lanzamiento apuntan en la misma dirección. TinyFish dice que Mercury 3 completó la mitad de 50 tareas reales de navegación web de Mind2Web, "significantly more than GPT-6.1-Sol", y Octen midió una mediana de tiempo de generación de 0.9 segundos en sus pruebas de búsqueda para gafas inteligentes.
¿Qué tan rápido es Mercury 3 en la práctica?
Esta es la parte que la mayoría de la cobertura del lanzamiento se salta. La cifra de 1,068 es la medición de Inception en su propio hardware de NVIDIA. El único número independiente que pude encontrar viene de OpenRouter, que tiene un único proveedor para Mercury 3 (la propia Inception) y publica el rendimiento en vivo.
Cuando lo revisé el 20 de octubre de 2026, OpenRouter mostraba una mediana de 160 tokens por segundo, y una segunda captura más tarde ese mismo día mostraba 254. Su promedio semanal de la mediana es 203, con una latencia mediana de alrededor de un segundo. Sigue siendo más rápido que los ~130 que Inception indica para Luna, pero es aproximadamente una quinta parte del titular.
¿Por qué la brecha? El rendimiento de OpenRouter se mide con tráfico real, con el esfuerzo de razonamiento que elija cada usuario y bajo la carga que tengan los servidores. La ventaja de velocidad de la difusión es mayor con baja concurrencia, que es el compromiso que describió un comentarista sobre el modelo de difusión experimental de Google:
"It doesn't benefit from batching to reduce memory bandwidth in the same way that a "standard" autoregressive model does, which ends up meaning that it's great at reducing latency for individual/low-concurrency users and delivers better outcomes on certain tasks but much more expensive per token at scale."
Kuleshov dice que Mercury ha escalado bien con el tamaño del lote, y los precios de Inception sugieren que puede servirse a volumen. Pero Simon Willison, que hizo su habitual prueba del pelícano, encontró la velocidad "a bit disappointing", y llamar directamente a la API de Inception en lugar de pasar por OpenRouter "didn't seem to speed it up."
¿Importa todavía la velocidad real? Depende de cuántas llamadas al modelo haya seguidas. Un chatbot que hace una llamada por mensaje apenas nota la diferencia entre 1,068 y 160. Un agente que hace 12 llamadas en secuencia las siente todas. Introduce tu propia tarea en la calculadora de abajo para ver dónde deja de importar la brecha de velocidad.
Cambia el número de pasos y de tokens por paso para ver cuánta espera del modelo ahorra Mercury 3 por tarea, a la velocidad de Inception y a la mediana medida por OpenRouter.
Con los valores por defecto (12 llamadas de 600 tokens), Mercury 3 termina de generar en 6.7 segundos a la velocidad de Inception y en 45 segundos con la mediana de OpenRouter, frente a 55 segundos de Luna. Incluso la cifra más lenta ahorra tiempo en cadenas largas. Con una sola llamada, toda la diferencia se reduce a menos de un segundo, y por eso Mercury 3 es una opción para bucles, no para respuestas sueltas.
Precios de Mercury 3 de un vistazo
Inception publica una única tarifa, igual en su propia API y en OpenRouter. La página de modelos lista toda la familia:
| Modelo | Entrada (lista → lanzamiento) | Entrada en caché | Salida (lista → lanzamiento) | Contexto | Ideal para |
|---|---|---|---|---|---|
| Mercury 3 | $0.20 → $0.10 | $0.02 → $0.01 | $0.70 → $0.35 | 1M | Razonamiento general, agentes |
| Mercury Voice | $0.40 → $0.20 | $0.04 → $0.02 | $1.50 → $0.75 | 128K | Agentes de voz, TTFT inferior a 170 ms |
| Mercury Decide | $0.04 → $0.02 | $0 | $0 (no se factura) | n/d | Clasificación, puntuación |
| Mercury Edit 2 | $0.25 | $0.025 | $0.75 | 32K | Autocompletado de código, siguiente edición |
Todos los precios son por millón de tokens. El acceso viene en tres planes: Free (100 millones de tokens, todos los modelos), Developer (por uso) y Enterprise (límites de tasa personalizados, SLA, precios por volumen). Inception no ha dicho cuándo termina el descuento de lanzamiento.
Cómo se compara con los modelos a los que persigue, usando la tarifa de cada proveedor:
| Modelo | Entrada por 1M | Salida por 1M | Nota |
|---|---|---|---|
| Mercury 3 (lanzamiento) | $0.10 | $0.35 | 50 % de descuento por ahora |
| Mercury 3 (lista) | $0.20 | $0.70 | Tras el descuento |
| GPT-6 Luna | $0.10 | $0.50 | API estándar de OpenAI |
| Claude Haiku 5.5 | $0.10 | $0.50 | Prompts de hasta 100K tokens; 5 veces más por encima |
| DeepSeek V4.1 Flash | $0.15 | $0.60 | Fuera de hora punta, sin caché; en hora punta el doble |
Así que en el lanzamiento, Mercury 3 es el token de salida más barato de este grupo. A precio de lista es el más caro en salida. Un comentarista de Hacker News expresó la preocupación con claridad: "I'm wondering if it'll still be useful once the discount is lifted?" Mi opinión: si lo compras por la velocidad, $0.70 sigue siendo barato. Si lo compras porque es barato, presupuesta al precio de lista. Mi guía de precios de GPT-6 Luna cubre por completo el lado de OpenAI, y las reglas de hora punta de DeepSeek las desgloso en mi artículo de precios de V4.1 Flash.
Un detalle más de precios que conviene saber: Mercury 2 y Mercury 2.5 están cerrados a nuevos usuarios. Los clientes existentes conservan el acceso hasta el 15 de noviembre de 2026, así que si usas alguno, planifica el cambio ya.
Cómo acceder a Mercury 3
Tienes cuatro vías de entrada, según la publicación de lanzamiento:
- Inception API Platform. Regístrate en platform.inceptionlabs.ai, crea una clave y recibe 100 millones de tokens gratis.
- OpenRouter. Mismo precio, enrutado a Inception, útil si ya facturas a través de OpenRouter.
- Baseten. Aparece en la biblioteca de modelos de Baseten, pero para acceder hay que contactar con Baseten. Mi reseña de Baseten cubre la plataforma.
- Vercel. Inception también menciona a Vercel como socio de lanzamiento.
La API es compatible con OpenAI, así que cambiar es sobre todo una URL base y un nombre de modelo. Esta es la llamada de la documentación de Inception:
curl https://api.inceptionlabs.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $INCEPTION_API_KEY" \
  -d '{
    "model": "mercury-3",
    "messages": [{"role": "user", "content": "What is a diffusion model?"}],
    "reasoning_effort": "medium",
    "max_completion_tokens": 8192
  }'
La documentación de integraciones de Inception cubre herramientas de programación (Cursor, Kilo Code, OpenCode), frameworks como LangChain y plataformas de voz como ElevenLabs y Vapi.
Para programar, el propio consejo de Kuleshov es usarlo como ayudante, no como líder. Un modelo rápido encaja con los subagentes de Claude Code y las tareas secundarias mientras un modelo mayor lleva el trabajo principal.
Qué dicen los primeros usuarios
El hilo de lanzamiento de Hacker News recibió 85 comentarios en su primer día. El ánimo fue de impresión pero con escepticismo sobre la afirmación de velocidad.
Las opiniones positivas vinieron de gente que lo probó con trabajo real:
"If their benchmarks are to be believed they've made some real progress. [...] EDIT: just trying this out on a repo and it's actually pretty good so far. Pleasantly surprised."
La queja más común fue la espera antes del primer token, que una cifra de tokens por segundo no refleja:
"Hmm at least in Openrouter, deepseek v4.1 flash via together/baseten/fireworks still beat mercury 3 on latency and intelligence Ttft is quite slow with mercury"
Otro probador vio lo mismo pero aun así le gustó el precio: "the issue with speed seems to be that ttft is still high," escribió, y añadió que "was as cheap as deepseek for a few tasks I tried." Y un comentarista cuestionó la economía: "Pricing can always be set at a loss, however, particularly for a private company." Es una pregunta razonable sin respuesta pública todavía.
Dónde se queda corto Mercury 3
- Aún sin benchmarks independientes. Todas las puntuaciones son de Inception, solo con esfuerzo medio.
- La velocidad real es menor que el titular. La mediana de OpenRouter fue de 160 a 254 tokens por segundo en la semana de lanzamiento, y los probadores reportan un primer token lento.
- Solo texto. Sin entrada de imagen ni audio. Inception dice tener prototipos multimodales internos, abiertos a probadores tempranos por correo.
- Pesos cerrados, tamaño no revelado. No puedes alojarlo tú mismo ni inspeccionarlo.
- Por detrás de Haiku 5.5 en dos pruebas. Recuerdo de contexto largo (MRCR v2) y programación DeepSWE, así que pruébalo con documentos largos antes de confiar en él ahí.
- El precio es una promoción. La salida a precio de lista cuesta $0.70, el doble de la tarifa de lanzamiento, sin fecha de fin anunciada.
- La salida estructurada no es impecable. OpenRouter muestra una tasa de error de salida estructurada del 2.78 % en su tráfico, así que mantén una validación de esquema en tu pipeline.
¿Es bueno Mercury 3 para atención al cliente?
El soporte es uno de los cuatro usos en producción que Inception cita en el lanzamiento, y la mayor brecha de benchmark para trabajo de soporte es τ³-bench Banking, que simula a un agente atendiendo clientes de un banco: 30.24 para Mercury 3 frente a 23.00 para Luna y 13.06 para Haiku 5.5. Lorikeet, un proveedor de IA de soporte, dijo a Inception que en las primeras pruebas "Mercury 3 beat other models on latency while also performing higher on evals and in production." Si estás comparando proveedores de soporte, mi artículo sobre alternativas a Lorikeet cubre ese mercado.
La velocidad importa más en los canales en vivo. En el chat web y los agentes de voz, un cliente mira los puntitos o escucha silencio. En tickets de correo, unos segundos no cambian nada. Ahí apunta Mercury Voice, con un tiempo hasta el primer token inferior a 170 milisegundos, y vale la pena compararlo con las herramientas de mi recopilación de los mejores agentes de voz con IA.
Pero una respuesta rápida y equivocada sigue siendo una respuesta equivocada. Lo que eesel aprendió ejecutando IA en colas reales es que no puedes confiar en ningún modelo en una cola en vivo hasta haber visto cómo maneja tus propios tickets pasados. Una puntuación de 30 en el benchmark bancario también significa que falló la mayoría de esas tareas, así que el modelo necesita protecciones, escalado y pruebas a su alrededor. Mi guía de prevención de alucinaciones de IA cubre esas protecciones, y la clasificación de tickets con IA es un primer trabajo de bajo riesgo para un modelo barato y rápido como este.
¿Quién debería usar Mercury 3?
Así lo decidiría yo:
- Quienes construyen agentes con cadenas largas de llamadas. Agentes de navegador, de búsqueda, subagentes de programación. Aquí la velocidad se acumula y aquí son más fuertes los resultados de socios de Inception. Pruébalo primero.
- Equipos de voz y chat en tiempo real. Mira Mercury Voice por la latencia del primer token y prueba Mercury 3 para los pasos de razonamiento detrás. Compáralo con Retell AI si quieres un stack de voz completo.
- Equipos que pagan Luna o Haiku en llamadas de alto volumen y bajo riesgo. Con el precio de lanzamiento es más barato en salida y más rápido. Rehaz las cuentas a precio de lista antes de comprometerte.
- Quien necesite visión, pesos o recuerdo de documentos largos. Espera, o elige otro modelo. Gemini 3.8 Flash maneja imágenes, y DeepSeek V4.1 Flash tiene pesos abiertos.
- Equipos cuyo cuello de botella no es el modelo. Si una sola respuesta tarda un segundo de cualquier manera, la velocidad no moverá tus números. Mira primero tu configuración de API de agente de IA o la recuperación de información.
Si todavía estás explorando el terreno, mi recopilación de los mejores agentes de IA y la guía del mejor modelo para tickets de soporte son buenas lecturas siguientes.
Prueba eesel
Mercury 3 es infraestructura: un modelo rápido, una API y una factura por token. Para ponerlo en tu cola de soporte, todavía tendrías que construir la conexión con el helpdesk, la recuperación sobre tu centro de ayuda, las reglas de escalado y el entorno de pruebas. eesel es el empleado. Su compañero de IA para el helpdesk se une a la cola que ya gestionas, aprende de tus tickets y documentos pasados, y puedes reproducirlo con tus conversaciones históricas antes de que responda a un solo cliente.
SamCart es un buen ejemplo de dónde se encuentran la velocidad y los canales. Ejecuta un agente de eesel en tickets de Freshdesk y otro aparte en la burbuja de chat de su sitio web, cada uno con su propio saludo y tono, ambos respondiendo desde unos 280 artículos del centro de ayuda. El agente de tickets responde solo hasta que un compañero toma el ticket, y un vendedor que pide hablar con una persona pone fin a su parte.
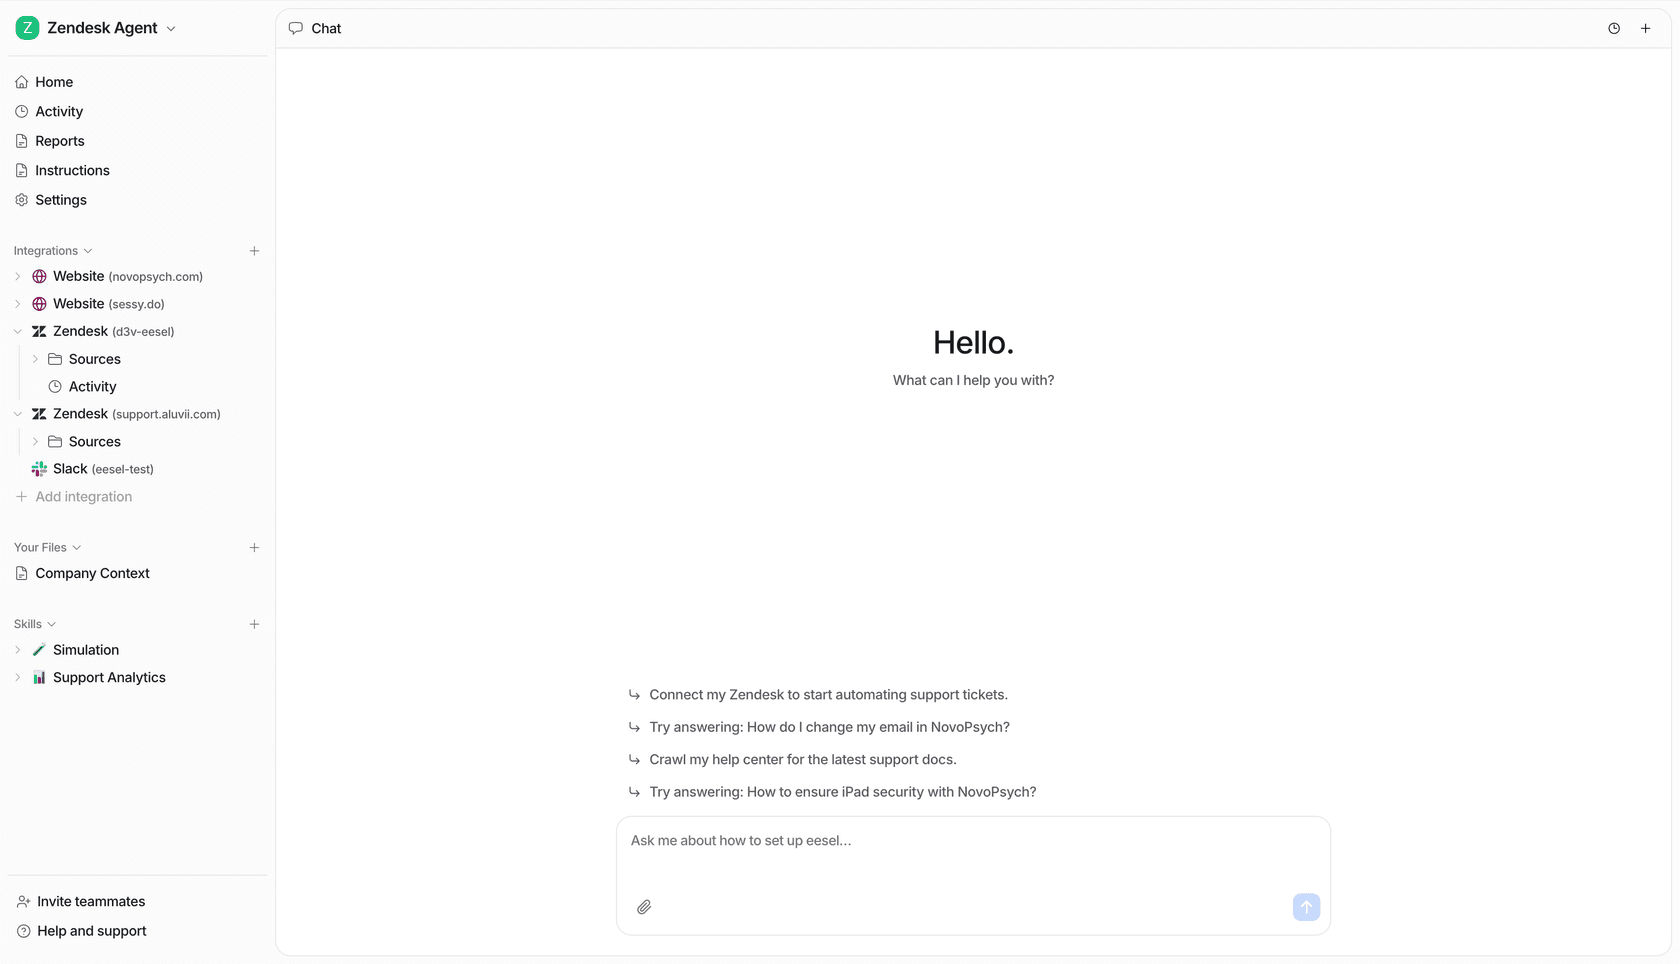
Si eres de los que prueban modelos nuevos desde una terminal, la CLI de eesel maneja al mismo compañero. eesel init chat-bubble --site https://your-site.com configura un agente de chat web que lee tus páginas, eesel instructions edita sus reglas permanentes, y eesel approvals lista las acciones que esperan a una persona. Cada comando imprime JSON, así que un agente de programación como Claude Code puede ejecutar la configuración por ti. Más en mi guía de la CLI de agentes de IA.
Los planes empiezan en $299 al mes por 500 créditos, donde un ticket o un chat es un crédito, y la prueba gratuita te da 100 créditos sin tarjeta. Prueba eesel con los tickets del mes pasado, o mira primero la página de precios. Si escribes contenido en lugar de responder tickets, el equipo también incluye un redactor de blog con IA.