

Mi veredicto: 3,7 sobre 5. Mercury 3 es el mejor argumento hasta ahora de que un modelo de lenguaje de difusión puede ser listo además de rápido. En la tabla propia de Inception supera a GPT-6 Luna y a Claude Haiku 5.5 en 10 de 12 benchmarks, y con el tráfico en vivo de OpenRouter funciona a una mediana de 221 tokens por segundo, más rápido que ambos rivales pero una quinta parte de los 1.068 que cita Inception.
Lo que frena la nota: el 10 % de peticiones reales más lentas avanza a 79 tokens por segundo o menos, todos los benchmarks se ejecutaron con esfuerzo medio mientras la API usa low por defecto, todavía no hay un ranking independiente, y solo acepta texto con un mínimo de temperatura de 0,5. En el lanzamiento cuesta 0,10 $ de entrada y 0,35 $ de salida por millón de tokens; presupuesta con el precio de lista de 0,20 $ / 0,70 $.
Para quién es: quienes construyen agentes con largas cadenas de llamadas al modelo, agentes de búsqueda y de navegador, y subagentes de programación. Quién debería esperar: quien necesite imágenes, pesos abiertos, salida determinista o recuperación probada en documentos largos. Para los equipos de soporte, es un motor potente, pero sigue siendo solo un motor. El compañero de IA para el helpdesk de eesel es el empleado que convierte un modelo en tickets respondidos, como hace Lesson Pro, que le hace anotar y redactar unos 1.900 tickets de Zendesk al mes.
Cómo reseñé Mercury 3
En eesel construyo funciones y agentes de IA, así que leo el lanzamiento de un modelo de forma distinta a una tabla de benchmarks. Me importan las costuras: qué hace la API por defecto, cómo se transmite la salida, qué pasa con las peticiones lentas y dónde se rompe un agente cuando el modelo es el eslabón débil. eesel lleva años ejecutando IA en colas de soporte reales, y el hábito que se quedó es que ningún modelo se acerca a un cliente hasta que ha reproducido tickets pasados reales. Las cifras de laboratorio nunca nos han dicho si algo funciona.
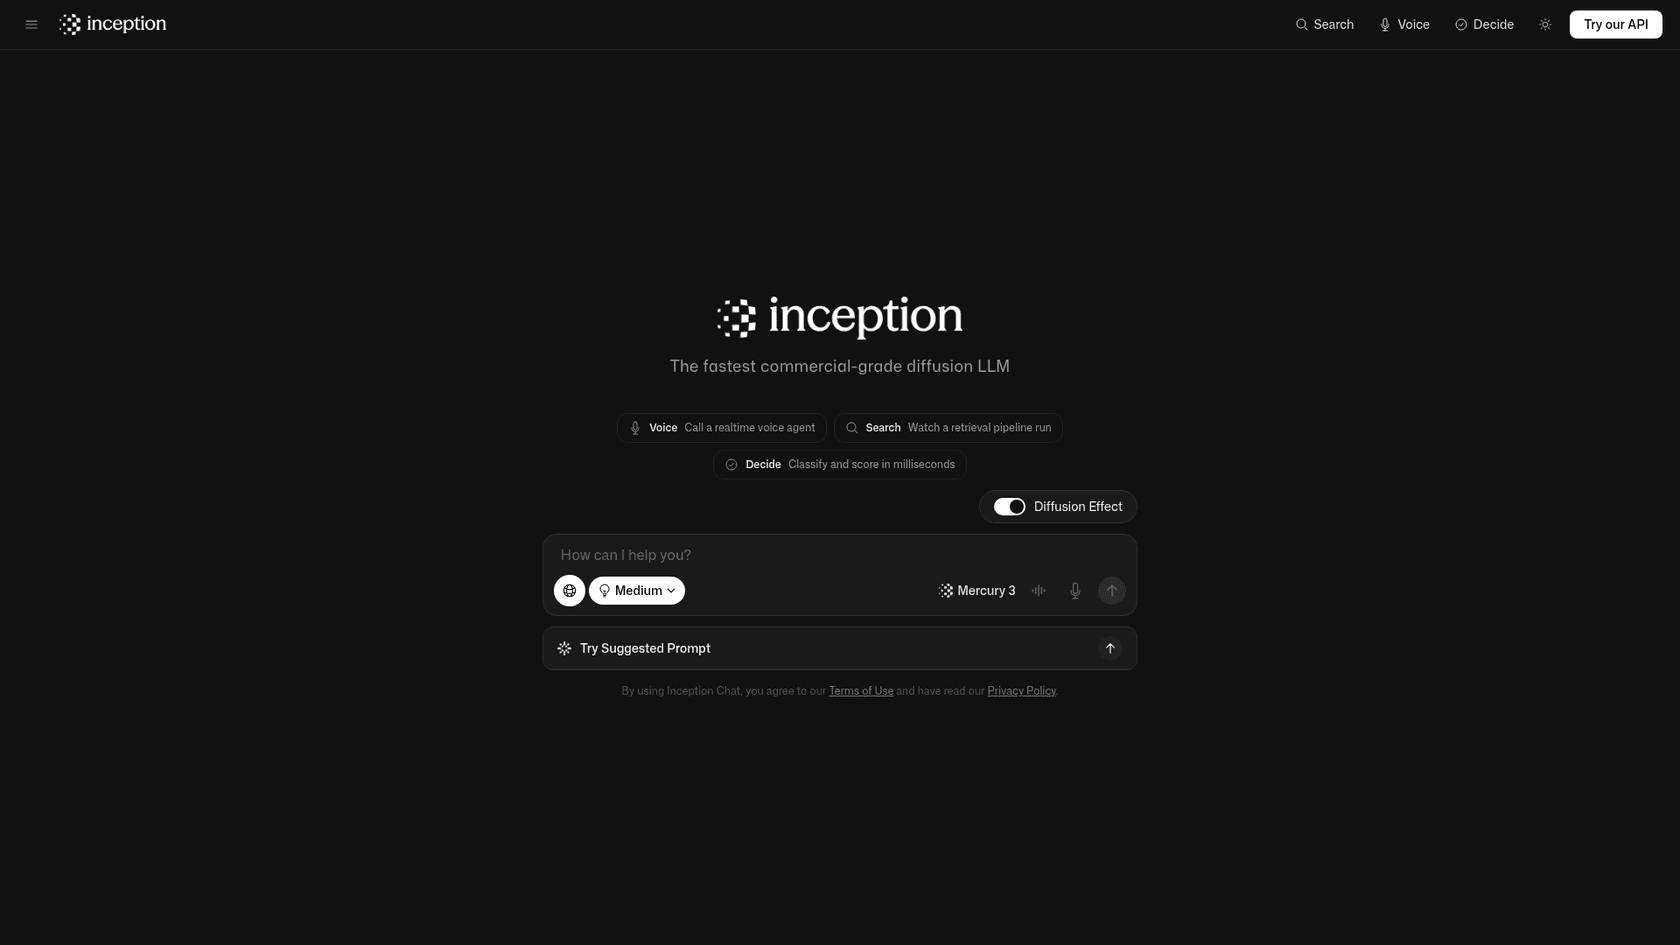
Esta reseña se apoya en cuatro cosas. La entrada de lanzamiento de Inception y su documentación de API. La página de rendimiento de OpenRouter, que publica percentiles sobre tráfico real. El hilo de lanzamiento en Hacker News, donde la gente lo probó en su propio trabajo en cuestión de horas. Y la propia app de chat de Inception, que muestra el proceso de difusión en pantalla.
Si quieres primero lo básico del lanzamiento (especificaciones, la tabla completa de benchmarks, vías de acceso), empieza por mi resumen de Mercury 3. Si solo te importa el coste, el desglose de precios de Mercury 3 de Rama lo calcula por tarea. Este artículo es el veredicto.
Cuadro de puntuación de Mercury 3
Así lo puntué, y por qué.
| Categoría | Puntuación | Por qué |
|---|---|---|
| Velocidad real | 4,0 / 5 | La mediana de 221 tok/s en OpenRouter supera a Luna y Haiku, pero la cola es lenta |
| Calidad para su clase | 4,0 / 5 | Por delante en 10 de 12 benchmarks del fabricante, a nivel de Luna o Haiku en el uso diario |
| Precio | 3,5 / 5 | La salida más barata de su clase en el lanzamiento, la más cara a precio de lista |
| Fiabilidad | 3,5 / 5 | 0,58 % de errores en llamadas a herramientas, 2,51 % de errores en salida estructurada en OpenRouter |
| Madurez y apertura | 3,5 / 5 | Sin benchmarks independientes, solo texto, pesos cerrados, tamaño no revelado |
| Total | 3,7 / 5 | Un paso real para los LLM de difusión, mejor como modelo auxiliar rápido |
La nota subiría pronto si ocurren dos cosas: que un ranking independiente como Artificial Analysis confirme la tabla de benchmarks y que la cola lenta de OpenRouter se acorte a medida que Inception añada capacidad. Ninguna se cumple el día del lanzamiento.
Qué cambia la difusión en la práctica
Casi todos los modelos que has usado, desde GPT-6.1 Sol hasta DeepSeek V4.1 Flash, escriben un token a la vez, de izquierda a derecha. Mercury 3 redacta toda la respuesta como texto ruidoso y la refina en unas pocas pasadas. Mi explicación de los modelos de difusión cubre la teoría. Para una reseña importa lo que eso hace a tu código y a tus usuarios.
El texto llega en bloques, no en tokens
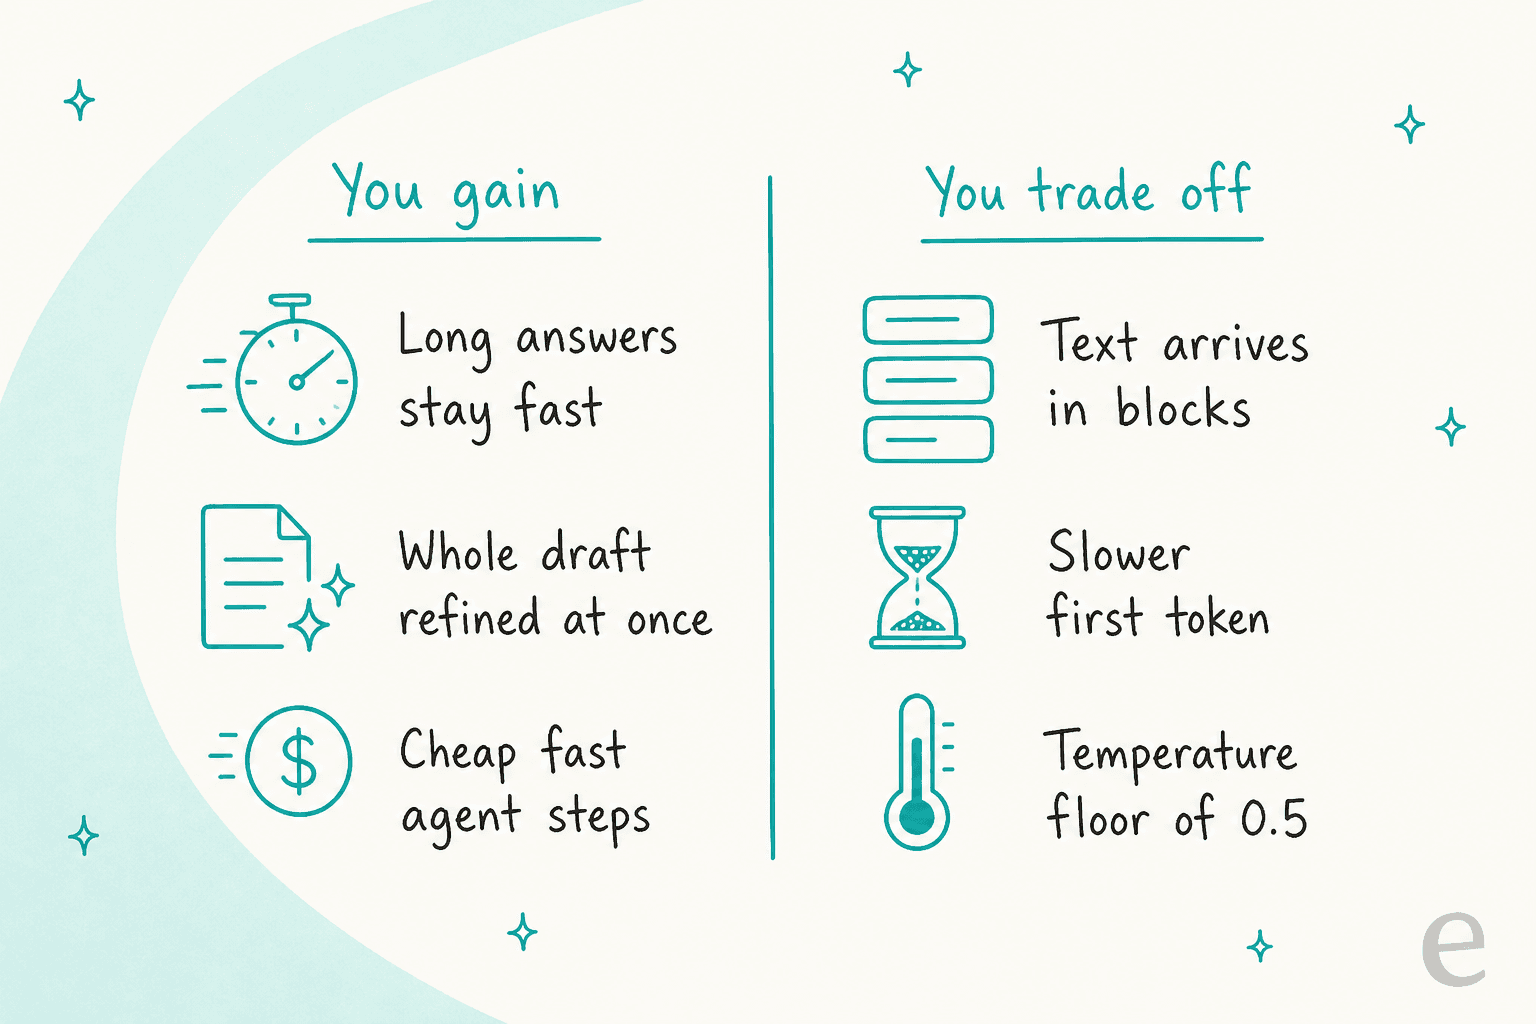
La documentación de streaming de Inception dice que las respuestas se transmiten "block-by-block", donde un bloque es un fragmento de texto refinado, no un solo token. En una ventana de chat eso se ve distinto del goteo palabra a palabra habitual: nada, luego una frase, luego la siguiente. Hay además un modo opcional diffusing en el que cada fragmento es la respuesta completa hasta ese momento, así que tu interfaz tiene que sobrescribir el texto en cada paso en lugar de añadirlo. Es una demo divertida y un error fácil si tu front end da por hecho que se añade.
Esta es también mi mejor hipótesis de por qué los probadores de Hacker News mencionaban una y otra vez el tiempo hasta el primer token. Uno escribió "Ttft is quite slow with mercury" en el hilo de lanzamiento, y otro probador dijo "the issue with speed seems to be that ttft is still high." Los tokens por segundo te dicen lo rápido que termina la respuesta, no lo pronto que el usuario ve algo.
Las respuestas largas apenas cuestan más tiempo
La ventaja es la otra cara. Un modelo token a token tarda el doble en escribir el doble. Un modelo de difusión refina todo el bloque en paralelo, así que la diferencia crece a medida que las respuestas y el razonamiento se alargan. El cofundador de Inception, Volodymyr Kuleshov, lo señaló el día del lanzamiento: cuanto más piensan los modelos de razonamiento por respuesta, más crece la ventaja de velocidad. Por eso el modelo encaja mejor con agentes de varios pasos que con respuestas de una línea.
Los valores por defecto no son el modelo evaluado
Este es el detalle que señalaría a cualquier equipo que lo pruebe. Cada puntuación de la tabla de lanzamiento de Inception se ejecutó con esfuerzo de razonamiento medium. Pero la documentación del esfuerzo de razonamiento dice que si omites reasoning_effort, mercury-3 usa low por defecto. Mercury 2 y 2.5 usaban medium.
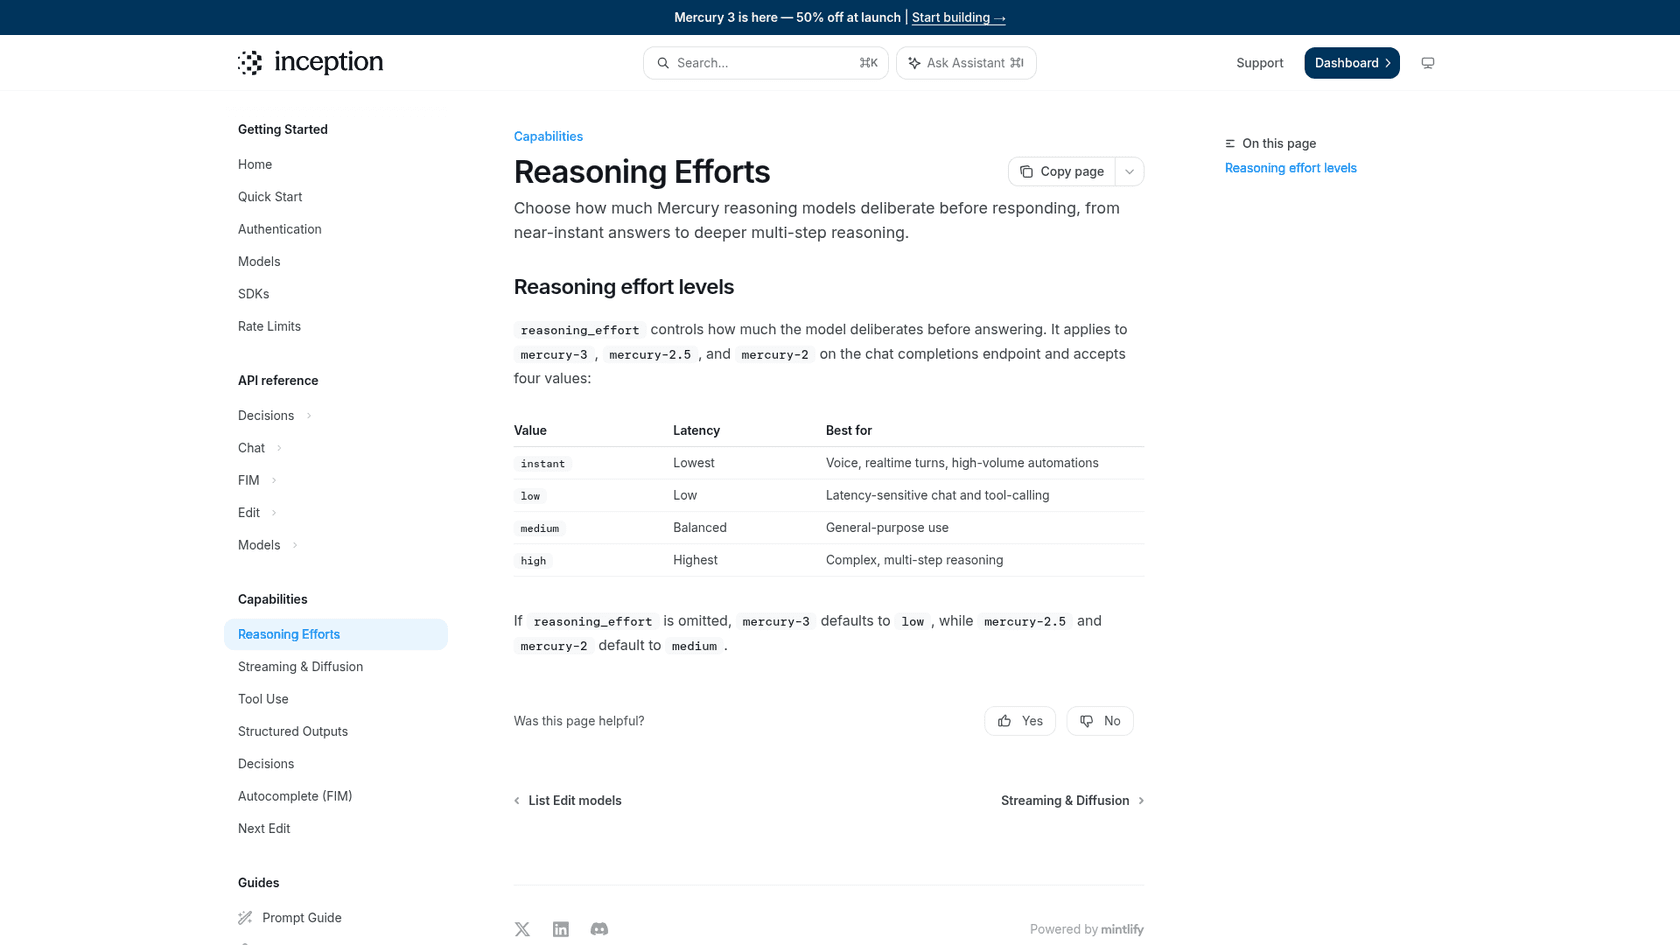
Así que una prueba rápida sin esfuerzo indicado está probando un ajuste más rápido y ligero que el de la tabla. Es un valor por defecto sensato para la velocidad, pero fija medium explícitamente antes de comparar calidad. Y no des por hecho que high es mejor: un probador observó en los dibujos de pelícanos de Simon Willison que "the medium pelican is better than the high". Es un garabato, no un benchmark, pero es un buen motivo para probar cada nivel en tu propia tarea.
La temperatura empieza en 0,5
La documentación de modelos de Inception indica que la temperatura de Mercury 3 es ajustable de 0,5 a 1,0. Si tu pipeline fija la temperatura en 0 para obtener resultados repetibles (clasificación, extracción, datos de prueba), aquí no puedes. Combínalo en su lugar con salidas estructuradas y una validación de esquema. Para trabajos de etiquetado puro, el modelo separado de Inception, Mercury Decide, está pensado para clasificación.
Velocidad anunciada frente a velocidad medida
La cifra de Inception es de 1.068 tokens de salida por segundo en GPU NVIDIA. Mi resumen cubrió la brecha en la mediana. Lo que quería para esta reseña era la dispersión, porque la espera total de un agente la fijan sus llamadas lentas, no las medias.
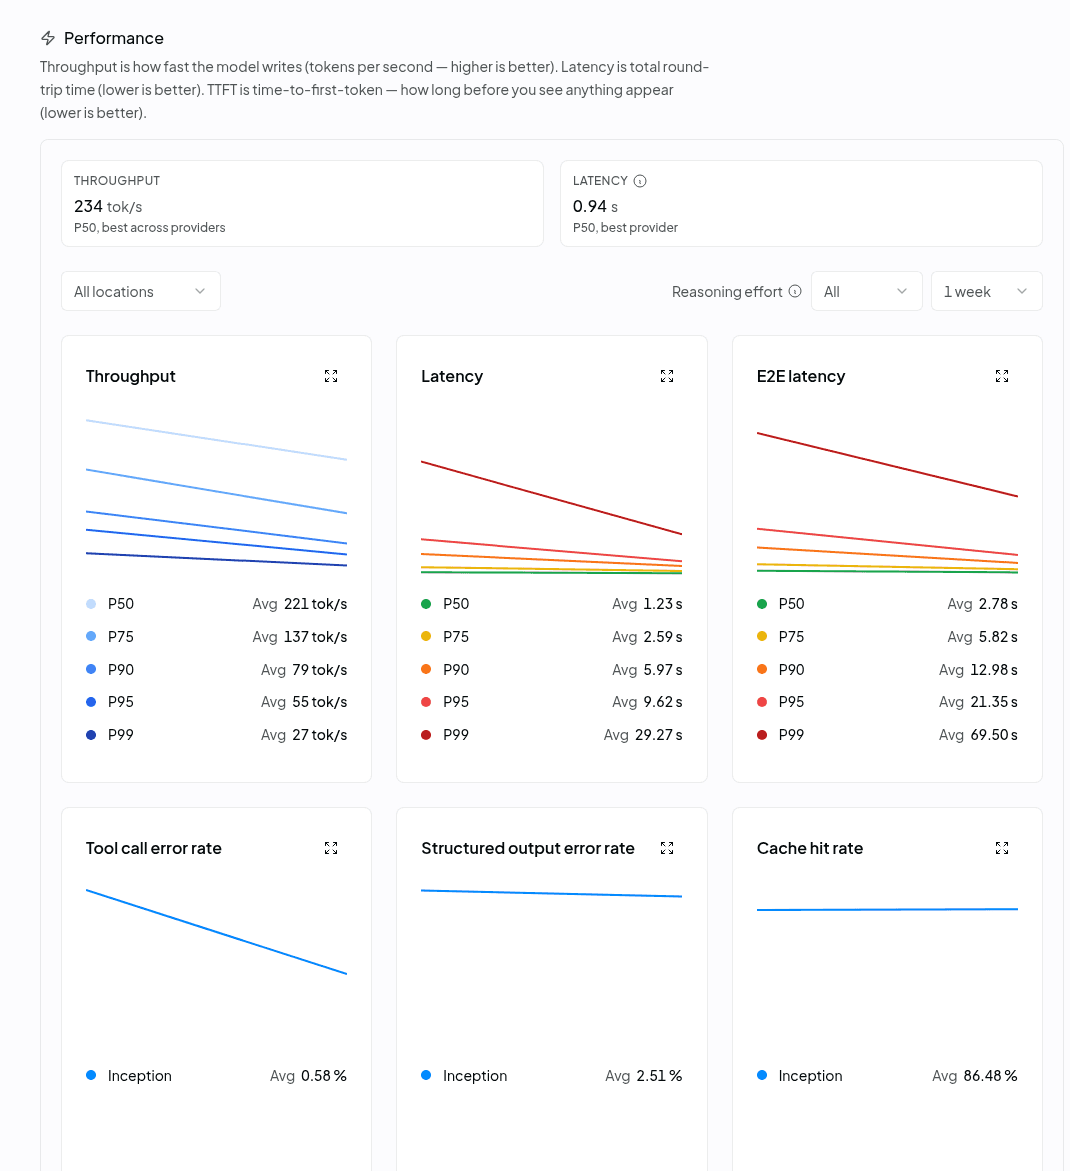
OpenRouter dirige cada petición de Mercury 3 a Inception y publica percentiles. Esto mostraba su página de rendimiento el 20 de octubre de 2026, promediado durante una semana:
| Percentil | Caudal | Latencia | Extremo a extremo |
|---|---|---|---|
| P50 | 221 tok/s | 1,23 s | 2,78 s |
| P75 | 137 tok/s | 2,59 s | 5,82 s |
| P90 | 79 tok/s | 5,97 s | 12,98 s |
| P95 | 55 tok/s | 9,62 s | 21,35 s |
| P99 | 27 tok/s | 29,27 s | 69,50 s |
La mediana es buena. La tabla propia de Inception sitúa a GPT-6 Luna en unos 130 tokens por segundo y a Haiku 5.5 en unos 240, así que Mercury 3 con tráfico real queda más o menos a la par de Haiku y bastante por delante de Luna. El problema es la cola: una de cada diez peticiones va a 79 tokens por segundo o menos, y una de cada cien tarda más de un minuto de extremo a extremo.
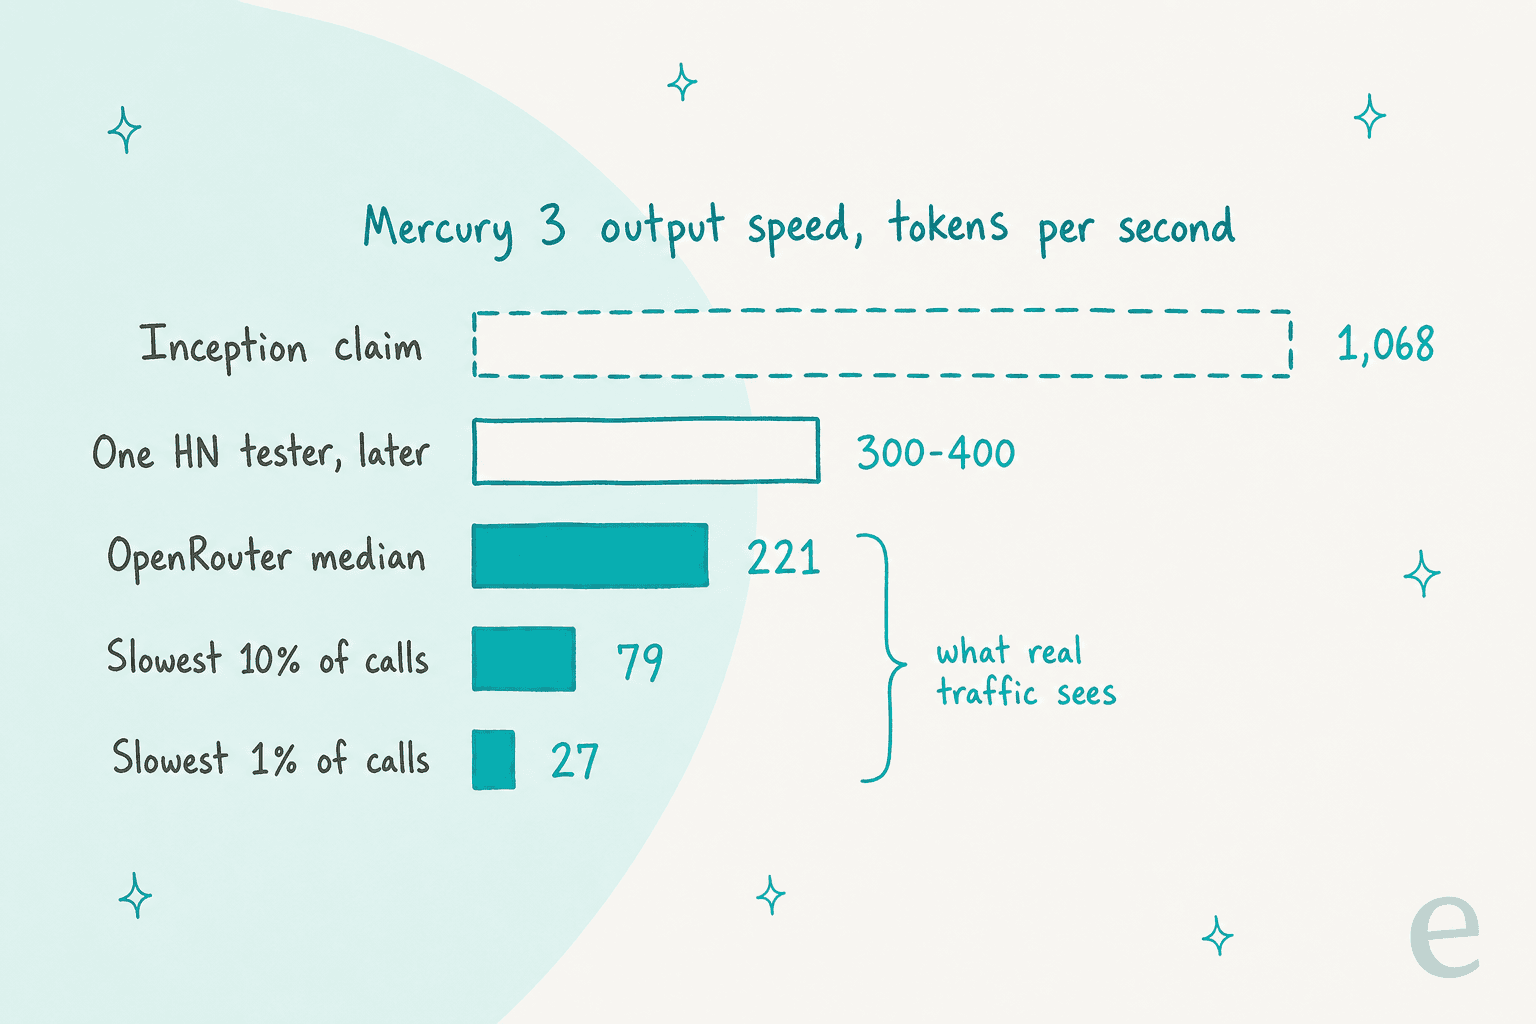
Dos salvedades lo mantienen justo. OpenRouter mezcla todos los niveles de esfuerzo que eligen sus usuarios, y el tráfico de la semana de lanzamiento es irregular. Para algunos usuarios la velocidad ya mejoraba al final del primer día:
"I've been trialing this for the last few hours. It was quite slow at first, but now I'm getting around 300-400tps. Still nowhere near 1000tps, but it's still incredibly fast compared to what I'm used to with other models."

Simon Willison, en cambio, encontró la velocidad "a bit disappointing" y no vio mejora al llamar a la API de Inception directamente en vez de a través de OpenRouter. Mi lectura: la mediana es real y útil hoy, la cifra de 1.068 es el mejor caso en el hardware propio de Inception, y la cola es el número a vigilar durante el próximo mes. Si comparas opciones de velocidad pura, mi artículo sobre Groq 3 LPX cubre la vía del hardware en lugar de la del modelo.
Comprobación de realidad de los benchmarks
La tabla de lanzamiento es sólida. Mercury 3 supera a Luna y a Haiku 5.5 en 10 de 12 pruebas cada uno, y las mayores diferencias están en el trabajo de agentes: SWE-Bench Atlas con 51,08 frente a 33,33 de Luna, y τ³-bench Banking con 30,24 frente a 23,00 y 13,06. La tabla completa está en mi resumen de Mercury 3, así que aquí me centro en cuánto peso puede soportar.
- Es una ejecución de Inception. Todavía no hay página de Artificial Analysis para Mercury 3, y Kuleshov dijo en Hacker News que los benchmarks de terceros y los tiempos de finalización de tareas están por llegar.
- Un solo nivel de esfuerzo. Las 12 filas están en medium. Un comentarista preguntó por qué, señalando que no hay una curva de low a max. No sabemos si Luna o Haiku cierran la brecha con más esfuerzo.
- Las derrotas son por poco; algunas victorias, amplias. Queda por detrás de Luna en AA-Omniscience (46,44 vs 46,94) y AA-LCR (77,67 vs 78,30) por muy poco, y por detrás de Haiku 5.5 en MRCR v2 (75,50 vs 78,40) y DeepSWE (46,31 vs 51,62). La recuperación en documentos largos es el área que probaría con más dureza.
- La lectura del propio fabricante es modesta. Kuleshov lo describió como de nivel Haiku o Luna en el uso diario, que me parece el marco honesto.
"That means that it won't yet replace Opus or Fable as the primary driver of a harness, but we have used it successfully for subagents"
Los informes prácticos coinciden. Un desarrollador construyó con él una pequeña app de macOS de principio a fin:
"I made it come up with a plan for this tool and had it implement the thing end to end in about 8 or 9 steps. It originally messed up the coordinate calculation but quickly corrected that when I pointed it out and other than that it one-shotted all the other steps."
El mismo probador dijo que el trabajo usó 26 millones de tokens, 1,3 millones de ellos sin caché, a unos 160 tokens por segundo. Es una imagen real útil: un arnés de programación reenvía mucho contexto, por eso el precio de la caché importa tanto como la tarifa principal. Otro probador reconstruyó un renderizador UML en tres turnos y dijo que actualizó el HTML correctamente.
Fortalezas y límites
Aquí va la versión equilibrada, en el orden en que las ponderaría.
Dónde es fuerte:
- Bucles de agentes. La velocidad se acumula cuando una tarea hace una docena de llamadas seguidas al modelo. TinyFish, socio de lanzamiento de Inception, dice que completó la mitad de 50 tareas web en vivo de Mind2Web, "significantly more than GPT-6.1-Sol."
- Trabajo auxiliar y de subagentes. Compactación de contexto, enrutamiento, resumen de la salida de herramientas. Con el anterior Mercury 2, Augment Code informó de un 82 % menos de latencia de compactación y un 90 % menos de coste frente a su modelo anterior. Eso es Mercury 2, pero Mercury 3 es la misma propuesta con un modelo mayor.
- Contextos largos a precio plano. Una ventana de 1M de tokens a una sola tarifa, mientras Haiku 5.5 factura 5 veces más pasados los 100K tokens. Mi guía de precios de Haiku 5.5 tiene los detalles.
- Fácil de probar. Es compatible con OpenAI, con 100 millones de tokens gratis en las claves nuevas y guías de configuración para Cursor, LangChain y Vapi.
Dónde es limitado:
- La cola lenta. Caudal P90 de 79 tok/s y tiempo de extremo a extremo P99 de 69,5 segundos en la vista de una semana de OpenRouter.
- La salida estructurada no es perfecta. OpenRouter muestra una tasa de error del 2,51 % en salida estructurada, así que mantén un validador en el flujo.
- Solo texto, pesos cerrados, tamaño sin revelar. Inception dice que lo multimodal está en prototipos internos. Para pesos de difusión abiertos, la alternativa es DiffusionGemma.
- Precio tras la promoción. A 0,70 $ por millón de tokens de salida, el precio de lista queda por encima de los 0,50 $ de Luna y Haiku, e Inception no ha anunciado fecha de fin para el descuento del 50 %.
- La disponibilidad aún se está asentando. La disponibilidad a tres días de OpenRouter fue del 99,26 %, con caídas visibles el día del lanzamiento.
¿Es Mercury 3 adecuado para tu carga de trabajo?
Casi toda la decisión de "cambiar o no" se reduce a tres preguntas: cuántas llamadas hay seguidas, si hay una persona esperando y si necesitas algo que Mercury 3 no ofrece. El selector de abajo te guía por ellas.
Responde tres preguntas para ver si Mercury 3 encaja con una carga de trabajo y qué probar antes de cambiar.
El patrón es simple: cuantas más llamadas seguidas y cuanto más espera una persona, más se gana Mercury 3 su sitio. Para una sola llamada en segundo plano, la velocidad no cambiará nada, y a precio de lista Luna o Haiku son la opción más barata. Mi desglose de precios de GPT-6 Luna tiene su parte de esa cuenta.
Cómo encaja Mercury 3 en una carga de soporte
El soporte es uno de los cuatro usos en producción que cita Inception, y el lanzamiento recoge a Lorikeet, un proveedor de IA para soporte, diciendo que Mercury 3 "beat other models on latency while also performing higher on evals and in production." El benchmark que más se parece al soporte, τ³-bench Banking, es también donde la ventaja de Mercury 3 es mayor.
Pero lee esa puntuación con cuidado. Un 30,24 significa que el modelo falló la mayoría de esas tareas bancarias simuladas, solo que menos que sus rivales. Es normal en modelos pequeños y rápidos, y es la razón por la que un modelo nunca es el agente de soporte completo. La velocidad ayuda más en canales en vivo como el chat en vivo con IA y los agentes de voz, donde un cliente mira la pantalla. En tickets por correo, una diferencia de dos segundos no cambia nada.
Donde mejor encaja un modelo auxiliar rápido en soporte es en el montón de tareas pequeñas alrededor de cada respuesta. Piensa en triaje de tickets, etiquetado, resumen de hilos largos y extracción de datos de pedidos. Es el mismo patrón de subagentes que Inception describe para programar. Y es también cómo se ve un despliegue de soporte real cuando lo abres.
Lesson Pro, que gestiona marcas de clases particulares como GOSKATE, es un buen ejemplo. Sus agentes de eesel trabajan en dos cuentas de Zendesk. En cada ticket, el agente primero averigua a qué marca pertenece el cliente, luego deja una nota interna y redacta una respuesta firmada con esa marca. Las solicitudes de empleo, los mensajes de voz y los formularios de pedido se omiten a propósito. Entre el 8 de agosto y el 8 de septiembre de 2026 trabajó unos 1.900 tickets, dejó unas 1.700 notas y redactó unas 560 respuestas para que el equipo las enviara. Cuando un compañero escribe "@eesel find instructors near this lesson", busca en tickets pasados de las localidades cercanas instructores que dieron clase allí.
Nada de eso depende de si el modelo que hay detrás escribe a 221 o a 1.068 tokens por segundo. Depende de la regla de marca, de la lista de omisión, de que los borradores vayan primero a una persona y de las pruebas. Esa es la diferencia a la que vuelvo una y otra vez: Mercury 3 es infraestructura; eesel es el empleado. Si eliges tú la capa del modelo, mis guías del mejor modelo para tickets de soporte y de la prevención de alucinaciones de IA cubren las salvaguardas, y probar un agente de IA cubre el paso que la mayoría de equipos se salta.
Quién debería usar Mercury 3 y quién debería esperar
Úsalo ya si:
- Construyes agentes con largas cadenas de llamadas: agentes de navegador, agentes de búsqueda, bucles de investigación. Aquí es donde su velocidad se acumula.
- Ejecutas arneses de programación y quieres un ayudante rápido. El propio consejo de Kuleshov son los subagentes, no el modelo principal, lo que encaja con configuraciones de Claude Code o Cursor en las que un modelo mayor planifica.
- Pagas por Luna o Haiku en llamadas de alto volumen y poco riesgo y puedes vivir con el precio de lista más adelante. Prueba con esfuerzo medium antes de cambiar.
Espera o elige otra cosa si:
- Necesitas entrada de imágenes, pesos abiertos o temperatura 0. Gemini 3.8 Flash maneja imágenes, y los modelos de lenguaje pequeños cubren el autoalojamiento.
- Dependes de una recuperación exacta en documentos largos. Haz primero tu propia evaluación.
- Haces una llamada al modelo por petición y nadie espera. La velocidad no cambiará tus números, así que elige por calidad y precio.
- Necesitas latencia garantizada. Hasta que P90 y P99 se acorten, mantén un modelo de respaldo o un timeout alrededor.
Si aún estás repasando las opciones, mi recopilación de los mejores agentes de IA y la reseña de Claude Haiku 5.5 son las siguientes lecturas naturales.
Prueba eesel
Un modelo rápido te da un token rápido. No te da una conexión con Zendesk, una regla de marca, una lista de tickets que omitir ni una forma de reproducir las conversaciones del mes pasado antes de que algo salga en vivo. El compañero de IA para el helpdesk de eesel llega con todo eso. Se une a tu Zendesk u otro helpdesk existente, lee tu centro de ayuda, tus macros y tickets pasados, y funciona con los disparadores que actives, como una mención a @eesel en una nota interna.
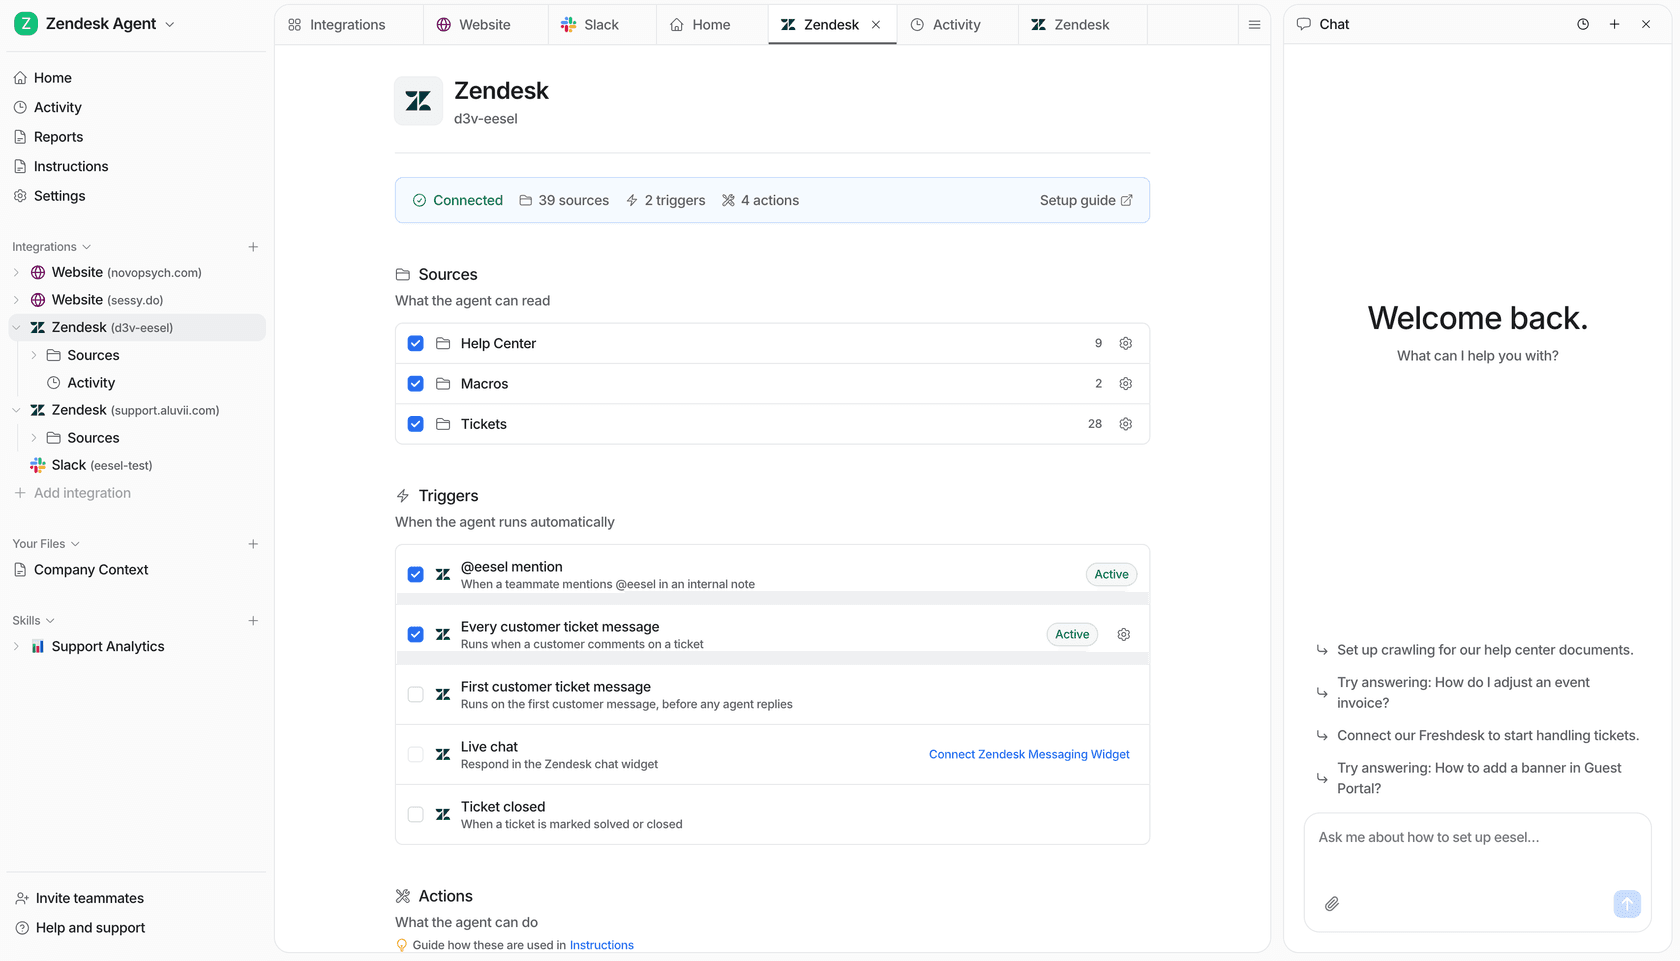
Si pruebas modelos desde una terminal, te gustará la CLI de eesel. Maneja el mismo compañero que el panel: eesel integrations connect zendesk inicia la conexión con el helpdesk, eesel automations lista y activa lo que el agente hace por sí solo, y eesel chat "how do I reset a password?" le hace una pregunta y transmite la respuesta. Cada comando imprime JSON, así que un agente de programación puede ejecutar la configuración por ti. Mi guía de la CLI de agentes de IA profundiza más.
Los planes empiezan en 299 $ al mes por 500 créditos, y la prueba gratuita incluye 100 créditos sin tarjeta. Prueba eesel con tus propios tickets pasados, o mira primero la página de precios. Si lo tuyo es el contenido y no los tickets, el equipo también cuenta con un redactor de blogs con IA.