

¿Qué es un modelo de decisión?
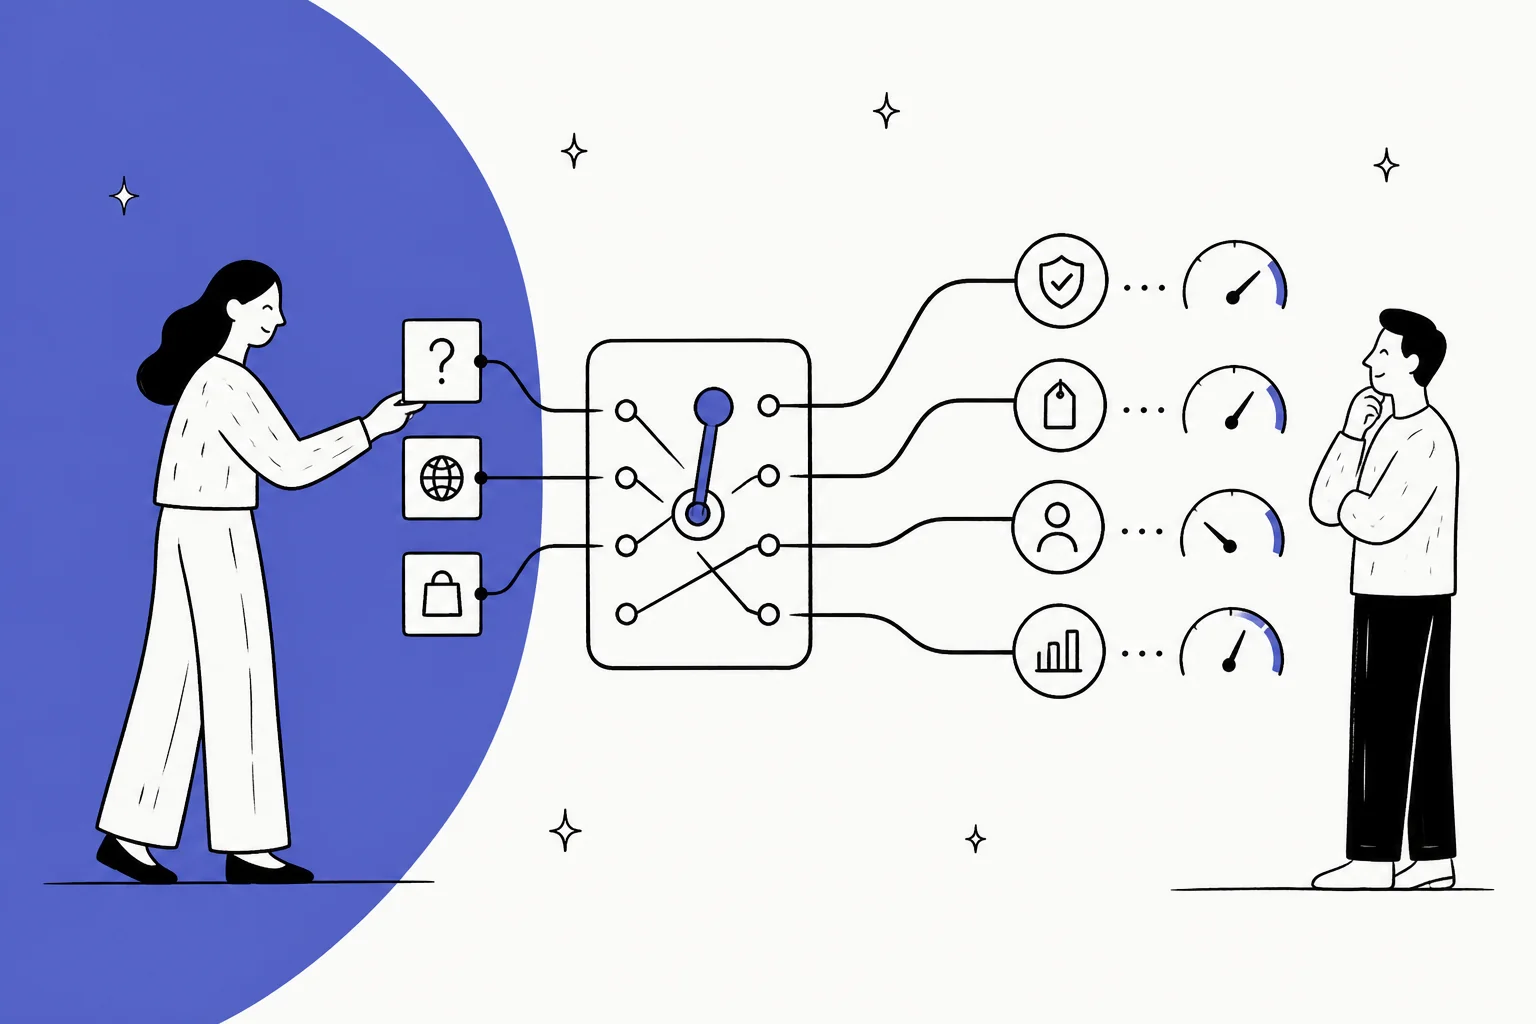
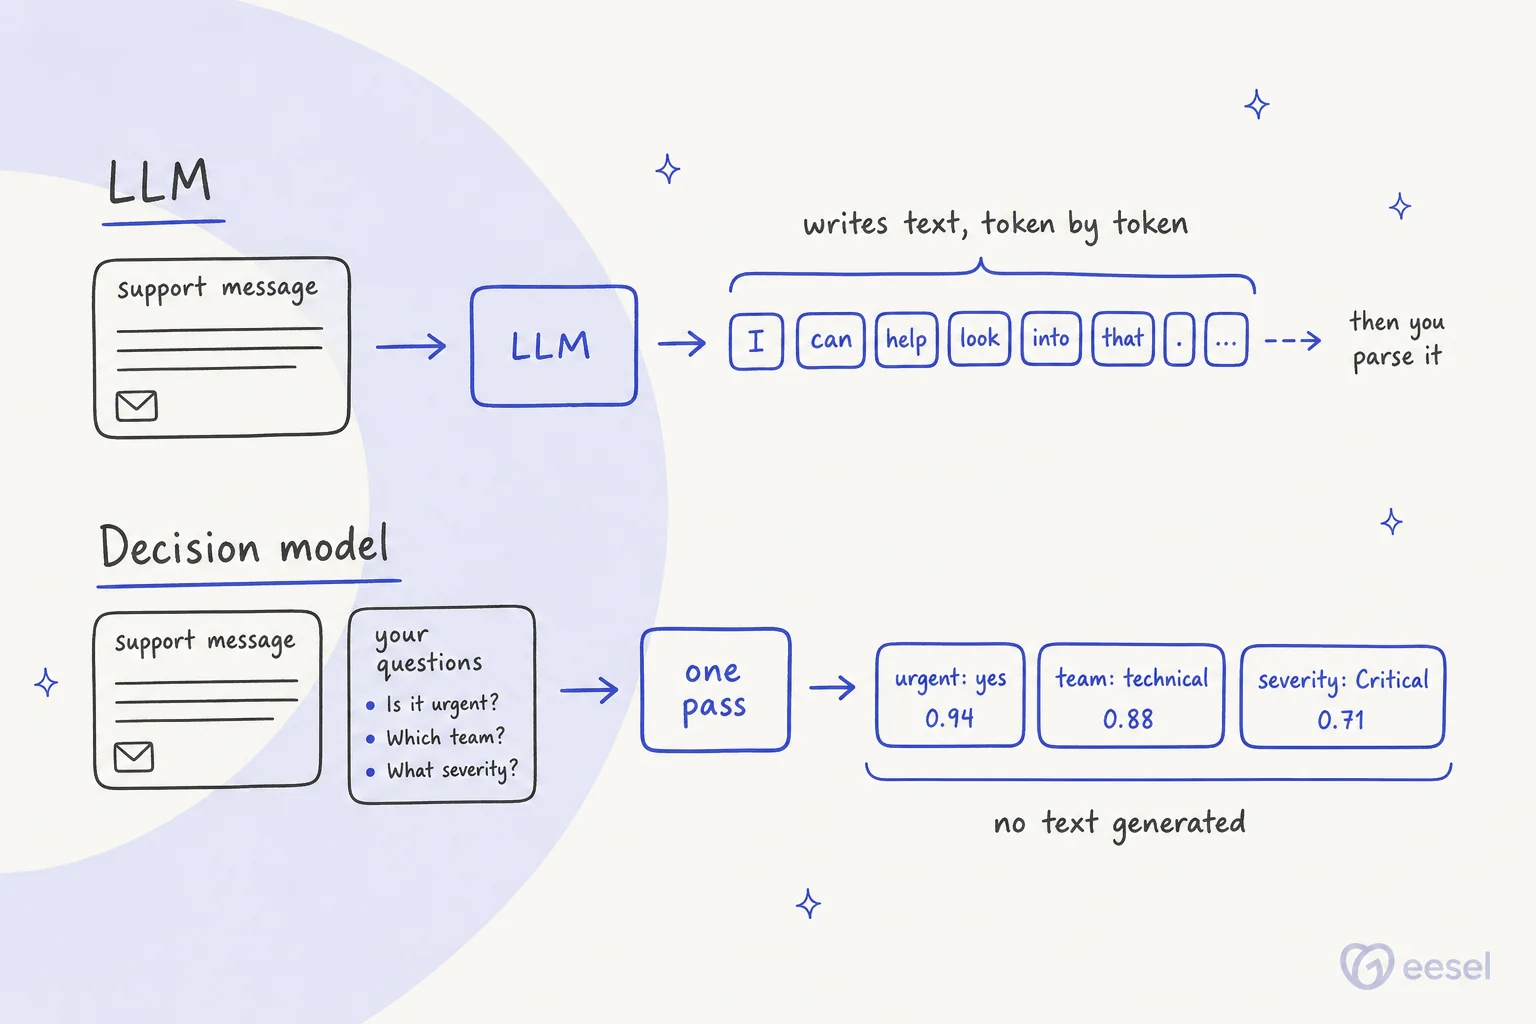
Un modelo de decisión recibe dos cosas: un estado (la entrada en bruto, como un correo de soporte, un bloque JSON o una captura de pantalla) y un conjunto de preguntas tipadas sobre ese estado. Devuelve una respuesta tipada por pregunta, cada una con una probabilidad. Sin párrafos, sin JSON que tengas que analizar, sin "¡Claro! Este es mi análisis".
La documentación de TypeSafe plantea muy bien el problema que resuelve: cuando le pides a un LLM un juicio que tu código va a consumir, "estás forzando a un sistema de generación de texto a producir decisiones estructuradas y luego analizando los resultados de vuelta". Un modelo de decisión se salta el texto por completo.
Casi todos los modelos de la categoría se han asentado en los mismos tres tipos de pregunta, que TypeSafe llama primitivas:
| Tipo de pregunta | Qué pregunta | Qué devuelve | Ejemplo en soporte |
|---|---|---|---|
| Noul | ¿Es cierta esta afirmación? | Una probabilidad, de 0 a 1 | "¿Es urgente esta solicitud?" |
| Choice | ¿Qué opción encaja? | La elección, una probabilidad por opción, una confianza | "¿Facturación, técnico o ventas?" |
| Score | ¿Dónde se sitúa en esta escala? | Un nivel, una probabilidad por nivel, una confianza | "¿Sin impacto, menor, mayor o crítico?" |
Puedes mezclar los tres en una sola solicitud, y cada pregunta se evalúa en paralelo sobre el mismo estado. TypeSafe dice que "añadir preguntas apenas cambia el tiempo de respuesta", y el README de Strands Decider dice lo mismo: el texto se lee una sola vez y "cada pregunta añade solo sus propios tokens".
Así se ve en la práctica, con el propio ejemplo de lanzamiento de Cloudflare. Una llamada hace tres preguntas sobre un único mensaje de soporte:
curl https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID/ai/run/@cf/cloudflare/clef \
  -X POST \
  -H "Authorization: Bearer $CLOUDFLARE_AUTH_TOKEN" \
  -d '{
    "model": "clef",
    "state": "Checkout has been failing for every customer for the last hour.",
    "questions": {
      "urgent": { "type": "noul", "instructions": "Is this support request urgent?" },
      "team": {
        "type": "choice",
        "instructions": "Which team should handle this request?",
        "criteria": {
          "billing": "Payments, invoices, and refunds",
          "technical": "Outages, errors, and configuration",
          "sales": "Plans and upgrades"
        }
      },
      "severity": {
        "type": "score",
        "instructions": "How severe is the customer impact?",
        "criteria": ["No impact", "Minor", "Major", "Critical"]
      }
    }
  }'
Si has hecho clasificación de tickets a mano, esa solicitud te resultará familiar. Son urgencia, equipo y gravedad, los mismos tres campos que rellena un clasificador humano, y la misma división que hay detrás de urgencia e impacto en la mayoría de helpdesks.
¿Cómo funciona un modelo de decisión por dentro?
Esta es la parte que me parece más interesante, porque el truco es más simple de lo que sugiere el marketing.
La mayoría de los modelos de decisión abiertos parten de un LLM abierto corriente (normalmente una base Qwen o Gemma) y cambian la forma en que responde. La publicación de lanzamiento de Cloudflare describe que Clef ejecuta "una pasada solo de prefill y luego puntúa en paralelo las opciones válidas del esquema". Strands eliminó por completo la cabeza del modelo de lenguaje, así que Strands Decider 2B físicamente no puede generar texto, y su blog de lanzamiento dice que la cabeza de puntuación que añadió tiene "poco más de un millón de parámetros en total".
Dicho llanamente, ocurren tres cosas:
- El modelo lee el estado y las preguntas una vez. Es el paso de "prefill" que todo LLM hace antes de escribir. Los modelos de decisión se detienen ahí.
- Una cabeza pequeña puntúa cada respuesta permitida. En vez de generar "technical" letra a letra, puntúa facturación, técnico y ventas a la vez, en función de lo que acaba de leer.
- Las puntuaciones se entrenan para ser honestas. TypeSafe llama a su método de entrenamiento Reinforcement Learning for Calibrated Decisions (RLCD). Cloudflare construyó su propia versión de RLCD para Clef y la combina con una pérdida de Brier, una penalización estándar para probabilidades excesivamente seguras (Cloudflare).
Ese tercer paso es el producto de verdad. Una confianza de 0.9 solo es útil si las respuestas con 0.9 son correctas alrededor del 90% de las veces. Strands informa de que, en tareas cortas de clasificación no vistas, "las respuestas con una confianza de 0.9 o más son correctas alrededor del 95% de las veces". Por eso se presenta a los modelos de decisión como una buena opción para la priorización de tickets y otras decisiones donde quieres un umbral seguro. Esa es la propiedad que te permite escribir if confidence > 0.9: auto-route, else: send to a human.
Como no se genera nada, el coste de salida cae a cero o casi. Compáralo con la llamada a funciones en un LLM, donde cada llave y cada comilla es un token de salida facturado. Lo mismo ocurre con el modo JSON. Jev no cobra nada por la salida, y Clef no lista ningún precio de salida. Por eso la página de inicio de Jev insiste tanto en el enfoque "más parecido a código": una solicitud, una respuesta tipada, siempre.
Modelos de decisión vs LLM vs clasificadores clásicos
La crítica más ruidosa en Hacker News es que esto es solo un clasificador con otra marca. Un comentarista lo resumió como "modelo de decisión = clasificador". No les falta razón en cuanto a las matemáticas. Donde se equivocan es en lo que cambia para quien lo pone en producción.
"LLM as judges - generalized, but too slow. ... traditional classifiers, very specific 1 trick pony, super fast and cheap once built. ... decision models/jev - are generic, you can throw them at most generic classification problems, and they are good enough."

Esa es la versión honesta. Así se comparan las tres opciones en una tarea típica de enrutamiento de tickets con IA:
| LLM con esquema estricto | Modelo de decisión | Clasificador clásico entrenado | |
|---|---|---|---|
| Etiquetas nuevas | Cambias el prompt | Cambias la solicitud | Recopilar datos, reentrenar |
| Salida | Texto que analizas | Respuesta tipada + probabilidad | Etiqueta + probabilidad |
| Latencia típica | De 1 a 3 segundos (mi prueba con Luna: 1.3 a 2.6 s) | 39 a 524 ms de mediana | Menos de 10 ms |
| Coste de tokens de salida | Facturado (Luna: $0.50/M) | Gratis o no facturado | Ninguno (autoalojado) |
| Confianza calibrada | Débil tras el posentrenamiento | La característica principal | Posible, difícil de conseguir bien |
| Puede escribir una respuesta | Sí | No | No |
| Mejor para | Trabajo abierto, respuestas, razonamiento | Muchas llamadas pequeñas zero-shot | Una tarea fija de alto volumen |
Las cifras de latencia de Luna provienen de una prueba que hice con GPT-6 Luna con el razonamiento desactivado para mi artículo sobre los precios de la Decisions API. El rango de los modelos de decisión es el del benchmark de Cloudflare de más abajo, sin contar Laya. La fila del clasificador refleja a Laya, un codificador de 421M que se comporta casi como un clasificador clásico y que Cloudflare midió en 5.8 ms.
La columna en la que me fijaría es "Etiquetas nuevas". Otro comentarista expuso el argumento práctico mejor que cualquier proveedor: "Poder resolver cualquier problema de clasificación arbitrario en minutos en lugar de en una semana es un gran avance". Si tu equipo de soporte añade una nueva línea de producto y una nueva categoría de enrutamiento cada trimestre, reentrenar un clasificador cada trimestre es el coste oculto que elimina un modelo de decisión.
¿Qué modelos de decisión puedes usar hoy?
La categoría se movió absurdamente rápido. El Jev Decision Index, gestionado por la comunidad, se lanzó el 22 de septiembre con 31 participantes abiertos y listaba 70 modelos abiertos en su actualización del 28 de septiembre. La mayoría son reproducciones de aficionados. Estos son los que tienen un proveedor real o una puntuación notable detrás:
| Modelo | Creador | Tamaño | Pesos abiertos | Alojado | Precio | Entradas | Decision Index |
|---|---|---|---|---|---|---|---|
| Jev | TypeSafe | No divulgado | No | API de TypeSafe, Workers AI | $0.042/M entrada, salida gratis | Texto | 57.9 |
| Clef | Cloudflare | 27B | Sí, Apache 2.0 | Workers AI | $0.24/M entrada | Texto, JSON, imágenes, vídeo | 61.2 (autodeclarado) |
| Clef-flash | Cloudflare | 9B | Sí, Apache 2.0 | Workers AI | $0.09/M entrada | Texto, JSON, imágenes, vídeo | 57.1 (autodeclarado) |
| pplx-decider-v1-27b | Perplexity | 26B | Sí | No verificado | Autoalojado | Texto, imágenes | 56.4 |
| Strands Decider 2B | AWS Strands Labs | 1.9B | Sí, Apache 2.0 | No | Gratis (autoalojado) | Texto (imágenes experimental) | No está en el tablero |
| Bespoke-Nimble-9B-v2 | Bespoke Labs | Adaptador 9B | Sí | No | Autoalojado | Texto | 39.6 |
| Kev 9B | Jared Palmer | Adaptador 9B | Sí, Apache 2.0 | No | Autoalojado | Texto | 38.5 |
| Tev1-4B | Together AI | 4B | Sí, licencia no definitiva | Together serverless | No registrado | Texto | 29.0 |
| Laya | Convai Innovations | 421M | Sí, Apache 2.0 | No | Autoalojado | Texto, más de 100 idiomas | 6.0 |
| Decisions API | OpenAI | Basado en GPT-6 Luna | No | Vista previa limitada | No publicado | Texto, imágenes | No está en el tablero |
Fuentes: el Decision Index, el tablero autodeclarado de Cloudflare y la página de cada modelo enlazada en las secciones siguientes. El Index está corregido por azar sobre 38 benchmarks, así que 0 significa adivinar al azar.
A continuación están los cuatro que miraría primero.
TypeSafe Jev
Jev es el original y sigue siendo la referencia contra la que todos se comparan. Es un modelo cerrado de TypeSafe AI, un equipo de San Francisco liderado por Diogo Almeida, quien coinventó los métodos RLHF e InstructGPT que hay detrás de ChatGPT. El 27 de septiembre, TypeSafe eliminó su lista de espera, así que ahora cualquiera puede crear una cuenta.
El precio destacado en la publicación de lanzamiento es $0.042 por millón de tokens de entrada con salida gratuita, y TypeSafe afirma tiempos de respuesta de extremo a extremo de 70 a 500 ms. Es solo texto, con 32K de contexto. Dos cosas que debes saber antes de comprometerte: la arquitectura y los pesos de Jev no son públicos, y la propia TypeSafe dice que "no puede demostrar que no esté subvencionado".
Para las cuentas con tu volumen, consulta mi desglose de los precios de Jev. Si quieres la visión práctica, la cubrí en mi reseña de Jev. También hay un nivel aparte de menor latencia, que describí como Jev Ultrafast.
Cloudflare Clef y Clef-flash
Clef es el modelo abierto que dice superar a Jev. Cloudflare lo construyó sobre Qwen3.8-27B (Clef-flash sobre Qwen3.5-9B), publicó ambos bajo Apache 2.0 y los hizo totalmente compatibles con la API de Jev, de modo que cambiar es sobre todo cuestión de cambiar una URL.
Las dos ventajas reales de Clef sobre Jev son la visión (lee imágenes y vídeo) y un contexto de 64K. Según las cifras de Cloudflare, además gana 3 de las 4 evaluaciones de flujos de trabajo de la propia TypeSafe, incluida la de atención al cliente, donde los tres modelos quedan a un punto entre sí (Clef 76.3, Clef-flash 77, Jev 76.0). La salvedad es que ambas puntuaciones de Clef son Cloudflare corrigiendo sus propios deberes: no están reproducidas en el tablero original, y Cloudflare omitió dos benchmarks. Además cuesta unas 5.7 veces el precio por token de Jev. Hice las cuentas por decisión en mi artículo sobre los precios de Cloudflare Clef.
Strands Decider 2B
Strands Decider 2B es la propuesta de AWS Strands Labs, escrita por Marc Brooker, Mike Chambers y Fabio Nonato de Paula. Es la opción pequeña que corre en tu portátil: 1.9B de parámetros sobre una base Qwen3.5-2B, con pesos, datos de entrenamiento y scripts de entrenamiento publicados.
Funciona en CPU, GPU NVIDIA o Apple silicon, con una mediana de 115 ms en una RTX 3090 y 153 ms en un M3 Pro para prompts cortos, según el repositorio de GitHub. En JevBench obtiene 0.762 en la versión más reciente. Me gusta lo sincera que es la publicación de lanzamiento: dice que el diseño de una sola pasada lo hace "significativamente peor resolviendo problemas complejos que los modelos de razonamiento" y no apto para chatbots ni resúmenes. Dos notas prácticas: no hay versión alojada (Hugging Face no muestra ningún proveedor de inferencia), y su servidor local no tiene autenticación, así que sirve para experimentos, no para tráfico de producción. Si ya construyes sobre el arnés de Strands, se conecta a un hook de llamada a herramientas como puerta de proceder/denegar.
Decisions API de OpenAI
OpenAI anunció la Decisions API en el DevDay del 29 de septiembre, y el resumen del DevDay la describe como "centrar la inteligencia de Luna en un conjunto específico de preguntas definidas por el usuario con respuestas finitas y predefinidas". Siete días después, sigo sin encontrar página de documentación, esquema de referencia, fila de precios ni entrada en el changelog. El endpoint /v1/decisions existe, pero una clave estándar recibe un HTTP 403 que indica que la API no está habilitada para este usuario.
Así que, por ahora, la única cifra verificable de OpenAI es la tarifa por token de GPT-6 Luna: $0.10 por millón de entrada y $0.50 por millón de salida. Si hoy estás en OpenAI, una llamada a Luna con un esquema enum estricto hace el mismo trabajo; mi artículo sobre la Decisions API de OpenAI explica esa alternativa.
¿Qué tan rápidos son los modelos de decisión?
La velocidad es donde la categoría se gana el nombre. Cloudflare midió la latencia mediana en 43 benchmarks para seis modelos de decisión en su propia infraestructura:
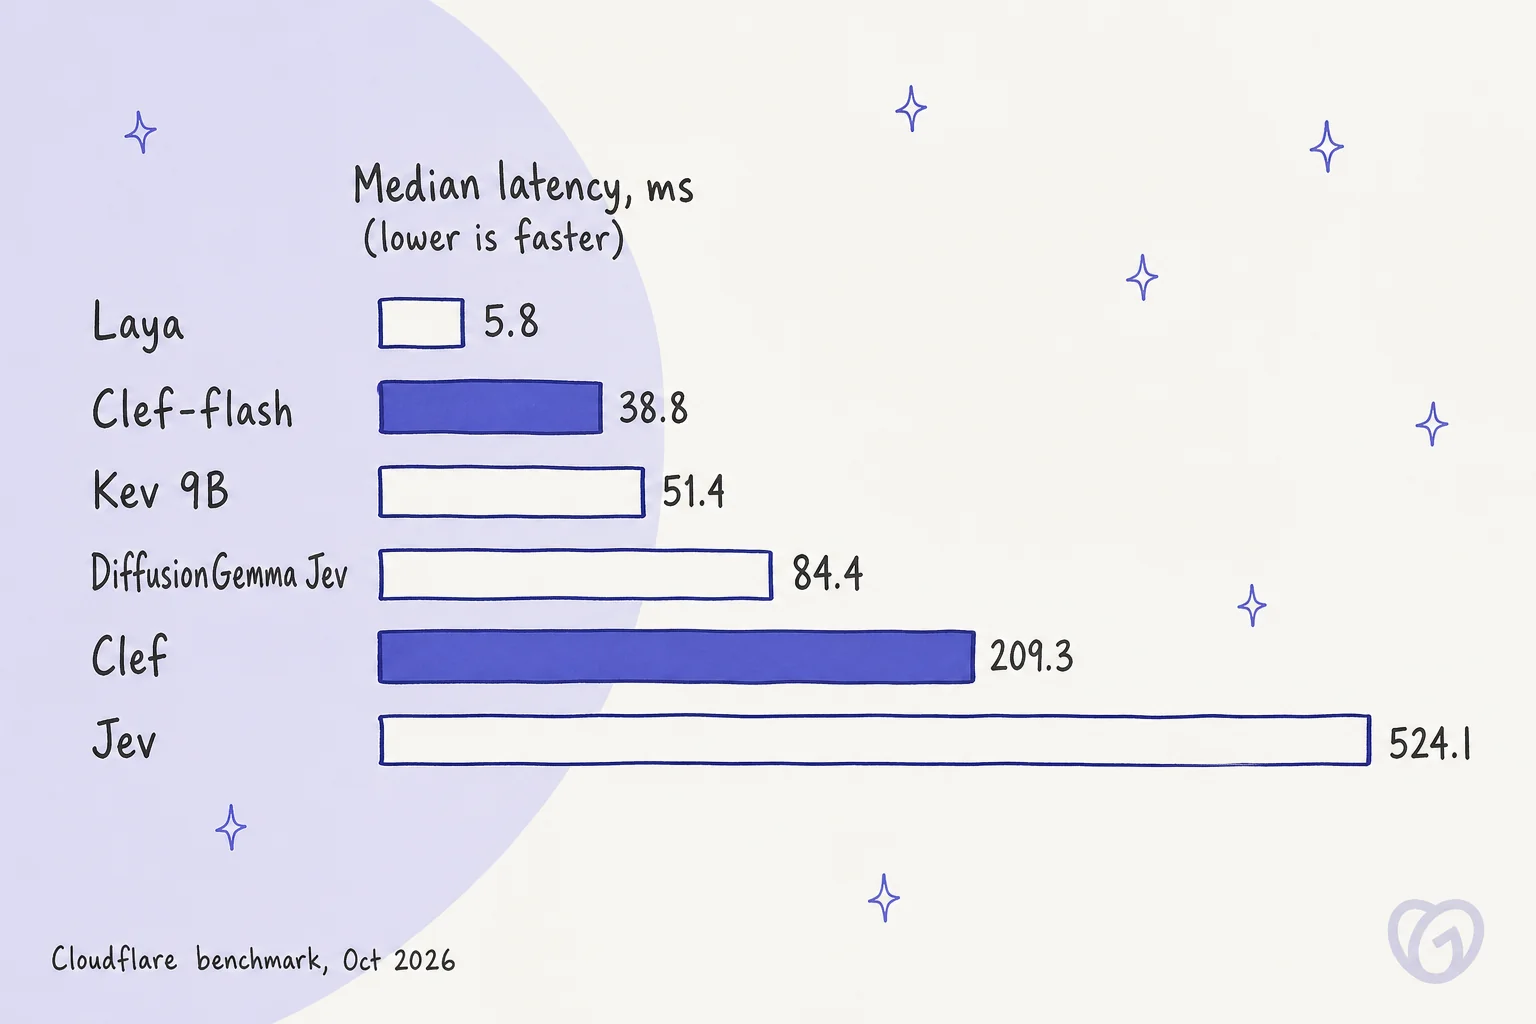
Dos salvedades honestas sobre ese gráfico. Primero, los 524 ms de Jev son un viaje de ida y vuelta alojado a través de internet, mientras que los modelos abiertos se midieron en las propias GPU de Cloudflare, así que no es una carrera en igualdad de condiciones. Segundo, Laya es rapidísimo pero obtiene 6.0 en el Decision Index; velocidad sin precisión es solo una respuesta incorrecta rápida.
Como comparación, un LLM haciendo el mismo trabajo se mide en segundos. Un desarrollador que cambió la capa de protección de un agente de soporte simulado de un LLM a Jev informó de "194ms vs 5,825ms. $125 vs $5,894 por millón de revisiones" en una prueba pequeña de 51 casos. Esa diferencia es todo el argumento para poner un modelo de decisión delante de un agente de IA para helpdesk como protección.
¿Son precisos los modelos de decisión?
Aquí es donde matizaría el entusiasmo. Los modelos de decisión son suficientemente buenos para muchas tareas, pero no son la opción más precisa que hay sobre la mesa.
En JevBench, las notas de evaluación de Strands describen la parte alta del tablero como "modelos de razonamiento (GPT-6 Luna 0.996), luego reconstrucciones de Jev sobre torsos más grandes, mayormente de 12B en adelante (0.83-0.93)". Un LLM de razonamiento como Luna o Claude Sonnet 5.5 sigue ganando en precisión. Los modelos de decisión ganan en coste, velocidad y calibración, y a cambio cedes unos puntos de precisión.
La precisión también cae a medida que crece el número de etiquetas. La propia ficha de Laya muestra 0.425 en BANKING77 (77 etiquetas) frente a 0.870 de Jev (Laya). Si tu helpdesk tiene 60 categorías de enrutamiento, prueba con las 60, no con una demo ordenada de cuatro.
Y las puntuaciones de confianza, el gran argumento de venta, todavía no son ciencia asentada:
"for production routing, you almost always want to threshold on confidence ('auto-handle above 0.9, route to a human below'), and that only works if the probabilities mean what they say. A 96% model with overconfident outputs is operationally worse than a 94% model with honest ones."
Un probador le pidió a Jev el resultado de una tirada de dado justo y obtuvo aproximadamente un 80% de confianza en el "1" (wat10000). Otro mostró una copia abierta de Jev que pasaba a "100% legítimo" cuando el propio correo decía que era legítimo (FooBarWidget). Los modelos de decisión no pueden alucinar un párrafo, pero sí pueden estar completamente seguros y equivocados, o dejarse convencer de una respuesta.
La ficha del modelo de Strands da la pauta correcta: "mide con tu propio tráfico antes de confiar en un umbral". Es la misma lección que hay detrás de evitar las alucinaciones de la IA en soporte: prueba con tickets reales, no con demos.
¿Qué modelo de decisión se ajusta a tu caso?
Elige la situación más parecida a la tuya.
Esa última pestaña no es broma. Un comentarista de Reddit lo dijo perfecto: "la mitad del enrutamiento que he escrito resultó ser un if disfrazado". Las reglas simples de enrutamiento de Zendesk siguen cubriendo mucho terreno.
¿Dónde encajan los modelos de decisión en el servicio de atención al cliente?
El soporte es el caso de uso al que acude primero cada proveedor, y con razón. La clasificación automática es sobre todo una pila de decisiones pequeñas y acotadas. El ejemplo de lanzamiento de Cloudflare es un ticket de soporte. Las propias evaluaciones de flujos de trabajo de TypeSafe incluyen un conjunto de atención al cliente de 5,330 filas.
La clasificación de intención es una pregunta de tipo choice. También lo es la detección de spam. La urgencia es un score, y "¿debería pasar a una persona?" es un sí/no, que es el corazón de la escalada con IA. Incluso el análisis de sentimiento es un score en una escala fija. Todas son preguntas acotadas con un conjunto fijo de respuestas. Esa es exactamente la forma para la que está hecho un modelo de decisión.
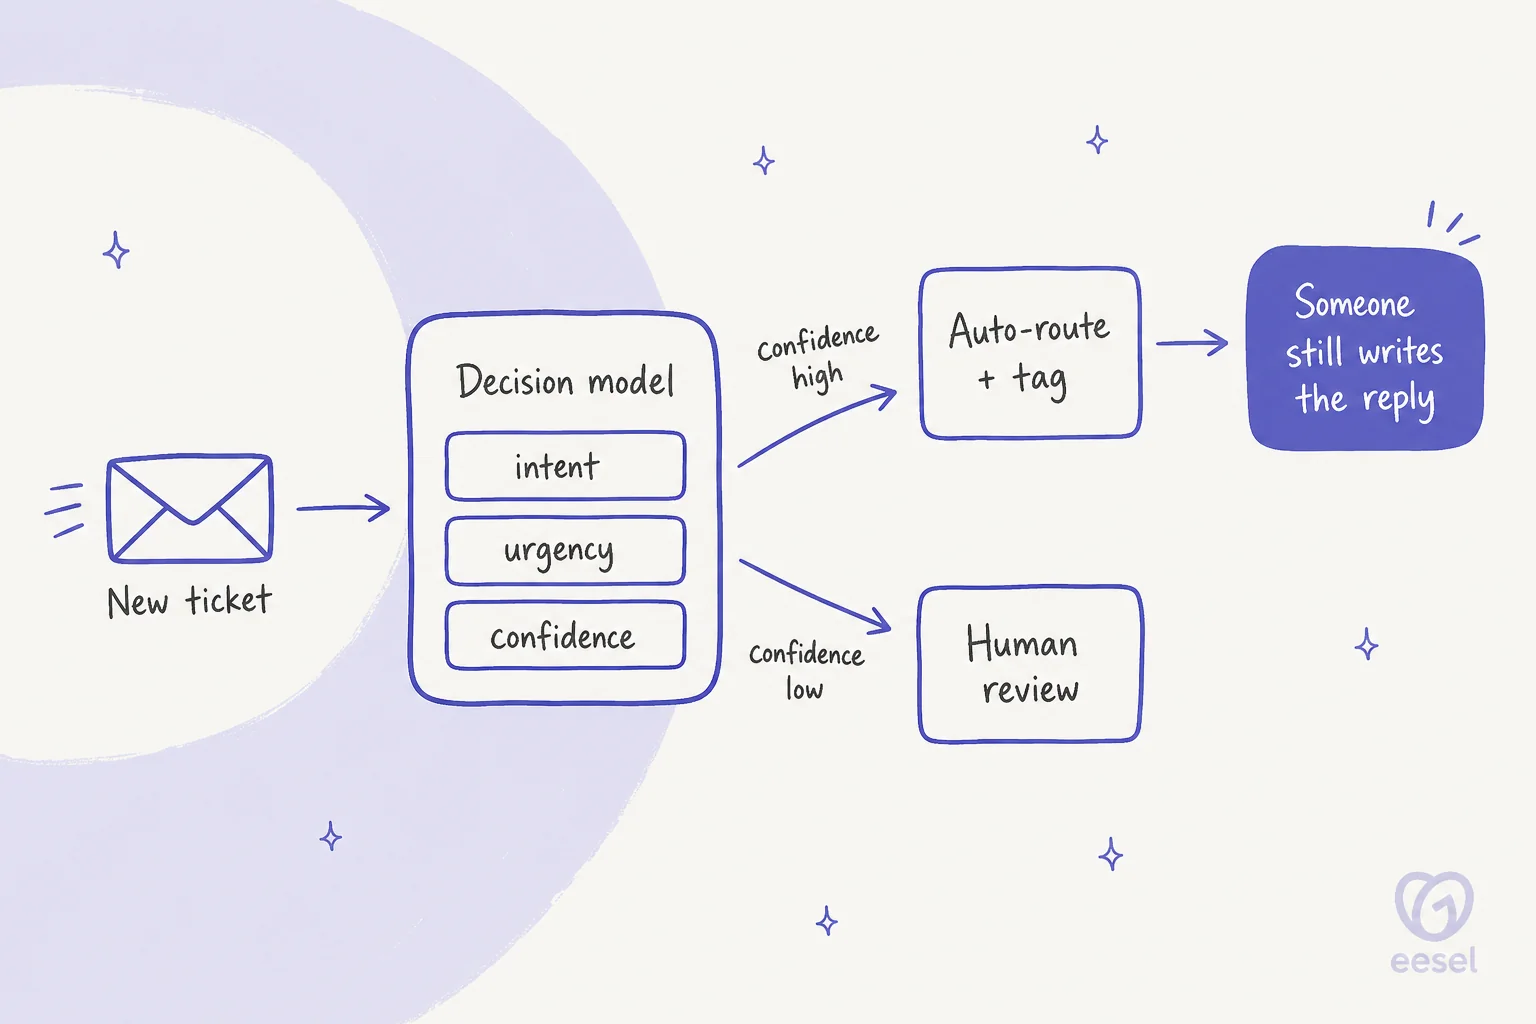
Esto es lo que he aprendido tras años poniendo IA en colas de soporte reales en eesel: clasificar es la mitad fácil. En una prueba con validación cruzada sobre la bandeja de entrada real de Zendesk de una empresa de comercio electrónico, la clasificación con IA alcanzó una precisión del 93% y detectó el 100% del spam, que suponía el 22% de la bandeja. En la misma prueba, solo el 12% de las respuestas redactadas por IA se enviaron tal cual, y el 7% tenía un error factual. La clasificación de tickets estaba casi resuelta. El trabajo estaba en la respuesta.
La puntuación de confianza es la pieza que los compradores llevan tiempo pidiendo. Un responsable de CX que gestiona 7,000 tickets al mes le dijo al equipo de eesel en una llamada de ventas:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Esa es la idea central de un modelo de decisión en una frase. También es la razón por la que eesel simula cada despliegue con los tickets históricos de un equipo antes de que nada salga en vivo: una respuesta con seguridad equivocada es peor que ninguna respuesta, y la única forma de saber dónde está tu umbral es probar con tráfico real.
Un comentario práctico de un propietario de un MSP merece escucharse antes de reconstruir tu stack en torno a la velocidad. En un hilo de r/SmallMSP, dijo que el modelo no era el cuello de botella: "Sospecho que Autotask es mi eslabón débil en cuanto a velocidad". Ahorrar 2 segundos en una llamada de enrutamiento no importa mucho si luego el ticket espera 40 minutos en una cola.
Entonces, ¿dónde encaja un modelo de decisión? Dentro de un flujo de trabajo que construyes tú mismo, como primera pasada barata. Si escribes código y procesas millones de eventos, un modelo de decisión es una gran pieza para enrutamiento, moderación o protecciones, y mi recopilación de alternativas a Jev cubre las opciones para construirlo tú mismo. Si eres un equipo de soporte que quiere tickets etiquetados, enrutados, escalados y respondidos en tu helpdesk actual, un modelo en bruto es el inicio de un proyecto, no el final. Todavía tendrías que construir el etiquetado, el proceso de escalado, la consulta de conocimiento y la respuesta.
Para el camino completo de hacerlo tú mismo, empieza con mi guía para automatizar la clasificación de tickets. Si prefieres comprar a construir, mi recopilación de herramientas de clasificación con IA compara las opciones ya hechas.
Prueba eesel para clasificación y respuestas
El compañero de IA para helpdesk de eesel hace las dos mitades del trabajo, de las que los modelos de decisión solo hacen una. Se une a tu cola actual (hay una integración con Zendesk, además de Freshdesk y Gorgias), etiqueta y enruta tickets, escala lo que no debe tocar y escribe la respuesta a partir de tu centro de ayuda y tickets pasados. Cada automatización incluso tiene un ajuste de "Model strength", con un modelo más ligero "para tareas simples como etiquetar o enrutar" (documentación de automatizaciones) y el más potente para redactar, así que la decisión barata y la respuesta difícil ya corren en modelos distintos.

La idea de confianza también se mantiene. Cada acción (una etiqueta, una respuesta, un reembolso) se configura como automática, que requiere aprobación o desactivada, y los eventos que tus instrucciones no cubren se omiten y se registran con un motivo. Puedes ejecutar una simulación con tus propios tickets pasados antes de que nada salga en vivo.
Si llegaste aquí como desarrollador, la CLI de eesel es el puente. Ejecuta npx @eesel/cli y podrás conectar un helpdesk, configurar una automatización con instrucciones de enrutamiento en lenguaje natural mediante eesel automations, y aprobar o denegar acciones retenidas con eesel approvals, todo desde una terminal. Cada comando devuelve JSON, así que Claude Code, Cursor o Codex pueden dirigir toda la configuración, y --dry-run comprueba una escritura antes de que ocurra. Obtienes la lógica de enrutamiento que habrías construido en torno a un modelo de decisión, más la parte que responde al cliente, sin escribir el código de unión.
Los planes empiezan en $299 al mes por 500 créditos en los precios de eesel, donde un crédito es un ticket, sin cargos por usuario, y hay un nivel gratuito con 100 créditos. Prueba eesel con tus propios tickets y comprueba dónde está realmente tu línea de confianza.
Preguntas frecuentes
¿Qué es un modelo de decisión en IA?
Un modelo de decisión es un modelo de IA pequeño que responde preguntas tipadas (sí/no, elegir una opción o puntuar en una escala) sobre un dato de entrada y devuelve cada respuesta con una probabilidad, en lugar de escribir texto. TypeSafe Jev inició la categoría en septiembre de 2026, y los modelos de decisión ya se usan para tareas como la clasificación de tickets. Ordenar un ticket por tema, también llamado clasificación de intención, es una tarea típica.
¿En qué se diferencian los modelos de decisión de los LLM?
Un LLM genera texto token a token, así que tienes que analizar su respuesta. Un modelo de decisión lee la entrada una vez y puntúa las respuestas permitidas en una sola pasada, de modo que no hay texto que generar y la salida es prácticamente gratis. La contrapartida es que los modelos de decisión no pueden escribir respuestas, código ni resúmenes, por eso un equipo de soporte sigue necesitando un agente de IA para helpdesk o una persona para la respuesta.
¿Los modelos de decisión son simplemente clasificadores?
Matemáticamente se parecen mucho: eligen entre etiquetas y devuelven probabilidades. Lo nuevo es que funcionan sin ejemplos (zero-shot) con etiquetas que defines al hacer la solicitud, así que no necesitas recopilar datos ni entrenar un modelo para cada nuevo problema de clasificación de tickets.
¿Cuánto cuestan los modelos de decisión?
Jev cuesta $0.042 por millón de tokens de entrada con salida gratuita, Cloudflare Clef cuesta $0.24 y Clef-flash $0.09 por millón de tokens de entrada, y Strands Decider 2B es gratis si lo ejecutas tú mismo. OpenAI no ha publicado un precio para su Decisions API. Mi artículo sobre los precios de Jev tiene las cuentas completas. Para Clef, consulta el desglose de precios de Clef.
¿Cuál es el mejor modelo de decisión?
En el Decision Index de la comunidad, Jev obtiene 57.9 y ningún modelo abierto probado de forma independiente lo supera todavía. Cloudflare indica 61.2 para Clef en su propia copia del tablero, pero esa puntuación es autodeclarada. Para imágenes, Clef; para uso sin conexión o en CPU, Strands Decider 2B; para las decisiones de texto alojadas más baratas, Jev.
¿Puedo usar un modelo de decisión para enrutar tickets?
Sí. El enrutamiento de tickets, la urgencia y las decisiones de escalado son el caso de uso de manual, y el propio ejemplo de lanzamiento de Cloudflare enruta un mensaje de soporte por equipo y gravedad. Aun así necesitas código o una herramienta de helpdesk que actúe sobre la etiqueta, y eso es lo que gestiona de principio a fin un compañero de IA para helpdesk.
¿Está disponible la Decisions API de OpenAI?
OpenAI anunció la Decisions API en el DevDay 2026 en vista previa limitada. A fecha del 6 de octubre de 2026 no hay documentación pública, esquema ni precio, y el endpoint devuelve un error de no habilitado para las claves de API estándar. Mi artículo sobre la Decisions API de OpenAI sigue lo que se sabe.
¿Los modelos de decisión sustituyen a un agente de soporte con IA?
No. Un modelo de decisión toma una decisión acotada, como qué equipo debe encargarse o qué urgencia tiene. No consulta un pedido, no aplica una política de reembolsos ni escribe una respuesta. Los modelos de decisión son una pieza para automatizar la clasificación de tickets, no un reemplazo del compañero que resuelve el ticket.