

Resumen rápido
LFM3 es la nueva familia de Liquid AI formada por seis modelos abiertos de unos 2B de parámetros cada uno, publicada el 27 de octubre de 2026, y el modelo de texto, LFM3-1.7B, obtiene una media de 49.37 en la tabla de 29 pruebas de rendimiento de Liquid frente a 47.24 de Qwen3.5-9B, un modelo cinco veces más grande. Está diseñado para agentes locales: decodifica 43.6 tokens por segundo en un iPhone 17 Pro usando 1.90 GB de memoria, aproximadamente 2.8x más rápido que el siguiente modelo que probó Liquid.
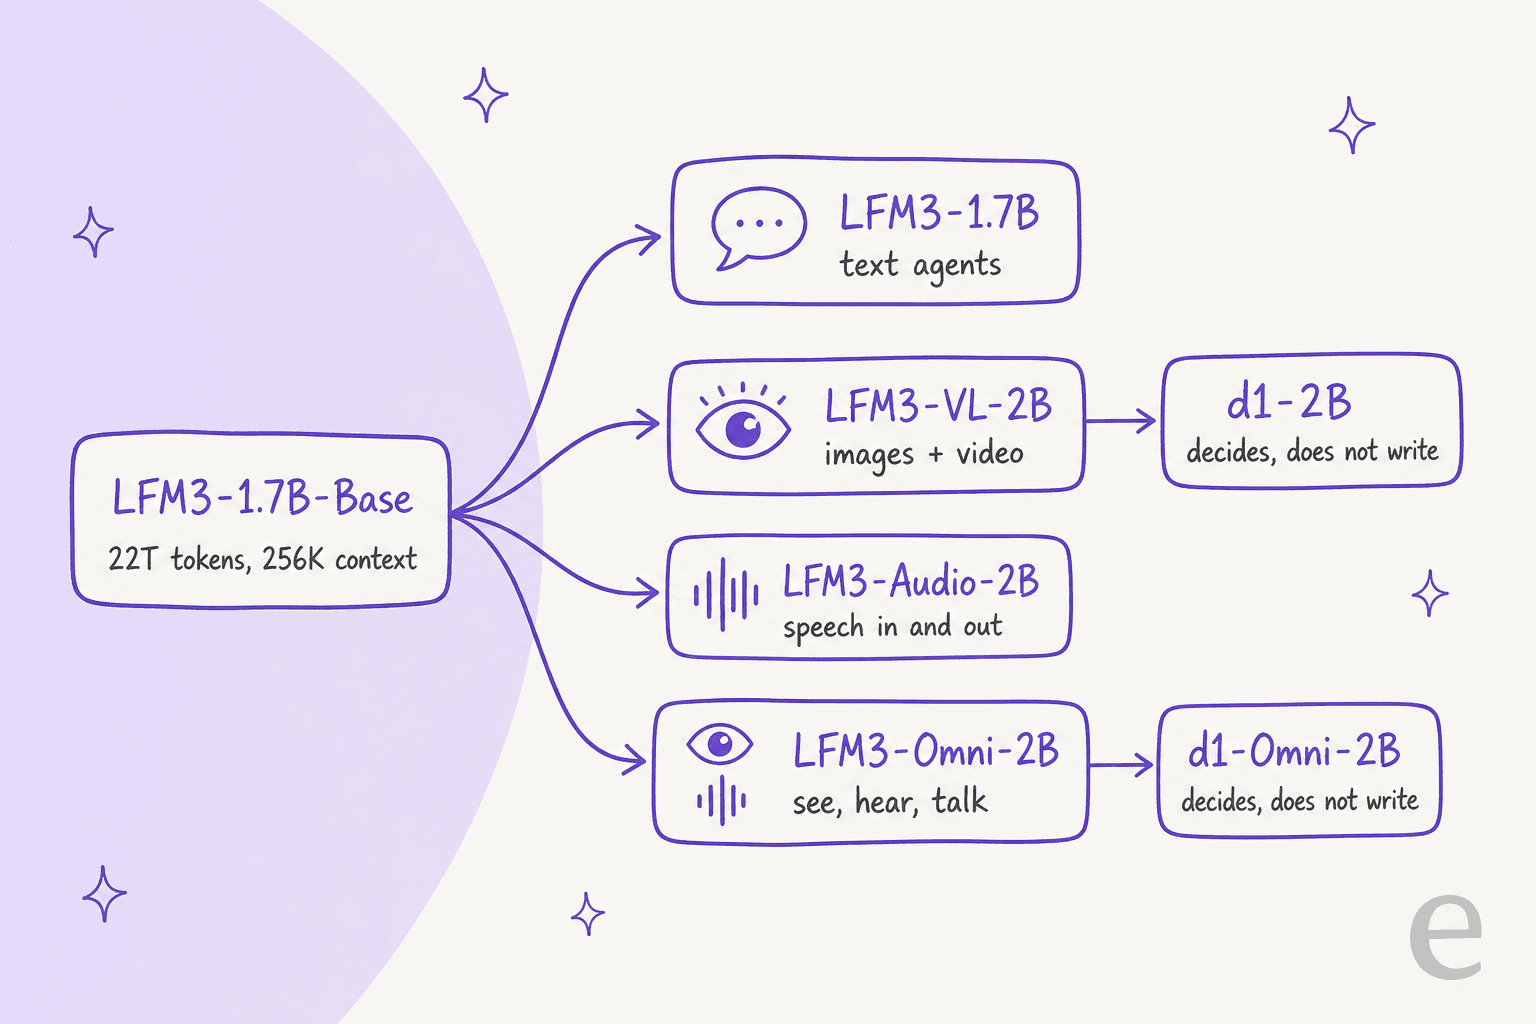
La familia abarca texto, visión, audio, un modelo "omni" que ve, oye y habla, y dos modelos de decisión (d1-2B y d1-Omni-2B) que responden preguntas sobre un ticket o documento en milisegundos en lugar de redactar una respuesta. Los pesos son gratuitos en Hugging Face, pero solo para empresas con menos de 10 M$ de ingresos anuales, y todavía no hay un precio publicado de la API para LFM3.
La pega: la propia ficha del modelo de Liquid dice que no se debe usar LFM3-1.7B para programación con agentes ni para razonamiento complejo de varios pasos, y todas las cifras anteriores las proporciona el proveedor. Para los equipos de soporte, la pieza interesante es d1-2B, que puede asignar y etiquetar un ticket en una sola pasada. Un modelo sigue necesitando una plataforma de soporte a su alrededor, por eso equipos como Dokument 24 usan un compañero de IA para soporte listo para trabajar que etiqueta y prepara borradores para cada nuevo ticket de Zendesk, en lugar de integrar un modelo por su cuenta.
¿Qué es LFM3?
LFM3 es la tercera generación de Liquid Foundation Models de Liquid AI, la empresa detrás de modelos pequeños pensados para ejecutarse en teléfonos, portátiles y coches en lugar de en un centro de datos. Liquid anunció LFM3 el 27 de octubre de 2026 como "every modality for specialized intelligence," y la primera versión abarca modelos "in the 2B parameter range."
Yo abordo los nuevos modelos desde la perspectiva de las búsquedas (¿qué pregunta realmente la gente sobre ellos?), con una pregunta de quien crea productos de fondo: ¿qué haría falta para usarlos como base de un producto real? Para LFM3, la respuesta es más interesante que en la mayoría de los lanzamientos, porque no es un solo modelo, sino una familia.
Los seis modelos postentrenados parten de una misma base, LFM3-1.7B-Base, que se preentrenó con 22 billones de tokens y tiene una ventana de contexto de 256K tokens. En lugar de un gran modelo generalista, la propuesta de Liquid es que elijas el modelo pequeño que encaje con la tarea, lo ajustes con tus propios datos y lo ejecutes en el dispositivo.
Los modelos LFM3 de un vistazo
Aquí tienes la primera versión completa, con las cifras de cada ficha de modelo de Hugging Face:
| Modelo | Qué hace | Parámetros | Contexto |
|---|---|---|---|
| LFM3-1.7B | Texto, llamadas a herramientas, agentes locales | 1.73B | 256K |
| LFM3-VL-2B | Recibe imágenes y vídeo, genera texto, con razonamiento paso a paso | 1.92B | 128K |
| LFM3-Audio-2B | Reconocimiento de voz, generación de voz, traducción de voz | 2B | 32K |
| LFM3-Omni-2B | Recibe texto, imágenes, vídeo y audio; genera texto y voz | 2.17B | 32K |
| d1-2B | Decisiones sobre texto e imágenes, sin generar texto | 1.92B | 128K |
| d1-Omni-2B | Decisiones sobre texto, imágenes y audio | 2B | No indicado |
El modelo de texto entiende 16 idiomas, entre ellos inglés, árabe, chino, japonés, hindi y polaco, según su ficha de modelo, algo que importa cuando ofreces soporte multilingüe. El modelo omni habla en 19 idiomas y variantes regionales.
¿Qué cambió en la arquitectura de LFM3?
LFM2 demostró que una combinación de convoluciones cortas y atención podía ejecutarse rápidamente en un teléfono. LFM3 mantiene esa idea y añade un tercer ingrediente. De sus 24 capas, lo que conviene destacar es que 13 son convoluciones cortas con compuertas, mientras que 5 son de atención de ventana deslizante con una ventana de 256 tokens y 6 son de atención global. Liquid lo llama "tri-hybrid."
El objetivo principal del rediseño es el contexto largo. La publicación del lanzamiento dice que LFM3-1.7B iguala a LFM2-1.2B en instrucciones cortas en distintos dispositivos periféricos, por parámetro, y es aproximadamente un 25 % más rápido con 8K tokens de contexto. Liquid encontró el diseño mediante una búsqueda con hardware en el bucle que abarcó 14 combinaciones de dispositivos y motores de ejecución, desde un Samsung Galaxy S26 Ultra y una Raspberry Pi 5 hasta portátiles Apple M4 Max y la NPU Qualcomm Hexagon.
Esta vez, el entrenamiento tuvo más peso en el trabajo con agentes. Los últimos 3.5 billones de tokens de preentrenamiento fueron datos seleccionados con "a larger share of agentic traces and diverse tool calls," y el modelo de texto pasó después por cuatro etapas de postentrenamiento: ajuste fino supervisado con 1.75 billones de tokens, aprendizaje por refuerzo mixto, destilación a partir de seis modelos maestros especializados y aprendizaje por refuerzo para agentes dentro de entornos de ejecución reales como OpenClaw y Hermes Agent.
¿Qué tal rinde LFM3-1.7B en las pruebas de rendimiento?
En la propia tabla de Liquid AI, LFM3-1.7B supera a modelos mucho más grandes en tareas de agentes y seguimiento de instrucciones, pero pierde en programación y conocimientos. Su media en 29 pruebas de rendimiento es de 49.37, frente a 47.24 de Qwen3.5-9B, 39.27 de Qwen3.5-4B, 39.19 de MiniCPM5 2B y 31.74 de Gemma 4 E4B.
Aquí tienes una selección de los resultados publicados:
| Prueba de rendimiento | LFM3-1.7B | MiniCPM5 2B | Gemma 4 E4B | Qwen3.5-4B | Qwen3.5-9B |
|---|---|---|---|---|---|
| AutomationBench (pública) | 41.29 | 4.71 | 1.92 | 8.67 | 15.10 |
| WebArena-Verified | 38.42 | 9.11 | 17.06 | 21.92 | 28.94 |
| BFCL V4 (llamadas a herramientas) | 71.39 | 62.65 | 48.25 | 55.12 | 62.83 |
| τ³-bench | 68.01 | 69.44 | 33.53 | 65.98 | 67.11 |
| IFBench | 73.03 | 62.08 | 44.56 | 38.16 | 48.84 |
| SWE-bench Verified (OpenCode) | 43.40 | 34.80 | 0.50 | 41.20 | 51.20 |
| GPQA Diamond | 63.37 | 65.15 | 57.88 | 75.76 | 80.40 |
| RULER 128K | 65.56 | 37.96 | 18.82 | 84.63 | 87.11 |
| Media (29 pruebas de rendimiento) | 49.37 | 39.19 | 31.74 | 39.27 | 47.24 |
La fila de τ³-bench es la primera que miraría si trabajas en soporte, porque τ-bench simula a un agente ayudando a clientes mediante conversaciones de varios turnos con herramientas y políticas. LFM3-1.7B obtiene 68.01, aproximadamente al nivel del 67.11 de Qwen3.5-9B y justo por detrás del 69.44 de MiniCPM5 2B. Es un resultado sólido para su tamaño, lo cual está bien, pero no es la ventaja aplastante que se ve en AutomationBench. (Para ver cómo se comparan los modelos alojados más grandes en tareas de soporte, mantengo actualizada una selección del mejor modelo de IA para tickets de soporte.)
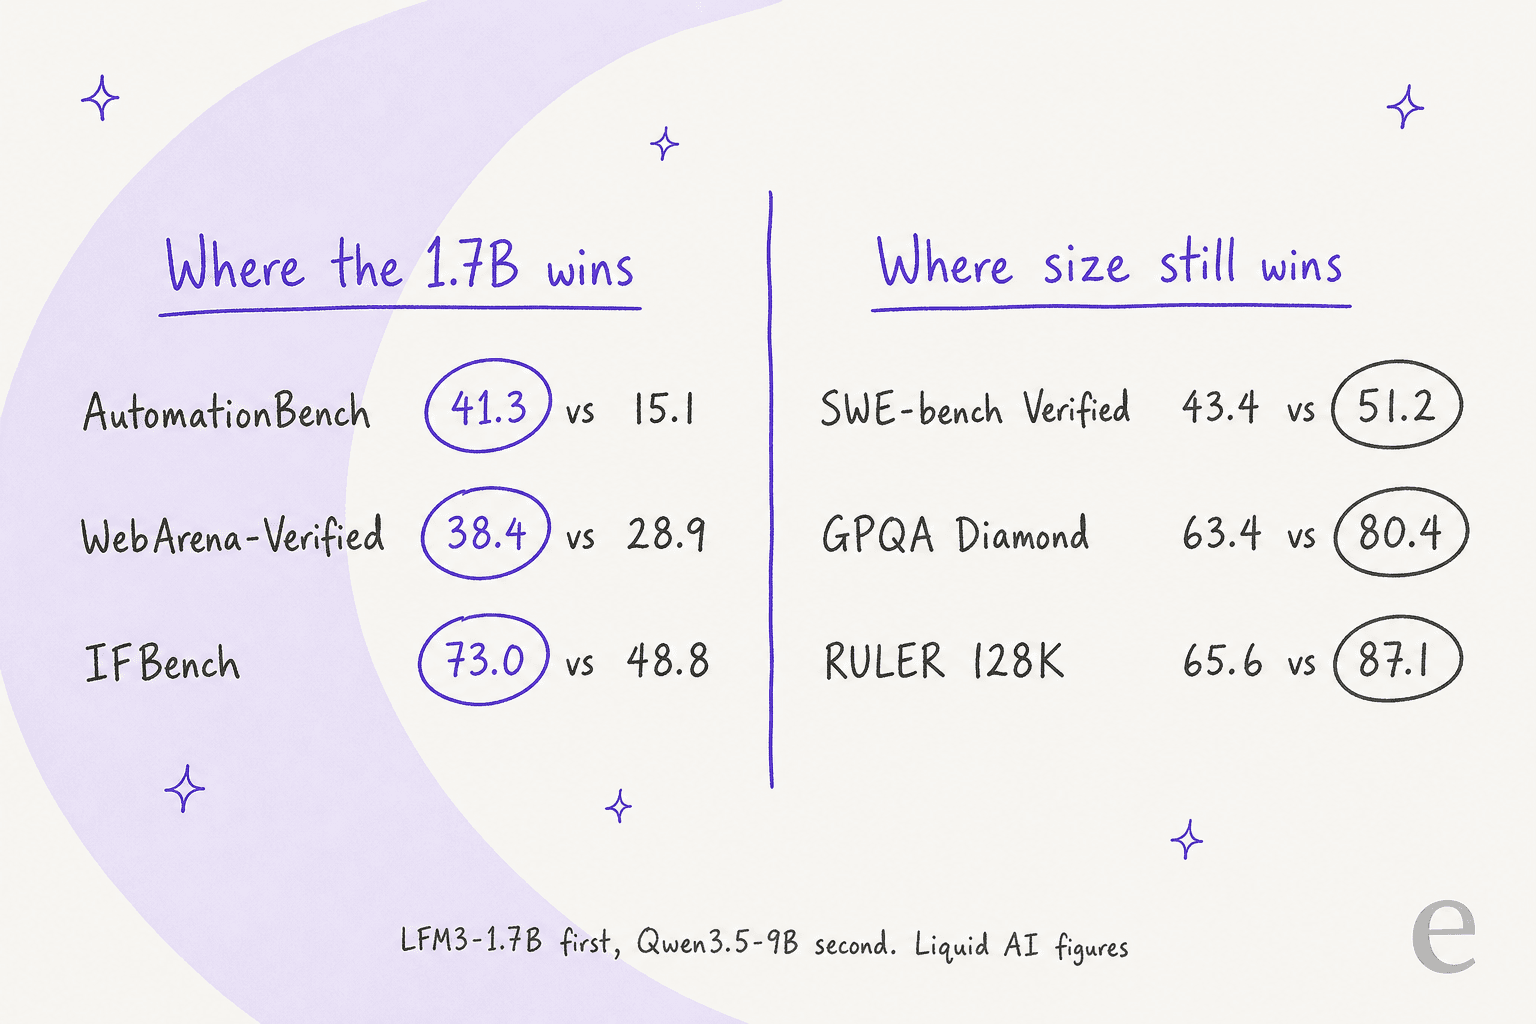
Esa diferencia es lo realmente importante. LFM3-1.7B es bueno siguiendo instrucciones y llamando a herramientas, y flojea cuando los conocimientos puros o la recuperación de información en contextos largos determinan la puntuación. Liquid viene a decir lo mismo: la búsqueda "helps close the knowledge gap," y casi duplica su puntuación en Humanity's Last Exam, de 7.17 a 13.90, cuando se permiten herramientas. Un lector del hilo del lanzamiento resumió la tabla así:
"Agentic coding numbers on par with Qwen3.5-4B, the rest of the numbers on par with Qwen3.5-9B. Most impressive for a 1.7B model!"

Otra cifra que conviene conocer: en AA-Omniscience, una prueba que recompensa decir "no lo sé" en lugar de adivinar, LFM3-1.7B obtuvo 92.93 en ausencia de alucinaciones frente a 13.64 de Qwen3.5-4B. Su precisión en la misma prueba fue de solo 7.07, así que alcanza ese resultado principalmente al negarse a responder. Para un modelo pensado para recurrir de todos modos a la búsqueda o a una base de conocimiento, ese es el instinto correcto, y es el mismo hábito que buscas al evitar las alucinaciones de la IA en soporte.
¿Qué tan rápido es LFM3 en un teléfono o portátil?
Muy rápido para su categoría. Liquid lo probó con llama.cpp en Q4_0 y un contexto de 32K tokens, y LFM3-1.7B fue el modelo más rápido en los tres dispositivos, con una decodificación entre 1.8 y 2.8 veces más rápida que la del siguiente, además de usar la menor cantidad de memoria.
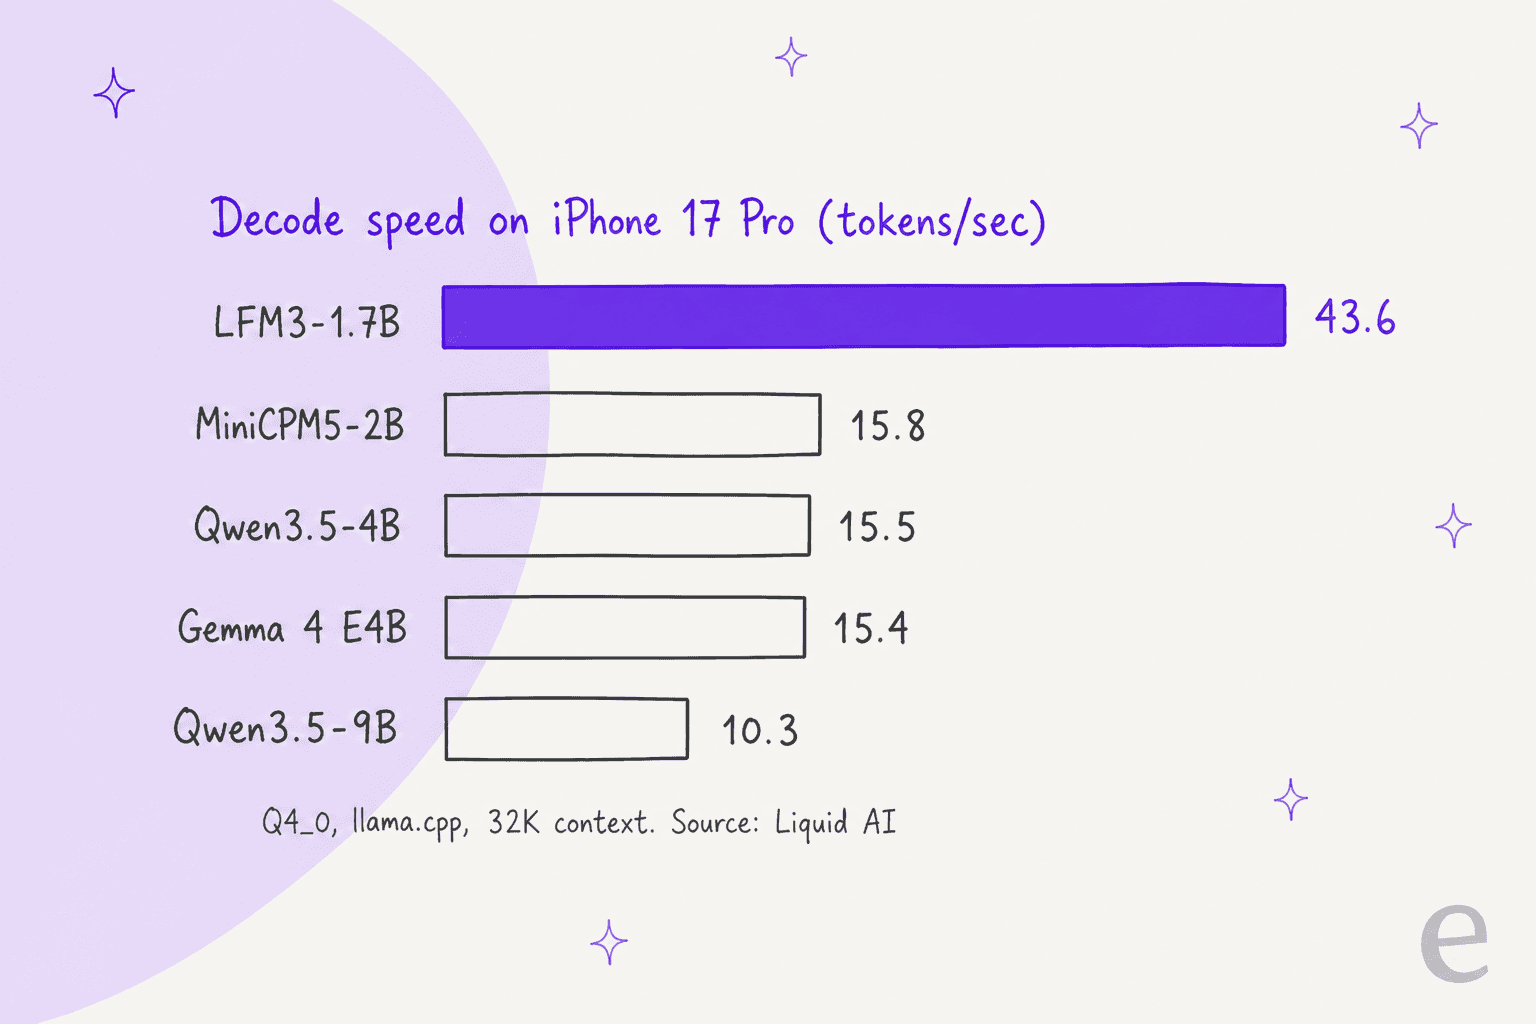
| Dispositivo | Decodificación de LFM3-1.7B | Siguiente más rápido | Memoria de LFM3-1.7B |
|---|---|---|---|
| iPhone 17 Pro | 43.6 tok/s | 15.8 (MiniCPM5-2B) | 1.90 GB |
| Apple M5 Max | 237.1 tok/s | 106.0 (MiniCPM5-2B) | 2.25 GB |
| AMD Ryzen AI Max+ 395 | 129.6 tok/s | 70.1 (MiniCPM5-2B) | 2.75 GB |
El contexto largo también consume pocos recursos. Un contexto completo de 128K tokens necesita 1.6 GB de caché KV, la memoria que usa un modelo para conservar la conversación hasta ese momento, frente a 4.3 GB de Qwen3.5-4B y 5.6 GB de MiniCPM5-2B. Compáralo con un modelo denso de tamaño medio como Nanbeige 4.3, que necesita unos 28 GB de caché para la misma longitud.
En servidores, las cifras se disparan. En una NVIDIA B300 con 1.024 solicitudes simultáneas, LFM3-1.7B produjo 41,710 tokens de salida por segundo, que Liquid redondea a 3.6 mil millones de tokens al día. Para demostrarlo, Liquid ejecutó más de 300.000 agentes LFM3-1.7B en paralelo sobre el archivo de correos de Enron. En su propia infraestructura de inferencia de baja latencia, la latencia p95 de una solicitud corta se mantuvo en 150 ms incluso con 500 solicitudes por segundo en una sola B200.
¿Qué pueden hacer los modelos de visión, audio y omni?
Los otros modelos de la familia son lo que hace que LFM3 resulte inusual para un lanzamiento de 2B. Cada uno es lo bastante pequeño para ejecutarse en un teléfono y cubre una tarea que normalmente necesita un modelo más grande en la nube.
LFM3-VL-2B es el primer modelo de visión de Liquid que admite vídeo, y razona paso a paso antes de responder. En 62 pruebas de visión obtiene una media de 71.4, por delante de Gemini 3.5 Flash Lite (70.0) y al nivel de Gemma 4 12B (71.7), un modelo más de seis veces mayor. Está a menos de dos puntos de GPT-5.6 Luna (73.4). Sus mejores puntuaciones están en lectura de documentos, OCR y gráficos (83.9) y en comprensión de interfaces gráficas (83.1).
LFM3-Audio-2B transcribe, habla y traduce voz, con un nuevo codificador de audio en streaming que empieza a procesar mientras todavía estás hablando. Liquid dice que el tiempo hasta el primer token puede ser de tan solo 50 ms.
LFM3-Omni-2B es el primer modelo de Liquid que ve, escucha y habla en uno solo: puedes hacer una pregunta por voz sobre una imagen y recibir una respuesta hablada, o preguntarle sobre un vídeo con sonido. También puede convertir directamente una petición hablada, junto con lo que aparece en pantalla, en una llamada estructurada a una herramienta. La demostración de Liquid lo muestra reservando un vuelo por voz en un portátil. Si estás valorando herramientas de voz para una línea de soporte, mi selección de los mejores agentes de voz con IA cubre las opciones alojadas, y esta guía sobre un agente de voz con IA para soporte explica la configuración.
¿Para qué sirven los modelos de decisión d1?
Esta es la parte de LFM3 a la que prestaría más atención si diriges un equipo de soporte. d1-2B y d1-Omni-2B no escriben nada. Les das una entrada y una lista de preguntas, y las responden todas en una sola pasada de inferencia, cada una con una probabilidad calibrada. Liquid enumera "a support ticket, an invoice, an app screen, a photo, a voice note" como entradas típicas.
La ficha del modelo d1-2B usa un ticket de soporte como ejemplo principal: un cliente al que se le cobró dos veces y cuyo paquete nunca llegó. En una sola pasada, el modelo elige un equipo (facturación, envíos o soporte técnico) y dice si corresponde un reembolso, además de enumerar los temas y puntuar la urgencia. Liquid informa de 5.7 ms por decisión en una H100. Eso encaja exactamente con el trabajo de clasificación y priorización de tickets, por eso creo que este es el modelo más práctico del lanzamiento para los equipos de soporte. Cubrí la categoría más amplia en mi explicación sobre los modelos de decisión.
Una novedad de esta generación son las respuestas tipadas. Además de sí/no, opciones múltiples y puntuaciones, los modelos d1 pueden:
- Señalar: dibujar un recuadro alrededor de algo que describes o contar todas sus apariciones.
- Leer: extraer texto, números y fechas de un documento con el fragmento exacto, o decir "no encontrado".
- Estimar: dar un número con un rango probable.
- Elegir: seleccionar todas las opciones que correspondan, cada una con su propia probabilidad.
d1-2B sustituye al anterior d1-3B con un tercio menos de parámetros. En la prueba "Typed Decisions (customer service cases)" de Liquid, d1-Omni-2B obtuvo 50.5 con entradas escritas y 48.0 cuando las mismas preguntas se hicieron por voz, y 83.4 en DecisionBench, una prueba de asignación y clasificación para empresas. Son pruebas de la propia Liquid, así que tómalas como punto de partida para tus propias evaluaciones. Si primero quieres la versión manual del mismo trabajo, aquí tienes cómo automatizar la clasificación y priorización de tickets con reglas. Un ingeniero de Liquid en el hilo del lanzamiento explicó claramente la ventaja del hardware:
"If you want to do local classification/image processing, I think the d1-2B is amazing, it can run on 1GB of unified RAM."
La ficha también es sincera sobre los límites: las preguntas que requieren muchos conocimientos favorecen a los modelos más grandes, y las respuestas se vuelven menos fiables más allá de unos 64K tokens de entrada.
¿Cuánto cuesta LFM3?
Los pesos son gratuitos para la mayoría de las empresas, y todavía no hay un precio publicado de la API. Esto es lo que figura en la página de precios de Liquid y en su licencia a fecha del 28 de octubre de 2026:
| Opción | Precio | Notas |
|---|---|---|
| Pesos abiertos, empresa con menos de 10 M$ de ingresos | Gratis | LFM Open License v1.0, basada en Apache 2.0 |
| Pesos abiertos, empresa con 10+ M$ de ingresos | Licencia de pago, solo bajo presupuesto | Contacta con el equipo de ventas de Liquid; se cuentan los ingresos de todo el grupo empresarial |
| Investigación y organizaciones sin ánimo de lucro que cumplan los requisitos | Gratis | Sin límite de ingresos |
| API de Liquid, modelos LFM3 | No publicado | Todavía no aparecen en la página de precios |
| API de Liquid, d1 | 0,02 $ por 1M de tokens de entrada, 0 $ de salida | El d1 anterior, no el d1-2B basado en LFM3 |
| API de Liquid, LFM2.5-24B-A2B | 0,05 $ de entrada / 0,70 $ de salida por 1M de tokens | El modelo alojado más grande de Liquid |
| Nueva cuenta de Liquid Console | 2 $ de crédito gratuito | Por organización |
Dos detalles importan más que los precios. Primero, el umbral de 10 M$ de ingresos cuenta todo tu grupo empresarial, no el producto, y el número de usuarios no importa. Segundo, la licencia no tiene copyleft, así que puedes mantener privada una versión ajustada, siempre que incluyas la atribución y una copia de la licencia cuando la redistribuyas.
OpenRouter figura como socio de lanzamiento desde el día 0, pero el 28 de octubre su página de Liquid solo mostraba modelos anteriores de Liquid y d1.1, sin ningún modelo LFM3 todavía. Si quieres hoy un modelo alojado con una tabla de tarifas pública, la comparación es con los precios de GPT-6 Luna. Gemini 3.5 Flash Lite es la otra opción económica.
¿Cómo se ejecuta LFM3?
Lo descargas de Hugging Face y lo ejecutas en local, o primero lo pruebas en el entorno de pruebas de Liquid en el navegador. La colección LFM3 tiene cada modelo en BF16, GGUF, MLX de 4 bits y ONNX, con versiones FP8 y NVFP4 para servidores.
La vía local más rápida es llama.cpp. La documentación de LFM3-1.7B ofrece este comando, con los ajustes recomendados por Liquid:
llama-cli -hf LiquidAI/LFM3-1.7B-GGUF --temp 0.1 --top-k 50 --repeat-penalty 1.1
Algunas cosas que conviene saber antes de empezar:
- Necesitas una compilación reciente. La ficha de GGUF dice que necesitas una compilación de llama.cpp compatible con LFM3. El archivo Q4_0 ocupa
1.05 GBy Q8_0 ocupa1.85 GB. - vLLM y SGLang sirven para ofrecer inferencia. Las pruebas de GPU de la propia Liquid usaron SGLang 0.5.22 con compatibilidad con LFM3.
- El razonamiento está activado por defecto. La plantilla de chat abre un bloque
<think>, y la ficha advierte que desactivarlo puede dar resultados inconsistentes. - Las llamadas a herramientas cambiaron de formato. LFM3 usa un formato XML que es un superconjunto del de Qwen3-Coder, no el formato personalizado de LFM2, así que los analizadores antiguos necesitan una actualización.
- El ajuste fino es económico. Liquid tiene cuadernos de TRL para SFT, DPO y GRPO en LFM3-1.7B. En su demostración de inspección de aerogeneradores, ajustó LFM3-VL-2B con unas 3.000 fotos en unas pocas horas en una sola A100. (Para contenido de soporte, RAG frente a ajuste fino es la pregunta más habitual.)
Si prefieres probar antes de descargar, Liquid Playground tiene LFM3-1.7B, LFM3-VL-2B, LFM3 Omni 2B y LFM3 Audio 2B en un selector de modelos.
¿Qué dicen los primeros usuarios sobre LFM3?
Solo lleva un día disponible, así que hay pocas experiencias de uso y proceden principalmente del hilo del lanzamiento en Hacker News, que alcanzó 101 puntos y 36 comentarios. Esas primeras observaciones sirven para contrastar la tabla de rendimiento con la realidad.
Un lector detectó un error factual básico en el entorno de pruebas y lo atribuyó a la cuantización:
"when asked “what does a cow say?”, LFM3-1.7B said that a cow can say “Oink”... I assume this is lower quant problem, though: Q8 versions I’ve played with through llama both give the correct “moo” answer."
Otro vio que el intenso entrenamiento en uso de herramientas aparecía donde no se había pedido, en una pregunta de cultura general sin instrucciones de sistema:
"I am seeing the following in the reasoning trace: > However, the instructions say I must use available tools when answering questions."
Las herramientas del primer día también tenían algunas asperezas. Un lector no pudo cargar las versiones MLX en LM Studio ni en otros dos entornos de ejecución MLX. El comentario más relevante para el trabajo de soporte vino de alguien que usaba la generación anterior para clasificar y priorizar mensajes entrantes:
"The LFM annotations are basically triage... Right now LFM 2.6 gets trustworthy annotations on just over 40% of data points."
Esa es una imagen realista de un modelo pequeño en producción: se ocupa de la primera pasada sencilla, y un modelo más grande o una persona se encarga del resto. Es la misma división que usaría para la clasificación de tickets con IA.
¿Dónde se queda corto LFM3?
Los límites reales están principalmente en la propia letra pequeña de Liquid:
- No es para programación con agentes ni razonamiento difícil. La ficha de LFM3-1.7B dice que está "not recommended for agentic coding or complex multi-step reasoning," y sugiere recuperación de información o búsqueda para tareas que requieren muchos conocimientos. La ficha del modelo de visión añade las conversaciones de varios turnos a esa lista.
- Todas las cifras las proporciona el proveedor. Artificial Analysis no había incluido LFM3 el 28 de octubre, así que todavía no hay una puntuación independiente.
- La licencia no es Apache 2.0. Se parece, pero el umbral de 10 M$ de ingresos significa que las empresas más grandes necesitan un acuerdo de pago antes de distribuirlo.
- Contexto corto en los modelos de voz. LFM3-Audio-2B y LFM3-Omni-2B tienen ventanas de 32K tokens, una octava parte de la del modelo de texto.
- Las herramientas todavía se están poniendo al día. La ficha de visión indica que la compatibilidad con llama.cpp está en revisión, sin vídeo, y que la compatibilidad con vLLM está en desarrollo.
¿Deberías usar LFM3?
Depende de lo que estés creando:
- Asistentes en el dispositivo y agentes locales: sí, prueba primero LFM3-1.7B. Ningún otro modelo de los que comparó Liquid se ejecuta tan rápido con tan poca memoria, y se entrenó dentro de entornos de ejecución reales de agentes. Tiene cabida en cualquier lista de agentes de IA de código abierto que quieras probar.
- Clasificación, asignación y extracción a escala: echa un vistazo a d1-2B. Una pasada, muchas preguntas, milisegundos por decisión y alrededor de 1 GB de RAM. Encaja de forma natural con la asignación de tickets y el etiquetado.
- Aplicaciones de voz y cámara: LFM3-Omni-2B es uno de los pocos modelos pequeños que oye y habla. Ten en cuenta el contexto de 32K.
- Agentes de programación: no. La propia Liquid lo dice, y modelos como Nanbeige 4.3 o la pareja Nemotron 3.5 Bolt son mejores puntos de partida.
- Un agente de atención al cliente: LFM3 es un motor potente para partes del trabajo, especialmente la clasificación y priorización, pero no es un agente por sí solo. La siguiente sección trata sobre lo que falta.
Ejecutar modelos pequeños en una cola real de soporte
Un modelo como d1-2B puede decirte que un ticket trata sobre facturación y es urgente. Para ayudar de verdad, sigue haciendo falta algo que esté dentro de tu plataforma de soporte, lea el ticket cuando llegue, consulte tu centro de ayuda y los tickets anteriores, guarde la etiqueta, prepare un borrador de respuesta y sepa de qué tickets debe encargarse una persona. Ese es el trabajo para el que está diseñado el compañero de IA para soporte de eesel, uno de los compañeros de IA listos para trabajar que contratas para una función específica, en lugar de un modelo que tienes que integrar.

Dokument 24, una empresa danesa de documentos legales en línea, es un buen ejemplo de clasificación y priorización en la práctica. Entre el 8 de agosto y el 8 de septiembre de 2026, eesel preparó unos 680 tickets de Zendesk, etiquetó unos 430 por producto (testamento, acuerdo prenupcial, poder preventivo o constitución de empresa) y dejó unos 670 borradores de respuesta en danés como notas internas para que el equipo los enviara. Responde a partir de unas 2.600 páginas web y elementos de Zendesk. Qontro, una empresa de software ERP de Auckland, genera un borrador para cada ticket de Freshdesk, pero las interrupciones del servicio, la pérdida de datos, las migraciones y la facturación pasan directamente a una persona. Esas reglas de asignación son la parte que una prueba de rendimiento nunca evalúa, y también son lo que determina el coste real por ticket.
Antes de ponerlo en marcha, eesel prueba tu configuración con tus tickets anteriores para que puedas ver sus respuestas antes que un cliente. Escribí por separado sobre cómo funcionan esas pruebas. Y si te gusta trabajar desde una terminal como lo harías con un modelo local, la CLI de eesel permite que tú, un script o un agente de programación como Claude Code conecten integraciones, editen las instrucciones permanentes del agente, aprueben o rechacen sus acciones pendientes y lean su registro de actividad, todo en JSON.
Prueba eesel
LFM3 es un motor rápido y económico para agentes en el dispositivo y decisiones en una sola pasada, como asignar un ticket. Si lo que necesitas esta semana es tener tickets etiquetados, asignados y con borradores de respuesta en tu configuración de Zendesk AI o Freshdesk, el compañero de IA para soporte de eesel se incorpora a tu plataforma de soporte en minutos, aprende de tus tickets anteriores y tu centro de ayuda, y trabaja dentro de las reglas que establezcas. Puedes empezar gratis con 100 créditos y sin tarjeta, para probarlo con tickets reales antes de decidir. Prueba eesel.
Preguntas frecuentes
¿Qué es LFM3?
LFM3 es la tercera generación de Liquid Foundation Models de Liquid AI, lanzada el 27 de octubre de 2026. El primer lanzamiento incluye seis modelos de pesos abiertos de unos 2B de parámetros cada uno, todos basados en una misma arquitectura llamada LFM3-1.7B-Base: un modelo de texto, uno de visión, uno de audio, uno omni y dos modelos de decisión. Pertenecen al mismo grupo de modelos de lenguaje pequeños que MiniCPM5 2B y las versiones pequeñas de Gemma 4.
¿Se puede usar LFM3 gratis?
Los pesos se pueden descargar gratis desde Hugging Face bajo la LFM Open License v1.0, basada en Apache 2.0. El uso comercial solo es gratuito mientras tu grupo empresarial tenga ingresos inferiores a 10 $ millones al año; por encima de esa cifra necesitas una licencia de pago de Liquid AI. El uso para investigación y para organizaciones sin fines de lucro que cumplan los requisitos no tiene límite de ingresos. Compáralo con modelos íntegramente bajo Apache 2.0 como Nanbeige 4.3.
¿Cuánto cuesta la API de LFM3?
Liquid AI aún no ha publicado un precio por token para ningún modelo LFM3. Su página de precios solo incluye d1 (0,02 $ por millón de tokens de entrada, 0 $ de salida), d1-ultra (0,042 $ / 0 $) y LFM2.5-24B-A2B (0,05 $ / 0,70 $), y las nuevas organizaciones reciben 2 $ de crédito gratis. LFM3 tampoco está aún en OpenRouter. Para conocer el contexto de los precios de modelos alojados, consulta los precios de GPT-6 Luna.
¿Cuánta memoria necesita LFM3-1.7B?
Alrededor de 1 GB a 4 bits. El archivo GGUF Q4_0 ocupa 1.05 GB y el Q8_0, 1.85 GB. En las pruebas de Liquid AI utilizó 1.90 GB en un iPhone 17 Pro con un contexto de 32K, y un contexto completo de 128K necesita 1.6 GB de caché KV, frente a los 4.3 GB de Qwen3.5-4B. Por eso es uno de los pocos modelos pequeños que funciona en un teléfono con un contexto largo.
¿Es LFM3-1.7B mejor que Qwen3.5?
En la propia tabla de Liquid AI, LFM3-1.7B obtiene una media de 49.37 en 29 pruebas de rendimiento, frente a 47.24 de Qwen3.5-9B, un modelo unas cinco veces más grande. Gana claramente en automatización empresarial y tareas en el navegador (AutomationBench 41.29 frente a 15.10) y pierde en programación y conocimientos (GPQA Diamond 63.37 frente a 80.40). Son cifras del proveedor, no pruebas independientes. Consulta el resumen de Qwen para conocer la otra perspectiva.
¿Se puede usar LFM3 para clasificar tickets de atención al cliente?
El modelo de decisión d1-2B es el más adecuado. Su ficha de modelo muestra cómo deriva un ticket a facturación, envíos o soporte técnico, marca los reembolsos y puntúa la urgencia en una sola pasada. Aun así, tendrías que conectarlo a tu plataforma de soporte y probarlo con tus propios tickets. Si buscas opciones listas para usar, consulta las mejores IA para clasificar tickets de soporte.
¿Qué son los modelos de decisión d1 de LFM3?
d1-2B y d1-Omni-2B son modelos que no escriben texto. Les das una entrada, como un ticket, una factura, una foto o una nota de voz, junto con una lista de preguntas, y las responden todas en una sola pasada con una probabilidad para cada respuesta. d1-2B procesa texto e imágenes, y d1-Omni-2B añade audio. Lee más sobre los modelos de decisión.