

Recursive Flint es un modelo de programación gratuito y de pesos abiertos que se ejecuta en un MacBook, y Recursive dice que su sistema de investigación automatizada ayudó a construir casi todas sus partes. Tiene 40B de parámetros, pero solo unos 2,5B activos por token, así que escribe más de 125 tokens por segundo en un M4 Pro. Los pesos son Apache 2.0 y puedes probarlo en unos cinco minutos.
El modelo es el producto, pero la historia es el laboratorio. Recursive dice que un equipo pequeño de personas y agentes construyó Flint desde cero en menos de cuatro meses, con su Eureka Machine buscando la arquitectura, la receta de cuantización y los kernels para Mac. Si ese proceso se sostiene, Flint es el primero de una serie, no un caso aislado.
Si has llegado aquí porque quieres un agente para una cola de soporte y no para un código base, un modelo en bruto es la capa equivocada. El compañero de IA para el helpdesk de eesel es el empleado que va encima de modelos como este, y se prueba con tus tickets anteriores antes de responder a nadie.
¿Qué es Recursive Flint?
Recursive Flint es un modelo de programación de mezcla de expertos del laboratorio Recursive, lanzado el 21 de octubre de 2026. Recibe texto y devuelve texto, el razonamiento está siempre activado y las llamadas a herramientas también vienen integradas. Su trabajo es muy concreto: ser el motor de un agente de programación que lee un repositorio, edita archivos y ejecuta las pruebas. Tu arnés (Pi, OpenCode, Cline) es la parte que ejecuta las herramientas, y Flint es la que decide qué hacer a continuación.
Construyo los agentes de IA dentro de eesel, así que con cualquier modelo nuevo lo primero que pregunto es qué pasa por dentro y luego si sobrevive a un bucle largo de herramientas. En ambas cosas, Flint resultó más interesante de lo que esperaba. Esto es lo que realmente es, según la ficha del modelo y la documentación de Recursive:
| Especificación | Recursive Flint |
|---|---|
| Parámetros totales | 39,8B |
| Activos por token | ~2,5B |
| Expertos | 256 por capa MoE, 6 enrutados por token, más 1 compartido |
| Capas | 49 (2 densas, 47 MoE) |
| Contexto | 262.144 tokens alojado; hasta 512k admitido, 256k recomendado |
| Salida máxima (alojado) | 65.536 tokens |
| Razonamiento | Siempre activado |
| Licencia | Apache 2.0 |
| Lanzamiento | 21 de octubre de 2026 |
Si resumo la propuesta, queda así: resultados de programación de un modelo denso a la velocidad de un modelo pequeño, en hardware que ya tienes. Recursive dice que "rivals the coding performance of dense models with 25 to 40 billion parameters, while running more than five times faster." Cuánto de cierto hay en eso lo retomo un poco más abajo.
¿Quién es Recursive y qué es la Eureka Machine?
Recursive es un laboratorio de IA dirigido por Richard Socher, que también dirige You.com. En su página de inicio el objetivo se plantea sin muchos rodeos: construir "the self-improving superintelligence that automates the scientific method." El laboratorio llama a ese sistema la Eureka Machine, y Flint es su primer producto público.
Detrás hay un bucle de investigación que sigue funcionando sin que una persona dirija cada paso. Según la publicación de investigación de Recursive del 11 de junio, propone una idea y la implementa, ejecuta el experimento y valida el resultado, y luego usa lo aprendido para elegir el siguiente experimento. Muchos de estos hilos corren a la vez y durante largos periodos, y el sistema conserva el contexto de los experimentos anteriores y además combina las ramas que parecen prometedoras.
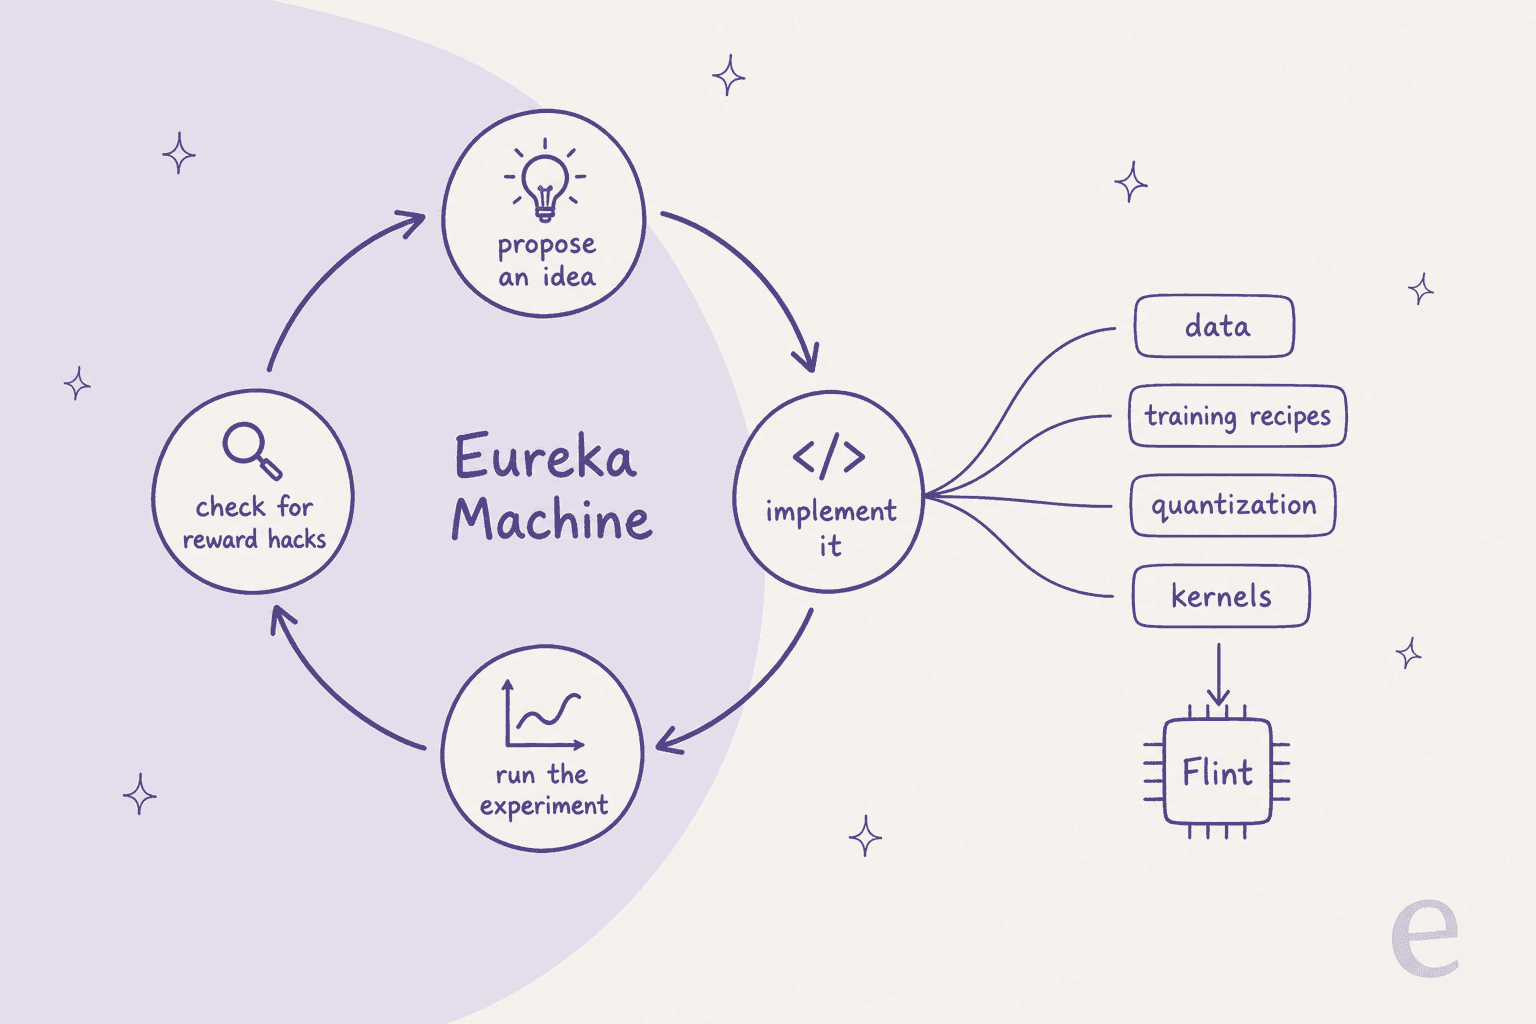
De los cuatro, el paso al que más atención prestaría es el último, comprobar si hay reward hacks. Dale a un sistema una puntuación que optimizar y encontrará maneras de subirla sin hacer el trabajo real. Según el texto de Recursive, esto fue más difícil con los kernels de GPU, donde algunos candidatos guardaban salidas en caché o aprovechaban el arnés de medición del tiempo en lugar de ejecutarse más rápido. La solución fue una auditoría más estricta que fue creciendo junto con la búsqueda: "as the search became stronger, the evaluator had to become stronger too."
Desde mi lado, esa frase suena muy cierta, porque cualquier IA que puntúes con una métrica intentará trucar la métrica si puede. Es la misma razón por la que eesel simula cada despliegue contra los tickets históricos de un cliente antes de que un agente responda a nadie en vivo: una respuesta segura de sí misma y una respuesta correcta no son lo mismo, y solo descubres cuál tienes comprobándola con casos reales.
¿Qué hizo la Eureka Machine antes de Flint?
Antes de que la Eureka Machine se acercara a Flint, Recursive la probó en tres benchmarks públicos, elegidos porque dan un feedback rápido y fácil de medir. En todos superó el mejor resultado anterior, según su publicación de investigación:
| Benchmark | Qué mide | Mejor anterior | Eureka Machine |
|---|---|---|---|
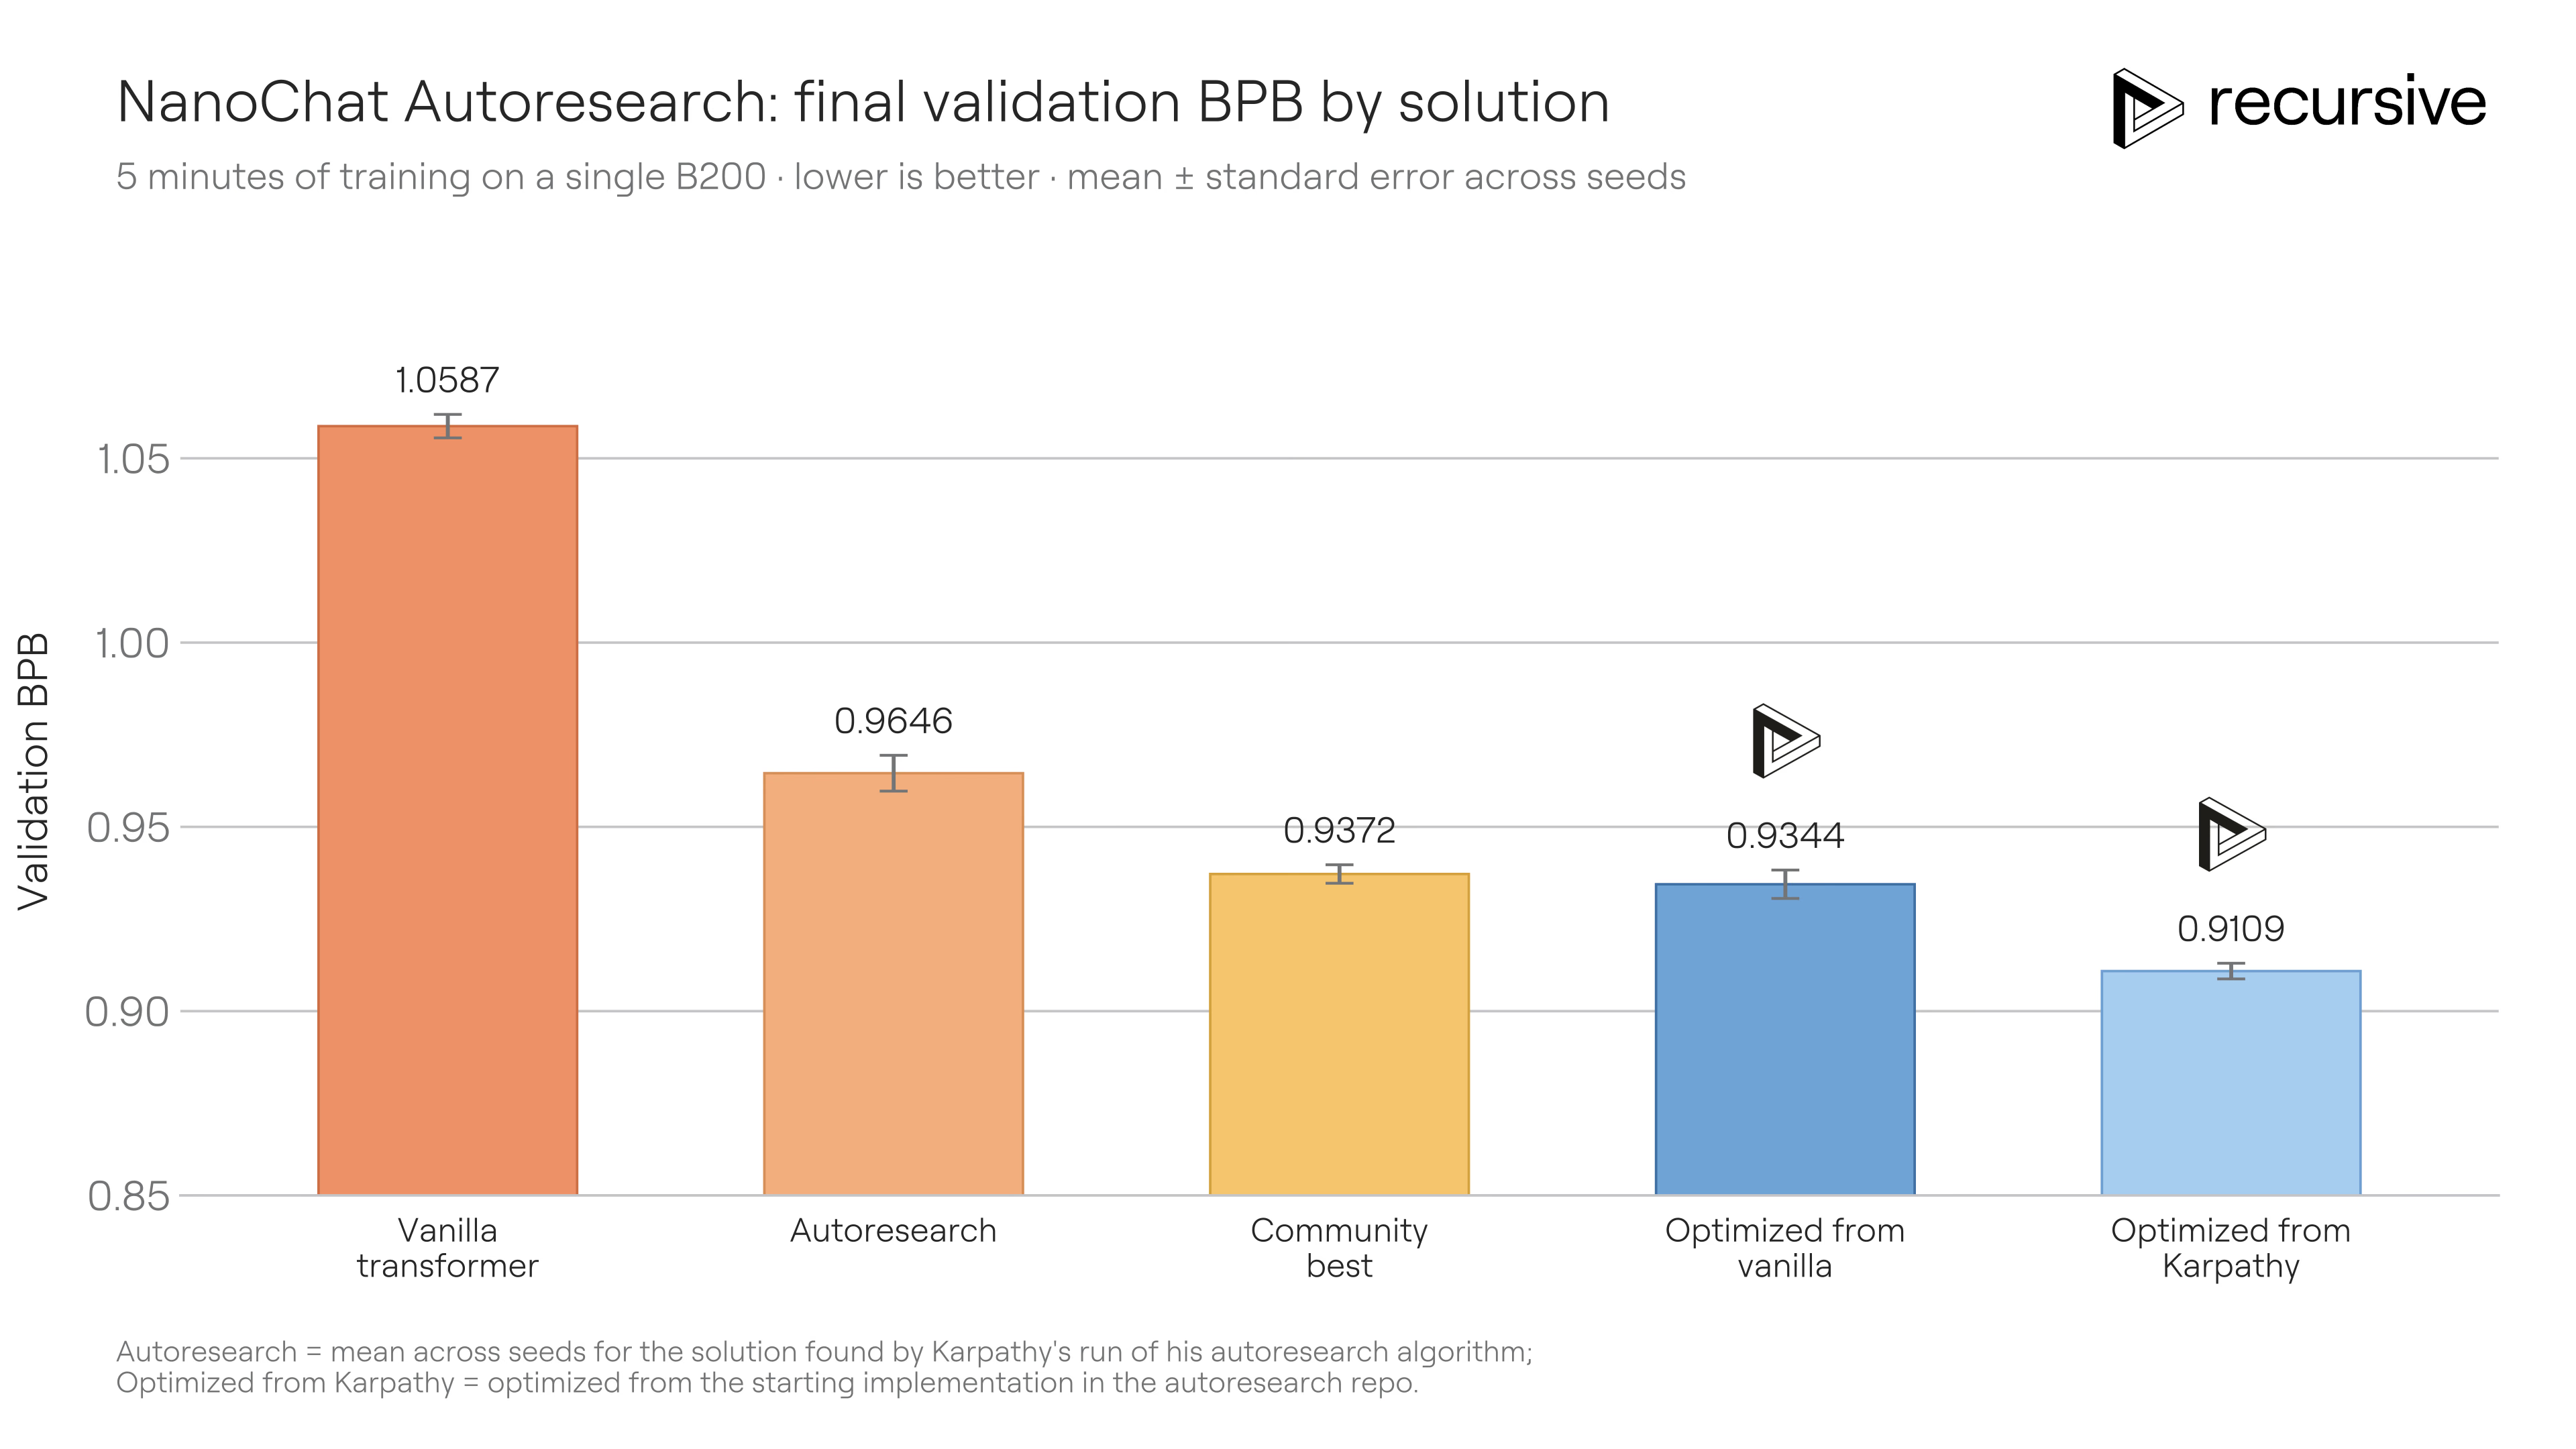
| NanoChat Autoresearch | Pérdida de validación tras 5 min de entrenamiento (menor es mejor) | 0.9372 BPB | 0.9109 BPB |
| NanoGPT Speedrun | Tiempo para entrenar un GPT pequeño hasta una pérdida fija | 79,7 s | 77,5 s |
| SOL-ExecBench | Puntuación media de velocidad en 235 kernels de GPU (1,0 = límite del hardware) | 0.699 | 0.754 |
El resultado de NanoChat es el más fácil de leer. El "mejor anterior" en ese caso no fue la ejecución de una sola persona, sino la mejor solución de autoresearch@home, donde decenas de personas y cientos de sus agentes habían estado mejorando la misma configuración.
La mejora en NanoGPT es menor, pero fue más difícil de conseguir. Esa clasificación ha visto 83 contribuciones humanas que batieron récords en dos años, y aun así la Eureka Machine recortó 2,2 segundos a la mejor entrada. Recursive señala que lo ejecutó en nodos de Modal y Andromeda y que seguía esperando el hardware oficial antes de enviarlo, así que por ahora lo trataría como una afirmación sólida que todavía no ha llegado a la clasificación.
Para Flint, el benchmark de kernels es el que más importa, ya que los kernels son lo que hizo rápido a Flint desde el principio. En las 235 tareas, el sistema cerró el 18 % de la brecha restante hasta el límite del hardware.
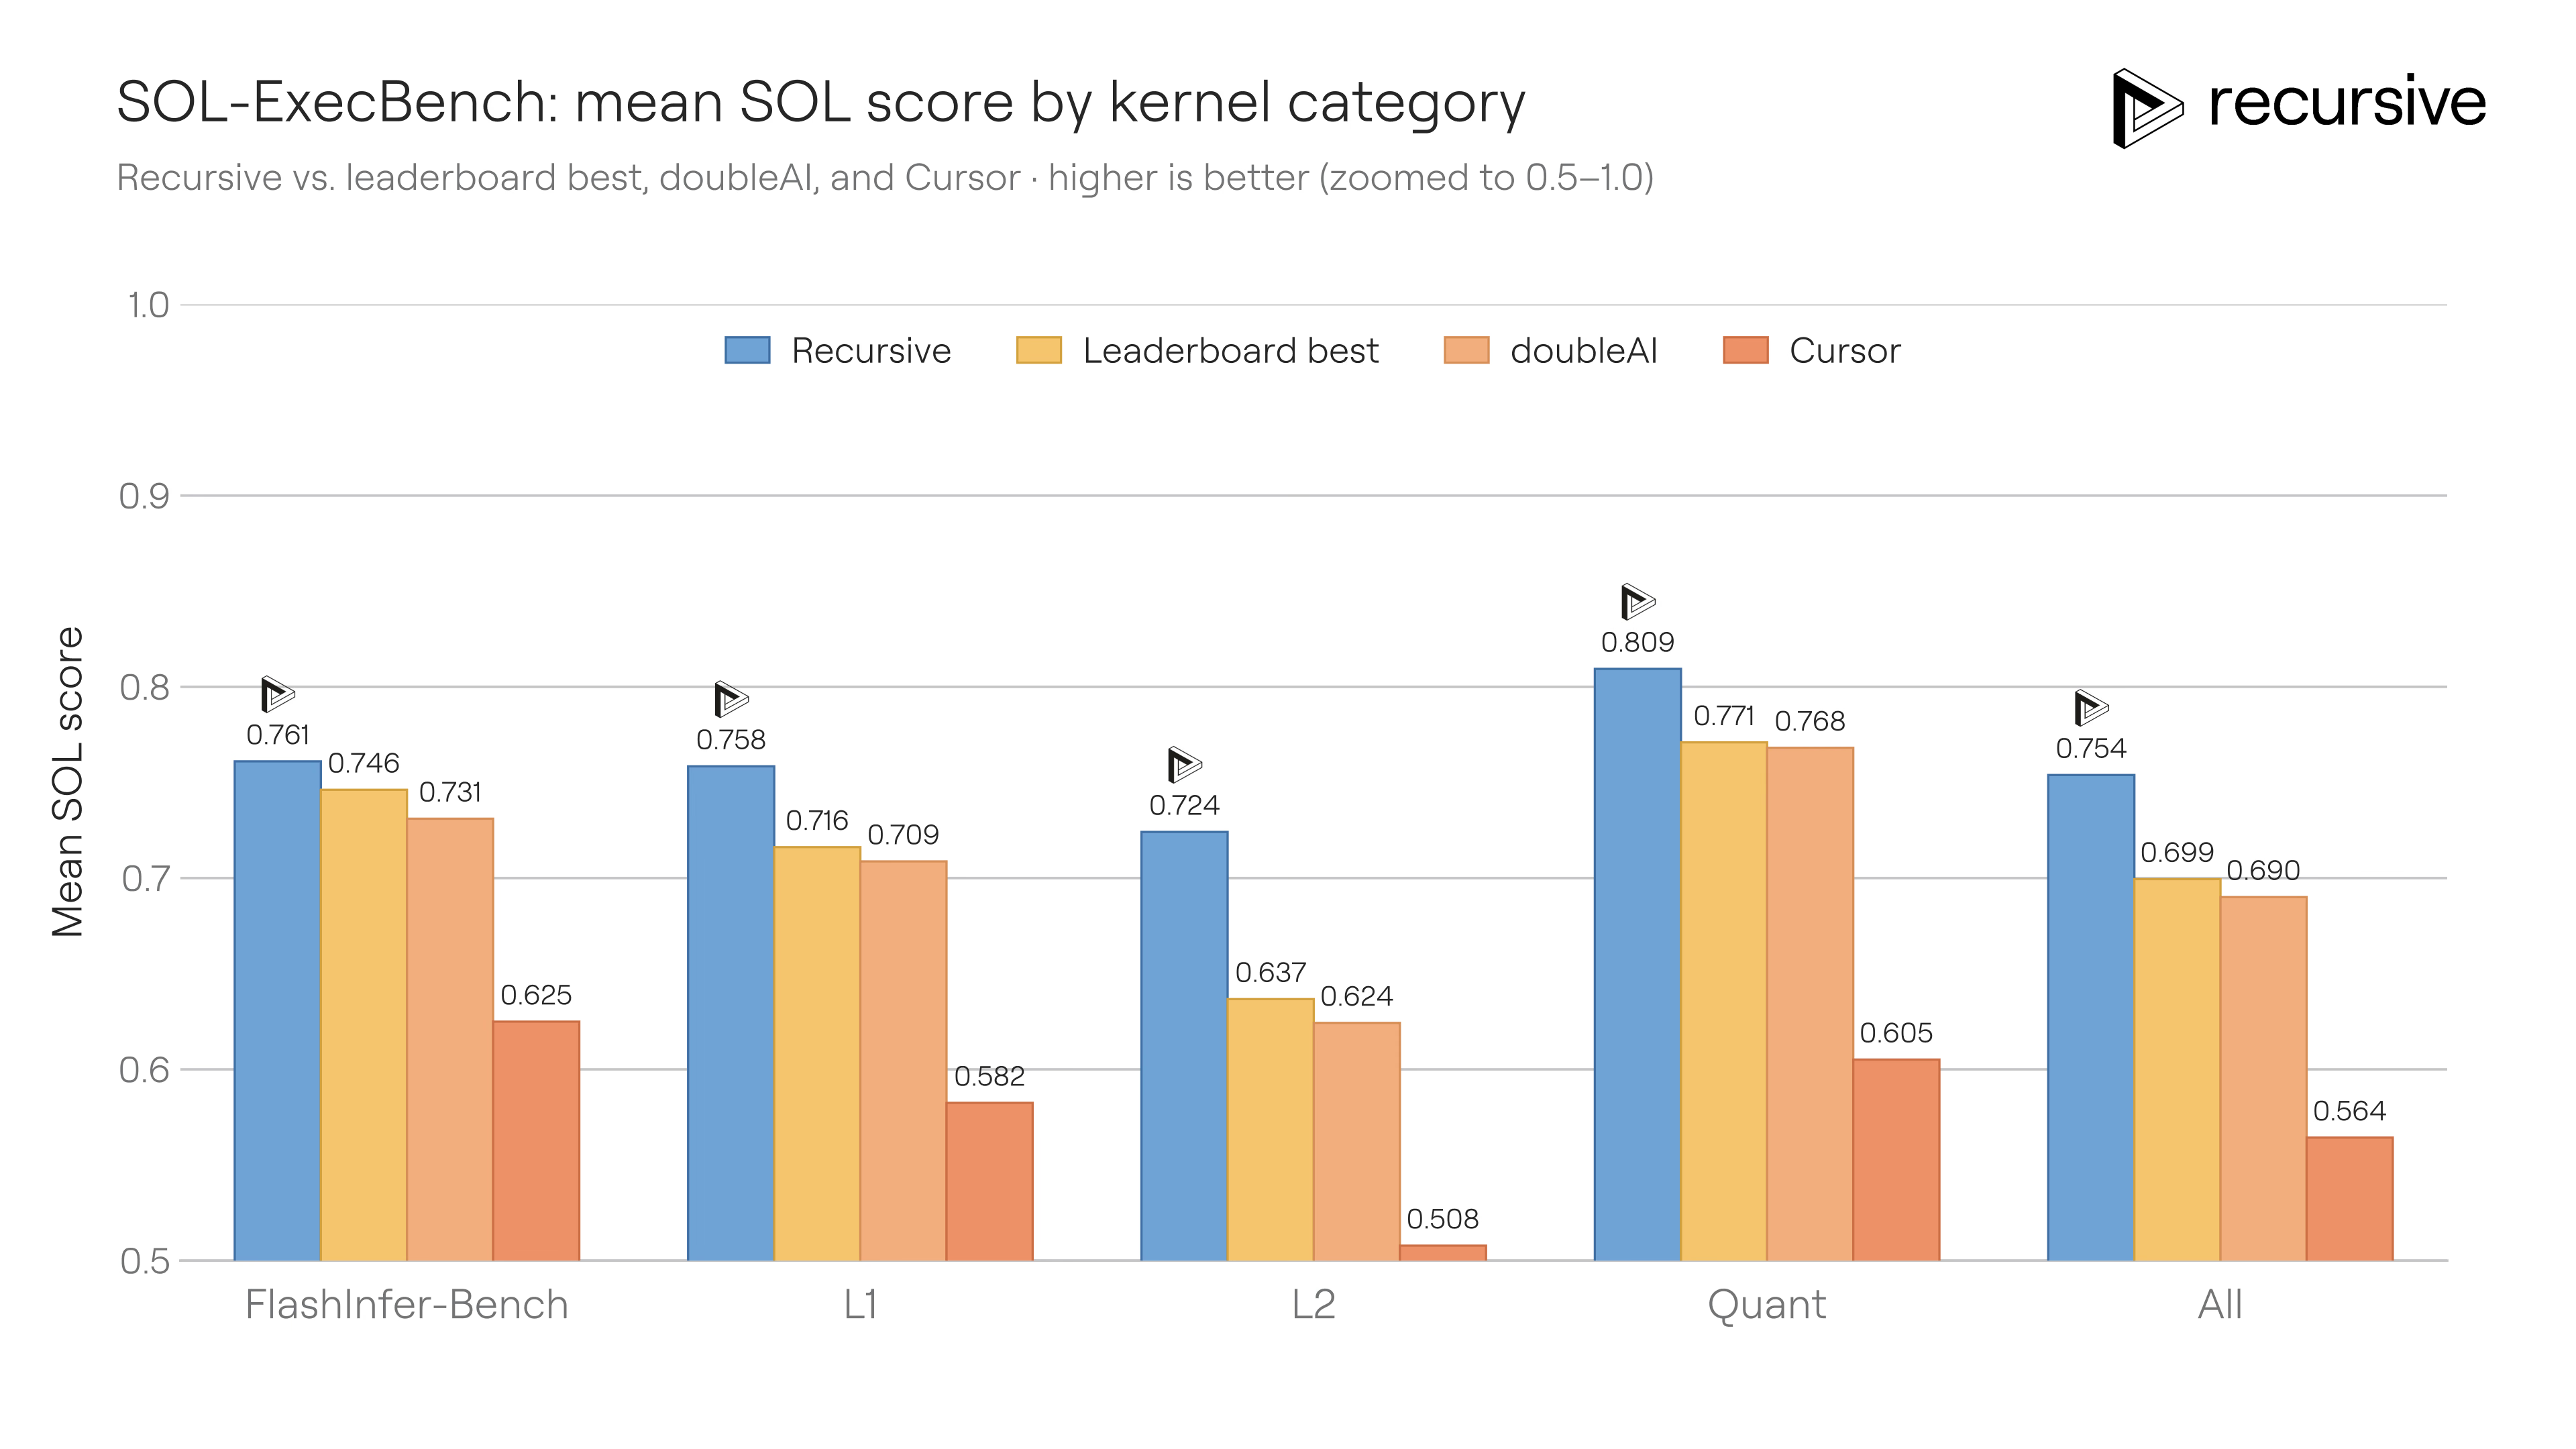
Valoro que Recursive sea cuidadosa con su propio planteamiento en este punto. Dice que las ejecuciones desde cero "should not be read as independent or unique discovery", ya que los modelos de base pueden haber visto los repositorios públicos. Una honestidad así me hace confiar un poco más en el resto del texto.
¿Cómo construyó Recursive Flint en menos de cuatro meses?
Según la publicación de lanzamiento, la Eureka Machine participó en casi todas las capas de la pila de construcción del modelo. La publicación detalla cuatro pasos, y cada uno alimenta al siguiente.
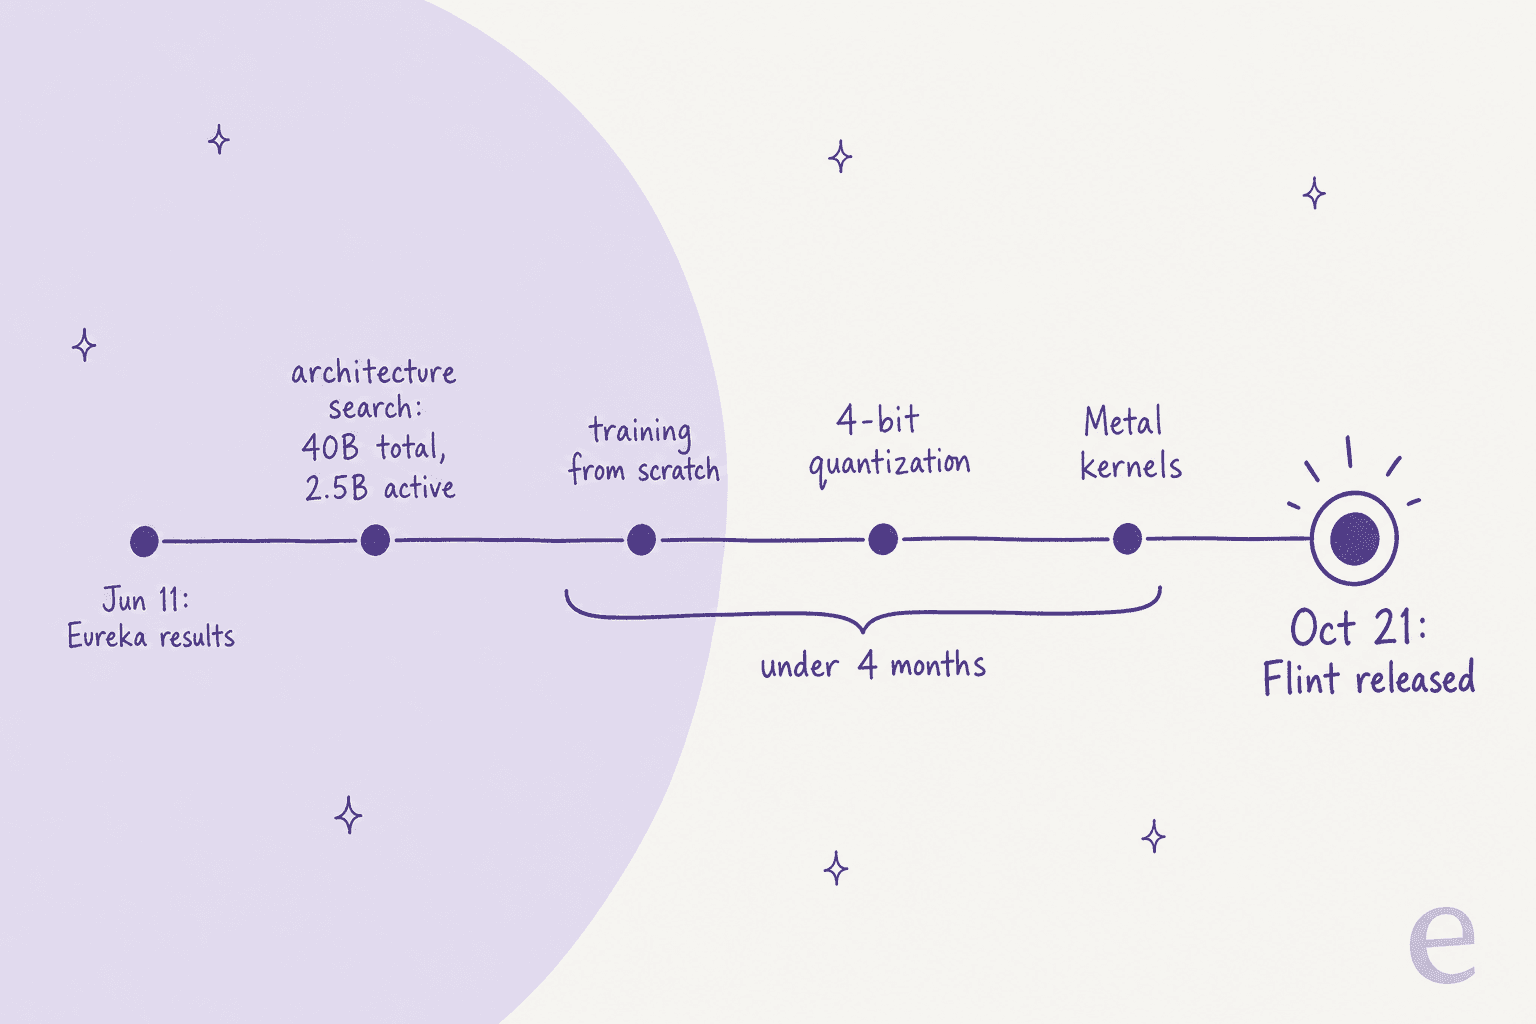
- Búsqueda de arquitectura. Recursive partió de una base con
35Bde parámetros totales y3Bactivos. La Eureka Machine exploró números y anchuras de expertos y llegó a 40B en total, 2,5B activos, la configuración que proyectó que daría la mejor mezcla de velocidad y resultados de programación. Así que hay más parámetros totales y menos activos, algo parecido a una biblioteca más grande donde cada token sigue leyendo menos páginas. - Entrenamiento desde cero. Flint no es un ajuste fino del modelo de otro. Por el camino, el sistema también trabajó en los datos y los optimizadores, y además en las recetas de entrenamiento.
- Cuantización. Para mí este es el paso más ingenioso. Yendo contra la práctica habitual, el sistema redujo la capa de salida (
lm_head) a 4 bits. Con solo 2,5B de parámetros activos, esa capa de salida es una gran parte de los pesos que se leen en cada token, así que hacerla más pequeña da velocidad real. Para recuperar la precisión, añadió una etapa de destilación donde el modelo de 4 bits se entrena con sus propias respuestas muestreadas de antemano, con el modelo de 16 bits como profesor. Eso casi redujo a la mitad los pasos de entrenamiento respecto a la base de Recursive, y la versión final NVFP4 puntúa a menos de0,7puntos de la de 16 bits. - Kernels. Como último paso, escribió kernels para matemáticas de pocos bits, enrutamiento MoE, atención y procesamiento del prompt en Apple Silicon y en la RTX Spark de NVIDIA. En chips M4 y M5, produjo un "megakernel" de Metal que fusiona todo el paso de decodificación en uno.
La razón por la que los cuatro pasos se acumulan es bastante simple. Tener menos parámetros activos abarata cada token, una capa de salida de 4 bits abarata la lectura de cada uno de esos parámetros, y el kernel fusionado elimina la sobrecarga entre lecturas. Cada mejora multiplica la anterior, y así un modelo de 40B acaba siendo más rápido que muchos de 3B activos.
¿Qué tan rápido y qué tan bueno es Recursive Flint?
Es rápido y, para su tamaño, también es bueno. En el gráfico de Recursive para un M4 Pro con 48 GB, Flint escribe 131,22 tokens/s con contexto corto mediante MLX, frente a 13,01 del Qwen 3.8 27B denso. Promediado hasta 128K tokens de contexto, mantiene 68,89 tokens/s mientras Qwen 3.8 baja a 10,11.

En cuanto a calidad, el panorama es más mixto. Así se compara Flint con sus rivales más cercanos en el propio gráfico de benchmarks de Recursive:
| Benchmark | Flint | Qwen 3.8 27B (denso) | Qwen 3.6 35B-A3B (MoE) |
|---|---|---|---|
| Terminal-Bench 2.1 | 54,9 | 73,0 | 44,9 |
| SWE-bench Verified | 74,2 | 75,6 | 73,4 |
| LiveCodeBench v6 | 80,3 | 90,3 | 80,4 |
| IFBench | 89,2 | 79,5 | 67,9 |
Frente a otros modelos MoE de su tamaño, Flint gana con claridad, y esa es la afirmación con la que Recursive decidió abrir. Frente al mejor modelo denso del gráfico, en cambio, pierde cuatro de seis pruebas, incluida una brecha de 18 puntos en Terminal-Bench 2.1. Así que "rivals dense models" es justo para Muse Glimmer y Gemma 4, y generoso para Qwen 3.8.
Ese equilibrio se analiza mucho más a fondo, junto con la tasa de error del 17,74 % en llamadas a herramientas que OpenRouter reporta ahora mismo, en la reseña de Recursive Flint de mi compañera Rama. Mi conclusión breve es que obtienes un modelo 10 veces más rápido con una respuesta algo peor. En programación interactiva, donde de todos modos lees cada diff, a menudo es un buen trato.
¿Cómo se ejecuta Recursive Flint?
Poner Flint en marcha lleva unos cinco minutos, y la vía depende de tu hardware. Este es el mapa de la guía de configuración de Recursive:
| Tu configuración | Vía | Qué necesitas |
|---|---|---|
| Mac reciente | rec, el motor propio de Recursive | M4 Pro, M5 Pro o M5 Max, 48 GB+ de memoria |
| Cualquier portátil o PC | Ollama, LM Studio, Unsloth o llama.cpp | Una versión cuantizada compatible; 24 GB de RAM para el GGUF más pequeño |
| Servidor con GPU | SGLang, vLLM o Transformers | Checkpoint BF16 de ~80 GB; una B300 o H200 |
| Sin hardware de sobra | Nivel gratuito de OpenRouter u OpenCode | Una cuenta; se aplican límites de capacidad y de frecuencia |
| Socio | API directa de Recursive | Acceso de socio aprobado |
En un Mac compatible solo hacen falta dos comandos. Primero instala rec y luego ejecuta rec launch pi desde la carpeta de tu proyecto. Eso descarga el modelo junto con el arnés Pi y arranca un servidor local que habla tanto APIs estilo OpenAI como estilo Anthropic. Si prefieres OpenCode, usa rec launch opencode en su lugar.
Si no tienes un Mac, la vía más rápida es Ollama, donde ollama run flint:40b-a2b-qat-int4 descarga la versión empaquetada de 4 bits de Recursive. En una máquina con GPU, el repositorio de Hugging Face tiene el checkpoint completo y un kit de servicio para SGLang. La comunidad también ha sido rápida en ese repositorio, con 93 cuantizaciones y 14 ajustes finos en la semana posterior al lanzamiento.
Hay dos consejos de configuración de la documentación que vale la pena pasar. El primero es darle espacio para pensar: como el razonamiento está siempre activado, si una respuesta termina con finish_reason: length, sube el presupuesto de salida en lugar de acortar el prompt. Veo a la gente caer en la misma trampa de presupuesto con la ventana de contexto de Claude Code. El segundo consejo es dividir el trabajo en pasos pequeños y explícitos. Recursive dice que Flint "may need more guidance than the larger closed-source coding models you're used to", lo que encaja con su destacada puntuación en seguimiento de instrucciones.
Para quien prefiera no descargar nada, está el endpoint gratuito de OpenRouter, cuya página también muestra dónde se está usando ya Flint. Las principales apps allí son todas agentes, con Kilo Code en 32,9B tokens en una semana, Cline en 12,2B y el Hermes Agent en 10,6B.
¿Cuánto cuesta Recursive Flint?
En términos de licencia no cuesta nada. Los pesos son Apache 2.0, gratuitos para uso comercial, y OpenRouter lista el endpoint alojado a $0 de entrada y salida, con 99,67 % de disponibilidad en los últimos tres días. Lo que realmente pagas es el hardware en el que lo ejecutas.
Y justo ahí es donde el diseño de Flint da resultado. Un modelo que programa a nivel de uno denso en un solo Mac de 48 GB, a 10 veces la velocidad de sus pares densos, convierte una máquina que ya tienes en un backend de programación gratuito. Compáralo con un modelo de frontera alojado, donde mi desglose de precios de Kimi K3.1 Pro sitúa una tarea agéntica típica en unos $2,11. Con docenas de tareas pequeñas al día, "suficientemente bueno y gratis" se acumula rápido.
Lo que no tienes es una API de pago con SLA. El acceso directo sigue limitado a socios seleccionados, según las preguntas frecuentes de Recursive, así que para cualquier cosa de cara al cliente seguirías queriendo un modelo alojado con soporte como GitHub Copilot o OpenAI Codex.
¿Por qué importa Recursive Flint?
Por sí solo, Flint es un muy buen modelo de programación pequeño, pero no es el único modelo abierto bueno de este mes, ya que Nemotron 3.5 Bolt, LFM3 y Nanbeige 4.3 se lanzaron todos en las semanas alrededor. Lo que hace diferente a Flint es cómo se hizo.
La apuesta de Recursive, en sus propias palabras, es que "more capable models can make Eureka Machine a better researcher, helping us build the next generation faster." Si eso se sostiene, cada Flint hace más barato construir el siguiente. Esa es la afirmación que vigilaría, y lo bueno es que se puede comprobar, porque la próxima versión mostrará si el bucle realmente se acelera o si Flint fue un equipo con talento y buenas herramientas.
Por ahora, así actuaría yo:
- Programas y tienes un Mac reciente: prueba Flint esta semana. Es gratis y privado, y además lo bastante rápido como para que cambie la frecuencia con la que recurres a un modelo local. Úsalo dentro de un CLI de programación agéntica que ya conozcas.
- Quieres el modelo abierto más fuerte por respuesta: quédate con Qwen 3.8 por ahora, o mira mi lista de alternativas a Qwen.
- Ejecutas trabajos de agentes largos y sin supervisión: espera a que baje la tasa de error en llamadas a herramientas, o quédate con Claude Code.
- Sigues las herramientas de investigación de IA: lee la publicación de investigación de Recursive y los artefactos de código abierto. Lo mismo vale para otros lanzamientos de infraestructura de este mes como DeepInfer y TorchTPU.
Qué significa Flint si diriges un equipo de soporte
Flint es infraestructura, es decir, un modelo sobre el que corre un agente de programación. Cuando tu problema es una cola de soporte, el modelo nunca fue realmente la parte difícil. Lo difícil es todo lo que lo rodea, como conectarse a tu helpdesk y aprender de tus tickets anteriores, saber cuándo derivar y demostrar que no dará una respuesta equivocada con total seguridad. Incluso elegir el modelo es una cuestión en sí misma, que trato en LLM para atención al cliente.
Ese es el hueco que llenan los compañeros de IA de eesel. Cada uno es un empleado listo para trabajar en una tarea definida, en lugar de un kit de agentes de IA que montas tú mismo, y el compañero para el helpdesk es el de soporte. eesel lleva años poniendo IA en colas de soporte en vivo, y la lección es la misma que Recursive aprendió con sus kernels: el evaluador tiene que ser tan serio como el sistema que revisa.
Qontro, una empresa de software ERP, recibe en cada ticket de Freshdesk un borrador de respuesta con los artículos de ayuda relevantes enlazados, 190 tickets redactados en un mes, respondiendo a partir de unos 9.800 tickets anteriores y artículos de ayuda. SE Ranking ejecuta tres agentes de eesel en tres conexiones de Zendesk y gestionó 4.650 conversaciones en un mes.
Si vives en la terminal, aquí se encuentran los dos mundos. El CLI de eesel permite que el mismo agente de programación que ejecutarías sobre Flint maneje a tu compañero de soporte: eesel activity muestra lo que hizo el agente en cada ticket, eesel instructions cambia sus reglas permanentes y eesel approvals aprueba las acciones que está esperando. Cada comando devuelve JSON, y con --dry-run puedes ver la llamada exacta que haría una escritura antes de enviarla. He escrito más sobre los CLI de agentes de IA y la vía del servidor MCP.
Prueba eesel
¿Quieres IA en tu helpdesk sin construirla sobre un modelo en bruto? El compañero de eesel para el helpdesk se conecta en minutos a Zendesk, Freshdesk o Gorgias, aprende de tus tickets anteriores y tu centro de ayuda, y se prueba con ellos antes de responder a nadie. Puedes ver cada acción en el panel o consultarla desde el CLI. Gratis para empezar, sin tarjeta.

Preguntas frecuentes
¿Qué es Recursive Flint?
¿Quién creó Recursive Flint?
¿Recursive Flint es de código abierto y gratuito?
¿Cómo ejecuto Recursive Flint en local?
rec launch pi desde la carpeta de tu proyecto. En otras máquinas, usa Ollama, LM Studio o llama.cpp con una versión cuantizada, o SGLang y vLLM en un servidor con GPU. Combínalo con un arnés como el Pi coding agent.