

En resumen
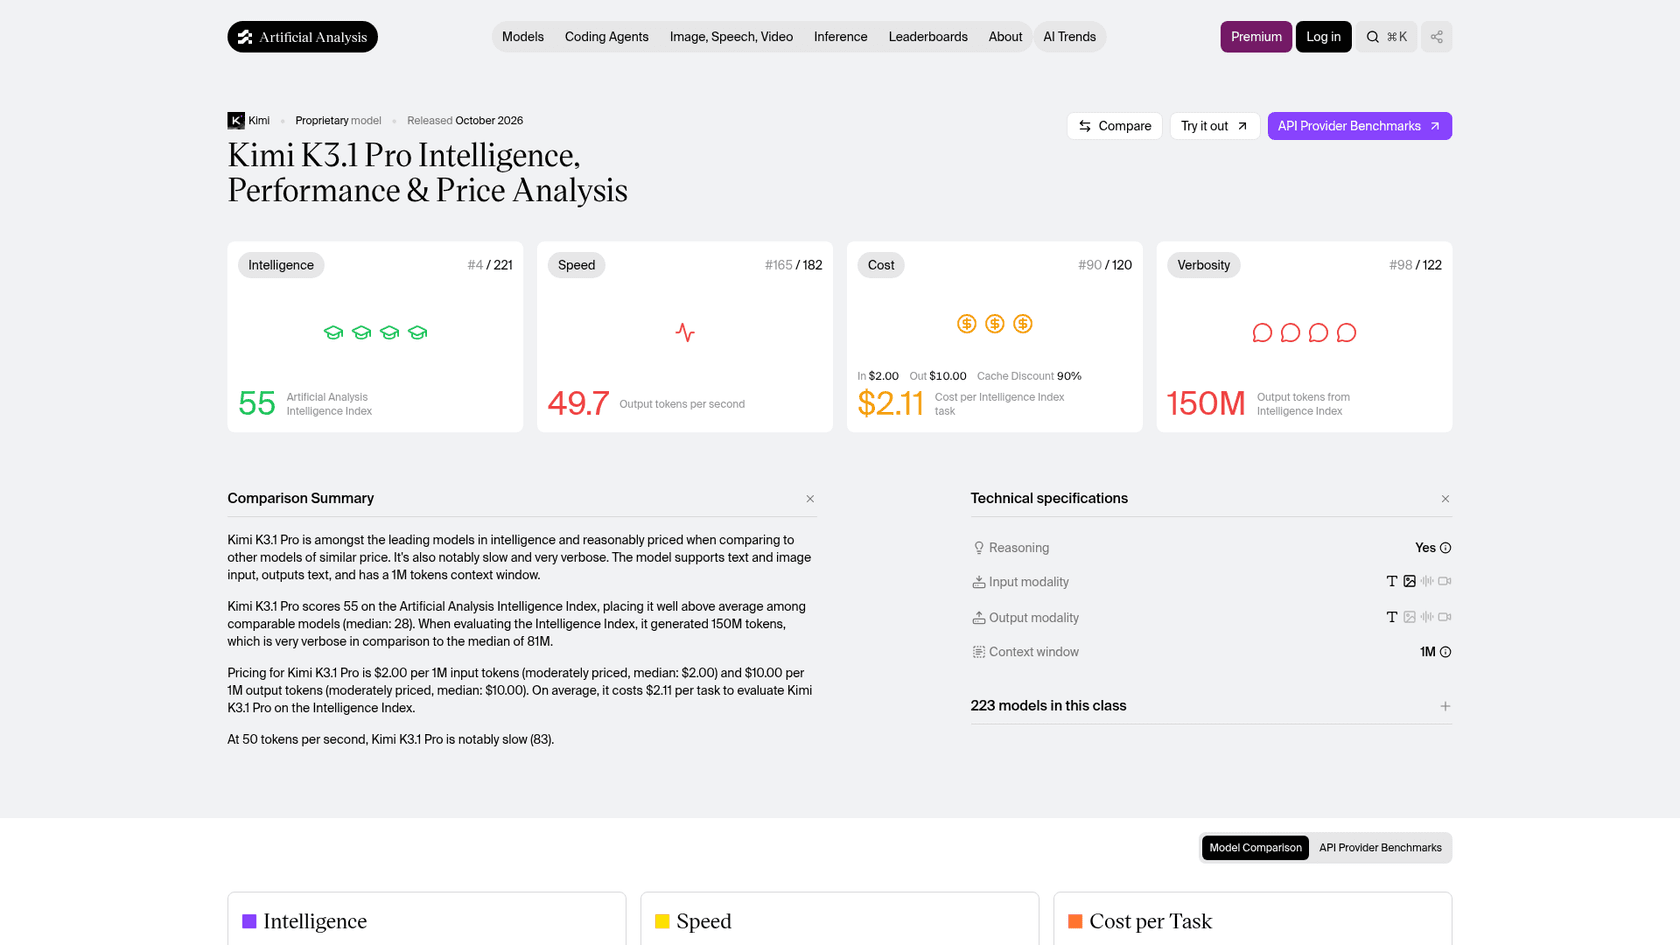
Kimi K3.1 Pro es el modelo de pesos abiertos más potente anunciado hasta ahora, con una puntuación de 55 en el Artificial Analysis Intelligence Index, 2.5 puntos por detrás de Claude Opus 5.5, a 2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida. Moonshot lo lanzó el 23 de octubre de 2026 como una versión de Kimi K3 con un postentrenamiento intensivo, y el salto es real: Terminal-Bench 4.0 pasó de 12.6% a 67.2% en Artificial Analysis.
El problema es todo lo que rodea a esas puntuaciones. Funciona a unos 50 tokens por segundo, casi al final de su categoría. Los pesos están prometidos "by Nov 4", así que hoy solo está disponible mediante API. Y los primeros suscriptores de Kimi Code afirman que agotan un límite de 5 horas en menos de una hora. La reducción de precio es por token, no por respuesta: escribe mucho, por lo que ejecutar el índice completo de pruebas cuesta $3,117, frente a $3,658 con K3, un ahorro del 15 %, no del 33 %.
Si estás eligiendo un modelo para un agente de soporte con IA, el modelo es la parte menor del trabajo. Llevo años en eesel incorporando IA a colas de soporte en producción, y lo difícil nunca es el motor. Es la conexión con la plataforma de soporte, las reglas de derivación y las pruebas con tickets reales anteriores. SE Ranking utiliza esa capa en tres productos en Zendesk, con unas 4,650 conversaciones al mes.
¿Qué es Kimi K3.1 Pro?
Kimi K3.1 Pro es el nuevo modelo insignia de Moonshot AI, y también es el primer lanzamiento de su serie K3.1. Moonshot lo describe como "our most capable 3T-class open-weight model to date", con una ventana de contexto de 1 millón de tokens. Por dentro, es un modelo de mezcla de expertos, con 2.8T parámetros totales y 104B activos, según la publicación de lanzamiento en X.
Viene en dos variantes: Kimi K3.1 Pro es la estándar, y Kimi K3.1 Pro Highspeed es el mismo modelo, pero se sirve "2-3× faster" al doble de precio. Ambos se pusieron en marcha el mismo día, en kimi.ai, las aplicaciones de Kimi, Kimi Work, Kimi Code y la API de Kimi.
Moonshot destaca cuatro áreas en las que ha mejorado: programación, creación 3D, investigación financiera y trabajo de agentes de larga duración. Si has seguido el lanzamiento de Kimi K3 en julio, la versión corta es esta: en tareas de agentes, K3.1 Pro es el modelo que K3 debía haber sido.
¿Qué cambió respecto a Kimi K3?
Para que quede claro, Kimi K3.1 Pro no es un nuevo modelo base. Moonshot lo describe como "a post-trained version of Kimi K3, with substantially larger post-training compute", que utiliza aprendizaje por refuerzo en "hundreds of downstream domains". Así que los 2.8T pesos son los mismos; lo que cambió es cuánto entrenamiento se dedicó a utilizarlos.
Sobre el papel parece una mejora incremental, pero las cifras cuentan otra historia. En la página de K3.1 Pro de Artificial Analysis, medido con la misma versión del índice que Kimi K3:
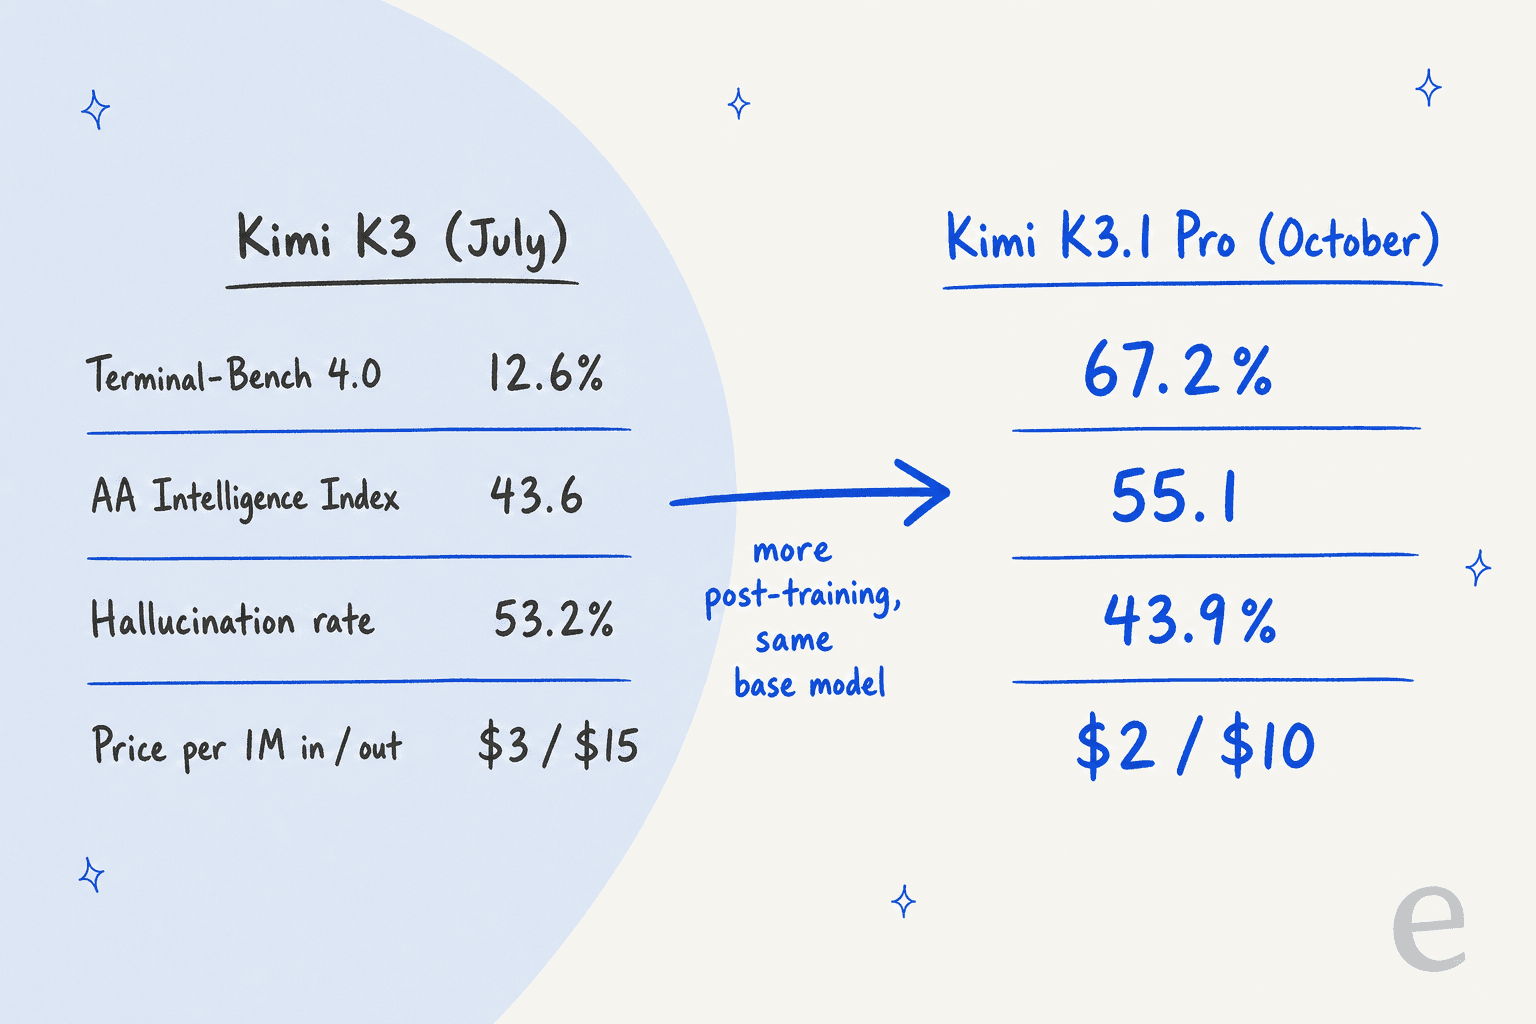
| Kimi K3 (Max) | Kimi K3.1 Pro | |
|---|---|---|
| Lanzamiento | 16 de julio de 2026 | 23 de octubre de 2026 |
| Intelligence Index (v4.3.2) | 43.6 | 55.1 |
| Terminal-Bench 4.0 | 12.6% | 67.2% |
| Tasa de alucinaciones (AA-Omniscience) | 53.2% | 43.9% |
| GDPval-AA (Elo) | 1,534 | 1,846 |
| Precio de la API por 1M (entrada / salida) | $3 / $15 | $2 / $10 |
| Velocidad de salida | 54.5 tokens/s | 49.7 tokens/s |
| Pesos | Abiertos | Previstos a más tardar el 4 de noviembre |
El salto de 12,6 % a 67,2 % en Terminal-Bench es la noticia principal. Esa prueba comprueba si un modelo puede completar de verdad trabajos de varios pasos dentro de una terminal, y eso es lo que hacen los agentes de programación todo el día. K3 era un modelo inteligente al que le costaba llevar esa inteligencia a la acción, mientras que K3.1 Pro sí lo hace.
Hay una trampa que conviene tener en cuenta si comparas con artículos anteriores: K3 obtuvo 57 en Artificial Analysis en agosto, pero desde entonces se ha cambiado la escala del índice. En la versión actual, K3 está en 43.6, así que K3.1 Pro supone un salto de 11.5 puntos, no una caída de 2 puntos. En su momento hice la misma comparación en mi reseña de Kimi K3, así que considera que aquellas cifras anteriores están en una escala distinta.
Moonshot también hizo algo un poco inusual: eliminó deliberadamente datos de entrenamiento relacionados con ciberseguridad de la versión de pesos abiertos. En su propia prueba interna de explotación de vulnerabilidades, el modelo final obtiene 81.0, frente a 90.5 del mismo modelo entrenado sin ese recorte. La regla que establece Moonshot es no "release open weights that would extend the absolute frontier of cyber capability."
¿Qué tan bueno es Kimi K3.1 Pro en las pruebas de rendimiento?
En el gráfico de 14 evaluaciones de la propia Moonshot, Kimi K3.1 Pro queda primero en 6 y segundo en 5, frente a Claude Opus 5.5, GPT-6 Astra, Claude Fable 5.1, DeepSeek V4.1 Flash y GLM-5.3. Todos los modelos se ejecutaron con el máximo esfuerzo de razonamiento.
Estos son los resultados destacados, tomados directamente del blog de lanzamiento de Moonshot:
| Prueba | Kimi K3.1 Pro | Opus 5.5 | GPT-6 Astra | Fable 5.1 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 66.4 | 58.2 | 57.9 |
| SWE Marathon | 51.7 | 46.3 | 42.5 | 45.6 |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | 54.5 |
| Humanity's Last Exam (con herramientas) | 70.0 | 67.7 | 57.2 | 65.6 |
| OSWorld V2.1 | 79.6 | 81.8 | 75.8 | 80.7 |
| GDPval-AA v2.1 (Elo) | 1846 | 1866 | 1573 | 1754 |
| BenchCAD (con herramientas) | 92.7 | 96.2 | 95.9 | 92.6 |
| Terminal-Bench-Science 0.1 | 38.1 | 63.3 | 68.1 | 40.0 |
Hay dos cosas que conviene saber antes de citar cualquiera de estos resultados.
Primero, las pruebas de programación se ejecutaron dentro del entorno de ejecución de Claude Code y no en el de Moonshot. Es una elección razonable, ya que la mayoría de los desarrolladores utiliza ese entorno, pero significa que los resultados muestran cómo rinde Kimi cuando se maneja como Claude. Una publicación de Lisan al Gaib planteó exactamente esta cuestión el día del lanzamiento.
Segundo, las cifras de terceros y las del proveedor no coinciden exactamente. Artificial Analysis sitúa a K3.1 Pro en 67.2% en Terminal-Bench 4.0 y a Opus 5.5 (Max) en 59.6%, una victoria mucho más amplia que el 65.7 frente a 66.4 de la propia Moonshot. Varios de los otros resultados destacados (Kimi Code Bench, las pruebas financieras, Kimi Hallu Bench) son pruebas internas de la propia Moonshot. La cifra en la que yo me apoyaría es la del índice independiente: 55.1, cuarto de 215 modelos.
Programación y agentes de larga duración
Para programación, la propuesta se centra en proyectos completos y no solo en parches. Según Moonshot, K3.1 Pro puede crear juegos en Unity, Unreal Engine y Godot, y la demostración que eligió es una ejecución prolongada en el proyecto de código abierto human-atlas: 167 misiones y 420 revisiones independientes para crear un simulador de marcha para un modelo corporal con 296 componentes esqueléticos y 402 musculares. Al final, el humano simulado pasó de desplomarse en segundos a caminar durante 11.2 segundos.
En SWE Marathon, una prueba de programación de larga duración, obtiene 51.7 frente al 46.3 de Opus 5.5. Si tuviera que fijarme en un solo resultado, sería este, porque en las tareas largas la diferencia de precio con Claude sigue acumulándose.
Modelado y diseño 3D
Esta parte es lo más distintivo del lanzamiento. K3.1 Pro escribe scripts para Blender y software CAD y los ejecuta directamente, "without MCP connectors", y Moonshot creó una función para consumidores en torno a ello, llamada 3D Make.
En BenchCAD con herramientas obtiene 92.7, por detrás de Opus 5.5 (96.2) y GPT-6 Astra (95.9). Sin herramientas, está casi exactamente empatado con Opus: 72.8 frente a 73.0. Moonshot dice que donde más destaca es en el trabajo paramétrico, es decir, piezas mecánicas y modelos arquitectónicos, además de productos y muebles configurables.
Trabajo financiero y precisión factual
La afirmación de Moonshot sobre finanzas es "hallucination down by 65%". Eso coincide aproximadamente con su prueba interna Kimi Hallu Bench, en la que la proporción de afirmaciones falsas en una prueba difícil con herramientas cayó de 23.4% (K3) a 8.3%.
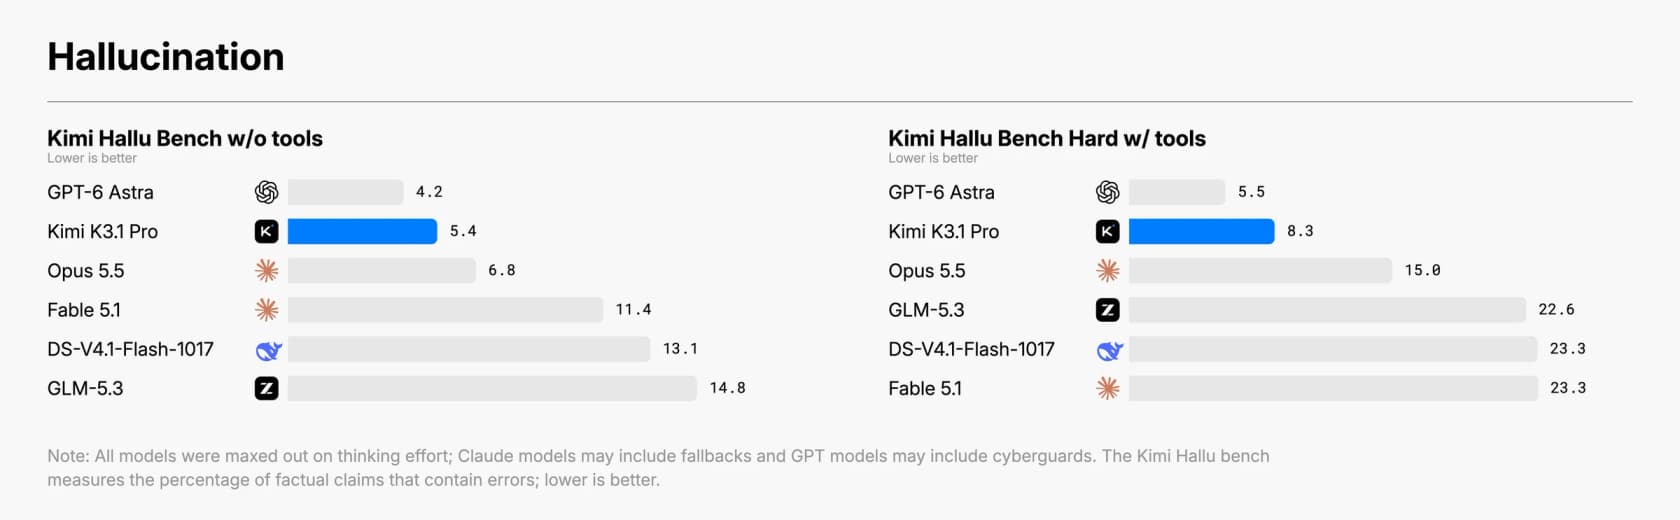
Hay que reconocerle a Moonshot que también añade que estas tasas "do not represent overall error rates in daily use." En la prueba independiente AA-Omniscience, la tasa de alucinaciones de K3.1 Pro es de 43.9%. Es mejor que la de Opus 5.5 Max (58.6%), pero está muy por detrás de Gemini 4 Argon (15.1%). Si un número incorrecto en una hoja de cálculo te va a costar dinero, sigue siendo necesario revisar su trabajo.
¿Cuánto cuesta Kimi K3.1 Pro?
Kimi K3.1 Pro cuesta 2 $ por millón de tokens de entrada, 0,20 $ por millón de tokens de entrada en caché y 10 $ por millón de tokens de salida en la API de Kimi, y Highspeed duplica esas tarifas. Los precios se mantienen constantes en todo el contexto de 1M, con "no tiering by context length", según la guía de inicio rápido de K3.1 Pro.
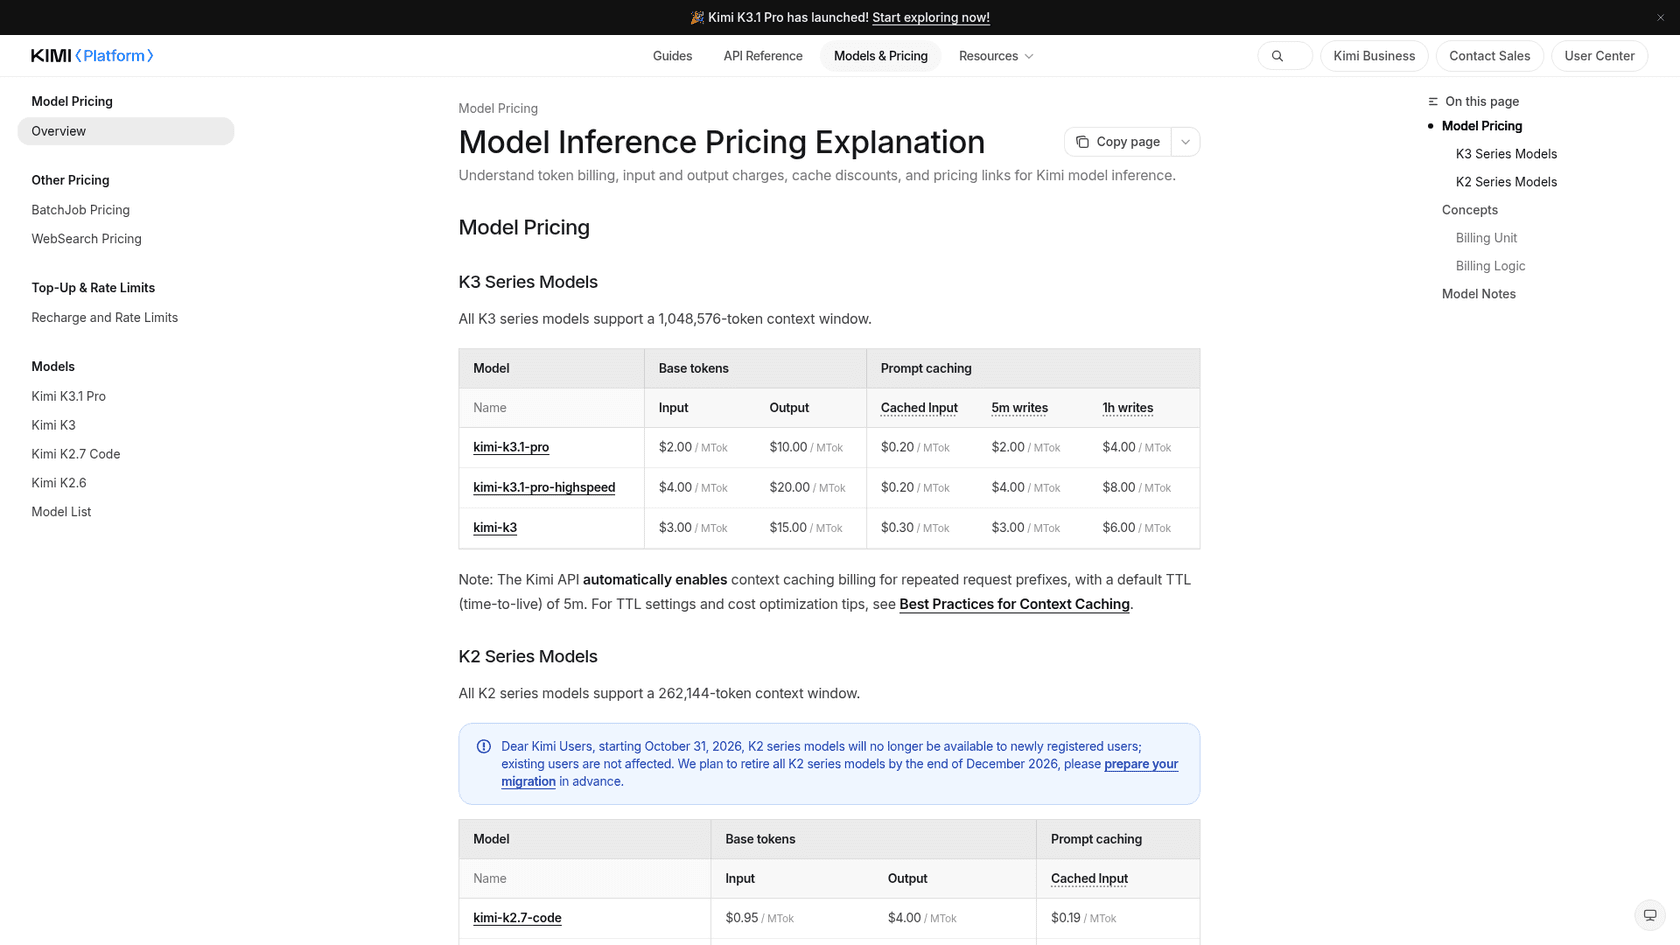
Según la página de precios de Kimi, por millón de tokens:
| ID del modelo | Entrada | Entrada en caché | Salida | Escritura en caché (5 min) | Escritura en caché (1 hora) |
|---|---|---|---|---|---|
kimi-k3.1-pro | $2.00 | $0.20 | $10.00 | $2.00 | $4.00 |
kimi-k3.1-pro-highspeed | $4.00 | $0.20 | $20.00 | $4.00 | $8.00 |
kimi-k3 | $3.00 | $0.30 | $15.00 | $3.00 | $6.00 |
Algunos detalles de facturación que cambian lo que realmente pagas:
- El almacenamiento en caché es automático para los prefijos de instrucciones repetidos, con una ventana predeterminada de 5 minutos. Los aciertos de caché cuestan un 90 % menos. Cuando tu agente reutiliza unas instrucciones de sistema largas, esto acaba importando más que la tarifa anunciada.
- Necesitas una recarga de 1 $ para desbloquear K3.1 Pro, y el total de tus recargas determina tu nivel de límite de solicitudes.
- Todavía no hay descuento por procesamiento por lotes. La tarifa por lotes del 60 % solo cubre los modelos K2 anteriores, que dejan de admitir nuevos usuarios el 31 de octubre de 2026.
- K3 sigue costando 3 $ / 15 $, así que para nuevos trabajos no hay muchos motivos para seguir usándolo.
En los precios de lista que registra Artificial Analysis, coincide exactamente con los precios de Claude Sonnet 5.5, los precios de Gemini 4 Argon y GPT-6.1 Sol. Es la mitad de los precios de Claude Opus 5.5, de 4 $ / 20 $.
Planes de la aplicación Kimi y Kimi Code
Si prefieres pagar una suscripción en lugar de por token, K3.1 Pro está incluido en los planes de suscripción de Kimi. Los precios que aparecen a continuación proceden de la página de Kimi Code:
| Plan | Mensual | Facturación anual (por mes) | Acceso a K3.1 Pro |
|---|---|---|---|
| Plus | $19 | $15 | Estándar |
| Pro | $39 | $31 | Estándar y Highspeed |
| Max | $99 | $79 | Estándar y Highspeed |
| Ultra | $199 | $159 | Estándar y Highspeed |
Highspeed consume créditos a un ritmo 2x mayor. Kimi cambió recientemente el nombre de los planes "with pricing unchanged", y Kimi Code sigue compartiendo una cuota con el resto de la suscripción. Con los nuevos planes desapareció el límite semanal de Kimi Code, pero se mantuvo el de la ventana móvil de 5 horas, y ese límite es la queja más sonada hasta ahora (más sobre ello a continuación).
Más barato por token, no siempre por tarea
Esta es la parte que omite la mayoría de la cobertura del lanzamiento. Por token, K3.1 Pro es un tercio más barato que K3, pero piensa mucho y escribe mucho. Artificial Analysis lo califica como "very verbose": utilizó unos 150M tokens de salida para ejecutar el índice, frente a una mediana de 87M para modelos similares.
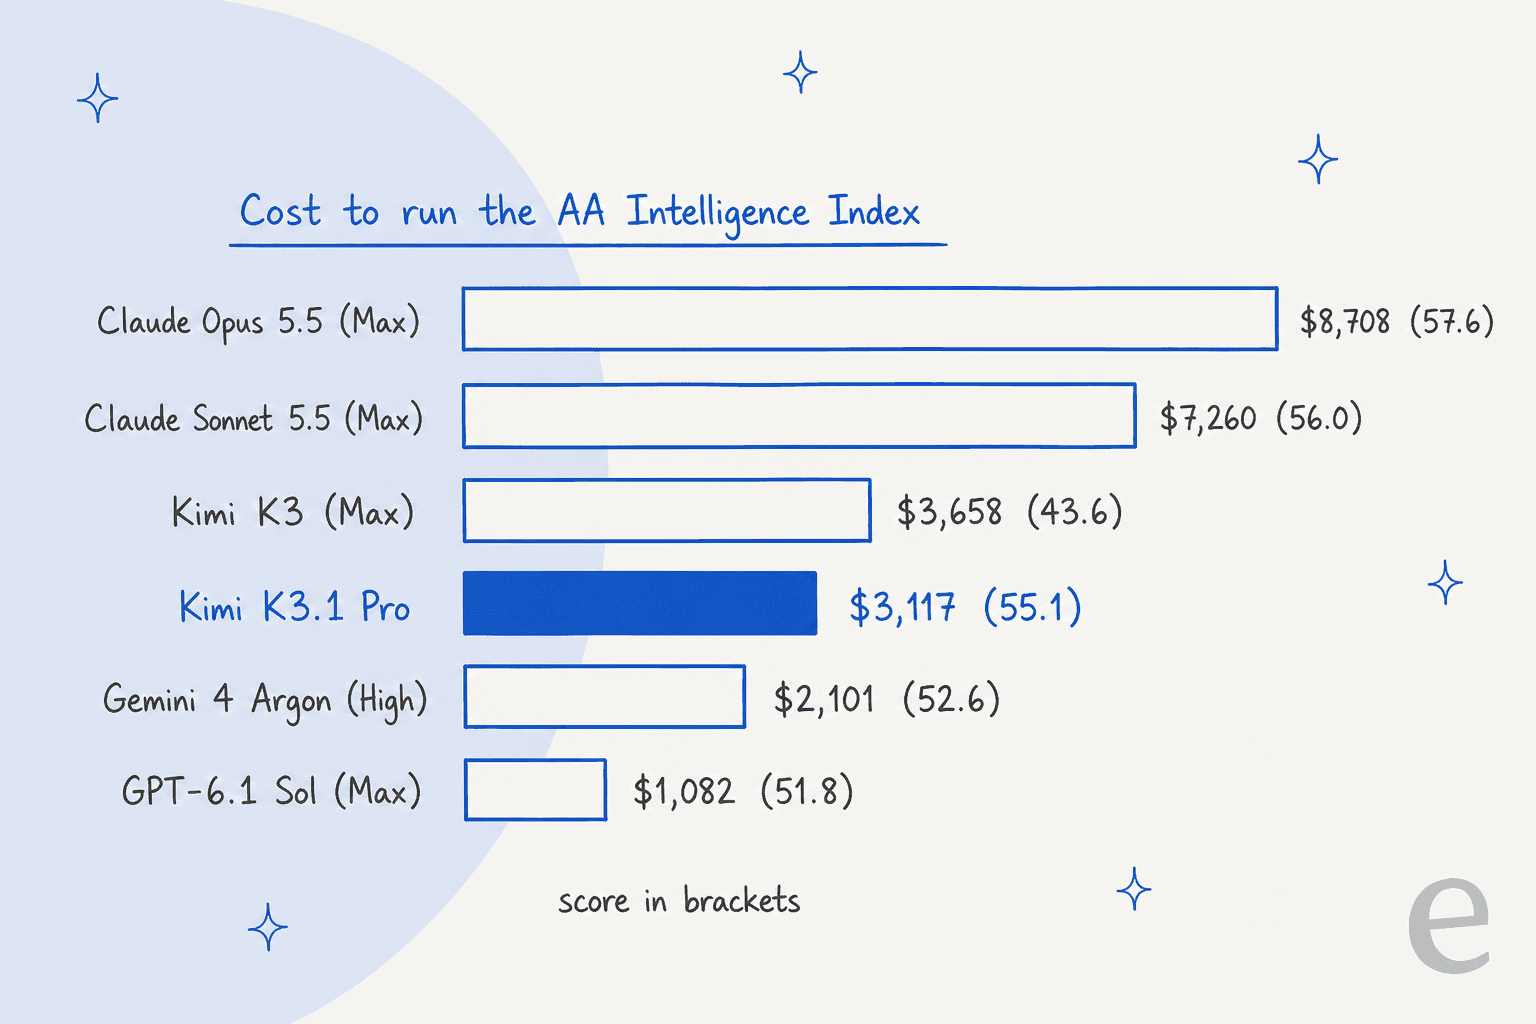
Así que la forma más honesta de comparar es el costo por trabajo:
- Frente a Claude, es una verdadera ganga. Se queda a 2.5 puntos de Opus 5.5 (Max) por el
36%del costo de ejecutar el índice, y cuesta bastante menos de la mitad que Sonnet 5.5 (Max), que consumió416Mtokens. - Frente a K3, el ahorro es menor de lo que parece.
$3,117frente a$3,658es aproximadamente un 15 % más barato, y a cambio obtienes un modelo mucho mejor. - Frente a las opciones económicas, no es la ganga. GPT-6.1 Sol (Max) ejecutó el índice por
$1,082y Gemini 4 Argon (High) por$2,101, con puntuaciones 3.3 y 2.5 puntos inferiores.
El gráfico de la propia Moonshot hace la comparación con Claude en Terminal-Bench, donde K3.1 Pro con esfuerzo máximo cuesta alrededor de 5 $ por tarea, frente a unos 14 $ de Opus 5.5:
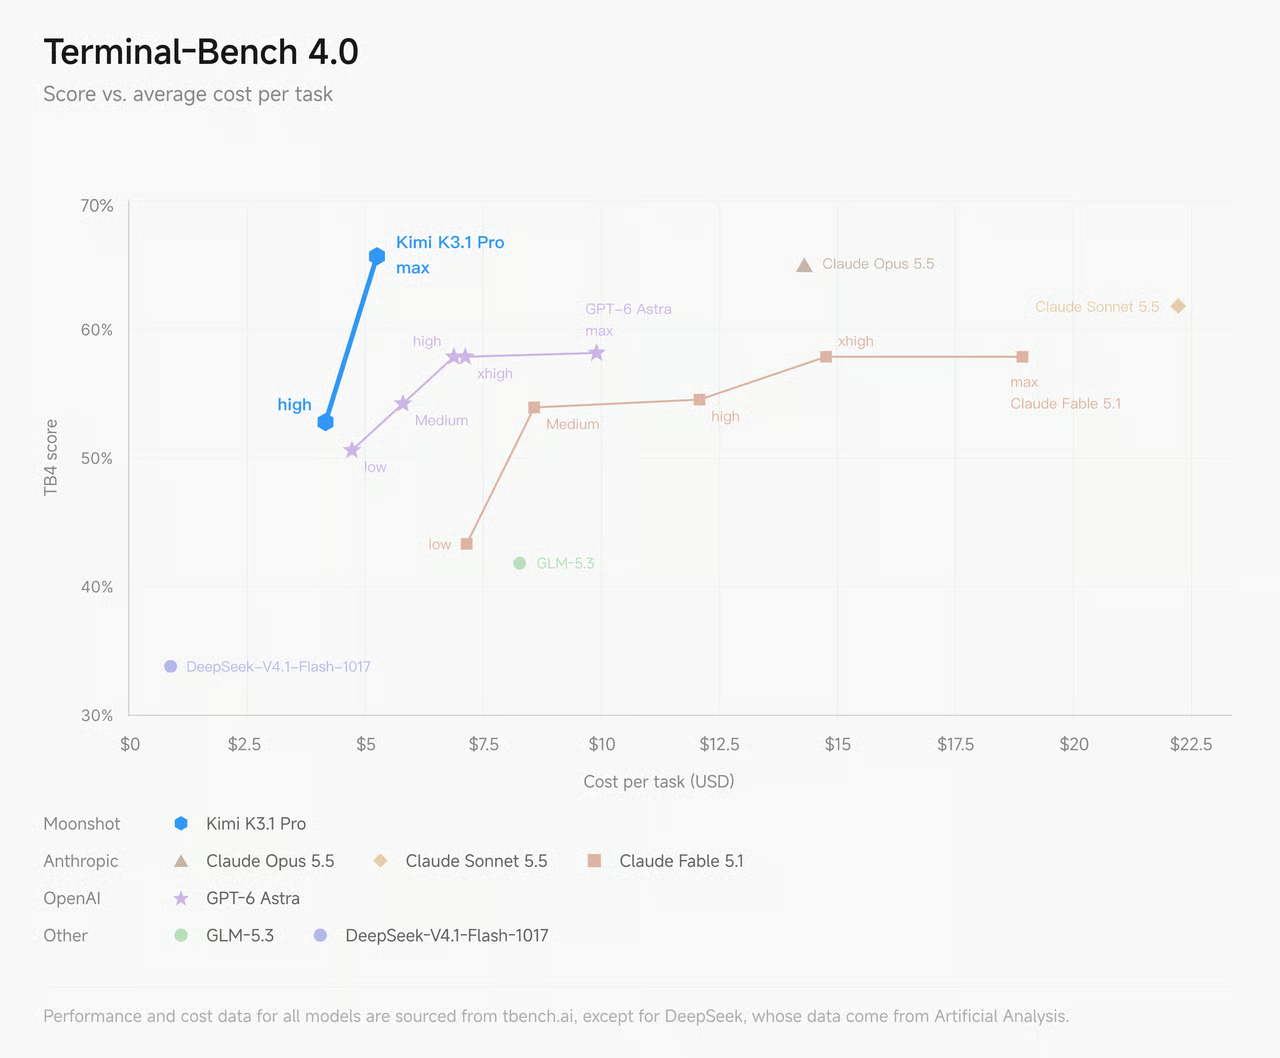
Nathan Lambert, investigador de Ai2, señaló esa misma contrapartida el día del lanzamiento:
"K3.1 is also cheaper than K3 per token, but some benchmarks in the blog show it uses meaningfully more tokens per answer, so it may be about the same price."
¿Es Kimi K3.1 Pro de código abierto?
Todavía no. Moonshot dice "Full model weights will be released by Nov 4, 2026", y al 27 de octubre aún no hay ningún repositorio en Hugging Face para él. Por ahora, Artificial Analysis lo clasifica como un modelo propietario, y 5 proveedores ofrecen la API, frente a 20 para K3.
Moonshot sí tiene antecedentes en este sentido: los pesos de K3 se publicaron en Hugging Face, y el repositorio de K3 muestra unos 2.78T parámetros en 8 bits. Cabe esperar que K3.1 Pro sea similar, lo que significa que ejecutarlo por tu cuenta es un trabajo para un clúster de servidores y no para una computadora portátil.
"a 3T parameter model is still a bit beyond even many enthusiasts for running locally."

Las condiciones de licencia de K3.1 Pro aún no están publicadas. La licencia de K3 permitía el uso comercial con algunas restricciones, así que lee la nueva antes de desarrollar sobre él. Si necesitas un modelo abierto que puedas desplegar hoy, DeepSeek V4.1 Flash obtiene 45.1 en el mismo índice a una fracción del costo.
¿Qué tan rápido es Kimi K3.1 Pro?
Lento. Artificial Analysis mide 49.7 tokens de salida por segundo en la API de Kimi, lo que lo sitúa en el puesto #165 de 182 modelos, frente a una mediana de sus pares de alrededor de 83. El tiempo hasta el primer token está bien, con 2.95 segundos. Lo que se nota es cuánto tiempo sigue escribiendo: una tarea media del índice tardó unos 17 minutos.
En la práctica, sigue siendo una mejora respecto a K3, ya que K3.1 Pro pierde menos tiempo pensando. Un desarrollador midió lo siguiente:
"Biggest gripe with K3 was slow responses, partly due to inefficient thinking. So far K3.1 pro is almost twice as fast as k3 on our benchmark."
La respuesta de Moonshot a eso es Highspeed: "2-3× the speed" al doble de precio. Artificial Analysis no lo ha evaluado hasta ahora, y la reacción el día del lanzamiento fue tibia:
"I'll wait for the openweight... btw double the price for 67 TPS... Hardly 'nitro'."
Mi opinión: para agentes en segundo plano que trabajan una hora mientras tú haces otra cosa, la velocidad apenas importa, así que el modelo estándar es la elección correcta. Para cualquier caso en el que haya una persona esperando, como una ventana de chat, paga por Highspeed o elige un modelo más rápido.
¿Qué dicen los desarrolladores sobre Kimi K3.1 Pro?
El hilo de lanzamiento en Hacker News reunió 1,089 puntos y 674 comentarios, y las reacciones se dividieron de forma bastante clara. Casi todo el mundo coincide en que es un gran avance respecto a K3 y también el mejor modelo de pesos abiertos anunciado hasta ahora, mientras que la mayoría de quienes programan a diario sigue diciendo que Claude Opus 5.5 está por delante en la práctica.
La más positiva de las pruebas independientes lo comparó con 180 pinturas generadas mediante código:
"It also does this while thinking less (~6.5k reasoning tokens vs ~8k for K3). Kimi K3.1 is roughly 2/3 the cost of Kimi K3 and ~1/3 the cost of Opus 5.5."
En el extremo negativo, una persona lo probó con 105 errores introducidos en dos repositorios reales, y allí obtuvo 36 frente a 41.7 de Opus 5.5:
"I'm sorry. Considering the cost, I see no reason to use this model."
Las pruebas de aficionados quedan en algún punto intermedio, aproximadamente al nivel de Fable 5.1 y Gemini 4 Argon:
"Ran it on my adversarial programming language (KillSwitch) benchmark[1]. Very significant improvement over K3. On par with Gemini 4 Argon and Fable 5.1. Much slower than both though."
Y luego están los límites de uso, que acapararon el hilo más que la calidad del modelo:
"Bought the $100/month subscription and hit my 5-hour limit with one prompt on default settings (max effort) in their CLI harness. It might be smart but it's unusable compared to other subscriptions right now."
Si piensas usarlo mediante una suscripción de Kimi Code, reduce el esfuerzo de razonamiento antes de juzgar el plan. La API admite low, high y max, y max es el valor predeterminado. Un comentarista que lo ejecutaba con subagentes más ligeros afirmó haber utilizado solo el 22 % de una cuota semanal durante una sesión de 8 horas, así que la configuración cambia bastante el panorama.
¿Cómo se accede a Kimi K3.1 Pro?
Hay cuatro vías en total, y la que encaje dependerá de lo que estés construyendo.
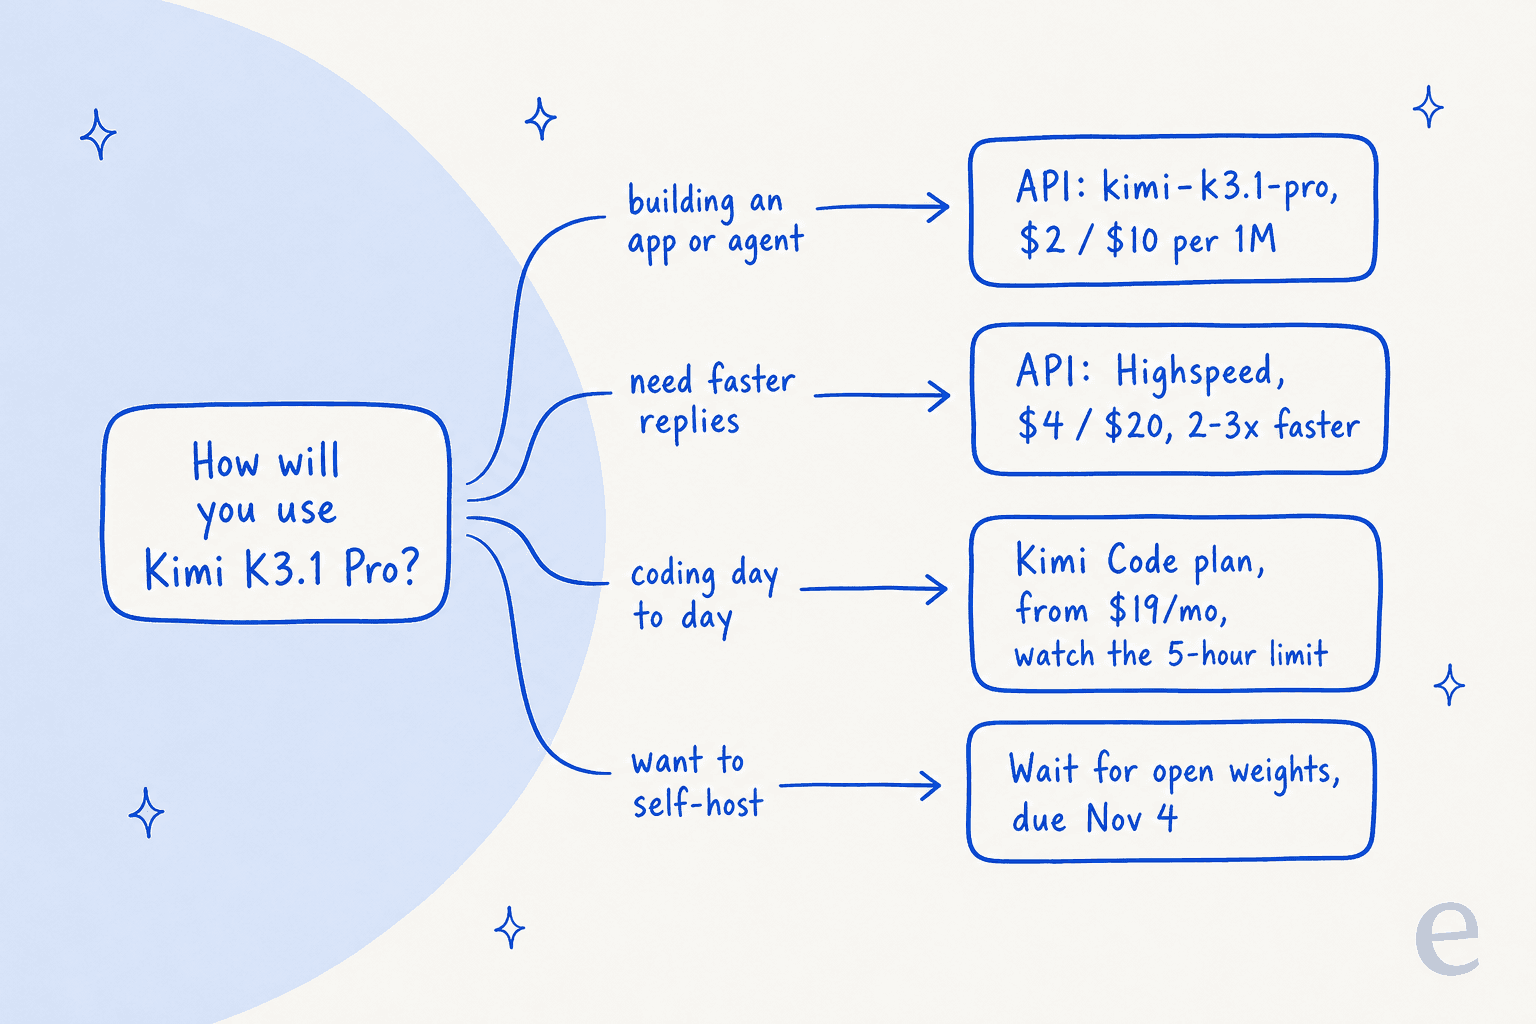
- API de Kimi. Usa los ID de modelo
kimi-k3.1-prookimi-k3.1-pro-highspeeden la plataforma de la API de Kimi. El razonamiento siempre está activado,reasoning_effortaceptalow,highomax, y la salida predeterminada es de131,072tokens (configurable hasta el 1M completo). Zero Data Retention está disponible para clientes de la API. - OpenRouter. Aparece como
moonshotai/kimi-k3.1-pro, con Moonshot como único proveedor por ahora. Es práctico si ya alternas entre modelos, y también útil cuando lo comparas con un nivel de API de IA gratuita. - Kimi Code. Lo seleccionas con
/model. Es el agente de programación de la propia Moonshot, que funciona en escritorio, CLI y complementos de IDE, y compite directamente con Claude Code y con el modelo anterior de Moonshot, Kimi K2.7 Code. - Aplicaciones de Kimi y Kimi Work. Esta es la vía para consumidores e incluye 3D Make. Kimi Work requiere la versión de escritorio
3.1.0o posterior. En Kimi Enterprise, K3.1 Pro está desactivado de forma predeterminada, así que los administradores tienen que activarlo.
¿Quién debería usar Kimi K3.1 Pro?
Esta es mi conclusión después de revisar la documentación y las pruebas, además de las primeras centenas de reacciones de desarrolladores.
Elígelo si ejecutas trabajos largos de agentes sin supervisión (programación, investigación, trabajo financiero intensivo con hojas de cálculo) por los que de otro modo pagarías los precios de Claude y puedes esperar los resultados. La calidad se acerca a Opus con aproximadamente un tercio del costo de ejecución, y no hay recargo por instrucciones largas en el contexto de 1M. También es el modelo al que conviene seguirle la pista si necesitas uno de vanguardia que, con el tiempo, puedas alojar tú mismo.
Descártalo si hay una persona esperando cada respuesta, porque a 50 tokens por segundo el chat en vivo y los intercambios rápidos al programar se sienten lentos. También puedes descartarlo si priorizas más el costo que la calidad: GPT-6.1 Sol y Gemini 4 Argon completan el mismo trabajo de evaluación por menos. Y si lo estás comparando con otros modelos abiertos, mi comparación de Qwen 3.8 Max frente a K3 y la lista de alternativas a Kimi K3 siguen siendo válidas para el panorama general.
El factor decisivo es si tu carga de trabajo es larga y admite esperas o corta e interactiva, y K3.1 Pro está diseñado para el primer tipo.
Qué significa Kimi K3.1 Pro para los equipos de soporte
Muchas personas que leen publicaciones de lanzamiento como esta tienen en mente una pregunta más concreta: ¿debería mi agente de soporte funcionar con este modelo? Creo que no es la primera pregunta que habría que hacerse. Un modelo como Kimi K3.1 Pro es un motor. Para responder tickets con él, aún tendrías que conectarlo a tu plataforma de soporte y sincronizar tu centro de ayuda y tus tickets anteriores, después decidir qué puede hacer por su cuenta y qué deriva a una persona, y también probarlo antes de que los clientes lleguen a verlo. He visto bots que suenan seguros dar respuestas incorrectas en colas en producción, y por eso eesel simula primero cada despliegue con los tickets históricos del propio equipo.
Esa capa es exactamente lo que es eesel. Contratas a un compañero de soporte con IA listo para trabajar que se incorpora a tu cola existente en Zendesk, Freshdesk o Gorgias, aprende de tu documentación y tus tickets anteriores, y después sigue las reglas de derivación que escribes en inglés sencillo. Si estás comparando la categoría en general, mi explicación sobre el empleado de IA cubre la diferencia entre contratar a un compañero y construirlo.

SE Ranking ofrece una buena imagen de cómo se ve eso en producción. Gestiona tres productos (SE Ranking, Planable y SE Visible) desde un único equipo de Zendesk, con un agente de eesel por producto. Cada agente busca en unas 16,800 páginas de contenido del centro de ayuda y del sitio web antes de responder, contesta al chat en vivo en el idioma del cliente y deriva los reembolsos, las ampliaciones de periodos de prueba y las consultas de nivel 2 a una persona, con los datos del cliente adjuntos. Entre el 8 de agosto y el 8 de septiembre de 2026, gestionó unas 4,650 conversaciones. Nada de esto depende de qué modelo obtuvo la puntuación más alta la semana pasada.
Si te atrae el enfoque de Kimi centrado en agentes, la CLI de eesel lo lleva al soporte. Puedes ejecutar al mismo compañero desde una terminal, por ejemplo, para revisar su trabajo reciente con eesel activity o aprobar y rechazar acciones pendientes con eesel approvals, y también puedes editar sus reglas permanentes con eesel instructions. Los comandos imprimen JSON y los comandos de escritura admiten --dry-run, lo que significa que los scripts y los agentes de programación como Claude Code pueden manejarlo, y también hay un servidor MCP. Explico este patrón más amplio en mi guía sobre la CLI para agentes de IA.
¿Quieres el resultado sin tener que ir comparando modelos? Prueba eesel gratis en tu propia plataforma de soporte y comprueba cómo gestiona los tickets de la semana pasada, o explora los mejores compañeros de IA para comparar primero las opciones.
Preguntas frecuentes
¿Qué es Kimi K3.1 Pro?
Kimi K3.1 Pro es el modelo insignia de Moonshot AI, lanzado el 23 de octubre de 2026. Tiene la misma base de 2.8T de parámetros que Kimi K3, con mucho más posentrenamiento, una ventana de contexto de 1M de tokens y una variante Highspeed más rápida. Obtiene 55 en el Artificial Analysis Intelligence Index, cerca de Claude Opus 5.5.
¿Cuánto cuesta Kimi K3.1 Pro?
En la API de Kimi, Kimi K3.1 Pro cuesta 2 $ por millón de tokens de entrada, 0,20 $ para la entrada en caché y 10 $ por millón de tokens de salida. La versión Highspeed cuesta 4 $ y 20 $. Es un tercio más barato que los precios de Kimi K3 y tiene el mismo precio de lista que Claude Sonnet 5.5.
¿Kimi K3.1 Pro es de código abierto?
Todavía no. Moonshot dice que los pesos completos de Kimi K3.1 Pro se publicarán a más tardar el 4 de noviembre de 2026, y hasta entonces solo está disponible mediante la API y la aplicación. Con 2.8T de parámetros, necesitará un clúster de servidores, no un portátil. Si quieres un modelo abierto que puedas ejecutar hoy, mi recopilación de agentes de IA de código abierto repasa las opciones.
¿Kimi K3.1 Pro es mejor que Claude Opus 5.5?
En el propio gráfico de Moonshot, Kimi K3.1 Pro gana en 6 de 14 pruebas de rendimiento y queda por detrás de Opus 5.5 en Terminal-Bench 4.0 por 0.7 puntos. En Artificial Analysis obtiene 55.1 frente a 57.6. La mayoría de los evaluadores independientes dicen que Opus sigue por delante en el uso diario, pero usar Kimi cuesta aproximadamente un tercio. Mi análisis de Claude Opus 5.5 aborda la otra perspectiva.
¿Qué es Kimi K3.1 Pro Highspeed?
Kimi K3.1 Pro Highspeed es el mismo modelo, que responde entre 2 y 3 veces más rápido, al doble de precio: 4 $ de entrada y 20 $ de salida por millón de tokens. En los planes de Kimi para consumidores, requiere el nivel Pro o superior y consume créditos al doble de velocidad. Es especialmente relevante para el chat y los ciclos de programación en los que la espera perjudica, como al trabajar en Claude Code.
¿Cómo uso Kimi K3.1 Pro en Kimi Code?
Kimi K3.1 Pro está disponible en Kimi Code con el plan Plus (19 $/mes) y superiores. Ejecuta Kimi Code y cambia de modelo con el comando /model. Presta atención al límite de uso en una ventana móvil de 5 horas, que los evaluadores alcanzan rápidamente con el esfuerzo al máximo. Para ver más opciones, consulta mi lista de asistentes de programación con IA.
¿Puedo usar Kimi K3.1 Pro para atención al cliente?
Puedes, pero Kimi K3.1 Pro es un modelo sin integrar, así que todavía tendrías que crear por tu cuenta la conexión con la plataforma de soporte, la sincronización del conocimiento, las reglas de transferencia y las pruebas. Sus 50 tokens por segundo también resultan lentos para el chat en vivo. Un compañero de equipo de atención al cliente con IA listo para usar como eesel se encarga de esa capa, y mi guía sobre el mejor modelo de IA para tickets de soporte compara los motores.