

Resumen breve
Kimi K3.1 Pro cuesta 2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida en la API de Kimi, con la entrada en caché a 0,20 $. La versión Highspeed cuesta exactamente el doble, 4 $ / 20 $. Si prefieres pagar una tarifa fija, está incluido en los planes de Kimi desde $19 al mes (Plus) hasta $199 (Ultra), con Highspeed a partir del plan Pro de $39.
El precio anunciado dice que es un tercio más barato que Kimi K3. La factura dice otra cosa: K3.1 Pro piensa y escribe mucho, así que una tarea promedio de un agente cuesta $2.11 frente a los $2.00 de K3 en Artificial Analysis. Pagas más o menos lo mismo por un modelo mucho mejor, no menos por el mismo. Frente a Claude sí supone un ahorro real, con menos de la mitad del costo por tarea de Sonnet 5.5 u Opus 5.5 con el esfuerzo máximo.
Dos detalles determinan la mayoría de las facturas: los tokens de salida y de razonamiento representan la mayor parte del costo, y los planes de suscripción tienen un límite móvil de 5 horas que los primeros compradores alcanzan en menos de una hora. Si lo que realmente quieres es una IA que responda tickets de soporte, llevo años en eesel ejecutando IA en colas de soporte reales, y la factura de tokens es la partida pequeña. SE Ranking gestiona unas 4,650 conversaciones al mes entre tres productos en Zendesk sin tener que elegir nunca un modelo.
¿Cuánto cuesta Kimi K3.1 Pro en la API?
Kimi K3.1 Pro cuesta 2,00 $ de entrada, 0,20 $ de entrada en caché y 10,00 $ de salida por millón de tokens en la página de precios de la API de Kimi. Moonshot lo lanzó el 23 de octubre de 2026 sin ninguna tarifa promocional, lo que significa que este parece ser el precio estándar y no un descuento de lanzamiento.
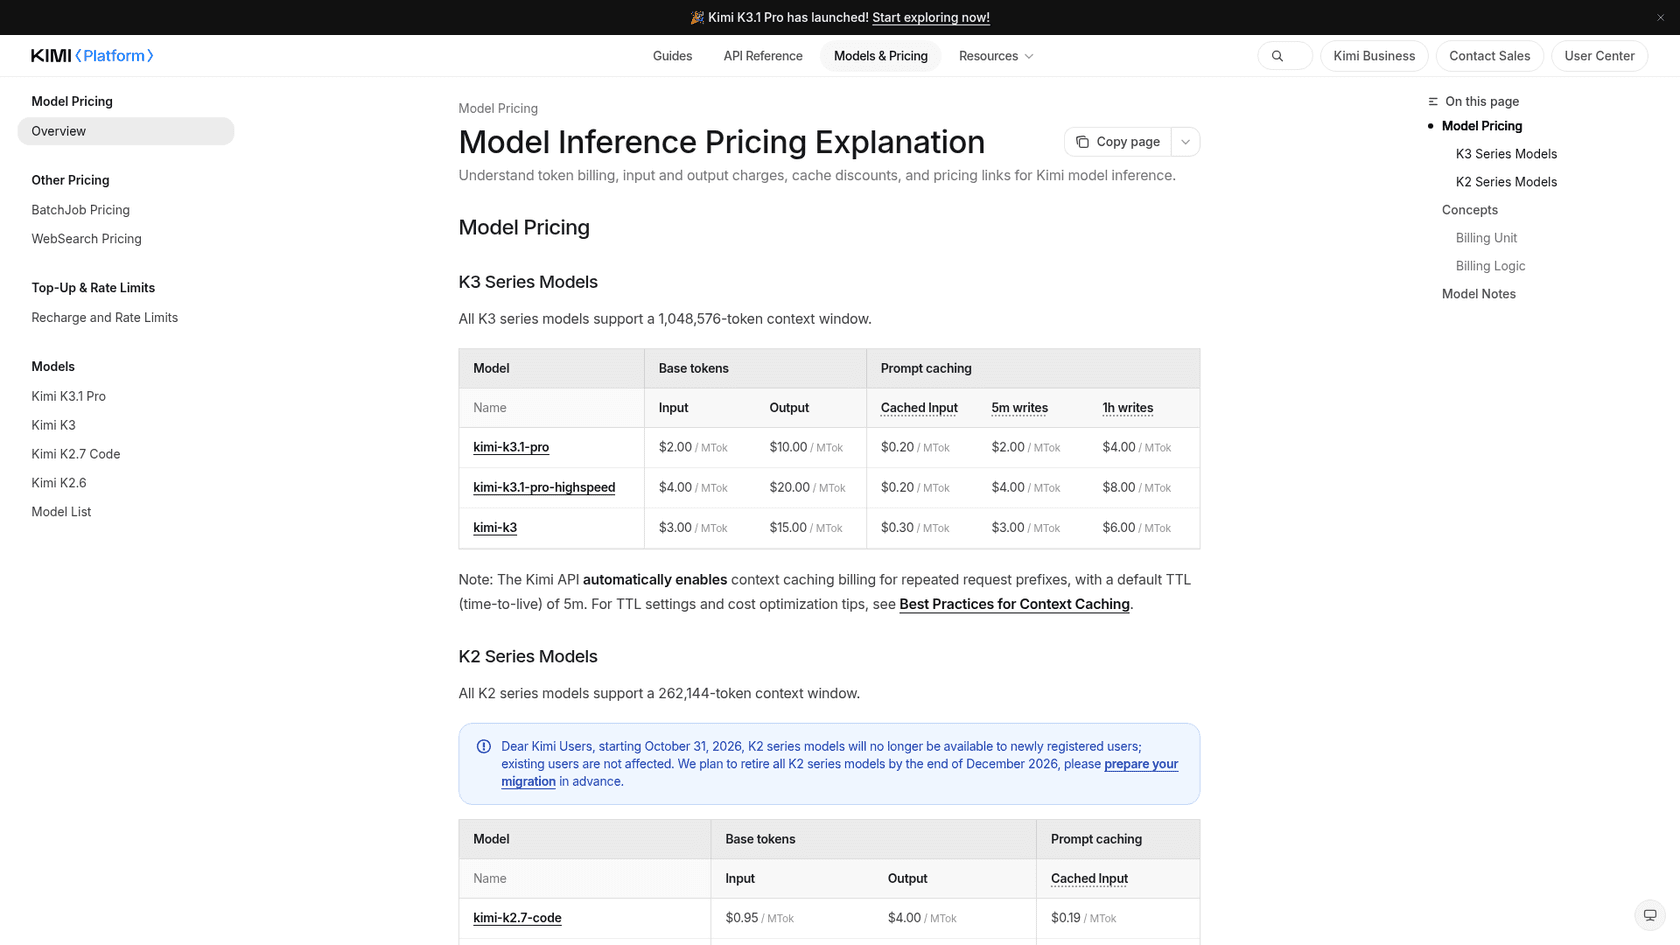
Aquí tienes la tabla completa de tarifas de la serie K3, por millón de tokens:
| ID del modelo | Entrada (sin coincidencia en caché) | Entrada en caché (con coincidencia en caché) | Salida | Escritura en caché, 5 min | Escritura en caché, 1 hora |
|---|---|---|---|---|---|
kimi-k3.1-pro | $2.00 | $0.20 | $10.00 | $2.00 | $4.00 |
kimi-k3.1-pro-highspeed | $4.00 | $0.20 | $20.00 | $4.00 | $8.00 |
kimi-k3 | $3.00 | $0.30 | $15.00 | $3.00 | $6.00 |
Hay algunos puntos de esa tabla en los que conviene detenerse:
- Sin recargo por contexto largo. Ambos modelos K3.1 Pro admiten un contexto de
1,048,576tokens, y la guía de inicio rápido de K3.1 Pro dice que "uses flat pay-as-you-go pricing", sin niveles según la longitud del contexto. Esto importa mucho si le proporcionas bases de código completas. - El precio de las coincidencias en caché no se duplica en Highspeed. Todo lo demás sí se duplica, pero la entrada en caché se mantiene en
$0.20, así que, si tus solicitudes reutilizan un prompt largo, Highspeed acaba costando menos de 2x en la práctica. - K3 sigue a la venta al precio anterior.
kimi-k3se mantiene en 3 $ / 15 $, y la documentación ahora lo llama "previous-generation flagship". No se me ocurre ningún proyecto nuevo en el que tenga sentido seguir con K3, salvo que necesites sus pesos abiertos hoy.
¿Qué cuenta como token facturable?
Cada token de entrada y cada token de salida, incluido el razonamiento. K3.1 Pro es un modelo de razonamiento que siempre tiene activado el pensamiento, y reasoning_effort está configurado en max de forma predeterminada, según la guía de claves de API de Moonshot. Esos tokens de pensamiento se facturan a la tarifa de salida de $10, aunque nunca llegues a verlos en la respuesta.
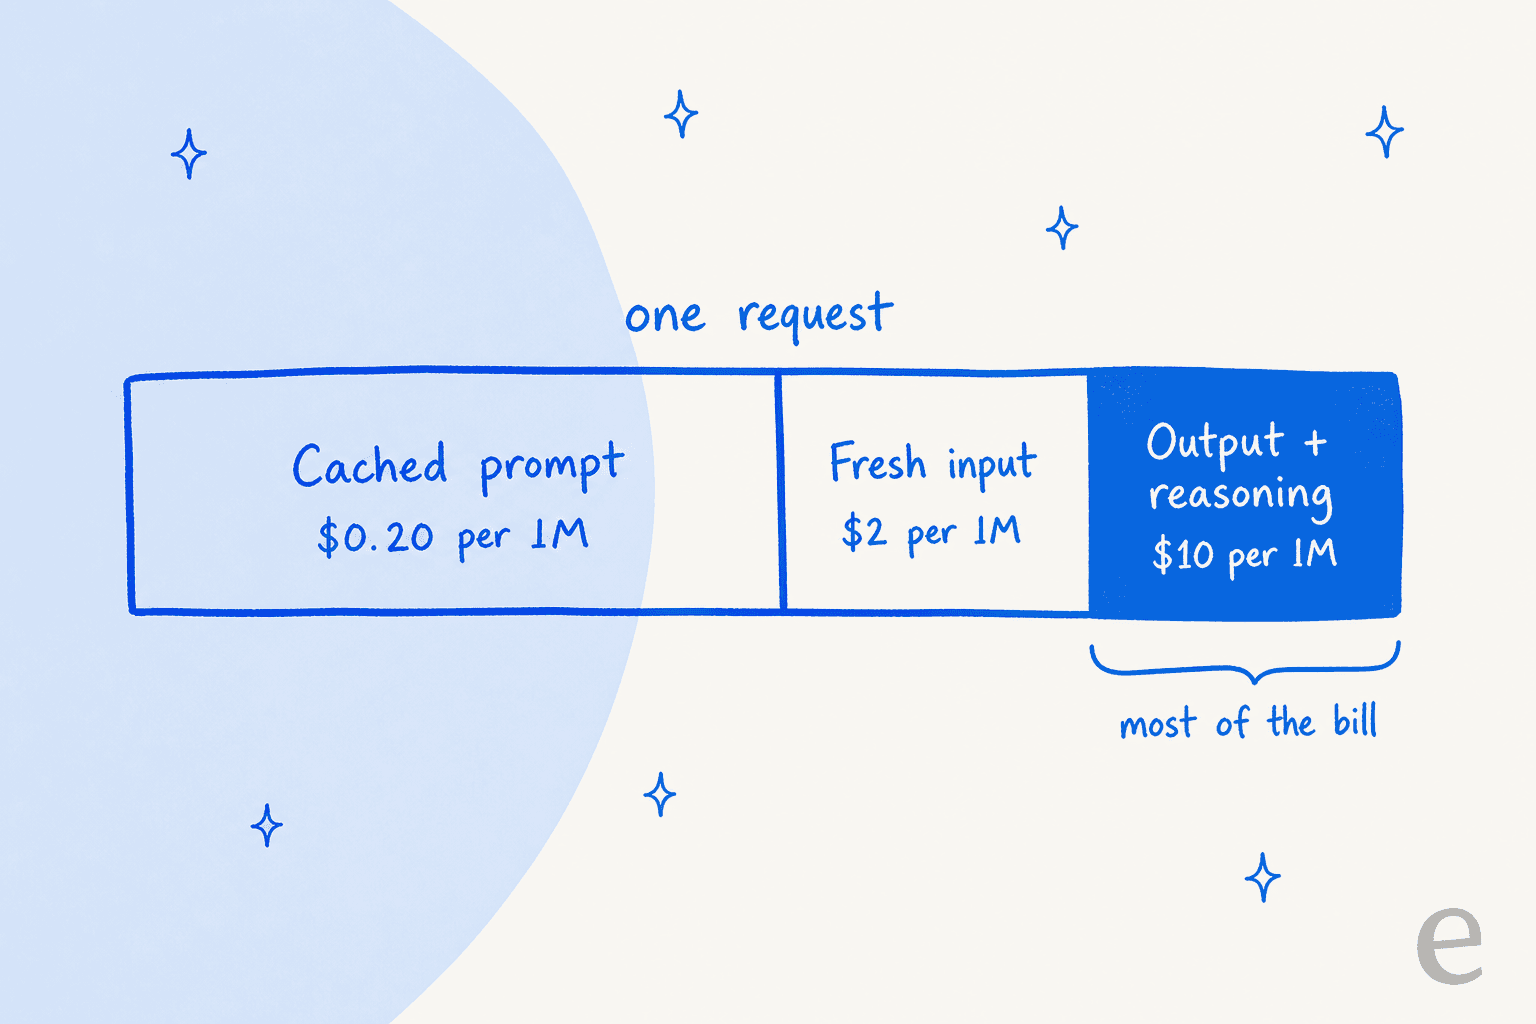
Ese es el factor que más influye en tu factura. En las ejecuciones de las pruebas de referencia de Artificial Analysis, una tarea promedio produjo 55,195 tokens de salida, de los cuales 34,883 fueron de razonamiento (página del modelo en AA). A 10 $ por millón, eso equivale a unos 55 centavos de salida por tarea, antes de contar un solo token de entrada.
¿Cómo funciona el almacenamiento en caché de prompts de Kimi?
El almacenamiento en caché se realiza automáticamente para los prefijos de prompts repetidos, con un tiempo de vida predeterminado de 5 minutos. Una coincidencia en caché cuesta $0.20, un 90 % menos que la entrada nueva. La escritura en caché se factura por separado, según cuánto tiempo la conserves: $2.00 por millón para el nivel de 5 minutos y $4.00 para el de 1 hora, que eliges con prompt_cache_options.ttl (guía de inicio rápido).
Hay dos detalles que suelen causar confusión. Los bloques parciales de caché se facturan como entradas sin coincidencia en caché, así que un prompt que cambia cerca del principio pierde la mayor parte de su descuento. El nivel de 1 hora también solo compensa cuando el tráfico es demasiado esporádico para mantener activa una caché de 5 minutos, lo que, para un agente con mucha actividad, significa que la opción predeterminada suele ser la más barata.
Los límites de uso dependen de tu recarga
K3.1 Pro se desbloquea tras una recarga exitosa de al menos $1, y el total de tus recargas determina tu nivel de límites de uso (Recargas y límites de uso):
| Nivel | Total de recargas | Concurrencia | Solicitudes/min | Tokens/min | Tokens/día |
|---|---|---|---|---|---|
| Tier0 | $1 | 1 | 3 | 500,000 | 1,500,000 |
| Tier1 | $10 | 15 | 100 | 2,000,000 | Sin límite |
| Tier2 | $20 | 40 | 100 | 3,000,000 | Sin límite |
| Tier3 | $100 | 50 | 200 | 3,000,000 | Sin límite |
| Tier4 | $1,000 | 60 | 200 | 4,000,000 | Sin límite |
| Tier5 | $3,000 | 100 | 300 | 5,000,000 | Sin límite |
El nivel de $1 sirve más para probar que para trabajar en producción. Con 1,500,000 tokens al día, menos de 30 tareas promedio de un agente lo agotarían por completo, pero en cuanto ingresas $10, desaparece el límite diario. Si ya has lidiado con los límites de uso de OpenAI, esta escala te resultará familiar, solo que los umbrales son mucho más bajos.
Todavía no hay descuento por lotes
La Batch API de Kimi cobra el 60 % del precio estándar, pero solo admite kimi-k2.7-code y kimi-k2.6. K3.1 Pro no está en esa lista. Esos modelos K2 dejan de aceptar nuevos usuarios el 31 de octubre de 2026 y se retiran a finales de diciembre, lo que significa que los trabajos nocturnos que dependían de los precios de Kimi K2.7 Code pronto pasarán a pagar las tarifas completas de K3.1.
¿Cuánto cuesta Kimi K3.1 Pro por tarea?
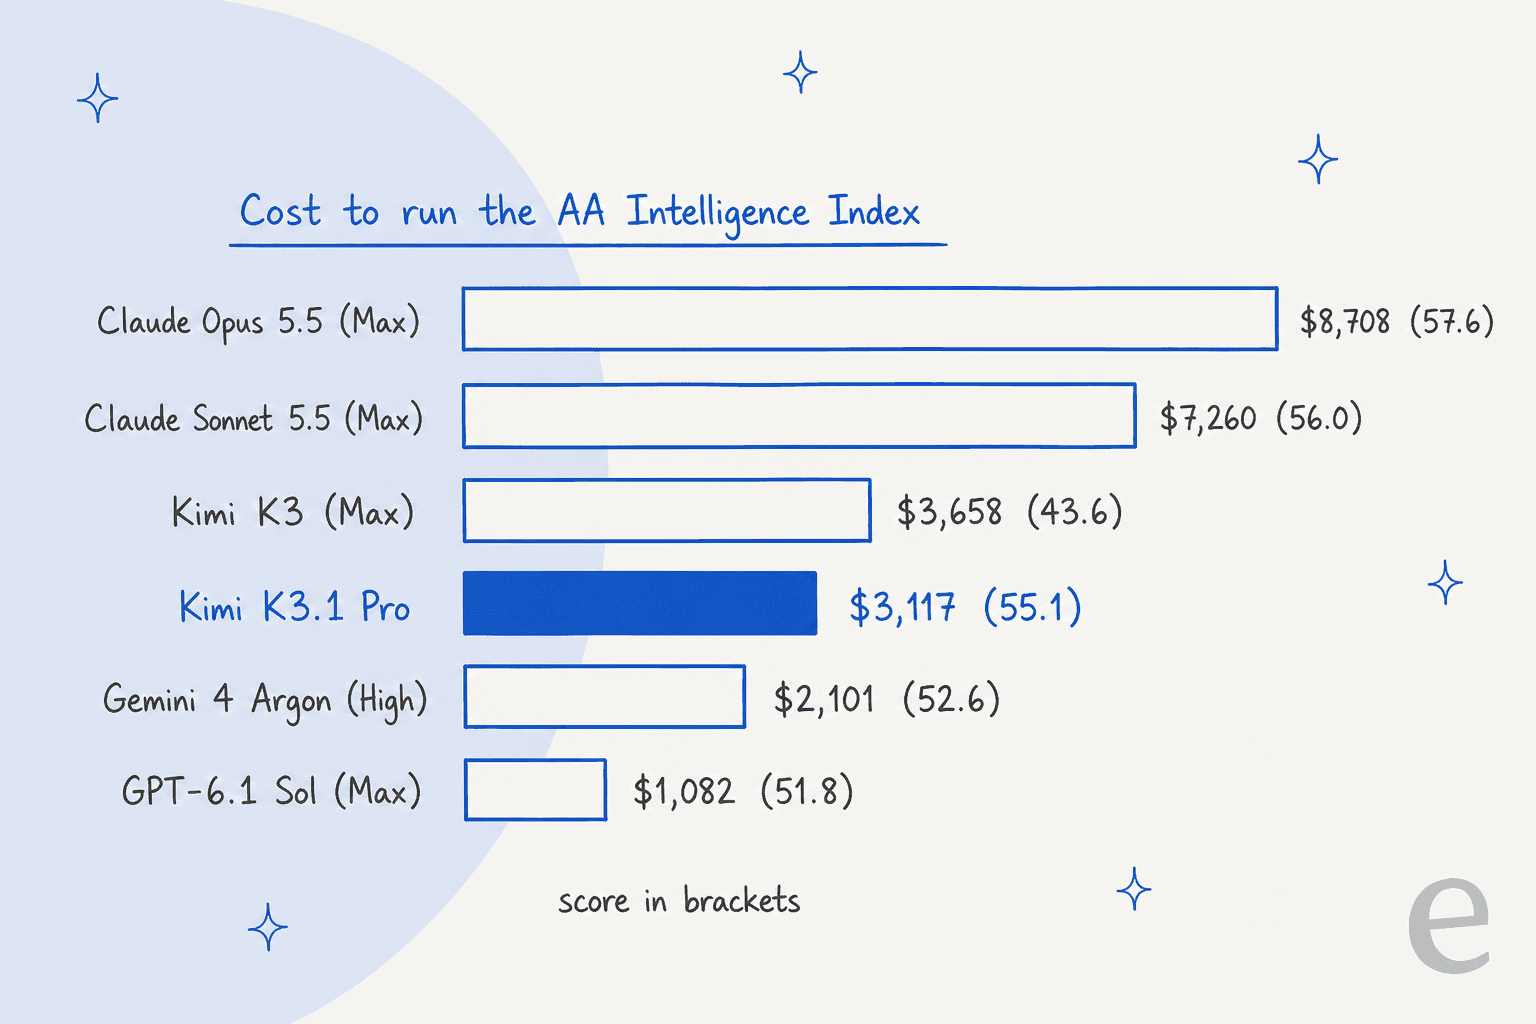
En Artificial Analysis, una tarea promedio de su Intelligence Index cuesta $2.11 con K3.1 Pro, y ejecutar el índice completo costó $3,117 (página del modelo en AA). Esa es la cifra que yo tomaría como referencia, porque ya incluye el razonamiento extenso que el precio por token oculta.
AA califica a K3.1 Pro como "very verbose". Utilizó unos 150M tokens de salida para ejecutar el índice, frente a una mediana de 87M entre los modelos de su grupo de precios. Así que ese tercio de descuento anunciado se reduce bastante rápido en cuanto el modelo empieza a pensar.
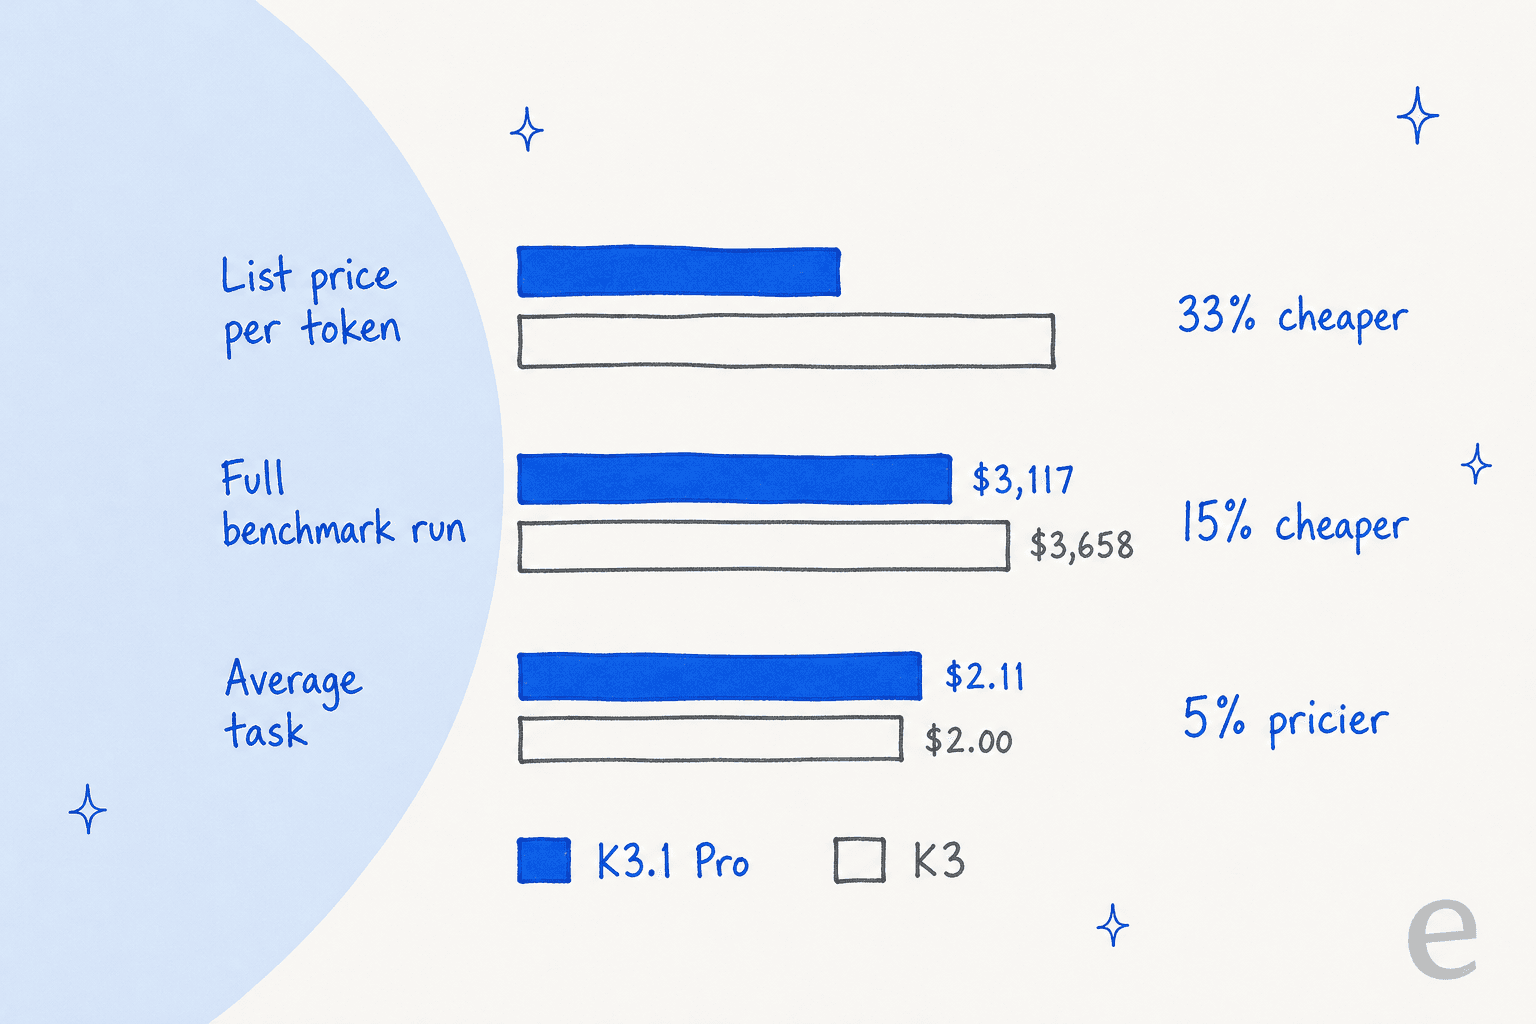
Las tres cifras no se contradicen, simplemente miden cosas distintas. La ejecución completa da más peso a las tareas grandes, que es donde se notan las mejoras de eficiencia de K3.1 Pro. La cifra de la tarea promedio es una media sin ponderar, en la que su escritura adicional en tareas pequeñas lo sitúa ligeramente por encima de K3. En cualquier caso, el resumen honesto es que obtienes un modelo 11.5 puntos más inteligente por aproximadamente el mismo dinero, no el mismo modelo por un tercio menos.
Nathan Lambert, investigador de Ai2, ya lo señaló el día del lanzamiento:
"K3.1 is also cheaper than K3 per token, but some benchmarks in the blog show it uses meaningfully more tokens per answer, so it may be about the same price."
Cómo se compara con otros modelos de vanguardia
Así queda frente a los modelos con los que la gente lo compara al comprar, todos de la misma página de Artificial Analysis:
| Modelo | Precio de lista (entrada / salida) | Intelligence Index | Costo por tarea | Costo de ejecutar el índice | Velocidad de salida |
|---|---|---|---|---|---|
| Claude Opus 5.5 (Max) | $4 / $20 | 57.6 | $5.98 | $8,708 | 98.1 t/s |
| Claude Sonnet 5.5 (Max) | $2 / $10 | 56.0 | $5.46 | $7,260 | 141.3 t/s |
| Kimi K3.1 Pro | $2 / $10 | 55.1 | $2.11 | $3,117 | 49.7 t/s |
| Claude Fable 5.1 (Max) | $10 / $50 | 53.4 | $7.63 | $13,129 | 69.8 t/s |
| GPT-6 Astra (Max) | $10 / $50 | 52.7 | $3.26 | $5,324 | 66.7 t/s |
| Gemini 4 Argon (High) | $2 / $10 | 52.6 | $1.62 | $2,101 | 79.7 t/s |
| GPT-6.1 Sol (Max) | $2 / $10 | 51.8 | $0.72 | $1,082 | 65.9 t/s |
| DeepSeek V4.1 Flash 1017 (Max) | $0.30 / $1.20 | 45.1 | $0.26 | $445 | 169.3 t/s |
| Kimi K3 (Max) | $3 / $15 | 43.6 | $2.00 | $3,658 | 54.5 t/s |
Mi lectura de esa tabla:
- Frente a Claude, es la opción clara por relación calidad-precio. Tiene el mismo precio anunciado que Sonnet 5.5, pero Sonnet con el esfuerzo máximo consumió
416Mtokens de salida en el índice, mientras que K3.1 Pro se queda a menos de un punto por bastante menos de la mitad del costo por tarea. - Frente a los modelos más baratos de 2 $ / 10 $, no es la ganga. GPT-6.1 Sol y Gemini 4 Argon terminan una tarea promedio por
$0.72y$1.62, con unos 3 y 2.5 puntos menos en el índice. Si te importa más el costo por trabajo que esos últimos puntos, esos salen ganando. - La velocidad es el precio oculto. Con
49.7tokens por segundo ocupa el puesto#165de 182 modelos. Una tarea promedio del índice tardó unos 17 minutos, algo que no verás en una factura, pero que resulta muy evidente para quien espera.
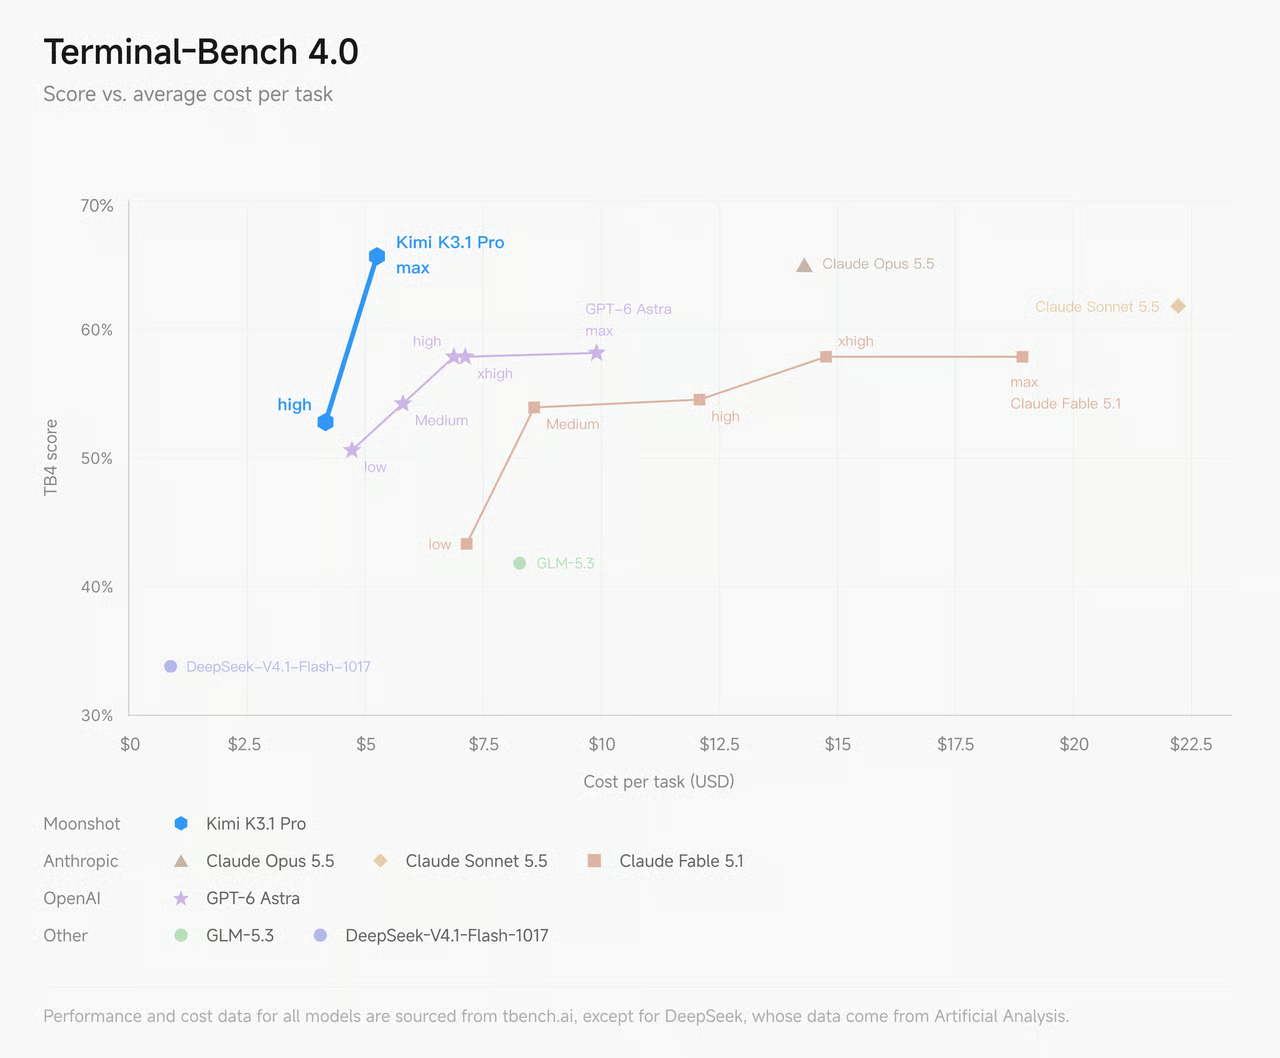
El gráfico de Moonshot hace esa misma comparación con Claude en Terminal-Bench, donde sitúa a K3.1 Pro en aproximadamente 5 $ por tarea frente a unos 14 $ de Opus 5.5:
Una persona que lo probó de forma independiente observó una diferencia similar en un trabajo más pequeño:
"Kimi K3.1 Pro ties Sonnet 5.5 at 93, for $0.68 and 11 min vs Sonnet's $1.61 and 14 min."

¿Vale la pena pagar el doble por Kimi K3.1 Pro Highspeed?
Solo cuando hay una persona esperando la respuesta. Highspeed es el mismo modelo servido a "about 2-3× the speed" por exactamente el doble del precio de entrada y salida (guía de claves de API). La calidad es idéntica, así que lo que compras es tiempo, no inteligencia.
Para trabajos nocturnos y agentes en segundo plano, o cualquier situación en la que nadie esté mirando el cursor, K3.1 Pro estándar es la opción evidente. Para chat en vivo o ciclos rápidos de programación, los 49.7 tokens por segundo del modelo base sí se sienten lentos, y Highspeed lo soluciona. Aunque no a todo el mundo le impresionó la mejora:
"I'll wait for the openweight... btw double the price for 67 TPS... Hardly 'nitro'."
Todavía no hay una medición independiente de la velocidad de Highspeed, Artificial Analysis no lo incluye, así que yo trataría el 2-3x de Moonshot como una afirmación hasta que alguien lo someta a pruebas.
¿Cuánto cuestan los planes de Kimi que incluyen K3.1 Pro?
Los planes de suscripción de Kimi van de $19 a $199 al mes e incluyen K3.1 Pro en la aplicación de Kimi y Kimi Work, además de Kimi Code, el agente de programación de Moonshot. Los precios siguientes proceden de la página de Kimi Code:
| Plan | Mensual | Facturación anual (por mes) | Facturación anual (total) | Acceso a K3.1 Pro |
|---|---|---|---|---|
| Plus | $19 | $15 | $180 | Estándar |
| Pro | $39 | $31 | $372 | Estándar y Highspeed |
| Max | $99 | $79 | $948 | Estándar y Highspeed |
| Ultra | $199 | $159 | $1,908 | Estándar y Highspeed |
Highspeed en un plan implica "2× credit usage". Kimi también cambió recientemente los nombres de sus planes, "with pricing unchanged", según su página de beneficios de Kimi Code, y los suscriptores actuales pueden conservar los nombres antiguos (Moderato, Allegretto, etc.). Los nuevos planes eliminaron el límite semanal de Kimi Code, pero mantuvieron la ventana móvil de 5 horas, además de una bolsa mensual de créditos compartida entre Kimi y Kimi Code.
En China, la misma escala tiene precios en yuanes, desde un plan Go de ¥49 (sin Kimi Code) hasta ¥1.399 al mes por Ultra, según la página de ayuda sobre precios de suscripción de Kimi.
¿Qué pasa cuando alcanzas el límite?
Puedes comprar Extra Usage, una recarga de pago por uso compartida entre Kimi y Kimi Code, con un mínimo de ¥25 por recarga. Kimi dice que su precio es "close to the official API pricing", así que, en la práctica, es la API con un proceso de pago distinto.
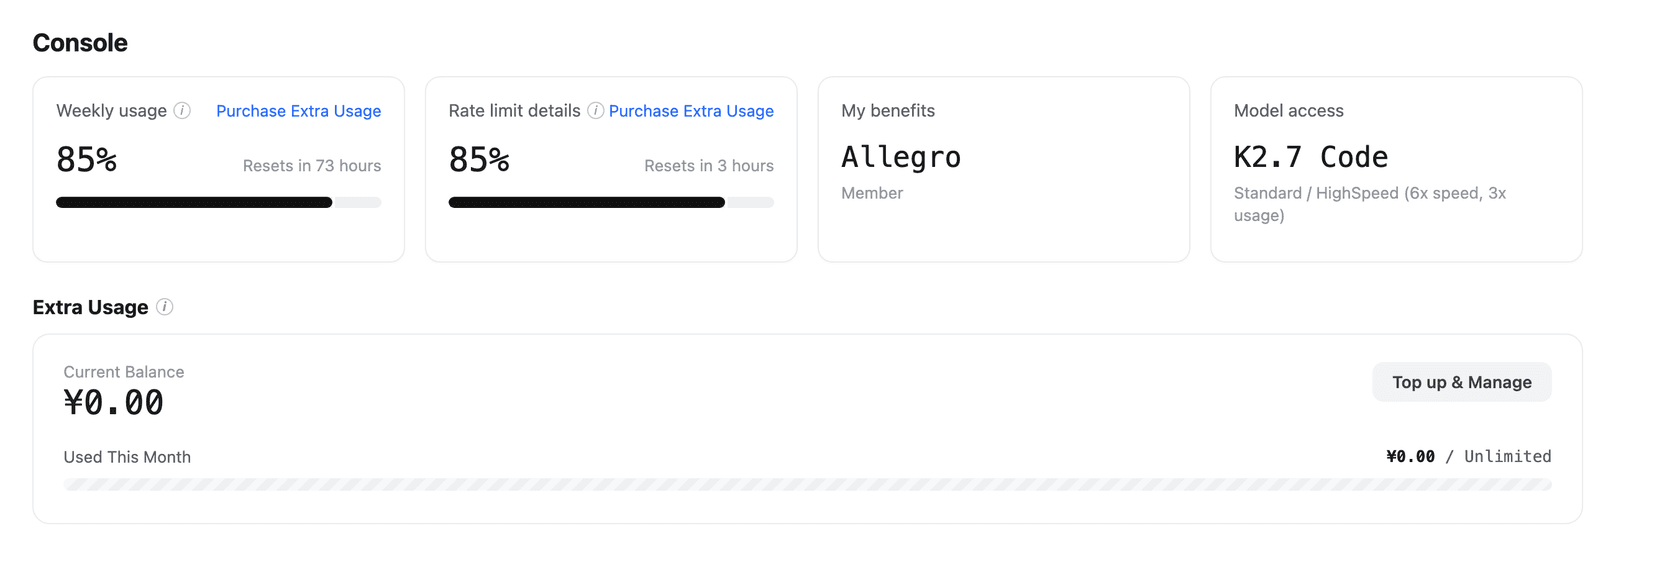
Eso importa, porque el límite de 5 horas es, hasta ahora, la queja más destacada sobre K3.1 Pro. En el hilo del lanzamiento de Hacker News, con 674 comentarios, se habló más de la cuota que de la calidad del modelo:
"If you are expecting any sort of usable limits on their subscription plan I suggest adjusting your expectations. I subscribed to $99 a month plan and within 47 minutes with one session (not asking for swarms or anything) was limited by 5-hour quota."
Para ser justos con Moonshot, el esfuerzo predeterminado max tiene mucho que ver con esto, y otro usuario del mismo hilo afirmó haber trabajado durante 8 horas consumiendo el 22 % de su cuota semanal al combinar K3.1 Pro con un modelo más ligero para los subagentes. Los planes sí funcionan, simplemente no rinden tanto desde el primer día como algunos planes de programación de la competencia.
¿Deberías usar la API o un plan de Kimi?
Elige según quién haga las llamadas al modelo. Si las hace tu aplicación o tu agente, usa la API: pagas por token y, después de una recarga de $10, no hay límite diario. Si eres tú quien hace las llamadas, desde Kimi Code o la aplicación de Kimi, un plan casi siempre es más barato, siempre que puedas convivir con la ventana de 5 horas.
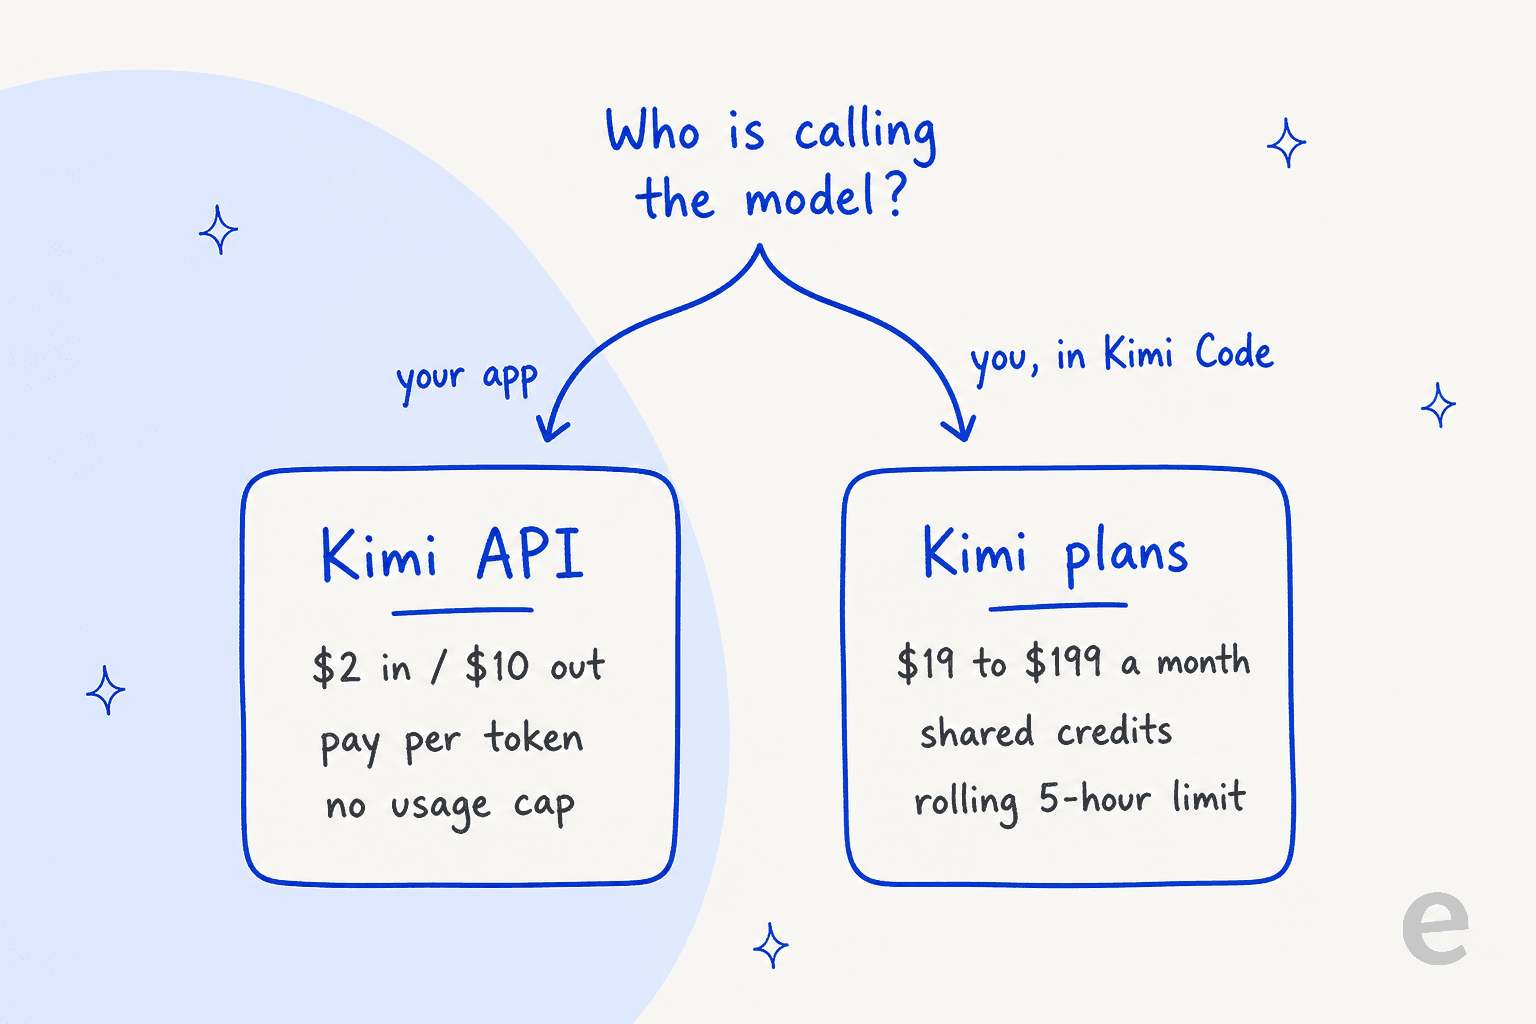
Las cuentas muestran por qué. Un desarrollador que ejecuta 20 tareas de agente por día laborable, con el promedio de Artificial Analysis de $2.11 por tarea, gastaría unos $928 al mes en la API (20 × 22 × $2.11). El plan Max de $99 es una ganga en comparación, y esa es precisamente la razón por la que Moonshot lo raciona con el límite móvil. Si estás comparando planes de programación, mi desglose de precios de Claude Code y mi lista de asistentes de programación con IA cubren la otra parte.
¿Cuánto costaría Kimi K3.1 Pro para mi carga de trabajo?
Introduce tus propias cifras. La calculadora de abajo usa las tarifas oficiales de la API de Kimi y supone que la parte almacenada en caché se mantiene activa (sin cargos por escritura en caché), así que conviene tratar el resultado como un mínimo.
Para que te hagas una idea de los casos reales, esto es lo que cuestan tres cargas de trabajo habituales con K3.1 Pro estándar, usando las tarifas oficiales:
| Carga de trabajo | Por solicitud | Volumen mensual | K3.1 Pro | Highspeed | Kimi K3 |
|---|---|---|---|---|---|
| Respuestas de soporte | 6.000 de entrada en caché + 2.000 de entrada nueva, 1.500 de salida | 10,000 | $202 | $392 | $303 |
| Preguntas y respuestas sobre documentos largos | 200.000 de entrada nueva, 3.000 de salida | 500 | $215 | $430 | $323 |
| Programación con agentes | Tarea promedio de AA ($2.11) | 440 | ~$928 | n/d | ~$880 |
El patrón se mantiene en los tres casos: el almacenamiento en caché de la entrada funciona por sí solo con prompts repetidos, y la salida es donde hay que buscar el ahorro. Bajar reasoning_effort del valor predeterminado max a high o low sería el primer ajuste que haría. En K3, AA midió la configuración de esfuerzo bajo en $1.15 por tarea frente a $2.00 con el máximo, a costa de una gran caída en la puntuación, así que pruébala con tus propias tareas antes de adoptarla. Si controlas el gasto de varios modelos, una herramienta de seguimiento de LLM te ayuda a detectar un agente fuera de control antes de que lo haga la factura.
¿Vale Kimi K3.1 Pro lo que cuesta?
Para programación con agentes y trabajos largos de varios pasos, sí. Es uno de los modelos con mayor puntuación que puedes comprar y cuesta bastante menos de la mitad que Claude por tarea con el esfuerzo máximo. También se ha prometido publicar los pesos "by Nov 4", lo que debería atraer a más proveedores de alojamiento. Solo para dar una idea de la escala, Kimi K3 está disponible a través de 20 proveedores en Artificial Analysis, frente a 5 de K3.1 Pro hoy.
Resulta menos conveniente en tres casos:
- Quieres terminar el trabajo al menor costo. GPT-6.1 Sol y Gemini 4 Argon realizan la tarea promedio por menos. Si solo importa el costo, DeepSeek V4.1 Flash está en otra liga con
$0.26por tarea. - Una persona espera cada respuesta. Con 50 tokens por segundo acabarás usando Highspeed, momento en el que la ventaja de precio frente a Sonnet 5.5 se reduce.
- Piensas depender de un plan de Kimi. La ventana de 5 horas es ajustada con el esfuerzo máximo. Reserva algo de presupuesto para Extra Usage, o espera unas semanas para ver si Moonshot la flexibiliza.
Si lo estás comparando con el panorama más amplio, mi lista de alternativas a Kimi K3 y mi análisis de los precios de Qwen 3.8 Max siguen siendo válidos.
Desde la perspectiva de los modelos abiertos, comparé Qwen 3.8 Max y K3 cara a cara, y el análisis completo del modelo está en mi artículo sobre Kimi K3.1 Pro.
Lo que el precio de un modelo no le dice a un equipo de soporte
Muchas de las personas que consultan precios de modelos como este en realidad se preguntan si deberían crear un agente de soporte sobre él. Como alguien que trabaja en las integraciones de eesel, diría que la cifra por token es la parte fácil. En el ejemplo de soporte anterior, $202 al mes te compran tokens, no un agente. Todavía tendrías que conectar tu plataforma de soporte, sincronizar tu centro de ayuda y tus tickets anteriores, escribir las reglas de derivación y probarlo todo antes de que un cliente vea una respuesta. Ese desarrollo es donde se concentra la mayor parte del tiempo y del riesgo, y por eso cada implementación de eesel se simula primero con los tickets históricos del propio equipo.
eesel elimina por completo ese desarrollo. Contratas a un compañero de soporte con IA listo para trabajar, que se incorpora a tu cola existente en Zendesk, Freshdesk o Gorgias y aprende de tus documentos y tickets anteriores; después, sigue las reglas de derivación que escribes en inglés corriente. El precio se basa en planes fijos de créditos en lugar de facturación por token, así que la factura no fluctúa cuando un modelo decide pensar más. Si quieres ver cómo se comparan los costos en conjunto, mi guía del costo por resolución hace las cuentas, y el artículo sobre el mejor modelo de IA para soporte compara los motores que hay detrás.

SE Ranking es un buen ejemplo de cómo se ve esto en producción. Gestiona tres productos (SE Ranking, Planable y SE Visible) desde un solo equipo de Zendesk, con un agente de eesel por producto. Cada agente busca en unas 16,800 páginas de contenido del centro de ayuda y del sitio web, responde al chat en vivo en el idioma del cliente y deriva los reembolsos, las ampliaciones de prueba y las consultas de nivel 2 a una persona con los detalles adjuntos. Entre el 8 de agosto y el 8 de septiembre de 2026, gestionó unas 4,650 conversaciones, y nada de eso dependió de qué modelo encabezara una clasificación esa semana.
Si te gusta el enfoque de Kimi centrado en la terminal, la CLI de eesel lleva lo mismo al soporte. Puedes revisar el trabajo reciente del compañero con eesel activity y aprobar o rechazar acciones pendientes con eesel approvals, además de editar sus reglas permanentes con eesel instructions. La salida es JSON y los comandos de escritura admiten --dry-run, así que los scripts y agentes de programación como Claude Code pueden manejarlo de forma segura.
También hay un servidor MCP, y explico el enfoque general en mi guía de la CLI para agentes de IA.
Prueba eesel
Si estás evaluando el precio de Kimi K3.1 Pro para dar soporte, prueba la versión en la que otra persona ya hizo el desarrollo. eesel incorpora a tu plataforma de soporte un compañero de IA listo para trabajar en cuestión de minutos y lo entrena con tus tickets anteriores; además, te permite probarlo con la cola de la semana pasada antes de que responda a nadie. Prueba eesel gratis, o compara primero las opciones en mi lista de los mejores compañeros de IA.
Preguntas frecuentes
¿Cuánto cuesta Kimi K3.1 Pro?
En la API de Kimi, Kimi K3.1 Pro cuesta 2 $ por millón de tokens de entrada, 0,20 $ por millón de tokens de entrada en caché y 10 $ por millón de tokens de salida. No hay recargo por contexto largo en toda la ventana de 1M de tokens. Mi análisis general de Kimi K3.1 Pro cubre el modelo en sí.
¿Cuánto cuesta Kimi K3.1 Pro Highspeed?
Kimi K3.1 Pro Highspeed cuesta 4 $ de entrada y 20 $ de salida por millón de tokens, exactamente el doble que el modelo estándar, para ofrecer aproximadamente entre 2 y 3 veces más velocidad. La entrada en caché se mantiene en 0,20 $. En los planes de Kimi para particulares, Highspeed requiere el plan Pro o superior y consume créditos al doble de velocidad.
¿Es Kimi K3.1 Pro más barato que Kimi K3?
Por token, sí: K3.1 Pro cuesta 2 $/10 $ frente a los 3 $/15 $ de los precios de Kimi K3, un tercio menos. Por tarea, el costo es casi igual, porque K3.1 Pro escribe más. Artificial Analysis lo sitúa en 2,11 $ por tarea media frente a los 2,00 $ de K3, con una puntuación 11.5 puntos superior.
¿Qué plan de Kimi necesito para Kimi K3.1 Pro?
El modelo estándar Kimi K3.1 Pro está disponible en el plan Plus (19 $/mes) y superiores, y Highspeed requiere Pro (39 $/mes) o superior. Kimi Code comparte la misma cuota que el resto de la suscripción. Compáralo con los precios de Claude Code si estás eligiendo un plan para programar.
¿Tiene Kimi K3.1 Pro un nivel gratuito o un descuento por procesamiento por lotes?
No. La API se desbloquea tras una recarga mínima de 1 $, y el descuento del 60 % de Batch API solo cubre los modelos K2 anteriores por ahora. Si necesitas una forma de experimentar sin costo, mi recopilación de API de IA gratuitas enumera las opciones actuales.
¿Es Kimi K3.1 Pro más barato que Claude?
A precio de tarifa, iguala los precios de Claude Sonnet 5.5 de 2 $/10 $ y cuesta la mitad que Claude Opus 5.5. Por tarea, es mucho más barato que ambos con el esfuerzo máximo: 2,11 $ frente a 5,46 $ de Sonnet 5.5 y 5,98 $ de Opus 5.5 según Artificial Analysis.
¿Cuánto cuesta Kimi K3.1 Pro para un bot de atención al cliente?
Para 10.000 respuestas al mes, cada una con un prompt de 6.000 tokens en caché, 2.000 tokens de entrada nuevos y 1.500 tokens de salida, los precios de Kimi K3.1 Pro se traducen en unos 202 $ al mes en tokens. La conexión con la plataforma de soporte, las pruebas y las reglas de transferencia se suman a ese costo. Un compañero de atención al cliente con IA listo para usar como eesel incluye esa capa.