

En resumen
La alternativa más parecida a Kimi K3.1 Pro es Claude Sonnet 5.5: los mismos 2 $/10 $ por millón de tokens, unas tres veces más velocidad de salida y una puntuación casi idéntica en las pruebas comparativas. Gemini 4 Argon también cuesta 2 $/10 $, pero solo hasta el 30 de noviembre de 2026; después, el precio se duplica.
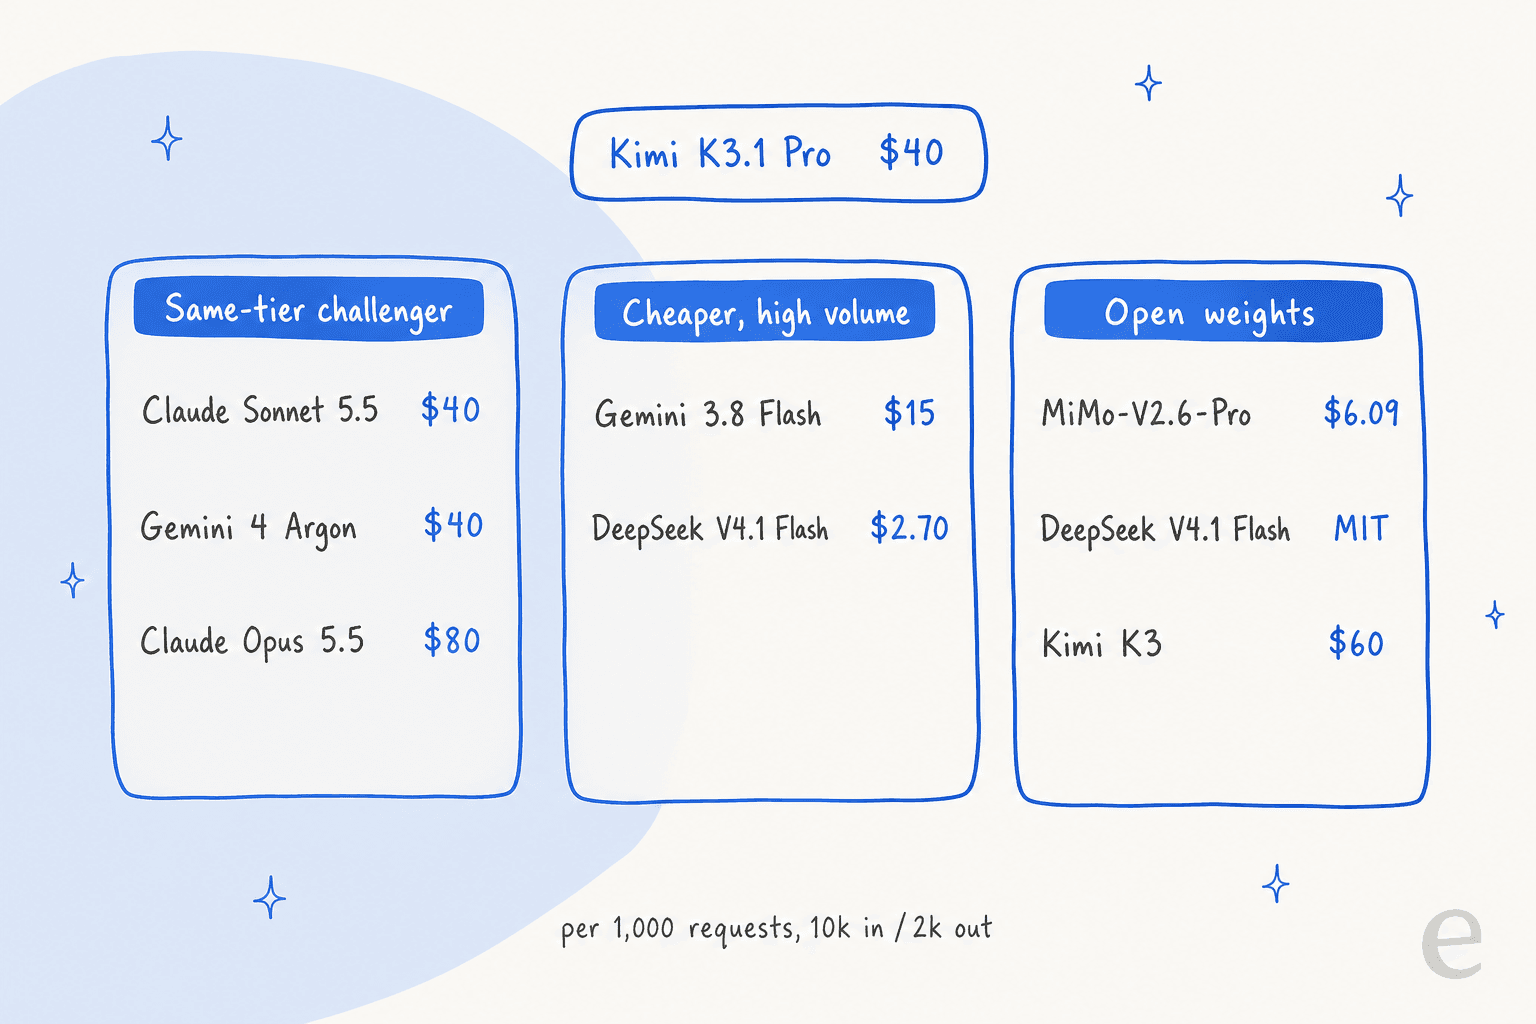
Si el problema es tu factura, las opciones más baratas son Gemini 3.8 Flash (unos $15 por 1.000 solicitudes típicas frente a los $40 de Kimi) y DeepSeek V4.1 Flash (unos $2.70 fuera de las horas punta). Si buscas pesos abiertos que puedas descargar hoy, tanto DeepSeek V4.1 Flash como MiMo-V2.6-Pro tienen licencia MIT.
La sorpresa es Claude Opus 5.5: el doble de precio de lista, pero más barato por tarea completada con esfuerzo High (1,82 $ frente a 2,11 $ en Artificial Analysis). Y si el modelo va a responder tickets de soporte, quizá no necesites elegir ninguno: un compañero de soporte con IA como eesel ya funciona con modelos de vanguardia y primero se prueba con tus tickets anteriores.
¿Por qué buscar más allá de Kimi K3.1 Pro?
Kimi K3.1 Pro es un modelo muy bueno, y quiero decirlo antes que nada. Obtiene 55.1 en el Intelligence Index de Artificial Analysis, en el puesto #4 de 215, a 2 $ de entrada y 10 $ de salida por millón de tokens en la API de Kimi. En Terminal-Bench 4.0 registró la puntuación más alta de todos los modelos de esa página, un 67,2 %.
Entonces, ¿por qué hay gente buscando alternativas una semana después del lanzamiento? Por lo que leí en los hilos del lanzamiento y en las cifras, hay cuatro razones que se repiten una y otra vez:
- Es lento. Artificial Analysis midió 49.7 tokens de salida por segundo frente a una mediana de 83.1 entre modelos comparables, lo que lo sitúa en el puesto #165 de 182 en velocidad. Un usuario que espera una respuesta en el chat lo nota.
- Escribe mucho. Usó 148M tokens de salida para completar el índice frente a una mediana de unos 87M entre modelos comparables, así que el bajo precio por token termina repercutiendo en la factura. Su costo medio por tarea del índice es de
$2.11, algo más que los$2.00de Kimi K3. - Los pesos aún no están disponibles. La guía de inicio rápido de K3.1 Pro de Moonshot dice que se publicarán a más tardar el 4 de noviembre. El día que lo comprobé, no había ningún repositorio de K3.1 Pro en Hugging Face.
- Menos formas de contratarlo. La API por lotes de Kimi no incluye K3.1 Pro, y los planes para consumidores alcanzan rápidamente sus límites de 5 horas, como explicó un comprador:
"If you are expecting any sort of usable limits on their subscription plan I suggest adjusting your expectations. I subscribed to $99 a month plan and within 47 minutes with one session (not asking for swarms or anything) was limited by 5-hour quota."

Ninguna de estas razones es decisiva por sí sola. Pero cada una apunta a una alternativa distinta, y por eso organicé esta lista según el motivo por el que quieres cambiar, no según una única clasificación. Mi análisis de Kimi K3.1 Pro incluye todos los resultados si aún estás decidiendo si realmente te conviene cambiar.
¿Cómo los comparé?
Desarrollo agentes de IA en eesel, donde el equipo lleva años poniendo modelos de vanguardia a trabajar en colas de soporte reales. La lección que se me quedó grabada: el precio por token no te dice casi nada sobre la factura. Lo que importa es el costo por tarea resuelta correctamente, es decir, el gasto total en un lote de tareas reales dividido entre las tareas que se resolvieron bien. Un modelo que cuesta la mitad según su precio de lista pero escribe el doble de tokens, o falla en una de cada cuatro tareas, no es más barato.
Así que, para cada alternativa, revisé tres cifras:
- Precio de lista, tomado únicamente de la página de precios o la documentación del propio proveedor.
- Costo por 1.000 solicitudes para una llamada típica de 10.000 tokens de entrada y 2.000 tokens de salida, sin caché. Este es un mínimo, porque los modelos de razonamiento suelen escribir mucho más de 2.000 tokens.
- Costo por tarea y puntuación en el Intelligence Index de Artificial Analysis, que somete a todos los modelos a las mismas 10 evaluaciones. Es la aproximación pública más cercana al costo por tarea resuelta correctamente.
Agrupé las siete opciones en tres categorías, tal como suele planteárselo la mayoría de los compradores: un competidor del mismo nivel a un precio similar al de Kimi, un modelo más barato para grandes volúmenes y pesos abiertos que puedes alojar por tu cuenta.
Alternativas a Kimi K3.1 Pro de un vistazo
Todos los precios que aparecen a continuación proceden de la página del propio proveedor. Las columnas de pruebas comparativas, velocidad y costo por tarea proceden de Artificial Analysis, con el nivel de esfuerzo indicado entre paréntesis.
| Modelo | Categoría | Entrada / salida por 1M | Entrada en caché por 1M | Contexto | Salida máxima | Por 1.000 solicitudes (10k entrada / 2k salida) | AA Intelligence Index | Costo por tarea de AA | Velocidad de salida (t/s) | Pesos |
|---|---|---|---|---|---|---|---|---|---|---|
| Kimi K3.1 Pro (referencia) | No aplica | 2 $ / 10 $ | 0,20 $ | 1M | 131K por defecto, hasta 1M | 40 $ | 55.1 | 2,11 $ | 49.7 | Prometidos a más tardar el 4 de noviembre |
| Claude Sonnet 5.5 | Mismo nivel | 2 $ / 10 $ | 0,10 $ | 1M | 128K | 40 $ | 56.0 (Max), 51.9 (Xhigh) | 5,46 $ (Max), 2,01 $ (Xhigh) | 141.3 (Max) | Cerrados |
| Gemini 4 Argon | Mismo nivel | 2 $ / 10 $ hasta el 30 de noviembre, después 4 $ / 20 $ | 0,10 $, después 0,20 $ | 1M | 65K por defecto, hasta 1M | 40 $, después 80 $ | 52.6 (High) | 1,62 $ (High) | 79.7 (High) | Cerrados |
| Claude Opus 5.5 | Mismo nivel, prémium | 4 $ / 20 $ | 0,20 $ | 1M | 128K | 80 $ | 57.6 (Max), 53.6 (High) | 5,98 $ (Max), 1,82 $ (High) | 98.1 (Max) | Cerrados |
| Gemini 3.8 Flash | Más barato | 0,75 $ / 3,75 $ hasta el 31 de diciembre, después 1,50 $ / 7,50 $ | 0,075 $, después 0,15 $ | 1M | 65K | 15 $, después 30 $ | 41 (High) | No disponible | 133.7 (High) | Cerrados |
| DeepSeek V4.1 Flash | Más barato, abierto | 0,15 $ / 0,60 $ fuera de horas punta, 0,30 $ / 1,20 $ en horas punta | 0,003 $ fuera de horas punta | 1M | 384K | 2,70 $ fuera de horas punta, 5,40 $ en horas punta | 45.1 (Max) | 0,26 $ (Max) | 169.3 (Max) | MIT |
| MiMo-V2.6-Pro | Pesos abiertos | 0,435 $ / 0,87 $ | 0,0036 $ | 1M | No indicado | 6,09 $ | 46.3 | Unos 0,14 $ | 54.7 | MIT |
| Kimi K3 | Abierto, misma familia | 3 $ / 15 $ | 0,30 $ | 1M | 131K por defecto, hasta 1M | 60 $ | 43.6 (Max) | 2,00 $ (Max) | 54.5 (Max) | Licencia Kimi K3 |
Hay dos cosas que llaman la atención. Primero, la categoría del mismo nivel está muy concurrida: tres modelos comparten el precio de Kimi de 40 $ por 1.000 solicitudes, al menos por ahora. Segundo, la columna de costo por tarea cambia el orden de la lista. Tanto Opus 5.5 en High como Gemini 4 Argon en High completan una tarea media por menos que Kimi K3.1 Pro, aunque Opus cuesta el doble por token.
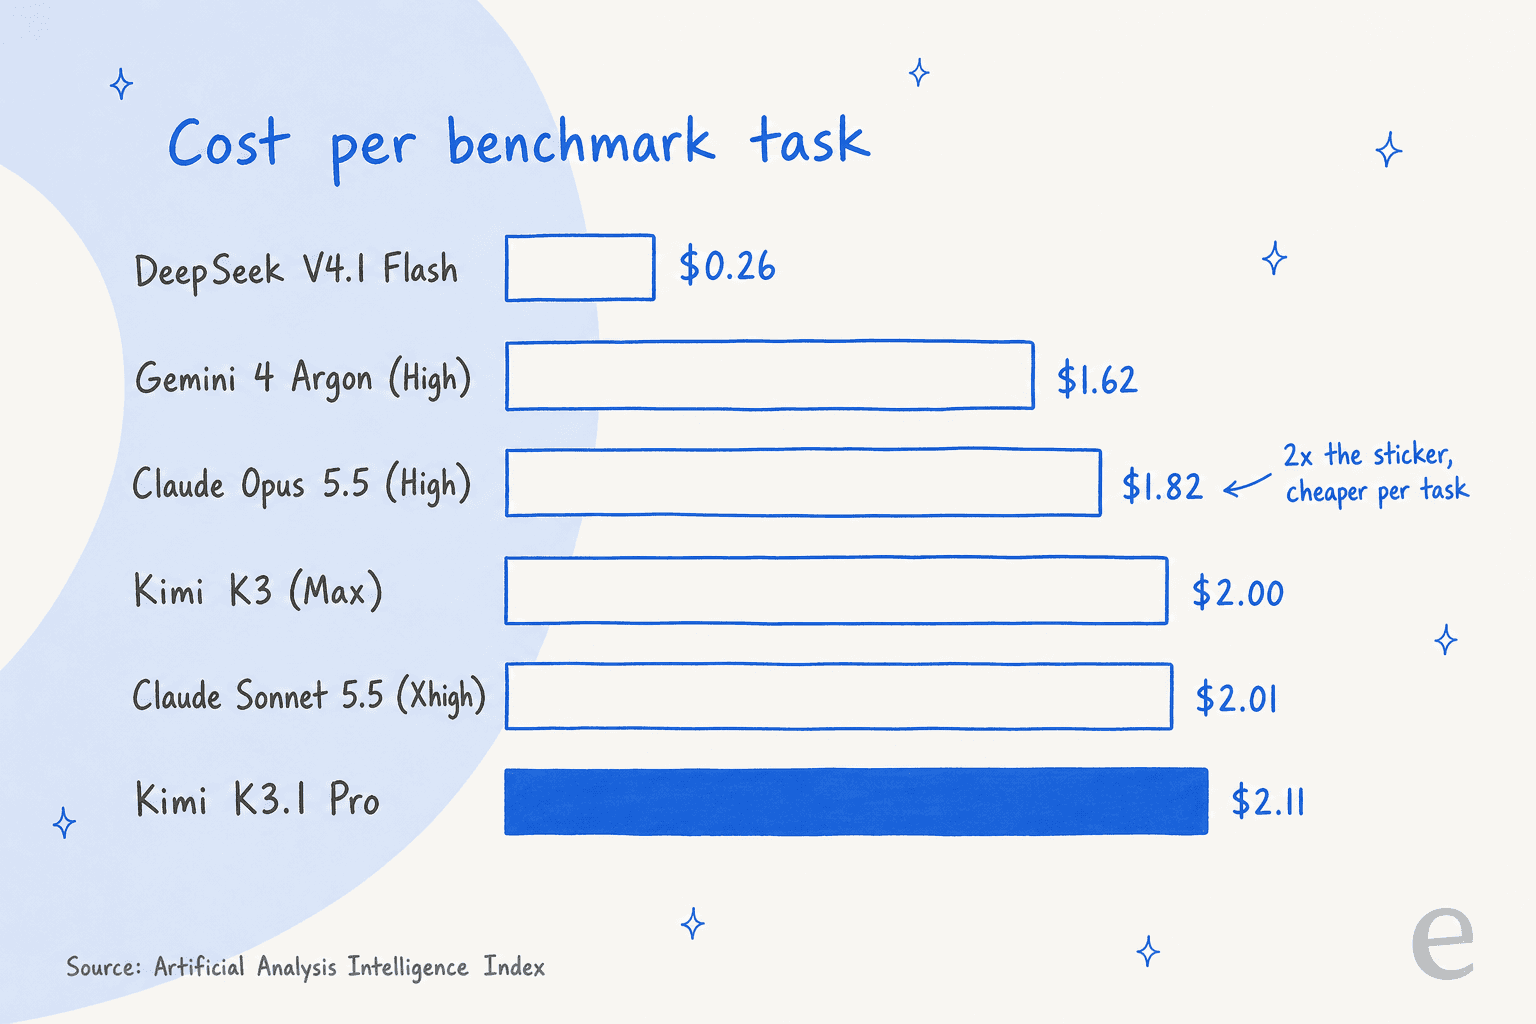
Una salvedad sobre ese gráfico: Kimi K3.1 Pro se ejecutó con su esfuerzo máximo predeterminado, mientras que Opus y Argon se ejecutaron en High. Pero esa es precisamente la idea. El esfuerzo es un parámetro que puedes ajustar, y la respuesta buena más barata suele venir de un modelo más potente con un ajuste inferior.
¿Qué alternativa encaja con tu producto?
Elige la tarea que realiza tu producto y la tarjeta te mostrará por dónde empezaría yo la comparación.
Elige una tarea para ver el modelo que probaría primero frente a Kimi K3.1 Pro, con su costo por 1.000 solicitudes de 10k tokens de entrada y 2k de salida.
1. Claude Sonnet 5.5
Ideal para: equipos que quieren el precio de Kimi con una salida más rápida y estable. Competidor del mismo nivel.
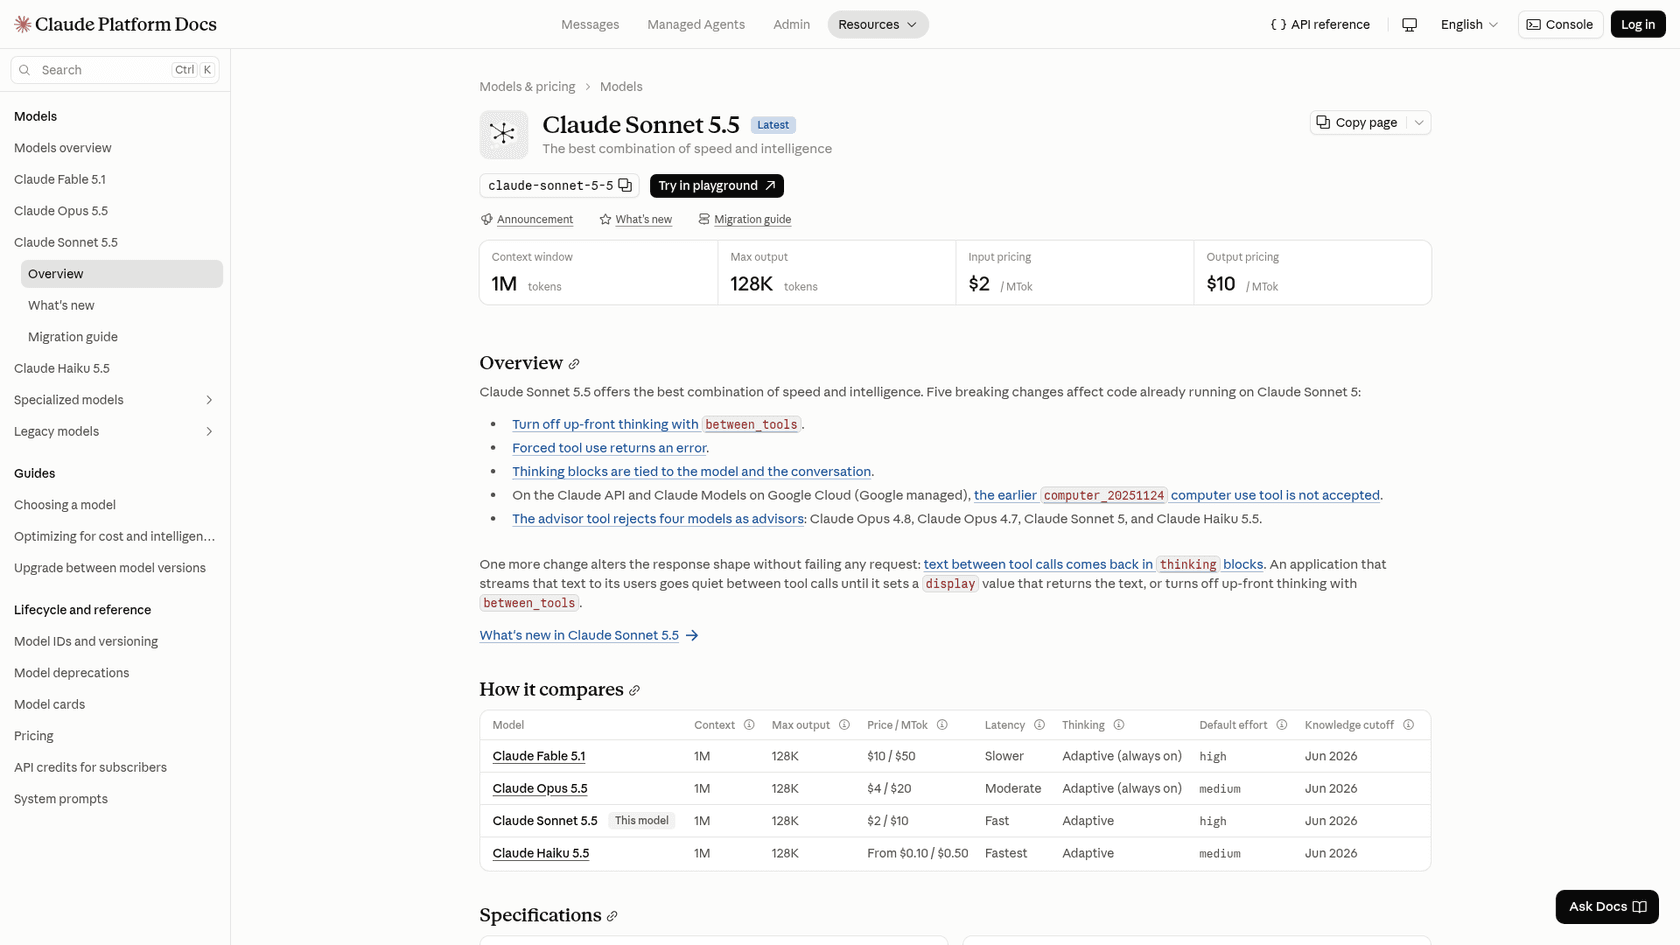
Claude Sonnet 5.5 es el sustituto más directo de esta lista. Anthropic le pone exactamente el mismo precio de lista que a Kimi K3.1 Pro, 2 $ de entrada y 10 $ de salida por millón de tokens, con una ventana de contexto de 1M y una salida máxima de 128K, según su descripción general del modelo.
Por qué elegirlo en lugar de Kimi K3.1 Pro
- Velocidad. Artificial Analysis midió 141.3 tokens por segundo con esfuerzo máximo, frente a los 49.7 de Kimi.
- Una puntuación ligeramente superior. 56.0 en el Intelligence Index en Max, frente a 55.1.
- Lecturas de caché más baratas. La página de precios de Anthropic cobra 0,10 $ por millón de tokens de entrada en caché en Sonnet 5.5, la mitad de los 0,20 $ de Kimi. En un bot de soporte con un prompt del sistema largo y estable, eso se acumula.
- Procesamiento por lotes. Sonnet 5.5 funciona a 1 $ / 5 $ en la API por lotes de Anthropic. La API por lotes de Kimi no incluye K3.1 Pro.
Una persona que comentó en el hilo del lanzamiento de K3.1 ejecutó ambos modelos en su propia prueba comparativa y encontró un empate en calidad:
"Kimi K3.1 Pro ties Sonnet 5.5 at 93, for $0.68 and 11 min vs Sonnet's $1.61 and 14 min."
En qué se queda corto
Sonnet 5.5 escribe mucho con esfuerzo máximo. Usó 416M tokens de salida para completar el índice, así que su costo por tarea en Max es de $5.46, más del doble que el de Kimi. En Xhigh, la puntuación baja a 51.9 y el costo a $2.01. También introdujo cinco cambios que rompen el código existente: el uso forzado de herramientas devuelve un error y el razonamiento no se puede desactivar de la forma anterior, según la página de descripción general. Si tu bot de soporte depende de forzar una llamada a una herramienta, comprueba eso primero.
Precios
| Concepto | Precio por 1M tokens |
|---|---|
| Entrada | 2 $ |
| Salida | 10 $ |
| Lectura de caché | 0,10 $ |
| Escritura en caché de 5 minutos | 2,50 $ |
| Escritura en caché de 1 hora | 4 $ |
| Entrada / salida por lotes | 1 $ / 5 $ |
El desglose completo está en mi guía de precios de Sonnet 5.5.
Mi opinión
Elige Sonnet 5.5 si la velocidad de Kimi es la razón por la que quieres cambiar, y ejecútalo por debajo del esfuerzo máximo. Descártalo si tu carga de trabajo consiste en ejecuciones largas de agentes con esfuerzo máximo, donde la menor cantidad de tokens de Kimi gana en la factura. El análisis de Sonnet 5.5 explica en detalle el equilibrio entre esfuerzo y costo.
2. Gemini 4 Argon
Ideal para: tareas con contexto largo y sensibles a la precisión al precio de Kimi, si cambias antes de diciembre. Competidor del mismo nivel.
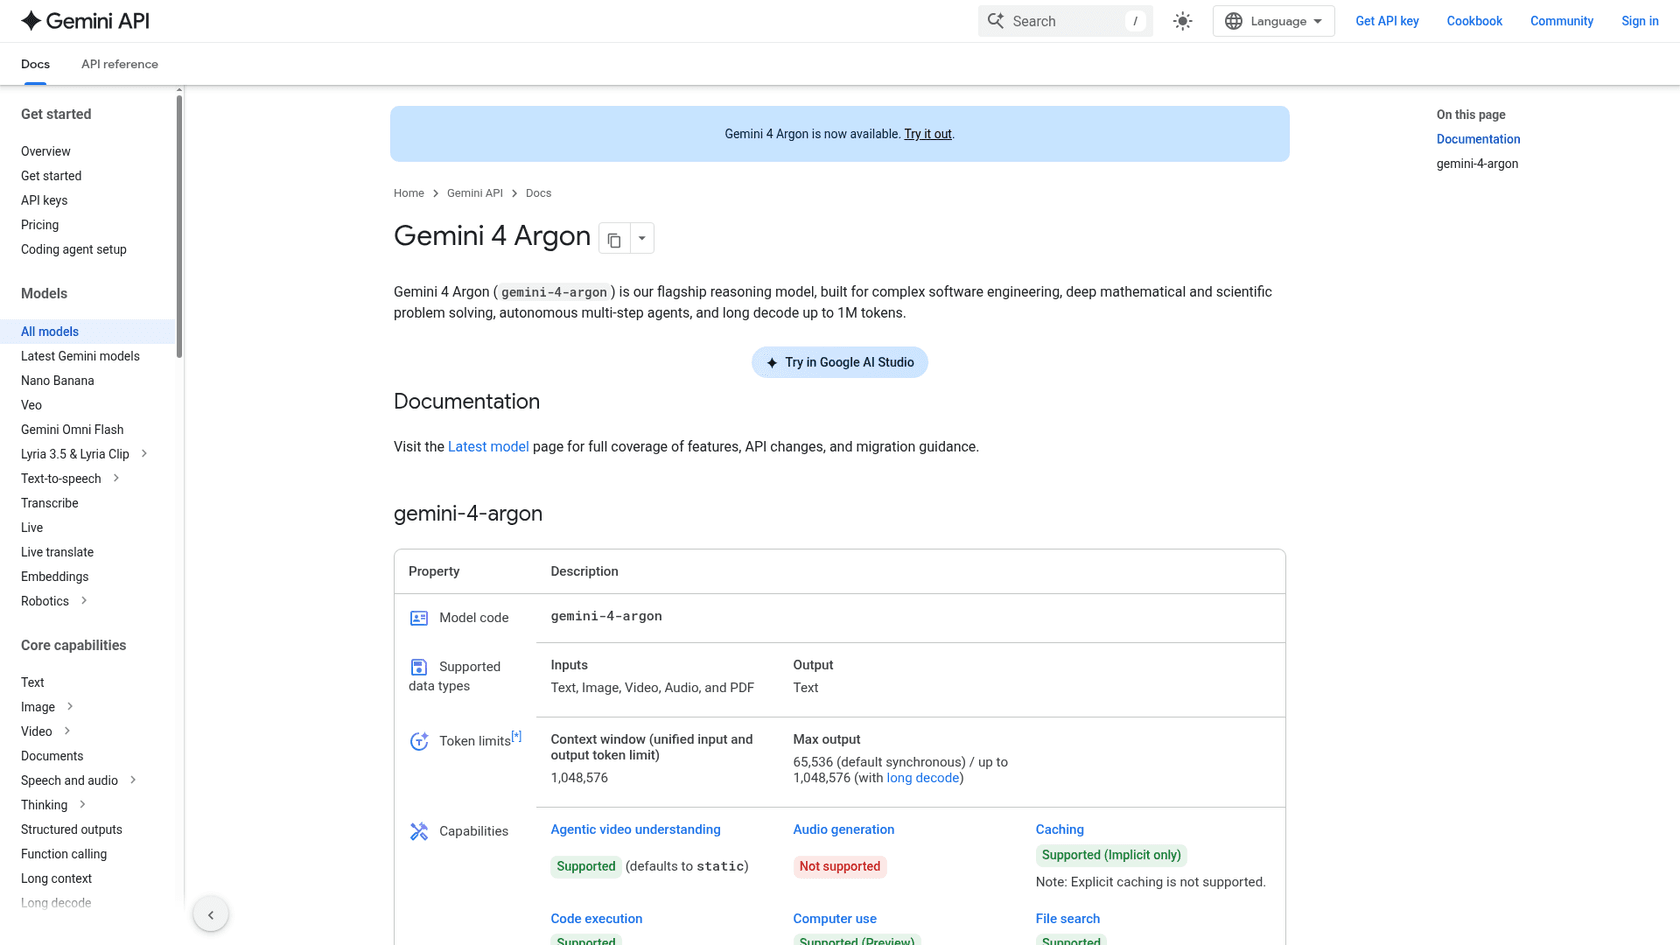
Gemini 4 Argon es el modelo insignia de razonamiento de Google y ya está disponible en la API de Gemini. Durante las próximas semanas cuesta exactamente lo mismo que Kimi K3.1 Pro, lo que lo convierte en la opción del mismo nivel más fácil de probar.
Por qué elegirlo en lugar de Kimi K3.1 Pro
- Menos respuestas inventadas. Artificial Analysis sitúa su tasa de alucinaciones en 15,1 %, frente al 43,9 % de Kimi K3.1 Pro. Para cualquier cosa de cara al cliente, esa sería la cifra que más me importaría.
- Más barato por tarea. Con esfuerzo High promedió
$1.62por tarea del índice con una puntuación de 52.6. - Salida larga. Su página del modelo indica 65.536 tokens de salida por defecto y hasta 1.048.576 con decodificación larga.
- Tus datos quedan fuera del entrenamiento. La página de precios de Google dice que el uso del nivel de pago no se utiliza para mejorar sus productos.
En qué se queda corto
El precio es promocional. Google indica 2 $ / 10 $ hasta el 30 de noviembre de 2026 y 4 $ / 20 $ a partir del 1 de diciembre, lo que lo sitúa al precio de lista de Opus 5.5. No admite caché explícita, solo implícita, y no hay nivel gratuito. Su puntuación en el índice, 52.6 en High, está 2.5 puntos por debajo de la de Kimi.
Precios
| Concepto | Hasta el 30 de noviembre de 2026 | Desde el 1 de diciembre de 2026 |
|---|---|---|
| Entrada por 1M | 2 $ | 4 $ |
| Salida por 1M (incl. razonamiento) | 10 $ | 20 $ |
| Entrada en caché por 1M | 0,10 $ | 0,20 $ |
| Entrada / salida por lotes por 1M | 1 $ / 5 $ | 2 $ / 10 $ |
| Fundamentación con búsqueda | 5.000 gratis al mes, después 14 $ por 1.000 | Igual |
Más detalles en mi artículo sobre precios de Gemini 4 Argon.
Mi opinión
Elige Argon si las respuestas incorrectas son tu mayor riesgo, y calcula el costo con la tarifa de diciembre para evitar sorpresas. Descártalo si necesitas un precio fijo para el próximo año. El análisis de Gemini 4 Argon profundiza en dónde lleva ventaja y dónde se queda atrás.
3. Claude Opus 5.5
Ideal para: las tareas de programación y de agentes más difíciles, donde una ejecución fallida cuesta más que los tokens. Competidor prémium del mismo nivel.
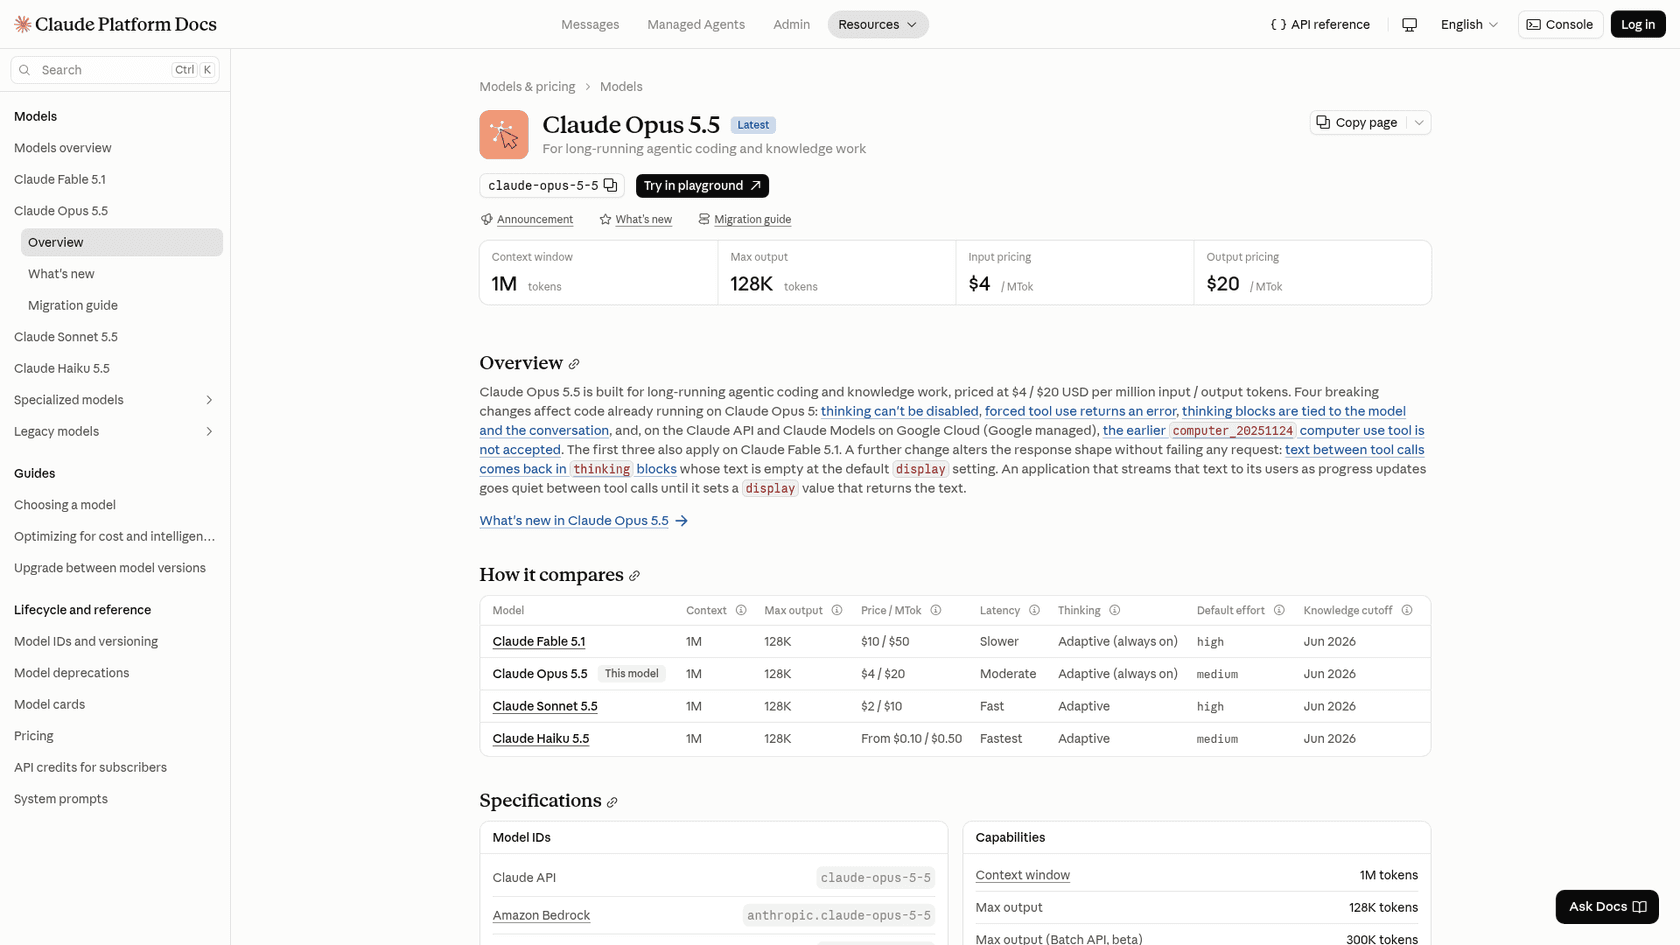
Claude Opus 5.5 es el modelo con el que se mide Kimi K3.1 Pro. La propia descripción general de modelos de Anthropic ahora recomienda a los desarrolladores empezar con él para la mayoría de las cargas de trabajo, y su esfuerzo predeterminado es medio.
Por qué elegirlo en lugar de Kimi K3.1 Pro
- La puntuación más alta de esta lista. 57.6 en el Intelligence Index en Max, la más alta de la comparación de Artificial Analysis.
- Más barato por tarea en High. 53.6 por
$1.82por tarea, menos que los$2.11de Kimi. - Quienes lo usan a diario siguen valorándolo por encima. En X, una persona que los probó comparó ambos en 180 pinturas creadas con código:
"I feel Opus still nails the subtle details better, like in the tractor example below. But I wonder if it matters when you can run Kimi 3x before it costs the same as one Opus?"
En qué se queda corto
En Max, Opus es la opción más cara: $5.98 por tarea y 8.708 $ para completar todo el índice, frente a los 3.117 $ de Kimi. Su tasa de alucinaciones en Max es del 58,6 % en Artificial Analysis, superior al 43,9 % de Kimi. Y las propias cifras de lanzamiento de Kimi lo sitúan a menos de un punto en Terminal-Bench 4.0 (65,7 % frente a 66,4 %).
Precios
| Concepto | Precio por 1M tokens |
|---|---|
| Entrada | 4 $ |
| Salida | 20 $ |
| Lectura de caché | 0,20 $ |
| Escritura en caché de 5 minutos | 5 $ |
| Escritura en caché de 1 hora | 8 $ |
| Entrada / salida por lotes | 2 $ / 10 $ |
| Entrada / salida en modo rápido | 8 $ / 40 $ |
Todo procede de la página de precios de Anthropic. El artículo sobre precios de Opus 5.5 analiza facturas reales.
Mi opinión
Elige Opus 5.5 en High cuando la calidad por ejecución sea el factor limitante y puedas configurar el esfuerzo por tu cuenta. Descártalo si tu tráfico es de gran volumen y sencillo, porque estarías pagando por un razonamiento que no utilizas. Mi análisis de Opus 5.5 repasa cada nivel de esfuerzo.
4. Gemini 3.8 Flash
Ideal para: tráfico de API de gran volumen en el que la respuesta no tiene que llegar en dos segundos. Categoría de opciones más baratas.
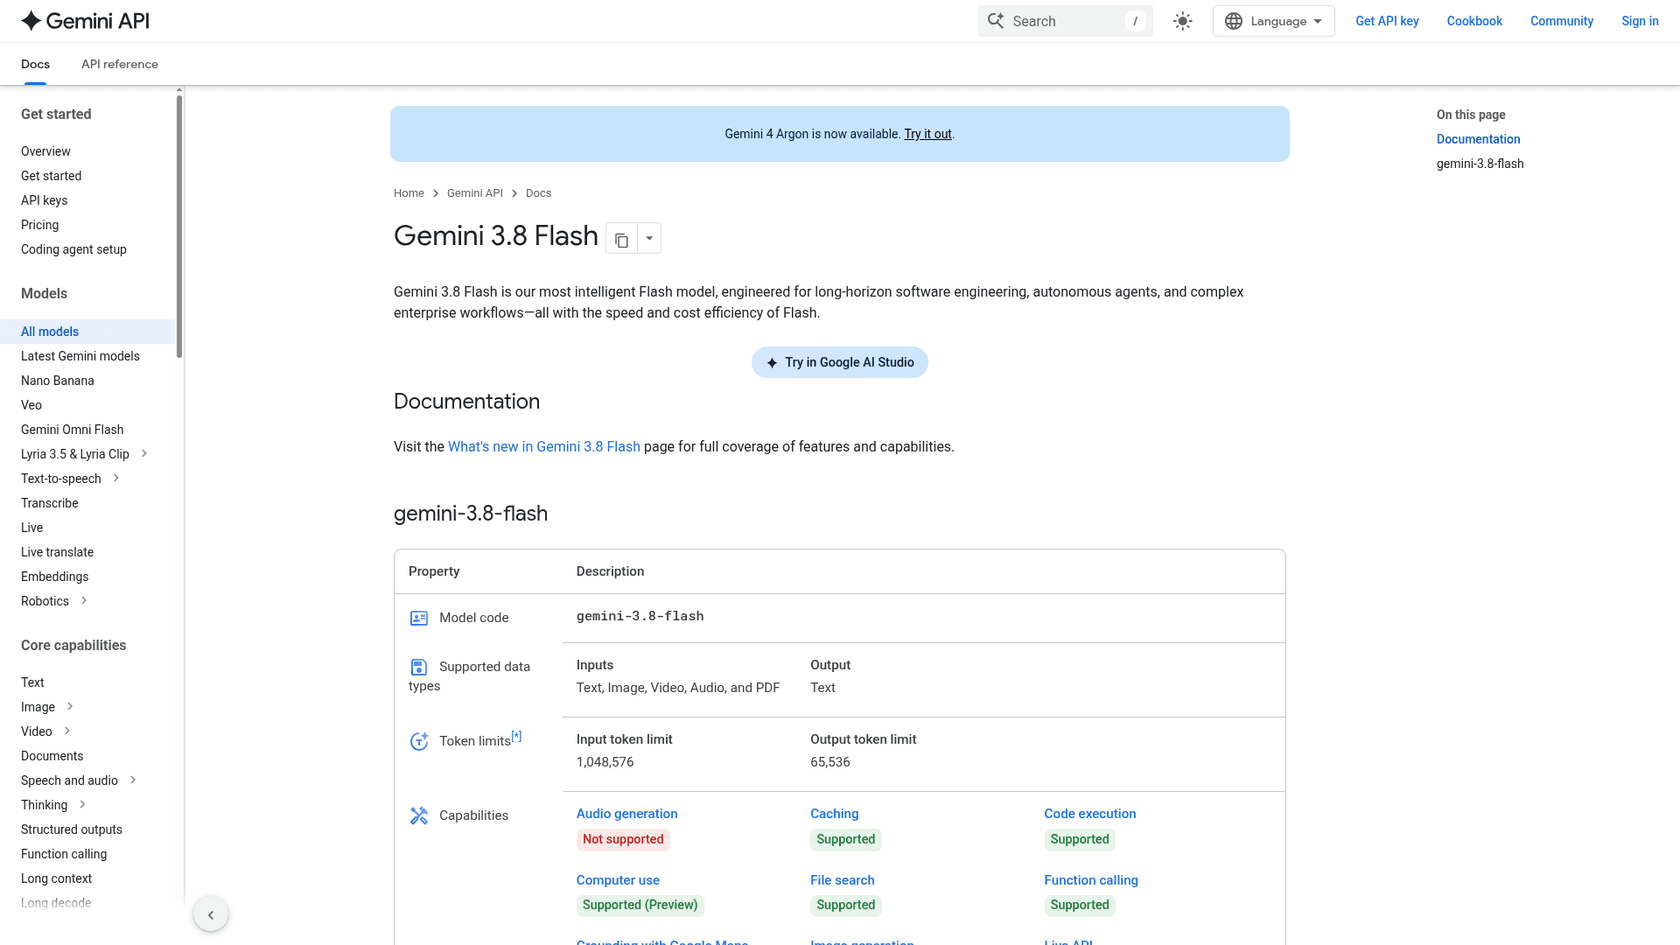
Gemini 3.8 Flash es el modelo cerrado más barato de esta lista. En la página de precios de la API de Gemini cuesta 0,75 $ de entrada y 3,75 $ de salida por millón de tokens, incluidos los tokens de razonamiento, hasta el 31 de diciembre de 2026.
Por qué elegirlo en lugar de Kimi K3.1 Pro
- Aproximadamente un tercio de la factura. Unos
$15por 1.000 solicitudes típicas frente a los$40de Kimi. - Salida rápida. 133.7 tokens por segundo en Artificial Analysis.
- Un nivel gratuito para pruebas y procesamiento por lotes a la mitad del precio de pago.
- Amplia variedad de entradas. Admite texto, imagen, video, audio y PDF, según su página del modelo.
En qué se queda corto
Es un paso atrás en inteligencia: 41 en el Intelligence Index en High, frente a los 55.1 de Kimi. Artificial Analysis también midió un tiempo hasta el primer token de 28.78 segundos, muy por encima de la mediana de 3.90 segundos de su nivel de precios, así que un usuario mirando una ventana de chat lo notará. Y el precio se duplica el 1 de enero de 2027, hasta 1,50 $ / 7,50 $.
Precios
| Concepto | Hasta el 31 de diciembre de 2026 | Desde el 1 de enero de 2027 |
|---|---|---|
| Entrada por 1M | 0,75 $ | 1,50 $ |
| Salida por 1M (incl. razonamiento) | 3,75 $ | 7,50 $ |
| Entrada en caché por 1M | 0,075 $ | 0,15 $ |
| Entrada / salida por lotes por 1M | 0,375 $ / 1,875 $ | 0,75 $ / 3,75 $ |
| Nivel gratuito | Sí | Sí |
Mi artículo sobre precios de Gemini 3.8 Flash incluye ejemplos con los cálculos.
Mi opinión
Elige 3.8 Flash para tareas en segundo plano: etiquetado, resúmenes y agentes que trabajan durante la noche. Descártalo para chat en vivo hasta que hayas medido por tu cuenta la espera hasta el primer token. El análisis de Gemini 3.8 Flash aborda el problema de la latencia.
5. DeepSeek V4.1 Flash
Ideal para: la factura más baja de esta lista, con pesos abiertos como respaldo. Categoría de opciones más baratas y pesos abiertos.
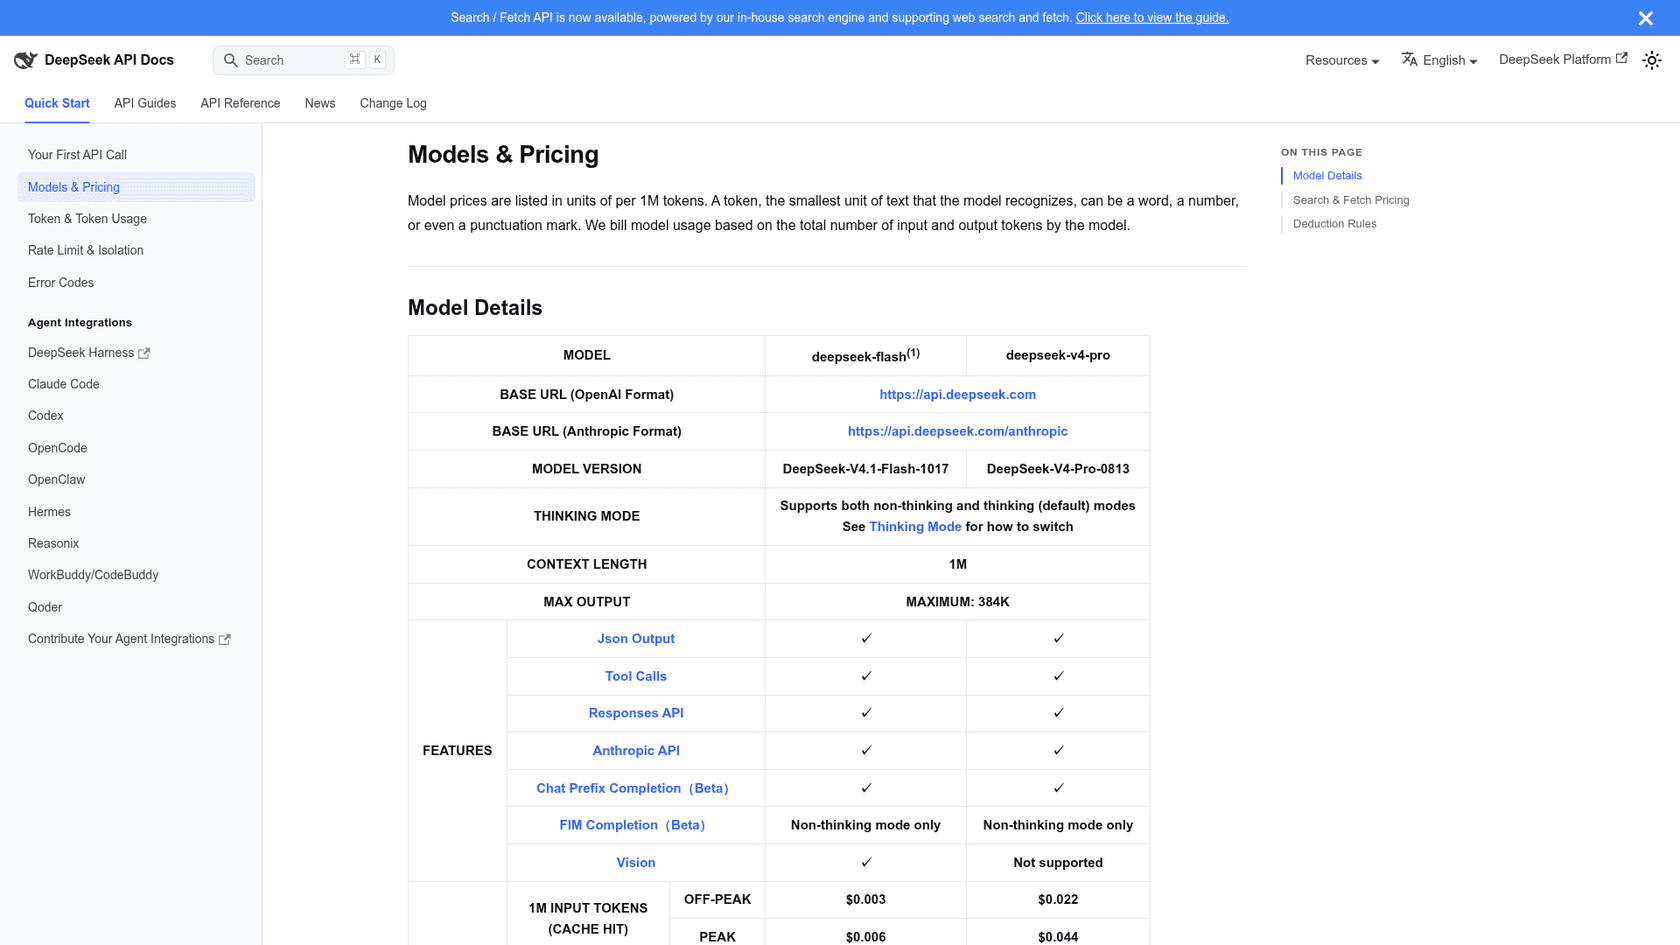
DeepSeek V4.1 Flash marca el precio mínimo de este grupo. En la página de modelos y precios de DeepSeek, el modelo deepseek-flash (ahora la versión 1017) cuesta 0,15 $ de entrada y 0,60 $ de salida por millón de tokens fuera de las horas punta.
Por qué elegirlo en lugar de Kimi K3.1 Pro
- Unas 15x más barato por solicitud. Unos
$2.70por 1.000 solicitudes típicas fuera de las horas punta, frente a$40. - Unas 8x más barato por tarea.
$0.26por tarea de Artificial Analysis, frente a$2.11, con una puntuación de 45.1. - Rápido. 169.3 tokens por segundo, el más rápido de esta lista.
- Pesos abiertos ya disponibles. Con licencia MIT en Hugging Face, unos 763B parámetros.
En la prueba comparativa de corrección de errores reales de una persona que lo probó, incluso terminó por delante:
"So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results: DeepSeek V4.1 Flash 1017 (max): 42.7 Muse Wonder Full 1.0 (max): 42 Opus 5.5 (max): 41.7 Kimi K3.1 Pro (max): 36 Muse Spark 1.3 (max): 32.2 I'm sorry. Considering the cost, I see no reason to use this model."
En qué se queda corto
Su puntuación en el índice está 10 puntos por debajo de la de Kimi, así que las tareas baratas lo son en parte porque las respuestas son más sencillas. Los precios se duplican durante las horas punta (de 01:00 a 04:00 y de 06:00 a 10:00 UTC los días laborables). Y, en cuanto a los datos de clientes, los términos de la API de DeepSeek no publican un acuerdo de tratamiento de datos ni una opción de retención cero, así que pide una revisión legal antes de enviarle tickets de soporte.
Precios
| Concepto | Fuera de horas punta por 1M | En horas punta por 1M |
|---|---|---|
| Entrada, acierto de caché | 0,003 $ | 0,006 $ |
| Entrada, fallo de caché | 0,15 $ | 0,30 $ |
| Salida | 0,60 $ | 1,20 $ |
| API Search o Fetch | 0,75 $ por 1.000 solicitudes | Igual |
Más información en mi guía de precios de DeepSeek V4.1 Flash y en el análisis de la actualización 1017.
Mi opinión
Elige DeepSeek V4.1 Flash para trabajo de gran volumen en el que un modelo de 45 puntos sea suficiente, y deriva las tareas difíciles a otro modelo. Descártalo para datos de clientes sujetos a regulación, a menos que alojes los pesos por tu cuenta.
6. MiMo-V2.6-Pro
Ideal para: pesos abiertos de un segundo proveedor, con un precio de API muy bajo. Categoría de pesos abiertos.
MiMo-V2.6-Pro es el modelo de un billón de parámetros de Xiaomi, publicado con pesos bajo licencia MIT en septiembre. La publicación de lanzamiento de Xiaomi lo describe como el modelo de código abierto más potente disponible en el momento de su lanzamiento, con una puntuación de 46 en el índice de Artificial Analysis.
Por qué elegirlo en lugar de Kimi K3.1 Pro
- Aproximadamente una sexta parte del precio por solicitud. 0,435 $ de entrada y 0,87 $ de salida por millón de tokens según los precios internacionales de Xiaomi, o unos
$6.09por 1.000 solicitudes típicas. - Una factura diminuta para todo el índice. Artificial Analysis gastó unos
$207en ejecutar todo su índice en MiMo-V2.6-Pro, frente a$3,117en Kimi K3.1 Pro. - Pesos que puedes descargar hoy, con licencia MIT, en Hugging Face.
- Una API por lotes a mitad de precio, algo que Kimi no ofrece para K3.1 Pro.
En qué se queda corto
Obtiene 46.3, nueve puntos por debajo de Kimi. Es igual de lento (54.7 tokens por segundo), con un tiempo hasta el primer token de 3.29 segundos. Xiaomi vende un modo UltraSpeed con una salida hasta 20x más rápida, pero a 10x el precio (4,35 $ / 8,70 $). Y con unos 1.02T parámetros, alojarlo por tu cuenta sigue implicando un clúster con varias GPU.
Precios
| Concepto | En tiempo real por 1M | Por lotes por 1M |
|---|---|---|
| Entrada, acierto de caché | 0,0036 $ | 0,0018 $ |
| Entrada, fallo de caché | 0,435 $ | 0,2175 $ |
| Salida | 0,87 $ | 0,435 $ |
| Entrada / salida de UltraSpeed | 4,35 $ / 8,70 $ | No se ofrece |
Más información en mi desglose de precios de MiMo V2.6.
Mi opinión
Elige MiMo-V2.6-Pro si quieres pesos abiertos y una API alojada barata del mismo proveedor, y tus tareas no necesitan un razonamiento al nivel de Kimi. Descártalo para cualquier cosa sensible a la latencia, salvo que pagues por UltraSpeed. El análisis de MiMo V2.6 incluye las pruebas comparativas.
7. Kimi K3
Ideal para: seguir con Moonshot usando pesos que ya son públicos. Pesos abiertos, misma familia.
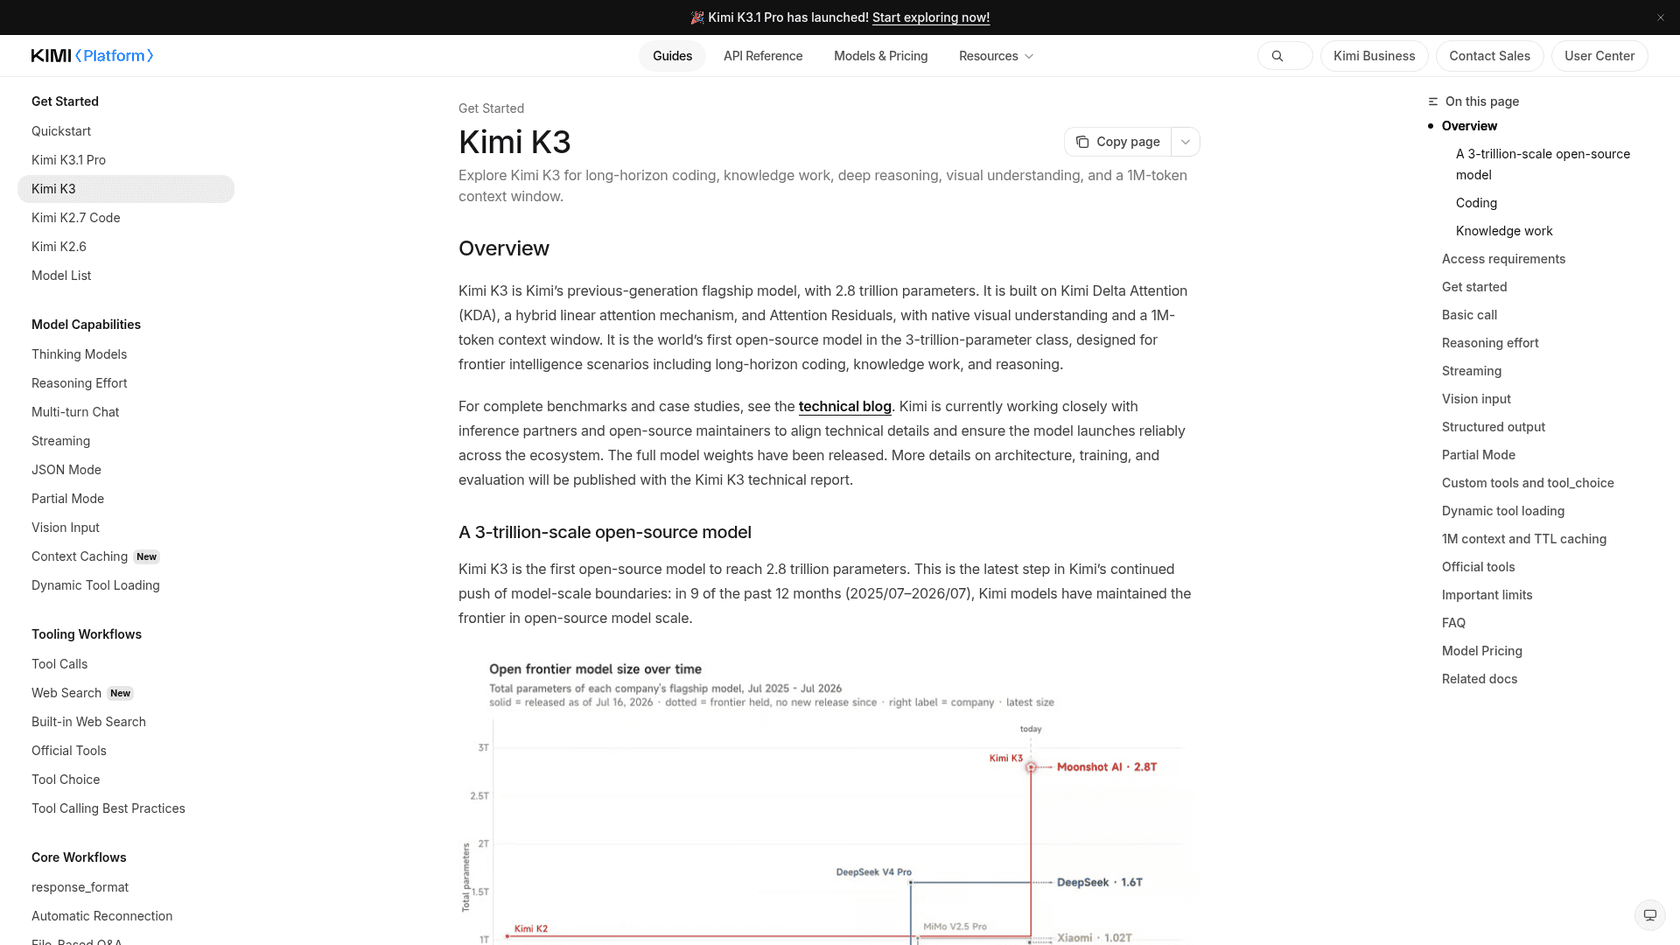
Kimi K3 es el modelo base de K3.1 Pro. La guía de inicio rápido de Moonshot ahora lo llama "previous-generation flagship", y sus pesos ya están en Hugging Face.
Por qué elegirlo en lugar de Kimi K3.1 Pro
- Pesos hoy, no para el 4 de noviembre. Unos 2.78T parámetros en el repositorio público.
- La misma API, las mismas herramientas. Si has desarrollado sobre la API de Kimi, toda la migración consiste en cambiar el ID del modelo.
- El mismo costo por tarea.
$2.00por tarea de Artificial Analysis, frente a$2.11para K3.1 Pro.
En qué se queda corto
Sinceramente, no hay muchos motivos para elegirlo en nuevos proyectos que usen un servicio alojado. Cuesta más por token (3 $ / 15 $), obtiene 43.6 frente a 55.1 y solo logró un 12,6 % en Terminal-Bench 4.0 frente al 67,2 % de K3.1 Pro. Su licencia también añade condiciones para productos muy grandes y empresas de alojamiento de modelos. Si solo necesitas los pesos de K3.1 Pro, esperar una semana o dos probablemente sea la mejor opción.
Precios
| Concepto | Precio por 1M tokens |
|---|---|
| Entrada, fallo de caché | 3 $ |
| Entrada, acierto de caché | 0,30 $ |
| Salida | 15 $ |
| Escritura en caché de 5 minutos | 3 $ |
| Escritura en caché de 1 hora | 6 $ |
De la página de precios de Kimi. Mi artículo sobre precios de Kimi K3 incluye el historial.
Mi opinión
Elige K3 solo si necesitas pesos abiertos de Kimi esta semana. De lo contrario, sigue con K3.1 Pro o elige una de las seis opciones anteriores. El análisis de Kimi K3 y mi comparación entre DeepSeek y Kimi K3 lo abordan con más profundidad.
¿Cuánto cuestan 1.000 solicitudes con cada uno?
Aquí está la misma solicitud típica, 10.000 tokens de entrada y 2.000 de salida sin caché, calculada con la tarifa de lista de cada proveedor. Es la cifra de la que parten la mayoría de las estimaciones de costos.
| Modelo | Entrada / salida por 1M | Costo por solicitud | Costo por 1.000 solicitudes |
|---|---|---|---|
| DeepSeek V4.1 Flash (fuera de horas punta) | 0,15 $ / 0,60 $ | 0,0027 $ | 2,70 $ |
| DeepSeek V4.1 Flash (horas punta) | 0,30 $ / 1,20 $ | 0,0054 $ | 5,40 $ |
| MiMo-V2.6-Pro | 0,435 $ / 0,87 $ | 0,0061 $ | 6,09 $ |
| Gemini 3.8 Flash (hasta el 31 de diciembre) | 0,75 $ / 3,75 $ | 0,015 $ | 15 $ |
| Gemini 3.8 Flash (desde el 1 de enero de 2027) | 1,50 $ / 7,50 $ | 0,030 $ | 30 $ |
| Kimi K3.1 Pro | 2 $ / 10 $ | 0,040 $ | 40 $ |
| Claude Sonnet 5.5 | 2 $ / 10 $ | 0,040 $ | 40 $ |
| Gemini 4 Argon (hasta el 30 de noviembre) | 2 $ / 10 $ | 0,040 $ | 40 $ |
| Kimi K3 | 3 $ / 15 $ | 0,060 $ | 60 $ |
| Claude Opus 5.5 | 4 $ / 20 $ | 0,080 $ | 80 $ |
| Gemini 4 Argon (desde el 1 de diciembre) | 4 $ / 20 $ | 0,080 $ | 80 $ |
| Kimi K3.1 Pro Highspeed | 4 $ / 20 $ | 0,080 $ | 80 $ |
Ahora, la advertencia. Los modelos de razonamiento rara vez se detienen en 2.000 tokens de salida. En el índice de Artificial Analysis, Kimi K3.1 Pro escribió 55.195 tokens de salida por tarea, la mayoría de razonamiento. Por eso la columna de costo por tarea de la tabla resumen importa más que esta, y por eso deberías repetir estos cálculos con tu propio tráfico antes de cambiar.
Así lo haría yo: toma 100 solicitudes reales de tu producto, pásalas por dos o tres de estos modelos y evalúa las respuestas. Después, divide el gasto de cada modelo entre las respuestas que realmente entregarías. Ese es tu costo por tarea resuelta correctamente, y es la única cifra que permite decidir. Mi guía de precios de Kimi K3.1 Pro recorre los mismos cálculos solo para Kimi.
¿Debería un equipo de soporte elegir un modelo?
Si tu producto es un bot de soporte, toda esta lista está un nivel por debajo de lo que necesitas. Un modelo es infraestructura. Lo que responde a tus clientes es todo lo que se construye a su alrededor: qué tickets anteriores lee, qué reglas sigue, cuándo transfiere el caso a una persona y cómo lo compruebas antes de ponerlo en marcha.
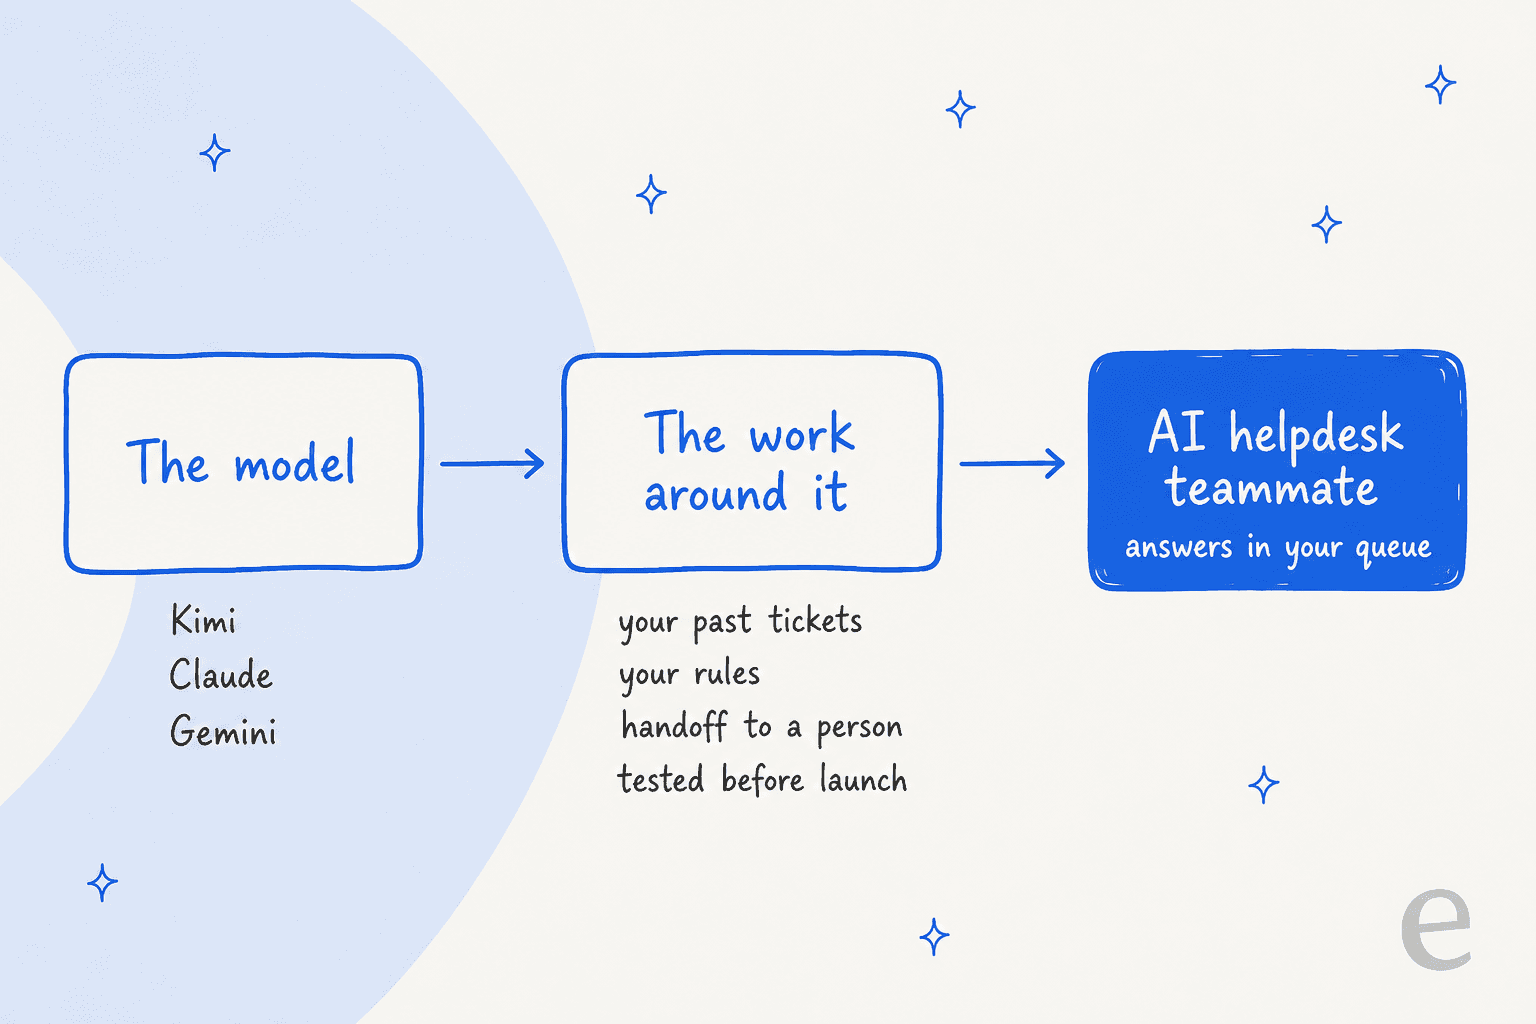
Esa es la parte a la que dedico mis días en eesel. He visto a un modelo dar respuestas fluidas e incorrectas con total seguridad en una cola real, y por eso ahora cada implementación de eesel vuelve a procesar primero cientos de tickets anteriores y compara los borradores con lo que el equipo envió realmente. La elección del modelo sigue importando. Simplemente no es la decisión que determina si un bot de soporte funciona o fracasa.
Qontro, una empresa de ERP de Nueva Zelanda, es un buen ejemplo. Conectó Freshdesk a eesel en julio de 2026 y cargó unos 9.800 tickets anteriores y artículos de ayuda. Entre el 8 de agosto y el 8 de septiembre, eesel redactó respuestas para unos 190 tickets y realizó unas 400 búsquedas de conocimiento durante el proceso. Las interrupciones del servicio, las pérdidas de datos y la facturación pasan directamente a una persona. El equipo compara cada borrador con lo que envió y utiliza las diferencias para corregir el centro de ayuda. Nadie en Qontro tuvo que hacer una comparación entre modelos para llegar a ese punto.
Para los desarrolladores que prefieren seguir en una terminal, la CLI de eesel permite manejar al mismo compañero. npx @eesel/cli init chat-bubble --site https://your-site.com configura un agente con una burbuja de chat en el sitio web que lee tus páginas, y eesel chat te permite probarlo desde la línea de comandos. Cada comando imprime JSON, así que un agente de programación como Claude Code o Cursor puede hacer la configuración por ti. Mi artículo sobre CLI de agentes de IA explica por qué eso importa.
Prueba eesel para tu cola de soporte
Si estabas valorando Kimi K3.1 Pro o uno de estos modelos para responder tickets de clientes, prueba primero la otra vía. eesel es un compañero de soporte con IA que se incorpora a tu plataforma de soporte actual, aprende de tus tickets anteriores y tu centro de ayuda, y se prueba con tu historial antes de responder a nadie. Funciona con Freshdesk, Zendesk y otros, y el plan gratuito incluye 100 créditos, donde un ticket o chat equivale a un crédito (consulta los precios).
Prueba eesel gratis, o lee cómo lo usan los equipos en el soporte para SaaS. Para una visión más amplia de la categoría, mi selección del mejor software de soporte con IA compara las principales opciones.
Preguntas frecuentes
¿Cuál es la mejor alternativa a Kimi K3.1 Pro?
Para la mayoría de los equipos es Claude Sonnet 5.5: los mismos 2 $ de entrada y 10 $ de salida por millón de tokens, aproximadamente el triple de velocidad de salida en Artificial Analysis y una puntuación del índice ligeramente superior con el esfuerzo máximo. Si el coste por tarea completada importa más que el precio de lista, prueba Claude Opus 5.5 con el nivel de esfuerzo High, que Artificial Analysis midió en 1,82 $ por tarea frente a 2,11 $ para Kimi K3.1 Pro. El análisis completo de Sonnet 5.5 tiene los detalles.
¿Hay una alternativa más barata a Kimi K3.1 Pro?
Sí. DeepSeek V4.1 Flash cuesta 0,15 $ de entrada y 0,60 $ de salida por millón de tokens fuera de las horas punta, lo que equivale a unos 2,70 $ por 1.000 solicitudes de 10.000 tokens de entrada y 2.000 de salida, frente a 40 $ para Kimi K3.1 Pro. Gemini 3.8 Flash cuesta unos 15 $ por las mismas 1.000 solicitudes hasta el 31 de diciembre de 2026. Consulta la guía de precios de DeepSeek V4.1 Flash y el desglose de precios de Kimi K3.1 Pro.
¿Cuáles son las alternativas de pesos abiertos a Kimi K3.1 Pro?
Tanto DeepSeek V4.1 Flash como MiMo-V2.6-Pro ofrecen pesos con licencia MIT en Hugging Face, y el anterior Kimi K3 tiene pesos abiertos bajo su propia licencia. Moonshot dice que los pesos de Kimi K3.1 Pro se publicarán a más tardar el 4 de noviembre de 2026, pero no estaban en Hugging Face cuando lo comprobé. Mi resumen de MiMo V2.6 cubre la opción de Xiaomi.
¿Es Claude Sonnet 5.5 mejor que Kimi K3.1 Pro?
Con el esfuerzo máximo, Sonnet 5.5 obtiene 56.0 en el Artificial Analysis Intelligence Index frente a 55.1 para Kimi K3.1 Pro, al mismo precio de lista, y genera unos 141 tokens por segundo frente a 50. Kimi es más barato por tarea completada con el esfuerzo máximo (2,11 $ frente a 5,46 $), porque Sonnet escribe más tokens. Mis artículos con el análisis de Kimi K3.1 Pro y los precios de Sonnet 5.5 profundizan en el tema.
¿Cómo comparo las alternativas a Kimi K3.1 Pro según su coste?
Compara el coste por tarea completada correctamente, no el precio por token. Toma el gasto total de un lote de prueba con tus propias tareas y divídelo entre las tareas que cada modelo completó correctamente. Un modelo con un precio de lista más bajo puede salir perdiendo si escribe más tokens o falla con más frecuencia, por eso incluyo el coste por tarea de Artificial Analysis junto a los precios por token. La guía sobre el coste de la atención al cliente con IA muestra la misma idea aplicada al soporte.
¿Qué alternativa a Kimi K3.1 Pro es mejor para la atención al cliente?
Para un bot de soporte, la velocidad y las respuestas incorrectas importan más que las puntuaciones máximas en las pruebas de rendimiento. Gemini 4 Argon tuvo la tasa de alucinaciones más baja de este grupo en Artificial Analysis (15,1 %), y Claude Sonnet 5.5 es rápido. Si no quieres crear el bot, un agente de soporte con IA como eesel ya utiliza modelos de vanguardia y aprende de tus tickets anteriores.
¿Debería esperar a los pesos abiertos de Kimi K3.1 Pro?
Solo si planeas alojarlo por tu cuenta. El modelo tiene 2.8 billones de parámetros en total, por lo que ejecutarlo por tu cuenta requiere un gran clúster de GPU. Si lo utilizas a través de una API, los pesos cambian poco para ti; el precio de la versión alojada ya es de 2 $ de entrada y 10 $ de salida por millón de tokens. El resumen de Kimi K3.1 Pro sigue las novedades del lanzamiento.