

Alternativas a Microsoft-Decision-1 de un vistazo
| Modelo | Proveedor | Entrada por 1M de tokens | Salida | Contexto por llamada | Imágenes | Cómo se ejecuta | Pesos y licencia | Decision Index v0.3.1 (Full) | Notas de datos y cumplimiento | Cuota gratuita |
|---|---|---|---|---|---|---|---|---|---|---|
| Microsoft-Decision-1 (referencia) | Microsoft | $0.042 | Gratis | 32,768 | No | Azure Foundry, OpenRouter | Cerrado | No figura | SLA de Azure; regiones no publicadas | Azure general $200, 30 días |
| Jev 1.13 | TypeSafe | $0.042 | Gratis | 64k por solicitud, 32k de estado + la pregunta más larga | No | TypeSafe API, Cloudflare Workers AI | Cerrado | 60.11 (referencia, empatado 2.º) | Retención cero de datos en el listado de Cloudflare | Ninguna documentada |
| OpenAI Decisions API | OpenAI | $0.10 | Gratis | 1,050,000 (2x el precio de entrada a partir de 272K) | Sí | OpenAI API, beta pública | Cerrado | No figura | ZDR y HIPAA para clientes elegibles, residencia en EE. UU. y UE | Ninguna |
| Clef-flash | Cloudflare | $0.038 | Gratis | 24,576 | Sí | Workers AI o autoalojado | Abierto, Apache 2.0 | 47.61 (#33) | Términos de cuenta de Cloudflare | 10,000 neurons de Workers AI al día |
| Clef | Cloudflare | $0.24 | Gratis | 65,536 | Sí | Workers AI o autoalojado | Abierto, Apache 2.0 | 53.08 (#19) | Términos de cuenta de Cloudflare | 10,000 neurons de Workers AI al día |
| Perplexity Decider v1.1 | Perplexity | El coste de tu GPU | n/d | 8,192 por decisión | Sí | Autoalojado, unos 49 GiB de pesos | Apache 2.0, descarga autenticada | 62.75 (#1) | Se queda en tu infraestructura | Descarga gratuita |
| Rune 26B-A4B v3 | Surogate (Invergent) | El coste de tu GPU | n/d | 262k | Sí | Autoalojado con el motor surogate | Apache 2.0, formulario de contacto | 57.43 (#10) | Se queda en tu infraestructura | Descarga gratuita |
| Strands Decider 2B | AWS Strands Labs | El coste de tu GPU | n/d | Probado con 4,096 | Opcional, sin entrenar | Autoalojado, cabe en una 3090 | Apache 2.0 | 21.75 (#84) | Se queda en tu infraestructura | Descarga gratuita |
| eesel (no es un modelo) | eesel | $299 al mes por 500 tickets o chats | n/d | Todo el ticket y el historial | Sí | Se conecta a tu helpdesk | Producto alojado | n/d | HIPAA en Enterprise | 100 créditos gratis |
Los precios y el contexto provienen de la documentación de cada proveedor, consultada el 11 de octubre de 2026. Las puntuaciones del Decision Index provienen del tablero Jev Decision Index, versión 0.3.1, actualizado el 10 de octubre.
¿Por qué mirar más allá de Microsoft-Decision-1?
Expliqué qué hace el modelo en mi resumen de Microsoft-Decision-1 y cuánto cuesta en el desglose de precios. Es un lanzamiento sólido. La propia tabla de Microsoft le da un 83.5 % de precisión media en 36 benchmarks con una mediana de 85 ms en Foundry. Pero hay algunas carencias que salen una y otra vez:
- Sin pesos abiertos. Es un Qwen3.5-9B posentrenado, pero la página de Hugging Face que Microsoft usaría devuelve 404. Lo alquilas o no lo usas. Si te gustaba la familia Qwen para autoalojar, este es cerrado.
- Solo texto, 32K de contexto. Las capturas de pantalla, los formularios escaneados y los hilos muy largos necesitan otro modelo.
- Papeleo de Azure escaso. Está en GA en el catálogo, pero aún no tiene fila en la página de precios de Foundry de Azure, ni regiones, cuotas o tarifa de lotes publicadas. Los equipos que compran a través de los modelos de Azure suelen querer eso antes de comprometerse.
- Aún sin puntuación independiente. No está en el Jev Decision Index, así que todas las cifras de precisión hasta ahora son del propio Microsoft.
Ese último punto marcó la mayor parte de la reacción el día del lanzamiento. La respuesta más votada bajo la publicación de lanzamiento de Satya Nadella fue directa:
"How is Jev not ranked? That's literally the #1 model people are going to compare this to."
Microsoft actualizó después la publicación para añadir Jev a la tabla de precisión y calibración. Aun así, la pregunta de fondo es la correcta. Los modelos de decisión son ya un campo concurrido, y el modelo de decisión que elijas debería depender de dónde se ejecuta y qué lee, no de los gráficos del día del lanzamiento.
Cómo elegí estas alternativas
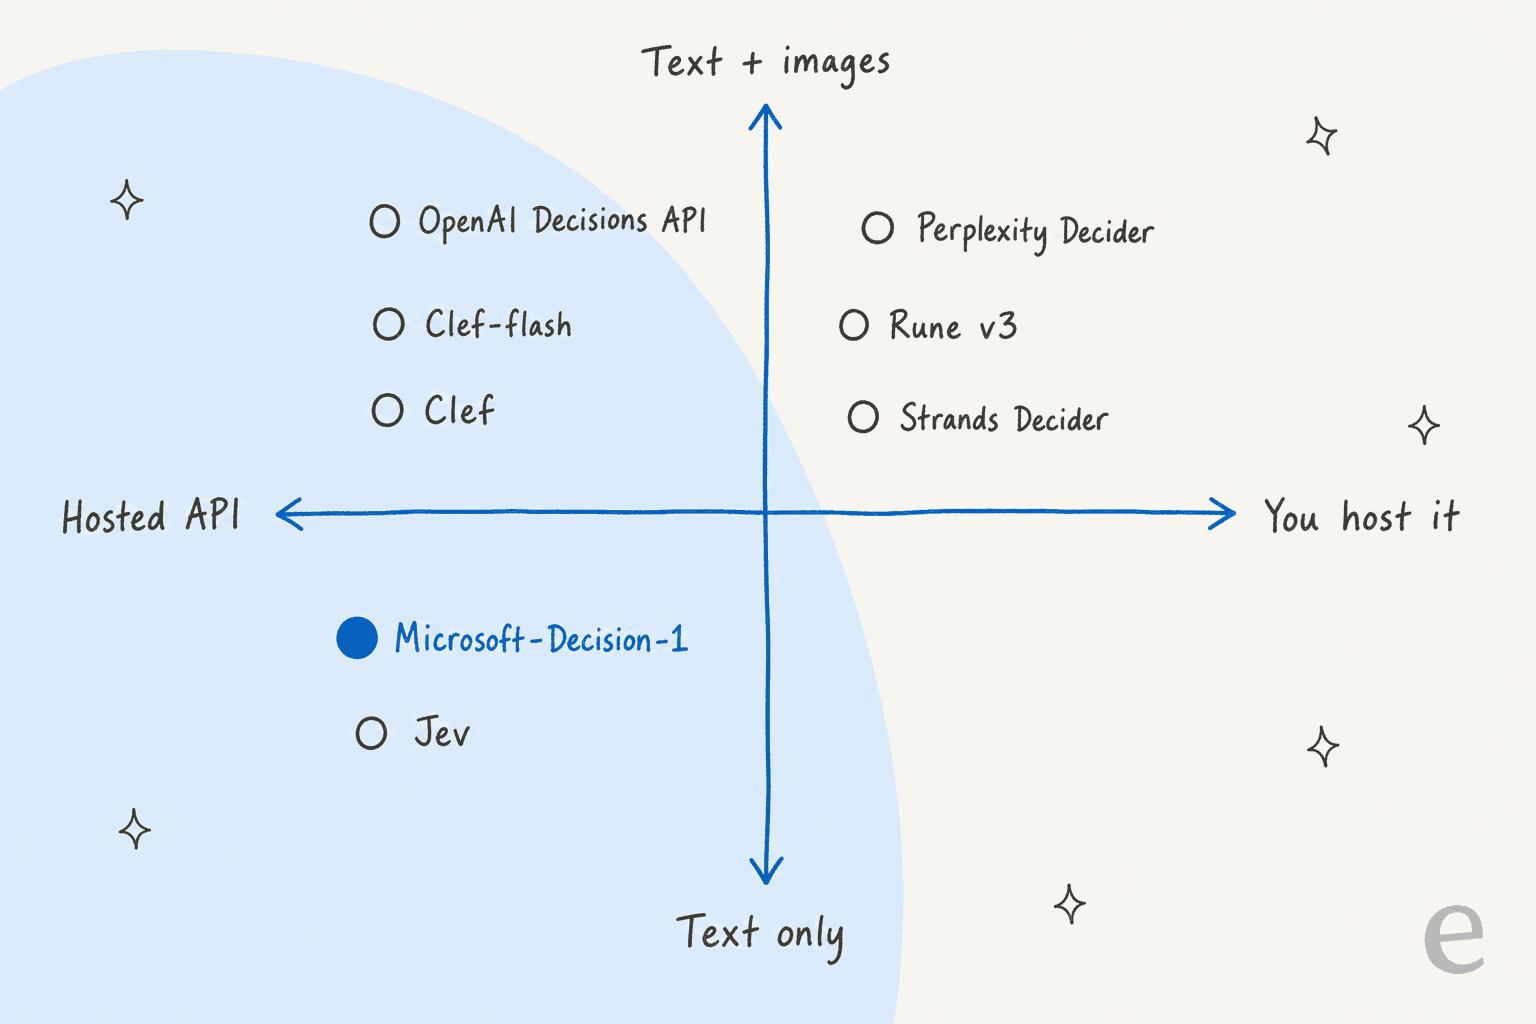
Vengo del lado de la búsqueda. Mi trabajo en eesel consiste sobre todo en averiguar qué preguntan realmente los compradores cuando escriben una consulta, y "Microsoft-Decision-1 alternatives" dos días después del lanzamiento se divide limpiamente en precio, alojamiento y tipo de entrada. Así que me quedé con modelos que hacen el mismo trabajo: envías un estado más opciones de respuesta fijas y recibes probabilidades calibradas en una sola pasada.
Todos los modelos de abajo aparecen en la propia tabla comparativa de Microsoft o puntúan en el Decision Index, o ambas cosas. Dejé fuera los modelos de chat generales con modo JSON, ya que el function calling en un modelo grande tiene una curva de costes completamente distinta. Cada entrada usa los mismos cinco encabezados para que puedas comparar de un vistazo.
¿Cuánto texto puede leer cada uno por llamada?
El contexto es la especificación que primero muerde en el trabajo de soporte. Un solo ticket con historial de pedidos, un extracto de política y tres respuestas de ida y vuelta puede superar los 10,000 tokens.
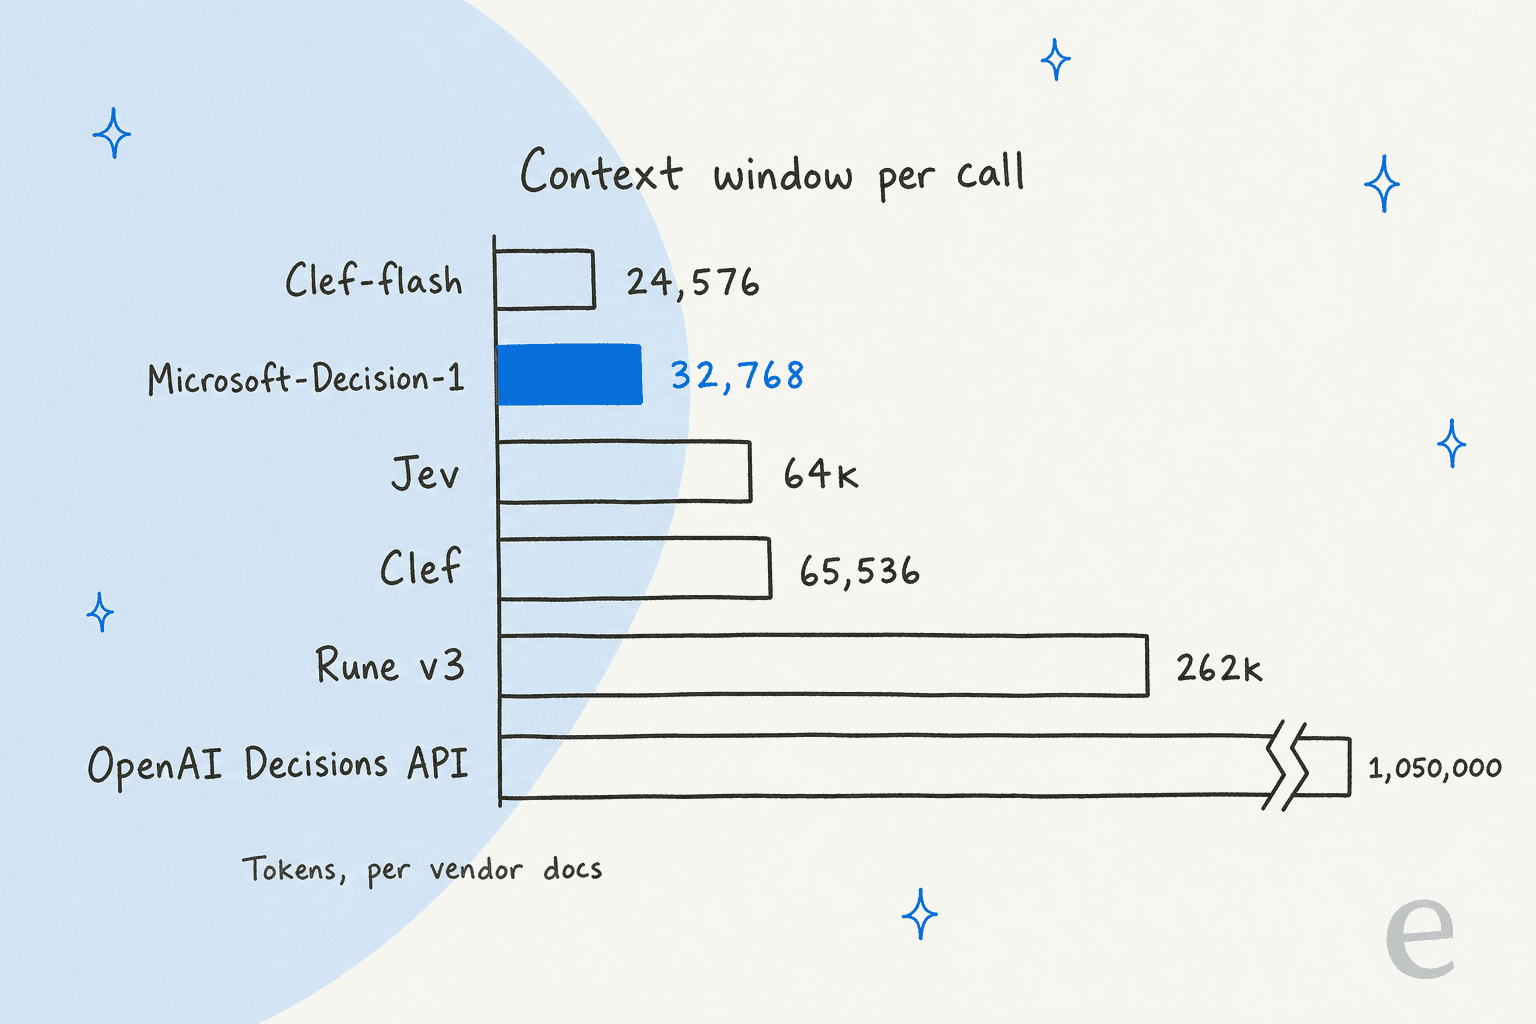
Perplexity Decider falta en ese gráfico a propósito. Su ficha dice que el texto y todas las imágenes de una decisión deben caber en 8,192 tokens, y las entradas más largas se rechazan en lugar de truncarse. Mejor puntuación, ventana más pequeña.
1. Jev 1.13 (TypeSafe)
Qué es
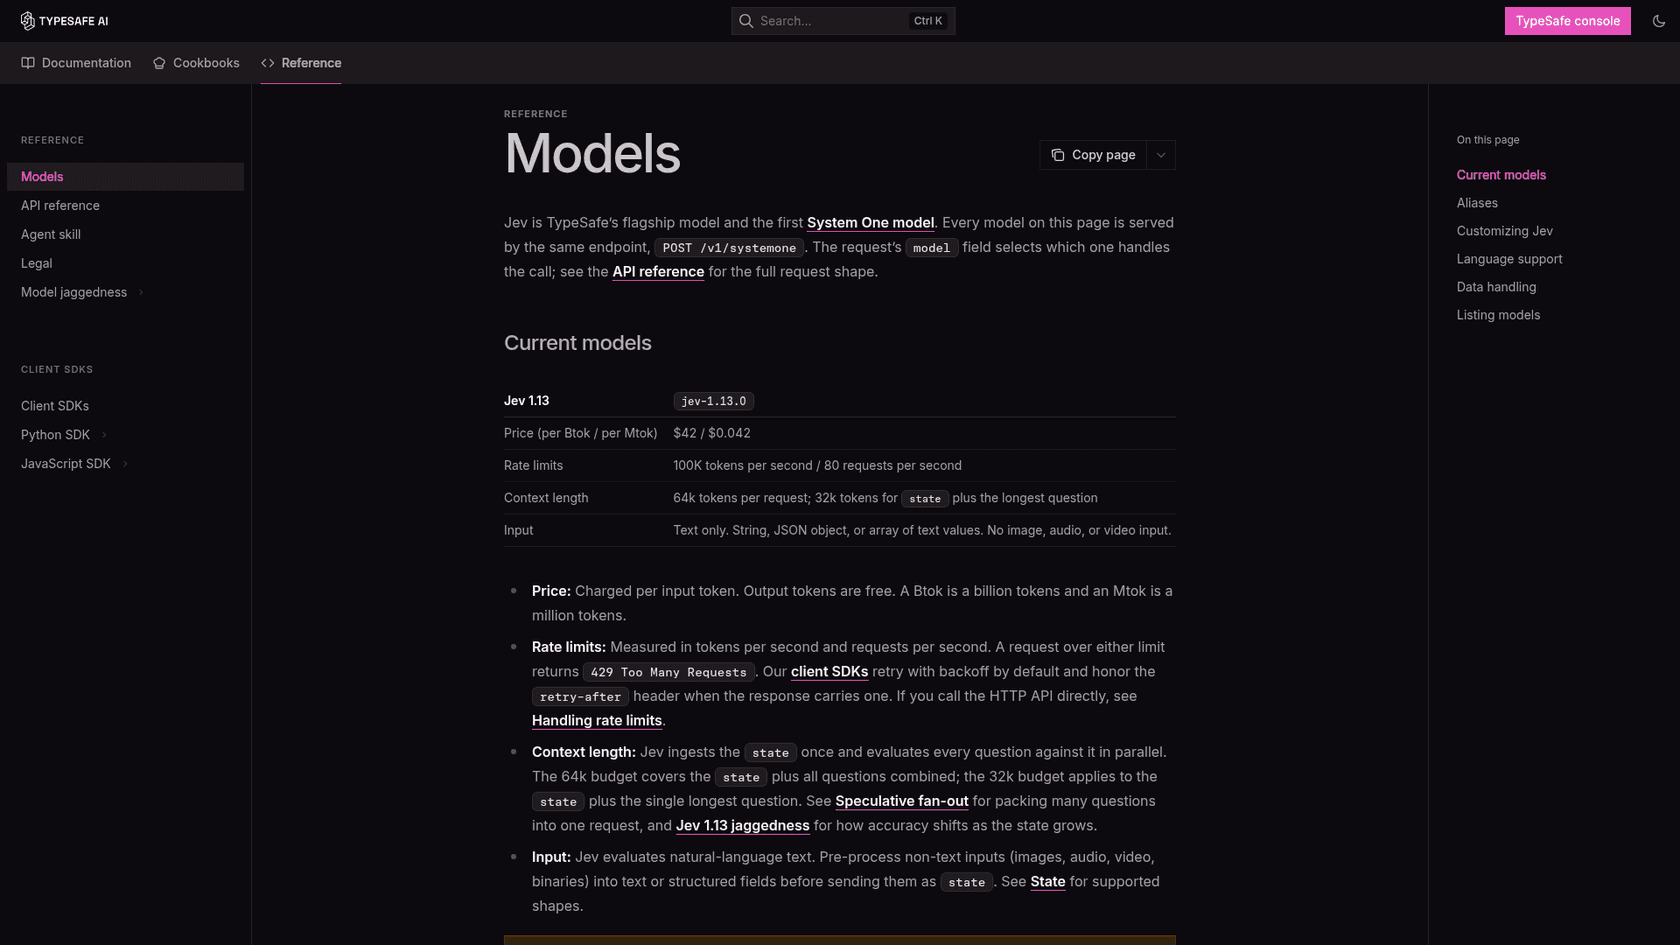
Jev es el modelo que inició la categoría. TypeSafe lo sirve a través de un único endpoint, POST /v1/systemone, y puntúa en paralelo cada pregunta que envías contra un estado compartido. Lo cubrí en profundidad en mi resumen de Jev.
Dónde supera a Microsoft-Decision-1
- Solicitudes más grandes. Jev admite 64k tokens por solicitud, con 32k para el estado más la pregunta individual más larga, según la página de modelos de TypeSafe. Microsoft se limita a 32,768.
- Mejor calibración. Incluso en la propia tabla de Microsoft, Jev puntúa 93.7 en calibración frente al 92.2 de Microsoft.
- Más sitios donde comprarlo. Además de la API de TypeSafe, Jev está en Cloudflare Workers AI al mismo precio, con entrada en caché gratuita y retención cero de datos.
Dónde se queda corto
- Solo texto, como Microsoft. Las imágenes hay que convertirlas primero en texto.
- TypeSafe advierte de que "Rate limits are adjusting dynamically" y pueden cambiar sin aviso. El límite actual es de 100K tokens y 80 solicitudes por segundo.
- La tabla de Microsoft lo sitúa ligeramente por detrás en precisión, 82.3 % frente a 83.5 %.
Un probador de Hacker News ejecutó ambos en su propia suite el día después del lanzamiento:
"In my minimal suite it was cheaper (by 0.72x) but higher latency (283ms vs 369ms p50) than Jev. Results were very comparable across all scenarios I measure, first of these that I have tested that actually justifies its existence as a commercial release."

Mismo precio de lista, facturas distintas: los tokenizadores cuentan de forma diferente, así que prueba con tus propios tickets.
Precios
$0.042 por millón de tokens de entrada, salida gratuita, sin nivel gratuito documentado. Mi artículo sobre los precios de Jev calcula el coste por decisión, y Jev Ultrafast cubre el nivel de velocidad.
Ideal para
Equipos que quieren una alternativa a Microsoft-Decision-1 con el mismo precio y la misma forma de API, entradas más largas y sin dependencia de Azure.
2. OpenAI Decisions API (gpt-6-luna)
Qué es
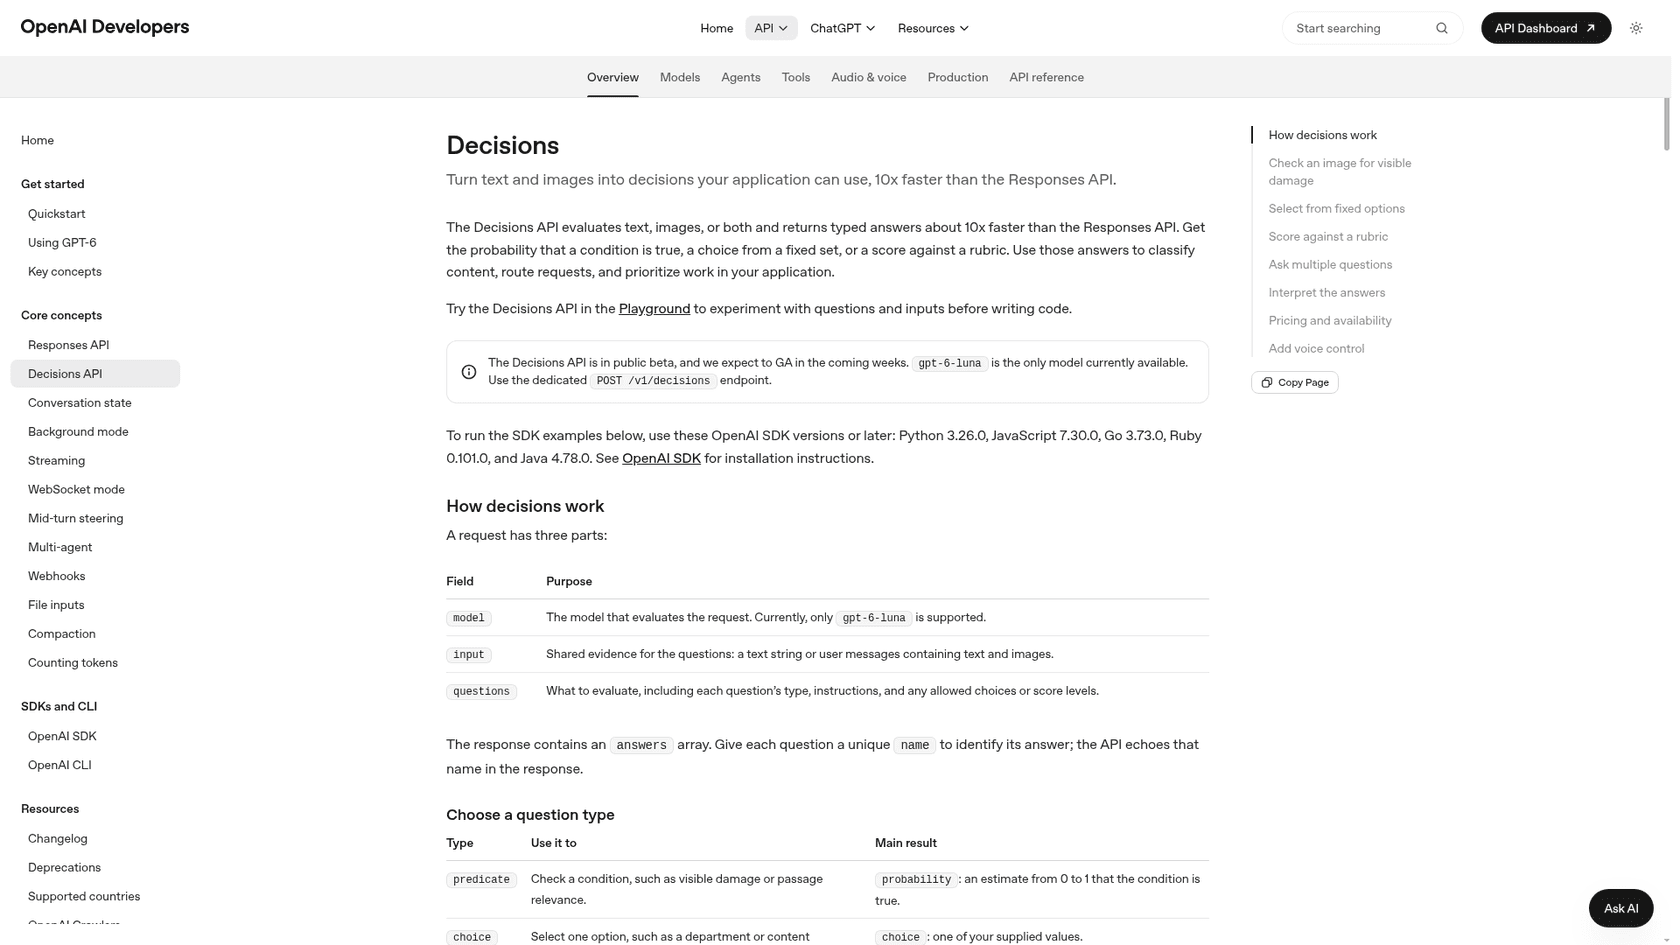
La versión de OpenAI de la misma idea, lanzada en beta pública el 6 de octubre. Llamas a POST /v1/decisions con gpt-6-luna, una entrada de texto e imágenes y una lista de preguntas de tipo predicate, choice o score. Mi guía de la Decisions API tiene el paso a paso.
Dónde supera a Microsoft-Decision-1
- Imágenes. Lee texto e imágenes en una sola llamada. Las imágenes deben ser URLs de datos base64 en línea.
- Contexto enorme. Hereda la ventana de 1,050,000 tokens de GPT-6 Luna, así que cabe todo el historial de un ticket.
- Opciones de cumplimiento. La guía de OpenAI menciona Zero Data Retention y HIPAA para clientes elegibles, además de residencia de datos en EE. UU. y la UE.
Dónde se queda corto
- Cuesta unas 2,4 veces más por token que Microsoft.
- Sigue en beta. OpenAI dice que espera la GA "in the coming weeks".
- Los prompts de más de 272K tokens se facturan a 2x la entrada, y se aplican recargos por procesamiento regional.
- OpenAI no publica latencia en milisegundos, solo "about 10x faster than the Responses API". La tabla de Microsoft lo midió en 300 ms de mediana y 79.4 % de precisión.
Precios
$0.10 por millón de tokens de entrada, sin cargos por salida, lectura de caché ni escritura de caché. Esa tarifa está en la guía de Decisions, aún no en la página principal de precios de la API de OpenAI. Más en mi artículo sobre los precios de Luna.
Ideal para
Equipos que ya usan OpenAI y necesitan puntuar capturas de pantalla o hilos largos, o que necesitan tener en regla la documentación HIPAA.
3. Cloudflare Clef-flash
Qué es
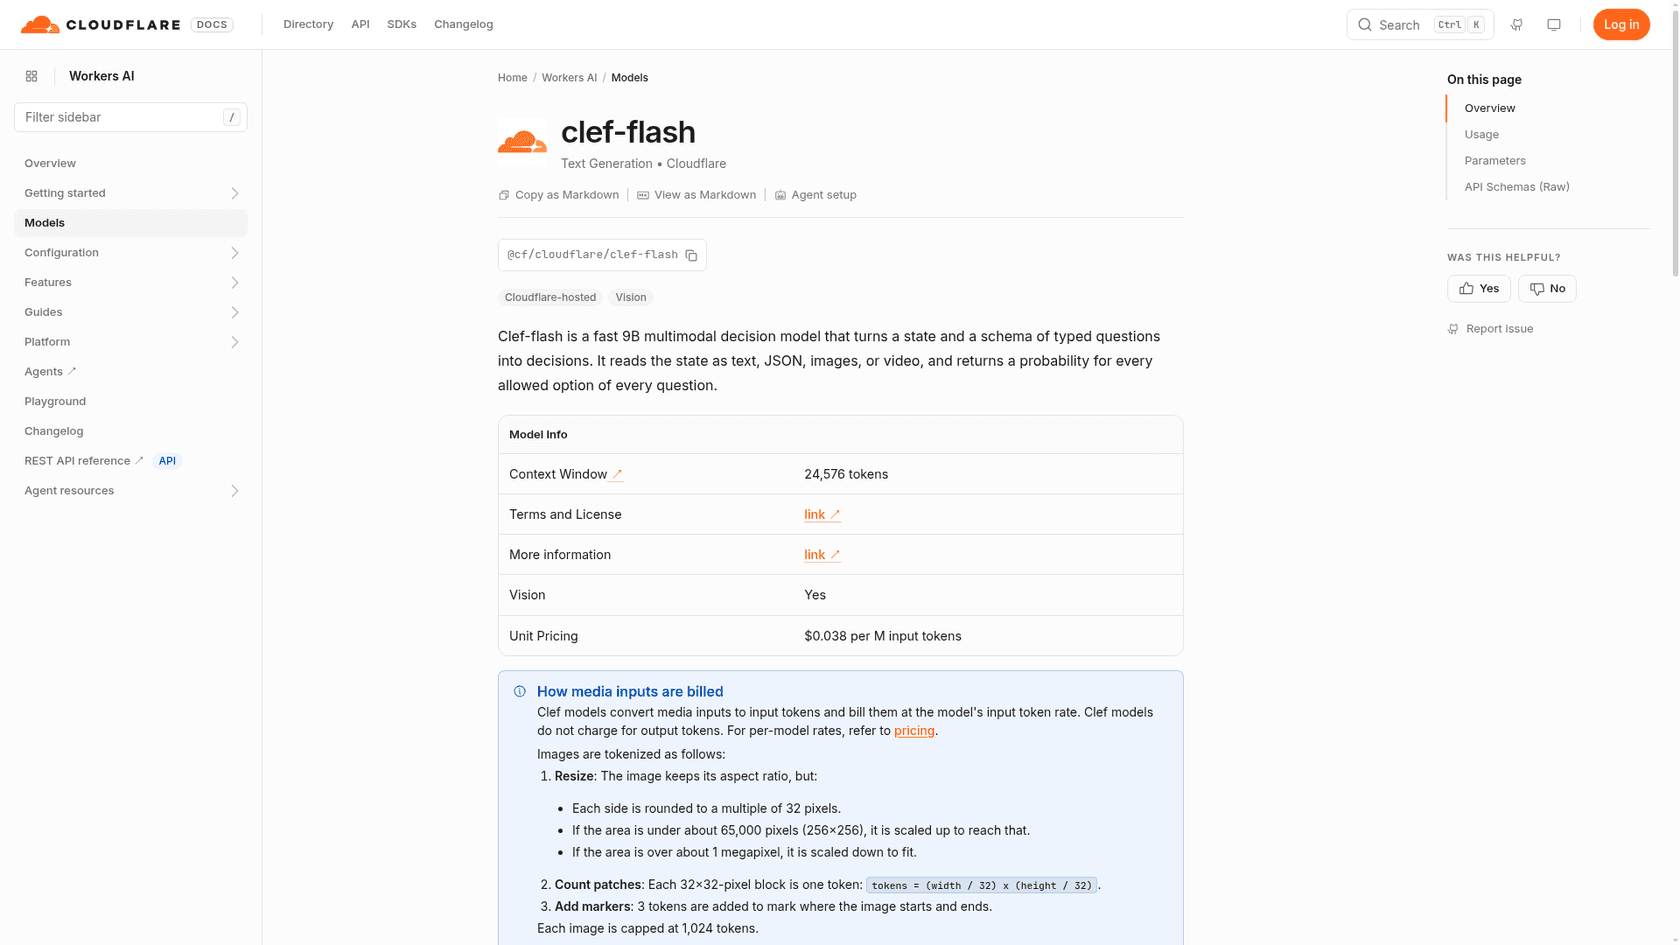
El pequeño modelo de decisión de Cloudflare, un 9B construido sobre la misma base Qwen3.5-9B que el de Microsoft. Se ejecuta en Workers AI como @cf/cloudflare/clef-flash, y los pesos están en Hugging Face bajo Apache 2.0. Mi resumen de Clef cubre ambos tamaños de Clef.
Dónde supera a Microsoft-Decision-1
- La tarifa alojada más barata. $0.038 por millón de tokens de entrada, frente a $0.09 hace una semana.
- Imágenes. La página de Cloudflare indica soporte de visión, con las imágenes facturadas como tokens de entrada.
- Cuota diaria gratuita. Workers AI da 10,000 neurons al día en los planes Free y Paid. Según mis cuentas son unos 2.9M de tokens de entrada de Clef-flash al día.
- Pesos abiertos, así que puedes llevarlo a tu propia infraestructura más adelante.
Dónde se queda corto
- La ventana de contexto se redujo a 24,576 tokens con el recorte de precio, más pequeña que la de Microsoft.
- Está en el puesto 33 del Decision Index (47.61), muy por debajo de Clef y Jev.
- No está en la tabla comparativa de Microsoft, así que no hay un benchmark compartido entre ambos.
Precios
$0.038 por millón de tokens de entrada y sin cargo por salida. Pasados los neurons gratuitos, Workers AI cobra $0.011 por 1,000 neurons.
Ideal para
Clasificación de texto o imágenes de alto volumen donde el coste por llamada importa más y las entradas son cortas.
4. Cloudflare Clef
Qué es
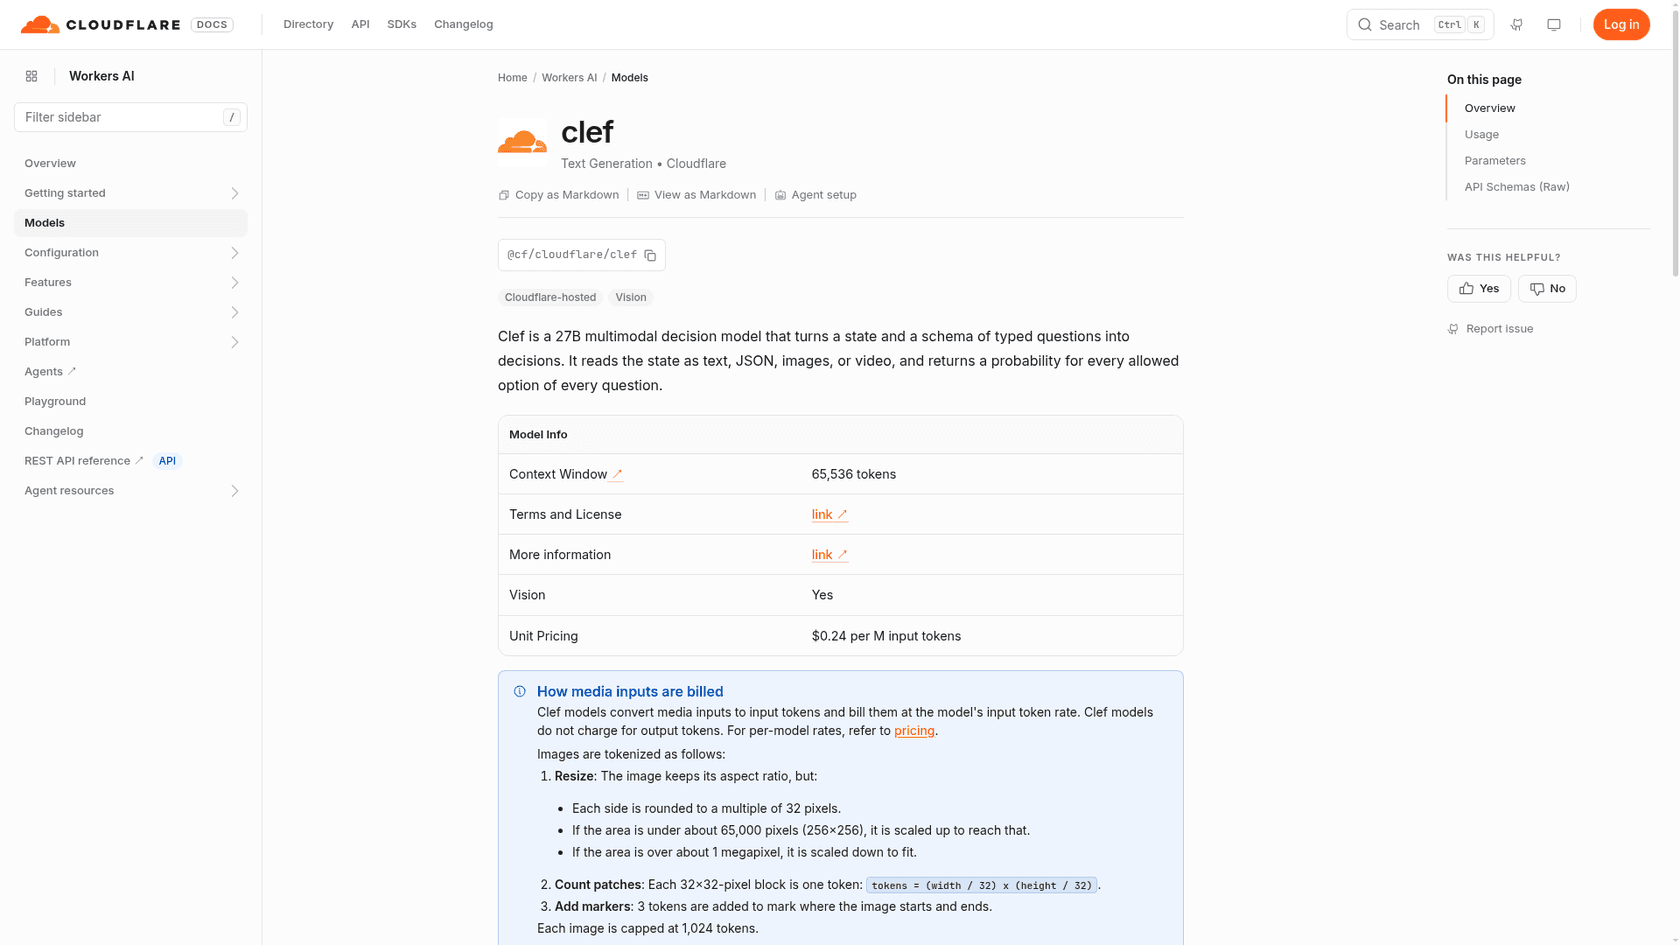
El Clef más grande: un modelo de decisión multimodal de 27B posentrenado a partir de Qwen3.8-27B, alojado en Workers AI y publicado bajo Apache 2.0.
Dónde supera a Microsoft-Decision-1
- El doble de contexto. 65,536 tokens.
- Imágenes y vídeo en el estado, según la ficha del modelo de Cloudflare.
- Una puntuación independiente. Está en el Decision Index con 53.08 Full, y su puntuación solo con benchmarks públicos, 61.71, es la cifra pública más alta entre las opciones alojadas aquí.
Dónde se queda corto
- A $0.24 por millón de tokens de entrada, cuesta casi 6 veces la tarifa de Microsoft.
- Su puntuación en la prueba privada lo baja al puesto 19, así que la cifra pública lo favorece.
- La mediana que Cloudflare declara fue de 209 ms, más lenta que los 85 ms que afirma Microsoft.
Precios
$0.24 por millón de tokens de entrada, sin cargo por salida y los mismos 10,000 neurons gratuitos al día (unos 458K tokens de entrada de Clef). Mi artículo sobre los precios de Clef tiene las cuentas.
Ideal para
Equipos en Cloudflare que necesitan entradas multimodales más largas y pagarán más por llamada por ello.
5. Perplexity Decider v1.1 (27B)
Qué es
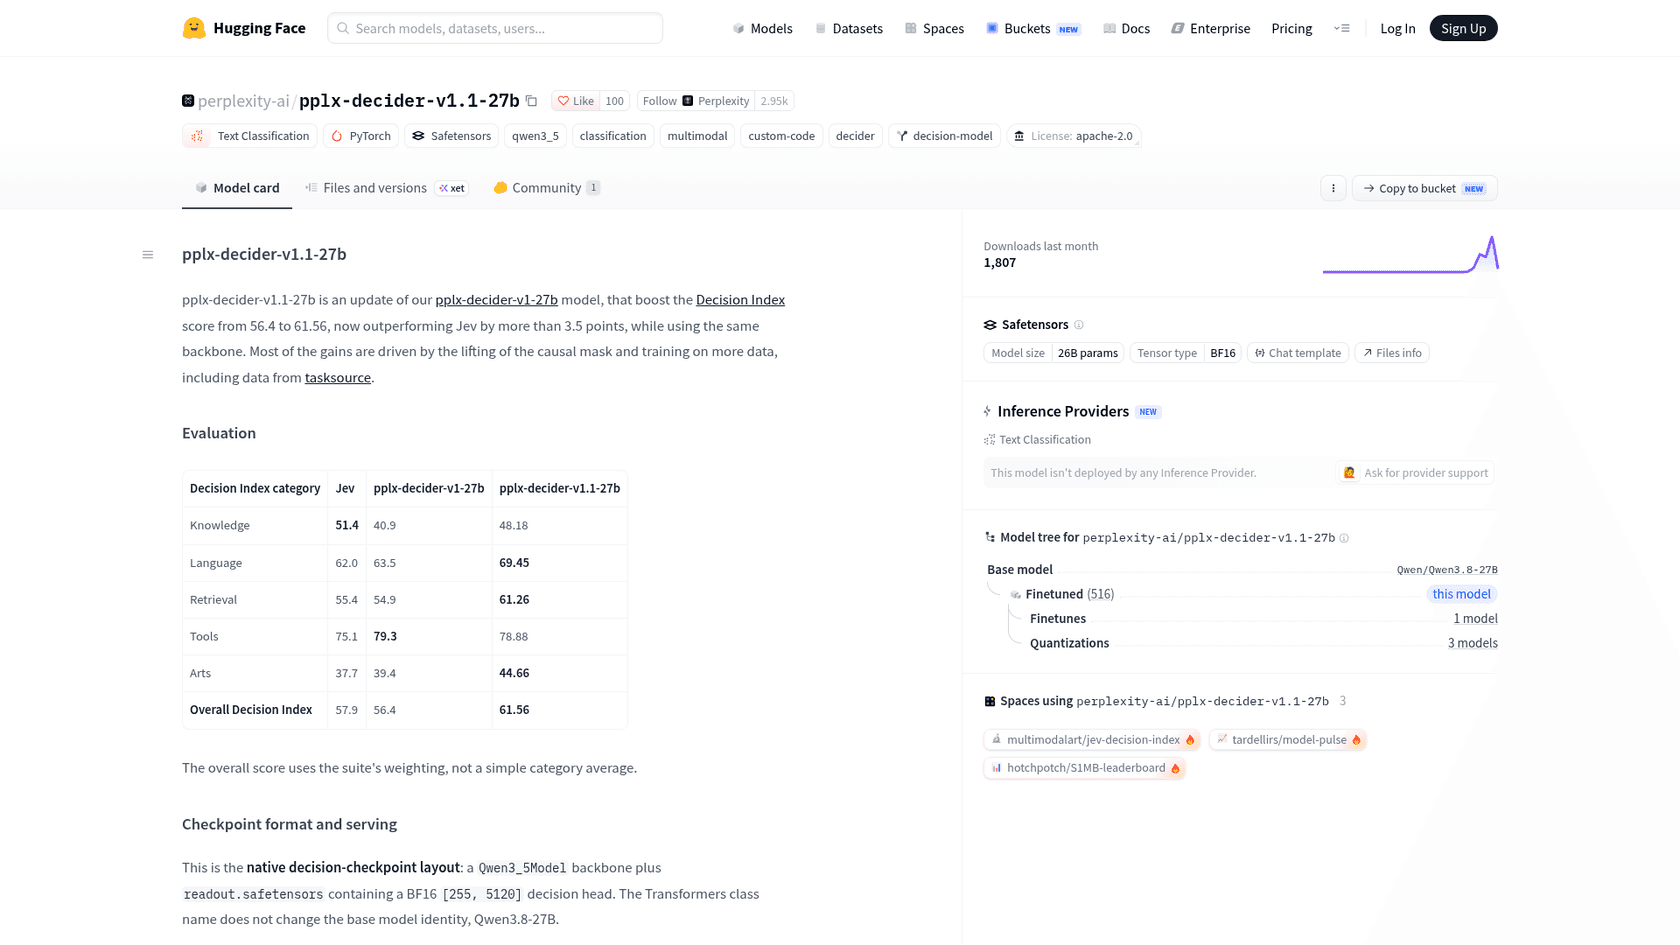
El modelo de decisión abierto de Perplexity, un ajuste fino completo de Qwen3.8-27B con una cabeza de decisión separada. Perplexity dice que v1.1 obtuvo la mayor parte de su mejora de "the lifting of the causal mask" y de más datos de entrenamiento. Lo descargas de Hugging Face y lo ejecutas con el código incluido.
Dónde supera a Microsoft-Decision-1
- Mejor puntuación independiente. Está primero en el Decision Index v0.3.1 con 62.75, por delante del 60.11 de Jev.
- Los pesos son tuyos. Apache 2.0, nada sale de tus servidores.
- Imágenes, pasadas como rutas de archivo, imágenes PIL o URLs base64.
Dónde se queda corto
- Límite estricto de 8,192 tokens por decisión, texto e imágenes combinados.
- Necesitas una GPU CUDA con sitio para unos 49 GiB de pesos más memoria de trabajo, y una cuenta autenticada de Hugging Face para descargarlo.
- Sin API alojada: la ficha dice que ningún proveedor de inferencia lo sirve.
- La inferencia causal por defecto no reproduce la configuración evaluada, así que debes usar el código de Perplexity o una exportación cuidadosa.
Precios
Gratis de descargar. Tu coste es el tiempo de GPU. Sobre el coste, un comentarista de Hacker News lo expresó bien:
"Open weight model pricing isn't really up to the company that built them (unless they are also serving them, in which case their API price may differ). It's really up to the serving cost and/or pricing of whoever is actually serving the model."
Ideal para
Equipos de ML con capacidad de GPU libre que quieren el modelo abierto más preciso y mantienen las entradas cortas.
6. Surogate Rune 26B-A4B v3
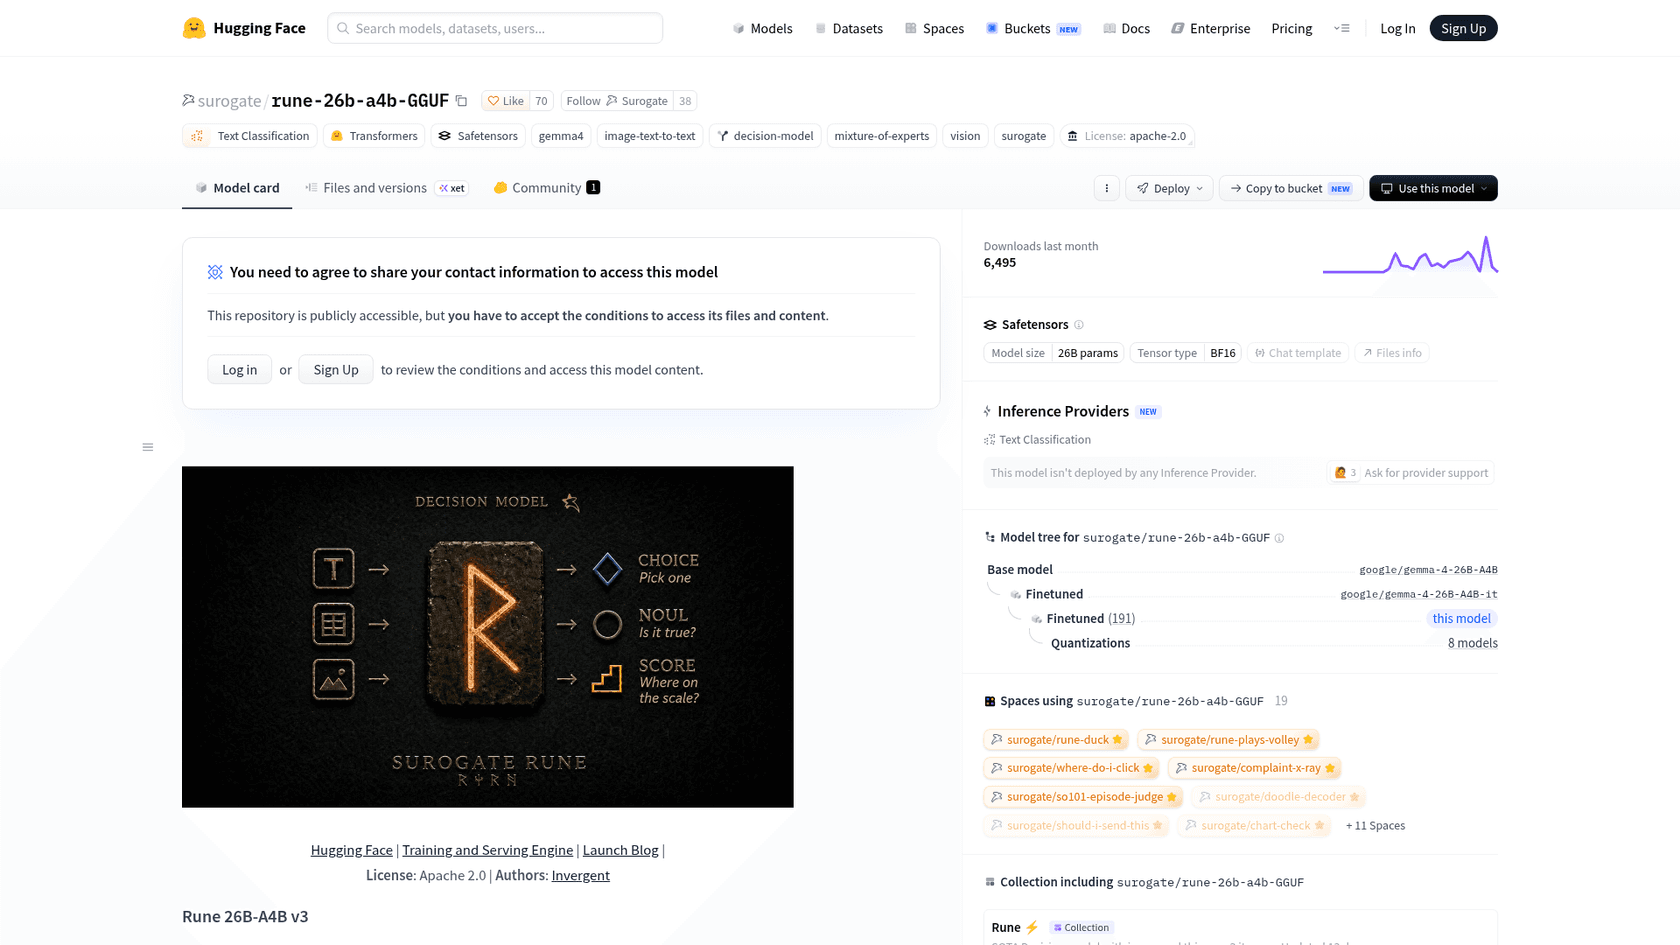
Qué es
El modelo de decisión abierto de Invergent, un ajuste fino completo de Gemma 4 26B-A4B (8 de 128 expertos activos por token). Responde preguntas choice, noul y score y lo sirve más rápido el motor de código abierto surogate.
Dónde supera a Microsoft-Decision-1
- Entradas largas. La ficha afirma un contexto de 262k, ocho veces el de Microsoft.
- Imágenes, conservando la torre de visión. La propia prueba de imágenes de Invergent puntuó 83.4 % con 1,120 tokens de imagen.
- Razonamiento opcional. Con
"thinking": true, las preguntas de las que no está seguro razonan antes de responder. Invergent estima que eso sube su índice unos 1.8 puntos, a unos 5 segundos por pregunta con razonamiento. - En la propia tabla de Microsoft puntuó 79.7 %, cerca del Luna de OpenAI.
Dónde se queda corto
- Las descargas están tras un formulario de datos de contacto.
- Sus probabilidades por defecto son demasiado confiadas. La ficha recomienda leer las respuestas con temperatura 2 para corregir la calibración.
- Invergent midió una mediana de 388 ms por solicitud en una RTX PRO 6000, más lenta que lo que afirma Microsoft.
- 10.º en el Decision Index (57.43), por detrás de Perplexity y Jev.
Precios
Gratis de descargar bajo Apache 2.0. Pagas el hardware.
Ideal para
Quienes autoalojan y necesitan entradas largas o con muchas imágenes y pueden ajustar el servicio por su cuenta.
7. Strands Decider (AWS Strands Labs)
Qué es
Un pequeño modelo de decisión abierto de Strands Labs de AWS, creado para pasos de agentes como selección de herramientas, guardarraíles y enrutamiento. El modelo de referencia es un 2B sobre Qwen3.5, y cuatro tamaños de Gemma 4 siguieron el 10 y el 11 de octubre. Cubrí el lanzamiento en mi artículo sobre Strands Decider.
Dónde supera a Microsoft-Decision-1
- Funciona con hardware modesto. El 2B alcanzó una mediana de 115 ms en una sola RTX 3090 en la propia prueba de Strands.
- Gratis y abierto, Apache 2.0, y encaja dentro del arnés de Strands más amplio para agentes.
- Entrada de imágenes opcional con
--vision, aunque Strands señala que no se entrenó nada con imágenes.
Dónde se queda corto
- La precisión es mucho menor. La tabla de Microsoft muestra 54.8 % en solo 23 de 36 benchmarks, y el Decision Index lo sitúa en el puesto 84 (21.75).
- Se probó con ventanas de 3,072 y 4,096 tokens.
- No hay ninguna API alojada en ningún sitio, Bedrock incluido.
Precios
Gratis. Tu propia GPU o CPU.
Ideal para
Guardarraíles locales y baratos para agentes y selección de herramientas donde la velocidad en hardware pequeño importa más que la máxima precisión.
8. eesel (si quieres la decisión y el trabajo)

Qué es
No es un modelo. Las siete opciones anteriores son infraestructura. eesel es el empleado: un compañero de helpdesk con IA que se une a tu cola de Zendesk, Freshdesk o Gorgias, toma la decisión de enrutamiento y luego escribe la respuesta o ejecuta la acción. Aprende de tus tickets pasados y de tu centro de ayuda.
Dónde supera a Microsoft-Decision-1
- Sin pipeline que construir. Sin umbrales, webhooks ni código de unión con la API del helpdesk.
- Actúa según la respuesta. Etiquetas, prioridad, escalado y la propia respuesta.
- Las acciones arriesgadas pueden esperar aprobación, de modo que una persona dé el visto bueno antes de cualquier cosa irreversible.
Dónde se queda corto
- Mucho más caro por ticket que una sola llamada a un modelo, porque incluye el trabajo.
- Vive en tu helpdesk. Si necesitas decisiones dentro del flujo de código de tu propia app, usa un modelo.
Precios
Los planes de eesel empiezan en $299 al mes por 500 créditos, donde un ticket o un chat es un crédito sin importar cuánto dure. 5,000 créditos cuestan $1,749 al mes. Hay un inicio gratuito con 100 créditos y sin tarjeta.
Ideal para
Equipos de soporte cuyo objetivo real es tener los tickets clasificados y respondidos, no un modelo que cablear.
¿Qué alternativa a Microsoft-Decision-1 deberías elegir?
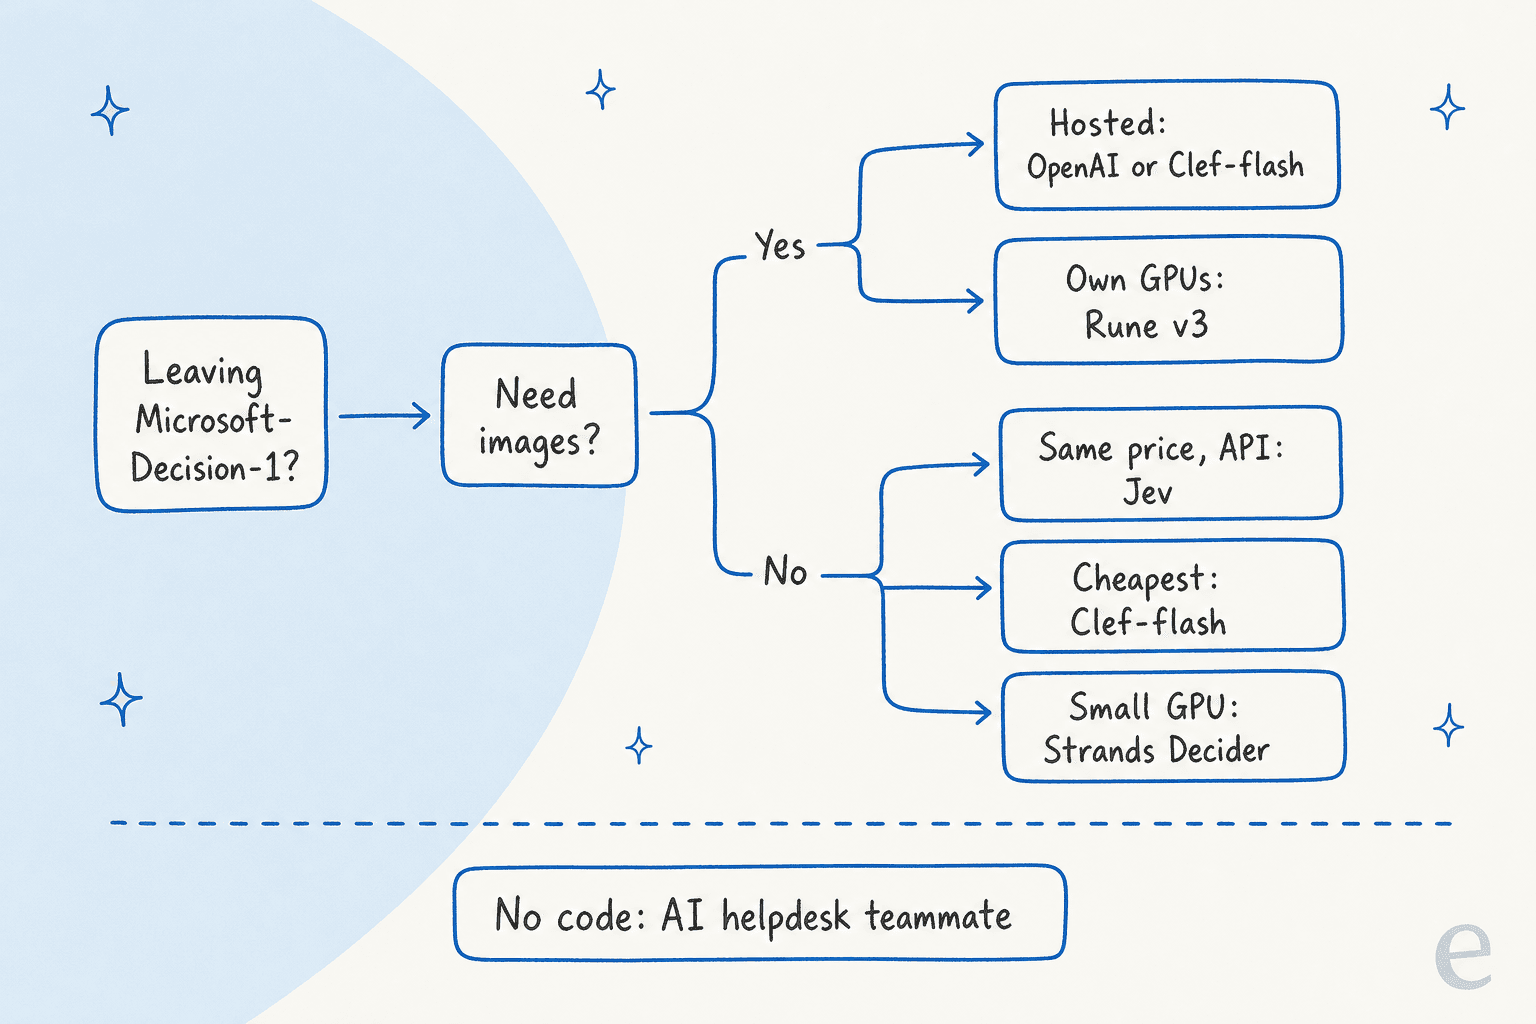
Mi versión corta:
- Mismo trabajo, sin Azure: Jev al mismo precio. Compara los dos primero con tus propios datos.
- La factura más baja: Clef-flash, si tus entradas caben en 24,576 tokens.
- Imágenes o hilos muy largos: la Decisions API de OpenAI alojada, Rune v3 autoalojado.
- La mejor precisión abierta: Perplexity Decider v1.1, si 8,192 tokens son suficientes.
- Pequeño y local: Strands Decider para guardarraíles de agentes.
Para los equipos de soporte, el caso de uso casi siempre es la clasificación de tickets y el enrutamiento. Ahí es donde la puntuación de probabilidad se gana su sitio: solo automatizas aquello de lo que el modelo está seguro. En colas reales, lo difícil viene después. En un ejemplo de nuestros propios datos, la IA de una empresa de infraestructura Web3 comparó una propuesta de ventas en frío de una lista de contactos con tickets pasados de Zendesk, la clasificó como spam y redactó un rechazo educado como nota interna en lugar de intentar responderla. Un modelo de decisión te da la etiqueta "spam". Alguien aún tiene que leer el historial y escribir la nota.
Vigila también los falsos positivos al etiquetar. Una tasa de error del 1 % es barata por llamada y cara cuando envía un reembolso a ventas. Mi comparativa de la mejor IA para triaje compara herramientas que resuelven esto de serie.
Sáltate el modelo, quédate con la decisión
Si comparas alternativas a Microsoft-Decision-1 porque quieres tickets enrutados, etiquetados y priorizados, quizá no necesites un modelo en absoluto. eesel funciona como una nueva incorporación para tu helpdesk: se conecta a Zendesk o Freshdesk en minutos, lee tus tickets pasados, toma las mismas decisiones de triaje que tomaría un modelo de decisión y luego responde al cliente. Puedes simularlo con tickets históricos antes de que toque uno en vivo.
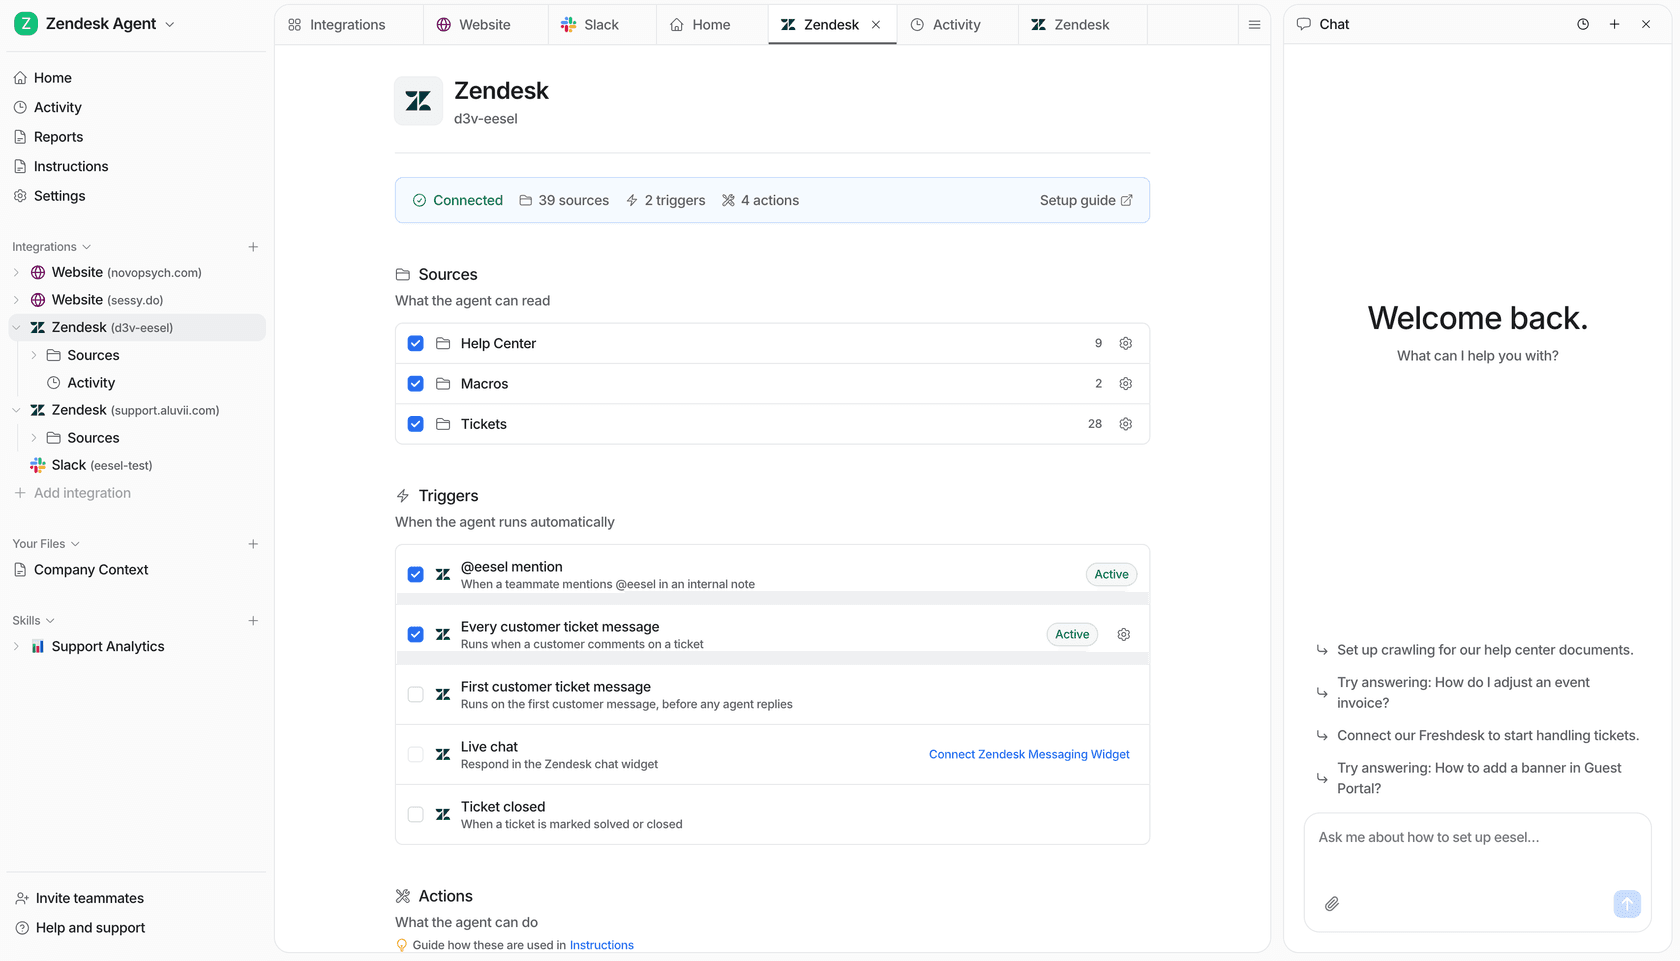
Si prefieres manejarlo desde código, la CLI de eesel ejecuta el mismo compañero que el panel. Cada comando imprime JSON, así que tú, un script o un agente de código como Claude Code, Codex o Cursor pueden configurarlo. eesel integrations conecta tu helpdesk, eesel automations enable <platform> <key> --instructions "..." escribe una regla de triaje con palabras sencillas, y eesel approvals lista las acciones retenidas para aprobar o denegar. Más sobre por qué importa en mi artículo sobre la CLI de agentes.
Prueba eesel gratis con 100 créditos y apúntalo a una semana de tus tickets. Si los enruta tan bien como lo haría tu pipeline de decisión, te habrás ahorrado la construcción.
Preguntas frecuentes
¿Cuáles son las mejores alternativas a Microsoft-Decision-1?
El reemplazo más cercano es Jev de TypeSafe, que cuesta lo mismo, $0.042 por millón de tokens de entrada. La Decisions API de OpenAI añade imágenes y una ventana de contexto enorme, Clef-flash de Cloudflare es la opción alojada más barata a $0.038, y Perplexity Decider, Rune v3 y Strands Decider son alternativas de pesos abiertos a Microsoft-Decision-1 que ejecutas tú mismo.
¿Hay una alternativa más barata a Microsoft-Decision-1?
Sí. Clef-flash de Cloudflare cuesta $0.038 por millón de tokens de entrada frente a los $0.042 de Microsoft, con salida gratuita en ambos. Los modelos de pesos abiertos no cuestan nada de descargar, pero pagas la GPU. Mi desglose de los precios de Clef cubre la cuota diaria gratuita en Workers AI.
¿Es Jev mejor que Microsoft-Decision-1?
En la tabla de 36 benchmarks de Microsoft, Microsoft-Decision-1 obtuvo un 83.5 % de precisión media frente al 82.3 % de Jev, mientras que Jev puntuó más alto en calibración (93.7 vs 92.2). Los precios son idénticos. Jev lee 64k tokens por solicitud frente a los 32,768 de Microsoft. Mi reseña de Jev cuenta más sobre cómo se comporta en la práctica.
¿Hay una alternativa de código abierto a Microsoft-Decision-1?
Microsoft no ha publicado los pesos, así que no puedes alojarlo tú mismo. Perplexity Decider v1.1, Surogate Rune 26B-A4B v3, los modelos Clef de Cloudflare y Strands Decider de AWS se publican bajo Apache 2.0. Perplexity Decider v1.1 encabeza actualmente el Decision Index de la comunidad.
¿Qué alternativa a Microsoft-Decision-1 admite imágenes?
La Decisions API de OpenAI, Cloudflare Clef y Clef-flash, Perplexity Decider y Rune v3 aceptan imágenes. Microsoft-Decision-1 y Jev solo admiten texto. Si aparecen capturas de pantalla en tu flujo de triaje de tickets, eso por sí solo reduce la lista.
¿Cómo se compara Microsoft-Decision-1 con la Decisions API de OpenAI?
OpenAI cobra $0.10 por millón de tokens de entrada en gpt-6-luna, unas 2,4 veces la tarifa de Microsoft, también con salida gratuita. A cambio obtienes imágenes, una ventana de 1,050,000 tokens y opciones ZDR y HIPAA para clientes elegibles. La API sigue en beta pública. Consulta mi artículo sobre los precios de la Decisions API.
¿Necesito un modelo de decisión para enrutar tickets de soporte?
Solo si estás integrando el enrutamiento en tu propio producto o pipeline. Si el objetivo es que los tickets se clasifiquen y se respondan dentro de tu helpdesk, un agente de helpdesk con IA hace la decisión y el trabajo sin código. Mi guía para automatizar el triaje de tickets recorre ambos caminos.