

Resumen
Strands Decider 2B es un modelo de decisión de 1,9B gratuito y abierto de AWS Strands Labs, publicado el 1 de octubre de 2026. Le das un texto y preguntas tipadas ("¿qué equipo?", "¿es urgente?") y devuelve una etiqueta con una puntuación de confianza en una sola pasada. Puntúa 0,762 en JevBench, cerca de lo más alto de su clase de tamaño, y funciona en unos 115 ms en una GPU de gaming.
Lo que la mayor parte de la cobertura del lanzamiento pasa por alto: los pesos son lo menos interesante de la caja. No hay API alojada, el servidor local no tiene autenticación, y en un servidor con CPU normal una pregunta tarda alrededor de 1,6 segundos, no 115 ms. Lo que AWS ha publicado en realidad es un kit abierto, con los datos de entrenamiento, la receta y un registro de investigación, para que puedas reentrenarlo con tus propias preguntas en unas 11 horas con una sola RTX 3090.
Para los equipos de soporte, clasificar el ticket es la mitad fácil. En una prueba de eesel con tráfico real, la clasificación con IA alcanzó una precisión del 93%, mientras que solo el 12% de las respuestas redactadas salieron sin editar. Si quieres que la clasificación, el enrutamiento y la respuesta se resuelvan juntos dentro de Zendesk o Freshdesk, el compañero de IA para helpdesk de eesel lo hace sin que tengas que alojar un modelo.
¿Qué es Strands Decider?
Strands Decider 2B es un modelo de decisión pequeño de Strands Labs, la rama experimental del proyecto de código abierto Strands Agents de AWS. El artículo de lanzamiento cita como autores a Marc Brooker, Mike Chambers y Fabio Nonato de Paula, y todo se publica bajo Apache-2.0.
Un modelo de decisión no escribe texto. Piénsalo como un modelo de lenguaje pequeño al que se le ha quitado el habla. Responde a preguntas que tú defines, entre opciones que tú defines, y te da una probabilidad para cada una. La categoría despegó después de que TypeSafe Jev se lanzara en septiembre, y el equipo de Strands lo dice sin rodeos: es "a type of model that has been gaining a lot of attention since TypeSafe AI's launch of Jev."
Yo construyo las integraciones de eesel y la superficie de la API de helpdesk, y la llamada de clasificación (qué equipo, qué urgencia, si es spam) es el paso que he conectado en más helpdesks que ningún otro. Así que leí este lanzamiento como leería una pieza que podría meter en un pipeline: qué devuelve, a qué velocidad, dónde falla y qué me queda por construir.
Esta es la ficha técnica resumida:
| Característica | Strands Decider 2B |
|---|---|
| Publicación | 1 de octubre de 2026 |
| Parámetros | 1,9 mil millones |
| Modelo base | Qwen3.5-2B-Base, LoRA de rango 16 + cabeza de punteros |
| Modelo de referencia actual | strands-decider-2B-hobson-v21 (v19 sigue publicado) |
| Tipos de pregunta | noul (sí/no), choice (una de N), score (escala ordenada) |
| Salida | Una respuesta por pregunta, con una probabilidad calibrada |
| Contexto | 4.096 tokens por defecto |
| Licencia | Apache-2.0 (pesos, código, datos, receta) |
| Opción alojada | Ninguna |
| Hardware | CUDA, Apple MPS o MLX, CPU |
Cada fila proviene del README de GitHub del proyecto y de su ficha de modelo en Hugging Face.
¿Cómo funciona Strands Decider?
El truco es restar. Strands toma un modelo de lenguaje normal, conserva su "torso" (las capas que entienden el texto) y descarta la cabeza que normalmente generaría palabras. En su lugar hay una diminuta cabeza de punteros, con poco más de un millón de parámetros, que puntúa cada opción de respuesta. El README lo resume así: "One forward pass, no generation, no decoding loop."
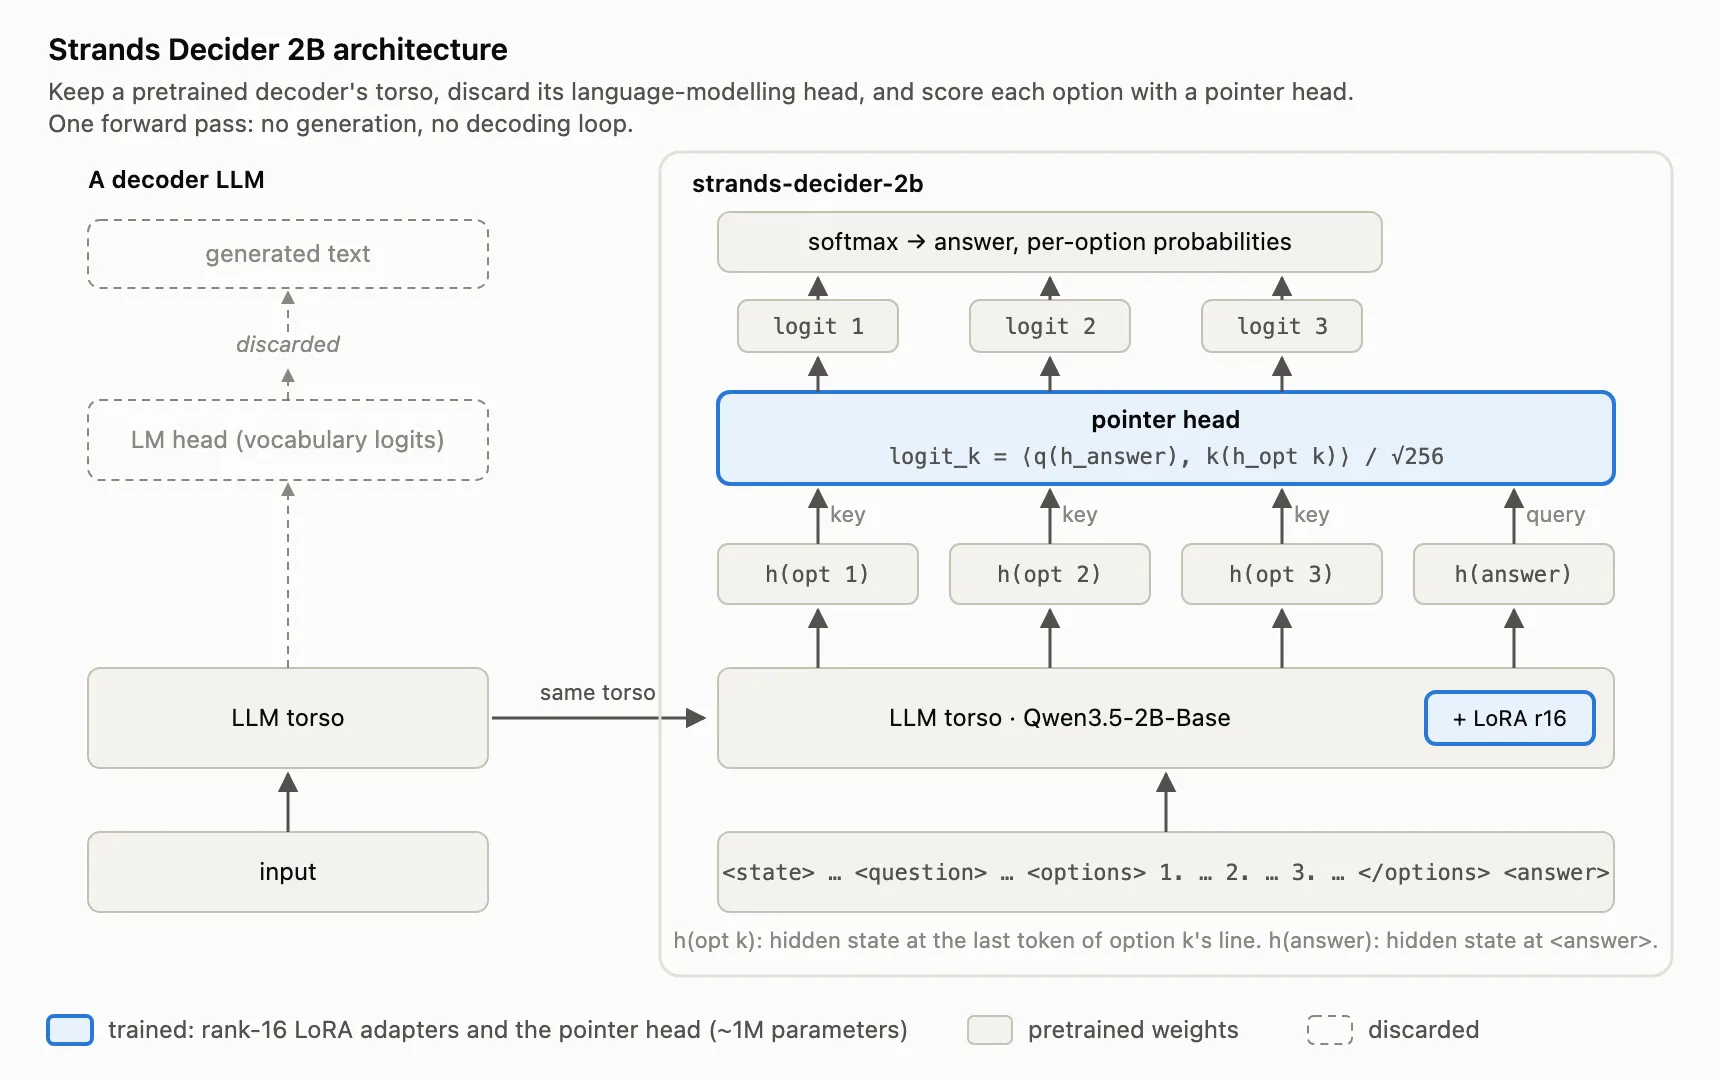
Como nunca genera, no puede salirse del formato. Si pides una de billing, sales o retail, obtienes una de esas tres, siempre. Es la misma promesa que la llamada a funciones en un LLM grande (o el modo JSON, su primo más laxo), pero más barata, porque no hay un bucle token a token ni JSON que analizar.
También significa que añadir preguntas cuesta muy poco. El modelo lee tu texto una vez, y "each question adds only its own tokens." Así que preguntar "¿qué equipo?", "¿es urgente?" y "¿qué tan frustrado está quien escribe?" en una sola llamada cuesta casi lo mismo que hacer una.
La demo de la ficha de Hugging Face es un ticket de soporte, lo que dice exactamente quiénes cree AWS que son los compradores:
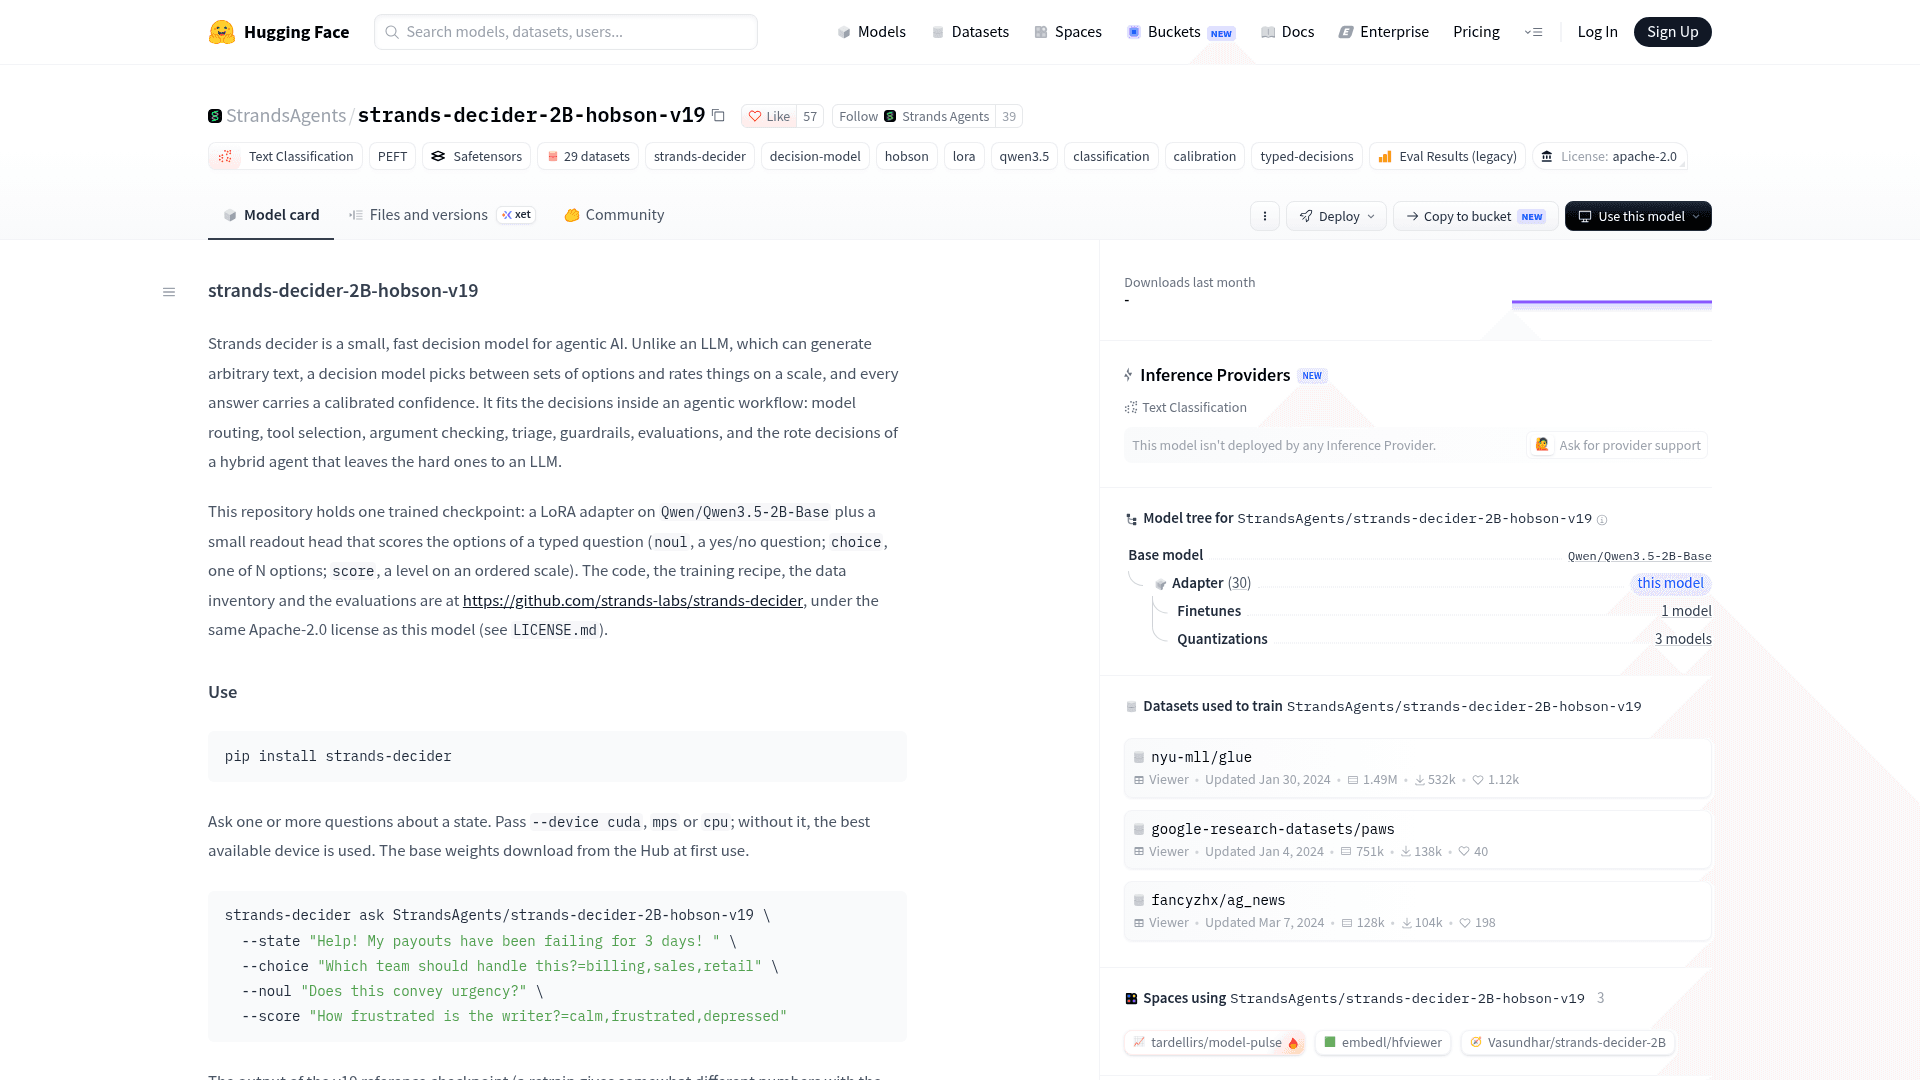
Para ejecutarlo como servicio, inicias el servidor incluido y le envías peticiones:
pip install strands-decider
strands-decider serve StrandsAgents/strands-decider-2B-hobson-v21 --port 8000
Los pesos se descargan de Hugging Face en el primer uso. Luego haces POST /v1/systemone con un objeto state y otro questions, y recibes respuestas por pregunta, uso de tokens (output_tokens: 1) y latency_ms. Algo que conviene saber antes de ilusionarte con cambiarlo por Jev: la documentación dice que el adaptador de JevBench funciona sin modificar contra este endpoint, y añade: "Compatibility with the Jev API itself is not verified" (docs/inference.md).
El proveedor también es franco sobre los límites. El artículo de lanzamiento dice que el diseño de una sola pasada lo hace "significantly worse at solving complex problems than reasoning models", y que es "unsuited for coding, chatbots, document summarization." La ficha del modelo añade que los documentos largos y de varios pasos son su punto débil.
¿Qué tan preciso es Strands Decider?
En el conjunto público de JevBench (231 tareas), las cifras del repositorio son:
| Medición | v21 (referencia) | v19 (lanzamiento) |
|---|---|---|
| Precisión | 0.762 (176/231) | 0.723 (167/231) |
| Puntuación de Brier (menos es mejor) | 0.323 | 0.342 |
| Error de calibración (ECE) | 0.064 | 0.052 |
| Niveles fácil / estándar / difícil | 1.000 / 0.931 / 0.550 | 1.000 / 0.875 / 0.505 |
La frase que más respeto de todo el lanzamiento es aquella en la que el equipo resta importancia a su propia mejora. Tras seis ejecuciones de entrenamiento cada una, las recetas de v19 y v21 promedian "172.8 and 172.3 JevBench tasks: the same accuracy." La cifra más alta de v21 es en buena parte suerte de la semilla, y lo dicen. Esa honestidad vale más que los cuatro puntos extra.
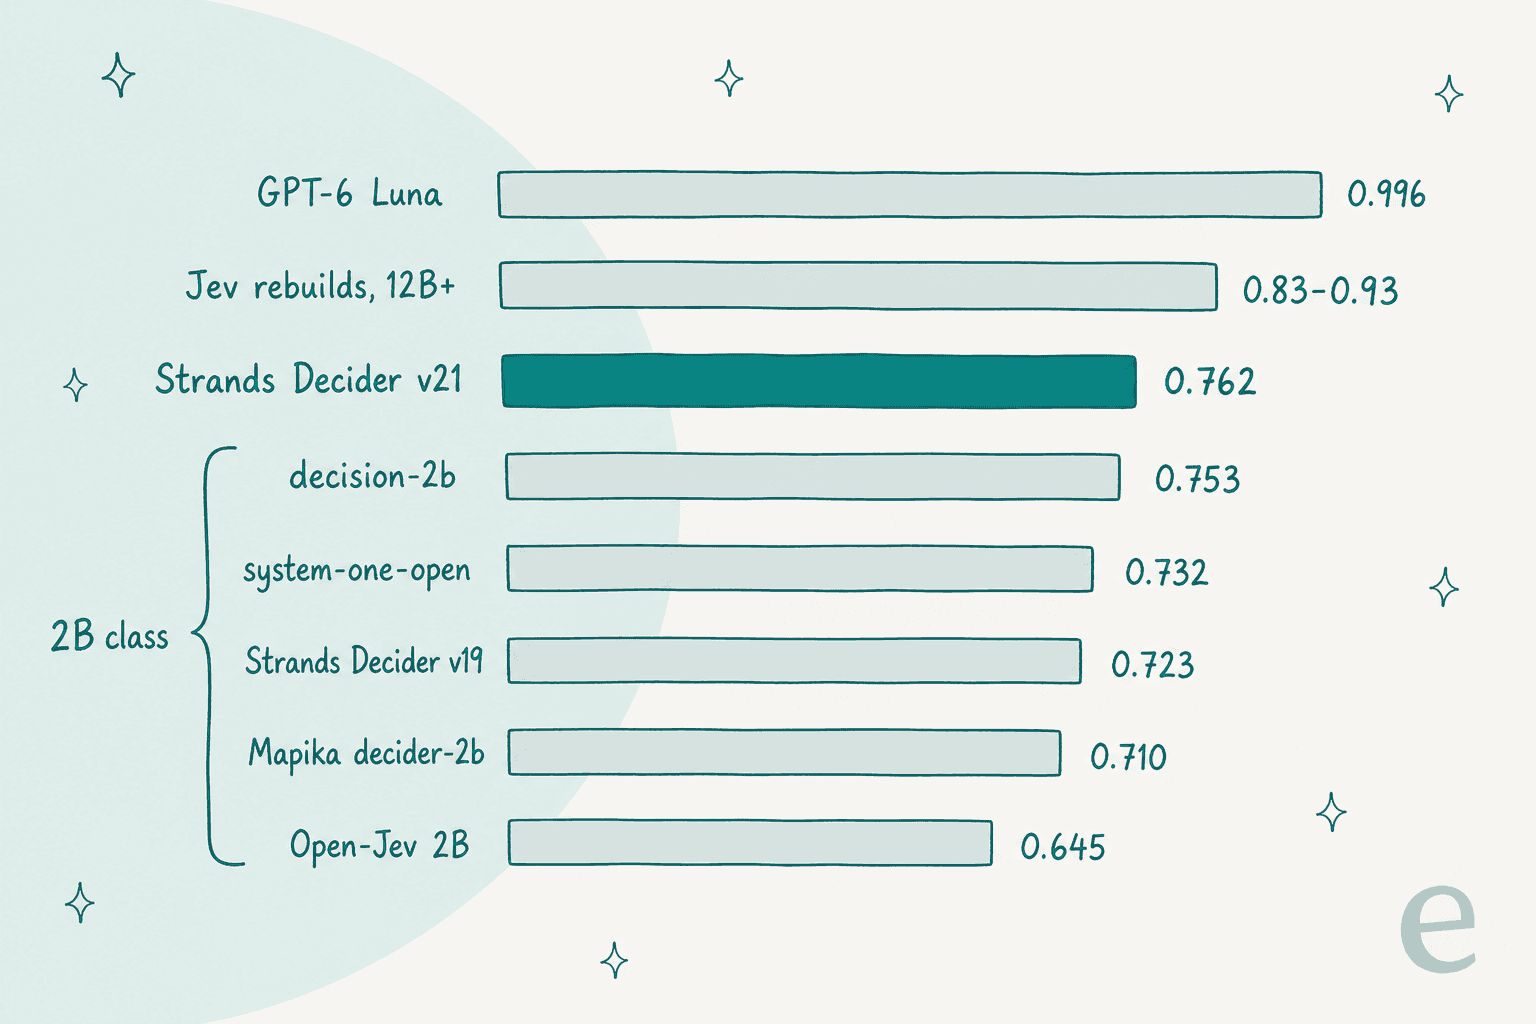
¿Dónde queda en la tabla? En la clasificación de JevBench v1.4.2 (89 sistemas, 25 de septiembre), v19 estaba en el puesto 50 en total y el 3.º de 33 en la clase de 2B, por detrás de decision-2b de FlyMy.AI (0,753) y de system-one-open, basado en Gemma (0,732), según las notas de evaluación. La cima de la tabla es de los modelos de razonamiento, con GPT-6 Luna en 0,996, y después las reconstrucciones de Jev sobre torsos de 12B o más, de 0,83 a 0,93. Si quieres ver todo el panorama junto, la comparativa de alternativas a Jev los ordena.
Así que el planteamiento honesto: Strands Decider es un modelo pequeño fuerte, no un modelo fuerte. Cambia unos 23 puntos de precisión frente a un LLM de frontera por velocidad, precio y la posibilidad de ejecutarse en tu propia máquina.
Un apunte si miras la gráfica del historial de entrenamiento en el artículo de lanzamiento: etiqueta dos puntos de comparación como "strands-decider-2b v10/v11". Marc Brooker lo corrigió en Hacker News: son otro modelo llamado "decider-2B", "which isn't ours."
¿Significan algo las puntuaciones de confianza?
La calibración es todo el argumento de venta. Una puntuación de confianza solo sirve si es honesta: una etiqueta solo sirve para automatizar si puedes decir "actúa por encima de 0,9, pasa a una persona por debajo." El repositorio afirma que, en tareas cortas de clasificación no vistas, "answers at a confidence of 0.9 or more are right about 95% of the time."
Es alentador, con dos salvedades que plantea la propia ficha del modelo: las bandas de confianza se fijaron solo con clasificación corta, así que "measure on your own traffic before you trust a threshold", y el modelo lee las preguntas con menos atención que los documentos, de modo que una pregunta reformulada suele obtener la misma respuesta. Los primeros usuarios han encontrado una tercera:
"From what i can tell from my (limited) experiments, there is a lot of variation caused by simply reordering options, plus a heavy bias toward the first option listed"

La solución es aburrida y funciona: baraja el orden de las opciones en tus pruebas y evalúa el modelo con unos cientos de tickets etiquetados tuyos antes de fiarte de cualquier cifra. El propio Brooker sugirió en HN que con 2B puedes ajustarlo con tus preguntas, o simplemente recalibrarlo sin ajuste fino.
¿Qué tan rápido es Strands Decider en hardware real?
La cifra estrella del artículo de lanzamiento es una mediana de 115 ms en una RTX 3090. Es real, y es un número de GPU. Este es el panorama más amplio, con todas las cifras tomadas del repositorio, sus pull requests o Hacker News:
| Hardware | Latencia por pregunta | Fuente |
|---|---|---|
| RTX 3090 (GPU) | mediana 115 ms, p95 299 ms | README |
| M3 Pro (Apple silicon) | mediana en caliente 153 ms por debajo de 300 tokens, 234 ms en todas las tareas | README |
| M4 Pro (solo CPU) | de 0,3 a 0,5 s una vez cargado | PR #46 |
| Xeon 8375C, 8 hilos | unos 1,6 s con entrada corta, de 16 a 18 s con ~3.000 tokens | docs/inference.md |
| Graviton 4, bf16 (PR sin fusionar) | 1,15 s | PR #48 |
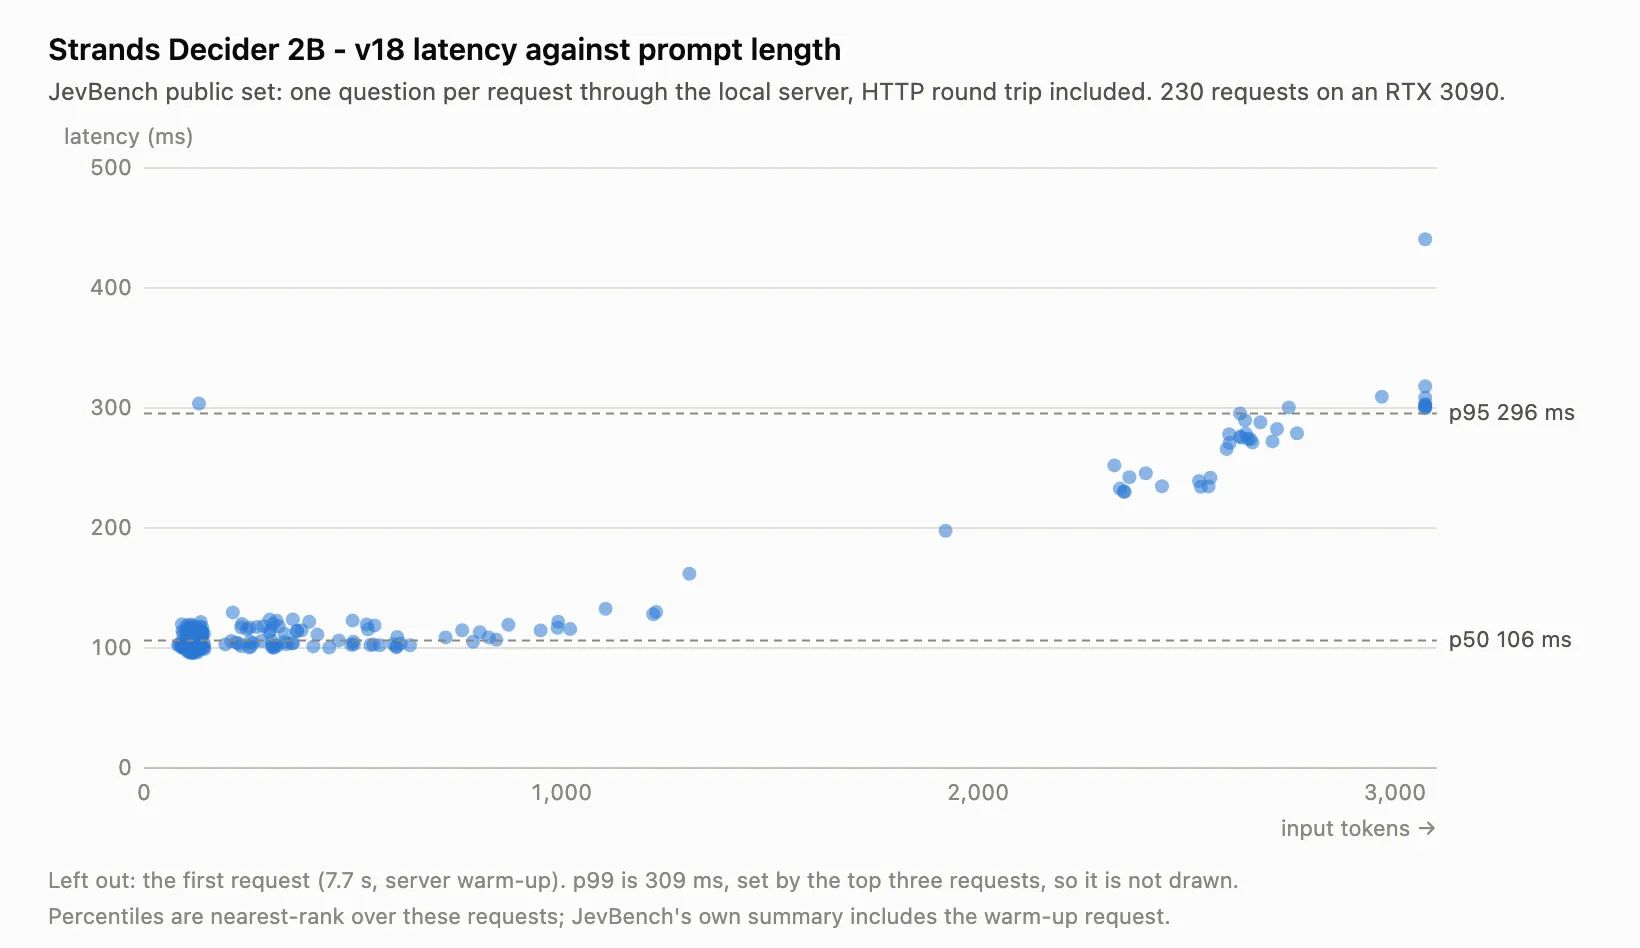
El patrón importa más que cualquier cifra suelta. La latencia crece más o menos al ritmo de la longitud de la entrada, así que un hilo largo de correos cuesta mucho más que un mensaje de chat de una línea. Y en el tipo de servidor con CPU que la mayoría de los equipos levanta por defecto, una decisión tarda segundos. Un usuario de HN vio alrededor de medio segundo con seis núcleos; otro midió 1.732 ms en un contenedor Docker solo con CPU. Si la decisión está delante de un cliente que espera una respuesta de chat, o dentro de un paso de enrutamiento inteligente, necesitas una GPU o Apple silicon.
¿Cuánto cuesta Strands Decider?
El modelo es gratis. Ejecutarlo no, y no hay nadie más que tú para pagarlo.
- Sin endpoint alojado. La página de Hugging Face dice "This model isn't deployed by any Inference Provider", y no hay ficha en Bedrock. Bedrock solo aparece en el artículo de lanzamiento como el LLM del ejemplo de agente.
- Sin autenticación. El servidor local se enlaza a
127.0.0.1y, en palabras de la ficha, "has no authentication: use it for local experiments." Ponerlo detrás de un balanceador de carga, con autenticación y monitorización, es cosa tuya, las mismas tareas que se tratan en las alternativas a Strands harness para alojar agentes. - Aún no hay una versión oficial para llama.cpp. Brooker explicó en HN que no se puede convertir solo el LoRA, porque "there's a whole pointer head and some custom layers." Existe un port GGUF de la comunidad, igual que uno ONNX, pero ambos son no oficiales.
Así se compara con las dos opciones alojadas con las que la mayoría de los equipos lo comparan:
| Strands Decider 2B | TypeSafe Jev | Cloudflare Clef | |
|---|---|---|---|
| Pesos | Abiertos, Apache-2.0 | Cerrados | Abiertos, Apache-2.0 |
| Tamaño | 1,9B | No divulgado | 27B (Clef-flash 9B) |
| API alojada | Ninguna | Sí, incl. Workers AI | Workers AI |
| Precio | Gratis, más tu hardware | $0.042 por 1M de tokens de entrada, salida gratis | $0.24 por 1M de entrada (flash $0.09) |
| Contexto | 4.096 por defecto | 32.000 | 64K alojado |
| Ajustarlo tú mismo | Sí, receta completa | No | Ajuste por RL con el equipo de Cloudflare |
| Análisis a fondo | Este artículo | Reseña de Jev | Clef explicado |
La tarifa de Jev procede de su ficha en Workers AI, y la de Clef de la página de modelo de Cloudflare. Las cuentas completas están en el desglose de precios de Clef.
Con la tarifa de Jev, un millón de decisiones de 500 tokens cuestan unos $21 en tokens de entrada. Esa es la vara que una GPU autoalojada tiene que superar una vez que añades las horas de ingeniería para mantenerla. Para la mayoría de los equipos no lo hará (la misma cuenta que con cualquier modelo autoalojado, mira los precios de Qwen), hasta que el volumen sea muy alto o los datos no puedan salir de tu red. Ese último caso, los datos regulados, es donde Strands Decider es más fácil de justificar.
¿Qué publicó realmente AWS?
Aquí es donde Strands Decider se distingue de Jev, y es la parte a la que enviaría a quien construye. El artículo de lanzamiento dice que la publicación incluye "all the training data and scripts we used to build the model."
- Datos de entrenamiento. Conjuntos de datos de Hugging Face, ContractNLI y MuSiQue, filas sintéticas verificadas por modelos de pesos abiertos y las distribuciones de salida de un profesor Qwen3.5-4B congelado. Cada fuente y su licencia figuran en data/sources.md.
- La receta. Un script,
training/recipe.sh all. Reentrenar lleva unas11 horas en una RTX 3090o unos1 h 10 min en ocho H100. - Un registro de investigación preregistrado. Cada ejecución de entrenamiento declara sus predicciones y condiciones de fallo antes de correr. Rara vez he visto esto en el lanzamiento de un modelo, y es la razón por la que confío en la admisión de que "v21 es igual que v19".
Eso hace que Strands Decider sea menos un competidor de Jev y más un kit para construir tu propio clasificador de tickets. Si tus categorías son específicas (tus líneas de producto, tus reglas de reembolso, tus niveles de escalado), reentrenar con unos miles de filas etiquetadas tuyas de clasificación de tickets es el camino que señalan los propios autores. Si el ajuste fino es nuevo para ti, la receta es uno de los lugares más limpios para aprenderlo.
El repositorio también se mueve rápido. Los pull requests fusionados el 7 y el 8 de octubre añaden soporte para torsos Gemma 4 (E2B, E4B, 12B y 26B-A4B) y un comando soup que promedia varias ejecuciones de entrenamiento en un solo checkpoint. Los PR nombran cinco checkpoints próximos, y Brooker escribió en HN que "we've got some new ones coming this week." Ninguno tiene aún cifras de benchmark publicadas, así que esperaría antes de planificar en torno a ellos.
¿Qué dicen los desarrolladores sobre Strands Decider?
El hilo de lanzamiento en Hacker News superó los 270 puntos en un día. El tono es más cálido que en los hilos de Jev, sobre todo porque los pesos son abiertos. El informe positivo más claro vino de alguien que lo ejecuta en el dispositivo:
"This is a great model. I've been running it on device in chrome extension to filter things like email. It is just the right mix of size, capability and speed to make it generally useful for adhoc bulk classification tasks."
El coautor Marc Brooker planteó hacia dónde ve que va esto, un modelo mental útil para quien construye agentes:
"There are a ton a ways to use models like this. Model routing is a popular emerging one. The one that really interests me is hybrid agentic workflows - filling the gap between deterministic workflows (e.g. AWS StepFunctions) and fully agentic workflows that use frontier intelligence."
Las críticas son justas y concretas. Un hilo sostuvo que una buena calibración en benchmarks "does not establish reliability on unfamiliar production inputs" (soltanov). Otro comentarista señaló que Clef de Cloudflare funciona sobre llama.cpp, mientras que Strands, por ahora, necesita su propio CLI y servidor:
"clef from cloudflare runs on llama.cpp - being locked-in to strands cli would be a bummer and will slow down adoption."
Coincide con mi lectura. El modelo es bueno para su tamaño, las herramientas son jóvenes, y quienes obtienen valor ahora mismo son desarrolladores cómodos alojando su propia inferencia.
¿Dónde encaja Strands Decider en una cola de soporte?
El uso evidente es la clasificación de tickets: qué equipo, qué grado de urgencia, si es spam. Es clasificación de intención clásica, y los modelos de decisión encajan bien en esa llamada. Aquí conviene fijar las expectativas con cuidado.
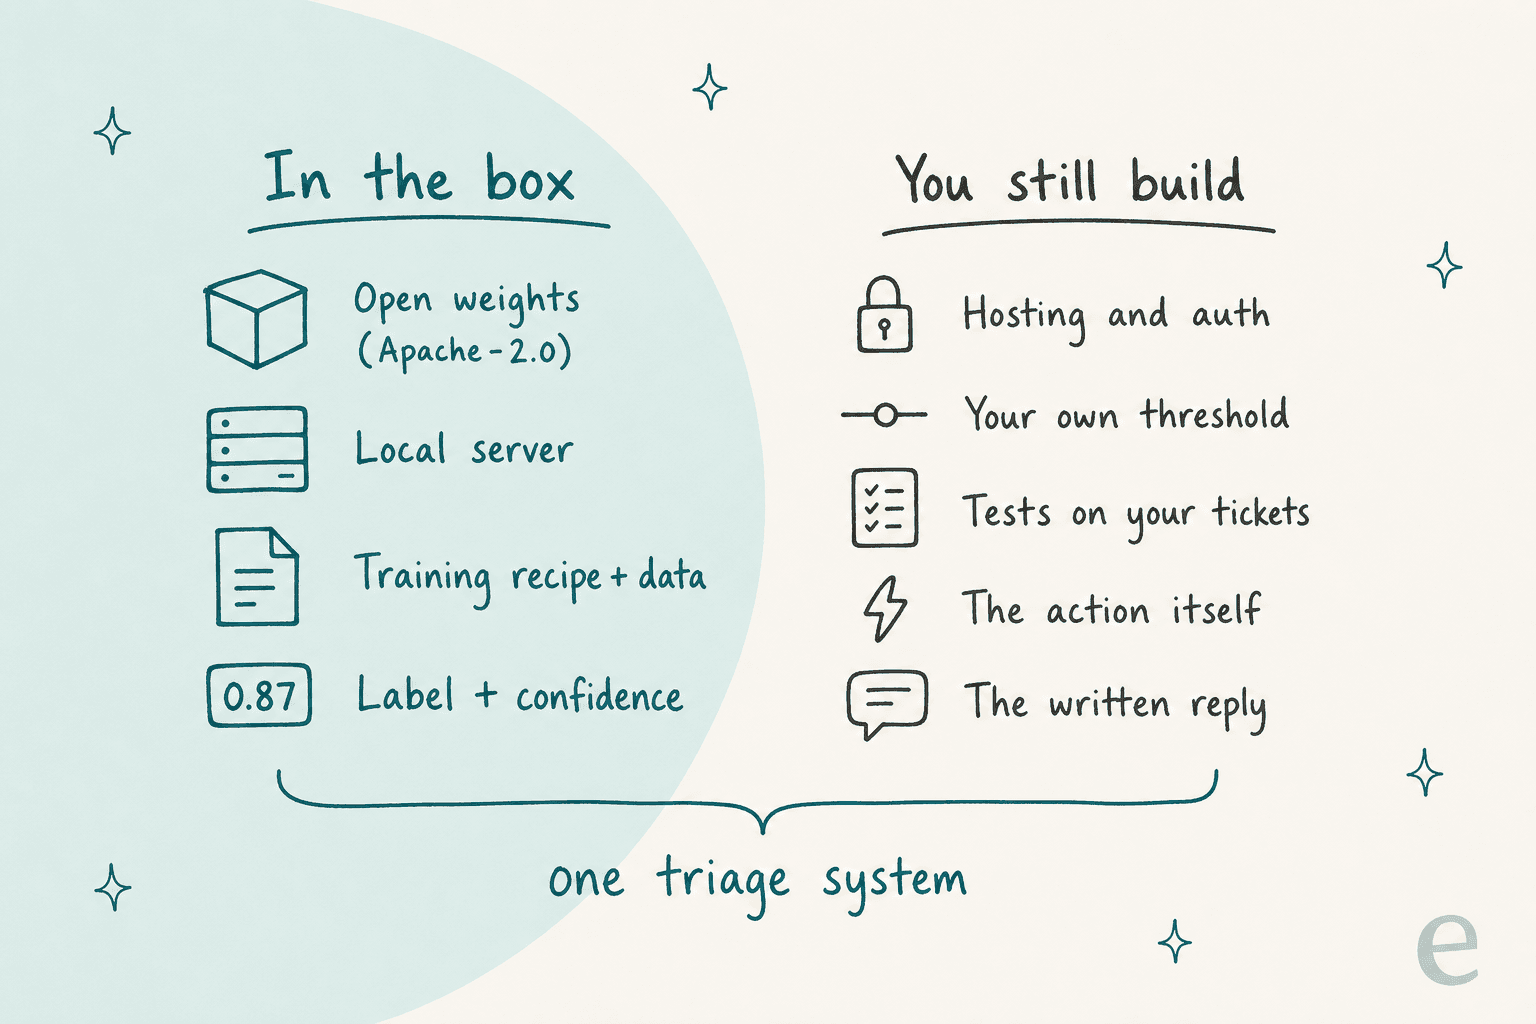
Una etiqueta es una fracción de un sistema de clasificación. Alguien tiene que alojar el modelo, elegir un umbral, probarlo con tickets reales y luego etiquetar, asignar o escalar el ticket en Zendesk o Freshdesk. Y después de todo eso, el cliente sigue necesitando una respuesta.
Así se ve cuando el umbral de confianza hace su trabajo:
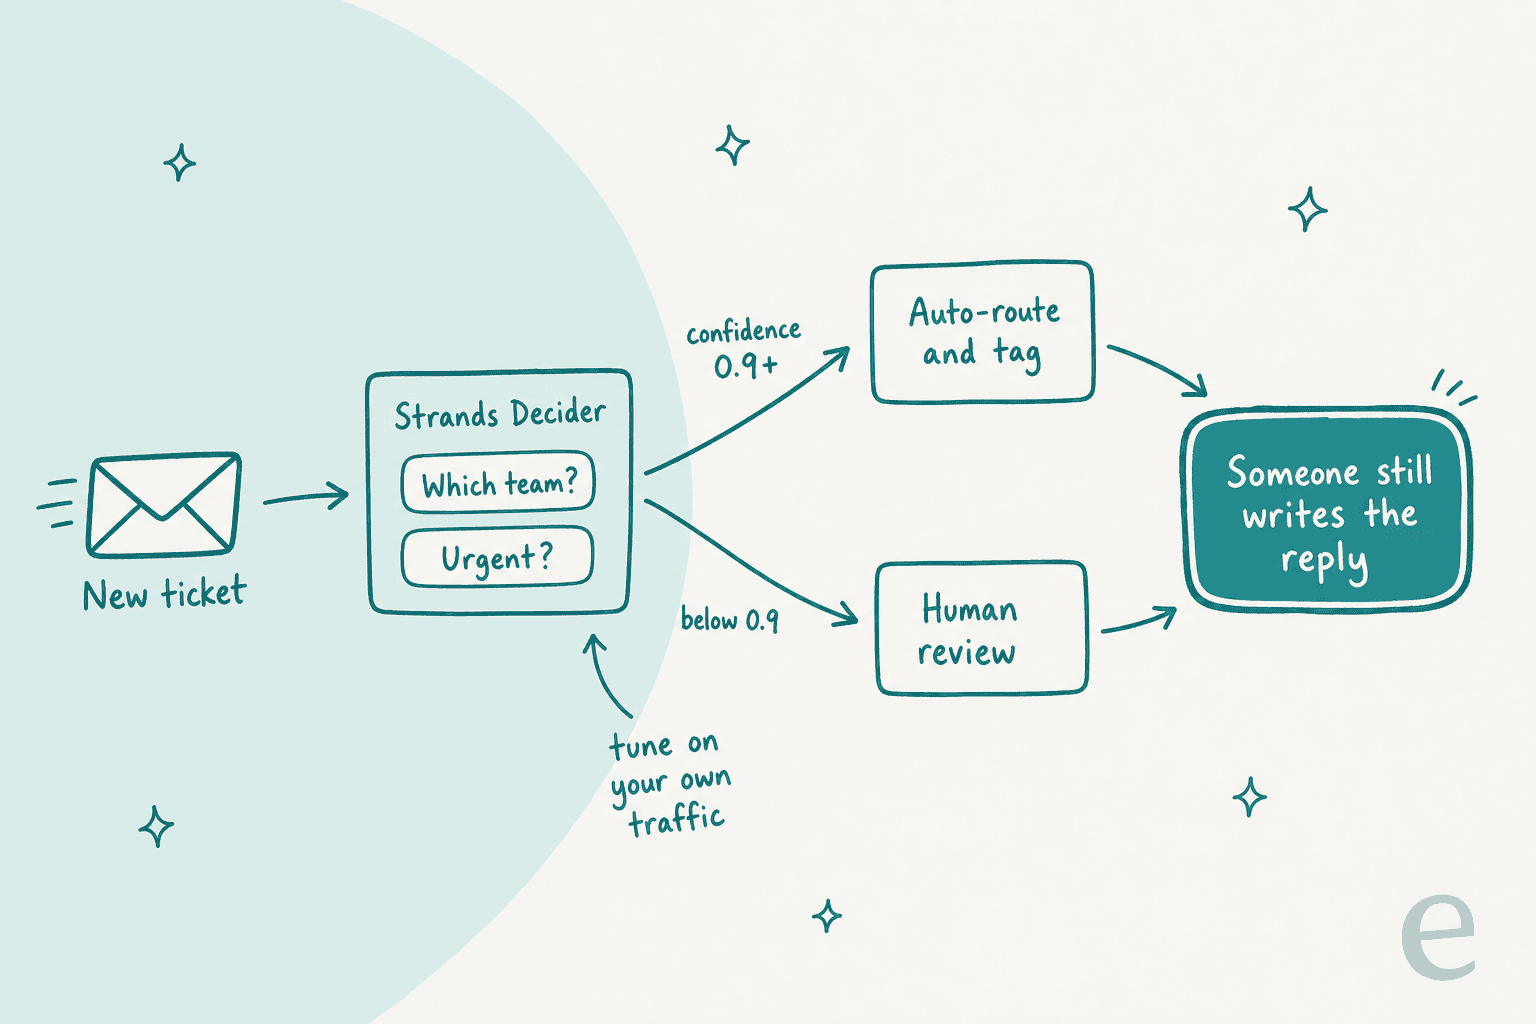
Esa última caja es la que los equipos subestiman. En una prueba de eesel con verificación cruzada sobre una bandeja de entrada real de Zendesk de un e-commerce, la clasificación con IA alcanzó el 93% de precisión y detectó el 100% del spam (cerca del 22% de la bandeja), pero solo el 12% de las respuestas redactadas se enviaron tal cual. Clasificar es la mitad fácil; la respuesta es donde está el trabajo.
Lo que piden los compradores es exactamente lo que promete un modelo de decisión calibrado. Una responsable de CX que gestiona unos 7.000 tickets al mes lo expresó así en una llamada de ventas de eesel:
"I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Esta es mi recomendación según la situación:
- Eres desarrollador y construyes un agente o un pipeline propio, tus datos no pueden salir de tu red y tienes una GPU: Strands Decider es una gran base. Reentrénalo con tus propias etiquetas.
- Quieres una llamada de decisión sin alojar nada: empieza con Jev. Clef y la Decisions API de OpenAI son las otras opciones alojadas.
- Diriges un equipo de soporte y quieres tickets clasificados y respondidos: no necesitas un modelo de decisión en absoluto. Necesitas algo que tome la decisión y actúe en consecuencia dentro de tu helpdesk. La comparativa de herramientas de clasificación con IA cubre ese camino, y la entrada del glosario sobre clasificación automática explica los términos.
eesel para clasificar, enrutar y responder
Si el trabajo que imaginas para Strands Decider es "ordenar mi cola de soporte", el compañero de IA para helpdesk de eesel hace ese trabajo de principio a fin. Se conecta a Zendesk, Freshdesk o Gorgias en pocos minutos (la integración con Zendesk es la configuración más habitual), aprende de tus tickets anteriores y tu centro de ayuda, y luego etiqueta, enruta, escala y redacta la respuesta.

La misma división en la que se basa Strands Decider, un modelo ligero para la decisión rápida y uno más pesado para la parte difícil, ya es un ajuste. Cada automatización de eesel tiene una opción "Model strength": el modelo habitual para redactar y trabajo de varios pasos, o uno más ligero para tareas como etiquetar o el enrutamiento de tickets. Los eventos que no coinciden con tus instrucciones se omiten y se registran con un motivo, que es el comportamiento de "leave them alone" que pedía aquella responsable de CX. Cada acción puede ponerse en Auto, Needs approval o Disabled en acciones y aprobaciones, de modo que los reembolsos pueden quedar tras un clic humano mientras el etiquetado funciona solo.
Si habrías recurrido a Strands Decider porque te gusta trabajar desde la terminal, la CLI de eesel te da el mismo compañero desde la línea de comandos. npx @eesel/cli funciona sin cuenta (un espacio de trabajo temporal con $5 de uso), cada comando imprime JSON y los errores vuelven como una línea JSON con un indicador retryable, de modo que Claude Code, Cursor o Codex pueden dirigir toda la configuración. Un desarrollador o un agente de programación puede montar un trabajo de clasificación con eesel automations enable <platform> <key> --instructions "...", comprobar un cambio antes con --dry-run y liberar acciones retenidas con eesel approvals approve <id>. Es el mismo agente que en el panel, y los cambios se sincronizan en ambos sentidos. Más sobre esto en mi repaso al terreno de las CLI de agentes.
Antes de que nada salga en vivo, la habilidad de simulación ejecuta el agente sobre tus tickets pasados reales y puntúa cada respuesta, de modo que ves la precisión con tu propio tráfico en lugar de con un benchmark. El plan gratuito incluye 100 créditos sin tarjeta, y los planes de pago empiezan en $299 al mes por 500 tickets o chats en los precios de eesel, sin tarifa por puesto.
Prueba eesel con una parte de tu cola y mira cuántos tickets clasificaría, y respondería, esta semana.
Preguntas frecuentes
¿Qué es Strands Decider?
Strands Decider 2B es un modelo de decisión de código abierto publicado por el equipo de Strands Labs de AWS el 1 de octubre de 2026. Lee un texto junto con preguntas tipadas (sí/no, elegir una o puntuar en una escala) y devuelve cada respuesta con una puntuación de confianza en una sola pasada hacia delante, en lugar de generar texto. Está pensado para tareas como la clasificación de tickets, el enrutamiento y las barreras de seguridad.
¿Strands Decider es gratis?
Sí. Los pesos, el código, los datos de entrenamiento y la receta se publican bajo Apache-2.0, así que descargarlo no cuesta nada. Pagas por el hardware en el que lo ejecutas, porque no hay un endpoint alojado en Bedrock ni en ningún proveedor de inferencia de Hugging Face. Compáralo con los precios de Jev o los precios de Clef, que son alojados y se facturan por token.
¿Qué tan preciso es Strands Decider 2B?
El modelo de referencia v21 puntúa 0,762 en el conjunto público de JevBench (176 de 231 tareas), y v19 puntúa 0,723. Eso lo sitúa cerca de lo más alto de la clase de 2B, pero los LLM de razonamiento como GPT-6 Luna siguen puntuando 0,996 en las mismas tareas. El propio repositorio dice que v21 y v19 tienen la misma precisión al promediar seis ejecuciones de entrenamiento.
¿Puede Strands Decider ejecutarse en una CPU?
Sí, pero espera segundos, no milisegundos. El repositorio mide alrededor de 1,6 segundos por pregunta en un Xeon de 8 hilos con una entrada corta, y de 16 a 18 segundos con unos 3.000 tokens. En una GPU RTX 3090 la mediana es de 115 ms. Para un paso de enrutamiento en vivo, planifica contar con una GPU o Apple silicon.
Strands Decider frente a Jev: ¿cuál debería usar?
Elige Strands Decider si necesitas pesos abiertos, autoalojamiento o la opción de ajustarlo con tus propias preguntas. Elige TypeSafe Jev si quieres una API alojada sin servidores que mantener y un contexto de 32.000 tokens. La comparativa de alternativas a Jev cubre el resto del panorama.
¿Puedo usar Strands Decider para clasificar tickets de soporte?
Sí. El propio ejemplo de la ficha de Hugging Face enruta una queja sobre pagos a facturación, ventas o tienda y marca la urgencia. Aun así, tienes que alojarlo, ajustar un umbral de confianza con tus propios tickets y construir el paso que etiqueta, enruta o responde. Un compañero de IA para helpdesk como eesel gestiona todo ese ciclo dentro de tu helpdesk.
¿Hay una API de Strands Decider en AWS Bedrock?
No, a fecha de 8 de octubre de 2026. El único servidor es uno local (strands-decider serve) que se enlaza a 127.0.0.1 sin autenticación. Bedrock aparece en el artículo de lanzamiento solo como el LLM del ejemplo de agente. Si quieres una API de decisión alojada, mira la Decisions API de OpenAI, Jev o Clef.