

¿Qué es Microsoft-Decision-1?
Microsoft-Decision-1 es un modelo de puntuación de decisiones. Le entregas un texto (Microsoft y OpenRouter lo llaman state) y una o más preguntas con un conjunto fijo de respuestas. Te devuelve una probabilidad para cada respuesta. Esa es toda la interfaz.
Microsoft lo anunció el 9 de octubre de 2026 en una publicación de su blog Command Line escrita por Achint Srivastava, VP de Ingeniería de Software en la Oficina del CTO. La publicación dice que está creado para «enrutamiento, clasificación, priorización, verificación y control de flujos de trabajo» (Microsoft). Satya Nadella publicó el lanzamiento el mismo día y dijo que Microsoft ya lo está probando internamente en respuesta a incidentes, control de calidad y descubrimiento científico (Satya Nadella en X).
Si la categoría es nueva para ti, mi explicación sobre los modelos de decisión cubre el contexto. La versión corta: TypeSafe Jev inició la categoría en septiembre de 2026, Cloudflare, AWS y OpenAI siguieron en pocas semanas, y Microsoft-Decision-1 es la primera entrada de un hiperescalar que vende el modelo en su propia nube.
Lo que no es importa tanto como lo que es. La ficha del modelo de Microsoft dice que «no está diseñado para generación de texto, respuesta abierta a preguntas, conversación, traducción ni resumen» (catálogo de Foundry). No puede escribir una respuesta, un resumen ni una línea de código. Elige.
¿Cómo funciona Microsoft-Decision-1?
Paso los días construyendo la parte de agentes de eesel, así que esta es la parte que busqué primero. La mecánica es más simple de lo que la publicación de lanzamiento hace parecer.
Microsoft tomó el Qwen3.5-9B de pesos abiertos de Alibaba y lo posentrenó «para una puntuación de decisiones rápida y de una sola pasada», y dice que «pronto lo migrará a otros modelos, incluidos Microsoft AI (MAI) y OpenAI» (Microsoft). Los datos de entrenamiento son «conjuntos de datos públicos sujetos al proceso Open Data de Microsoft, más datos sintéticos creados por el equipo» (catálogo de Foundry). La base Qwen es la misma familia que está detrás de Clef-flash de Cloudflare y Strands Decider de AWS.
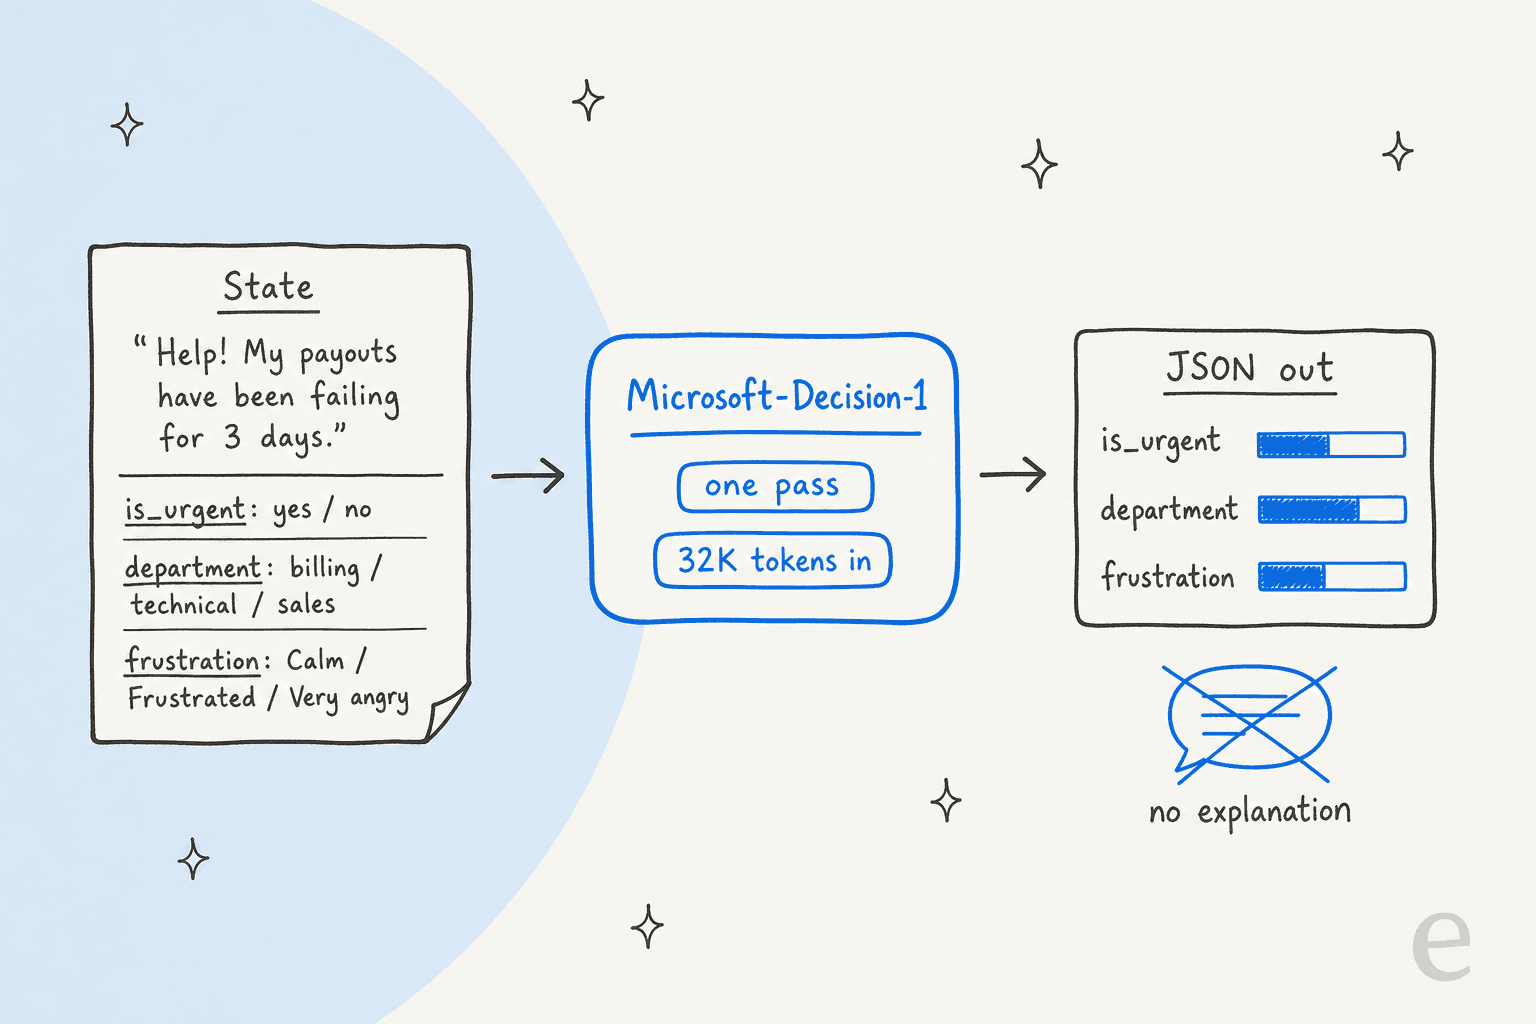
En términos simples, en una llamada ocurren tres cosas:
- Lee el estado y cada pregunta una sola vez. Entran hasta 32.768 tokens de texto. Microsoft lo llama «puntuación de una sola pasada» (catálogo de Foundry).
- Puntúa cada respuesta permitida. En lugar de escribir «billing» letra por letra, asigna una probabilidad a billing, technical y sales al mismo tiempo.
- Devuelve JSON y se detiene. No hay justificación. La ficha dice claramente que el modelo «no genera explicaciones ni justificaciones».
Los tipos de pregunta coinciden con lo que los usuarios de Jev ya conocen. En OpenRouter, una solicitud puede llevar varias preguntas con nombre sobre el mismo estado (OpenRouter):
| Tipo de pregunta | Qué pregunta | Qué devuelve | Ejemplo de soporte |
|---|---|---|---|
noul | ¿Es cierto esto? | Una probabilidad de 0 (no) a 1 (sí) | «¿Transmite este mensaje urgencia?» |
choice | ¿Qué opción encaja? | La elección más una probabilidad por opción | «¿Facturación, técnico o ventas?» |
score | ¿Dónde en esta escala? | Una posición en una rúbrica ordenada | «¿Tranquilo, Frustrado o Muy enfadado?» |
El catálogo de Microsoft enumera algunos extras: calificación basada en rúbricas de respuestas de IA y acciones de agentes, comprobaciones de fundamentación frente a la evidencia aportada, comprobaciones de seguridad y «abstención explícita», es decir, una opción como «no se puede determinar» cuando la evidencia es escasa (catálogo de Foundry). Esto último está infravalorado. Un modelo que puede decir «aquí no hay suficiente para decidir» es mucho más fácil de poner delante de una cola real.
Aquí está la solicitud de ejemplo de OpenRouter, ligeramente recortada. Es un ticket de soporte, lo que dice quiénes creen Microsoft y OpenRouter que serán los primeros compradores:
const decision = await openrouter.alpha.decisions.create({
  decisionsRequest: {
    model: "microsoft/microsoft-decision-1",
    state: "Help! My payouts have been failing for 3 days.",
    questions: {
      is_urgent: {
        type: "noul",
        instructions: "Does this message convey urgency?",
        criteria: { true: "Explicitly time-sensitive", false: "No urgency expressed" }
      },
      department: {
        type: "choice",
        instructions: "Which team should handle this?",
        criteria: {
          billing: "Payments, invoicing, refunds",
          technical: "Bugs, outages, integrations",
          sales: "Pricing, upgrades, new accounts"
        }
      },
      frustration: {
        type: "score",
        instructions: "How frustrated is the customer?",
        criteria: ["Calm", "Frustrated", "Very angry"]
      }
    }
  }
});
Tu código lee entonces las respuestas y decide qué hacer, por ejemplo escalar cuando is_urgent supera 0,8 y el departamento es facturación. Esa lógica de umbrales es el punto clave. Compárala con el modo JSON de un LLM general, donde pagas cada token de salida y aun así obtienes una etiqueta sin una confianza honesta asociada.
¿Cómo se accede a Microsoft-Decision-1?
Hay dos puertas, y se comportan de forma distinta.
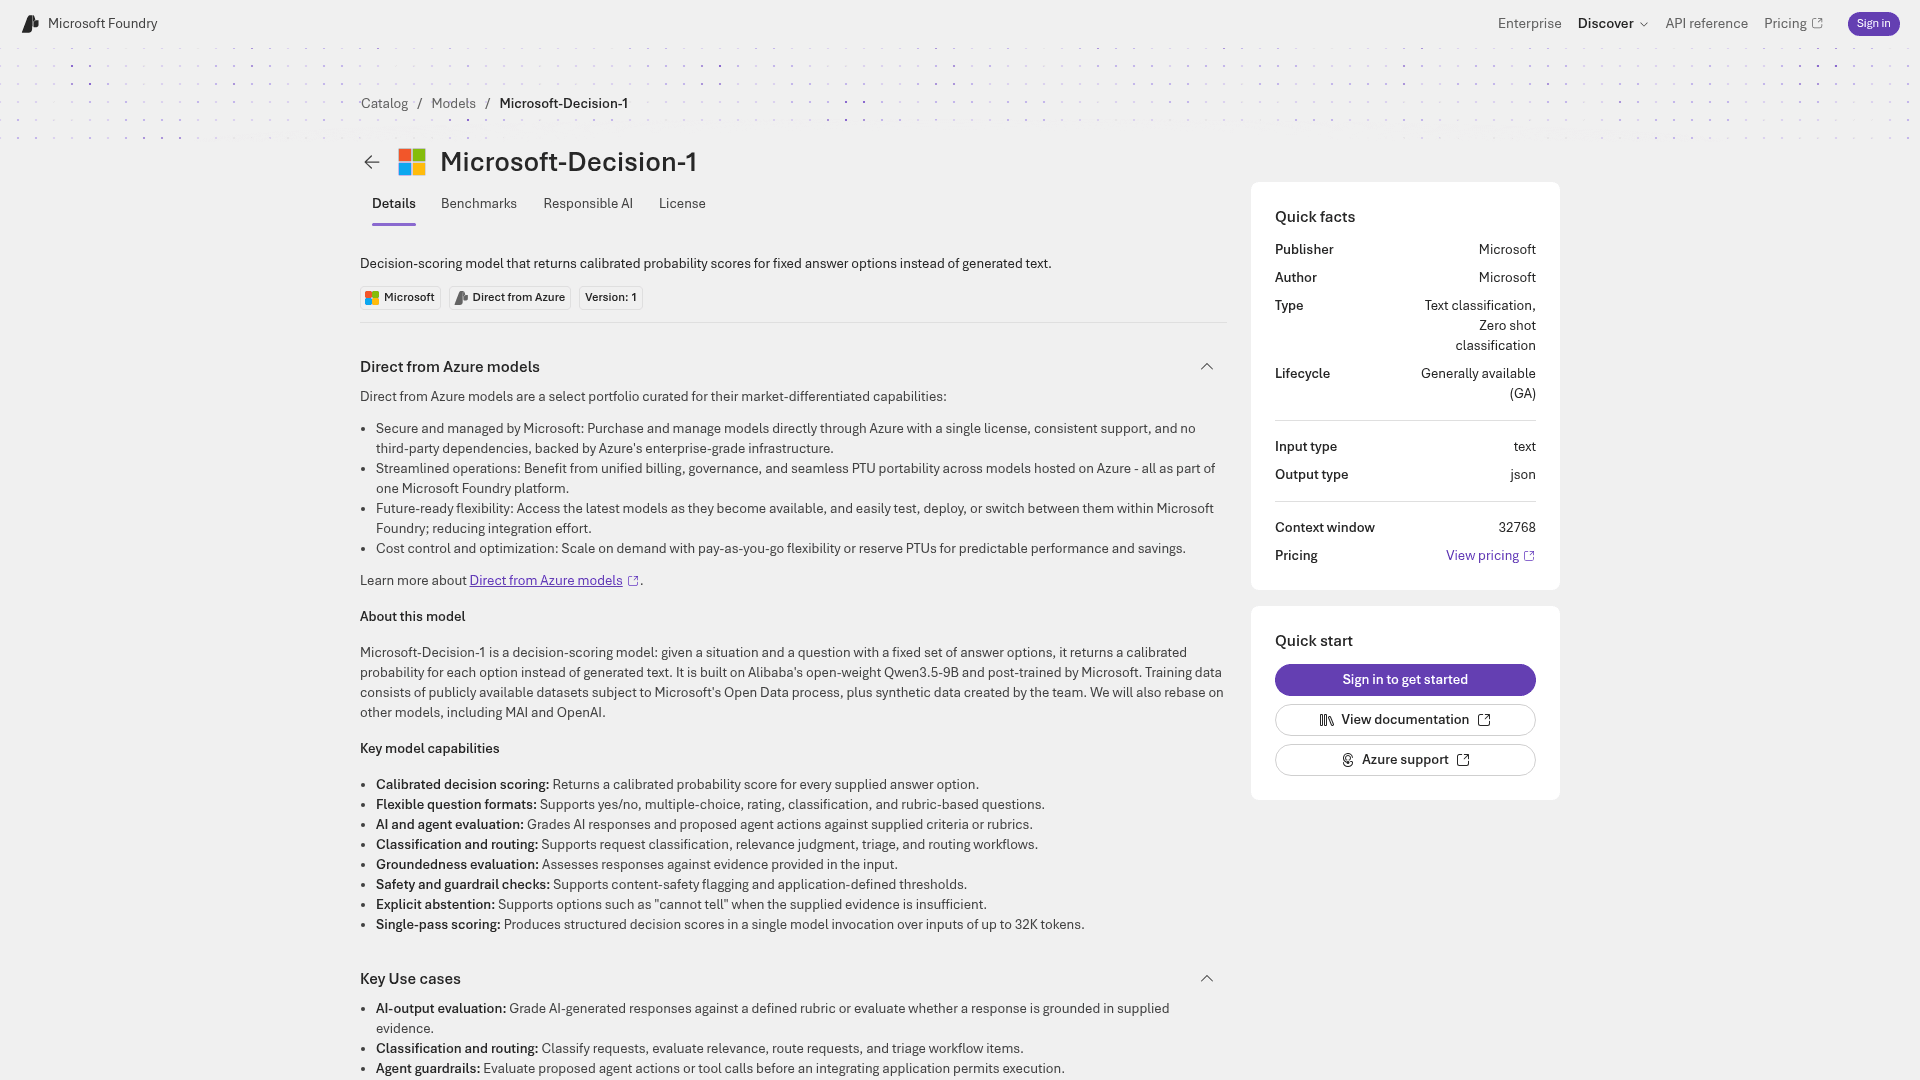
Microsoft Foundry, «Direct from Azure». El catálogo lista Microsoft-Decision-1 como Versión 1 con un ciclo de vida «Generally available (GA)», texto de entrada, JSON de salida y una ventana de contexto de 32.768 tokens (catálogo de Foundry). La documentación de Microsoft Learn lo sitúa entre los modelos vendidos directamente por Azure, que «se facturan a través de tu suscripción de Azure, están cubiertos por los acuerdos de nivel de servicio de Azure y cuentan con el soporte de Microsoft» (Microsoft Learn). Si ya compras modelos de Azure OpenAI, esta es la vía de compra habitual.
La Decisions API de OpenRouter. No hace falta una cuenta de Azure. El ID del modelo es microsoft/microsoft-decision-1, funciona en POST https://openrouter.ai/api/alpha/decisions, y OpenRouter advierte que «los SDK de chat completions no funcionarán con él» (OpenRouter). Azure es el único proveedor detrás, así que cada solicitud sigue llegando a la infraestructura de Microsoft.
| Microsoft Foundry | OpenRouter | |
|---|---|---|
| Estado | GA, Versión 1 | Activo desde el 9 de octubre de 2026 |
| Cuenta | Suscripción de Azure | Clave de OpenRouter |
| Facturación | Tu factura de Azure | Créditos de OpenRouter |
| SLA | Se aplican los SLA de Azure | No es un SLA de Azure |
| Formato de solicitud | Aún no documentado públicamente | Decisions API documentada |
| Actualizaciones del modelo | Versión 1 en el catálogo | «Los pesos se actualizan continuamente mientras la forma de la API se mantiene» |
| Velocidad medida | 85 ms p50, prueba propia de Microsoft | 0,19 s p50 del mejor proveedor, medición de OpenRouter |
Dos filas de esa tabla cambiarían cómo lo pondría en producción. Primero, Foundry es el hogar de producción más seguro, pero el formato de solicitud aún no es público. Un usuario de Hacker News que lo desplegó el primer día escribió:
«Quizá no estoy mirando en el lugar correcto, pero no encuentro cómo es la forma de la API. Incluso he desplegado este modelo vía Foundry y no dice qué enviar ni qué esperar de vuelta.»

Cuando lo comprobé el 11 de octubre, seguía sin haber una página de guía en Learn para el modelo. Segundo, la nota de OpenRouter de que los pesos se actualizan continuamente significa que un umbral que ajustaste el mes pasado puede desviarse sin avisar. Si enrutas con confidence > 0.9, vuelve a comprobarlo tras las actualizaciones.
¿Qué afirman los benchmarks de Microsoft?
La publicación de lanzamiento de Microsoft abre con una comparación de 36 benchmarks que cubre 147.137 preguntas «mantenidas ciegas respecto al entrenamiento» (Microsoft). Este es el núcleo de la tabla que publicó:
| Modelo | Precisión media | Latencia mediana | Calibración (100 = perfecta) |
|---|---|---|---|
| Microsoft-Decision-1 | 83.5% | 85 ms p50, 125 ms p95 | 92,2 |
| Jev 1.13.0 | 82,3 % | 240 ms | 93.7 |
| Quyet-1.0-Large | 81,9 % | 380 ms | 93,1 |
| GPT-6 Luna Decisions | 79,4 % | 300 ms | 89,9 |
| H2O-Lightning-4B v1.1 | 77,2 % | 210 ms | 91,8 |
| Strands-Decider 2B (23 de 36 benchmarks) | 54,8 % | No medida | Sin puntuar |
| GPT-6 Sol (referencia) | Sin clasificar | 3,01 s | Sin puntuar |
Fuente: el anuncio de Microsoft. Microsoft también informa de que el modelo cambia su respuesta en un 1,3 % de las perturbaciones de media, con cero cambios cuando las opciones se parafrasean, se invierten o se reordenan. Las pruebas de seguridad cubrieron 5.250 solicitudes en 11 benchmarks.
Lee las notas al pie antes de citar esas cifras. La latencia de cada competidor procede de la mediana ajustada de JevBench v1.6.1, comprobada el 7 de octubre. Los 85 ms de Microsoft-Decision-1 se «midieron a través de Foundry en la misma región». No es la misma carrera. Y Microsoft queda tercero en calibración, 1,5 puntos por detrás de Jev, lo que importa más que la ventaja en precisión si piensas actuar automáticamente por encima de un umbral de confianza.
Jev no estaba en la tabla al principio. La respuesta con más «me gusta» bajo la publicación de lanzamiento de Nadella, con 335, decía:
«¿Cómo es que Jev no está clasificado? Es literalmente el modelo n.º 1 con el que la gente va a compararlo.»
El anuncio ahora incluye una nota del editor que dice que «se actualizó respecto al original para añadir benchmarks de Jev en precisión y calibración». Mérito para Microsoft por corregirlo rápido. Mi reseña de Jev tiene más sobre el modelo con el que se compara.
Los resultados internos son más escasos pero interesantes. Microsoft dice que su equipo de Copilot lo encontró «competitivo con GPT5.6 Luna y 100 veces más rápido», y que su equipo de XBOX Research pasó más de 10.000 elementos de feedback por él a «más de 14 veces más rápido y 200 veces menos costoso» que GPT-6 Sol (Microsoft). Son equipos de Microsoft evaluando el modelo de Microsoft, así que lo trataría como señales de casos de uso, no como prueba.
¿Qué se ha medido de forma independiente?
No mucho todavía, lo cual es normal dos días después del lanzamiento. Esto es todo lo que pude comprobar desde fuera de Microsoft.
OpenRouter publica su propia latencia para cada modelo que sirve. En tres días midió un p50 del mejor proveedor de 0,19 segundos, un p50 medio de 0,27 segundos y un p99 de 0,67 segundos, con una disponibilidad del 99,90 % (OpenRouter).
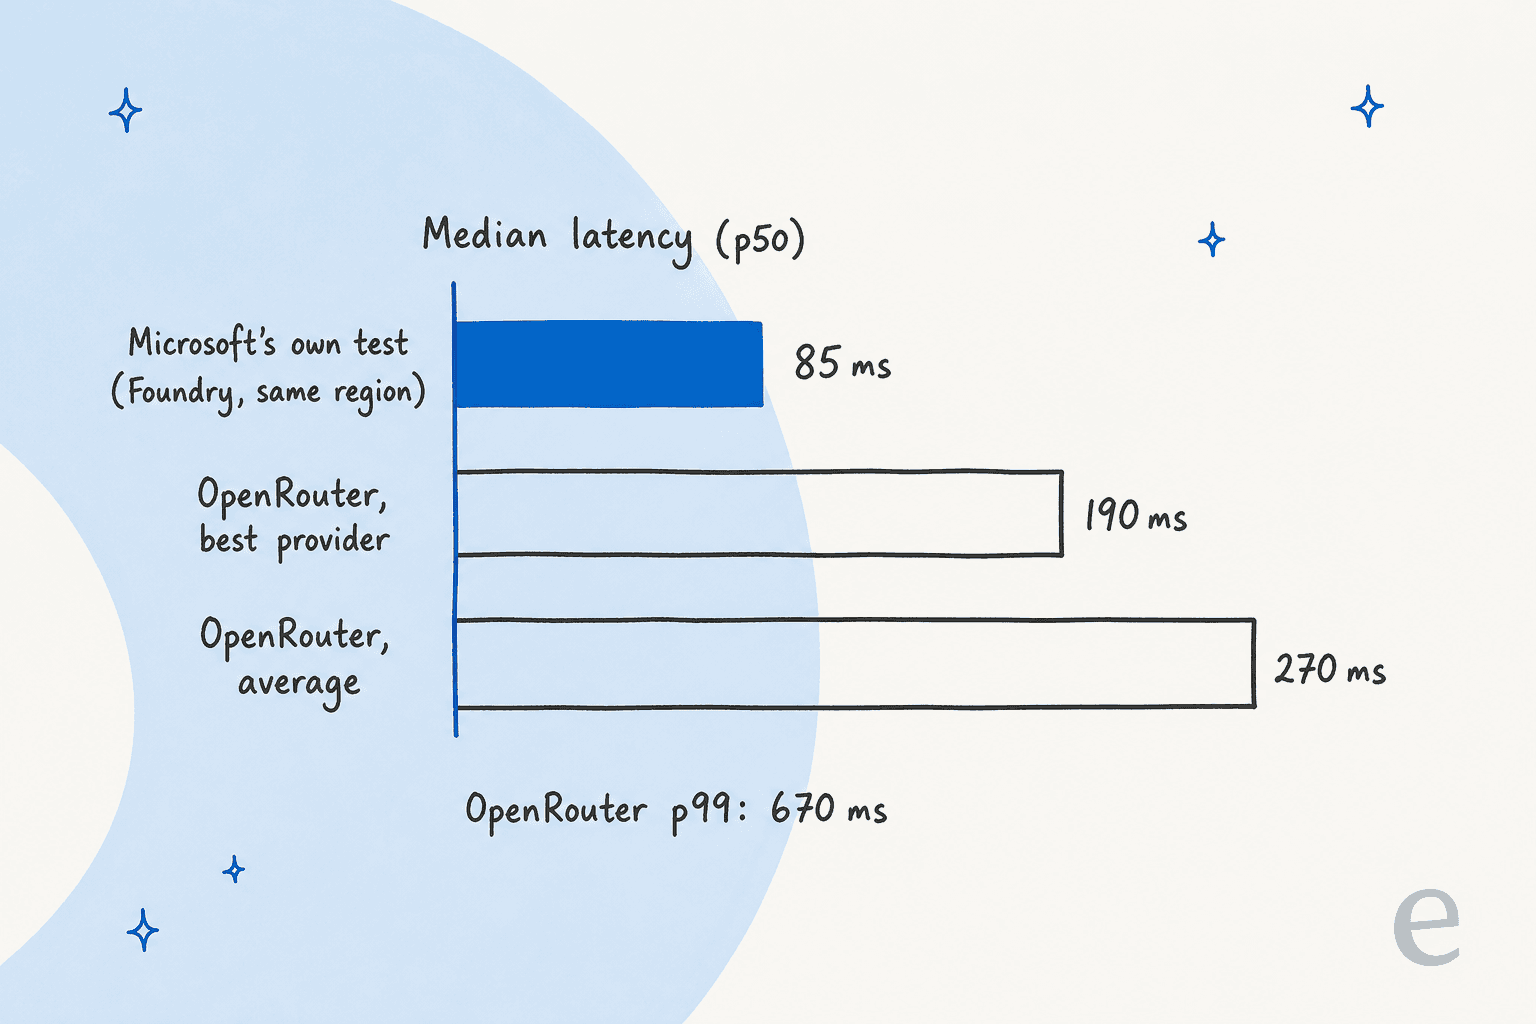
Esa diferencia no significa que la cifra de Microsoft sea errónea. Se mide junto al modelo, mientras que la de OpenRouter incluye un salto por un router. Pero si lo llamas por internet público, cuenta con unos 200 a 300 ms, no 85. Para una sola llamada de enrutamiento sobre un ticket, sigue siendo instantáneo. Para un agente que encadena 20 decisiones, vale la cuenta de Microsoft: «añadir solo 100 milisegundos a cada una de 20 decisiones secuenciales suma dos segundos al flujo de trabajo completo».
La única comparación práctica que encontré vino de un comentarista de Hacker News que lo ejecutó contra Jev:
«En mi suite mínima fue más barato (en un 0,72x) pero con mayor latencia (283 ms frente a 369 ms p50) que Jev. Los resultados fueron muy comparables en todos los escenarios que mido, el primero de estos que he probado que realmente justifica su existencia como lanzamiento comercial.»
Es la pequeña suite de una persona, pero encaja con la forma de la historia: respuestas más o menos al nivel de Jev, a un precio igual al de Jev.
Lo que falta: el Jev Decision Index mantenido por la comunidad se actualizó a la v0.3.1 el 10 de octubre con 117 entradas, y Microsoft-Decision-1 no es una de ellas. Jev está en 60,11 en la nueva puntuación Full de ese ranking, así que hay una vara clara esperando. El uso también es incipiente. Los rankings de decisiones de OpenRouter esta semana muestran a Jev 1.13 con 999M de solicitudes, a GPT-6 Luna Decisions con 11,7M y a Microsoft-Decision-1 fuera del top 10.
¿Cuáles son los límites y las incógnitas?
Esta es la sección que leería dos veces antes de ponerlo en producción. Algunos son decisiones deliberadas de alcance y otros son simples lagunas de la documentación de la semana de lanzamiento.
- Sin explicaciones. Devuelve puntuaciones, nunca razones. Si un responsable de soporte pregunta «¿por qué esto fue a facturación?», el modelo no puede decirlo.
- Solo texto, contexto de 32K. Sin imágenes ni capturas de pantalla, a diferencia de Clef o de la Decisions API de OpenAI. Un hilo de correo largo con historial citado puede alcanzar el tope.
- Sin pesos abiertos. La URL de Hugging Face devuelve un 404, así que el autoalojamiento y el ajuste fino no son opciones.
- Sin regiones, límites de tasa ni cuotas publicados. No aparece en la página de disponibilidad regional de Azure, y la pestaña de licencia del catálogo no se mostraba a visitantes sin sesión, así que no pude leer los términos de licencia.
- Aún no está en la lista de precios de Azure. La tarifa de 0,042 $ está en el anuncio y en OpenRouter, pero la página de precios de Foundry Models no tiene una fila para él. Desglosé lo que eso significa en mi publicación sobre los precios de Microsoft-Decision-1.
- Usos fuera de alcance. Microsoft dice que «no debe usarse como única base para decisiones relativas a crédito, empleo, vivienda, seguros, educación, salud, derechos legales» (catálogo de Foundry).
El primer punto provocó el comentario más duro del hilo de HN, que alcanzó 195 puntos y 65 comentarios:
«Usar el resultado de un modelo de "decisión" sin ver el razonamiento de una decisión concreta parece mucha confianza.»
Estoy de acuerdo, con un matiz. No necesitas que el modelo se explique si registras lo que vio, lo que eligió y con qué confianza, y envías los casos de baja confianza a una persona. Es la misma disciplina que aplicaría para evitar las alucinaciones de la IA en un bot de soporte: probar con historial real, poner puertas a las decisiones de riesgo, mantener un rastro.
¿Cómo se compara Microsoft-Decision-1 con Jev, Clef y el resto?
Microsoft-Decision-1 llega a un campo muy poblado. La versión rápida de quién es quién, comprobada el 11 de octubre de 2026:
| Modelo | Creador | Precio de entrada por 1M | Contexto | Entradas | Pesos abiertos | Dónde se ejecuta | Jev Decision Index v0.3.1 |
|---|---|---|---|---|---|---|---|
| Microsoft-Decision-1 | Microsoft | 0,042 $, salida gratis | 32.768 | Texto | No | Foundry, OpenRouter | No aparece |
| Jev 1.13 | TypeSafe | 0,042 $, salida gratis | 64K por solicitud | Texto | No | API de TypeSafe, Workers AI, OpenRouter | 60,11 (2.º empatado) |
| Clef | Cloudflare | 0,24 $ | 65.536 | Texto, JSON, imágenes, vídeo | Sí, Apache 2.0 | Workers AI | 53,08 (19.º) |
| Clef-flash | Cloudflare | 0,038 $ | 24.576 | Texto, JSON, imágenes, vídeo | Sí, Apache 2.0 | Workers AI | 47,61 (33.º) |
| OpenAI Decisions API | OpenAI | 0,10 $, salida gratis | 1.050.000 de GPT-6 Luna | Texto, imágenes | No | API de OpenAI, beta pública | No aparece |
| Strands Decider 2B | AWS Strands Labs | Gratis para autoalojar | Se ejecuta con 3.072 a 4.096 | Texto | Sí, Apache 2.0 | Tu propio hardware | 21,75 (84.º) |
Fuentes: la documentación de cada proveedor (por ejemplo, la página de Clef de Cloudflare y la guía de Decisions de OpenAI) y los datos del Decision Index del 10 de octubre.
Algunas cosas destacan. Microsoft igualó exactamente el precio de Jev, y solo Clef-flash es más barato por token. Clef y la API de OpenAI aceptan imágenes, algo que Microsoft no hace. Y OpenAI llama predicate a su tipo sí/no en lugar de noul, así que pasar de uno a otro no es un simple cambio de URL. Traté los costes de esa API en mi desglose de los precios de la Decisions API.
La comparación de precios en la propia publicación de Microsoft generó críticas. El gráfico de costes de Microsoft sitúa a Microsoft-Decision-1 en unos 11 $ por millón de textos clasificados frente a unos 2.434 $ de GPT-6 Sol. Un comentarista de HN señaló lo que falta:
«Microsoft solo compara el precio del suyo con GPT Sol(!), no con GPT Terra, ni con GPT Luna (en el que se basa el imitador de Jev de OpenAI), y desde luego no con Jev (4/10 del coste de Luna).»
Buen punto. Frente a un modelo general como GPT-6 Luna, cualquier modelo de decisión parece barato. Frente a sus verdaderos pares, Microsoft-Decision-1 tiene un precio igual, no menor. Si estás sopesando todo el campo, mi resumen de alternativas a Jev repasa modelo por modelo.
¿Es Microsoft-Decision-1 la opción adecuada para tu trabajo?
Elige la situación más parecida a la tuya.
Si la velocidad pura es tu criterio principal, mi análisis de Jev Ultrafast cubre el nivel de baja latencia de TypeSafe, el rival más cercano a la promesa de velocidad de Microsoft.
¿Qué significa Microsoft-Decision-1 para los equipos de soporte?
Soporte es el caso de uso al que todos recurren primero, y con razón. La clasificación de tickets es un montón de preguntas pequeñas y acotadas con respuestas fijas. La clasificación de intenciones es una pregunta choice. La urgencia y el análisis de sentimiento son puntuaciones en una escala fija. «¿Debería verlo una persona?» es un sí/no, el corazón de la escalada con IA. Microsoft-Decision-1 puede responder todo eso en una sola llamada por una fracción de céntimo.
Esto es lo que querría que todo responsable de soporte supiera antes de entusiasmarse: ordenar es la parte que ya funciona bien.
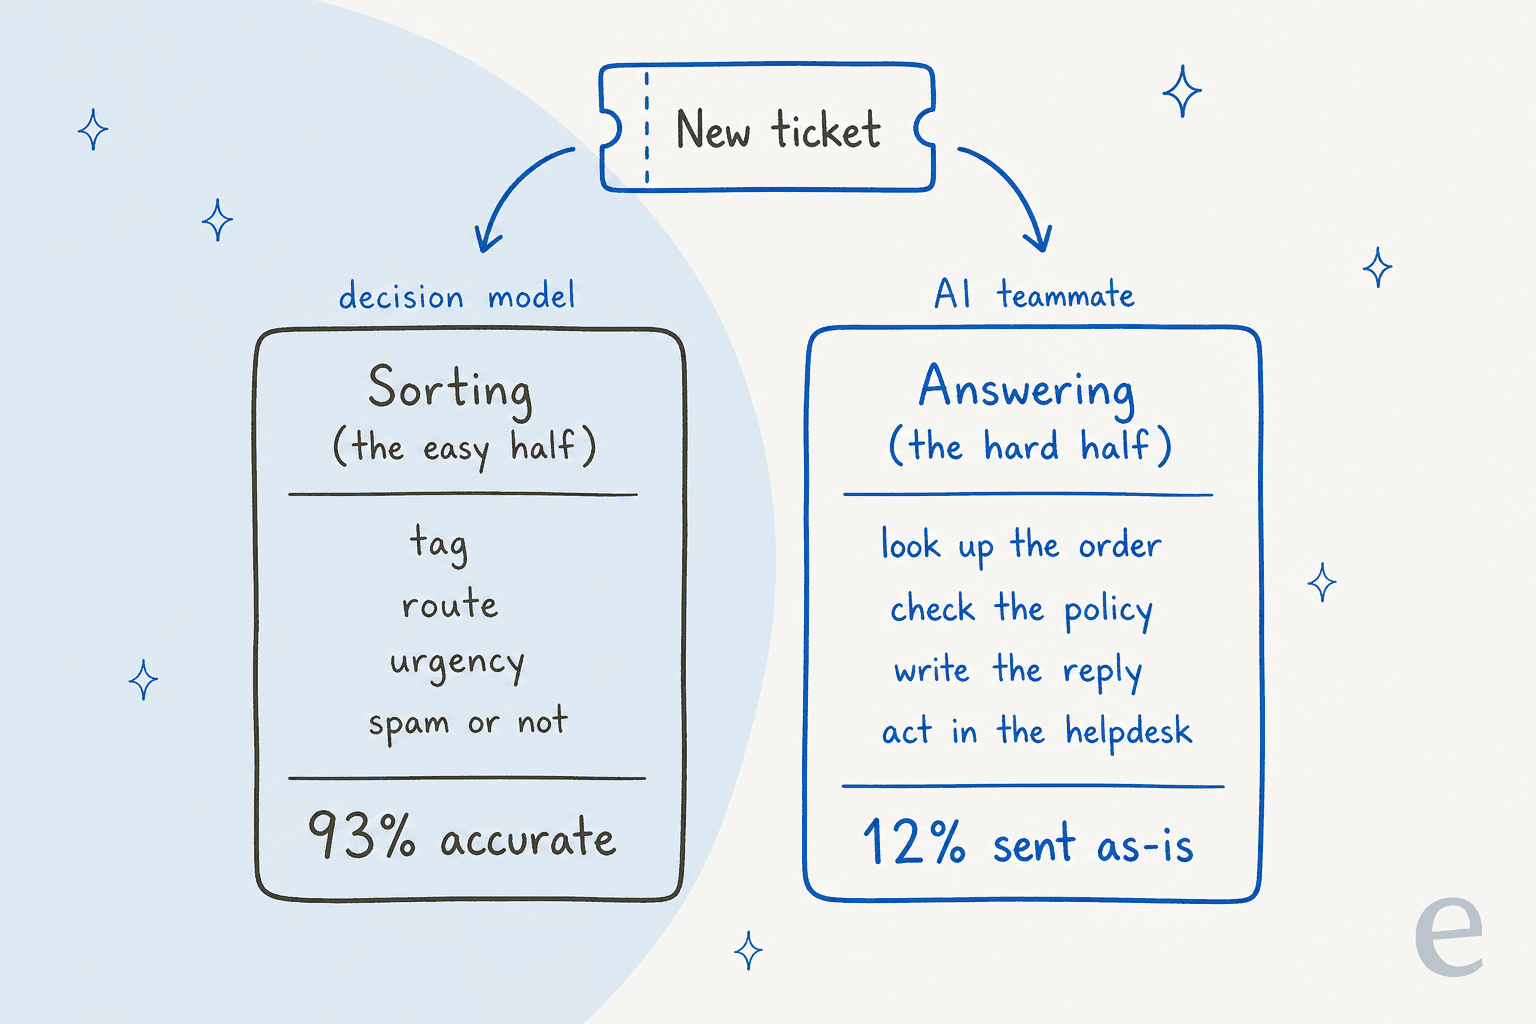
Esas cifras proceden de una prueba con validación cruzada que he visto, con tráfico real de Zendesk en una empresa de comercio electrónico. La clasificación con IA fue 93% precisa y detectó el 100% del spam, que suponía el 22% de la bandeja, con cero falsos positivos. Las respuestas redactadas iban en la dirección correcta el 88% de las veces. Pero solo el 12 % salió sin ediciones, y el 7 % contenía un error factual. La etiqueta fue fácil. La respuesta era el trabajo.
Eso coincide con lo que dicen que quieren los compradores de eesel. Una responsable de CX con 7.000 tickets al mes lo expresó así en una llamada:
«La IA nunca podrá responder el 100 % de las preguntas, pero si lo intenta y solo contesta "lo siento, no sé esto", no puedo ir a revisar mis 7.000 tickets para ver si la IA realmente dio una buena respuesta.»
Lo que piden es primero una decisión segura (¿es una que puedo gestionar?) y después una acción. Un modelo de decisión te da la primera parte como un número. Convertir ese número en una etiqueta en Zendesk, una reasignación, un reembolso retenido para aprobación y una respuesta con la voz de tu marca es todo lo que rodea al modelo. Por eso trataría a Microsoft-Decision-1 como un componente para equipos que construyen su propio enrutamiento de tickets con IA, no como una herramienta de soporte por sí sola.
Si lo construyes tú mismo, un orden sensato es:
- Empieza con las preguntas que tus clasificadores ya responden. Equipo, urgencia, spam, nivel de priorización de tickets. Escríbelas como preguntas
choiceyscorecon las mismas etiquetas que usa tu helpdesk. - Reproduce un mes de tickets pasados. Compara las elecciones del modelo con lo que hizo realmente tu equipo, por etiqueta, no como un solo promedio.
- Fija un umbral por pregunta. Enruta automáticamente por encima, envía a una persona por debajo y registra ambos casos.
- Mantén reglas simples donde funcionan. Si «reembolso» en el asunto siempre significa facturación, las reglas de enrutamiento de Zendesk son gratis y nunca se desvían.
- Decide quién escribe la respuesta. Es la parte que un modelo de decisión no puede hacer y la que tus clientes realmente ven.
Para una visión más amplia de las opciones, mi resumen de herramientas de clasificación con IA compara lo que viene integrado hoy en cada helpdesk, y la guía para automatizar la clasificación de tickets recorre la configuración de principio a fin.
Prueba eesel para clasificar tickets y responder
Microsoft-Decision-1 es infraestructura: una forma rápida y barata de que tu código tome una decisión. eesel es el empleado que toma la decisión y luego hace el trabajo. El compañero de helpdesk con IA se incorpora a tu cola existente mediante la integración con Zendesk, Freshdesk o Gorgias. Etiqueta, enruta y escala, y luego redacta la respuesta a partir de tu centro de ayuda y de tickets pasados.
La división a la que vuelve una y otra vez esta publicación ya está integrada. Cada automatización tiene un ajuste de «Potencia del modelo», con «uno más ligero para tareas simples como etiquetar o enrutar» y el modelo habitual para redactar (documentación de eesel). Cada acción puede ponerse en Auto, Requiere aprobación o Desactivada, y los eventos que el agente decide omitir se registran con una razón. Antes de que nada salga en vivo, puedes simular el agente con tus propios tickets pasados y ver dónde habría coincidido con las respuestas de tu equipo.

Si prefieres configurarlo desde un terminal, la CLI de eesel ejecuta el mismo compañero que el panel. Cada comando imprime JSON, de modo que Claude Code, Codex o Cursor pueden dirigir toda la configuración. Un comando como eesel automations enable <platform> <key> --instructions "..." configura una regla de clasificación en palabras sencillas, eesel approvals lista las acciones retenidas para aprobar o denegar, y --dry-run comprueba una escritura antes de que ocurra. Escribí más sobre por qué importa en mi artículo sobre la CLI de agentes.
Los precios son un plan fijo mensual de créditos: un ticket es un crédito sin importar cuánto trabajo ocurra dentro de él, desde 299 $ al mes por 500 créditos, y recibes 100 créditos gratis para probarlo sin tarjeta. Conecta tu helpdesk, apúntalo a los tickets del mes pasado y mira cómo los ordena y qué habría respondido. Prueba eesel.
Preguntas frecuentes
¿Qué es Microsoft-Decision-1?
Microsoft-Decision-1 es un modelo de decisión que Microsoft lanzó el 9 de octubre de 2026. Le das un texto y un conjunto de opciones de respuesta fijas, y devuelve una probabilidad calibrada para cada opción en JSON en lugar de escribir texto. Es uno de un grupo en rápido crecimiento de modelos de decisión creados para tareas de enrutamiento, clasificación y verificación.
¿En qué se basa Microsoft-Decision-1?
Microsoft dice que posentrenó el modelo de pesos abiertos Qwen3.5-9B de Alibaba para puntuar decisiones en una sola pasada y planea migrar el modelo más adelante a modelos de Microsoft AI (MAI) y OpenAI. La familia Qwen también está detrás de Clef-flash de Cloudflare y Strands Decider de AWS.
¿Cómo uso Microsoft-Decision-1?
Hay dos vías: desplegarlo desde el catálogo de Microsoft Foundry, donde se vende directamente desde Azure y se factura a tu suscripción de Azure, o llamarlo a través de la Decisions API de OpenRouter con el ID de modelo microsoft/microsoft-decision-1. Los SDK de chat completions no funcionan con él, así que prepara una solicitud tipada, como con TypeSafe Jev.
¿Cuánto cuesta Microsoft-Decision-1?
Microsoft-Decision-1 cuesta 0,042 $ por millón de tokens de entrada y los tokens de salida son gratis, la misma tarifa de referencia que Jev. La página de precios de Foundry de Azure aún no tiene una fila para él. Para el cálculo de costes del rival, consulta mi desglose de los precios de Jev.
¿Es Microsoft-Decision-1 mejor que Jev?
En la propia tabla de 36 benchmarks de Microsoft, Microsoft-Decision-1 promedia un 83,5 % de precisión frente al 82,3 % de Jev 1.13.0, mientras que Jev puntúa más alto en calibración (93,7 frente a 92,2). Ningún ranking independiente ha puntuado aún a Microsoft-Decision-1, así que trata la ventaja como una afirmación. Mi reseña de Jev cubre lo que Jev hace bien.
¿Puede Microsoft-Decision-1 clasificar tickets de soporte?
Sí. Las decisiones de urgencia, equipo y sentimiento son exactamente las preguntas de opciones fijas para las que fue creado, y la propia solicitud de ejemplo de OpenRouter es un mensaje de soporte. Aun así, necesitas algo que aplique la etiqueta, mueva el ticket y redacte la respuesta, que es el trabajo de un compañero de helpdesk con IA. Consulta cómo automatizar la clasificación de tickets para ver el flujo completo.
¿Microsoft-Decision-1 explica sus decisiones?
No. La ficha del modelo de Microsoft indica que es solo de texto y no genera explicaciones ni justificaciones. Si necesitas una razón con cada decisión, para un registro de auditoría o una escalada a una persona, tienes que registrar tú mismo las entradas y opciones o usar un LLM para ese paso.
¿Son abiertos los pesos de Microsoft-Decision-1?
No. No hay repositorio de Hugging Face para Microsoft-Decision-1, y Microsoft no ha publicado ninguna licencia ni opción de autoalojamiento. Si necesitas pesos abiertos, Clef de Cloudflare y Strands Decider de AWS son Apache 2.0.