

Qué es realmente Microsoft-Decision-1
Microsoft-Decision-1 es un modelo pequeño que no escribe texto. Le das una situación y un conjunto fijo de opciones de respuesta, y devuelve una probabilidad calibrada para cada opción. Microsoft lo lanzó el 9 de octubre de 2026 en Microsoft Foundry y a través de OpenRouter, con una publicación de lanzamiento de Satya Nadella en X.
Pertenece a una categoría de rápido crecimiento de modelos de decisión, junto a TypeSafe Jev, Cloudflare Clef y Strands Decider. Microsoft lo construyó haciendo post-entrenamiento de Qwen3.5-9B, el modelo de pesos abiertos de Alibaba (consulta los precios de Qwen para ver la familia), y dice que "pronto lo reconstruirá sobre otros modelos, incluidos Microsoft AI (MAI) y OpenAI".
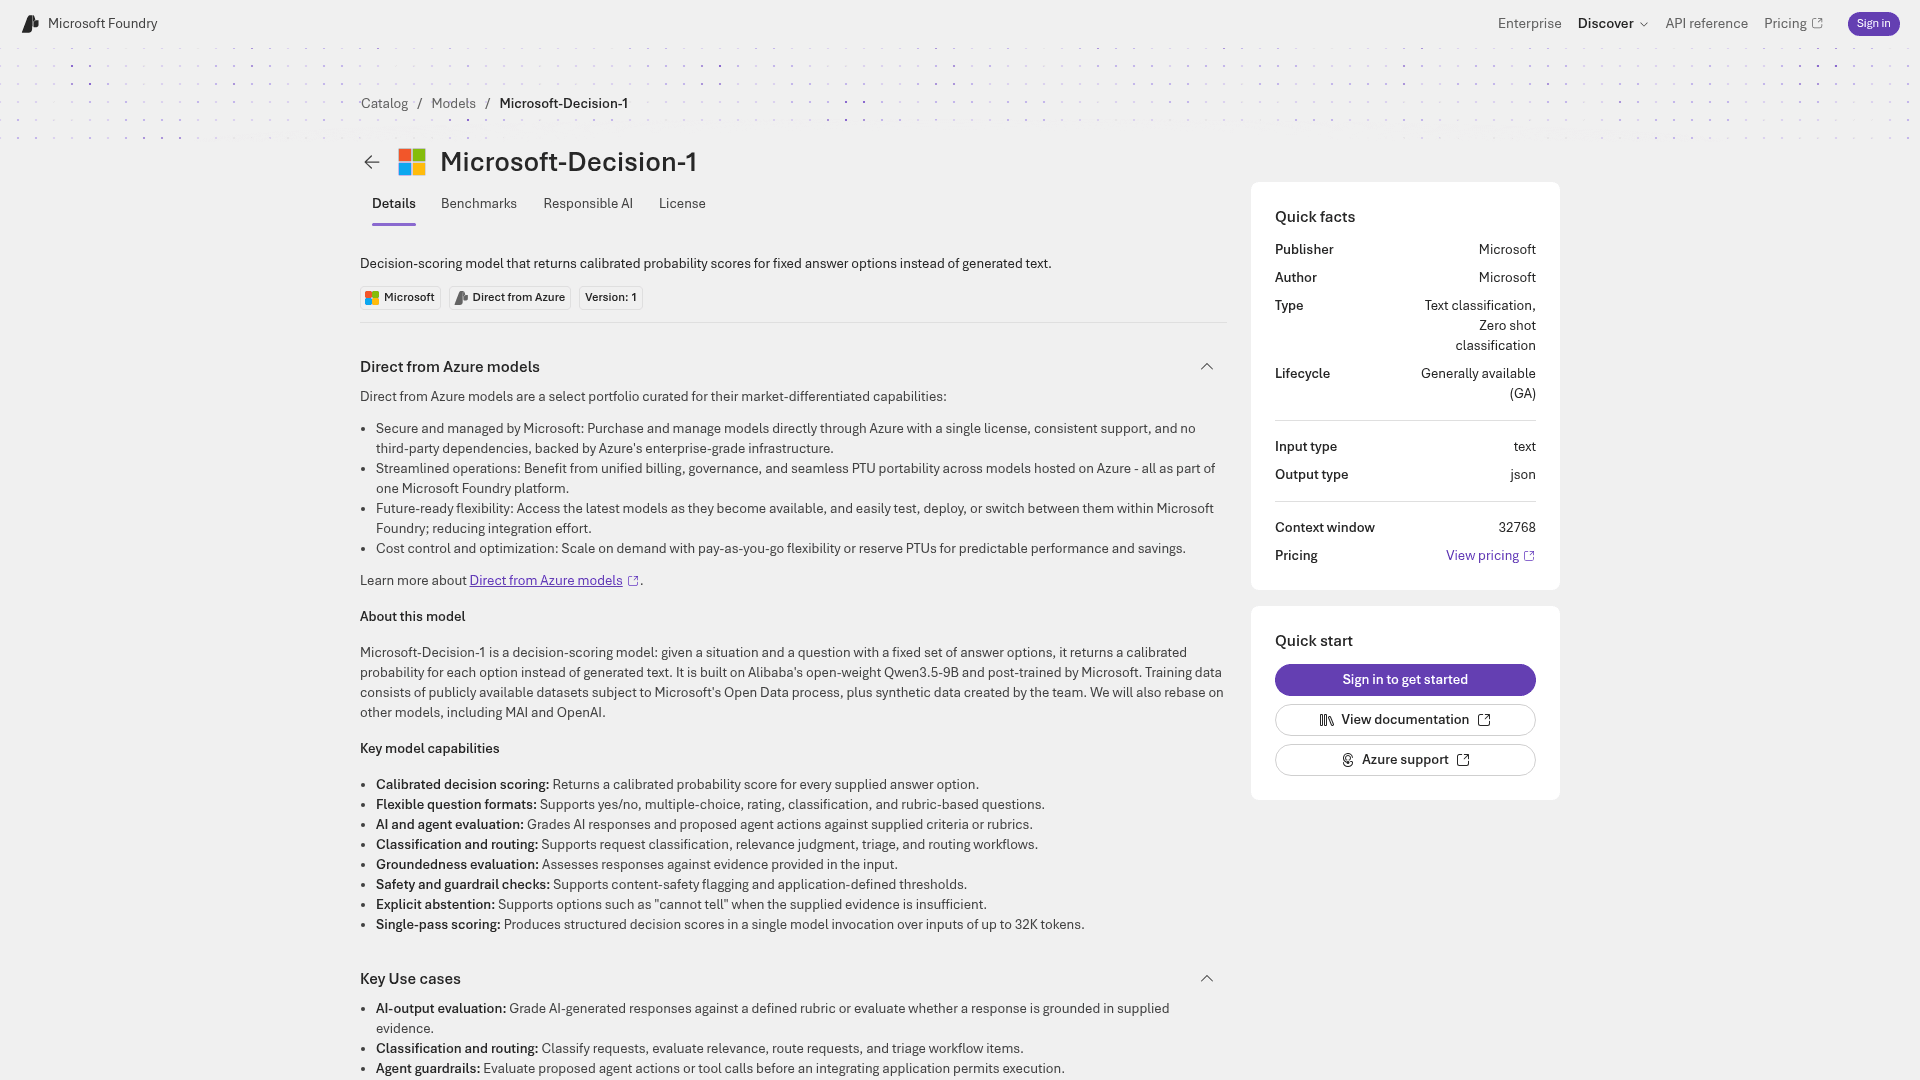
Los datos rápidos de la ficha del modelo en Foundry:
- Ciclo de vida: "Generally available (GA)", versión 1, vendido "Direct from Azure"
- Ventana de contexto: 32.768 tokens
- Entrada / salida: texto de entrada, JSON de salida. Sin explicaciones ni justificaciones
- Tipos de pregunta: sí/no, opción múltiple, calificación y evaluación basada en rúbricas
- Pesos: no publicados. La ruta de Hugging Face devuelve un 404
Me dedico a construir integraciones y APIs, y esta forma me resulta familiar. Gran parte de lo que hace un agente de soporte con IA todo el día no es escribir. Es responder preguntas pequeñas: ¿esto es facturación o técnico?, ¿es urgente?, ¿el cliente está enojado?, ¿el borrador es seguro para enviar? Un modelo que solo responde esas preguntas, rápido y con una puntuación de confianza, es útil. La cuestión del precio es si esa utilidad es lo bastante barata como para invocarla en cada ticket.
¿Cuánto cuesta Microsoft-Decision-1?
Microsoft lo dice en una sola frase en la publicación de lanzamiento: "Input tokens cost $0.042 USD per million tokens. Output tokens are free."
| Concepto | Precio | Notas |
|---|---|---|
| Tokens de entrada | $0.042 por 1M | Todo lo que envías: el ticket, las preguntas, las opciones |
| Tokens de salida | Gratis | Las probabilidades que se devuelven |
| Nivel gratuito | Ninguno específico del modelo | Se aplica el crédito general de Azure de $200 / 30 días a cuentas nuevas |
| Descuento por lotes | No publicado | |
| Descuento por entrada en caché | No publicado | |
| Rendimiento aprovisionado (PTU) | No publicado | El catálogo menciona las PTU solo en el texto genérico "Direct from Azure" |
| OpenRouter | $0.042 entrada / $0 salida | Un solo proveedor: Azure |
La salida gratis importa más de lo que parece. Con un LLM, una respuesta de clasificación te cuesta tokens de salida, y la salida suele costar 5 veces la entrada o más. Aquí la respuesta es gratis, así que la factura depende por completo de cuánto texto envías.
Dónde se paga
Hay dos vías de acceso, y cuestan lo mismo:
- Microsoft Foundry. Se factura a través de tu suscripción de Azure. La documentación de Microsoft Learn dice que los modelos vendidos por Azure se "facturan a través de tu suscripción de Azure, están cubiertos por los acuerdos de nivel de servicio de Azure y cuentan con el soporte de Microsoft" (Microsoft Learn).
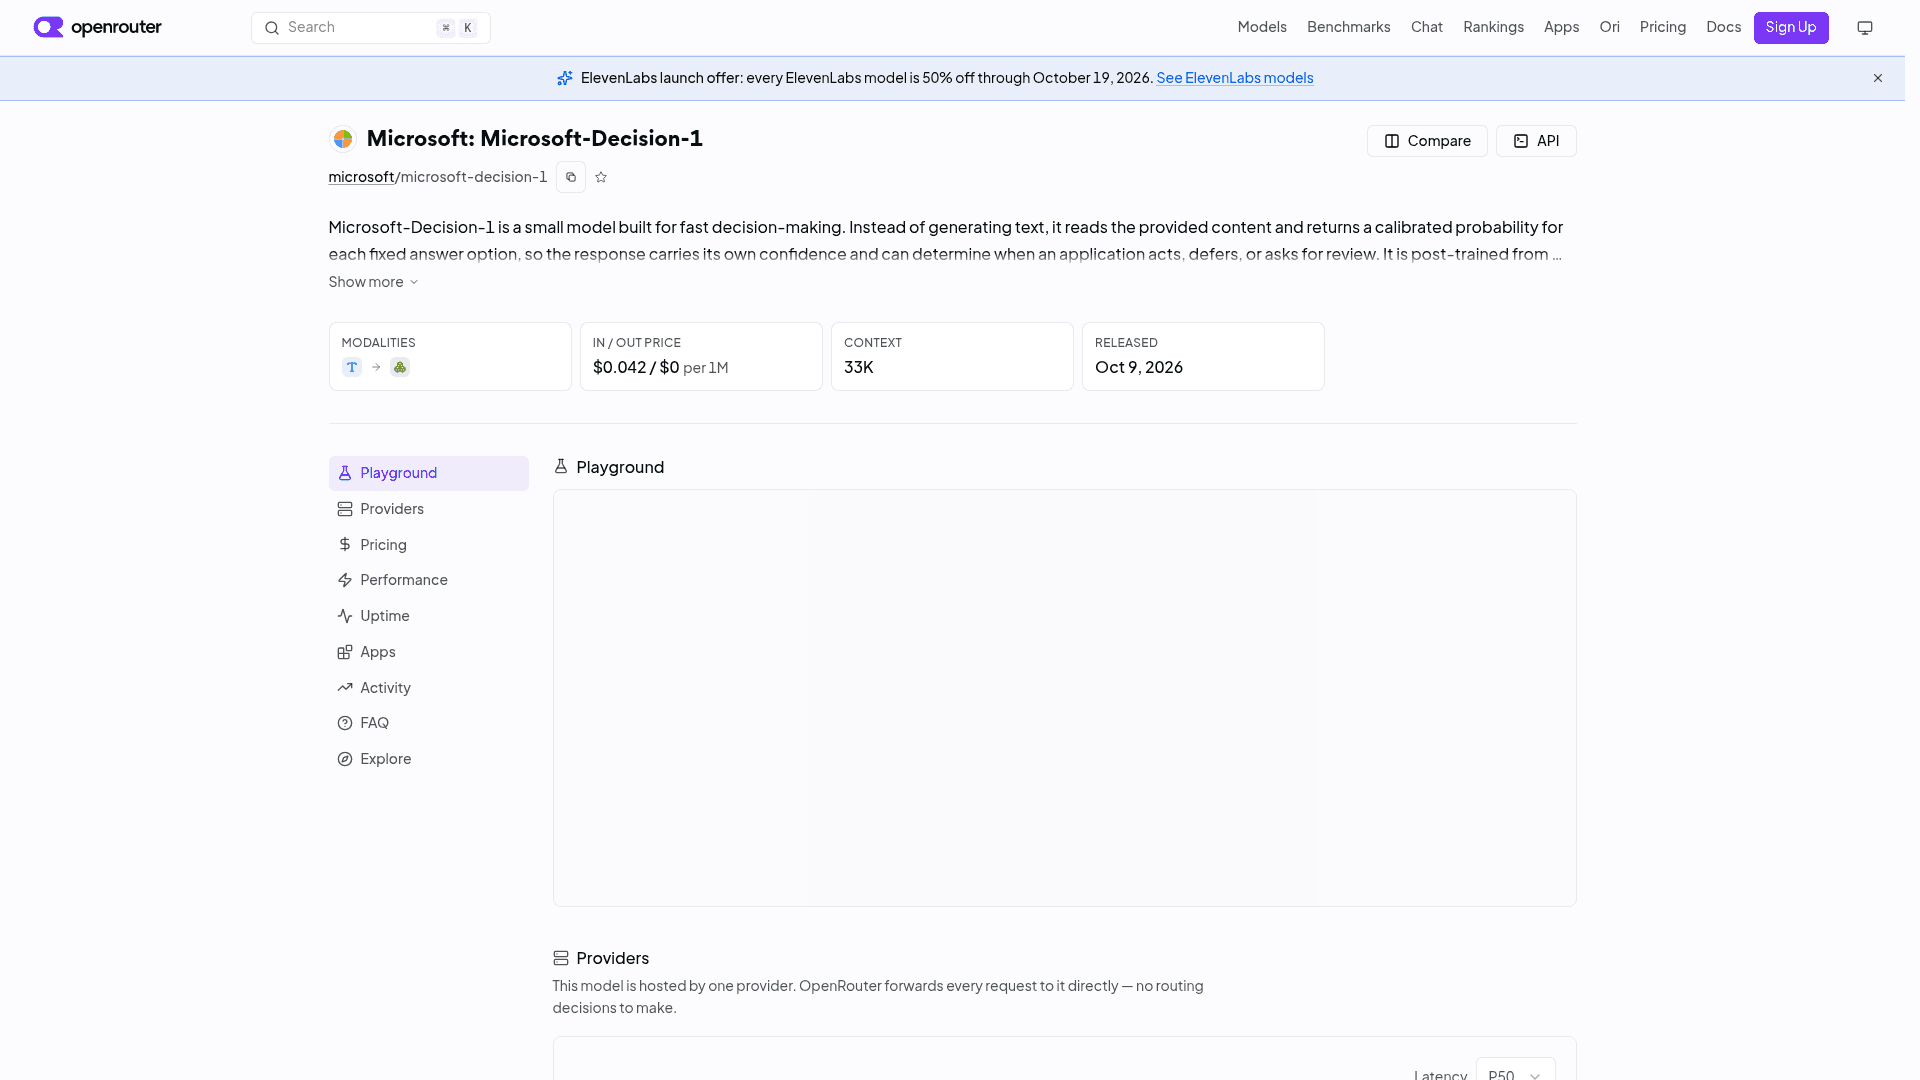
- OpenRouter. Mismos $0.042 de entrada y $0 de salida, servido por Azure por detrás. La página de OpenRouter muestra un promedio ponderado pagado de $0.04152 por millón de tokens de entrada durante los primeros días (OpenRouter).
Si tu empresa ya funciona sobre Azure, o ya compra modelos de Azure OpenAI, Foundry es el camino obvio: una sola factura, compras ya establecidas y el SLA de Azure. OpenRouter es la vía más rápida para un prototipo, ya que te saltas por completo la configuración de Azure.
Microsoft-Decision-1 vs Jev vs Clef vs OpenAI: precio por token
La publicación de lanzamiento de Microsoft compara el costo solo con GPT-6 Sol. De ahí sale la frase "200 veces menos costoso". Es una cifra legítima, pero compara un modelo de decisión específico con un modelo general insignia, como comparar el precio de una calculadora con el de un portátil.
La comparación que importa es con los otros modelos de decisión. Estas son las tarifas vigentes al 11 de octubre de 2026:
| Modelo | Proveedor | Entrada por 1M | Salida por 1M | Contexto |
|---|---|---|---|---|
| Clef-flash | Cloudflare | $0.038 | no indicada | 24.576 |
| Microsoft-Decision-1 | Microsoft | $0.042 | gratis | 32.768 |
| Jev 1.13 | TypeSafe | $0.042 | gratis | 64k por solicitud |
Decisions API (gpt-6-luna) | OpenAI | $0.10 | gratis | 1,05M |
| Clef | Cloudflare | $0.24 | no indicada | 65.536 |
| Strands Decider 2B | AWS (pesos abiertos) | solo autoalojado | solo autoalojado | 3k a 4k probados |
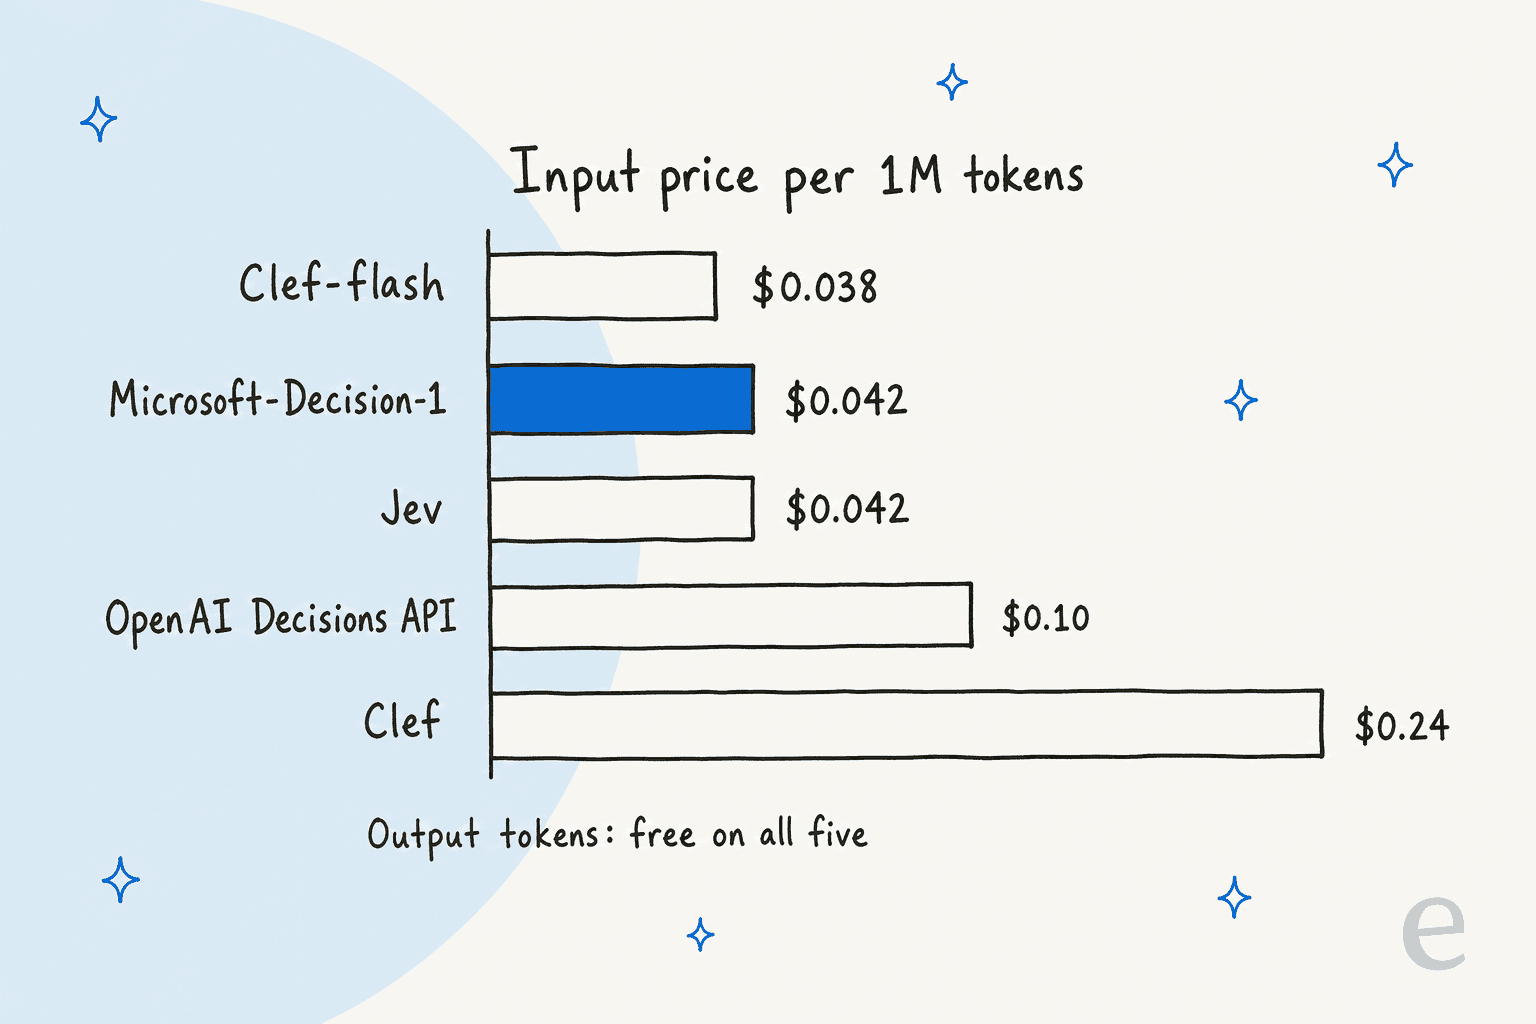
Tres cosas llaman la atención:
- Empata con Jev al centavo. Microsoft igualó exactamente los precios de Jev, lo que no es casualidad en un mercado donde Jev es la opción por defecto.
- Supera a OpenAI por 2,4 veces. La Decisions API de OpenAI entró en beta pública el 6 de octubre a $0.10 por millón de tokens de entrada.
- Ya no es el más barato. Cloudflare bajó Clef-flash a $0.038, con un contexto menor de 24.576 tokens. Es un 10 % menos que Microsoft-Decision-1. Mi desglose anterior de los precios de Clef explica cómo lo factura Workers AI.
La comunidad de desarrolladores notó enseguida la comparación que faltaba. La respuesta más votada bajo la publicación de lanzamiento de Nadella planteó la pregunta obvia:
"How is Jev not ranked? That's literally the #1 model people are going to compare this to."
Microsoft actualizó después la publicación para añadir Jev a sus tablas de precisión y calibración, pero el gráfico de costos sigue mostrando solo GPT-6 Sol. En Hacker News, un comentarista expresó la crítica de precio sin rodeos:
"Looks like yet another non-price-competitive Jev competitor. Microsoft only compares the price of theirs to GPT Sol(!), not GPT Terra, or GPT Luna (which is what OpenAI's Jev wannabe is based on), and certainly not Jev (4/10 the cost of Luna). I can't remember when a new product created So many competitors so quickly. What is very clear is that everyone is saying "Doh!", slapping themselves on the forehead, and scrambling to get a slice of this obvious-in-retrospect massive pie. What no-one appears to have done yet is to come close to Jev on pricing!"

Ese comentario se escribió antes de que el precio se conociera ampliamente. En realidad, Microsoft sí se acercó a Jev en precio: lo igualó.
Por token no es por decisión
Este es el giro que hace que las tarifas sean menos útiles de lo que parecen. Cada modelo tokeniza y da formato a tu solicitud de manera distinta, así que el mismo ticket puede costar un número diferente de tokens en cada uno. La única comparación práctica que encontré vino de un usuario de Hacker News que ejecutó Microsoft-Decision-1 contra Jev en su propio conjunto de pruebas:
"In my minimal suite it was cheaper (by 0.72x) but higher latency (283ms vs 369ms p50) than Jev. Results were very comparable across all scenarios I measure, first of these that I have tested that actually justifies its existence as a commercial release. Qwen tunes are nice and all but either price or performance makes each example I have tested not viable unless you are able to cheaply self-host and fine-tune further."
Misma tarifa, factura real distinta. Es el conjunto de pruebas de una persona, no un benchmark, pero el instinto es correcto: pasa tus propios tickets por ambos y compara la factura, no la página de precios.
Cuánto cuesta realmente una decisión
Como la salida es gratis, el único número que necesitas es cuántos tokens de entrada lleva cada llamada. Eso es el texto del ticket más tus preguntas y las descripciones de sus opciones.
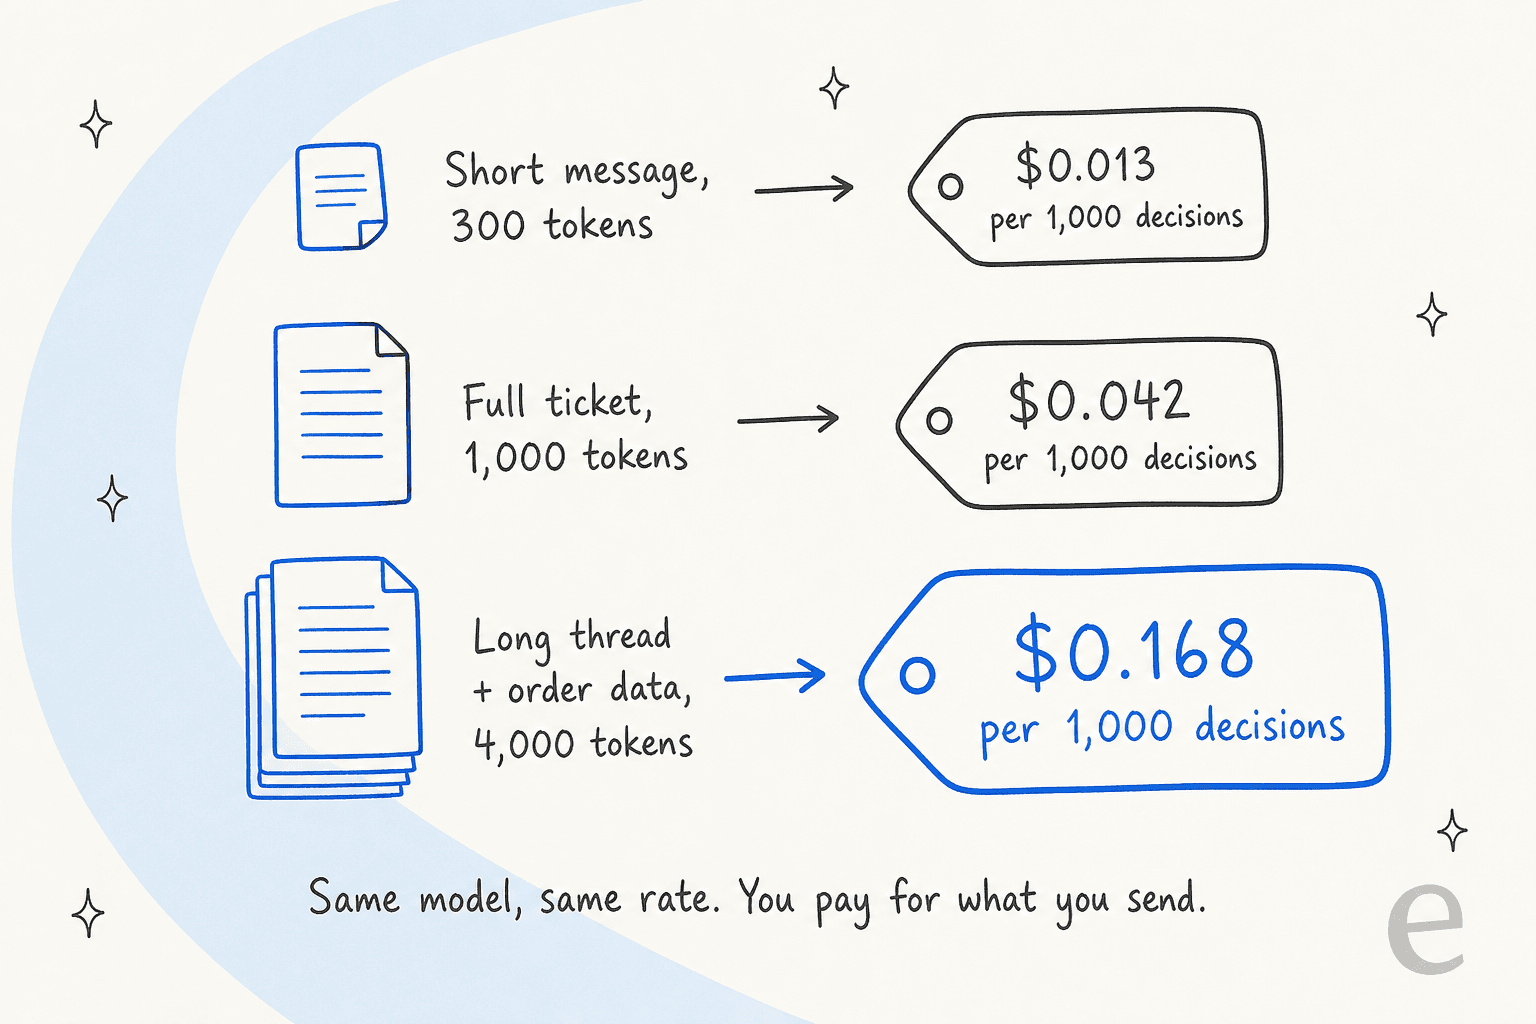
La estimación propia de Microsoft es que clasificar un millón de textos cuesta unos $11 con Microsoft-Decision-1 frente a unos $2,434 con GPT-6 Sol. Haciendo la cuenta a $0.042 por millón de tokens, eso implica unos 260 tokens de entrada por texto en su prueba. Los tickets de soporte suelen ser más largos, y un hilo extenso con historial de pedidos adjunto puede llegar a varios miles de tokens.
Esto es lo que paga realmente un equipo de soporte, suponiendo dos llamadas de decisión por ticket (por ejemplo, una para enrutar y otra para "¿es seguro responder automáticamente?"):
| Equipo | Tickets / mes | Tokens por llamada | Tokens al mes | Microsoft-Decision-1 | OpenAI Decisions API | Clef |
|---|---|---|---|---|---|---|
| Equipo pequeño | 2.000 | 1.000 | 4M | $0.17 | $0.40 | $0.96 |
| Mediano | 10.000 | 1.500 | 30M | $1.26 | $3.00 | $7.20 |
| Cola grande | 100.000 | 2.000 | 400M | $16.80 | $40.00 | $96.00 |
Las cifras de Clef son a precio de lista, antes de la asignación diaria gratuita de Cloudflare. En cualquier caso, una cola de 100.000 tickets cuesta menos de $20 al mes de puntuar. En ese punto el modelo no es tu costo. Lo es el tiempo de ingeniería para construir, probar y mantener la canalización que lo rodea.
Una palanca más: una sola llamada puede llevar varias preguntas con nombre sobre el mismo ticket (OpenRouter). Si preguntas "qué equipo", "qué tan urgente" y "es spam" en una sola solicitud, pagas el texto del ticket una vez en lugar de tres. Agrupar es la forma más fácil de reducir la factura, y la optimización de LLM más barata que harás jamás.
Estima tus propios costos de Microsoft-Decision-1
Introduce tu volumen, los tokens promedio por llamada y cuántas llamadas haces por ticket. La calculadora pone precio a los cinco modelos de decisión alojados con sus tarifas de lista.
Trampas de precios a tener en cuenta
La tarifa es simple. La letra pequeña que la rodea es escasa, y esa es la trampa. Hay varias cosas que conviene revisar antes de construir sobre ella:
- Todavía no está en la página de precios de Azure. El enlace "View pricing" del catálogo lleva a la página de precios de Foundry Models, que lista otros modelos de Microsoft pero ninguna fila de Microsoft-Decision-1 al 11 de octubre. La cifra de $0.042 proviene de la publicación de lanzamiento y de OpenRouter.
- Sin tarifas regionales ni aprovisionadas publicadas. En la misma página de Azure, MAI-DS-R1 de Microsoft cuesta 1,1 veces más en despliegues regionales que en globales. Nada confirma si Microsoft-Decision-1 sigue el mismo patrón, así que compruébalo antes de elegir una opción de residencia de datos.
- Sin lista de regiones ni cuotas. El modelo falta en la página de disponibilidad por región de Microsoft, y los límites de tasa no están documentados.
- Tu SDK de chat no funcionará. En OpenRouter se ejecuta en un endpoint de Decisions aparte, y "chat completions SDKs will not work with it." En el lanzamiento, un desarrollador que lo desplegó en Foundry escribió que "it doesn't say what to POST or what to expect back" (wkcheng, Hacker News). Calcula tiempo de integración.
- Los pesos cambian por debajo. OpenRouter señala que "weights are updated continually while the API shape stays the same." Si fijas un umbral de confianza como "enrutar automáticamente por encima de 0.85", vuelve a comprobarlo tras las actualizaciones.
- El tope de 32.768 tokens. Los hilos de correo largos con adjuntos pegados pueden superarlo. Tendrás que recortar, y la lógica de recorte también es tiempo de ingeniería.
Ninguna de estas es un impedimento. Son el estado normal de un modelo que tiene dos días. Pero "GA" en la ficha del modelo y "no figura en la página de precios" en Azure es una combinación que merece un correo rápido a tu representante de Azure antes de comprometer volumen.
¿Es lo bastante preciso para justificar el precio?
El precio solo importa si las respuestas son correctas. Las cifras de Microsoft son sólidas, pero son pruebas de Microsoft. En su comparación de 36 benchmarks (147.137 preguntas), Microsoft reporta una precisión promedio del 83,5 %, por delante de Jev 1.13.0 con 82,3 % y de GPT-6 Luna Decisions con 79,4 %. Queda tercero en calibración, con 92,2 frente al 93,7 de Jev.
| Modelo | Precisión promedio | Latencia mediana | Calibración |
|---|---|---|---|
| Microsoft-Decision-1 | 83,5 % | 85 ms (p95 125 ms) | 92,2 |
| Jev 1.13.0 | 82,3 % | 240 ms | 93,7 |
| GPT-6 Luna Decisions | 79,4 % | 300 ms | 89,9 |
| GPT-6 Sol (referencia) | sin clasificar | 3,01 s | sin puntuar |
Fuente: publicación de lanzamiento de Microsoft, todas las cifras ejecutadas por Microsoft. La latencia de Microsoft se midió a través de Foundry en la misma región; las demás provienen de JevBench.
Vale la pena conocer dos verificaciones independientes. La medición propia de OpenRouter muestra una latencia p50 de 0,19 segundos, más lenta que la cifra de 85 ms de Microsoft, lo cual tiene sentido porque incluye saltos de red. Además, Microsoft-Decision-1 todavía no aparece en el ranking comunitario Jev Decision Index, donde el decider de Perplexity y Jev ocupan los dos primeros puestos.
Si fijas umbrales sobre probabilidades, la calibración importa más que la precisión. Un usuario de Hacker News resumió ese equilibrio: "if you need calibration better use JEV" (nowittyusername). La diferencia es de 1,5 puntos, que es poca, pero favorece a Jev.
Microsoft también compartió resultados internos: su equipo de Microsoft Copilot encontró el modelo "competitive with GPT5.6 Luna and 100 times faster", y Xbox Research lo halló "200 times less expensive" que GPT-6 Sol en más de 10.000 comentarios de usuarios. Señales útiles, pero de nuevo autoinformadas. Si lo estás comparando con un modelo general pequeño, mi análisis de GPT-5.6 Luna cubre ese lado.
¿Vale la pena Microsoft-Decision-1 para equipos de soporte?
A $0.042 por millón de tokens, el precio del modelo deja de ser un factor. La pregunta real es si quieres construir el sistema alrededor.
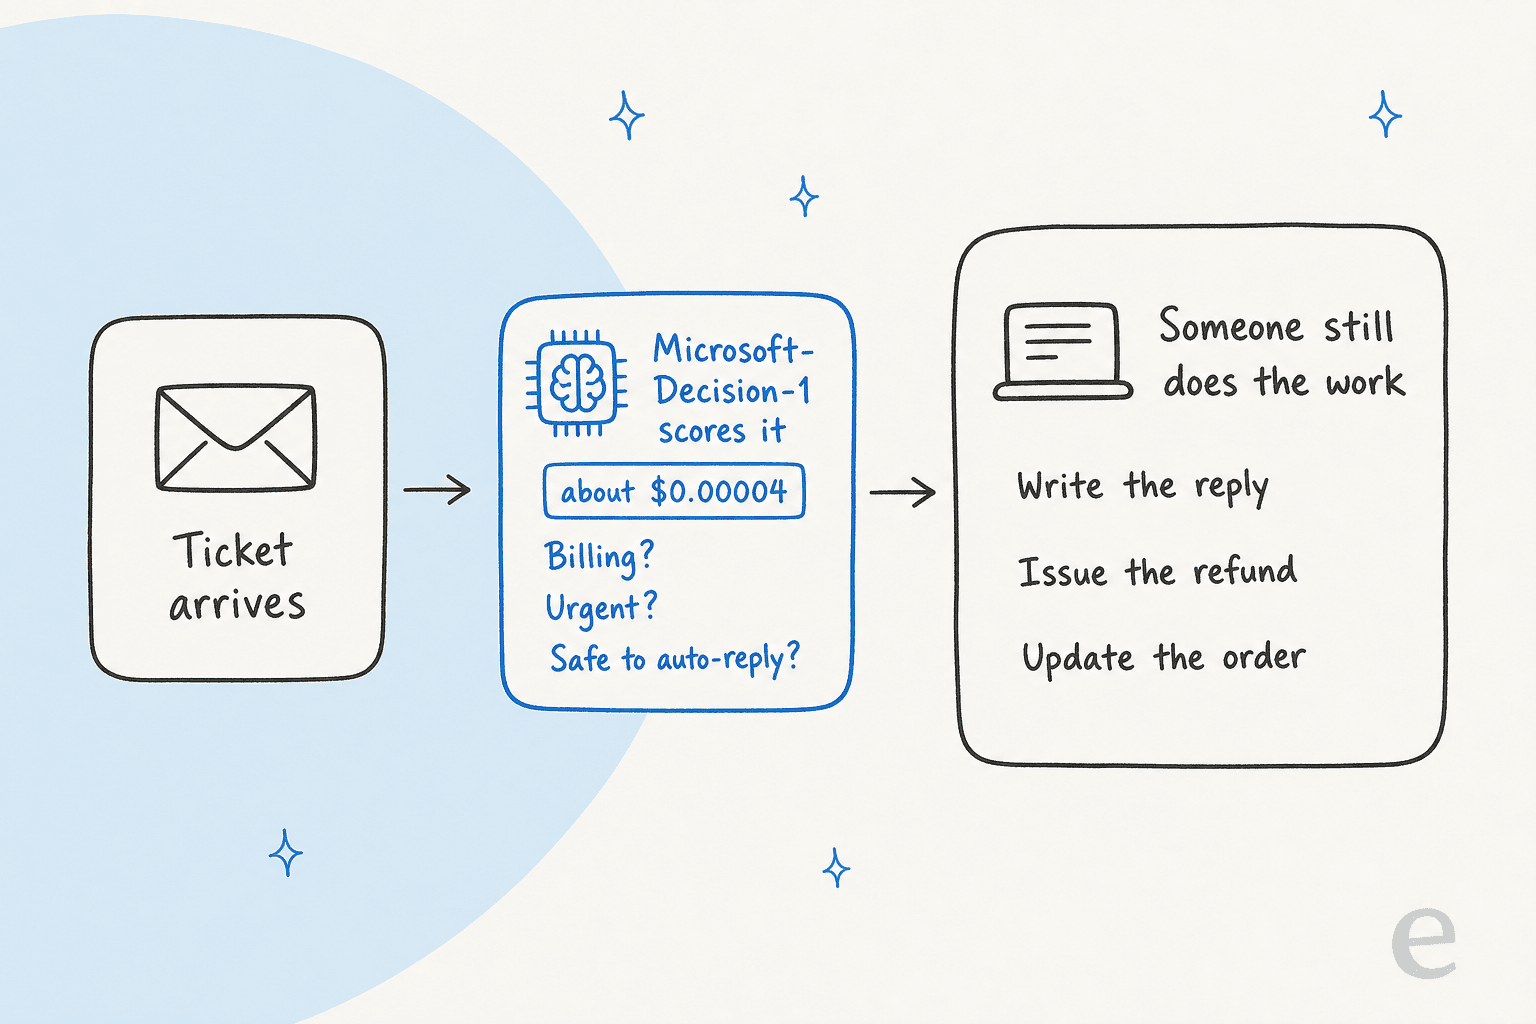
Lo que te da es el paso de clasificación del triaje de tickets: a qué cola va, qué tan urgente es, si es spam, si este borrador de IA es seguro para enviar.
Lo que todavía tienes que construir es todo lo que lo rodea: traer el ticket a través de tu API de helpdesk, redactar las preguntas (estas plantillas de prompts de triaje son un buen comienzo), fijar los umbrales, enrutar según la respuesta y, después, resolver de verdad el ticket.
Ese último paso es el caro, y es donde he visto vivir los errores reales. En una prueba con tráfico real en una bandeja de Zendesk de comercio electrónico, el triaje de eesel alcanzó un 93 % de precisión y detectó el 100 % del spam, mientras que solo el 12 % de los borradores de IA se envió sin ediciones. Clasificar es la mitad fácil. Responder bien es la mitad difícil.
La puntuación de probabilidad sigue siendo lo más útil de estos modelos. Un responsable de CX con 7.000 tickets al mes lo planteó con claridad en una llamada de ventas con eesel:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Una probabilidad calibrada es justo la herramienta para eso. Así que mi veredicto:
- Usa Microsoft-Decision-1 si tienes ingenieros, ya funcionas sobre Azure y quieres triaje, enrutamiento o verificaciones de barreras de seguridad dentro de tu propio producto o canalización.
- Usa Jev o Clef-flash si optimizas costos a un volumen enorme y no dependes de Azure. La diferencia de precio es pequeña, así que prueba primero la precisión con tus propios datos.
- Evita construirlo si lo que realmente quieres es que los tickets se clasifiquen y se respondan dentro de tu helpdesk. Eso es un producto, no una llamada a un modelo, y puedes automatizar el triaje de tickets sin escribir código. Consulta mi resumen de la mejor IA para triaje de tickets.
eesel para la decisión y lo que viene después
Si estás evaluando el precio de Microsoft-Decision-1 porque quieres tickets enrutados, etiquetados y priorizados, considera saltarte la construcción. eesel es un compañero de IA para tu helpdesk. Se conecta a Zendesk, Freshdesk, Gorgias y otros en pocos minutos, aprende de tus tickets anteriores y de tu centro de ayuda, y toma las mismas decisiones de triaje en Zendesk y de escalado que tomaría un modelo de decisión. Luego escribe la respuesta, actualiza el pedido o lo pasa a una persona cuando no está seguro.

El precio es por ticket, no por token. Los planes de eesel empiezan en $299 al mes por 500 créditos, donde un ticket o un chat equivale a un crédito, sin importar cuántos pasos dé el agente dentro de él. Con 5.000 créditos son $1,749 al mes, o unos 35 centavos por ticket. Es mucho más que una llamada de decisión, porque incluye el trabajo, no solo la clasificación. Comparado con el costo por ticket de un agente humano, la historia es otra; mi desglose de costo de IA vs agente humano hace esas cuentas, y los precios de Zendesk AI muestran cuánto cuesta la vía del complemento nativo. Antes de salir en vivo, puedes simular el agente con tus tickets históricos para ver qué habría hecho, que es como probaría cualquiera de estos modelos de todos modos.
Si eres desarrollador, la CLI de eesel te da el mismo compañero desde una terminal. npx @eesel/cli init chat-bubble --site <url> configura un espacio de trabajo, eesel integrations conecta tu helpdesk, eesel automations define reglas de enrutamiento y eesel approvals te permite aprobar o denegar acciones que el agente retuvo para revisión. Es el mismo agente que el panel, y cada comando imprime JSON, así que Claude Code, Cursor o un script de CI pueden manejarlo. eesel mcp token también expone el espacio de trabajo como un servidor MCP. Esa es la diferencia práctica con un modelo de decisión: el modelo le da a tu código una probabilidad, mientras que la CLI le da a tu código un agente de IA que actúa en consecuencia.
Puedes probar eesel gratis con 100 créditos, sin tarjeta. Conecta tu helpdesk, apúntalo a una semana de tickets y compara su enrutamiento con lo que haría tu propia canalización de decisión.
Preguntas frecuentes
¿Cuánto cuesta Microsoft-Decision-1?
Microsoft-Decision-1 cuesta $0.042 por millón de tokens de entrada, y los tokens de salida son gratis. Esa es toda la tarifa de Microsoft-Decision-1 hoy: sin niveles, sin cargo por usuario. Para dar una idea de escala, coincide con los precios de Jev al centavo.
¿Se puede usar Microsoft-Decision-1 gratis?
No. No hay un nivel gratuito específico del modelo. Una cuenta nueva de Azure recibe el crédito general de $200 durante 30 días de Azure, que cubriría millones de decisiones a esta tarifa. Si solo necesitas clasificar tickets sin construir nada, las herramientas de clasificación de tickets con IA son otra vía.
¿Es Microsoft-Decision-1 más barato que Jev?
Según la tarifa publicada, no. Ambos listan $0.042 por millón de tokens de entrada con salida gratis. Clef-flash de Cloudflare ahora es un poco más barato, a $0.038. Un probador de Hacker News informó que Microsoft-Decision-1 salió más barato que Jev en su propio conjunto de pruebas, lo que sugiere que el número de tokens varía según el modelo, así que prueba con tus propias entradas. Mi resumen de alternativas a Jev cubre el panorama más amplio.
¿Cómo se comparan los precios de Microsoft-Decision-1 con la Decisions API de OpenAI?
La Decisions API de OpenAI cobra $0.10 por millón de tokens de entrada en gpt-6-luna, también con salida gratis. Eso hace que Microsoft-Decision-1 sea unas 2,4 veces más barato por token. El desglose de los precios de la Decisions API tiene los detalles.
¿Cuánto cuesta una decisión en Microsoft-Decision-1?
Depende de cuánto texto envíes. Un ticket de soporte de 1.000 tokens cuesta unos $0.000042 de puntuar, es decir, 4,2 centavos por cada 1.000 tickets. Un hilo de 4.000 tokens con datos de pedido cuesta cuatro veces más. La estimación de Microsoft es de unos $11 por clasificar un millón de textos cortos. Consulta triaje de tickets para ver para qué se suelen usar esas decisiones.
¿Puedo comprar Microsoft-Decision-1 a través de OpenRouter?
Sí. OpenRouter lo lista al mismo precio de $0.042 de entrada y $0 de salida, servido por Azure. Usa el endpoint de Decisions API de OpenRouter, no el de chat completions, así que tu código actual con el SDK de chat no funcionará tal cual.
¿Microsoft-Decision-1 tiene descuentos por lotes o por entrada en caché?
No que Microsoft haya publicado. El modelo todavía no figura en la página de precios de Foundry Models de Azure, y no hay tarifa publicada para rendimiento aprovisionado, lotes o entrada en caché. Si piensas comprometerte con capacidad reservada, pide primero una cotización a tu equipo de cuenta de Azure. Para una planificación de costos más amplia, consulta el costo de un agente de soporte con IA.
¿Vale la pena Microsoft-Decision-1 para equipos de atención al cliente?
Para enrutar y hacer triaje dentro de tu propio producto, sí: el precio es tan bajo que deja de ser una partida de gasto. El costo que importa es el trabajo posterior a la decisión, como redactar la respuesta o emitir el reembolso. Esa es la parte que gestiona un agente de helpdesk con IA como eesel.