

GPT-6.2 Sol cuesta 2 $ por millón de tokens de entrada, 0,10 $ en caché y 10 $ de salida, exactamente lo que costaba GPT-6.1 Sol. Por tarea difícil es alrededor de un 20 % más barato, porque usa menos tokens. Pero un simple cambio de modelo puede costar más en dos puntos. En mi prueba, GPT-6.2 Sol no cacheó nada del campo instructions de nivel superior, mientras que 6.1 Sol sí lo hacía, lo que convierte 5,45 $ por 1.000 tickets de soporte en 29,20 $. Y no hay nivel Flex, así que los trabajos que corrían en 6.1 Sol Flex ahora cuestan entre un 20 % y un 100 % más, a menos que se muevan a la API Batch.
¿Cuánto cuesta GPT-6.2 Sol?
GPT-6.2 Sol cuesta 2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida en el nivel Standard, con la entrada en caché a 0,10 $. OpenAI lo lanzó el 17 de noviembre de 2026 junto con GPT-6.2 Astra, y el post de lanzamiento dice que "mantiene las tarifas de GPT-6.1 Sol". Si te interesa el modelo en sí, el resumen de GPT-6.2 Sol cubre qué cambió y cómo rinde en benchmarks.
Si lo estás evaluando para una cola de soporte, un compañero de IA del helpdesk como eesel se salta el medidor de tokens, y con la CLI de eesel un agente de código puede subir artículos de ayuda aprobados y probar preguntas contra ellos antes de que nada se publique. Conectar el helpdesk en sí todavía necesita que un admin lo apruebe.
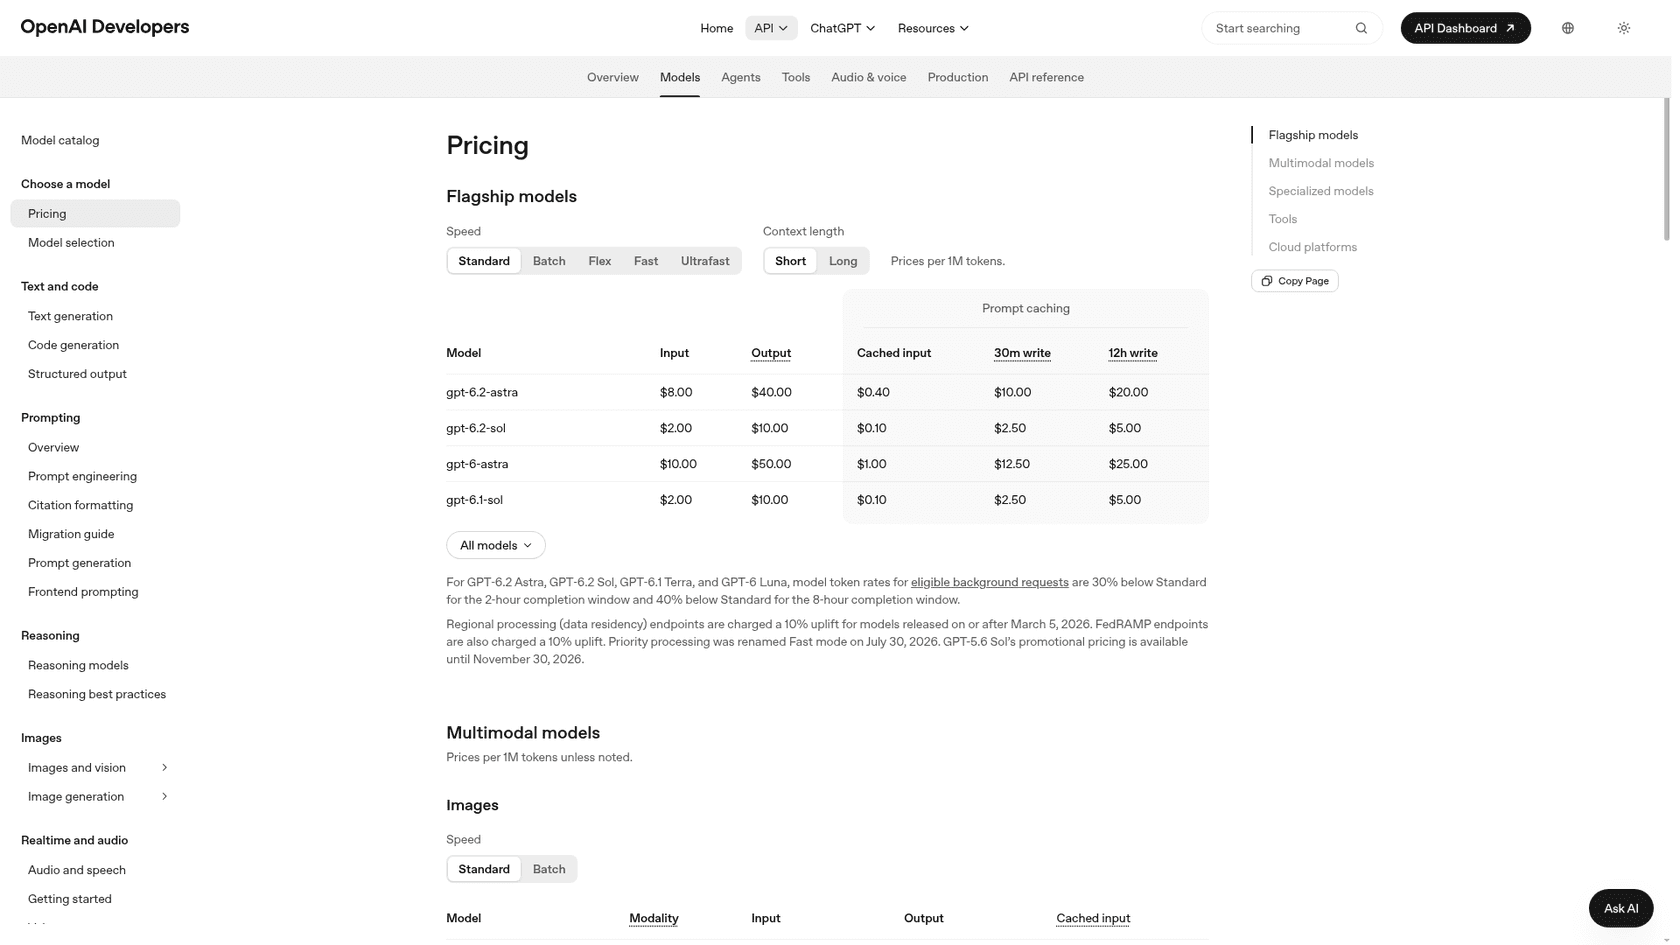
Paso buena parte de mi semana viendo cómo la gente busca precios de modelos, y la pregunta detrás de "precios de GPT-6.2 Sol" es casi siempre la misma: ¿la actualización va a cambiar mi factura? Así que lo bauticé como eesel bautiza a un agente de soporte, por ticket, y corrí mi propia prueba de caché en ambas versiones de Sol. Aquí está cada medidor de la página de precios de OpenAI y la página del modelo GPT-6.2 Sol, por millón de tokens:
| Nivel | Entrada | Entrada en caché | Escritura de caché 30 min | Escritura de caché 12 h | Salida |
|---|---|---|---|---|---|
| Standard | 2,00 $ | 0,10 $ | 2,50 $ | 5,00 $ | 10,00 $ |
| Standard, más de 272.000 de entrada | 4,00 $ | 0,20 $ | n/a | n/a | 15,00 $ |
| Batch | 1,00 $ | 0,05 $ | 1,25 $ | 2,50 $ | 5,00 $ |
| Background, ventana de 8 horas | 1,20 $ | 0,06 $ | 1,50 $ | 3,00 $ | 6,00 $ |
| Background, ventana de 2 horas | 1,40 $ | 0,07 $ | 1,75 $ | 3,50 $ | 7,00 $ |
| Fast | 4,00 $ | 0,20 $ | 5,00 $ | 10,00 $ | 20,00 $ |
| Ultrafast (hasta el 28 feb 2027) | 6,00 $ | 0,30 $ | 7,50 $ | 15,00 $ | 30,00 $ |
| Ultrafast (desde el 1 mar 2027) | 12,00 $ | 0,60 $ | 15,00 $ | 30,00 $ | 60,00 $ |
| Flex | No disponible |
Las filas de background son mi cálculo a partir de la regla de OpenAI de que las solicitudes en segundo plano elegibles corren "30 % por debajo de Standard en la ventana de 2 horas y 40 % por debajo de Standard en la ventana de 8 horas". La fila de contexto largo viene de la página del modelo: más allá de 272.000 tokens de entrada, las tarifas de entrada y caché se duplican y la salida cuesta 1,5 veces la tarifa de contexto corto para toda la solicitud. No lista precios de escritura de caché en contexto largo, así que he dejado esos campos en blanco.
El modelo tiene una ventana de contexto de 1.050.000 tokens, 922.000 tokens máximos de entrada, 128.000 tokens máximos de salida y un corte de conocimiento del 1 de junio de 2026. La API también "rechaza las solicitudes que fijan el esfuerzo de razonamiento en none", así que low es la configuración más barata que puedes elegir. Los endpoints regionales de residencia de datos cuestan un 10 % extra, como en cualquier modelo lanzado después del 5 de marzo de 2026.
¿Por qué se te factura exactamente?
Cada solicitud de GPT-6.2 Sol cae en hasta cuatro medidores, y tienen precios muy distintos:
- Entrada fresca a 2 $ por millón: el mensaje del cliente y cualquier otra cosa que haya cambiado.
- Entrada en caché a 0,10 $ por millón: la parte al inicio del prompt que coincide exactamente con una solicitud reciente.
- Escrituras de caché a 2,50 $ (30 minutos) o 5 $ (12 horas) por millón: la primera vez que se guarda un prefijo reutilizable.
- Salida a 10 $ por millón: la respuesta más cualquier token de razonamiento oculto, que la guía de razonamiento de OpenAI factura como salida.
La guía de caché de prompts de OpenAI dice que las escrituras de caché "no son una tarifa adicional": cada token de entrada se factura una vez, a una de las tres tarifas de entrada. Las lecturas en GPT-6.2 Sol cuestan "0,05 veces la tarifa de entrada normal", un descuento del 95 %, mientras que la mayoría de los otros modelos recientes de OpenAI tienen un 90 %. El prefijo mínimo cacheable es de 1.024 tokens.
Eso hace que un token en caché cueste una vigésima parte del precio de uno fresco. En cualquier app que envía las mismas instrucciones o el mismo conocimiento en cada llamada, la tasa de acierto de caché importa más que el precio de lista. Por eso el siguiente resultado me sorprendió.
¿GPT-6.2 Sol realmente cachea tu prompt?
Solo si el prompt está en el lugar correcto. Lo probé el 18 de noviembre de 2026 a través de la API Responses: un centro de ayuda de 8.300 tokens para una empresa SaaS ficticia, tres preguntas de clientes distintas seguidas, esfuerzo bajo, cada caso dos veces en ambos modelos Sol. La única variable fue dónde se situaba el centro de ayuda.
| Modelo | Posición del prompt | Llamada 1 | Llamadas 2 y 3 |
|---|---|---|---|
| GPT-6.1 Sol | instructions de nivel superior | 8.295 tokens escritos en caché | 8.283 tokens leídos de caché |
| GPT-6.1 Sol | Mensaje developer | 8.295 escritos | 8.283 leídos |
| GPT-6.2 Sol | instructions de nivel superior | 0 escritos | 0 leídos |
| GPT-6.2 Sol | Mensaje developer | 8.295 escritos | 8.283 leídos |
Ambas corridas dieron números idénticos. Así que el mismo código que cacheaba perfectamente en GPT-6.1 Sol deja de cachear en cuanto cambias el ID del modelo a gpt-6.2-sol, y nada da error. Simplemente pagas 2 $ por millón en cada token de prompt en lugar de 0,10 $. La prueba de eesel del día de lanzamiento en GPT-6.2 Astra mostró el mismo comportamiento, así que parece un cambio de toda la generación 6.2, no una rareza de Sol.
La documentación de OpenAI apunta en la misma dirección sin decirlo directamente. La guía de caché señala que "las instructions de nivel superior no pueden contener un punto de corte explícito" y que las instrucciones developer reutilizables van "en un bloque input_text dentro de un mensaje developer". El post de lanzamiento también recomienda "mantener los prefijos del prompt sin cambios y añadir las instrucciones nuevas al final".
Esto es lo que eso le hace a un agente de soporte que reutiliza un prompt de 12.500 tokens (instrucciones más contenido del centro de ayuda) con 600 tokens de entrada nueva y 300 tokens de salida por ticket:
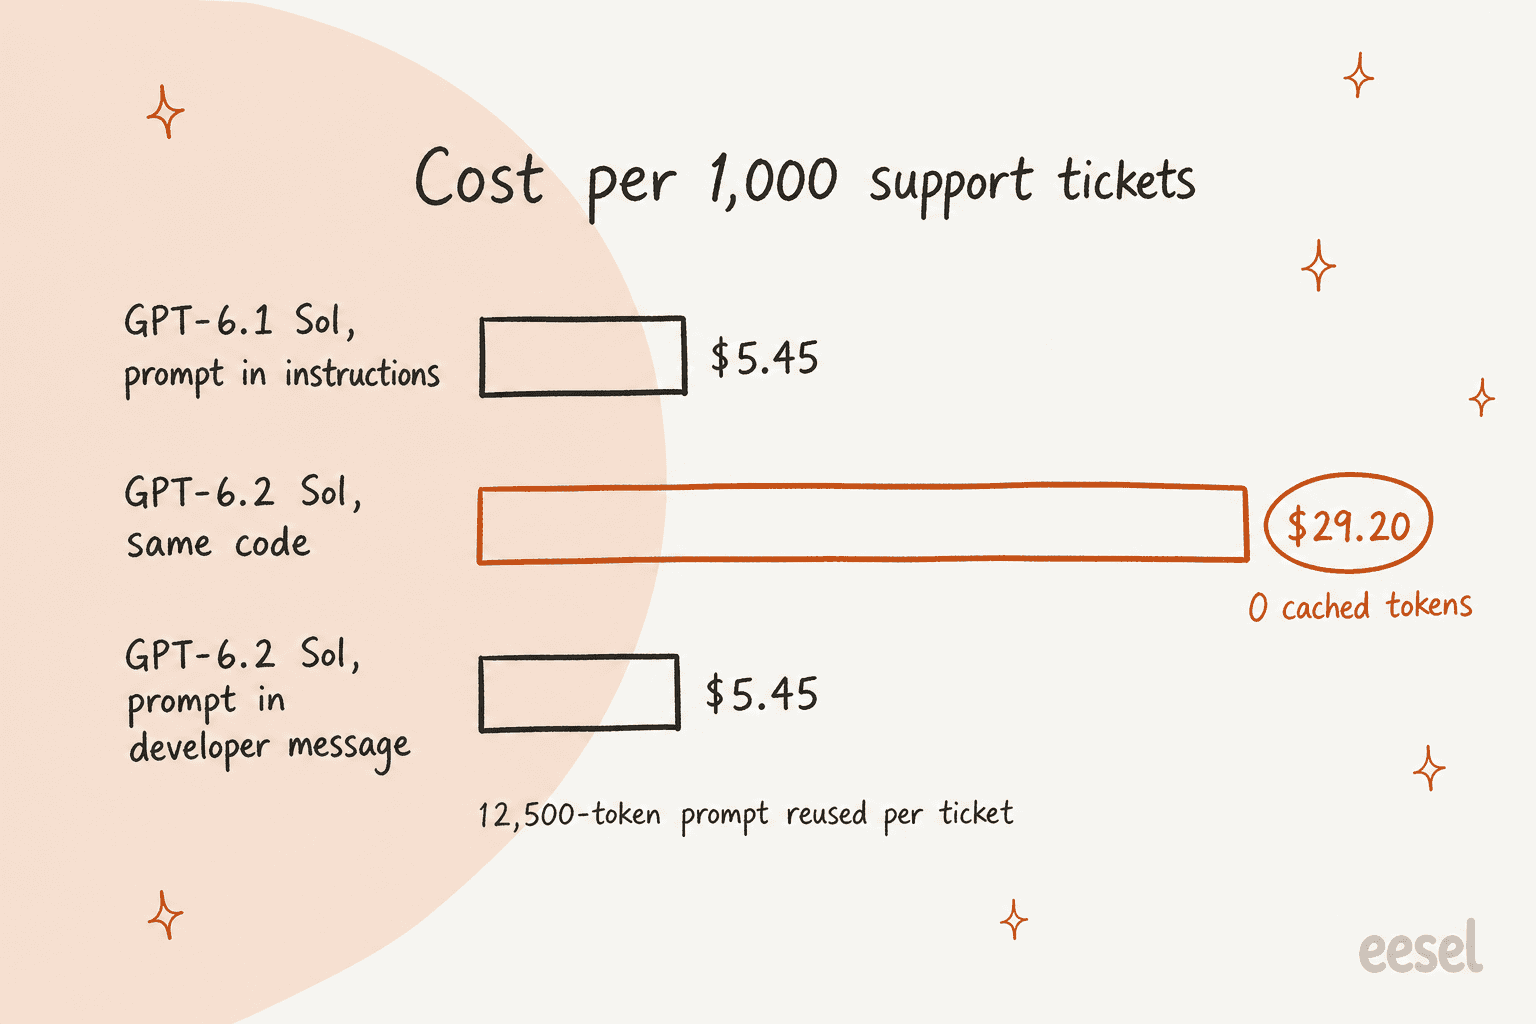
Eso es un salto de 5,4 veces por ticket por una actualización de modelo que se suponía neutral en precio. La solución son unas pocas líneas: mueve el prompt a un mensaje developer y luego revisa cached_tokens en el bloque usage de tus primeras llamadas. Si migraste directamente desde GPT-5.6 Sol o anterior, la guía de migración de OpenAI también dice que reemplaces prompt_cache_retention por prompt_cache_options.ttl.
¿Qué pasó con los precios Flex?
GPT-6.2 Sol no los tiene. La tabla Flex de OpenAI lista GPT-6.1 Sol a 1 $/5 $, junto con GPT-6 Astra, GPT-6.1 Terra y GPT-6 Luna, pero sin fila para 6.2 Sol:
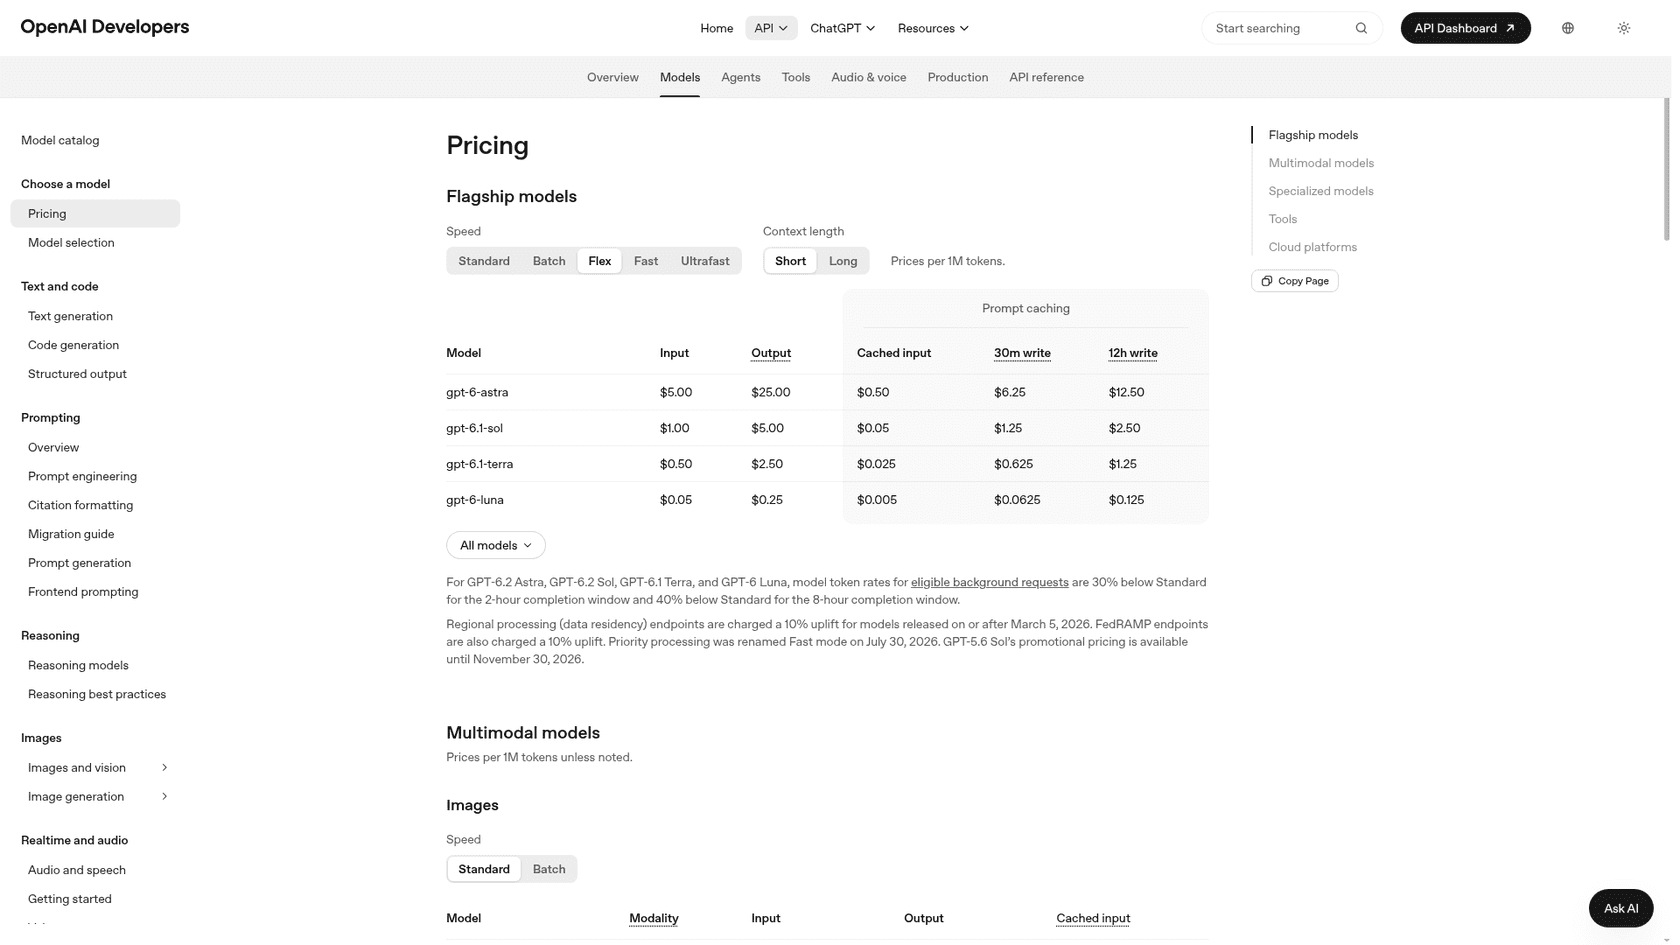
Los desarrolladores lo notaron a las pocas horas del lanzamiento:
"Did they remove the flex pricing? I see it here:- https://developers.openai.com/api/docs/models/gpt-6.1-sol but not here:- https://developers.openai.com/api/docs/models/gpt-6.2-sol"

Flex importaba porque bepreisaba tokens "a las tarifas de la API Batch", según la guía de Flex de OpenAI, mientras seguía respondiendo a una llamada normal de API, solo más lenta y con "disponibilidad de recursos ocasional". Era útil para evals, enriquecimiento de datos y trabajos nocturnos. En GPT-6.2 Sol, esos trabajos tienen tres rutas de descuento, cada una con un truco:
- API Batch (50 % de descuento). Mismo precio que el antiguo Flex, pero envías un archivo y recoges los resultados después, así que el código cambia.
- Background, ventana de 8 horas (40 % de descuento). Un flag en una llamada normal de Responses, pero un 20 % más que Flex.
- Background, ventana de 2 horas (30 % de descuento). Más rápido, pero un 40 % más que Flex.
Según la guía de background de OpenAI, las ventanas con descuento están en beta pública, requieren procesamiento Standard y comparten el límite de tasa de Batch. También hay un truco de caché: "las solicitudes Standard fuera de las ventanas de finalización con descuento no pueden reutilizar las entradas de caché de prompt creadas por solicitudes en segundo plano de 2h u 8h, incluso cuando el prompt es idéntico". Así que no puedes calentar un caché durante la noche y leerlo barato desde tu app en vivo.
Aquí hay un trabajo nocturno, etiquetando 50.000 tickets antiguos con unos 2.000 tokens de entrada y 200 de salida cada uno:
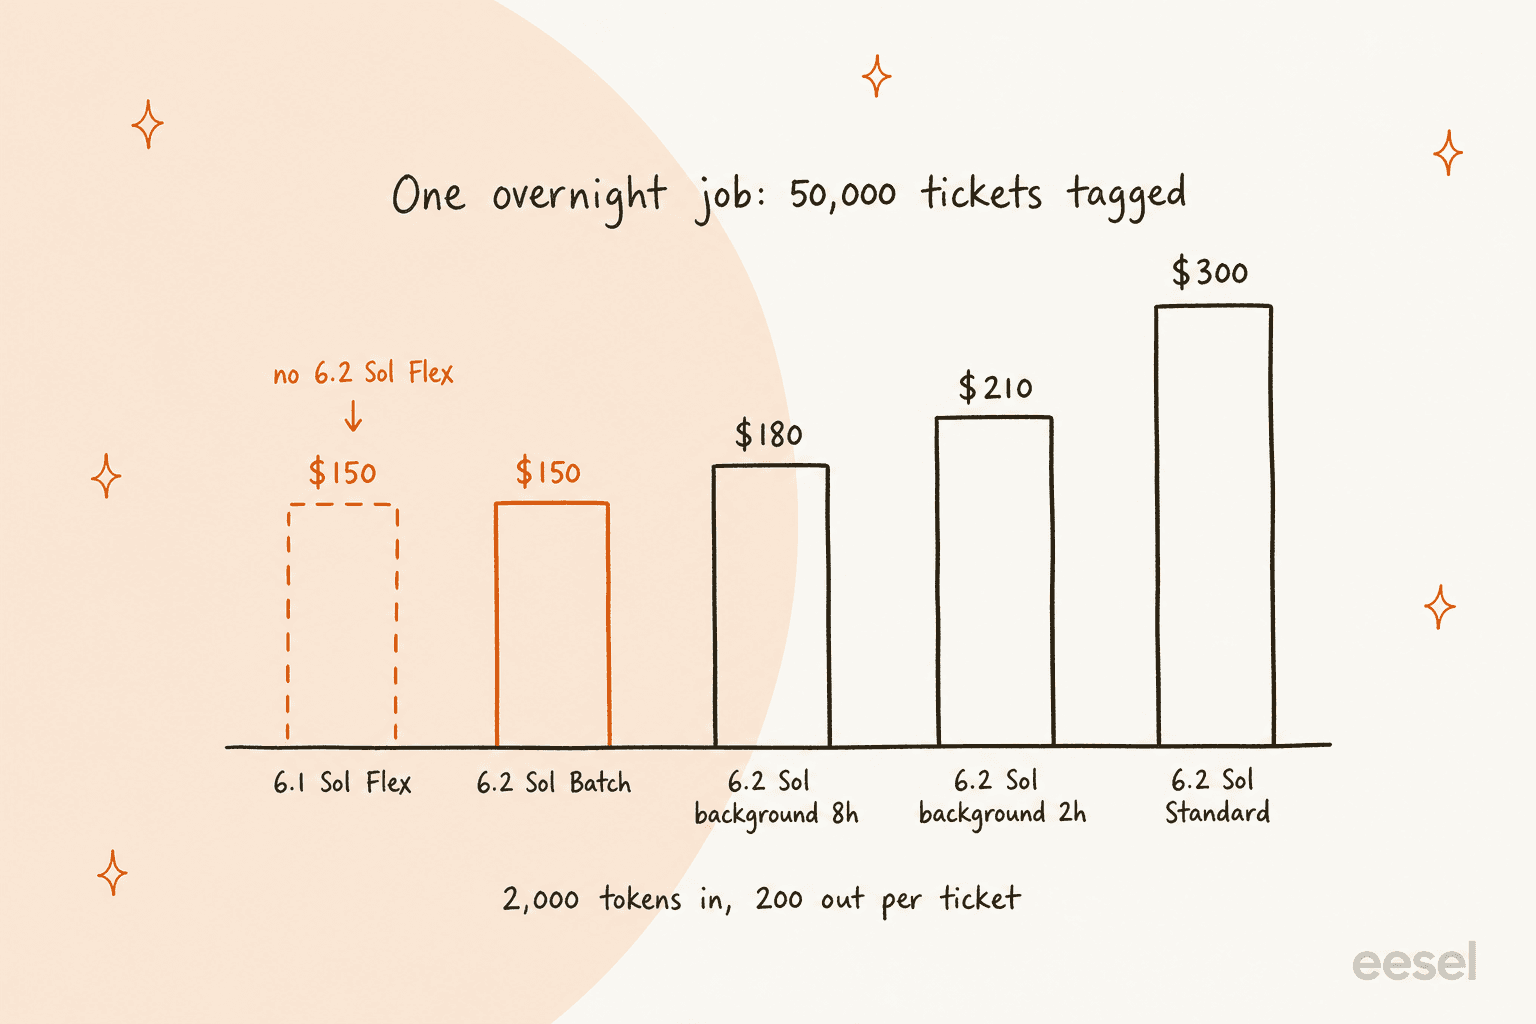
Si un trabajo así corre cada noche, la diferencia entre Batch y Standard es de 4.500 $ al mes. Para etiquetado puro o triage, un modelo más pequeño puede ser el mejor ahorro: GPT-6.1 Terra todavía tiene Flex a 0,50 $/2,50 $, y GPT-6 Luna baja todavía más.
¿Es GPT-6.2 Sol más barato por tarea que GPT-6.1 Sol?
En trabajo largo y difícil, sí, en torno a un 20 %. En respuestas cortas, es un poco más caro. Ambas cosas son ciertas, y cuál notas depende de cuánto tenga que pensar el modelo.
Artificial Analysis pone el costo de correr su Intelligence Index en 1,01 $ por tarea para GPT-6.2 Sol frente a 1,27 $ para GPT-6.1 Sol con esfuerzo máximo, con una puntuación de 57 frente a 55. Mismas tarifas, menos tokens: Artificial Analysis contó 60,9 millones de tokens de salida para 6.2 Sol en max frente a 63,7 millones para 6.1 Sol. También sitúa a 6.2 Sol "a la par de GPT-6 Astra por aproximadamente el 15 % del costo por tarea".
Las respuestas cortas de soporte cuentan otra historia. En la prueba de 60 corridas de tickets de eesel para la reseña de GPT-6.2 Sol, con 15 tickets en esfuerzo bajo y medio en ambos modelos, cada configuración pasó las 15:
| Configuración | Costo por 1.000 tickets | Tokens de salida promedio |
|---|---|---|
| GPT-6.2 Sol, medio | 1,42 $ | 60 |
| GPT-6.2 Sol, bajo | 1,41 $ | 58 |
| GPT-6.1 Sol, medio | 1,35 $ | 55 |
| GPT-6.1 Sol, bajo | 1,32 $ | 52 |
GPT-6.2 Sol escribió respuestas algo más largas, y al mismo precio por token, eso explica la mayor parte de la diferencia del 5 % al 7 %. Esos tickets usaron un prompt corto sin centro de ayuda, por eso son tan baratos frente al ejemplo de 12.500 tokens de arriba.
En Hacker News, un desarrollador que leía las gráficas de OpenAI llegó a la misma conclusión sobre el intercambio de esfuerzo:
"Looks like 6.1-sol high+ is equivalent to 6.2-sol medium at the same price. So a bit smarter at a cheaper cost."
¿Qué esfuerzo de razonamiento deberías pagar?
Para la mayoría de las apps, medio. Los tokens de razonamiento se facturan como salida a 10 $ por millón, así que el esfuerzo es tanto un ajuste de precio como de calidad. Artificial Analysis contó estos tokens de salida en todo su Intelligence Index para GPT-6.2 Sol:
| Esfuerzo | Índice de Inteligencia AA | Tokens de salida para correr el índice | Salida frente a max |
|---|---|---|---|
| Bajo | 41 | 7,2 M | 12 % |
| Medio | 53 | 14,6 M | 24 % |
| Alto | 55 | 22,7 M | 37 % |
| Xhigh | 56 | 33,3 M | 55 % |
| Max | 57 | 60,9 M | 100 % |
Medio conserva 53 de los 57 puntos de max con un cuarto de los tokens de salida. Pasar de xhigh a max casi duplica la salida por un solo punto. La guía de migración de OpenAI también recomienda empezar las integraciones nuevas en medium.
En tareas cortas como respuestas de soporte, el ajuste casi no se nota. Las corridas de bajo y medio esfuerzo en esa prueba de tickets costaron 1,41 $ y 1,42 $ por 1.000 tickets porque el modelo razona muy poco antes de una respuesta de tres frases en cualquier caso. Invierte tu tiempo de ajuste en el caché, no en el esfuerzo, a menos que tu agente corra trabajos largos de varios pasos.
¿Cuánto costaría GPT-6.2 Sol para tu volumen?
Introduce tus propios números en la calculadora. Compara GPT-6.2 Sol con GPT-6.1 Sol y GPT-6.2 Astra en la misma carga de trabajo, usando las tarifas publicadas por OpenAI. Los fallos de caché se facturan como escrituras de caché de 30 minutos. El selector de posición del prompt aplica lo que vi en mi prueba: en los modelos 6.2, un prompt en el campo instructions de nivel superior se factura como entrada fresca en cada llamada.
Con los valores predeterminados, 8.000 solicitudes al mes con una tasa de acierto de caché del 95 % cuestan 55,60 $ en GPT-6.2 Sol. Cambia la posición del prompt al campo instructions y el mismo mes cuesta 233,60 $, mientras GPT-6.1 Sol se queda en 55,60 $. Cambia el nivel a una ventana de background y verás la brecha de Flex de la sección anterior.
¿Qué cuesta GPT-6.2 Sol en distintos tamaños de equipo?
Aquí está la carga de trabajo de soporte de 12.500 tokens en tres volúmenes mensuales, a tarifas Standard. La columna del medio asume que el prompt está en un mensaje developer con un 95 % de acierto; la tercera muestra qué pasa cuando está en el campo instructions.
| Tickets al mes | GPT-6.2 Sol, en caché | GPT-6.2 Sol, campo instructions | GPT-6.2 Sol, Batch | GPT-6.2 Astra, en caché |
|---|---|---|---|---|
| 1.000 | 6,95 $ | 29,20 $ | 3,48 $ | 27,80 $ |
| 8.000 | 55,60 $ | 233,60 $ | 27,80 $ | 222,40 $ |
| 50.000 | 347,50 $ | 1.460,00 $ | 173,75 $ | 1.390,00 $ |
Batch solo encaja con trabajo que nadie está esperando, como redactar resúmenes de los tickets de la semana pasada. Las respuestas en vivo se quedan en Standard. El desglose de precios de GPT-6.2 Astra muestra por qué Astra cuesta cuatro veces más en la misma carga de trabajo.
Para dar una idea de escala, MentorShow, una plataforma francesa de aprendizaje en línea, le dijo a eesel que recibe entre 5.000 y 13.000 tickets al mes. Su agente de eesel lee cada nueva conversación de HubSpot, revisa el registro del miembro y una base de conocimiento de 123 artículos, y deja una nota interna con un borrador de respuesta en el idioma del miembro. A ese volumen, los tokens de GPT-6.2 Sol con un caché funcionando salen a entre 35 $ y 90 $ al mes. Con el error del campo instructions, entre 146 $ y 380 $.
De cualquier forma, los tokens son la línea pequeña en el costo del servicio con IA. Las líneas más grandes son el retrieval, el function calling para búsquedas de pedidos, las reglas de escalamiento y la observabilidad para ver qué dijo el agente.
Por eso el costo de un agente de soporte de IA depende más de construir frente a comprar que del modelo.
¿Es GPT-6.2 Sol más barato que Claude Sonnet 5.5?
En el precio de lista son idénticos. La página de precios de Anthropic lista a Claude Sonnet 5.5 a 2 $ de entrada, 10 $ de salida y 0,10 $ en lecturas de caché por millón de tokens. Las diferencias están en la letra pequeña:
| Por millón de tokens | GPT-6.2 Sol | Claude Sonnet 5.5 | GPT-6.2 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| Entrada | 2,00 $ | 2,00 $ | 8,00 $ | 4,00 $ |
| Salida | 10,00 $ | 10,00 $ | 40,00 $ | 20,00 $ |
| Lectura de caché | 0,10 $ | 0,10 $ | 0,40 $ | 0,20 $ |
| Escritura de caché más barata | 2,50 $ (30 min) | 2,50 $ (5 min) | 10,00 $ (30 min) | 5,00 $ (5 min) |
| Escritura de caché más larga | 5,00 $ (12 h) | 4,00 $ (1 h) | 20,00 $ (12 h) | 8,00 $ (1 h) |
| Prompts de más de 272.000 | 2x entrada, 1,5x salida | Misma tarifa hasta 1M | 2x entrada, 1,5x salida | Misma tarifa hasta 1M |
| Batch | 50 % de descuento | 50 % de descuento | 50 % de descuento | 50 % de descuento |
Tres cosas decidirán cuál es más barato para ti:
- Las colas tranquilas favorecen a Sol. La misma escritura de 2,50 $ compra 30 minutos en Sol y 5 minutos en Sonnet. Si las solicitudes llegan con 10 minutos de separación, Sol mantiene el caché caliente y Sonnet lo sigue reescribiendo.
- Los prompts enormes favorecen a Sonnet. Anthropic cobra "la misma tarifa por token" en toda la ventana de 1M. Una solicitud de 400.000 tokens con una respuesta de 4.000 tokens cuesta 1,66 $ en GPT-6.2 Sol y 0,84 $ en Sonnet 5.5. Dividir documentos en partes de menos de 272.000 cierra la mayor parte de esa brecha.
- La cantidad de tokens por tarea decide el resto. Con tarifas iguales, gana el modelo que responde en menos tokens. Eso depende de la carga de trabajo, así que prueba ambos con tus propios prompts.
Si quieres comparar más ampliamente, Claude Opus 5.5 cuesta el doble por token, y mejor modelo IA para soporte compara todo el campo en trabajo de tickets.
¿Cuánto cuesta GPT-6.2 Sol en ChatGPT?
En ChatGPT pagas una suscripción fija, no por token. OpenAI dice que GPT-6.2 Sol está "disponible para todos los usuarios Plus, Pro, Enterprise y Edu en ChatGPT Work y Codex", con acceso para Enterprise y Edu una vez que un admin del workspace lo activa.
| Plan | Precio | Acceso a GPT-6.2 Sol |
|---|---|---|
| Free | 0 $ | No listado en el post de lanzamiento |
| Go | 8 $/mes | No listado en el post de lanzamiento |
| Plus | 20 $/mes | Sí, en ChatGPT Work y la app Codex |
| Pro (Pro 100, Pro 200, Pro 500) | Desde 100 $/mes | Sí; Pro 200 obtiene Ultrafast con Sol por primera vez, y Pro 500 obtiene Ultrafast con Sol o Astra |
| Enterprise y Edu | Contactar a ventas | Sí, una vez que un admin lo habilita |
Los precios vienen de la página de precios de ChatGPT. Los planes Pro también incluyen créditos mensuales de API: 100 $, 200 $ o 500 $ según el nivel, sujeto a los términos de elegibilidad de OpenAI. A la tarifa en caché de 6,95 $ por 1.000 tickets, 200 $ de créditos cubren unos 28.800 tickets de GPT-6.2 Sol al mes. La guía de precios de ChatGPT tiene el desglose completo de planes.
¿Vale la pena GPT-6.2 Sol para el soporte al cliente?
En precio, sí. Es un cuarto del costo en tokens de GPT-6.2 Astra y pasó los 15 tickets en la prueba de eesel. Los riesgos reales están en otro lado. Artificial Analysis midió una tasa de alucinación del 55 % para Sol con esfuerzo máximo, lo que significa que adivina en lugar de admitir que no sabe algo. En esa prueba convirtió un número de rastreo en un enlace a ups.com que la herramienta de pedidos nunca proporcionó. Un modelo barato que adivina todavía necesita fundamentación, prevención de alucinaciones y pruebas con tickets reales antes de responder a los clientes.
También está la pregunta de si quieres una factura de tokens en absoluto. Esta puede moverse sin que tu código cambie: el caché deja de acertar tras una actualización, un nivel de descuento desaparece, o Ultrafast se duplica el 1 de marzo de 2027. En una llamada de ventas de eesel, un comprador consciente del presupuesto le dijo al equipo que el precio de un proveedor anterior se había más que duplicado, y pidió un bloqueo contractual del precio antes de firmar nada. Los precios por token no pueden ofrecer eso.
Esa es la disyuntiva de construir frente a comprar. Si construyes sobre GPT-6.2 Sol, obtienes tokens baratos, más el trabajo de vigilar cached_tokens, niveles y páginas de precios. Si compras, la elección de modelo y sus rarezas de facturación se vuelven problema de otro.
Probar eesel
Si estás evaluando precios de GPT-6.2 Sol porque quieres IA en tu cola de soporte, el compañero de IA del helpdesk de eesel te da eso sin medidor de tokens. Se conecta al helpdesk que ya usas, aprende de tus tickets pasados y tu centro de ayuda, y te deja correrlo contra tickets históricos para que leas cada respuesta antes de que toque a un cliente real. Los planes son paquetes fijos de créditos, desde 299 $ por 500 créditos, así que un cambio de caché o un nivel nuevo en OpenAI no aparece en tu factura.
Lesson Pro, un grupo de marcas de clases privadas, lo usa en dos cuentas de Zendesk: en un mes trabajó 1.900 tickets, dejó 1.700 notas internas para el equipo y redactó 560 respuestas para que una persona las aprobara, respondiendo a partir de unos 4.000 tickets, artículos y páginas web.

Puedes probar eesel gratis en una parte de tu cola, o compararlo con usar ChatGPT directamente si todavía estás decidiendo si construirlo tú mismo.
Preguntas frecuentes
¿Cuánto cuesta GPT-6.2 Sol?
¿GPT-6.2 Sol es más caro que GPT-6.1 Sol?
¿GPT-6.2 Sol tiene precios Flex?
¿Cómo consigo el descuento de entrada en caché de GPT-6.2 Sol?
cached_tokens en el bloque usage de la API Responses para confirmarlo.