¿Qué es la OpenAI Decisions API?
La Decisions API es un nuevo endpoint de OpenAI para una tarea concreta: elegir entre opciones que defines de antemano. Así la describe el resumen del DevDay 2026 de OpenAI:
"Decisions API enables real-time decision-making by focusing Luna's intelligence on a specific set of user-defined questions with finite pre-defined answers. Developers supply context using text or images, and get back answers they can use to classify content, route requests, or choose an agent's next action."
Me dedico a construir agentes de IA, y la mayoría de las llamadas a modelos dentro de uno no escriben nada. Son pequeñas bifurcaciones del camino, como qué equipo se encarga de este ticket o si esto necesita a una persona. Un modelo general puede responderlas bien, solo que va por el camino lento, generando texto primero. La Decisions API es la apuesta de OpenAI de que este tipo de llamada merece su propio carril.
Está junto a los lanzamientos más grandes del DevDay, como los agentes siempre activos de OpenAI Dots, el modelo GPT-6.1 Sol y Codex Security Cloud.
Tuvo menos tiempo en el escenario que esos. El segmento de la keynote dura menos de un minuto, empieza hacia el minuto 22:15 de la keynote, y la misma semana llegó también ChatGPT Space. Aun así, si gestionas una cola de soporte, este es el lanzamiento que más se parece a tu trabajo diario.
¿Cómo funciona la Decisions API?
Envías tres cosas y recibes una. El flujo, hasta donde OpenAI lo ha descrito, es este:
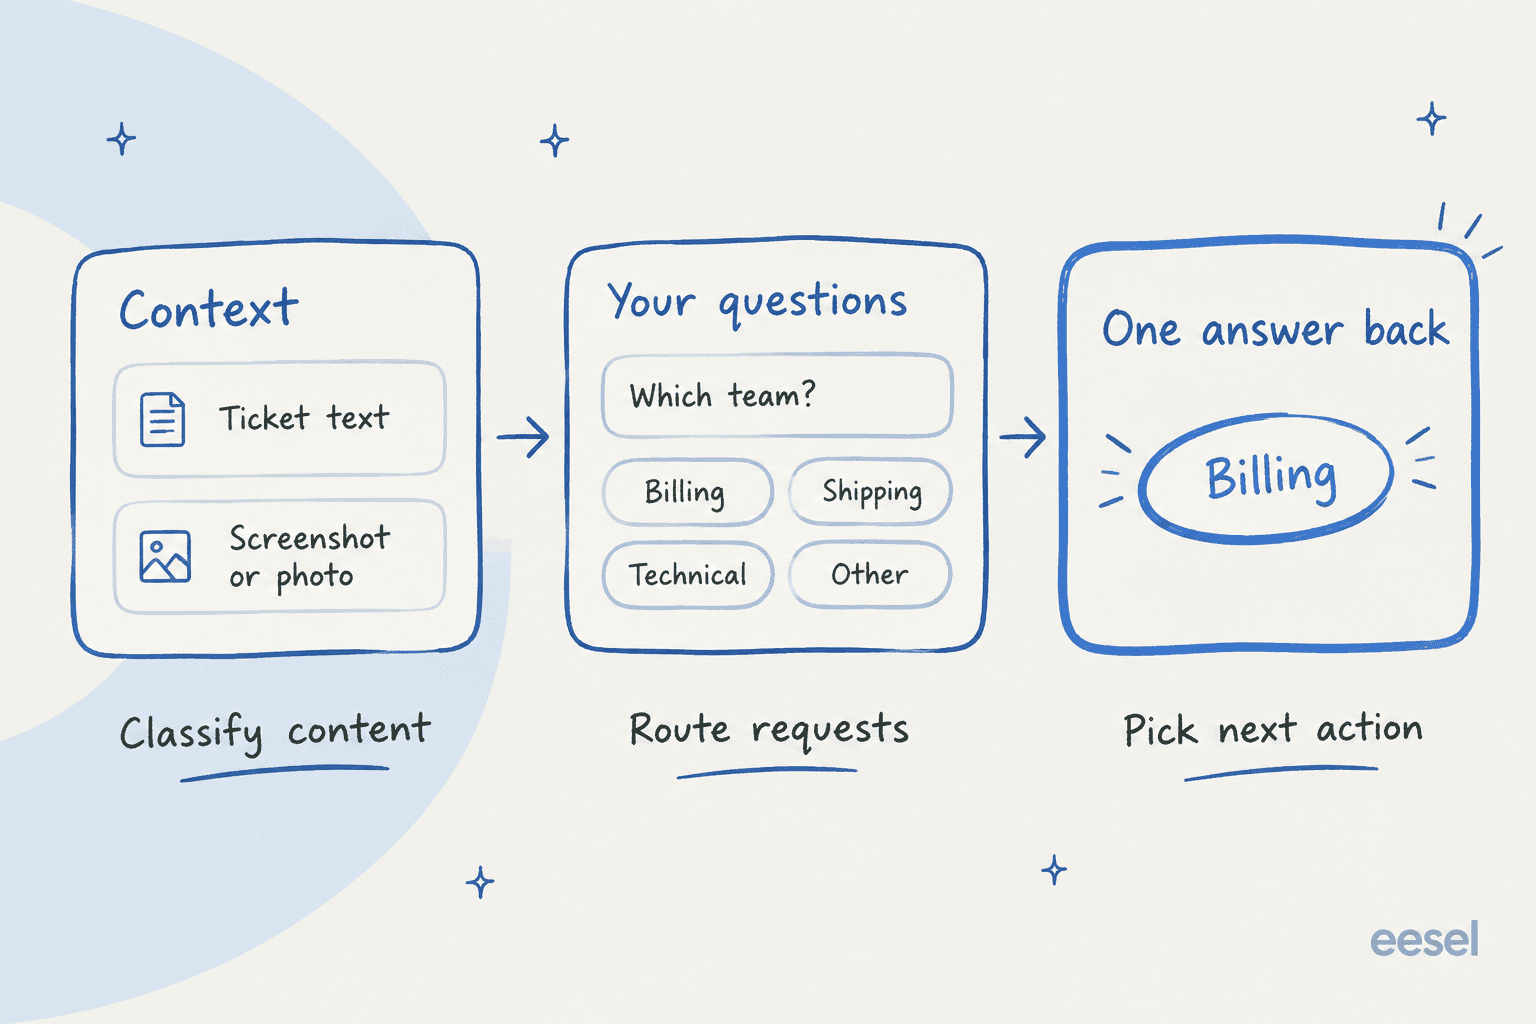
- Contexto. Texto o imágenes, es decir, el cuerpo de un ticket, la transcripción de un chat o una foto del producto que adjuntó el cliente.
- Preguntas con respuestas finitas. Defines cada pregunta, más la lista completa de respuestas que puede devolver.
- Una selección de vuelta. Una respuesta de tu lista, y luego tu código actúa.
El ejemplo de soporte salió en realidad de la propia cuenta de desarrolladores de OpenAI, en un hilo de @OpenAIDevs:
"Send text or images as context. For example, supply a support request and the teams it could go to. The API returns a selection your app can use."
Por debajo funciona sobre GPT-6 Luna, que OpenAI llama su "most efficient model for focused, high-volume tasks" en la página del modelo Luna. La keynote explica la velocidad diciendo que un conjunto predefinido de opciones es lo que permite a Luna responder en una fracción de segundo. No hay que escribir nada palabra por palabra, así que hay menos que esperar.
Si piensas construir sobre ella, las partes que OpenAI aún no ha explicado importan casi tanto:
- El esquema de la solicitud y la respuesta, ya que no hay página de referencia de la API.
- Si una llamada puede llevar varias preguntas y cuántas respuestas puede tener cada una.
- Si la respuesta incluye una puntuación de confianza. La prensa dice que sí, pero no encontré ninguna página ni publicación de OpenAI que la mencione.
- La unidad de facturación y los límites de uso, además de si se aplican Batch o Flex.
Un lector de Hacker News aventuró el mecanismo en el hilo del DevDay: "I think they simply use the LLMs softmax scores (uncalibrated confidence)". Es una lectura plausible, aunque nadie la ha confirmado.
¿Se puede usar ya la OpenAI Decisions API?
Solo si OpenAI te eligió a ti. El resumen dice que está "available in limited preview today with a broad release planned in the coming days", y el hilo de OpenAI Developers añade que "preview access is limited to selected API customers for testing."
Fui a comprobar qué significa esto en la práctica. POST https://api.openai.com/v1/decisions es una ruta real, y una clave estándar recibe de ella esta respuesta:
{"error":{"message":"Decision API is not enabled for this user.","type":"invalid_request_error","param":null,"code":null}}
Eso es un HTTP 403, es decir, un bloqueo de función y no una ruta inexistente. Rutas cercanas como /v1/decisions/create y /v1/beta/decisions sí devuelven 404. El bloqueo salta incluso con un cuerpo vacío, así que los errores tampoco filtran nada sobre la forma de la solicitud. Recibí el mismo 403 el 1 de octubre y otra vez el 2 de octubre, tres días después de la promesa de «en los próximos días».
El rastro documental también es escaso. A 2 de octubre:
| Qué comprobé | Resultado |
|---|---|
Guía de documentación (/api/docs/guides/decisions) | 404 |
Referencia de la API (/api/reference/decisions) | 404 |
| Changelog de la API, entradas del 29 sep | Sin entrada de la Decisions API |
| Página de precios de la API | Sin fila de la Decisions API |
| Publicación de anuncio independiente | Ninguna, solo el resumen del DevDay |
GET /v1/models | Ningún ID de modelo que contenga "decision" |
Así que, por ahora, la Decisions API es una promesa y un endpoint restringido. Es bastante normal en una vista previa, pero significa que no puedes probarla bajo carga, ponerle precio ni leer sus límites.
¿Qué aporta la Decisions API frente a los structured outputs?
Un comentarista de HN hizo la pregunta obvia a las pocas horas del lanzamiento:
"It seems a bit silly since OpenAI LLMs already can output structured data."

Es un buen argumento. Ya hoy puedes hacer que Luna responda desde una lista fija: usa la Responses API, pon el reasoning en none y pasa un esquema JSON estricto cuyo único campo sea un enum de tus respuestas. Abajo está la solicitud exacta que ejecuté mientras la Decisions API seguía restringida:
{"model":"gpt-6-luna","reasoning":{"effort":"none"},
 "input":[{"role":"developer","content":"Route the support ticket. Which queue?"},
          {"role":"user","content":"I was charged twice for my order #4471"}],
 "text":{"format":{"type":"json_schema","name":"route","strict":true,
   "schema":{"type":"object","properties":{"queue":{"type":"string","enum":["billing","shipping","technical","other"]}},
   "required":["queue"],"additionalProperties":false}}}}
Devolvió {"queue":"billing"} en las tres ejecuciones, con 60 tokens de entrada y 12 de salida. Eso da $0.000012 por llamada a las tarifas Standard de Luna. Quien haya usado el function calling de OpenAI conocerá la idea, solo que con una correa más corta, y es también la configuración detrás de la mayoría del enrutamiento de tickets con IA para SaaS hoy.
Hay un inconveniente, sin embargo, que planteó un comentarista en un hilo anterior de HN sobre OpenAI y Jev:
"It's not guaranteed to be correct: it's guaranteed to be formatted in a particular way. You can get the same thing with grammars on any LLM."
Así que el problema del formato ya está resuelto. Lo que la Decisions API promete además es velocidad, más lo que acabe significando el ajuste de precisión de "focusing Luna's intelligence". Con lo que hay público hasta ahora, las dos opciones se comparan así:
| Decisions API | Luna + structured outputs | |
|---|---|---|
| Estado | Vista previa limitada, clientes seleccionados | Disponible ahora |
| Entrada | Texto o imágenes | Texto e imágenes |
| Salida | "A selection" de tus respuestas | JSON que coincide con tu esquema |
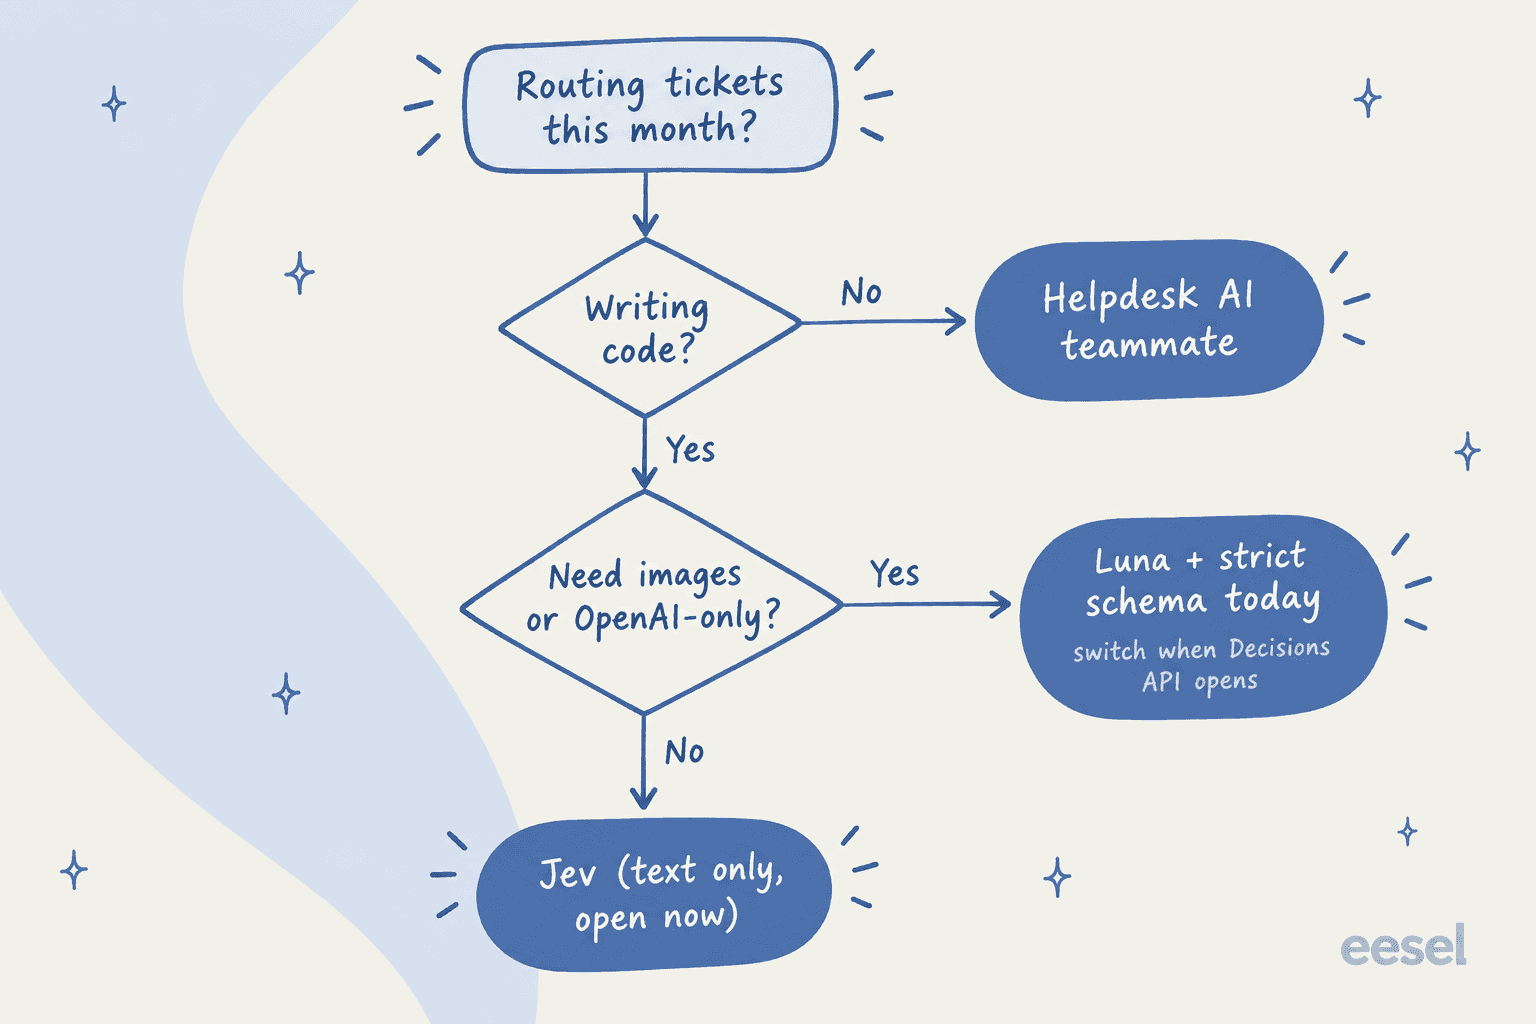
| Velocidad | "Less than a few hundreds of milliseconds end to end" (afirmación de personal de OpenAI) | Mediana de 1,46 s en mi prueba |
| Precio | No publicado | $0.10 entrada / $0.50 salida por 1M de tokens |
| Puntuación de confianza | No confirmada | Ninguna por defecto |
| Documentación | Aún ninguna | Guía de structured outputs |
¿Qué tan rápida es la Decisions API?
La única afirmación escrita de OpenAI sobre velocidad viene de un miembro del personal, no hay nada en la documentación. Thibault Sottiaux, que trabaja en OpenAI, publicó el día del lanzamiento:
"Decisions API, for lightning fast constrained decision making powered by Luna. Supports visual inputs, and tuned to be able to make decisions in less than a few hundreds of milliseconds end to end."
Para ver qué tendría que superar, envié 20 tickets de soporte por Luna dos veces por configuración y pedí una cola y una prioridad, además de si el ticket era seguro para responder automáticamente. Son 160 llamadas en total, medidas de extremo a extremo desde un portátil, así que el viaje de red está incluido.
| Configuración (mi prueba) | Mediana | Más rápida | Más lenta |
|---|---|---|---|
| GPT-6 Luna, reasoning none | 1,46 s | 0,95 s | 2,79 s |
| GPT-6 Luna, reasoning low | 1,62 s | 0,95 s | 3,20 s |
| GPT-6 Luna, reasoning medium | 2,33 s | 1,44 s | 5,75 s |
| GPT-6.1 Sol, reasoning low | 2,17 s | 1,52 s | 4,98 s |
Si la afirmación de OpenAI se cumple, la Decisions API sería unas cinco veces más rápida que mi mejor configuración de Luna. Dónde importa esa diferencia y dónde no:
- Triaje de correo y tickets. Realmente no. Nadie nota si un ticket se etiquetó en 300 ms o en 1,5 segundos.
- Chat en vivo. Sí. Una pausa de 1,5 segundos antes de que el bot haya decidido siquiera quién debe responder se acumula a lo largo de una conversación.
- Agentes. Aquí es donde más importa. Un agente construido con algo como OpenAI AgentKit que toma 20 pequeñas decisiones por tarea espera 30 segundos con Luna, frente a unos pocos segundos a la velocidad afirmada.
Parte de la prensa muestra un gráfico de "150 ms vs 1.6 s". No pude encontrar esas cifras en ninguna página ni publicación de OpenAI, así que no planificaría nada con ellas antes de que salga la documentación.
¿Cómo se compara con TypeSafe Jev?
Es difícil hablar de este lanzamiento sin mencionar TypeSafe Jev. TypeSafe lanzó Jev el 15 de septiembre como un modelo creado solo para decisiones tipadas, y la Decisions API apareció dos semanas después. Un comentarista de HN lo dijo sin rodeos en el hilo del DevDay: "Decisions API is a validation for Jev and the entire space it created."
Según lo que ha publicado cada empresa, se alinean así:
| OpenAI Decisions API | TypeSafe Jev | |
|---|---|---|
| Acceso | Vista previa limitada | Abierto a todos desde el 27 sep |
| Entrada | Texto o imágenes | Solo texto, según la página de modelos de Jev |
| Tipos de pregunta | Preguntas con respuestas fijas | Choice, Score y Noul (probabilidad de verdadero o falso) |
| Salida | Una selección | Opción más probabilidades y confianza |
| Precio | No publicado | $0.042 por 1M de tokens de entrada, salida gratis |
| Velocidad | "Less than a few hundreds of milliseconds" | "70ms-500ms" de extremo a extremo, según la publicación de lanzamiento |
| Opciones por pregunta | No publicado | Hasta 255 por Choice |
| Límites de uso | No publicado | 100K tokens/s o 40 solicitudes/s |
Para la mayoría de los equipos se reduce a dos filas. Jev no acepta imágenes, así que si tu cola está llena de capturas y fotos de daños, eso apunta a OpenAI. Por el otro lado, Jev devuelve una probabilidad con cada respuesta, y eso es justo lo que necesitas para decidir cuándo no actuar.
Mi reseña de Jev cuenta cómo se comportó en las pruebas. Para las cuentas de tarifas, el desglose de precios de Jev las tiene, incluido el nivel más rápido Jev Ultrafast.
En precio, la comparación temprana con Luna ya se inclina hacia Jev:
"They say it's built on Luna, which costs $0.10M/in, vs Jev which only costs $0.04M/in, which is interesting ..."
Ten en cuenta que ese es el precio de lista de Luna, no un precio de la Decisions API. OpenAI podría fijar un precio muy distinto para el endpoint cuando se abra.
¿Para qué puedes usar la Decisions API en soporte?
OpenAI nombró tres tareas, y cada una tiene una versión clara en soporte:
- Clasificar contenido. Etiquetar un ticket por intención, producto o sentimiento, detectar spam o distinguir una solicitud de reembolso de una devolución.
- Enrutar solicitudes. Enviar un ticket a facturación, envíos o técnico, o a una cola por idioma o nivel. Es el clásico enrutamiento inteligente, la tarea que OpenAI usó como su propio ejemplo. El mismo patrón sirve para el enrutamiento en ecommerce.
- Elegir la siguiente acción de un agente. Decidir si debe consultar el pedido, hacer una pregunta aclaratoria, responder o escalar a una persona, normalmente a partir de la detección de intención.
Las dos primeras son lo que la mayoría de los equipos entiende por triaje de tickets, y las decisiones tipadas ya funcionan bien ahí. La mayoría de los helpdesks también incluyen alguna versión nativa, desde el triaje automático de Freshdesk hasta una larga lista de apps de clasificación para Zendesk. En una prueba con tráfico real en una tienda online de joyería con unos 1.000 tickets al mes en Zendesk y Shopify, las llamadas tipadas de eesel lograron un 93 % de precisión en el triaje y detectaron el 100 % del spam sin ningún falso positivo, y el spam era el 22 % de esa bandeja.
Mi propia prueba mostró dónde empiezan los problemas. Todas las configuraciones eligieron la cola correcta 40 de 40 veces. En «¿es seguro responder automáticamente?», en cambio, Luna sin reasoning sacó 33 de 40, e incluso GPT-6.1 Sol solo 39 de 40. Enrutar es la parte fácil; saber cuándo no actuar es la difícil. Una cola equivocada te cuesta unos minutos, mientras que una respuesta automática equivocada sale directa a un cliente.
Los compradores trazan la línea en el mismo lugar. Un responsable de CX de una marca de suplementos con unos 7.000 tickets al mes en Gorgias le dijo a eesel en una llamada de ventas que no podían revisar a mano cada respuesta de la IA, así que la IA tenía que mantenerse al margen de todo aquello de lo que no estuviera segura:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Un endpoint de decisiones te da la respuesta. A menos que también devuelva una confianza calibrada, no te dice cuándo dejar un ticket en paz, así que esa regla sigue siendo tuya. Antes de confiar una acción a cualquier clasificador, conviene leer sobre los falsos positivos en el etiquetado con IA.
¿Cuánto costará la Decisions API?
Nadie fuera de OpenAI lo sabe todavía. No hay fila de precio, y OpenAI no ha dicho si factura por token, por llamada o por pregunta. Por ahora, la única referencia pública es la propia tarifa de Luna:
| Nivel de GPT-6 Luna | Entrada por 1M | Entrada en caché por 1M | Salida por 1M |
|---|---|---|---|
| Standard | $0.10 | $0.01 | $0.50 |
| Batch / Flex | $0.05 | $0.005 | $0.25 |
| Fast | $0.20 | $0.02 | $1.00 |
A esas tarifas mi prueba de 160 llamadas costó $0.047 por 1.000 tickets sin reasoning, y $0.089 con esfuerzo medio. Incluso un mes de 10.000 tickets sale muy por debajo de un dólar. Las cuentas completas y los costes ocultos, además de la pelea de precios con Jev, están en mi artículo sobre los precios de la Decisions API, y la guía más amplia de precios de la API de OpenAI tiene la tarifa de cada modelo. Solo por precio, la decisión nunca es la parte cara de un stack de soporte.
¿Deberías construir ya sobre la Decisions API?
Todavía no, a menos que estés en la vista previa. Aun así puedes construir hoy la misma función e intercambiar el endpoint más adelante. Así lo decidiría yo:
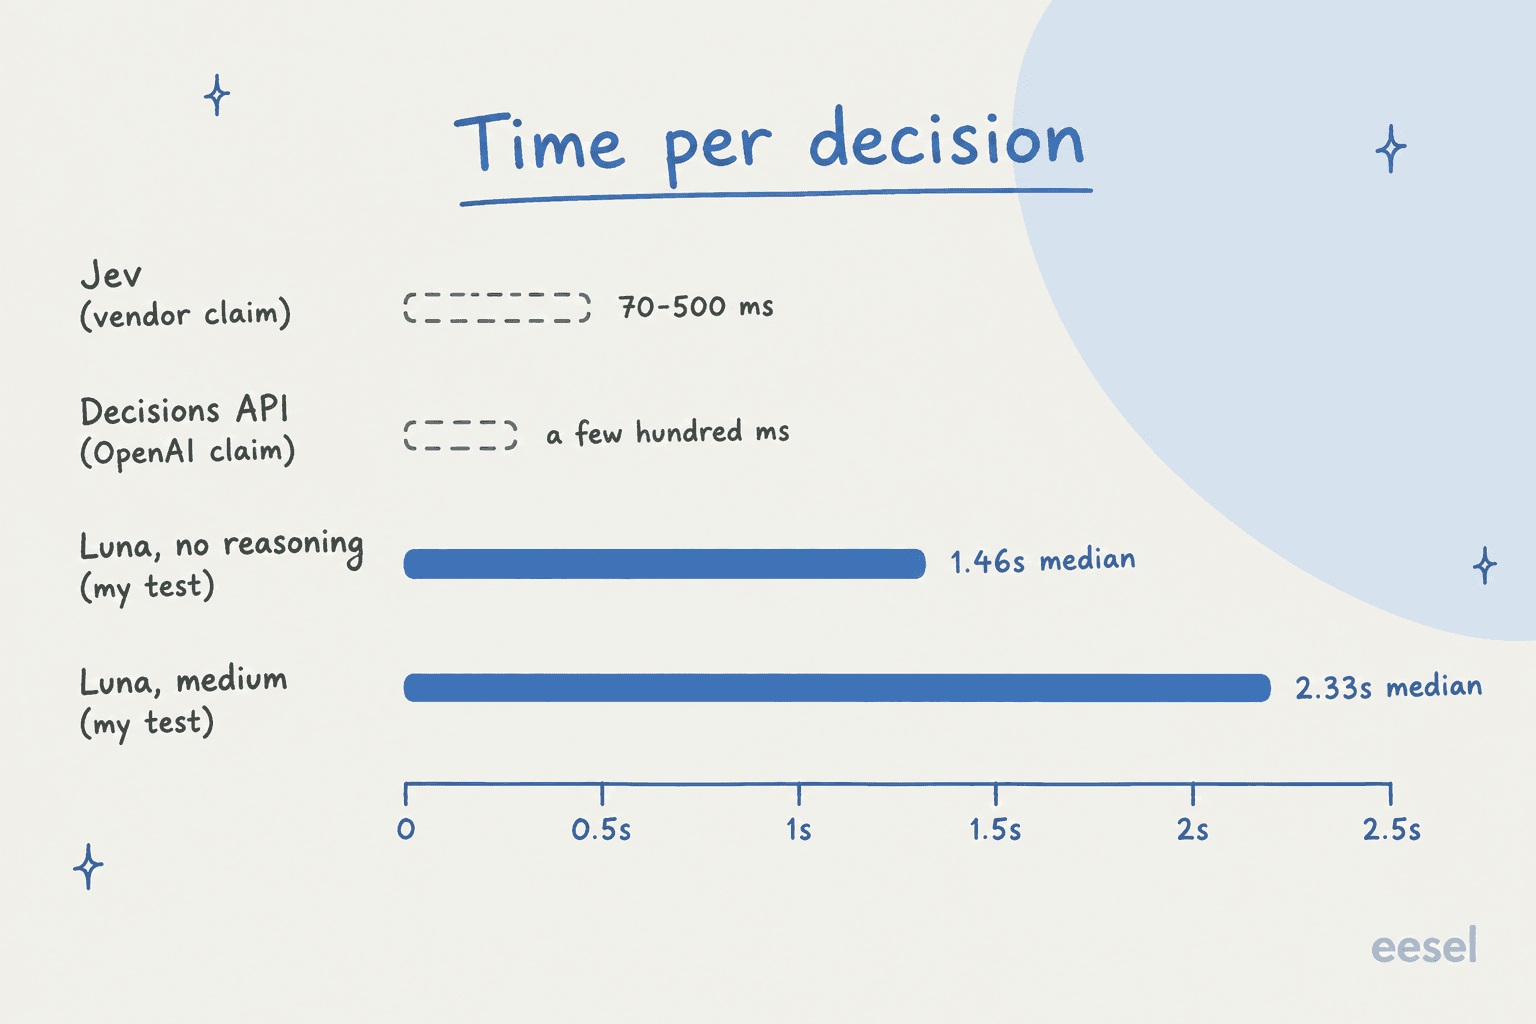
- Escribes código y te quedas en OpenAI. Lanza Luna con un esquema enum estricto y el reasoning en
noneolow. Mantén las preguntas y la lista de respuestas en un solo lugar, y pasar a/v1/decisionsseguirá siendo un cambio pequeño. El artículo de alternativas a Luna cubre otros modelos pequeños si quieres un plan B, como Gemini 3.5 Flash-Lite. - Necesitas respuestas en menos de un segundo con texto. Prueba Jev ya. Está abierto y tiene precio, y también devuelve probabilidades. La lista de alternativas a Jev cubre el resto de ese campo.
- Tus entradas son imágenes. Quédate con OpenAI. Luna acepta imágenes hoy, y según el changelog de la API OpenAI corrigió el 25 de septiembre un error de codificación de imágenes que había "degraded image understanding", así que vuelve a ejecutar cualquier evaluación de imágenes anterior.
- Quieres enrutamiento dentro de Zendesk o Freshdesk, no una API. Entonces puedes saltarte por completo la cuestión del endpoint. Empieza con mi guía sobre cómo automatizar el triaje de tickets, o el resumen de la mejor IA para el triaje de tickets. Los equipos de Zendesk también pueden comparar Zendesk Intelligent Triage.
Sobre el momento, los escépticos tienen un punto:
"It's another Jev copy, like we've seen so many over the last few weeks. But with no benchmarks or price comparison, which likely means it doesn't compare that well."
Yo sería menos duro. Una vista previa restringida sin precio es normal, y la entrada de imágenes es una diferencia real. Aun así, «sin documentación, sin precio, sin benchmarks» es motivo suficiente para no basar una hoja de ruta en ella esta semana.
eesel para un enrutamiento de tickets con confianza
La Decisions API es infraestructura. Elige una respuesta de tu lista, y todo lo que rodea a esa respuesta lo tienes que construir tú, como la conexión con el helpdesk y las etiquetas, la regla de «enviar a una persona» y un registro de lo que hizo. eesel es el compañero que ya hace ese trabajo. Su compañero de helpdesk con IA se une a tu cola en Zendesk o Freshdesk, aprende de tu centro de ayuda y de tickets pasados, y luego enruta, etiqueta y responde, con reglas de escalado que escribes en lenguaje sencillo.

Según mi prueba, la parte que más importa es la decisión de «¿es seguro responder automáticamente?», y ahí es donde eesel pone su esfuerzo. Antes de tocar una cola en vivo, eesel reproduce cientos de tus tickets pasados y puntúa sus respuestas contra lo que tu equipo realmente envió, de modo que las decisiones arriesgadas salgan a la luz antes de que las vea un cliente. Cualquier ticket del que no esté seguro pasa a una persona.
Si has llegado aquí porque prefieres construir con código, la CLI de eesel ejecuta el mismo compañero y espacio de trabajo desde una terminal. eesel instructions edita las reglas de enrutamiento, eesel activity lista cada ticket que tocó y eesel approvals permite que una persona dé el visto bueno a una acción antes de que ocurra. Cada comando imprime JSON y admite --dry-run, así que scripts y agentes de programación como Claude Code o Cursor pueden manejarlo, y cada espacio de trabajo también funciona como servidor MCP.
Los precios son por ticket, no por token: un ticket o chat es un crédito, los planes empiezan en $299 por 500 créditos y el plan gratuito da 100 créditos sin tarjeta. Prueba eesel con una porción de tu cola y comprueba de cuáles de los tickets está lo bastante seguro como para encargarse.
Preguntas frecuentes
¿Qué es la OpenAI Decisions API?
¿Ya está disponible la OpenAI Decisions API?
¿Cuánto cuesta la OpenAI Decisions API?
¿En qué se diferencia la Decisions API de los structured outputs?
¿Es la OpenAI Decisions API una copia de TypeSafe Jev?
¿Puedo usar la OpenAI Decisions API para enrutar tickets de soporte?
¿La Decisions API devuelve una puntuación de confianza?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.