¿Qué es Amazon Bedrock Managed Agents?
Amazon Bedrock Managed Agents, impulsado por OpenAI, es un runtime gestionado para agentes de IA con estado en AWS. Creas una sesión con un modelo, instrucciones, herramientas y un entorno de ejecución, le envías mensajes y el servicio ejecuta el bucle del agente y las llamadas al modelo. En palabras de AWS, está "built on a customized version of OpenAI's Agents API engineered to be AWS-native" (AWS What's New), y la página del producto dice que "combines OpenAI models with the Codex harness and Amazon Bedrock AgentCore" (AWS).
Yo me encargo de las integraciones y las API de eesel, así que he montado este mismo tipo de bucle a mano más de una vez. Y lo primero que hay que saber es algo que la página de marketing deja un poco enterrado: "gestionado" aquí cubre la conversación y el bucle de razonamiento, no la máquina sobre la que trabaja tu agente. Esa máquina la ejecutas tú.
Llegar hasta aquí llevó un tiempo. Esta es la cronología, toda de fuentes primarias:
| Fecha | Qué pasó | Fuente |
|---|---|---|
| 27 feb 2026 | Amazon y OpenAI anuncian una alianza, que incluye un "Stateful Runtime Environment" en Bedrock | Amazon |
| 28 abr 2026 | BMA se anuncia en preview limitada, junto con los modelos de OpenAI y Codex en Bedrock | OpenAI |
| 1 jun 2026 | Los modelos de OpenAI y Codex en Bedrock pasan a GA; BMA sigue en "coming soon" | AWS ML blog |
| 29 sep 2026 | BMA se abre como preview pública en 3 Regiones de EE. UU. | AWS What's New |
Los clientes de lanzamiento nombrados son Box y Salesforce. En el post de lanzamiento de Amazon, el CTO de Box, Ben Kus, dice que reúne los modelos de OpenAI "with the scale, security, and infrastructure of AWS", y Salesforce lo combina con su producto Headless 360 en la página de producto de AWS.
Si has leído mi guía de la OpenAI Agents API, la forma te resultará familiar: misma línea de harness que OpenAI Codex (su precio es aparte), mismos objetos de agente, sesión y eventos. La diferencia tiene que ver sobre todo con quién aloja el bucle y quién firma las solicitudes.
Cómo funciona Bedrock Managed Agents
La documentación de AWS divide el servicio en seis partes (documentación de AWS):
- Sesión: una conversación con estado con un agente. Indica un modelo, instrucciones, herramientas, un rol de IAM y un entorno de ejecución.
- Turno: el trabajo que se hace en respuesta a un mensaje: razonamiento, llamadas a herramientas y salida.
- Entorno de ejecución: el cómputo que tú proporcionas, donde realmente corren los comandos y las herramientas locales.
- Exec server: el proceso
codex exec-serverque conecta tu entorno con BMA mediante una conexión saliente. - Items y eventos: los items son el registro duradero de lo ocurrido; los eventos son un flujo en vivo del progreso.
- Rol de sesión: el rol de IAM que BMA asume para llamar al modelo (y, si lo usas, para iniciar AgentCore Runtime).
AWS tiene su propio diagrama de cómo se comunican esas piezas:
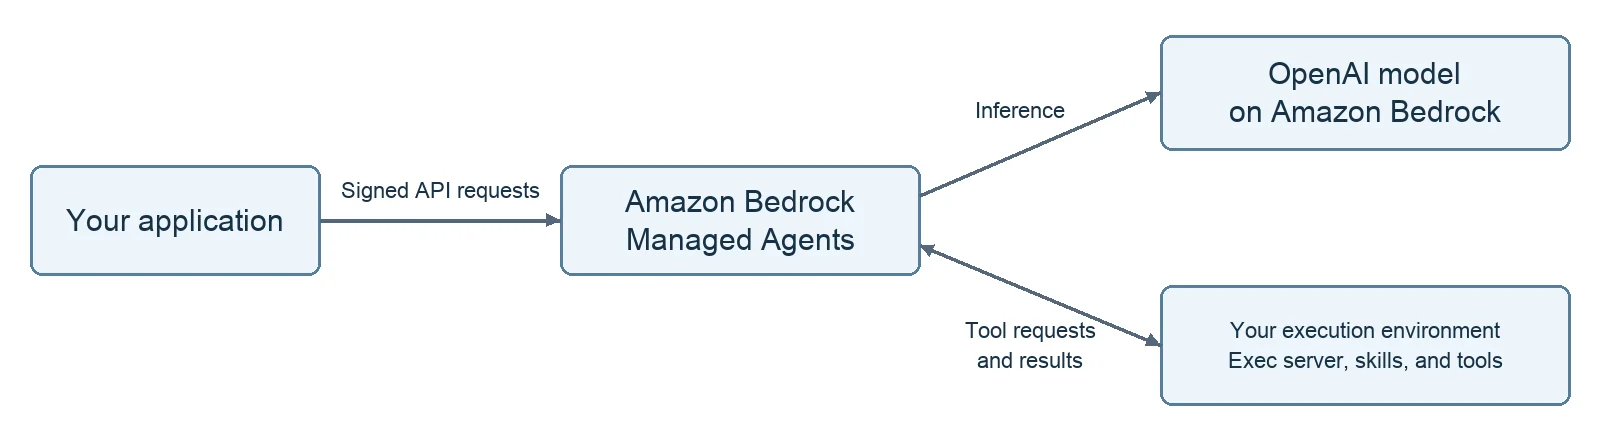
Lo que me sorprendió fue el recuadro de abajo a la derecha. En Claude Managed Agents o en la Agents API alojada de OpenAI, puedes dejar que el proveedor ejecute un sandbox por ti. En BMA no hay opción de sandbox del proveedor. Las herramientas "execute in the compute environment that you provide" (documentación de AWS), así que el exec server, el espacio de trabajo, las reglas de red y cualquier servidor MCP corren por tu cuenta.
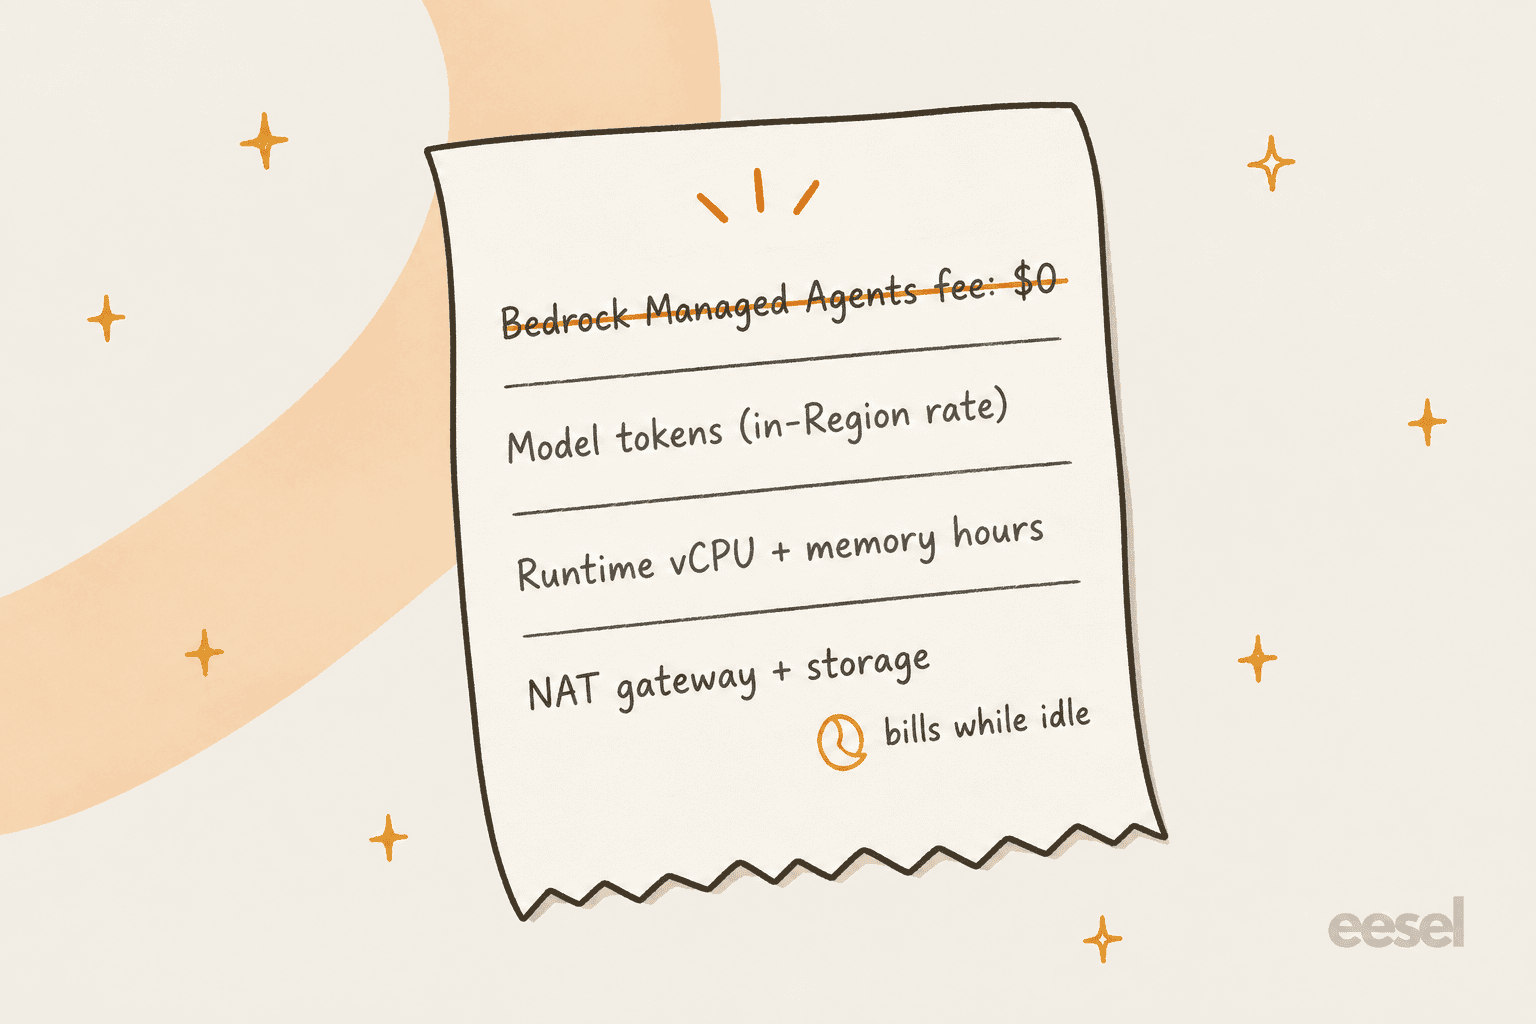
Ese es el intercambio, el mismo que veo en cada comparativa de mejores agentes de IA. Cedes comodidad y obtienes una historia de seguridad limpia: la inferencia del modelo, el runtime del agente y tus herramientas se quedan dentro de AWS, y la página de producto de AWS lo dice tal cual: "The agent runtime and model inference remain inside AWS" (AWS).
La API es pequeña
La superficie REST de la preview son siete operaciones en el endpoint regional bedrock-mantle, todas firmadas con AWS SigV4 en lugar de una clave de API de OpenAI (referencia de la API): crear, listar, recuperar y eliminar una sesión, enviar eventos, transmitir eventos y listar items. Envías un mensaje publicando un evento agent.session.input.message y luego lees los resultados del endpoint de items, de 1 a 100 por página (guía de sesiones).
Hay dos detalles en la documentación que te ahorrarán una tarde:
- Un envío correcto devuelve un cuerpo vacío. Significa "aceptado", no "terminado". La finalización aparece en el estado de la sesión, los items y los eventos.
- Una sesión
idleno es prueba de que la tarea funcionara. AWS dice que revises los items de salida y, en el caso de comandos, el código de salida. Cancelar un turno tampoco "does not undo side effects from tools that already completed."
Skills y herramientas
Una skill es una carpeta con un archivo SKILL.md, colocada bajo uno de los directorios de capacidades de la sesión (hasta 32 rutas). Las herramientas vienen de servidores MCP STDIO que corren dentro de tu entorno (mi guía del servidor MCP para agentes de IA explica el patrón), y puedes restringir cada servidor con una lista allowed_tools (skills y herramientas). Si has usado skills en Claude Code, el formato es lo bastante parecido como para sentirte en casa.
AWS es directa con la parte de seguridad: "Treat instructions from documents, websites, and tool responses as untrusted input" (documentación de seguridad). Es un consejo sobre prompt injection, y suena distinto cuando el agente tiene una shell real en un host real.
Dónde corre realmente tu agente: autoalojado o AgentCore
Tienes dos entornos de ejecución, y la elección decide la mayor parte del trabajo de configuración y parte de tu factura (documentación de AWS):
| Cómputo autoalojado | AgentCore Runtime | |
|---|---|---|
| Qué aportas | Un host, un espacio de trabajo, acceso de red y un codex exec-server en marcha | Un AgentCore Runtime con el exec server y su adaptador dentro de un contenedor ARM64 |
| Qué crea el stack de ejemplo de AWS | Solo roles de IAM (sin host) | Runtime, VPC con subredes privadas, 1 NAT gateway, buckets de S3 con versionado para skills y salidas, montajes de S3 Files |
| Quién inicia el exec server | Tú, en una segunda terminal | BMA activa el Runtime por ti |
| Límites de tiempo del ejemplo | Los decides tú | 28,800 segundos (8 horas) de inactividad y de vida máxima |
| Ideal para | Máquinas de desarrollo, contenedores existentes, pruebas rápidas | Cómputo gestionado por sesión que se queda en tu cuenta |
AgentCore es la plataforma de agentes más amplia de AWS y es el cómputo por defecto de BMA. El argumento de AWS es que, a medida que tus agentes crezcan, puedes apoyarte en más de ella: autorización, descubrimiento de agentes y herramientas, observabilidad y evaluación (AWS).
Si solo quieres ver algo funcionando, el camino autoalojado es el más rápido. El camino de AgentCore es el que de verdad pondrías en producción, y es también donde empiezan a acumularse los costes que no aparecen en la línea de "sin cargo adicional".
Qué incluye la preview y qué deja fuera
Si solo vas a leer una sección dos veces antes de comprometerte, que sea esta. La página de limitaciones de la preview de AWS es inusualmente clara sobre los límites:
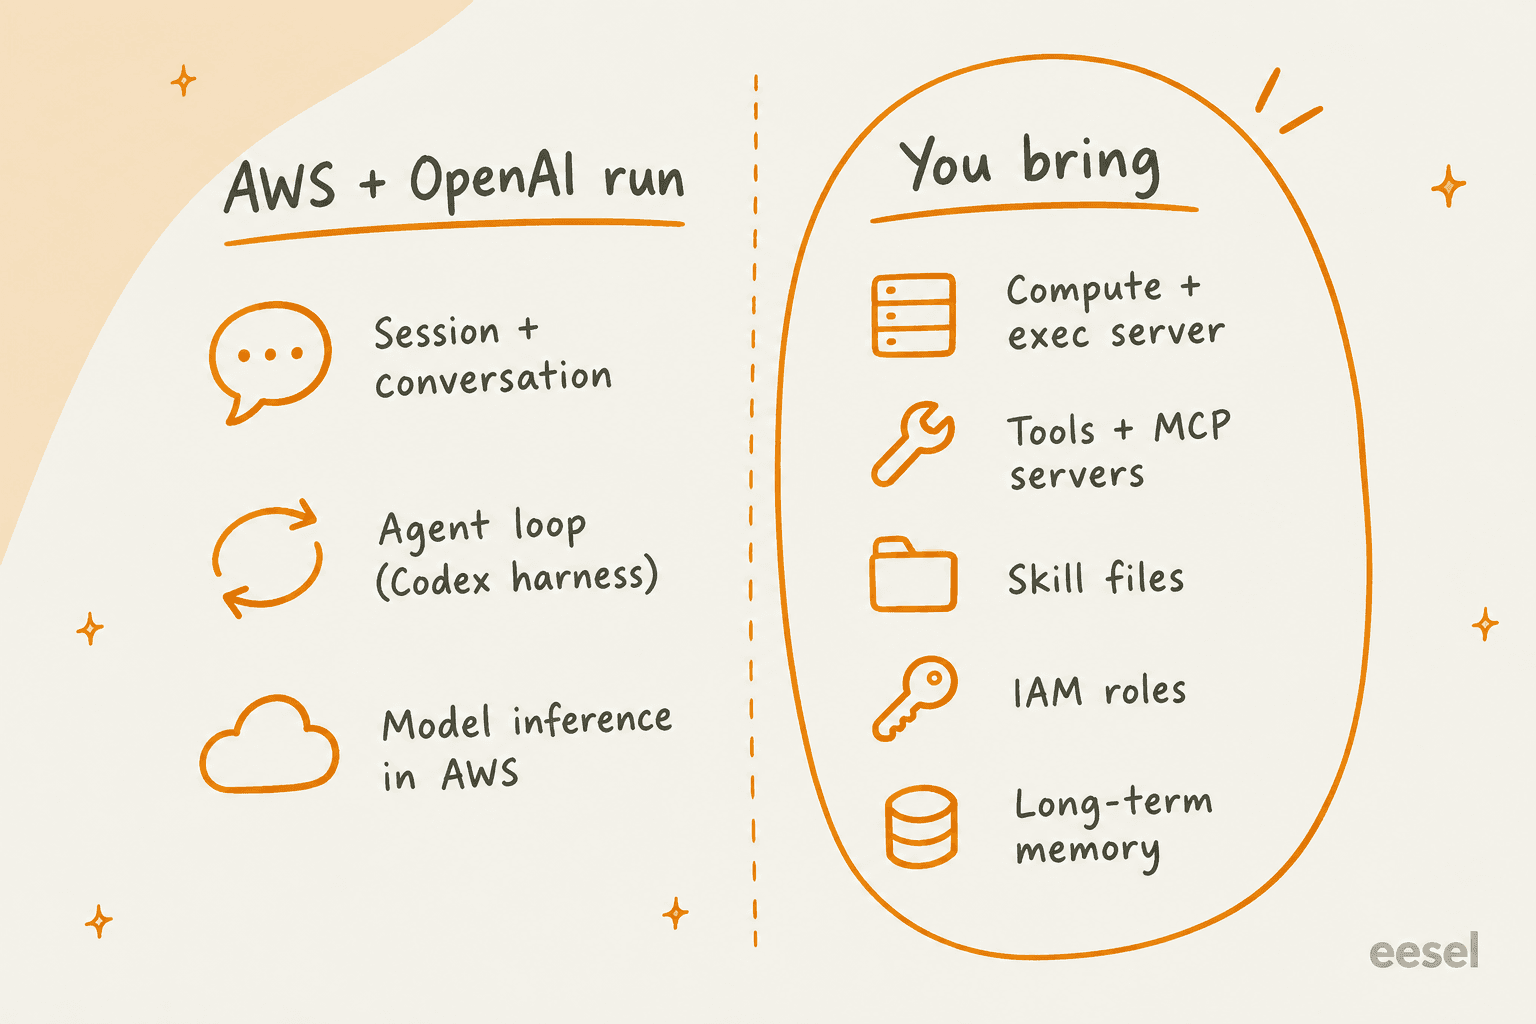
- La entrada es solo texto. La superficie de entrada de sesión documentada es texto.
- Sin subagentes ni code mode. AWS dice que no los actives en la configuración de una sesión, así que los patrones de orquestación de subagentes quedan descartados por ahora.
- Sin memoria a largo plazo. "The preview does not provide a built-in long-term memory integration; provision and authorize any application-specific datastore separately."
- Sin inferencia entre Regiones. Lo que importa para el precio, como verás más abajo.
- Sin clave KMS gestionada por el cliente para los datos de sesión gestionados por el servicio.
- Sin consola. Todo pasa por la API y el paquete de ejemplo de AWS.
- Sin API dedicada para listar turnos. Correlacionas los turnos mediante los valores
turn_idde los items.
Hay una brecha fácil de pasar por alto. El mensaje de lanzamiento dice que el runtime gestionado "handles inference, memory, and skills" (AWS) y que cada agente "supports human approval before consequential actions", según el mismo anuncio de la preview. En ambos casos, la documentación para desarrolladores dice algo más acotado. Memoria significa contexto dentro de una sola sesión, y para acciones con efectos externos la guía de seguridad dice que hay que "enforce authorization and any required human review in the application or tool implementation" (documentación de seguridad). Así que el control human-in-the-loop es algo que construyes, no algo que activas.
Para una preview, nada de esto es inusual. Lo que sí significa es que la versión que puedes usar hoy se parece más a "un bucle gestionado más un buen repositorio de ejemplo" que a una plataforma de agentes terminada. La página de BMA de OpenAI añade una advertencia que conviene tomar al pie de la letra: "Shared concepts don't imply identical API contracts or feature availability." No copies una solicitud de la OpenAI Agents API esperando que funcione en Bedrock.
Cuánto cuesta Bedrock Managed Agents
La línea de precios de AWS es corta: "During preview, there is no additional charge for BMA beyond the underlying AWS resources your agents consume. Pricing is subject to change at general availability" (AWS What's New). La documentación detalla qué son los "recursos subyacentes": la inferencia del modelo más los recursos de AWS que use tu aplicación, y el ejemplo de AgentCore "can continue to incur charges when no BMA turn is running" (documentación de AWS).
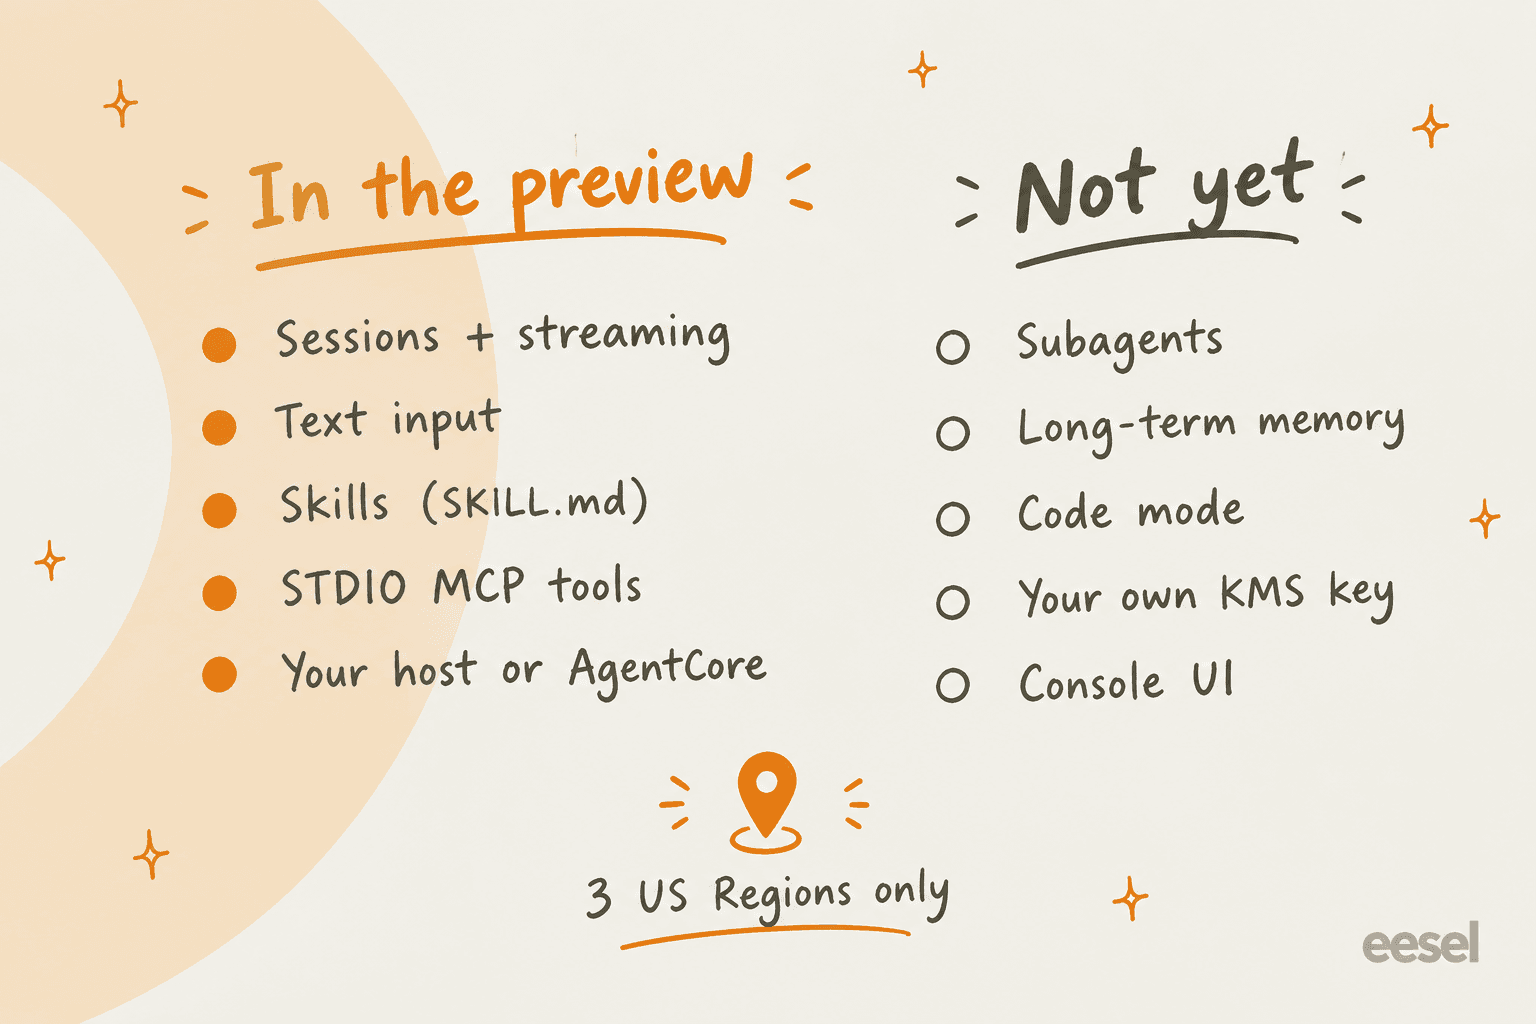
Línea 1: tokens del modelo, a la tarifa in-Region
Cada modelo de OpenAI en Bedrock tiene su precio en su ficha de modelo. El problema es que la preview de BMA no admite perfiles de inferencia entre Regiones, así que pagas la tarifa in-Region, y AWS señala que "Commercial In-Region prices include a 10% fee over OpenAI rates" (ficha de GPT-5.6 Luna). Estas son las tarifas de contexto corto (272K tokens de entrada o menos) por millón de tokens:
| Modelo | Entrada (in-Region) | Entrada en caché | Salida (in-Region) | Tarifa global, igual que la de OpenAI (ent. / sal.) |
|---|---|---|---|---|
| GPT-5.6 Luna (predeterminado en el ejemplo de BMA) | $0.22 | $0.022 | $1.32 | $0.20 / $1.20 |
| GPT-6 Luna | $0.11 | $0.011 | $0.55 | $0.10 / $0.50 |
| GPT-6.1 Sol | $2.20 | $0.11 | $11.00 | $2.00 / $10.00 |
| GPT-5.6 Terra | $2.20 | $0.22 | $13.20 | $2.00 / $12.00 |
| GPT-5.6 Sol | $4.40 | $0.44 | $22.00 | $4.00 / $20.00 |
| GPT-6 Astra | $11.00 | $1.10 | $55.00 | $10.00 / $50.00 |
Cada tarifa sale de la ficha de Bedrock de ese modelo, todas enlazadas desde la página de modelos de OpenAI de AWS. AWS no publica una lista fija de modelos compatibles con BMA, y la ficha de GPT-6.1 Sol indica que el prompt caching explícito no es compatible con ese modelo en Bedrock, así que revisa tu modelo antes de contar con descuentos por caché. Las solicitudes de contexto largo (más de 272K de entrada, una fracción de la ventana de contexto de más de 1M) cuestan todavía más. GPT-5.6 Sol sube a $8.80 de entrada y $33.00 de salida.
Línea 2: horas de runtime
Si usas AgentCore Runtime, pagas sus tarifas de cómputo. En las microVM v2 son $0.1276 por vCPU-hora y $0.0169 por GB-hora, facturadas por segundo, y AWS dice que la CPU no se factura mientras el agente espera E/S, como la respuesta del modelo (precios de AgentCore). Si es autoalojado, pagas lo que ya cueste tu host.
Línea 3: el NAT gateway que nadie menciona
El stack de ejemplo de AgentCore de AWS crea un NAT gateway. A la tarifa publicada de US East son $0.045 por hora más $0.045 por GB procesado, y las horas parciales se facturan como horas completas (precios de Amazon VPC). Dejado en marcha durante un mes (730 horas), son unos $33 al mes antes de que tu agente haga una sola cosa. Para una empresa es poco dinero. Aun así, es justo el tipo de línea que aparece en una cuenta de desarrollo tres meses después de que alguien olvidara ejecutar los pasos de limpieza.
Un ejemplo práctico
Supón que una tarea del agente lee un código base y algunos documentos: 200,000 tokens de entrada, 20,000 de salida, unos 10 minutos en una sesión de AgentCore de 2 vCPU / 4 GB.
- Con GPT-5.6 Luna: $0.044 de entrada + $0.026 de salida = unos $0.07 en tokens.
- Con GPT-5.6 Sol: $0.88 de entrada + $0.44 de salida = unos $1.32 en tokens.
- Techo del runtime: 2 vCPU x $0.1276 + 4 GB x $0.0169 = $0.32 por hora si la CPU estuviera ocupada todo el tiempo, es decir, unos $0.05 por 10 minutos, y menos en la práctica porque esperar al modelo no factura CPU.
La conclusión: la elección del modelo mueve la factura unas 19 veces; el runtime apenas la mueve. A bajo volumen notarás los costes fijos (NAT gateway, almacenamiento), y a alto volumen, los tokens. Si quieres las mismas cuentas para la versión alojada de OpenAI, mi artículo de precios de la Agents API cubre sus tarifas de contenedor por cada 20 minutos, y mi guía de precios de AWS cubre el resto de la factura de AWS.
Cómo se compara con otros runtimes de agentes gestionados
Todos los grandes laboratorios venden ya alguna versión de "nosotros ejecutamos el bucle del agente por ti". Donde de verdad difieren es en dónde viven dos cosas: el bucle y las herramientas.
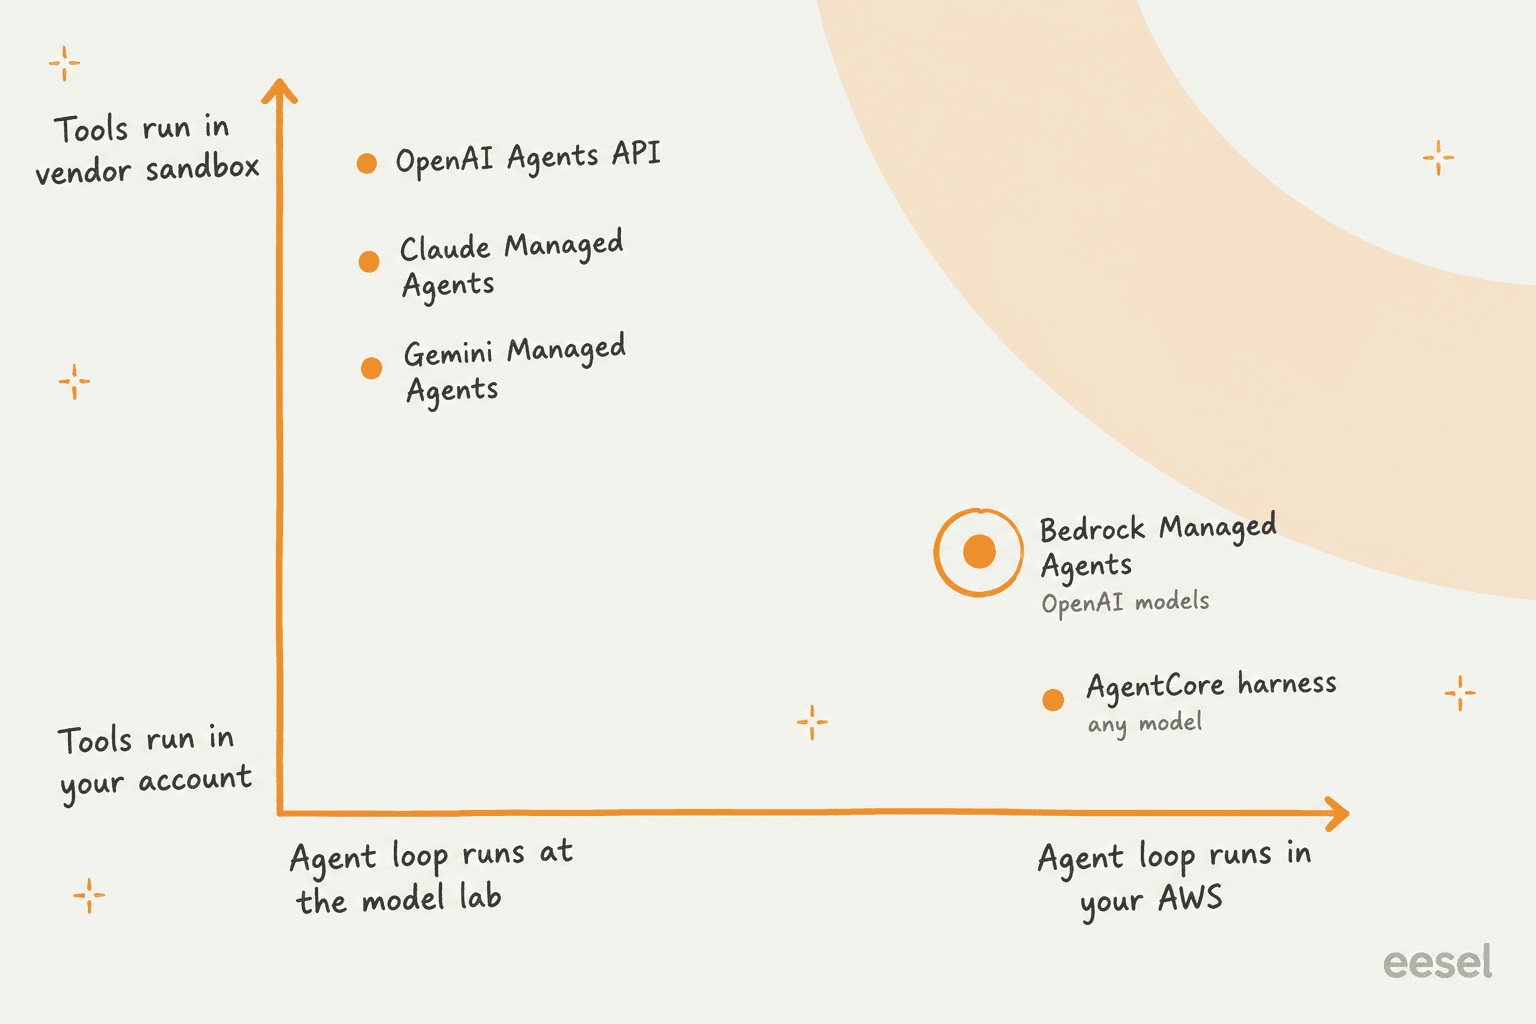
Claude Managed Agents y la Agents API de OpenAI también ofrecen sandboxes autoalojados, así que el grupo de arriba a la izquierda es su modo por defecto y no el único. Aun así, la orquestación se queda con el laboratorio: en la versión de Anthropic, las entradas y salidas de las herramientas siguen fluyendo al plano de control de Anthropic, y en la de OpenAI, elegir un sandbox autoalojado solo mueve la ejecución de herramientas. BMA es la única opción aquí que mantiene el harness de OpenAI, los modelos de OpenAI y tus herramientas dentro de AWS.
| Bedrock Managed Agents | Claude Managed Agents | OpenAI Agents API | Gemini Managed Agents | Harness de AgentCore | |
|---|---|---|---|---|---|
| Estado | Preview pública, 3 Regiones de EE. UU. | Beta | Beta pública (10 sep 2026) | Preview pública (19 may 2026) | Disponibilidad general |
| Modelos | OpenAI en Bedrock | Solo Claude | Solo OpenAI | Solo Gemini | Bedrock, OpenAI, Gemini, cualquier proveedor de LiteLLM |
| Dónde corren las herramientas | Solo tu host o AgentCore | Sandbox de Anthropic o el tuyo | Sandbox de OpenAI, el tuyo, proveedores asociados o ninguno | Sandbox de Google (4 CPU / 16 GB) | microVM por sesión en tu cuenta |
| Tarifa de runtime | Ninguna durante la preview | $0.08 por hora de sesión mientras corre | $0.03 a $1.92 por contenedor de 20 min; ninguna si es autoalojado | Cómputo no facturado en la preview | $0.1276 por vCPU-hora + $0.0169 por GB-hora |
| Memoria a largo plazo | No (preview) | Memory stores | No publicado | No (archivos conservados 7 días) | AgentCore Memory |
| MCP | STDIO dentro de tu entorno | Servidores remotos + túneles | Remoto o local | HTTP remoto | Vía AgentCore Gateway |
| Subagentes | No | Sí (multiagente) | Sí | No publicado | No publicado |
Un par de cosas de esa tabla merecen una segunda mirada.
El harness de AgentCore es el rival más cercano de BMA, y también es de AWS. Está en GA, admite "any model provided by Amazon Bedrock, OpenAI, Google Gemini, or any LiteLLM-compatible provider" y no hay un cargo aparte por el harness (harness de AgentCore). AWS también ha movido los Bedrock Agents originales a modo de mantenimiento: se renombraron Bedrock Agents Classic y se cerraron a nuevos clientes el 30 de julio de 2026, y AWS dirige las nuevas construcciones al harness (documentación de AWS). Así que, a menos que te comprometas específicamente con el harness de OpenAI, yo empezaría por ahí.
Claude Managed Agents es hoy el producto más completo. Tiene memory stores, orquestación multiagente, sandboxes del proveedor y MCP remoto, y también se puede usar a través de Claude Platform on AWS de Anthropic. Por esa vía, sin embargo, quien procesa los datos es Anthropic y no AWS. Si tu requisito es "AWS es el único procesador", BMA (o Claude en Amazon Bedrock, que cubrí en Claude Code en Bedrock) es la respuesta más limpia. Para una lista más amplia, mira mi recopilación de alternativas a la OpenAI Agents API.
Cómo empezar con Bedrock Managed Agents
La ruta más rápida es el ejemplo autoalojado de AWS. Si tu AWS CLI ya está configurada, calcula una hora. El tutorial autoalojado de AWS tiene todos los comandos:
- Instala las herramientas. Node.js 20+, AWS CLI v2,
curlcon soporte de SigV4,jqy Codex CLI 0.154.0 o posterior (incluyecodex exec-server). - Elige una Región y un endpoint.
us-east-1,us-west-2ous-east-2, con el endpointhttps://bedrock-mantle.<region>.api.aws. - Descarga el paquete de ejemplo y el binario de Codex que coincida con tu host (siempre Linux ARM64 para AgentCore).
- Despliega los roles de IAM con
npm ci,npx cdk bootstrapynpm run deploydesde la carpetaself-hosted/. Obtienes un rol de cliente y un rol de sesión que BMA asume. - Crea una sesión, conecta el exec server y envía un turno. Los scripts numerados del paquete (
0.create-session.sh,1.attach-exec-server.sh,2.submit-turn.sh,3.read-result.sh) te guían paso a paso.
La mayoría de las primeras ejecuciones fallan por el modelo de IAM. Hay tres identidades: quien llama (necesita permisos de BMA más iam:PassRole sobre el rol de sesión), el rol de sesión (en el que confía bedrock-mantle.amazonaws.com y al que se permite bedrock-mantle:CreateInference para tu modelo) y la identidad que usa tu entorno de ejecución (documentación de seguridad). Conviene guardar en favoritos la página de solución de problemas antes de empezar, sobre todo la parte de revisar AWS_PROFILE en cada terminal. Además, usa un espacio de trabajo dedicado, porque "the agent can use the files, tools, and permissions available to that environment."
Qué dicen quienes construyen con ella
La preview pública se abrió esta semana, así que las opiniones de uso real aún escasean. Lo que hay son reacciones al lanzamiento de gente que vive en AWS, y en su mayoría coinciden en el atractivo:
"Bedrock Managed Agents (limited preview): AWS runs OpenAI's agent harness, and all inferences run through Bedrock. Basically, you'd use the OpenAI SDK against AWS-owned infrastructure, and your data stays in AWS.
AgentCore Runtime is the only one that's GA right now, so it's the only viable option if you need something for production."

El ángulo del cumplimiento normativo sale una y otra vez en el hilo de Hacker News sobre el lanzamiento original:
"This would be a nice compliance win. One less sub-processor and all our data is already on AWS so less worrying about sending it off somewhere else"

También vale la pena escuchar a los escépticos. El analista Mitch Ashley planteó la cuestión del lock-in sin rodeos:
"The question for enterprise architects is whether AgentCore stays open enough to govern non-AWS execution, or quietly becomes the lock-in seam."
Y un comentarista de Hacker News, hablando de la capa de cómputo que BMA usa por defecto, no se calló nada:
"There's not really a good solution, as AgentCore runtime sucks and is expensive. You basically have to build this yourself because nobody is solving for self-hosted managed infra for agents, and we don't really have the time to build this sort of system on top of building our actual product."
Esa última frase, "on top of building our actual product", es toda la historia de los runtimes de agentes gestionados. Reducen el trabajo de infraestructura, pero el trabajo de producto sigue siendo tuyo.
Quién debería usar Bedrock Managed Agents (y quién no)
Úsalo si ya estás muy metido en AWS, tu equipo de seguridad o compras ha aprobado AWS pero no a un nuevo proveedor de IA, y quieres específicamente el harness y los modelos de OpenAI. El modelo de IAM por agente, el registro en CloudTrail y la historia de "nada sale de la cuenta" son el valor real, y son difíciles de conseguir en otro sitio con modelos de OpenAI.
Espera si necesitas subagentes, memoria a largo plazo, entrada de imágenes o cualquier cosa fuera de tres Regiones de EE. UU. Nada de eso está en la preview, y no hay fecha de GA.
Descártalo si no estás atado a los modelos de OpenAI (el harness de AgentCore está en GA y es agnóstico al modelo), o si quieres que el proveedor ejecute también el sandbox (Claude Managed Agents o la Agents API alojada de OpenAI).
Y piénsalo bien si tu objetivo real es un agente de negocio, como uno que responda tickets de soporte. Un agente de soporte es un producto, no un runtime. Me encuentro con este patrón a menudo. En las notas de bajas de clientes de eesel, varios clientes, entre ellos una empresa de AR y tecnología de la construcción y una marca de belleza DTC, se fueron para construir su agente de soporte directamente sobre una API de LLM. Otros hicieron lo contrario. Un responsable de ingeniería de una empresa de hardware de cajeros de Bitcoin, con una base de conocimiento de más de 300 artículos en Confluence, contó al equipo de eesel por qué eligieron comprar:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
BMA acorta el camino de "construir". No elimina la integración con el helpdesk, la recuperación de conocimiento, la lógica de escalado ni las pruebas. Y esas son las partes que llevan meses.
eesel para equipos que quieren el agente, no la fontanería
Bedrock Managed Agents es infraestructura. eesel es el empleado. En concreto, eesel es una plataforma de compañeros de IA donde contratas compañeros listos para trabajar en tareas definidas, y para soporte ese es el compañero de IA para helpdesk: se conecta en minutos a Zendesk, Freshdesk, Gorgias y al resto de tu helpdesk, aprende de tus tickets anteriores y tu centro de ayuda, y se ejecuta contra cientos de tus tickets históricos en una simulación antes de responder a un cliente real. Según las propias estadísticas de clientes de eesel, Gridwise vio un 73% de sus tickets de nivel 1 resueltos en el primer mes.
Si el motivo por el que mirabas BMA es que te gusta manejar agentes desde una terminal, eesel también lo tiene. La CLI de eesel (@eesel/cli) opera el mismo compañero y el mismo espacio de trabajo que ves en el panel: conecta integraciones, edita las instrucciones permanentes del agente, aprueba o rechaza acciones pendientes con eesel approvals y lee cada ejecución con eesel activity. Cada comando imprime JSON, los comandos de escritura admiten --dry-run para que veas la llamada exacta antes de enviarla, y la autenticación sin interfaz funciona en CI. Agentes de programación como Claude Code, Codex y Cursor pueden manejarla, y cada espacio de trabajo expone además un servidor MCP. Es la misma idea que el diseño API-first de BMA, pero apuntada a un agente de soporte terminado en lugar de a un bucle vacío.
Prueba eesel gratis. Los precios empiezan con un plan gratuito de 100 créditos, y luego planes de pago desde $299 al mes por 500, y un ticket o chat gestionado equivale a un crédito.
Preguntas frecuentes
¿Qué es Amazon Bedrock Managed Agents?
¿Cuánto cuesta Bedrock Managed Agents?
¿Bedrock Managed Agents está disponible de forma general?
¿Qué diferencia hay entre Bedrock Managed Agents y la OpenAI Agents API?
¿Bedrock Managed Agents tiene memoria?
¿Qué modelos admite Bedrock Managed Agents?
¿Debería usar Bedrock Managed Agents para atención al cliente?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.