Resumen
Bedrock Managed Agents (BMA) cobra $0 por el servicio durante su vista previa pública, que se abrió el 29 de septiembre de 2026. Lo que realmente pagas son tres cosas: tokens de modelos de OpenAI a la tarifa in-Region de Bedrock (un 10% por encima de los precios de OpenAI), CPU y memoria de AgentCore Runtime si lo usas, y unos $33 al mes por el NAT gateway de la pila de ejemplo de AWS, que se factura aunque no se ejecute nada.
En una tarea típica de 10 minutos (200K tokens de entrada, 20K de salida) con GPT-5.6 Luna en AgentCore, me salen unos $0.09 por tarea. Con GPT-5.6 Sol, la misma tarea cuesta unos $1.34. Así que el modelo que elijas mueve la factura unas 15 veces, mientras que el recargo de AWS en esa tarea con Luna es de aproximadamente medio centavo. Y AWS dice que el precio "is subject to change" en GA.
Mi opinión: el precio de BMA es razonable para equipos que necesitan que los agentes de OpenAI se queden dentro de AWS. Solo presupuesta el modelo, no el titular de $0. Si el agente que estás valorando es de soporte, eesel es la opción lista para usar: un plan mensual fijo de créditos, con la integración con el helpdesk y las pruebas con el historial de tickets ya hechas.
¿Cuánto cuesta Bedrock Managed Agents?
La línea de precios de AWS para la vista previa es una sola frase: "During preview, there is no additional charge for BMA beyond the underlying AWS resources your agents consume. Pricing is subject to change at general availability" (AWS What's New).
Dos años haciendo SEO me enseñaron algo sobre las búsquedas de precios: la palabra "gratis" lleva a más gente a una conclusión equivocada que cualquier otra. Quien busca "bedrock managed agents pricing" quiere la cifra que verá su equipo de finanzas, y esa cifra nunca es $0. La documentación para desarrolladores detalla qué cubren los "recursos subyacentes": "You incur charges for model inference and the AWS resources that your application uses," y el ejemplo de AgentCore "can continue to incur charges when no BMA turn is running" (AWS docs).
Si el servicio es nuevo para ti, mi guía de Bedrock Managed Agents explica cómo encajan las sesiones, el exec server y los entornos de ejecución. Este artículo trata solo de la factura.
Aquí está cada línea que puede aparecer, en una tabla:
| Concepto de coste | Precio en vista previa | Unidad facturable | Cuándo se aplica |
|---|---|---|---|
| Tarifa del servicio BMA | $0 | n/a | Siempre (sujeto a cambios en GA) |
| Tokens de modelos de OpenAI | Tarifa in-Region, p. ej. $0.22 entrada / $1.32 salida para GPT-5.6 Luna | Por 1M de tokens de entrada, en caché y de salida | En cada turno |
| CPU de AgentCore Runtime v2 | $0.1276 por vCPU-hora | Por segundo, solo CPU activa | Si AgentCore es tu entorno de ejecución |
| Memoria de AgentCore Runtime v2 | $0.0169 por GB-hora | Por segundo, la memoria inactiva se recupera tras 120 segundos | Si AgentCore es tu entorno de ejecución |
| NAT gateway | $0.045 por hora + $0.045 por GB | Por hora (las horas parciales se facturan completas) | Pila de ejemplo de AgentCore de AWS |
| S3, S3 Files, CloudWatch | Tarifas estándar de AWS | Almacenamiento y solicitudes | Skills, resultados y registros |
| Cómputo autoalojado | Lo que cueste tu host | Tu factura actual | Si ejecutas codex exec-server tú mismo |
Esa es toda la estructura. No todas las líneas pesan igual, así que el resto del artículo trata de las que importan.
Línea 1: tokens del modelo y el recargo in-Region del 10%
Cada modelo de OpenAI en Bedrock publica sus precios en su propia ficha de modelo. El detalle que importa para BMA está en las limitaciones de la vista previa: la inferencia entre regiones no es compatible. Es decir, cada solicitud de BMA paga la tarifa in-Region, y AWS lo dice claramente: "Commercial In-Region prices include a 10% fee over OpenAI rates" (ficha de GPT-5.6 Luna).
Estas son las tarifas del nivel Standard, contexto corto (272K tokens de entrada o menos), por millón de tokens, para los modelos de OpenAI que consideraría para un agente, todas de sus fichas de Bedrock en la página de modelos de OpenAI de AWS:
| Modelo | Entrada (tarifa BMA) | Escritura en caché | Lectura de caché | Salida (tarifa BMA) | Tarifa propia de OpenAI (ent. / sal.) |
|---|---|---|---|---|---|
| GPT-6 Luna | $0.11 | $0.1375 | $0.011 | $0.55 | $0.10 / $0.50 |
| GPT-5.6 Luna | $0.22 | $0.275 | $0.022 | $1.32 | $0.20 / $1.20 |
| GPT-6.1 Sol | $2.20 | $2.75 | $0.11 | $11.00 | $2.00 / $10.00 |
| GPT-5.6 Terra | $2.20 | $2.75 | $0.22 | $13.20 | $2.00 / $12.00 |
| GPT-5.6 Sol | $4.40 | $5.50 | $0.44 | $22.00 | $4.00 / $20.00 |
| GPT-6 Astra | $11.00 | $13.75 | $1.10 | $55.00 | $10.00 / $50.00 |
Cuatro detalles de esas fichas cambiarán tu estimación más de lo que sugiere la tabla:
- El contexto largo duplica la entrada. Cuando una solicitud supera los 272,000 tokens de entrada, la tarifa de contexto largo se aplica "to the full request," no solo al excedente (ficha de GPT-6.1 Sol). En GPT-5.6 Sol son $8.80 de entrada y $33.00 de salida. Un agente que arrastra una gran ventana de contexto en cada turno llegará ahí enseguida.
- Sin descuentos Priority ni Flex. Todas las fichas indican que los niveles Priority y Flex no son compatibles, así que no hay un nivel más barato tipo lote para trabajos nocturnos. Solo existe Standard.
- El caché no es uniforme. La ficha de GPT-6.1 Sol lista precios de caché pero dice "Explicit prompt caching is not supported for this Bedrock model." Revisa la ficha del modelo exacto antes de contar con el descuento del 90% en lectura de caché.
- Los modelos más nuevos viven en una sola región. En el endpoint
bedrock-mantleque usa BMA, GPT-6 Luna y GPT-6.1 Sol solo están disponibles enus-east-1. Si despliegas en Oregón u Ohio, estás en la familia GPT-5.6.
La generación más nueva también es la más barata por token aquí: GPT-6 Luna cuesta la mitad que GPT-5.6 Luna tanto en entrada como en salida. Si ibas a elegir una Luna de todos modos, prueba primero GPT-6 Luna. Mis artículos sobre precios de GPT-6 Luna y precios de GPT-6.1 Sol los comparan con el resto de la gama de OpenAI.
Línea 2: horas de AgentCore Runtime
BMA no ejecuta tus herramientas por sí mismo; se ejecutan en cómputo que tú aportas: tu propio host o Amazon Bedrock AgentCore Runtime, que es la opción por defecto en el ejemplo de AWS. Si usas AgentCore, pagas sus tarifas de runtime (precios de AgentCore):
| Recurso de AgentCore Runtime | Tarifa de consumo | Base comprometida |
|---|---|---|
| CPU de microVM v2 | $0.1276 por vCPU-hora | $0.0997 por vCPU-hora (lanzamiento antes de octubre de 2026) |
| Memoria de microVM v2 | $0.0169 por GB-hora | $0.0132 por GB-hora (lanzamiento antes de octubre de 2026) |
| CPU de microVM v1 | $0.0895 por vCPU-hora | n/a |
| Memoria de microVM v1 | $0.00945 por GB-hora | n/a |
| Instancias de runtime (EC2) | Tarifa On-Demand de EC2 | más una comisión de gestión del 12% |
Este modelo de facturación es más favorable a los agentes de lo que parece. AWS dice que la CPU "scales to zero during I/O wait (waiting for LLM responses, tool / API calls, or database queries)," y que en v2 "idle memory is reclaimed automatically" tras 120 segundos. Como un agente pasa la mayor parte de su vida esperando al modelo, la mayor parte del tiempo real no factura CPU.
La propia página de precios de AWS tiene un ejemplo resuelto muy parecido a un agente de soporte: 1 millón de sesiones al mes, 10 minutos cada una, 90% de espera de E/S, 1 vCPU y hasta 2.5 GB. Su total es de $0.006703 por sesión, o $6,703 al mes por el millón. Y eso es solo runtime, antes de pagar un solo token.
Una cosa a vigilar: el ejemplo de AgentCore de BMA fija el tiempo de inactividad y la vida máxima del runtime en 28,800 segundos, es decir, ocho horas. La memoria inactiva se recupera, sí, pero una sesión que olvidas sigue siendo una sesión.
Línea 3: el NAT gateway que factura mientras tu agente duerme
La pila de ejemplo de AgentCore de AWS crea una VPC con subredes privadas, un endpoint de gateway de S3 y un NAT gateway. Según los precios de Amazon VPC en US East, un NAT gateway cuesta $0.045 por hora más $0.045 por GB procesado, y las horas parciales se facturan como horas completas.
En un mes de 730 horas son $32.85 antes de que tu agente haga nada. Para un equipo de producción es poco dinero. En una cuenta de desarrollo, donde alguien probó el ejemplo un viernes y se olvidó, es una línea que sigue apareciendo cada mes hasta que alguien ejecuta los pasos de limpieza. Por eso la propia documentación de AWS sugiere ejecutar el ejemplo en una cuenta de desarrollo.
Las demás líneas de almacenamiento (buckets de S3 para skills y resultados, montajes de S3 Files, registros de CloudWatch) suelen ser centavos con volumen de pruebas. Como escalan con lo que escribe tu agente, conviene revisarlas en tu factura de AWS cuando estés en producción.
Cuánto cuesta realmente una tarea de agente
Este es el ejemplo resuelto que uso. Una tarea en la que el agente lee código y documentación y luego escribe un resultado. Son 200,000 tokens de entrada y 20,000 de salida, sin caché, 10 minutos en una sesión de AgentCore de 2 vCPU / 4 GB donde la CPU está ocupada el 20% del tiempo.
- Runtime: 120 segundos ocupados x 2 vCPU x $0.1276 por hora = $0.0085, más 600 segundos x 4 GB x $0.0169 por hora = $0.0113. Redondea a $0.02, y menos si v2 recupera la memoria inactiva.
- Tokens con GPT-5.6 Luna: 0.2M x $0.22 + 0.02M x $1.32 = $0.070.
- Tokens con GPT-5.6 Sol: 0.2M x $4.40 + 0.02M x $22.00 = $1.32.
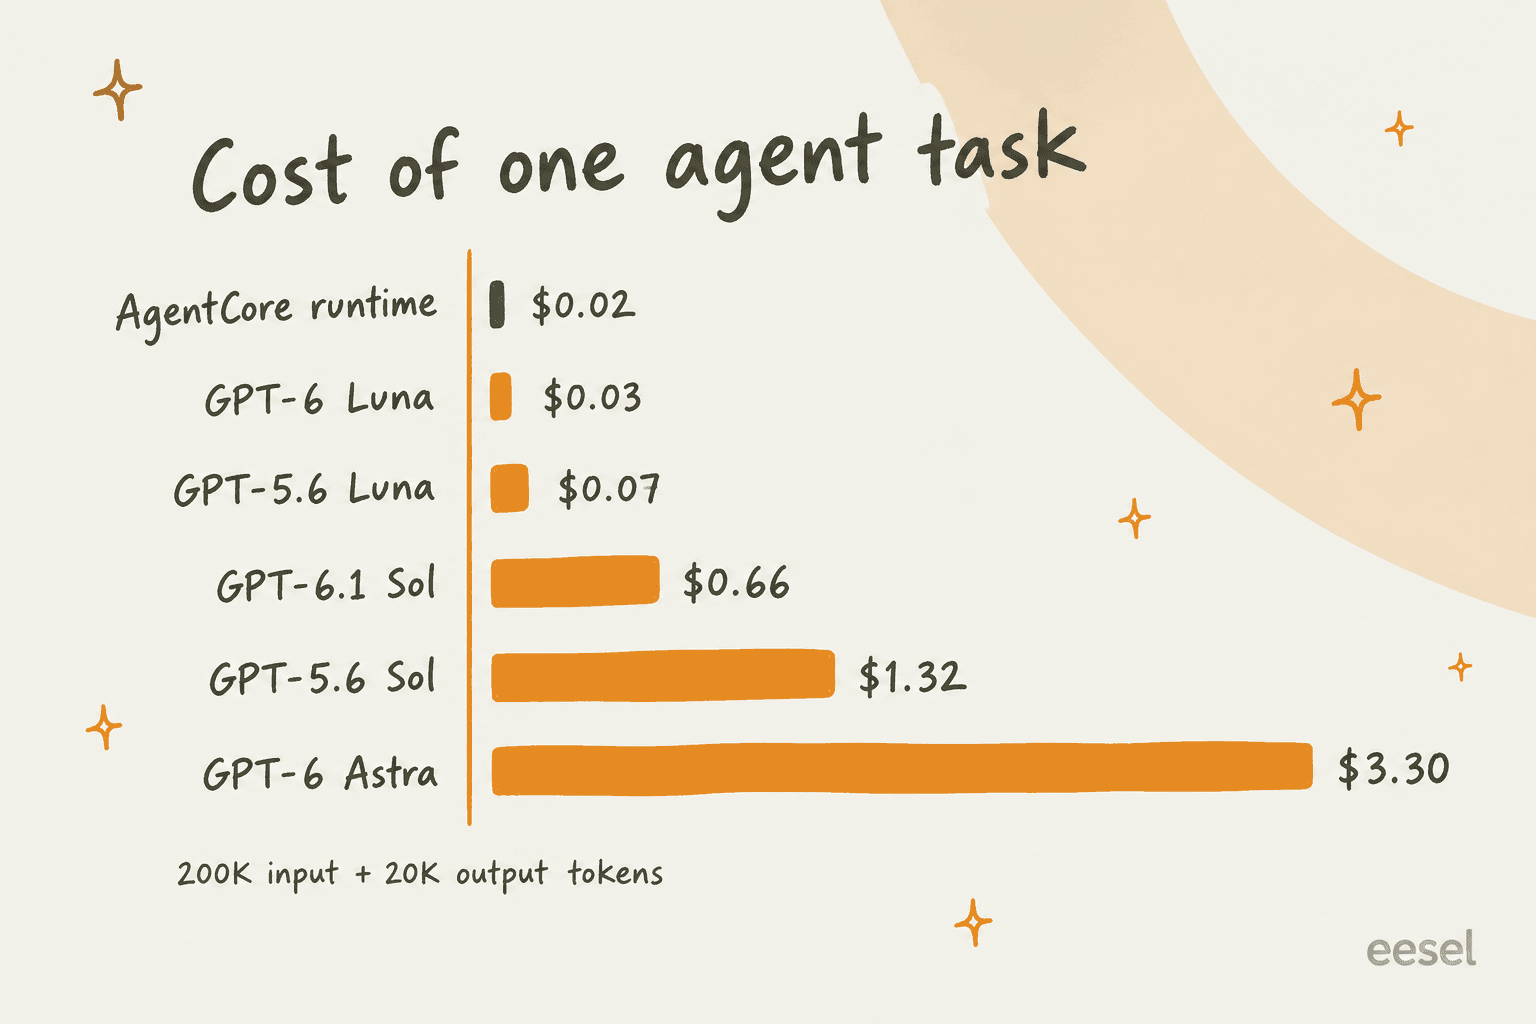
Si te llevas una sola cosa de este artículo, que sea ese gráfico. El runtime es la barra más pequeña del gráfico. Pasar de GPT-6 Luna a GPT-6 Astra en la misma tarea multiplica por 100 el coste en tokens, mientras el runtime de AgentCore se queda en unos dos centavos. Si quieres recortar una factura de BMA, la palanca es la elección del modelo. Ajustar las vCPU apenas mueve nada.
Así escala a lo largo de un mes con GPT-5.6 Luna, con el NAT gateway activado:
| Tareas al mes | Tokens | Runtime de AgentCore | NAT gateway | Total mensual | Por tarea |
|---|---|---|---|---|---|
| 1,000 | $70 | $20 | $33 | $123 | $0.123 |
| 10,000 | $704 | $198 | $33 | $935 | $0.093 |
| 100,000 | $7,040 | $1,977 | $33 | $9,050 | $0.091 |
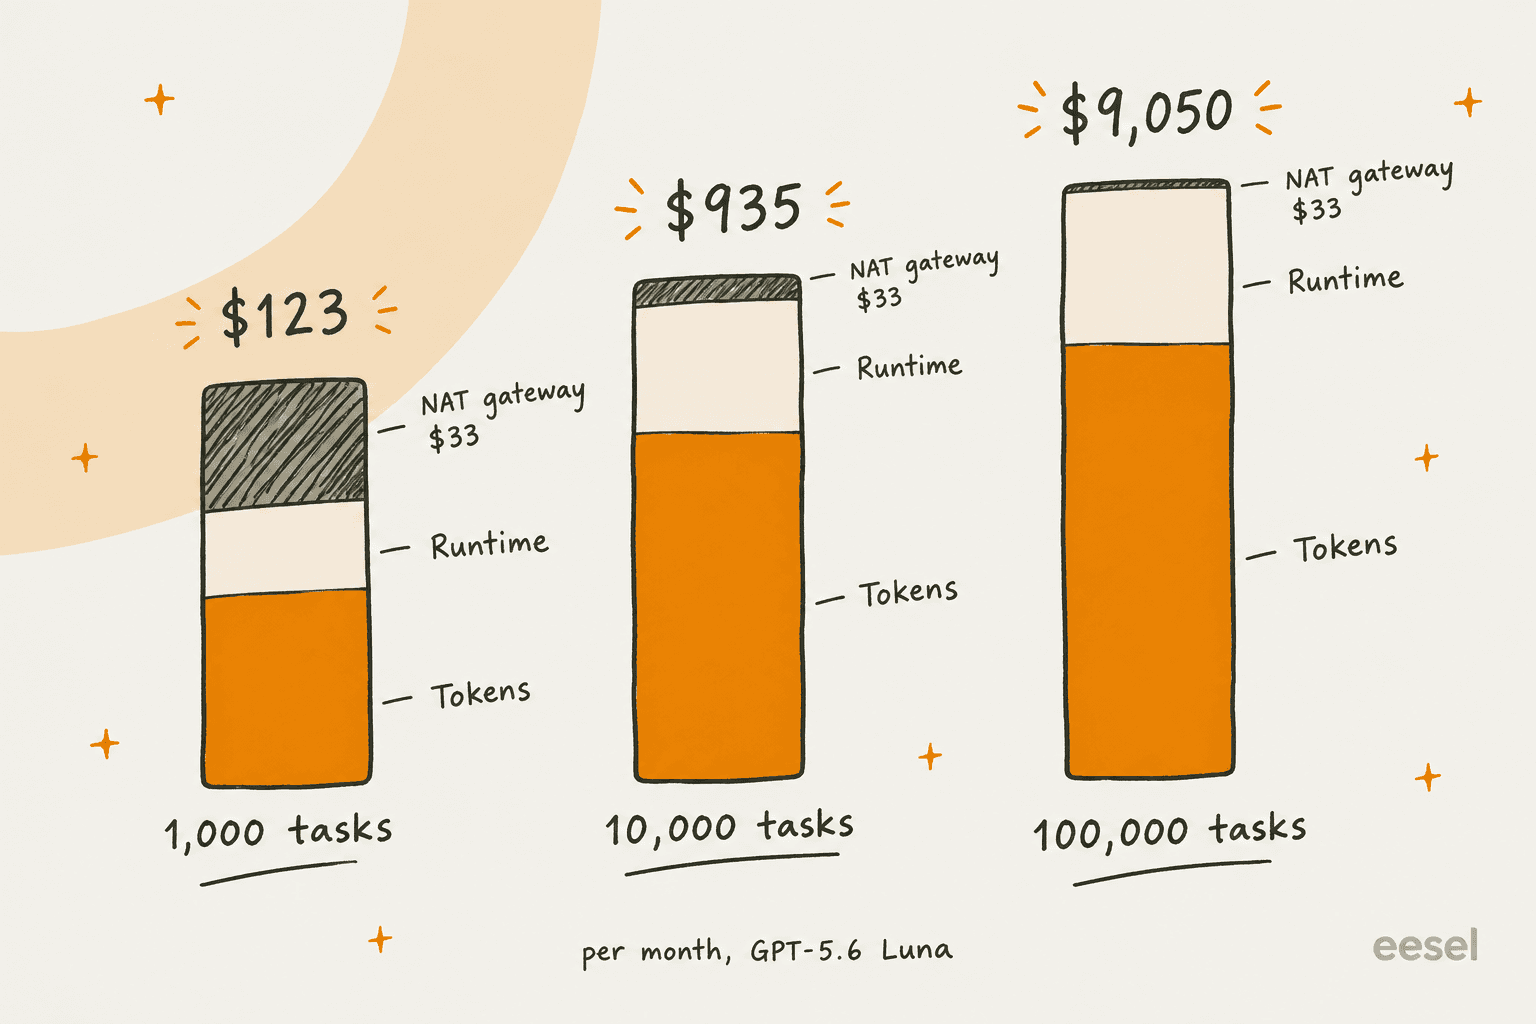
Con poco volumen, el NAT gateway fijo supone más de una cuarta parte de la factura. Con 100,000 tareas es ruido y los tokens son casi el 80%. Así que el consejo cambia según la escala: los equipos pequeños deberían autoalojar o desmontar la pila de ejemplo entre pruebas, y los grandes deberían centrarse en la elección del modelo y el prompt caching (hacer que el contexto repetido sea cacheable).
Puedes introducir tus propias cifras en la calculadora de abajo, que usa las mismas tarifas que las tablas anteriores:
¿Vale la pena el recargo del 10% de AWS?
Creo que es la pregunta que más se hacen los compradores. La respuesta es más favorable a AWS de lo que sugiere el titular. Aquí está la misma tarea de 10 minutos con GPT-5.6 Luna, calculada de cuatro formas:
| Configuración | Tokens | Runtime | Por tarea |
|---|---|---|---|
| API de OpenAI Agents, sandbox autoalojado | $0.064 (tarifa de OpenAI) | $0 | $0.064 |
| Bedrock Managed Agents, autoalojado | $0.070 (tarifa in-Region) | $0 | $0.070 |
| Bedrock Managed Agents en AgentCore | $0.070 | unos $0.020 | $0.090 |
| API de OpenAI Agents, contenedor alojado de 4 GB | $0.064 | $0.06 | $0.124 |
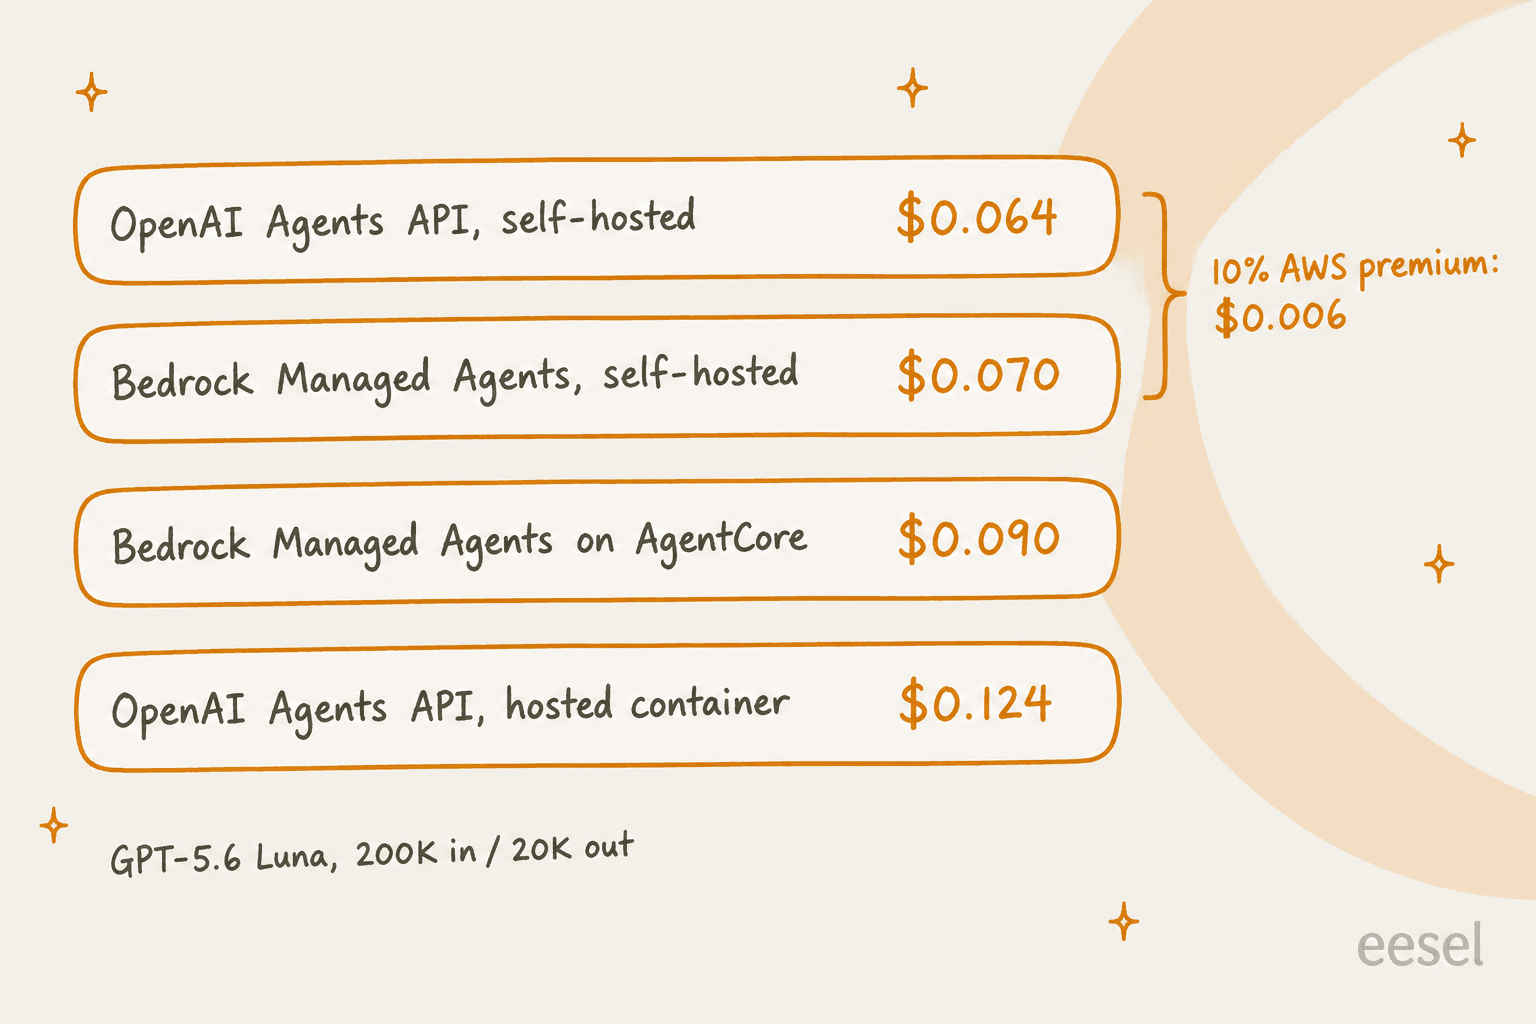
La línea del contenedor alojado usa la tarifa publicada de OpenAI de $0.12 por sesión de 20 minutos para un contenedor de 4 GB, facturada por minuto con un mínimo de 5 minutos (precios de OpenAI). Mi artículo sobre precios de la API Agents repasa todos los tamaños de contenedor.
Así que el recargo de AWS en esta tarea es de unos $0.006. Es dinero real con un millón de tareas al mes (unos $6,400), pero es menor que la diferencia entre el contenedor alojado de OpenAI y la facturación de AgentCore que tiene en cuenta la E/S. Si de otro modo usarías el sandbox alojado de OpenAI, BMA en AgentCore puede salir más barato por tarea, no más caro. Si autoalojarías en cualquiera de los dos casos, BMA te cuesta exactamente ese 10%.
Lo que compra el recargo es la parte que importa en una revisión de seguridad: el runtime del agente, la inferencia del modelo y tus herramientas se quedan dentro de tu cuenta de AWS, bajo el contrato de AWS. La lógica de compras la expresó bien un comentarista de Hacker News:
"A lot of companies already have data processing agreements and compliance sign-off for using AWS. Many are hesitant to send their data to AI startups with an incentive to train their models and a history of being.... loose with how they intake training data. Even when they do give assurances otherwise. AWS is more trusted in this aspect. If this ends up similar to Claude on Bedrock, it's the same price."

No resultó ser exactamente el mismo precio, pero se acerca: un 10% más por la garantía in-Region. Si tu empresa ya tiene la documentación de AWS firmada y tardaría meses en aprobar un nuevo proveedor de IA, ese 10% es probablemente el trabajo de cumplimiento más barato que comprarás este año.
Cómo se compara el precio de BMA con otros runtimes de agentes gestionados
Todos los grandes laboratorios venden ya un bucle de agente gestionado, y cada uno cobra el runtime a su manera. Los tokens siempre se pagan aparte, a las tarifas de modelo de cada proveedor:
| Runtime | Tarifa de runtime | Unidad facturable | Modelos |
|---|---|---|---|
| Bedrock Managed Agents | $0 en vista previa, más tu cómputo | n/a | OpenAI en Bedrock |
| Claude Managed Agents | $0.08 por hora de sesión | Tiempo en estado running | Solo Claude |
| API de OpenAI Agents | $0.03 a $1.92 por contenedor de 20 minutos | Por minuto, mínimo de 5 minutos | Solo OpenAI |
| Gemini Managed Agents | Cómputo no facturado en vista previa | n/a | Solo Gemini |
| AgentCore harness | Sin tarifa de harness, más AgentCore Runtime | CPU y memoria por segundo | Cualquier modelo de Bedrock, OpenAI, Gemini o compatible con LiteLLM |
Ahora mismo dos de ellos son gratuitos en la capa de runtime, y ambos son vistas previas. Ese es el patrón a notar: los precios de lanzamiento en esta categoría son generosos, y ningún laboratorio ha dicho cuánto costará su vista previa cuando esté disponible de forma general.
El AgentCore harness es la única opción nativa de AWS que ya está disponible de forma general, es agnóstica al modelo y no tiene tarifa de harness aparte. A menos que estés comprometido específicamente con el harness de OpenAI, te da la misma facturación de runtime y más variedad de modelos. Claude Managed Agents añade un cargo de runtime pero hoy incluye más funciones: almacenes de memoria, multiagente y sandboxes de proveedor. Mi artículo sobre precios de la API de Anthropic cubre el lado de tokens de esa comparación, y el repaso de alternativas a la API de OpenAI Agents abarca el resto del panorama.
También hay un ángulo estratégico que una publicación de LinkedIn expresó mejor que yo:
"Near-zero switching costs between frontier models on the same bill sounds like a buyer's market. It is, for now. When you can swap Claude for GPT-5.5 with a one-line code change, models start looking interchangeable, and the platform hosting them all owns the customer relationship and the pricing power."

Es una razón para mantener portable el código de tu agente, no para evitar BMA.
Costes ocultos que debes presupuestar
Las tarifas publicadas son bastante claras. Lo que sorprende a los equipos es lo que no aparece en ninguna tarifa:
- La tarifa de GA que nadie ha anunciado. AWS no ha publicado precio ni fecha posteriores a la vista previa. Si quieres un valor provisional, los $0.08 por hora de sesión de Claude añadirían unos $0.013 a la tarea de 10 minutos de arriba. Trátalo como un escenario de presupuesto, no como una predicción.
- El crecimiento del contexto entre turnos. Cada turno reenvía la conversación hasta ese momento, así que una tarea de 20 turnos puede costar mucho más que 20 copias del primer turno. El caché ayuda en los modelos que lo admiten, y el precipicio de contexto largo de 272K duele en los que no.
- Lo que BMA todavía no incluye. La vista previa no tiene memoria a largo plazo integrada, así que AWS indica que hay que "provision and authorize any application-specific datastore separately" (limitaciones de la vista previa). Si añades AgentCore Memory, cuesta $0.25 por 1,000 eventos nuevos más $0.75 por 1,000 registros de largo plazo almacenados al mes (precios de AgentCore).
- Revisión humana. Para acciones con efectos externos, la documentación de seguridad indica que debes aplicar tú mismo la autorización y cualquier revisión human-in-the-loop. Eso es tiempo de ingeniería, no una línea de la factura de AWS.
- Tiempo de ingeniería, sin más. Es la línea más grande de todas, y nunca aparece en la factura de AWS.
Sobre ese último punto, vale la pena escuchar a los propios críticos de AgentCore:
"There's not really a good solution, as AgentCore runtime sucks and is expensive. You basically have to build this yourself because nobody is solving for self-hosted managed infra for agents, and we don't really have the time to build this sort of system on top of building our actual product."
Con las cifras de arriba, no estoy de acuerdo en que el runtime sea caro. Pero la segunda mitad de ese comentario es el coste real de cualquier runtime gestionado: construir el producto sigue siendo cosa tuya.
¿Vale la pena Bedrock Managed Agents para un agente de soporte?
Aquí es donde veo que más se equivocan las cuentas. Alguien calcula un agente de soporte en BMA, ve unos nueve centavos por conversación y decide que será baratísimo. La cuenta de tokens también es correcta. Pero deja fuera la integración con el helpdesk, la recuperación sobre tu base de conocimiento, las reglas de escalada, las pruebas con tickets reales y el ingeniero de guardia que lo mantiene.
En eesel llevo años viendo esto en ambos sentidos. Un cliente mediano que se fue tras una integración rota y un soporte lento dijo al equipo de eesel "long term we will just build our own, which is so possible now with AI." Y en el otro sentido: un responsable de ingeniería de una empresa de hardware con una base de conocimiento de más de 300 artículos explicó por qué eligieron comprar:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Ambas son decisiones razonables. Si tienes ingenieros que quieren ser dueños de un agente de IA y necesitas modelos de OpenAI dentro de AWS, el precio de BMA no será lo que te detenga. Si comparas BMA con contratar un agente ya hecho, compara el coste total de construir frente a comprar en lugar de solo la factura de tokens. Mi guía sobre cómo crear agentes de soporte enumera todas las piezas a las que te comprometerías.
eesel: el agente de soporte con precio fijo
Si lo que estás valorando es un compañero de IA para el helpdesk, eesel saca el contador de tokens del presupuesto. Se conecta a Zendesk, Freshdesk, Gorgias y al resto de tu helpdesk y aprende de tus tickets pasados y tu centro de ayuda. Antes de responder a un cliente real, se prueba en simulación con cientos de tus tickets históricos.
Los precios son un plan de créditos en lugar de una factura de tokens: un plan gratuito con 100 créditos y luego planes de pago desde $299 al mes por 500 créditos, donde un ticket o chat gestionado es un crédito, con todas las funciones y puestos ilimitados. Finanzas puede poner esa cifra en una hoja de cálculo sin adivinar el crecimiento del contexto, y en el terreno del soporte al cliente, Gridwise vio resuelto el 73% de sus solicitudes de nivel 1 en el primer mes.
Y si el motivo por el que mirabas BMA es que quieres manejar agentes desde una terminal o un script, la CLI de eesel lo hace con el mismo compañero que ves en el panel. Puedes conectar integraciones, editar sus instrucciones, aprobar o rechazar acciones pendientes y leer su actividad, con salida JSON y --dry-run en las escrituras. También pueden manejarla agentes de programación como Claude Code, Codex y Cursor, algo que traté en mi artículo sobre CLI para agentes de IA.
Prueba eesel gratis y mira cuánto cuesta un agente de soporte cuando la fontanería ya está hecha.
Preguntas frecuentes
¿Cuánto cuesta Bedrock Managed Agents?
¿Bedrock Managed Agents es gratis durante la vista previa?
¿Por qué el precio de Bedrock Managed Agents es más alto que el de la API de OpenAI?
¿Cuál es la forma más barata de ejecutar Bedrock Managed Agents?
¿Cómo se comparan los precios de Bedrock Managed Agents con Claude Managed Agents?
¿Cambiarán los precios de Bedrock Managed Agents en la disponibilidad general?
¿Debería crear un agente de soporte en Bedrock Managed Agents para ahorrar?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.